Вот бы CUDA в интерпретаторы
Было бы любопытно попытаться использовать GPU в интерпретаторах. В том же самом JavaScript (про который я всё говорил, что это самый недооценённый язык и который грозится перейти в разряд переоценённых) или PHP.
Вот алгоритм сортировки приспособили для выполнения на GPU, на NVIDIA GeForce GTX480, код его реализующий, позволяет сортировать аж несколько миллиардов (!)
Правда, указанная видеокарта тот ещё монстр, в стоечный сервер её
Очередной BSOD
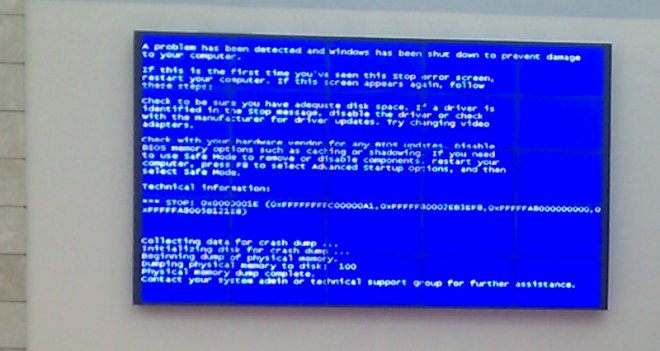
Очередной BSOD в торговом центре.
P.S. Начал смотреть «Обмани меня», нравится.
DE██
Досматривая
Я
«Жгут кислород»
Если мне
Не, ну конечно, из O2 можно получить O3, но условия совсем не те, нужен разряд. Может имеется ввиду окисление
Могла бы окисляться сама нить, но чтобы «сжигать кислород» нити бы требовались дикие количества, между тем она служит годами. Да и вольфрам, из которого делают обычно нити накаливания, очень стойкий металл.
Все неприятные эффекты от обогревателей связаны не с глупым мифом о «сжигании кислорода», а с двумя причинами — иссушением воздуха (который уносится с тёплым воздухом из помещения, холодный несёт меньше паров) и сжиганием воздушной пыли (в случае открытой нити или наличия очень горячих зон), которая какую только гадость в себе не несёт.
А то смотрите какую ерунду пишут:
«Иколайн» сжигает кислород в помещении?
Температура рабочей поверхности пластины обогревателя «Иколайн» невысока — всего 250°С, что недостаточно для сжигания кислорода в помещении. Исключение составляют обогреватели ЭИ10R, которые являются высокотемпературными, но они применяются только на открытых площадках
Кстати, теперь мы знаем при какой температуре якобы «сжигается кислород» — рабочая температура ЭИ10R составляет 600°C. Что за реакция
«Жгут кислород»—2
Не поленился написать на сайт, с которого (в прошлом посте) цитировал абзац из FAQ про «сжигание кислорода». Вот что ответили:
Взрослый человек должен понимать, что основная масса населения не осведомлена о таких понятиях как «сжигает кислород» или «не сжигает кислород», но при приобретении климатического оборудования активно интересуется данным вопросом. Объяснять, что такого понятия не существует, а на поверхности просто сгорает пыль и т. п. с выделением запаха — бесполезное занятие, клиент уйдет туда, где скажут «не сжигает кислород».
Полагаю вы хотели сделать открытие, основываясь на материалах моего сайта? Должен вас разочаровать, «сжигание кислорода» не происходит. Надеюсь Вы меня поняли, а я Вас ;)
Правда, остаётся открытым вопрос почему же ЭИ10R
Квартира строится

Прошло два месяца и дом, где мы купили квартиру, строится приятными темпами — как видно на фото, построили два этажа подземной парковки и приступают к строительству первого этажа здания. Между делом, стоимость жилья в этом квартале сильно выросла — примерно тысяч на шесть.
Из проблем — я до сих пор не получил полис страхования. В прошлый раз я нашёл в нём ошибку — улицу прописки написали «Зоре», а не «Зорге» (это фамилия советского разведчика), так и переделывают до сих пор.
Некоторые программисты стыдятся знания PHP
Просто наблюдение. Заметил, что на собеседовании программисты оправдываются, что знают PHP. «Не знаю как так получилось».
Сказка — ложь, да в ней намёк
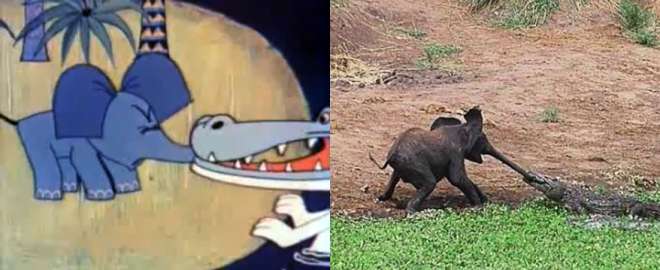
Клички городов
Вчера ночью
Есть несколько обсуждений на эту тему (например, на SearchEngines), но никакого подробного исследования в духе Лебедева.
Мне больше всего нравится «три шурупа» — неофициальное название Уфы («ӨФӨ» — так пишется название столицы Башкортостана на башкирском).
Пакетное скругление картинок
Надоело уменьшать картинки и скруглять им углы вручную. Написал программу для этого. Она уменьшает все
Обработанные файлы попадают в директорий «out», который создаётся по текущему пути.
Параметры запуска: makecorner [качество [ширина [радиус]]]
P.S.
P.P.S. Размер файла связан с тем, что там внутри библиотека GD и jpegtran (для оптимизации JPEG).
Добавлено через день: ключи запуска программы изменились.
Симферополь
Напоминаю, что читающие трансляции (в ЖЖ, «ярушке», ещё
Симферополь — город средних размеров (около 340 тысяч жителей) в республике Крым (Украина).
Я ездил туда по работе, поэтому удалось прогуляться только в центре города. А центр — это, обычно, не совсем то место, которое характеризует город.

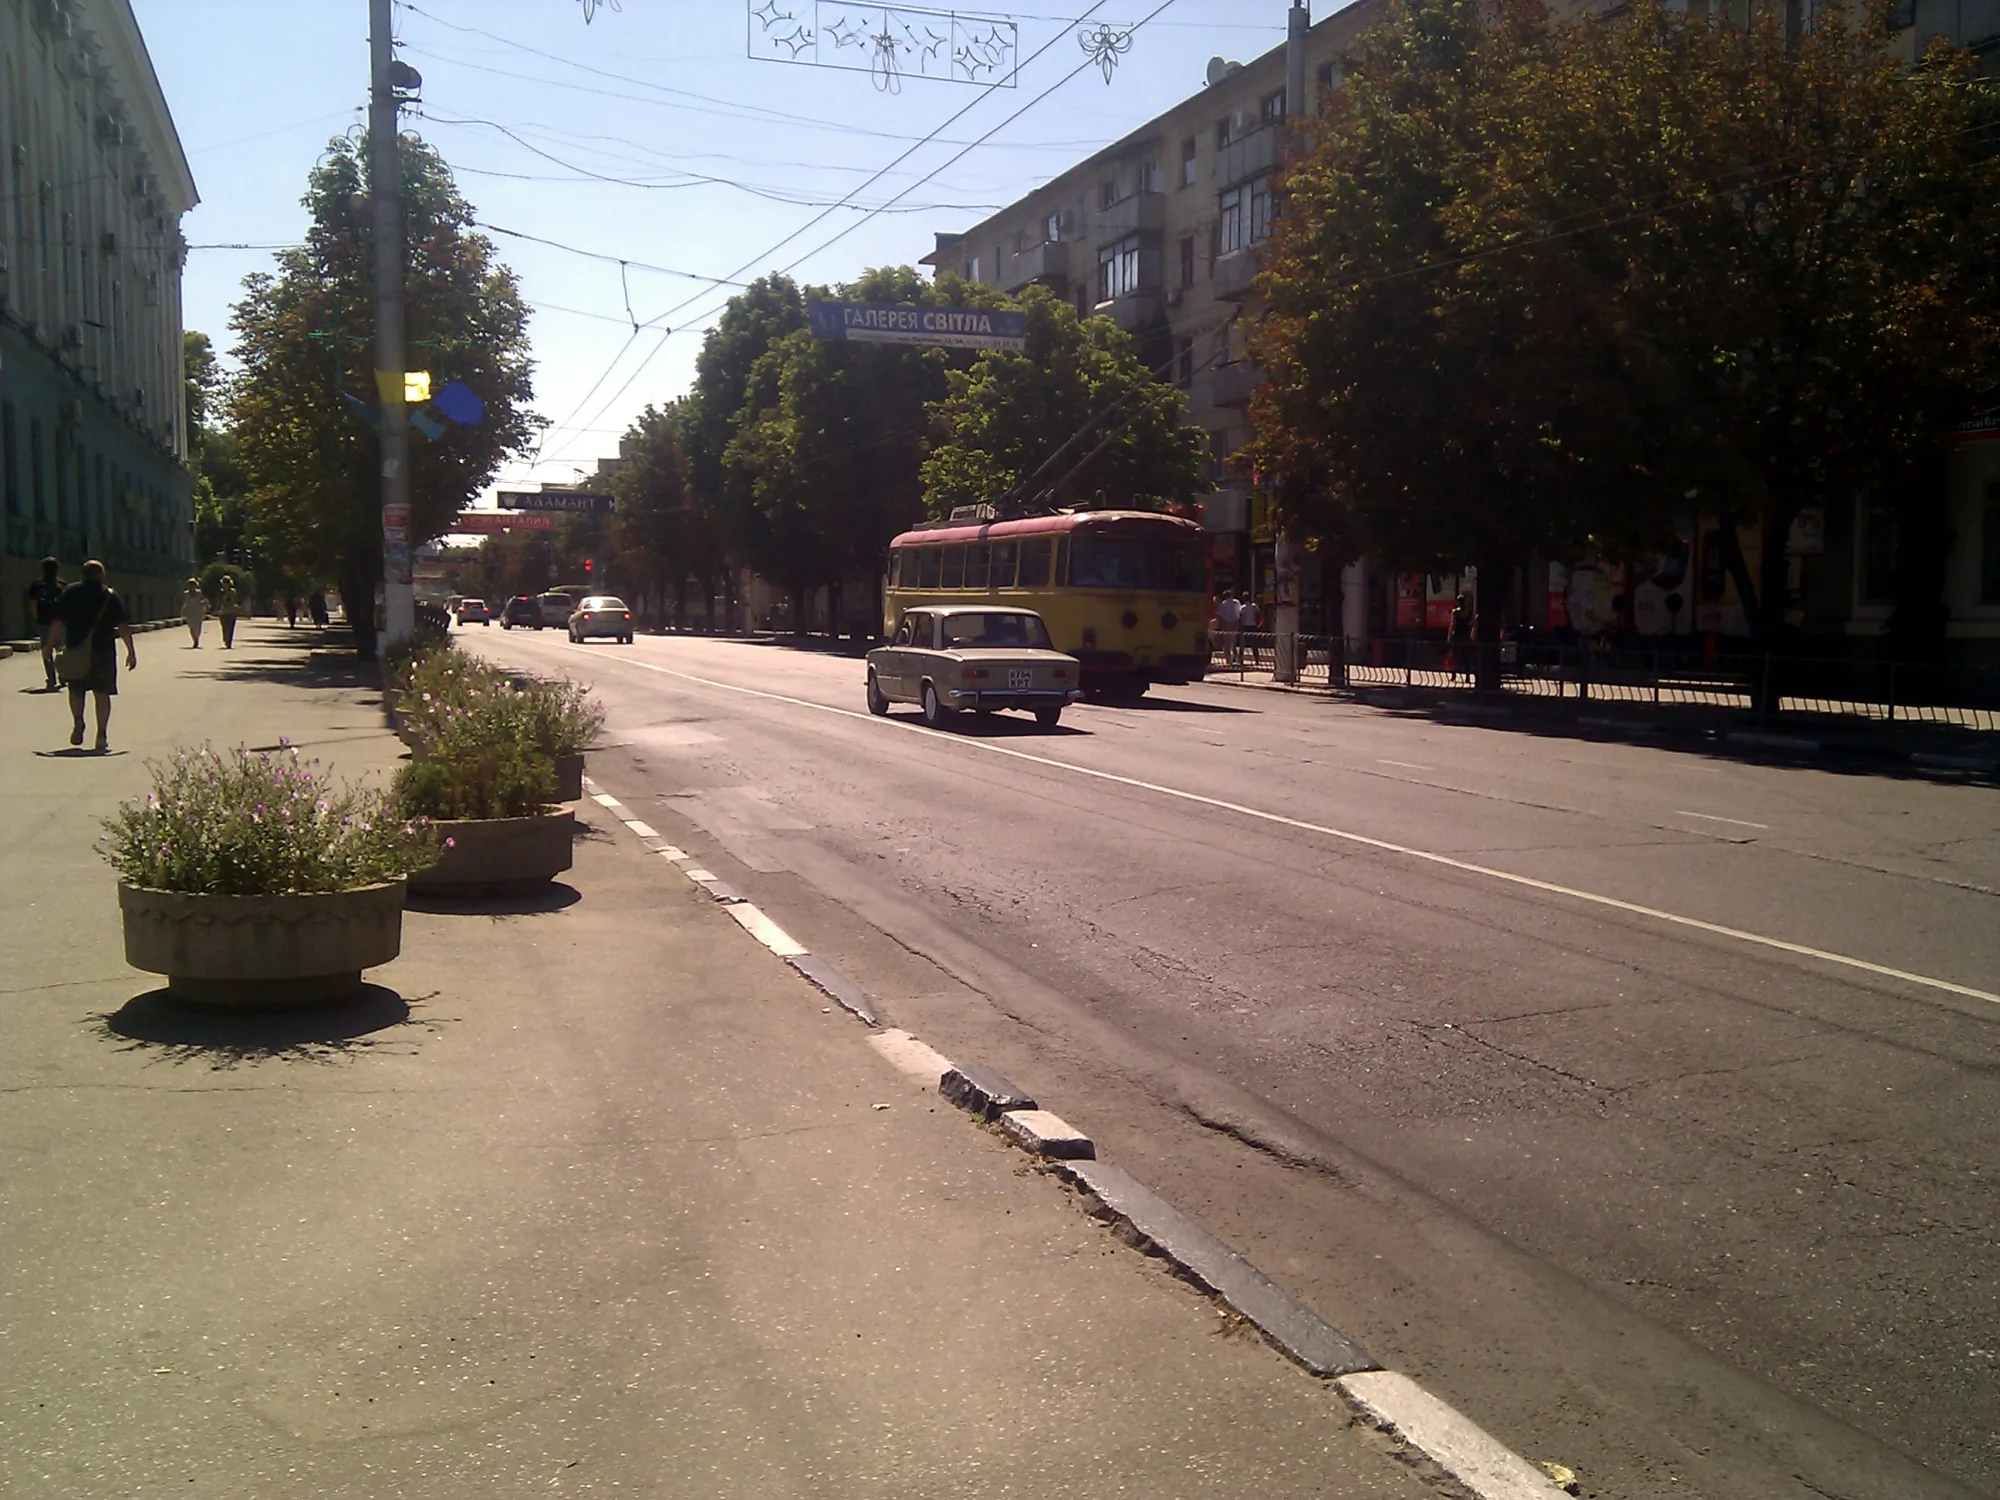
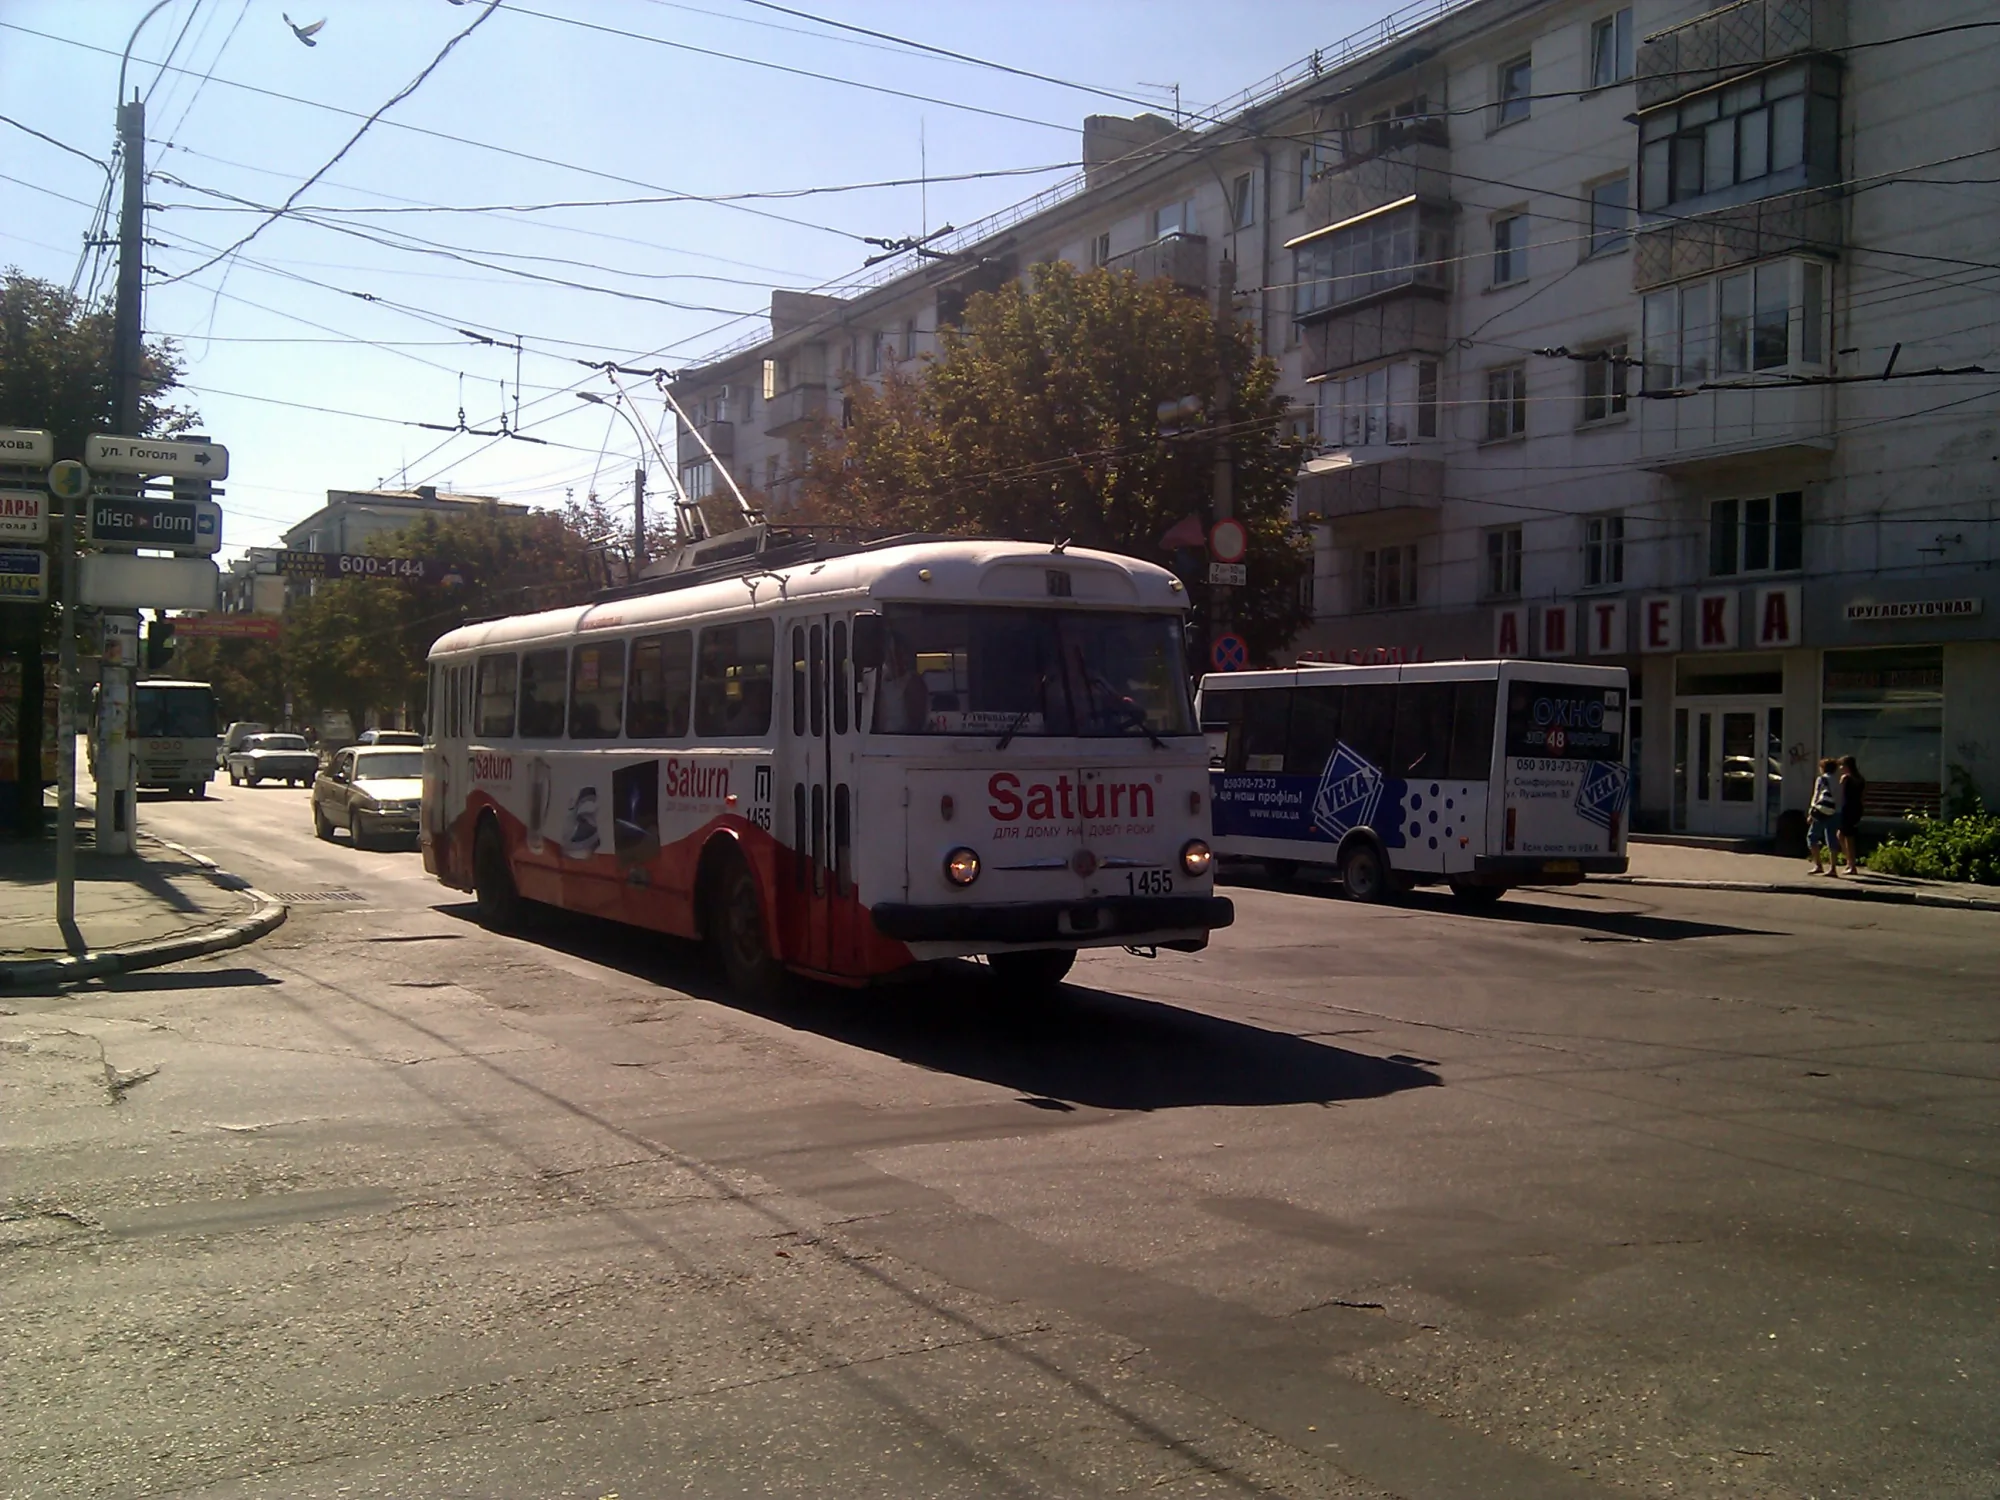
Центр города — это, в основном, небольшие, обычно двухэтажные, здания, сильно потрёпанные жизнью,
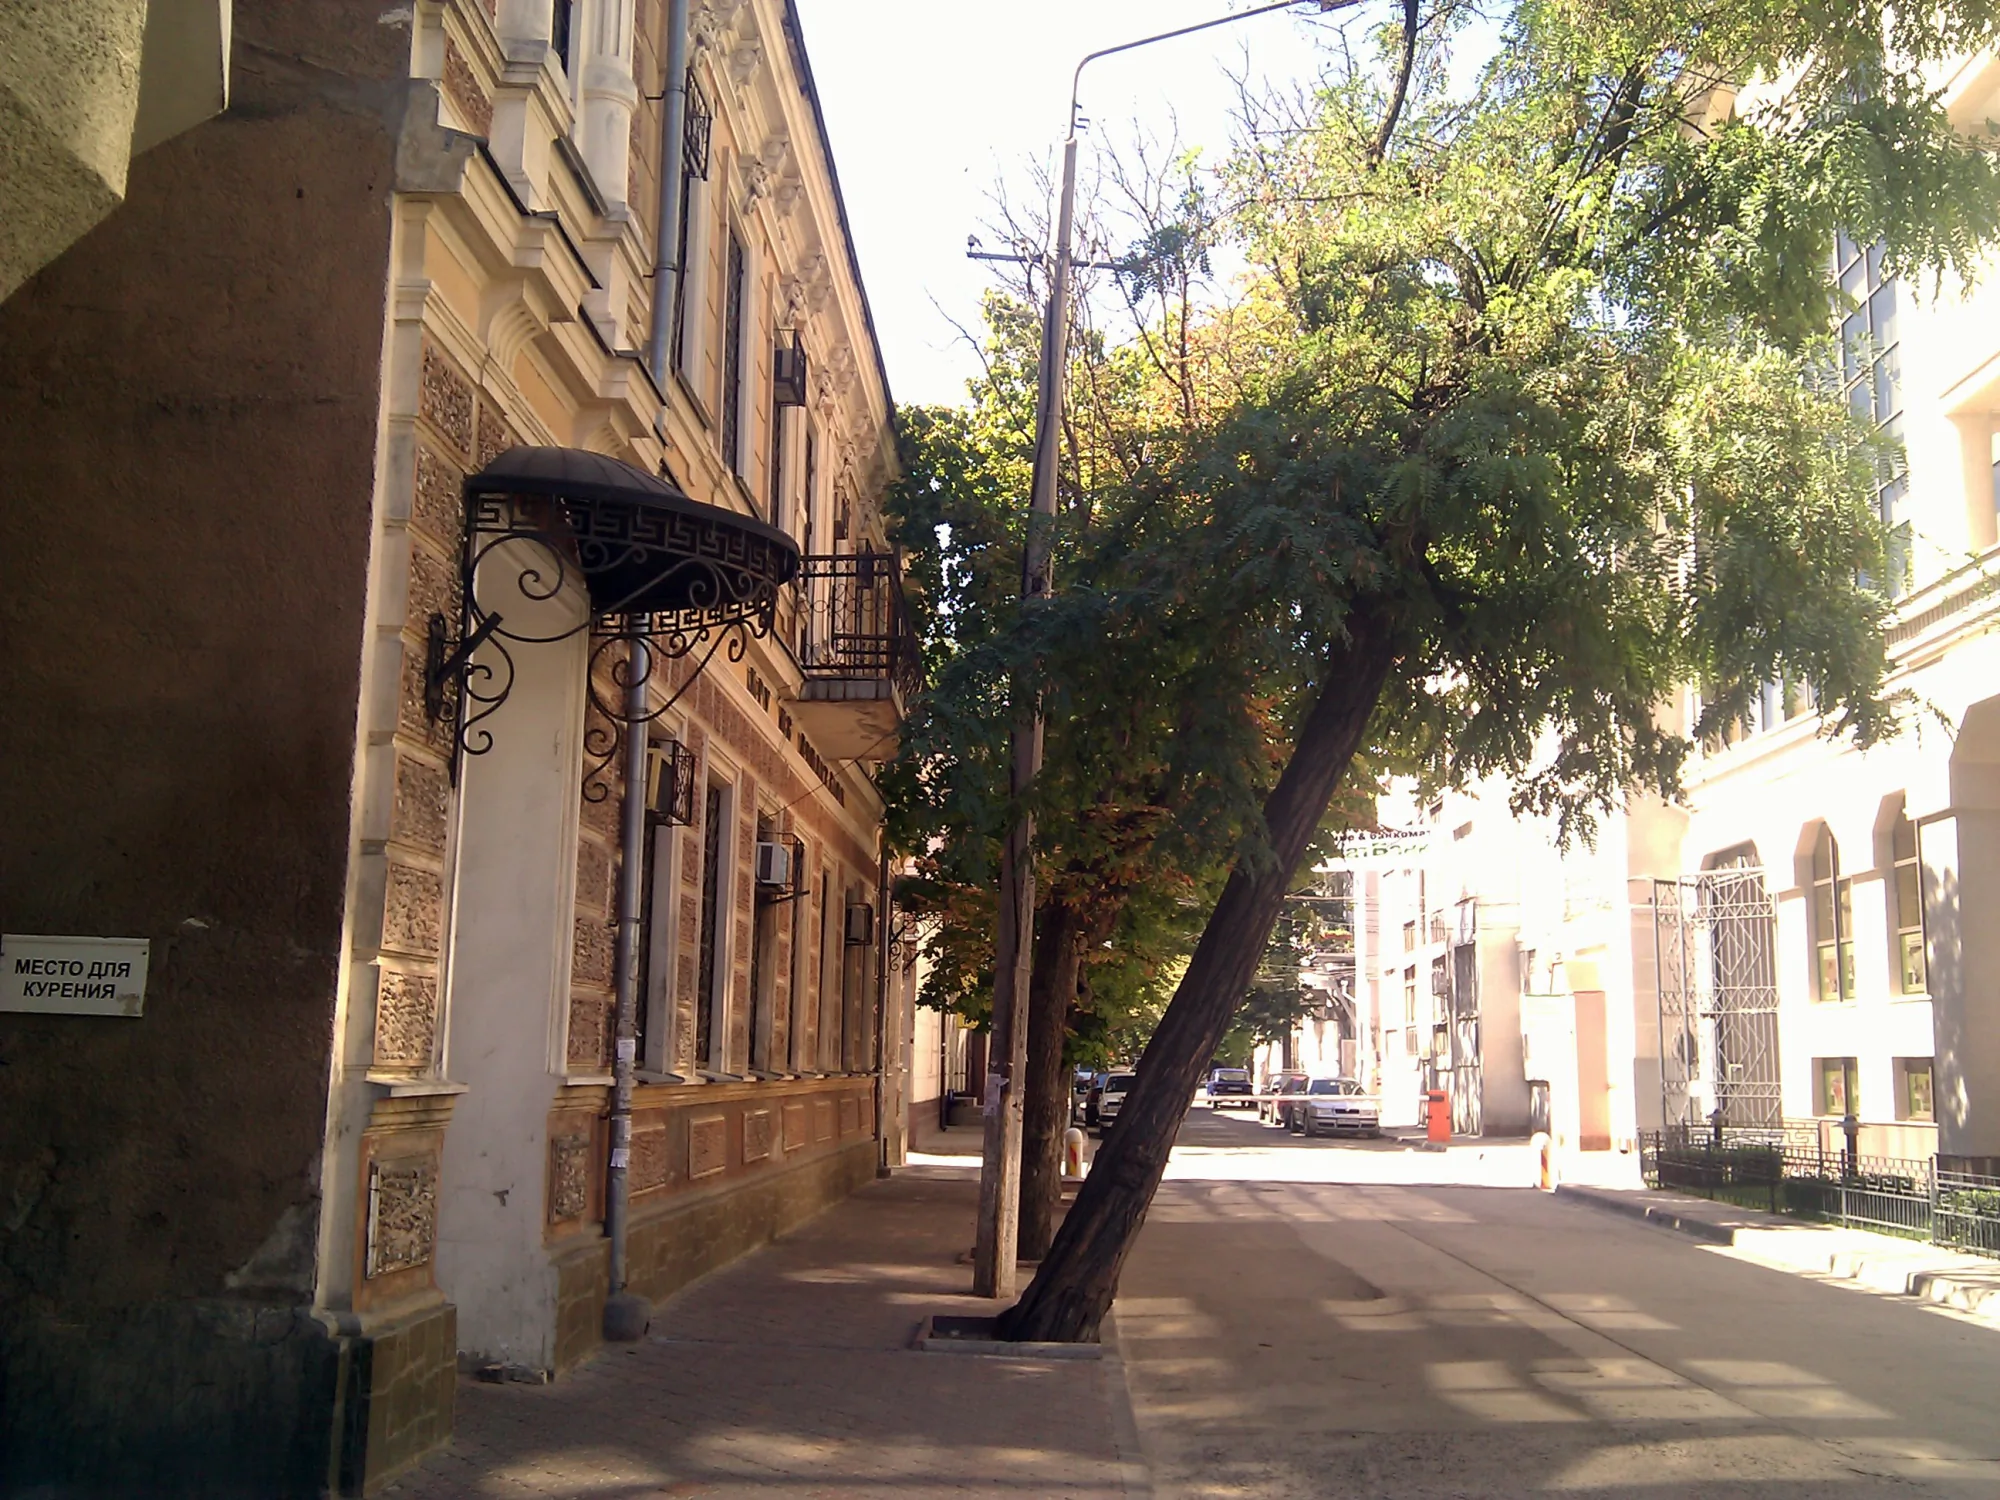
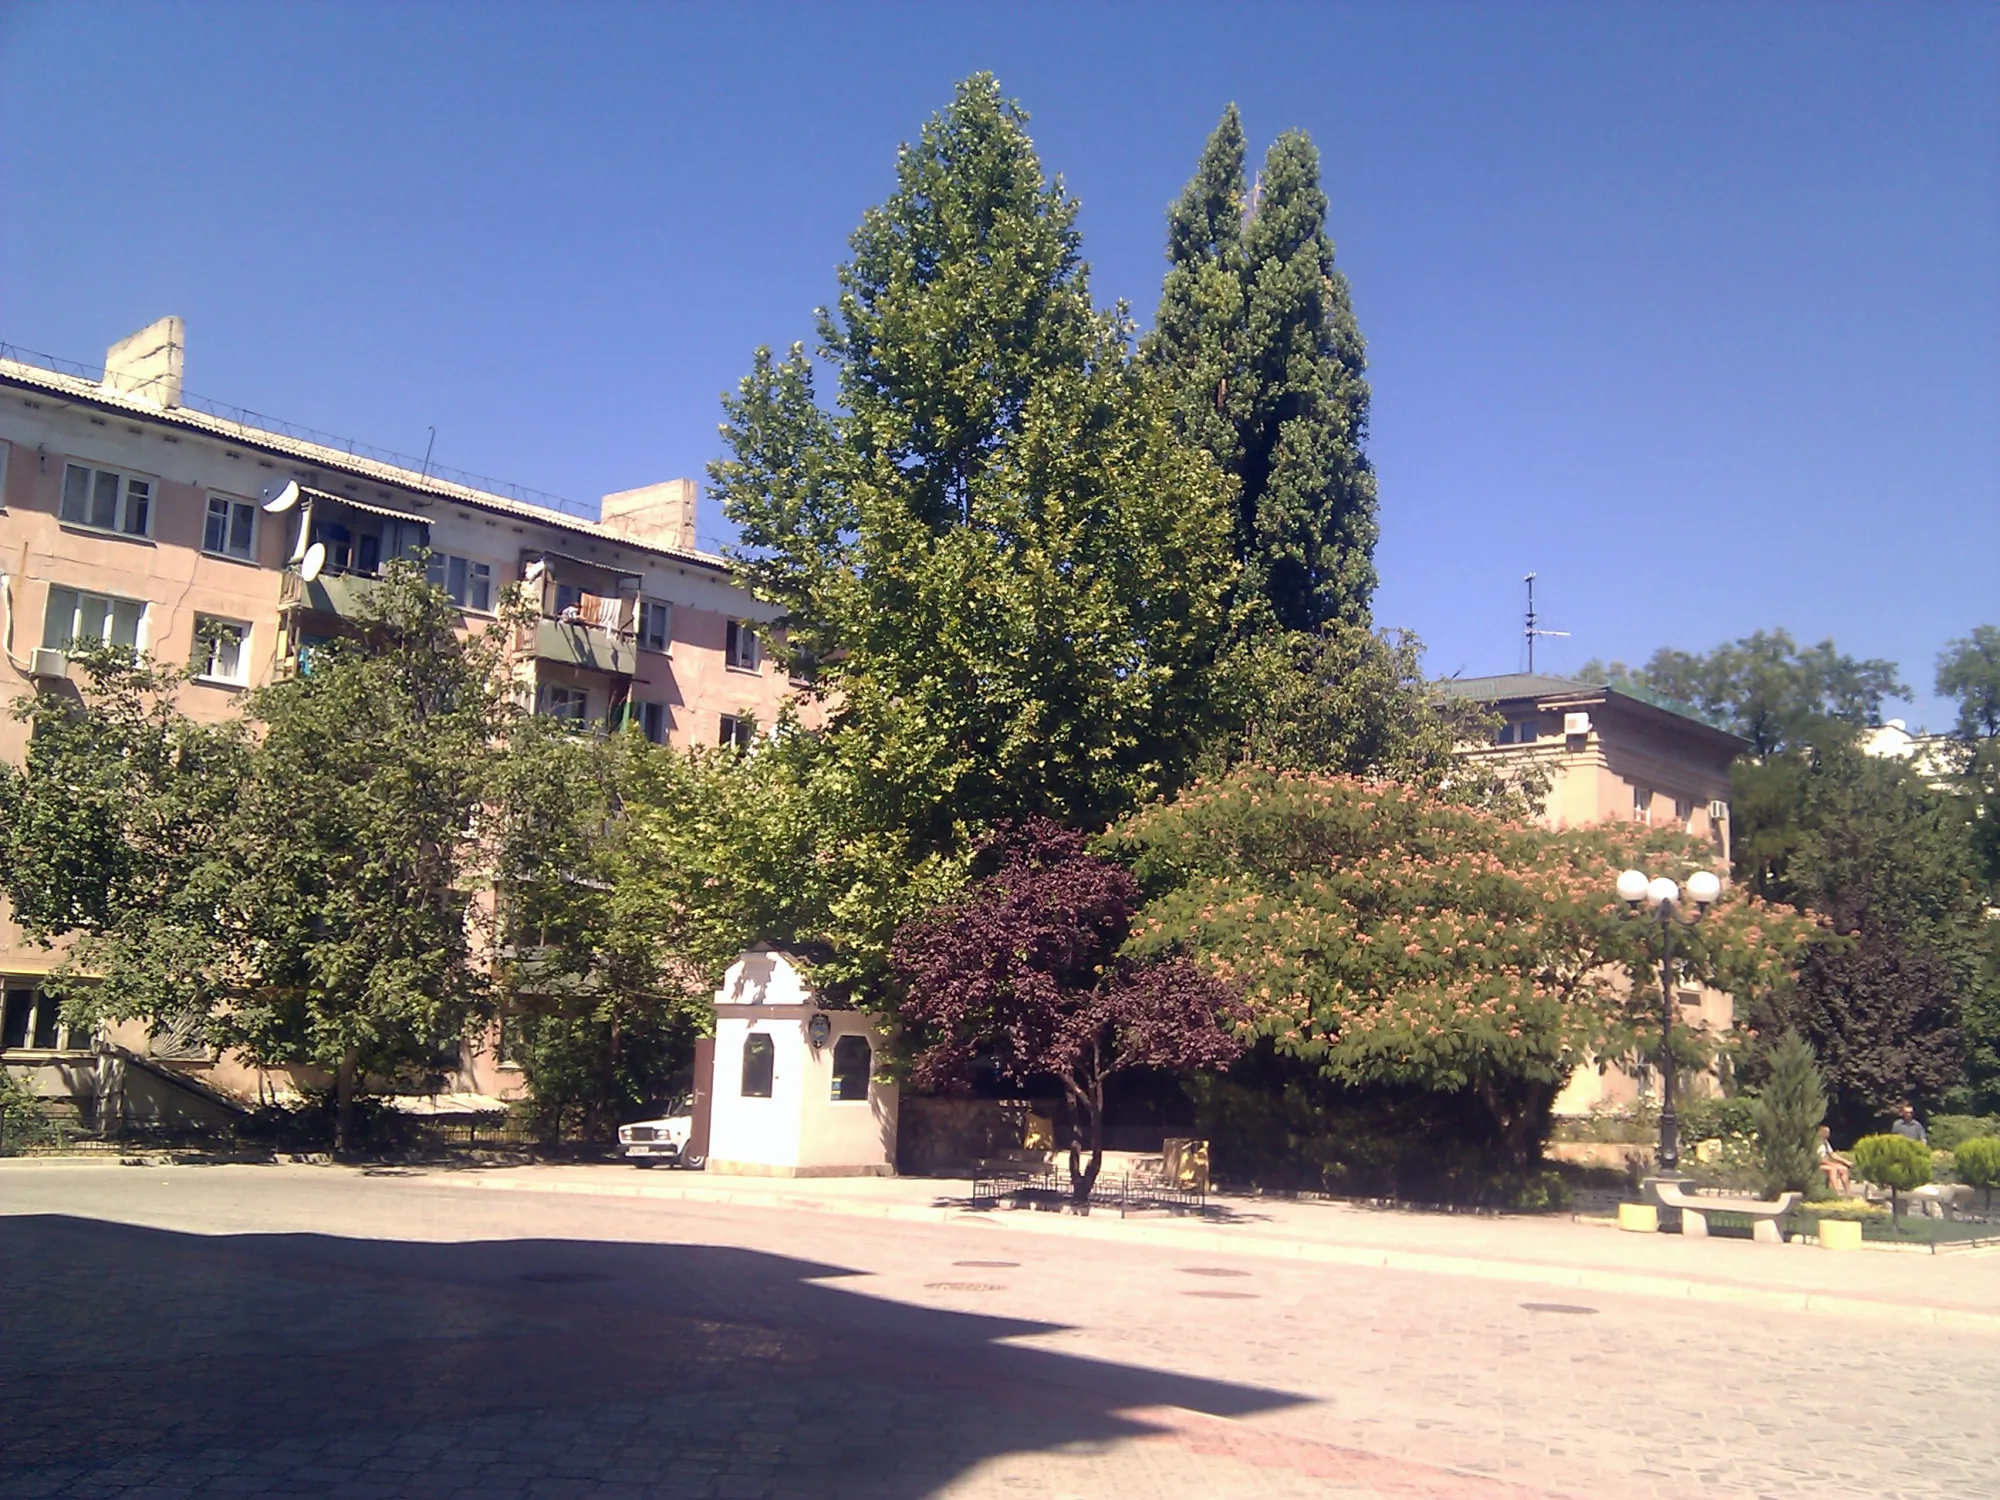
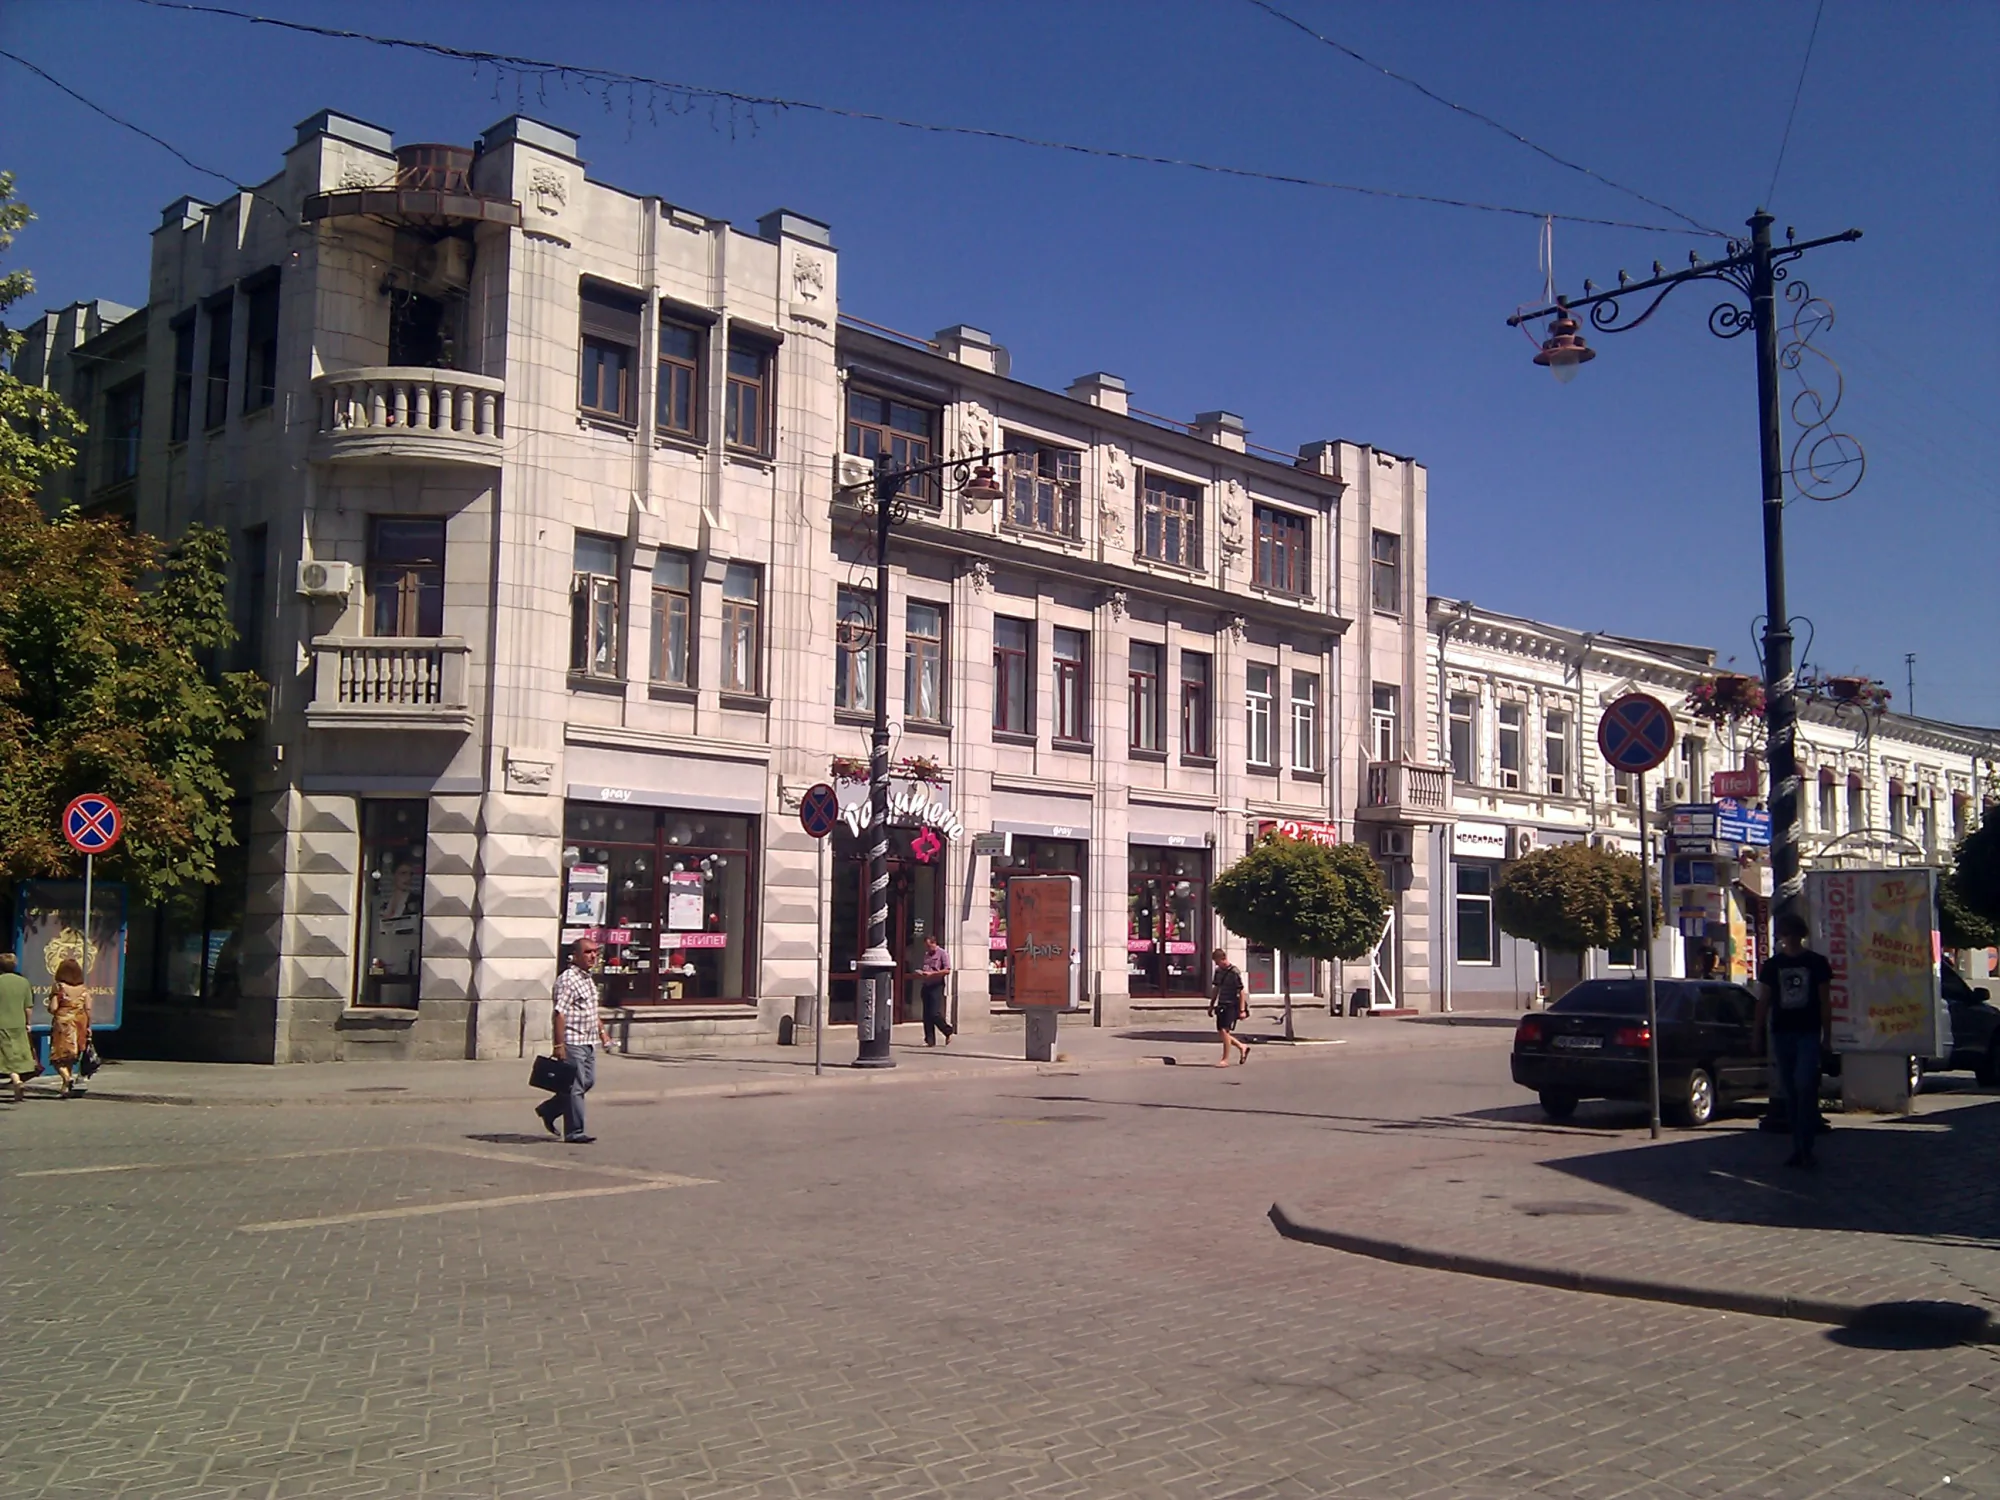
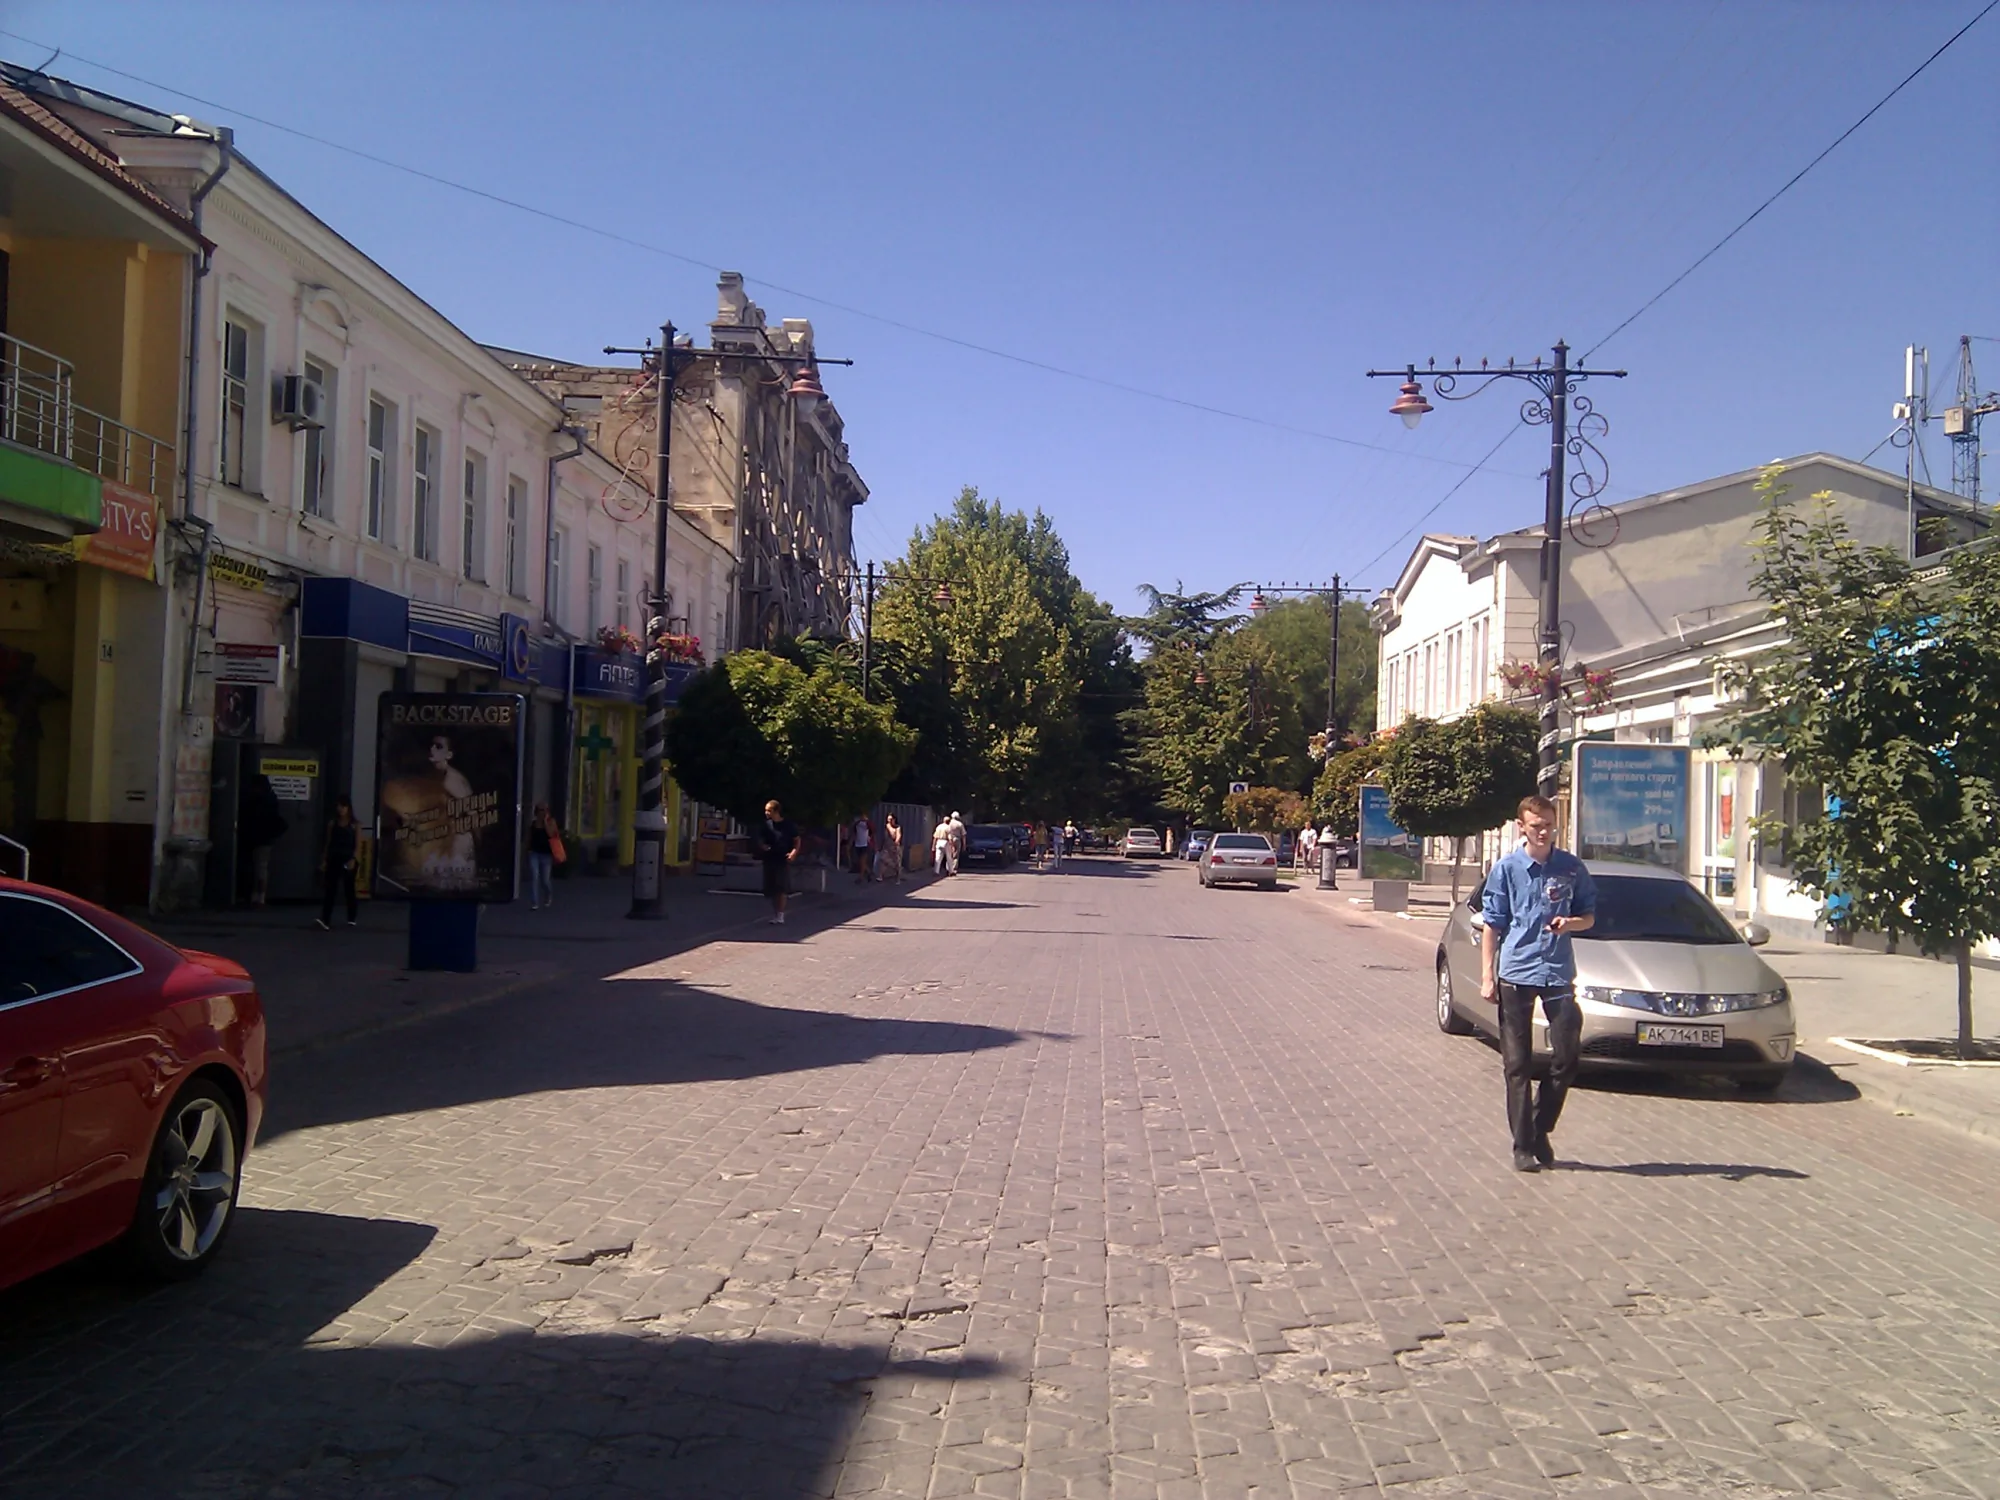
Если завязать вам глаза, долго
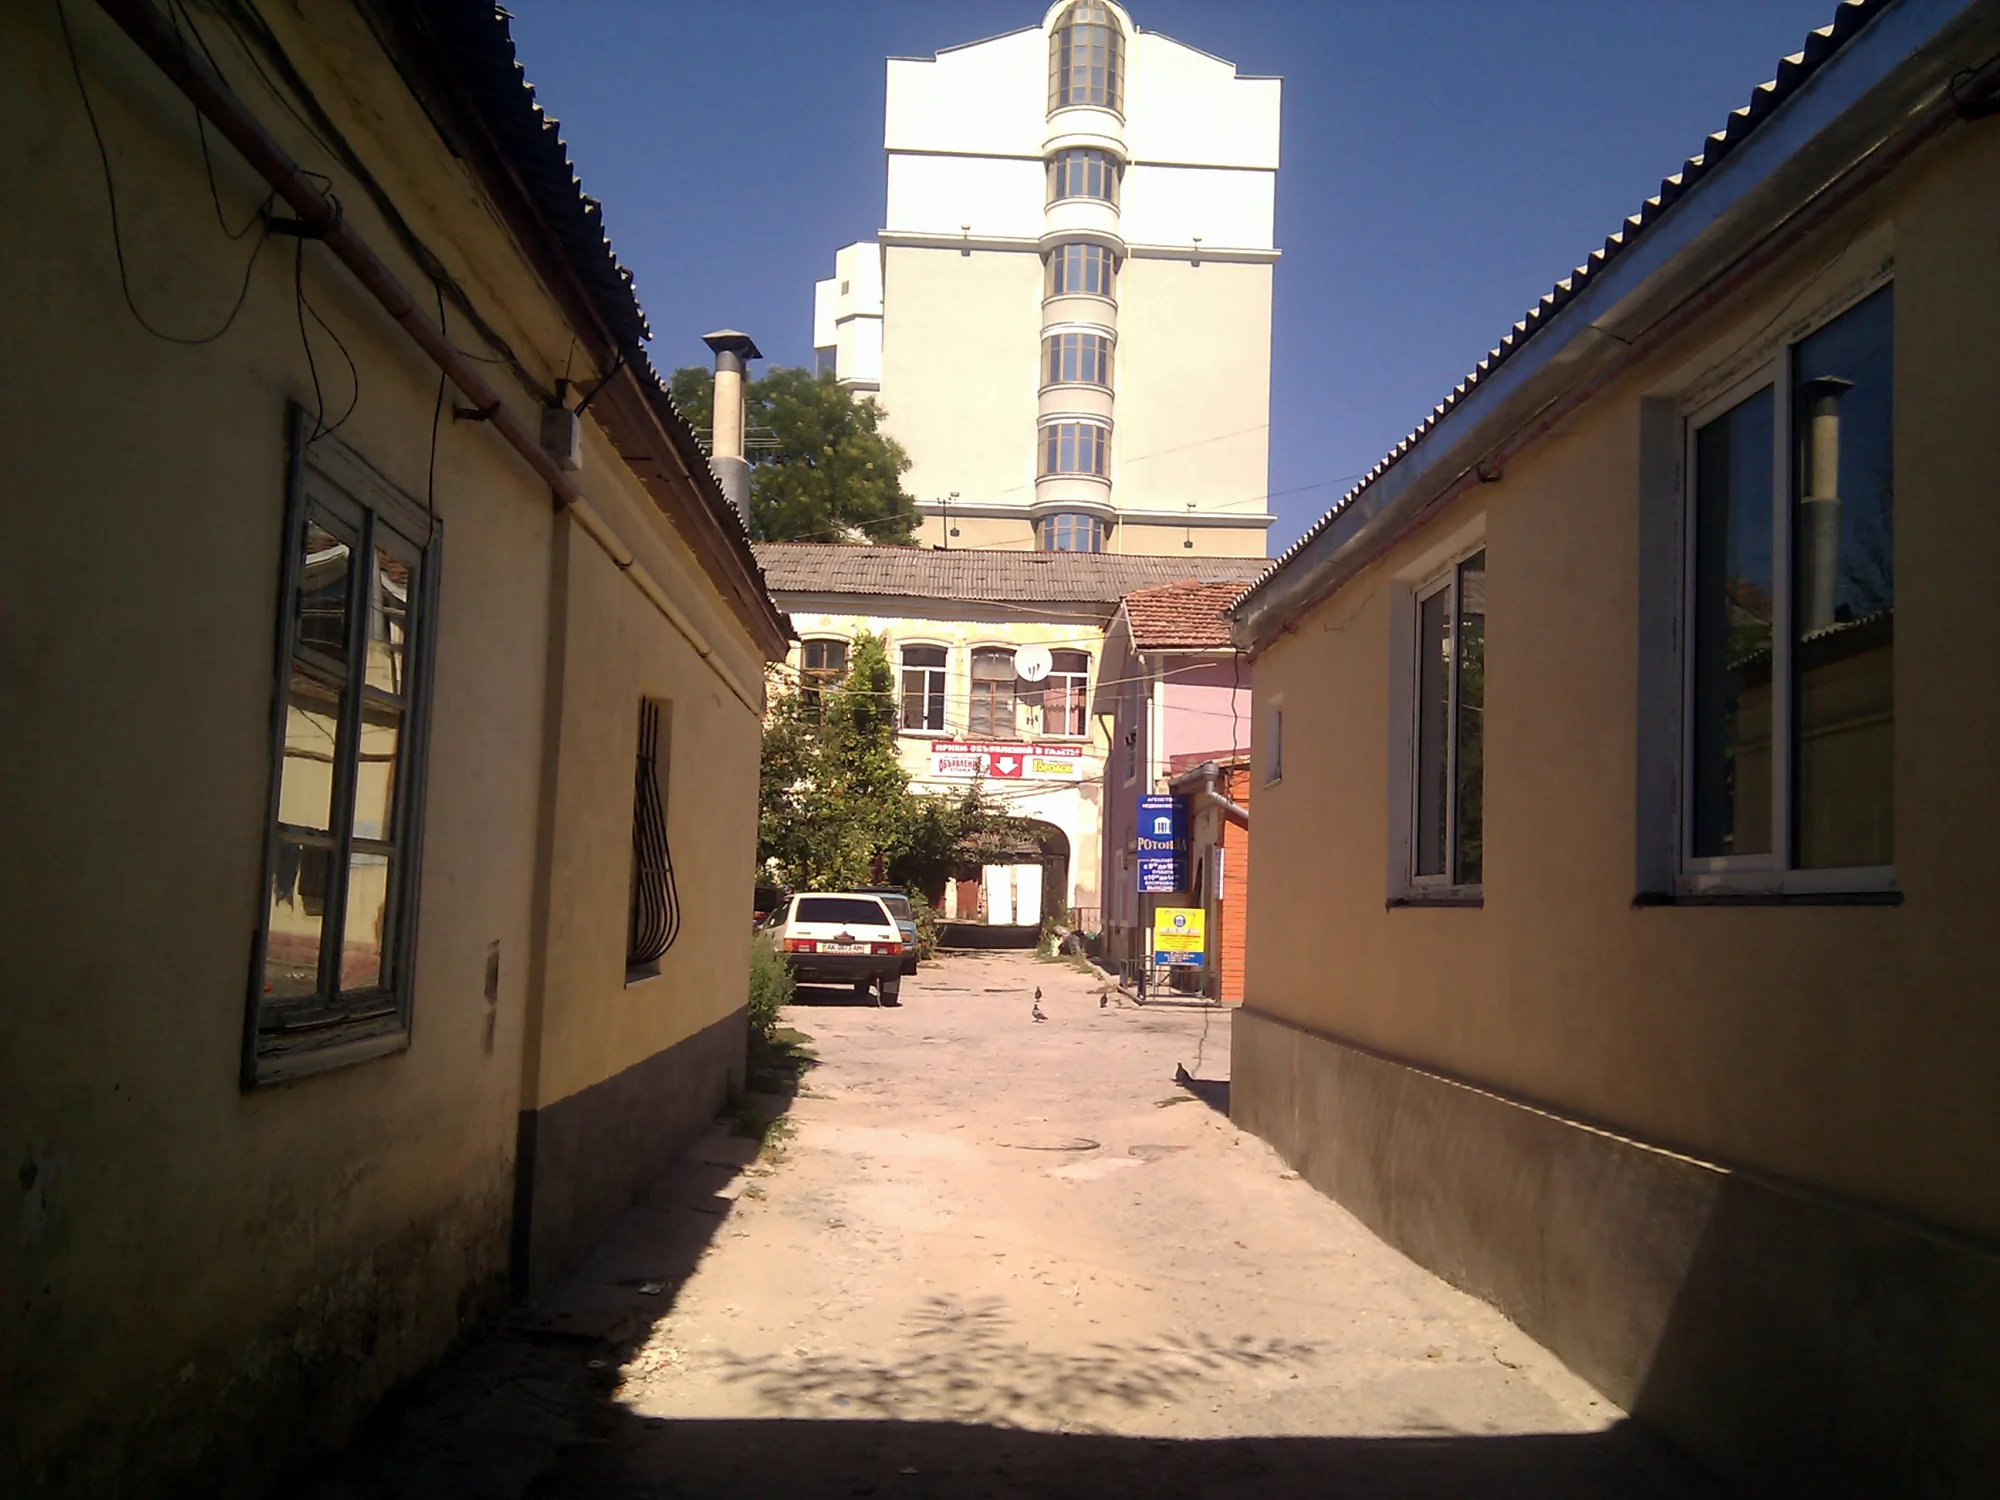
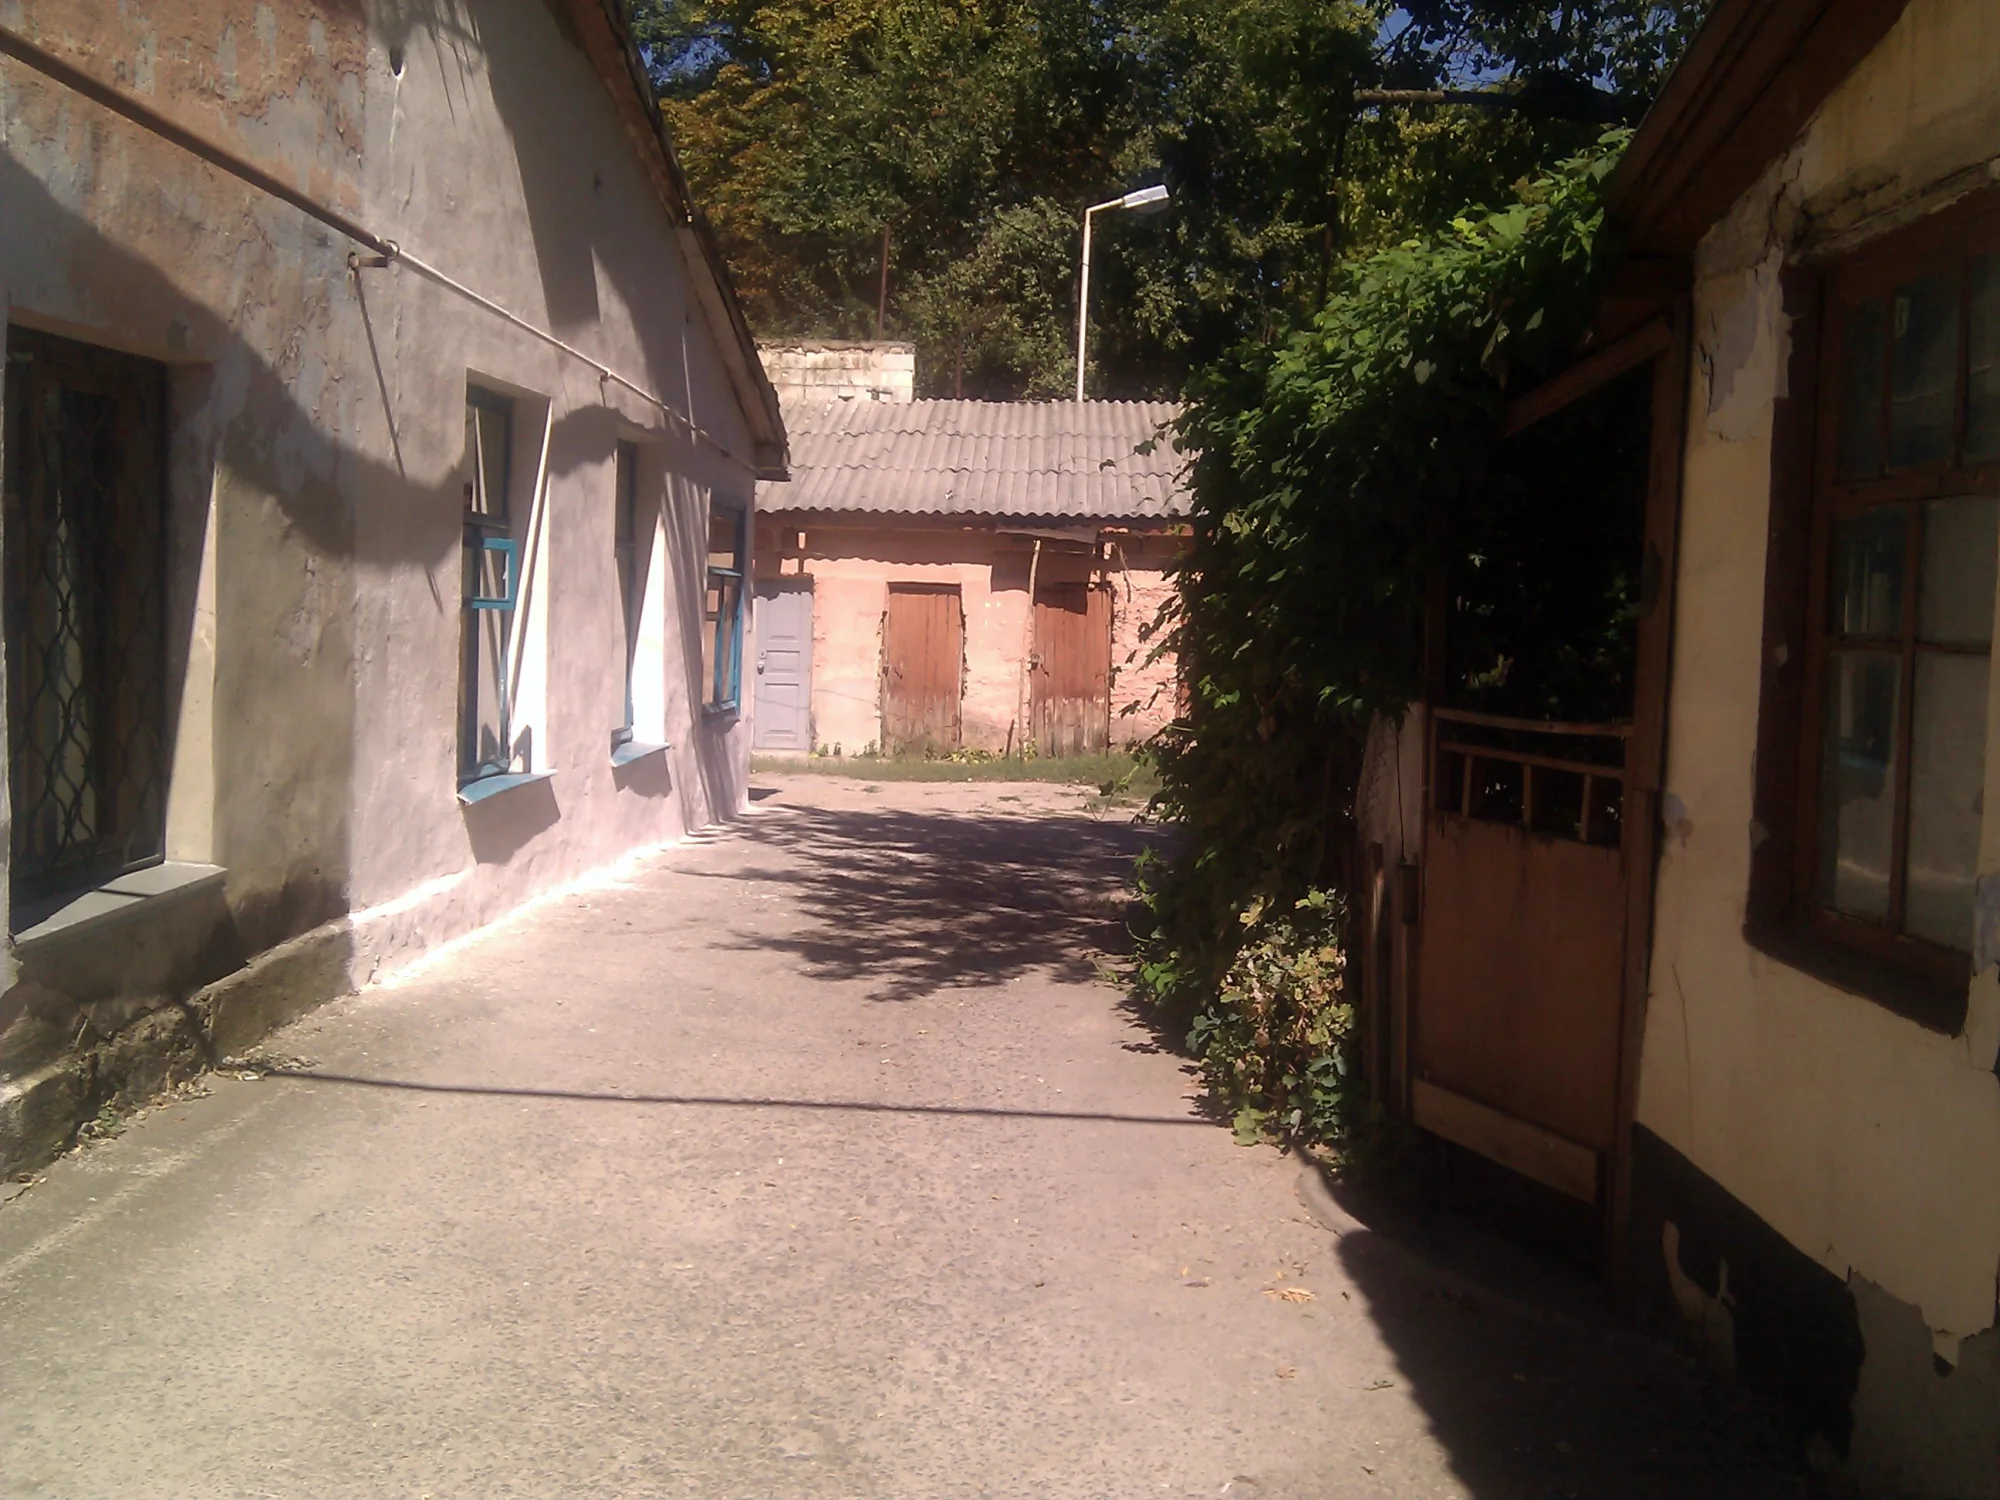
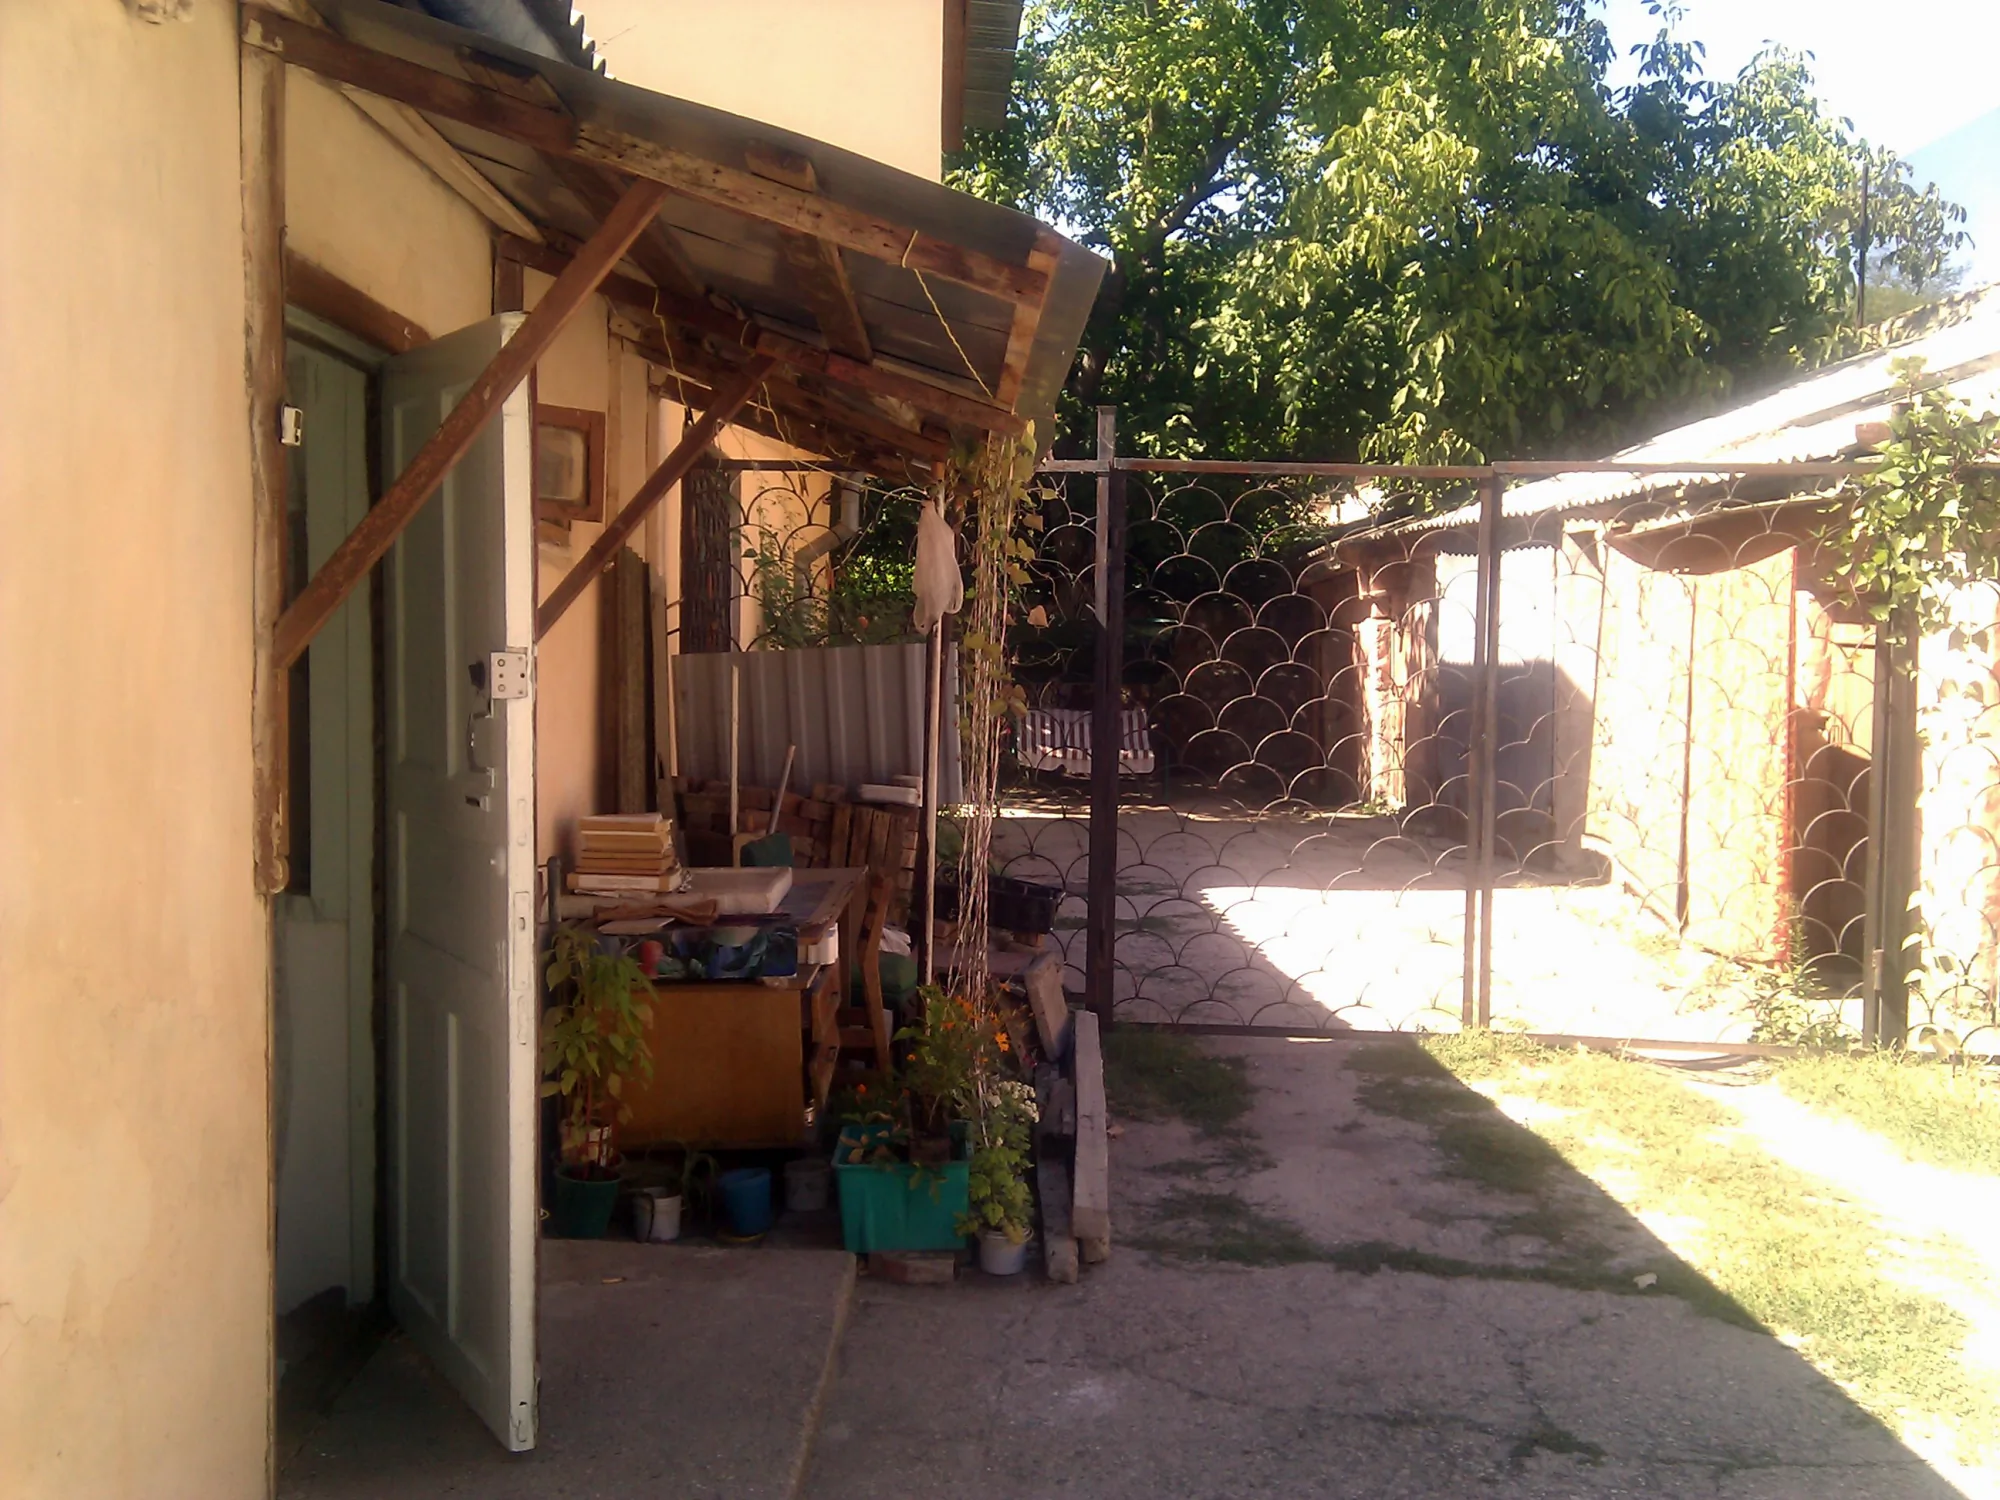
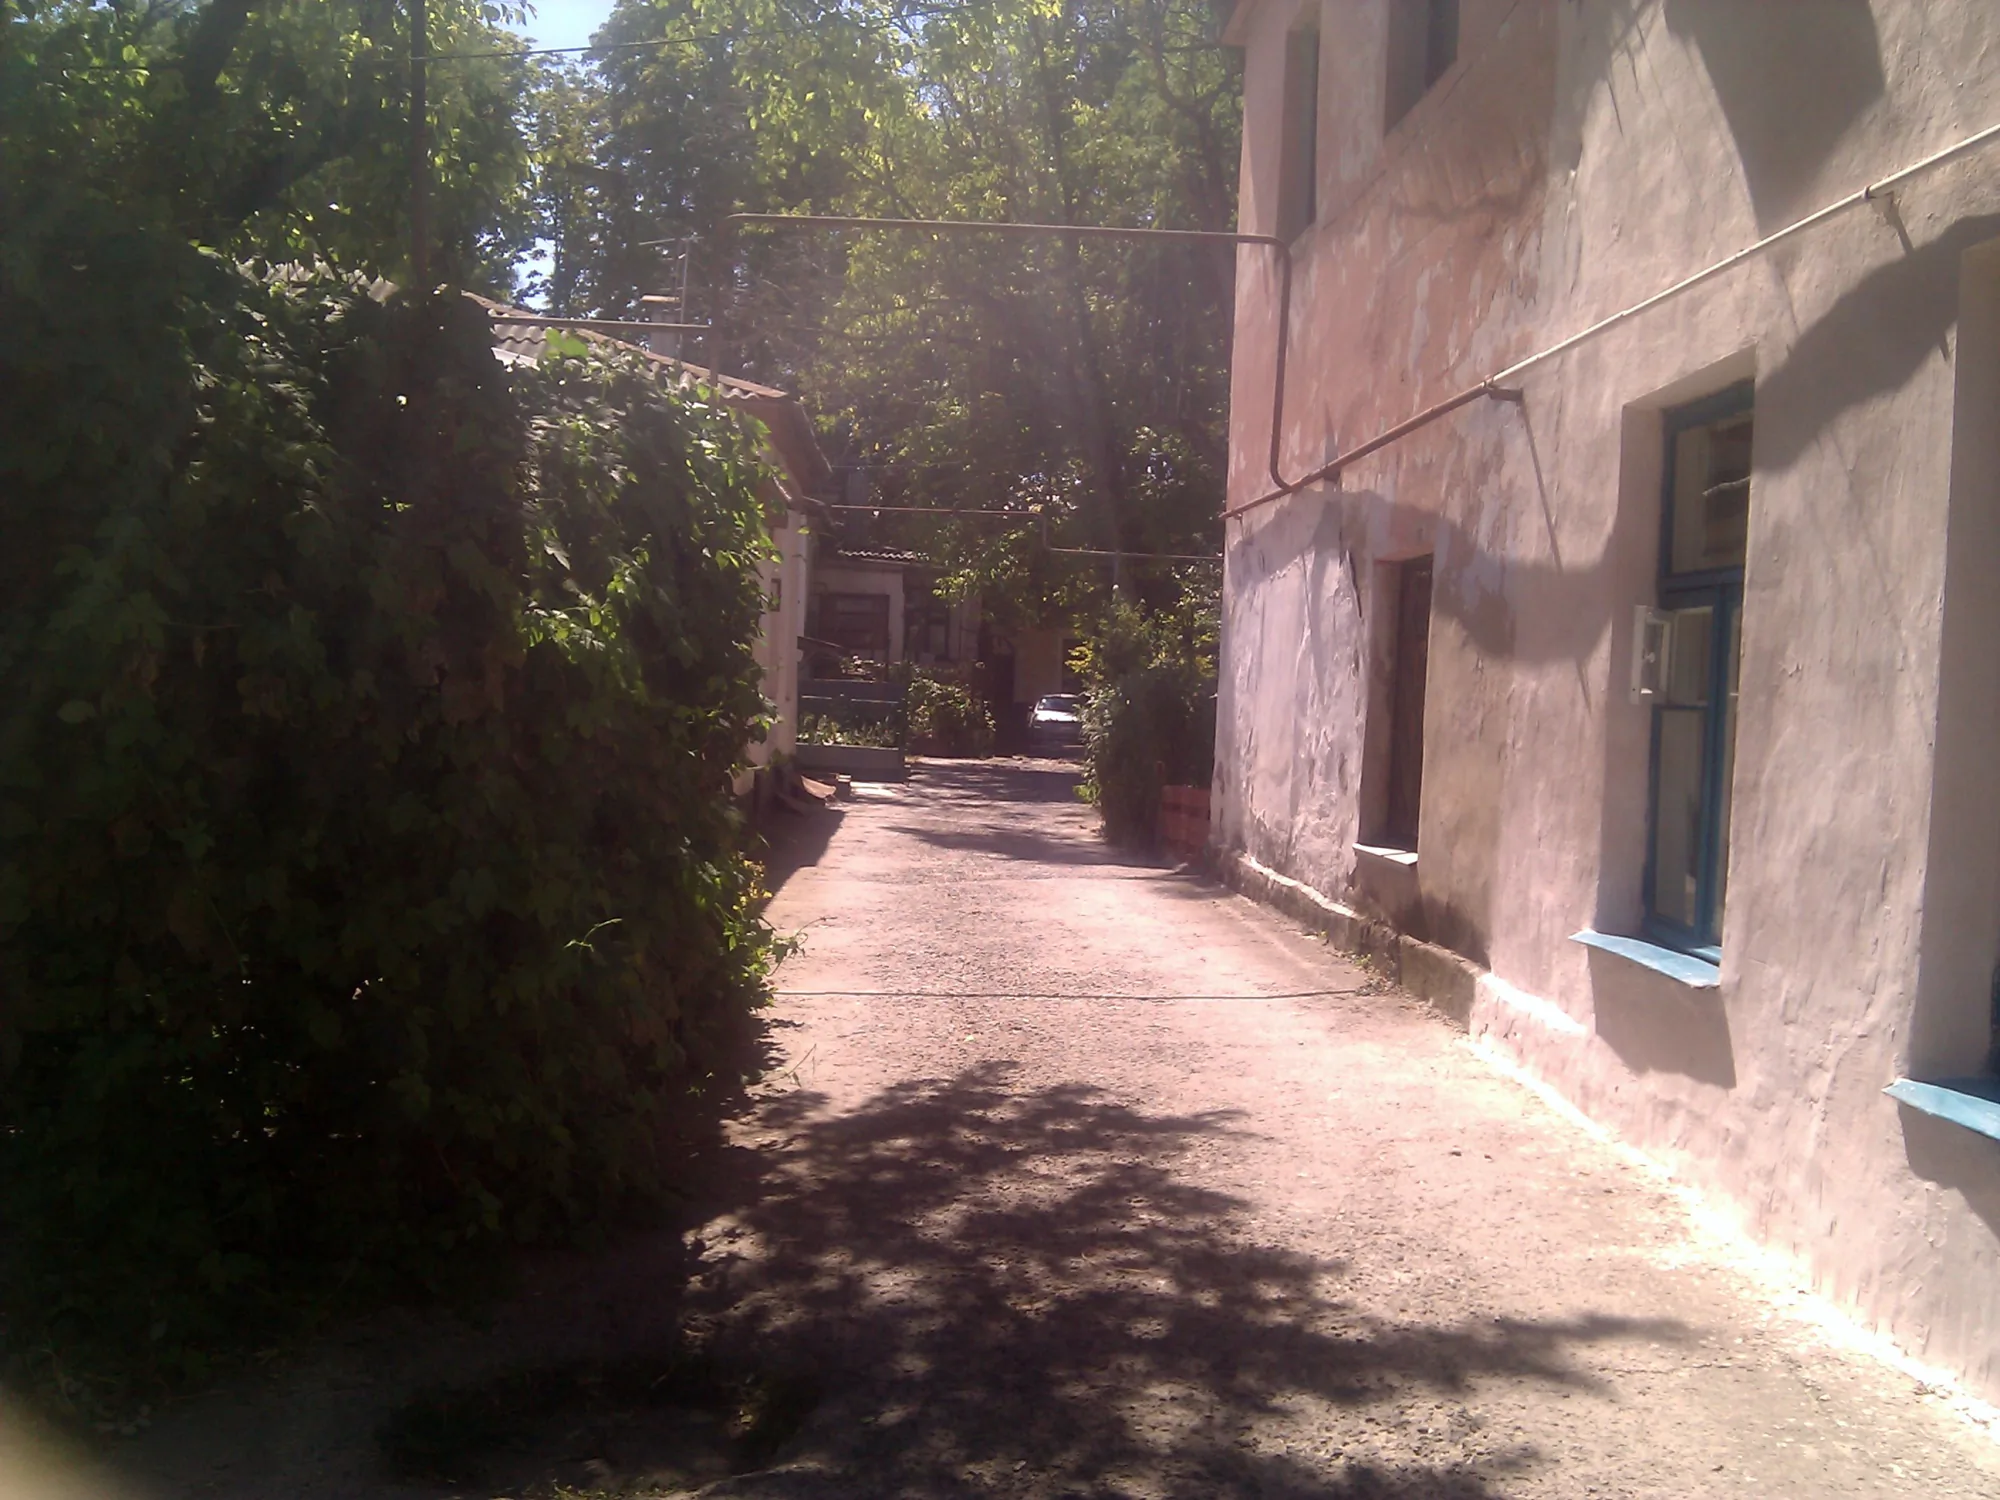
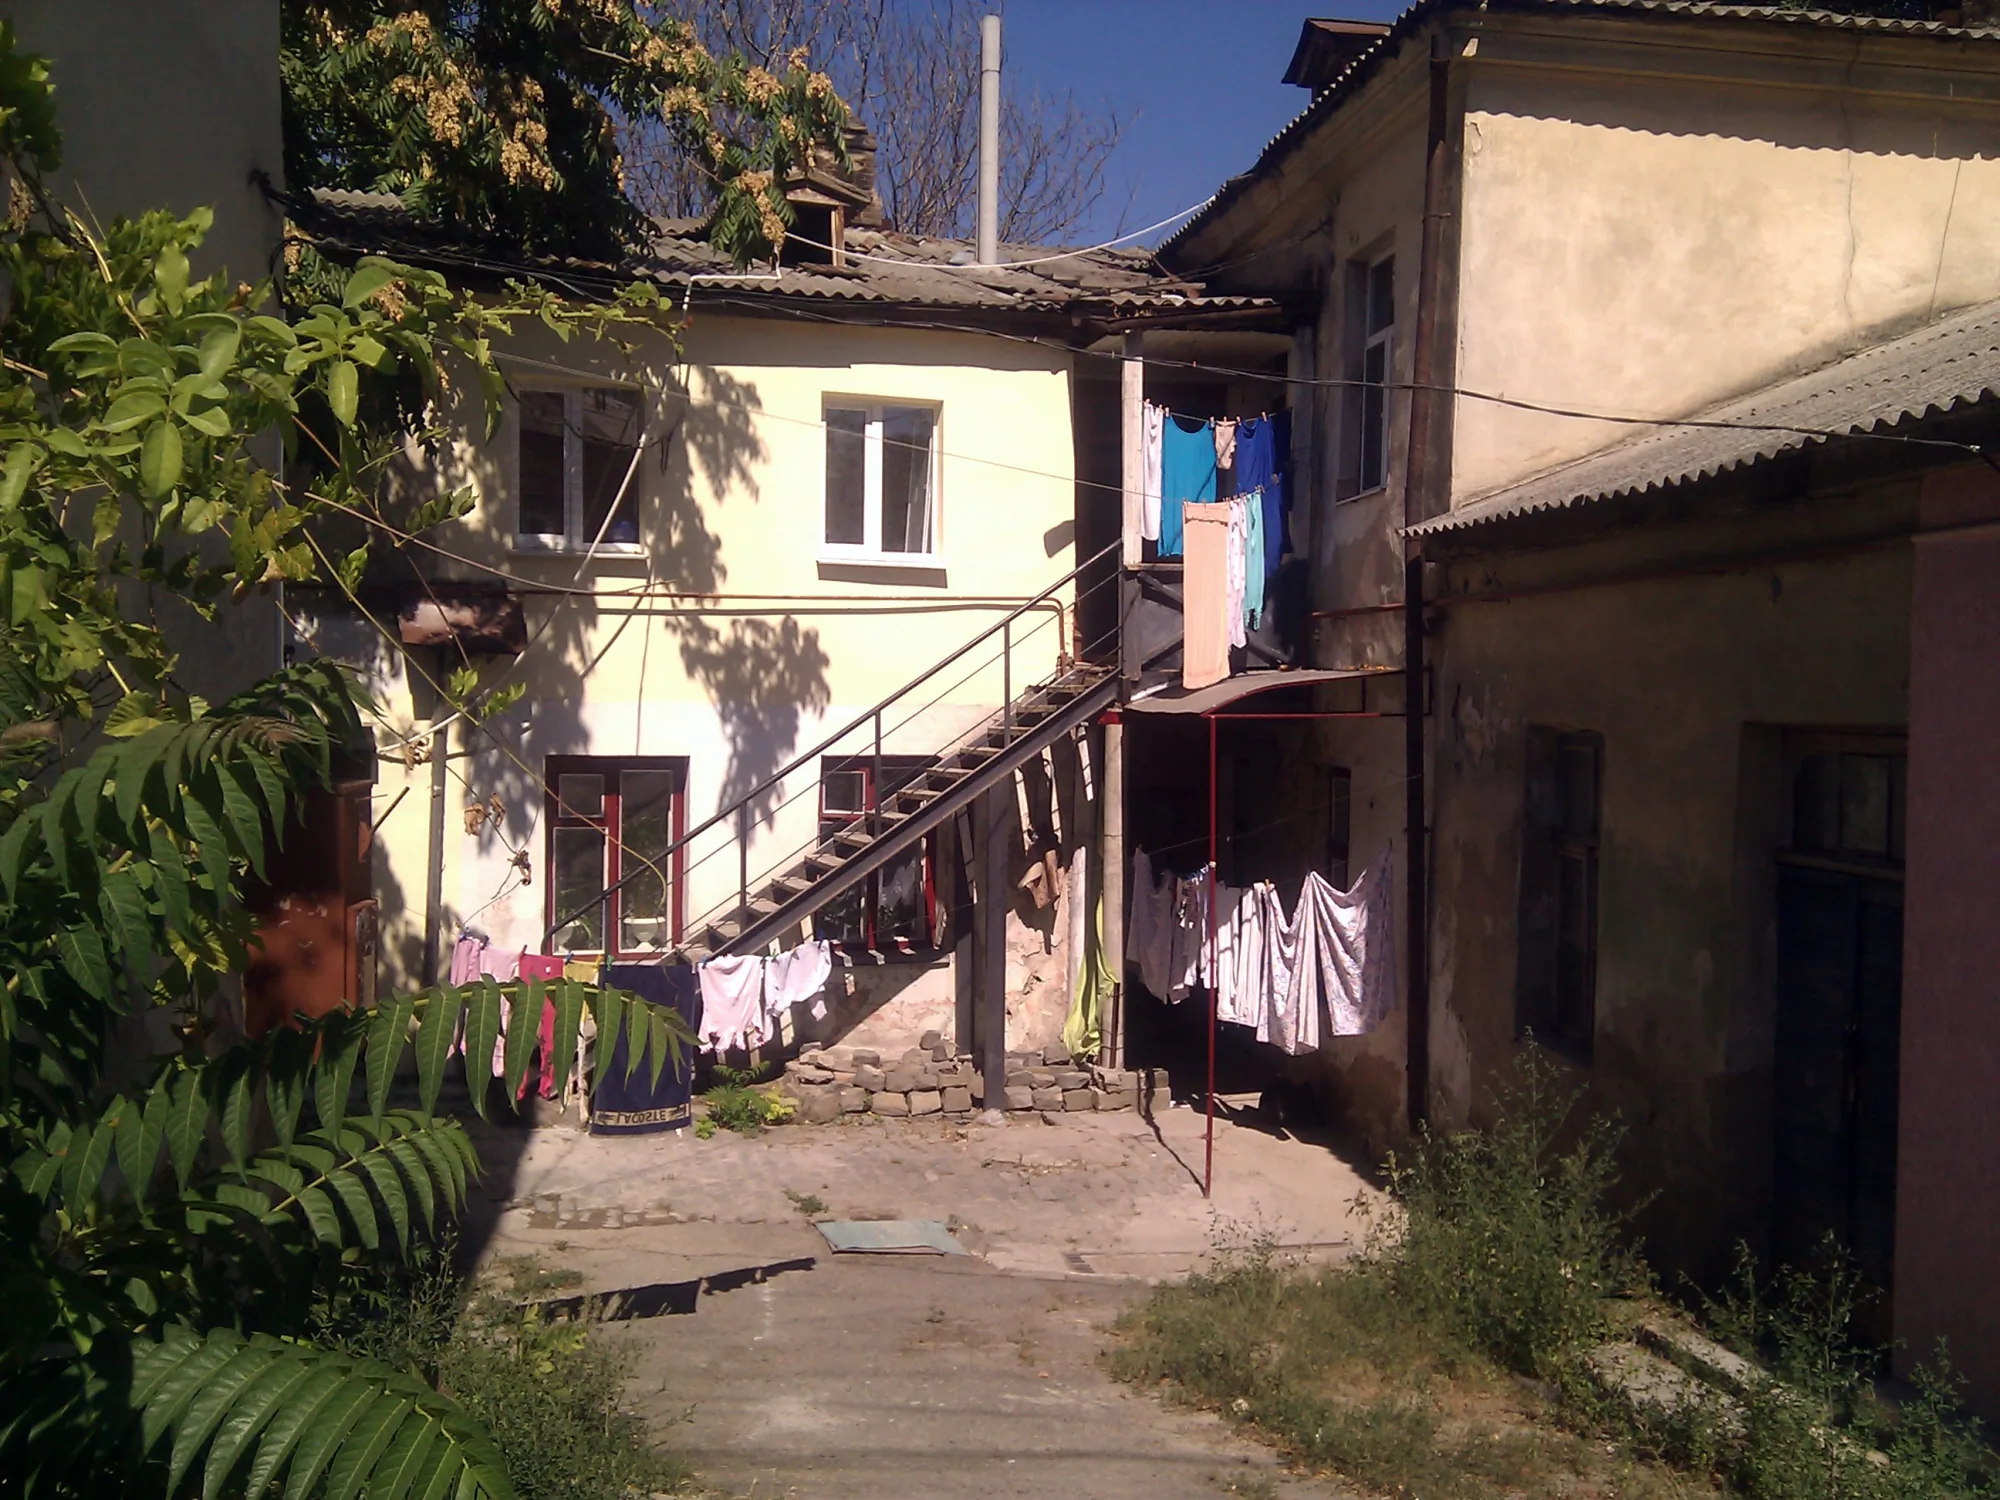
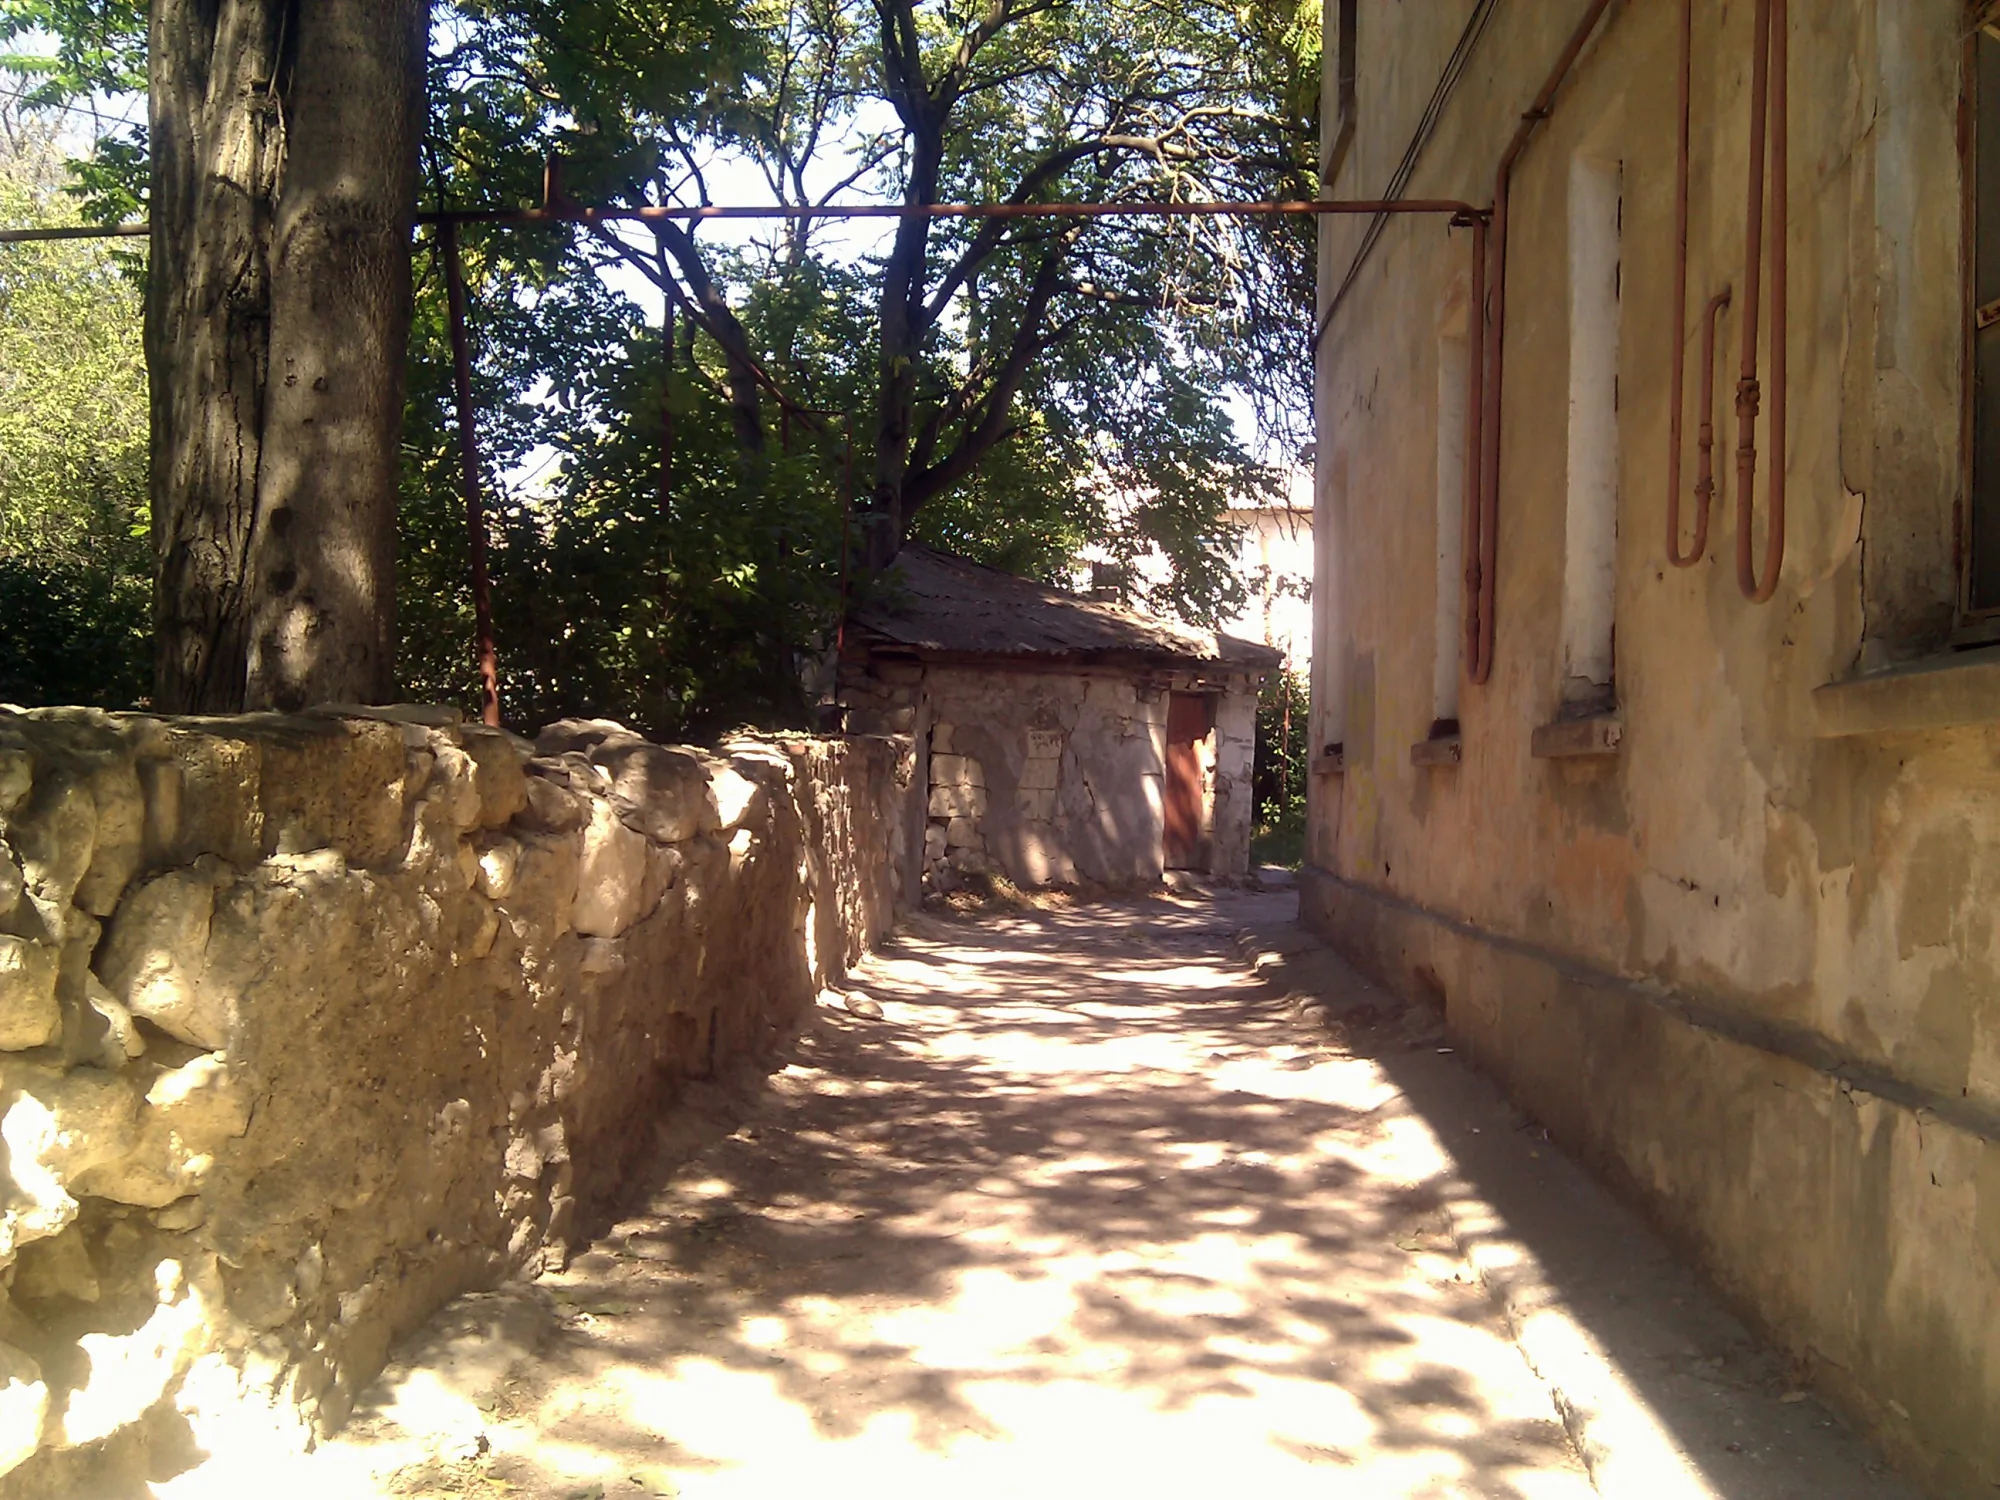
Наверное, именно этим миркам город обязан давно забытому в Москве явлению — маленькие дети, передвигающиеся по городу (не двору!) самостоятельно. Мой маршрут примерно на километр совпал с маршрутом детей на фото, дальше они пошли по своим делам, а я свернул
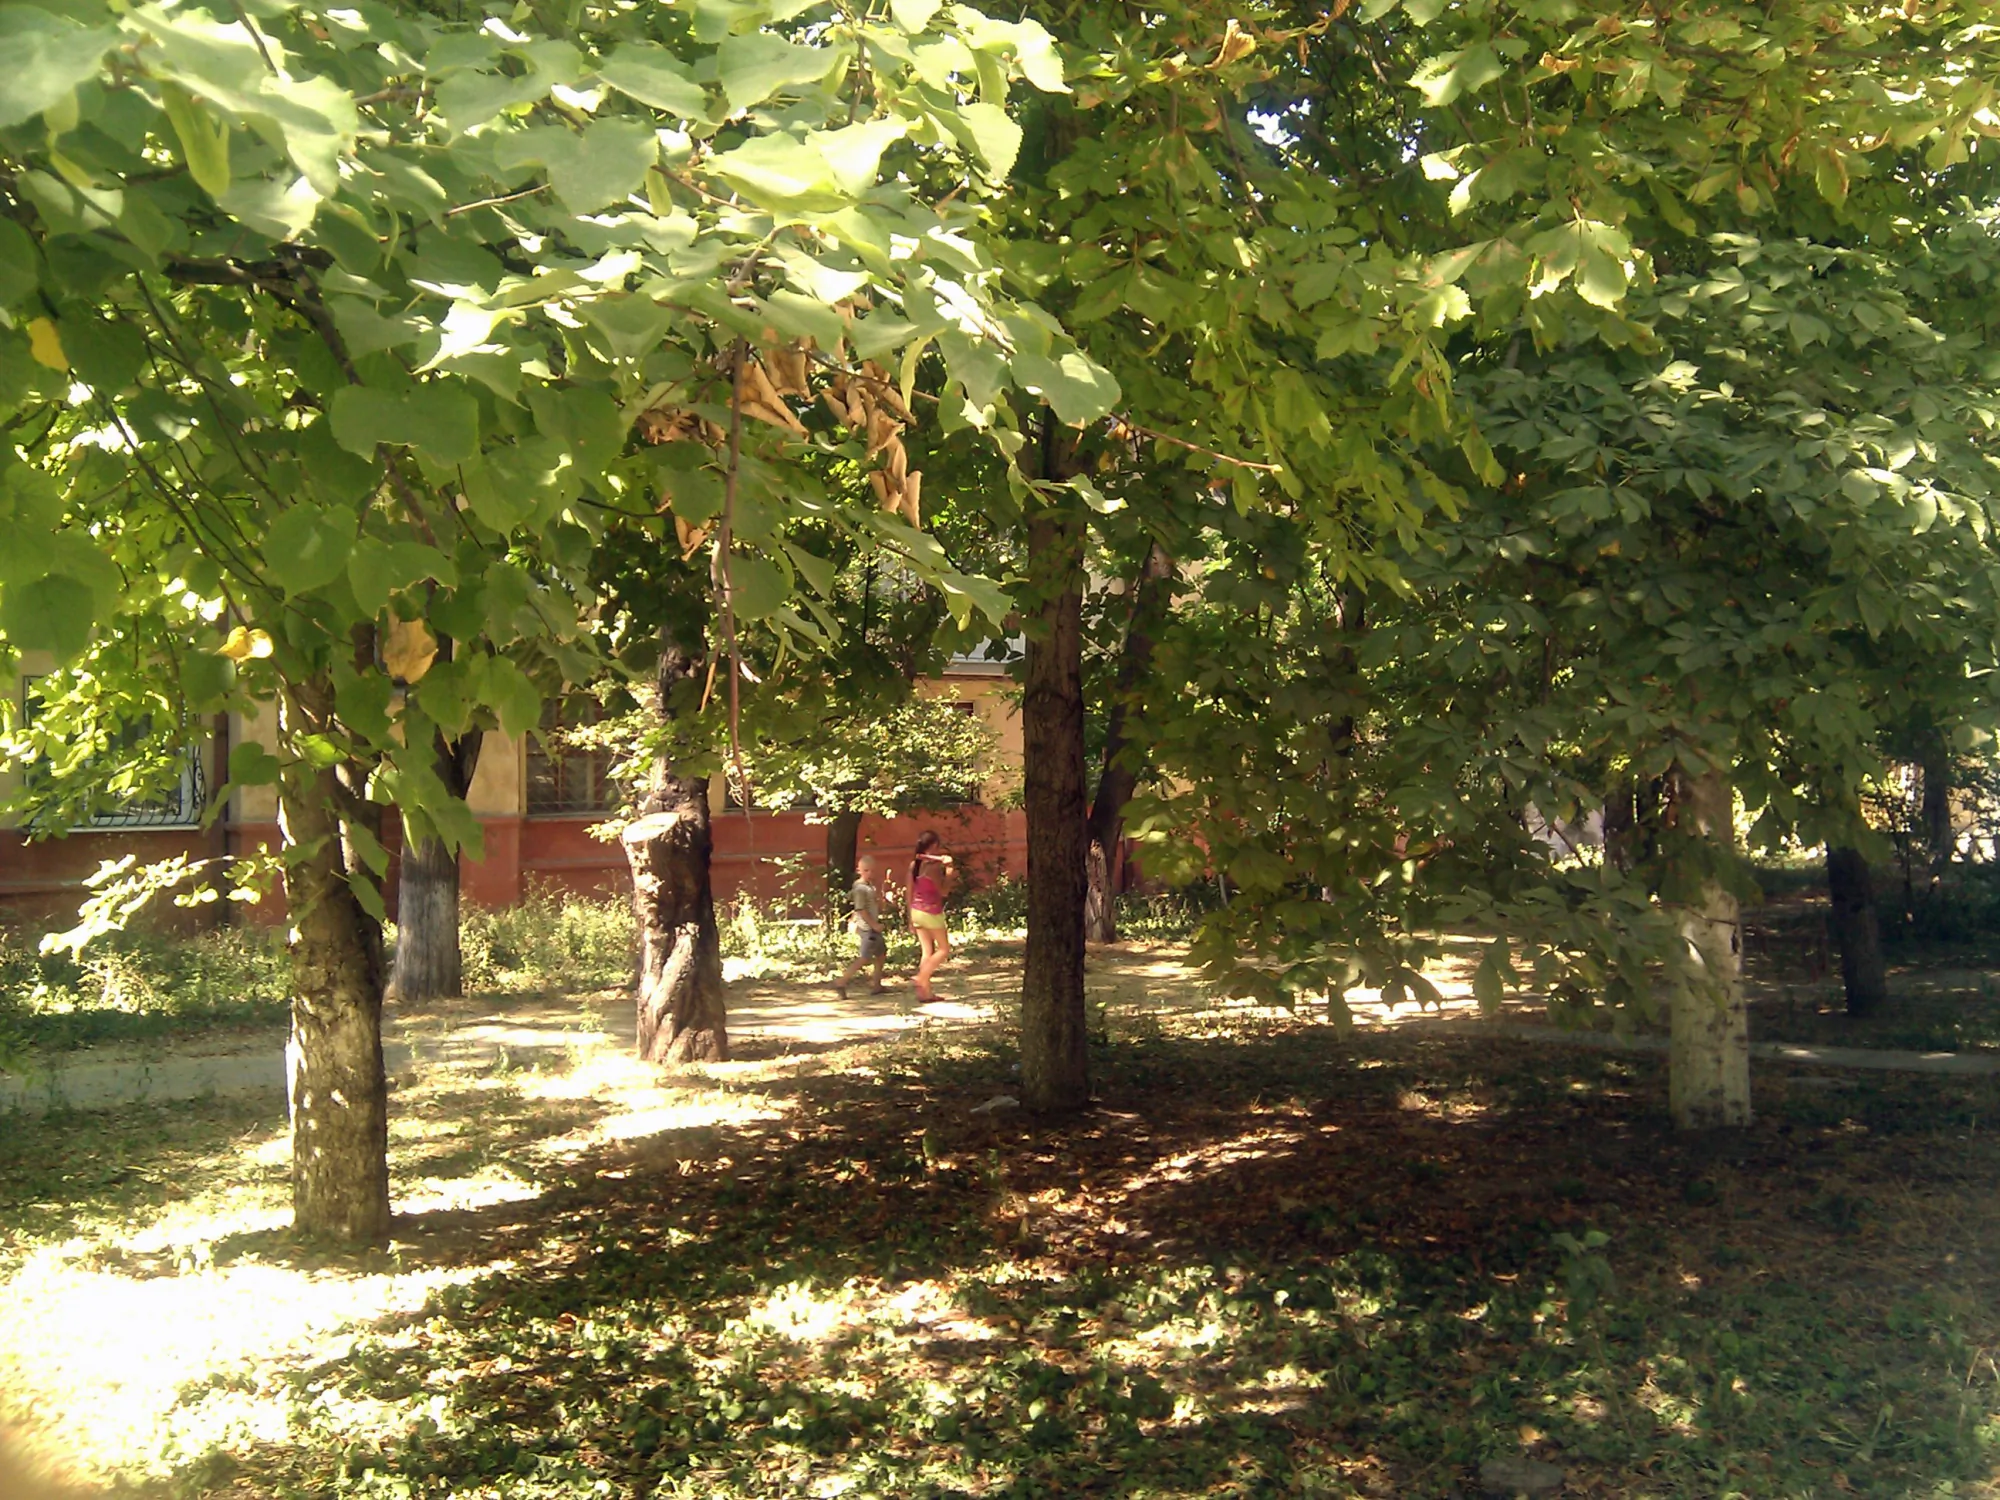
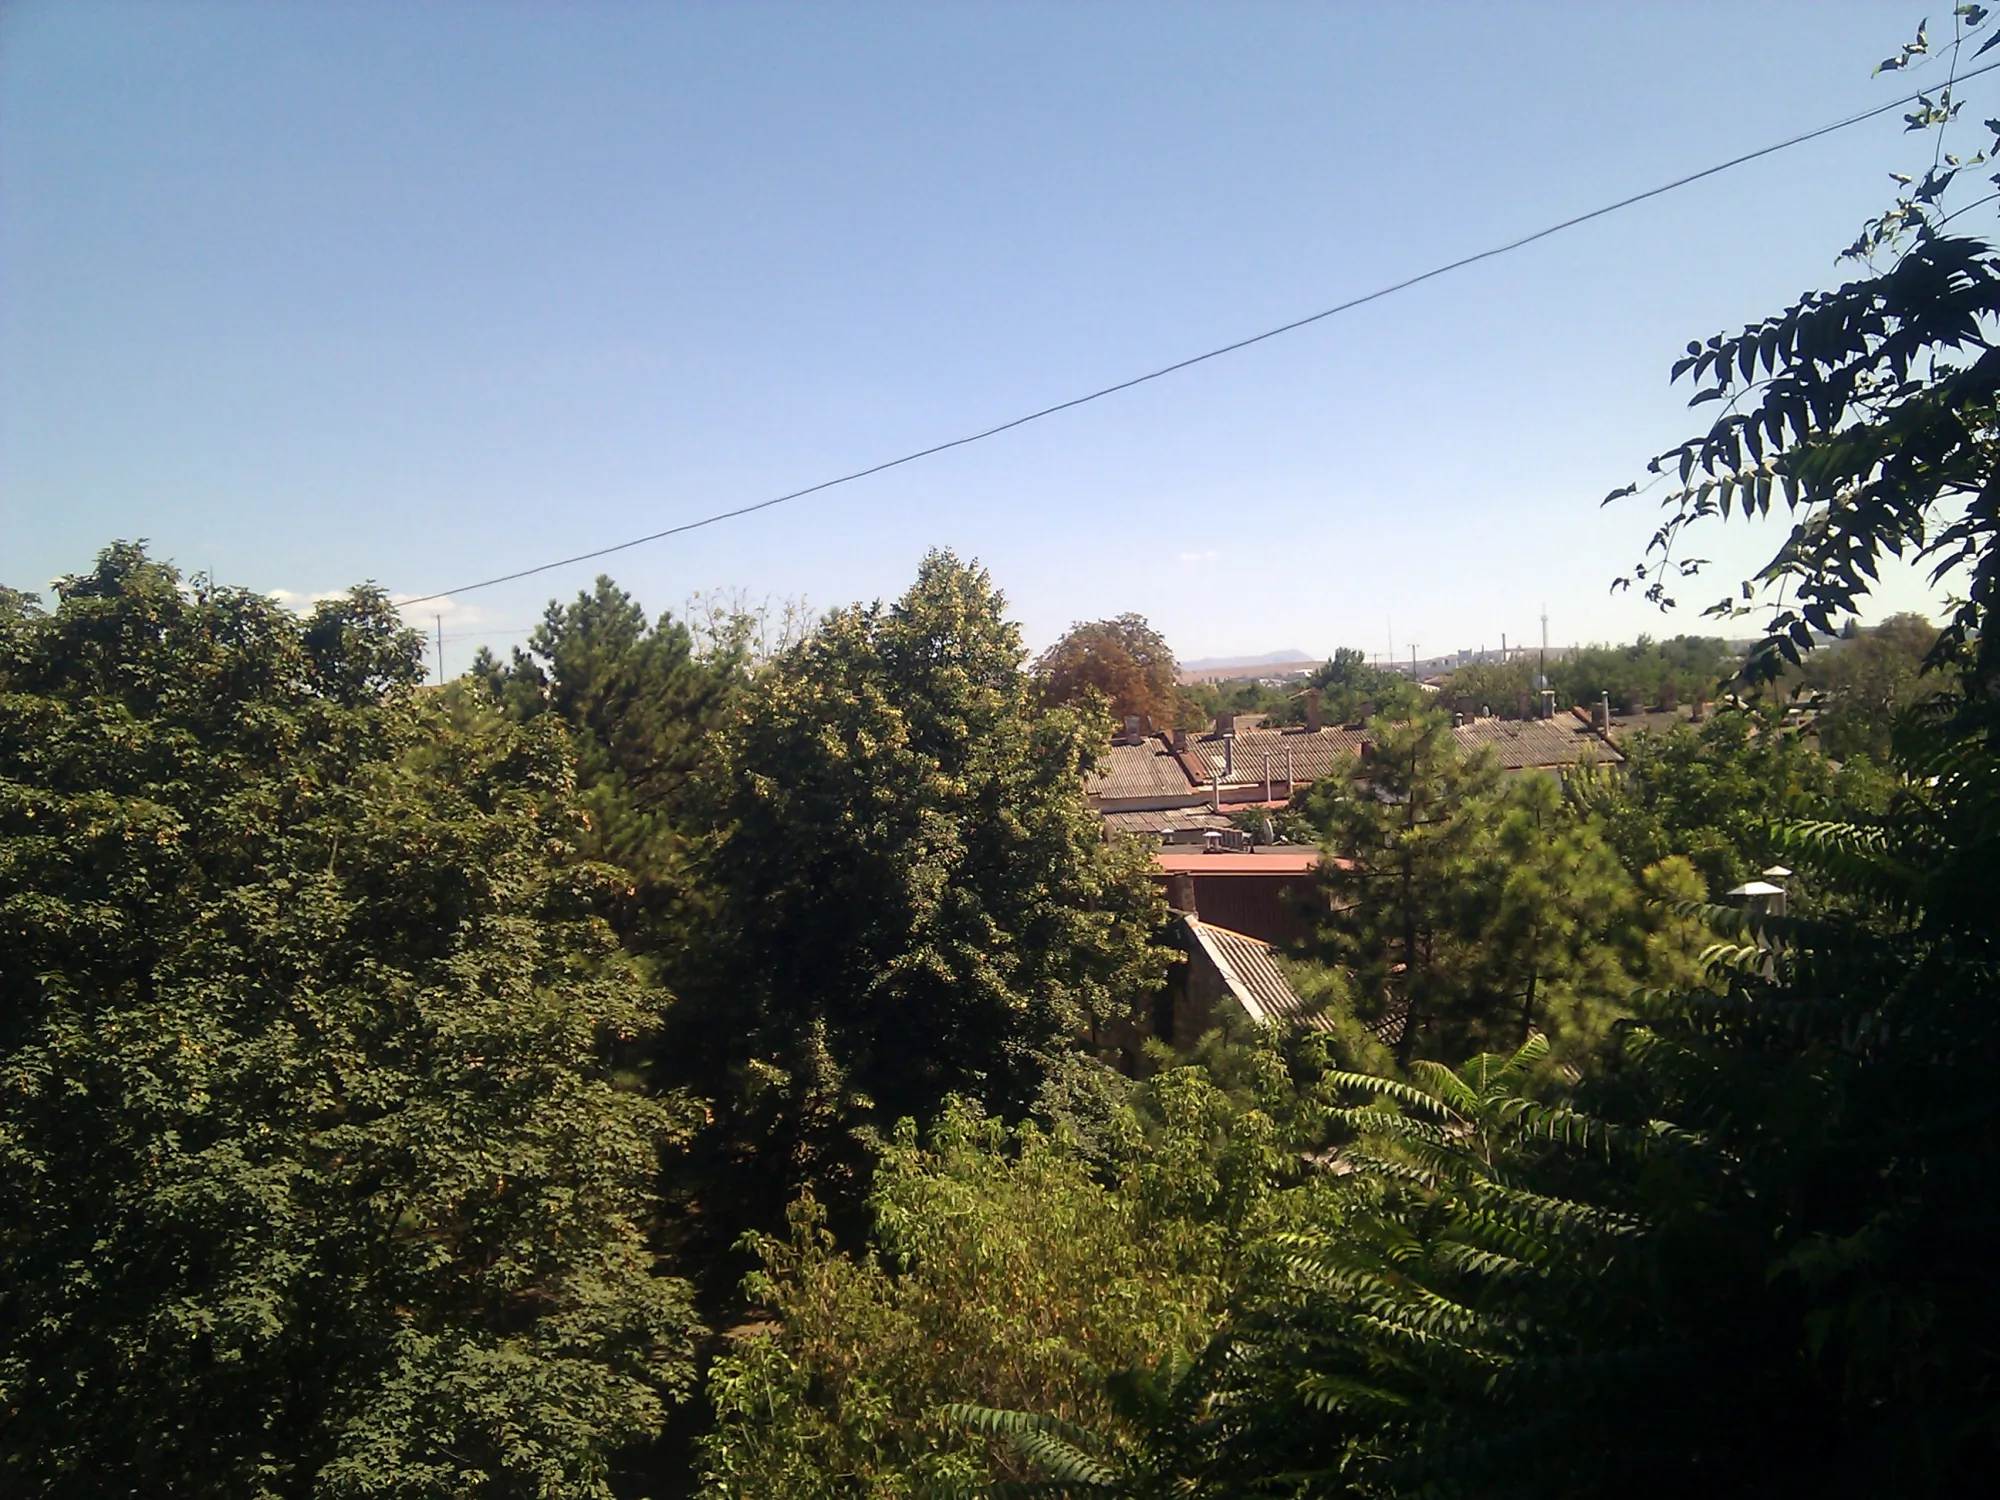
На взгляд туриста, это мирный, спокойный и очень зелёный город. Дорогу можно переходить не торопясь,
Есть и непривычные для России растения —
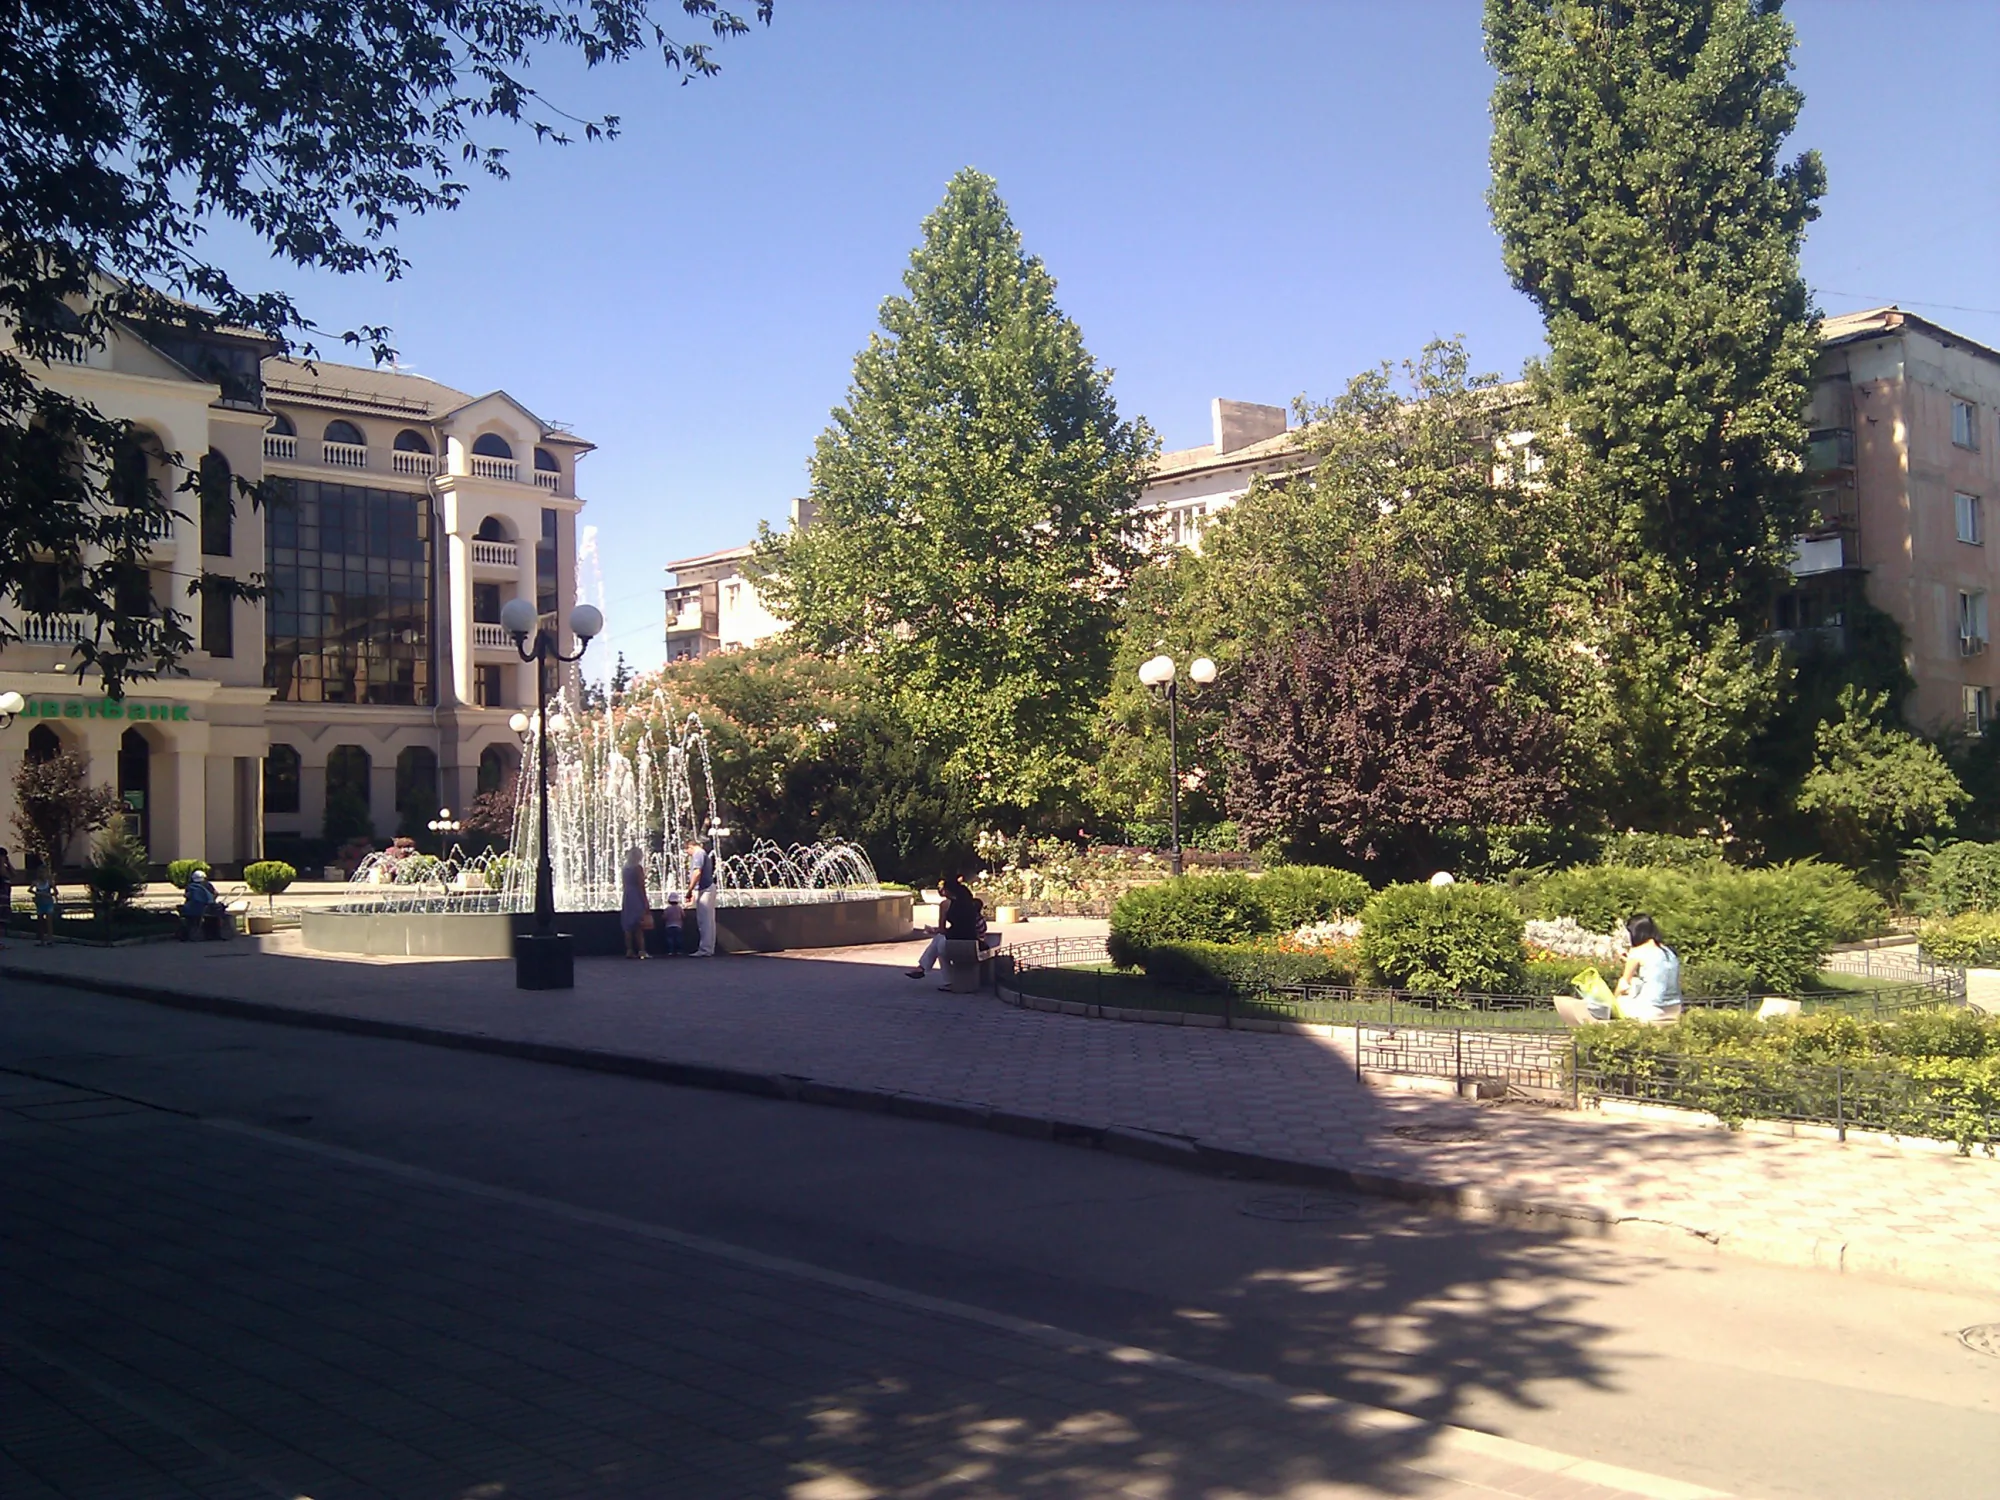
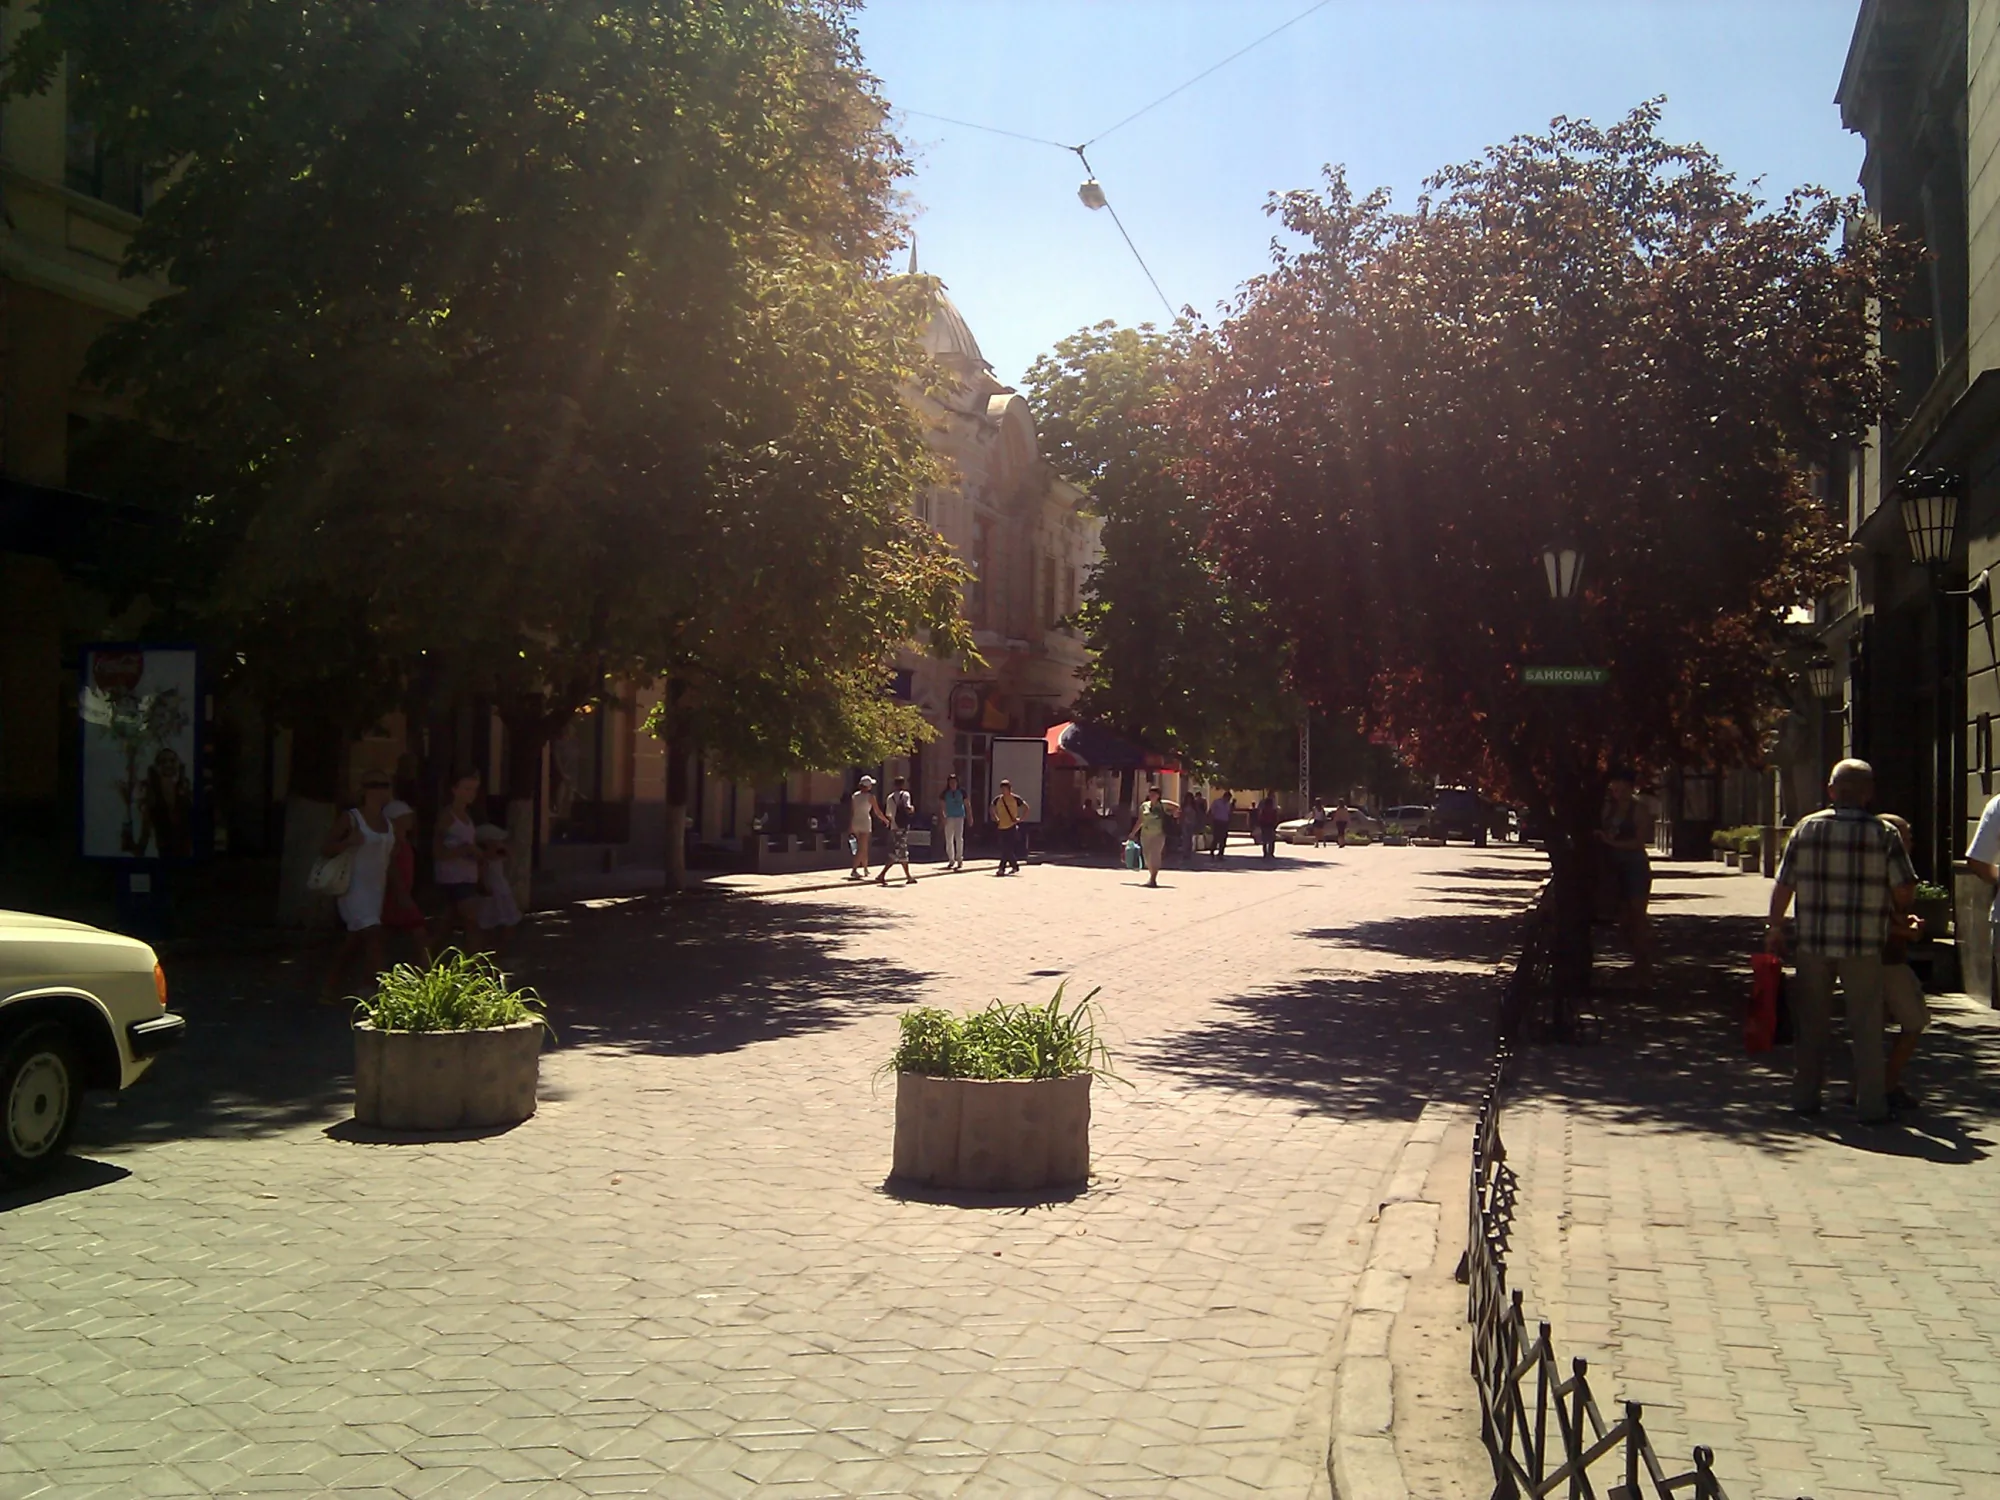
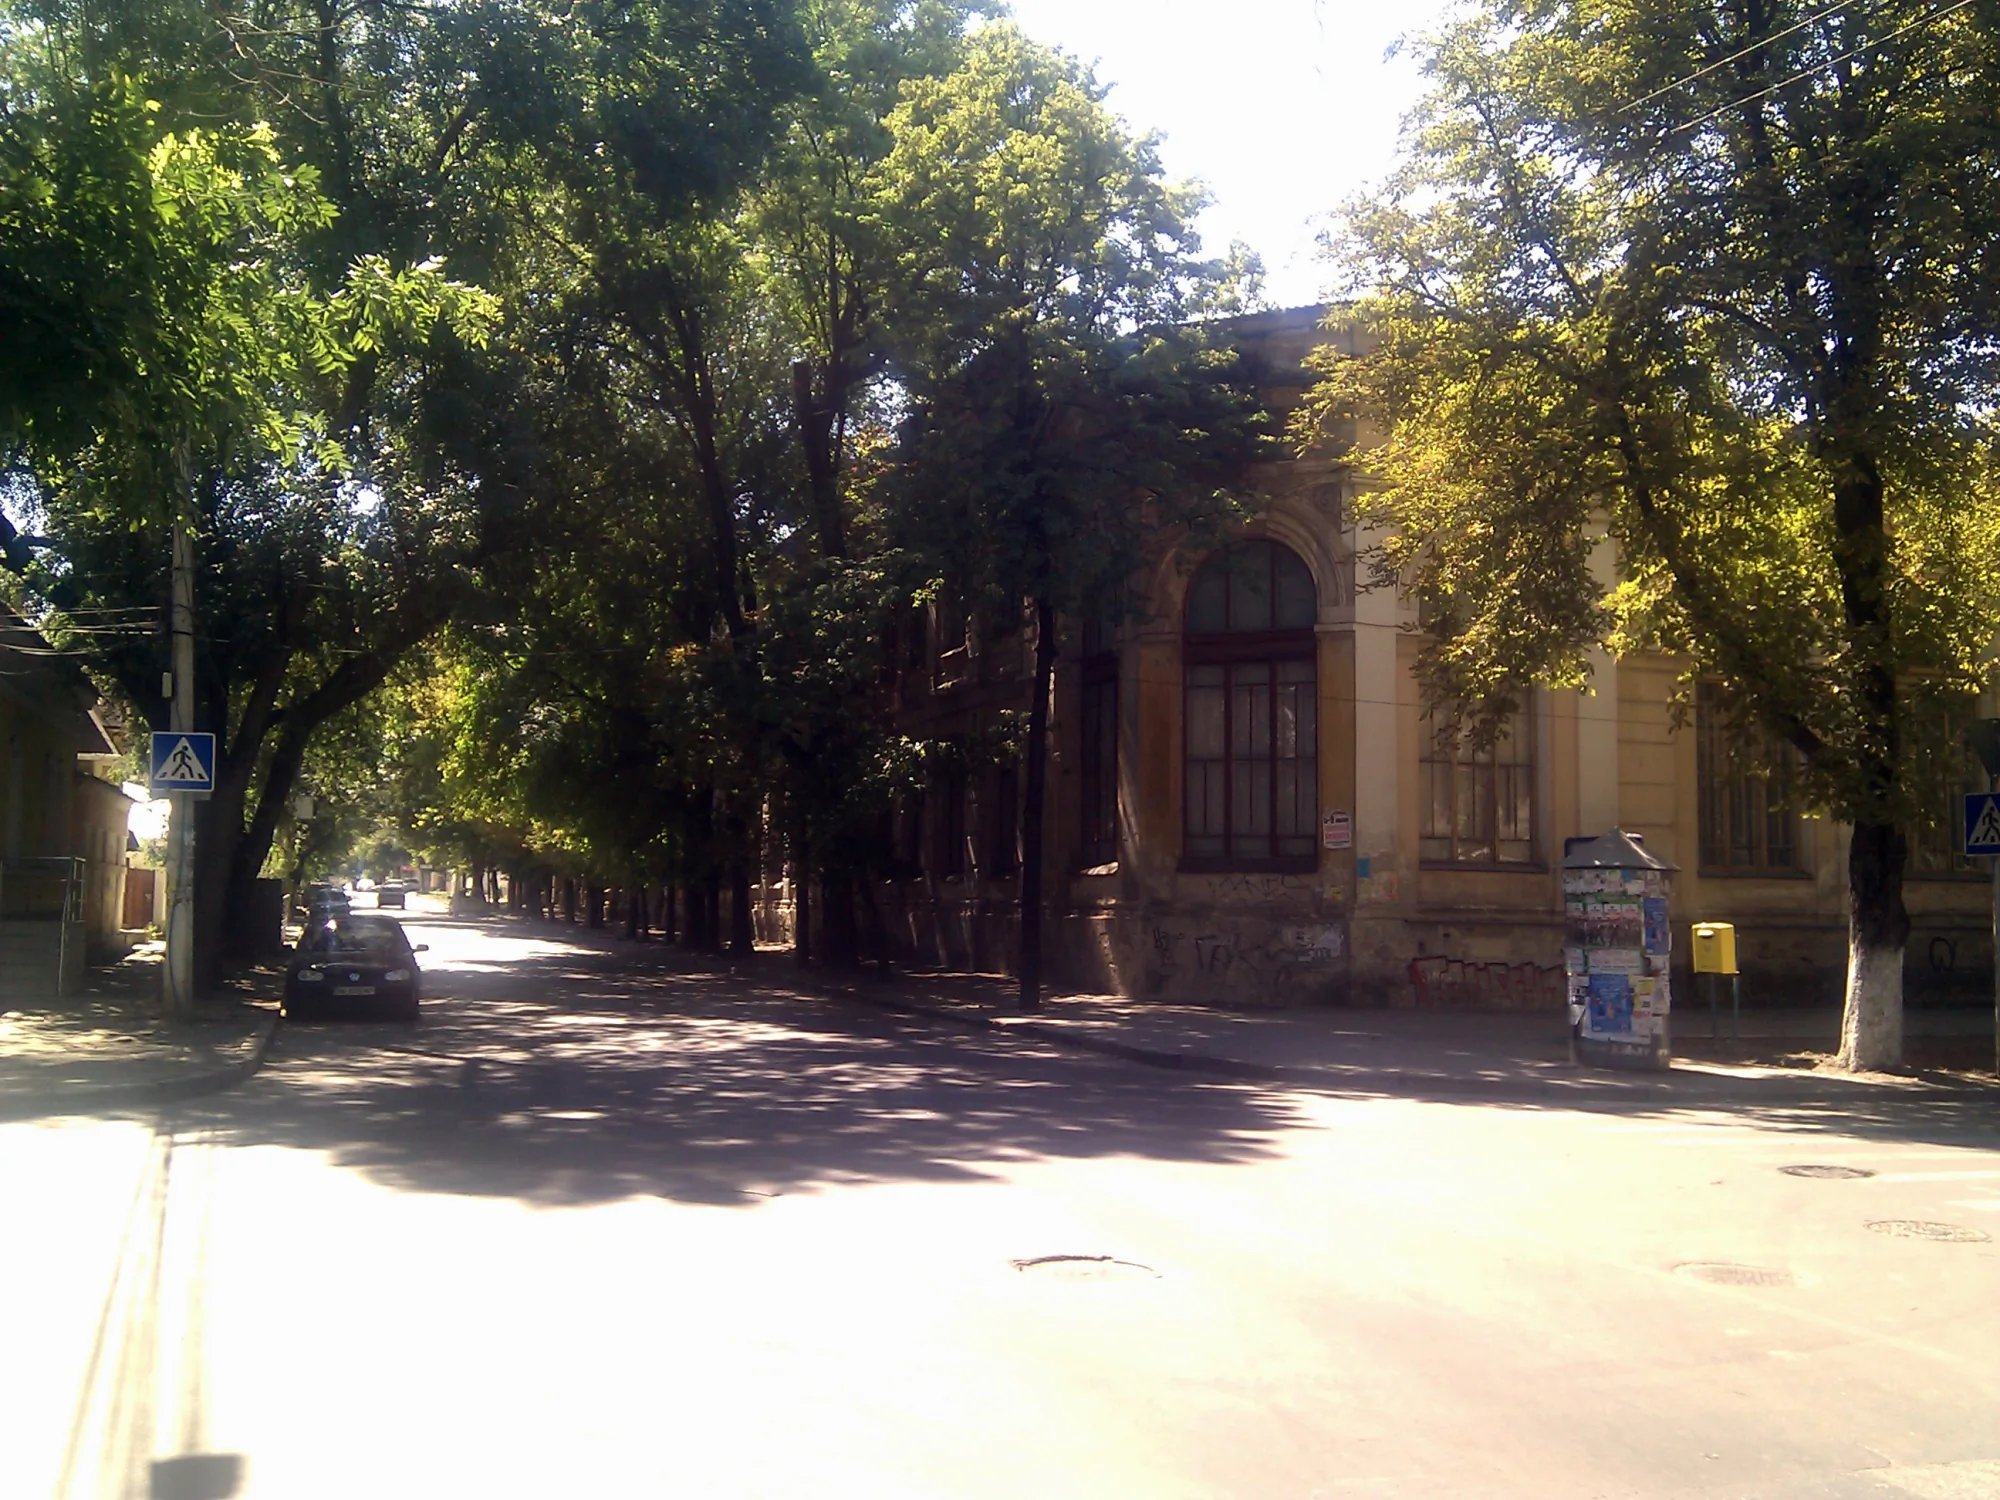
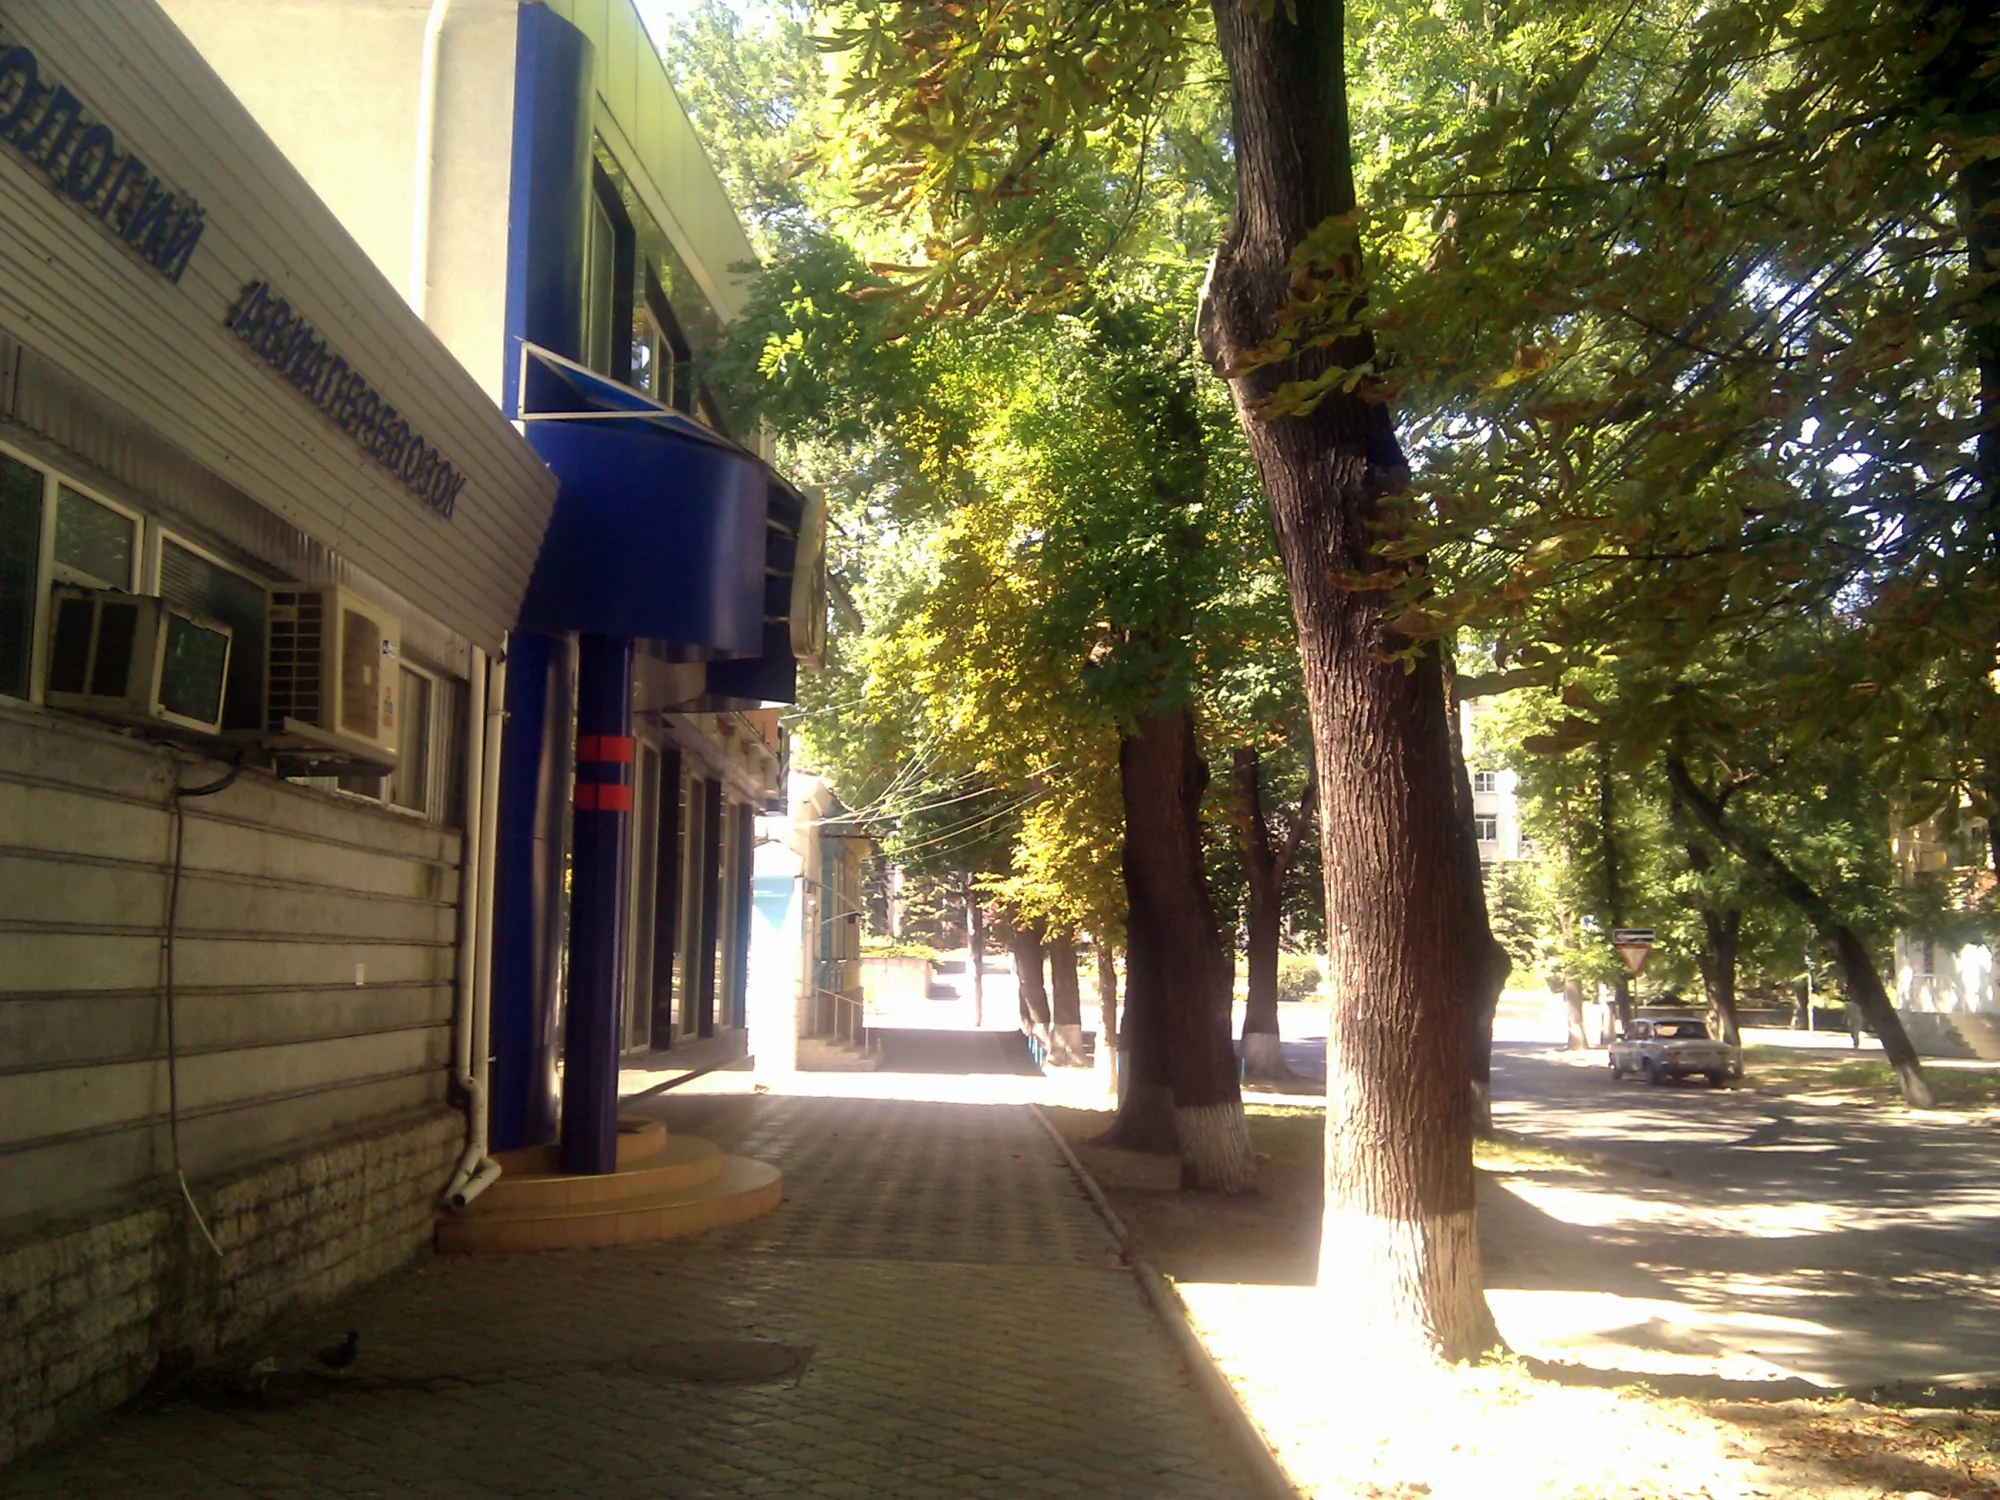
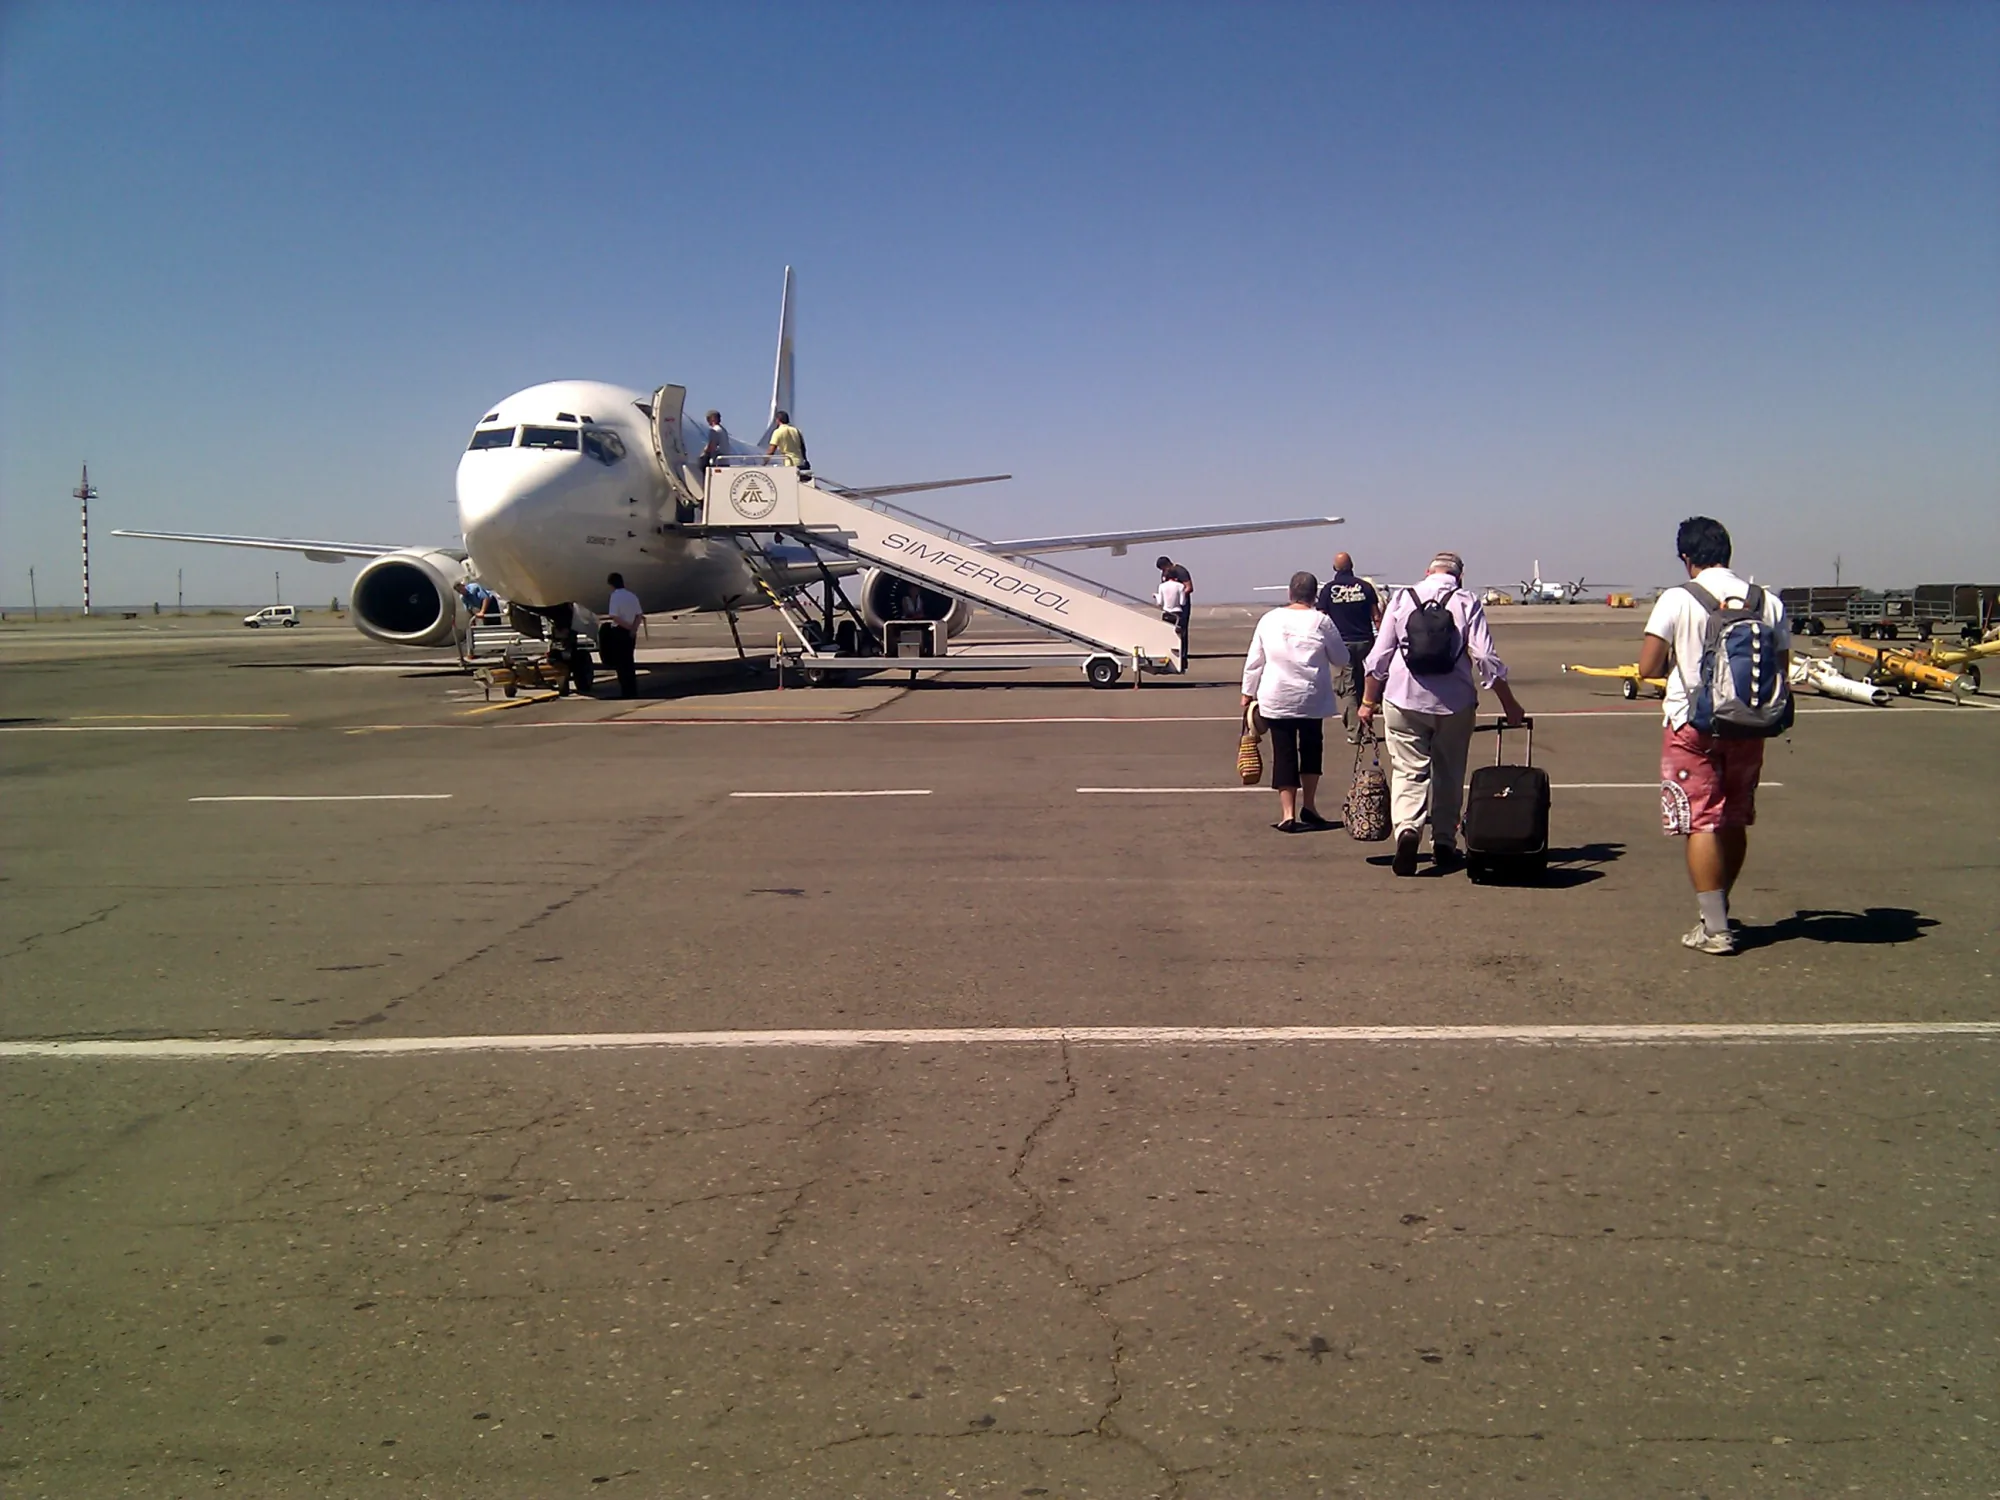
Последнее, где я побывал — аэропорт. В Симферополе он маленький, до самолёта нужно идти пешком, очень непривычно, хотя и разумно. В Казани аэропорт тоже небольшой, но пассажиров важно развозят на автобусе.
В целом, очень приятный город, по крайней мере его центр. Я не походил по туристическим местам, мне не хотелось, но надеюсь
Остальные фотографии можно увидеть на «Яндекс.Фотках».
«Декстер»
Вчера мы досмотрели «Теорию лжи» и начали смотреть «Декстер». Ребята, я не понимаю чем интересен этот сериал. Объясните, скука же.
Предложили разрабатывать Samba4
Разработчики Samba предложили войти в команду разработки. Я в шоке.
Пакетное скругление картинок v0.1
Неожиданно тема пакетного скругления картинок оказалась близка не только мне. В комментариях накидали несколько предложений по улучшению программы.
Я постарался выполнить всё то, что смог добавить за вечер.
-
-quality=85 --radius=10 —background=#ffffff --mask=*.{j,J}{p,P}{g,G} --out-dir=out
GUI за вечер, конечно же, я не прикручу, а с сохранением EXIF есть сложности: на деле оказалось, что EXIF не то вырезается, он просто не сохраняется библиотекой GD, буду думать.
Скачать новую версию можно там же, где и предыдущую.
Ошибки до собеседования
Некоторые люди умудряются совершать ошибки ещё до собеседования. А именно — осложнить мне чтение своего резюме. Соответственно, из двух ребят я буду сначала собеседовать того, чьё резюме мне удалось прочитать без мучений. Загвоздка в том, что до второго претендента дело может и не дойти.
Ошибок такого типа пока обнаружено ровно две: резюме в загадочных форматах (например, ODT — это формат OpenOffice, у меня есть великолепный MS Office, а ставить OO только ради того чтобы прочесть
Насчёт первого небольшая ремарка — прежде чем слать резюме в ODT или WPS, подумайте, теряете ли вы
О втором подробнее. Я не люблю читать на английском, просто потому что мне труднее его читать, чем русский. Если нет положительной обратной связи
Нужно понимать, что для человека идти по пути наименьшего сопротивления естественно, если только другой путь не принесёт очевидных благ (признание, славу, деньги, внутреннее равновесие и так далее — как мы видим, даже внутренняя мотивация сгодится). В чтении резюме таких выгод нет. Так что я сначала обработаю заявки тех людей, чтение резюме которых затратит меньше моих сил, а только потом (это же работа, её всё равно делать) — остальных.
В результате, как я уже говорил, до «остальных» дело может и не дойти — достойный кандидат может найтись раньше.
Сколько глаз у семи нянек?
Я часто говорю, что многие взрослые недалеко от детей ушли по интеллектуальному развитию. Развитие на одном уровне, но по разным причинам. Простая загадка — на вас смотрят десять человеческих глаз, сколько людей перед вами?
Дети, не задумываясь, почти всегда ответят «пять», потому что в их опыте
Правильный ответ же формул не требует — от одного нуля до бесконечности. Нужно только включить мозг.
Добавлено позднее:
Ближайшие поездки
C
PHP и UTF-8
Все уже
Увы,
Немного праздника в этот однобайтный склеп привносит тот замечательный факт, что
Печальнее всего с двумя вещами.
Вторая проблема заковыристее. В PHP испокон веков аж три модуля для работы с регулярными выражениями — PCRE, Regular Expression (POSIX Extended) и уже знакомый нам Multibyte String. Первый работает
PCRE в таких помощниках не нуждается, потому что сам умеет работать
if (preg_match('/(\w)/iu', 'ПриветN', $m)) {
        var_dump($m);
    }
Выдаст нам… букву «N». Почему? Находить в строке
Matching characters by Unicode property is not fast, because PCRE has to search a structure that contains data for over fifteen thousand characters. That is why the traditional escape sequences such as \d and \w do not use Unicode properties in PCRE
То есть «\d» (цифры), «\w» (буквы) и, кстати, «\b» (граница слова) и «\s» (пробельные символы) работают только с однобайтовыми кодировками. Ужасно? Не то слово! Всё потеряно? К счастью, нет.
Если внимательно читать документацию по PCRE, то найдётся много интересного, в том числе решение и этой проблемы. В одной из версий этой библиотеки появилась экспериментальная конструкция, называемая «глаголом» (VERB), «глаголы» умеют очень многое, но нас интересует специфический «глагол» «UCP», который (ура) занимается тем, что переключает «\w», «\s», «\d» и «\b» в полностью юникодный режим.
То есть такой код даст нам ожидаемый результат:
if (preg_match('/(*UCP)(\w)/iu', 'ПриветN', $m)) {
        var_dump($m);
    }
Победа? Ничего подобного. Этот глагол работает начиная с PCRE 8.10, в самой последней стабильной версии PHP (5.3.3) содержится PCRE 8.02, там этот глагол ещё не поддерживается, я проверял.
Нужная нам версия 8.10 войдёт в PHP 5.3.4. Но,
Но не стоит опускать руки,
Подведём итоги. Для перевода (большого) проекта
Ну а так же не забыть про внешние источники данных — перевести базу
Милиция → Полиция
Посмотрите чем на самом деле грозит нам «закон» о полиции.
Для комментирования ситуации пригодится большой матерный загиб.
PHP и UTF-8: первый этап
Я решил описать переход проекта
Основная идея — я добавлю в проект статический класс UTF. В этом классе будет переключатель (я назвал его «ON»), если он в состоянии «false», то все статические методы класса вызывают функции, работающие с однобайтовыми кодировками, иначе —
Выглядит он примерно так:
class UTF
{
    const ON = false;

    static public function strpos($haystack, $needle, $offset = 0)
    {
        if (self::ON) {
            return mb_strpos($haystack, $needle, $offset, 'UTF-8');
        }

        return strpos($haystack, $needle, $offset);
    }

    // … и так далее
}
Для чего нужен переключатель ON? Он позволяет переключить разом весь проект в состояние
Итак, нам надо посмотреть что же нужно переписывать и заменять в проекте. Я поступил просто — открыл в руководстве по PHP разделы строковых функций, функций PCRE и регулярных выражений в формате POSIX, скопировал их себе в программу и оформил как регулярное выражение:
<?
$funclist = <<<LIST
addcslashes — Quote string with slashes in a C style
chop — Alias of rtrim
chr — Return a specific character
chunk_split — Split a string into smaller chunks
convert_cyr_string — Convert from one Cyrillic character set to another
count_chars — Return information about characters used in a string
hebrev — Convert logical Hebrew text to visual text
hebrevc — Convert logical Hebrew text to visual text with newline conversion
html_entity_decode — Convert all HTML entities to their applicable characters
htmlentities — Convert all applicable characters to HTML entities
htmlspecialchars_decode — Convert special HTML entities back to characters
htmlspecialchars — Convert special characters to HTML entities
lcfirst — Make a string`s first character lowercase
levenshtein — Calculate Levenshtein distance between two strings
localeconv — Get numeric formatting information
ltrim — Strip whitespace (or other characters) from the beginning of a string
metaphone — Calculate the metaphone key of a string
money_format — Formats a number as a currency string
nl_langinfo — Query language and locale information
ord — Return ASCII value of character
rtrim — Strip whitespace (or other characters) from the end of a string
setlocale — Set locale information
similar_text — Calculate the similarity between two strings
soundex — Calculate the soundex key of a string
sscanf — Parses input from a string according to a format
str_getcsv — Parse a CSV string into an array
str_ireplace — Case-insensitive version of str_replace.
str_pad — Pad a string to a certain length with another string
str_rot13 — Perform the rot13 transform on a string
str_shuffle — Randomly shuffles a string
str_split — Convert a string to an array
str_word_count — Return information about words used in a string
strcasecmp — Binary safe case-insensitive string comparison
strcmp — Binary safe string comparison
strcoll — Locale based string comparison
strcspn — Find length of initial segment not matching mask
stripcslashes — Un-quote string quoted with addcslashes
stripos — Find position of first occurrence of a case-insensitive string
stristr — Case-insensitive strstr
strlen — Get string length
strnatcasecmp — Case insensitive string comparisons using a "natural order" algorithm
strnatcmp — String comparisons using a "natural order" algorithm
strncasecmp — Binary safe case-insensitive string comparison of the first n characters
strncmp — Binary safe string comparison of the first n characters
strpbrk — Search a string for any of a set of characters
strpos — Find position of first occurrence of a string
strrchr — Find the last occurrence of a character in a string
strrev — Reverse a string
strripos — Find position of last occurrence of a case-insensitive string in a string
strrpos — Find position of last occurrence of a char in a string
strspn — Finds the length of the first segment of a string consisting entirely of characters contained within a given mask.
strtolower — Make a string lowercase
strtoupper — Make a string uppercase
strtr — Translate certain characters
substr_compare — Binary safe comparison of two strings from an offset, up to length characters
substr_count — Count the number of substring occurrences
substr_replace — Replace text within a portion of a string
substr — Return part of a string
trim — Strip whitespace (or other characters) from the beginning and end of a string
ucfirst — Make a string`s first character uppercase
ucwords — Uppercase the first character of each word in a string
wordwrap — Wraps a string to a given number of characters
preg_filter — Perform a regular expression search and replace
preg_grep — Return array entries that match the pattern
preg_last_error — Returns the error code of the last PCRE regex execution
preg_match_all — Perform a global regular expression match
preg_match — Perform a regular expression match
preg_quote — Quote regular expression characters
preg_replace_callback — Perform a regular expression search and replace using a callback
preg_replace — Perform a regular expression search and replace
preg_split — Split string by a regular expression
ereg_replace — Replace regular expression
ereg — Regular expression match
eregi_replace — Replace regular expression case insensitive
eregi — Case insensitive regular expression match
split — Split string into array by regular expression
spliti — Split string into array by regular expression case insensitive
sql_regcase — Make regular expression for case insensitive match
ctype_alnum — Check for alphanumeric character(s)
ctype_alpha — Check for alphabetic character(s)
ctype_cntrl — Check for control character(s)
ctype_digit — Check for numeric character(s)
ctype_graph — Check for any printable character(s) except space
ctype_lower — Check for lowercase character(s)
ctype_print — Check for printable character(s)
ctype_punct — Check for any printable character which is not whitespace or an alphanumeric character
ctype_space — Check for whitespace character(s)
ctype_upper — Check for uppercase character(s)
array_change_key_case — Changes all keys in an array
array_multisort — Sort multiple or multi-dimensional arrays
arsort — Sort an array in reverse order and maintain index association
asort — Sort an array and maintain index association
krsort — Sort an array by key in reverse order
ksort — Sort an array by key
natcasesort — Sort an array using a case insensitive "natural order" algorithm
natsort — Sort an array using a "natural order" algorithm
rsort — Sort an array in reverse order
sort — Sort an array
LIST;

$funcs = array();

foreach (explode("\n", $funclist) as $line) {
    list($line) = explode(" ", $line, 2);

    $funcs[] = $line;
}

$regexp = '/(?<!UTF::)\b(' . implode('|', $funcs) . ')\s*\(/si';

set_time_limit(0);

$it = new RecursiveIteratorIterator(new RecursiveDirectoryIterator('.'));

for (;$it->valid(); $it->next()) {
    $ext = pathinfo($it->getBaseName(), PATHINFO_EXTENSION);

    if ($ext == 'php') {
        if (preg_match_all($regexp, file_get_contents($it->key()), $matches)) {
            echo $it->key(), "\n";

            echo '    ', implode("\n    ", array_map('strtolower', $matches[1])), "\n\n";
        }
    }
}
Список функций я проредил — удалил оттуда те, у которых проблем
bolk@dev:~/daproject$ grep ' ' tool.log | sort | uniq -c | sort -rn
    225     substr
    195     preg_replace
    174     trim
    132     preg_match
    132     htmlspecialchars
    127     strpos
    113     strtolower
     88     strlen
     50     preg_replace_callback
     40     rtrim
      …

bolk@dev:~/daproject$ grep './' tool.log
./tool.php
./htdocs/_file.php
./htdocs/file1.php
./htdocs/dir/file1.php
./htdocs/dir/file2.php
./htdocs/dir/file3.php
./htdocs/dir/file4.php
./htdocs/dir/file5.php
./htdocs/class.php
./htdocs/_ajax.php
…
На следующем этапе я заменю эти функции на их аналоги. Кстати, если у вас используются оба алиаса одной функции (например, chop и trim), то подумайте над тем, чтобы привести всё к единому виду.
Отдельно надо будет
Так же очень полезно получить список всех используемых модулей, чтобы решить какие из них могут быть проблемными.
PHP и UTF-8: второй этап (ничего не забыли?)
Итак, на первом этапе перевода нашего
Могли.
Итак, как их найти? Мне кажется, хороший путь — посмотреть где встречается сигнатура „<?“:
bolk@dev:~/daproject$ grep --binary-files=without-match -R '<?' * | cut -d':' -f1 |
> grep -v '.svn' | sed -re 's/.*?/([^/]+)/1/' | awk -F. '/./{print $NF}' | sort -u
conf
csv
example
inc
js
package
php
pm
png
py
svg
tpl
xml
xsl
Очевидно, что файлы формата XML (у меня это расширения xml, xsl и svg) так же могут содержать сигнатуру „<?“ (там это часть языка), текстовые файлы (conf, csv) так же её могут содержать (они вообще могут содержать что угодно).
Как же отфильтровать такой мусор? У интерпретатора PHP есть специальная опция, для того, чтобы проверить является ли подаваемый на вход файл синтаксически верным. Мы ей можем воспользоваться:
bolk@dev:~/daproject$ grep --binary-files=without-match -R '<?' * | cut -d':' -f1 | egrep -v '.svn|.php' |
> xargs -rn1 -I{} php -r 'echo `php -l {}`;' | grep -F 'No syntax errors detected in' | sort -u
No syntax errors detected in htdocs/_dir/file1.csv
No syntax errors detected in htdocs/_dir/file2.png
No syntax errors detected in htdocs/_dir/file3.csv
No syntax errors detected in htdocs/_dir/file4.png
No syntax errors detected in htdocs/_dir/file5.csv
No syntax errors detected in templates/file1.tpl
…
Оказывается, PHP у меня есть даже внутри файлов с расширением png!
К несчастью, у меня таких файлов достаточно прилично — 39, поэтому я собираюсь некоторые из них отбросить сразу:
sed -e 's/^No syntax errors detected in //' tool2.log | xargs -n1 head --verbose | lessОказалось, что рассматривать как файлы PHP нужно файлы с ещё двумя расширениями — inc и tpl, остальные так же содержат
Поэтому я добавлю в программу из предыдущего этапа ещё два расширения и запущу её снова. У меня количество функций не изменилось — 38, а вот файлов добавилось — стало 176 против 173. Ура, теперь файлы
А что по поводу используемых расширений PHP? Их много и с каждым месяцем становится всё больше (я сам написал 3 или 4), вдруг
Для начала неплохо было бы узнать сколько у нас вообще расширений. Я знаю, что расширения в PHP подключаются двумя способами: в конфигурационном файле и при помощи функции dl. Для начала посмотрим, используется ли у нас функция dl:
bolk@dev:~/daproject$ find \( -name '*.php' -or -name '*.inc' -or -name '*.tpl' \) -exec egrep -i 'dl\s*\(' {} \; -print
    * @return bool Success or not on the dl() call
            // if either returns true dl() will produce a FATAL error, stop that
            return @dl('php_'.$ext.$suffix) || @dl($ext.$suffix);
./php/lib/PEAR.php
        if(!extension_loaded("mysql")) dl("mysql.so");
./php/db/mysql.php
У меня dl используется. Берём на заметку, что через dl подгружается модуль MySQL, а заглянув в PEAR, обнаружим, что там есть метод loadExtension, который является мультиплатформенной обёрткой для dl.
Для очистки совести я поискал случаи использования loadExtension в проекте (не забудьте, что регистр нужно игнорировать), но не нашёл.
Итак, мы выяснили какие модули у нас подгружаются через dl — только один (mysql), что же вкомпилированно в сам PHP или подключено из файлов конфигурации? Нет способа лучше, чем узнать что сам PHP думает об этом:
bolk@dev:~/daproject$ php -m
[PHP Modules]
zip
xmlwriter
libxml
xml
wddx
tokenizer
…
У меня это 54 модуля. Это очень много. Действительно ли их столько используется в проекте? Вот уж вряд ли. Надо
Отсюда мысль — узнать какие функции/классы содержатся в модуле и поискать их в файлах.
Давайте я это сделаю в следующей части, а то мне сейчас собеседование проводить.
PHP и UTF-8: второй этап (продолжение: ничего не забыли?)
Итак, в прошлый раз мы выяснили какие файлы у нас содержат программы на PHP и какие расширения есть в нашем интерпретаторе. Кстати, не забывайте про внепроектные файлы, те, что лежат в других папках, например, уровнем ниже. Их тоже надо использовать в нашем исследовании.
Выяснить какие же расширения реально используются в проекте нам поможет следующая программа:
<?
    $extensions = array_merge(
        get_loaded_extensions(true),
        get_loaded_extensions()
    );

    $funcs = array();

    foreach ($extensions as $extension) {
        if ($extension == 'standard' || $extension == 'session') {
            continue;
        }

        $extfuncs = get_extension_funcs($extension);

        if ($extfuncs) {
            $funcs = array_merge(
                $funcs,
                    array_combine(
                        array_map('strtolower', $extfuncs),
                        array_fill(0, sizeof($extfuncs), $extension)
                )
            );
        };
    }

    $classes = get_declared_classes();

    set_time_limit(0);

    $classes_regexp = '/new\s+(?i)(' . implode('|', $classes) . ')/s';
    $funcs_regexp   = '/(' . implode('|', array_keys($funcs)) . ')/si';

    $it = new RecursiveIteratorIterator(new RecursiveDirectoryIterator('.'));

    for (;$it->valid(); $it->next()) {
        $ext = pathinfo($it->getBaseName(), PATHINFO_EXTENSION);

        if ($ext == 'php' || $ext == 'tpl' || $ext == 'inc') {

            $content = file_get_contents($it->key());

            if (preg_match_all($classes_regexp, $content, $matches)) {
                echo $it->key(), "\nClass: ",
                    implode("\nClass: ", array_map('strtolower', $matches[1])), "\n\n";
            }

            if (preg_match_all($funcs_regexp, $content, $matches)) {
                echo $it->key(), "\n";

                foreach ($matches[1] as $func) {
                    $func = strtolower($func);

                    if (isset($funcs[$func])) {
                        echo 'Module: ', $funcs[$func], "\n";
                    } else {
                        echo 'Something wrong: ', $func, "\n";
                    }
                }

                echo "\n\n";
            }
        }
    }
У меня она отработала достаточно неспешно, за несколько минут. Каковы же результаты?
bolk@dev:~/daproject$ awk -F: '/^Module/{print $2}' tool2.log | sort -u
 ctype
 curl
 date
 gettext
 hash
 iconv
 …

bolk@dev:~/daproject$ awk -F: '/^Class/{print $2}' tool2.log | sort -u
 exception
 simplexmlelement
Начнём с конца — Exception это класс для работы с исключениями,
А вот остальные 19 модулей, используемых в проекте, просмотреть сложнее. Их тех, что у меня есть я сразу могу исключить SQLITE3, XML,
Как я узнаю какие модули работают
На что ещё надо обратить внимание? На две вещи — нет ли в файлах
С первым просто, я перевожу проект
bolk@dev:~/wiki$ find -type f -name '?*.*' | grep -v '.svn' | xargs -r -n1 egrep -iH 'cp1251|cp\-1251|windows\-1251'
./php/dir1/file1.php:         if (strtolower($rss->encoding) != 'windows-1251') {
./php/dir1/file2.php:                 $c = @iconv($rss->encoding, 'cp1251', $c);
./php/dir2/file3.php:                    $title = iconv('UTF-8', 'CP1251', $employers[$i]->first_name .' '. $employers[$i]->last_name);
…
У меня таких строк — вагон и маленькая тележка, что с ними делать, будем решать дальше, пока же отметим, что они есть, причём в количестве 158 штук.
А что с PEAR? Точнее, с теми файлами PEAR, которые подключаются не из папки проекта, а из папки PEAR, которая скрыта
У меня таких импортов, кстати, не оказалось.
Кажется, информации накоплено достаточно, пора
(И тут я предлагаю сделать перерыв до завтра)
Тест на понимание
Кстати, мой текст про «Ошибки до собеседования» прекрасный тест на восприятие текста. В нём есть две сентенции, которые
Первое — резюме лучше слать как обычный текст, если возможно, вторая — резюме, которое
Неизвестно откуда читателями синтезировано два ложных утверждения: якобы я предлагаю слать резюме в формате DOC (это не так) и якобы я не рассматриваю резюме на английском
Где вы это всё вычитали, м?
Как бороться с туннельным синдромом
В ЖЖ появилась отличная статья «RSI — как бороться с туннельным синдромом», полезна она тем, что вполне тянет на полное исследование вопроса. Крайне, крайне рекомендую к прочтению полностью, а себе я выпишу несколько вещей, которые мне показались особенно примечательными:
- чтобы проверить предрасположенность к RSI, нужно попробовать оттянуть большой палец к запястью, если получается — есть предрасположенность (предрасположенность к RSI — это растянутость связок, растянутость связок побуждает кисть «болтаться» в работе, и приводит к износу сухожильной сумки)
- алкоголь дополнительно повреждает нервы в воспалённом районе кисти и, похоже, смазку сухожилий
- PowerBall нужно использовать без фанатизма. Регулярное превышение
6-8 тысяч оборотов на нём вам сделает RSI, если его даже не было. Для того, чтобы укрепить мышцы, надо систематично крутить его на относительно небольших оборотах: «столько, пока комфортно терпишь, плюс ещё тридцать секунд» - используйте клавиатуру с мягким ходом клавиш, без «дребезга» и щелчков. Шелчки передаются связкам и травмируют их
- обрезайте ногти под ноль. Два миллиметра — уже много. Нажатие на клавиатуру подушечками пальцев щадит связки сильнее, чем нажатие или задевание части поверхности клавиши ногтями
- мышку использовать нельзя. В списках причин RSI мышь стоит на первом месте. В опросниках у врачей по поводу RSI мышь стоит на первом месте: «Используете ли вы компьютерную мышку?» Используйте точпад
ЖЖ, OpenID и мой блог
Good news, everyone!
Я взял примеры, которые идут с библиотекой OpenID от JanRain, которую я использую. И оказалось, что OpenID ЖЖ в примерах работает нормально. Это означает, что это я с библиотекой делаю Оказалось, что не все тесты работают нормально. Значит, надо искать ошибку в библиотеке. Ох.
Добавлено позднее: а пока написал в JanRain и ЖЖ по письму с полным описанием бага.
Травма плеча перестала беспокоить
«Загадочная травма», о которой я писал меньше месяца назад отпустила. Как только боль прошла, в тот же день смог поднять «разогревочные» 68 кг, около 10 раз. Это, конечно, несколько меньше, чем обычно (обычно —
Теперь пока боюсь сорвать, делаю только один подход в день и смотрю на реакцию, надо увеличивать количество подходов, потом — вес.
Пакетное скругление картинок: оболочка
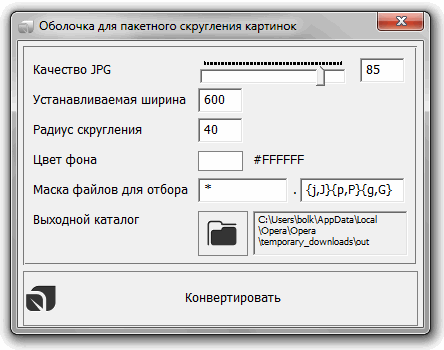
Пока у меня нет свободного вечера, чтобы заняться «скруглятором», но это не значит, что с проектом ничего не происходит. Читатель с ником oldTV изготовил отличную графическую оболочку «MCShell». Выглядит замечательно.
PHP и UTF-8: третий этап (создание прототипов)
Этот сериал хорош тем, что я пишу его в реальном времени. Единственно, первая фаза — когда я собирал первоначальные данные и обдумывал как мне подступиться к этой задаче, заняла куда больше времени, чем может показаться. Итак, в предыдущей части мы выяснили какие модули используются в нашем проекте и узнали, что в нём
В этой части мы подготовимся к тому, чтобы заменить в проекте все упоминания небезопасных (с точки зрения работы
Как я уже сказал, расширение Reflection работает в PHP с багами, именно поэтому я максимально подробно стараюсь обработать ошибочные ситуации. После запуска программы, можно подсчитать, какое количество функций (у меня их 10) не отобразилось правильно, ничего не поделаешь, придётся их править руками. Файл Я удаляюсь править прототипы руками, а в следующей части уже перейдём к непосредственной замене. P.S. В коде есть странное место — «blah» . ’\$var’, увы, у меня Что же дальше?
<?
function U_makeproto($funcname)
{
    $func = new ReflectionFunction($funcname);

    $out = '    static public function ' . $funcname . '(';

    $counter = 0;
    $hasRefOptional = $hasOptional = false;
    $names = array();

    foreach ($func->getParameters() as $param) {
        $name = $param->getName();

        if ($name !== null && $name != '...') {
            $names[] = $name = '$' . $name;
        } else {
            $names[] = $name = '$param' . $counter++;
        }

        if ($param->isPassedByReference()) {
            $name = '&' . $name;
        }

        if ($param->isArray()) {
            $name = 'array ' . $name;
        }

        if ($param->isOptional()) {
            $name .= '=';
            $name .= $param->isDefaultValueAvailable() ? $param->getDefaultValue() : 'null';

            if ($param->isPassedByReference()) {
                $hasRefOptional = true;
            }

            $hasOptional = true;
        }

        $out .= $name . ', ';
    }

    $out = rtrim($out, ', ') . ') {';
    if ($counter || !$names) {
        $out .= "\n        // FIXME: Invalid proto ( https://www.php.net//$funcname )\n";
    }

    $out .= "\n        if (self::ON) {".
            "\n            // TODO: UTF version".
            "\n        }\n";

    if (!$hasRefOptional) {
        if ($hasOptional || !$counter && !$names) {
            $out .= "\n        " . '$params = func_get_args();'.
                    "\n        return call_user_func_array('$funcname', \$params);";
        } else {
            $hereNames = implode(', ', $names);

            $out .= "\n        return $funcname($hereNames);";
        }
    } else {
        $reqCounter = $func->getNumberOfRequiredParameters();
        $out .= "\n        switch (func_num_args()) {".
                "\n            case $reqCounter:".
                "\n                " . '$params = func_get_args();'.
                "\n                return call_user_func_array('$funcname', \$params);";

                for ($i = $reqCounter+1, $len = $func->getNumberOfParameters(); $i<=$len; $i++) {
                    $hereNames = implode(', ', array_slice($names, 0, $i));

                    $out .= "\n            case $i:".
                            "\n                return $funcname($hereNames);";
                }

                $out .= "\n            default:".
                        "\n                 trigger_error('Wrong parameter count for $funcname()', E_USER_WARNING);".
                        "\n                 return null;";

                $out .= "\n        }";
    }

    return $out . "\n    }";
}


echo "<?php\nclass UTF\n{\n    const ON = false;\n\n";
foreach (file('php://stdin', FILE_IGNORE_NEW_LINES | FILE_SKIP_EMPTY_LINES) as $funcname) {
    echo U_makeproto($funcname), "\n\n";
}

echo "}";bolk@dev:~/daproject$ sed -re 's/\s+\S+\s+//' tool-func.log | php tool-func-proto.php > utf.php
bolk@dev:~/daproject$ grep -c FIXME utf.php
10
PHP и UTF-8: третий этап (давайте уже что-нибудь заменим)
Ну что ж, всё готово для того, чтобы
Запустить её можно, например, так (напоминаю, что у меня PHP находится в файлах с расширениями php, tpl и inc): Программа напечатает имена файлов, где произошла замена. Своеобразная проверка — запустите её ещё раз, на втором проходе никаких имён файлов выведено быть не должно! Обязательно проследите, чтобы запуск не затронул ваш класс Utf! Итак, мы заменили функции на вызовы класса Utf. Всё работает? У меня не заработало. Причины две — я ошибся в имени одной из функций в классе Utf и появились проблемы с preg_replace_callback. О последней проблеме поподробнее. Пока preg_replace_callback была встроенной функцией всё было замечательно, как только она стала статическим методом класса, проблемы появились. Всё дело в указании в качестве callback метода статического класса. Такие вещи придётся править вручную. Если нет возможности провести тестирование, то можно воспользоваться подсказками IDE — во многих случаях она укажет на такие ситуации, но, в любом случае, лучше все такие места просмотреть глазами. Сегодня ночью я улетаю в Екатеринбург, так что, думаю, это последняя часть на этой неделе. Кстати, остаются ещё строковые функции, вызываемые как callback, внутри eval Что же дальше?
<?
    if ($_SERVER['argc'] <> 3) die;
    if (realpath($_SERVER['argv'][2]) == realpath(__FILE__)) die;

    $file = file_get_contents($_SERVER['argv'][2]);
    if (strpos($file, '<?') === false) die;

    $funcs = file($_SERVER['argv'][1], FILE_IGNORE_NEW_LINES | FILE_SKIP_EMPTY_LINES);
    foreach ($funcs as &$func) {
        list(,$func) = preg_split('/\s+/s', $func, 2, PREG_SPLIT_NO_EMPTY);
    }

    $skip   = false;
    $skipIf = array(T_PAAMAYIM_NEKUDOTAYIM, T_DOUBLE_COLON, T_OBJECT_OPERATOR);
    $fixed  = false;

    ob_start();

    foreach (token_get_all($file) as $token) {
        if (is_scalar($token)) {
            echo $token;
        } else {
            if (!$skip && $token[0] == T_STRING && in_array(strtolower($token[1]), $funcs)) {
                $fixed = print 'Utf::' . $token[1];
            } else {
                echo $token[1];
            }

            $skip = in_array($token[0], $skipIf);
        }
    }

    file_put_contents($_SERVER['argv'][2], ob_get_clean());

    if ($fixed) {
        echo $_SERVER['argv'][2], "\n";
}bolk@dev:~/daproject$ find -type f \( -name '*.php' -or -name '*.tpl' -or -name '*.inc' \) | grep -vF '.svn' |
> xargs -n1 php tool4.php tool-func.log
./php/file.php
./php/dir1/file1.php
./php/dir1/file2.php
./php/dir1/dir2/file3.php
…
Ограничение сна: FAIL
Всё, хватит, заканчиваю свой эксперимент по ограничению количества сна. Мне, чтобы выспаться, нужно около 9…10 часов, я ограничивал время сна до 5…8 часов в день. Появились все признаки усталости: сонливость, рассеянность. Правда, сегодня всё будет ещё хуже — у нас вылет в Екатеринбург в половину первого, а в 8:15 уже подъём.
Не знаю, буду ли читать комментарии. Как получится.
Веб-сервис оптимизации SVG

Евгений Рыжков изготовил из моего скрипта оптимизации SVG
33
Ну вот мне и 33. В этой связи часто вспоминают выражение «возраст Христа», сделайте мне одолжение не надо в мой день рождения вспоминать во сколько Христос помер, мне не будет приятно.
Я
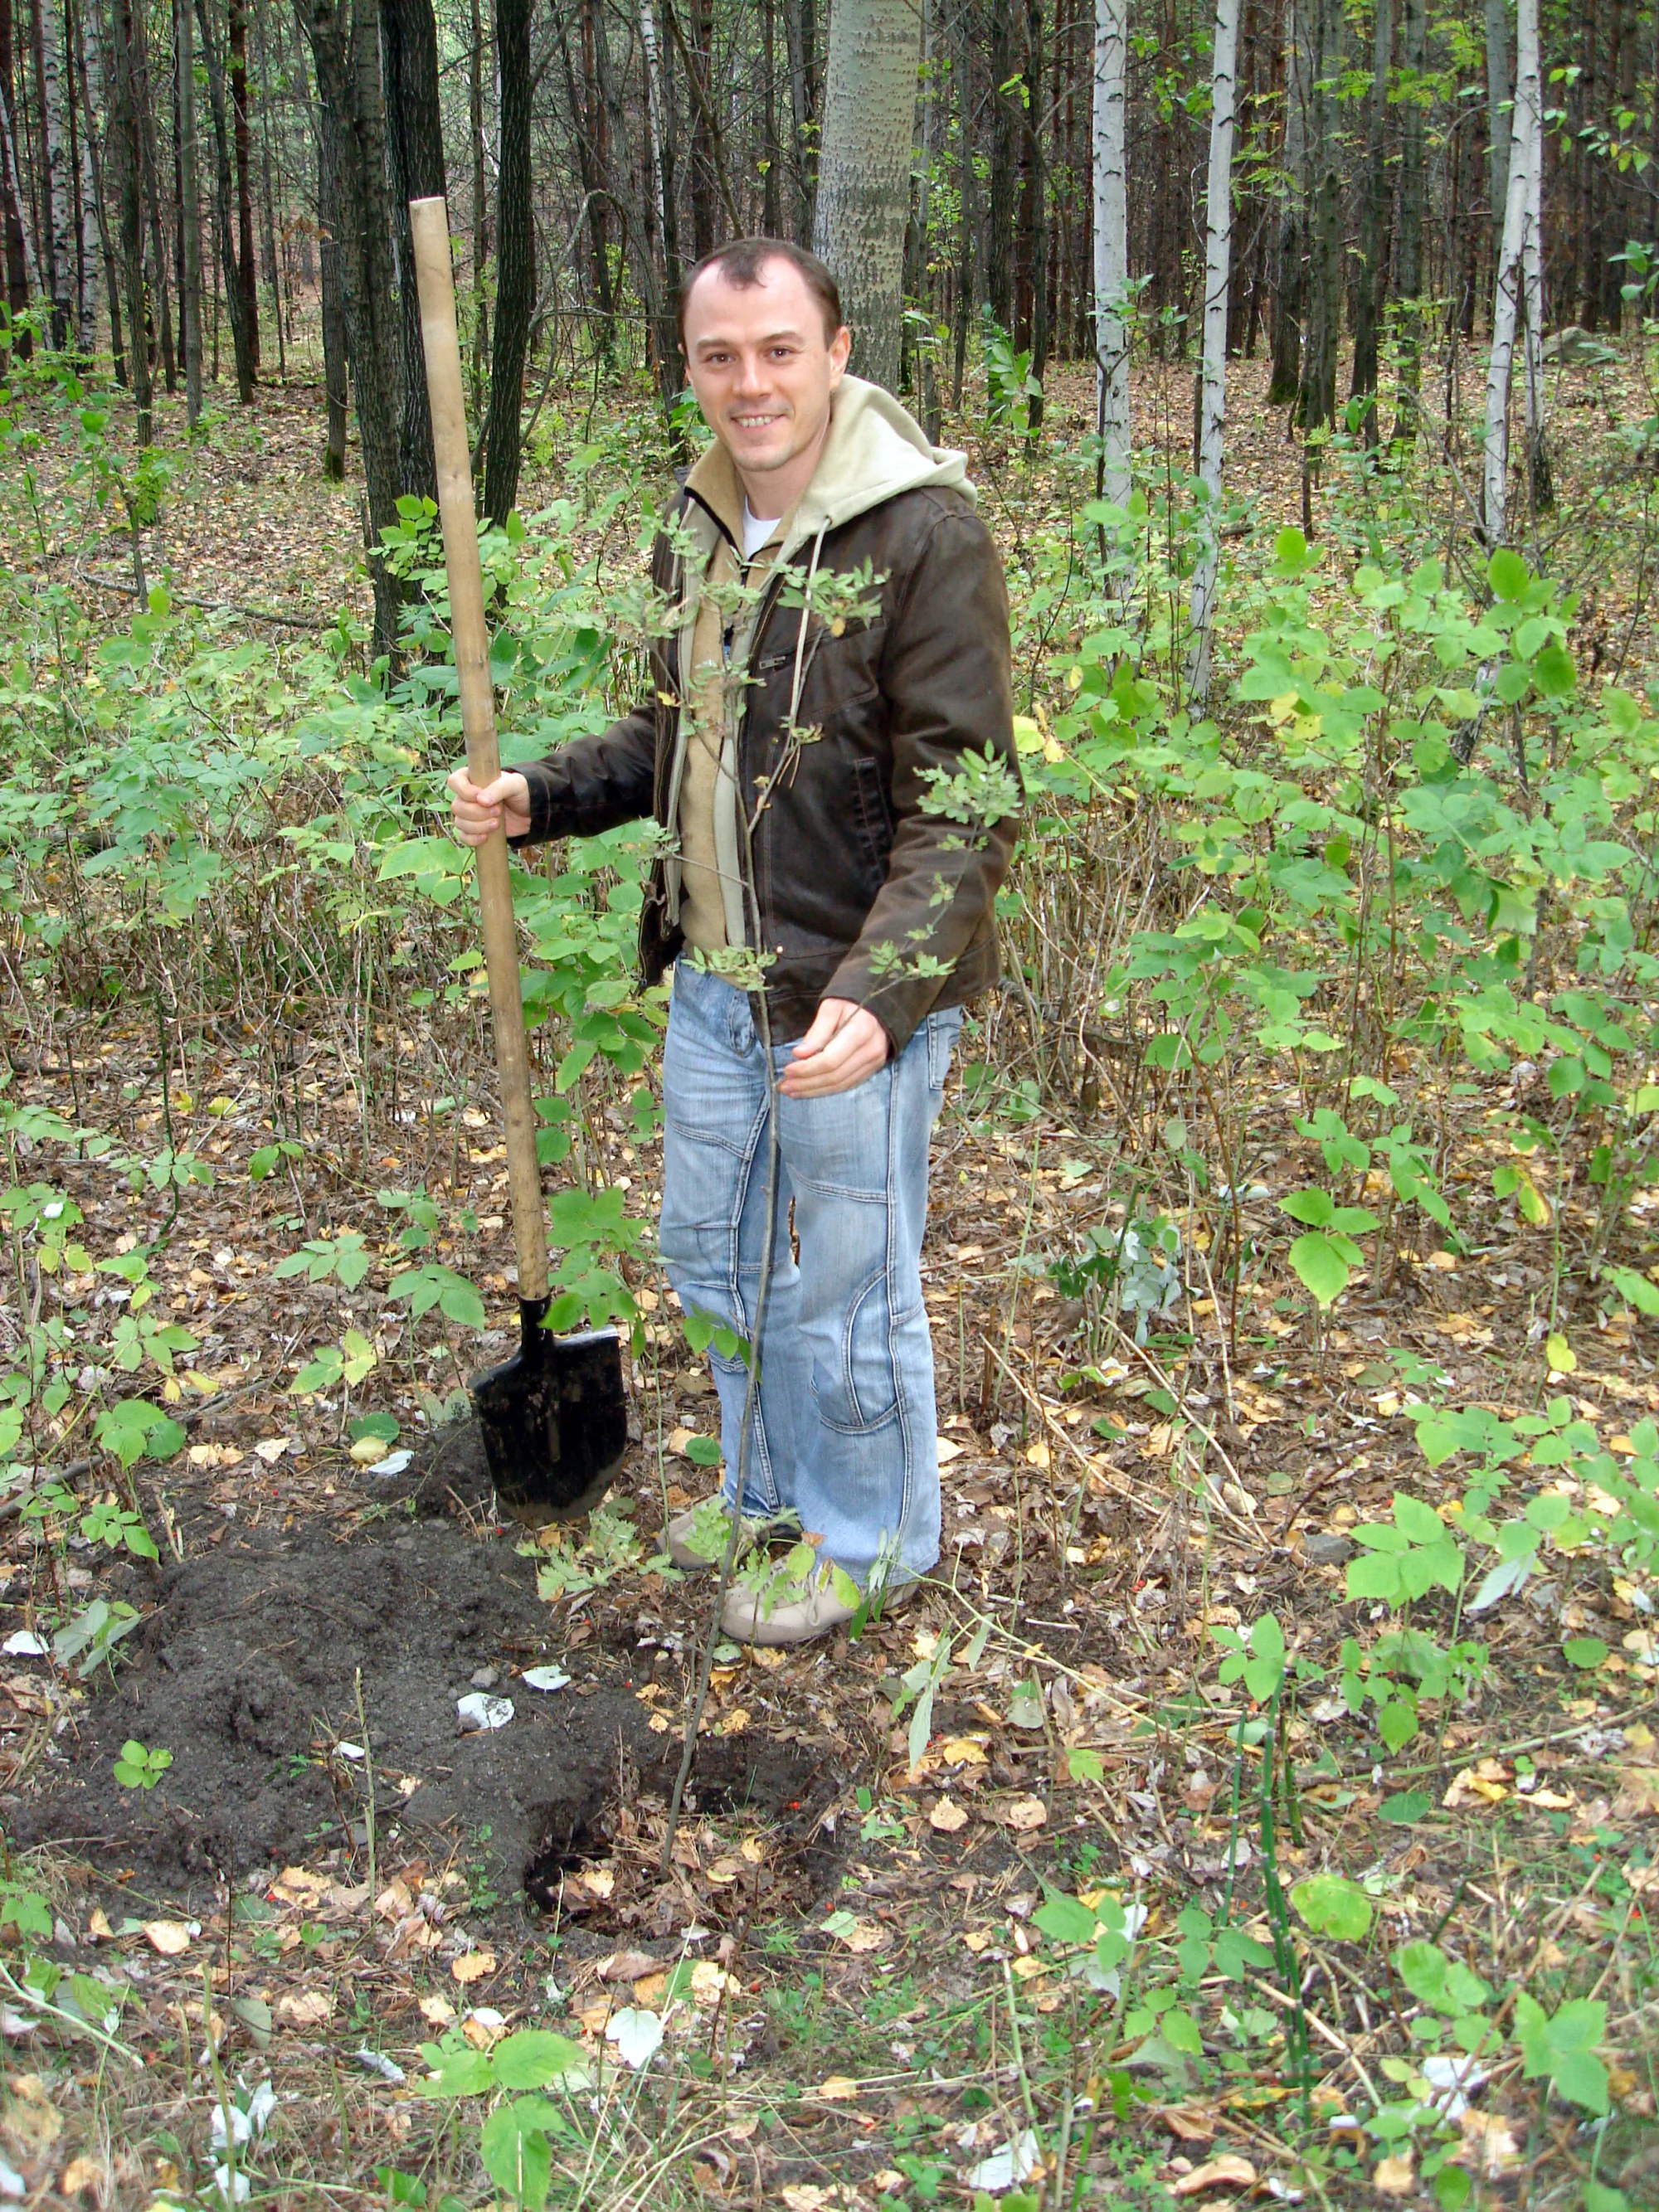
Согласно расхожей поговорке, настоящий мужчина должен посадить дерево, построить дом и вырастить сына. В этом году я начал претворение этого плана в жизнь. Итак, с предыдущего дня рождения я успел следующее:
- побывал на Мёртвом море, в Минске (Белоруссия), Иерусалиме (Израиль), Вифлееме (Палестина),
Шарм-эль-Шейхе (Египет), Акабе и Петре (Иордания),Караби-яйла и Симферополе (Крым), а так же в Екатеринбурге и Булгаре - научился программировать на PowerShell
- попробовал новый для себя спорт — бег на 10км и спелеологию
- спустился в восемь пещер, самая глубокая — 102 метра и в сьяновские каменоломни
- поднял 101,5 кг на штанге
- увидел в продаже свою книгу
- посетил Белоярскую АЭС
- водил настоящий самолёт, справил вторую годовщину свадьбы в воздухе
- купил квартиру и посадил дерево (рябину)
- пережил это лето с его пожарами и беспрецедентной жарой
- прочитал 84 книги
Спасибо заранее за поздравления!
PHP и UTF-8: четвёртый этап
В прошлой части мы
Начнём с eval, его проще всего найти: К счастью, почти всё что я нашёл — это Теперь я попробую найти вообще все Не все Вот что у меня получилось: readline_callback_handler_install, readline_callback_read_char, ob_start, session_set_save_handler, CURLOPT_HEADERFUNCTION, CURLOPT_PASSWDFUNCTION, CURLOPT_PROGRESSFUNCTION, CURLOPT_READFUNCTION, CURLOPT_WRITEFUNCTION, FILTER_CALLBACK, iterator_apply, set_exception_handler, pcntl_signal, array_map, array_filter, array_walk, array_walk_recursive, array_udiff_uassoc, array_diff_uassoc, array_udiff_assoc, array_diff_ukey, array_udiff , array_intersect_ukey, array_uintersect_uassoc, array_uintersect_assoc, array_intersect_uassoc, array_intersect_assoc , array_uintersect, array_reduce, uksort, usort, uasort. Или для командной строки (регулярное выражение я тут подсократил): В выводе нужно высматривать только вызовы строковых функций и статических методов, которые стоят на месте Всё, что осталось найти — вызовы preg_replace с модификатором «e». Я, было, подумал Думаю, в следующей части надо Какие у нас есть варианты?
bolk@dev:~/daproject$ find -type f ( -name '*.php' -or -name '*.tpl' -or -name '*.inc' ) | xargs -n1 egrep -li 'bevals*('
./php/lib/magpierss/extlib/Snoopy.class.inc
./php/lib/PEAR.php
./php/dir1/file1.php
./php/dir1/file2.php
./php/dir1/file3.phpbolk@dev:~/daproject$ find -type f ( -name '*.php' -or -name '*.tpl' -or -name '*.inc' ) |
> xargs -n1 egrep -H 'array_map|array_filter|array_walk|…|uasort' | less
Пакетное скругление картинок v0.2
Новая версия пакетного скруглителя картинок. Из нового: короткие имена ключей (их видно после запуска), ключи для сохранения EXIF из оригинального файла
Микроцефал

Я люблю разглядывать инструкции для пассажиров из самолётов, там много смешного. Вот, например,
«Ты слишком правильный»
Я об этом уже говорил, ну да ладно, ещё скажу. Фраза «ты слишком правильный» по бессмысленности стоит
Человек произносящий «ты слишком правильный» как бы подразумевает, что оппонент живёт по правилам, тогда как он сам их нарушает, бунтует, чем выгодно отличается от.
Последнее для меня совершенно сомнительно, а первое попросту смешно. Все люди, которые
Пакетное скругление картинок v0̶.̶2̶.̶1 0.2.2
Ребята, качайте новую версию, я сделал antialiasing для углов. Ну и пришлось же помучиться! Я немного заболел, пока сидел дома, сделал.
Основная идея такова — рисуется красный круг на чёрном фоне, на него накладывается фильтр Гаусса (тут меня ждала засада — в PHP 4.4.4, который у меня, нет функций imagefilter и imageconvolution, зато последняя, написанная на чистом PHP есть в интернeтах).
Далее, я считаю красную компоненту круга
Получилось, на мой взгляд, очень неплохо, но скорость обработки, конечно, снизилась.
Добавлено позже: обновил до 0.2.2 — теперь вся работа с временными файлами делается внутри временной папки (путь до неё берётся из переменных окружения).
QR-код в ASCII
 ▄▄▄▄▄▄▄  ▄▄ ▄▄    ▄▄▄▄▄▄▄
 █ ▄▄▄ █    ▄▄▄▀ ▄ █ ▄▄▄ █
 █ ███ █ ▀▄▀▄▀ ▄ ▀ █ ███ █
 █▄▄▄▄▄█ █▀█▀▄▀█ ▄ █▄▄▄▄▄█
  ▄▄   ▄ ▀██▀██ ▀█ ▄▄ ▄
 ▄▄█▀ █▄▀█▀▀▀▀▄▄█  ▀▀ █▄▀█
 ▄███ ▀▄ ▀  ▄ ▄█▄█ ▄█▀▀  ▄
 ▀ ▀▄▀▄▄▀▄▄▄█▄ ▀██▄▀█ ▄▄▀█
 ▀▀▄▄▄▀▄ ▀▀█ █▄▀▄███▄▄  ▄
 ▄▄▄▄▄▄▄ ▀▄▄▀▄▄ ▀█ ▄ █▄▀ █
 █ ▄▄▄ █  ▄█▀█ ███▄▄▄█▄ ▄█
 █ ███ █ ▄██▀▀▄▀▀▀█  █▀▀█▄
 █▄▄▄▄▄█ ▀ ▀ ███ ██▀▀▀▄  ▄
Интересная штука —
IE9 beta
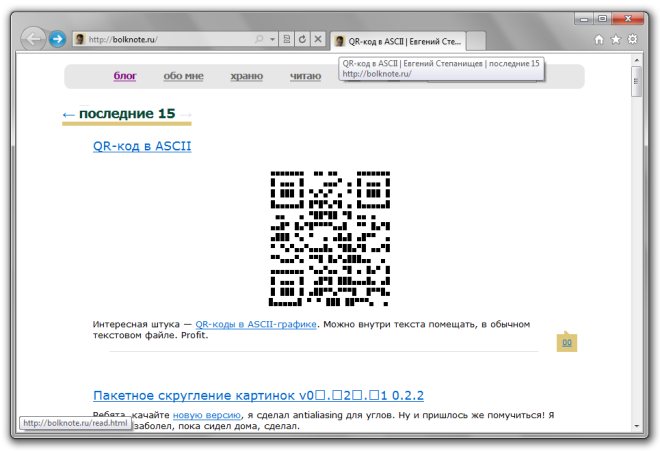
Вышла первая
Сайты открываются через
Тьфу.
Белоярская АЭС
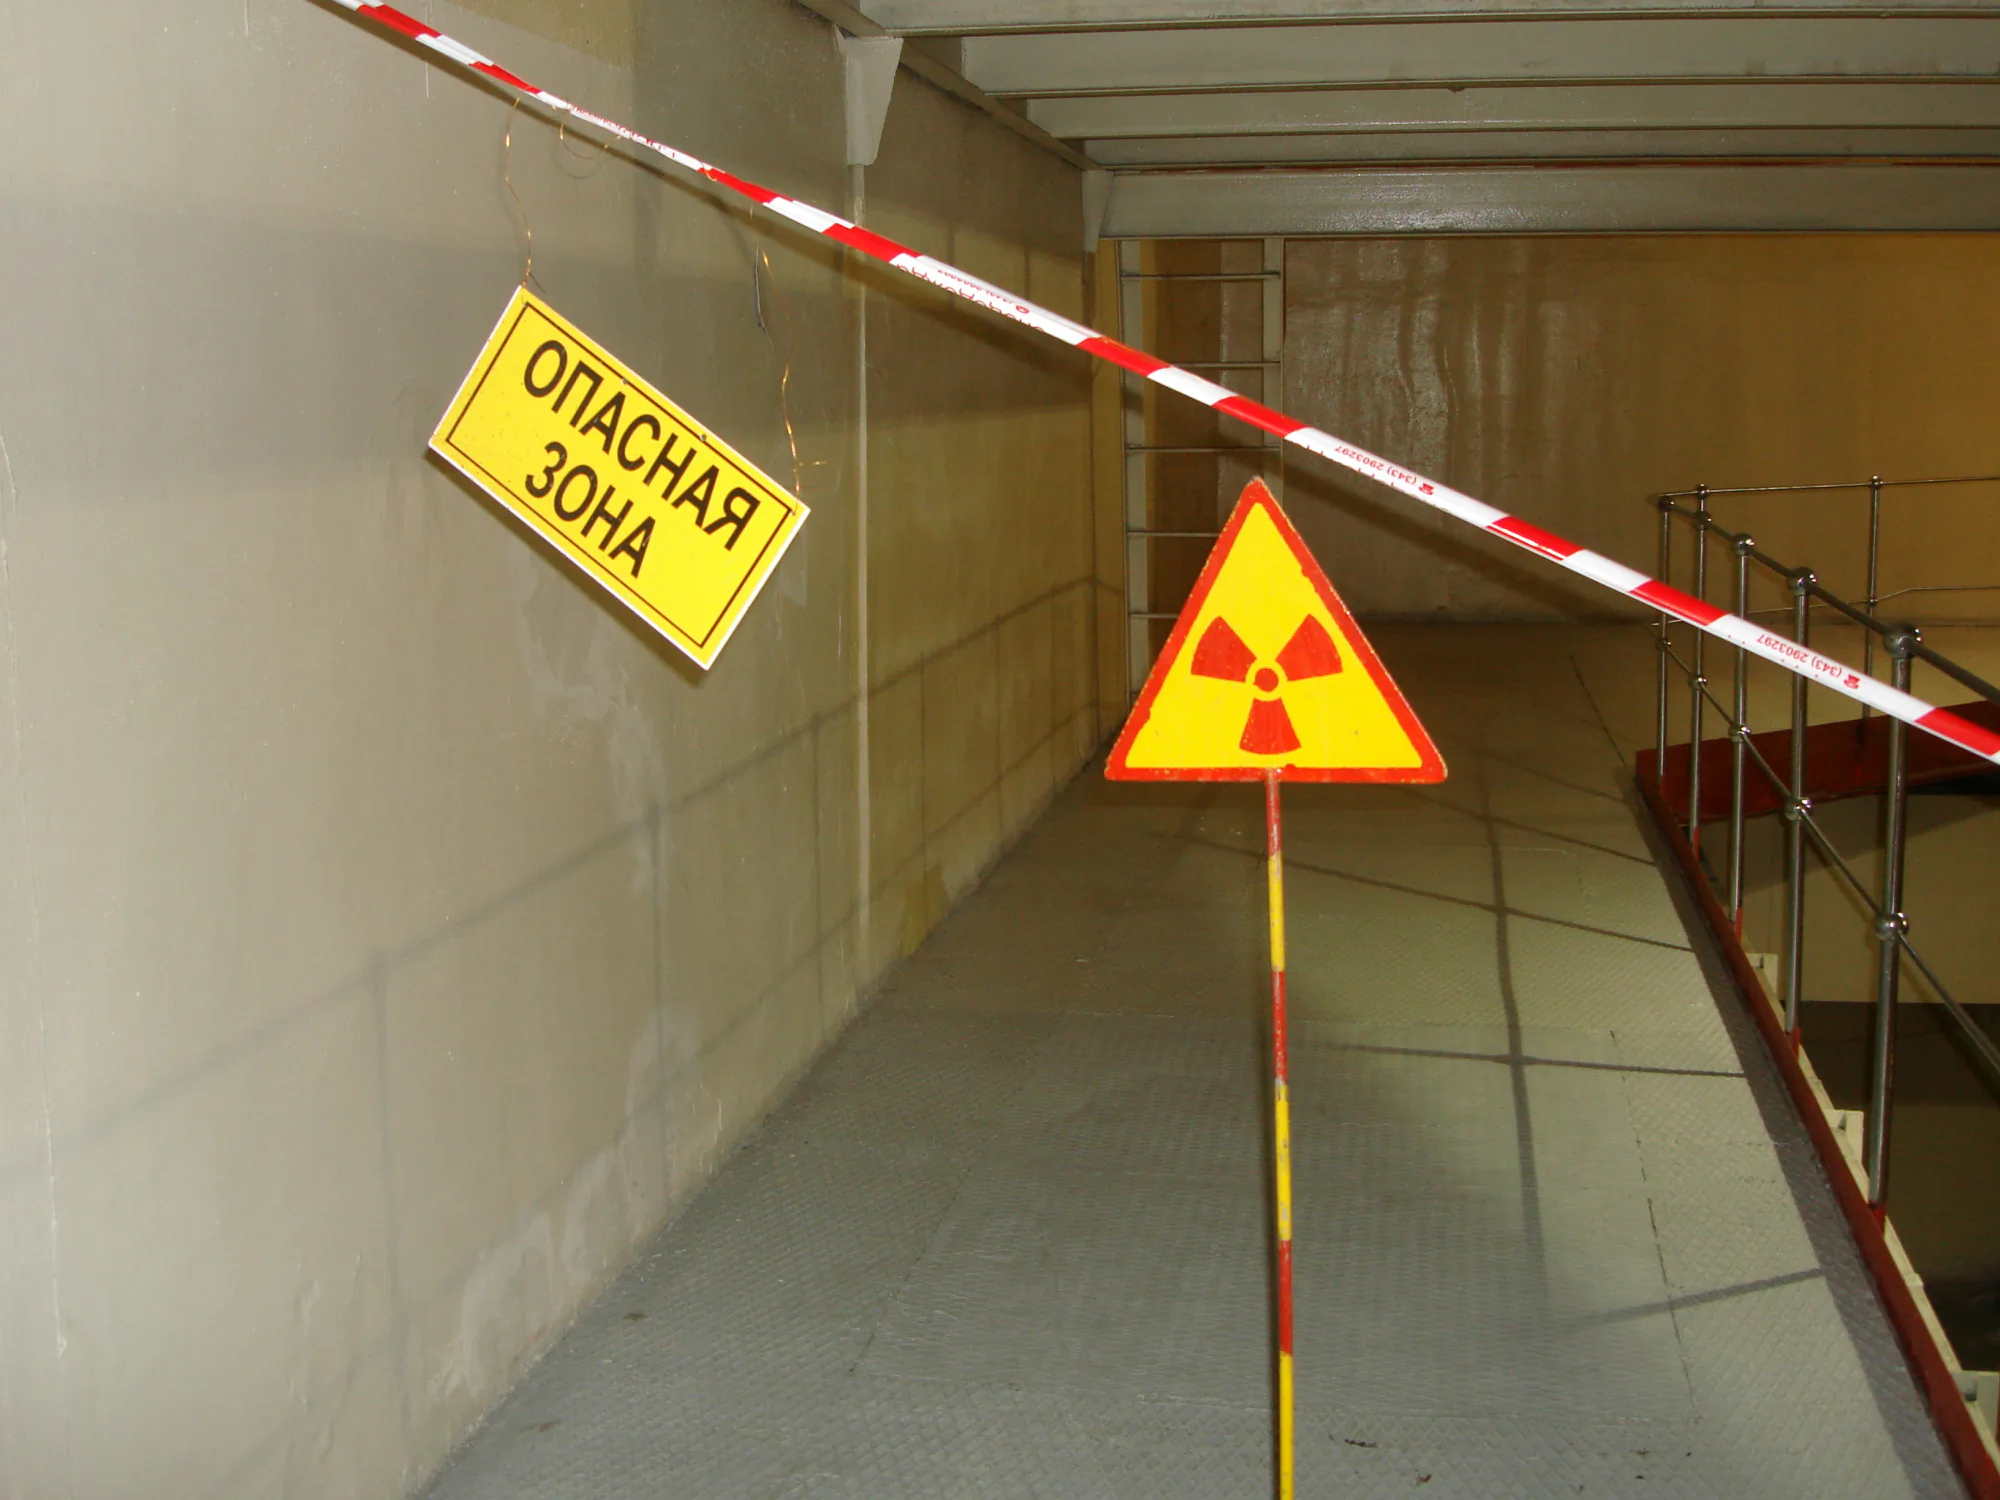
Есть такое направление — технотуризм, это посещение всевозможных закрытых учреждений и объектов. Мне давно хотелось посетить настоящую атомную электростанцию и вот, в прошлые выходные, мы с женой съездили на Белоярскую АЭС (находится в городе Заречный Свердловской области).
АЭС — закрытый объект, попасть туда простому смертному (а тем более посмотреть на реактор) крайне тяжело, сейчас очень удачный момент — «Росатом» заинтересован в пиаре отрасли и под эгидой популяризации блоггерам разрешается участвовать в довольно редких (несколько раз в год) экскурсиях.
Спасибо огромное агентству «Редкая марка» и  Бутяковой персонально за организованную экскурсию. Если лично.
На территории предприятия действует строгий пропускной режим, до реактора нужно пройти несколько охраняемых пропускных, всё достаточно строго, фотографировать можно только дозволенное,
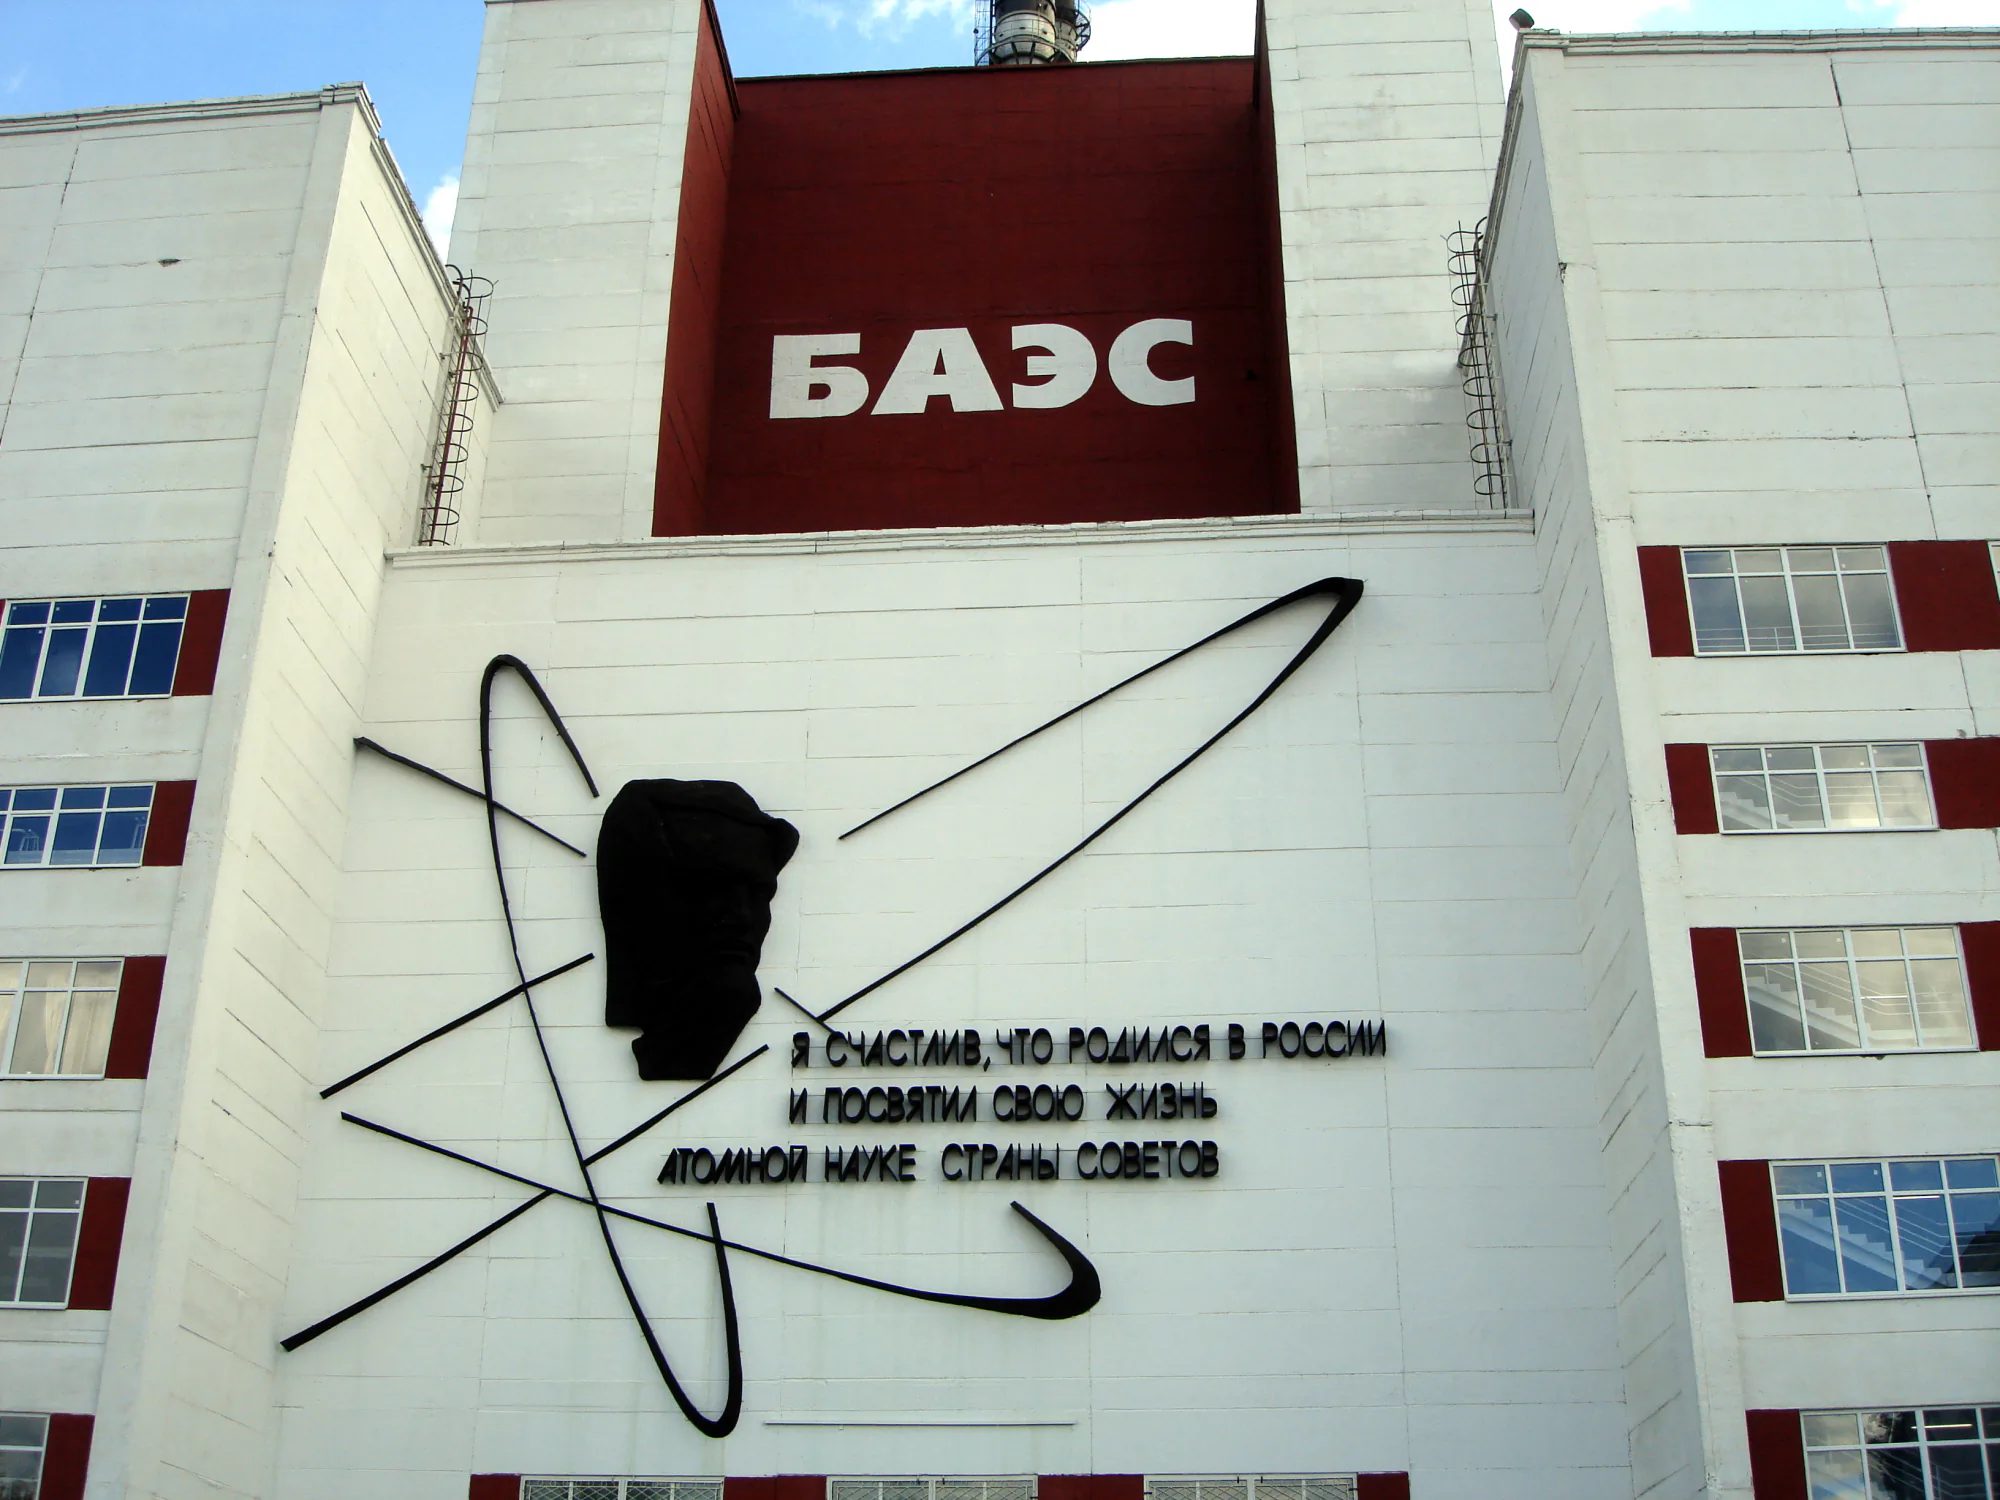
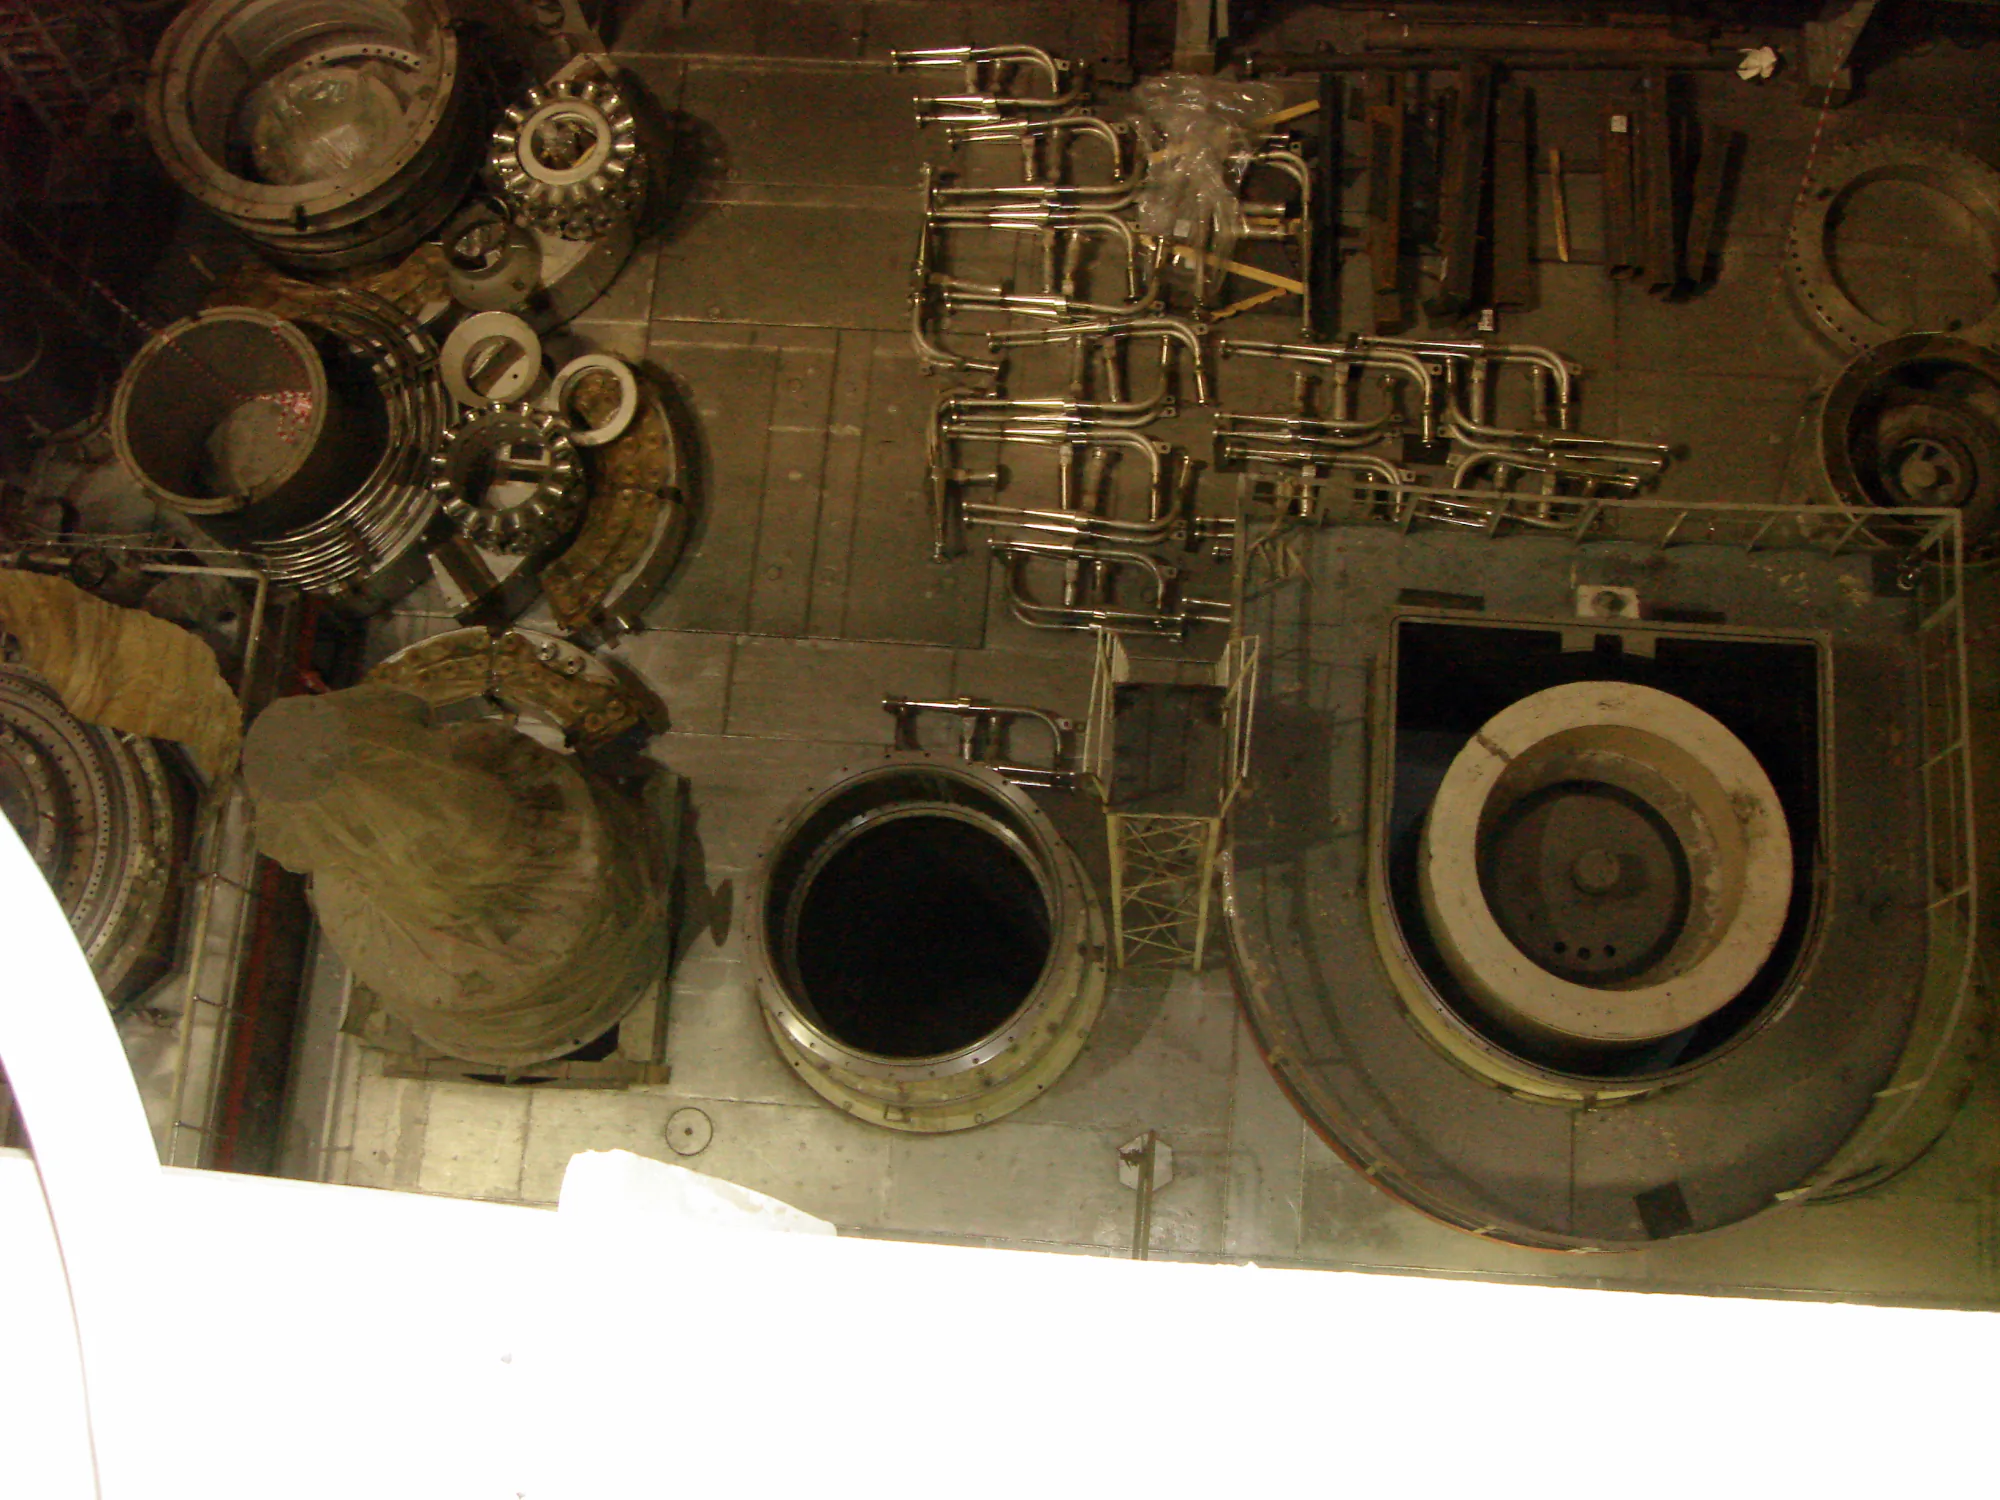
Белоярская АЭС уникальна тем, что на её территории действует единственный в мире реактор на быстрых нейтронах
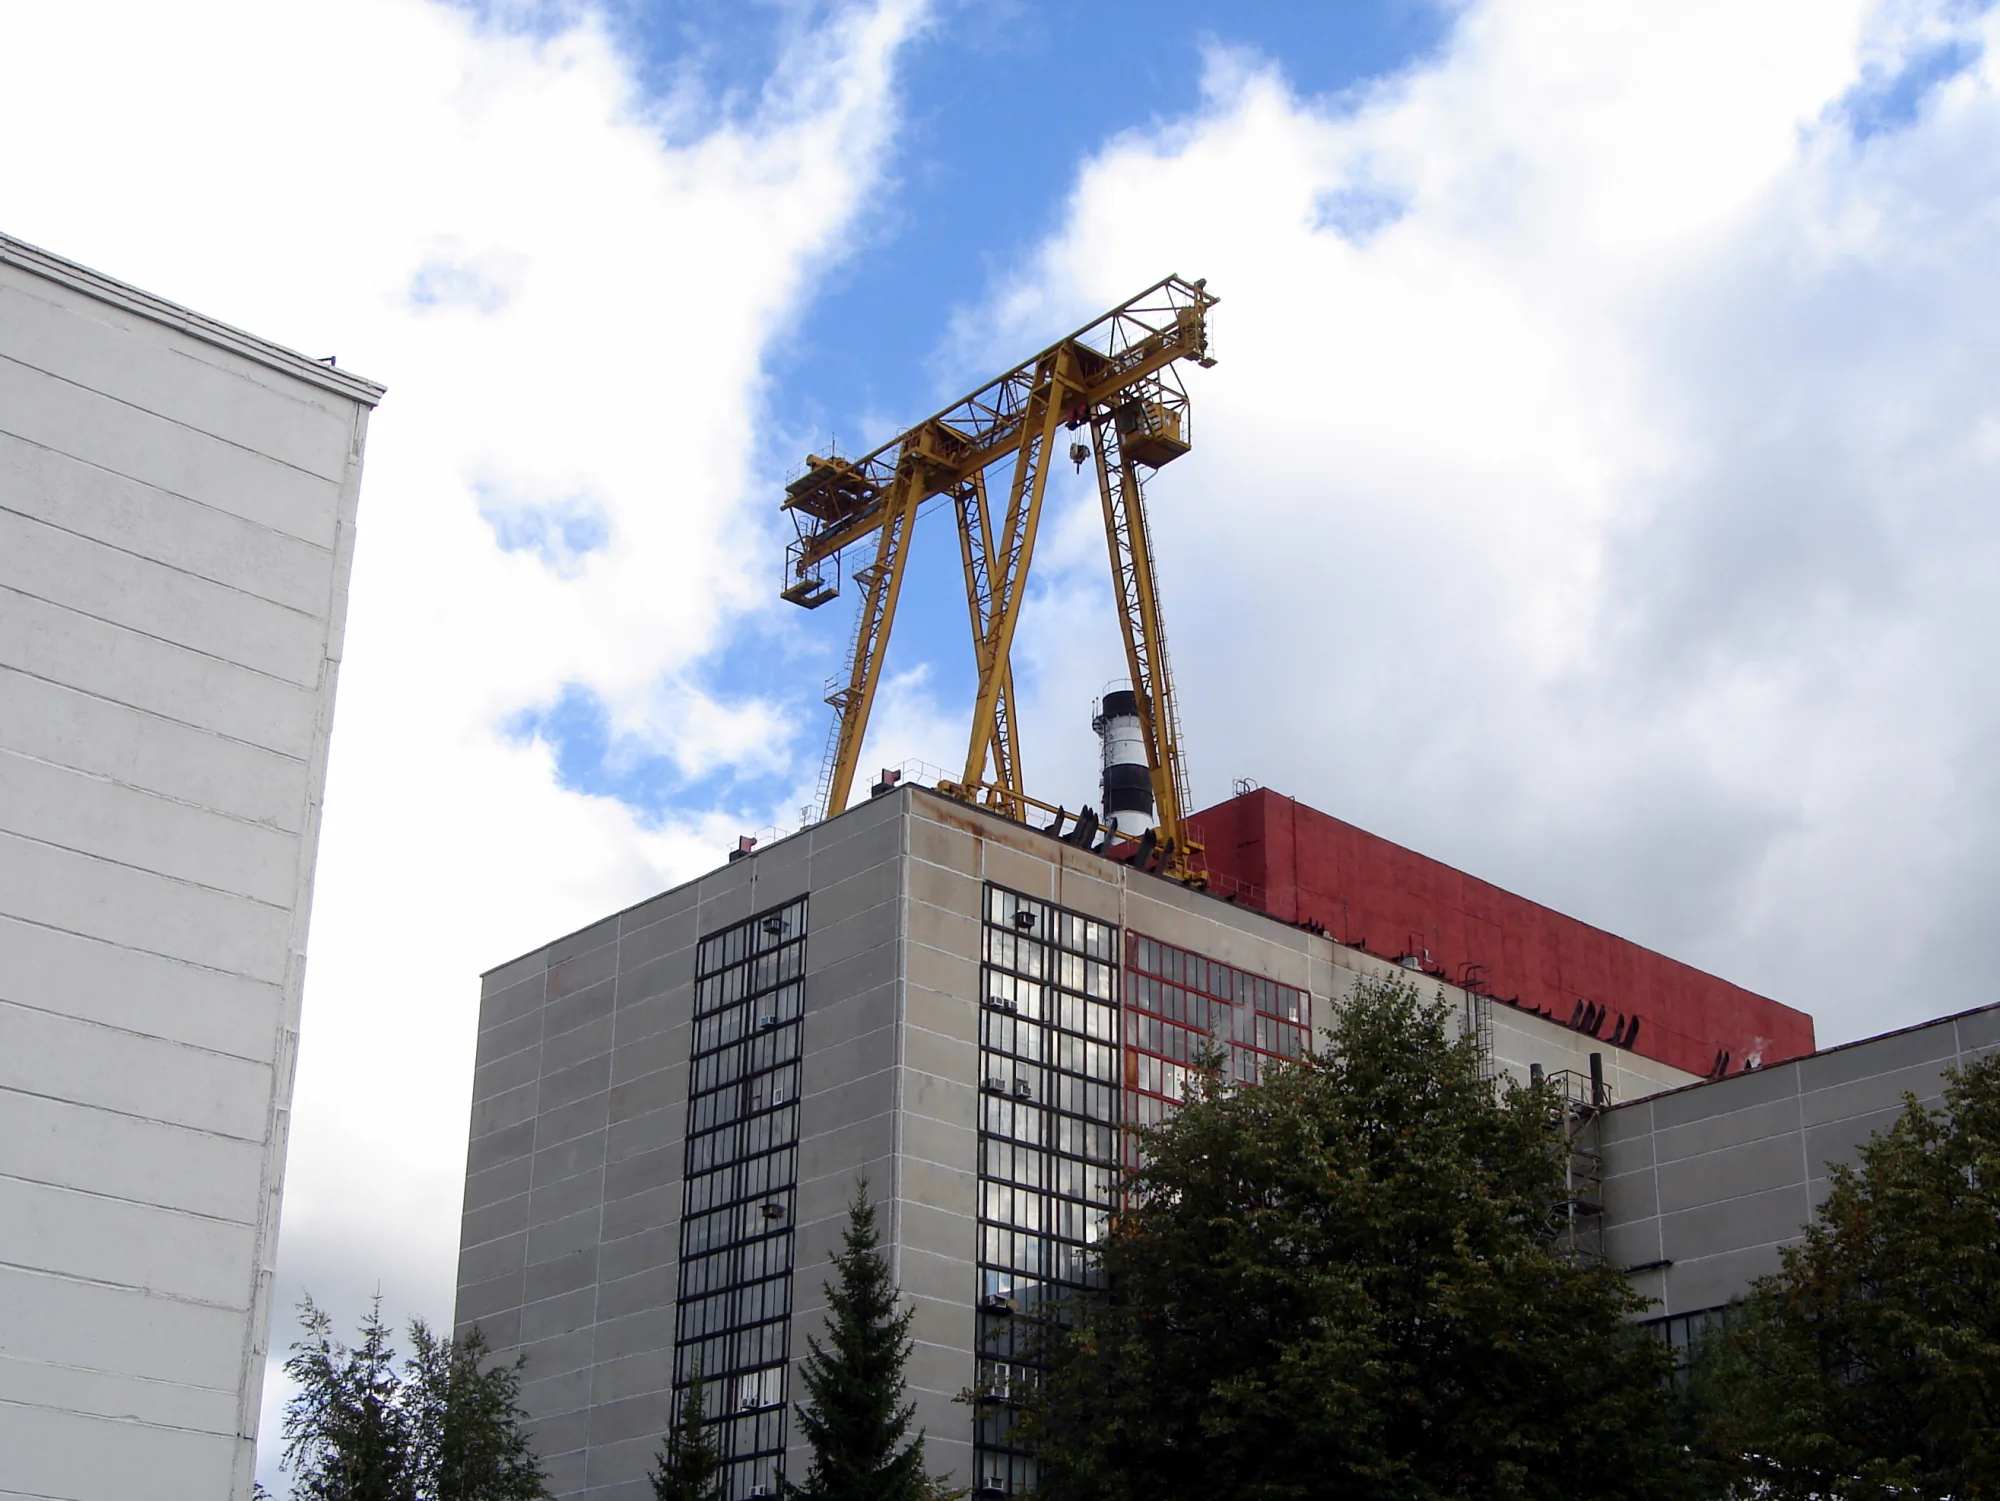
Мало кому удалось приблизиться к этому достижению, да что там, мало кому удалось ввести в эксплуатацию реакторы подобного типа, это при том, что никаких секретов в его устройстве нет, иностранцы часто приезжают на станцию перенимать опыт.
Дело не только в очень удачных инженерных решениях, но и в применённых материалах. Можно только гордиться промышленностью СССР, но вот такого же доверия к промышленности России у меня нет. Сейчас на территории АЭС возводится энергоблок
Что такое атомная электростанция изнутри? Моё воображение рисовало, довольно туманно, огромный реактор, вокруг куча обслуживающего персонала… На деле атомная электростанция — это трубы. Трубы, трубы, трубы, трубы и очень мало людей.
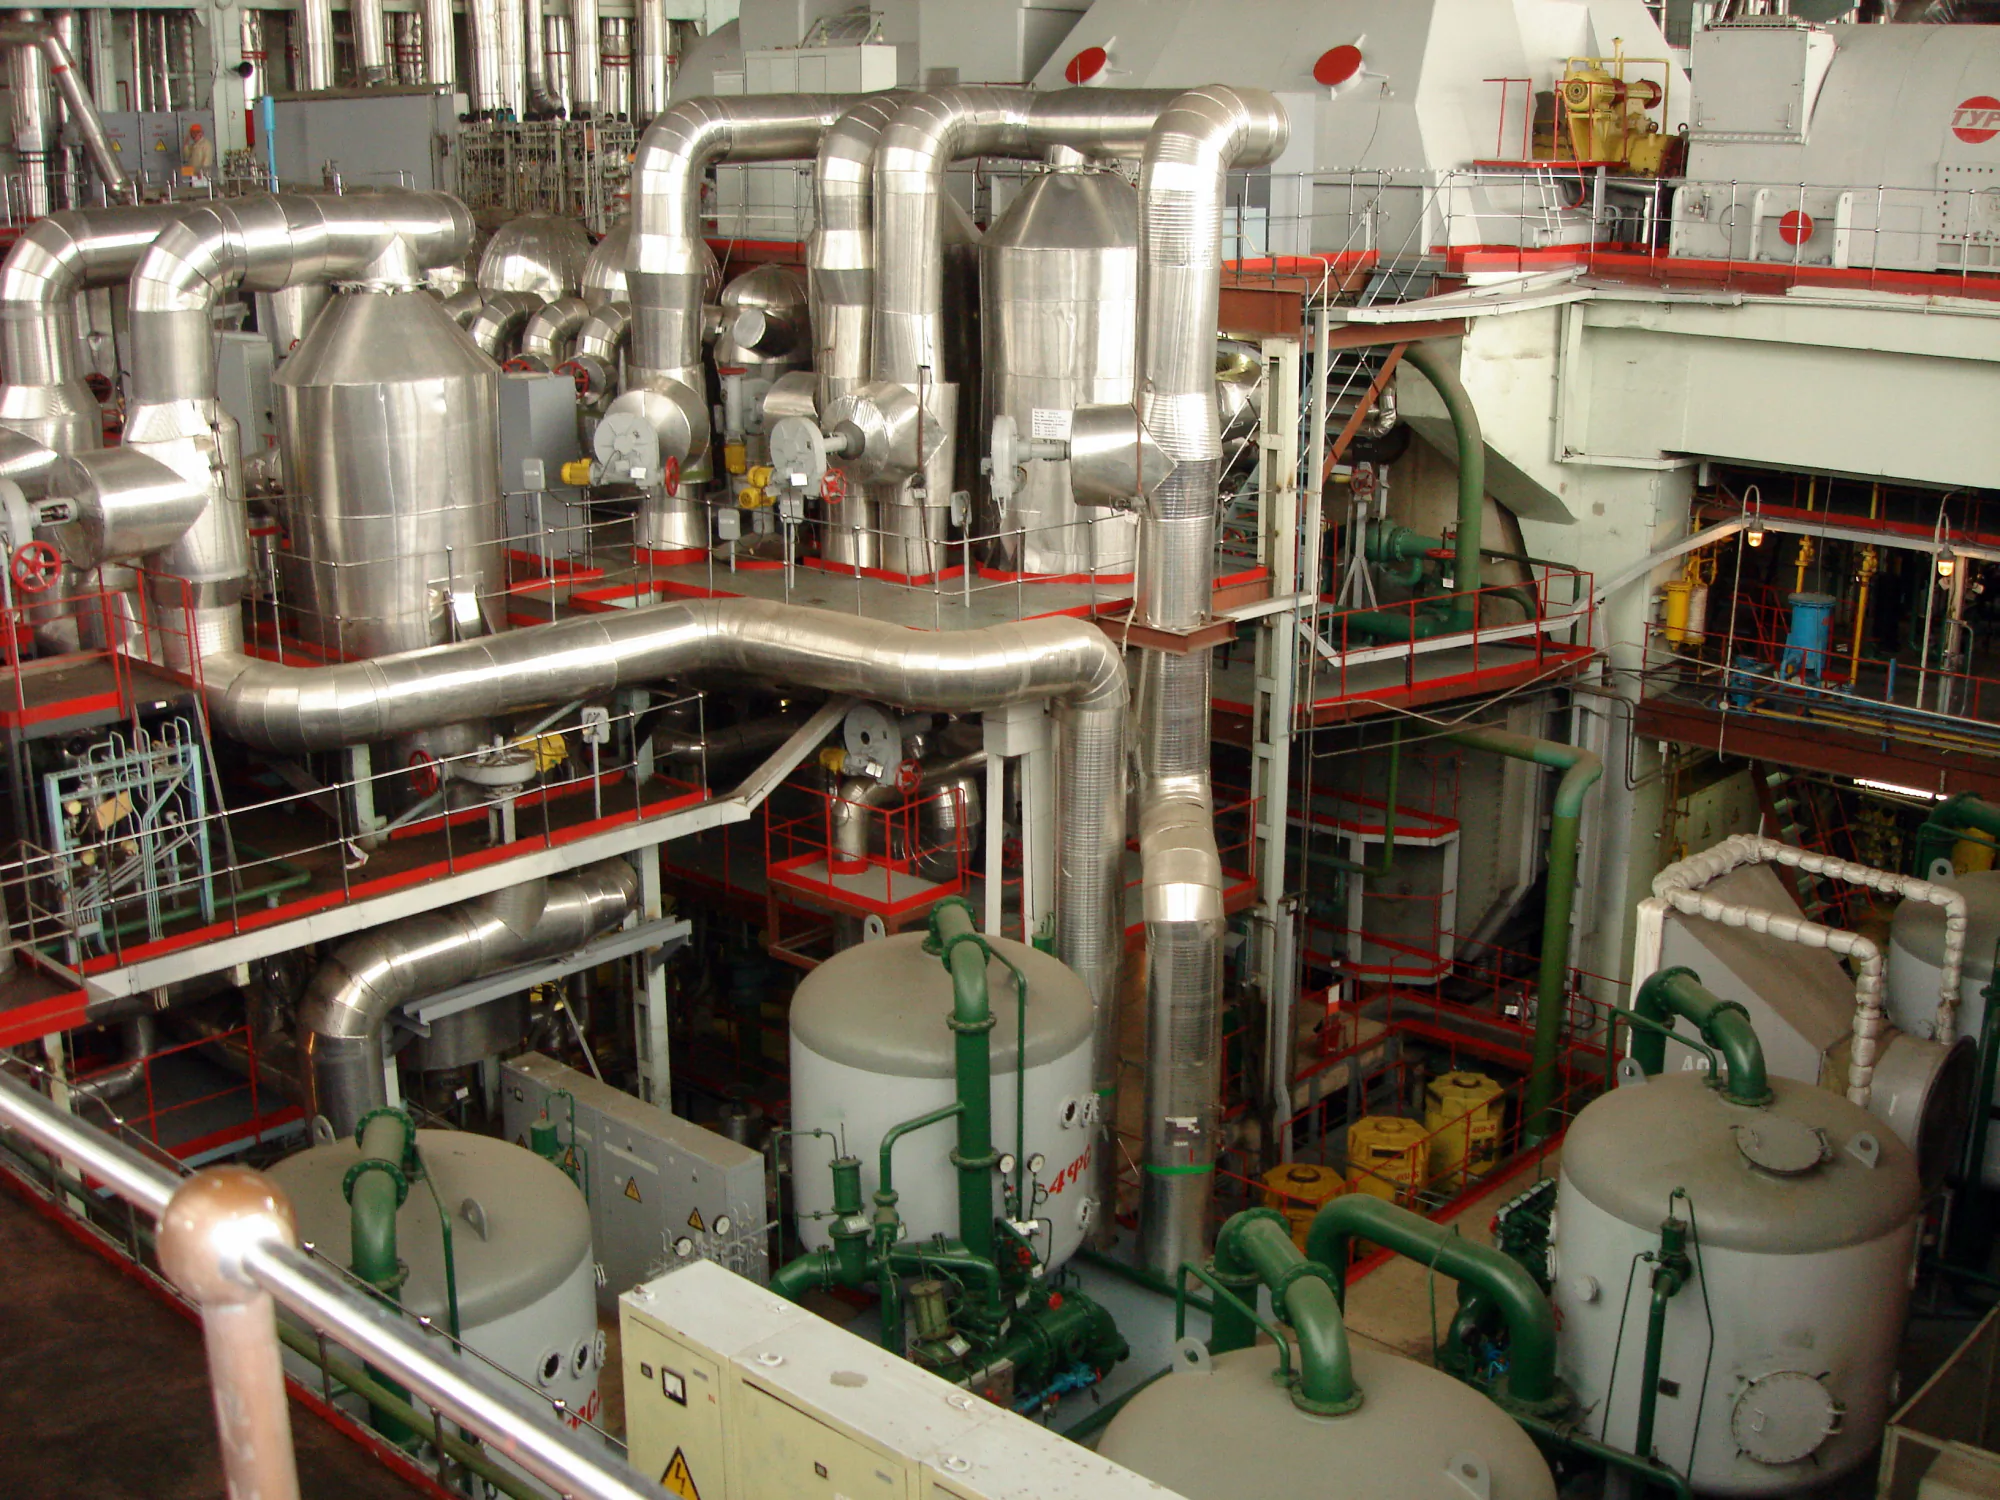
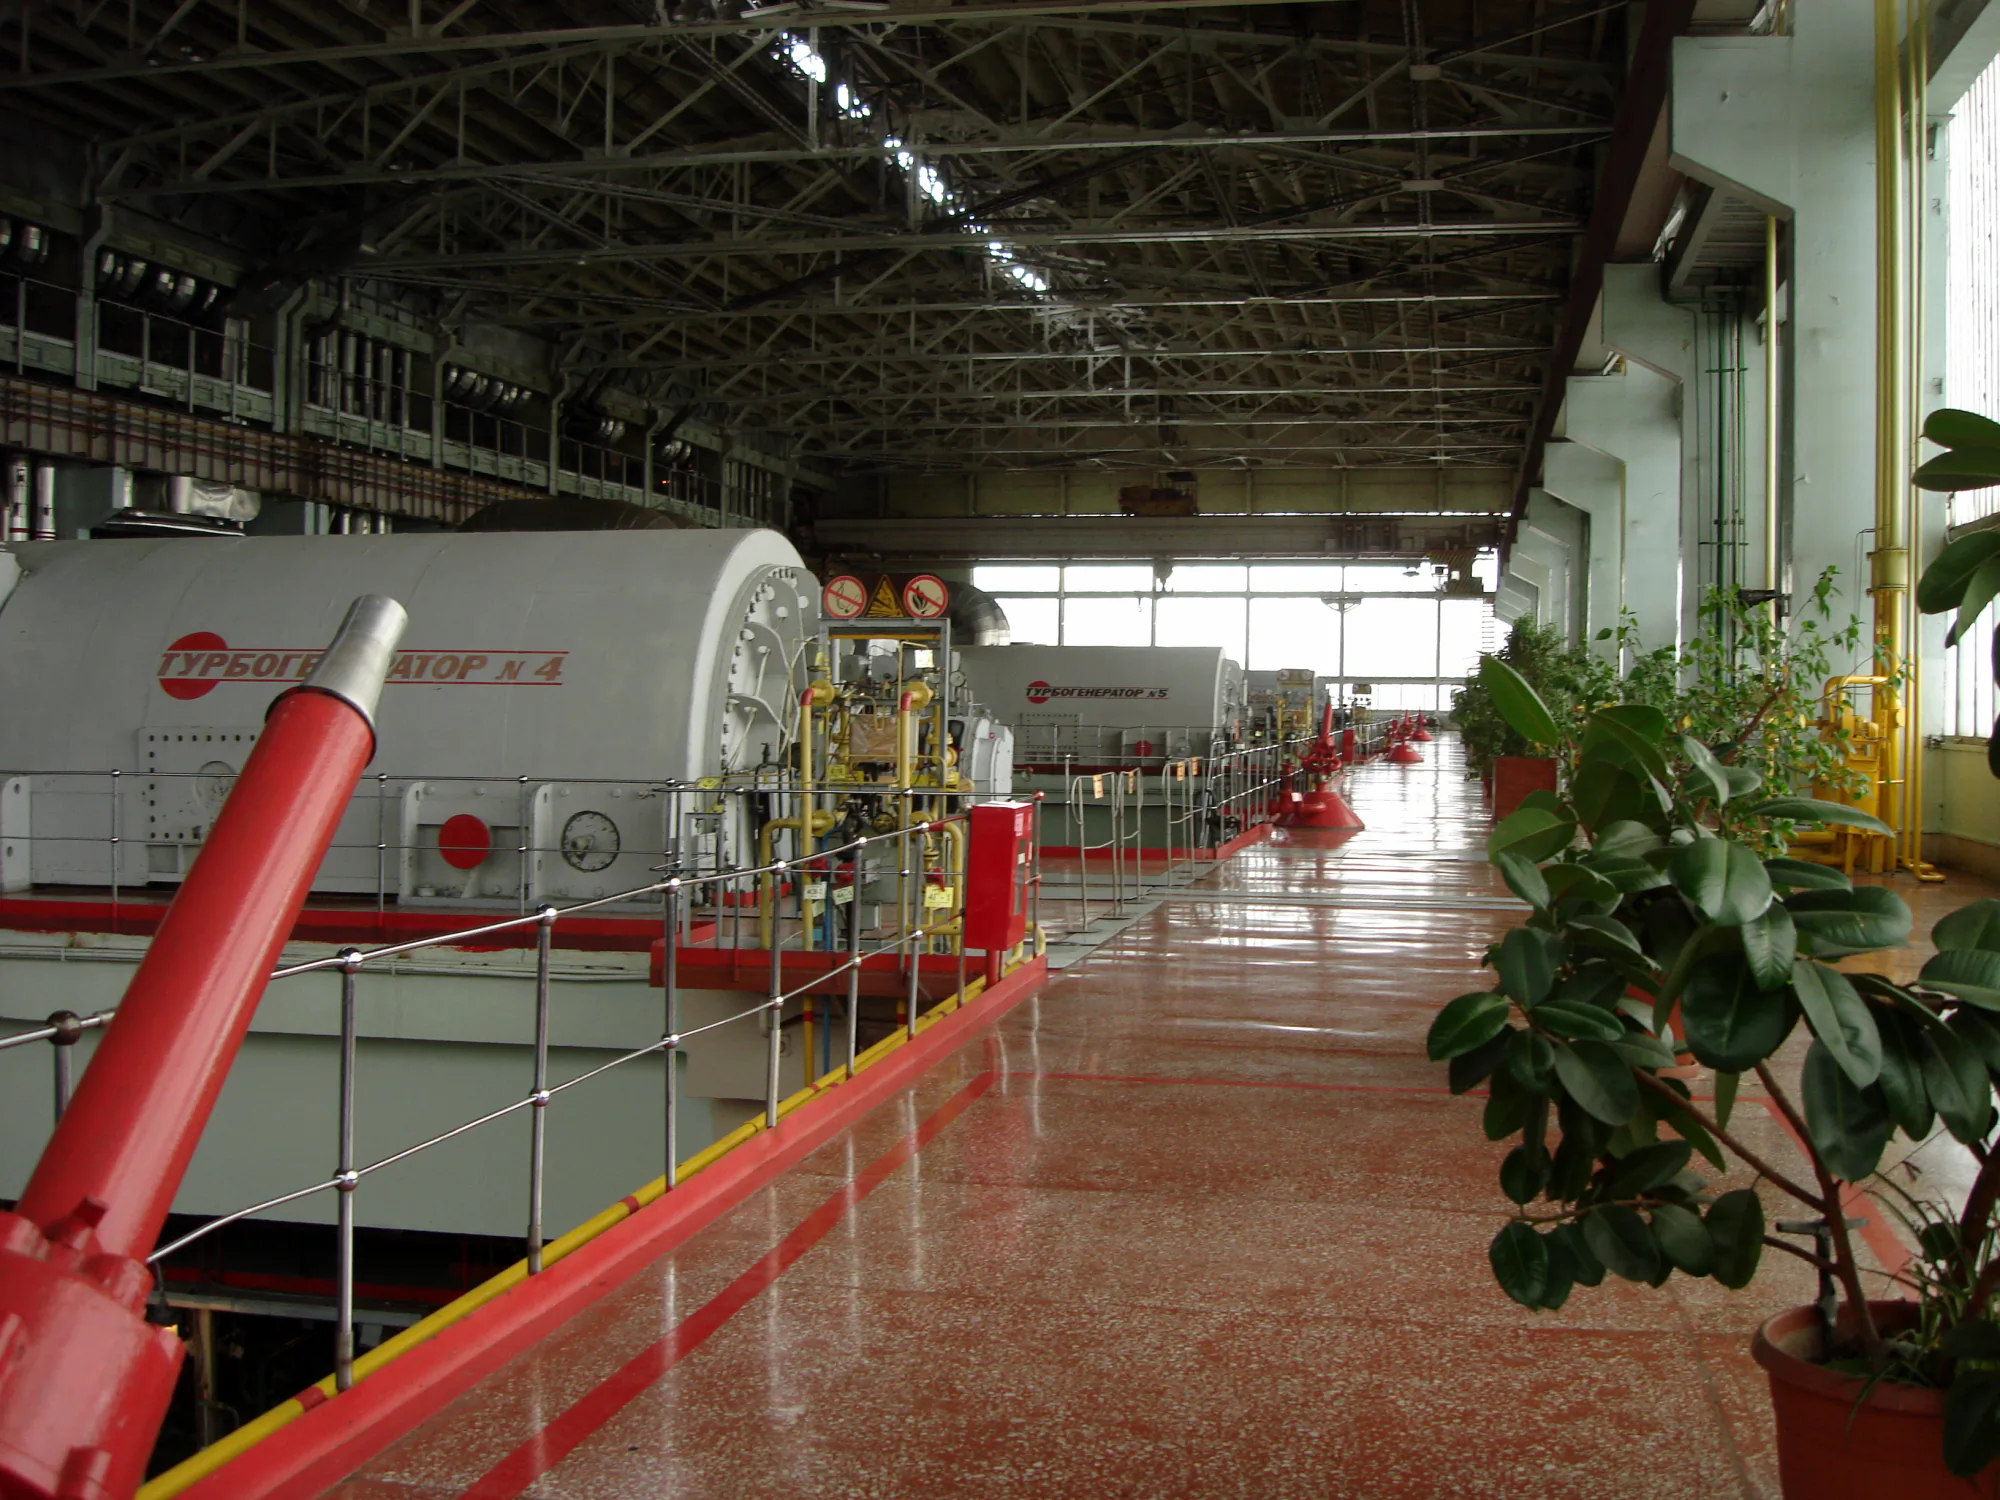
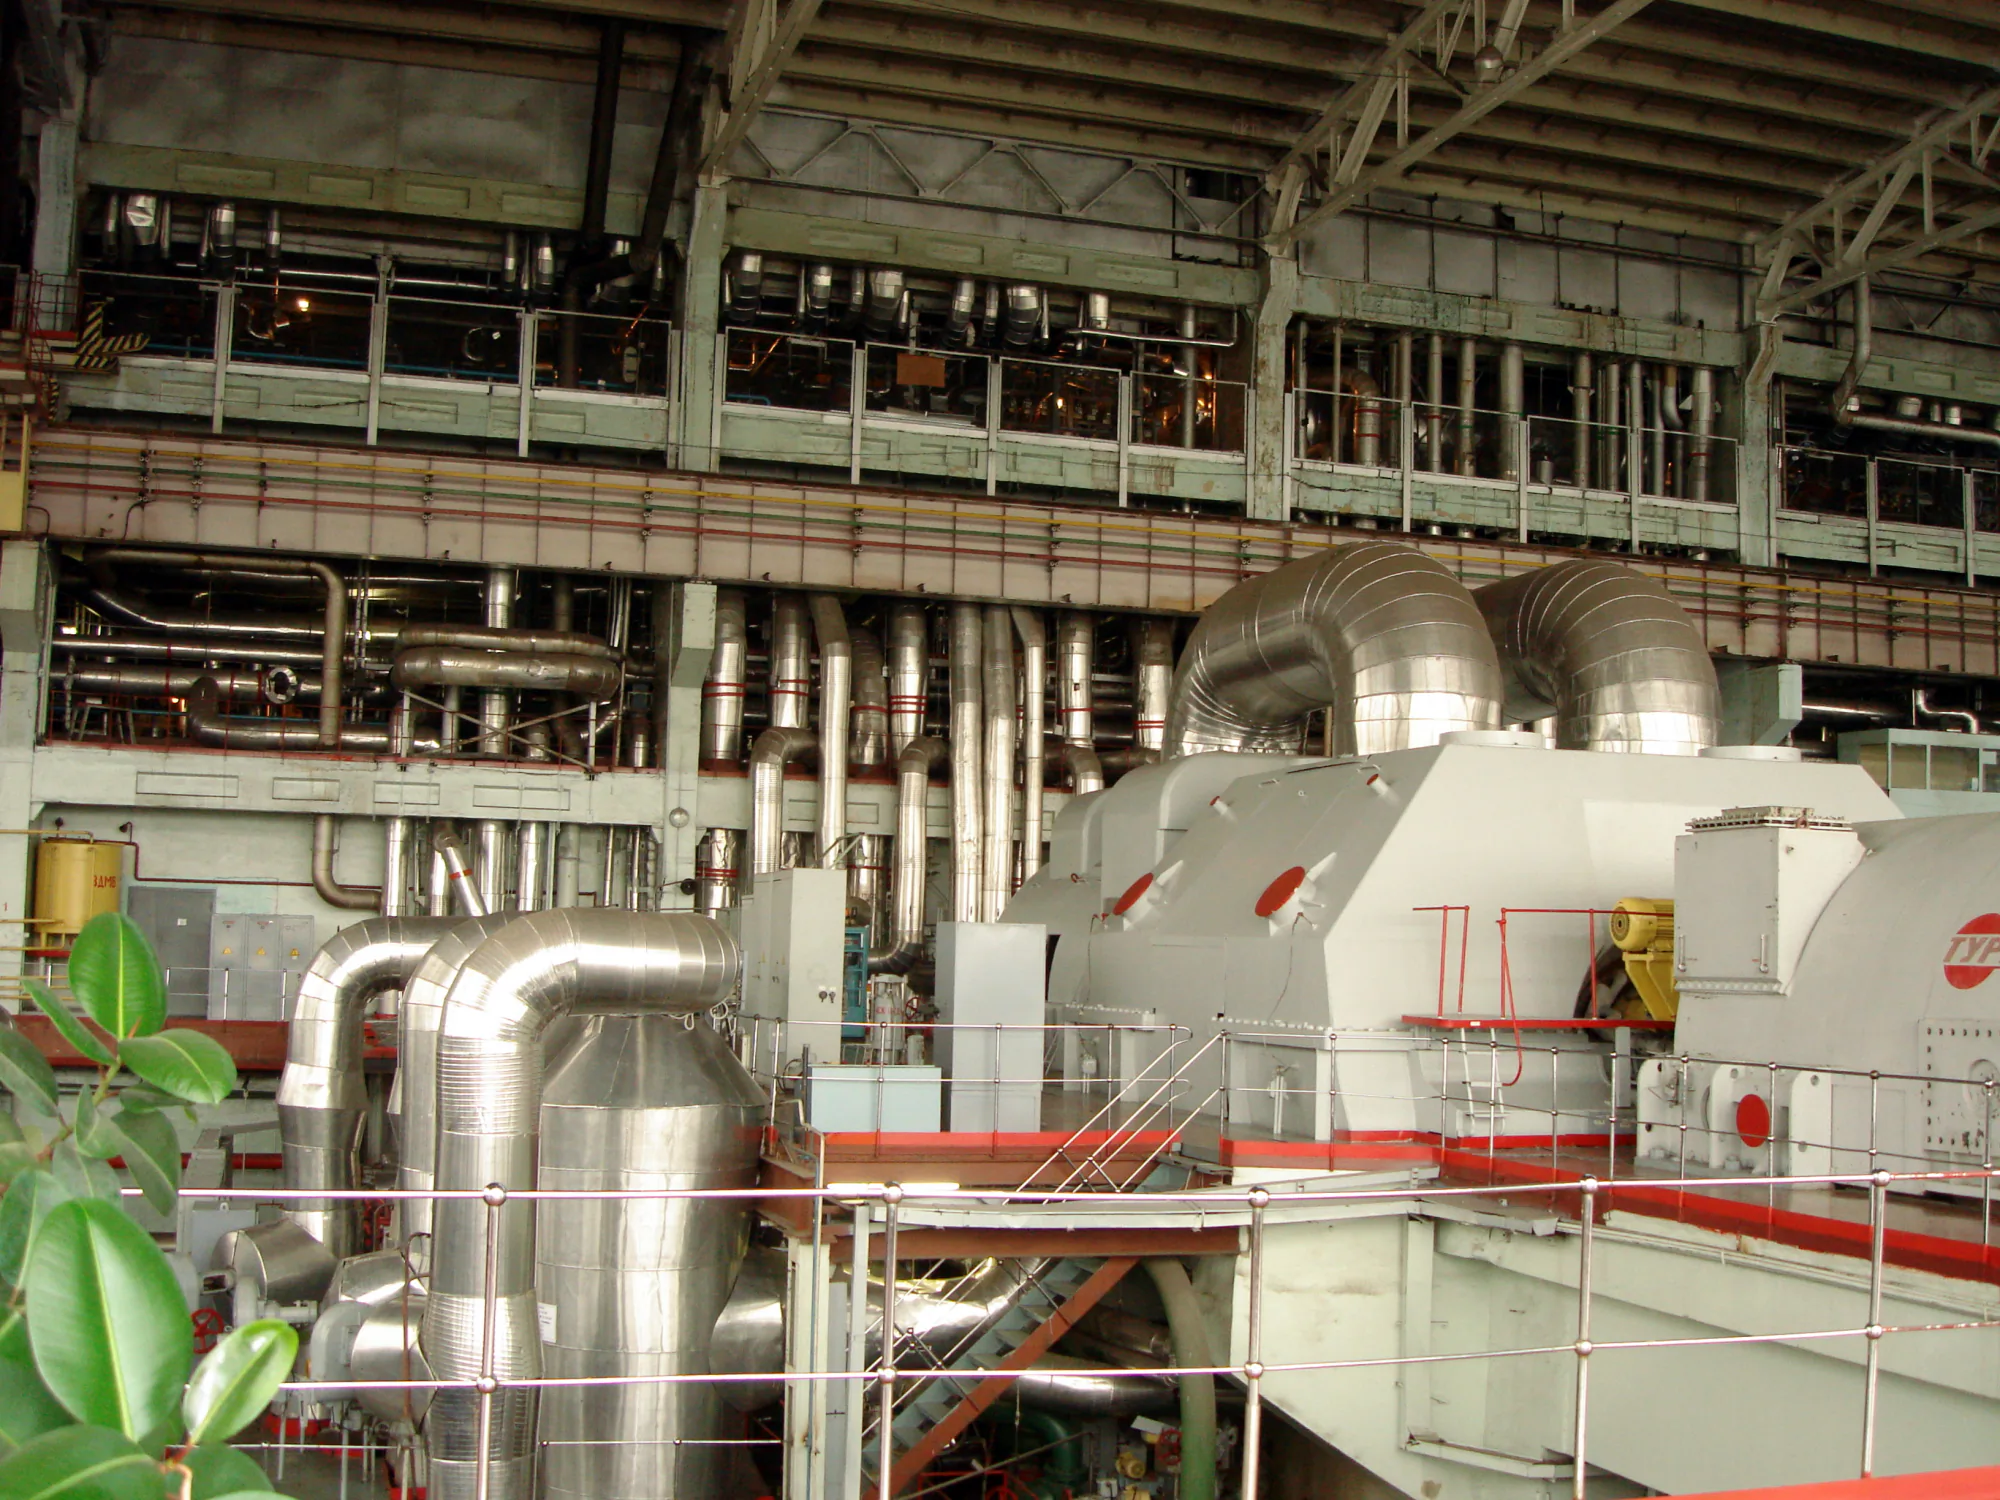
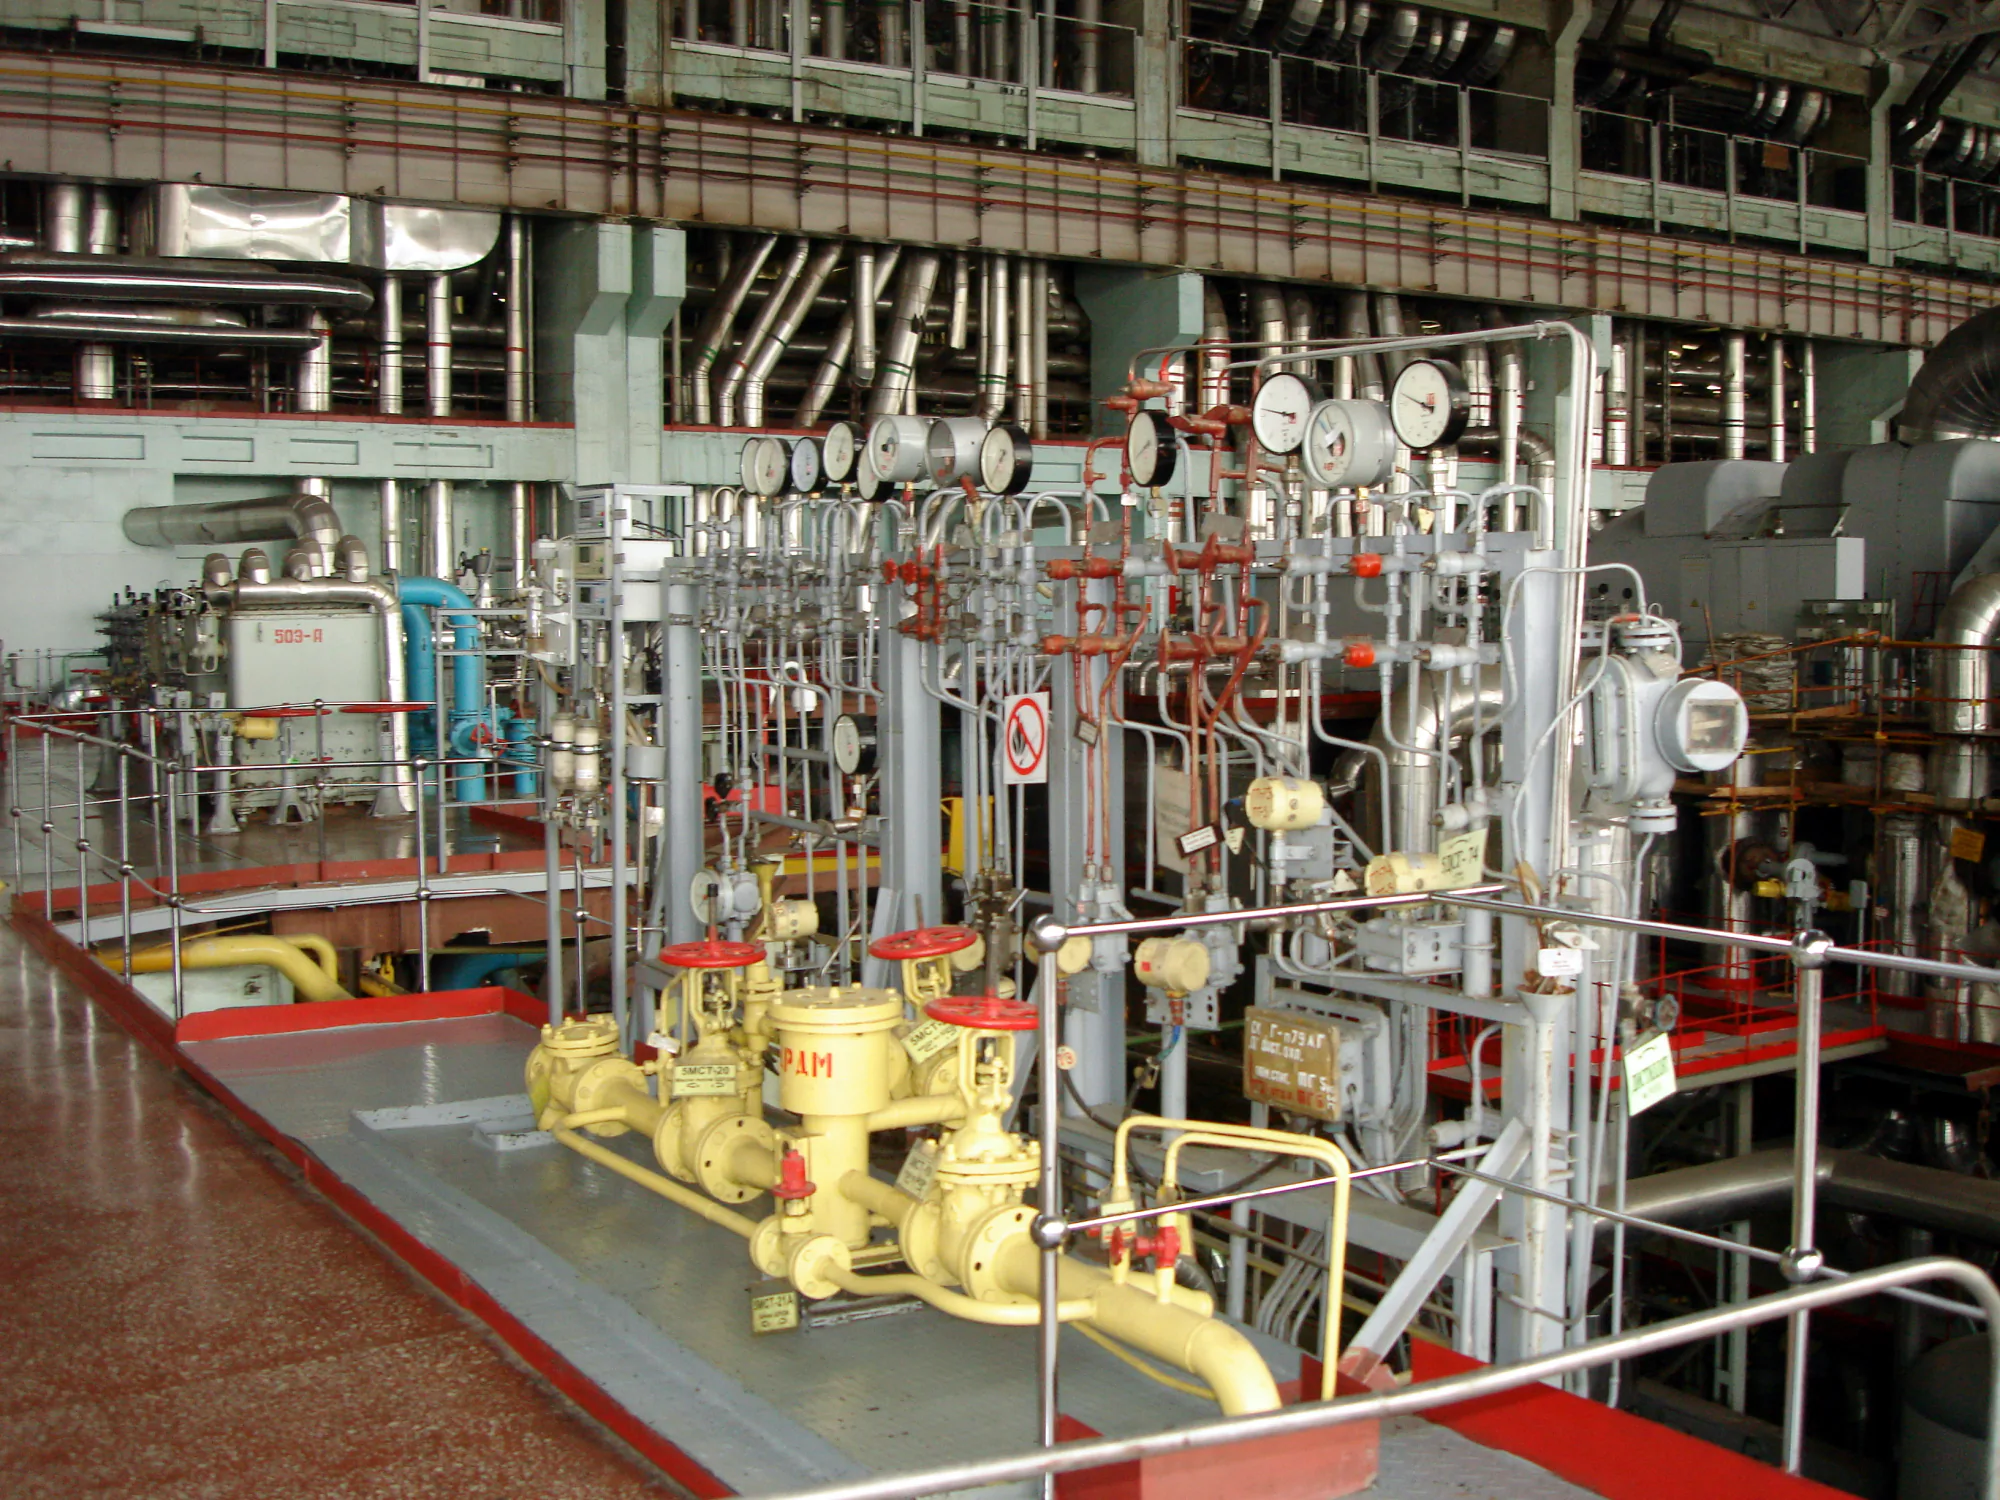
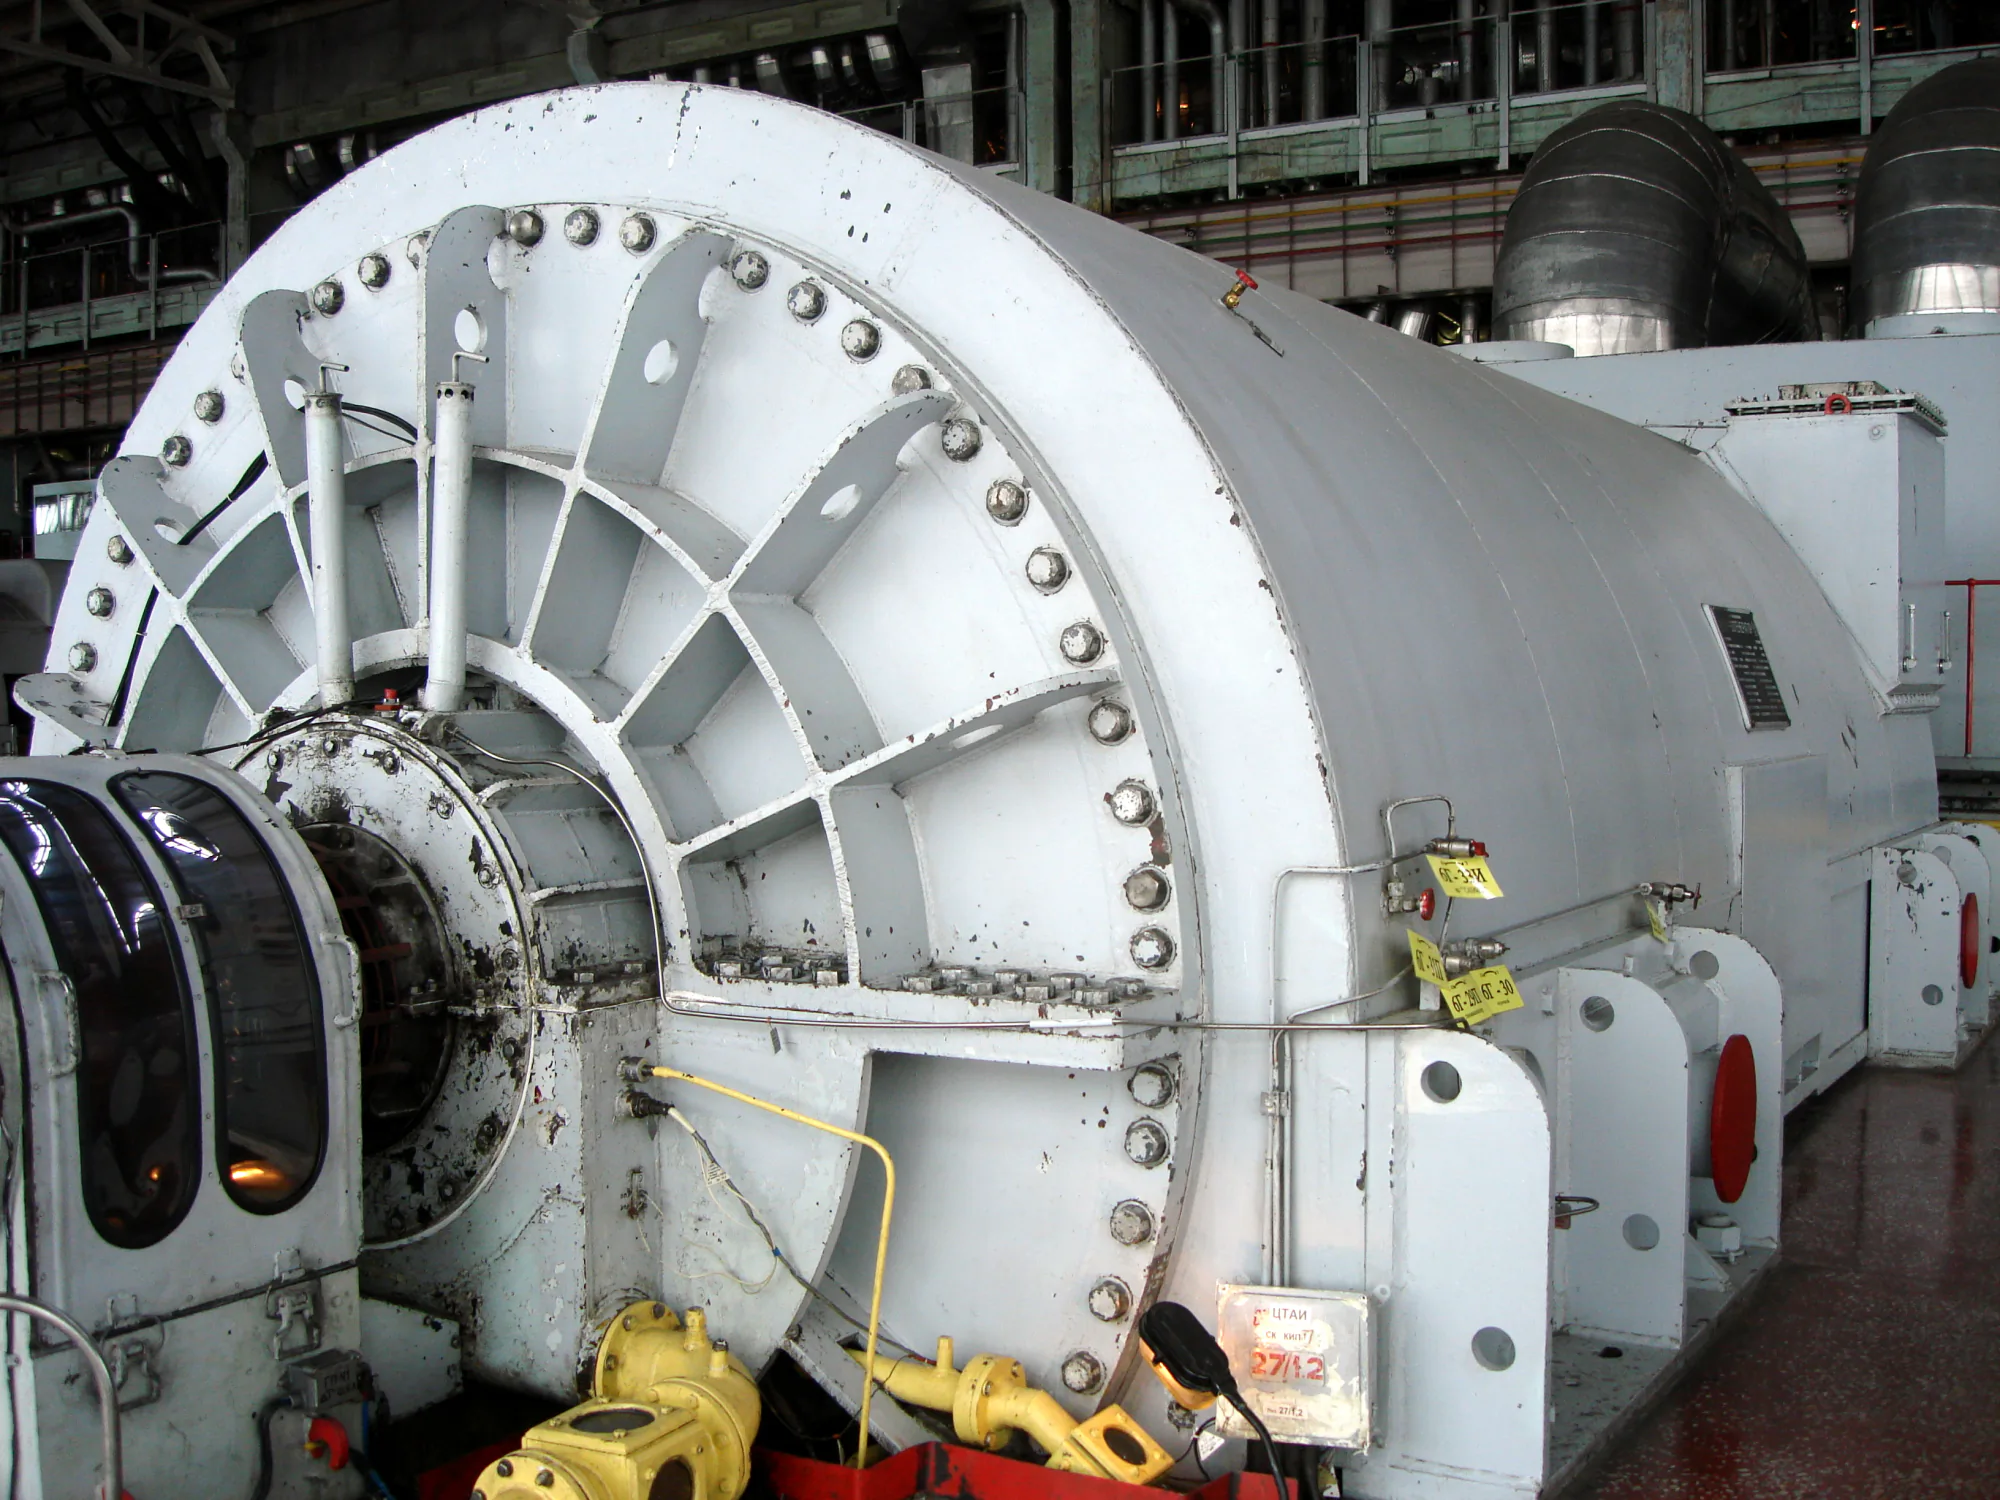
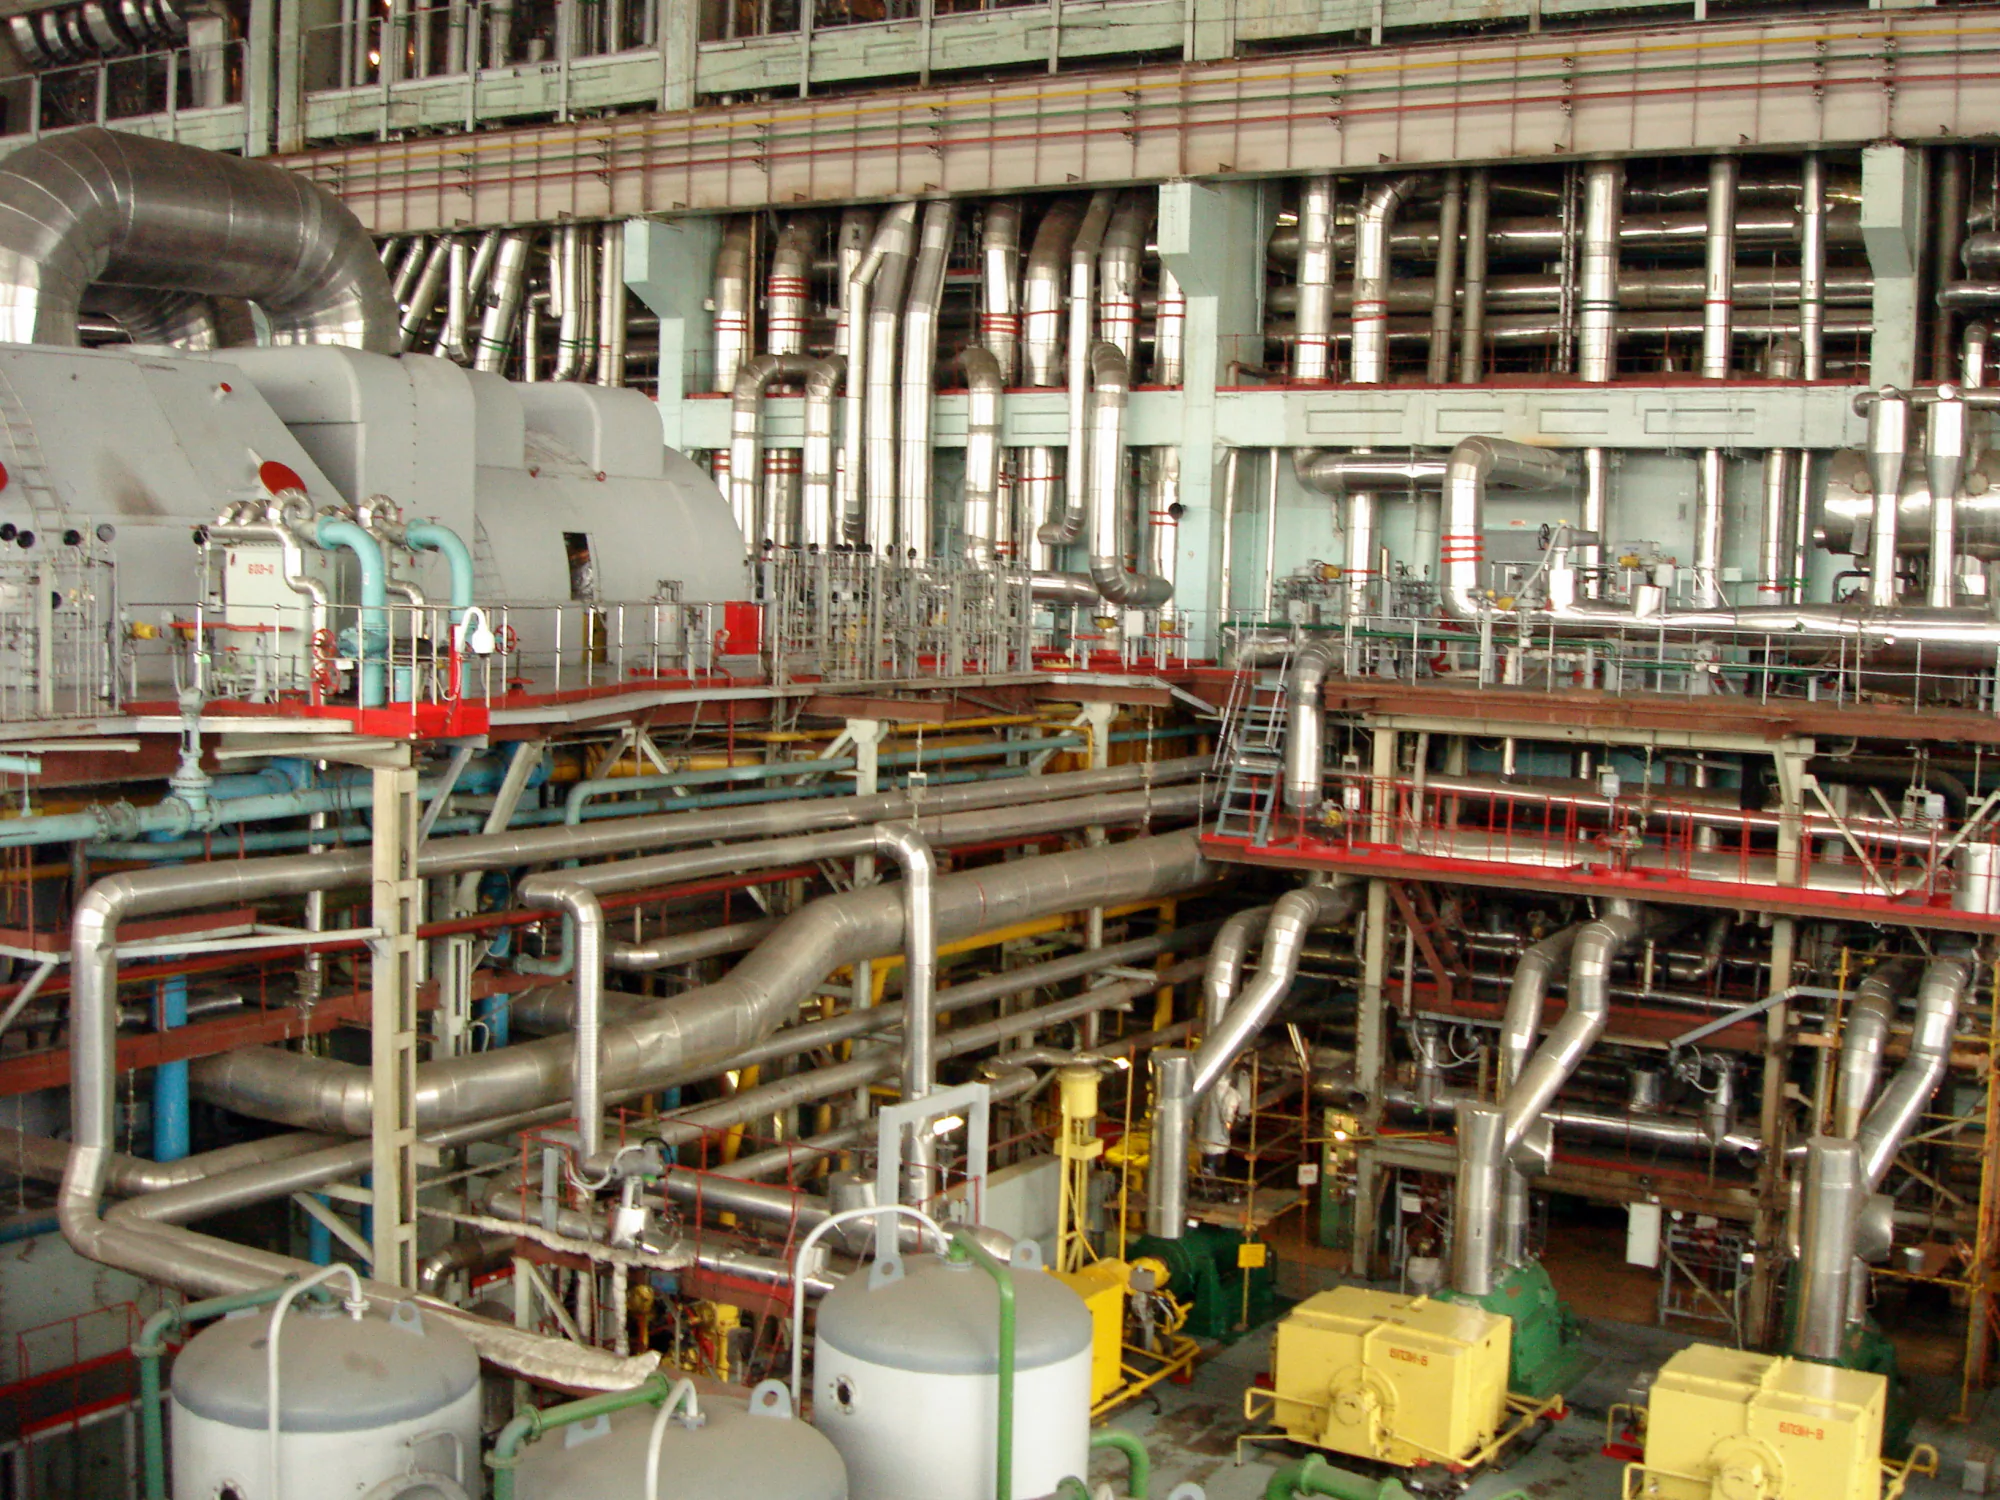
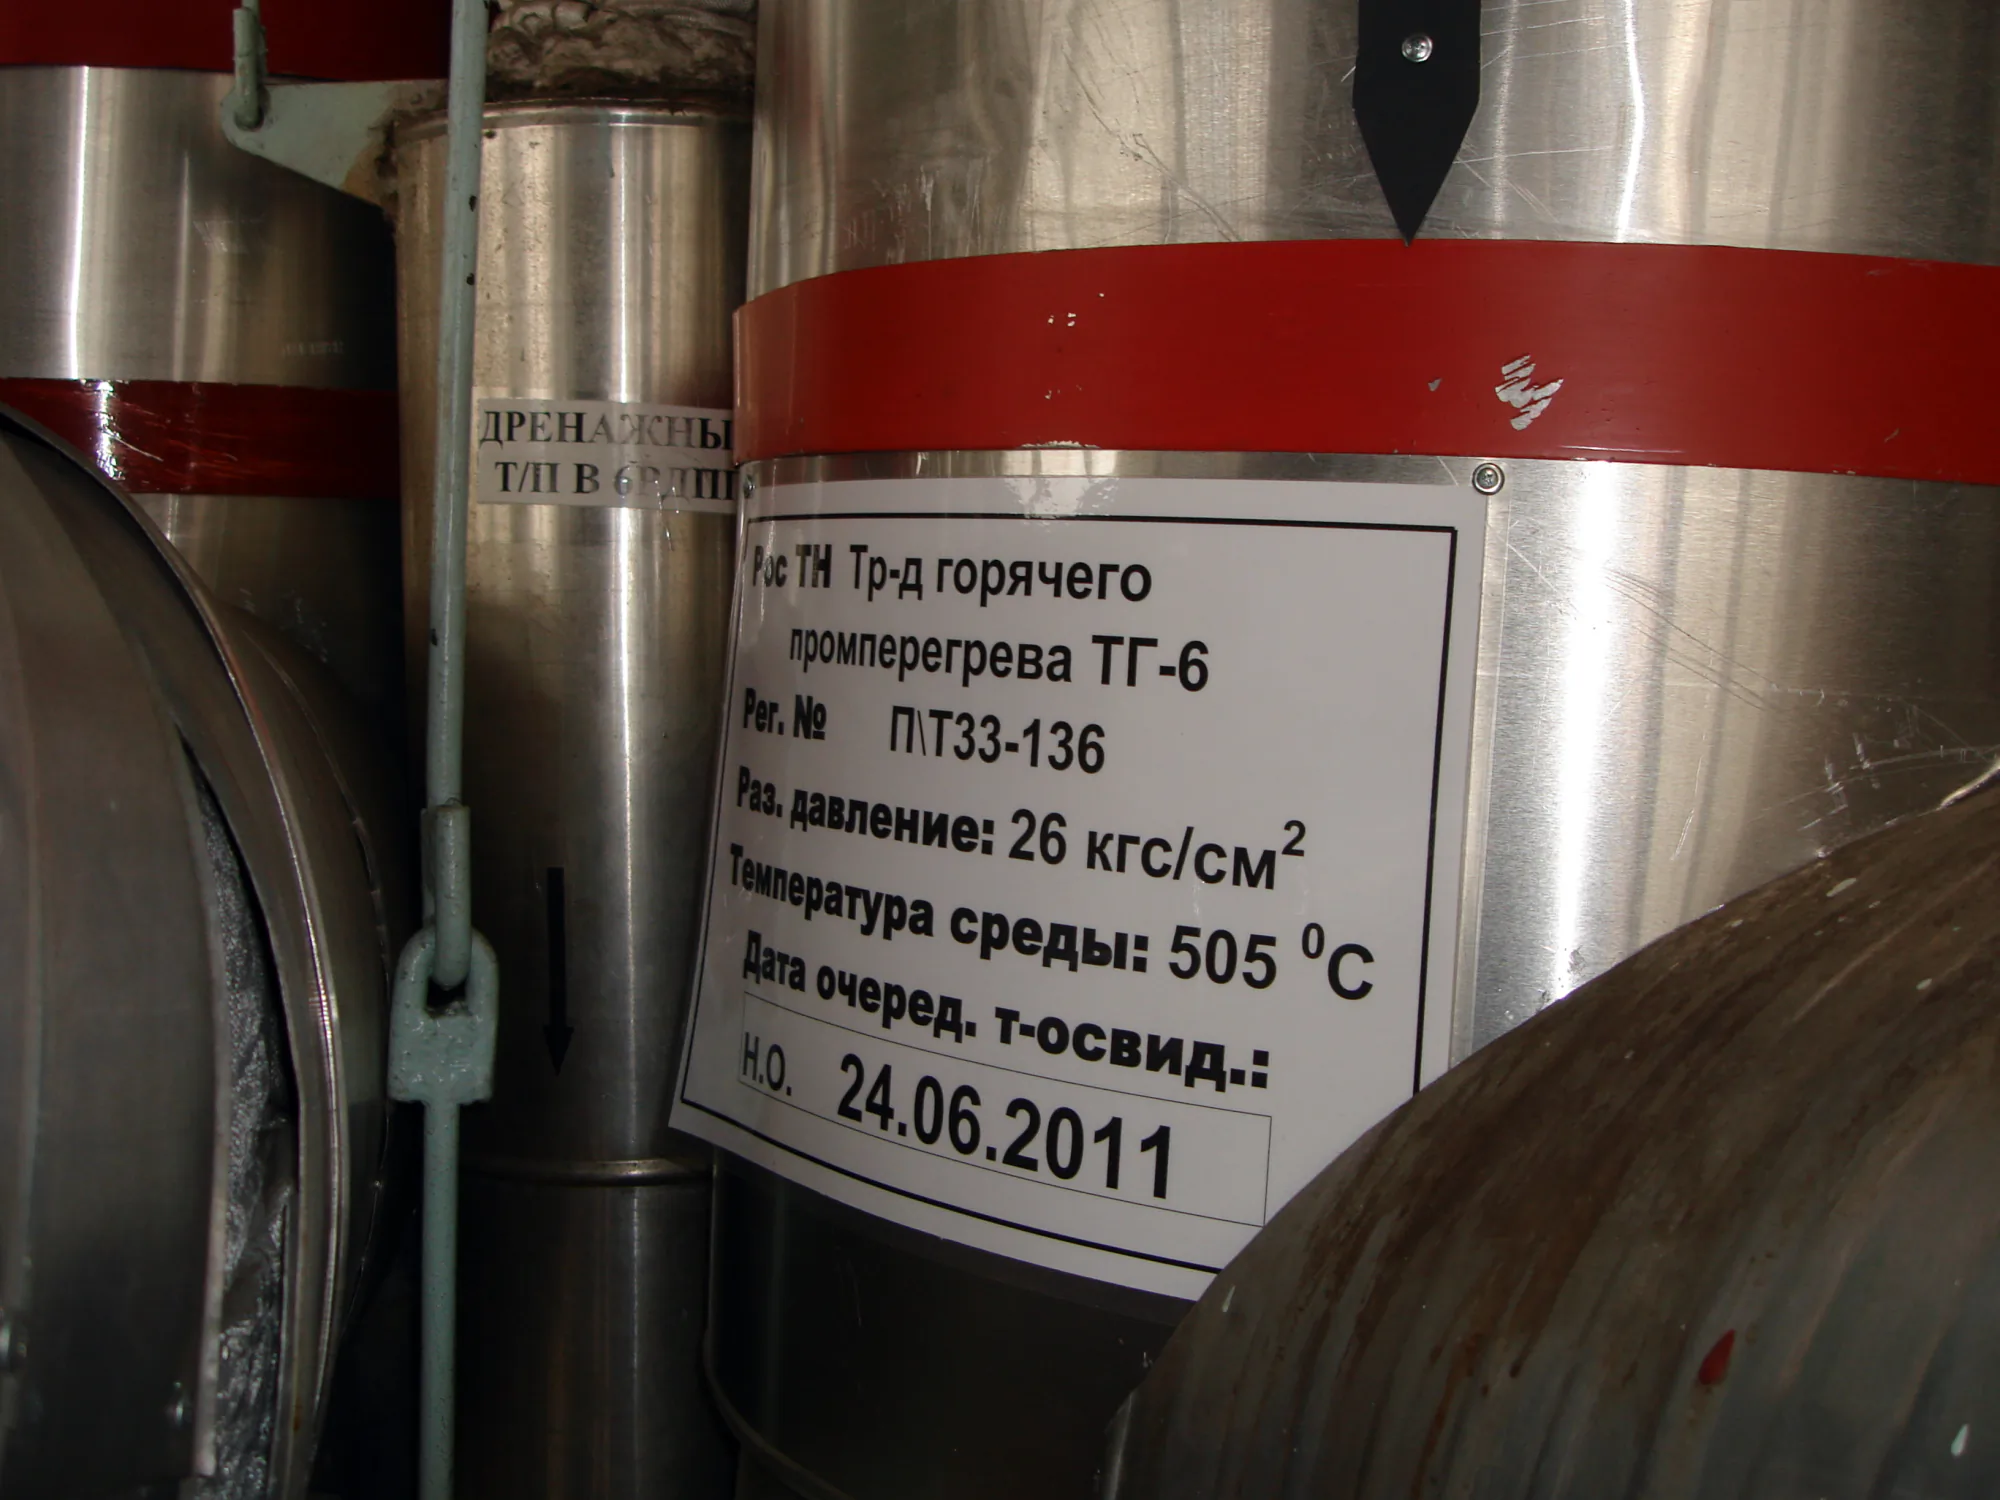
Внутри довольно жарко, несмотря на то, что на улице едва только снег не шёл, внутри технологических зданий можно было прогуливаться разве что не в футболке.
Самый совершенный атомный реактор, на настоящий момент, это обычная печка, энергия снимается через тепло. Кстати, в реакторе на быстрых нейтронах БАЭС в качестве теплоносителя используется жидкий натрий (это очень эффективно, но порождает массу технических трудностей, например, натрий при контакте с водяными парами взрывается).
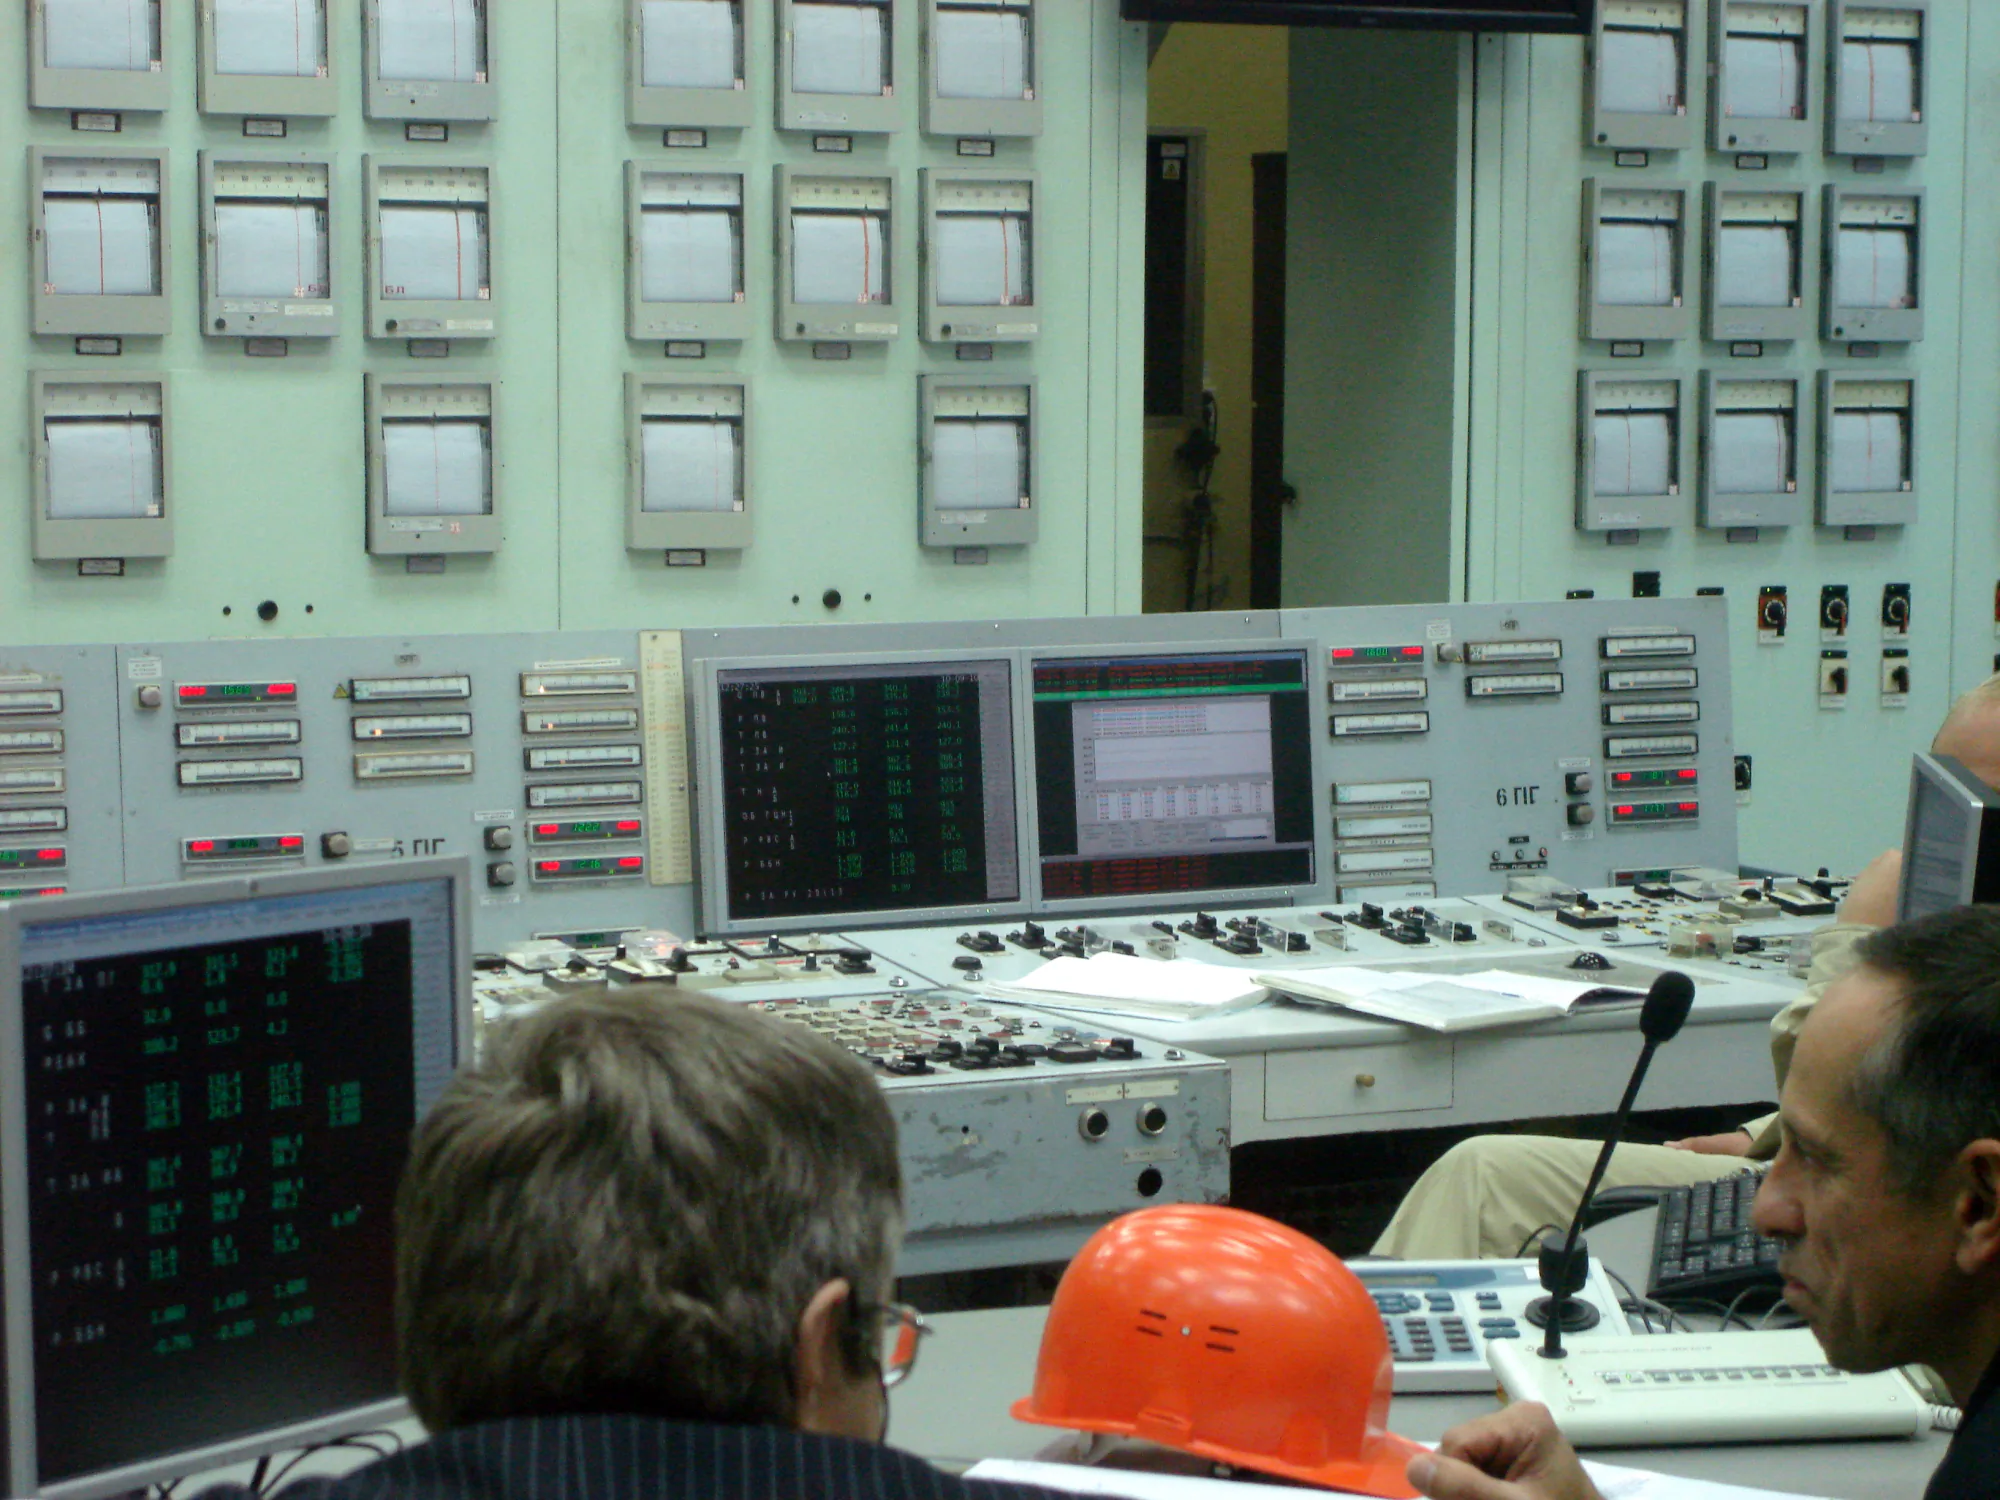
Как и в моём воображении, на реальных АЭС всё управляется из больших комнат с кучей приборов, правда, люди не сидят сутками, напряжённо вглядываясь в их показания, а довольно расслабленно, даже вальяжно наблюдают за ситуацией. Такая расслабленность может моментально смениться слаженной активностью и умение мгновенно концентрироваться — главное качество, необходимое в этой работе.
Одна ошибка — курсы переквалификации, экзамены, вторая — прощай диспетчерская.
На фотографиях видно, что часть приборов современенная, часть, не иначе, осталась ещё с советских времён. Это закономерно — диспетчеры привыкают к определённым приборам и снимать показания с новых для них неоправданное неудобство. Тем не менее, приборы выходят из строя и обновления всё же производят, но дозированно.
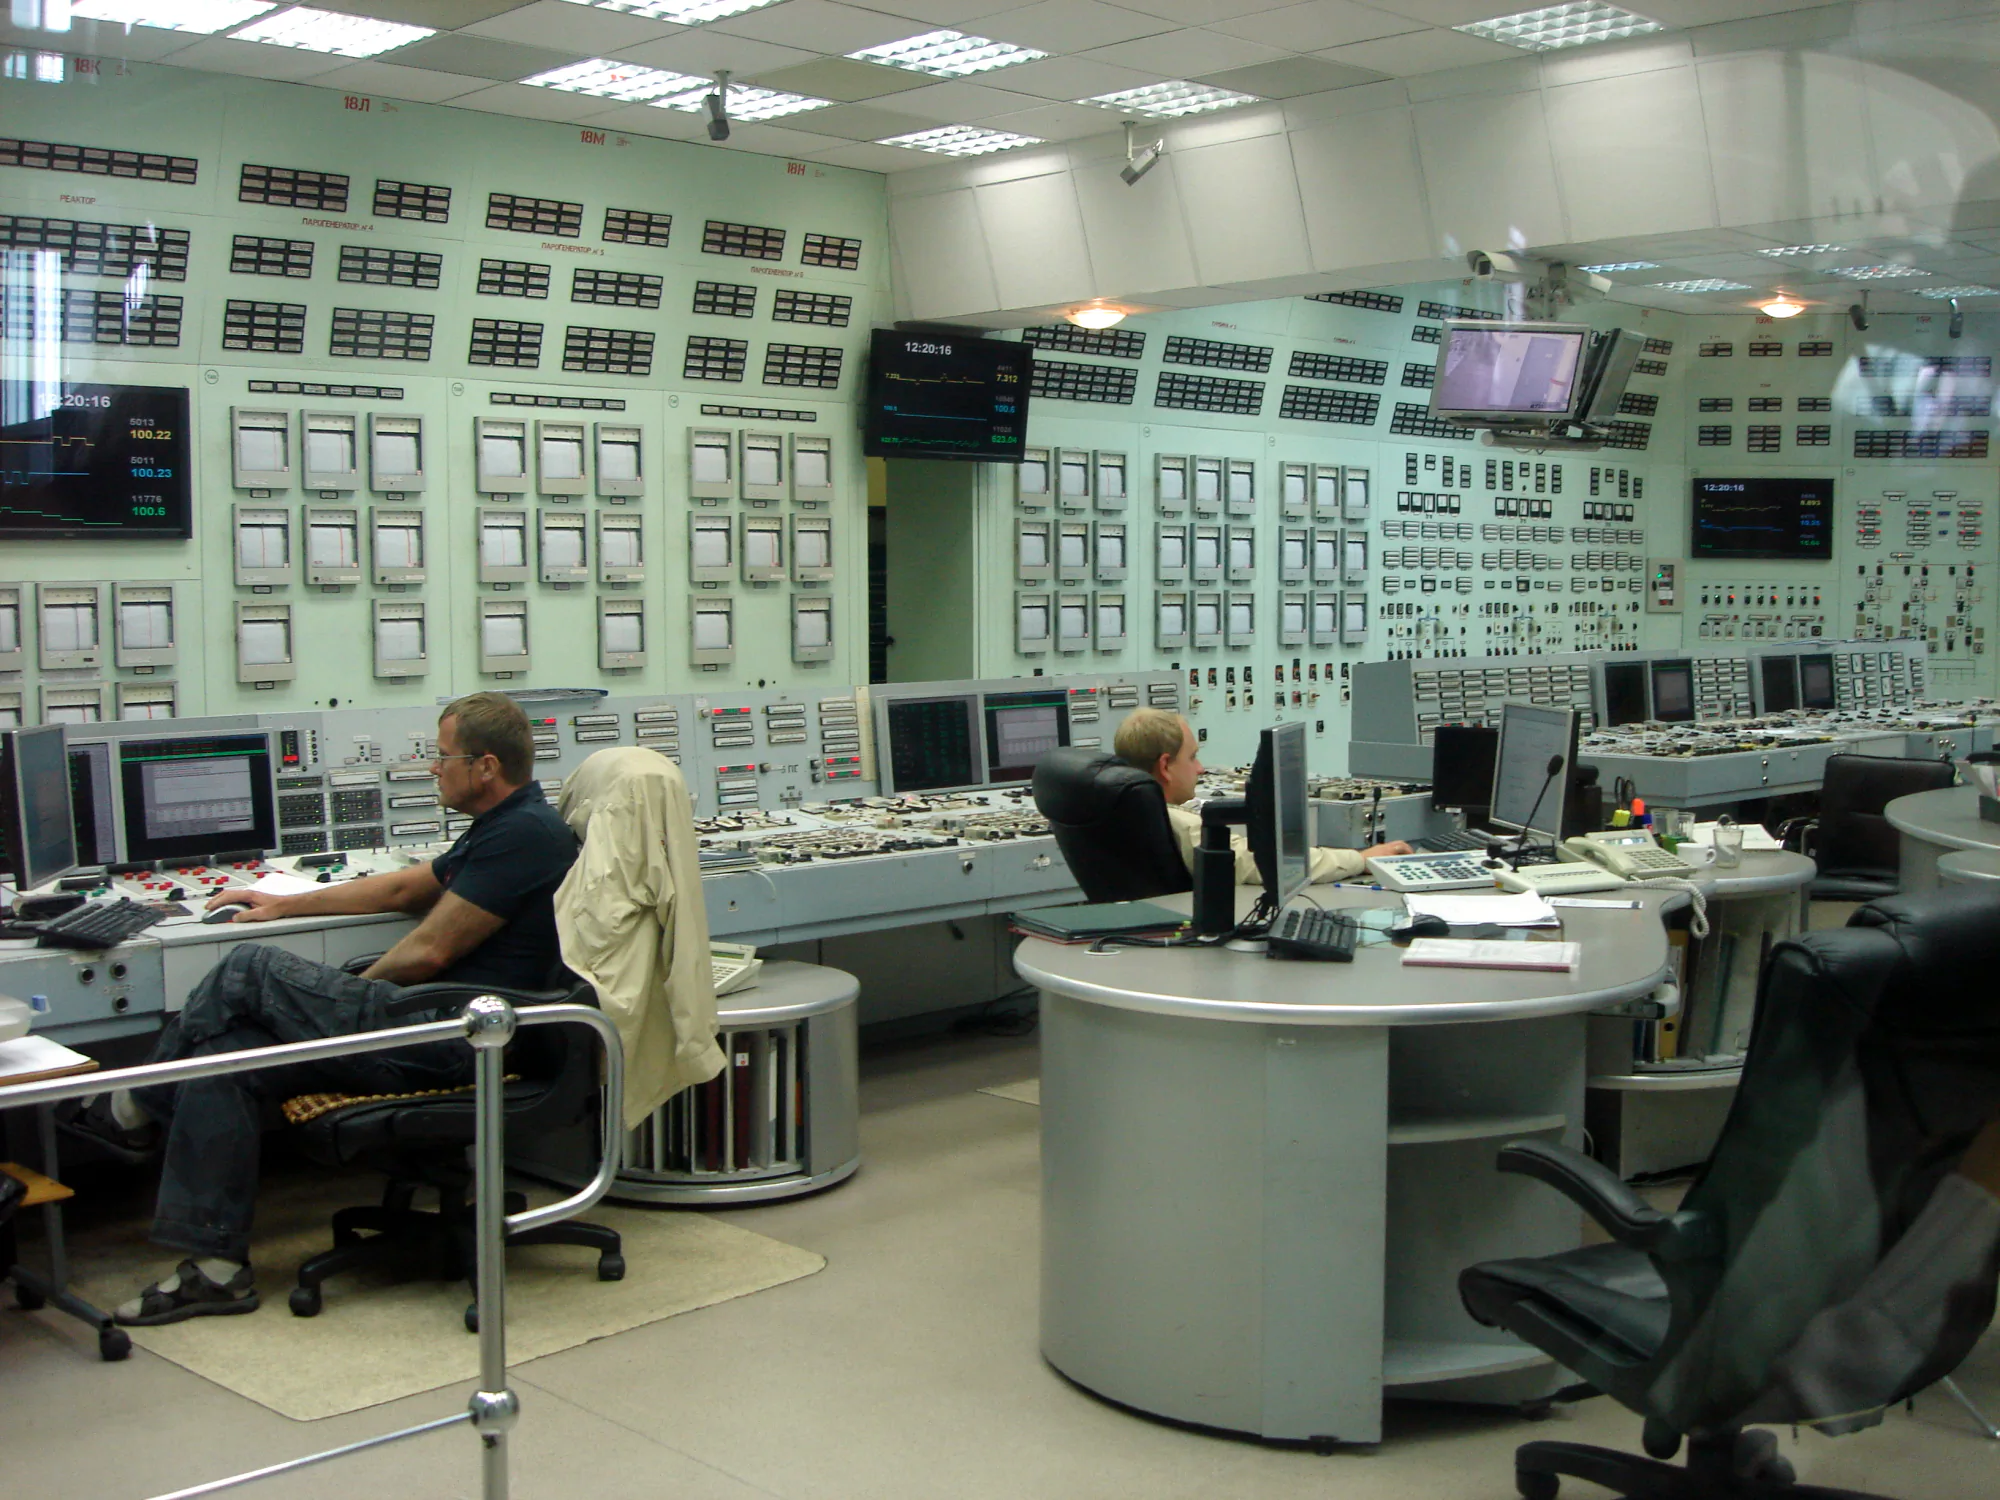
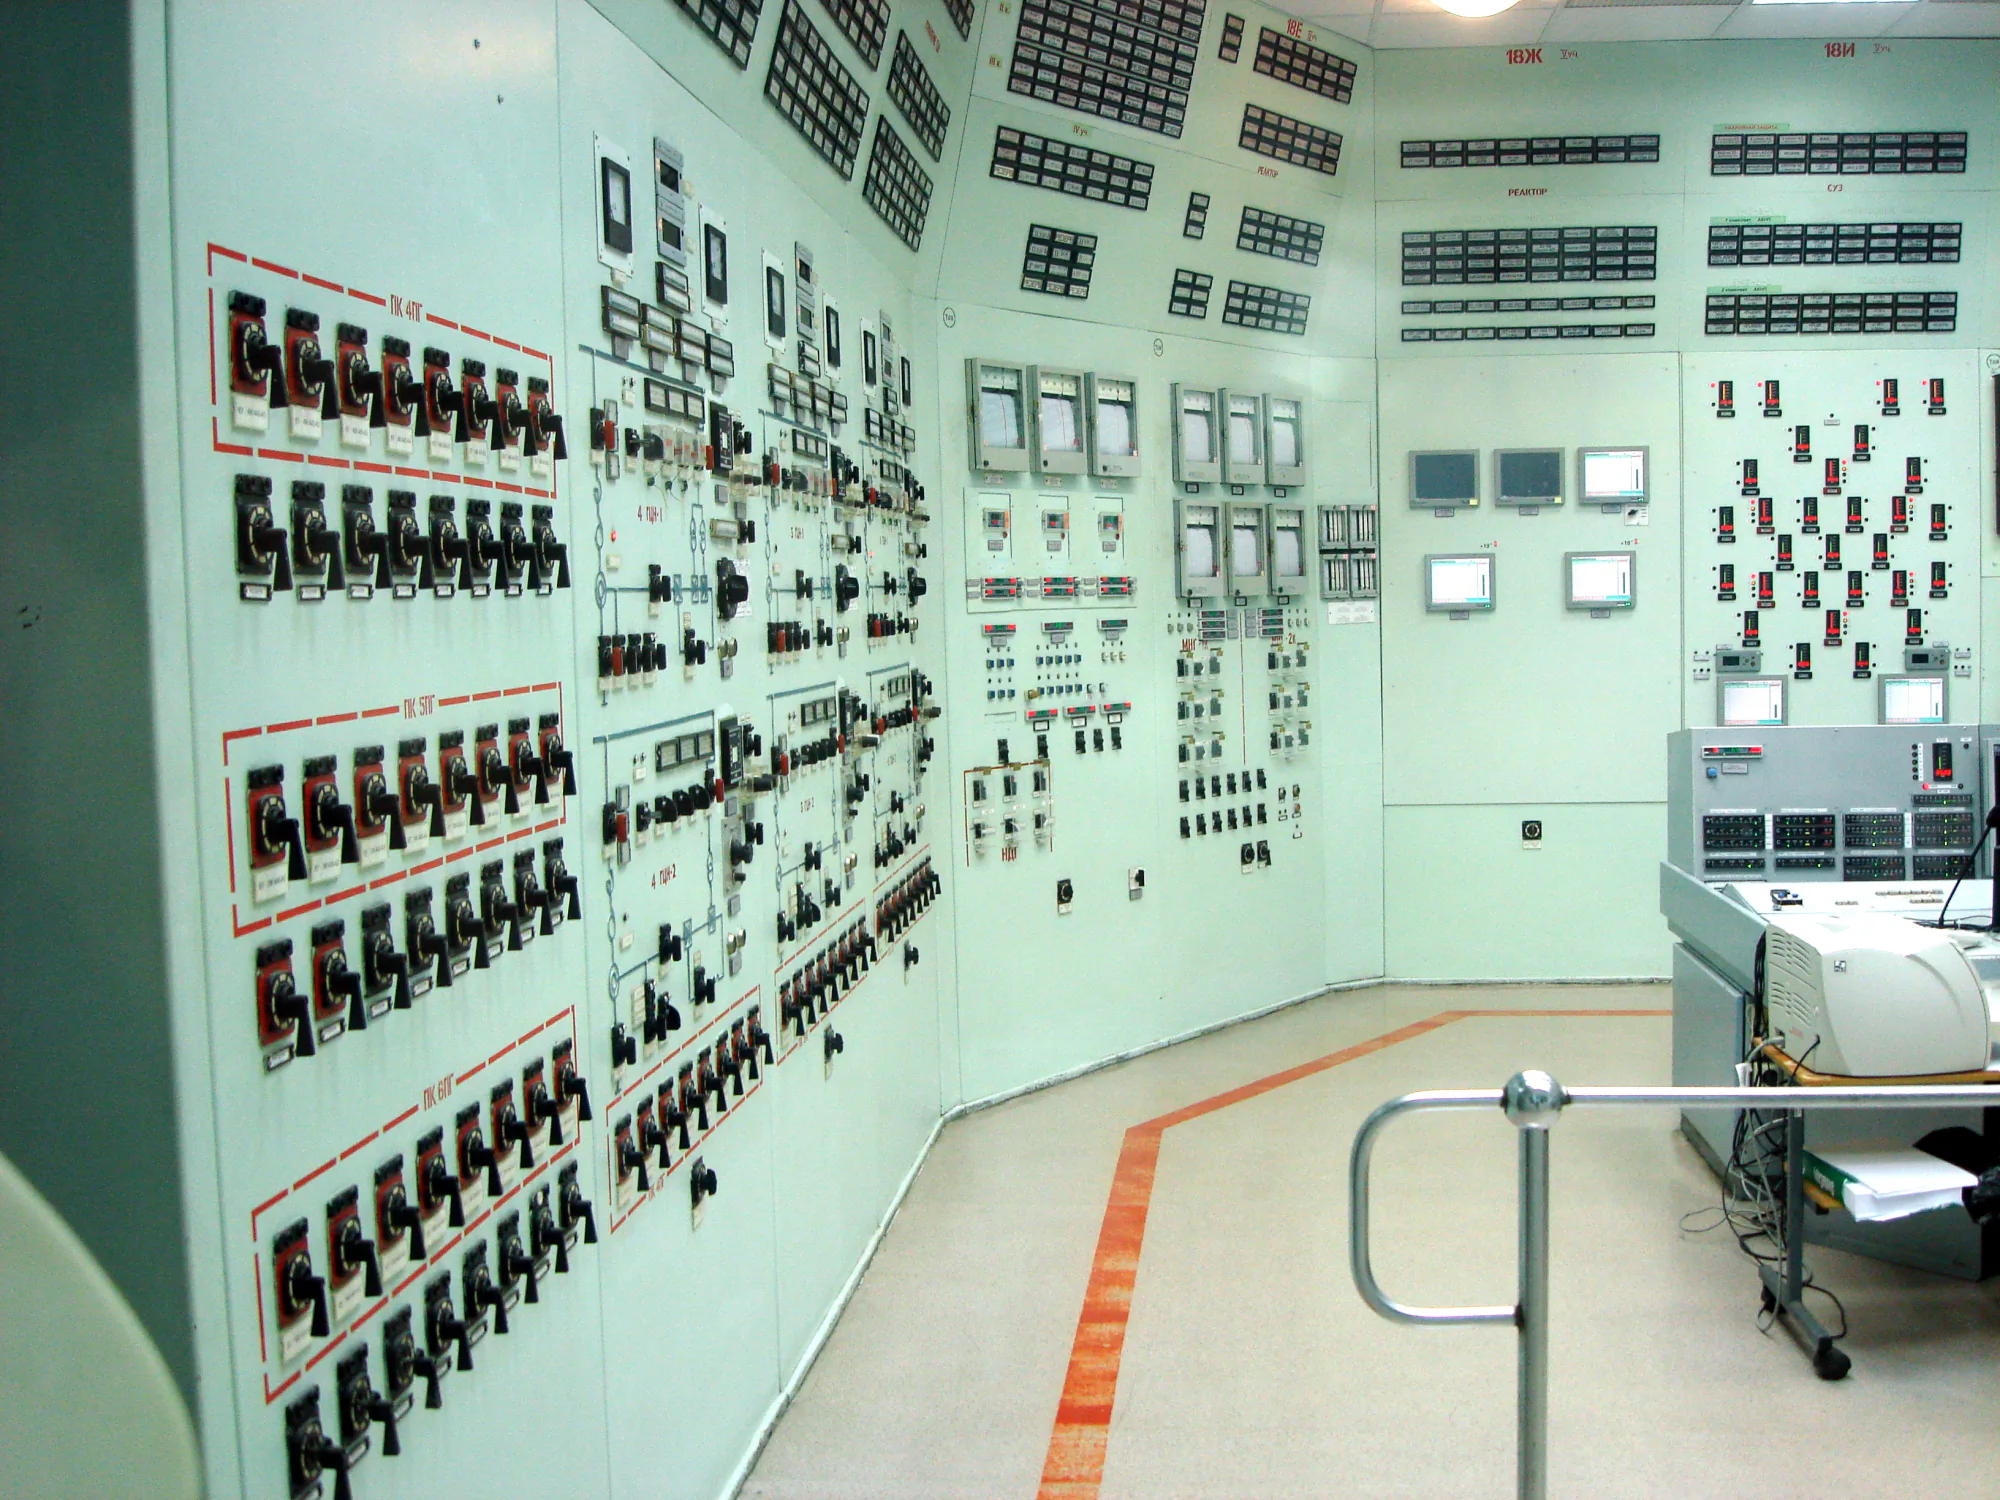
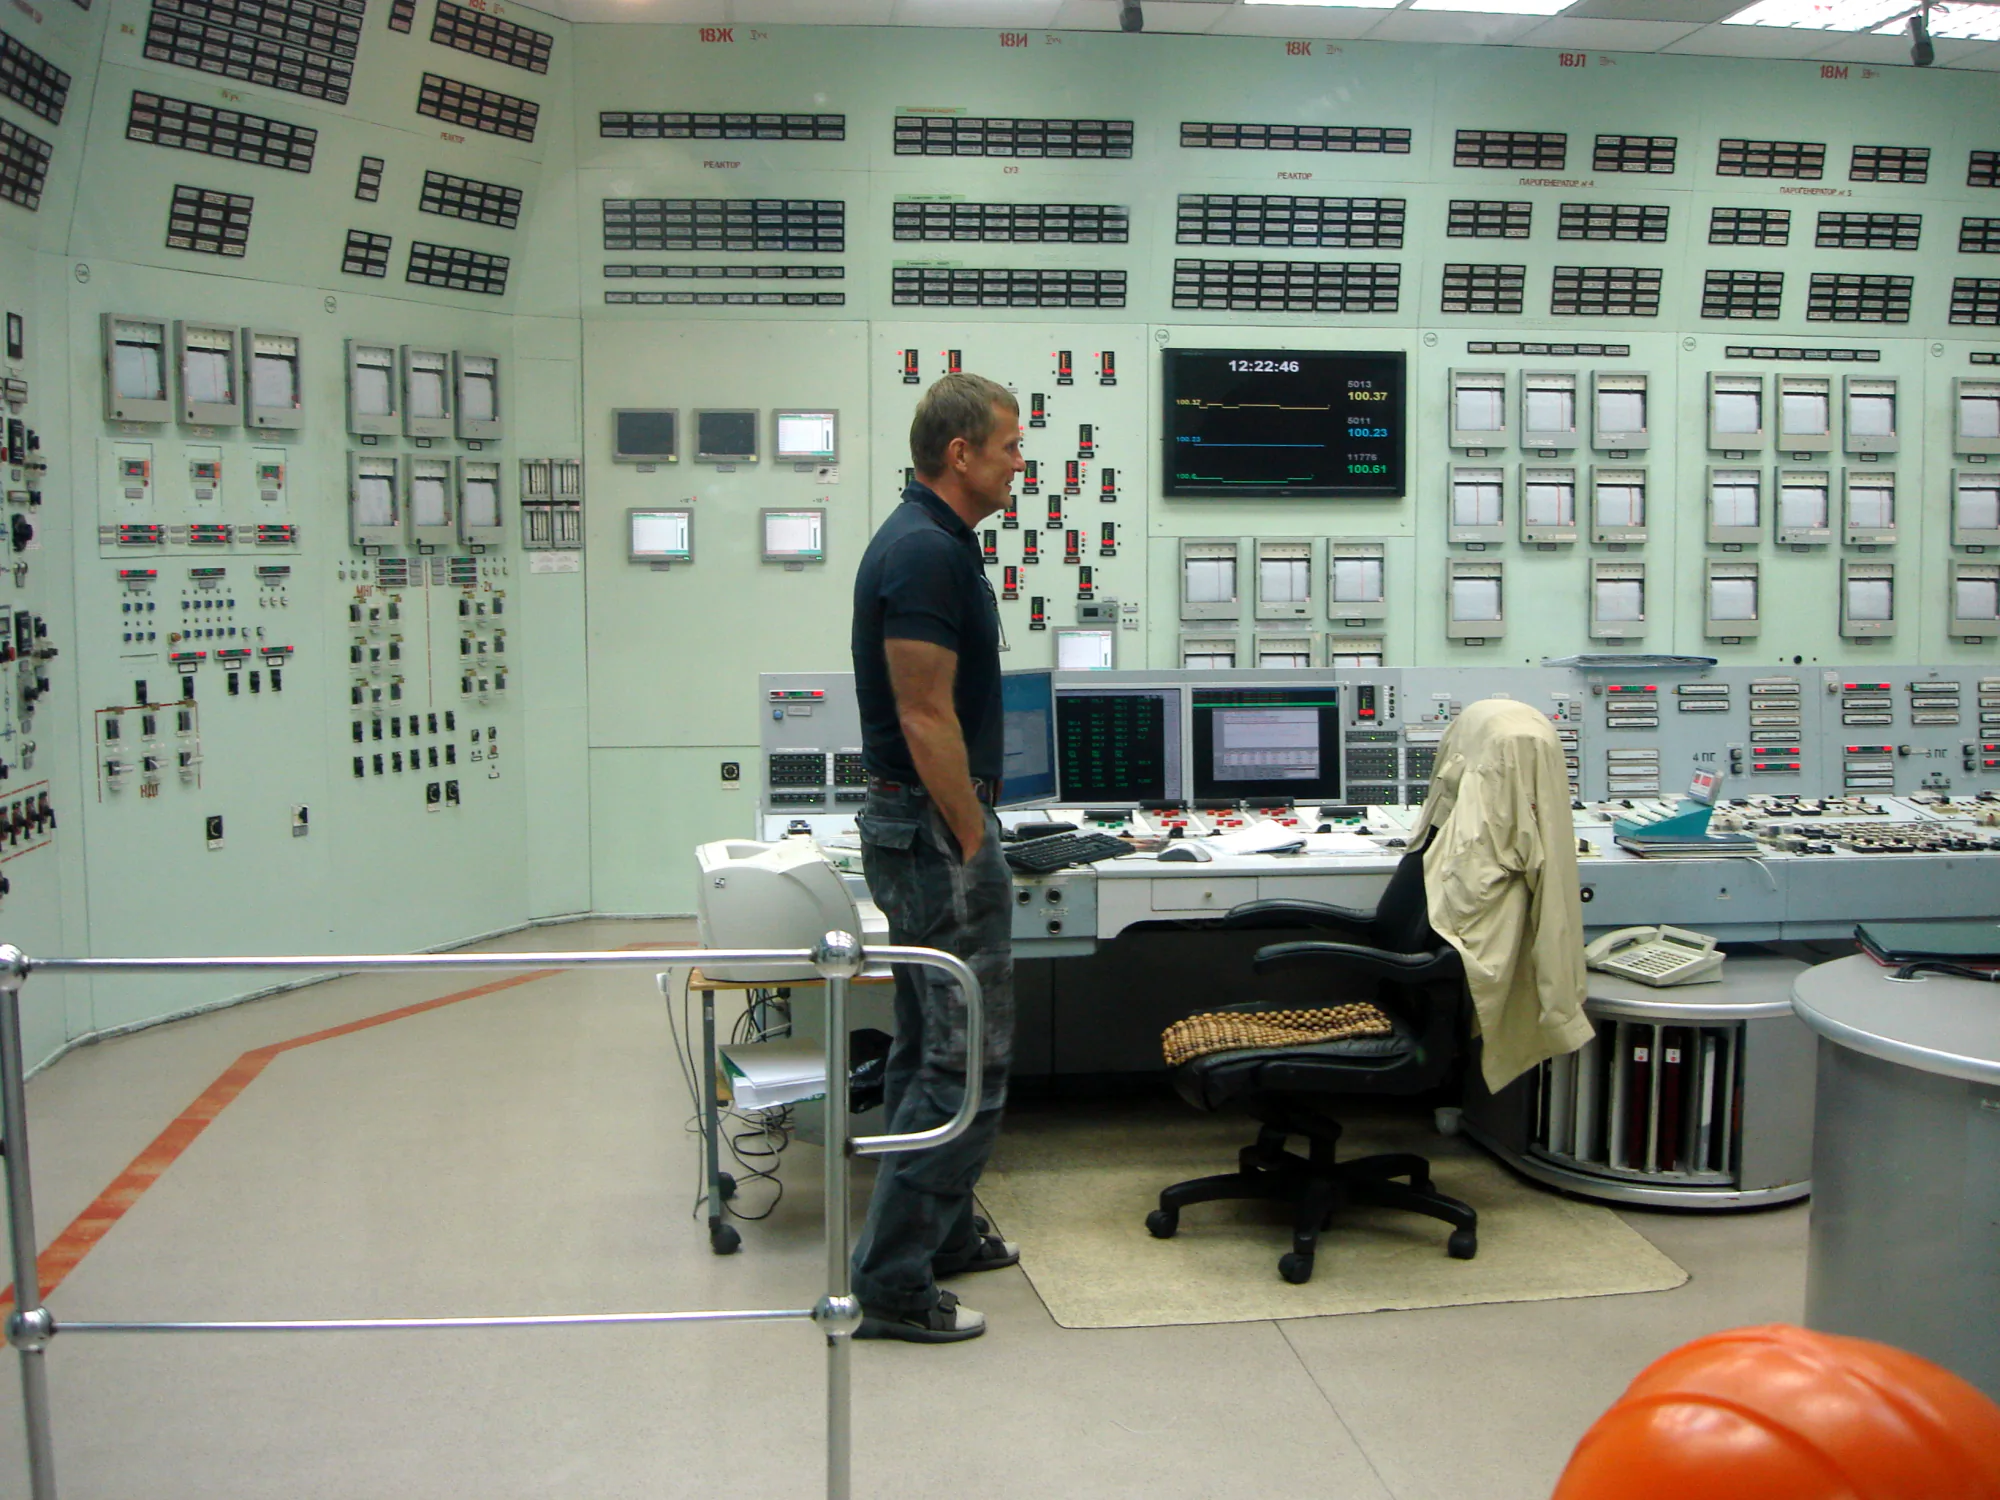
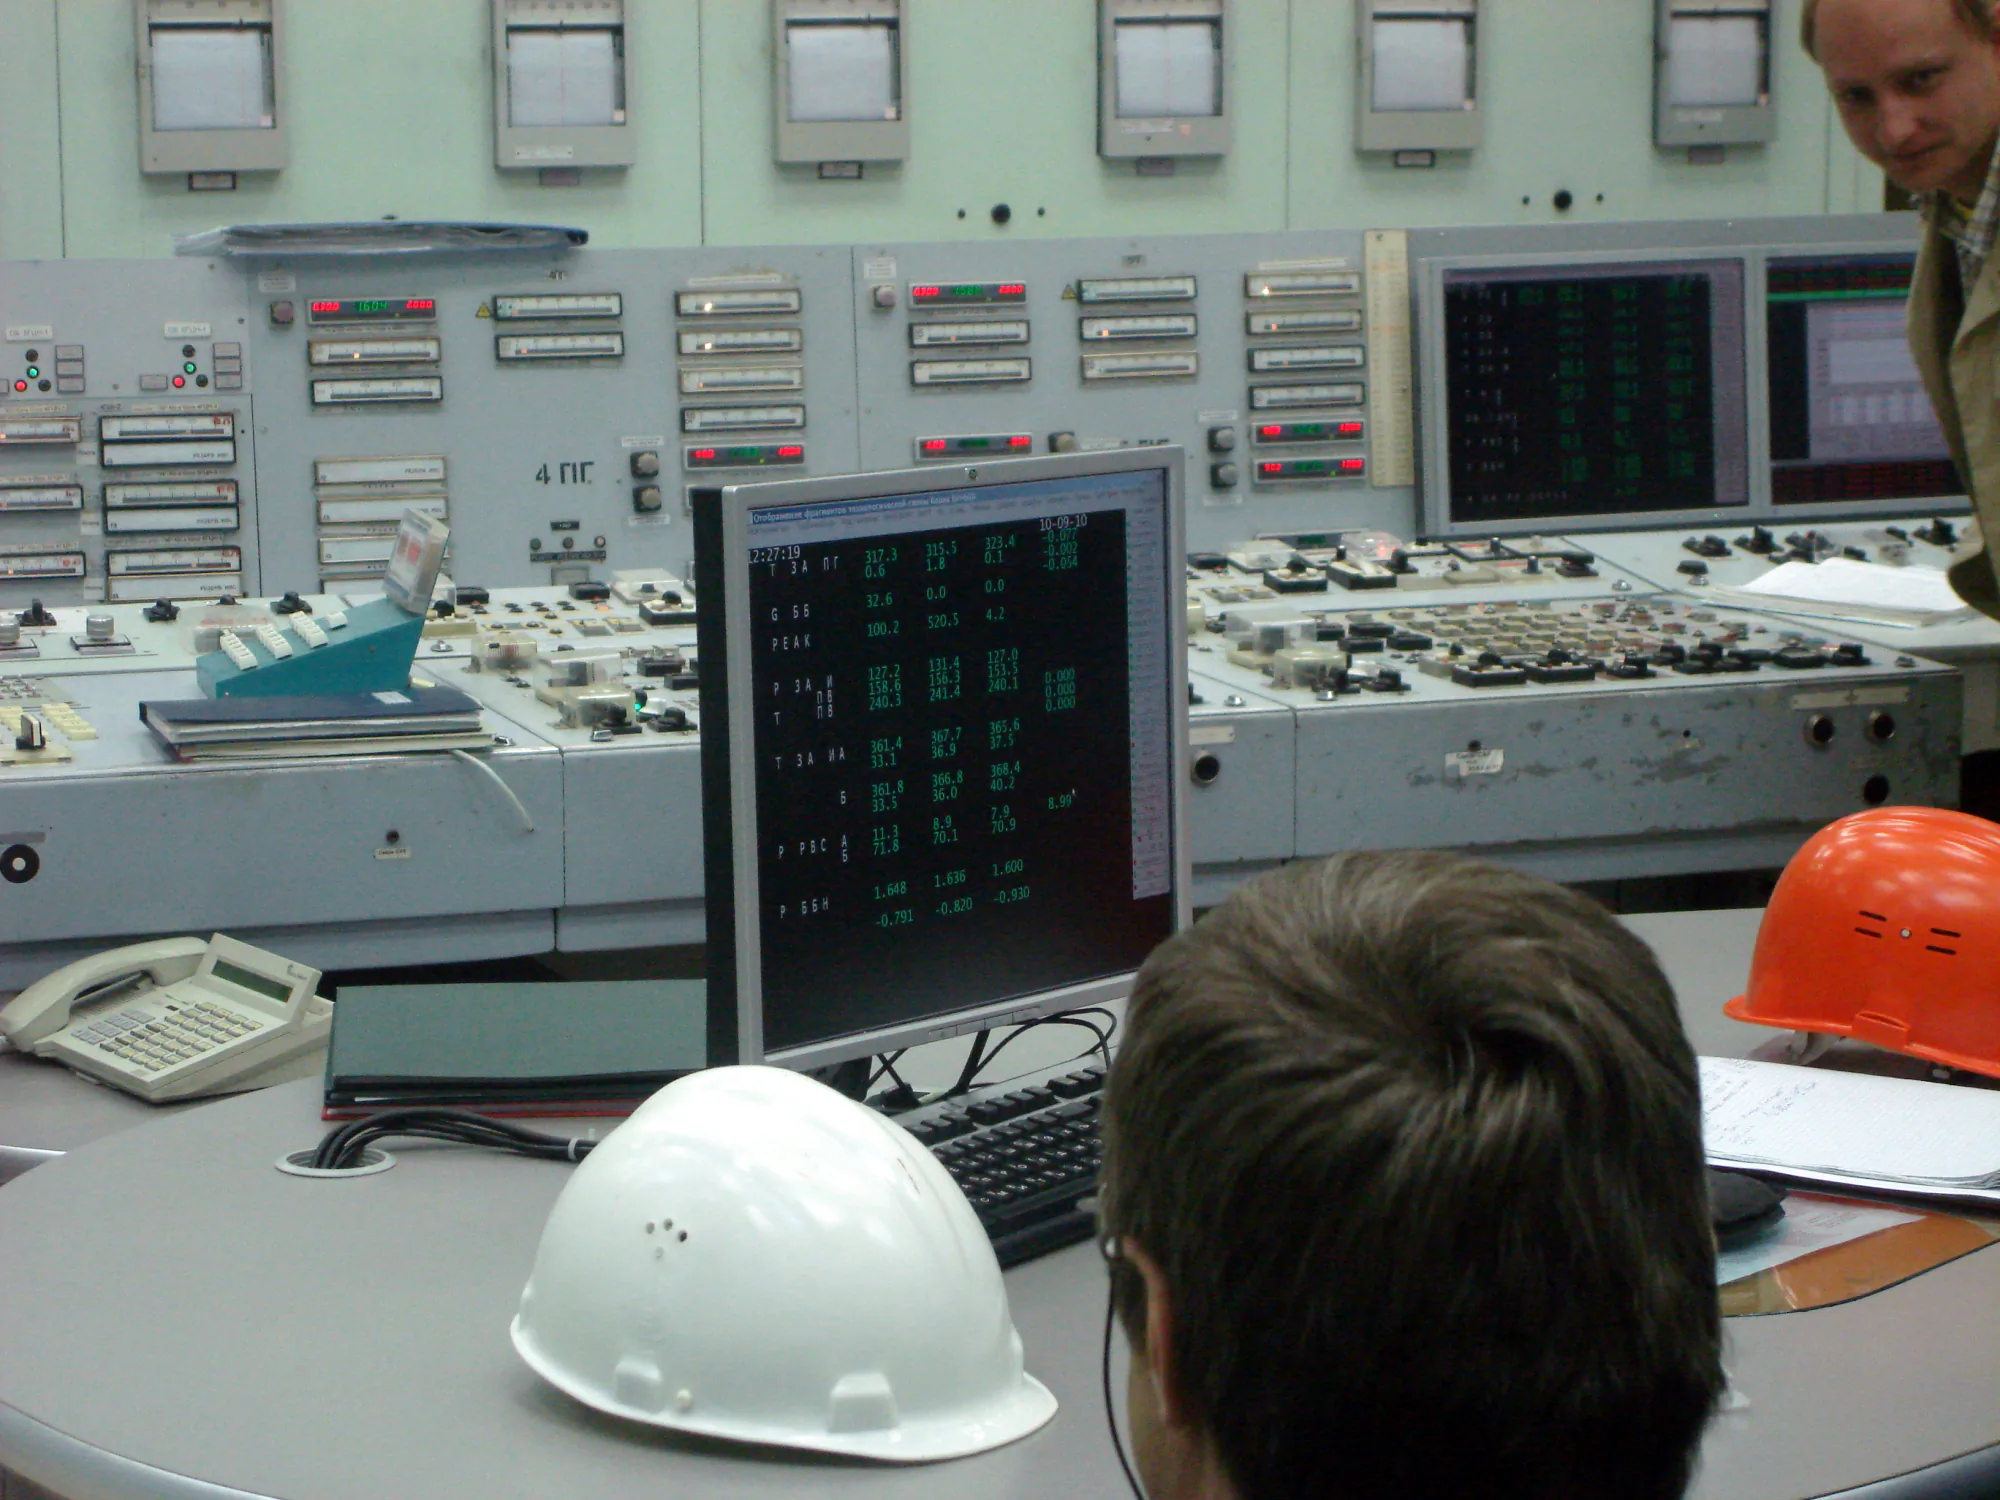
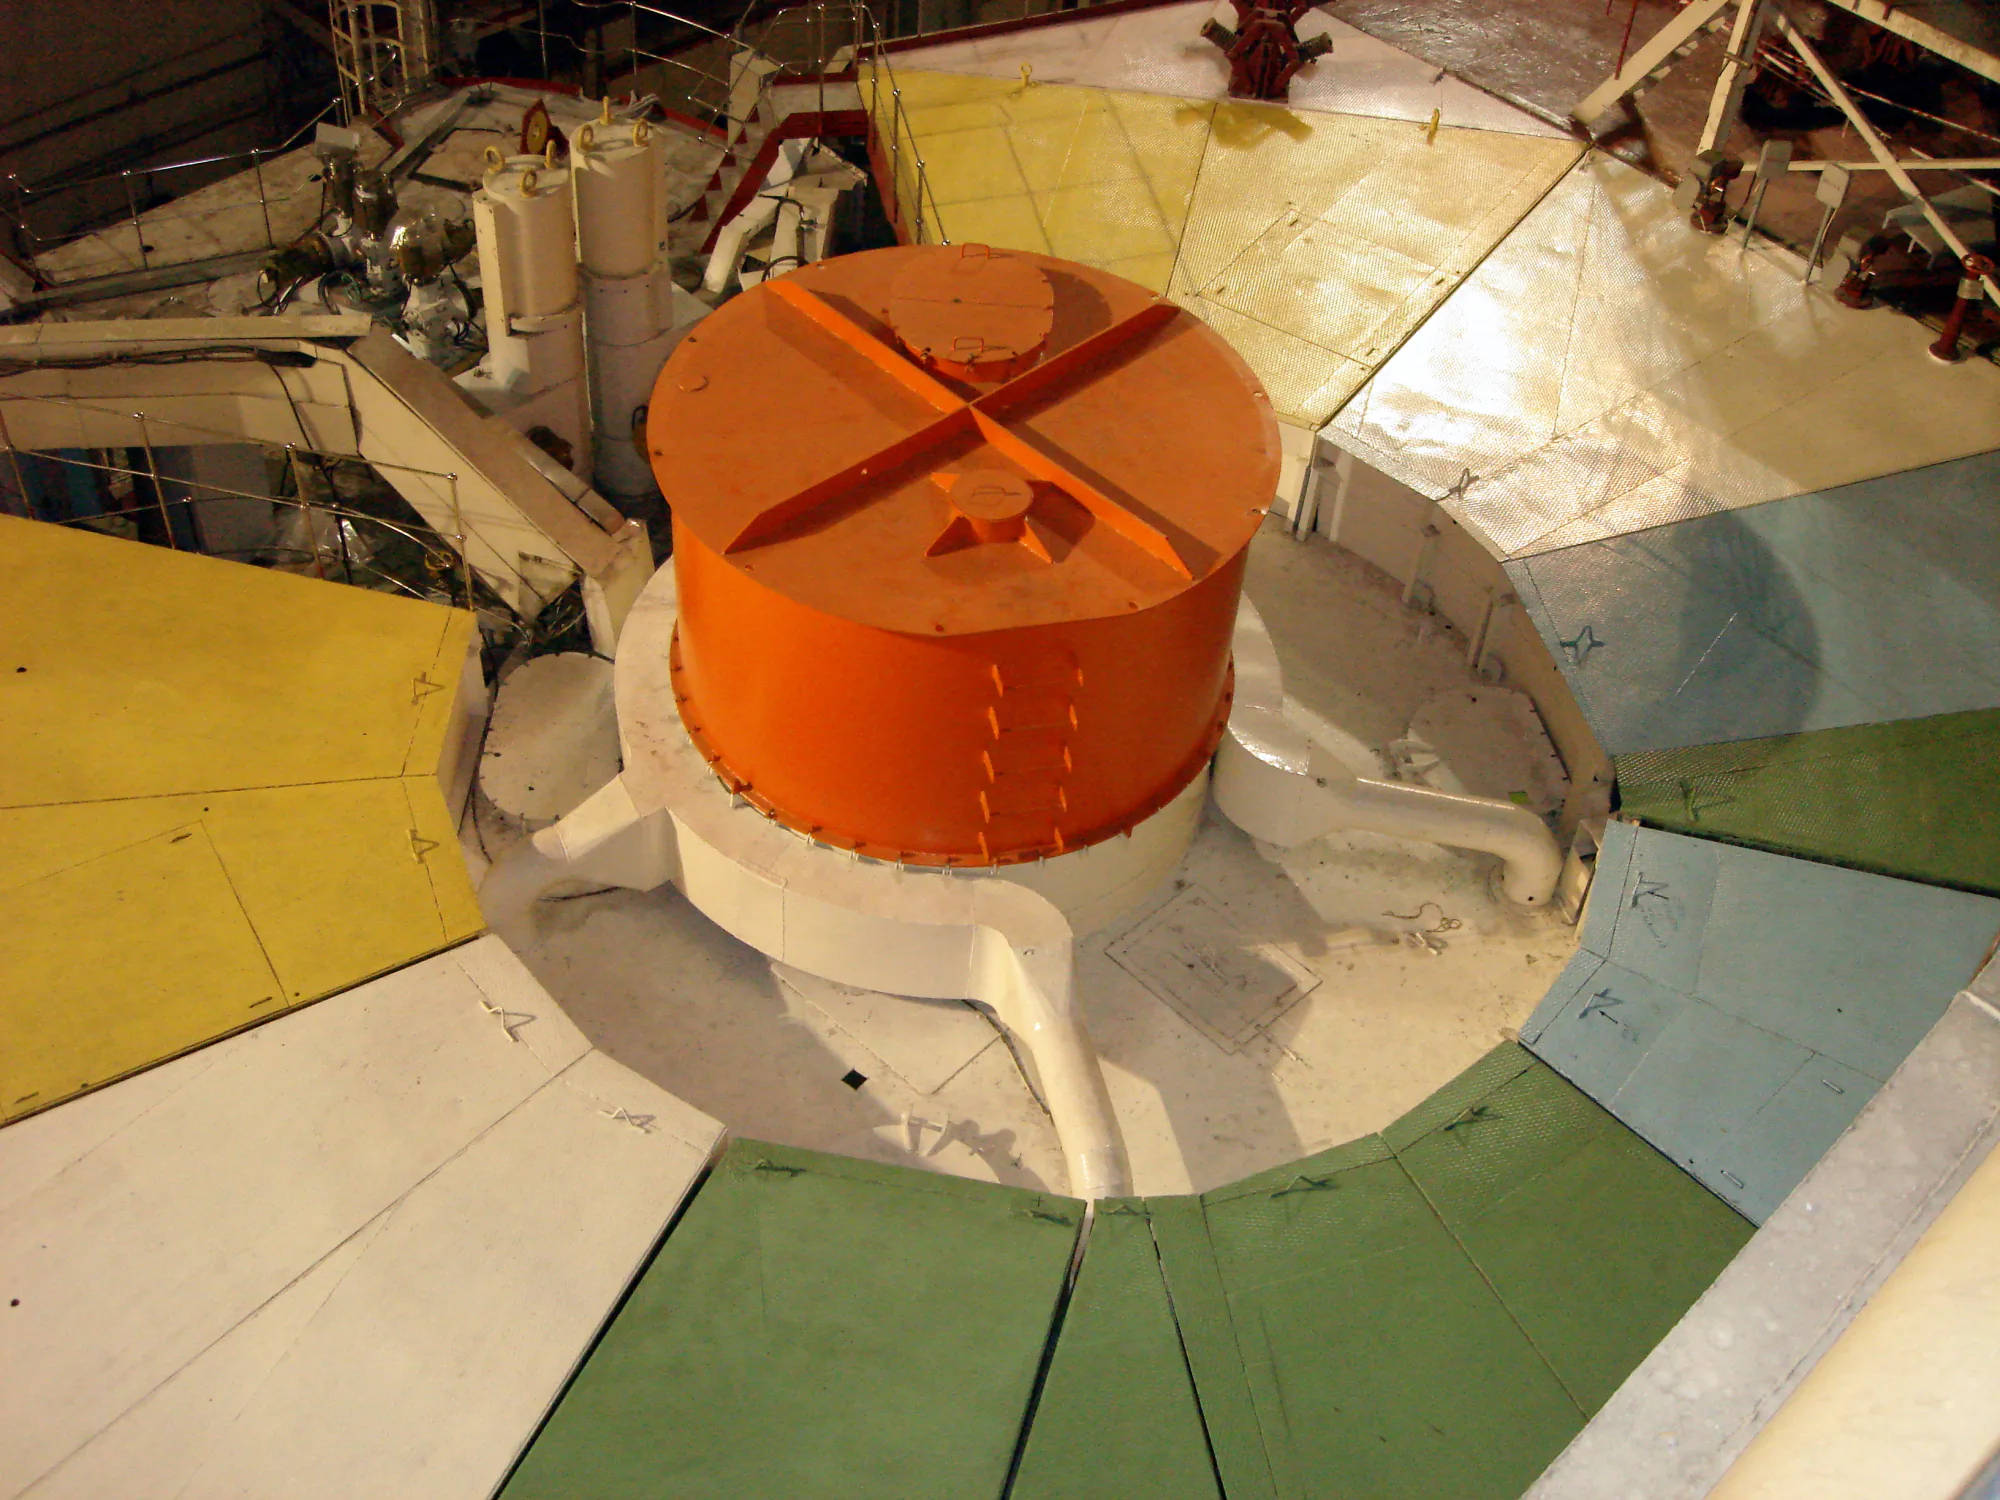
Сам реакторный цех ещё более пустынный и огромный (десятки метров в любую сторону). Небольшая яркая бочка, окружённая «лепестками» — реактор. Не впечатляет, правда? Внутри реактора интересно до смерти, но в могилу мы не стремимся.
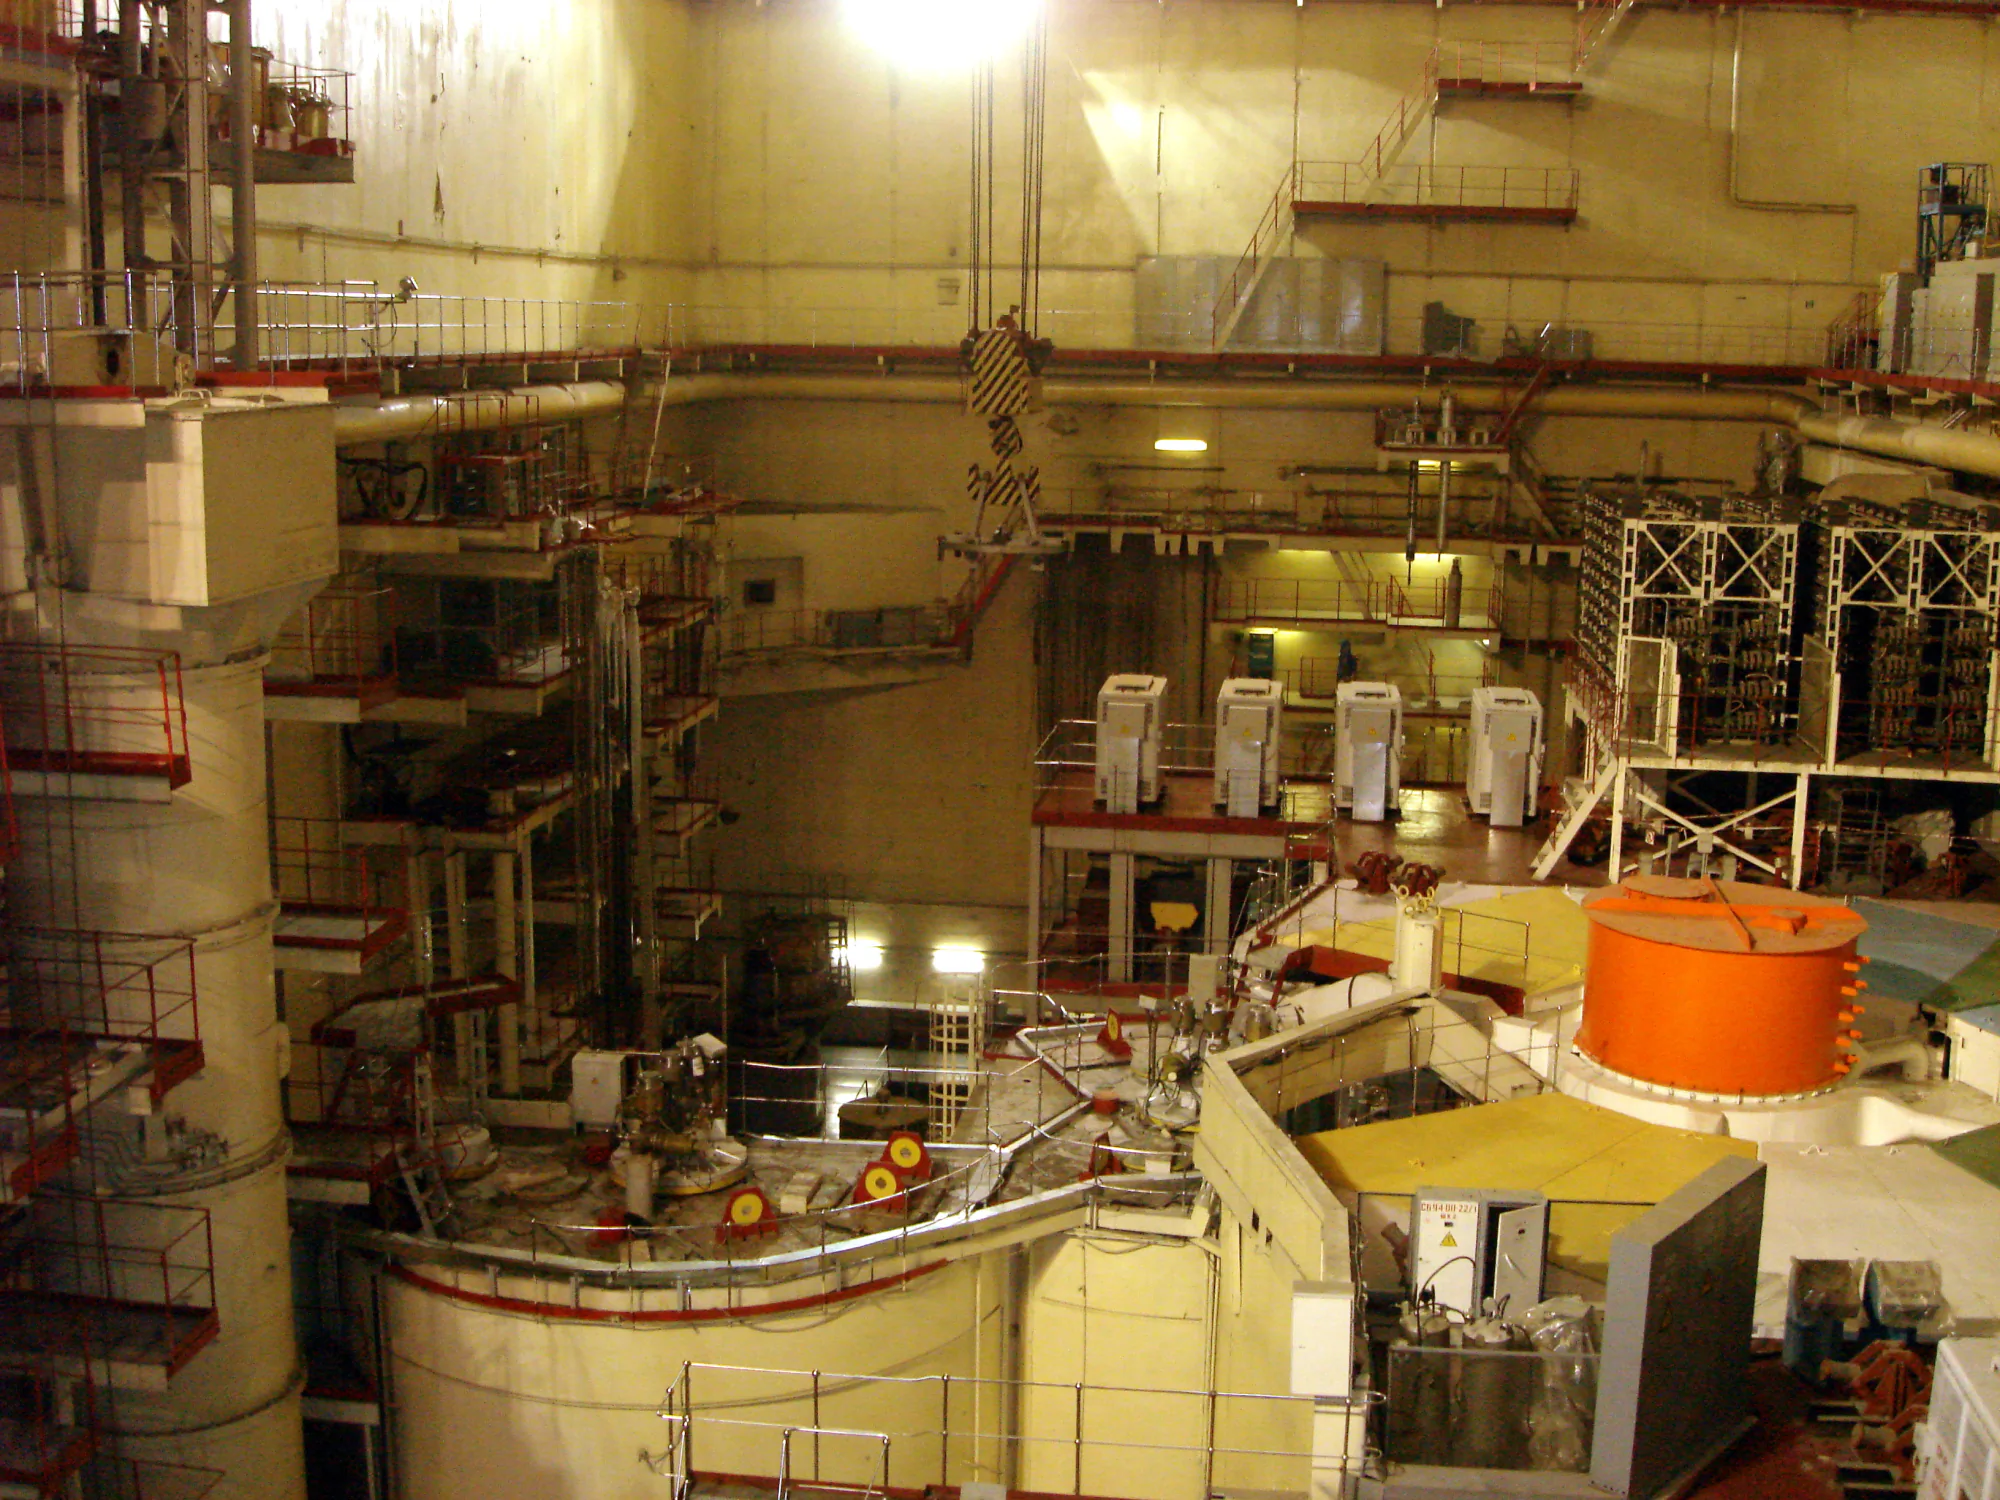
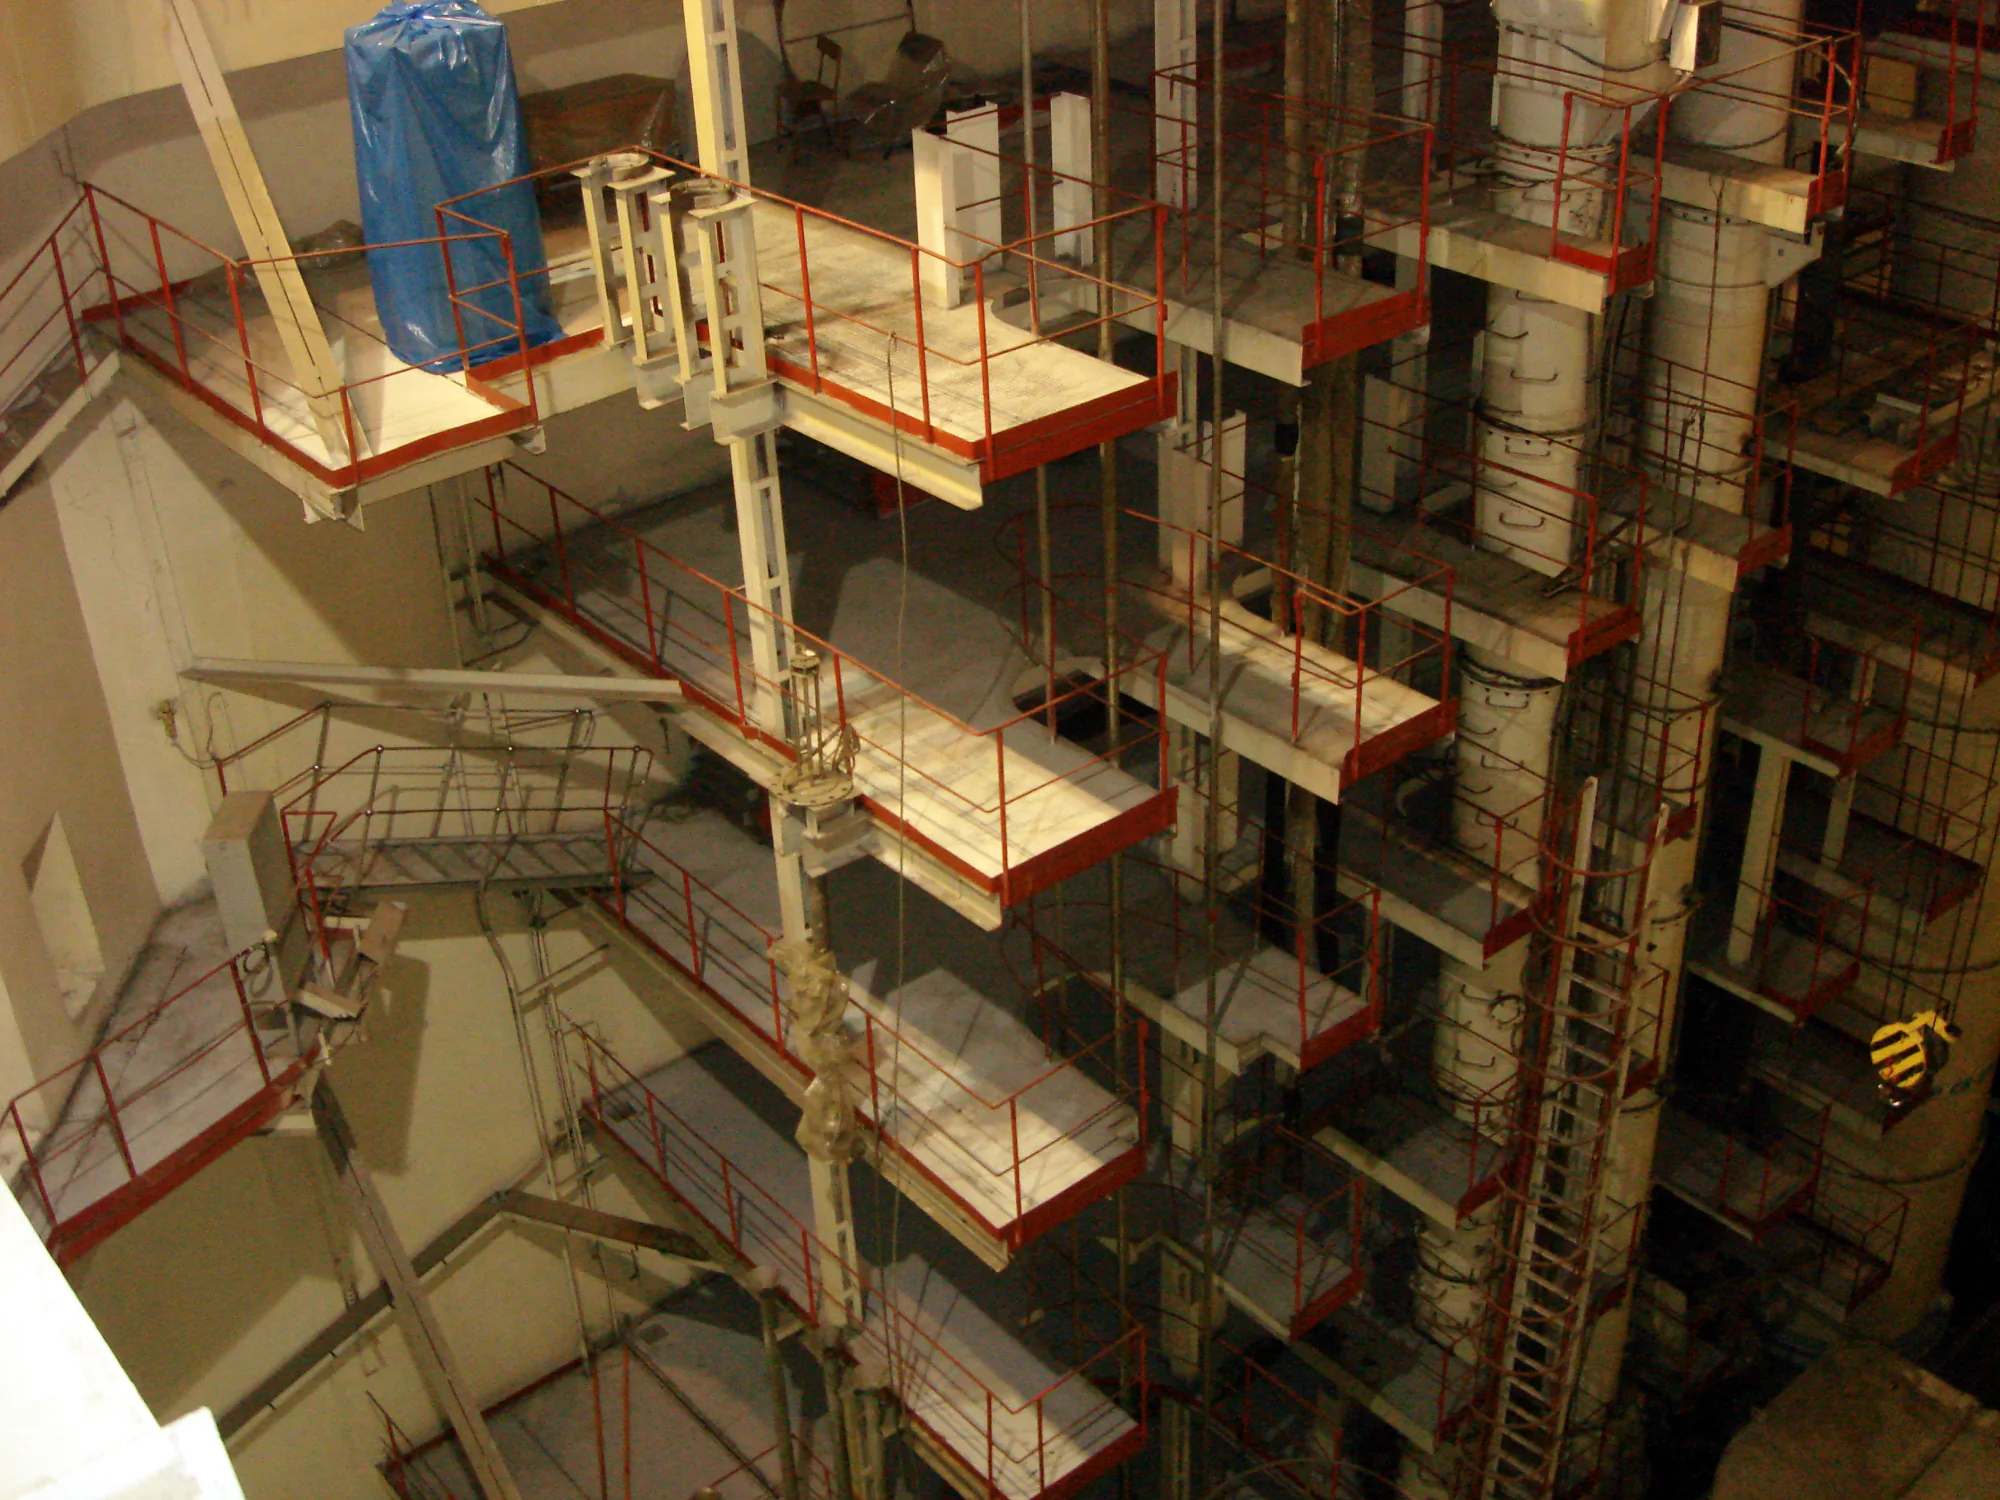
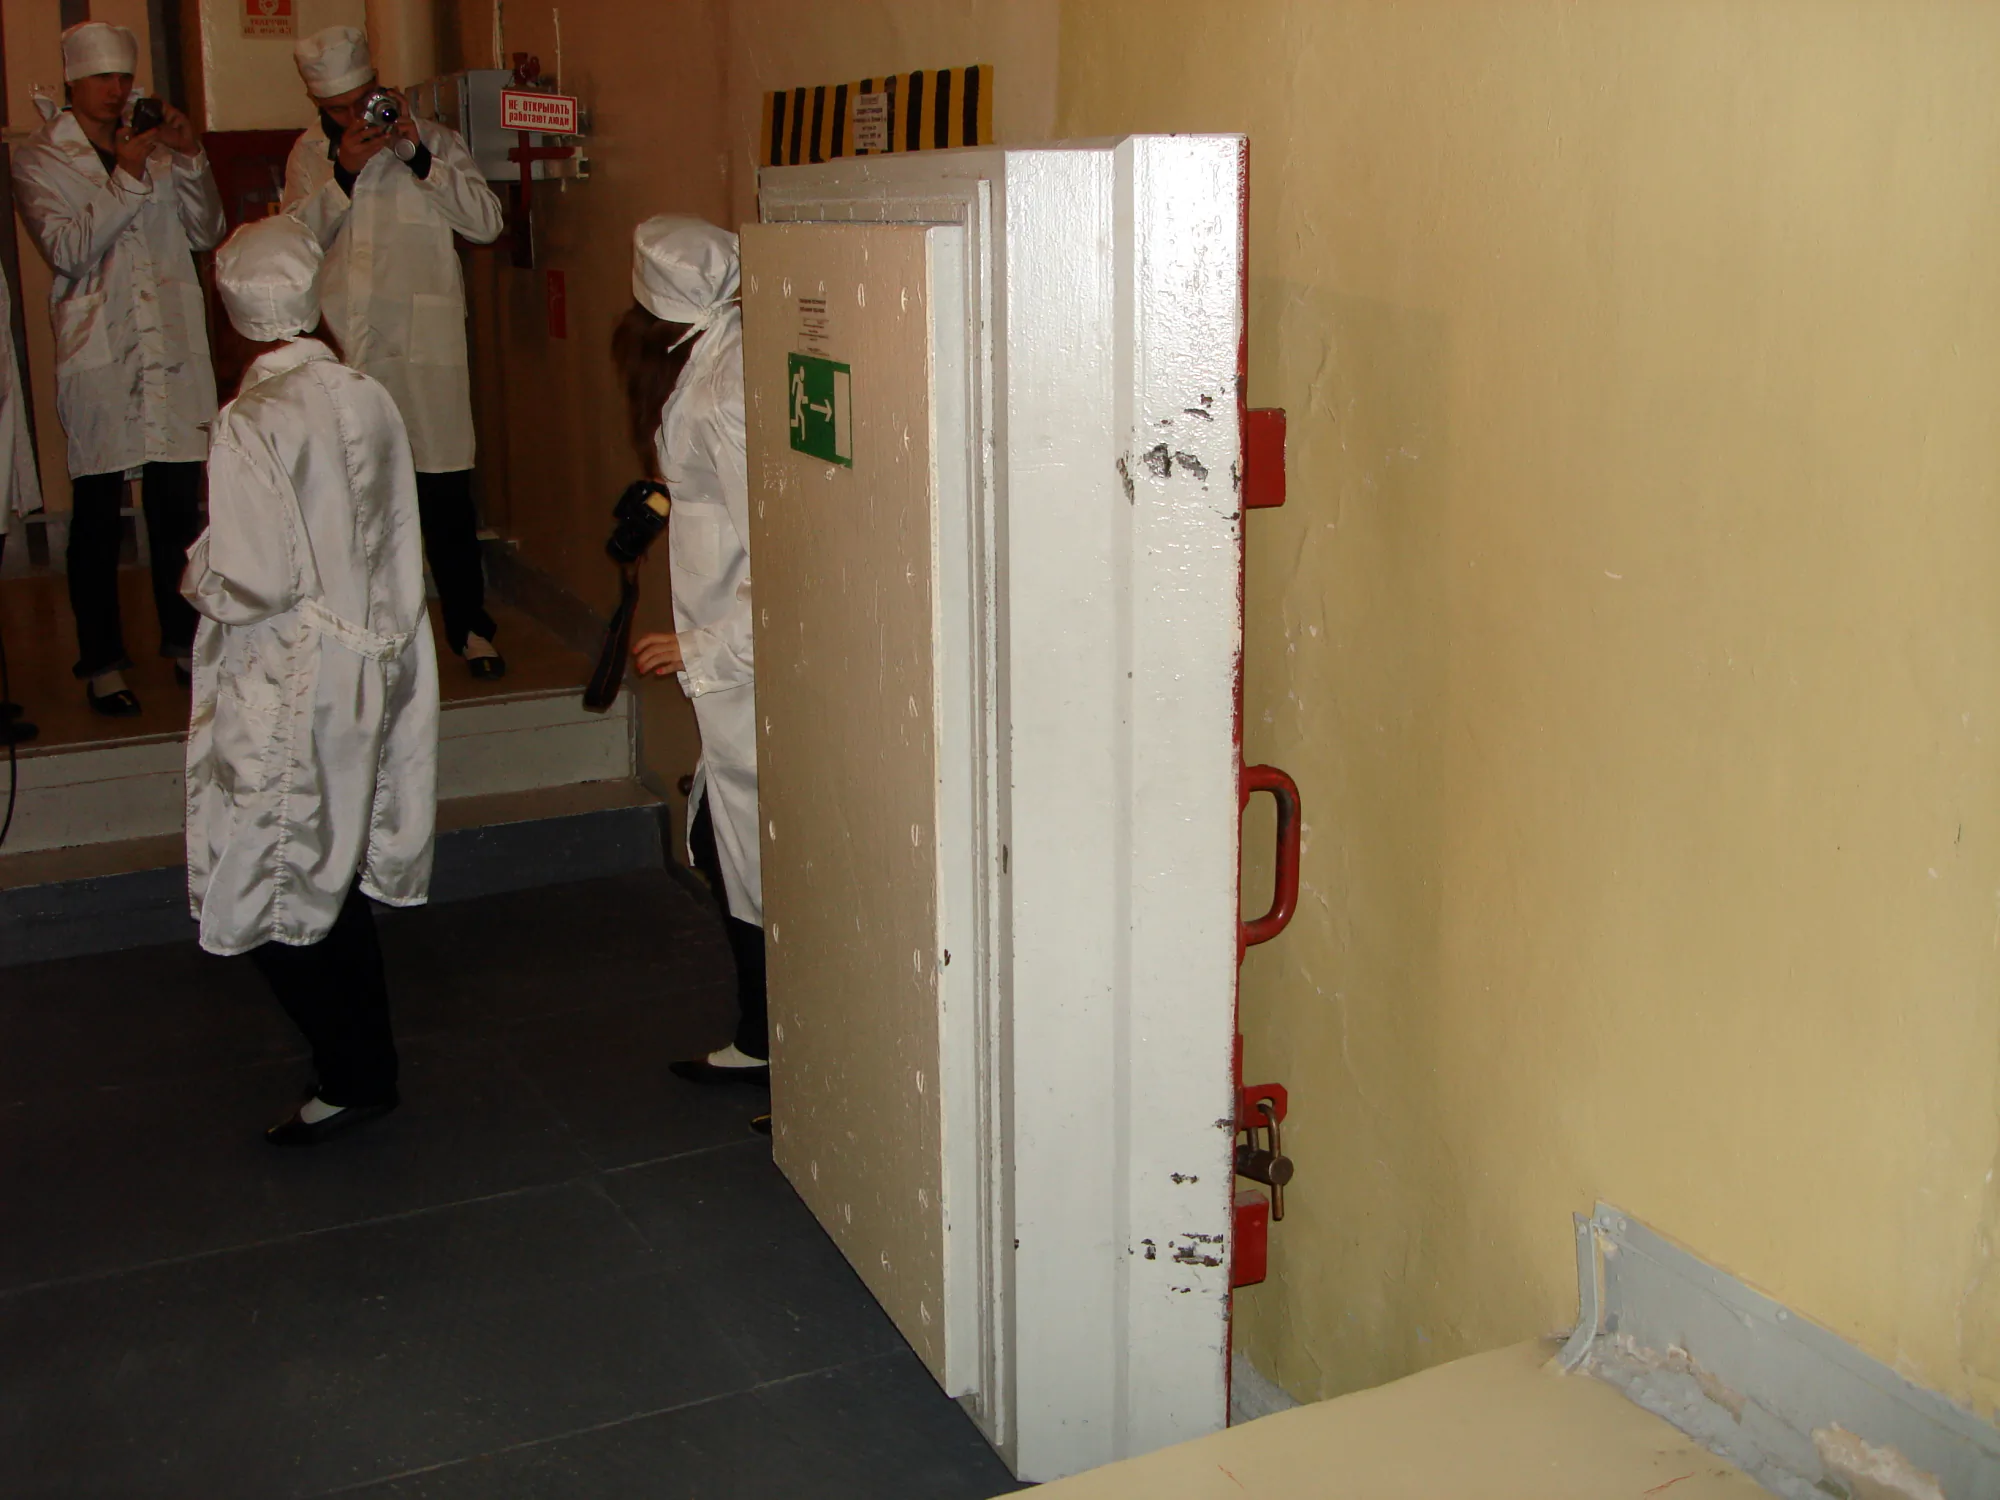
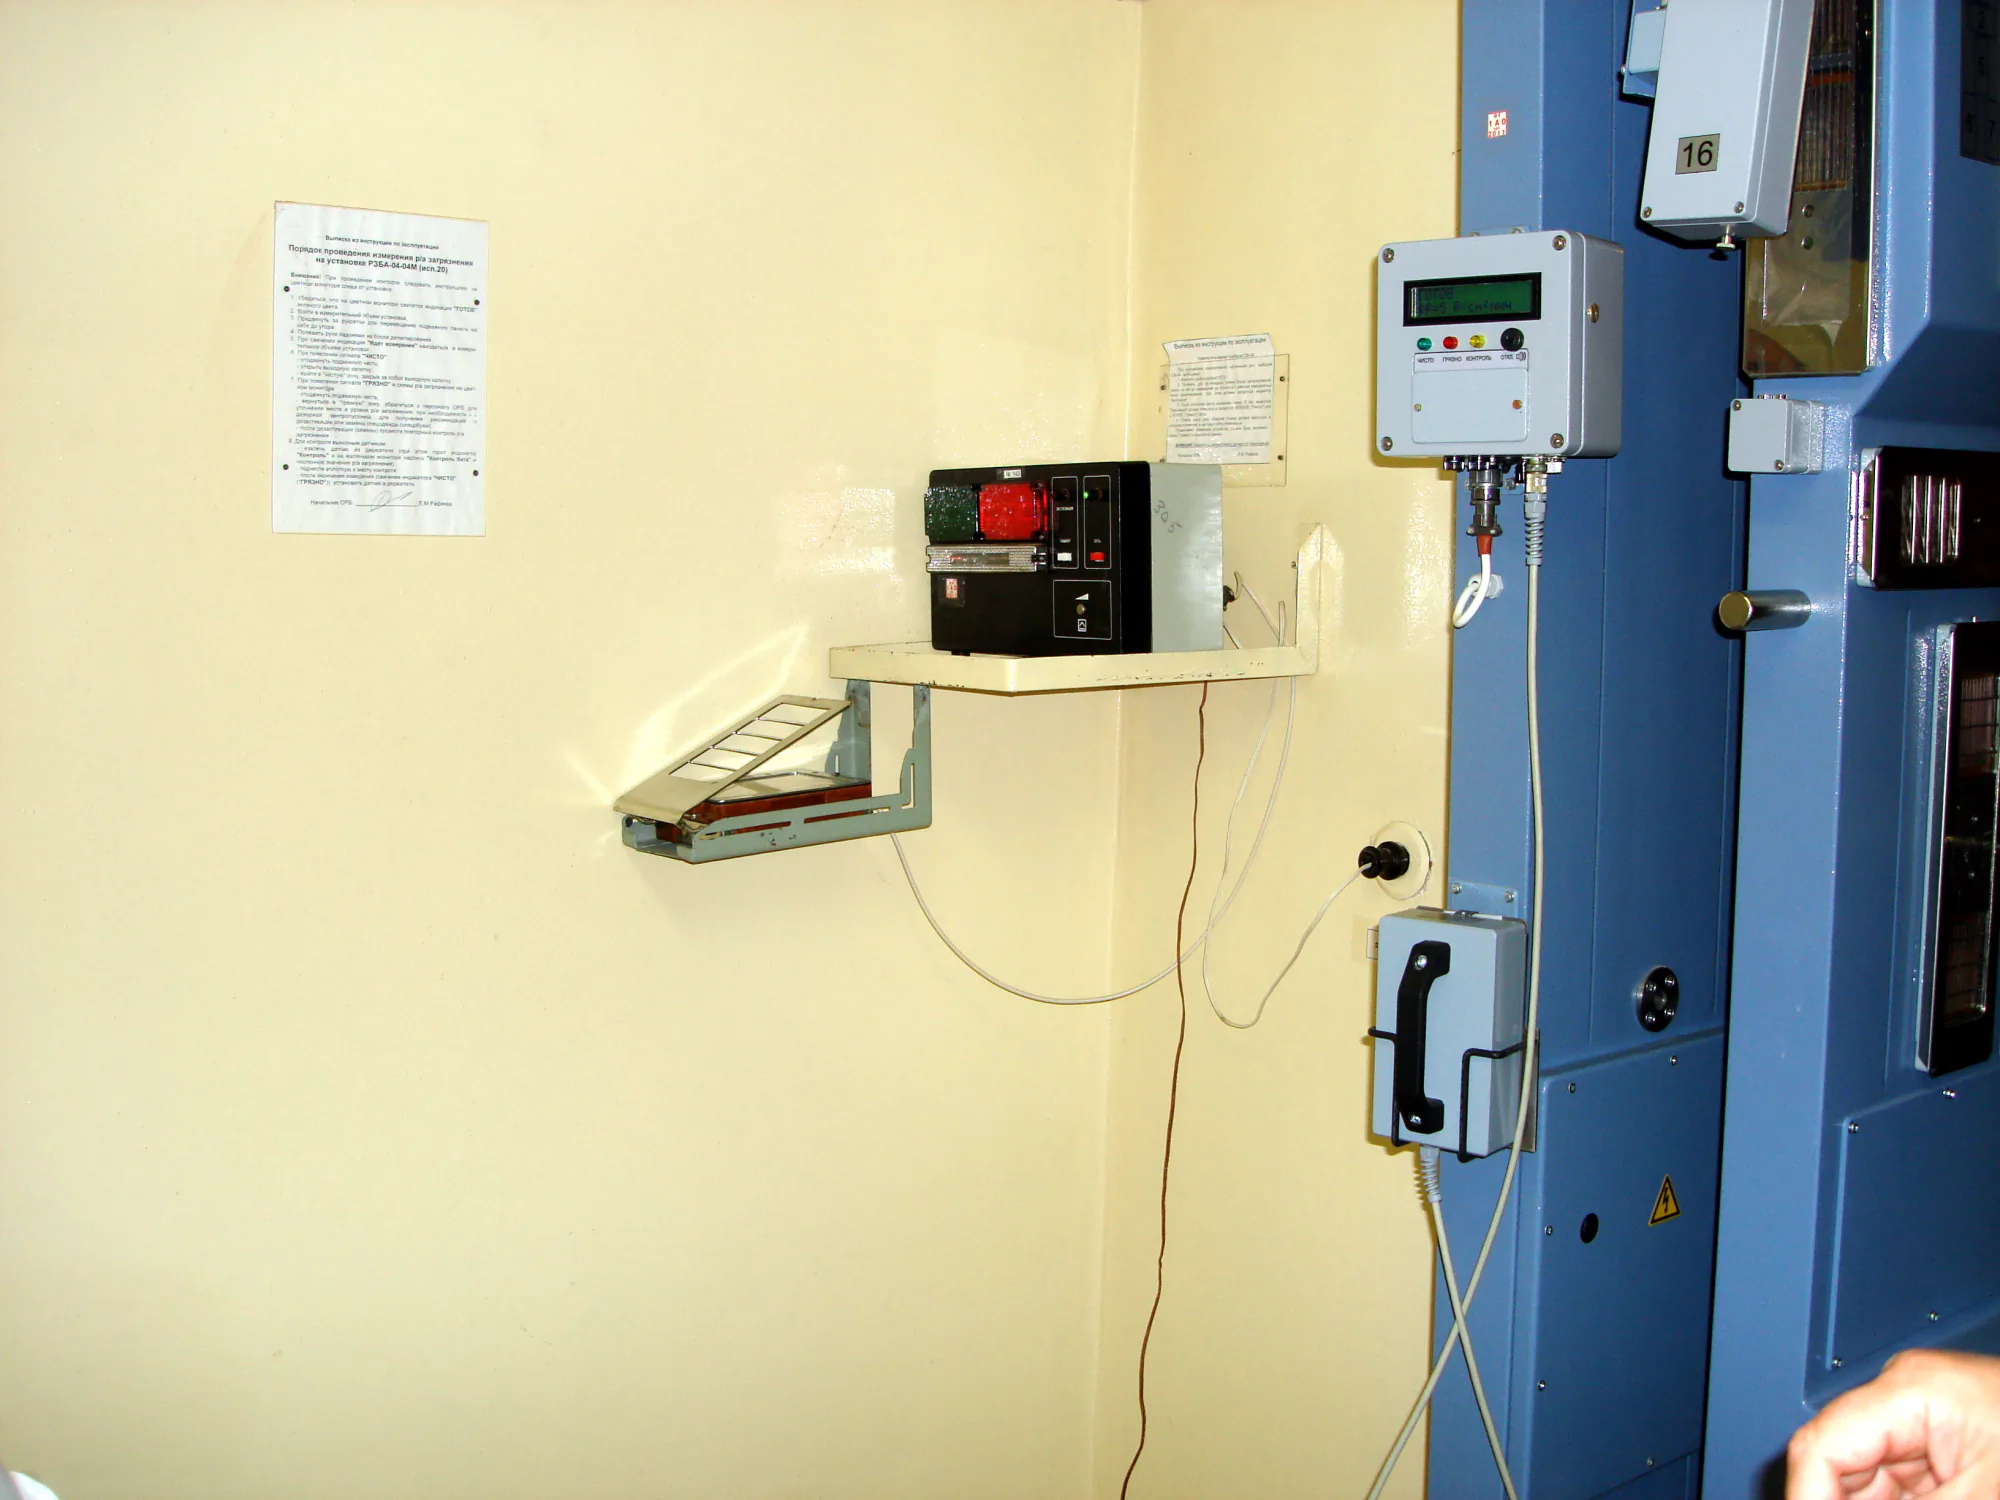
На выходе из реакторного цеха проверка — не принесли ли мы на себе радиацию.
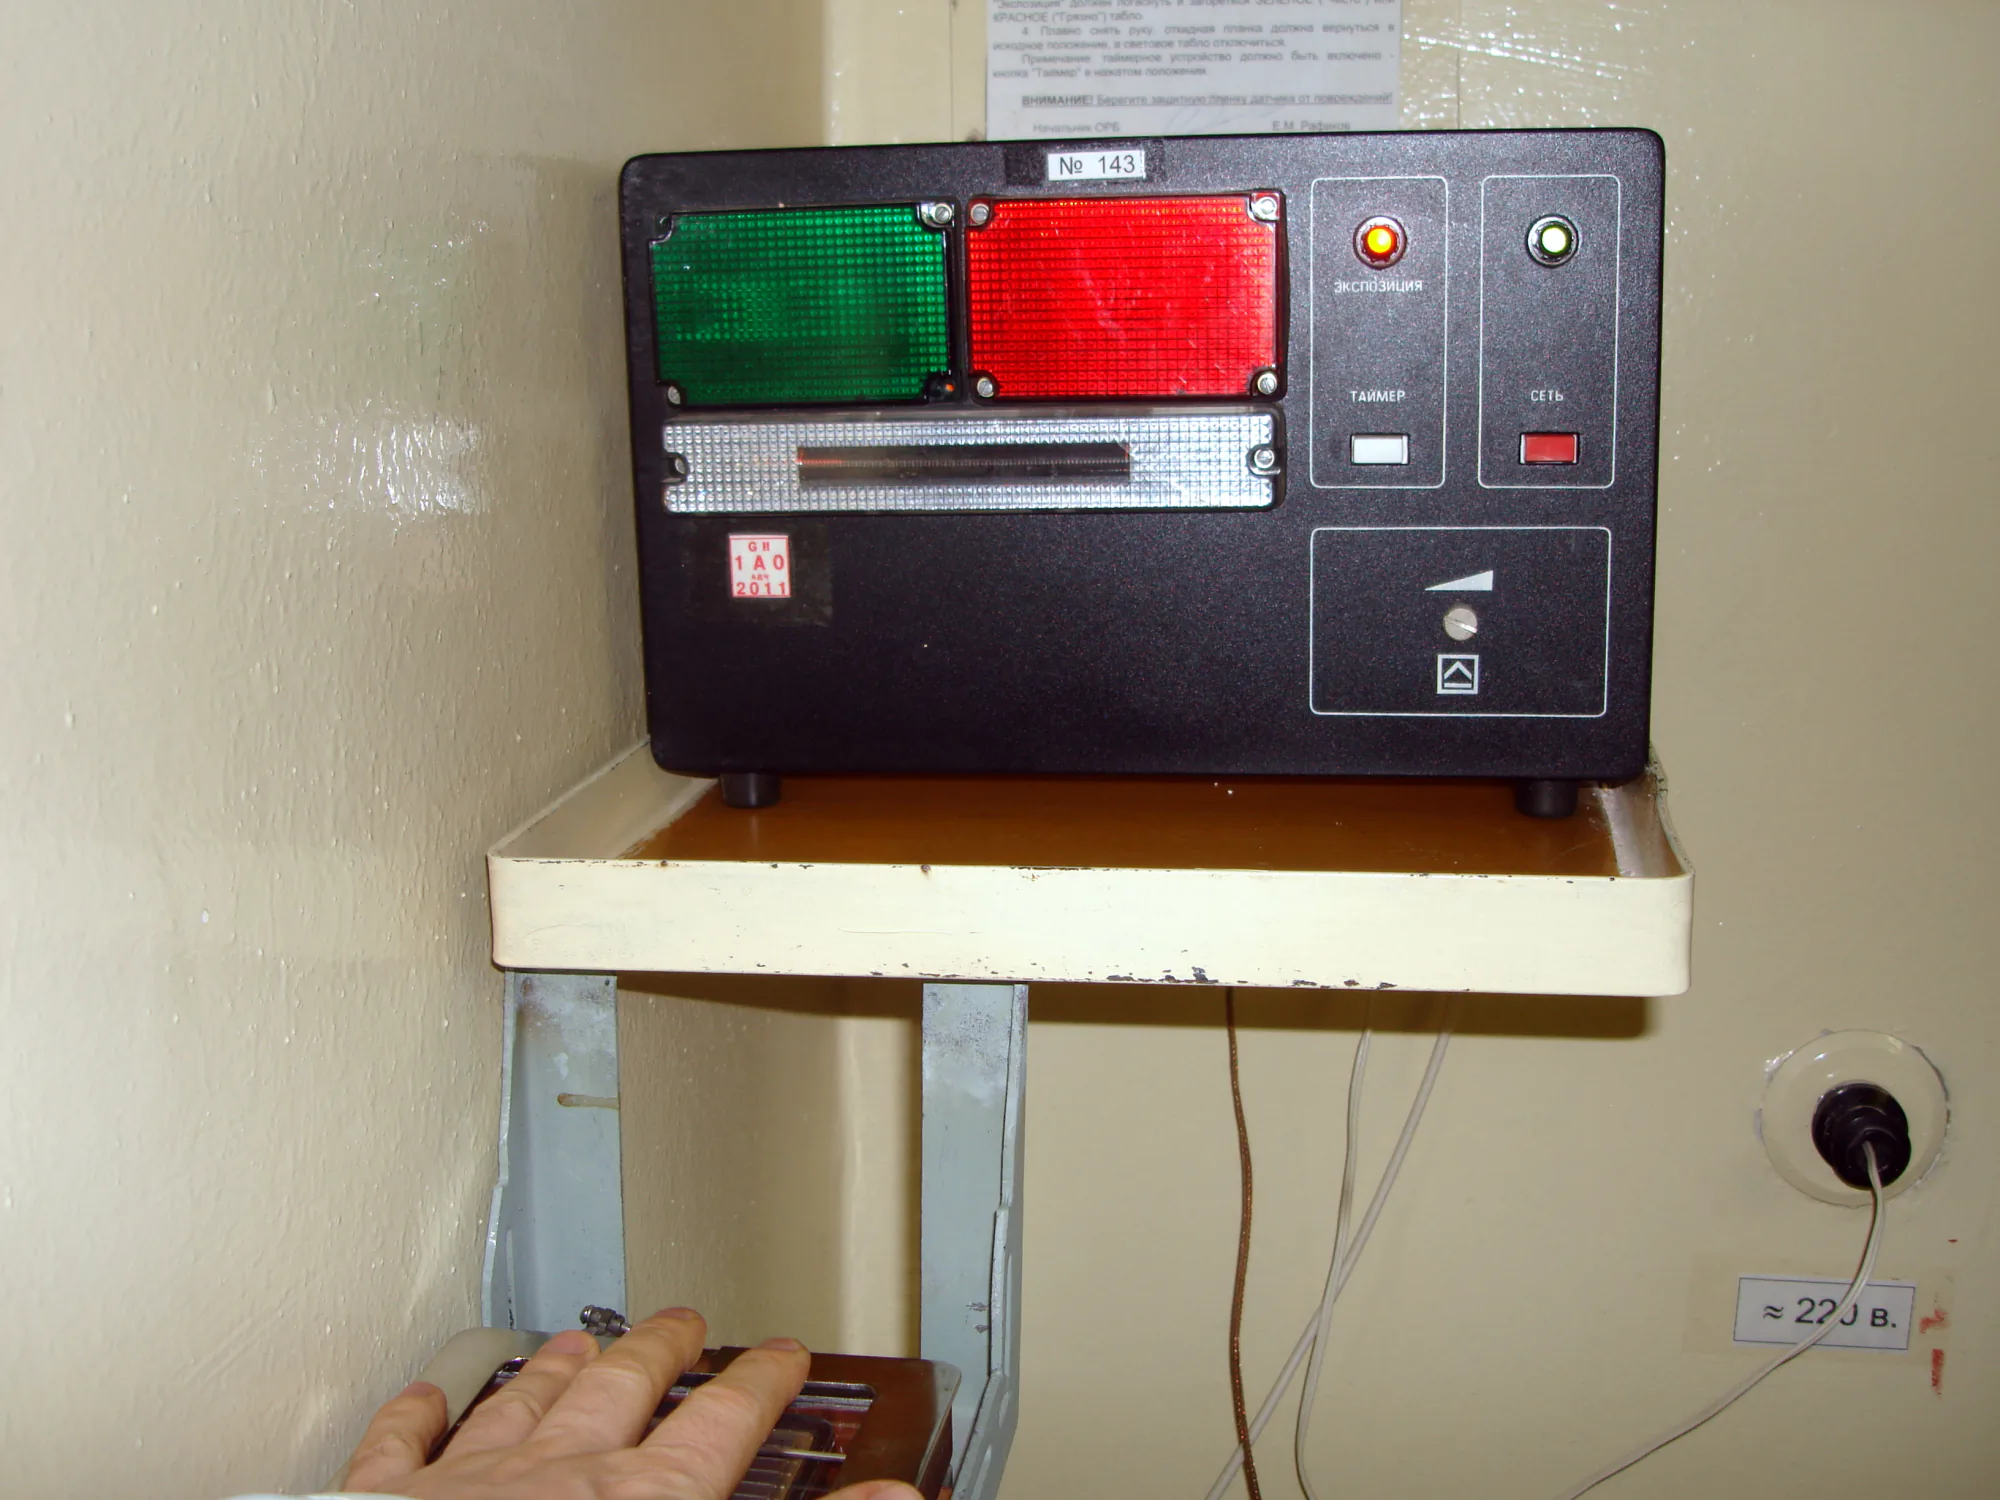
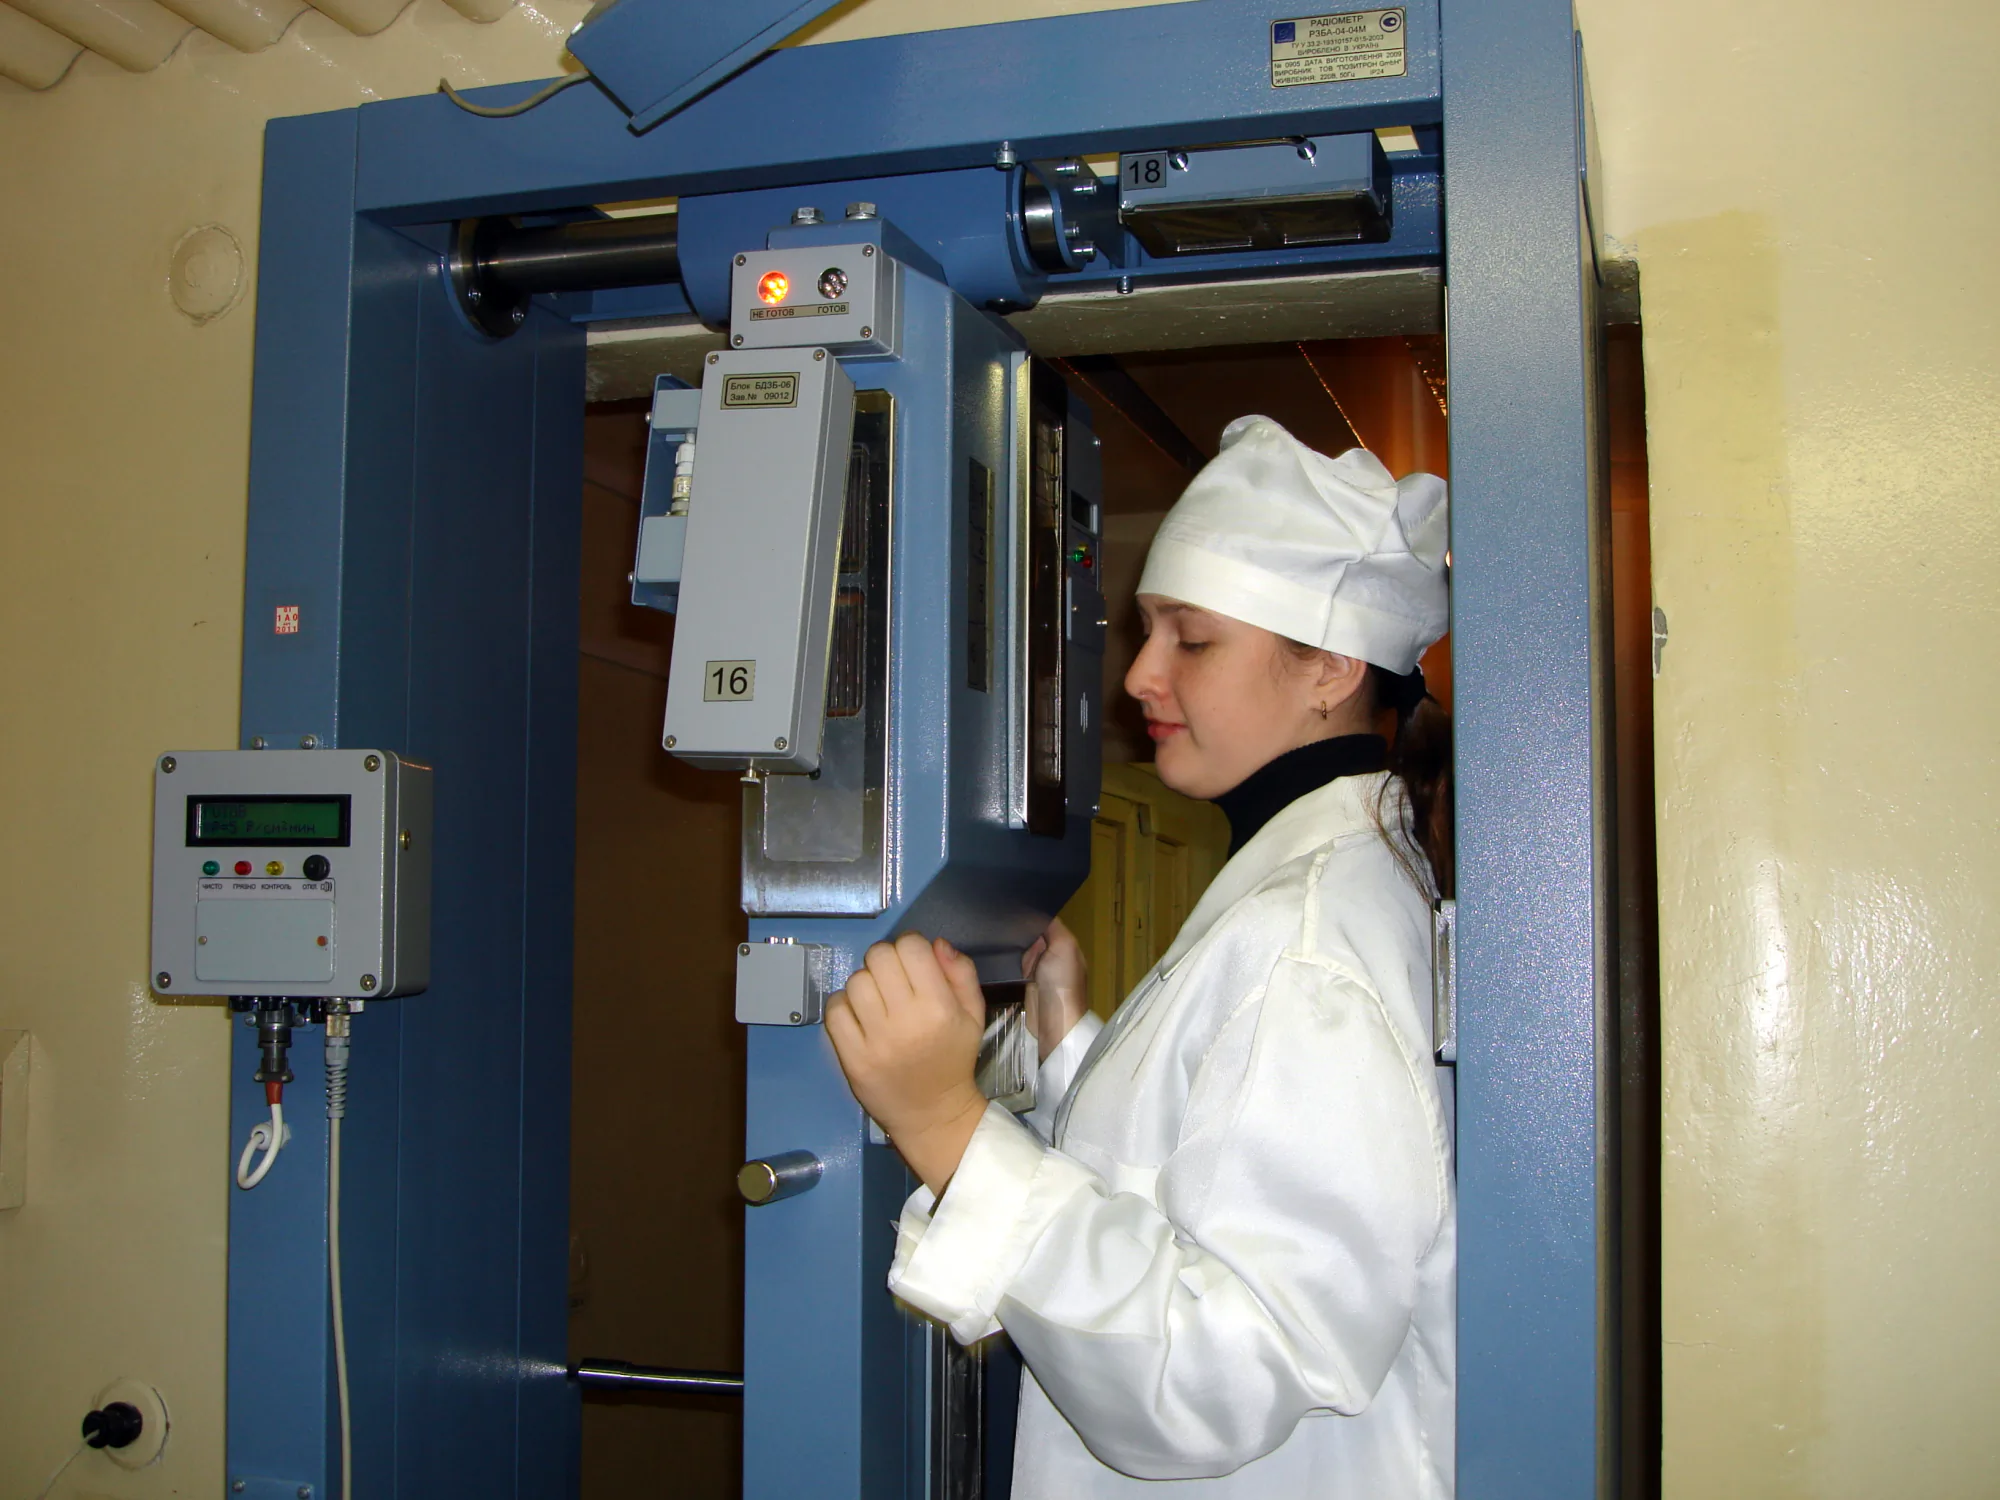
Общие впечатления — один раз съездить на такой объект интересно, в дальнейшем я бы посетил разве что музей в Обнинской АЭС (это первая гражданская АЭС в мире), не сомневаюсь, что остальные станции похожи между собой, на взгляд неспециалиста, как две капли воды.
PHP и UTF-8: четыре с половиной или некоторые функции
Я пока приостановил эпопею
public static function strcmp($str1, $str2) {
    // используется модуль intl
    return collator_compare(collator_create(''), $str1, $str2);
}

public static function strncmp($str1, $str2, $len) {
    return self::strcmp(self::substr($str1, 0, $len), self::substr($str2, 0, $len));
}

public static function strcasecmp($str1, $str2) {
    return self::strcmp(self::strtolower($str1), self::strtolower($str2));
}

static public function ctype_space($text) {
    return preg_match('/^\p{Zs}+$/us', $text);
}
Привожу в качестве иллюстрации того, что не всё так сложно как кажется. Стоит только сесть и начать.
Некоторые функции в PHP уже есть (mb_substr),
И, кстати, в ходе родился замечательный совет: если функцию трудно реализовать (например, str_ireplace), посмотрите, может проще переписать место, где она используется. У меня две функции были использованы ровно по одному разу.
Добавлено позднее: тщательно изучил вопрос сравнения Unicode, я выяснил, что производить сравнение так, как это сделал я нельзя, поэтому функцию strcmp я удалил, буду переписывать. Например, буква «ё» в Unicode стоит дальше «л», а должно быть наоборот.
Добавлено ещё позже: в PHP 5.3 появилось расширение Intl, основанное на известной библиотеке UCI, оказывается это расширение собирается и с PHP 5.2.4+, так что имеет смысл использовать именно его.
PHP и UTF-8: четыре и шесть десятых или ещё проблемные функции
С прошлого этапа я, в данном проекте, был занят тем, что писал
Более простая, но тоже не самая очевидная функция — addcslashes. Она экранирует указанные символы слешем, представляя все символы с кодом большим 128 как восьмеричное число, например, буква «ф» (в кодировке cp1251), если указать её во втором параметре, будет представлена «\364». Вопрос в следующем — символы Ответ в парной функции — stripcslashes. Если последовательно заэкранировать все байты Моя задача — эмулировать поведение функции в точности, в этой связи str_pad содержит две загадки: если задана строка дополнения из двух символов и более, то как аргумент дополняется слева и какая сторона дополняется первой, когда дополнять надо обе стороны? Как видим, сначала дополняется правая сторона, а при дополнении слева символы дополняют в указанном порядке (когда я программировал эту функцию, у меня был соблазн сделать дополнение с конца последовательности). Вообще, в PHP функций с тонкостями поведения масса. Функция wordwrap Дальше
static public function ord($character) {
        if (self::ON) {
            $codes = unpack('N', mb_convert_encoding($character, 'UCS-4BE', 'UTF-8'));
            return reset($codes);
        }

        return ord($character);
    }

    static public function chr($ascii) {
        if (self::ON) {
            return mb_convert_encoding(pack('N', $ascii), 'UTF-8', 'UCS-4BE');
        }

        return chr($ascii);
}bolk@dev:~/daproject$ php -r 'var_dump(str_pad("..", 3, "12", STR_PAD_BOTH));'
string(3) "..1"
bolk@dev:~/daproject$ php -r 'var_dump(str_pad("..", 5, "12", STR_PAD_LEFT));'
string(3) "121.."
«Community»
Только что, в шестнадцатой серии сериала «Сообщество», Абед Надир произнёс, напиваясь, «будем здоровы»
Отличный сериал, кстати. Спасибо всем тем, кто советовал.
Хром → Опера
К сожалению, с «Хрома» (это браузер), к которому я уже привык и который обставил с любовью плагинами, мне придётся пересесть
Но. Недавняя неприятная история, когда в код «Хромиума» (это «Хром», но без «жучков») попал один из «шпионских» модулей, заставляет задуматься — что ещё, по небрежности или умышленно, могла забыть выключить корпорация «Гугл» в своём браузере? Тем более, что ещё на слуху история о том, что «Гугл» собирал данные
Перехожу обратно на «Оперу», других вариантов нет. «Сафари» под Windows — это
Огромные пульты
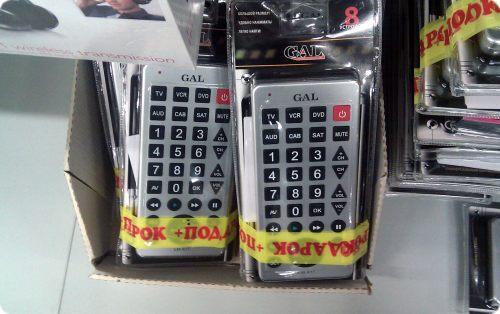
В супермаркете сегодня увидел — универсальный пульт «Gal
Как ни странно, но такого монстра я бы купил. Если бы у меня был телевизор.
Мёртвые японские души
Расследование министерства юстиции Японии не смогло обнаружить 234,354 тысячи человек старше 100 лет, которые по бумагам числятся живыми, в действительности их местопребывание, по обнародованным в пятницу данным, неизвестно.
Ничего загадочного — за кого родственники получали пенсии,
И это министерство проверило только список столетних, если взять возраст младше, неизвестно сколько там таких «зомби». Мне интересно — если отфильтровать умерших, насколько снизится средняя продолжительность жизни в Японии?
НАМИ
Ездил сегодня ремонтировать обогреватель «AirComfort». Ничего обогреватель, простенький, потому и ломаться там особо нечему, спираль перегорела. Так бывает, повёз менять. Пишу себе заметку на будущее, если ещё сгорит. Замену осуществляет ровно одна организация — «Ремсервис», располагающаяся на территории НАМИ (это центральный
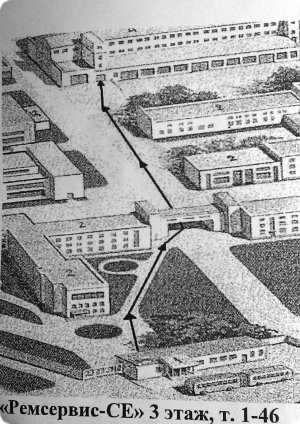
Работает эта печальная организация с 10 до 17 по рабочим дням. С собой надо иметь паспорт и 1000 рублей. С паспортом идём в бюро пропусков, выписываем временный пропуск, по схеме, на третьем этаже находим «Ремсервис». Это организация из трёх человек — принимающей звонки женщины, мастера, который всё ремонтирует и дядьки, который ходит по комнате и разговаривает.
Замена спирали происходит всё в той же печальной комнате, где принимают клиентов и занимает полчаса. Институт находится на ул. Автомоторная, д. 2 (проезд автобусом №123 с метро Речной вокзал).
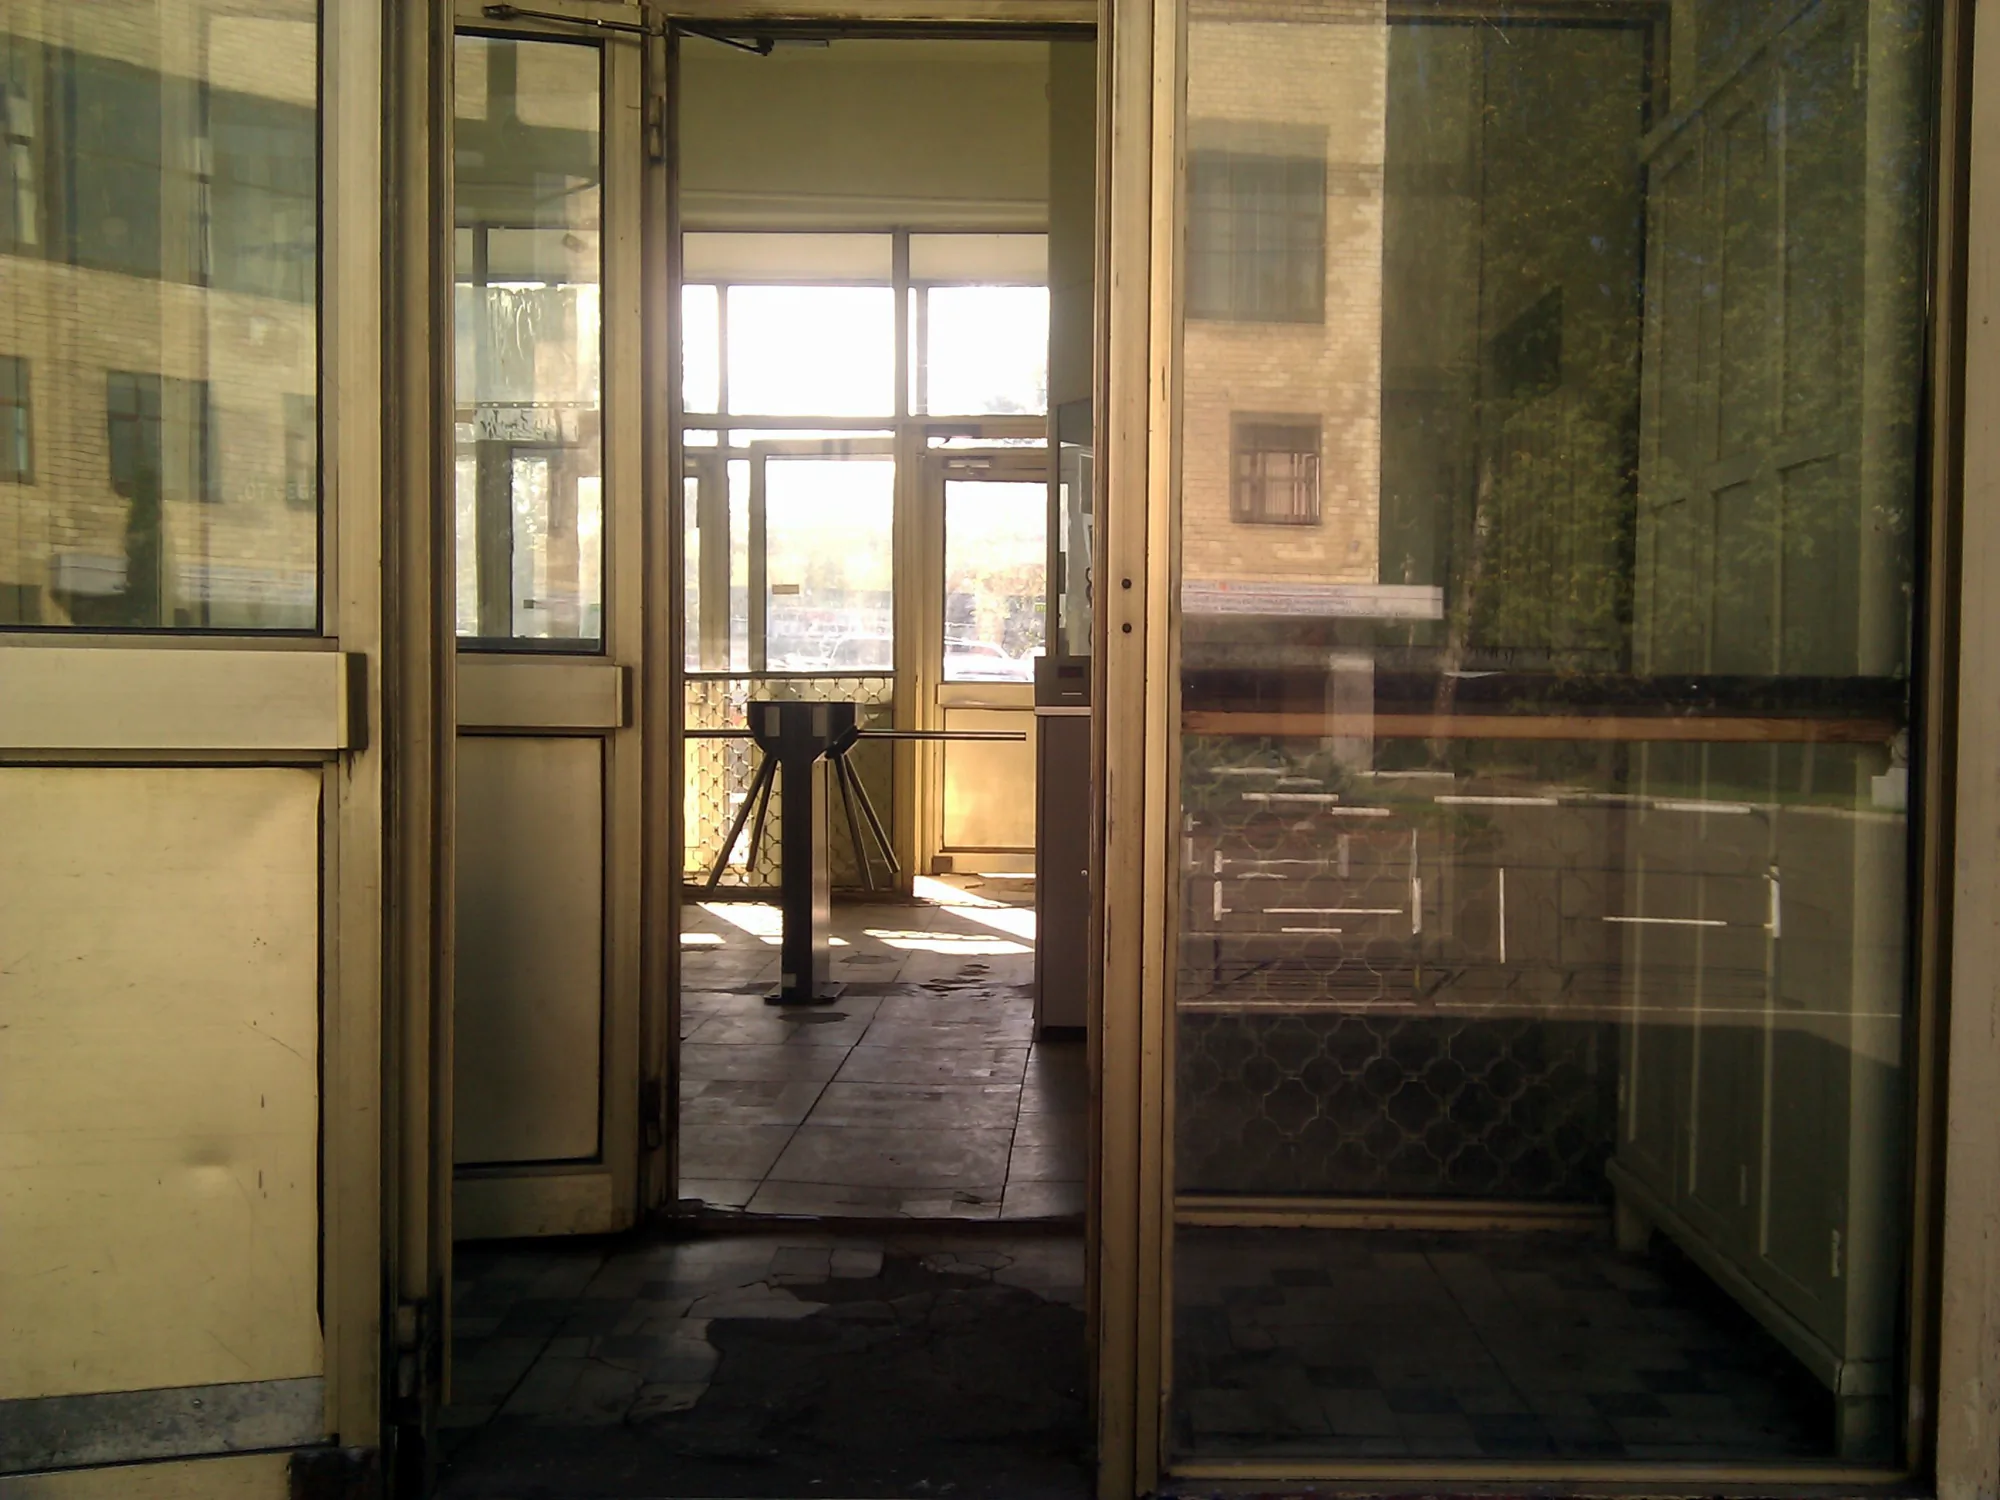
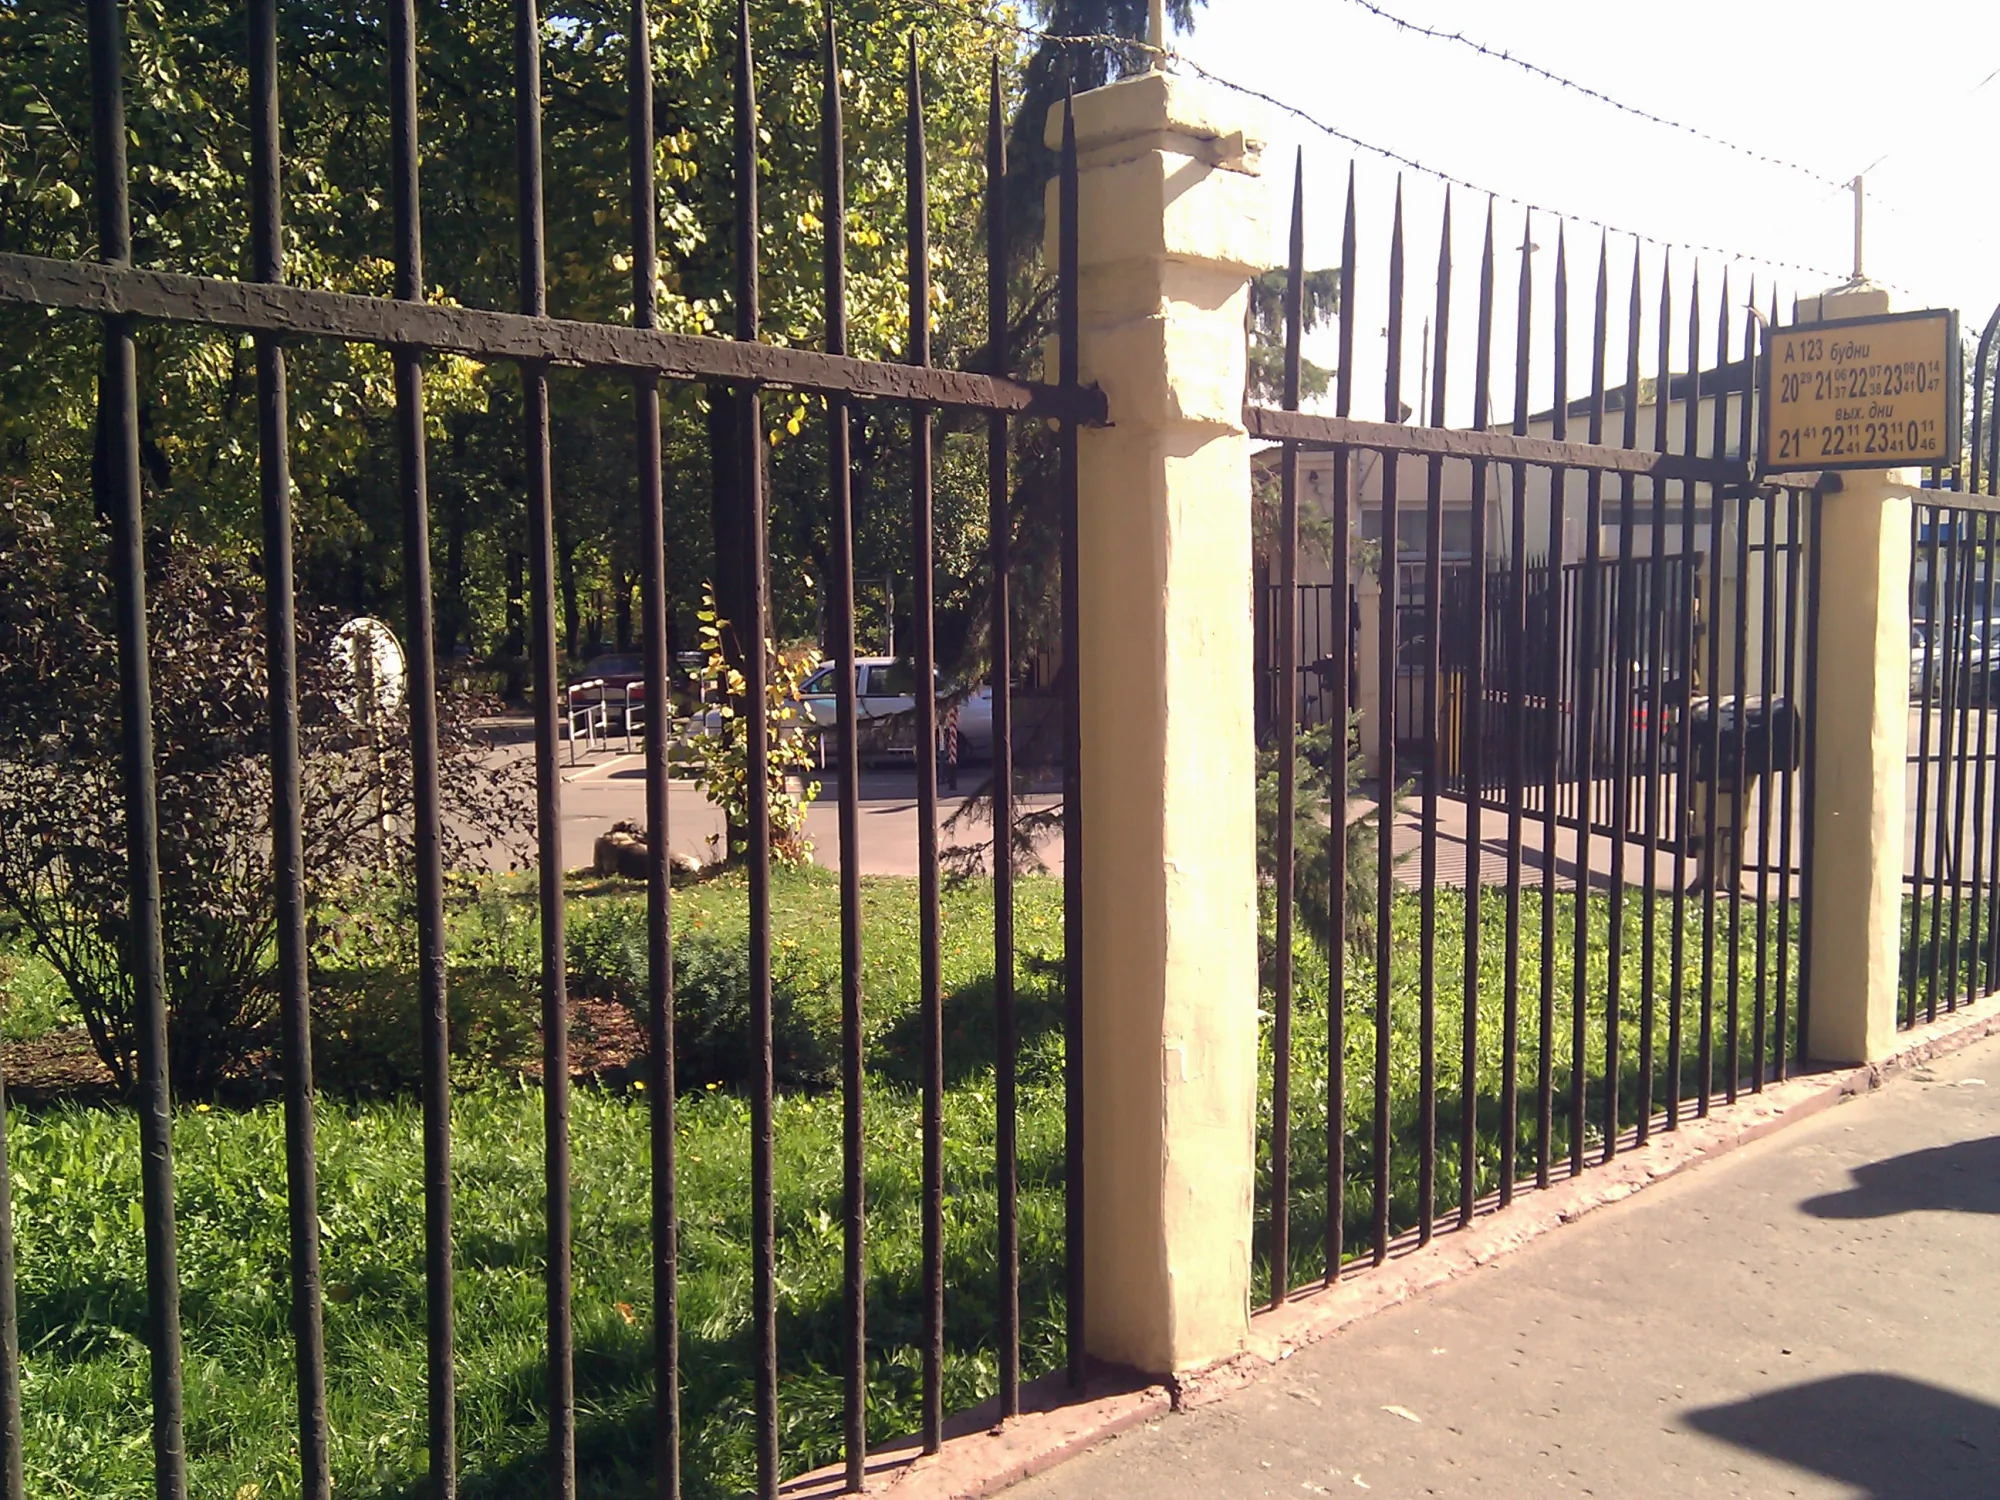
Вообще НАМИ прекрасный образец «усадьбы разорившегося помещика» — видно, что денег
Дополнение: нагревательный элемент поставили хуже, чем тот что бы. Новый светит куда больше старого, соответственно, греет меньше.
PHP и UTF-8: пятый этап
Итак, пятый этап. Точнее на этап, он, пожалуй, не тянет, но после этапов 4,5 и 4,6 мне хочется целых чисел.
В самом деле, если простое взятие символа по индексу в строке с фиксированным размером символа имеет сложность O(1), то Я написал небольшие тесты. Замерял три прохода по тексту объёмом 187,5КБ. Проход по строке с однобайтной кодировкой — 0,2 секунды, по строке Так вот, одна из вещей, которой мало кто пользуется — возможность создать в PHP свой итератор. У меня тут не руководство по итераторам, поэтому я ограничусь лишь кодом и примером использования. Основная идея — если мы двигаемся по строке последовательно, Использовать итератор достаточно просто: Так как в итерации сначала вызывается «current», а потом «next» мне показалось странным терять информацию о положении следующего символа, которую мы в «current» уже знаем, так что я передаю её в «next» через защищённое свойство. Список функций (из моего списка используемых функций), которые я перепишу с итератором (или скорость которых увеличится): trim, ltrim, rtrim, wordwrap, strcspn и strspn, а так же некоторые места в коде проекта.Итак, пятый этап
class UtfString implements Iterator
    {
        protected $str;   // строка
        protected $idx;   // бинарный индекс строки
        protected $pos;   // UTF-8-индекс
        protected $len;   // бинарная длина
        protected $next;  // бинарный указатель на следующий

        protected $idx_start; // бинарный индекс откуда стартуем
        protected $pos_start; // UTF-8-индекс откуда стартуем

        // проверка — байт не является началом символа
        protected function isNotBegin($ch)
        {
            return (ord($ch) & 192) == 128;
        }

        public function __construct($str, $pos_start = 0)
        {
            $this->str = $str;
            $this->pos = $this->pos_start = $pos_start;
            $this->len = strlen($str);
            $this->next = null;

            if ($pos_start) {
                for ($i = 0; $i<$pos_start; $i++) {
                    $this->idx_start++;

                    while ($this->isNotBegin($this->str[$this->idx_start])) {
                        $this->idx_start++;
                    }
                }
                $this->idx = $this->idx_start;

            } else {
                $this->idx = $this->idx_start = 0;
            }
        }

        public function current()
        {
            $idx = $this->idx;
            $out = $this->str[$idx++];

            while ($this->isNotBegin($ch = $this->str[$idx])) {
                $out .= $ch; // быстрее, чем массив!
                $idx++;
            }

            $this->next = $idx;

            return $out;
        }

        public function key()
        {
            return $this->pos;
        }

        public function next()
        {
            $this->pos++;

            if ($this->next) {
                $this->idx  = $this->next;
                $this->next = null;
            } else {
                for ($this->idx++; $this->isNotBegin($this->str[$this->idx]); $this->idx++);
            }
        }

        public function rewind()
        {
            $this->idx = $this->idx_start;
            $this->pos = $this->pos_start;
        }

        public function valid()
        {
            return $this->idx < $this->len;
        }

        public function __toString()
        {
            return $this->str;
        }
}$str = str_repeat('Привет', 64000);
foreach (new UtfString($str) as $position => $char) {
// …
}
Гостиница «Которосль» в Ярославле
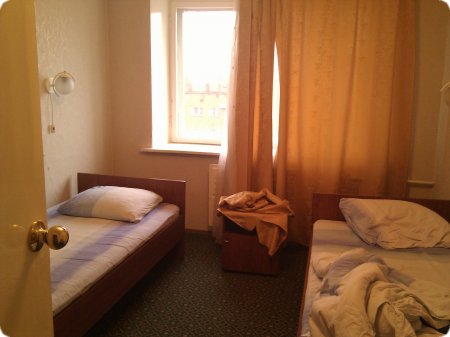
Номер категории «Люкс» в гостинице «Которосль» — это, ребята, сидячая ванна, механические замки, шумный холодильник «Смоленск» (этакий отбойный молоток в ночи), отсутствие халата, зубной щётки, мусорки, сейфа и интернета. Правда мебель чистенькая и новая, хотя и тошнотворная, но я не понимаю почему это называется «Люкс». Чего тут «люксового»?
Добавлено на следующий день: вот так выглядит спальня в номере, обратите внимание на оригинальную конструкцию лампы. Нет, это не реализация идей Тесла по беспроводной передачи электричества, это просто провод обрезан.
Кстати, на конференции ADD, где я сейчас нахожусь, Windows 7 отказалась подключаться к интернету, пришлось на телефоне («Андроид» подключился без проблема и сразу) посмотреть выданный
PHP4 без XML-парсера
Мне тут по работе пришлось решить странную, по нынешним временам задачу — принимать XML в программе на PHP4.3+, где никакого парсера XML может не оказаться. Таковы реалии продукта и среды, где он будет использоваться (это код внешнего проекта). Поэтому мне пришлось написать небольшой парсер, который, правда, расcчитывает, что XML будет
В качестве иллюстрации я использую в коде крайне простую функцию, которая не строит дерево, а просто собирает вызовы в массив, но понятно, что собрать дерево тоже ничего не стоит.Дальше
<?
// Very Simple XML SAX Parser by Evgeny Stepanischev
// /
class VerySimple_XMLParser
{
    var $saxCallback;

    function VerySimple_XMLParser($saxCallback)
    {
        $this->saxCallback = $saxCallback;
    }

    function parse($xml)
    {
        if (preg_match_all('#<![CDATA[.*?]]>|</?[^>]*>|[^<]+#us', $xml, $matches)) {
            foreach ($matches[0] as $match) {
                $this->parseThis($match);
            }
        }
    }

    function parseThis($match)
    {
        $calls = array(
            '<!--'      => 'COMMENT',
            '<?'        => 'PI',
            '<![CDATA[' => 'CDATA',
            '<!'        => 'DTD',
            '</'        => 'TAGCLOSE',
            '<'         => 'TAGOPEN',
        );

        foreach ($calls as $need => $type) {
            if (strpos($match, $need) === 0) {
                return $this->parseByType($type, $match);
            }
        }

        return $this->parseByType('OTHER', $match);
    }

    function parseByType($type, $text)
    {
        if ($type == 'COMMENT') {
            return $this->addChunk($type, substr($text, 4, -3));
        }

        if ($type == 'CDATA') {
            return $this->addChunk('TEXT', substr($text, 9, -3));
        }

        if ($type == 'OTHER') {
            return $this->addChunk('TEXT', $text);
        }

        if ($type == 'TAGCLOSE') {
            $end = strcspn($text, ' >');

            return $this->addChunk('TAGCLOSE', substr($text, 2, $end - 2));
        }

        if ($type == 'TAGOPEN') {
            $this->addChunk('TAGOPEN', $this->parseTag($text));

            if (substr($text, -2) == '/>') {
                $end = strcspn($text, ' >');

                return $this->addChunk('TAGCLOSE', substr($text, 1, $end - 2));
            }
        }

        return '';
    }

    function parseTag($text)
    {
        $end = strcspn($text, ' />');
        $name = substr($text, 1, $end - 1);

        return array($name, $this->parseTagAttributes(substr($text, $end)));
    }

    function parseTagAttributes($text)
    {
        $nameStart = '(?:[A-Za-z_:]|[^\x00-\x7F])';
        $nameChar  = '(?:[A-Za-z0-9_:\.-]|[^\x00-\x7F])';
        $attrValue = '(?:\'[^\']*\'|"[^"]*")';

        if (preg_match_all("/{$nameStart}{$nameChar}*=$attrValue/us", $text, $matches)) {
            return $this->parseAttributes($matches[0]);
        }

        return array();
    }

    function parseAttributes($rawAttributes)
    {
        $attributes = array();

        foreach ($rawAttributes as $rawAttr) {
            list($name, $value) = explode('=', $rawAttr, 2);
            if ($value[0] == '"' || $value[0] == "'") {
                $value = substr($value, 1, -1);
            }

            $attributes[$name] = $value;
        }

        return $attributes;
    }

    function addChunk($type, $arg)
    {
        call_user_func($this->saxCallback, $type, $arg);
    }
}

// Пример использования

$xml =<<<XML
<!-- комментарий -->
<?xml version="1.0"?>
<root attribute="a.a" v="a">
    <v><![CDATA[data]]></v>
    <v>data</v>
    <v/>
</root>
XML;

// Понятно, что можно написать класс и передать в качестве
// callback в парсер метод объекта, но я для простоты, как пример,
// написал очень простую функцию
function VerySimple_XMLParser_Collector()
{
    static $tree = array();

    if (func_num_args() == 2) {
        $tree[] = func_get_args();
    } else {
        return $tree;
    }
}

$sax = &new VerySimple_XMLParser('VerySimple_XMLParser_Collector');
$sax->parse($xml);

echo '<plaintext>';
var_dump(VerySimple_XMLParser_Collector());
IE9 и его скорость, по сравнению с другими браузерами
Сижу сейчас на семинаре Михаила Черномордикова из Microsoft «HTML5, CSS3 и новый Internet Explorer 9». На экране — известный тест Flying Images, который Михаил демонстрирует в IE9 бета1 и FF 4 (неизвестной) бете.
У IE9, судя по всему сильное преимущество. Я
Скачал FF 4 beta7pre, включил в конфигурации всё, что относится к аппаратному ускорению, потестировал. В общем, Microsoft… вводит нас в заблуждение (как и статья на «Хабре»). FireFox явно впереди, хоть и незначительно.
Пасхальное яйцо в Lixil CMS
Сегодня я случайно обнаружил один из сайтов на той CMS и оказалось, что пасхальное яйцо до сих пор работает, его можно увидеть, если послать
Картинку можно увидеть только в IE, так как не выдаётся
data:text/html,<img src="//old.teletrade.ru/?LRPC=90&args={}">Вставлял я этот кусок кода ради теста — найдут ли программисты компании его в коде и смогут ли понять что он делает.
Bitrix WTF
Я сейчас в Ярославле слушаю доклад по клиентским сертификатам.
Рядом со мной сидит Коля Мациевский, он один из первых в России начал комплексно исследовать вопрос оптимизации загрузки сайтов и владеет сейчас первой в России компанией «WeBo», которая этим занимается. Коле скоро выступать, а пока он ковыряет исходники своего продукта, а точнее плагина, который встраивает упомянутый продукт в CMS «Bitrix».
Причина в том, что внутренний антивирус «Bitrix»
$ll = strlen(bin2hex($this->body))/2;

if($ll > 500)
{
    $val = 9;
    $r += $val;
    $this->resultrules['rulescriptlenghts_sl'] = $val;
    return $r;//только одно правило из блока
}
Вот эта странная во всех отношениях (почему не просто strlen?) проверка считает вирусным любой
3G в Ярославле
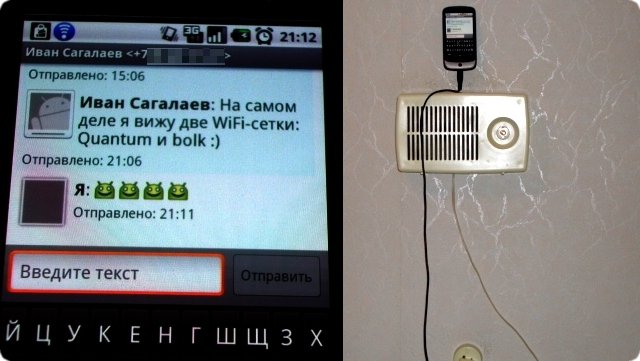
Ловил два дня 3G в Ярославле. Кстати, да. В номере «Люкс» есть радиоточка!
House M.D.
Сериал «Сообщество» мы посмотрели ещё на прошлой неделе, начали «Доктора Хауса». В шестой серии первого сезона, в отражении стеклянной двери смутно видно съёмочную группу.
Тонкости heredoc в PHP
В PHP, как и в некоторых других языках (Bash, Perl) есть конструкция heredoc — это способ задать многострочную строку. Посмотрите как удобно, не нужно экранировать кавычки:
// это PHP
$str = <<<STR
Привет, я строка "в кавычках",
'в апострофах'.
STR;
Но меня всегда раздражало, что завершающий ограничитель приходится прижимать к левому краю, пробел и табуляция дают ошибку (хотя в Perl относительно недавно разрешили делать отступы для этой конструкции).
Сегодня, в очередной раз раздражаясь по этому поводу, я решил попробовать использовать неразрывные пробелы (Alt Right+Space в раскладке Бирмана), получилось, работает даже в PHP 4.4.4. Подходит, конечно, для исходников в кодировке
Правда, строки внутри, конечно, менять нельзя, но эта конструкция часто используется вместе с HTML, а ему отступы неинтересны.
$str = <<<    HTML
    <table>
        <tr class="row"><td>'Привет'</td></tr>
    </table>
    HTML;
Только не забудьте, что отступы надо делать и в начальной конструкции, и в конечной.
Ярославль
Ярославль — город, входящий в Золотое кольцо России, наверняка, один из красивейших городов России, жаль у меня не было времени в этом убедиться. Надо будет приехать туда летом.
Ранней осенью, в наших климатических условиях редкий город выглядит достойно. Ярославль под зябким осенним дождём выглядит так же неприглядно, как и любой другой российский город в грязи, мокрых листьях под пасмурным солнцем.
Любить окружающую действительность мне в такую погоду трудно, а город, который в такой момент является частью этой действительности — ещё сложнее. Ярославлю — 1000 лет, об этом в городе написано на каждом столбе, но праздника в городе не ощущается.
Я помню празднование наглого тысячелетия в Казани

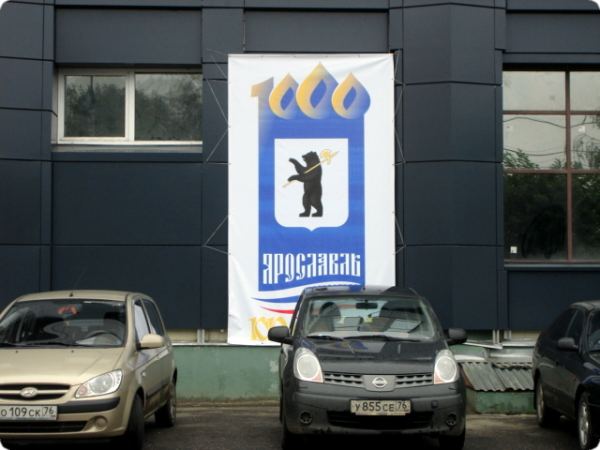
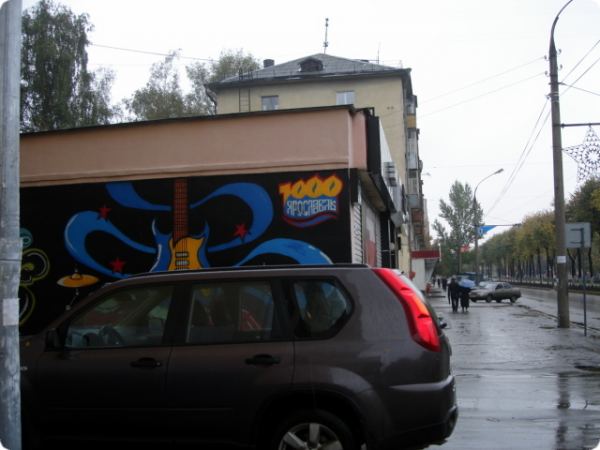
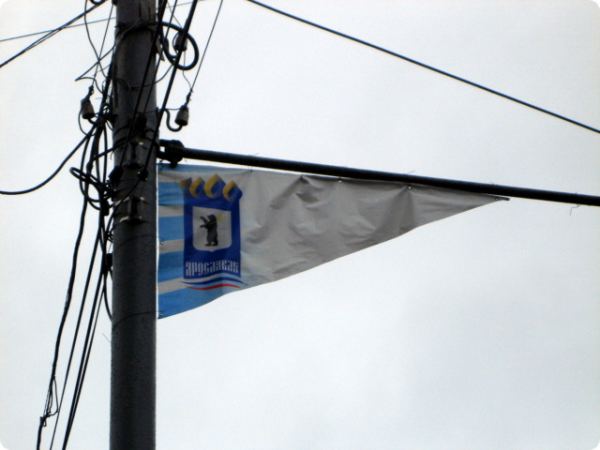
Я люблю думать, гуляя по улицам
Кажется, в Ярославле всё те же не прополотые корни прошлого, что и в Москве…
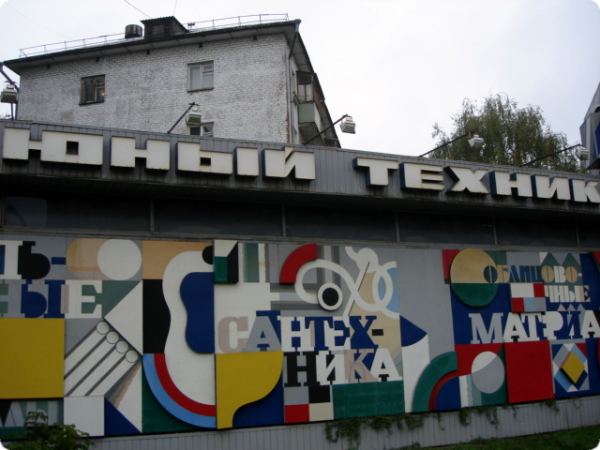
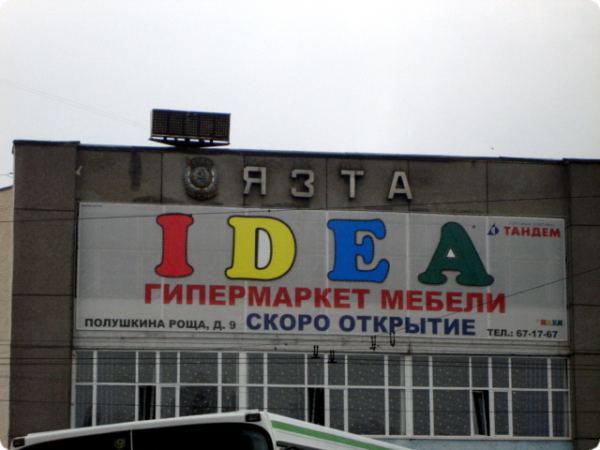
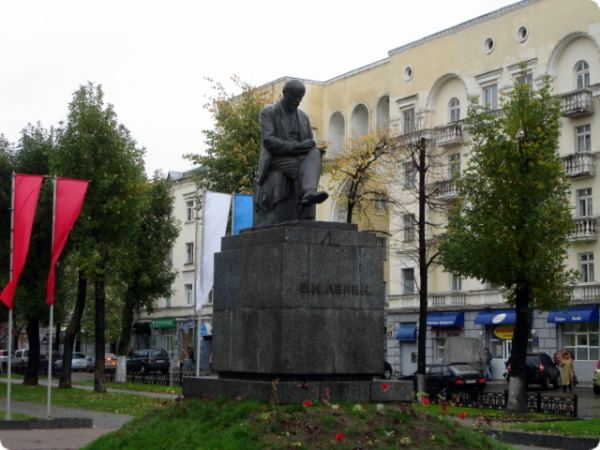
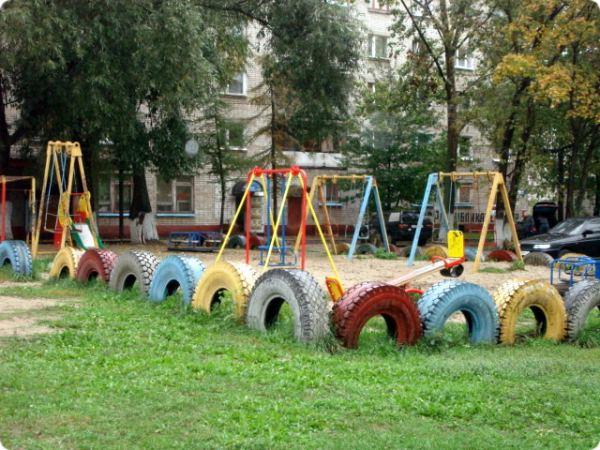
То же народное творчество на стенах…
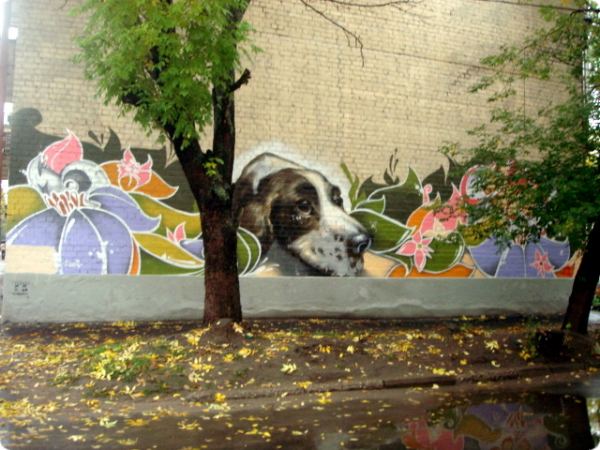
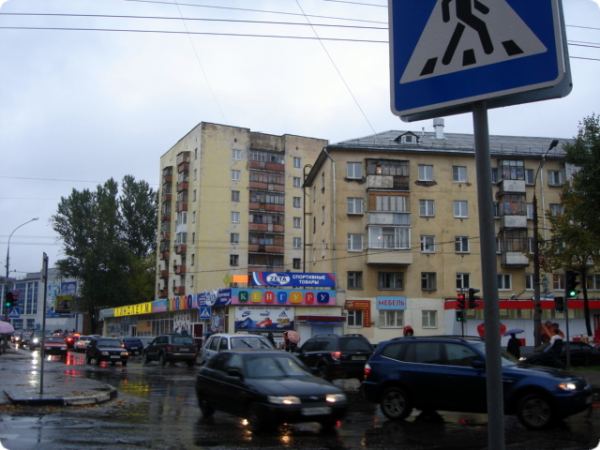
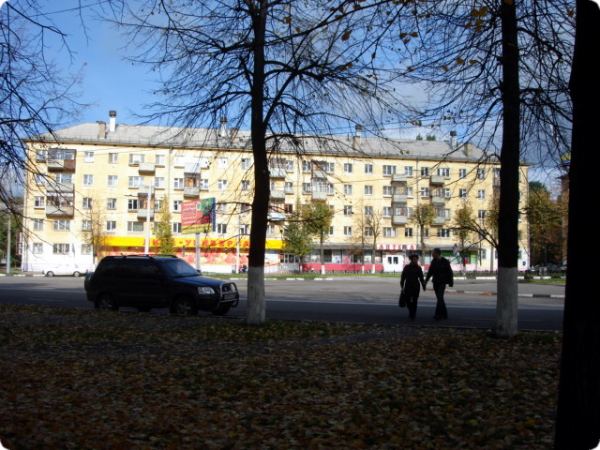
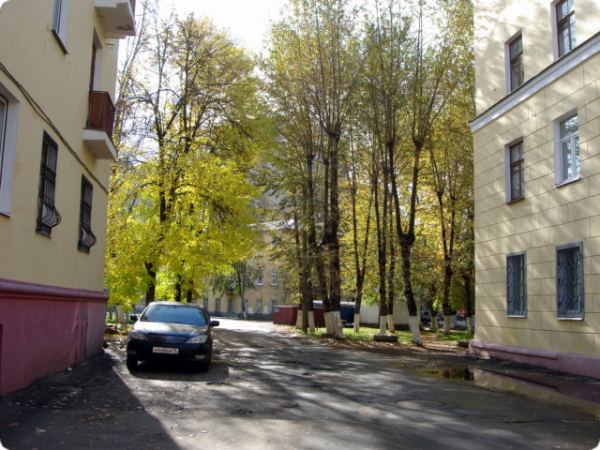
Те же однообразные и одинаковые по всей стране пятиэтажки и старые дворики…
Те же памятники старины…
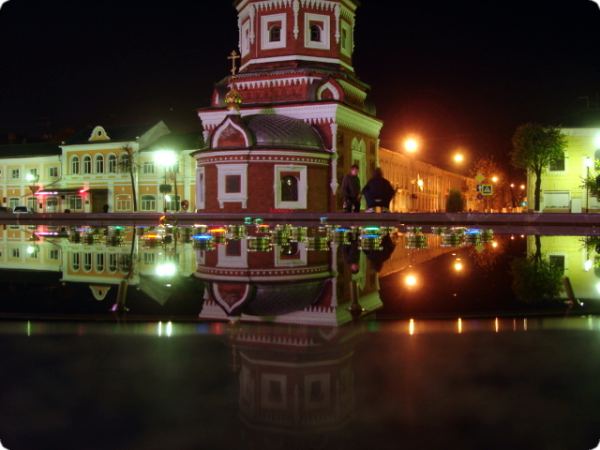
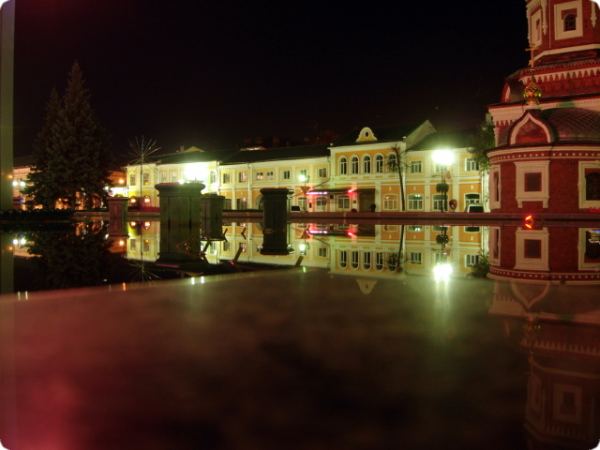
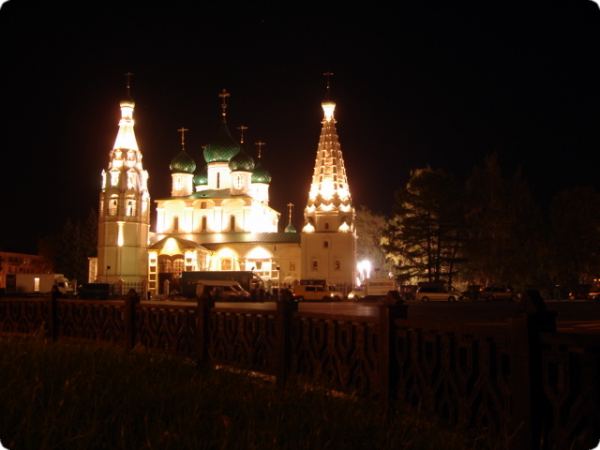
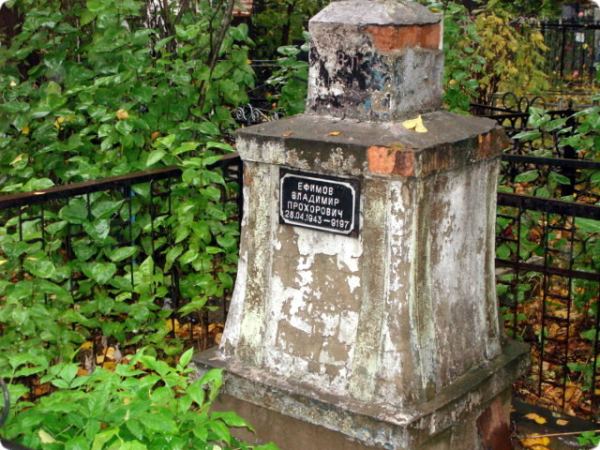
То же самое разгильдяйство везде — даже на кладбище…
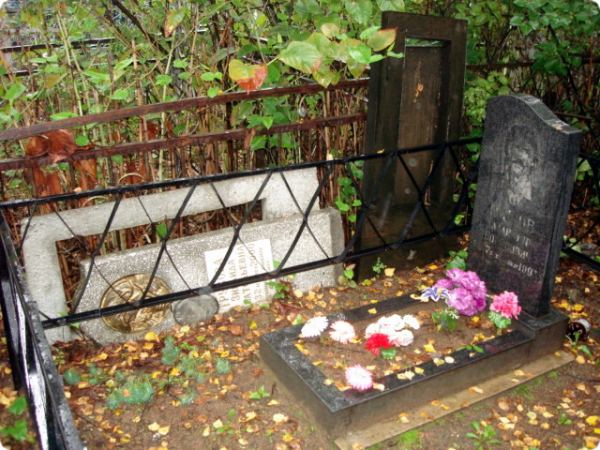
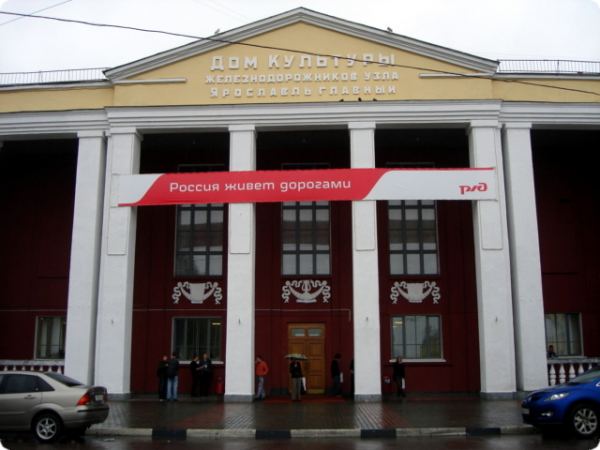
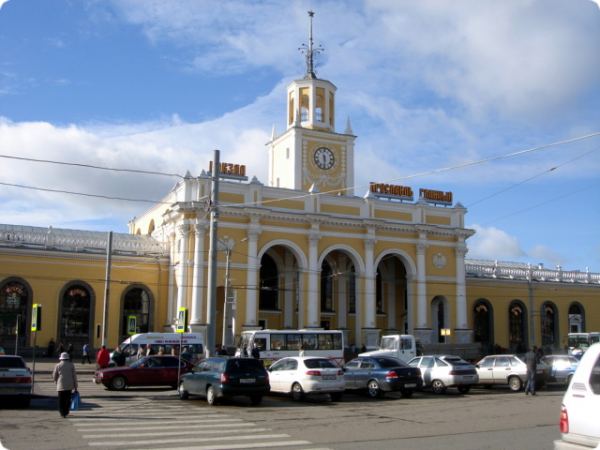
Конечно, может быть я узнал о том, что не в Москве по многочисленным упоминаниям названия города…
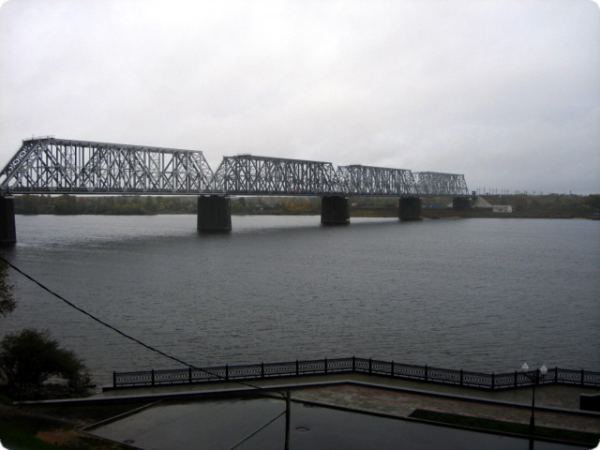
Или по реке, разве река Москва течёт так же несуетно?
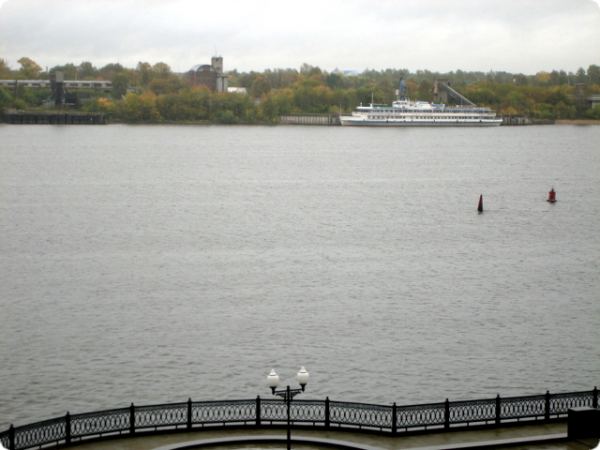
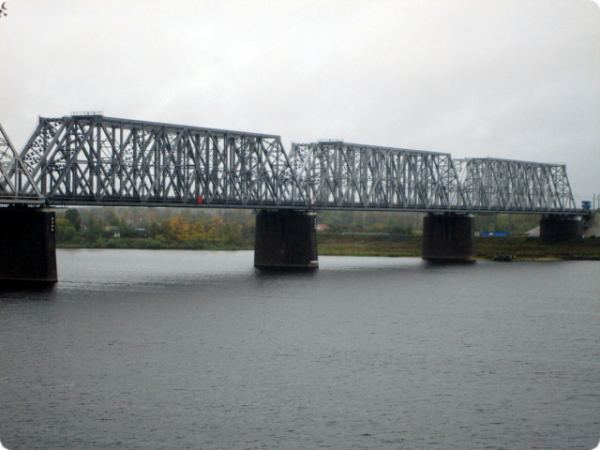
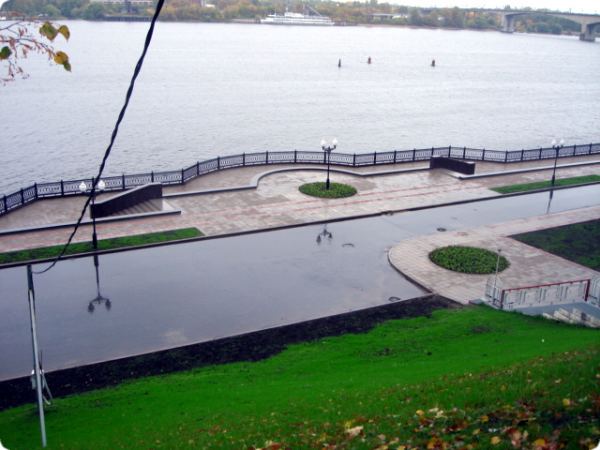
Может отличаются люди? Или они везде одинаковые?
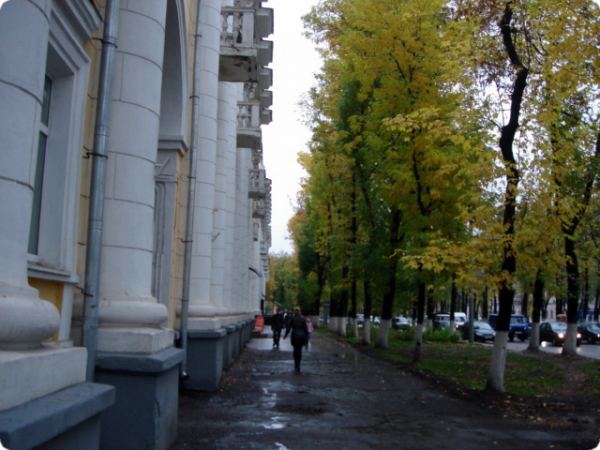
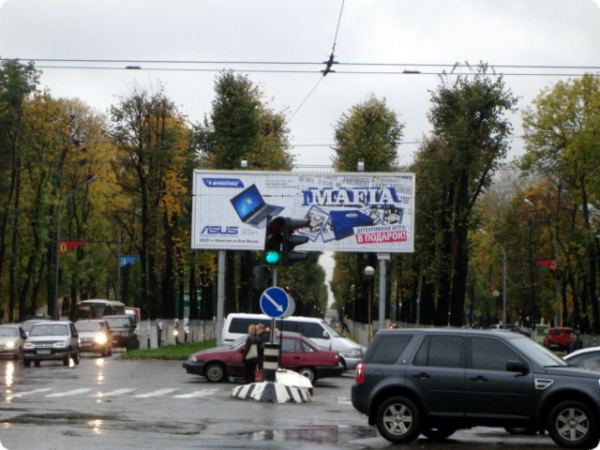
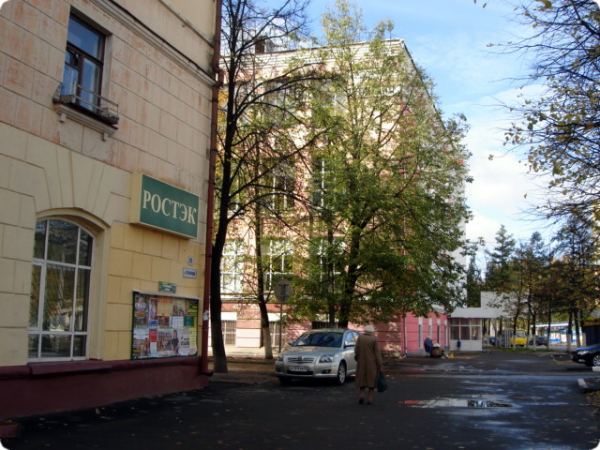
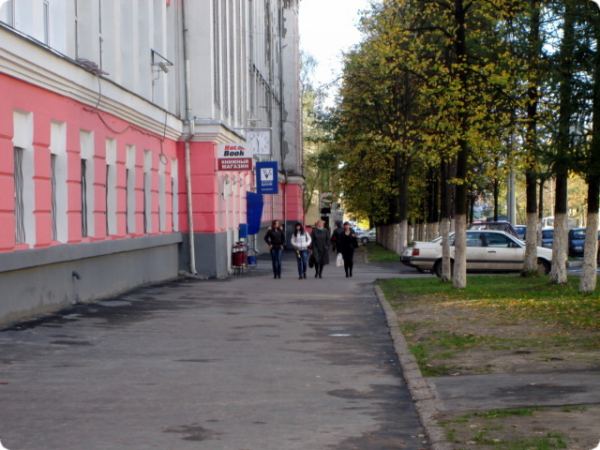
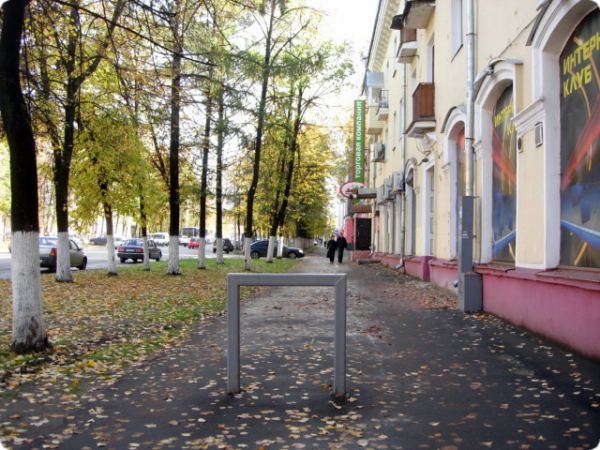
Если вы ждёте
Он был не рад мне, а я был не рад промокшим ногам, сырости и холоду. В следующий раз, когда приеду, позвоню заранее, может мы ещё понравимся друг другу.
PHP4 без XML-парсера, плюс XPath
Я недавно написал простенький парсер XML для PHP 4.3+, для случаев, когда никакого встроенного парсера XML на хостинге не оказалось.
Весь XPath я, конечно, реализовывать не буду, да мне столько и не надо. В общем, написал класс, который используется в паре VerySimple_XMLParser. Реализованы получение потомков тега, «*», «node()» и «text()». Это всё, но мне хватит.
// Simple XPath for VerySimple_XMLParser
// /
class VerySimple_XMLParser_Tree
{
    var $path;
    var $counter;
    var $xpath;

    function VerySimple_XMLParser_Tree()
    {
        $this->path = array('/');
        $this->counter = 0;
        $this->xpath = array();
    }


    function collect($type, $args)
    {
        $path = implode($this->path);

        switch ($type) {
            case 'TEXT':
                $this->xpath[$path . $this->counter . '/text()/'] = $args;
                $this->counter++;
                break;

            case 'TAGOPEN':
                list($name, $attributes) = $args;

                $tag = $this->counter . '/' . $name . '/';

                $this->xpath[$path . $tag] = $attributes;
                $this->counter = 0;

                $this->path[] = $tag;
                break;

            case 'TAGCLOSE':
                $this->counter = 1 + (int) array_pop($this->path);
                break;
        }
    }

    function halfxpath($path)
    {
        $keys = array_keys($this->xpath);
        $trans = array(
            '\/'       => '\/\d+\/',
            '\*'       => '[^\/()]+',
            'node\(\)' => '[^\/]+',
        );

        $filter   = strtr(preg_quote($path, '/'), $trans);
        $filtered = preg_grep("/^$filter\/$/su", $keys);

        $nodes = array();

        foreach ($filtered as $key) {
            $nodes[$key] = $this->xpath[$key];
        }

        return $nodes;
    }
}

// а вот так это можно использовать:
$xml =<<<XML
<root>
    <a>
        <b><c>Xa!</c></b>
        <b>Hello</b>
    </a>
    <a name="value"/>
</root>
XML;

$tree = &new VerySimple_XMLParser_Tree();

$sax = &new VerySimple_XMLParser(array(&$tree, 'collect'));
$sax->parse($xml);

echo '<plaintext>';
var_dump($tree->halfxpath('/*/a/b/text()'));
var_dump($tree->halfxpath('/*/a/b/node()'));
var_dump($tree->halfxpath('/*/a/b/*'));
var_dump($tree->halfxpath('/root/a'));
Метод для запросов я назвал «halfxpath», намекая, что это не настоящий XPath, а лишь неполноценная эмуляция.
Основная идея, как видно из кода — не парсить XML в дерево, а помещать каждый элемент по специального вида пути, который потом будет проверен на совпадение по регулярному выражению, приготовленному из запроса.
Собираемся менять фотоаппарат
Мыльница
Последние несколько лет я себе на день рождения дарю сотовый телефон, а в этом году, как назло Nexus One меня всем устраивает, даже удивительно. Придётся поменять фотоаппарат.
Пока думаем брать Canon EOS 550D. Подумаем ещё немного и возьмём.
«Андроид» 2.2.1
У меня вчера «Андроид» на телефоне обновился, выкачав новую прошивку через EDGE (бедняга, попросил бы, я б WiFi включил). В интернетах пишут, что залатали пару дыр, а из того, что я заметил — появился твёрдый знак на клавиатуре.
Дополнение: поправили ошибку с именованием дней недели.
SQL-инъекция в штрих-коде?

А вот ещё идея возникла. Распечатываете этот
штрих-код на стикеры, и незаметно клеите их рядом с ценниками в супермаркетах конкурента.Когда в конце рабочего дня будут производить учет товаров
какой-нибудь доброход-товаровед обязательно посветит на негоштрих-код сканером. :)А там написано *’; DROP TABLE products; —*
P.S. Я и сам принимал участие в разработках программ складского учета с применением сканеров штрихкода. И знаю — никто там, естественно, входные данные не проверяет, чаще всего шпарят прям напрямую запросы с динамическими параметрами
в SQL-базу. А теперь вот задумался,прогресс-то не стоит на месте… :)
Забавно, неужели правда сработает?
Optkit: можно ли автоматизировать мою графику?
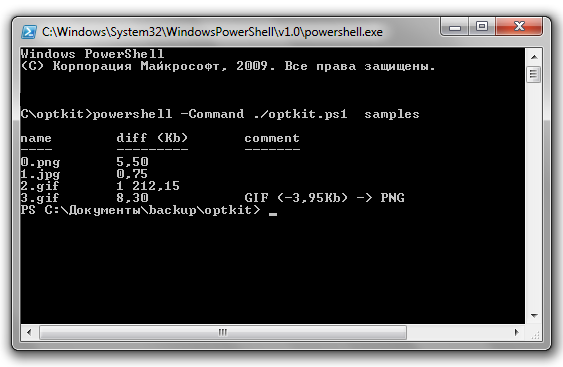
Выкладываю optkit — программу (написана на PowerShell v1, это значит — под Windows), которая определяет можно ли оптимизировать графику в форматах PNG, GIF, JPEG в указанной папке. При запуске нужно указать папку.
Примерный вывод есть на скриншоте. Выводится сколько удалось сэкономить, для GIF выводится сколько они будут занимать в PNG (если это даст экономию).
Программа использует ряд других программ, которые должны лежать в папке utils, это:
- SuperGIF 1.5 (должен быть «купленным»)
- GIFLite (можно поискать
FTP-поиском), утилита не используетсядля 64-битных ОС - jpegtran
- optipng
- pngout (нужна command line версия)
Моя программа не использует никаких продвинутых техник (например, не пытается избавиться от прозрачных, но не одноцветных участков), может ещё руки дойдут и сделаю.
Дополнено: Харисов подсказывается, что на Bash есть инструмент интереснее — imgcomp и писался явно не пару вечеров, как мой. Кстати, сравнивая две программы (на Bash и PowerShell) можно сделать интересные выводы о читаемости этих языков и их мощности.