программирование
Пакетное скругление картинок: оболочка
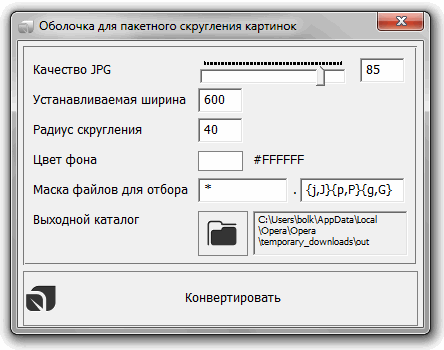
Пока у меня нет свободного вечера, чтобы заняться «скруглятором», но это не значит, что с проектом ничего не происходит. Читатель с ником oldTV изготовил отличную графическую оболочку «MCShell». Выглядит замечательно.
PHP и UTF-8: второй этап (продолжение: ничего не забыли?)
Итак, в прошлый раз мы выяснили какие файлы у нас содержат программы на PHP и какие расширения есть в нашем интерпретаторе. Кстати, не забывайте про внепроектные файлы, те, что лежат в других папках, например, уровнем ниже. Их тоже надо использовать в нашем исследовании.
Выяснить какие же расширения реально используются в проекте нам поможет следующая программа:
<?
    $extensions = array_merge(
        get_loaded_extensions(true),
        get_loaded_extensions()
    );

    $funcs = array();

    foreach ($extensions as $extension) {
        if ($extension == 'standard' || $extension == 'session') {
            continue;
        }

        $extfuncs = get_extension_funcs($extension);

        if ($extfuncs) {
            $funcs = array_merge(
                $funcs,
                    array_combine(
                        array_map('strtolower', $extfuncs),
                        array_fill(0, sizeof($extfuncs), $extension)
                )
            );
        };
    }

    $classes = get_declared_classes();

    set_time_limit(0);

    $classes_regexp = '/new\s+(?i)(' . implode('|', $classes) . ')/s';
    $funcs_regexp   = '/(' . implode('|', array_keys($funcs)) . ')/si';

    $it = new RecursiveIteratorIterator(new RecursiveDirectoryIterator('.'));

    for (;$it->valid(); $it->next()) {
        $ext = pathinfo($it->getBaseName(), PATHINFO_EXTENSION);

        if ($ext == 'php' || $ext == 'tpl' || $ext == 'inc') {

            $content = file_get_contents($it->key());

            if (preg_match_all($classes_regexp, $content, $matches)) {
                echo $it->key(), "\nClass: ",
                    implode("\nClass: ", array_map('strtolower', $matches[1])), "\n\n";
            }

            if (preg_match_all($funcs_regexp, $content, $matches)) {
                echo $it->key(), "\n";

                foreach ($matches[1] as $func) {
                    $func = strtolower($func);

                    if (isset($funcs[$func])) {
                        echo 'Module: ', $funcs[$func], "\n";
                    } else {
                        echo 'Something wrong: ', $func, "\n";
                    }
                }

                echo "\n\n";
            }
        }
    }
У меня она отработала достаточно неспешно, за несколько минут. Каковы же результаты?
bolk@dev:~/daproject$ awk -F: '/^Module/{print $2}' tool2.log | sort -u
 ctype
 curl
 date
 gettext
 hash
 iconv
 …

bolk@dev:~/daproject$ awk -F: '/^Class/{print $2}' tool2.log | sort -u
 exception
 simplexmlelement
Начнём с конца — Exception это класс для работы с исключениями,
А вот остальные 19 модулей, используемых в проекте, просмотреть сложнее. Их тех, что у меня есть я сразу могу исключить SQLITE3, XML,
Как я узнаю какие модули работают
На что ещё надо обратить внимание? На две вещи — нет ли в файлах
С первым просто, я перевожу проект
bolk@dev:~/wiki$ find -type f -name '?*.*' | grep -v '.svn' | xargs -r -n1 egrep -iH 'cp1251|cp\-1251|windows\-1251'
./php/dir1/file1.php:         if (strtolower($rss->encoding) != 'windows-1251') {
./php/dir1/file2.php:                 $c = @iconv($rss->encoding, 'cp1251', $c);
./php/dir2/file3.php:                    $title = iconv('UTF-8', 'CP1251', $employers[$i]->first_name .' '. $employers[$i]->last_name);
…
У меня таких строк — вагон и маленькая тележка, что с ними делать, будем решать дальше, пока же отметим, что они есть, причём в количестве 158 штук.
А что с PEAR? Точнее, с теми файлами PEAR, которые подключаются не из папки проекта, а из папки PEAR, которая скрыта
У меня таких импортов, кстати, не оказалось.
Кажется, информации накоплено достаточно, пора
(И тут я предлагаю сделать перерыв до завтра)
PHP и UTF-8: второй этап (ничего не забыли?)
Итак, на первом этапе перевода нашего
Могли.
Итак, как их найти? Мне кажется, хороший путь — посмотреть где встречается сигнатура „<?“:
bolk@dev:~/daproject$ grep --binary-files=without-match -R '<?' * | cut -d':' -f1 |
> grep -v '.svn' | sed -re 's/.*?/([^/]+)/1/' | awk -F. '/./{print $NF}' | sort -u
conf
csv
example
inc
js
package
php
pm
png
py
svg
tpl
xml
xsl
Очевидно, что файлы формата XML (у меня это расширения xml, xsl и svg) так же могут содержать сигнатуру „<?“ (там это часть языка), текстовые файлы (conf, csv) так же её могут содержать (они вообще могут содержать что угодно).
Как же отфильтровать такой мусор? У интерпретатора PHP есть специальная опция, для того, чтобы проверить является ли подаваемый на вход файл синтаксически верным. Мы ей можем воспользоваться:
bolk@dev:~/daproject$ grep --binary-files=without-match -R '<?' * | cut -d':' -f1 | egrep -v '.svn|.php' |
> xargs -rn1 -I{} php -r 'echo `php -l {}`;' | grep -F 'No syntax errors detected in' | sort -u
No syntax errors detected in htdocs/_dir/file1.csv
No syntax errors detected in htdocs/_dir/file2.png
No syntax errors detected in htdocs/_dir/file3.csv
No syntax errors detected in htdocs/_dir/file4.png
No syntax errors detected in htdocs/_dir/file5.csv
No syntax errors detected in templates/file1.tpl
…
Оказывается, PHP у меня есть даже внутри файлов с расширением png!
К несчастью, у меня таких файлов достаточно прилично — 39, поэтому я собираюсь некоторые из них отбросить сразу:
sed -e 's/^No syntax errors detected in //' tool2.log | xargs -n1 head --verbose | lessОказалось, что рассматривать как файлы PHP нужно файлы с ещё двумя расширениями — inc и tpl, остальные так же содержат
Поэтому я добавлю в программу из предыдущего этапа ещё два расширения и запущу её снова. У меня количество функций не изменилось — 38, а вот файлов добавилось — стало 176 против 173. Ура, теперь файлы
А что по поводу используемых расширений PHP? Их много и с каждым месяцем становится всё больше (я сам написал 3 или 4), вдруг
Для начала неплохо было бы узнать сколько у нас вообще расширений. Я знаю, что расширения в PHP подключаются двумя способами: в конфигурационном файле и при помощи функции dl. Для начала посмотрим, используется ли у нас функция dl:
bolk@dev:~/daproject$ find \( -name '*.php' -or -name '*.inc' -or -name '*.tpl' \) -exec egrep -i 'dl\s*\(' {} \; -print
    * @return bool Success or not on the dl() call
            // if either returns true dl() will produce a FATAL error, stop that
            return @dl('php_'.$ext.$suffix) || @dl($ext.$suffix);
./php/lib/PEAR.php
        if(!extension_loaded("mysql")) dl("mysql.so");
./php/db/mysql.php
У меня dl используется. Берём на заметку, что через dl подгружается модуль MySQL, а заглянув в PEAR, обнаружим, что там есть метод loadExtension, который является мультиплатформенной обёрткой для dl.
Для очистки совести я поискал случаи использования loadExtension в проекте (не забудьте, что регистр нужно игнорировать), но не нашёл.
Итак, мы выяснили какие модули у нас подгружаются через dl — только один (mysql), что же вкомпилированно в сам PHP или подключено из файлов конфигурации? Нет способа лучше, чем узнать что сам PHP думает об этом:
bolk@dev:~/daproject$ php -m
[PHP Modules]
zip
xmlwriter
libxml
xml
wddx
tokenizer
…
У меня это 54 модуля. Это очень много. Действительно ли их столько используется в проекте? Вот уж вряд ли. Надо
Отсюда мысль — узнать какие функции/классы содержатся в модуле и поискать их в файлах.
Давайте я это сделаю в следующей части, а то мне сейчас собеседование проводить.
PHP и UTF-8: первый этап
Я решил описать переход проекта
Основная идея — я добавлю в проект статический класс UTF. В этом классе будет переключатель (я назвал его «ON»), если он в состоянии «false», то все статические методы класса вызывают функции, работающие с однобайтовыми кодировками, иначе —
Выглядит он примерно так:
class UTF
{
    const ON = false;

    static public function strpos($haystack, $needle, $offset = 0)
    {
        if (self::ON) {
            return mb_strpos($haystack, $needle, $offset, 'UTF-8');
        }

        return strpos($haystack, $needle, $offset);
    }

    // … и так далее
}
Для чего нужен переключатель ON? Он позволяет переключить разом весь проект в состояние
Итак, нам надо посмотреть что же нужно переписывать и заменять в проекте. Я поступил просто — открыл в руководстве по PHP разделы строковых функций, функций PCRE и регулярных выражений в формате POSIX, скопировал их себе в программу и оформил как регулярное выражение:
<?
$funclist = <<<LIST
addcslashes — Quote string with slashes in a C style
chop — Alias of rtrim
chr — Return a specific character
chunk_split — Split a string into smaller chunks
convert_cyr_string — Convert from one Cyrillic character set to another
count_chars — Return information about characters used in a string
hebrev — Convert logical Hebrew text to visual text
hebrevc — Convert logical Hebrew text to visual text with newline conversion
html_entity_decode — Convert all HTML entities to their applicable characters
htmlentities — Convert all applicable characters to HTML entities
htmlspecialchars_decode — Convert special HTML entities back to characters
htmlspecialchars — Convert special characters to HTML entities
lcfirst — Make a string`s first character lowercase
levenshtein — Calculate Levenshtein distance between two strings
localeconv — Get numeric formatting information
ltrim — Strip whitespace (or other characters) from the beginning of a string
metaphone — Calculate the metaphone key of a string
money_format — Formats a number as a currency string
nl_langinfo — Query language and locale information
ord — Return ASCII value of character
rtrim — Strip whitespace (or other characters) from the end of a string
setlocale — Set locale information
similar_text — Calculate the similarity between two strings
soundex — Calculate the soundex key of a string
sscanf — Parses input from a string according to a format
str_getcsv — Parse a CSV string into an array
str_ireplace — Case-insensitive version of str_replace.
str_pad — Pad a string to a certain length with another string
str_rot13 — Perform the rot13 transform on a string
str_shuffle — Randomly shuffles a string
str_split — Convert a string to an array
str_word_count — Return information about words used in a string
strcasecmp — Binary safe case-insensitive string comparison
strcmp — Binary safe string comparison
strcoll — Locale based string comparison
strcspn — Find length of initial segment not matching mask
stripcslashes — Un-quote string quoted with addcslashes
stripos — Find position of first occurrence of a case-insensitive string
stristr — Case-insensitive strstr
strlen — Get string length
strnatcasecmp — Case insensitive string comparisons using a "natural order" algorithm
strnatcmp — String comparisons using a "natural order" algorithm
strncasecmp — Binary safe case-insensitive string comparison of the first n characters
strncmp — Binary safe string comparison of the first n characters
strpbrk — Search a string for any of a set of characters
strpos — Find position of first occurrence of a string
strrchr — Find the last occurrence of a character in a string
strrev — Reverse a string
strripos — Find position of last occurrence of a case-insensitive string in a string
strrpos — Find position of last occurrence of a char in a string
strspn — Finds the length of the first segment of a string consisting entirely of characters contained within a given mask.
strtolower — Make a string lowercase
strtoupper — Make a string uppercase
strtr — Translate certain characters
substr_compare — Binary safe comparison of two strings from an offset, up to length characters
substr_count — Count the number of substring occurrences
substr_replace — Replace text within a portion of a string
substr — Return part of a string
trim — Strip whitespace (or other characters) from the beginning and end of a string
ucfirst — Make a string`s first character uppercase
ucwords — Uppercase the first character of each word in a string
wordwrap — Wraps a string to a given number of characters
preg_filter — Perform a regular expression search and replace
preg_grep — Return array entries that match the pattern
preg_last_error — Returns the error code of the last PCRE regex execution
preg_match_all — Perform a global regular expression match
preg_match — Perform a regular expression match
preg_quote — Quote regular expression characters
preg_replace_callback — Perform a regular expression search and replace using a callback
preg_replace — Perform a regular expression search and replace
preg_split — Split string by a regular expression
ereg_replace — Replace regular expression
ereg — Regular expression match
eregi_replace — Replace regular expression case insensitive
eregi — Case insensitive regular expression match
split — Split string into array by regular expression
spliti — Split string into array by regular expression case insensitive
sql_regcase — Make regular expression for case insensitive match
ctype_alnum — Check for alphanumeric character(s)
ctype_alpha — Check for alphabetic character(s)
ctype_cntrl — Check for control character(s)
ctype_digit — Check for numeric character(s)
ctype_graph — Check for any printable character(s) except space
ctype_lower — Check for lowercase character(s)
ctype_print — Check for printable character(s)
ctype_punct — Check for any printable character which is not whitespace or an alphanumeric character
ctype_space — Check for whitespace character(s)
ctype_upper — Check for uppercase character(s)
array_change_key_case — Changes all keys in an array
array_multisort — Sort multiple or multi-dimensional arrays
arsort — Sort an array in reverse order and maintain index association
asort — Sort an array and maintain index association
krsort — Sort an array by key in reverse order
ksort — Sort an array by key
natcasesort — Sort an array using a case insensitive "natural order" algorithm
natsort — Sort an array using a "natural order" algorithm
rsort — Sort an array in reverse order
sort — Sort an array
LIST;

$funcs = array();

foreach (explode("\n", $funclist) as $line) {
    list($line) = explode(" ", $line, 2);

    $funcs[] = $line;
}

$regexp = '/(?<!UTF::)\b(' . implode('|', $funcs) . ')\s*\(/si';

set_time_limit(0);

$it = new RecursiveIteratorIterator(new RecursiveDirectoryIterator('.'));

for (;$it->valid(); $it->next()) {
    $ext = pathinfo($it->getBaseName(), PATHINFO_EXTENSION);

    if ($ext == 'php') {
        if (preg_match_all($regexp, file_get_contents($it->key()), $matches)) {
            echo $it->key(), "\n";

            echo '    ', implode("\n    ", array_map('strtolower', $matches[1])), "\n\n";
        }
    }
}
Список функций я проредил — удалил оттуда те, у которых проблем
bolk@dev:~/daproject$ grep ' ' tool.log | sort | uniq -c | sort -rn
    225     substr
    195     preg_replace
    174     trim
    132     preg_match
    132     htmlspecialchars
    127     strpos
    113     strtolower
     88     strlen
     50     preg_replace_callback
     40     rtrim
      …

bolk@dev:~/daproject$ grep './' tool.log
./tool.php
./htdocs/_file.php
./htdocs/file1.php
./htdocs/dir/file1.php
./htdocs/dir/file2.php
./htdocs/dir/file3.php
./htdocs/dir/file4.php
./htdocs/dir/file5.php
./htdocs/class.php
./htdocs/_ajax.php
…
На следующем этапе я заменю эти функции на их аналоги. Кстати, если у вас используются оба алиаса одной функции (например, chop и trim), то подумайте над тем, чтобы привести всё к единому виду.
Отдельно надо будет
Так же очень полезно получить список всех используемых модулей, чтобы решить какие из них могут быть проблемными.
PHP и UTF-8
Все уже
Увы,
Немного праздника в этот однобайтный склеп привносит тот замечательный факт, что
Печальнее всего с двумя вещами.
Вторая проблема заковыристее. В PHP испокон веков аж три модуля для работы с регулярными выражениями — PCRE, Regular Expression (POSIX Extended) и уже знакомый нам Multibyte String. Первый работает
PCRE в таких помощниках не нуждается, потому что сам умеет работать
if (preg_match('/(\w)/iu', 'ПриветN', $m)) {
        var_dump($m);
    }
Выдаст нам… букву «N». Почему? Находить в строке
Matching characters by Unicode property is not fast, because PCRE has to search a structure that contains data for over fifteen thousand characters. That is why the traditional escape sequences such as \d and \w do not use Unicode properties in PCRE
То есть «\d» (цифры), «\w» (буквы) и, кстати, «\b» (граница слова) и «\s» (пробельные символы) работают только с однобайтовыми кодировками. Ужасно? Не то слово! Всё потеряно? К счастью, нет.
Если внимательно читать документацию по PCRE, то найдётся много интересного, в том числе решение и этой проблемы. В одной из версий этой библиотеки появилась экспериментальная конструкция, называемая «глаголом» (VERB), «глаголы» умеют очень многое, но нас интересует специфический «глагол» «UCP», который (ура) занимается тем, что переключает «\w», «\s», «\d» и «\b» в полностью юникодный режим.
То есть такой код даст нам ожидаемый результат:
if (preg_match('/(*UCP)(\w)/iu', 'ПриветN', $m)) {
        var_dump($m);
    }
Победа? Ничего подобного. Этот глагол работает начиная с PCRE 8.10, в самой последней стабильной версии PHP (5.3.3) содержится PCRE 8.02, там этот глагол ещё не поддерживается, я проверял.
Нужная нам версия 8.10 войдёт в PHP 5.3.4. Но,
Но не стоит опускать руки,
Подведём итоги. Для перевода (большого) проекта
Ну а так же не забыть про внешние источники данных — перевести базу
Пакетное скругление картинок v0.1
Неожиданно тема пакетного скругления картинок оказалась близка не только мне. В комментариях накидали несколько предложений по улучшению программы.
Я постарался выполнить всё то, что смог добавить за вечер.
-
-quality=85 --radius=10 —background=#ffffff --mask=*.{j,J}{p,P}{g,G} --out-dir=out
GUI за вечер, конечно же, я не прикручу, а с сохранением EXIF есть сложности: на деле оказалось, что EXIF не то вырезается, он просто не сохраняется библиотекой GD, буду думать.
Скачать новую версию можно там же, где и предыдущую.
Пакетное скругление картинок
Надоело уменьшать картинки и скруглять им углы вручную. Написал программу для этого. Она уменьшает все
Обработанные файлы попадают в директорий «out», который создаётся по текущему пути.
Параметры запуска: makecorner [качество [ширина [радиус]]]
P.S.
P.P.S. Размер файла связан с тем, что там внутри библиотека GD и jpegtran (для оптимизации JPEG).
Добавлено через день: ключи запуска программы изменились.
Некоторые программисты стыдятся знания PHP
Просто наблюдение. Заметил, что на собеседовании программисты оправдываются, что знают PHP. «Не знаю как так получилось».
Вот бы CUDA в интерпретаторы
Было бы любопытно попытаться использовать GPU в интерпретаторах. В том же самом JavaScript (про который я всё говорил, что это самый недооценённый язык и который грозится перейти в разряд переоценённых) или PHP.
Вот алгоритм сортировки приспособили для выполнения на GPU, на NVIDIA GeForce GTX480, код его реализующий, позволяет сортировать аж несколько миллиардов (!)
Правда, указанная видеокарта тот ещё монстр, в стоечный сервер её
Chromium 7 alpha vs. IE9TPP4

Появился Chromium 7 с аппаратным ускорением и сразу порвал в клочья Internet Explorer 9 TTP4. Пятнадцатого сентября выходит уже бета IE9, так что вряд ли он сильно ускорится.
Epic War 4

Подсел
Но медленно наращивать мощность очень уж скучно, сделал патч, который увеличивает количество денег до двух миллионов, применив его
Для того, чтобы применить патч, найдите
Программа написана сразу на трёх языках — PowerShell (для Windows) и PHP с Python (для всех), запускайте любым из этих трёх интерпретаторов:
#!/usr/bin/env python
########################################################
# Written by Evgeny Stepanischev (//bolknote.ru)  #
# Epic War 4 money patch (for PowerShell, Python, PHP)  #
#<?/*
"""*/
echo str_repeat('#', 55), chr(10);

if ($_SERVER['argc'] > 1) {

    $fp = @fopen($_SERVER['argv'][1], 'r+b');
    if ($fp) {
        $content = fread($fp, 655350);
        $content = preg_replace('/(?<=stat_money).{5}/s', pack('H*', '0480C584B4'), $content);

        rewind($fp);
        fwrite($fp, $content);
        echo 'Done.';
    } else {
        echo 'Invalid file.';
    }

    fclose($fp);
} else {
    echo 'Usage: ', $_SERVER['argv'][0], '<filename>';
}

__halt_compiler();

""" + """ " | out-null

If ($args) {
    [char[]] $binary = Get-Content -encoding byte $args[0]

    $binary = [string]::join('', $binary) -replace`
              'stat_money.{5}', `
              "stat_money$([char]0x4)$([char]0x80)$([char]0xC5)$([char]0x84)$([char]0xB4)"

    Set-Content $args[0] ([byte[]][char[]] $binary) -encoding byte

    "Done."

} Else {
    "Usage: " + $MyInvocation.MyCommand.Name +" <filename>"
}

"""
from sys import argv
from os.path import basename

if len(argv) > 1:
    name = 'stat_money'

    f = open(argv[1], 'r+b')
    binary = bytearray(f.read())

    try:
        index = binary.index(name) + 1 + len(name)
        binary[index:index+4] = '\x80\xc5\x84\xb4'

        f.seek(0)
        f.write(binary)
        f.close()
        print('Done.')
    except:
        print('Invalid file.')
else:
    print('Usage: %s <filename>' % basename(argv[0]))

# " | out-null
python patch.ps1 DEF4_SAVE.sol или powershell -Command .\patch.ps1 DEF4_SAVE.sol или php patch.ps1 DEF4_SAVE.sol
Жаль расцветить три языка в одном файле можно только вручную.
Ограничения на localStorage
localStorage —
Last time I’ve checked, Chrome 5.0.375.99 beta let me save
2600-2700 thousands of characters, Firefox 3.5.9 —5200-5300k, Explorer 8 —4900-5000k, and Opera 10.60 popped a dialog, letting me give the script unlimited storage.
Причём, я ещё заметил, что браузеры с разной скоростью выделяют место под хранилище. Некоторые («Опера», например, выделяет его за время O(1)), другие заметно замедляются с ростом размера выделяемой памяти.
Добавлено позднее: кстати. У объекта localStorage есть несколько методов, в тот же самый объект отображаются, как свойства, пары ключ/значение. В любом браузере, кроме FF, можно запросто перезаписать любой из методов этого объекта. Только FF предусмотрительно не позволяет этого делать. Жаль только, что он не позволяет этого делать молча, не выбрасывая exception.
Если читать стандарт, то ощущение такое, что авторы просто не учли этого случая и разрешают перезаписывать эти методы.
Зачем нужны все эти -moz-, -o-, -ms-, -webkit-?
На сайте
Хотя я
OpenID ЖЖ
1) в ЖЖ, у аккаунтов, переименованных после 15.07.2010 нет OpenID. 2) ЖЖ перешёл на OpenID v2,
Как исправить второе я пока не знаю. Буду думать.
JS — слишком сложный язык для большинства
JS — честное слово, это
Есть такой прекрасный сайт — «WTFJS», прекрасен он тем, что отлично иллюстрирует эту мысль. Встречаются там, конечно, совершенно идиотские примеры поведения интерпретаторов, но большая часть — совершенно нормальные вещи, в которое люди восторженно тыкают пальцем, потому что изучали JS «на примерах».
Скажем, вот, пример с сайта:
var void = function () {}
 //=> SyntaxError: missing variable name
Я
DNS rebinding
Меня восторгает атака «DNS rebinding», вострогает своей простотой. Суть такова. Как известно, у страницы в браузере есть стотыщьмильёнов способов получить содержимое произвольного URL, но с одним условием — получить данные можно только с того же хоста, на том же порту и по тому же протоколу.
Хакер заманивает жертву на свой сайт — example.org, DNS этого сайта настроен так, что выдаёт то настоящий IP этого сайта, то 192.168.0.1. Страница обращается по URL на своём хосте, браузер проверяет — протокол, доменное имя, порт совпадает, разрещает запрос, но запрос попадает не на внешний сайт, а на адрес 192.168.0.1. В домашних сетях там, чаще всего, находится интерфейс роутера.
Дальше уже зависит от фантазии взломщника.
Защищиться от атаки очевидным способом (запретив запрос, если сменился IP) нельзя — есть масса сайтов (например, «Яндекс») снижающих нагрузку, распределяя пользователей по нескольким
У IE есть такое понятие как «зоны безопасности», там локальные сайты выделены в отдельную зону. Мне кажется хорошим методом запрещать доступ по XHR/Flash/Java, если зоны у страницы, которая запрашивает и у URL, который запрашивается, различаются.
Собеседование
У нас с Сергеем Чистовичем сейчас проходит примерно по 1—2 собеседования в день. Для оптимизации (чтобы быстрее понять что знает кандидат, а что нет), приходится придумывать вопросы с подвохом.
Например (это Python), что будет тут — True или False и почему:
u'ВАС' == 'ВАС'
str('') == str('')
object() == object()
Добавлено через несколько часов: ребята из комментариев, вы что правда считаете этот элементарнейший тест «тонкостями» и «хитростями» языка? То есть вы в коде никогда не сравниваете два объекта? Два числа, например, да что числа, просто любые два объекта?
А такие вещи как разное поведение наследования у «классических» и «новых» классов, наверное, вообще у вас считается заумью?
CSS vs. JSSS
Почти никто не помнит, но в прошлом веке, в браузере Netscape Navigator (который позже стал Communicator) был ещё один способ задавать таблицы стилей — JSSS.
Вообще, сейчас принято с теплотой вспоминать поделие Netscape и осуждать Microsoft за самоуправство в стандартах, но тогда время было такое. Кто такие были W3C и кто — Microsoft с Netscape. В Netscape придумывали «стандартов» никак не меньше (а то и больше), чем в Microsoft. И где сейчас LAYER, MULTICOL или тот же JSSS? Впрочем, фирма Netscape в 1996 году отправила JSSS в W3C.
Выглядел JSSS примерно так (даже функции поддерживались!):
<style type="text/javascript">
 tags.p.fontSize = "14pt";
 with(tags.H2)
 {
   color = "red";
   fontSize = "16pt";
   marginTop = "2cm";
 }
contextual(tags.H1, tags.EM, ids.x78, classes.foo.all).color = evaluate_color();
tags.P.firstLine.fontStyle = "small-caps";
tags.IMG.width = .50 * document.width;
if (visual.colorDepth > 2) {
  body.bgColor = "white";
  body.color = "blue";
} else {
  body.bgColor = "black";
  body.color = "white";
}
</style>
И иногда, перебирая в голове ушедшие технологии, я задумываюсь — а не было бы принятие JSSS вместо CSS более удачным шагом? Нужно было бы учить на один язык меньше (JS уже есть в браузере), да и последние тенденции в CSS3 показывают, что он медленно двигается в сторону
Вот пример:
@media only screen and (max-width: 1024px) {
    div {
        width: -moz-calc(100% - 2 * 3px);
        height: -moz-max(50%, 18px);
    }
}

@-webkit-variables {
   step: -1;
}

ol {
    counter-reset: list -webkit-var(step);
}
li:before {
    counter-increment: list;
    content: counter(list) ". ";
}
Уже похоже
Так вот, нужно ли это всё было городить? В JavaScript это уже есть. Впрочем, нужны, конечно, ограничения, чтобы JSSS не превратился в труднопроходимую кашу, CSS более лаконичен и строг. Но вопрос в том, удобно ли уже сейчас читать CSS больших проектов? Я пробовал, мой ответ — вряд ли. Это чудовищно сложно.
В общем, мне кажется, что Netscape был
Специальный вид «Яндекса» для speeddial «Оперы»
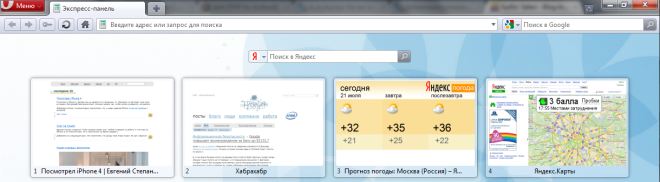
Я рад, что явился катализатором в «Яндексе» появления визуальных закладок для «Оперы» (для плагина FireFox «SpeedDial» тоже будет работать).
Проект «Погоды» я даже поменеджерил.
К сожалению, пока нет технической возможности делать то же самое для «Хрома» и «Сафари», так как использовать media queries (как для «Оперы» и FF) не получится, браузеры на WebKit ведут тут себя нелогично, нужно проверять особый
rel="noreferrer"
Как известно, около года назад в WebKit появилась поддержка атрибута «rel» у ссылки со значением «noreferrer». Если указать это значение, то браузер не будет передавать заголовок «referer», в котором указано с какого адреса браузер осуществил переход.
Это прекрасная вещь, которая позволяет защищать, к примеру, информацию из интранета. У нас (в «Яндексе») стоят специальные скрипты для скрытия заголовка «referer» специальными ухищрениями, чтобы предотвратить утечку (так как некоторые сервисы у нас с ЧПУ) данных. Этот атрибут, если он был бы реализован везде, решил бы эту задачу более изящно.
К сожалению, с его распространением, думаю, будет расти его параноидальное использование, что сильно повлияет на статистику. Сейчас можно быть
Ну и ещё один показатель бардака —
P.S. Возможно поддержка «noreferrer» и ещё