программирование
Воздушный бой на чистом HTML
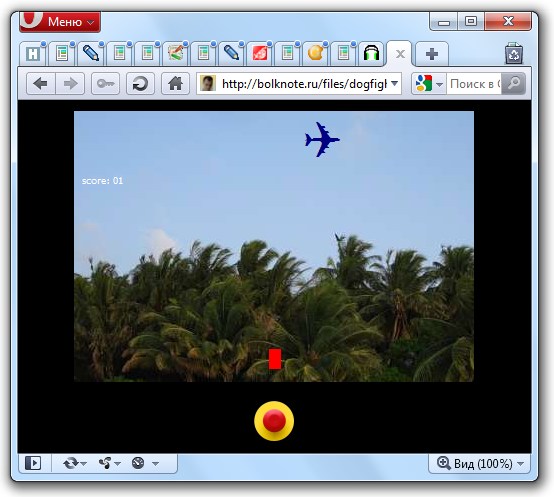
Все в последнее время настолько в восторге от новых возможностей браузеров, что пишут игру за игрой на HTML5/CSS/JavaScript. Это всё скучно. Вчера перед сном я размышлял об игре на чистом HTML (даже без CSS), а сегодня, пока собирался в Самару, на 404fest, потихоньку её написал.
Встречайте — Pure HTML Air Fight. Написано на чистом HTML, без использования JavaScript, CSS и серверной логики. На сервере отрабатывает только скрипт, контролирующий введённый URL и запускающий игру, если URL ошибочен.
Задача классическая — попасть в пролетающий самолёт, внизу есть кнопка, запускающая ракету. Скорость самолёта и задержка меняется (на самом деле они жёстко зависят от момента пуска ракеты, у меня же чистый HTML, никакого рандома).
Кстати, в игре есть фоновый звук при попадании в самолёт.
Добавлено позднее: сайт под «хабрэффектом», так что может открываться крайне медленно, игра может вообще не работать.
Добавлено ещё позднее: некоторые ребята (в том числе в комментариях на «Хабре»)
Как преобразовать пробелы в табуляции в вашей программе
По code guidelines PHPbb в коде нужно использовать табуляции, вместо пробелов. К сожалению, я об этом поздновато узнал, теперь надо всё, что я написал привести к правильному виду.
Оказывается, в Linux есть специальная утилита для этого — unexpand (находится в пакете coreutils). Кстати, есть и противоположная по действию утилита — expand.
PHP и UTF-8: пятый с половиной этап
После последнего, на данный момент, пятого этапа, меня опять потянуло на нецелые числа. Что поделать — я работаю над другим проектом, поэтому на полноценный этап я ничего не наскрёб, но работу потихоньку продолжаю. В прошлый раз я занимался оптимизацией — сделал итератор
Использовать так же просто, как и предыдущий, «прямой» итератор: Второй параметр указывает с какого символа (с конца) нужно начинать итерироваться.Так, и?
<?
    class UtfReverseString implements Iterator
    {
        protected $str;   // строка
        protected $idx;   // бинарный индекс строки
        protected $pos;   // UTF-8-индекс
        protected $curend;  // бинарный указатель на конец текущего символа

        protected $idx_start; // бинарный индекс откуда стартуем
        protected $pos_start; // UTF-8-индекс откуда стартуем

        // проверка — байт не является началом символа
        protected function isNotBegin($ch)
        {
            return (ord($ch) & 192) == 128;
        }

        public function __construct($str, $pos_start = 0)
        {
            $len = strlen($str);

            $this->str = $str;
            $this->idx = strlen($str); // этот указатель будет уточнён тут же, ниже
            $this->pos = strlen(utf8_decode($str)) - 1 - $pos_start; // лучше использовать mb_strlen, если есть возможность

            while ($pos_start-- >= 0) {
                $this->curend = --$this->idx;

                while ($this->idx > 0 && $this->isNotBegin($this->str[$this->idx])) {
                    $this->idx--;
                }
            }

            $this->idx_start = $this->idx;
            $this->pos_start = $this->pos;
        }

        public function current()
        {
            return substr($this->str, $this->idx, $this->curend - $this->idx + 1);
        }

        public function key()
        {
            return $this->pos;
        }

        public function next()
        {
            $this->pos--;
            $this->curend = $this->idx - 1;

            for ($this->idx--; $this->isNotBegin($this->str[$this->idx]); $this->idx--);
        }

        public function rewind()
        {
            $this->idx = $this->idx_start;
            $this->pos = $this->pos_start;
        }

        public function valid()
        {
            return $this->idx >= 0;
        }

        public function __toString()
        {
            return $this->str;
        }
}$str = new UtfReverseString('Привет', 1);
foreach ($str as $ch) {
echo $ch, ' ';
}
Optkit: можно ли автоматизировать мою графику?
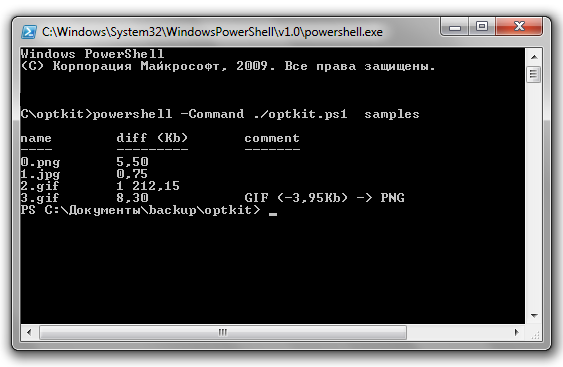
Выкладываю optkit — программу (написана на PowerShell v1, это значит — под Windows), которая определяет можно ли оптимизировать графику в форматах PNG, GIF, JPEG в указанной папке. При запуске нужно указать папку.
Примерный вывод есть на скриншоте. Выводится сколько удалось сэкономить, для GIF выводится сколько они будут занимать в PNG (если это даст экономию).
Программа использует ряд других программ, которые должны лежать в папке utils, это:
- SuperGIF 1.5 (должен быть «купленным»)
- GIFLite (можно поискать
FTP-поиском), утилита не используетсядля 64-битных ОС - jpegtran
- optipng
- pngout (нужна command line версия)
Моя программа не использует никаких продвинутых техник (например, не пытается избавиться от прозрачных, но не одноцветных участков), может ещё руки дойдут и сделаю.
Дополнено: Харисов подсказывается, что на Bash есть инструмент интереснее — imgcomp и писался явно не пару вечеров, как мой. Кстати, сравнивая две программы (на Bash и PowerShell) можно сделать интересные выводы о читаемости этих языков и их мощности.
PHP4 без XML-парсера, плюс XPath
Я недавно написал простенький парсер XML для PHP 4.3+, для случаев, когда никакого встроенного парсера XML на хостинге не оказалось.
Весь XPath я, конечно, реализовывать не буду, да мне столько и не надо. В общем, написал класс, который используется в паре VerySimple_XMLParser. Реализованы получение потомков тега, «*», «node()» и «text()». Это всё, но мне хватит.
// Simple XPath for VerySimple_XMLParser
// /
class VerySimple_XMLParser_Tree
{
    var $path;
    var $counter;
    var $xpath;

    function VerySimple_XMLParser_Tree()
    {
        $this->path = array('/');
        $this->counter = 0;
        $this->xpath = array();
    }


    function collect($type, $args)
    {
        $path = implode($this->path);

        switch ($type) {
            case 'TEXT':
                $this->xpath[$path . $this->counter . '/text()/'] = $args;
                $this->counter++;
                break;

            case 'TAGOPEN':
                list($name, $attributes) = $args;

                $tag = $this->counter . '/' . $name . '/';

                $this->xpath[$path . $tag] = $attributes;
                $this->counter = 0;

                $this->path[] = $tag;
                break;

            case 'TAGCLOSE':
                $this->counter = 1 + (int) array_pop($this->path);
                break;
        }
    }

    function halfxpath($path)
    {
        $keys = array_keys($this->xpath);
        $trans = array(
            '\/'       => '\/\d+\/',
            '\*'       => '[^\/()]+',
            'node\(\)' => '[^\/]+',
        );

        $filter   = strtr(preg_quote($path, '/'), $trans);
        $filtered = preg_grep("/^$filter\/$/su", $keys);

        $nodes = array();

        foreach ($filtered as $key) {
            $nodes[$key] = $this->xpath[$key];
        }

        return $nodes;
    }
}

// а вот так это можно использовать:
$xml =<<<XML
<root>
    <a>
        <b><c>Xa!</c></b>
        <b>Hello</b>
    </a>
    <a name="value"/>
</root>
XML;

$tree = &new VerySimple_XMLParser_Tree();

$sax = &new VerySimple_XMLParser(array(&$tree, 'collect'));
$sax->parse($xml);

echo '<plaintext>';
var_dump($tree->halfxpath('/*/a/b/text()'));
var_dump($tree->halfxpath('/*/a/b/node()'));
var_dump($tree->halfxpath('/*/a/b/*'));
var_dump($tree->halfxpath('/root/a'));
Метод для запросов я назвал «halfxpath», намекая, что это не настоящий XPath, а лишь неполноценная эмуляция.
Основная идея, как видно из кода — не парсить XML в дерево, а помещать каждый элемент по специального вида пути, который потом будет проверен на совпадение по регулярному выражению, приготовленному из запроса.
Тонкости heredoc в PHP
В PHP, как и в некоторых других языках (Bash, Perl) есть конструкция heredoc — это способ задать многострочную строку. Посмотрите как удобно, не нужно экранировать кавычки:
// это PHP
$str = <<<STR
Привет, я строка "в кавычках",
'в апострофах'.
STR;
Но меня всегда раздражало, что завершающий ограничитель приходится прижимать к левому краю, пробел и табуляция дают ошибку (хотя в Perl относительно недавно разрешили делать отступы для этой конструкции).
Сегодня, в очередной раз раздражаясь по этому поводу, я решил попробовать использовать неразрывные пробелы (Alt Right+Space в раскладке Бирмана), получилось, работает даже в PHP 4.4.4. Подходит, конечно, для исходников в кодировке
Правда, строки внутри, конечно, менять нельзя, но эта конструкция часто используется вместе с HTML, а ему отступы неинтересны.
$str = <<<    HTML
    <table>
        <tr class="row"><td>'Привет'</td></tr>
    </table>
    HTML;
Только не забудьте, что отступы надо делать и в начальной конструкции, и в конечной.
Bitrix WTF
Я сейчас в Ярославле слушаю доклад по клиентским сертификатам.
Рядом со мной сидит Коля Мациевский, он один из первых в России начал комплексно исследовать вопрос оптимизации загрузки сайтов и владеет сейчас первой в России компанией «WeBo», которая этим занимается. Коле скоро выступать, а пока он ковыряет исходники своего продукта, а точнее плагина, который встраивает упомянутый продукт в CMS «Bitrix».
Причина в том, что внутренний антивирус «Bitrix»
$ll = strlen(bin2hex($this->body))/2;

if($ll > 500)
{
    $val = 9;
    $r += $val;
    $this->resultrules['rulescriptlenghts_sl'] = $val;
    return $r;//только одно правило из блока
}
Вот эта странная во всех отношениях (почему не просто strlen?) проверка считает вирусным любой
IE9 и его скорость, по сравнению с другими браузерами
Сижу сейчас на семинаре Михаила Черномордикова из Microsoft «HTML5, CSS3 и новый Internet Explorer 9». На экране — известный тест Flying Images, который Михаил демонстрирует в IE9 бета1 и FF 4 (неизвестной) бете.
У IE9, судя по всему сильное преимущество. Я
Скачал FF 4 beta7pre, включил в конфигурации всё, что относится к аппаратному ускорению, потестировал. В общем, Microsoft… вводит нас в заблуждение (как и статья на «Хабре»). FireFox явно впереди, хоть и незначительно.
PHP4 без XML-парсера
Мне тут по работе пришлось решить странную, по нынешним временам задачу — принимать XML в программе на PHP4.3+, где никакого парсера XML может не оказаться. Таковы реалии продукта и среды, где он будет использоваться (это код внешнего проекта). Поэтому мне пришлось написать небольшой парсер, который, правда, расcчитывает, что XML будет
В качестве иллюстрации я использую в коде крайне простую функцию, которая не строит дерево, а просто собирает вызовы в массив, но понятно, что собрать дерево тоже ничего не стоит.Дальше
<?
// Very Simple XML SAX Parser by Evgeny Stepanischev
// /
class VerySimple_XMLParser
{
    var $saxCallback;

    function VerySimple_XMLParser($saxCallback)
    {
        $this->saxCallback = $saxCallback;
    }

    function parse($xml)
    {
        if (preg_match_all('#<![CDATA[.*?]]>|</?[^>]*>|[^<]+#us', $xml, $matches)) {
            foreach ($matches[0] as $match) {
                $this->parseThis($match);
            }
        }
    }

    function parseThis($match)
    {
        $calls = array(
            '<!--'      => 'COMMENT',
            '<?'        => 'PI',
            '<![CDATA[' => 'CDATA',
            '<!'        => 'DTD',
            '</'        => 'TAGCLOSE',
            '<'         => 'TAGOPEN',
        );

        foreach ($calls as $need => $type) {
            if (strpos($match, $need) === 0) {
                return $this->parseByType($type, $match);
            }
        }

        return $this->parseByType('OTHER', $match);
    }

    function parseByType($type, $text)
    {
        if ($type == 'COMMENT') {
            return $this->addChunk($type, substr($text, 4, -3));
        }

        if ($type == 'CDATA') {
            return $this->addChunk('TEXT', substr($text, 9, -3));
        }

        if ($type == 'OTHER') {
            return $this->addChunk('TEXT', $text);
        }

        if ($type == 'TAGCLOSE') {
            $end = strcspn($text, ' >');

            return $this->addChunk('TAGCLOSE', substr($text, 2, $end - 2));
        }

        if ($type == 'TAGOPEN') {
            $this->addChunk('TAGOPEN', $this->parseTag($text));

            if (substr($text, -2) == '/>') {
                $end = strcspn($text, ' >');

                return $this->addChunk('TAGCLOSE', substr($text, 1, $end - 2));
            }
        }

        return '';
    }

    function parseTag($text)
    {
        $end = strcspn($text, ' />');
        $name = substr($text, 1, $end - 1);

        return array($name, $this->parseTagAttributes(substr($text, $end)));
    }

    function parseTagAttributes($text)
    {
        $nameStart = '(?:[A-Za-z_:]|[^\x00-\x7F])';
        $nameChar  = '(?:[A-Za-z0-9_:\.-]|[^\x00-\x7F])';
        $attrValue = '(?:\'[^\']*\'|"[^"]*")';

        if (preg_match_all("/{$nameStart}{$nameChar}*=$attrValue/us", $text, $matches)) {
            return $this->parseAttributes($matches[0]);
        }

        return array();
    }

    function parseAttributes($rawAttributes)
    {
        $attributes = array();

        foreach ($rawAttributes as $rawAttr) {
            list($name, $value) = explode('=', $rawAttr, 2);
            if ($value[0] == '"' || $value[0] == "'") {
                $value = substr($value, 1, -1);
            }

            $attributes[$name] = $value;
        }

        return $attributes;
    }

    function addChunk($type, $arg)
    {
        call_user_func($this->saxCallback, $type, $arg);
    }
}

// Пример использования

$xml =<<<XML
<!-- комментарий -->
<?xml version="1.0"?>
<root attribute="a.a" v="a">
    <v><![CDATA[data]]></v>
    <v>data</v>
    <v/>
</root>
XML;

// Понятно, что можно написать класс и передать в качестве
// callback в парсер метод объекта, но я для простоты, как пример,
// написал очень простую функцию
function VerySimple_XMLParser_Collector()
{
    static $tree = array();

    if (func_num_args() == 2) {
        $tree[] = func_get_args();
    } else {
        return $tree;
    }
}

$sax = &new VerySimple_XMLParser('VerySimple_XMLParser_Collector');
$sax->parse($xml);

echo '<plaintext>';
var_dump(VerySimple_XMLParser_Collector());
PHP и UTF-8: пятый этап
Итак, пятый этап. Точнее на этап, он, пожалуй, не тянет, но после этапов 4,5 и 4,6 мне хочется целых чисел.
В самом деле, если простое взятие символа по индексу в строке с фиксированным размером символа имеет сложность O(1), то Я написал небольшие тесты. Замерял три прохода по тексту объёмом 187,5КБ. Проход по строке с однобайтной кодировкой — 0,2 секунды, по строке Так вот, одна из вещей, которой мало кто пользуется — возможность создать в PHP свой итератор. У меня тут не руководство по итераторам, поэтому я ограничусь лишь кодом и примером использования. Основная идея — если мы двигаемся по строке последовательно, Использовать итератор достаточно просто: Так как в итерации сначала вызывается «current», а потом «next» мне показалось странным терять информацию о положении следующего символа, которую мы в «current» уже знаем, так что я передаю её в «next» через защищённое свойство. Список функций (из моего списка используемых функций), которые я перепишу с итератором (или скорость которых увеличится): trim, ltrim, rtrim, wordwrap, strcspn и strspn, а так же некоторые места в коде проекта.Итак, пятый этап
class UtfString implements Iterator
    {
        protected $str;   // строка
        protected $idx;   // бинарный индекс строки
        protected $pos;   // UTF-8-индекс
        protected $len;   // бинарная длина
        protected $next;  // бинарный указатель на следующий

        protected $idx_start; // бинарный индекс откуда стартуем
        protected $pos_start; // UTF-8-индекс откуда стартуем

        // проверка — байт не является началом символа
        protected function isNotBegin($ch)
        {
            return (ord($ch) & 192) == 128;
        }

        public function __construct($str, $pos_start = 0)
        {
            $this->str = $str;
            $this->pos = $this->pos_start = $pos_start;
            $this->len = strlen($str);
            $this->next = null;

            if ($pos_start) {
                for ($i = 0; $i<$pos_start; $i++) {
                    $this->idx_start++;

                    while ($this->isNotBegin($this->str[$this->idx_start])) {
                        $this->idx_start++;
                    }
                }
                $this->idx = $this->idx_start;

            } else {
                $this->idx = $this->idx_start = 0;
            }
        }

        public function current()
        {
            $idx = $this->idx;
            $out = $this->str[$idx++];

            while ($this->isNotBegin($ch = $this->str[$idx])) {
                $out .= $ch; // быстрее, чем массив!
                $idx++;
            }

            $this->next = $idx;

            return $out;
        }

        public function key()
        {
            return $this->pos;
        }

        public function next()
        {
            $this->pos++;

            if ($this->next) {
                $this->idx  = $this->next;
                $this->next = null;
            } else {
                for ($this->idx++; $this->isNotBegin($this->str[$this->idx]); $this->idx++);
            }
        }

        public function rewind()
        {
            $this->idx = $this->idx_start;
            $this->pos = $this->pos_start;
        }

        public function valid()
        {
            return $this->idx < $this->len;
        }

        public function __toString()
        {
            return $this->str;
        }
}$str = str_repeat('Привет', 64000);
foreach (new UtfString($str) as $position => $char) {
// …
}
Хром → Опера
К сожалению, с «Хрома» (это браузер), к которому я уже привык и который обставил с любовью плагинами, мне придётся пересесть
Но. Недавняя неприятная история, когда в код «Хромиума» (это «Хром», но без «жучков») попал один из «шпионских» модулей, заставляет задуматься — что ещё, по небрежности или умышленно, могла забыть выключить корпорация «Гугл» в своём браузере? Тем более, что ещё на слуху история о том, что «Гугл» собирал данные
Перехожу обратно на «Оперу», других вариантов нет. «Сафари» под Windows — это
PHP и UTF-8: четыре и шесть десятых или ещё проблемные функции
С прошлого этапа я, в данном проекте, был занят тем, что писал
Более простая, но тоже не самая очевидная функция — addcslashes. Она экранирует указанные символы слешем, представляя все символы с кодом большим 128 как восьмеричное число, например, буква «ф» (в кодировке cp1251), если указать её во втором параметре, будет представлена «\364». Вопрос в следующем — символы Ответ в парной функции — stripcslashes. Если последовательно заэкранировать все байты Моя задача — эмулировать поведение функции в точности, в этой связи str_pad содержит две загадки: если задана строка дополнения из двух символов и более, то как аргумент дополняется слева и какая сторона дополняется первой, когда дополнять надо обе стороны? Как видим, сначала дополняется правая сторона, а при дополнении слева символы дополняют в указанном порядке (когда я программировал эту функцию, у меня был соблазн сделать дополнение с конца последовательности). Вообще, в PHP функций с тонкостями поведения масса. Функция wordwrap Дальше
static public function ord($character) {
        if (self::ON) {
            $codes = unpack('N', mb_convert_encoding($character, 'UCS-4BE', 'UTF-8'));
            return reset($codes);
        }

        return ord($character);
    }

    static public function chr($ascii) {
        if (self::ON) {
            return mb_convert_encoding(pack('N', $ascii), 'UTF-8', 'UCS-4BE');
        }

        return chr($ascii);
}bolk@dev:~/daproject$ php -r 'var_dump(str_pad("..", 3, "12", STR_PAD_BOTH));'
string(3) "..1"
bolk@dev:~/daproject$ php -r 'var_dump(str_pad("..", 5, "12", STR_PAD_LEFT));'
string(3) "121.."
PHP и UTF-8: четыре с половиной или некоторые функции
Я пока приостановил эпопею
public static function strcmp($str1, $str2) {
    // используется модуль intl
    return collator_compare(collator_create(''), $str1, $str2);
}

public static function strncmp($str1, $str2, $len) {
    return self::strcmp(self::substr($str1, 0, $len), self::substr($str2, 0, $len));
}

public static function strcasecmp($str1, $str2) {
    return self::strcmp(self::strtolower($str1), self::strtolower($str2));
}

static public function ctype_space($text) {
    return preg_match('/^\p{Zs}+$/us', $text);
}
Привожу в качестве иллюстрации того, что не всё так сложно как кажется. Стоит только сесть и начать.
Некоторые функции в PHP уже есть (mb_substr),
И, кстати, в ходе родился замечательный совет: если функцию трудно реализовать (например, str_ireplace), посмотрите, может проще переписать место, где она используется. У меня две функции были использованы ровно по одному разу.
Добавлено позднее: тщательно изучил вопрос сравнения Unicode, я выяснил, что производить сравнение так, как это сделал я нельзя, поэтому функцию strcmp я удалил, буду переписывать. Например, буква «ё» в Unicode стоит дальше «л», а должно быть наоборот.
Добавлено ещё позже: в PHP 5.3 появилось расширение Intl, основанное на известной библиотеке UCI, оказывается это расширение собирается и с PHP 5.2.4+, так что имеет смысл использовать именно его.
IE9 beta
Вышла первая
Сайты открываются через
Тьфу.
Пакетное скругление картинок v0̶.̶2̶.̶1 0.2.2
Ребята, качайте новую версию, я сделал antialiasing для углов. Ну и пришлось же помучиться! Я немного заболел, пока сидел дома, сделал.
Основная идея такова — рисуется красный круг на чёрном фоне, на него накладывается фильтр Гаусса (тут меня ждала засада — в PHP 4.4.4, который у меня, нет функций imagefilter и imageconvolution, зато последняя, написанная на чистом PHP есть в интернeтах).
Далее, я считаю красную компоненту круга
Получилось, на мой взгляд, очень неплохо, но скорость обработки, конечно, снизилась.
Добавлено позже: обновил до 0.2.2 — теперь вся работа с временными файлами делается внутри временной папки (путь до неё берётся из переменных окружения).
Пакетное скругление картинок v0.2
Новая версия пакетного скруглителя картинок. Из нового: короткие имена ключей (их видно после запуска), ключи для сохранения EXIF из оригинального файла
PHP и UTF-8: четвёртый этап
В прошлой части мы
Начнём с eval, его проще всего найти: К счастью, почти всё что я нашёл — это Теперь я попробую найти вообще все Не все Вот что у меня получилось: readline_callback_handler_install, readline_callback_read_char, ob_start, session_set_save_handler, CURLOPT_HEADERFUNCTION, CURLOPT_PASSWDFUNCTION, CURLOPT_PROGRESSFUNCTION, CURLOPT_READFUNCTION, CURLOPT_WRITEFUNCTION, FILTER_CALLBACK, iterator_apply, set_exception_handler, pcntl_signal, array_map, array_filter, array_walk, array_walk_recursive, array_udiff_uassoc, array_diff_uassoc, array_udiff_assoc, array_diff_ukey, array_udiff , array_intersect_ukey, array_uintersect_uassoc, array_uintersect_assoc, array_intersect_uassoc, array_intersect_assoc , array_uintersect, array_reduce, uksort, usort, uasort. Или для командной строки (регулярное выражение я тут подсократил): В выводе нужно высматривать только вызовы строковых функций и статических методов, которые стоят на месте Всё, что осталось найти — вызовы preg_replace с модификатором «e». Я, было, подумал Думаю, в следующей части надо Какие у нас есть варианты?
bolk@dev:~/daproject$ find -type f ( -name '*.php' -or -name '*.tpl' -or -name '*.inc' ) | xargs -n1 egrep -li 'bevals*('
./php/lib/magpierss/extlib/Snoopy.class.inc
./php/lib/PEAR.php
./php/dir1/file1.php
./php/dir1/file2.php
./php/dir1/file3.phpbolk@dev:~/daproject$ find -type f ( -name '*.php' -or -name '*.tpl' -or -name '*.inc' ) |
> xargs -n1 egrep -H 'array_map|array_filter|array_walk|…|uasort' | less
Веб-сервис оптимизации SVG

Евгений Рыжков изготовил из моего скрипта оптимизации SVG
PHP и UTF-8: третий этап (давайте уже что-нибудь заменим)
Ну что ж, всё готово для того, чтобы
Запустить её можно, например, так (напоминаю, что у меня PHP находится в файлах с расширениями php, tpl и inc): Программа напечатает имена файлов, где произошла замена. Своеобразная проверка — запустите её ещё раз, на втором проходе никаких имён файлов выведено быть не должно! Обязательно проследите, чтобы запуск не затронул ваш класс Utf! Итак, мы заменили функции на вызовы класса Utf. Всё работает? У меня не заработало. Причины две — я ошибся в имени одной из функций в классе Utf и появились проблемы с preg_replace_callback. О последней проблеме поподробнее. Пока preg_replace_callback была встроенной функцией всё было замечательно, как только она стала статическим методом класса, проблемы появились. Всё дело в указании в качестве callback метода статического класса. Такие вещи придётся править вручную. Если нет возможности провести тестирование, то можно воспользоваться подсказками IDE — во многих случаях она укажет на такие ситуации, но, в любом случае, лучше все такие места просмотреть глазами. Сегодня ночью я улетаю в Екатеринбург, так что, думаю, это последняя часть на этой неделе. Кстати, остаются ещё строковые функции, вызываемые как callback, внутри eval Что же дальше?
<?
    if ($_SERVER['argc'] <> 3) die;
    if (realpath($_SERVER['argv'][2]) == realpath(__FILE__)) die;

    $file = file_get_contents($_SERVER['argv'][2]);
    if (strpos($file, '<?') === false) die;

    $funcs = file($_SERVER['argv'][1], FILE_IGNORE_NEW_LINES | FILE_SKIP_EMPTY_LINES);
    foreach ($funcs as &$func) {
        list(,$func) = preg_split('/\s+/s', $func, 2, PREG_SPLIT_NO_EMPTY);
    }

    $skip   = false;
    $skipIf = array(T_PAAMAYIM_NEKUDOTAYIM, T_DOUBLE_COLON, T_OBJECT_OPERATOR);
    $fixed  = false;

    ob_start();

    foreach (token_get_all($file) as $token) {
        if (is_scalar($token)) {
            echo $token;
        } else {
            if (!$skip && $token[0] == T_STRING && in_array(strtolower($token[1]), $funcs)) {
                $fixed = print 'Utf::' . $token[1];
            } else {
                echo $token[1];
            }

            $skip = in_array($token[0], $skipIf);
        }
    }

    file_put_contents($_SERVER['argv'][2], ob_get_clean());

    if ($fixed) {
        echo $_SERVER['argv'][2], "\n";
}bolk@dev:~/daproject$ find -type f \( -name '*.php' -or -name '*.tpl' -or -name '*.inc' \) | grep -vF '.svn' |
> xargs -n1 php tool4.php tool-func.log
./php/file.php
./php/dir1/file1.php
./php/dir1/file2.php
./php/dir1/dir2/file3.php
…
PHP и UTF-8: третий этап (создание прототипов)
Этот сериал хорош тем, что я пишу его в реальном времени. Единственно, первая фаза — когда я собирал первоначальные данные и обдумывал как мне подступиться к этой задаче, заняла куда больше времени, чем может показаться. Итак, в предыдущей части мы выяснили какие модули используются в нашем проекте и узнали, что в нём
В этой части мы подготовимся к тому, чтобы заменить в проекте все упоминания небезопасных (с точки зрения работы
Как я уже сказал, расширение Reflection работает в PHP с багами, именно поэтому я максимально подробно стараюсь обработать ошибочные ситуации. После запуска программы, можно подсчитать, какое количество функций (у меня их 10) не отобразилось правильно, ничего не поделаешь, придётся их править руками. Файл Я удаляюсь править прототипы руками, а в следующей части уже перейдём к непосредственной замене. P.S. В коде есть странное место — «blah» . ’\$var’, увы, у меня Что же дальше?
<?
function U_makeproto($funcname)
{
    $func = new ReflectionFunction($funcname);

    $out = '    static public function ' . $funcname . '(';

    $counter = 0;
    $hasRefOptional = $hasOptional = false;
    $names = array();

    foreach ($func->getParameters() as $param) {
        $name = $param->getName();

        if ($name !== null && $name != '...') {
            $names[] = $name = '$' . $name;
        } else {
            $names[] = $name = '$param' . $counter++;
        }

        if ($param->isPassedByReference()) {
            $name = '&' . $name;
        }

        if ($param->isArray()) {
            $name = 'array ' . $name;
        }

        if ($param->isOptional()) {
            $name .= '=';
            $name .= $param->isDefaultValueAvailable() ? $param->getDefaultValue() : 'null';

            if ($param->isPassedByReference()) {
                $hasRefOptional = true;
            }

            $hasOptional = true;
        }

        $out .= $name . ', ';
    }

    $out = rtrim($out, ', ') . ') {';
    if ($counter || !$names) {
        $out .= "\n        // FIXME: Invalid proto ( https://www.php.net//$funcname )\n";
    }

    $out .= "\n        if (self::ON) {".
            "\n            // TODO: UTF version".
            "\n        }\n";

    if (!$hasRefOptional) {
        if ($hasOptional || !$counter && !$names) {
            $out .= "\n        " . '$params = func_get_args();'.
                    "\n        return call_user_func_array('$funcname', \$params);";
        } else {
            $hereNames = implode(', ', $names);

            $out .= "\n        return $funcname($hereNames);";
        }
    } else {
        $reqCounter = $func->getNumberOfRequiredParameters();
        $out .= "\n        switch (func_num_args()) {".
                "\n            case $reqCounter:".
                "\n                " . '$params = func_get_args();'.
                "\n                return call_user_func_array('$funcname', \$params);";

                for ($i = $reqCounter+1, $len = $func->getNumberOfParameters(); $i<=$len; $i++) {
                    $hereNames = implode(', ', array_slice($names, 0, $i));

                    $out .= "\n            case $i:".
                            "\n                return $funcname($hereNames);";
                }

                $out .= "\n            default:".
                        "\n                 trigger_error('Wrong parameter count for $funcname()', E_USER_WARNING);".
                        "\n                 return null;";

                $out .= "\n        }";
    }

    return $out . "\n    }";
}


echo "<?php\nclass UTF\n{\n    const ON = false;\n\n";
foreach (file('php://stdin', FILE_IGNORE_NEW_LINES | FILE_SKIP_EMPTY_LINES) as $funcname) {
    echo U_makeproto($funcname), "\n\n";
}

echo "}";bolk@dev:~/daproject$ sed -re 's/\s+\S+\s+//' tool-func.log | php tool-func-proto.php > utf.php
bolk@dev:~/daproject$ grep -c FIXME utf.php
10