программирование
Makecorner 0.25
Выложил (на то же место) новую версию программы для скругления уголков (я про неё писал в сентябре).
Изменения следующие:
- появился новый параметр ключа —width, можно указать «auto» или просто «a» и программа не будет масштабировать картинку.
- я постарался улучшить оптимизацию JPEG изображений встроенной программой jpegtran: теперь я указываю специальные профили из программы jpegcrush и задаю ключ «grayscale», если JPEG
чёрно-белый (сканирую каждый пиксель и смотрю серый ли он). - появилось «пасхальное яйцо».
Добавлено позже: нашёлкакую-то ошибку с определением серых изображений. Пожалуйста, пока не качайте эту версию.
Ещё позже: поправил. Опечатка в одном месте.
CANVAS 1K Tank Game

Решил попробовать уместить 1020 1023 байта (то есть на четыре один байт меньше, чем килобайт).
Цель — подбить своим «танком» как можно больше вражеских ракет. Управление — курсорными клавишами, стрелять пробелом. Даётся три жизни, за каждые 20 сбитых ракет жизнь добавляется, если ракета долетит до вашей стороны или коснётся танка, жизнь теряется. Для рестарта игры просто перезагрузите страницу.
Должно работать везде, где поддерживается тег CANVAS, я тестировал в «Опере» 11, «Хроме» 10 и FF 3.6.13.
Have a fun!
Ещё позже: на заметку. Я вчера обращался к тегу CANVAS по идентификатору. Это очень длинный способ (не говоря уже о том, что тег должен иметь идентификатор, что ещё тратит место), вчера, когда мне показали JS1K, я там увидел способ короче: «document.body.children[0]», а сегодня я придумал способ ещё короче: «document.all[3]», это нестандартное свойство, но его поддерживают все браузеры. Если использовать это свойство, то программа начинает занимать 1007 байт и у меня появляется ещё 17 байт. Может танк переделать? Мне пришлось упростить графику, И ещё позже: вернул прежний танк и сменил цвет «спецэффекта» при столкновении на красный, игра снова занимает 1020 байт. Если интересно, можно посмотреть как выглядит исходный код JavaScript моей игрушки. И ещё я внезапно придумал как ещё И ещё: сократил Неинтересные технические подробности
Порисовал немного на теге CANVAS, ничего интересного

Попробовал порисовать на теге CANVAS, хотелось хоть
<canvas width="500" height="240"></canvas>
<script type="text/javascript">
(function (c) {
    var img = c.createImageData(500, 240);

    var putPixel = function (x, y, c) {
        var index = (x + y * 500) << 2;

        for (var i = 0; i<4; i++) {
            img.data[index+i] = c[i];
        }
    };

    var x = 0, y = 0, color, leaf, idx,
    k = [
          [ 0.00, 0.00, 0.00, 0.16, 0.00, 0.00 ],
          [ 0.85, 0.04,-0.04, 0.85, 0.00, 1.60 ],
          [ 0.05,-0.26, 0.23, 0.22, 0.00, 1.60 ],
          [-0.15, 0.30, 0.26, 0.24, 0.00, 0.44 ],
    ];

    for (var i = 0; i<200000; i++) {
        leaf = Math.random();

        if (leaf <= 0.010) leaf = 0; else
        if (leaf <= 0.860) leaf = 1; else
        if (leaf <= 0.930) leaf = 2; else
        leaf = 3;

        x = x * k[leaf][0] + y * k[leaf][1] + k[leaf][4];
        y = y * k[leaf][2] + y * k[leaf][3] + k[leaf][5];

        putPixel(parseInt(y * 55), 120 - parseInt(x * 40), [10, 100, 20, 255]);
    }

    c.putImageData(img, 0, 0);
})(document.getElementsByTagName('canvas')[0].getContext('2d'));
</script>ГИМП — говно
Похоже весь opensource служит одной цели — чтобы мы, когда покупаем программы, могли сравнить и увидеть за что платим.
Скачал бесплатный графический редактор ГИМП, чтобы подредактировать пару фотографий. В диалоге открытия файла, чтобы ГИМП показал мне миниатюру файла, мне предлагается кликнуть сначала на файл, потом на место, где должна появиться миниатюра! Два клика и куча движений мышью на каждый из 120 файлов, в котором я хочу найти нужный.
И вот так там всё.
UTF-8: быстрые регулярные выражения в PHP
Утром я написал пост о производительности различных движков регулярных выражений, а весь день перебирал разные варианты, смотрел подробности и так далее.
Как я уже писал, мне понравилась библиотека RE2, я даже скомпилировал её и посмотрел, к сожалению, оказалось, что она использует треды, а в PHP с этим не очень (не все модули PHP thread safe, поэтому чаще всего PHP собирается без поддержки тредов).
Я уже начал смотреть другие библиотеки, когда Алексей Захлестин напомнил мне про модуль PHP Multibyte String (функции mb_*), который содержит в себе движок регулярных выражений Oniguruma.
Я всегда плохо относился к этому движку, так как считал, что у него очень бедные возможности для работы
Сегодня я присмотрелся к движку получше. Конечно, PCRE он не заменит, но некоторых случаях вполне сможет его подменить как быстрый аналог, только надо применять несколько правил (речь идёт о версии 4.7.1, которая в PHP):
Я погонял тесты, сравнивал PCRE в режиме полном
bolk-dev ~/regexp-benchmark $ php test.php
PCRE Full UTF-8: 1.0458080768585
Oniguruma: 0.24942803382874Производительность различных библиотек регулярных выражений
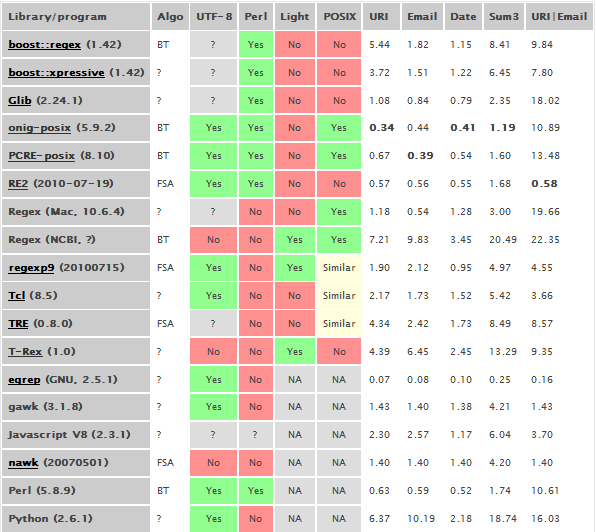
Много читал с утра о библиотеках регулярных выражений. Хочется найти такую, чтобы работала
Автор сравнивает по скорости обработки три регулярных выражения, правда довольно несложных, на приличного объёма тексте. Но даже и на этих несложных регулярках есть явные аутсайдеры — например, Python (хотя другие тесты дают другие результаты).
Жалко автор не составил такую же таблицу для режима
Например, мне из таблицы понравилась библиотека RE2, она показывает хорошие результаты, при этом в последнем тесте вырывается далеко вперёд. Правда в ней не реализована часть синтаксиса (например, нет backreferences), но это я бы пережил. А вот насколько она эффективная в режиме
Кстати, скрипты для тестирования доступны для скачивания. Можно попробовать переключить пару библиотек
Добавлено позднее: раз доступны скрипты тестирования, я решил посмотреть не находится ли уже RE2 в режиме
RE2 p(argv[1]);
buf = (char*)calloc(BUF_SIZE, 1);
while (fgets(buf, BUF_SIZE - 1, stdin)) {
        ++l;
        for (q = buf; *q; ++q); if (q > buf) *(q-1) = 0;
        if (RE2::PartialMatch(buf, p))
                printf("%d:%sn", l, buf);
}
free(buf);
Чтобы выключить режим
Прозрачный фон SVG в Хроме и Сафари
Владислав Шкодин написал статью на «Хабре», где рассказал как ему удалось победить старый баг в движке WebKit — если вставить SVG с прозрачным фоном в тег OBJECT, что «Сафари» и «Хром»
Решение очень простое. Прямо внутри файла SVG, после тега svg нужно написать следующее:
<style>
    svg { -webkit-background-clip: text; }
</style>
UTF-8: как быстрее получить длину строки
Как я уже писал, сегодня ночью я наткнулся на вариант измерения длины
Сегодня я почистил код (в PHP известна бинарная длина строки, поэтому я убрал проверки на символ с кодом ноль и соптимизировал код), сгенерировал таблицу HammingWeight, которая отсутствует в коде автора и перевёл проверку в двух крайних циклах на подобную таблицу.
Потом это всё скомпилировал и погонял тесты.
Сначала я получил очень странные результаты и только потом понял что случилось. В общем, разрыв в скорости функций (mb_strlen и той, что на SSE2) тем больше, чем ближе тестируемая строка к однобайтовой. Чаще всего, с SSE2 быстрее встроенной в PHP в 5—8 раз:
thasonic-dev ~/uni/futf-0.1 $ php ../test/test_strlen.php | sort -k2 -t:
SSE2 UTF-8:                 0.025604963302612
mb_strlen:                   0.15917205810547
strlen/utf8_decode:   0.62052989006042
Что совсем странно, прежнего впечатляющего результата с прежними данными и функциями я получить не смог, правда, есть подозрение, что за ночь сменилось оборудование (были аппаратные проблемы на машине) на сервере, где я производил замеры.
В общем, о приросте в 24 раза остаётся только мечтать.
Похоже, это почти предел на сегодняшний момент. Единственная возможность ускорения, которая приходит в голову — использовать GPU на видеокарте. Например, видеокарта GTX275 управляется с 16000 потоков (!), что позволяет подсчитать длину строки порциями по 15,5КБ!
Но это больше из разряда
Так что оставлю как есть, займусь переписываем substr в SSE2, а потом выложу всё в открытый доступ.
Добавлено позднее: в следующем году Intel и AMD выпустят процессоры, поддерживающие набор комманд AVX, интересно там то, что размер регистров SIMD (которые используются и в SSE) расширяется до 256 бит. То есть через
UTF-8: как быстро получить подстроку (+новый вариант strlen)
Из кода быстрой функции strlen
Я вкомпилил эту функцию в PHP, помог найти ошибки и отладить и сделал замеры:
bolk-dev ~/uni/futf-0.1 $ php ../test/test_substr.php  | sort -k2 -t:
Fast UTF-8: 0.18010711669922
mb_substr:  0.87068700790405
Разница примерно в 4 раза. Я ещё попробовал отрезать строку через функцию preg_match, сравнимо по скорости с mb_substr, но медленнее и есть ограничение — квантификатор preg_match не захватывает больше 65535 символов.
Добавлено позднее: после того как мы отладили эту функцию, я вспомнил про команды ассемблера SSE — это наборы команд (сейчас их пять — SSE1, 2, 3, 4.1 и 4.2), которые оперируют восемью регистрами размером 128 бит.
Как я рассказывал, самый быстрый алгоритм для strlen, который я нашёл, работает следующим образом: сначала указатель на строку первым циклом выравнивается по границе 4 или 8 байт (в зависимости от архитектуры процессора), чтобы процессор смог быстрее читать дальше, потом, работая сразу с числом длиной 4 или 8 байт, одной операцией подсчитывается сколько в выделенной строке содержится начальных байт символов.
Если внутри нашего рабочего участка встречается символ с кодом ноль (признак конца строки), то происходит выход в последний цикл, который занимается тем, что просматривает побайтно получившийся «хвост».
Час назад я поставил себе gcc под Windows и стал потихоньку писать примерный код, читать документацию, изучать команды в интернете, пока совершенно случайно не наткнулся на уже готовый вариант, написанный с применением инструкций SSE2.
Нашёл в интернете тест для таких функций, включил туда найденную и сделал замеры:
C:\MinGW\bin\test.exe
cp_strlen_utf8:          0.105706
cp_strlen_utf8_sse2: 0.030002
В 3,5 раза обгоняет предыдущий вариант, то есть, смею надеяться, обгонит встроенную в PHP функцию примерно в 24 раза. Завтра попробую.
Немаловажно, что даже на машинах с архитектурой 32 бита рассматриваемый вариант покажет ту же скорость, что и на машинах 64 бита.
99 бутылок: КуМир
47. КуМир — очередной неинтересный язык программирования «Комплект учебных Миров или Миры Кушниренко».
В 1995 году «КуМир» (о ужас!) был рекомендован Министерством образования РФ в качестве основного учебного материала по курсу «Основы информатики и вычислительной техники» на основе учебника А. Г. Кушниренко, Г. В. Лебедева и Р. А. Свореня.
Совершенно неинтересно про него рассказывать, если честно, хотя среда разработки очень неплоха в плане диагностики ошибок.
Добавлено позднее: Язык оказался диалектом или реализацией уже известного мне языка «РАЯ».
| написал Евгений Степанищев bolknote.ru

алг песня про пиво
нач
    цел пиво
    нц для пиво от 99 до 1 шаг -1
        вывод сколько пива(пиво), ' on the wall, ', нс
        вывод 'Take one and pass around,', нс
        вывод сколько пива(пиво-1), ' on the wall.', нс, нс
    кц
    вывод "No more bottles of beer...", нс
    вывод "Go to the store and buy some more...", нс
    вывод "99 bottles of beer."
кон

алг лит сколько пива(цел пиво)
нач
    если пиво = 0 то
        знач:="No"
    иначе
        знач:=цел_в_лит(пиво)
    все

    знач:=знач + ' bottle'

    если пиво <> 1 то
        знач:=знач+'s'
    все
конПосмотрел на Perl6
Очень давно хотел посмотреть во что превратился Perl6 за те годы, что я его не видел. Посвятил четыре часа своей жизни на изучение. Что я хочу сказать, богатейший язык при беднейшей документации. Синтаксис, как и положено языку Perl, позволяет сделать одно и то же миллионом различных способом, 99% из которых нечитаемы.
Я в восторге.
К сожалению, не всё описанное в документации работает (например, lvalue-метод substr класса Str у меня работать отказался),
Сегодня на «Хабре» появилась интересная статья, где описывался нормальный алгоритм Маркова для деления двух целых чисел с точностью 4 знака после запятой в унарной системе счисления. То есть: |/|||| = 0.25, ||/||| = 0.6666 и так далее.
Замены в статье уже описаны, осталось реализовать алгоритм (в заменах я поменял пустую строку на два апострофа: ’’). Привожу с сокращением списка замен:
use v6;

my $входная = '||/|||';
my @замены  = <%* *% %| %* *| ** |* t t* *t …тут просто замены через пробел… p^ '' p .FIN _ .FIN>;

loop {
    my $нашёл = Bool::False;
    my $начтонадо;

    for @замены -> $что, $начто {
        my $где = $входная.index($что);

        if defined $где {
            $нашёл = Bool::True;

            given $начто {
                when <''>  {
                    $начтонадо = ''
                }
                when /FIN/ {
                    ($начтонадо = $начто) ~~ s[FIN] = '';
                    $нашёл = Bool::False;
                }
                default    {
                    $начтонадо = $начто
                }
            }

            #`{
                К сожалению, lvalue метод не сработал:
                $входная.substr($где, $что.chars) = $начтонадо;

                выдаёт «cannot modify readonly value
            }

            $входная = $входная.substr(0, $где) ~ $начтонадо ~ $входная.substr($где + $что.chars);
            say $входная;
            last;
        }
    }

    last unless $нашёл;
}
END {
    $входная.say;
}
К сожалению, не удалось использовать итераторы, они недостаточно хорошо описаны,
Меня очень радует нативная поддержка Unicode, которая реализована куда глубже, чем в Python, к примеру, конструкция языка >> может быть заменена на », в качестве ограничителей (например, многострочного комментария) можно использовать символы 「 и 」, а say "Ⅰ".succ правильно выдаёт Ⅱ).
Наворотили в языке много. Отдельной строкой — регулярные выражения. Синтаксис совсем другой, мне кажется более продуманным, чем тот, что сейчас в Perl5 (и тем более в PCRE), возможностей стало больше, а выражения выглядят аккуратнее.
Судьба PHP6
Поговорил с одним из разработчиков PHP по поводу судьбы PHP6, самое ожидаемое изменение которого — переход на юникодные строки. Так вот Антон Довгаль рассказал, что проект, по сути, заброшен. Те несколько человек, которые занимались проектом, либо уволились, либо потеряли к нему интерес и сейчас считается, что поддержка юникодных строк в языке не так уж и нужна.
На примере своего опыта разработки и перевода проектов на PHP
То, что в PHP приходится для поддержки Юникода работать
Работать в PHP
Если бы этот язык нативно поддерживал
UTF-8: как быстрее измерить длину строки в PHP
Я потихоньку буду писать как получается оптимизировать самые важные функции работы
Сейчас, после перевода «Вики» мы столкнулись с тем, что некоторые операции занимают непозволительно много времени.
Простые оптимизации я уже применил: выкинул из класса
Одна из самых частоиспользуемых функций — strlen, которая определяет длину строки. Я всегда считал, что самый быстрый способ подсчитать длину
Мои тесты показывают что это не так. Самый быстрый способ (по крайней мере в PHP 5.3.2) — это mb_strlen, strlen/utf8_decode — на втором месте, потом идёт sizeof+preg_split, а самый медленный — iconv_strlen.
Для интереса я вкомпилил в PHP функцию для быстрого подсчёта длины строки
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
Fast UTF-8: 0.68232107162476
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это тысяча итераций на файле в 400КБ.
Я оставил функцию mb_strlen.
Добавлено позднее: другая быстрая функция дала ещё худший результат: 0,79, против прежнего варианта в 0,68.
Добавлено ещё позже: а вот третья функция показала действительно впечатляющие результаты:
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
More Fast UTF-8:  0.12948799133301
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это уже дело — она почти в 7 раз быстрее лучшего результата PHP.
Вкратце, алгоритм такой: строка циклом выравнивается по границе четырёх
Добавлено через несколько дней: есть и ещё более быстрая функция.
HTTP-заголовок Default-Style
Если бы я сейчас на ночь глядя не решил почитать по диагонали спецификацию тега LINK, то так, наверное, никогда в жизни бы и не узнал о существовании
Если у вас подключены несколько таблиц стилей к одному документу, вы можете дать им имя, прописав его в атрибуте «title», и выбрать его через
<head>
<style type="text/css" title="right">
body {
  background: blue;
}
</style>

<style type="text/css" title="wrong">
body {
  background: red;
}
</style>

<meta http-equiv="Default-Style" content="right" />
</head>
Работать должен только стиль с именем «right» (можно дать и русские имена). Слово должен я выделил, потому что это стандарт. Жизнь, как всегда, богаче.
Я проверил на браузерах, которые у меня есть, в «Опере» 11 RC3 и Internet Explorer 9 beta это не работает, работает в Firefox 3.6.12, Safari 5 и Chrome 9.0.597.19, можете проверить свой браузер, фон должен быть синим.
Можно из этого сделать своеобразный
Добавлено: во встроенном браузере на моём «Нексусе» работает («Андроид» 2.2.1), в Firefox 2.0 и Chrome 5.0.375.125 — тоже.
Добавлено ещё позже: в комментарях меня поправляет Денис Попов: по стандарту если заданы несколько тегов LINK, задающих стили с title, то выбирается первый («Опера» и «IE» нарушают стандарт уже в этом месте, я проверил), если не задан специальный
Прочитайте комментарий, там есть немаловажные подробности.
Невидимая страница
Если бы мне сегодня показали исходник страницы (будет видно только в «Опере» и «FireFox»), который я встретил сейчас на «Хабре», я был бы озадачен куда больше.
Кода у этой страницы просто нет. Ларчик открывается (в «Опере» и FF) просто: есть такой RFC 5988, озаглавленный «Web Linking», где описан способ подключать в документ различные ресурсы прямо через
Идея проста: подключаем через заголовок CSS для пустой страницы и внутри CSS уже формируем то, что нужно (текст можно писать через свойство «content»).
Link: </pathto/magic.css>;rel=stylesheetWebSocket отключают в браузерах
В WebSocket (протоколе) нашли дыру, в этой связи «Опера» 11 и FF 4 отключат у себя реализацию этого протокола до решения проблем безопасности.
Добавлено: подробный обзор проблемы есть на «Хабре»
Придумал название для какой-нибудь новой Wiki
Если я
MySQL и строки
Век живи, век учись.
Не знал, что в MySQL есть своеобразный typecast для строк — можно объявить любой collate для строки вот таким простым синтаксисом (я всега пользовался «’строка’ COLLATE latin1_danish_ci» и ему подобным):
SELECT n'текст' -- эквивалентно следующей строке
SELECT _utf8'текст'

SELECT _binary'aaa' = _binary'AAA' -- эти строки не равны (бинарное сравнение)PCRE 8.10
Заодно, после перевода проекта
Для этого я собрал специальный модуль YGX, это тот же extension PCRE, только с новой версией библиотеки (кстати, модуля пришлось делать два — для PHP 5.2.xx и 5.3.xx отдельно).
Теперь, когда у меня в PHP два вида функций — preg_* (старая PCRE) и ygx_* (новая PCRE 8.10), можно сравнивать поведение обоих. Вот первый небольшой тест:
bolk-dev ~/wiki $ php -r 'var_dump(ygx_replace("/a?/u", "", "abc"));'
string(2) "bc"
bolk-dev ~/wiki $ php -r 'var_dump(preg_replace("/т?/u", "", "тест"));'
string(4) "ес"
bolk-dev ~/wiki $ php -r 'var_dump(ygx_replace("/т?/u", "", "тест"));'
NULL
Как видно, PCRE 8.10 в последнем случае выдаёт NULL. Такое поведение похоже на баг. Выражение, конечно, довольно бессмысленное, но на практике оно встретилось в составе более сложного.
Чтобы в этом случае не получался NULL (хотя правильного результата всё равно не будет), можно поставить «глагол» «(*FAIL)» (это специальное значение, который ни с чем не совпадает):
bolk-dev ~/wiki $ php -r 'var_dump(ygx_replace("/(*FAIL)т?/u", "", "тест"));'
string(8) "тест"
Стоит ввести в выражение хоть
Что делать в этом случае, кроме как переписать регулярное выражение полностью, я пока не придумал.
Аппаратное ускорение PHP
Обсуждается возможность аппаратного ускорения PHP, точнее использования в коде возможностей GPU, в данный момент речь идёт о библиотеке CUDA фирмы NVIDIA.
Первое что приходит в голову — это ускорение сортировок чисел и вычисление md5/sha1. Я слишком слабо разбираюсь в вопросе, чтобы понять с первого взгляда куда ещё можно приспособить графические ускорители.