mysql
Эмодзи в MySQL
Вчера при импорте на сайт реакций из «Телеграма» заметил
Пошёл разбираться, выяснилось, что в базе всё лежит отдельно, как положено. Нейросеть «Сол» обнаружила странное — несмотря на то, что эмодзи «глаз» и «палец» имеют разные коды, «МайЭсКьюЭль» считает их одним значением и объединяет при группировке.
Вот тут «Сол» меня сильно расстроил. Сначала он предложил группировать через функцию HEX() . Решение само по себе плохое, но проблема ещё и в том, что движок сайта поддерживает три СУБД, и в «Постгресе» такой функции нет, а генерировать разные запросы под базы не очень хочется.
Тогда он решил считать хеш через PHP, чтобы группировать по нему. К сожалению, в этот момент я не следил за окном, где он копался, и он успел это реализовать и даже задеплоить.
Меня такая реализация категорически не устроила. Мне в целом понятно, что проблема связана с тем, что называется «collate» — в СУБД это набор правил, по которым сравниваются строки. У «МайЭсКьюЭля» много особенностей при работе с Юникодом, с которыми я уже сталкивался, поэтому был уверен, что дело именно в одной из них.
Готовый рецепт нашёлся безо всяких проблем. Чтобы эмодзи сравнивались правильно, нужно установить «collate» для этого столбца как utf8mb4_bin, что мы и сделали. Не думаю, что это необходимо, тем не менее для остальных баз мы выставили в этом месте бинарный «collate» — С для «Постгреса» и BINARY для «ЭскуэльЛайта».
InnoDB full-text search
Хорошие новости, оказывается, с версии 5.6.4 MySQL поддерживает полнотекстовые поиск в InnoDB (12 лет прошло с момента появления этого движка в Майэскюэле) и, кстати, в версии 5.5 и выше
Поиск пропусков в таблице
У нас тут сегодня на работе возникла гипотетическая потребность найти пропуски в конкретной таблице базы данных. Так как я кроме как с MySQL в последнее время ни с чем не имел, прикинул как бы я решил эту задачу там. Получилось
SELECT id FROM (
    SELECT id, id-@prev AS diff, @prev:=id
    FROM
        (SELECT @prev:=NULL) ``,
        sourceofdata
   ORDER BY id
) `` WHERE diff>1
Внутри есть напрасный запрос «SELECT @prev:=NULL», который там только затем, чтобы решение получилось в одну строку.
Может
int(?) в MySQL
Кто уверен, что точно знает что означает тип «int(11)» в MySQL? Я именно «интами» не пользовался никогда, всегда заводил через tinyint и т. п., поэтому, глядя на то СУБД в эти скобочки сама подставляет
Оказывается, это размер да не тот:
int(i) i — это не ограничение разрядности, int всегда одинаков -2³¹
до +2³¹-1 (или 0до 2³²-1), а ограничение количества показываемых символов при отображении столбца, его значение от 1 до 255. Например, INT(5) объявляет столбец целого типа который при отображении будет выводиться в колонках по пять цифр.Если в столбце реально записано значение которое нельзя отобразить
5-тью цифрами то оно будет отображено большим количеством символов, т. е. при выводе значение не усекается.
Так что будете заводить в следующий раз таблицу в MySQL, где идут подряд пять целых чисел, задайте им размерности 72, 101, 108, 108 и 111. Получится по кодам «Hello» в кодировке ASCII. Кто за вами потом разгадает, получит удовольствие.
Внимание: MySQL считает, что буквы «ё» и «е» — одно и то же.
Увы, MySQL, если выбрать кодировку Unicode, считает, что «е» и «ё» — это одно и то же. Багом это не считается, в официальной таблице, где описано как MySQL 6.0 сравнивает символы, эти символы в одном ряду.
mysql> set names utf8 collate utf8_unicode_ci;
Query OK, 0 rows affected (0.00 sec)

mysql> select 'е'='ё', 'ё'='ѐ'\G
*************************** 1. row ***************************
'е'='ё': 1
'ё'='ѐ': 1
1 row in set (0.00 sec)
Самое печальное, это нелогичное поведение всплывает, если есть потребность перевести базу с CP1251
mysql> set names cp1251;
Query OK, 0 rows affected (0.00 sec)

mysql> select 'е'='ё', 'ё'='ѐ'\G
*************************** 1. row ***************************
'е'='ё': 0
'ё'='ѐ': 0
1 row in set (0.00 sec)
Чем это может быть плохо? Например, у нас
mysql> set names utf8 collate utf8_unicode_ci;
Query OK, 0 rows affected (0.00 sec)

mysql> create table surname(surname varchar(255) primary key);
Query OK, 0 rows affected (0.07 sec)

mysql> insert into surname values('Рублёв');
Query OK, 1 row affected, 1 warning (0.00 sec)

mysql> insert into surname values('Рублев');
ERROR 1062 (23000): Duplicate entry 'Рублев' for key 'PRIMARY'
Я придумал только один способ, исправляющий это поведение (но у него есть недостаток):
mysql> create table surname(surname varchar(255) primary key collate 'utf8_bin');
Query OK, 0 rows affected (0.02 sec)

mysql> insert into surname values('Рублёв');
Query OK, 1 row affected (0.00 sec)

mysql> insert into surname values('Рублев');
Query OK, 1 row affected (0.00 sec)

mysql> select * from surname where surname='рублев';
Empty set (0.00 sec)
Я выключил case insensitive у данного столбца, явным указанием «collate». Это полностью решает проблему с «ё», но лишает нас удовольствия искать, не заботясь о совпадении регистра.
MySQL и строки
Век живи, век учись.
Не знал, что в MySQL есть своеобразный typecast для строк — можно объявить любой collate для строки вот таким простым синтаксисом (я всега пользовался «’строка’ COLLATE latin1_danish_ci» и ему подобным):
SELECT n'текст' -- эквивалентно следующей строке
SELECT _utf8'текст'

SELECT _binary'aaa' = _binary'AAA' -- эти строки не равны (бинарное сравнение)Mongo vs. MySQL
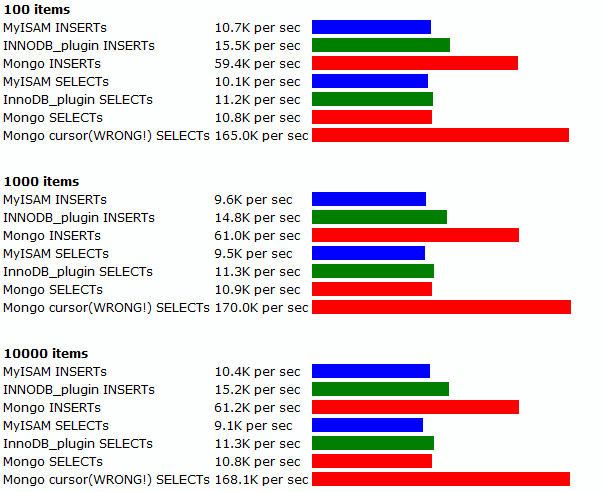
Сравнение скорости MongoDB и MySQL на вставку и чтение. Как видно из данных, MongoDB
Конечно, это достаточно сферические тесты, но голые чтение/запись тоже интересны.
На графу «Mongo cursor (WRONG)» внимания не обращайте, это ошибочные данные.
XML в MySQL
Кавычки вокруг слова «чудесный» какбэ намекают, что я
Речь идёт о двух функциях — ExctractValue и UpdateXML. Если в поле таблицы хранится XML, то первая функция позволит выбрать данные при помощи XPath, а вторая — (при помощи XPath же) изменить
Примерно так:
SELECT ExtractValue('<a>c</a><b/>', '//a');

SELECT UpdateXML('<a><b>ccc</b><d></d></a>', '/a', '<e>fff</e>');

SELECT * FROM users WHERE ExtractValue(info, '//firstname') == 'Иван' AND ExtractValue(info, '//surname') == 'Сагалаев';
В случае, если XPath не дал результата или в поле оказался не XML, функции вернут NULL (версии MySQL до 5.1.12 содержат баг и частично могут работать даже
MySQL 5.1 не готов
MySQL 5.1 ставить на production нельзя:
We still have 20 known and tagged crashing and wrong result bugs in 5.1 35 more if we add the known crashing bugs from 5.0 that are likely to also be present in 5.1.
We still have more than 180 serious bugs (P2) in 5.1. Some of these can be found here.
We have more than 300 known and verified less critical bugs that are not going to be addressed soon. (The total reported number of bugs to the MySQL server is of course much larger
Пишет о свежем релизе MySQL 5.1 Michael Widenius, «родитель» MySQL, который занимает сейчас пост технического директора в MySQL AB.
Для тех, кто не читает
A Quick Look at MySQL 6.0’s New Backup
На сайте для разработчиков под MySQL появилась интересная статья «A Quick Look at MySQL 6.0’s New Backup», о том что есть в MySQL 6.0 для резервного копирования данных. Вообще в MySQL это было больное место, особенно на нагруженных проектах — как сделать резервное копирование без остановки проекта, наконец
Sun MySQL
Уже все интересующиеся в курсе, что Sun купила MySQL AB? Сумма сделки — 800 миллионов долларов США и 200 миллионов в качестве опциона. Людям особенно интересно что будет с InnoDB, который принадлежит Oracle и, по сути, является единственным нормальным движком в MySQL. Конечно, MySQL разрабатывали очень хороший storage Falcon, но до его завершения ещё далеко.
Оптимизация MySQL InnoDB
Давно хотел записать, чтобы не потерять. Выдержка из главы «Defragmenting a Table» руководства по MySQL:
It can speed up index scans if you periodically perform a “null” ALTER TABLE operation: ALTER TABLE tbl_name ENGINE=INNODB
That causes MySQL to rebuild the table. Another way to perform a defragmentation operation is to use mysqldump to dump the table to a text file, drop the table, and reload it from the dump file.
Пример скрипта для автоматической дефрагментации — дальше.
mysql_connect('localhost', 'root', 'пароль');

$res = mysql_query('SHOW DATABASES');

while (list($dbname) = mysql_fetch_row($res))
{
        mysql_select_db($dbname);

        $rec = mysql_query('SHOW TABLE STATUS');

        while ($data = mysql_fetch_object($rec))
        if ($data->Engine == 'InnoDB')
        {
                echo 'Processing ', $dbname, '.', $data->Name, ' ... '; flush();

                mysql_query("ALTER TABLE {$data->Name} ENGINE=InnoDB");

                echo "done.n";
        }

        mysql_free_result($rec);
}

mysql_free_result($res);
Скажи спасибо, сволочь!
Фраза из руководства по MySQL (вариант руководства на русском):
Благодаря этому удобному синтаксису, в сервере MySQL не поддерживается оператор ANSI SQL || для конкатенации строк: вместо него используется функция CONCAT().
«Благодаря… не поддерживается»? Не вижу причин благодарить.
Вложенные запросы в MySQL
В интернете есть слухи о вложенных запросах в MySQL 3.xx.
Базы данных. Наведем порядок
Устав бороться со своей и чужой ленью, я решил принять
Естественно, что файл предназначен для описания достаточно небольших баз данных (менее 7—10 таблиц). В этом случае больших баз без хорошо составленной наглядной документации все равно не обойтись. Не надейтесь. :)
Четкий формат представления имеют пока только таблицы, в силу того, что остальными объектами приходится пользоваться достаточно редко, да и синтаксис их описания различается для разных СУБД, но, возможно, в следующих версиях формата появятся правила и их описания тоже.
Вот пример описания двух таблиц, связанных между собой
[/usr/local/pgsql/bin/psql eshop]

items / товары
-----------------------
id              serial / идентификатор
gid             int4   / категория товара -> group.id
name            text   / наименование
price           real   / цена
comment         text   / описание товара

CREATE INDEX items_price_idx ON items (price)

group / категории
-----------------------
id              serial  / идентификатор -> items.gid
parent          int4    / родитель в дереве. -1, если верхний уровень -> id
name            text    / наименование
Думаю из примера и так все понятно, но я
Строчка, заключенная в квадратные скобки, — команда, принимающая данные. Пустые строки и строки, начинающиеся с двух минусов игнорируются. В абзаце, где описывается таблица, первым идет ее имя, ниже — описания ее полей: наименования, через табуляцию тип. В конце каждой значимой строки через пробел и слеш находится ее краткое описание.
Инструкции заведения секвенсоров, представлений и хранимых процедур записываются в одну строку.
Так как формат файла представлений достаточно легко может быть разобран и преобразован в команды мониторов mSQL, PostgreSQL и MySQL я, пару дней назад, выбрав время, написал небольшую программку на Перле. Правда толком ее еще не обкатал, но не думаю, что с ее эксплуатацией возникнут
Интепретатор файлов таблиц: intp.pl
#!/usr/bin/perl

sub StripComment
{
        my ($line) = @_;
        unless ($line=~s{^([^/]*)\s+/.+}{$1}o)
        {
                print "Предупреждение: не указан комментарий [ $line ].\n"
                unless ($line=~/^CREATE/o);
        };

        return $line;
};

sub AddData
{
        my ($table, @query) = @_;
        my $query  = join ',', @query;
        my $result = '';

        if ($todrop)
        {
                for (@query)
                {
                        if (/([^ ]+) serial$/)
                        {
                        $result.= "DROP SEQUENCE ${table}_${1}_seq\\g\n";
                        last;
                        };
                };


                $result.= "DROP TABLE $table\\g\n";
        };

        $result.= "CREATE TABLE $table ($query)\\g\n";

        return $result."\n";
};

sub AddDrop
{
        my $table = $_[0];

        if ($todrop && $table=~/^CREATE ([^ ]+ +[^ ]+)/o)
        {
                return "DROP $1\\g\n$table\\g\n";
        } else
        {
                return "$table\\g\n";
        };
};

unless (open F, (shift or '.tables'))
{
        print <DATA>;
        die "\n"
};

@query  = ();
$table  = '';
$result = '';
$comm   = '';
$todrop = shift or 0;

while (<F>)
{
        chomp;
        next if ($_ eq '' || /^\-\-/);

        if (/^\[(.+?)\]$/)
        {
                $comm = $1;
                next;
        };


        @data =  split (/       +/,StripComment $_);
        if (@data < 2)
        {
                $result.= @query?AddData($table, @query):AddDrop ($table)
                if ($table ne '');

                $table  = $data[0];
                @query  = ();
        } else
        {
                push @query, "$data[0] $data[1]";
        };
};

close F;

$result.= AddData ($table, @query) if (@query);

if ($result ne '')
{
        if ($comm ne '')
        {
                open  F, "|$comm";
                print F "$result\\q";
                close F;
        } else
        {
                print "Ошибка: не указана команда для приема данных.";
        };
} else
{
        print "Ошибка: файл для обработки пуст.";
};

__END__

Интерпретатор файлов таблиц для СУБД.
Написал Евгений Степанищев (2000 год).

Использование: inpt.pl имя_файла [DROP]

DROP - предварительно сделать DROP для таблиц и SEQUENCE

Формат:

-- БД stat                              комментарий

tablename / описание                    имя таблицы
---------------------                   оформительский элемент

поле1   тип / описание                  поля таблицы,
поле2   тип / описание                  описание интепретатор игнорирует
и т.д.

[/usr/local/mysql/bin/mysql stat]       комманда, принимающая данные
P.S. Если
P.P.S. Вышеописанное ни в коем случае не претендует на панацею и всеобъемлющий инструмент, а всего лишь на роль мелочи, которая поможет избежать некоторых возможных трудностей.
Софт. FAR 1.70b2, MySQL, PostgreSQL…
Новость дня — вышел FAR 1.70b2 build 321. С некоторый пор этот, один из лучших (скажу лучший — заклюют :) файловых менеджеров, разрабатывается не одним человеком, а группой разработчиков (FAR Team). С этих же самых пор список WhatsNew каждой новой версии поражает своим размером. Вот и на этот раз, я насчитал 64 пункта! Приставки Beta бояться не нужно, FAR Team обещает выпустить release только в случае полного отсутствия багов. То есть никогда :). Так что — качать!
Продолжая тему FARa.
Смешно, но факт — я знаю людей, которые пользуются FARом, начиная чуть ли не с первой версии и не знают о существовании такий вещи, как плагины. На всякий случай, сообщу. Сам FAR — это еще не все. К нему существуют «довески», называемые плагинами, которые сильно расширяют его функциональность. Например, есть плагины для чтения почты, работы с FTP через Proxy-сервер, проигрывания музыкальных файлов (точнее управления WinAMP’ом) и многого другого. Плагины можно взять на сайте PlugRing, ссылка на который есть в конце статьи (см. «ссылки по теме»).
Из других новостей мира вареза — появление MySQL
Так что, если будете выбирать СУБД для Веба… вы знаете, что я бы посоветовал.