utf8
Чуть более быстрый подсчёт длины строки в UTF-8
Сегодня очень плохо спал — всё время просыпался, потом долго ворочался, не мог уснуть. Утром оказалось мозг никак не мог успокоиться после вчерашней заметки про разбор быстрого алгоритма для подсчёта длины строки в
Вчера я остановился на том, что у разбираемого способа есть две очевидные недоработки — ненужное вычисление, которое решается инвертированием условия и подсчёт «хвоста», который всегда вычисляется «классическим» способом — без векторизации, хотя если строка у нас кратна вектору, можно было бы этого избежать.
Первый недостаток исправлялся очень просто, а хорошая реализация второй проверки мне вчера в голову не пришла.
Зато, когда я проснулся, она уже была у меня в голове. Всего три операции — первой получаем вектор, где на позициях с ненулевым байтом записывается 255, потом делается операция «И» с номерами позиций и весь вектор суммируется.
В итоге, если ноль стоит в векторе только на крайней правой позиции, у нас получается сумма арифметической прогрессии без последнего элемента.
По замерам такой вариант чуть быстрее.
size_t strlen_utf8(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-63);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            uint8x16_t pos = {1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16};
            uint8_t sum = vaddvq_u8(vandq_u8(vtstq_u8(operand, operand), pos));

            // арифметическая прогрессия без последнего члена
            if (sum == 16*(16+1) / 2 - 16) {
                uint8x16_t gt = vcgtq_s8(operand, threshold);
                return len + vaddvq_u8(vandq_u8(gt, delta)) - 1;
            } else {
                break;
            }
        }

        uint8x16_t gt = vcgtq_s8(operand, threshold);
        len += vaddvq_u8(vandq_u8(gt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Разбор быстрого подсчёта длины строки в UTF-8
Давайте попробуем
Напомню как выглядел код:
size_t strlen_php(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-64);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            break;
        }

        uint8x16_t lt = vcltq_s8(operand, threshold);
        len += sizeof(uint8x16_t) - vaddvq_u8(vandq_u8(lt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Для ускорения подсчёта в алгоритме используется векторизация, — это когда мы работаем с пачкой чисел, делая над каждым из них
Вектор загружается функцией vld1q_s8, где коды символов считываются по адресу, записанному в указателе p. В дальнейшем мы будем его сдвигать на размер вектора, чтобы забирать следующую пачку данных.
Ниже используется функция vminvq_u8, которая вычисляет минимальное значение в векторе, рассматривая его как набор байтов без знака. Если там ноль, значит строка кончилась и в нашем векторе — хвост, который надо досчитать обычным способом, без вектора. Тут можно было бы проверить на какой позиции слева находится признак конца строки, если на самой последней, то строка была кратна вектору. Но я не стал заморачиваться. Но такая проверка оказалась медленнее подсчёта длины хвоста обычным способом.
Дальше функция vcltq_s8 сравнивает каждый байт в векторе со значением −64 — это значение загружается в каждый элемент вектора для сравнения функцией vdupq_n_s8.
Результирующий вектор заполняется значениями 0 или 255, в зависимости от результата сравнения. Функция vandq_u8 производит операцию «И» с единицей, после чего у нас в векторе ноль остаётся неизменным, а 255 превращается в единицу. Эти единицы мы суммируем функцией vaddvq_u8.
Теперь у нас получился вектор, в котором подсчитаны все внутренние байты символов, а чтобы подсчитать внешние, надо вычесть это число из длины вектора. Правильнее было бы инвертировать сравнение, до этого в разгаре экспериментов просто не дошли руки.
Полученное число мы добавляем к вычисляемой длине и сдвигаем указатель. В конце досчитываем хвост обычным циклом. Конец алгоритма.
Определяем границу символа в UTF-8
В Телеграме попросили рассказать как работает код, который я приводил вчера в заметке про ускорение функции, возвращающей количество символов в строке с кодировкой
Там действительно есть что рассказать, но рассказ придётся разбить на несколько частей. Я постараюсь по возможности не погружаться в дебри. В этой части начну с того, что расскажу чем вообще необычна эта кодировка.
Все кодировки условно можно разделить на две части: кодирующие символ фиксированным или переменным количеством байт. К первым можно отнести, например, CP1251,
Справедливости ради, есть и другие виды кодирования, но нам их рассматривать ни к чему.
Тут важно то, что для строки в
Посмотрим на картинку из «Википедии», которая показывает как устроена эта кодировка:

Тут нам интересна только колонка «шаблон», где видно, что все «внутренние» байты символов начинаются с одной и той же сигнатуры — старший бит установлен, младшие — сброшены.
То есть, байты в диапазоне от 10000000 до 10111111 (в бинарном представлении) — внутренние байты, остальные — начало символа. Опять же, согласно таблице начала попадают в диапазоны 00000000-01111111 и от 11000000 до 11011111.
Умные люди заметили одну закономерность, сейчас мы её тоже увидим. Давайте напишем небольшую программу:
#include <stdio.h>

int main() {
    const signed char arr[] = {
        0b10000000, 0b10111111, 0b00000000, 0b01111111, 0b11000000, 0b11011111
    };

    for (int i = 0; i < sizeof(arr) / sizeof(arr[0]); i++) {
        for (int b = 128; b; b >>= 1) {
            printf("%d", (arr[b] & i) > 0);
        }

        printf(" % d\n", arr[i]);
    }
}
Вот что она выводит (диапазон, в котором находятся внутренние байты, я выделил другим цветом):
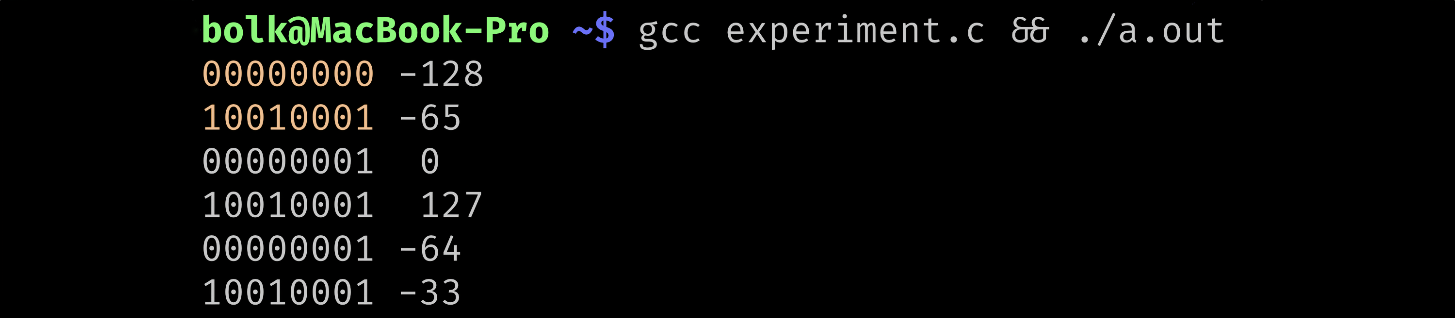
Закономерность в том, что все внутренние байты в знаковом представлении по значению меньше −64. Это довольно дешёвая проверка с точки зрения машинного кода, что очень хорошо, так как наша цель — производительность.
Про остальное — в следующий раз.
UTF-8 на ARM
Пока проект внедрения Юникода во «Флиппер Зеро» на паузе, — разработчики занимаются обновлением одной из важных библиотек, я вспомнил, что
Например,
Любопытно посмотреть как обстоят дела с ускорением таких вещей на процессоре, который установлен на «Флиппере». Правда до него у меня руки ещё не дошли, но я уже потренировался на своём «Макбуке», благо тут процессор той же архитектуры.
Идея всё та же — векторизация. За референс я взял наивную реализацию с перебором по одному байту:
size_t strlen_naive(const char* str) {
    size_t len = 0;
    char ch;

    while ((ch = *str++)) {
        len += (ch & 0b11000000) != 0b10000000;
    }

    return len;
}
Попробовал несколько вариантов, но лучше всех показали себя две функции: та, которую я упоминал в первом абзаце и переделанная нашими общими с братишкой усилиями реализация, найденная в недрах PHP.
После переделки она стала выглядеть так:
size_t strlen_php(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-64);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            break;
        }

        uint8x16_t lt = vcltq_s8(operand, threshold);
        len += sizeof(uint8x16_t) - vaddvq_u8(vandq_u8(lt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Повторюсь, у меня пока не дошли руки попробовать это всё на «Флиппере», но на моём «Макбуке» результаты выглядят следующим образом. Это десять тысяч прогонов на русскоязычном тексте, размер которого чуть больше ста тысяч символов.
Name   Length  Time
----   ------  ----
PHP    117465   97797
Fast   117465  143780
Naïve  117465  531535
Не скажу, что я делал всё как положено, — надо бы считать среднее и отклонение, разносить по разным файлам, научиться прибивать процесс к производительным ядрам, но разница в результатах достаточно показательна (я запускал несколько десятков раз), поэтому, как мне кажется, и так нормально.
Цифры в попугаях (больше — хуже), которые выдаёт сишная функция clock(), компилировал компилятором Clang 15 с ключом -O3.
Перекодировка вручную
Меня удивляет, что многие программисты сейчас не умеют перекодировать строку в ошибочной кодировке вручную, даже если знают как она получилась.
С различными кодировками сейчас мало где можно столкнуться, тем не менее мне неясно в чём сложность задачи. Вроде даже ничего знать не надо.
Например, я вижу вот такую строку: Требуется авторизация. Она так выглядит, потому что она была в кодировке
iconv -f utf8 -t cp1251 <<<"Требуется авторизация"
Требуется авторизация
«Гопник-2»: UTF-8
Продолжаю писать про портирование
Я уже очень давно не работаю под этой операционной системой, поэтому некоторые обычные, возможно, для многих вещи для меня являются открытием. Когда я начинал процесс портирования игры под эту платформу, я был уверен, что столкнусь в трудностями совершенно в других частях кода. Одной из неожиданностей была плохая работа «Виндоуз» с кодировкой
Если вывод в консоль удалось победить сравнительно легко, то со вводом возникли проблемы — вызов SetConsoleCP(CP_UTF8), который должен был помочь, не помог. В интернете пишут, что он, по всей видимости, не реализован — просто не делает ничего.
Если с латинскими буквами проблем не возникает, они кодируются одним байтом, это ничем не отличается от того как программы до этого работали десятилетиями, а вот с русскими буквами беда — для них требуется два байта и в таком виде Виндоуз их не понимает.
Рекомендуемый специалистами способ — переключить консоль в режим ввода кодировки
#ifdef __MINGW32__
        int wlen = 100;
        int save = _setmode(_fileno(stdin), _O_U16TEXT);
        wchar_t *wstr = (wchar_t *) malloc(wlen * sizeof(wchar_t));
        fgetws(wstr, wlen, stdin);

        int len = WideCharToMultiByte(CP_UTF8, 0, wstr, -1, 0, 0, 0, 0);
        user_name = (char *) malloc(len);
        WideCharToMultiByte(CP_UTF8, 0, wstr, -1, user_name, len, 0, 0);
        _setmode(_fileno(stdin), save);

        free(wstr);
#endif
Мне, к счастью, ввод русских букв нужен только в одном месте — там где игрок вводит своё имя. Я убрал используемую там функцию fgets под условную компиляцию и вставил кусок, который выше. С таким исправлением всё заработало, как ожидается.
UTF-8: быстрые регулярные выражения в PHP
Утром я написал пост о производительности различных движков регулярных выражений, а весь день перебирал разные варианты, смотрел подробности и так далее.
Как я уже писал, мне понравилась библиотека RE2, я даже скомпилировал её и посмотрел, к сожалению, оказалось, что она использует треды, а в PHP с этим не очень (не все модули PHP thread safe, поэтому чаще всего PHP собирается без поддержки тредов).
Я уже начал смотреть другие библиотеки, когда Алексей Захлестин напомнил мне про модуль PHP Multibyte String (функции mb_*), который содержит в себе движок регулярных выражений Oniguruma.
Я всегда плохо относился к этому движку, так как считал, что у него очень бедные возможности для работы
Сегодня я присмотрелся к движку получше. Конечно, PCRE он не заменит, но некоторых случаях вполне сможет его подменить как быстрый аналог, только надо применять несколько правил (речь идёт о версии 4.7.1, которая в PHP):
Я погонял тесты, сравнивал PCRE в режиме полном
bolk-dev ~/regexp-benchmark $ php test.php
PCRE Full UTF-8: 1.0458080768585
Oniguruma:         0.24942803382874
UTF-8: как быстрее получить длину строки
Как я уже писал, сегодня ночью я наткнулся на вариант измерения длины
Сегодня я почистил код (в PHP известна бинарная длина строки, поэтому я убрал проверки на символ с кодом ноль и соптимизировал код), сгенерировал таблицу HammingWeight, которая отсутствует в коде автора и перевёл проверку в двух крайних циклах на подобную таблицу.
Потом это всё скомпилировал и погонял тесты.
Сначала я получил очень странные результаты и только потом понял что случилось. В общем, разрыв в скорости функций (mb_strlen и той, что на SSE2) тем больше, чем ближе тестируемая строка к однобайтовой. Чаще всего, с SSE2 быстрее встроенной в PHP в 5—8 раз:
thasonic-dev ~/uni/futf-0.1 $ php ../test/test_strlen.php | sort -k2 -t:
SSE2 UTF-8:                 0.025604963302612
mb_strlen:                   0.15917205810547
strlen/utf8_decode:   0.62052989006042
Что совсем странно, прежнего впечатляющего результата с прежними данными и функциями я получить не смог, правда, есть подозрение, что за ночь сменилось оборудование (были аппаратные проблемы на машине) на сервере, где я производил замеры.
В общем, о приросте в 24 раза остаётся только мечтать.
Похоже, это почти предел на сегодняшний момент. Единственная возможность ускорения, которая приходит в голову — использовать GPU на видеокарте. Например, видеокарта GTX275 управляется с 16000 потоков (!), что позволяет подсчитать длину строки порциями по 15,5КБ!
Но это больше из разряда
Так что оставлю как есть, займусь переписываем substr в SSE2, а потом выложу всё в открытый доступ.
Добавлено позднее: в следующем году Intel и AMD выпустят процессоры, поддерживающие набор комманд AVX, интересно там то, что размер регистров SIMD (которые используются и в SSE) расширяется до 256 бит. То есть через
UTF-8: как быстро получить подстроку (+новый вариант strlen)
Из кода быстрой функции strlen
Я вкомпилил эту функцию в PHP, помог найти ошибки и отладить и сделал замеры:
bolk-dev ~/uni/futf-0.1 $ php ../test/test_substr.php  | sort -k2 -t:
Fast UTF-8: 0.18010711669922
mb_substr:  0.87068700790405
Разница примерно в 4 раза. Я ещё попробовал отрезать строку через функцию preg_match, сравнимо по скорости с mb_substr, но медленнее и есть ограничение — квантификатор preg_match не захватывает больше 65535 символов.
Добавлено позднее: после того как мы отладили эту функцию, я вспомнил про команды ассемблера SSE — это наборы команд (сейчас их пять — SSE1, 2, 3, 4.1 и 4.2), которые оперируют восемью регистрами размером 128 бит.
Как я рассказывал, самый быстрый алгоритм для strlen, который я нашёл, работает следующим образом: сначала указатель на строку первым циклом выравнивается по границе 4 или 8 байт (в зависимости от архитектуры процессора), чтобы процессор смог быстрее читать дальше, потом, работая сразу с числом длиной 4 или 8 байт, одной операцией подсчитывается сколько в выделенной строке содержится начальных байт символов.
Если внутри нашего рабочего участка встречается символ с кодом ноль (признак конца строки), то происходит выход в последний цикл, который занимается тем, что просматривает побайтно получившийся «хвост».
Час назад я поставил себе gcc под Windows и стал потихоньку писать примерный код, читать документацию, изучать команды в интернете, пока совершенно случайно не наткнулся на уже готовый вариант, написанный с применением инструкций SSE2.
Нашёл в интернете тест для таких функций, включил туда найденную и сделал замеры:
C:\MinGW\bin\test.exe
cp_strlen_utf8:          0.105706
cp_strlen_utf8_sse2: 0.030002
В 3,5 раза обгоняет предыдущий вариант, то есть, смею надеяться, обгонит встроенную в PHP функцию примерно в 24 раза. Завтра попробую.
Немаловажно, что даже на машинах с архитектурой 32 бита рассматриваемый вариант покажет ту же скорость, что и на машинах 64 бита.
Судьба PHP6
Поговорил с одним из разработчиков PHP по поводу судьбы PHP6, самое ожидаемое изменение которого — переход на юникодные строки. Так вот Антон Довгаль рассказал, что проект, по сути, заброшен. Те несколько человек, которые занимались проектом, либо уволились, либо потеряли к нему интерес и сейчас считается, что поддержка юникодных строк в языке не так уж и нужна.
На примере своего опыта разработки и перевода проектов на PHP
То, что в PHP приходится для поддержки Юникода работать
Работать в PHP
Если бы этот язык нативно поддерживал
UTF-8: как быстрее измерить длину строки в PHP
Я потихоньку буду писать как получается оптимизировать самые важные функции работы
Сейчас, после перевода «Вики» мы столкнулись с тем, что некоторые операции занимают непозволительно много времени.
Простые оптимизации я уже применил: выкинул из класса
Одна из самых частоиспользуемых функций — strlen, которая определяет длину строки. Я всегда считал, что самый быстрый способ подсчитать длину
Мои тесты показывают что это не так. Самый быстрый способ (по крайней мере в PHP 5.3.2) — это mb_strlen, strlen/utf8_decode — на втором месте, потом идёт sizeof+preg_split, а самый медленный — iconv_strlen.
Для интереса я вкомпилил в PHP функцию для быстрого подсчёта длины строки
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
Fast UTF-8: 0.68232107162476
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это тысяча итераций на файле в 400КБ.
Я оставил функцию mb_strlen.
Добавлено позднее: другая быстрая функция дала ещё худший результат: 0,79, против прежнего варианта в 0,68.
Добавлено ещё позже: а вот третья функция показала действительно впечатляющие результаты:
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
More Fast UTF-8:  0.12948799133301
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это уже дело — она почти в 7 раз быстрее лучшего результата PHP.
Вкратце, алгоритм такой: строка циклом выравнивается по границе четырёх
Добавлено через несколько дней: есть и ещё более быстрая функция.
PHP, UTF-8: восьмой этап, заключительный
Прошло уже немало времени, с тех пор как я описал предыдущий этап перевода
Для начала надо понять что же делать с чтением и записью файлов. Нет никакого автоматического способа решить что делать с этими операциями в вашем проекте, хорошие новости заключаются в том, что, скорее всего, ничего делать не придётся. Мне не пришлось, хотя, чтобы это понять, нужно было исследовать исходники. Побайтовое чтение файлов — редкая операция в мире Даже в том случае, если вы производите с файлом Для другой операции, нам понадобится четыре метода в классе работы с UTF (напоминаю, что константа ON этого класса определяет включена ли поддержка UTF): метод charset возвращает Замены очевидны: везде, где в коде встречается Потом нужно проверить все места, где встречаются вызовы chr и ord («egrep ’\\b(ord|chr)’ -R .») и проверить не нужно ли переписать После этого осталось только перекодировать исходный код: И базу: В процессе пуска проекта выяснилась ещё одна немаловажная подробность (спасибо Саше Покатилову): оказывается, несмотря на то, что установки локали (setlocale) никак не влияет на функции сортировки в PHP, она влияет на некоторые функции работы с файлами (dirname, basename и некоторые другие), вот цитата из описания функции dirname: dirname() is locale aware, so for it to see the correct directory name with multibyte character paths, the matching locale must be set using the setlocale() function. Поэтому не забывайте выставлять локаль, если пользуетесь этими функциями. Дополнено: внезапно нашлись неприятные грабли, будьте осторожны: функция preg_match_all (и preg_match) с ключём PREG_OFFSET_CAPTURE возвращает бинарное смещение в строке (т. е. указывающее не на байт, а на символ), даже Я поступил просто — написал простую функцию, которая корректирует выходные значения. Идея простая: отрезаем при помощи substr строку до смещения, потом измеряем её Еще позднее: оказывается и параметр offset (последний параметр в preg_match и preg_match_all) работает с бинарным смещением, И ещё позже: а вот вам ещё сюрприз: модуль Multibyte String считает, что кодировка И ещё сильно позже: strftime тоже использует локаль.Что же дальше?
# вот эти файлы перекодировать не надо, они у меня уже в UTF-8
SKIPIT='./php/Utf.php|./php/UtfReverseString.php|./php/UtfString.php'
tmp=`tempfile`

for line in $(find -name '*.php' -or -name '*.tpl' -or -name '*.inc' | egrep -v "$SKIPIT"); do
    iconv -fcp1251 -tutf8 "$line" -o "$tmp"
    [ -e "$tmp" ] && mv -f "$tmp" "$line"
donemysqldump -pпароль -uпользователь --add-drop-table --create-options --default-character-set=utf8 --order-by-primary -q база |
sed -e 's/cp1251;$/utf8;/mg' |
mysql -pпароль -uпользователь база
PHP, UTF-8: седьмой этап, давайте что-нибудь сделаем с регулярными выражениями
В прошлый раз я рассматривал, по сути, самый сложный этап — замену всех вхождений $var[$index] и им подобных на вызов моей функции. В процессе замены я несколько раз корректировал заметку и доводил некоторые вещи руками.
В самой первой части я рассказывал о том как можно решить проблему К сожалению, этот «глагол» появился только в PCRE 8.10, а в самом последнем PHP, на сегодняшний момент, содержится 8.02. Как я говорил ранее, новый PCRE можно вкомпилить в PHP при помощи специального ключа. Внутренние сервисы, где я работаю, используют Поскольку мы сейчас переходим постепенно на новую версию Ubuntu (с Hardy Heron на Lucid Lynx), то часть машин у нас пока на Цапле, а часть — уже на Рыси. Это значит, что пакетов нужно будет собрать шесть. Дело это непростое. Я решил попробовать «выдрать» из внутренностей PHP модуль PCRE, переименовать его функции и константы и поставить его как простой подключаемый модуль. Мне удалось сделать, модуль «свежего PCRE» (можно скачать в разделе «Храню»). Модуль называется ygx, все функции начинаются с префикса «ygx_», константы — с «YGX_». Что это за сокращение, не спрашивайте, когда я начинал работать, я это знал, а сейчас забыл. Сложнее всего было корректно переименовать только те функции, типы, константы и так далее, которые видно в PHP, не задев всё то, что импортируется из внешней библиотеки PCRE. Ставится модуль примерно следующим образом: потом нужно прописать в php.ini строку «extension=ygx.so», перезапустить Поскольку к этому моменту все вызовы функций PCRE у меня заменены на вызовы одноимённых методов статического класса UTF, то мне нужно поменять «preg_» на «ygx_» только в одном месте — внутри методов этого класса.Что же дальше?
mkdir /tmp/pcre
cd !:1
wget ftp://ftp.csx.cam.ac.uk/pub/software/programming/pcre/pcre-8.10.tar.bz2
tar xvfj pcre-8.10.tar.bz2
cd pcre-8.10
./configure --prefix=/usr/local/pcre-8.10 --enable-utf8 --enable-unicode-properties --disable-static
make && make install
cd -

wget /files/php_fresh_pcre.zip
unzip php_fresh_pcre.zip
phpize
./configure --with-ygx-regex=/usr/local/pcre-8.10
make && sudo make install
phpize --clean
cd ; rm -rf /tmp/pcre
PHP, UTF-8: шестой этап, она же «строки, часть II». Заменяем
В прошлой части я пытался упростить себе задачу, посчитав сколько различных видов операций получения символа из строки по индексу есть у нас в коде. Но для того, чтобы подсчитать эти ситуации, нужен парсер, который эти случаи выделит.
Я такой парсер начал писать несколько дней назад и очень быстро увидел, куда меня этот путь ведёт. К сожалению,
Код я выкинул и начал писать заново, основываясь на токенах (лексемах), которое выдаёт встроенное в язык API токинайзера. По ходу процесса я часто уточнял случаи и производил тестирование. Получился довольно неряшливый парсер, к тому же с некоторыми багами, которые я счёл несущественными. Например, не обрабатывается ситуация isset($var, $var[$idx]).
В PHP isset (а так же empty и unset) — конструкции, а не функции и принимают на вход только переменные. У меня получение символа по индексу заменяется на Utf::get(…), а внутри строки на другую конструкцию — $_ENV[0x5f3759df]->get(…), так что если произойдёт замена внутри isset, будет синтаксическая ошибка.
Т. е. у меня в коде, внутри файла с классом Utf есть ещё и такая строка — «$_ENV[0x5f3759df] = new Utf();». $_ENV я выбрал за то, что это переменная (а переменную внутри строки проще заменять на другую переменную, пусть и с вызовом метода, PHP это позволяется) и это, в терминах PHP, «суперглобальный» массив, то есть он доступен отовсюду.
Итак, я сказал, что парсер имеет баги, но на весь довольно большой код у меня было всего четыре случая, правда один довольно странный — пропала треть исходного кода, так что, если будете применять — сохраните оригинальный код (мой лежал в SVN).
Первая операция, которую вам нужно сделать ещё до запуска парсера — это запустить следующий скрипт. У меня парсер работает
Так что я перекодировал код туда и обратно и сравнил что получилось:
for file in $(find -name '*.php' -or -name '*.inc' -or -name '*.tpl'); do
    sum_new=`iconv -fcp1251 -tutf8 "$file" | iconv -futf8 -tcp1251 | md5sum -b | cut -d' ' -f1`
    sum_orig=`md5sum -b "$file" | cut -d' ' -f1`

    if [ $sum_new != $sum_orig ]; then
        echo $sum_new $sum_orig $file
    fi
done
У меня ничего не поломалось, так что я спокойно запустил пасер. После запуска я проверил синтаксис скриптов интерпретатором и вручную избавил четыре найденные ошибки:
find -name '*.php' -or -name '*.inc' -or -name '*.tpl' | xargs php -lПосле всех запусков проект выглядит рабочим, но в понедельник я обязательно буду тестировать весь проект.
Добавлено позднее: а вот как выглядит метод get в классе Utf:
static public function get($str, $index)
    {
        if (!is_scalar($str)) {
            return isset($str[$index]) ? $str[$index] : null;
        }

        return self::substr($str, $index, 1);
    }
Добавлено позже: нашёл ещё два бага: неверно отрабатываются
Конструкции heredoc я нашёл при помощи «grep -FR ’<<<’ *» и просмотрел их все, их было очень мало и ни одна из них не содержала переменных.
Добавлено ещё позже: опаснее оказалась ситуация, которую просто так можно и не заметить: замена вызова func($var[$index]) на func(Utf::get($var, $index), где прототип func описан как func(&$var). Синтаксис PHP вполне допускает такие ситуации, а на деле в массив могут не попасть изменения, которые должны были переданы быть по ссылке.
Способов исправить такую ситуацию два. Первый — логгировать все вызовы Utf::get, которые применяются к массивам и править их на получение переменной по индексу. Второй — найти и просмотреть все такие ситуации. Я выбрал второй способ:
find \( -name '*.php' -or -name '*.tpl' -or -name '*.inc' \) |
xargs egrep -oh 'ion[\t ]+\w+[\t ]*([^{]+' | awk -F'[( ]' '/&\$/{print tolower($2)}' |
sort -u | egrep -v '^preg_' | xargs -I{} egrep -iR  --exclude-dir=.svn {}'[\t ]*(.*?Utf::get' *
Этот скрипт (который очень долго работает) показывает все подозрительные строки (у меня их 7 оказалось), их надо просмотреть, выявить потенциально проблемные и поправить, если проблема действительно есть.
И ещё позже: так же есть набор встроенных функций, которые используют передачу массива по ссылке, я их нашёл вот таким способом:
(cat<<FUNCS
'\b(?:array_multisort|array_pop|array_push|\
array_replace_recursive|array_replace|\
array_shift|array_splice|\
array_unshift|array_walk_recursive|\
array_walk|arsort|asort|current|each|\
end|key|krsort|ksort|natcasesort|natsort|\
next|pos|prev|reset|rsort|shuffle|\
sort|uasort|uksort|usort)[ \t]*\([\t ]*[^$)]'
FUNCS
) | xargs -I[] find \( -name '*.tpl' -or -name '*.php' -or -name '*.inc' \) -exec \
egrep [] {} \; -print
PHP, UTF-8, всё ещё строки: упрощаем задачу, часть I
Итак, я достаточно долго думал над задачей как мне заменить все операции получения символа из строки по индексу, чтобы понять насколько она сложна. Решить её можно, но скучно и не нужно. Я подумал, что очень вряд ли у меня в коде встречаются все возможные случаи, которые я рассмотрел в прошлый раз, поэтому я решил посмотреть что же у меня встречается на самом делом.
Около 3,5 тысяч. Я временами дьявольски усидчив, но рассматривать каждую строку из нескольких тысяч, это для меня перебор. Что же делать? Для начала мне хочется упростить своё регулярное выражение. Конечно, по синтаксису PHP имена переменных можно писать, например, Безусловно, моё регулярное выражение захватило очень много лишнего, надо эти ситуации обработать. Например, можно исключить добавление элемента в массив, это легко узнаваемая конструкция ($arr[] = $elm): Ситуация мало изменилась, давайте попробуем улучшить её значительно. Например, удалить все строки, где происходит только явное обращение к массиву: $arr[’index’] (но не $arr[’index’][0]): Ощутимая разница. Открываем получившийся файл и смотрим что бы мы ещё могли выкинуть… Продолжение следует, я сегодня рано встал, пойду домой.Что же дальше?
bolk@dev:~/daproject$ find \( -name '*.php' -or -name '*.inc' -or -name '*.tpl' \) -exec \
egrep '\$\{?[a-zA-Z_\x7f-\xff][a-zA-Z0-9_\x7f-\xff]*[\[\{]' -- {} \; |
sort -u | tee out-vars-1.log | wc -l

3670bolk@wiki:~/daproject$ IFS='\n'
for line in $(cat out-vars-1.log); do
(echo $line | sed -r 's/\$\w+\[\]//g' | egrep -q '\$\{?\w+[\[\{]') && echo $line
done | sed -r 's/^\s+//' | awk '!t[$0]++' | tee out-vars-2.log | wc -l
3357bolk@dev:~/daproject$ IFS='\n'
for line in $(cat out-vars-2.log); do
(echo $line | sed -r 's/\$\w+[\[\{](["'\''])[^\1]*\1(\]|\})([^\[\{])/\2/g' | egrep -q '\$\{?\w+[\[\{]') && echo $line
done | tee out-vars-3.log | wc -l
1353
PHP, UTF-8, рассуждения по поводу строк
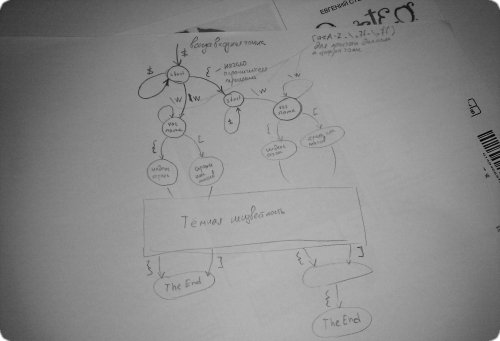
Работаю с низким приоритетом над автоматической заменой операций получения символа в строке по индексу на такую же операцию, но которая умела бы работать
В общем, задача сложная, я над ней думаю. Пока в сторону парсеров синтаксиса (colorer, Text_Highlighter и PHP tokinizer). Из исследования выяснилось, что все они могут мне помочь примерно в равной степени, так что я думаю, что возьму PHP tokinizer. К сожалению, ни один из парсеров не парсит PHP настолько удобно, чтобы избавить меня от всех проблем, так что я думаю над их решением. Когда у меня будет понимание как бороться со всеми проблемами, буду программировать.Что дальше?
I � Unicode
Давайте я вам про Unicode ещё раз расскажу?
Как известно, в памяти компьютера числа представлены битами, которые группируются в байты. Один байт может хранить одно из 256 значений (поскольку состоит из восьми бит, каждый из которых может хранить одно из двух). Следовательно, числа, значения которых > 255 хранятся в больше, чем одном байте.
Например, числа до 65535 можно уместить уже в двух байтах: в так называемом старшем записывается сколько раз полных 256 содержится в числе, а в младшем — остаток: старший × 256 + младший.
В зависимости от типа процессора, порядок, в котором записаны в памяти старшие и младшие байты, различается. Собственно, мне хорошо известны только две системы: младший записывается первым (как в процессорах Intel) и старший записывается первым (в процессорах ARM, которые стоят в смартфонах). Есть ещё смешанная, но с ней я не сталкивался. Системы эти носят имена:
Есть ещё системы, которые умеют переключать порядок (те же ARM) и называются
Термины
Сюрприз для непрограммистов: буквы в памяти компьютера тоже представлены числом. Это просто номер по порядку в компьютерном алфавите. Так девочки в нашем классе «кодировали» записки: вместо букв ставили номер позиции в алфавите.
Было принято очевидное решение — выделять на символ не один байт, а несколько. Так появился стандарт Unicode, где огромному количеству символов дано своё число и закреплены начертания, стандарт дополняется и новые версии выходят почти каждый год.
Система кодирования Unicode, где выделяются два байта, называется
Так как способов хранения чисел, не умещающихся в памяти у нас несколько, то системы подразделяются
Первого апреля
BOM. BOM расшифровывается как «byte order mark» (признак порядка байт) и ставится внутри файлов упомянутых двух- и четырёхбайтных кодировок. Если BOM внутри файла не встретился, принимается порядок
Теперь непрограммистам будет трудно.
Пока всё было достаточно просто, но человечество придумало ещё одну кодировку —
Трудность в том, что
Итак. Каждый символ в кодировке занимает от 1
Тут надо вспомнить что такое биты. Бит — единица информации, мельче не бывает, у него всего два значения — 0 или 1. Байт состоит из 8 битов, биты очень удобно записывать в позиционной двоичной системе: 00001011. «Позиционная» тут означает, что значение числа зависит от его позиции. Кстати, это привычная нам система. В числе «22» две двойки, но у первой значение в десять раз больше, чем у второй. Это десятичная позиционная система. В двоичной, каждая более левая однёрка будет больше в два раза своей соседки.
Таким образом число 1011 расшифровывается из двоичной как 1 × 23 + 0 × 22 + 1 × 21 + 1 × 20 = 1 × 8 + 1 × 2 + 1 × 1 = 8 + 2 + 1 = 11 в десятичной системе.
В первом символе нужно посчитать количество бит со значением «1» до первого нуля. Это общее количество байт, которым записан данный символ. Если количество байт — один (это вроде как специальный признак), то вы нашли не первый байт символа.
У нас в примере количество бит до первого нуля — два. Значит, буква записана двумя символами — первый это тот, на которым мы находимся и второй — который следует за ним. Каждый байт
Могу рассказать
Чем быстрее всего отрезать строку в кодировке UTF-8
Решил протестировать — чем быстрее всего можно отрезать строку в кодировке
Я взял строку в 700
- хуже всех справилась реализация на чистом PHP — 0.34 сек
- получше — iconv_substr. 0.063 сек
- ещё лучше — mb_substr. 0.0175 сек
- лучше всех — preg_replace. 0.005 сек
Если кому интересно, вот моя функция по проходу по строке в кодировкеUTF-8:
$len = strlen($text);
    for ($pos = $cutted = 0; $cutted < $cut && $pos < $len; ++$cutted)
    {
            $ch = ord($text[$pos]);

            // multibyte char
            if (0x80 & $ch)
            {
                    for (; $ch & 0x80; ++$pos, $ch <<= 1);
            }
            else
            {
                    $pos++;
            }
    }
Итак, лучший способ отрезать первые $N символов
preg_replace('/^(.{'.$N.'}).*$/uSs', '$1', $text)