ИИ
«Тайна Карпатского замка», 1981
У меня время от времени бывают навязчивые идеи.
Таких идей у меня — целый список, самых разнообразных. Сложнее всего с идеями разыскать
Например, два месяца назад они помогли мне разыскать фильм «Охота на роботов» 1984 года по тем деталям, которые я вспомнил. Я подумал, что разыщу и всё остальное, но потом дело встало. Как я ни пытался, искусственный интеллект ничем мне помочь не смог.
На днях я купил платный доступ к ЧатуГПТ, а сегодня подумал — не поможет ли мне доступ к новейшим моделям разыскать ещё
На этот раз сработало! Модель ChatGPT o3 нашла фильм по описанию — им оказалась «Тайна Карпатского замка» 1981 года, причём я наврал в деталях — мне казалось, что это
Одна из сцен, которая мне запомнилась, видна на скриншоте — девушка, которую искал главный герой, оказалась механической куклой. Ну, это я так помнил эту сцену. В реальности девушка была забальзамирована после смерти, а в этой сцене её мумия разрушилась от контакта с воздухом.

Портреты предков
Я тут необычный эксперимент проделал — загрузил фотографии жены и дочки в «ЧатГПТ» и написал такой промпт:
Я тебе загрузил фотографии мамы и дочки. Сделай тщательно описание их портретов, как это делают в полиции. Вычти черты лица мамы из черт лица дочки и нарисуй портрет вероятного отца девочки в возрасте 47 лет.
Намеренно не стал дописывать, что я на самом деле давно облысел и что на лице у меня усы и эспаньолка. Тем не менее, получилось очень похоже на меня и даже на моего папу. Можно определённо утверждать, что это

Окрылённый успехом, я сделал то, ради чего, собственно, и затеял этот эксперимент — взял фотографии бабушки со стороны мамы и её сестёр, фотографию их мамы и похожим промптом попробовал нарисовать портрет моего прадеда с их стороны.
Он жил в небольшой деревне Старое Исаково и пропал на войне. Ни одной его фотографии нет — вероятно в те годы фотоаппараты не были распространены.

Не знаю уж насколько похоже вышло, сравнить не с чем, но определённо

Попробовал то же самое со стороны папы — нарисовать Феодора Николаевича Старостина. Одно время я надеялся разыскать его могилу. Он так же пропал на войне и его военные бумаги хранились в том же сгоревшем военкомате и ни одной фотографии тоже нет — в Старой Письмянке, где он жил, видимо, тоже негде было сфотографироваться.
Тут к фотографиям я добавил несколько словесных деталей: что вероятный цвет глаз — карий, что он работал агротехником в колхозе, что надо добавить небольшую седину и что он, вероятнее всего, был скорее поджарым, чем страдал от излишнего веса.
«Курсор»
Чтобы отойти от разочарования, решил
Попросил три понятных изменения сделать, любой дурак справится:
- a@b заменить на вызов функции floor(a, b), которую я написал;
- a$ заменить на вызов floor(a, 0);
- там, где оператор else перенесен на другую строку от конструкции if, надо либо заэкранировать перенос через обратный слеш, либо вернуть else на одну строку с if.
Задача простая, но даже тут «Курсор» накосячил, не справившись с подсчётом скобок. В итоге, тщательно проверял все замены и считал скобки я сам. К чёрту такую автоматизацию, по сумме, я бы сам быстрее сделал.
Раньше я бы к этому спокойно отнёсся, но в последнее время раздражительность повысилась — мёрзну и всё время на грани простуды. Отопление давно отключили, а на улице резко похолодало — снег уже несколько раз шёл. Но, видимо, недостаточно холодно, чтобы включать отопление обратно.
Вокруг очень многие болеют пневмонией, это ещё что такое, откуда? Я уверен, что слово «пневмония» я слышал за прошедшие два года больше, чем за всю прошлую жизнь. Сам я всё время кашляю, хотя не чувствуется, что болею, временами только
Эрудиция, ум, предприимчивость
Вряд ли стоит говорить о том, как ценен для человека ум. В конце концов, именно ум дистанцирует нас от других животных. Но ум очень сложно померить. Как быстро понять, что
Это потому, что люди от необходимости придумали несколько признаков, чтобы быстро определить — умный человек или нет, все они грешат неточностями, но других у нас нет. Например, мы признаём умными тех, кто хорош в науках — например, математике или физике. При этом они могут казаться откровенно тупыми в других областях. Эрудированный человек тоже кажется умным, мы привыкли к тому, что умные люди эрудированны, а исключения редки. Нам кажутся умными грамотные люди — как правило грамотность приходит с упорной работой над собой, а она развивает интеллект.
Я не буду пытаться дать определение уму или интеллекту, я хочу поговорить о другом. Мы столкнулись с новым объектом, который кажется умным, но умным не является — речь, конечно, о больших языковых моделях.
Человек оказался не готов к тому, что чат из машины хранит в своих формулах столько знаний, вычисляет некие связи между ними, так хорошо пишет тексты, что они кажутся рассуждениями, но при этом не является умным.
Некоторые мои знакомые, всерьёз обманувшись этим, навсегда (по их словам) разочаровались в больших языковых моделях, когда столкнулись с «галлюционациями» — это когда языковая модель в процессе генерации текста в некоторых местах далеко отходит от реальности, просто потому что работает так, что её задача — сгенерировать правдоподобный текст, а не рассуждать, придерживаясь фактов. Вероятности выпадения следующего слова настроены в ней так, чтобы как можно ближе быть к реальным знаниям, но и только.
Но хуже всего, что другие мои знакомые вдруг уверовали в мудрость языковых моделей и просят у них точного рецепта как поправить дела в ситуациях, которые определяют их жизнь. Я к ним не лезу, у меня нет синдрома мессии, да кажется, что они так глубоко верят, что мои слова для них куда менее весомы, чем их заблуждения. Это похоже на психотерапию, но разница огромна — психотерапевт никогда не будет делать выбор за вас, языковые модели же подобной этикой не связаны, в них нет такого понятия.
В этой связи я даже

TODO: попросить chatgpt сгенерировать сюда заголовок

Реально, у многих, включая меня, уже есть
В общем, время, когда можно было, не редактируя, использовать то, что генерируют нейросети потихоньку проходит. Можно, конечно, серьёзнее работать с промтами, но это, как будто, пока более затратно, чем переработка текста человеком.
DeepSeek R1 на A100
Как я уже писал, мы попробовали позапускать «Дипсик Эр1» на разных конфигурациях графических ускорителей NVIDIA A100. Запускали не полную модель, а квантизованную. Неясно насколько она глупее на наших задачах, бегло попробовали разные тесты, как будто бы от квантизации она пострадала несильно.
Я собирался написать об этом ещё раз, когда мы разберёмся с подходящей конфигурацией,

Выводы следующие.
Для того, чтобы модель поместилась в видеопамять, суммарно нужно около 150 гигабайт. То есть две Nvidia A100 по 80 ГБ подходят. Эта конфигурация позволяет работать одному пользователю в один момент времени. Остальные будут ждать, когда ресурс освободится. Соответственно, конфигурация, которая у меня на скриншоте, может отвечать одновременно двум пользователям.
При этом оперативная память почти не используется. Её можно выделять очень мало.
Если модель в видеопамять не умещается, она может загружаться в оперативную память, но при этом скорость её работы сильно падает, не советую.
Ядер центрального процессора при этом много не надо. Иногда по непонятной причине они нагружаются, но не сильно. Около пары десятков ядер хватает за глаза, можно было уменьшать, но мы этот параметр не крутили.
Покупать при этом, конечно же, надо не A100, а H100, у них сейчас самое выгодное соотношение цена/вычислительная мощность. Ждать их дольше, но оно того стоит.
Обфускация кода
Есть такой метод защиты кода от исправлений и анализа — обфускация. Это когда мы удаляем из кода форматирование, комментарии и все осмысленные названия исправляем на бессмысленные. Обфускацию используют не только для этого, но для нашего разговора это несущественно.
Это довольно очевидная мысль, но, кажется, её ещё никто не высказывал — обфускация, как метод защиты кода, доживает последние деньки. Можно уже прямо сейчас от него отказываться и искать
Большие языковые модели очень успешно разбирают обсусцированный или запутанно написанный код, не тратя на это
При этом опасность такой деобфускации минимальна, даже если нейросеть
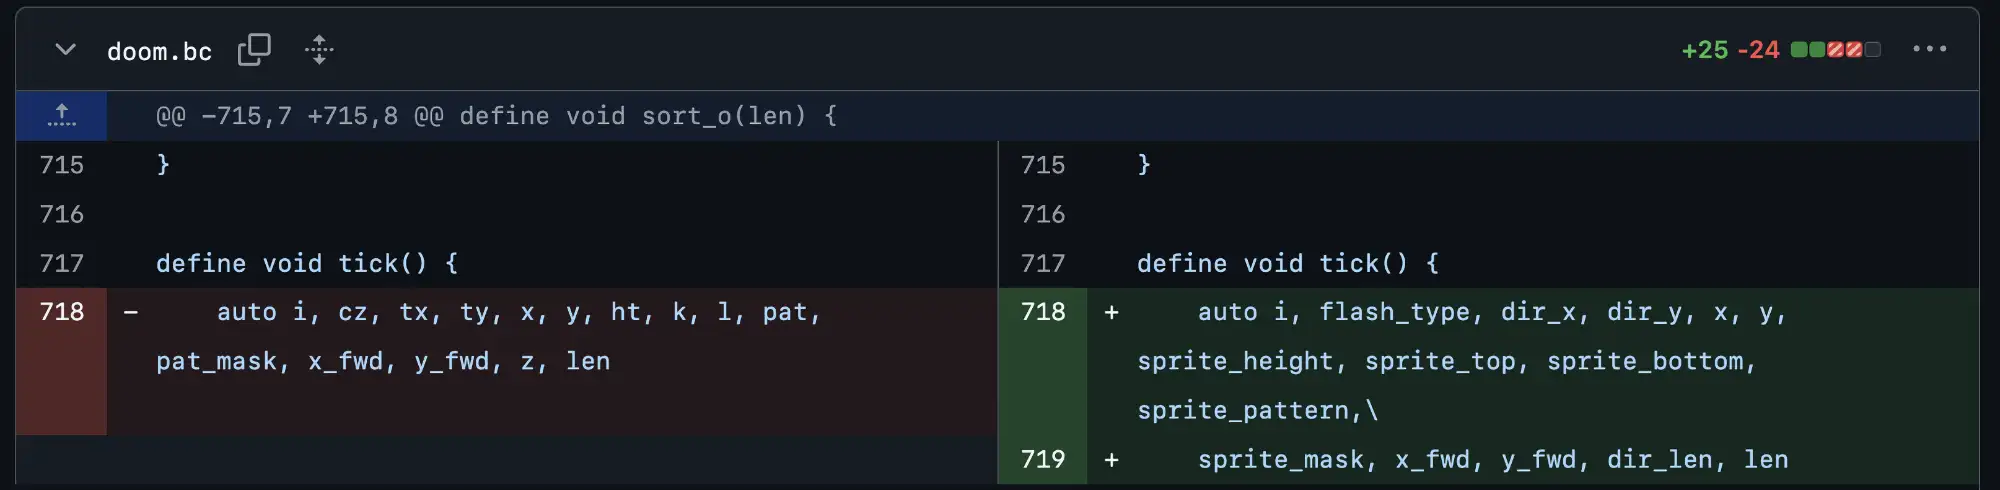
Пару слов о том, какая защита могла бы сработать против чтения кода нейросетями. Надо поступать ровно обратным образом — давать сущностям максимально подробные, но неправильные имена и комментарии. Мои эксперименты показывают, что такой метод пока имеет право на существование. Нейросети очень сильно ориентируются на смысл в названиях и промтами такое поведение крайне сложно купировать.
Добавлено: читатель в комментариях справедливо замечает, что такой код можно обфусцировать стандартными средствами, а потом деобфусцировать нейросетями.
Да, но для этого надо знать, что его защитили таким методом, а узнать это, как будто бы, не очень просто. Вряд ли каждый догадается обфусцировать код перед последующим анализом.
DeepSeek R1
Хочу поделиться. Погоняли китайскую нейросеть «ДипСик Эр1» на оборудовании «Селектела», за что ребятам, как всегда, большое спасибо. Это, конечно, чудо, что на относительно скромном оборудовании можно себе развернуть полноценную большую языковую модель.

На двух nVidia A100 40 GB модель
Завтра попробуем замерить сколько человек может работать с такой моделью параллельно. Но даже уже в этой конфигурации можно проверять
«Охота на роботов», 1984
Многие годы я мучился от того, что не мог вспомнить в каком же фильме видел сцену
Даже у Артемия Лебедева, когда у него была рубрика «Что за фильм?» в блоге, где люди помогали друг другу вспомнить название по описанию, спрашивал. Но и там не помогли.
Та сцена, как заноза, сидела у меня в мозгу и беспокоила. Не знаю как это всё устроено, но я не мог избавиться от идеи разыскать этот фильм. У меня похожие навязчивые идеи часто бывают.

Попробовал описать каждую деталь, которую я помню, китайской нейросети «ДипСик». Она великолепно справилась даже без поиска по интернету — просто сразу выдала кандидата и на сто процентов попала. Я, по мере ответа, даже начал улыбаться — быстро понял, что попадание верное.
У меня в списке «хочу разыскать» есть ещё два фильма и книга. С книгой вряд ли
Добавлено позднее: рано обрадовался. В остальном не повезло — не нашлись ни фильмы, ни книга.
Что там нечётные числа?
Возможно вы уже забыли, но в конце прошлого года я написал небольшую программу, которая искала числа, генерируемые по определённому закону. Рассчитывая быстро упереться в ограничения целого типа в Си, я запускал её на своём ноутбуке, но конца вычислений не дождался.
Тогда я сократил размерность типа вдвое — стал вычислять
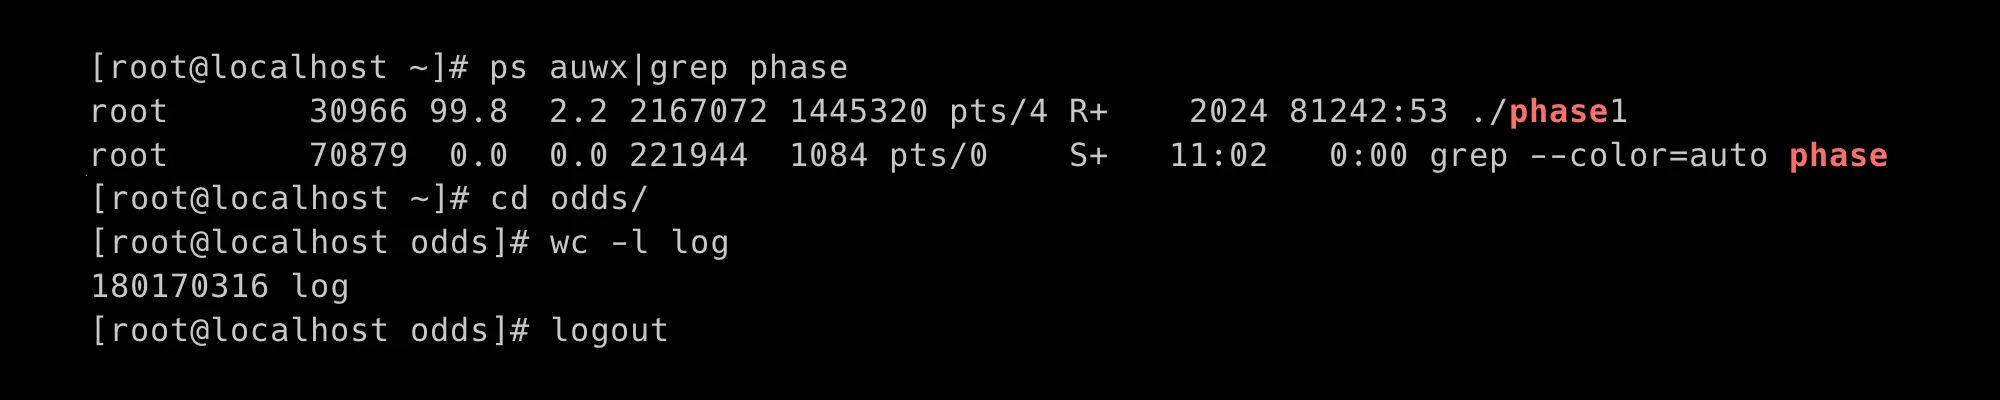
Сегодня мне надоело, я этот процесс остановил. Вывод — на одном ядре считать совершенно не вариант, надо дописывать многопоточную версию.
Я, кстати, её даже начинал писать — накидал
Единственное, в чём я признателен нейросеткам, — они решили мою проблему с производительность. Моя многопоточная версия упиралась в блокировку некого разделяемого ресурса и я решил посмотреть справятся ли нейросети с этой проблемой. Справились! В остальном время было потрачено зря.
Надо бы уже показать кованным мешкам кто тут папочка и дописать код самостоятельно.
Необычная система счисления в bc
В моём временно любимом bc есть интересная, но не сразу понятная особенность работы с числами. Даже в режиме ввода десятичных чисел принимаются буквы в верхнем регистре, то есть число может состоять из цифр в диапазонах 0…9 и A…Z. Буквы при этом обозначают цифры от десяти до тридцати пяти.
Но так как режим десятичный, результирующее значение числа, содержащего буквы, вычисляется необычно. Я специально не описываю словами, ниже скажу почему. Принцип на картинке, думаю, понятно как всё получается.

Мне стало интересно решить задачу конвертации десятичных чисел в такую необычную систему. Из самого принципа следует, что десятичное число может быть представлено несколькими способами, так что придумать можно куда больше одного алгоритма.
Сегодня на работе, пока обедали с братишкой, пытались в режиме обсуждения решить задачу в уме. Потратили на это почти весь обед, в конце я перенёс то, что придумалось, в код программы:
def convert(num):
    if num == 0: return 0
    out, orig_num = "", num

    while num:
        num, r = divmod(num, 10)
        v = min(2 if r > 5 else 3, num)
        if (digit := v * 10 + r) > 9:
            out = chr(digit - 10 + ord('A')) + out
        else:
            out = str(digit) + out

        num -= v

    return out if len(out) < len(str(orig_num)) else orig_num
А потом мы решили развлечься ещё одним способом — аккуратно сформулировать эту задачу в тексте и решить её искусственным интеллектом. Взяли топовые сети — ЧатГПТ, ДипСик и так далее.
Я намеренно не показываю получившийся промпт, вдруг вы захотите тоже попробовать, но скажу сразу — с первого или даже пятого раза сформулировать задачу так, чтобы хоть
Из этого можно сделать важный
А если посмотреть чуть глубже, то можно додуматься вот до чего. В ближайшее время искусственный интеллект не убьёт профессию программиста, а просто её модифицирует. Сейчас программисты описывают задачу, переведённую ими в алгоритм, на языке программирования, а в будущем буду описывать её на натуральных языках.
Полезный промпт
В жизни мне нередко пригождается умение объяснять — часто приходится объяснять
Думаю, поэтому, когда пришли большие языковые модели, у меня не возникло никаких сложностей в написании промптов. Мне, как правило, очевидно где граница между общими знаниями, на которых учили нейросеть, и локальными, которые в неё попасть не могли, но которые нужны для решения задачи.
Из этого и составляется промпт — задача плюс локальные знания, необходимые для её выполнения. Но иногда так лень думать что именно надо сообщить нейросети. Мы же не можем рассказать вообще всё, поэтому надо напрягаться и вычленять главное.
К счастью, есть полезный промпт, позволяющий и это переложить на нейросеть. Достаточно попросить её задать вам несколько вопросов по теме.
Например, нам надо поздравить с днём рождения друга Вадима. У нас туго с фантазией и мы хотим поручить эту задачу нейросети.
Можно написать «напиши мне поздравления с днём рождения моего друга Вадима» и получить
Вместо этого можно попросить задать десять вопросов о Вадиме и только потом написать поздравление. Попадание будет куда точнее, в поздравлении появятся элементы личного, а факты о Вадиме не придётся вымучивать самостоятельно.

«Элиза»
В детстве я несколько раз пытался написать программу, с которой можно было бы разговаривать. К сожалению, русский язык в силу своей флективной природы для этого подходит для этого плохо, поэтому у меня мало что получалось.
Не помню, знал ли я тогда про то, что это вообще возможно, хотя бы отчасти. Доступа к периодической компьютерной литературе у меня не было, но не исключено, что
Так или иначе, про его существование я знаю несколько десятков лет — иногда попадаются упоминания о нём в том, что я читаю. Мне всегда интересно было с ним поговорить, но его код был утерян, поэтому это было невозможно.
Недавно код был обнаружен в бумагах Вейценбаума и теперь любой человек может пообщаться с легендарной «Элизой».
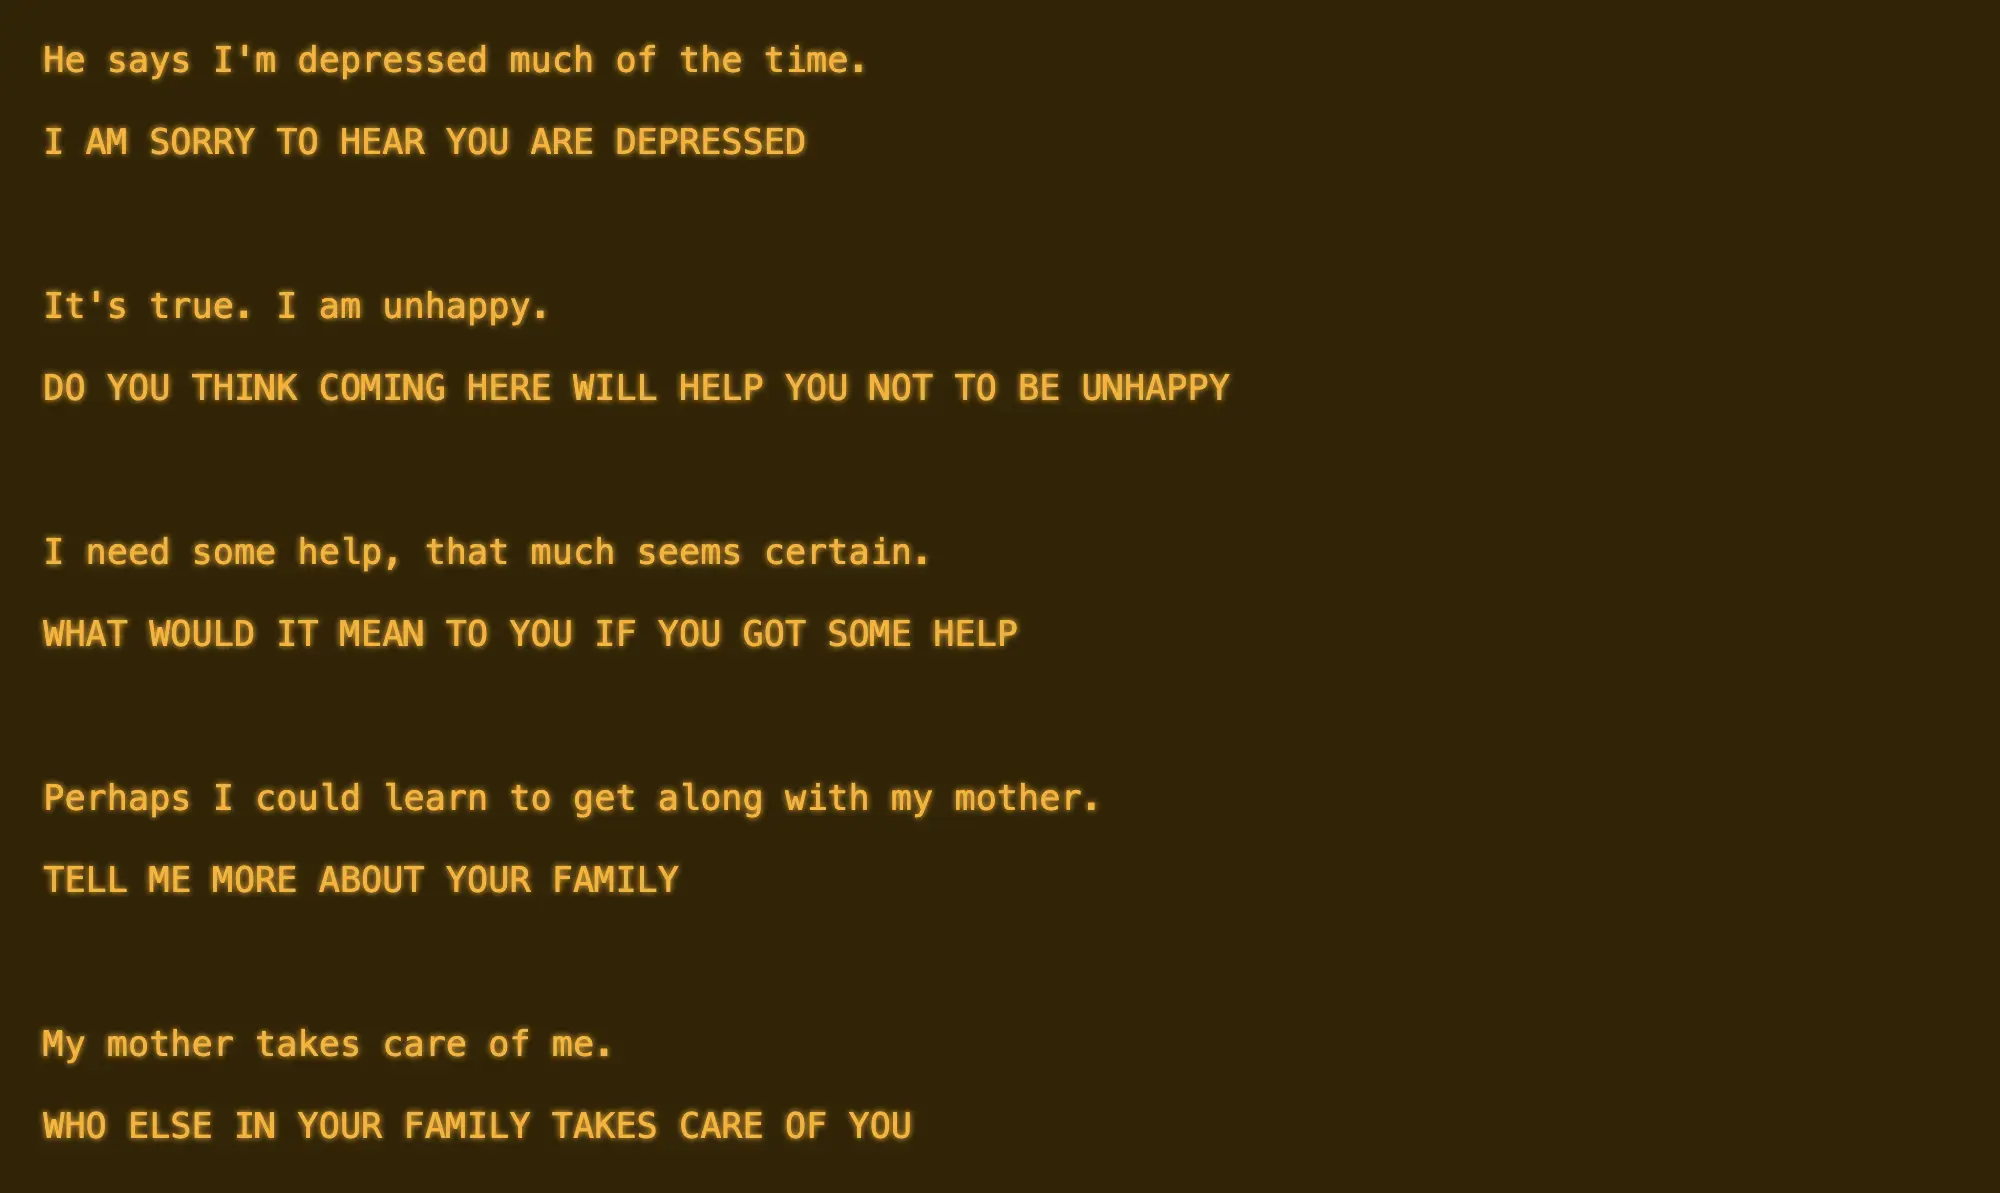
«Элиза» очень неплохо притворяется человеком. На известном тесте Тьюринга она опережает «ЧатГПТ 3.5» — 27% против 14%. Возможно в это сложно поверить, но общение с «ЧатГПТ» и в самом деле мало напоминает общение с живыми людьми, я удивлён, что вообще хоть
Самое же удивительное для меня, что 27% набирает код, занимающий чуть больше 400 строк!
Наверное поэтому так много людей всерьёз считают, что современные языковые модели — это думающие личности.
Социальный интеллект и большие языковые модели
Позавчера общались с одной журналисткой по теме развития информационных технологий и, конечно, затронули тему искусственного интеллекта (ИИ). И я, наконец, проговорил и сформулировал одну мысль, которая давно мне кажется интересной.
Большинство людей из моего окружения всё с большей неизбежностью сталкивается с большими языковыми моделями.
Когда мы формулируем запросы для систем ИИ, мы вынуждены быть чёткими и точными, сообщать контекст, иначе система просто не поймёт нас или даст неправильный ответ — у неё нет знаний о нас и, часто, нет никакой истории общения, так что ей не на что опереться, чтобы прочитать
И вот тут, на мой взгляд, должна происходить интересная вещь: чем чаще мы сталкиваемся с необходимостью правильно и ясно излагать свои мысли, тем мы должны лучше становиться в общении с людьми.
Общение с нейросетями должно помогать нам научиться структурировать свои запросы, избегать двусмысленностей и мыслить более логично. Это, думаю, тренирует наш мозг на поиск краткости и точности, а значит, мы должны начинать лучше доносить свои мысли и в обычных разговорах. Мы учимся быть более внимательными к словам, строить фразы так, чтобы собеседник или система поняли нас с первого раза. Это должно сказаться на качестве коммуникации, как в личной жизни, так и на работе.
Когда мы взаимодействуем с людьми, мы часто не уточняем все детали, рассчитывая, что собеседник сам «додумает», что от него хотят. В таких случаях ответственность за недоразумения мы перекладываем на исполнителя, хотя именно мы не предоставили ему точных указаний. С нейросетями такой подход не работает: если не задать задачу чётко, результат будет далёк от желаемого. Это заставляет нас более ответственно подходить к формулировке запросов и быть внимательными в общении.
Таким образом, даже если нейросети — это просто инструмент, они помогают нам развивать очень важный навык — навык общения. Мы учимся быть более точными, ясными и осознанными в общении, что в конечном итоге делает нашу коммуникацию с людьми более эффективной.
«ГигаЧат» и распознавание картинок
Прислали тут новость по сберовской нейросети «ГигаЧат», — теперь она научилась описывать словами изображение. Вообще не удивили, конечно. Нейросети, умеющие такое, существуют лет десять. Но, может, тут


«ГигаЧат» ожидаемо не справился. Я готов согласиться, что горелка керосиновой лампы
Интересно, что «ГигаЧат» время от времени даёт очень разные описания. Последнюю фотографию я загрузил несколько раз. Один раз он увидел вместо «таблетки» пулю, в другой раз ответил правильно — сказал, что видит «металлическую деталь круглой формы с отверстиями».
Ещё смешнее получилось с фотографией дочки, снятой на «Флиппер» из предыдущего поста:

Для интереса и я это изображение попробовал загрузить несколько раз, получил совершенно разные, но одинаково далёкие от реальности результаты.
Я подумал, что можно написать такую же «нейросеть», которая будет в ответ на загруженную картинку генерировать
Но, справедливости ради, более понятные изображения «ГигаЧат» описывает очень неплохо. Вот пример из заметки про «метроном» в китайских боевиках:

Нейродекаданс
В конце
Оказалось, что ответ на этот вопрос прост и даже, наверное, очевиден — дело в насмотренности. Многие из тех, с кем я тогда познакомился, много путешествовали — изучали окружающий мир, плюс выписывали целую году журналов, которые потом с жадностью просматривали. Таким образом они тренировали свои нейросетки в мозгу на генерацию изображений.
С той поры прошла пара десятилетий и для того, чтобы изучать мир, не обязательно путешествовать, да и журналы, наверное, никто из иллюстраторов уже не выписывает. Всё ушло в интернет.
Но в последнее время в интернете всё больше используются сгенерированные изображения. Да и помимо интернета, они много где сейчас встречаются — на билбордах, брошюрах, в некоторой части современных книг, в рекламе и их становится всё больше.
Люди в массе, похоже, не видят ничего странного в косоруких уродцах, которых генерят нейросети — с чётным количеством пальцев, руками разной длины, коленками посередине бёдер, одеждой, смешанной с частями тела и так далее.
И я вот думаю — каково будет в этом мире жить иллюстраторам? У многих ли мозг выработает слепоту на сгенерированное, чтобы отстроиться от этих мусорных изображений, которые заваливают сейчас медиасреду?
Я тут провожу такую параллель. Вся моя грамотность базируется на насмотренности. И лично я довольно быстро деградирую в плане грамотности, если перестаю читать книги. В интернете все пишут, как бог на душу положит, меня это сбивает.
Наверное у иллюстраторов те же проблемы?
IAndex.Music
Почти пять лет назад я рассуждал про грядущую культурную разобщённость — думаю, что персонально генерируемый контент напрочь убьёт некоторые темы для разговоров. Не с кем будет обсудить понравившиеся фильм или книгу — как это сделать, если у каждого они свои?
За пять прошедших лет нейросети пока ещё не развились до такого уровня, но уже появилась возможность проверить мои рассуждения на практике. С момента появления сервиса «Моя волна» в «Яндекс.Музыке», я почти всю музыку слушаю там, совершенно не утруждая себя запоминанием исполнителей или отдельных композиций, которые в данный момент хорошо легли на моё настроение.

Кажется я мало подвержен музыкальной ностальгии, поэтому если трек вернётся в следующий раз, — очень хорошо, не вернётся — ну послушаю
Блеск и нищета нейросетевых рисунков
У меня начисто отсутствует навык любования художественной фотографией. Например, когда в гостях у известного казанского фотохудожника Евгения Канаева мне дали в руки несколько его работ, я из вежливости их полистал и, не почувствовав интереса, отложил. Видимо отсутствует насмотренность, не развиты нужные кусочки мозга.
Возможно это

Безусловно иллюстрация иллюстрации рознь, если постараться, при помощи нейросетей можно нарисовать очень реалистичное изображение. Если повезёт, может получиться даже
Беда в том, что людям закономерно заморачиваться не хочется, а детали кажутся несущественными. По правде говоря, сначала, пока
Очень надеюсь, что качество нейросетей будет прогрессировать быстрее, чем моё недовольство несуразицами в деталях, а то хоть в интернет не ходи.
Галлюцинации нейросетей
С «галлюцинациями» нейросетей сталкивался каждый, кто хоть раз использовал языковые модели. Слово удачное, уже даже используется как официальный термин. Галлюцинациями называются ситуации, когда нейросеть в ответ на запрос выдаёт
Понятно почему так получается — статистический попугай, умеющий облекать свою статистику в человеческую речь и не обязан придерживаться фактов. Если
Ожидается, что в скором времени нас захлестнёт потоком контента, генерируемого при помощи нейросетей. К сожалению, мусора в интернете станет ещё больше, но это, кстати, происходит и само по себе.
Увы, но краткосрочная эпоха авторского контента безвозвратно ушла в небольшие клубы по интересам, которые в потоке информационной
Мусор мусору рознь, я проблему вижу не сколько в увеличении потока «желтизны» и прочего вымоченного в уксусе вторсырья, а скорее в массовом появлении контента, изобилующего галлюцинациями нейросетей. С учётом того, что люди, в основном, воспринимают информацию некритически, как мне кажется, стоит ожидать невиданной коррозии общей эрудиции у общества в целом.
Вот один из встреченных мной примеров, пока довольно безобидный:
Поначалу фильм напоминает «Моего соседа Тоторо» — трогательную историю о детях, покинувших город и познающих природу. С поправкой на настроение. Если смерть мамы Сацуки и Мэй была шокирующим ударом ближе к финалу в остальном доброй детской истории, то Мохито теряет близкого уже в начале фильма — и это задаёт повествованию меланхоличный тон.
В фильме «Мой сосед Тоторо» с мамой Сацуки и Мэй всё в порядке, она выздоравливает, о смерти там нет ни слова. Думаю автор статьи пользовался услугами нейросети, а этот пассаж просто пропустил и не вычесал при редактуре.
У меня есть и более острые примеры, но цитировать я не стану, там такое, что того и гляди заденешь
То ли ещё будет, когда эти галлюцинации просочатся в инструкции, договоры и учебники.
Large Language Brother
Мне тут попеняли, что я ничего не пишу про нейросети. Всё потому, что мой теоретический интерес перешёл в практическую плоскость. Это как
Так и с большими языковыми моделями и прочими генераторами контента. У меня в браузере всегда закреплены две вкладки — одна со списком бесплатно доступных языковых моделей, вторая —
Использую я их реже, чем смартфон, но тоже достаточно часто — иногда несколько раз
В «Виселице», которую я писал для «Флиппера Зеро» есть хороший пример — я попросил модель написать код для сворачивания чисел в диапазоны, потом я его немного видоизменил, но общий костяк получил почти без усилий.
Мечта, чтобы машина писала весь код за человека, как показывает практика, пока не достигнута,