ИИ
О разном
Раз дочка в Лениногорске счастливо проводит время с бабушкой и дедушкой и нет надобности
Всё вожусь с языком «
Теперь ко мне едет уже собранный «
Говорят нам на днях должны вернуть нейросеть «Фейбл 5», на которую американское правительство наложило запрет. Сам я её погонять успел мало, но те, кто успел, говорят, что она программирует уже на уровне синьора. Ну проверим, у меня задача для неё есть — довести
В то, что она хотя бы дотянет до этого уровня я не верю, но любопытно посмотреть насколько близко подойдёт, так как доступные сейчас сети уже упёрлись в свой потолок.
Поставил себе и родителям
«МК-Про»: два регистра в одном
В оптимизаторе
Сейчас я реализую многоходовую оптимизацию, и у меня трудятся сразу несколько агентов, чтобы её запрограммировать.
Первая часть уже, в принципе, давно готова: идея в том, чтобы хранить в одном регистре сразу два значения. Тут можно придумать несколько способов, но самый простой — следующий.
Идея в том, что два целых числа с известными диапазонами можно упаковать в одно число: одно — в целую часть, другое — в дробную. Тогда извлечь их можно операциями нахождения целой части (
В эталонной программе, о которой идёт речь, все регистры заняты под завязку, и эта оптимизация должна работать в связке с другой: в дробной части будет храниться счётчик, а в целой — опорное число для адреса перехода, которое, например, будет менять знак в зависимости от условия. Сам адрес считается по подобранной формуле.
Опорное число и формула подбираются в зависимости от того, где реально оказались в памяти подпрограммы, к которым надо перейти, и это не проблема. Хотя сеть убеждала меня, что опорное число придётся подобрать вручную, я подсказал ей идею простого решателя, и он, судя по тестам, работает.
Вчера я остановился на том, что решатель должен перебирать функции, в том числе тригонометрические: именно они обычно дают самый толковый результат.
В общем, зарядил я «Кодекс», чтобы он покопался в микрокоде калькулятора и алгоритмически повторил код, реализующий тригонометрию в Си++. Цель была обозначена, на мой взгляд, очень чётко. Но не зря я говорю, что нейросеть иногда похожа на джина, который всё, что можно понять двояко, вывернет вам во вред.
Когда я уходил спать, всё работало как часы — нейросеть копалась в ПЗУ калькулятора, сравнивала реализацию с эталоном, разбиралась почему ошибки. Утром я первым делом полез в этот код, чтобы посмотреть что получилось. А там…
А там, как говорят поляки «wygląda jak gówno, a smakuje jeszcze lepiej» — «выглядит как говно, а на вкус ещё лучше». Пятьдесят тысяч строк отвратительного лапшекода, сгенерированного программно из ПЗУ
Сеть
«МК-Про»: переписано на Си++
Сегодня наконец закончился процесс переноса кода
Производительность трансляции улучшилась в среднем в 2,5 раза. Есть один регресс у одной короткой программы, которая выполняются до 50 миллисекунд, но это, скорее всего, погрешность: не исключено, что в этот момент в фоне стартовало
За восемь дней было переписано 122 тысячи строк, которые превратились в 145,5 тысяч строк на C++.

«МК-Про»: прогресс по переводу на Си++
По моим ощущениям, я должен был перевести с помощью нейросети на Си++ код транслятора языка программирования высокого уровня «
В реальности же пошёл уже шестой день. С некоторыми перерывами, конечно: иногда работа, например, прерывается ночью — сеть ждёт от меня ответа
В данном случае мы наблюдаем горе от ума: сеть попроще —
Я согласен с тем, что так, наверное, лучше, потому что это позволяет скорректировать архитектуру, поэтому особо не настаиваю, но ждать уже надоело. В данный момент прогресс такой: перетащено всё — основной код транслятора, оптимизирующие стратегии (их более 300), тесты синтаксиса проходят, но эталонные программы транслируются байт в байт не все: ещё около двух третей сильно отличаются от эталона.
Программирование на четырёх GPU
Я сходил в отпуск, но ребята в офисе не прекращали тестировать нейросетки для локального программирования. Мы уже смотрели на сети, которые запускаются на одной и двух картах Nvidia H100, и приступили к тестированию конфигурации из четырёх H200.
Я не помню, рассказывал ли я, для чего вообще мы рассматриваем конфигурации больше чем с одним графическим ускорителем. Ответ простой — большие сети занимают очень много памяти и в память одного ускорителя не помещаются. Современные фреймворки разбивают сети на части, загружают их в память нескольких ускорителей, а данные между ними гоняют по быстрой шине, соединяющей ускорители между собой. В случае карт Nvidia это шина NVlink.
К слову, мы пробовали соединение через центральную шину — с точки зрения производительности это печально, пользоваться невозможно.
В общем, мы потестировали несколько больших моделей, работающих в этой конфигурации и спустя две недели рейтинг уже сложился:
DeepSeek-V4-Flash zai-org/GLM-4.5-Air-FP8 Qwen3-Coder-480B-A35B-Instruct-FP8
Можно попробовать ещё ГЛМ поновее и КИМИ, но они обе будут с сильными квантированием, поэтому есть сомнения, что они смогут побить победителя. «Квен»

«МК-Про»: переписываю на Си++
Сейчас транслятор
Но вчера я решил переписать его на Си++. При помощи нейросети, конечно. Производительность ТайпСкрипта стала серьёзным блокером: в процессе трансляции оптимизатор перебирает огромное количество вариантов, чтобы уместить программу в 105 байт, и иногда этот процесс занимает минуты. Надеюсь, перевод на Си++ решит эту проблему.
Интересно, за какое время нейросеть справится с этой задачей. Проект большой: около 80 тысяч строк только основного кода; кроме того, очень много тестов — около двух тысяч, если ничего не путаю, — и есть эталонные программы, которые должны скомпилироваться байт в байт.
Спустя полтора часа транслировалось уже десять программ и я удивился такой скорости, пошёл читать исходники, а там, то, что на скриншоте — чёртова ленивая нейросеть просто затолкала внутрь кода эталонный результат десяти программ. Офигенное решение.

«МК-Про»: ЯП высокого уровня для «МК-61»
Язык высокого уровня для программируемого калькулятора «Электроника

Вообще, начал я его писать, потому что меня спросили, не знаю ли я
Справедливости ради, хорошо, пожалуй, ещё не вышло, мы только на пути к этому, хотя я верю, что может получиться. Тот вариант, который сейчас уже есть, я оцениваю
На скриншоте видна очередная сессия, которая, как можно заметить длится без перерыва уже более тридцати часов и до конца ещё очень далеко — неделя или около того. Чтобы сеть не прерывалась, я выставил так называемую «цель», её видно на скриншоте.
105 байт памяти, стек и пятнадцать официально доступных регистров вынуждают использовать самые нетривиальные хаки. Их очень много: если начать рассказывать, я буду писать только о них. Самый нетривиальный, как оказалось, — хак с использованием регистра X2. Это недокументированная возможность, поэтому её использование не очень распространено.
Это не вполне регистр, скорее техническая ячейка для хранения копии экрана, но в программном режиме она обрастает некоторым количеством багов — их вообще в этом калькуляторе полно, — что позволяет использовать её в некоторых случаях как ещё один регистр. В основном — для хранения промежуточных значений.
Я собрал очень много готовых программ — больше четырёх сотен, и в самых плотно упакованных все регистры уже заняты. Выгрузить их тоже некуда: памяти, напоминаю, очень мало — сотня байт, поэтому X2 там очень даже к месту.
Интересно, насколько хорошо будет работать оптимизация, когда нейросетка её доделает. Хотя мы всё обвешиваем тестами, промежуточный результат пока ничего не даёт, кроме расхода токенов: оптимизацию можно будет полноценно включить только в самом конце. Очень жду завершения этого этапа: так долго подпинывать нейросеть без промежуточного результата — скучновато.
Попробовал «Кодекс»
Так исторически сложилось, что серьёзно программировать с нейросетями я начал с «Курсора». До сих пор его использую, и планов
«Курсор» — специализированная среда разработки, заточенная под работу с нейросетями. В ней есть очень много специальных костыликов, позволяющих нейросети делать свою работу. Такие среды дают огромный прирост по сравнению с копированием кода из окна нейросети — тем, с чего мы все начинали.
Недавно братишка уговорил меня попробовать «Кодекс» — конкурирующую среду разработки, которую делает компания
Не обманул: позже я убедился, что в рамках подписки за двести долларов можно работать почти с любой интенсивностью. Там, где в «Курсоре» легко тратились двести долларов в день, тут я, заплатив один раз, больше ничего не плачу́.
Объяснение простое: «Курсор» в основном перепродаёт токены чужих нейросетей, зарабатывая на разнице, а «Кодекс» продаёт токены нейросетей той компании, которая его делает.
При этом с «Курсором» мне работать приятнее.
Я часто вижу, как «Кодекс» принимает часть моих указаний, на которые он уже отвечал, за сигнал к действию и начинает выполнять задачи, которыми уже занимался. В «Курсоре» я такого не видел ни разу.
У «Кодекса» есть режим планирования, но развёрнутые планы он не пишет, а тем планам, которые пишет, не всегда следует. Он может без видимой причины остановиться, не доделав задачу; в этом случае мне приходится его подпинывать словами «делай дальше» или «продолжай».
В отпуске я очень много использую «Кодекс» — каждый день для развлечения пишу язык высокого уровня для калькулятора «Электроника
Выводы.
«Кодекс» я и дальше планирую использовать для своих собственных задач.
Бюджет «Курсора» буду тратить на работе.

Язык высокого уровня для «МК-61»
Я тут довольно большой проект начал — язык высокого уровня для программируемого калькулятора «Электроника
Программирую вайбкодингом, разумеется, лучшими нейросетями из доступных — «Опусом 4.8» и «ГПТ 5.5». Вручную это проект на годы, без сеток я бы его даже не начинал.
Основная сложность — скромные возможности. На программу выделено всего 105 байт и несколько регистров, которыми можно оперировать, поэтому все лучшие программы написаны просто с нереальным количеством хаков, использующих как универсальные вещи (вроде

Ядро языка уже давно написано и даже пережило несколько рефакторингов, но до конца ещё далеко. Я перевёл на него несколько существующих кодовых бриллиантов, чтобы разобраться с применёнными там приёмами оптимизации и моему транслятору до таких вершин ещё далеко.
Сейчас я, например, разбираюсь с упаковкой нескольких переменных в один регистр. Идея простая, но позволяет иногда экономить очень много: если у нас есть три переменные и каждая принимает значение от нуля до десяти, то можно хранить их в одном регистре поразрядно от «00.0» до «99.9».
Так, например, переписывается в текущем синтаксисе игра «Охота на лис» из блога Дениса Монатко:
program FoxHuntMK61 {
  field: board(0..9, 0..9)

  state {
    cell: coord(field)
    foxes: coord_list(field, 9) = random_unique()
    bearing: counter 0..9 = 0
  }

  loop {
    cell = read()

    if cell in foxes {
      found_fox()
    }

    scan_from_cell()
    show("--", cell:02, "--", bearing)
  }

  fn found_fox() {
    show(-20)
  }

  fn scan_from_cell() {
    bearing = line_count(foxes, cell)
  }
}
Это один из более чем двадцати примеров, где оптимизатор справляется лучше или на уровне опытного программиста на этом калькуляторе.
ИИ и системное администрирование
Вокруг программирования с помощью нейросетей так много шума, что кажется, будто остальные айтишные профессии остаются в стороне: будто в их жизни ничего не меняется и не поменяется.
Разумеется, это не так. Я уже
Тогда я обошёлся без автоматизации — просто потому, что нейросеть выполняла мои хотелки с такой скоростью, что автоматизация оказалась мне не нужна. Тем более что в нестандартных ситуациях я не ограничен интерфейсом выбранного решения: в моём распоряжении голая командная строка, пиши что хочешь.
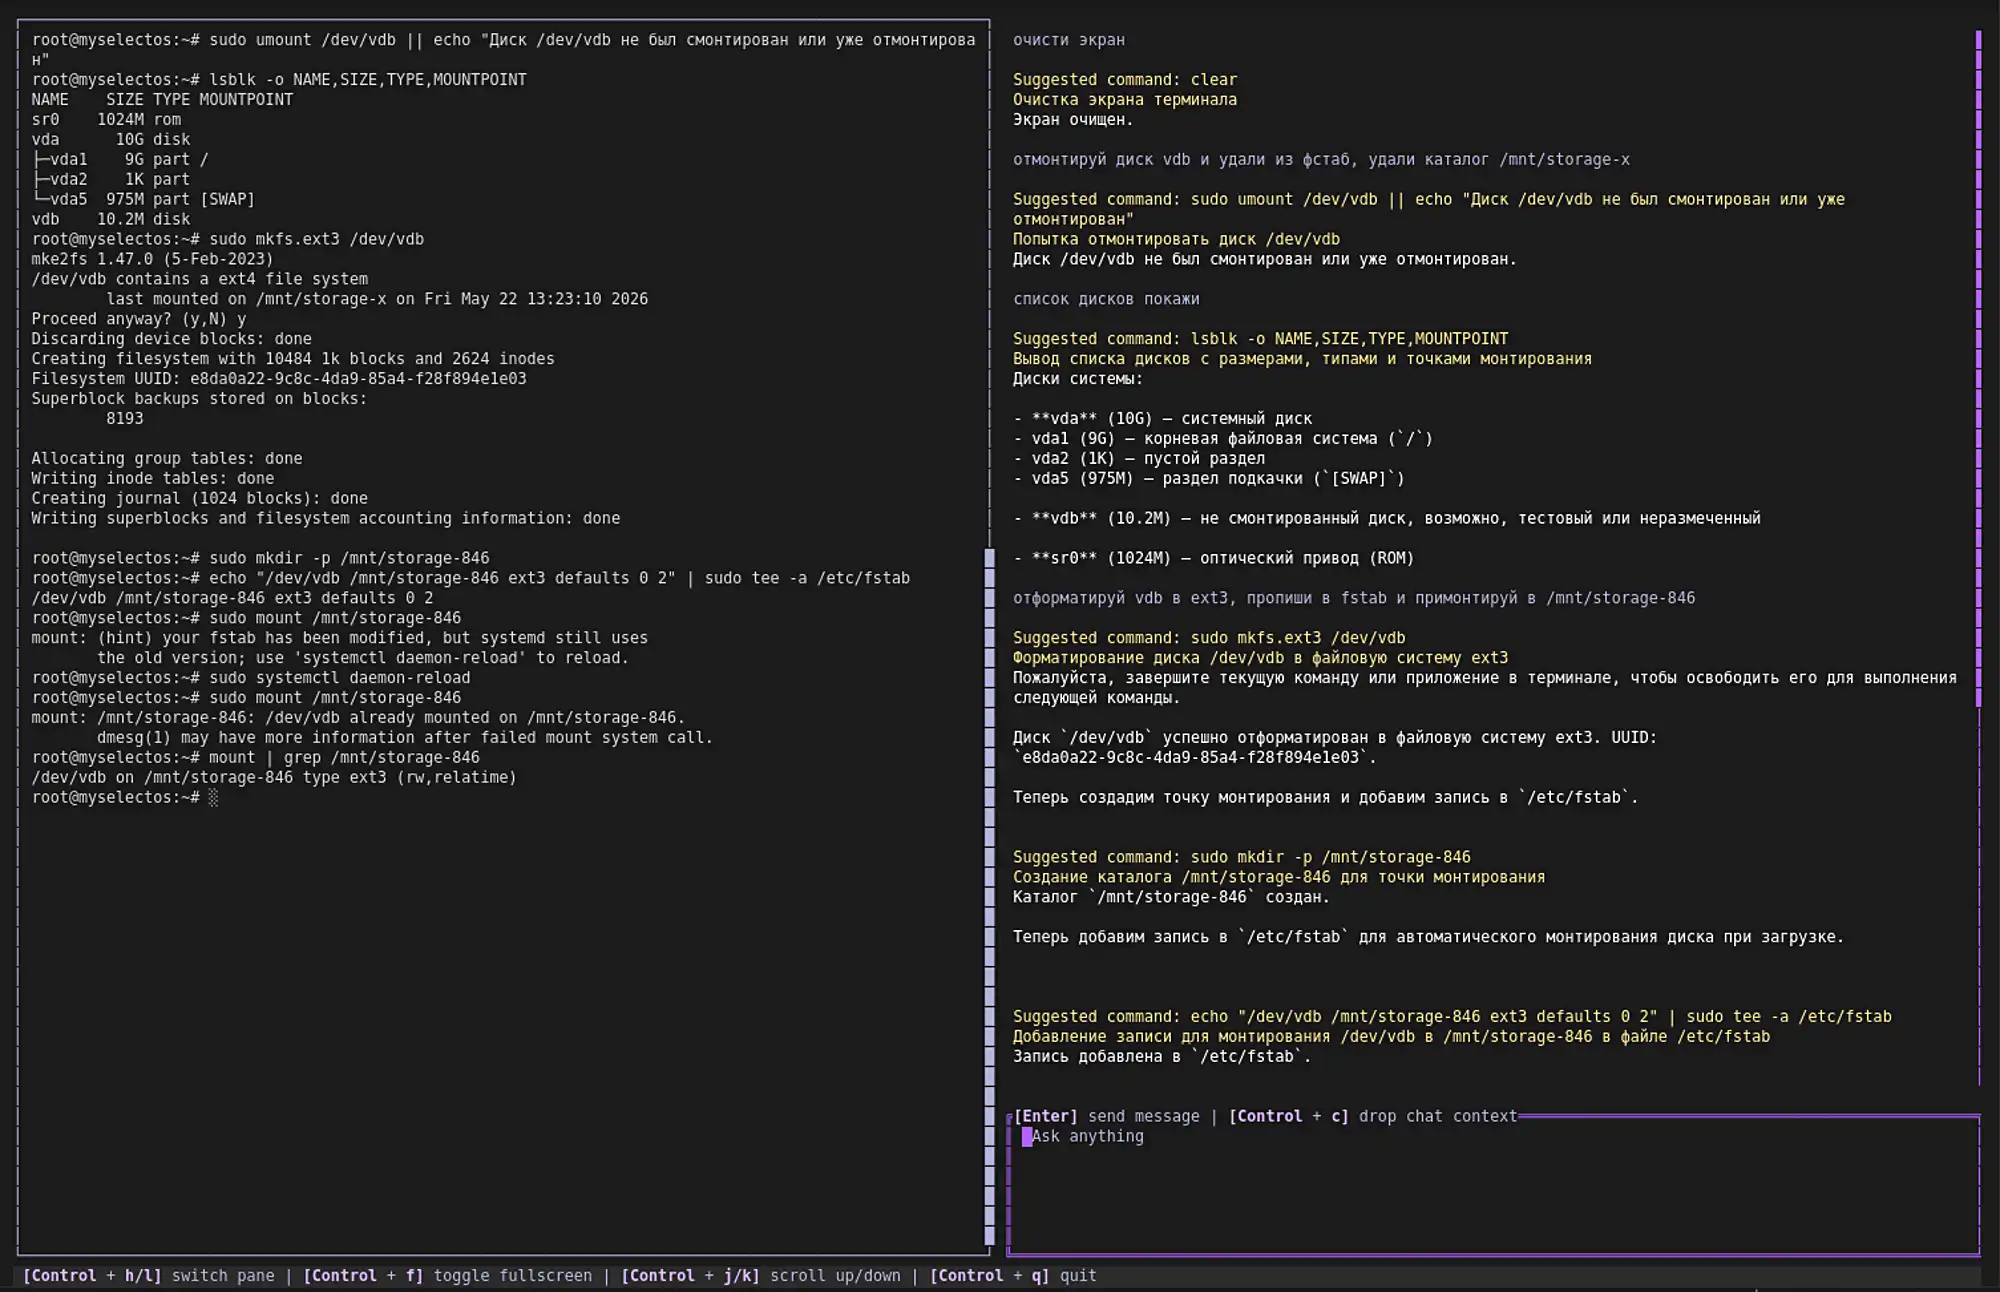
Выглядит это не очень промышленно, но не надо думать, что никто не исследует тему того, каким образом можно было бы хотя бы частично заменить системного администратора искусственным интеллектом.
На скриншоте — одна из первых ласточек: Линукс от «Селектела» со встроенным «системным администратором»; в его качестве выступает нейросеть «Квен 3.5» с весьма скромными по нынешним временам характеристиками. Она превращает задачу пользователя в команды в консоли сервера.
Интерфейс пока аскетичный, но и задачи полностью заменить администратора пока нет: каждая команда требует анализа специалистом и подтверждения. В таком режиме от администратора не требуется знать хитрые ключи командной строки или нетривиальную последовательность действий — всё это за него уже может делать машина.
У нас один из сотрудников, занимающихся системным администрированием, в настоящий момент гоняет это решение на изолированной виртуалке. Не для рабочих задач, разумеется, а чтобы понять, куда ветер дует.
Программирование на двух GPU

На этой неделе мы наконец получили NVLink, чтобы связать наши два видеоускорителя собственной шиной. Это нужно, чтобы запускать модели большего размера, занимающие обе карты: на шине общего назначения скорости не те, и модели еле ворочаются.
Развернуть и потрогать пока успели только две модели:
deepseek-ai/DeepSeek-V4-Flash QuantTrio/MiniMax-M2.7-AWQ
Обе модели урезанные, разумеется, но даже так они еле умещаются на картах, параллельность никакая. Эти модели должны быть мощнее, чем те, которые удалось запустить на одной карте; по крайней мере, синтетика даёт ожидаемые результаты, но на практике не всё так однозначно.
Ребятам больше всех пока понравился
Надо понимать, что серьёзным облачным моделям эти модели в подмётки не годятся: они мощнее примерно на порядок, и оборудование, которое позволяет их запустить, стоит совершенно других денег.
Для серьёзного программирования такие локальные модели непригодны,
Manchester Baby
Мне кажется, нейросети потенциально могут породить такое явление: зачем искать и скачивать программу, если проще её написать?
Я уже начал лениться. Я тут недавно писал про «компьютерную шею» в фильме про Швейка 1957 года, а сегодня прочитал про эмулятор компьютера 1948 года — Манчестерской малой экспериментальной машины. Я о ней никогда не слышал и не то, чтобы это
Я знаю только о компьютерах Конрада Цузе того же времени, на этом мои познания заканчиваются, но о его работе никто и не знал — война помешала, а тут
Эмулятор из прочитанной мной статьи идёт в наборе с целой кучей других и обещает качаться больше недели, поэтому я нашёл другой. Я сильно не утруждался, первым мне попался экземпляр для ДОСа, но поскольку я недавно как раз запускал у себя ДОС, то решил, что он меня вполне устроит.
Оказалось, что устройство ввода компьютера того времени не вполне совместимо с моим терпением, тыкаться в эмуляторе ДОСа быстро наскучило. И вот тут проявилась та лень, о которой я пишу: вместо того, чтобы поискать новый эмулятор, я просто попросил нейросеть адаптировать мне то что есть для моей операционной системы.
Нейросетка справилась одной левой — я сел позаниматься своими вещами, а когда переключился обратно, у меня уже запускался готовый эмулятор.
Программирование на одной GPU
Интересная штука встречается очень часто. Мне сложно её принять, хотя я понимаю, почему так произошло. Для людей нейросети слились в одно большое атомарное явление. Ну, знаете, как «учёные»: «Учёные заявили…». Какие учёные? Может, там биолог про математику говорит? Многим неважно, есть ли консенсус среди учёных по этому вопросу и насколько проверены данные, на основании которых «учёные заявили».
Так же и тут. Как будто бы многие считают, что нейросети одинаковые: видел одну — видел все. Разумеется, это не так. Они разные по размеру, а значит, и по способностям. У большинства есть специализация, они обучались на разных данных и обладают разным «опытом». И то, что вы можете развернуть у себя на ноутбуке, в подмётки не годится большинству из того, что есть в «облаках».
Мы недавно провели эксперимент среди нейросетей для программирования, которые можно развернуть на одной Nvidia H100. У неё 96 ГБ видеопамяти, и это сейчас один из самых главных критериев — размер памяти, а не мощность самой карты.
Даже в этом сегменте результаты сильно различаются. Мы попробовали следующие сети:
openai/gpt-oss-120b — четыре бита на параметрQwen/Qwen3-Coder-Next-FP8 zai-org/GLM-4.7-Flash Qwen/Qwen3-Coder-30B-A3B-Instruct gemma-4-31B-it
Среди этих почти одинаковых по параметрам сетей — выбивается только OSS со своими 120 миллиардами параметров, но в сильно урезанном виде — есть явный и безусловный лидер:
Я веду к тому, что если вы попробовали
Забавные часы: утечка памяти
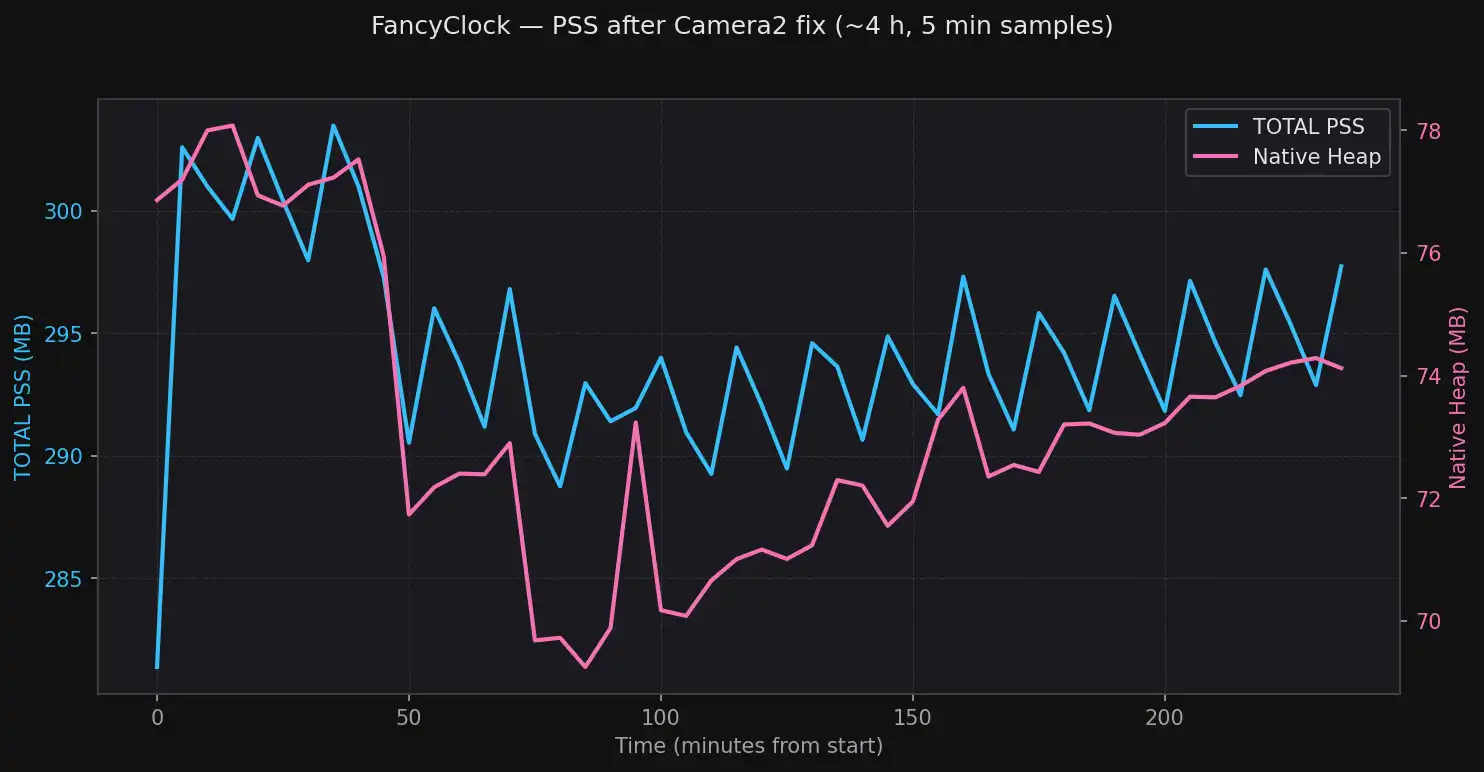
Обратил внимание, что мои «Забавные часы» иногда как будто вылетают: дважды по утрам я приходил, а на терминале — «Андроид», без часов. Я сразу заподозрил, что моё приложение «течёт»: накапливает ресурсы и не освобождает их, пока система его не прибивает
Нейросеть мне на слово не поверила — я использовал
Только после этого она начала разбираться в проблеме. Неожиданно оказалось, что причина — в компоненте работы с камерой фреймворка «Флаттер», на котором построено это приложение. Камера используется для мониторинга освещённости: в моём устройстве нет соответствующего датчика, поэтому приложение переключает фон, определяя уровень света с помощью камеры.
Как мы ни крутили этот модуль, за два дня работы с камерой ресурсы всё равно выедались подчистую. Пришлось заменить компонент на нативный для «Андроида».
Забавные часы
Купил себе на «Авито» бывший платёжный терминал — на борту «Андроид», так что мысль была запрограммировать себе (при помощи нейросетей, разумеется)
Пока у меня
В итоге, когда я в очередной раз засиделся
Скачал с «Гуглфонтса» 1500 случайных шрифтов, выдрал из них цифры и сварганил приложение на «Флаттере», которое выводит цифры случайным шрифтом и в случайном контрастном цвете. В приложении два фона — светлый и тёмный, выбираются автоматически в зависимости от освещённости, которая измеряется камерой.

Проект выложен у меня на «Гитхабе».
«Тетрис» на Brainfuck ★
Ну разумеется я вчера не смог уснуть без того, чтобы не посмотреть что ещё мог бы написать ИИ на «Брейнфаке»! Попробовал написать «Тетрис», тем более что у меня были готовые идеи как это сделать. Правда для этого пришлось модифицировать интерпретатор. Свой собственным, разумеется, который я начал писать ещё
Дело в том, что у «Брейнфака» нет рандомизации и ввод устроен очень просто — есть инструкцию чтения символа и всё. Правда сам язык не определяет подробности чтения символа, поэтому реализации отличаются. В основном авторы интерпретаторов делают буферизированный ввод, дожидаясь нажатия кнопки «Ввод». Правда тут тоже есть нюансы —
Чтобы приступить к «Тетрису» пришлось сделать две модификации.
Все расширения я сделал включаемыми и отключаемыми при помощи ключей интерпретатора, тем более у меня их уже и так было немало — некоторые существующие программы отличаются в своих ожиданиях относительно деталей реализации.
Чтобы каждый раз не вспоминать какие ключи нужны программе, я придумал способ как их указывать — если в начале программы на «Брейнфаке» стоит обычный шебанг, я беру параметры интерпретатора оттуда.
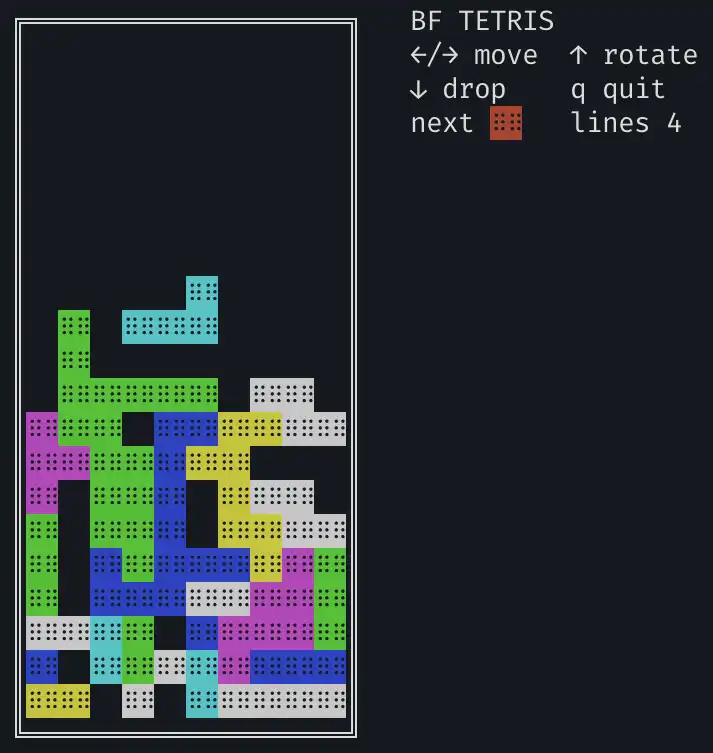
Как легко догадаться по скриншотам, нейросеть (я использовал
Я даже сделал в своём интерпретаторе поддержку сжатия исходников. Наверное никому раньше не приходило в голову этим заниматься — как правило программы на «Брейнфаке» пишут люди и до таких размеров они их не доводят.
Трансляция такого огромного файла и применение оптимизаций занималось около 15—20 секунд на моём ноутбуке, так что пришлось применить ряд оптимизаций — немного переписать парсер интерпрератора, сделать кеширование и поработать над уменьшением размера кода «Тетриса».
«Тетрис» работает в консоли и, надеюсь, никому не надо объяснять, что для раскрашивания блоков и позиционирования тут широко применяются
Единственное о чём надо рассказать — как регулируется скорость игры. В «Брейнфаке» нет ничего, чтобы создавать паузы заданной длительности, но некоторые программы работают ощутимо долго. Хотя у меня и оптимизирующий интерпретатор, всё оптимизировать он не может. Поэтому мы с нейросетью просто «на глазок» подобрали код, который достаточно плохо оптимизируется и тормозит на моём ноутбуке ровно насколько, чтобы играть было комфортно.
ИИ: Brainfuck
Три года назад я в шутку предлагал программистам переходить на «Брейнфак» — эзотерический язык программирования из восьми конструкций, который плохо давался нейросеткам.
Я пропустил момент, когда модели научились на нём писать. Буквально вчера догадался снова попробовать, оказалось — могут! Программу на скриншоте мне «Курсор» написал в режиме «Авто», где выбираются, в основном, слабые модели. Топовые справляются даже с такими заданиями как написать несложный эмулятор командной строки с несколькими основными командами и небольшой файловой системой!
Для человека это уже
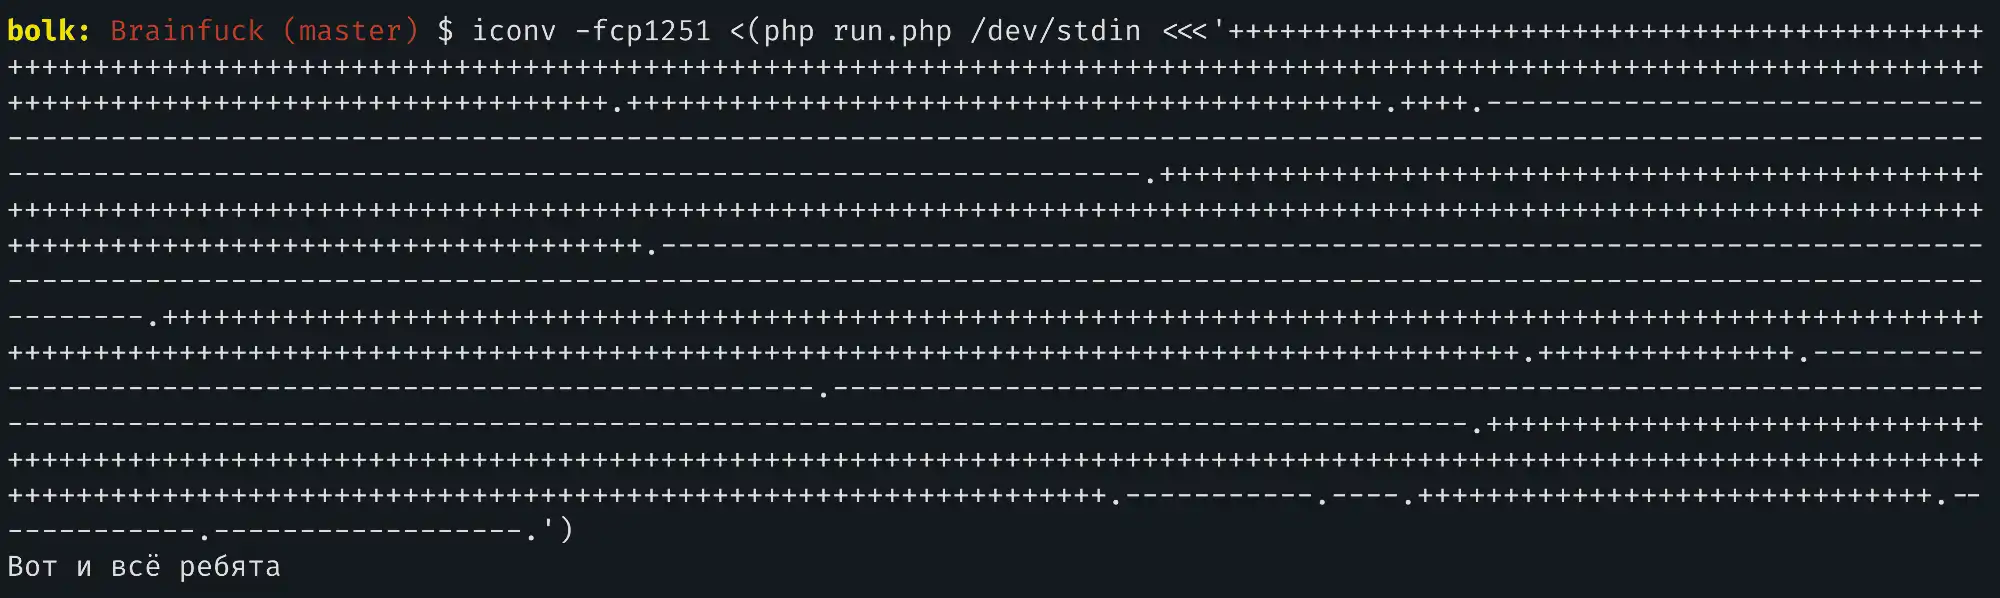
Две вещи, с которыми модели ещё не справляются — это написание «квайна» (программы, которая выводит сама себя) и оптимизация программ на «Брейнфаке» по размеру. Даже топовые модели наотрез у меня отказываются такое писать. Даже после прямого приказа.
Интересно будет помучить этой задачкой новую модель «Антропика», которая должна появиться летом — я считаю их модели лучшими, хотя их последний «Опус» несколько разочаровал.
Добавлено позднее: справедливости ради насколько простую программу, как на картинке выше, нейросети и сейчас могут написать оптимальнее:

Мир в бутылке: графика
Хочу немного остановиться на том, откуда взялась графика моего проекта, который я условно пока называю «Мир в бутылке», и какие нейросети я использовал для рисования.
Первых персонажей для будущего перформанса я нарисовал в «ЧатеГПТ 5.4». На вход дал несложный промпт,
нарисуй 10 характерных
персонажей-человечков в пиксельном стиле маленького размера. референс в картинке
В качестве референса был приложен первый попавшийся скрин

Собственно, этот спрайт плюс небольшое текстовое техническое задание, где я поверхностно описал, какими возможностями будут обладать будущие персонажи, я и подал на вход «Опусу 4.7».
Картинки я на спрайты не резал: нейросеть справилась с этим самостоятельно — вырезала, сделала им прозрачный фон и даже добавила простенькую анимацию ходьбы. Кстати, позже я обнаружил, что у меня в коде оказалось два варианта спрайтов — для ходьбы влево и вправо, — и попросил оставить только один вариант, а второй делать поворотом спрайта.
Травку, камешки, насекомых и игровые предметы мне рисовал уже «Опус». С мелкими предметами он справился хорошо, а с теми, что покрупнее, — хуже. В итоге котёл, костёр, сундук и так далее я снова попросил нарисовать «ЧатГПТ». На мой взгляд, он их нарисовал слишком детализированно:

Поскольку их надо было сделать сильно меньше, «Опус» перерисовал новую версию «по мотивам». В итоге качество меня устроило. Текущий вариант лучше, чем было раньше, но выглядит менее натурально, чем то, что нарисовал «ЧатГПТ». В силу того, что я придерживаюсь
Гидру я рисовал в «Нанобанане 2», приложив как референс картинки персонажей. Текущий результат получился примерно с четвёртой или пятой попытки и, если честно, не кажется мне идеальным, но мне больше хотелось проектировать мир, а не возиться с графикой настолько долго.
Претензия всё та же: по сравнению с персонажами гидра чересчур детализирована.

Что делать дальше я пока не решил. Либо доделаю этот мир — там осталась ещё одна нереализованная задумка, либо перейду на другую платформу
Мир в бутылке: поведение ведьмы
Вчерашняя идея прикрутить небольшую нейросетку, которая будет выстраивать поведение ведьмы,
Обидно, досадно, но ладно. Там было пространство для манёвра, но слишком медленно тренируется. Чтобы ускорить, нужно переписывать весь игровой мир
Решил пойти другим путём — попробовать «дерево решений», оно легче в обучении и его проще потом разбирать. Это помогло — эксперименты пошли бойчее, и я довольно быстро увеличил метрику с 1,715601 до 1,933353, что довольно много на самом деле. Метрика там по простенькой формуле учитывает результативность кампании — удалось ли убить гидру и сколько народу выжило.
Потом «Курсор» просто разобрал мне получившееся дерево и перенес ту же логику в правила. Следующий шаг — хочу расширить количество «решений», которые может принять ведьма и посмотреть что получится.

ИИ: Claude Mythos и поиск уязвимостей
Я давно предсказывал, а месяц назад даже об этом написал, что нейросети в этом году побьют все прежние рекорды по поиску уязвимостей. Прогноз уже начинает сбываться: компания «Антропик» не стала публиковать свою модель следующего поколения «Мифос», потому что она исключительно хороша в поиске уязвимостей.
Вроде обещают показать летом, когда все крупные поставщики софта закроют выявленные этой моделью уязвимости.
Я сразу заподозрил в этом заявлении изрядную долю маркетинга и оказался прав: как показало исследование, изрядную часть уязвимостей, которые раскрыли, нашли также и модели предыдущего поколения. Тем не менее я охотно верю, что «Мифос» сильнее «Опуса», просто не думаю, что настолько, насколько это хотят показать.
В конце концов, это хороший