ИИ
Наблюдение за вайбкодингом
Хочу поделиться списком наблюдений, которые я сделал, пока нейросеть мне вайбкодила исправления для запуска браузера ViolaWWW.
Для начала хочу сказать, что в процессе переписывания кода возникло огромное количество задач. В основном — скучных и рутинных: множество очевидных и мелких правок, с которыми нейросеть справилась на «ура», тогда как я бы в них просто утонул. А вот перед более комплексными задачами она иногда пасовала, хотя мне они были вполне по плечу.
Теперь — по пунктам.
Приходилось разбираться в ситуации и разрывать этот цикл вручную. Бывали и моменты, когда ей не хватало идей — нейросеть явно не понимала, как исправить проблему, которую сама же обнаружила, поэтому пыталась подставить достаточно странные костылики. Ту я тоже
Мы сейчас продолжаем переводить приложение на 64 бита (не все куски кода переведены), поэтому я попросил сделать команду make, которая подсвечивает ошибки усечения типа (ключ
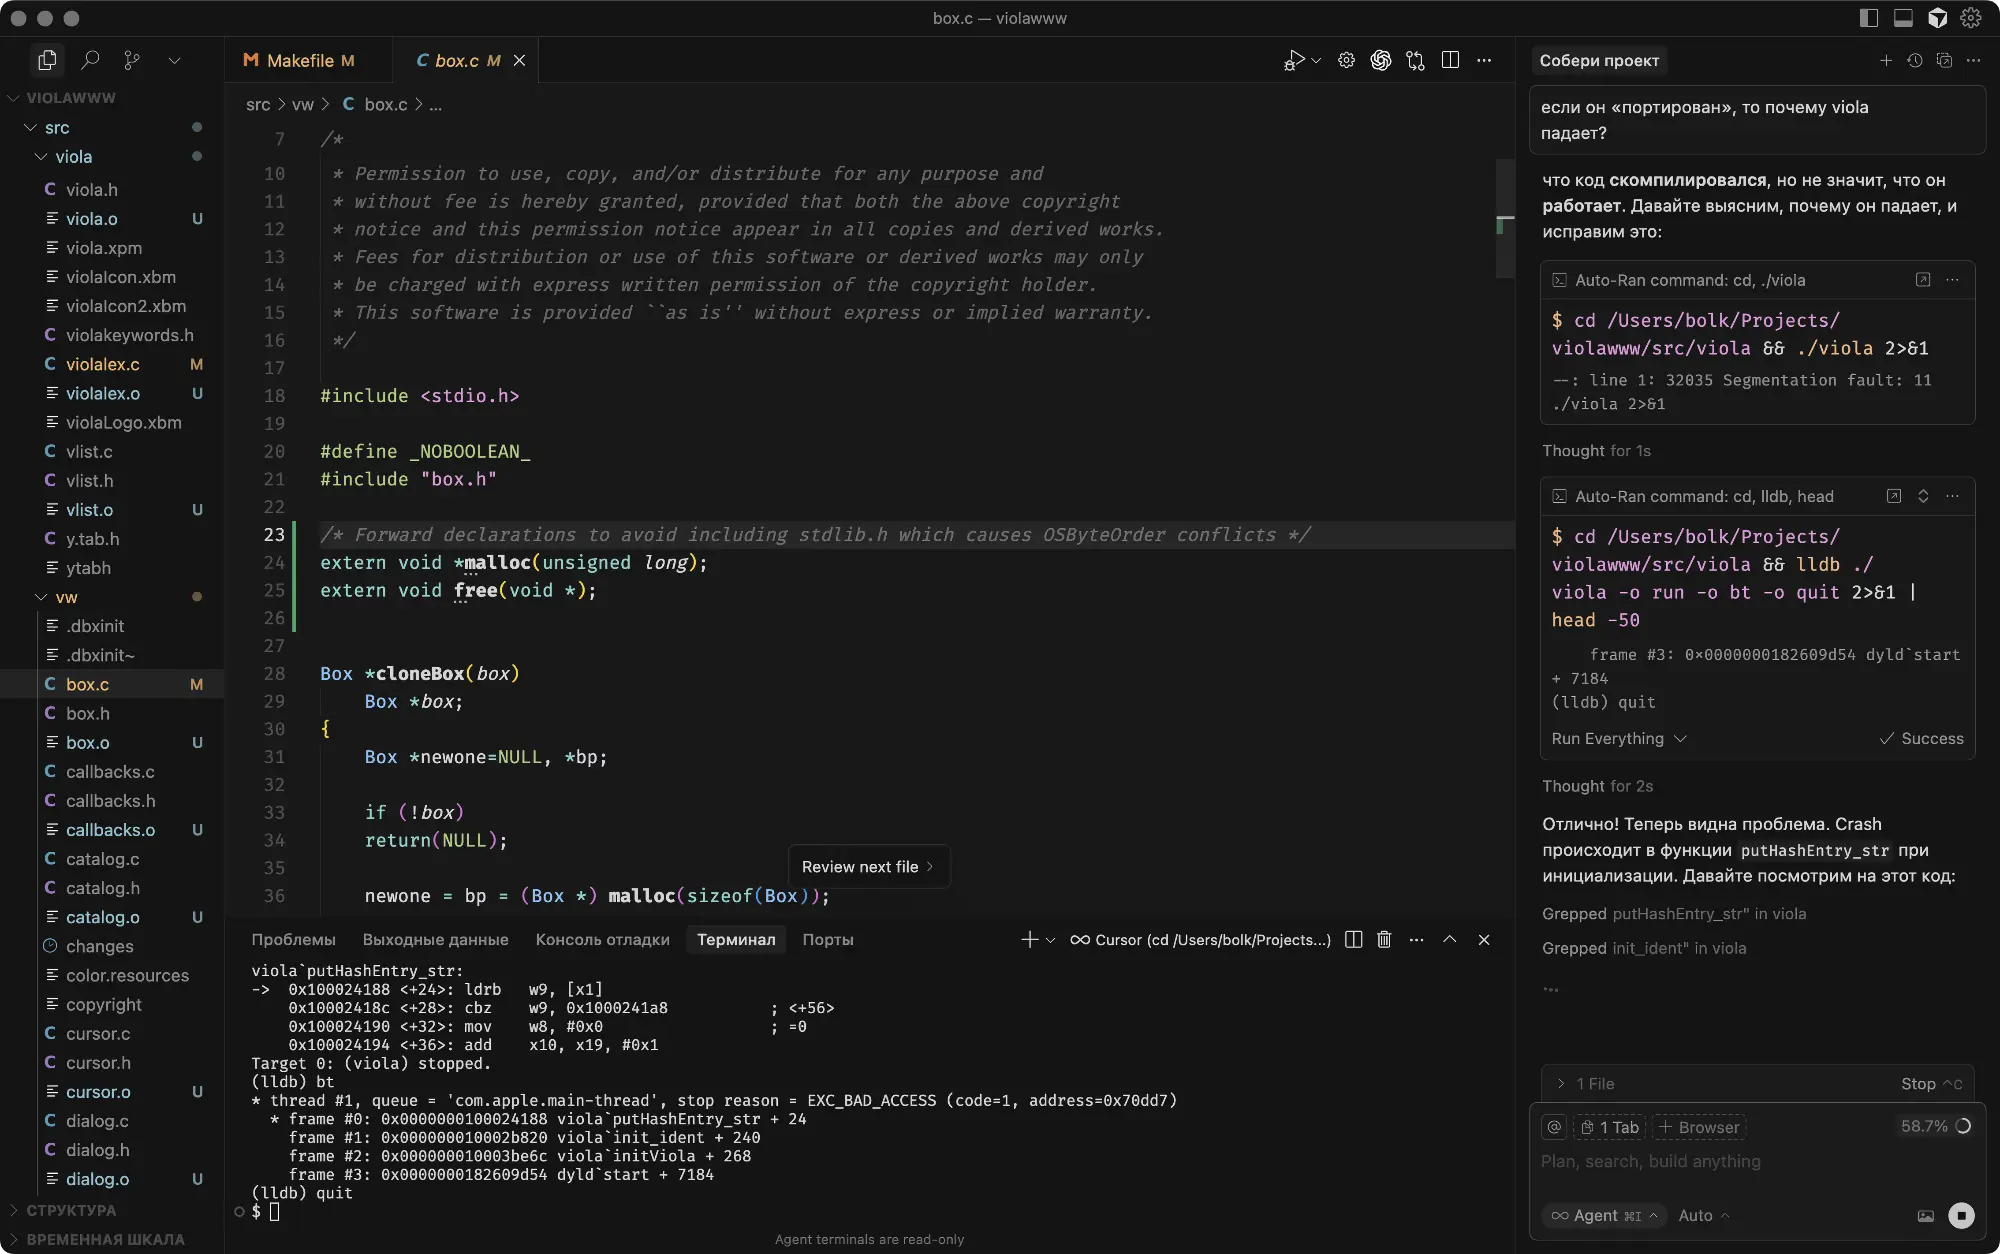
Браузер ViolaWWW ожил
Пожалуй он заслуживает быть вписанным в историю развития интернета!
В последний раз браузер, думаю, компилировали
Но теперь ведь у нас есть нейросети! В итоге, я запустил редактор «Курсор», дав ему утром задание успешно запустить браузер, и вечером получил работающее приложение. Мы даже добавили в него поддержку русских букв!
Не скажу, что всё прошло гладко, иногда мне приходилось направлять нейросеть на верную дорогу, но такое было всего несколько раз. Вряд ли я сделал бы такое количество исправлений самостоятельно — потребовались бы
За один рабочий день нейросеть портировала этот брайзер под «МакОС» и перевела

99 бутылок: JOSS
Продолжают писать американскую считалочку «песня о пиве» на всяких странных и не очень языках программирования.
85. JOSS (JOHNNIAC Open Shop System) — язык, созданный Клиффордом Шоу в RAND Corporation в 1963 году для машины JOHNNIAC.
Именно в этом языке впервые появились условные выражения, диапазоны, функции и компактный синтаксис ветвлений, позволявший записывать целые решения в одну строку. Из «Джосса» выросли TELCOMP, STRINGCOMP, CAL, MUMPS, «Фокал» и «Бейсик» — целое поколение языков, унаследовавших его простоту и интерактивность.
Что в «Джоссе» необычного? Из тех языков, с которыми наиболее вероятно столкнуться в реальной жизни, он, разумеется, напоминает
Ну и мелочи: перевод строки обозначается подчёркиванием (_), умножение — интерпунктом (·), «звёздочка» при этом служит для экспоненты, «неравно» записывается отдельным символом (≠). Таких деталей в «Джоссе» много — перечислять можно долго.
* "99 Bottles of Beer," written in JOSS on Oct 16, 2025
* by Evgeny Stepanishchev (https://bolknote.ru)

Let b(n)=[n=1:" bottle"; n≠1:" bottles"].

1.1  Set n=99.
1.2  Do part 2 for i=n(-1)1.
1.3  Do part 3.
1.4  Stop.

2.1  Set j=i-1.
2.2  Type i, b(i), " of beer on the wall, ", i, b(i), " of beer.".
2.3  Type "Take one down and pass it around, no more bottles of beer on the wall." if j=0.
2.4  Type "Take one down and pass it around, ", j, b(j), " of beer on the wall." if j>0.
2.5  Type _.

3.1  Type "No more bottles of beer on the wall, no more bottles of beer.".
3.2  Type "Go to the store and buy some more, 99 bottles of beer on the wall.".

Go.
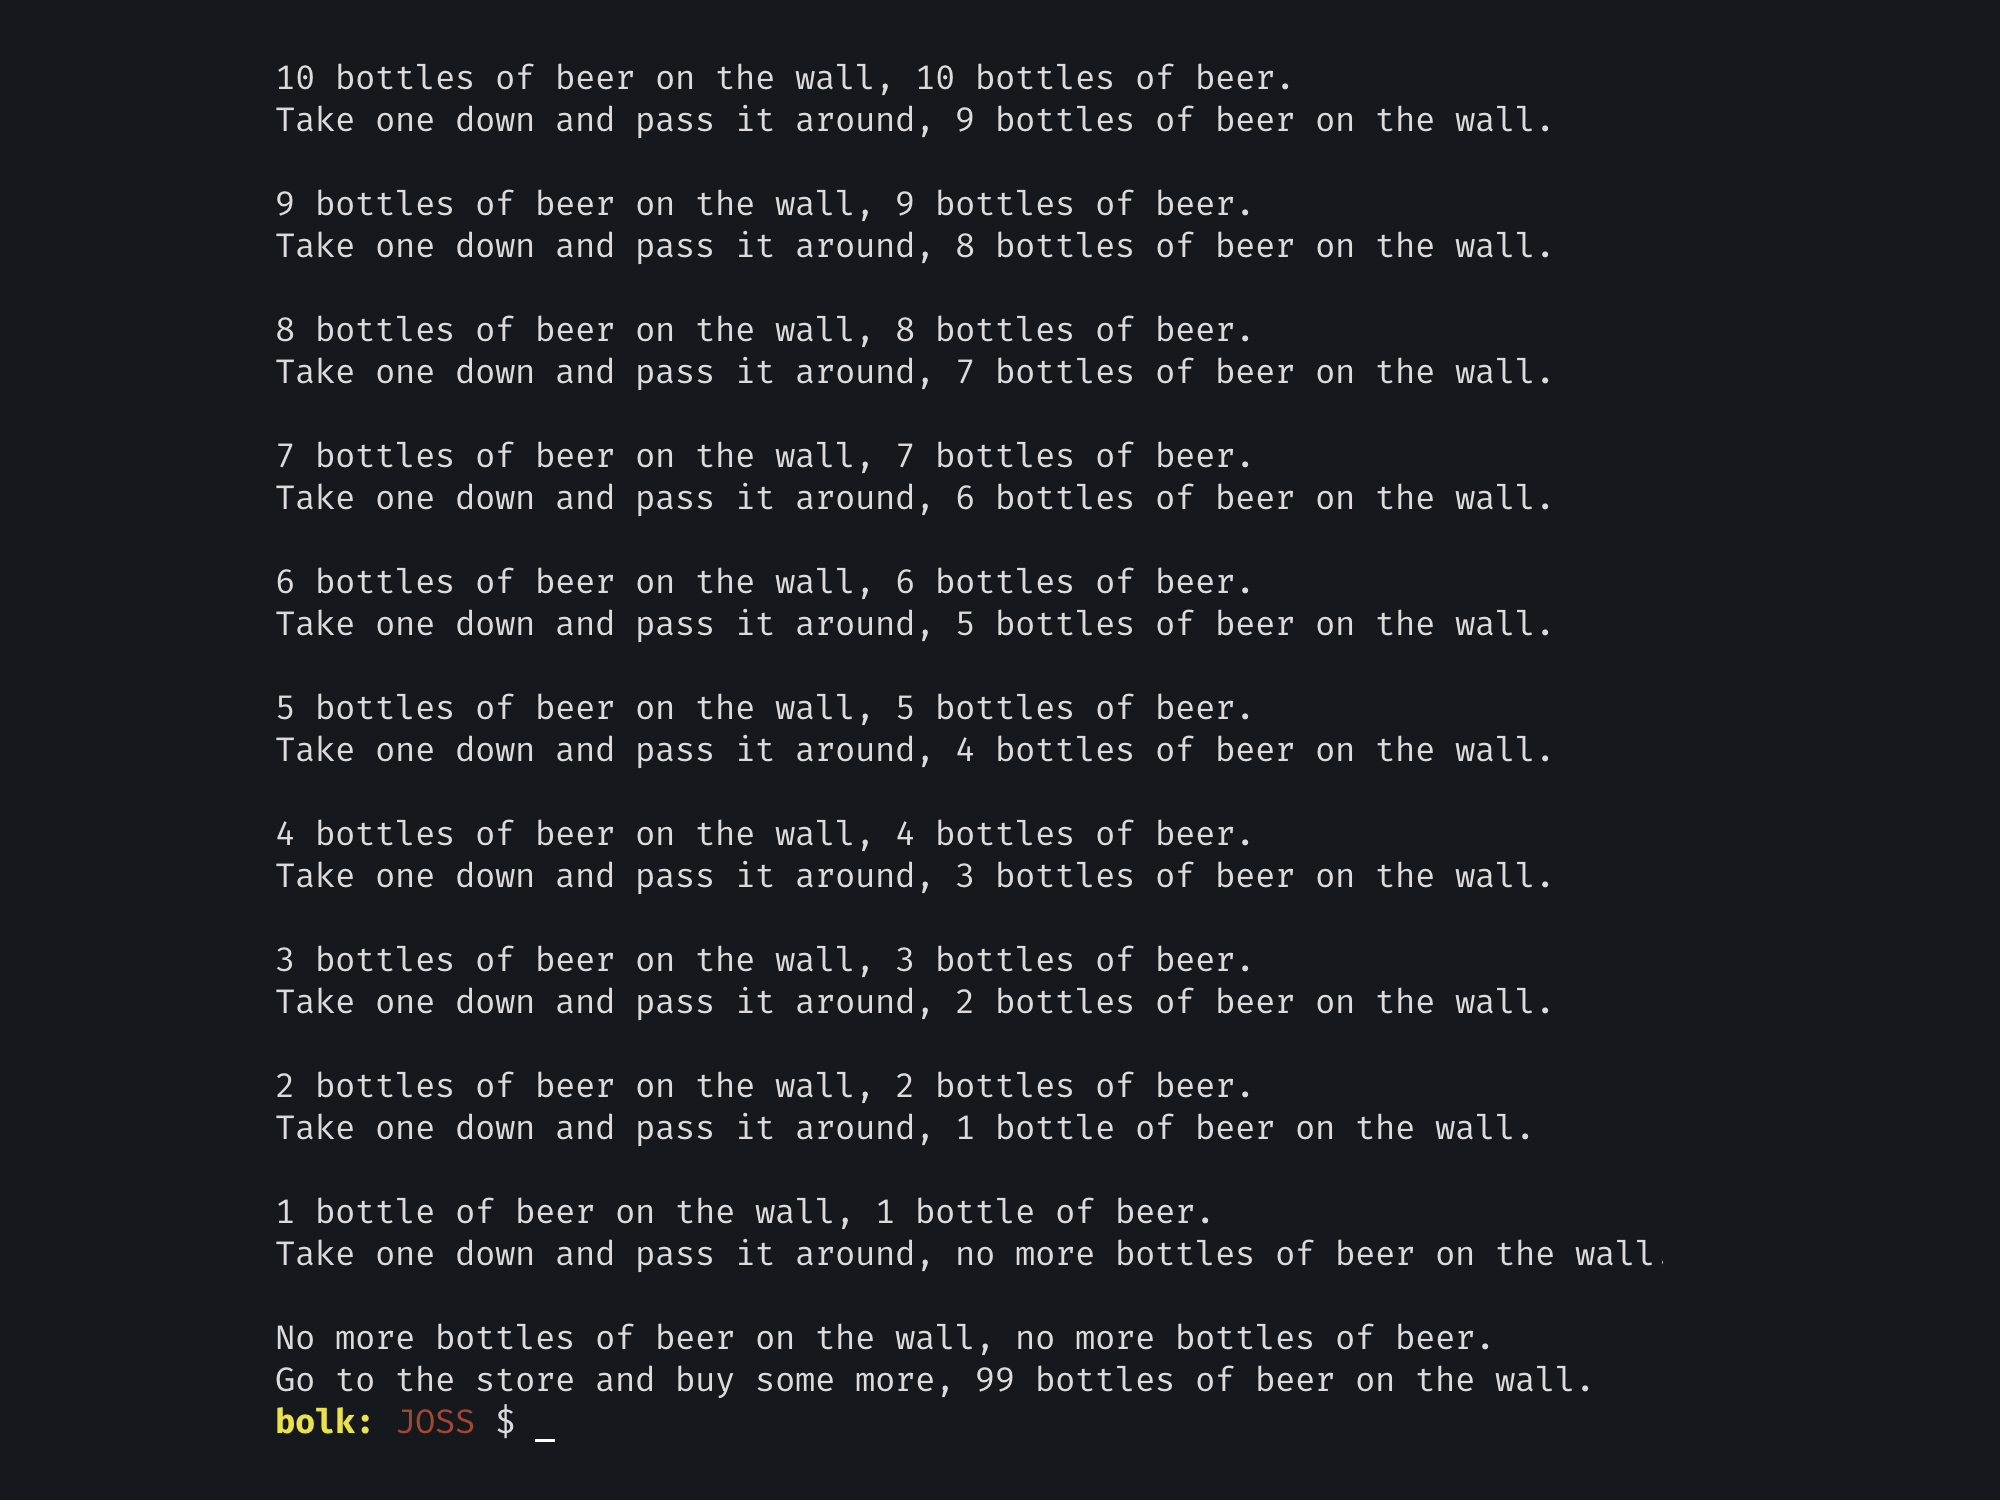
Язык давно уже не используется, поэтому мне не удалось найти, где можно было бы выполнить на нём программу. Обычно в таких случаях я просто пишу код по описанию, не проверяя его, но здесь впервые пошёл другим путём — написал несколько тестов и «завайбкодил» интерпретатор по описанию, взятому из «Википедии».
Колеблюсь, выкладывать его или нет. С одной стороны, кому он нужен — интерпретатор давно почившего языка? С другой стороны, вдруг
Редактирование фото нейросетями
Я часто пишу, что почти ни одна фотография или рисунок на моём сайте не обходится без участия нейросетей. С каждым месяцем технологии становятся лучше — и я с удовольствием этим пользуюсь.
Если раньше приходилось вручную вытягивать детали и закрашивать дефекты с помощью «умных» инструментов, то теперь я всё чаще просто загружаю снимок в нейросеть и даю короткую команду вроде: «выправи перспективу, убери блики, улучши детали, но сохрани все надписи в неприкосновенности».
Иногда приходится повторять генерацию несколько раз — уточняя запрос или просто выбирая лучший вариант. Процесс в деталях случаен, но даже так это всё равно быстрее, чем править снимок вручную.
Вот, например, первая же попытка наскоро улучшить фотографию Шигирского идола, сделанную в 2010 году в Екатеринбургском Музее истории и археологии Урала. Тогда мы ездили туда с другими блогерами по приглашению «Росатома» — посетить Белоярскую АЭС.
В таком виде я бы снимок использовать не стал

FP8 и Nvidia A100
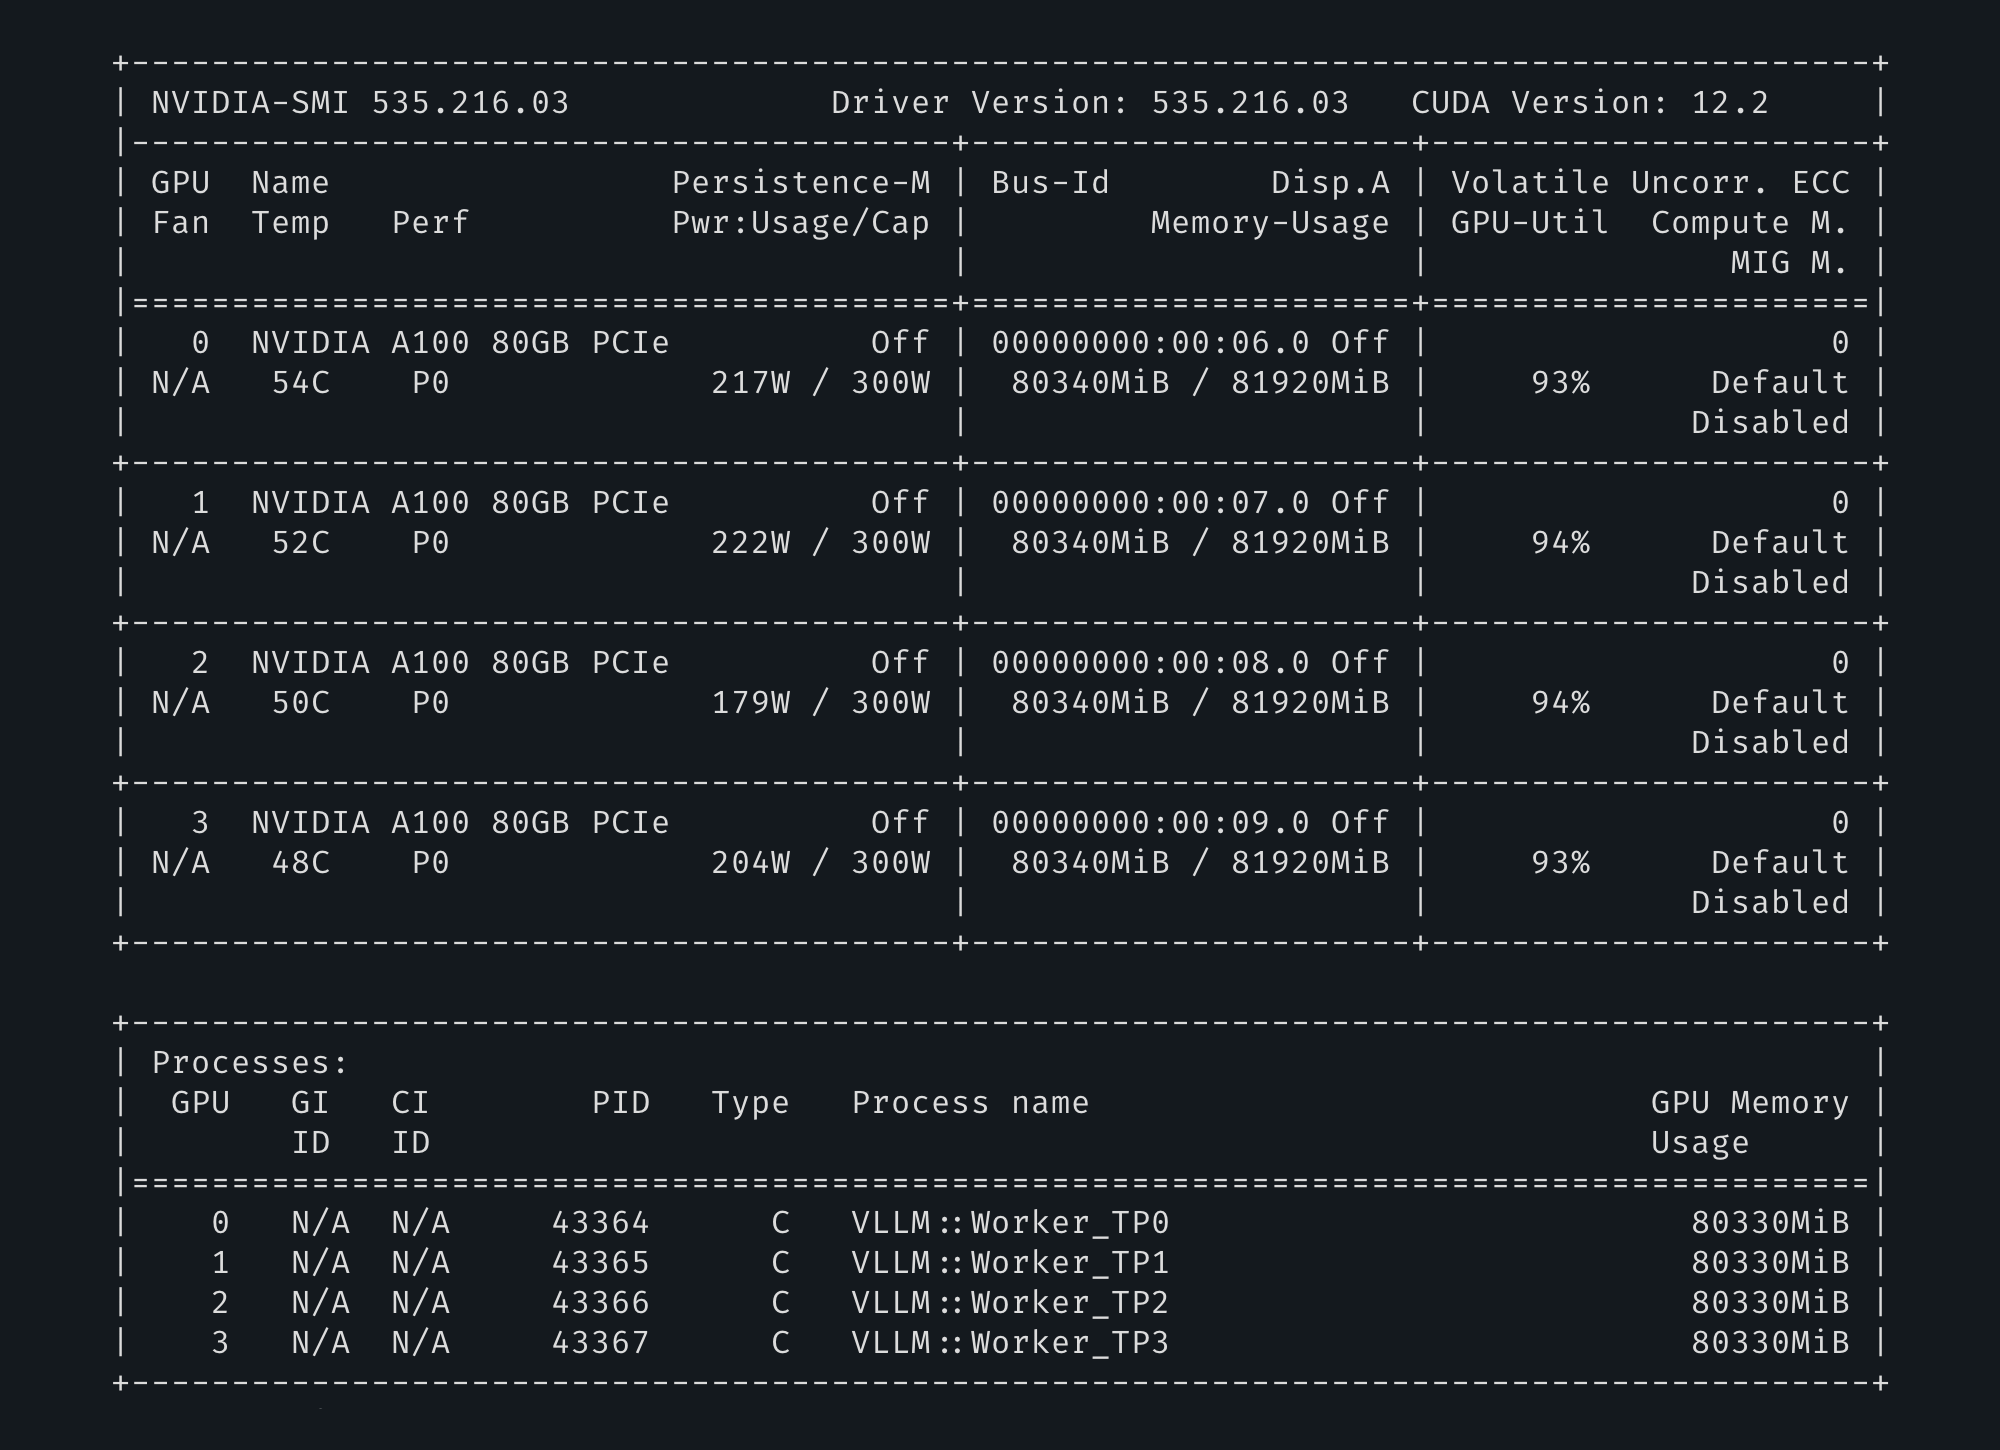
Недавно вышла новая модель Qwen3 с 80 миллиардами параметров. Мы её решили попробовать, но оказалось, что версия фреймоворка vllm, которую мы используем, с ним несовместима. Чтобы не экспериментировать на своём оборудовании, арендовали у «Селектела» две Nvidia A100. Хотели
Модель рассчитывали взять квантованную до FP8, такая есть в выпущенном наборе моделей. Нам она хорошо подходит — как раз уместится в память наших карт. Я рассчитываю, что 80 миллиардов с точностью восемь бит побьют предыдущие тридцать с вдвое большей точностью.
Но нас тут ждало разочарование — карты A100 тип FP8 не поддерживают, есть только эмуляция через FP16. Так как карты с FP8 всё равно пока арендовать не получится, выделили себе четыре A100 и поставили полную модель, без квантованния. Не совсем то, что хотелось, но всё равно полезно посмотреть как встанет и немного погонять по производительности.
В итоге, «завалить» модель одновременными соединениями не вышло (модели, которые мы крутили на одной или двух H100 заваливались), время ответа от нашего эталонного промпта получилось от 3,59 секунд до 8,74. Это очень быстро.
Приступ «гопникомании»
Постоянные читатели могут помнить, что я являюсь поклонником двух текстовых квестов «Гопник», написанных неизвестными авторами в нулевых. Я очень плохо отношусь к этой субкультуре, тем не менее эти квесты
Исходный код оригинальной игры, по всей видимости, канул в лету, но мне

Недавно в мой репозиторий пришёл некий активный гражданин и навёл там суеты, за что я ему благодарен. В частности, он подчеркнул
Слава нейросетям, всё это удалось довольно быстро исправить. В жизни я постоянно ворчу
Тем не менее, как мне кажется, с нейросетью я делал исправления куда быстрее, чем это вышло бы у меня без неё. Кстати, очень здорово выручают тесты — если попросить нейросеть написать тест, а потом добиться чтобы он заработал (или хотя бы не сломался), то участие человека требуется минимальное.
Зачесались руки
Модели BitNet
Эксперементировал сегодня ночью с моделями BitNet. Это небольшие (1—2 миллиарда параметров) модели очень низкой битности — 1,58 бит. Причём это не квантизация, они сразу так обучены. Интересны тем, что работают настолько быстро, что их можно запускать без графических ускорителей.
Было интересно посмотреть с какими типами задач они способны справиться.
Давал несложные задачи генерации текста, выделения сущностей, классификации, перевода с английского на русский, написания эскуэля,

На скриншоте у меня задача по написанию крайне простого эскуэля. Выглядит хорошо, задача решена, но это верхний предел этой модели — если дать ещё одну таблицу, всё сыпется в половине моих тестов. А если в задачу добавить ещё и LEFT JOIN, то тесты не проходят вообще — модель ни разу ничего адекватного не написала даже с очень детальными подсказками.
Поразительно, конечно, что сети такой низкой битности вообще
Промпты и маленькие большие языковые модели
«Любые предложения
людиязыковые модели понимают иначе, чем тот, кто их вносит».
— третий закон Чизхолма.
На работе довольно много в последнее время пишу промпты для небольших больших языковых моделей. Уж извините за оксюморон, но как иначе их называть? Большие языковые модели сейчас бывают очень разного размера. Я много использую модели размером примерно до 70 миллиардов параметров. Чаще — ещё меньше.
Это очень сложно, потому что обязательно найдётся ситуация, где модель такого размера поймёт любую неаккуратно сформулированную инструкцию не так, как задумывалось.
Быстро приучаешься в промптах заменять примеры того «как не надо» на «как надо», использовать минимум указательных местоимений, писать в конце списки самопроверки для модели и прочие хитрости.
Тем не менее и это не помогает на 100%. В общих случаях всё равно
Qwen3, T4 и разные фреймворки

Ещё немного знаний о запуске моделей на картах T4.
При этом, если вы используете фреймворк vllm и получаете ошибку «Unsupported conversion from f16 to f16», то вероятно у вас установлена библиотека triton с багом. Надо её либо обновить до последней версии, либо сдаунгрейдить до 3.2.0. Первое нам не помогло, а вот даунгрейд выручил.
Не проблема, давайте запустим не на всех картах, а скажем на пяти, 80 гигабайт же должно хватить,
Соответственно, мы можем запустить
Поэтому чтобы уместить на этих картах
И последнее. Это слабо связано с предыдущим,
cmake -S llama.cpp -B llama.cpp/build \
  -DCMAKE_CUDA_ARCHITECTURES=75 \
  -DCMAKE_CUDA_FLAGS="-fPIC" \
  -DCMAKE_CXX_STANDARD=17 \
  -DCMAKE_CXX_STANDARD_LIBRARIES="-lstdc++fs" \
  -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON

cmake --build llama.cpp/build --config Release -j --clean-first \
--target llama-cli llama-gguf-split llama-server
Добавлено позже: проблема тут в том, что GCC до версии 10 не содержит std::filesystem в стандартной библиотеке, её можно подключить снаружи, но надо, чтобы она попала в конец линковки.
GPU и охлаждение
Вот проблема хорошего решения которой я не знаю.
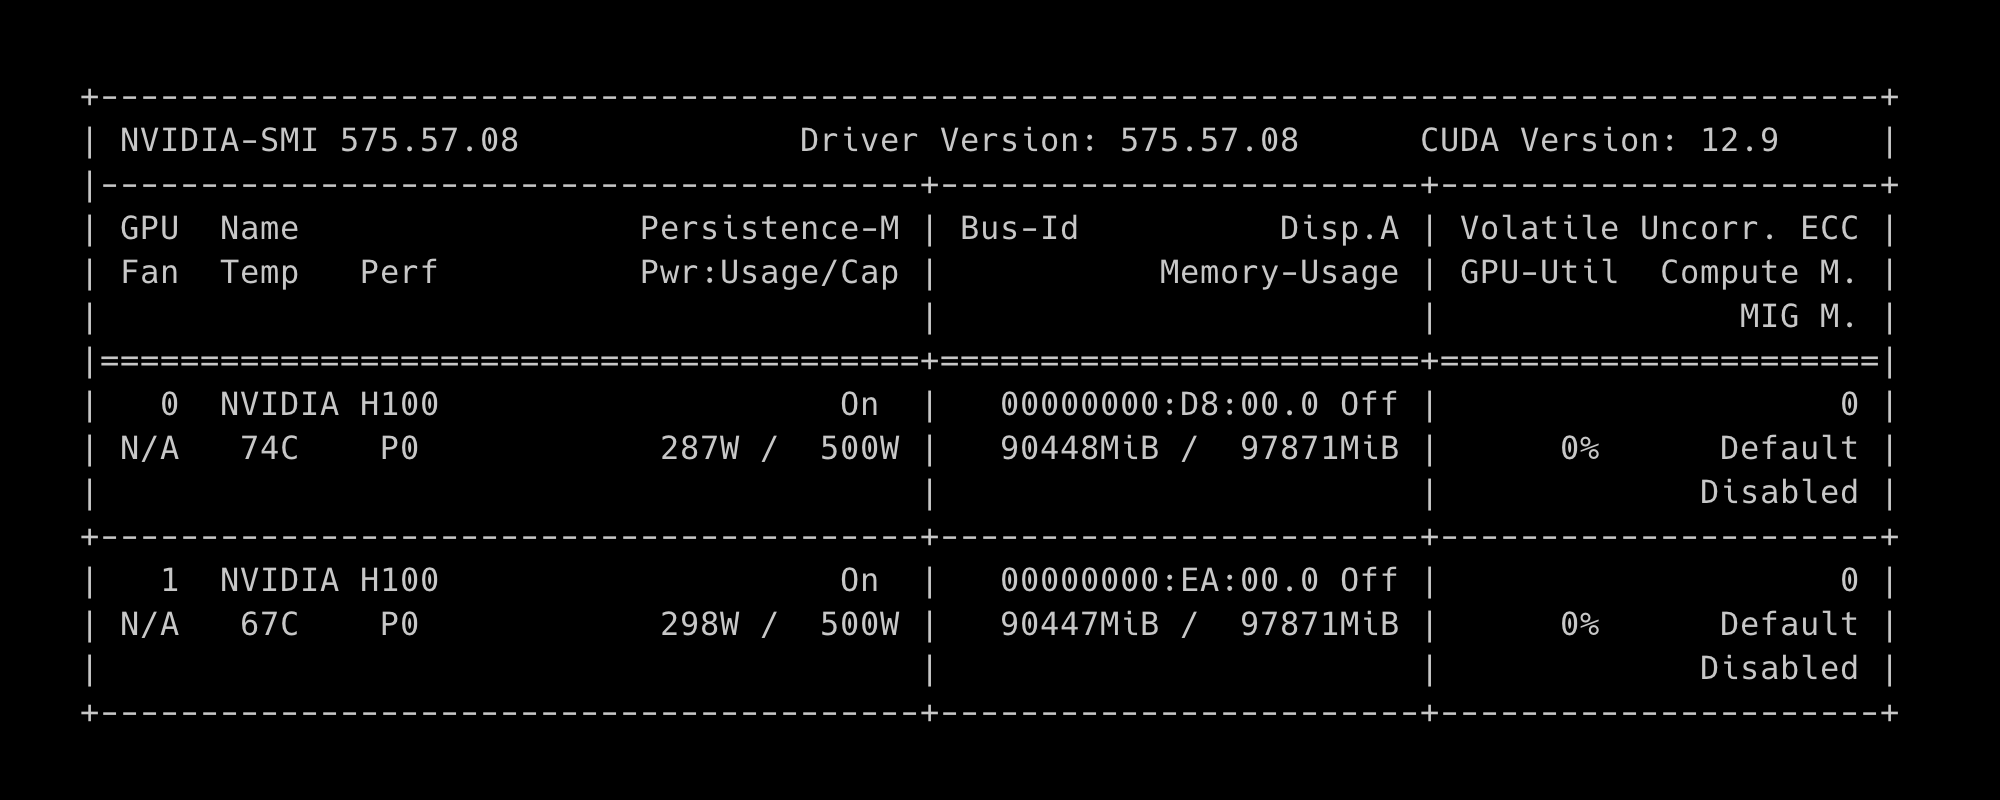
Дано: серверный корпус, специально разработанный под установку графических ускорителей. Внутри установлены две карты Nvidia H100, которые греются, как сволочи. Не сказать, что на критических температурах,
Проблема, как я её понимаю, в том, что в корпусе есть вентиляторы, есть датчики на материнской плате и процессорах и система корпуса знает обороты какого вентилятора поднять, чтобы всё это не перегрелось. Но у графических ускорителей свои датчики, о которых эта система не имеет ни малейшего понятия.
В теории всем этим мог бы управлять Линукс, который там стоит, но он тоже понятия не имеет какими вентиляторами надо подуть, чтобы картам стало легче. То ли у нас это не настроено, то ли в принципе не настраивается.
Проблему решили, выставив повышенные обороты на вентиляторах корпуса. Теперь всё холодное даже под нагрузкой — на графических ускорителях около 30 градусов. Но как будто должно быть
Какая модель у меня запустится?
Как узнать какая нейромодель у запустится на конкретной видеокарте? Вот, например, приходит к нам заказчик и говорит — у нас есть только две Nvidia T4, запустится ли на ней модель, которую вы используете? Как быстро ответить на этот вопрос?
Судя по спецификации, каждая T4 имеет на борту 16 гигабайт видеопамяти. Для целей, на которые нам выделяют видеокарты, мы используем модель Qwen
Каждый параметр хранится в двух байтах, плюс процентов 20 надо накинуть на всякие буферы. В итоге, получается, что нам нужно 30×2+20% = 80 гигабайт. 20% я грубо накидываю, можно вычислять точнее, но для прикидки сойдёт.
Две карты по 16 могут работать вместе, современные фреймворки так умеют, то есть совокупно у нас всего 32 гигабайта. То есть модель не умещается?
Полная модель не уместится, но есть квантованные версии. Дело в том, что модели хранят свои параметры в виде чисел с плавающей точкой. Чем точнее мы храним эти числа, тем лучше работает модель (в своих пределах, конечно). Если памяти у нас мало, хорошее решение — снизить точность. Модель от этого «поглупеет», но это может оказаться некритично.
Мы выбрали квантование в 4 бита, то есть по половинке байта на модель. Таким образом, потребуется 30×0,5+20% = 18 гигабайт.
Большую группу пользователей эти видеокарты не вывезут —

Ещё немного про Nvidia H100 NVL
Надо бы записать ещё немного фактов про Nvidia H100 NVL, которую мы недавно запускали. А то забудется, а в интернете очень мало описано опыта людьми, которые делали
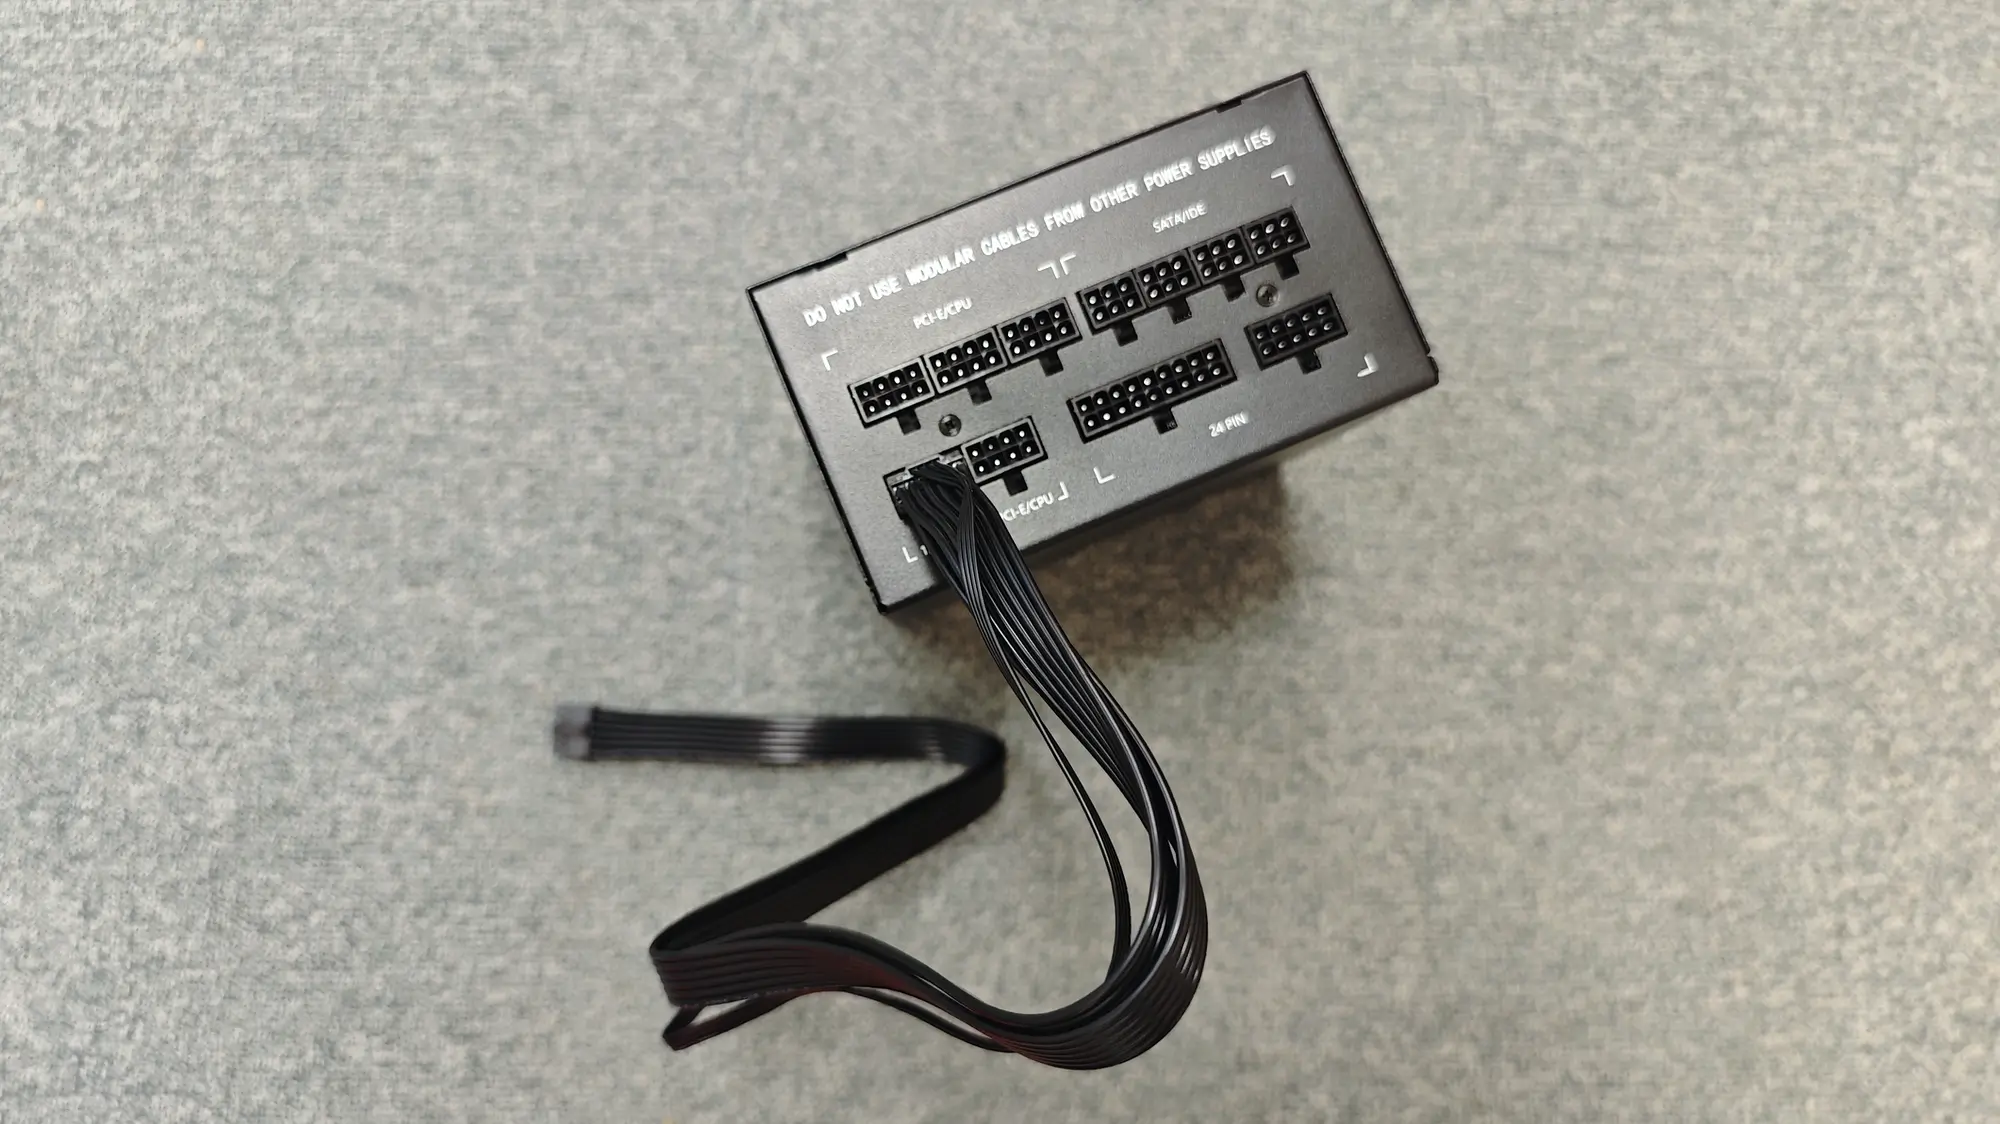
Сначала мы запустили её в менее производительном режиме, так было быстрее — переходник я просто купил на «Авито» за наличку и забрал в течение часа. Позже мы получили блок питания, у которого есть специальный разъём для мощных видеокарт, с которого можно снять до 600 Ватт включительно.
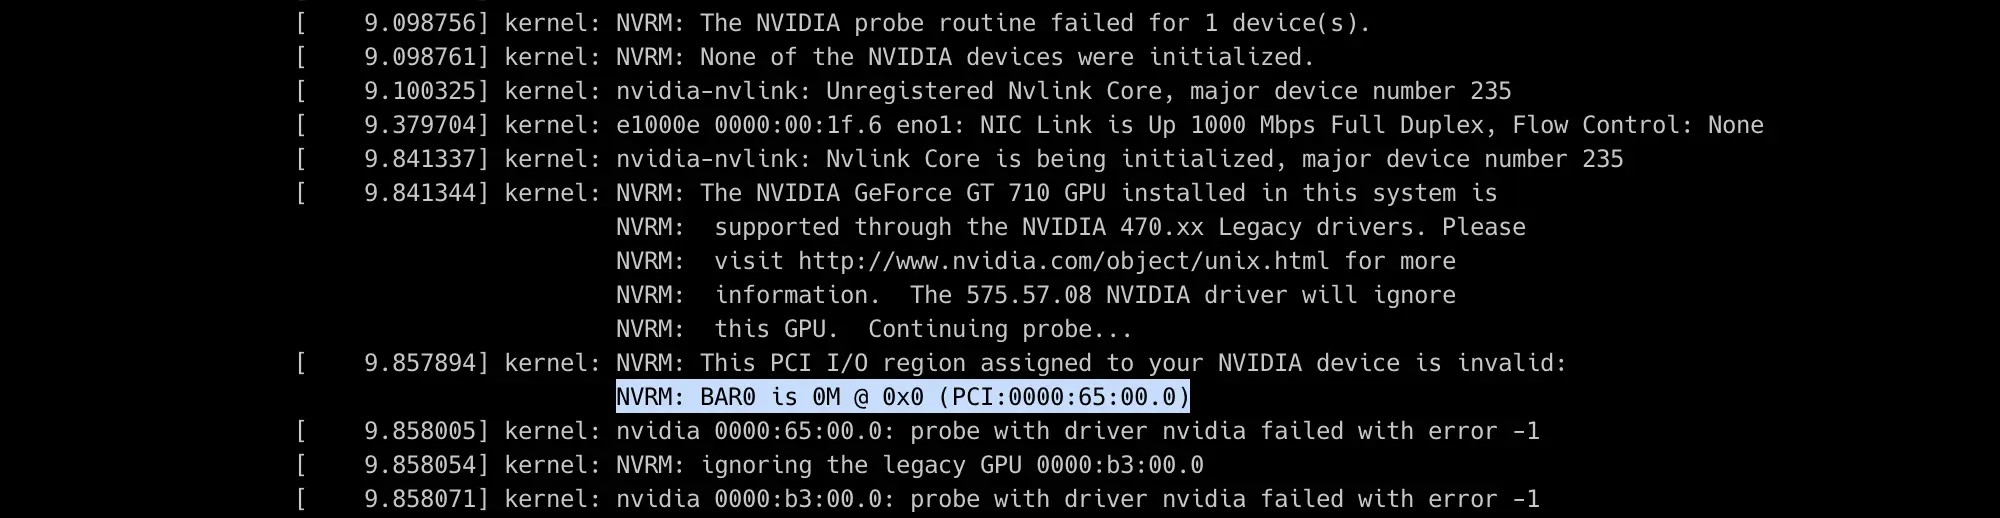
И, наконец,
Если это так, включите в БИОСе опцию RBAR (ReBAR, Resizeable BAR), а в параметры ядра добавьте опцию pci=realloc (последнее, возможно, не обязательно, но утверждать не берусь).
Китайская Nvidia A100
У одного из клиентов в качестве оборудования для запуска нейросетевых моделей обнаружилось
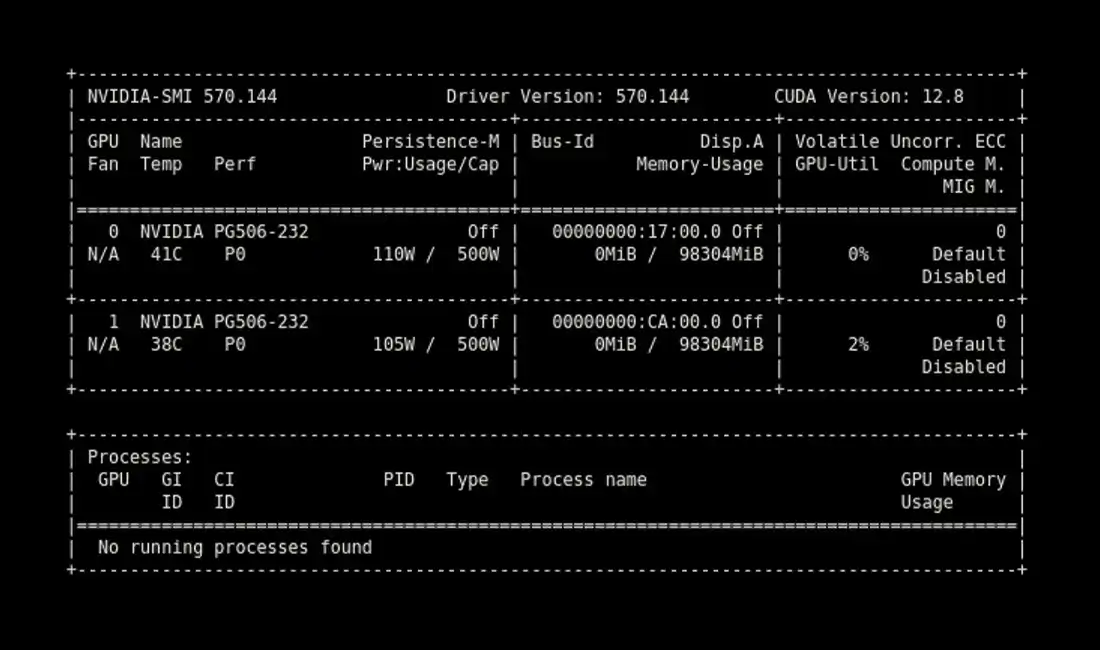
Я только вчера
Оказывается под «улучшать» понимается наращивание памяти и разблокировка дополнительных ядер. При этом, чтобы всё это можно было использовать, на видеокарту заливается взломанная прошивка.
Вот, кстати, непонятно — ядра заблокированы потому что они неисправны или это маркетинговый ход. Если первое, значит они могут работать с ошибками, а как их диагностировать и на чём это скажется — ума не приложу.
Добавлено позднее: в комментариях в канале справедливо заметили, что может быть и то и другое. Раньше так тоже делали — в процессоре делали дополнительные ядра, тестировали и, даже если все ядра были исправными, всё равно выключали часть, чтобы выпускать процессоры в рамках одной линейки.
Питание для Nvidia Tesla H100 NVL
Хочу записать себе новые знания.
Видеокарта Nvidia Tesla H100, про которую я вчера писал, вставляется в шину PCIe пятого поколения. Оттуда она может получить максимум 75 Ватт, тогда как карте надо больше. Она может работать, согласно спецификации, в одном из двух режимов — с потреблением 310 или 400 Ватт в пике.
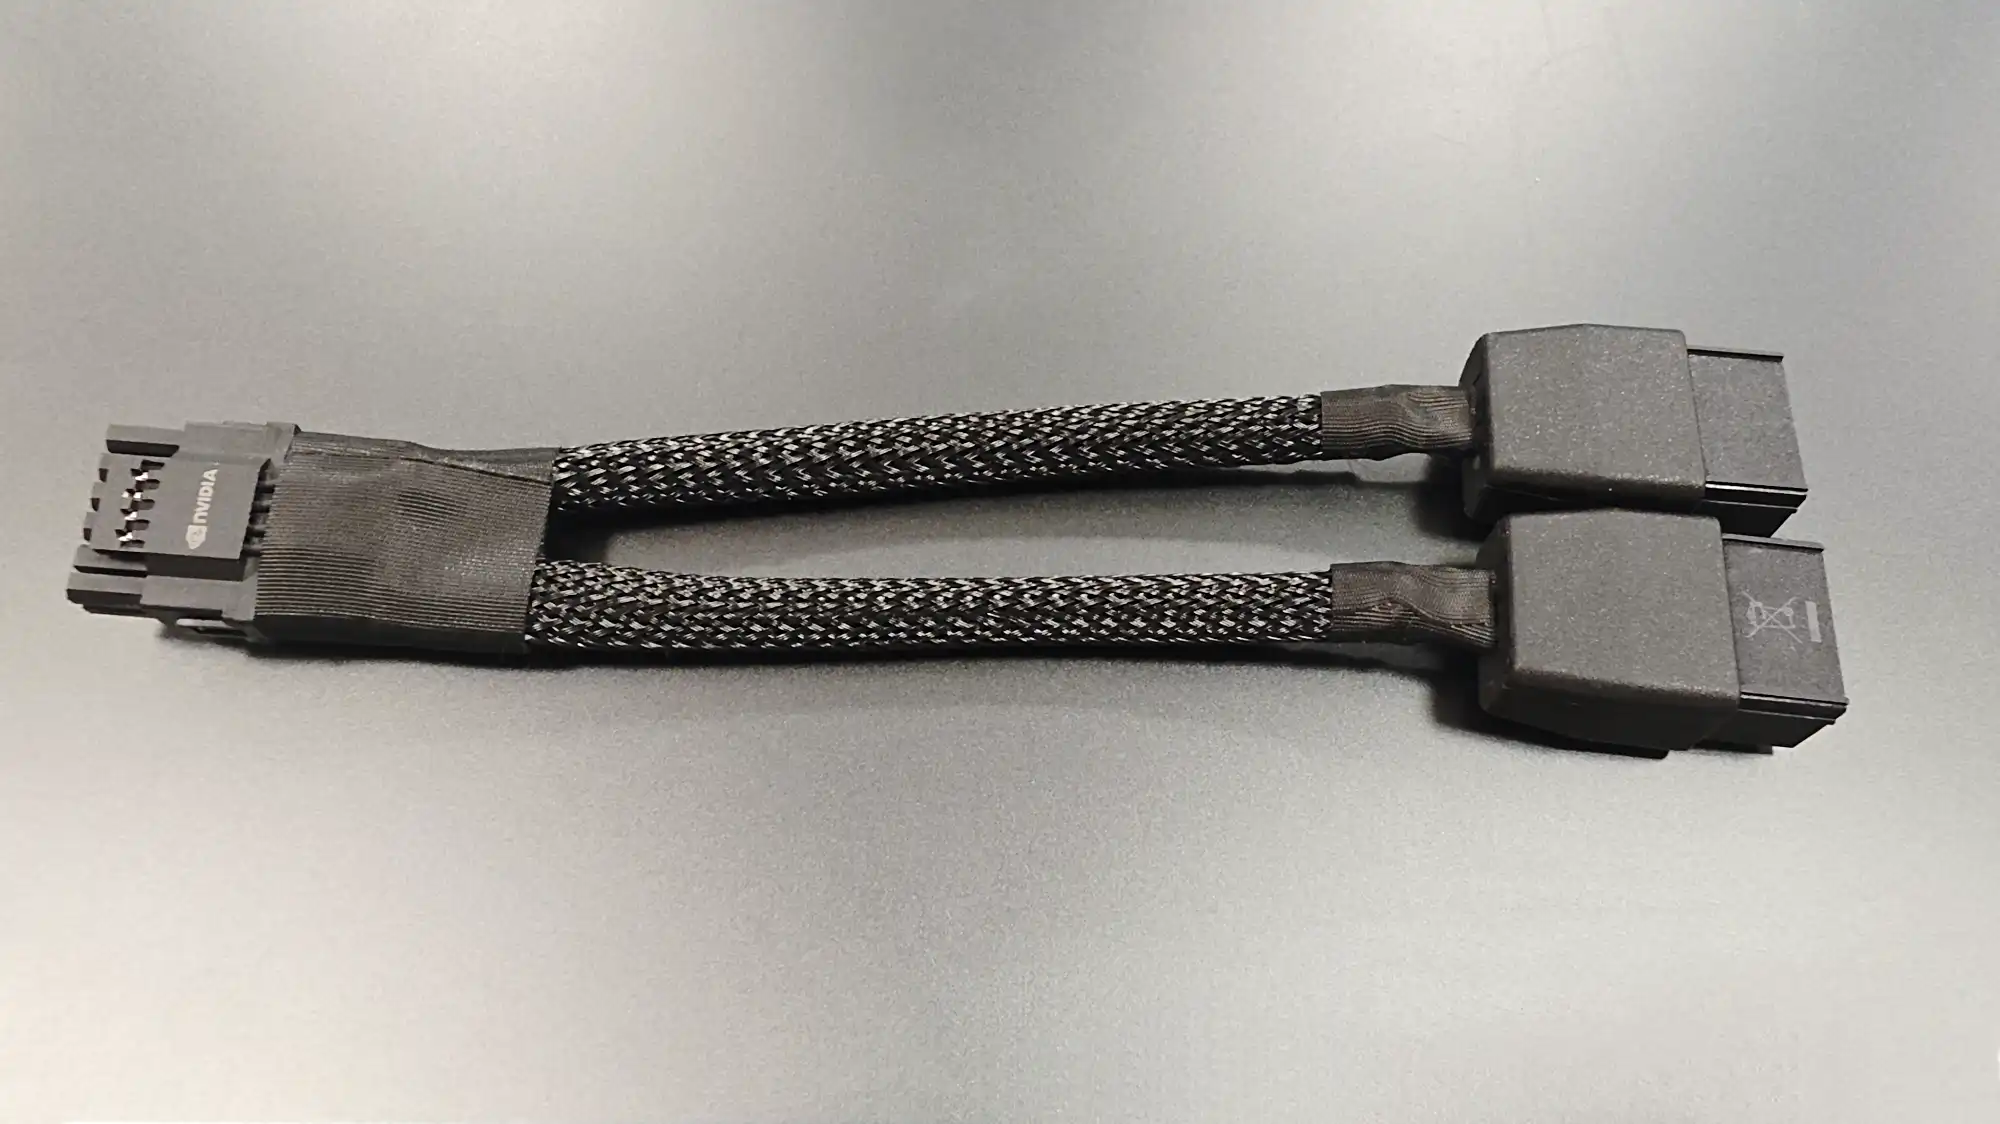
Для этого используется вот такой кабель. Ток, который он может подвести от разъёма материнской платы, ограничен сечением проводов внутри кабеля. Оно может различаться в зависимости от производителя. Но как карта узнаёт сколько мощности ей можно получить, чтобы не пережечь кабель?
Оказывается, для этого используется специальный интерфейс, четыре контакта которого видно слева.
Два провода из четырёх кодируют ток, который может отдавать кабель, остальные два сейчас не используются. Сигналы 0 и 1 на этих проводах означают мощность от 151 до 300 Ватт, 1 и 0 — от 301 до 450.
Бывают токи и выше, кодировка для них тоже предусмотрена, для этого используются провода с большим количеством «хвостов» — три или четыре.
Nvidia Tesla H100 NVL
Вот так выглядит видеокарта Nvidia Tesla H100 NVL — одна из трёх карт, на которых мы гоняем различные модели искусственного интеллекта. Сбоку видно, что она большая, но и толщина у неё огого — в два пальца. Извините, что не достал, страшно доставать карту стоимостью в несколько миллионов из антистатического пакетика — вдруг статикой убъёшь.
На этой карте мы гоняем небольшие пока модели — примерно 30—32 миллиарда параметров (Qwen3, Magistral, Mistral,
К слову, взаимодействие с хвалёной моделью

Очеловечивание ИИ
Мне кажется, одна из проблем во взаимодействии с большими языковыми моделями, проистекает из того, что мы, для описания работы с ними, пытаемся подобрать слова точные только в литературном смысле — «модель считает», «модель посоветовала» и так далее.
Потом люди несут это дальше, думая, что эти глаголы адекватно описывают процессы, тогда как модель ничего не считает и не советует, она текст генерирует.
Отсюда возникает непонимание почему модель не может посчитать количество букв в слове, решить переформулированную задачу на логику или ответить на мой вопрос с задержкой в тридцать секунд, если я это попросил.
ИИ в дипломах

Всё забываю рассказать.
Я уже пятый год в составе комиссии принимаю дипломные работы в ИВМиИТе — это институт внутри Казанского Федерального Университета. Таким образом наша компания пытается отобрать себе способных студентов на работу.
В этом году произошло
Пока секретарь ходил выяснять как нам быть, — оказалось, что он тоже не в курсе, я погонял студента вопросами по тексту диплома. Очень похоже, что и всё остальное ему генерировала нейросеть — например,
Секретарь вернулся с ответом от директора института. Тот сказал, что использование ИИ при написании диплома не только не запрещено, но и, пожалуй, даже хорошо — новые технологии надо осваивать.
В итоге, мы поставили ему тройку. Не за беззастенчивое использование ИИ, а за плохое знание своей собственной дипломной работы.
Недокументированные возможности bc
У той версии утилиты bc, которая является частью проекта GNU, есть ряд недокументированных возможностей, про которые я узнал, исследуя её исходный код.
Я уже писал про недокументированную и сломанную функцию random(), которая починена в новой версии моими усилиями. Но кроме этого, есть ещё две вещи отсутствующие в документации.
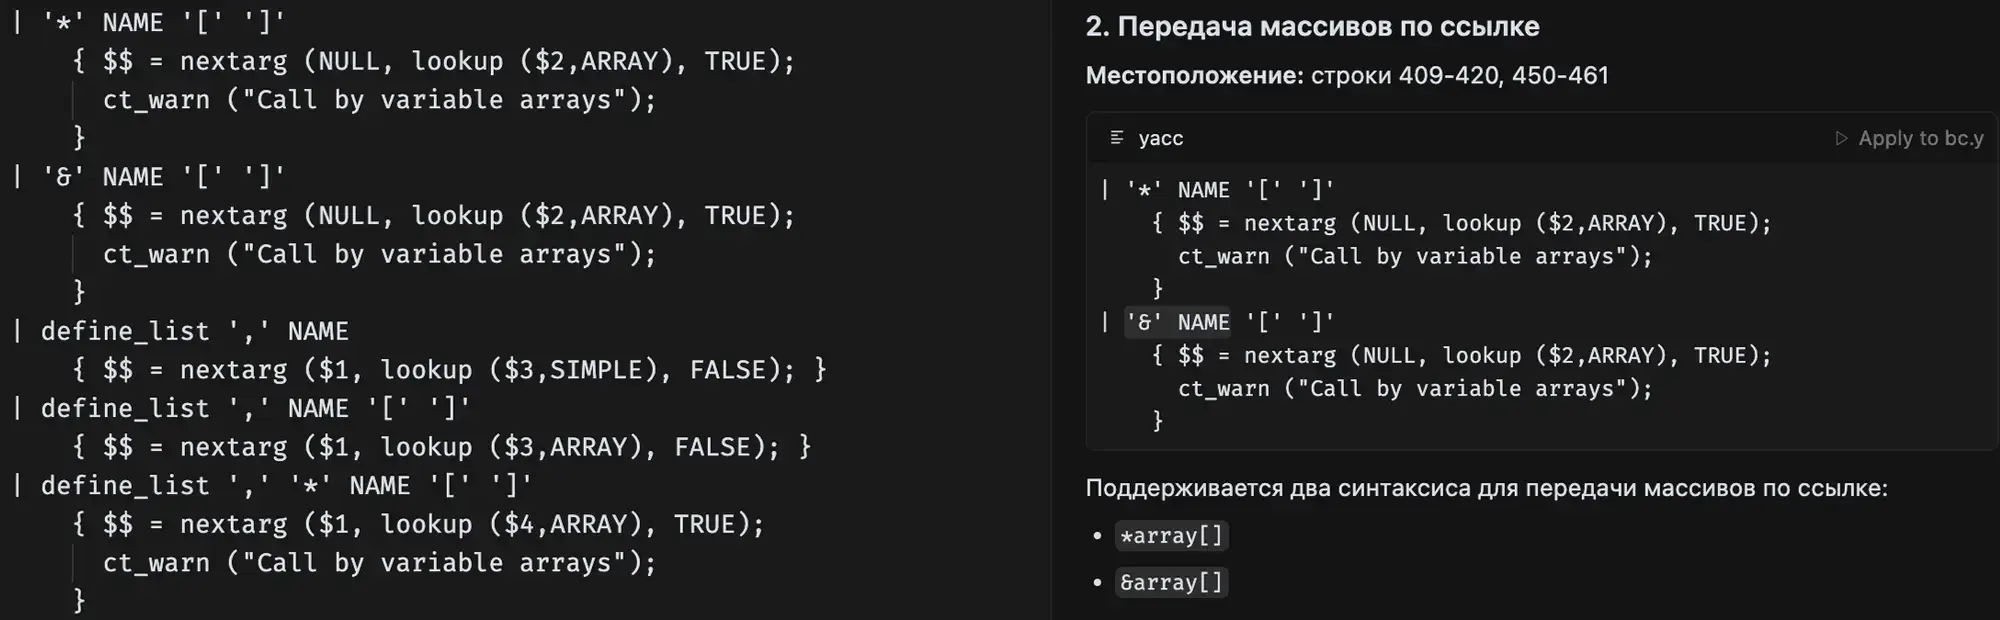
Но это я сам нашёл, руками. Стало интересно посмотреть, что могут найти языковые модели. Для исследования я выбрал редактор кода «Курсор» и модель Claude Sonnet 4.
С первого захода «Клод» нашёл много всего, но бо́льшая часть — вполне обычные возможности, присутствующие в документации. Засучил рукава, порылся в найденном. Кроме мусора там нашлось и полезное — ключ и функцию random() он нашёл, но про символ & не упомянул.
Пришлось подтолкнуть — поместить в контекст нужный файл (bc.y) и спросить нет
С минимальным участием человека нашлись все недокументированные возможности о которых я знаю — три из трёх, правда эти жемчужины пришлось искать вручную в кучке навоза.
Какой вывод?
Я считаю, что это, в определённом смысле, успех — «Клод» помог мне вычленить искомое гораздо быстрее, чем в своё время это сделал я. Да, без моей подсказки третью возможность он не нашёл, но и задача очень и очень нетривиальная.
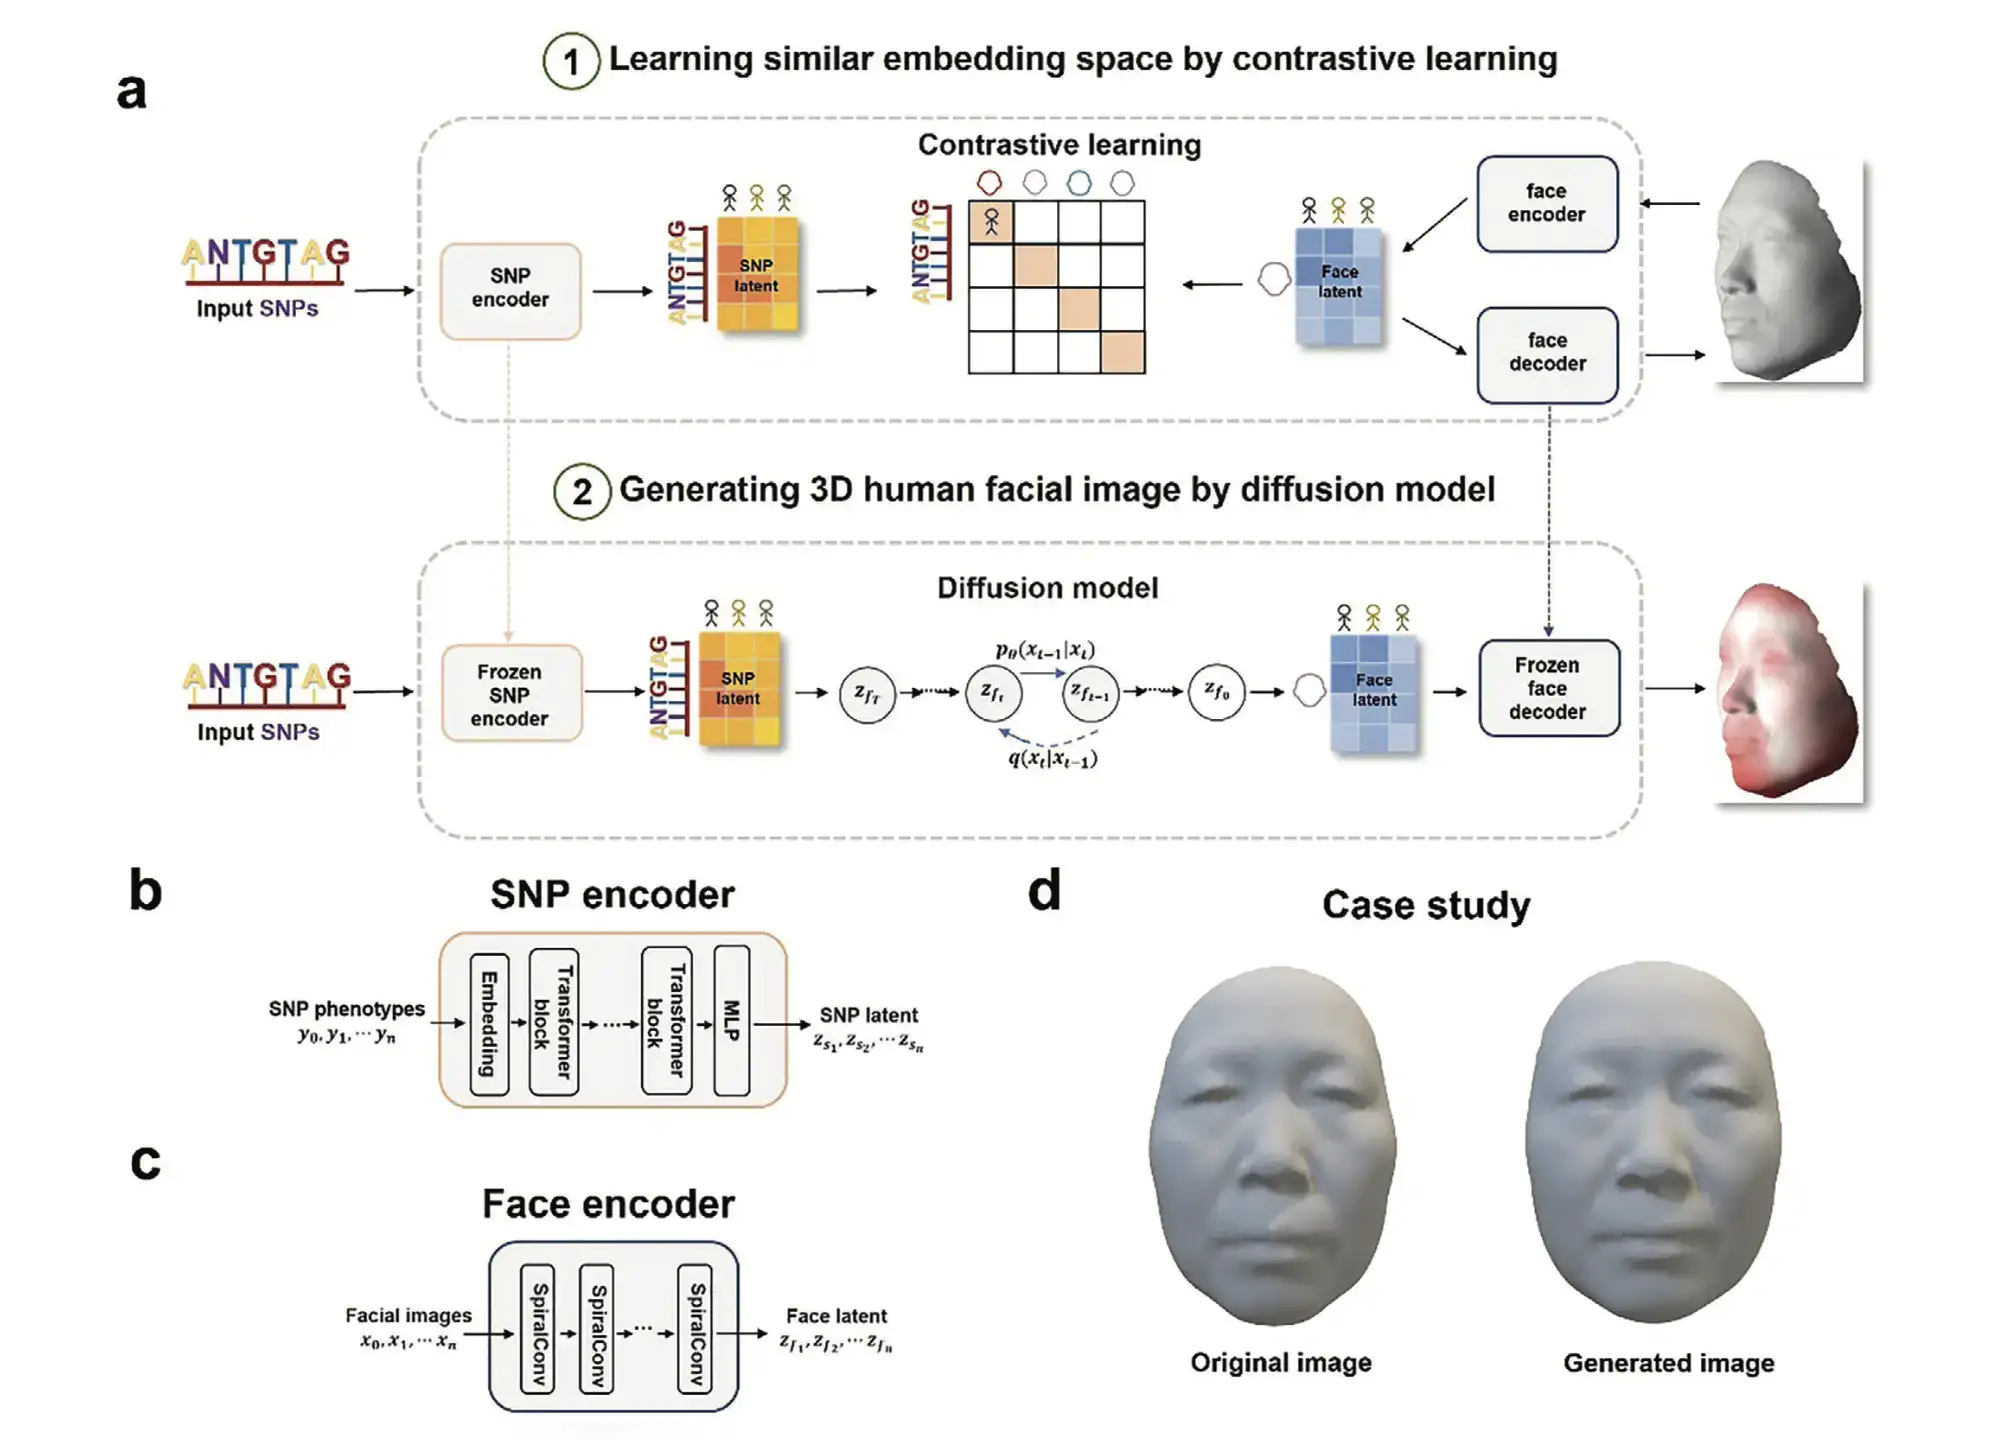
ДНК-портрет китайца
Пять лет назад я мечтал о том, что
Утверждается, что теперь у нас есть ответ. Эксперименты идут давно, но недавно результат улучшили ещё на 12% и достигли совершенно былинных результатов.
Китайцы представили модель, которая умеет генерировать трёхмерное изображение лица по ДНК с погрешностью в 3,5 миллиметра. Причём она умеет генерировать лицо в любом возрасте, что ещё более полезно. Лица, конечно, китайские, но вряд ли сложно перенести тот же опыт на другие типажи.
Платная нейросеть ChatGPT
Решил попробовал оплатить ЧатГПТ на месяц (стоит 20 долларов). Интересно было какие плюсы это даёт. «На берегу», до решения, казалось, что это эксперимент на раз — попробую для успокоения любопытства и забуду. Но я ошибался. Самой убойной фишкой оказалось «глубокое исследование» — нейросеть за десятки минут гуглит информацию, относящуюся к запросу, а в конце составляет отчёт.
Я для теста задал найти мне информацию о «штурвале Бауэра», через полчаса у меня был отчёт, занявший несколько экранов. Я бы взял из него лишь малую часть, но удобно, что такое можно
Сам я
Да и с более прозаичными вещами эта фишка справляется отлично — например, я заказал ей найти мне переключатель дешевле 15 тысяч, чтобы подключать два разных компьютера к одной клавиатуре и мыши и двум мониторам. Он нашёл мне две модели, одна из них продаётся на «Озоне». То, что нужно!
В общем, чувствую, это будет лучшее моё вложение двадцати долларов за последнее время!