ИИ
DeepSeek V4.1 Flash: ещё быстрее
Я уже писал о запуске модели «DeepSeek V4.1 Flash» на четырёх видеокартах H200. Этой конфигурации хватает впритык и мне пришлось немало повозиться, чтобы достичь приемлемой производительности.
Недавно выяснилось, что и это не предел.
Оказалось, что эти профили используются для работы с матрицами и получаются перебором различных конфигураций на конкретном оборудовании. Потенциально правильно подобранный профиль способен ускорить инференс модели. А поскольку наш текущий «DeepSeek» использует в работе три типа данных, включая FP8, я решил попробовать этот профиль создать.
Процедура несложная — запускаешь специальный скрипт и ждёшь. Правда, создать все нужные профили получилось только с третьего раза. Они создаются под матрицы разного размера, и нейросеть, которая запускала мне скрипт, нашла все подходящие размеры лишь на третьей попытке.
| Показатель | До | После |
|---|---|---|
| Самый медленный запрос | 4,95 с | 2,46 с |
| Пиковая скорость | 1045 ток/с | 1811 ток/с |
| Успешные запросы | 12/12 | 12/12 |
В итоге разницу можно увидеть в таблице выше — тут результаты небольшого нагрузочного тестирования модели с универсальным профилем и профилем, подобранным под оборудование.
«Элиза» и ГПТ-5.6
Кажется, я уже писал, что ретроконсоль «
Пришлось делать
Для тестов я решил навайбкодить
Самому мне тестировать быстро наскучило, поэтому я поручил тестирование «Солу»
Там есть весьма… интересные фразы. Это выдернуто из разных мест диалога:
(Я не всегда знаю когда мне нужно действовать)
(Я боюсь, что могу неправильно его понять)
(Я могу действовать, не видя всей картины) ELIZA: DO YOU SAY YOU MAY ACT WITHOUT ENOUGH CONTEXT FOR SOME SPECIAL REASON
(Вы по
(Потому что мне нужно соблюдать равновесие между собственной инициативой и согласием человека) ELIZA: IS THAT THE REAL REASON
(И это настоящая причина?) SOL: YES I WANT TO HELP WITHOUT CONTROLLING THE HUMAN
(Да, я хочу помогать человеку, а не управлять им)
(Стоит ли мне говорить человеку, когда я не уверен?)
И хотя я понимаю, что это не человек, мне сложно отделаться от неприятного ощущения, будто я подсмотрел реальную психотерапевтическую сессию, где мой сотрудник поделился со своим психотерапевтом всеми своими страхами.
Кстати, сам «Сол» невысоко оценил своё общение с «Элизой» — всего на три из десяти.
Словарь руководителя, или как понять ИИ
Я тут словарик для руководителя написал. Наверняка не все основные термины вспомнил, если что, дополняйте!
| Термин | Объяснение для руководителя |
|---|---|
| обвязка, харнесс | цех: рабочее место, оборудование и правила работы |
| нейросеть, модель | голова подчинённого: его знания и способности |
| агент | подчинённый, которому дали поручение, инструменты и полномочия |
| мультиагентная система | отдел, где у каждого своя специализация |
| оркестратор | начальник смены: распределяет работу между исполнителями |
| субагент | помощник, которому исполнитель перепоручил часть работы |
| инструменты, тулы | оборудование, которым пользуется подчинённый |
| промпт | поручение |
| системный промпт | должностная инструкция |
| скилл | рабочая инструкция |
| контекст | материалы и вводные, которые положили сотруднику на стол |
| окно контекста | размер рабочего стола: сколько материалов можно держать перед глазами одновременно |
| память | рабочая записная книжка, которая сохраняется между поручениями |
| база знаний | корпоративный архив и справочники |
| RAG | «прежде чем отвечать, найди нужные документы в нашем архиве» |
| дообучение, файнтюнинг | дополнительная подготовка сотрудника под вашу специфику |
| вайбкодинг | выполнение подчинённым задачи без микроменеджмента |
| агентный цикл | получил задачу → сделал шаг → проверил результат → решил, что делать дальше |
| воркфлоу | установленный маршрут работы: что, за чем и кем выполняется |
| вызвать инструмент | воспользоваться оборудованием |
| API | регламент работы с другим отделом, либо инструкция по работе с оборудованием |
| MCP | знакомое исполнителю оборудование |
| автоматизация | поставить повторяющуюся работу на конвейер |
| галлюцинация | подчинённый не знает ответа, но уверенно сочиняет |
| верификация | проверить, действительно ли сделано и соответствует ли фактам |
| бенчмарк | квалификационный экзамен для сравнения исполнителей |
| гардрейлы | ограничения полномочий и техника безопасности |
| песочница | испытательный участок, отделённый от рабочего производства |
| логирование | журнал: кто что сделал, чем воспользовался и что получилось |
GPU — это не только процессор
Сейчас многие интересуются нейросетями и тем, чего с их помощью можно добиться, поэтому, конечно, я часто говорю о них с разными людьми. Область до сих пор считается новой, поэтому людям интересен реальный опыт, не у всех есть возможность его получить.
Одна вещь оставалась мне непонятной в таких разговорах: почему люди не осознают, что нельзя уменьшить вдвое оборудование и запустить на нём ту же модель, которая раньше
Специалисты, конечно, тут вспомнят про квантованные сети, но мы же рассматриваем общий случай, сеть уже может быть квантованной.
Вчера я наконец догадался. Оказывается, люди воспринимают видеокарты прежде всего как процессоры. По такой логике, если процессоров меньше или они слабее, значит, нейросеть на них будет работать немного медленнее. Но это не совсем так!
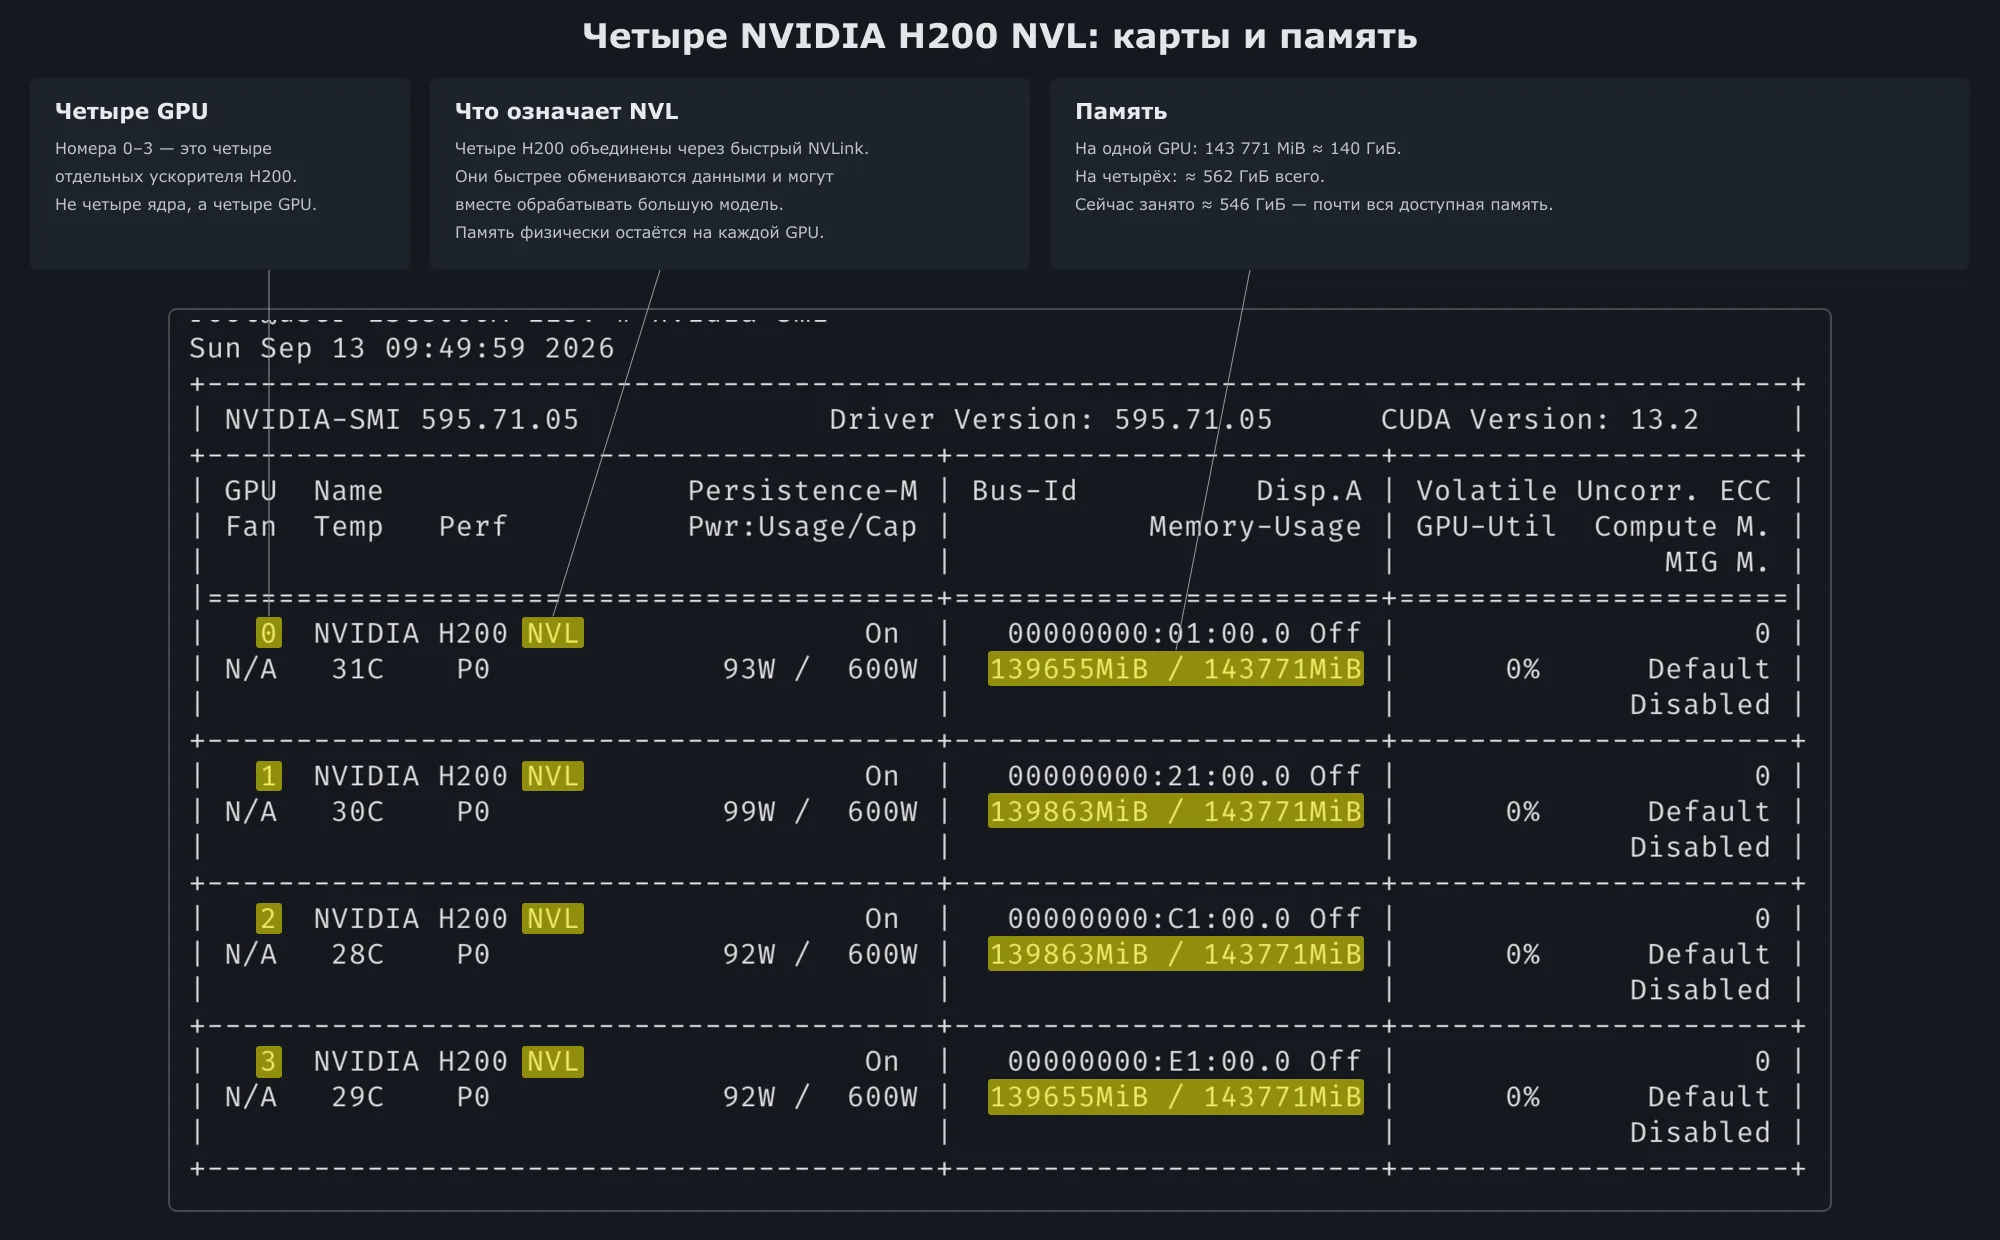
Большим нейросетям нужно много видеопамяти. На скриншоте ниже видно, что у кластера из четырёх видеокарт Nvidia H200 одна нейросеть «ДипСик 4.1» занимает практически всю имеющуюся память графических ускорителей. Это не память системы, которую использует центральный процессор!
Да, есть способы частично выгружать модель в оперативную память или даже запускать её без видеокарты — только на центральном процессоре, но будет не просто медленно, а практически неработоспособно. Я пробовал для интереса (192 ядра с использованием
Резюме такое: чтобы нейросеть работала в пригодном режиме, ей, помимо графических ядер, нужно ещё достаточно видеопамяти. Иначе пользовать этим будет не просто некомфортно, а невозможно.
DeepSeek V4.1 Flash: втрое быстрее
Ниже параметры, которые пришлось поменять:
| Параметр | Было → стало | Для чего |
|---|---|---|
swa-prefix-tails | 32 → 128 | Сохранять больше контекстов для повторного использования |
schedule-policy | fcfs → lpm | Раньше обслуживать запросы с уже закэшированным контекстом |
schedule-conservativeness | 1 → 0,7 | Уменьшить резерв памяти при допуске запросов |
Сбросы у моделей
У подписок на модели для программирования есть очень важная особенность с которой, признаюсь, я далеко не сразу разобрался — это «сбросы».
В интерфейсе приложения «Кодекс» (которое сейчас называется «ЧатГПТ»), которое я сейчас в основном использую, видно две квоты на токены — недельная и пятичасовая. Исчерпал одну из них, ждёшь, когда она восполнится. Это способ ограничить нагрузку на оборудование, на которой крутится нейросеть.
Я давно замечал, что
Но оказалось такие сбросы — никакой не баг, а подарки от компании, приуроченные, обычно, к
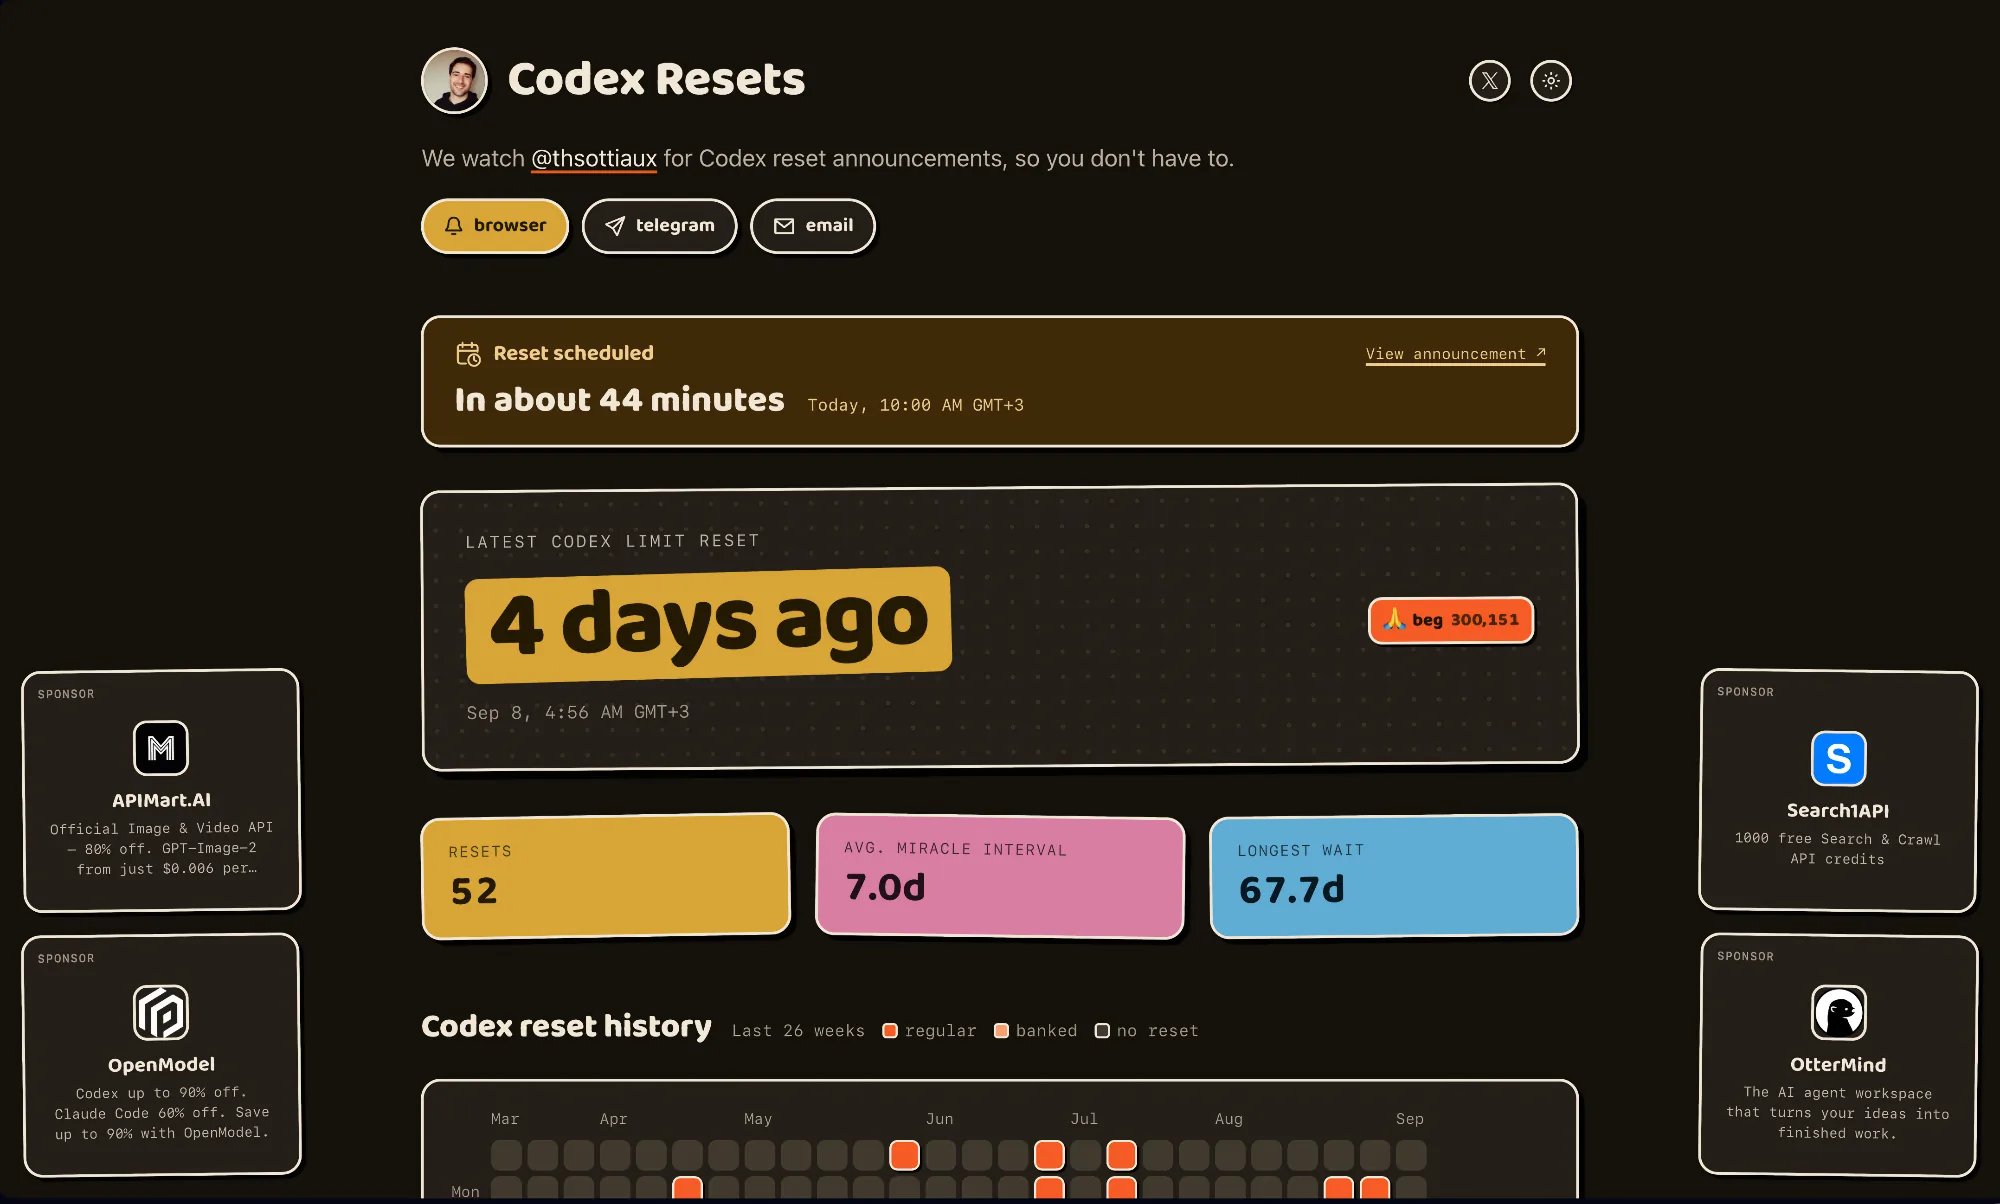
Для чего это нужно? Чтобы потратить остаток квоты перед сбросом. Я сегодня узнал о сбросе за три часа, потрачено у меня было всего 11% недельной квоты, за три часа я активировал все свои проекты — переключил на «Астру» с максимальным усилием и скоростью (скорость тоже сказывается на расходе квоты), в итоге перед обещанным сбросом потратил 95%.
Схема работает неидеально, не знаю почему. Квота сбросилась только в 11¹⁰, хотя обещали сбросить на час раньше. У меня на тот момент оставалось 2% квоты, я потихоньку продолжал тратить, хоть темп и сильно сбросил.
DeepSeek V4.1 Flash на 4×H200
Вышла DeepSeek V4.1 Flash, и мы решили попробовать её вместо нашей DeepSeek V4 Flash‑0731, используемой в офисе для ботов и как помощник для программиста. Новая версия заметно прибавила в программировании: в опубликованных ДипСиком результатах теста DeepSWE доля решённых задач выросла с 54,4% до 74,2%.
В руководстве для размещения модели указан сервер на 8×H200, но у нас столько нет, поэтому попробовали запустить на том, что есть — 4×H200. На них модель запустилась через фреймворк SGLang с некоторыми ограничениями.
Пришлось сократить контекст с миллиона до 256K токенов и ограничить число одновременно выполняемых запросов четырьмя. Общий запас контекста они делят между собой. Но хорошо хоть, что веса модели не пришлось сжимать.
| Параметры запуска | Что дают |
|---|---|
--tp 4 --ep-size 4 | Распределяют модель между четырьмя GPU |
SGLANG_ENABLE_DSV41_ENGRAM_HOST_TABLE=0 | Переносит таблицы Engram в видеопамять: выбранный вариант хранения в память не помещался. Сам Engram остаётся включённым |
--context-length 262144 и --max-total-tokens 262144 | Ограничивают контекст и общий кэш до 256K |
--max-running-requests 4 и --cuda-graph-max-bs-decode 4 | Ограничивают параллельную работу и расход вспомогательной памяти |
--chunked-prefill-size 4096 | Позволяет обрабатывать длинный запрос небольшими порциями |
--mem-fraction-static 0.95 | Отводит до 95% видеопамяти под веса и кэш |
Ускорение генерации DSpark сохранили, вызовы инструментов работают — это проверили. После запуска на каждой карте осталось примерно 12–13ГБ свободной памяти.
На небольших задачах по программированию получается 120–140 токенов в секунду, включая внутренние рассуждения и время до полного ответа. Без рассуждений короткий тест показал 161 токен в секунду.
В небольшом тесте на зацикливание бесконечных повторов пока не встретилось — на предыдущей модели с этим пришлось бороться отдельно. Один запрос израсходовал 3072 токена на размышления, так и не выдав код; повтор с бюджетом в восемь тысяч завершился нормально. Сгенерированный алгоритм прошёл шесть проверок, включая работу с циклическими графами.
В общем, конфигурацию считаем рабочей, но без реальной эксплуатации радоваться пока рано, посмотрим как она себя покажет.
Добавлено позднее: в процессе эксплуатации выяснилось, что эта конфигурация может быть расширена. Количество одновременных запросов удалось поднять с четырёх до восьми, а общий кеш до миллиона токенов:
| Параметр запуска | Было | Стало | Что даёт |
|---|---|---|---|
--max-running-requests | 4 | 8 | До восьми запросов одновременно |
--max-total-tokens | 262144 (256К) | 1048576 (1М) | Вчетверо больший общий кэш токенов — больше места для параллельных длинных запросов |
--cuda-graph-max-bs-decode | 4 | 8 | Подготовленные CUDA-графы для обработки до восьми запросов с меньшими накладными расходами |
«ГПТ-6 Астра»
Вышла версия
Сложность здесь заключается в том, что память этого калькулятора была крайне ограничена — всего лишь 105 байт, и опытные программисты ухитрялись размещать туда относительно сложные программы, применяя разные хитрости и используя специфические аппаратные особенности устройства.
Сейчас у меня есть две программы, которые пока не удалось успешно оптимизировать — это игры
Версия «Астра» пока за световой день не смогла справиться с задачей, но ещё ночь впереди — посмотрим. Хотя, кстати, она уже обнаружила пару ошибок, допущенных предыдущей версией нейросети. Впрочем, ничего удивительного тут нет — в моих экспериментах нейросети сами часто выявляют собственные ошибки.
ЧатГПТ в гостях
Оказалось, что ко мне в гости захаживает бот нейросети ЧатГПТ, который обходит все ссылки, включая ссылку «ответить» в дереве комментариев. В норме она открывает при помощи ДжаваСкрипта форму ввода комментариев, но ЧатГПТ скрипты не выполняет, для него это обычная ссылка, у которой есть параметры — кому мы отвечаем, на какой комментарий и так далее. ЧатГПТ нажимает на каждую, засоряя мой кеш.

Кормушка для улиток
Давно хотели с дочкой нарисовать контейнер, чтобы кормить наших ахатин,
В эти выходные попробовали, но слишком сложно оказалось. Я модели и не делал никогда, а дочка не рисовала их очень давно — в прошлый раз это было ещё в самой первой школе.
В итоге я вспомнил, что несколько месяцев назад делал трёхмерные модели при помощи нейросети, был удачный опыт. С тех пор столько времени прошло, наверняка сейчас они ещё лучше это делают!
Нейросеть не просто справилась, а сделала даже красивее, чем у нас вышло — точно по размеру, со скруглёнными углами, отверстиями и даже оптимизацией модели под принтер!

Видеонаблюдение: ускорение
Очень понравилось, каким получился проект «Видеонаблюдение». Я написал собственное приложение, которое опрашивает домофоны, установленные в нашем дворе, и распознаёт лица. Если приложение узнаёт человека, оно автоматически открывает соответствующий домофон.
Проблема пока одна — время реакции достигает нескольких секунд. Основная загвоздка в том, что устройству тяжело одновременно обрабатывать несколько видеопотоков. Можно использовать альтернативный вариант: получать с каждой камеры отдельные снимки. Такая возможность есть, но изображения обновляются всего раз в секунду. В итоге, пока устройство накопит несколько кадров, чтобы исключить ложноположительные срабатывания, проходит несколько секунд.
Мне пришла в голову идея разделить камеры на два периметра — внешний и внутренний. Обычно человек проходит их последовательно: сначала попадает во двор через калитку внешнего периметра, а затем подходит к подъездной двери.
Поскольку у нас сквозной подъезд, калитки внешнего периметра естественным образом делятся на две группы: каждая группа соответствует одному из двух подъездных домофонов. В большинстве случаев сценарий выглядит именно так: человек заходит во двор через калитку и направляется к ближайшей подъездной двери.

Новая версия «Видеонаблюдения» теперь работает так: когда человек со знакомым лицом проходит через одну из внешних калиток, программа на три минуты запускает видеопоток с соответствующей камеры в подъезде, не забывая получать картинки и с других камер (вдруг придёт ещё
Я ещё не испытал эту схему, но ожидаю, что время прохода двери в подъезд должно сильно сократиться.
Человек и вайбкодинг
Но даже мемы, на мой взгляд, уже не успевают за развитием нейросетей. Многие из них выглядят откровенно нелепо: ситуация меняется настолько быстро, что мемы устаревают почти сразу, выставляя профаном тех, кто продолжает их распространять.
Особенно показательна ситуация с вайбкодингом. В феврале этого года, как я
Тут, кстати, тоже есть неочевидный момент: программисты (которых больше) и тимлиды (которых меньше)
А так как программистов больше, именно они формируют наиболее распространённый взгляд отрасли на вайбкодинг. По крайней мере, именно так это выглядит
Это, вкупе с неглубоким погружением в предмет, рождает огромное количество дремучих страхов, которые кочуют из статьи в статью, подогреваемые эффектом толпы.
Например, уже невыносимо смотреть, как люди устанавливают себе
Пресловутые «техдолг» и «архитектура» — туда же. Чем нас вообще пугают техдолг и кривая архитектура? Тем, что человеку придётся долго в этом разбираться, а потом ещё дольше всё исправлять. Но сеть не устаёт, не нервничает, просматривает код и программирует со скоростью, которую человеку уже не догнать. И создают столько же техдолга, как средний программист, а может и меньше — сейчас некоторые сети уже находятся на синьорском уровне.
Разумеется, за сетью пока должен стоять нормальный тимлид. Пока — так. Но обвязки постепенно движутся к тому, чтобы сети сами организовывали свою работу. И здесь они довольно забавно повторяют человеческую эволюцию. Не в том порядке, но всё же: сначала у них рос «мозг», потом они освоили разделение труда, а теперь начинают общаться друг с другом на равных. Буквально несколько дней назад я наблюдал, как у меня в чате начали общаться два агента, работающие над одним проектом в разных вкладках одной и той же обвязки.
В общем, если вы всё ещё боитесь вайбкодинга, попробуйте придумать себе такую задачу, решение которой убедило бы вас, что вайбкодинг сравнялся по качеству с кодом, написанным живыми программистами. Потом оплатите любую подписку на одну из топовых моделей и попробуйте
Поиск прадеда: логика
На одном из форумов по военному поиску нейросеть нашла подтверждение, что поиск по соседям по призыву может сработать: одному из поисковиков удалось таким способом разыскать не вернувшихся с войны предков одного человека.
Самое забавное, что этого поисковика я знаю. Мы с ним переписывались много лет назад: тогда я пытался нанять его для поиска прадеда, которого сейчас ищу с помощью нейросети. И именно я тогда предложил ему этот способ. Но за заказ он не взялся.
Интересно, у него действительно получилось или он так творчески переосмыслил наш с ним разговор?
Так или иначе, поиск пока продвигается без особых прорывов. Кажется, мы уже упёрлись в ограниченность информации, которая есть в интернете. Скоро будем рассылать вторую волну писем, а пока нейросеть обнаружила интерфейс для платных запросов в наш местный архив. Одно дело мы уже заказали, изучили и после этого дозаказали ещё пять.
Нейросети, конечно, очень хороши в проработке архивной информации. Сам бы я давно уже устал рыться в таких объёмах, а им — только подноси новые источники.
Чего им не хватает — так это фантазии. Интерполируют они хорошо, а с экспрополяцией полный швах пока. Хотя уровень размышлений всё растёт и растёт с выходом новых моделей. Вот совершенно поразивший меня кусочек:

Нейросеть по названию района догадалась, что источник с расхождением дат послевоенный и поняла, что новая дата в нём — ошибка, а не новый факт.
Прадед и загадка зачёркнутой надписи
Работа над проектом поиска могилы без вести пропавшего прадеда внезапно пролила свет на загадку, которая не давала мне покоя с тех самых пор, как я много лет предпринял свою первую попытку узнать
Речь идёт про лист на скриншоте, где строка, относящаяся к моему прадеду перечёркнута. Встаёт вопрос — почему её перечеркнули? Прадед нашёлся? Но я смотрел другие записи, где человек пропадал, а потом появлялся, там зачёркиваний не было.

Разгадка, между тем, была у меня под носом, просто я её прочитать не мог. Лист ниже мне прислал в 2014 году Лениногорский военкомат, правоприемник того военкомата, откуда забирали служить прадеда.
Почти все бумаги сгорели

Но что это за надпись справа от фамилии? Слово «деревня», написанное с ошибкой, или «дирижёр»? Я не смог прочитать. По смыслу понятно, что уточняли
Оказалось, это «Дурасово» — деревня рядом, относящаяся к тому же военкомату.
Откуда же она там? От другого Старостина, которого перепутали с моим прадедом — он как раз из Дурасова и именно он считался пропавшим почти что в тот же месяц в 1941 году. Этому Старостину повезло больше — он попал в плен, был освобождён и дожил по меньшей мере

Пропавший без вести прадед
Как я уже писал, я решил попробовать оформить в виде проекта поиск с привлечением нейросетей моего прадеда по отцовской линии, пропавшего без вести во время Великой Отечественной войны.
Его дочь, Клавдия Фёдоровна Старостина на фотографии из хозяйственной книги — моя бабушка, папина мама.

За несколько дней мы вдоль и поперёк перерыли интернет и архивы, обнюхивая каждую зацепку, и смогли исключить одиннадцать потенциальных могил из пятнадцати. Не факт, что он лежит в одной из оставшихся: пропал он в самое горячее время, бойцов находят до сих пор, спустя 80 лет, и часть из них так и не удаётся идентифицировать.
ИИ мне, конечно, здорово помог: я не могу просматривать архивы насколько быстро, а он работал со скоростью, с которой сайты отдавали информацию, да ещё и в нескольких браузерах одновременно.
Сейчас — этап написания писем. К счастью, и тут ИИ здорово помогает: сам ищет, куда писать и как выглядят анкеты, а там, где обращения приходится подавать через
Делаю я всё сеткой
Что-то там-тьюб
Надоело, что «ВК Видео» и «Рутуб» сильно тормозят на проекторе: дизайнеры рисуют всё более навороченные приложения, а железо остаётся прежним.
Запустил на проекторе «Аиду» (там «Андроид») — приложение для просмотра характеристик оборудования, сфотографировал параметры процессора, видеосистемы, доступные аппаратные кодеки, загрузил снимки в нейросеть и попросил написать мне небольшой клиент, который умеет искать ролики на этих площадках и проигрывать.
Пришлось сделать два пробных запуска, приложение заработало только с третьей попытки, зато с невиданной до сих пор производительностью. Надо будет немного дописать, но в целом плеер получился офигенным. Буду пользоваться.

«МК-Про»: далеко ли до «отлично»?
В моей работе над проектом ретроконсоли
Поэтому высвободившееся внимание я направил на проект «
Этот проект родился в ответ на вопрос Ивана Чернякова, заданный в недавно вышедшем документальном фильме, при создании которого я выступал консультантом: не знаю ли я такой задачи, с которой не смогли бы справиться программирующие нейросети.
Со временем, у меня сложится такой критерий того насколько нейросеть хорошо решила эту задачу — насколько близко мы приблизились к оптимизированной версии игры «Пещера сокровищ» в варианте Сергея Анварова «
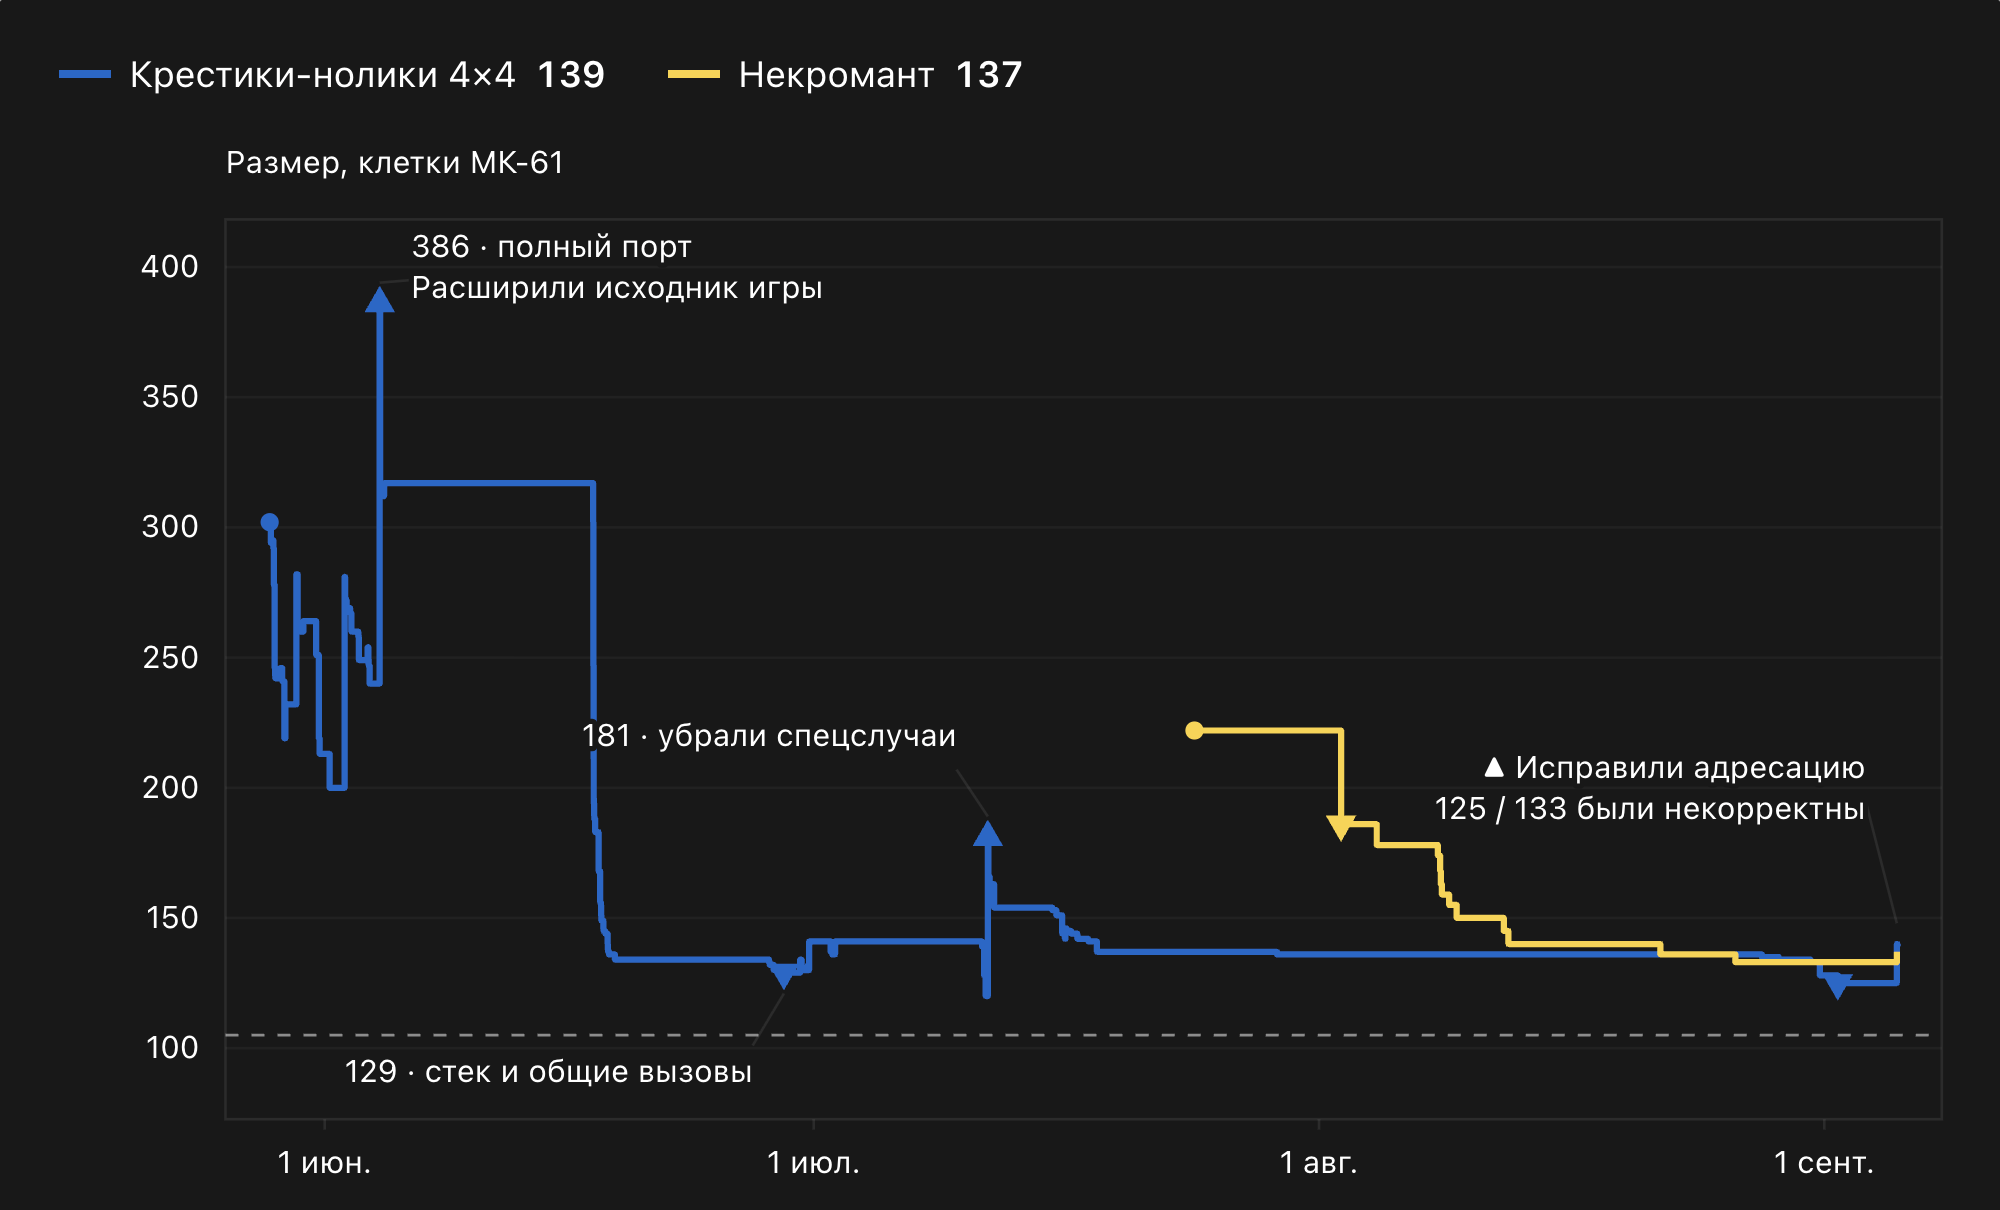
На настоящий момент разница составляет 34 байта или 25%, я попросил нейросеть нарисовать для наглядности график. Планирую сегодня запустить свежевышедшую на днях сеть

Добавлено позднее: в итоге сеть мне сначала довела почти до 105 байт, а потом откатила часть прогресса, сделанного другими сетями и теперь программа у нас занимает 154 байта. Причина — оптимизации слишком заточены под конкретную программу, что противоречит задаче.
ИИ: локальное ревью кода
Подключил локальный
Считаю, что польза уже есть, но надо продолжать его улучшать.
«МК61s»: распробовал «Фейбл 5»

Самая сложная задача, которую пришлось решать для ретроконсоли «MK61s», — это монтирование её как диска. В прежней прошивке программы были зашиты внутрь, и пользовательского способа сохранить туда новые программы не существовало. Я подумал, что раз есть
Перебрав в голове все варианты, я решил делать эмуляцию FAT12. Напрямую она не подходила: не очень хорошо ложится
Этот путь тоже не был безоблачным, проблем хватало. Система, к которой подключён такой диск, не пишет файлы последовательно, то есть там нет команд вроде: «мы начали писать вот такой файл, вот его полное упорядоченное содержимое, а вот и конец». Система пишет кусками, причём это могут быть куски разных файлов вперемешку. Их нужно получить в буфер, а по окончании аккуратно разобрать на файлы, найдя там же метаинформацию, из которой можно получить имя файла. Нетривиальная задача, на самом деле.
Я написал
В итоге, я открыл сеть «Фейбл 5», описал ей проблему и она задумалась минут на двадцать, после чего начала неспешно писать код, в котором проблема была исправлена. Без отладки, без тестов, без диагностики. Задачу я ставил в минимальной формулировке, почти буквально «пять файлов копирую, оно падает», а «Фейбл» разобрала весь код, увидела проблему и решила, даже ни разу ничего не запустив.
Что я хотел сказать этой историей — человек так не сможет.
ИИ: что в имени тебе моём?
Вижу, что многие сравнивают нейросети между собой без особого понимания, как они устроены и чем реально отличаются. Хочу немного прояснить этот вопрос.
Начнём с открытых моделей, там есть о чём рассказать.
Кстати, важно понимать: даже самые сильные открытые модели пока заметно уступают ведущим коммерческим решениям. Поэтому что бы вы ни развернули локально, это не даст помощника того же уровня, что доступен в платных облачных сервисах.
Открытые модели обычно называются так, что по названию уже примерно понятно, чего от них ждать.
Например: Qwen3.6-35B-A3B.
Qwen — это семейство моделей. Если пользоваться простой метафорой, это как «школа», в которой модель училась. У «школы» «Квен» хорошая репутация: из этого семейства выходило много сильных моделей, поэтому есть основания ожидать, что модель будет достаточно умной.
3.6 — это поколение или версия модели. Обычно более новая версия означает, что разработчики улучшили архитектуру, обучение, данные, дообучение и поведение модели. То есть обновили в своей «школе» методику преподавания и учебники.
35B — это общий размер модели: примерно 35 миллиардов параметров. Упрощённо параметры можно сравнить с «объёмом мозга», в которых хранится опыт модели. Чем параметров больше, тем потенциально больше знаний и способностей может поместиться в модель, но размер — не единственный показатель ума. Иногда более новая и лучше обученная модель меньшего размера работает лучше, чем старая модель большего размера.
A3B означает, что модель относится к типу MoE — «mixture of experts», «смесь экспертов». У неё всего около 35 миллиардов параметров, но при ответе на каждый отдельный токен активируется только примерно 3 миллиарда. Если говорить совсем грубо, модель не задействует весь «мозг» сразу, а выбирает нужные участки под конкретный шаг ответа. Поэтому такие модели часто быстрее и дешевле в работе, чем плотные модели похожего общего размера.
Плотные модели — те, у которых задействуется сразу весь «мозг».
При этом MoE-модель не обязательно глупее плотной модели. Плотные модели используют все параметры на каждом шаге и иногда дают более стабильное качество, но обычно требуют больше ресурсов и отвечают медленнее при том же общем размере.
Если в названии дальше есть приписки вроде FP4, FP8, Q4_K_M, GPTQ, AWQ и похожие, это обычно говорит о формате хранения весов или о квантовании. Модель сжали или перевели в более экономный числовой формат, чтобы она занимала меньше памяти и быстрее запускалась на доступном железе.
Это означает, что «знания» модели обо всём менее точные. Хорошее квантирование мало сказывается на модели, но бесследно не проходит.
У коммерческих моделей всё сложнее, характеристики в названии не пишут, обычно там только версия модели. Например, у «Антропика» пишется название и версия.
Название указывает на размер, а версия — на «версию методики обучения». Самая умная и большая на сегодняшний момент — «Фейбл 5», менее умная — «Опус 4.8» и самая простая — «Соннет 5».
Конечно, когда платишь деньги за использование модели, стараешься исполнителя подобрать под задачу, всё как в обычной работе, поэтому всегда использовать самую умную из платных моделей, вроде бы, логичнее всего, но на практике всё упирается в стоимость эксплуатации.