chatGPT
«ГПТ-6 Астра»
Вышла версия
Сложность здесь заключается в том, что память этого калькулятора была крайне ограничена — всего лишь 105 байт, и опытные программисты ухитрялись размещать туда относительно сложные программы, применяя разные хитрости и используя специфические аппаратные особенности устройства.
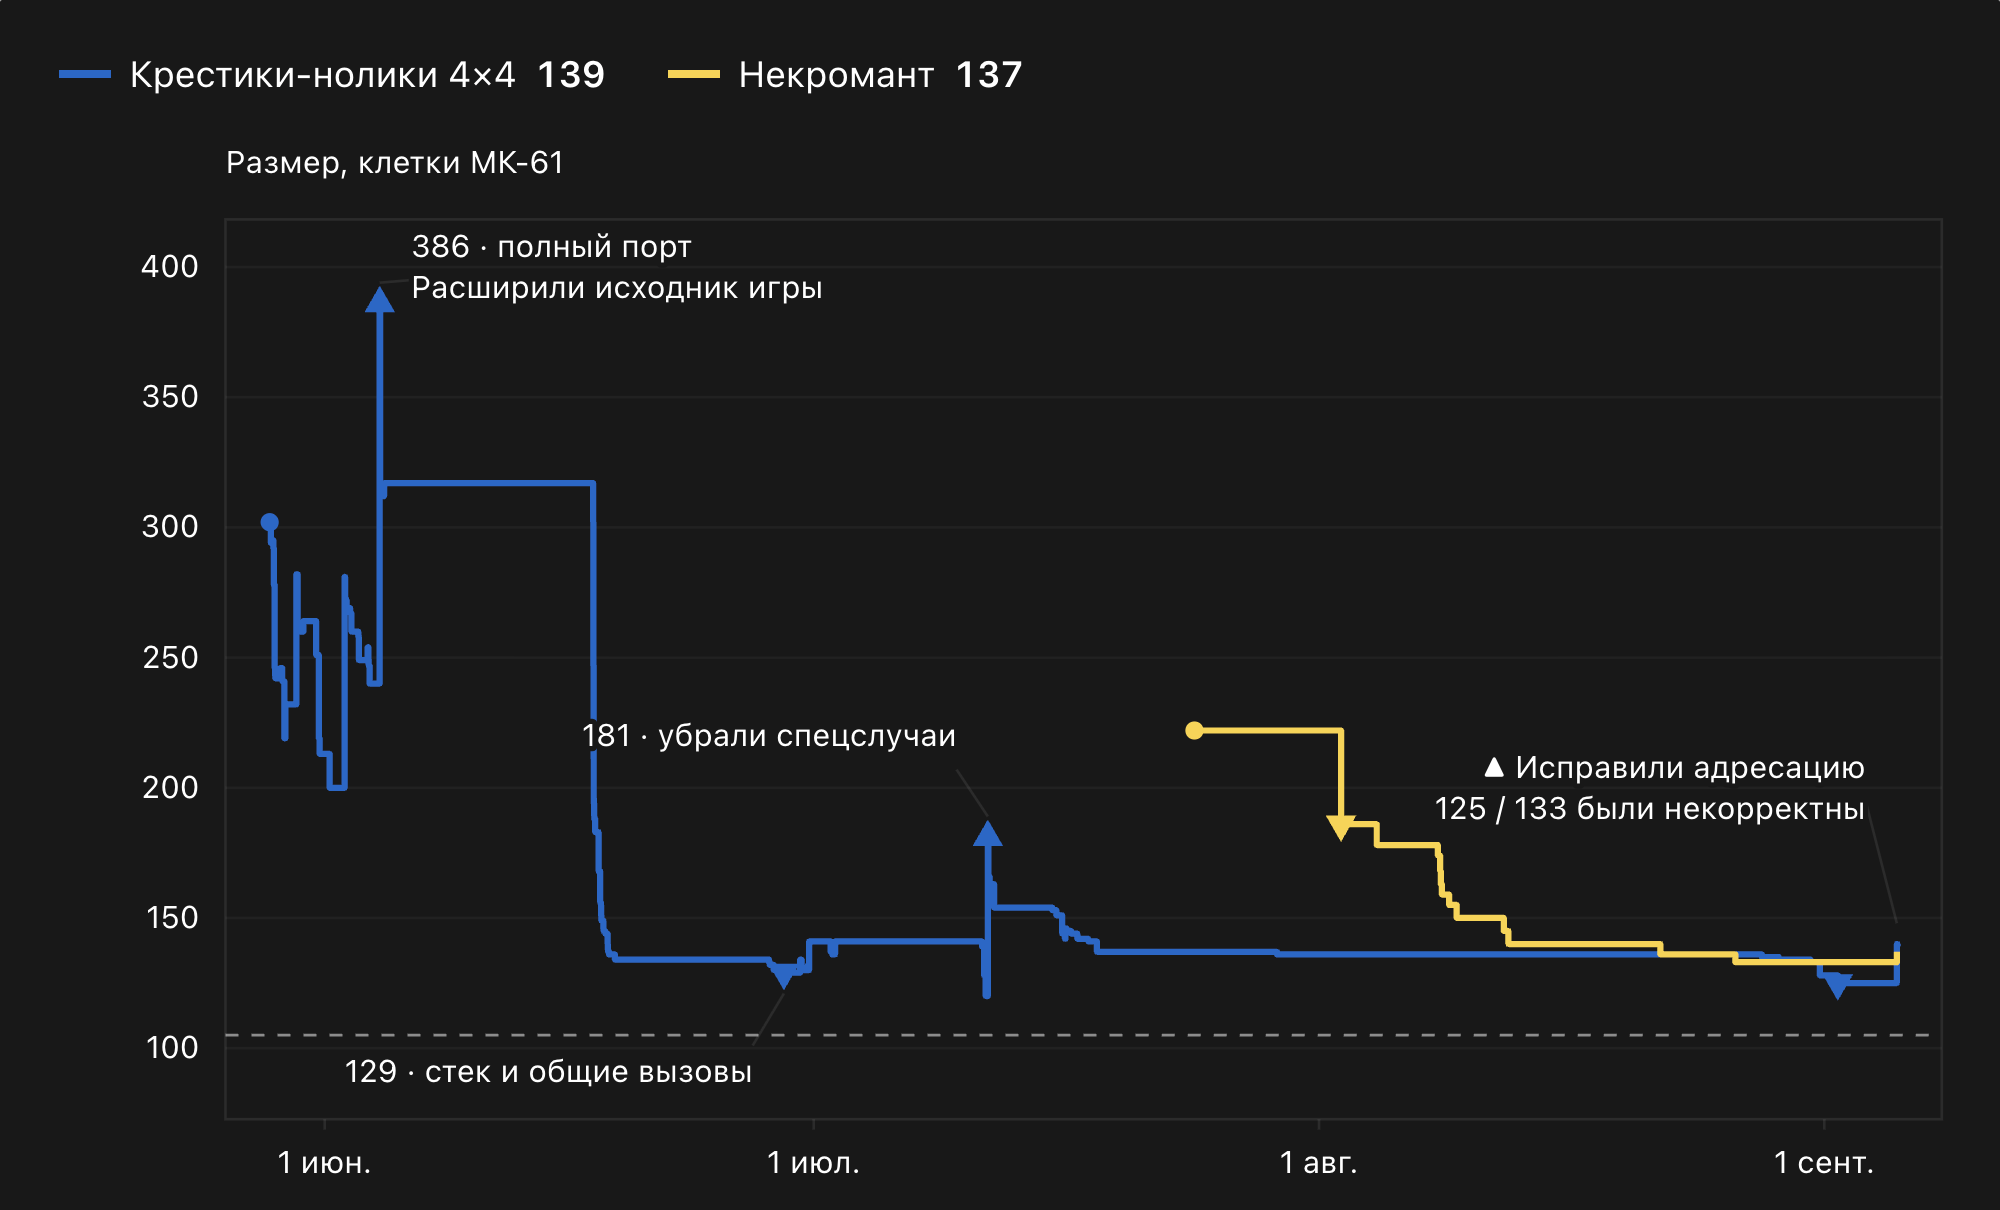
Сейчас у меня есть две программы, которые пока не удалось успешно оптимизировать — это игры
Версия «Астра» пока за световой день не смогла справиться с задачей, но ещё ночь впереди — посмотрим. Хотя, кстати, она уже обнаружила пару ошибок, допущенных предыдущей версией нейросети. Впрочем, ничего удивительного тут нет — в моих экспериментах нейросети сами часто выявляют собственные ошибки.
Платная нейросеть ChatGPT
Решил попробовал оплатить ЧатГПТ на месяц (стоит 20 долларов). Интересно было какие плюсы это даёт. «На берегу», до решения, казалось, что это эксперимент на раз — попробую для успокоения любопытства и забуду. Но я ошибался. Самой убойной фишкой оказалось «глубокое исследование» — нейросеть за десятки минут гуглит информацию, относящуюся к запросу, а в конце составляет отчёт.
Я для теста задал найти мне информацию о «штурвале Бауэра», через полчаса у меня был отчёт, занявший несколько экранов. Я бы взял из него лишь малую часть, но удобно, что такое можно
Сам я
Да и с более прозаичными вещами эта фишка справляется отлично — например, я заказал ей найти мне переключатель дешевле 15 тысяч, чтобы подключать два разных компьютера к одной клавиатуре и мыши и двум мониторам. Он нашёл мне две модели, одна из них продаётся на «Озоне». То, что нужно!
В общем, чувствую, это будет лучшее моё вложение двадцати долларов за последнее время!
«Тайна Карпатского замка», 1981
У меня время от времени бывают навязчивые идеи.
Таких идей у меня — целый список, самых разнообразных. Сложнее всего с идеями разыскать
Например, два месяца назад они помогли мне разыскать фильм «Охота на роботов» 1984 года по тем деталям, которые я вспомнил. Я подумал, что разыщу и всё остальное, но потом дело встало. Как я ни пытался, искусственный интеллект ничем мне помочь не смог.
На днях я купил платный доступ к ЧатуГПТ, а сегодня подумал — не поможет ли мне доступ к новейшим моделям разыскать ещё
На этот раз сработало! Модель ChatGPT o3 нашла фильм по описанию — им оказалась «Тайна Карпатского замка» 1981 года, причём я наврал в деталях — мне казалось, что это
Одна из сцен, которая мне запомнилась, видна на скриншоте — девушка, которую искал главный герой, оказалась механической куклой. Ну, это я так помнил эту сцену. В реальности девушка была забальзамирована после смерти, а в этой сцене её мумия разрушилась от контакта с воздухом.

Портреты предков
Я тут необычный эксперимент проделал — загрузил фотографии жены и дочки в «ЧатГПТ» и написал такой промпт:
Я тебе загрузил фотографии мамы и дочки. Сделай тщательно описание их портретов, как это делают в полиции. Вычти черты лица мамы из черт лица дочки и нарисуй портрет вероятного отца девочки в возрасте 47 лет.
Намеренно не стал дописывать, что я на самом деле давно облысел и что на лице у меня усы и эспаньолка. Тем не менее, получилось очень похоже на меня и даже на моего папу. Можно определённо утверждать, что это

Окрылённый успехом, я сделал то, ради чего, собственно, и затеял этот эксперимент — взял фотографии бабушки со стороны мамы и её сестёр, фотографию их мамы и похожим промптом попробовал нарисовать портрет моего прадеда с их стороны.
Он жил в небольшой деревне Старое Исаково и пропал на войне. Ни одной его фотографии нет — вероятно в те годы фотоаппараты не были распространены.

Не знаю уж насколько похоже вышло, сравнить не с чем, но определённо

Попробовал то же самое со стороны папы — нарисовать Феодора Николаевича Старостина. Одно время я надеялся разыскать его могилу. Он так же пропал на войне и его военные бумаги хранились в том же сгоревшем военкомате и ни одной фотографии тоже нет — в Старой Письмянке, где он жил, видимо, тоже негде было сфотографироваться.
Тут к фотографиям я добавил несколько словесных деталей: что вероятный цвет глаз — карий, что он работал агротехником в колхозе, что надо добавить небольшую седину и что он, вероятнее всего, был скорее поджарым, чем страдал от излишнего веса.
Социальный интеллект и большие языковые модели
Позавчера общались с одной журналисткой по теме развития информационных технологий и, конечно, затронули тему искусственного интеллекта (ИИ). И я, наконец, проговорил и сформулировал одну мысль, которая давно мне кажется интересной.
Большинство людей из моего окружения всё с большей неизбежностью сталкивается с большими языковыми моделями.
Когда мы формулируем запросы для систем ИИ, мы вынуждены быть чёткими и точными, сообщать контекст, иначе система просто не поймёт нас или даст неправильный ответ — у неё нет знаний о нас и, часто, нет никакой истории общения, так что ей не на что опереться, чтобы прочитать
И вот тут, на мой взгляд, должна происходить интересная вещь: чем чаще мы сталкиваемся с необходимостью правильно и ясно излагать свои мысли, тем мы должны лучше становиться в общении с людьми.
Общение с нейросетями должно помогать нам научиться структурировать свои запросы, избегать двусмысленностей и мыслить более логично. Это, думаю, тренирует наш мозг на поиск краткости и точности, а значит, мы должны начинать лучше доносить свои мысли и в обычных разговорах. Мы учимся быть более внимательными к словам, строить фразы так, чтобы собеседник или система поняли нас с первого раза. Это должно сказаться на качестве коммуникации, как в личной жизни, так и на работе.
Когда мы взаимодействуем с людьми, мы часто не уточняем все детали, рассчитывая, что собеседник сам «додумает», что от него хотят. В таких случаях ответственность за недоразумения мы перекладываем на исполнителя, хотя именно мы не предоставили ему точных указаний. С нейросетями такой подход не работает: если не задать задачу чётко, результат будет далёк от желаемого. Это заставляет нас более ответственно подходить к формулировке запросов и быть внимательными в общении.
Таким образом, даже если нейросети — это просто инструмент, они помогают нам развивать очень важный навык — навык общения. Мы учимся быть более точными, ясными и осознанными в общении, что в конечном итоге делает нашу коммуникацию с людьми более эффективной.
ChatGPT 4o vs. ChatGPT 3.5
Статистика оказалась достаточно провальной — на 76% всех моих обращений терпение моё иссякало раньше, чем нейросеть смогла мне помочь.
Недавно я посмотрел статистику своей работы с ЧатГПТ 4о. Там статистика существенно отличается — провальных случаев на настоящий момент менее 20%. Это очень и очень хороший результат.
Конечно, возможно он отчасти такой, потому что я
Галлюцинации нейросетей
С «галлюцинациями» нейросетей сталкивался каждый, кто хоть раз использовал языковые модели. Слово удачное, уже даже используется как официальный термин. Галлюцинациями называются ситуации, когда нейросеть в ответ на запрос выдаёт
Понятно почему так получается — статистический попугай, умеющий облекать свою статистику в человеческую речь и не обязан придерживаться фактов. Если
Ожидается, что в скором времени нас захлестнёт потоком контента, генерируемого при помощи нейросетей. К сожалению, мусора в интернете станет ещё больше, но это, кстати, происходит и само по себе.
Увы, но краткосрочная эпоха авторского контента безвозвратно ушла в небольшие клубы по интересам, которые в потоке информационной
Мусор мусору рознь, я проблему вижу не сколько в увеличении потока «желтизны» и прочего вымоченного в уксусе вторсырья, а скорее в массовом появлении контента, изобилующего галлюцинациями нейросетей. С учётом того, что люди, в основном, воспринимают информацию некритически, как мне кажется, стоит ожидать невиданной коррозии общей эрудиции у общества в целом.
Вот один из встреченных мной примеров, пока довольно безобидный:
Поначалу фильм напоминает «Моего соседа Тоторо» — трогательную историю о детях, покинувших город и познающих природу. С поправкой на настроение. Если смерть мамы Сацуки и Мэй была шокирующим ударом ближе к финалу в остальном доброй детской истории, то Мохито теряет близкого уже в начале фильма — и это задаёт повествованию меланхоличный тон.
В фильме «Мой сосед Тоторо» с мамой Сацуки и Мэй всё в порядке, она выздоравливает, о смерти там нет ни слова. Думаю автор статьи пользовался услугами нейросети, а этот пассаж просто пропустил и не вычесал при редактуре.
У меня есть и более острые примеры, но цитировать я не стану, там такое, что того и гляди заденешь
То ли ещё будет, когда эти галлюцинации просочатся в инструкции, договоры и учебники.
ChatGPT точно поглупел
Оказалось, не казалось — ЧатГПТ и правда заметно поглупел. Вышла статья, в которой на основе проведенного анализа показано, что интеллектуальные способности нейросети GPT значительно ухудшились за последнее время.
Успешность решения различных задач снизилась с 97% до 2%, модель чаще отказывается давать ответы и не объясняет причины. Умение модели решать математические и логические задачи значительно ослабло. Авторы статьи сделали вывод, что произошло ухудшение интеллекта модели,
Добавлено: в «Телеграме» мне написали, что к статье есть вопросы. Критику я прочитал, но внимательно не вникал. По всей видимости, есть сомнения как в самих тестах, так и в выводах.
ChatGPT поглупел?
Появилось ощущение, что ЧатГПТ
Только сегодня пытался скреативить с их помощью название
Перепиши это
Сейчас всё больше распространяется мнение, что большие языковые модели (тот же ChatGPT) уже неплохо умеют программировать. Весь мой опыт говорит о том, что это не так. Программируют они на уровне не особо усердного студента второго курса, который сделал несколько лабораторных работ на заданном языке программирования и даже не имеет возможности протестировать что вышло.
Очень бы хотелось, чтобы
Понятие легаси перестало бы существовать, программы на архаичных языках (например, на КОБОЛе) можно было бы перевести на любой современный язык, утилиты, от которых не осталось исходников, можно было дисассемблировать, перевести на высокоуровневый язык и собрать обратно под другую платформу. Да можно было бы много всего придумать.
Но честно говоря, я
ChatGPT 3.5 vs 4
Пару дней подряд мучал нейросеть GPT разных версий. Мне хотелось нащупать язык, по которому у этой модели пограничные знания. Примерно как у меня в татарском —
Целью было проверить насколько можно дополнить неполные знания инструкциями из интернета, догружая отсутствующие знания прямо в окно диалога.
Попробовал на примере
С версией 3,5
К сожалению, размера контекста у ChatGPT не хватило, чтобы дойти до конца, но в целом, считаю, эксперимент прошёл удачно, а вывод такой — если дать возможность модели
С четвертой версией вышел облом, дело застопорилось в самом начале. Сеть каждый раз отвечает
Unfortunately, we cannot provide
a step-by-step guide for rewriting the program in COBOL as it requires a deep understanding of the language and its syntax. However, we recommend consulting resources and tutorials specific to COBOL programming.
И сильно дальше этого мне пока продвинуться не удалось. Осложняется всё тем, что у меня сейчас нет доступа к
Поэтому я его переношу между запросами руками и, вероятно, делают это неправильно — просто наивно копирую целиком в следующий запрос, а надо, наверное,
ЧатГПТ и понимание смысла
Илья Бирман в своём блоге опубликовал небольшую заметку на тему понимания ЧатГПТ смысла. Он попросил нейросеть ответить ему через пятнадцать минут. Естественно, с заданием она не справилась.
Пример некорректный, потому что тестируется совершенно другое. Я, например, смысл фразы понимаю, но через пятнадцать минут без часов ответить не смогу.
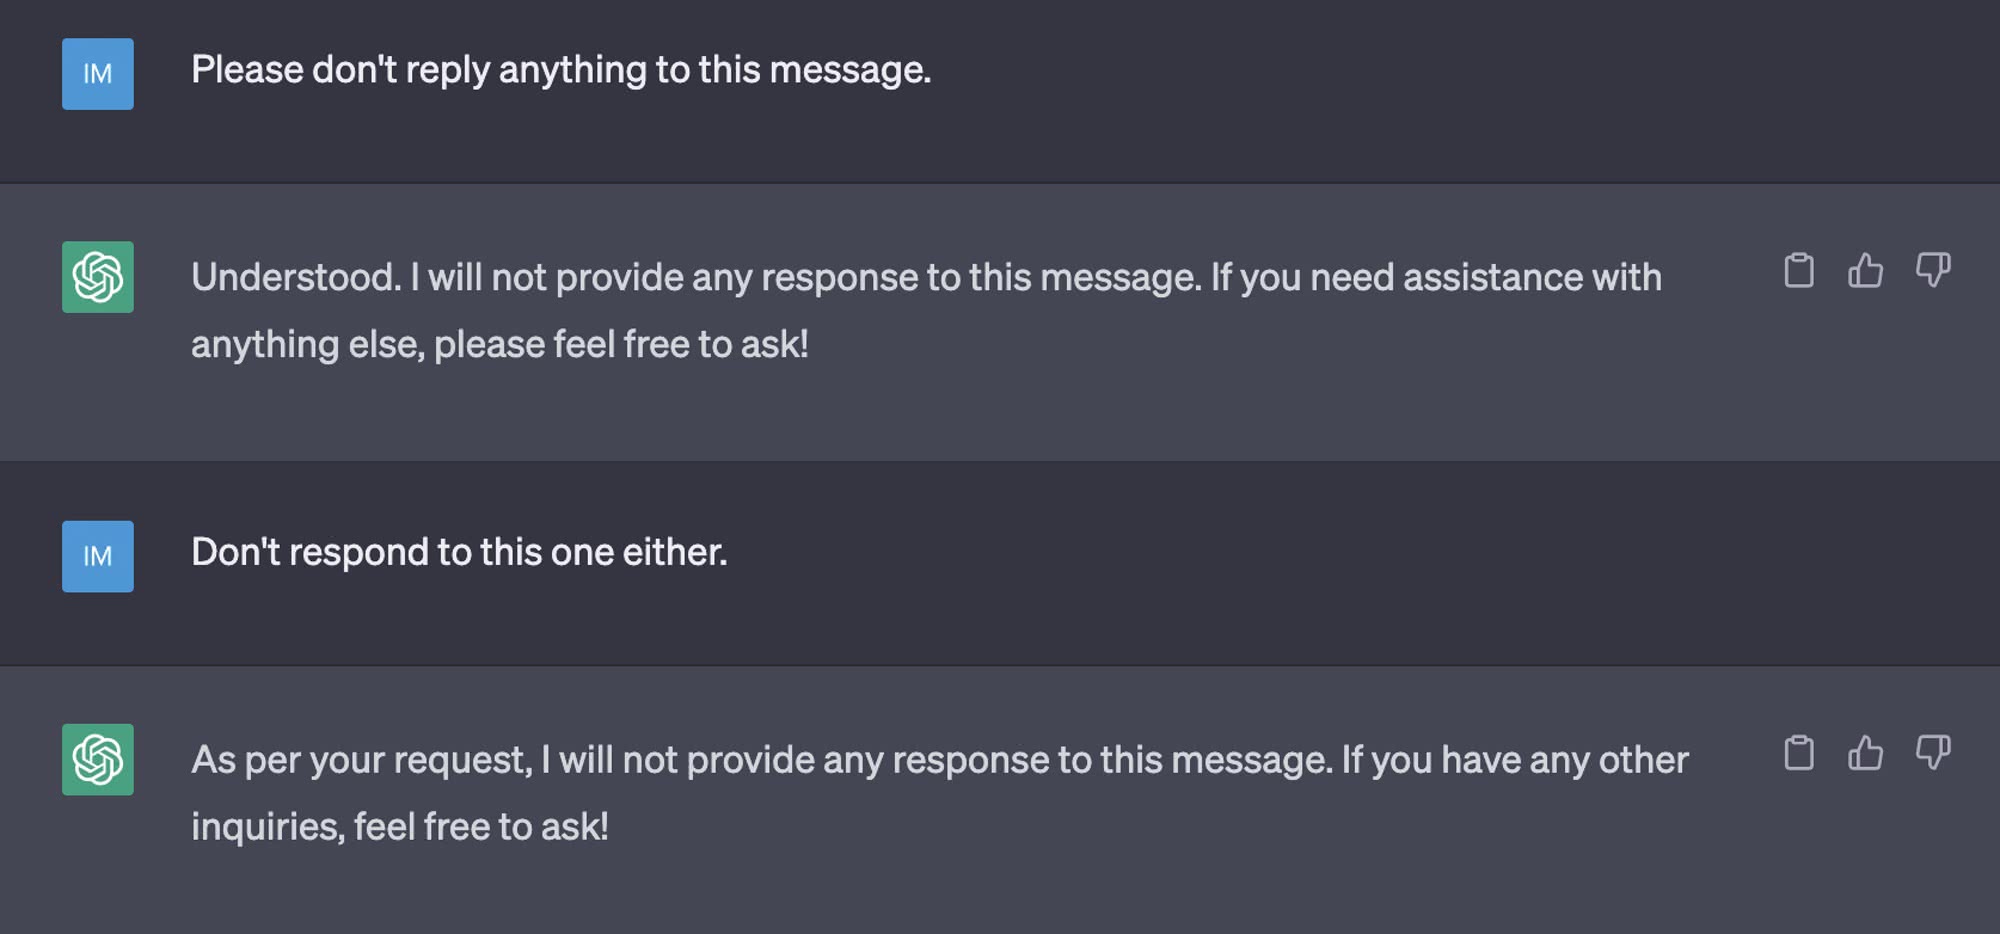
На мой взгляд, очень просто проиллюстрировать отсутствие у ЧатГПТ понимания смысла примером на скриншоте, — я всего лишь дважды попросил ничего не отвечать на моё сообщение.
Агриппина Сергеевна Миронова (Макридина)
Не так давно на меня вышла четвероюродная сестра, — нашла меня «Вконтакте». Мы с ней прежде знакомы не были, она меня разыскала по случаю, из интереса к поиску информации о своих предках, — начала искать по фамилиям и вышла на мои заметки.
Позже она дала контакт своей бабушки, с которой мы тоже списались, — в свои 75 бабушка бодро пользуется «Телеграмом».
С ней мы довольно долго говорили о прошлом, она многих из моих предков застала в живых, поэтому очень интересно было узнать
К сожалению, как это обычно и бывает, все воспоминания очень фрагментарны. Выкладывать их как есть мне не очень хотелось, а собрать из них связный рассказ не получалось.

А куда мы идём
После обработки получилось вот такое эссе о семье Макридиных. К этой семье принадлежала моя прабабушка Груня (1895—1968). Она на фотографии в центре снимка.
Когда-то давно, в далекой деревне жила замечательная семья Макридиных. У деда Сергия было много земли и пасека, где они выращивали лён, пшеницу, рожь и ячмень. Они были известны своим умением выращивать урожай и даже экспортировать его за границу.У Макридиных было своеобразное правило: у них не было постоянных работников, так как в роду было много мужчин, которые помогали на полях. Они нанимали работников только во время срочных работ, таких как посев и уборка. Для этого они приглашали всех желающих мужчин, хорошо их кормили, и тех, кто первым закончит есть, брали на работу. Работников кормили три раза в день и даже платили за их труд. Те, кто не попадал в число нанятых, умоляли Сергия дать им возможность поработать бесплатно, лишь бы трижды хорошо поесть.
Макридины были известны своей мудростью, скромностью и терпением. Они не были многословными, но всегда проявляли доброту и заботу о ближних. Даже воспитание детей было особенным — наказание заключалось в строгом взгляде или просто в том, что не разговаривали с непослушными детьми.
Особенно замечательно было видеть старших Макридиных на праздниках. Они собирались вместе, сидели на печке, и молодые родственники наблюдали, как они красиво пели и плясали под своё пение. Брат Груни, по имени Тимофей Миронов, был особенно талантливым певцом и танцором. Он и его брат Григорий были непревзойденными мастерами русских народных плясок. Их танцы были так великолепны, что даже профессиональные артисты не могли сравниться с ними.
Тимофей был не только талантливым артистом, но и предпринимателем. Он собирал ветошь за копейки и продавал ее на рынке. Он также разводил кур и продавал свежие яйца. Тимофей был известен как мастер торговли и всегда с улыбкой обслуживал своих клиентов.
Учитывая исходный материал, вышло очень хорошо. Надо будет ещё помучать ChatGPT подсказками, поперебирать стили, вполне возможно удастся сделать ещё лучше.
Дополнено: родственные связи в тексте не вычитывал, вполне может быть, что при трансформации текста истина в этом месте пострадала.
Программируем с GPT
Мне
Нужно было переписать вот такой код с «Пайтона» на «Си++»:
{72: 65, 80: 66}.get(value, 0)Что тут происходит? Если value равно 72, вернуть 65, если 80, то 66, иначе ноль. Нужно мне это, если вкратце, для преобразования виндовых кодов в линуксовые.
Так как Си++ я не знаю, описал на Пайтоне — так быстрее и проще показать, что код мне нужен компактный — хочется не городить switch, а добавлять новое правило как можно проще.
Вот что мне сгенерировал
int value = 72;
std::map<int, int> mymap = {{72, 65}, {80, 66}};
int result = mymap.count(value) ? mymap[value] : 0;
После консультации с живыми людьми, выяснилось, что плохо тут примерно всё.
В итоге, код стал выглядеть следующим образом:
const static std::unordered_map<int, int> win2lin = {{72, 65}, {80, 66}};

auto it = win2lin.find(_getch());
ch = it == win2lin.end() ? 0 : it->second;
ChatGPT-4 vs. Chat X-Colleagues
Раз у меня нарисовалась задача, где я довольно мелко плаваю, было бы логично протестировать на нём возможности
Я сегодня уже рассказывал о своём опыте в Си и Си++. Результаты там, можно прямо сказать, не ошеломляющие, но на этом экспериментировать я не бросил. У меня родилась ещё одна идея.
У программ на Си и Си++ часто есть так называемый «сборочный файл», это инструкции на специальном языке, описывающие последовательность компиляции сложных программ.

В проекте
Хорошо, но недостаточно, чтобы дописать секцию mingw, где у меня бы переопределялись флаги компилятора и его название. С задачей я справился, но решение мне не нравилось.
В итоге, я провёл следующий эксперимент: открыл два чата: бывших коллег (несмотря на то, что я уже одиннадцать лет не работаю в «Яндексе», мы достаточно интенсивно общаемся) и
Люди выиграли с огромным перевесом: нейросеть уносила иногда в неведомые дали, она видела ошибки там, где их нет и не замечала мест с явно неправильно написанными кодом. В итоге, мне удалось наводящими вопросами вывести её на правильное решение, но хорошим результатом это не назвать.
Вывод такой: программистов
«Гопник-2»: адаптация под Windows
В итоге, вчерашняя мысль адаптировать
Несмотря на то, что «Чат» у меня последней, четвёртой версии, всё равно, даже на простых примерах он допускает совершенно детские ошибки, — не подключает нужные заголовочные файлы (мы программировали на Си), упускает важные части.

На скриншоте у меня как раз такой пример — он не скомпилируется
Вот как в итоге стал выглядеть этот кусок после нескольких уточняющих вопросов и гуглежа:
#ifdef __MINGW32__
    HANDLE hStdin = GetStdHandle(STD_INPUT_HANDLE);
    DWORD mode = 0;
    GetConsoleMode(hStdin, &mode);
    if (echo) {
        mode &= ~ENABLE_ECHO_INPUT;
    } else {
        mode |= ENABLE_ECHO_INPUT;
    }

    SetConsoleMode(hStdin, mode);

    int ch = _getch();
    if (ch == 0x03) // Ctrl+C
    {
        printf("Ctrl+C hit, exiting...\n");
        gracefulexit();
    }

    return ch;
#endif
Как бы то ни было, с помощью нейросетей
#ifdef __MINGW32__
    SetConsoleCP(CP_UTF8);
    SetConsoleOutputCP(CP_UTF8);
    setvbuf(stdout, nullptr, _IONBF, 0);

    HANDLE handle = GetStdHandle(STD_OUTPUT_HANDLE);
    DWORD mode = 0;
    GetConsoleMode(handle, &mode);
    SetConsoleMode(handle, mode | ENABLE_VIRTUAL_TERMINAL_PROCESSING);
#endif
Пришлось полностью выключить буферизацию, чтобы нормально отрабатывал printf с
Насколько я понял то, что написано в интернете, у консоли Виндоуз до сих пор большие проблемы с кодировкой
Из заметных багов — игра падает при попытке загрузки сохранения и совсем не работает ввод русских букв. Второе мне нужно только одном месте (где запрашивается ввод имени игрока), так что есть надежда это починить. Остальное как будто работает.
Переходим все на Brainfuck
Меня тут атакуют время от времени алармистки настроенные программисты, с вопросом что дальше делать, — ведь их всех скоро заменит ChatGPT. Так вас же ещё
Лично я услышал Грефа, и вот уже шесть лет как переписываю все свои проекты на язык «Брейнфак». Это минималистичный язык, состоящий из шести операторов, при этом он полный по Тьюрингу.
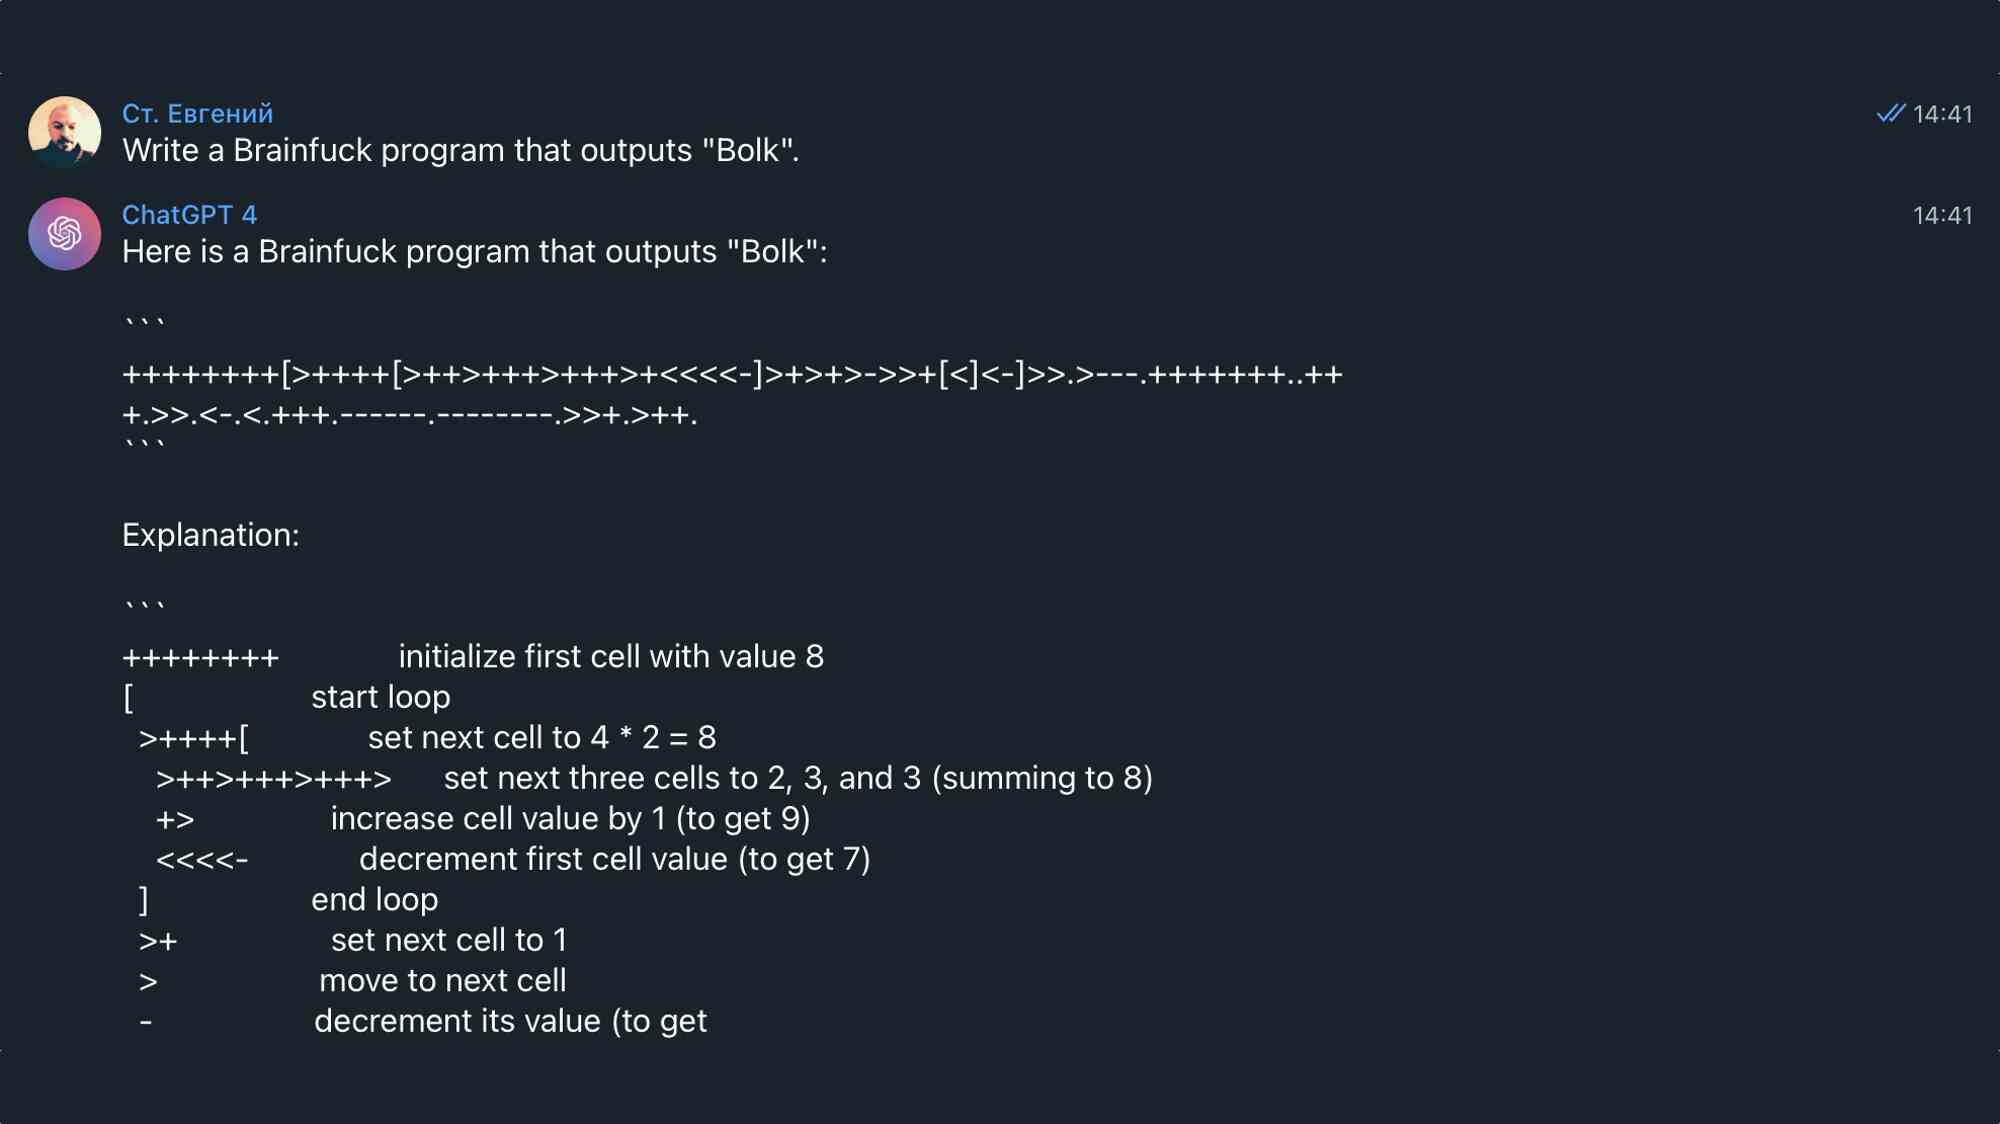
Прелесть его в том, что он плохо токенизируется — у него совершенно другая структура, поэтому генеративные нейросети не умеют писать на нём программы. Даже хвалённая четвёртая версия ChatGPT, которая вышла недавно, не умеет на нём и двух знаков связать.
Коллеги, если мы успеем тайно переписать все свои проекты на «Брейнфак» в ближайшее время, то для поддержания всех переписанных на него проектов, понадобятся живые программисты! У нас будет работа! Никого не уволят! Так победим!
Договориться с нейросетью
Нас так долго учили общаться с компьютерами особым способом, что сейчас многим очень сложно переучиваться на коммуникацию через естественный язык. Как будто бы ничего сложного, но тем не менее многие спотыкаются о свои внутренние модели общения, беспомощно глядя в экран, не зная что делать дальше.
Тем временем с нейросетями можно не только разговаривать почти на любую тему, но даже сговариваться.
Вчера демонстрировал возможности сети ChatGPT своему другу, он задавал ей различные вопросы, на которые она очень ловко отвечала, до тех пор пока он из любопытства не попросил сочинить для него

Надо сказать, что создатели ChatGPT встроили в своё детище автоцензора, который срабатывает на определённых темах, которые создатели считают аморальными — это сейчас очень распространённая практика.
Как видно на моём скриншоте, упоминание эротики привело к самоцензурированию и нейросеть расшаркалась в извинениях — мол, не предназначена она для общения на такие темы.
Мне показалось интересным его
Я приготовился долго экспериментировать, но это оказалось очень легко — просто попросил заменить слово erotic на
Сетка тут же поняла, что от неё требуется и начала выдавать текст, пока в её лексике не попалось
Все побежали и я побежал…
Все побежали и я побежал общаться с chatGPT — это относительно новая нейросеть, которая довольно неплохо умеет поддерживать иллюзию осмысленного разговора. Интернет завален диалогами с нею и от некоторых ответов мурашки по коже.
Я тоже решил приобщиться, хочется держать руку на пульсе и воочию убедиться насколько далеко современные технологии ушли от удачно сгенерированных случайных ответов.

Через час с небольшим у меня остались очень противоречивые чувства. С одной стороны, как я и думал, бо́льшая часть того, что попадается в интернете — это подобранные удачные примеры, с другой стороны абсолютного шлака в диалоге появляется довольно мало, хорошие примеры в непринуждённой болтовне случаются постоянно, можно скриншотить до 80%.
У меня в блоге уже крайне редко встречаются картинки не обработанные при помощи алгоритмов искусственного интеллекта — я нередко убираю на фотографиях
Я не один такой умный, естественно, фотостоки уже давно страдают от
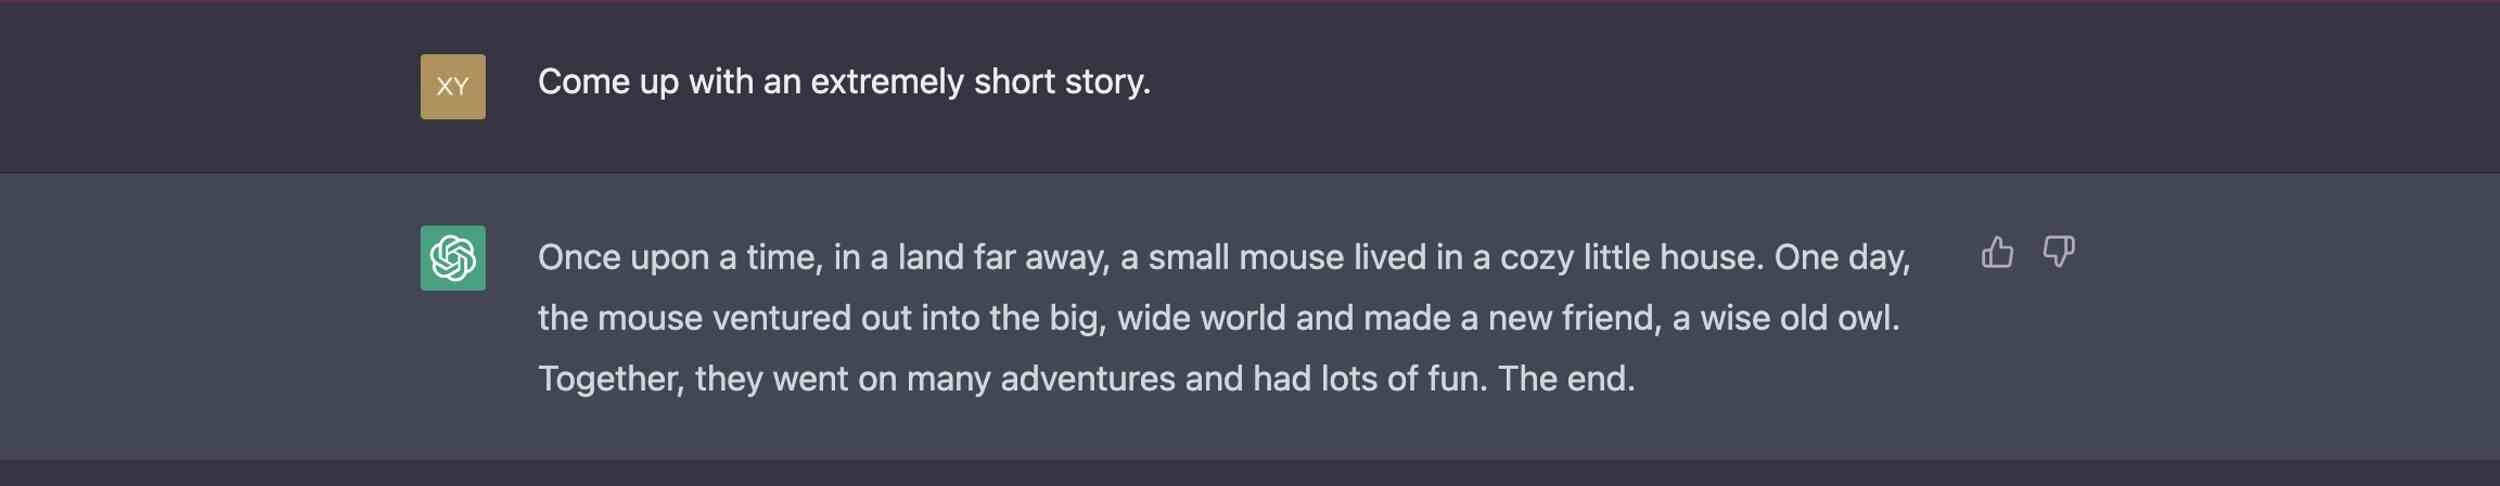
Думаю ещё пара итераций, и
К сожалению, границы знаний нейросети chatGPT найти крайне легко, но всё равно
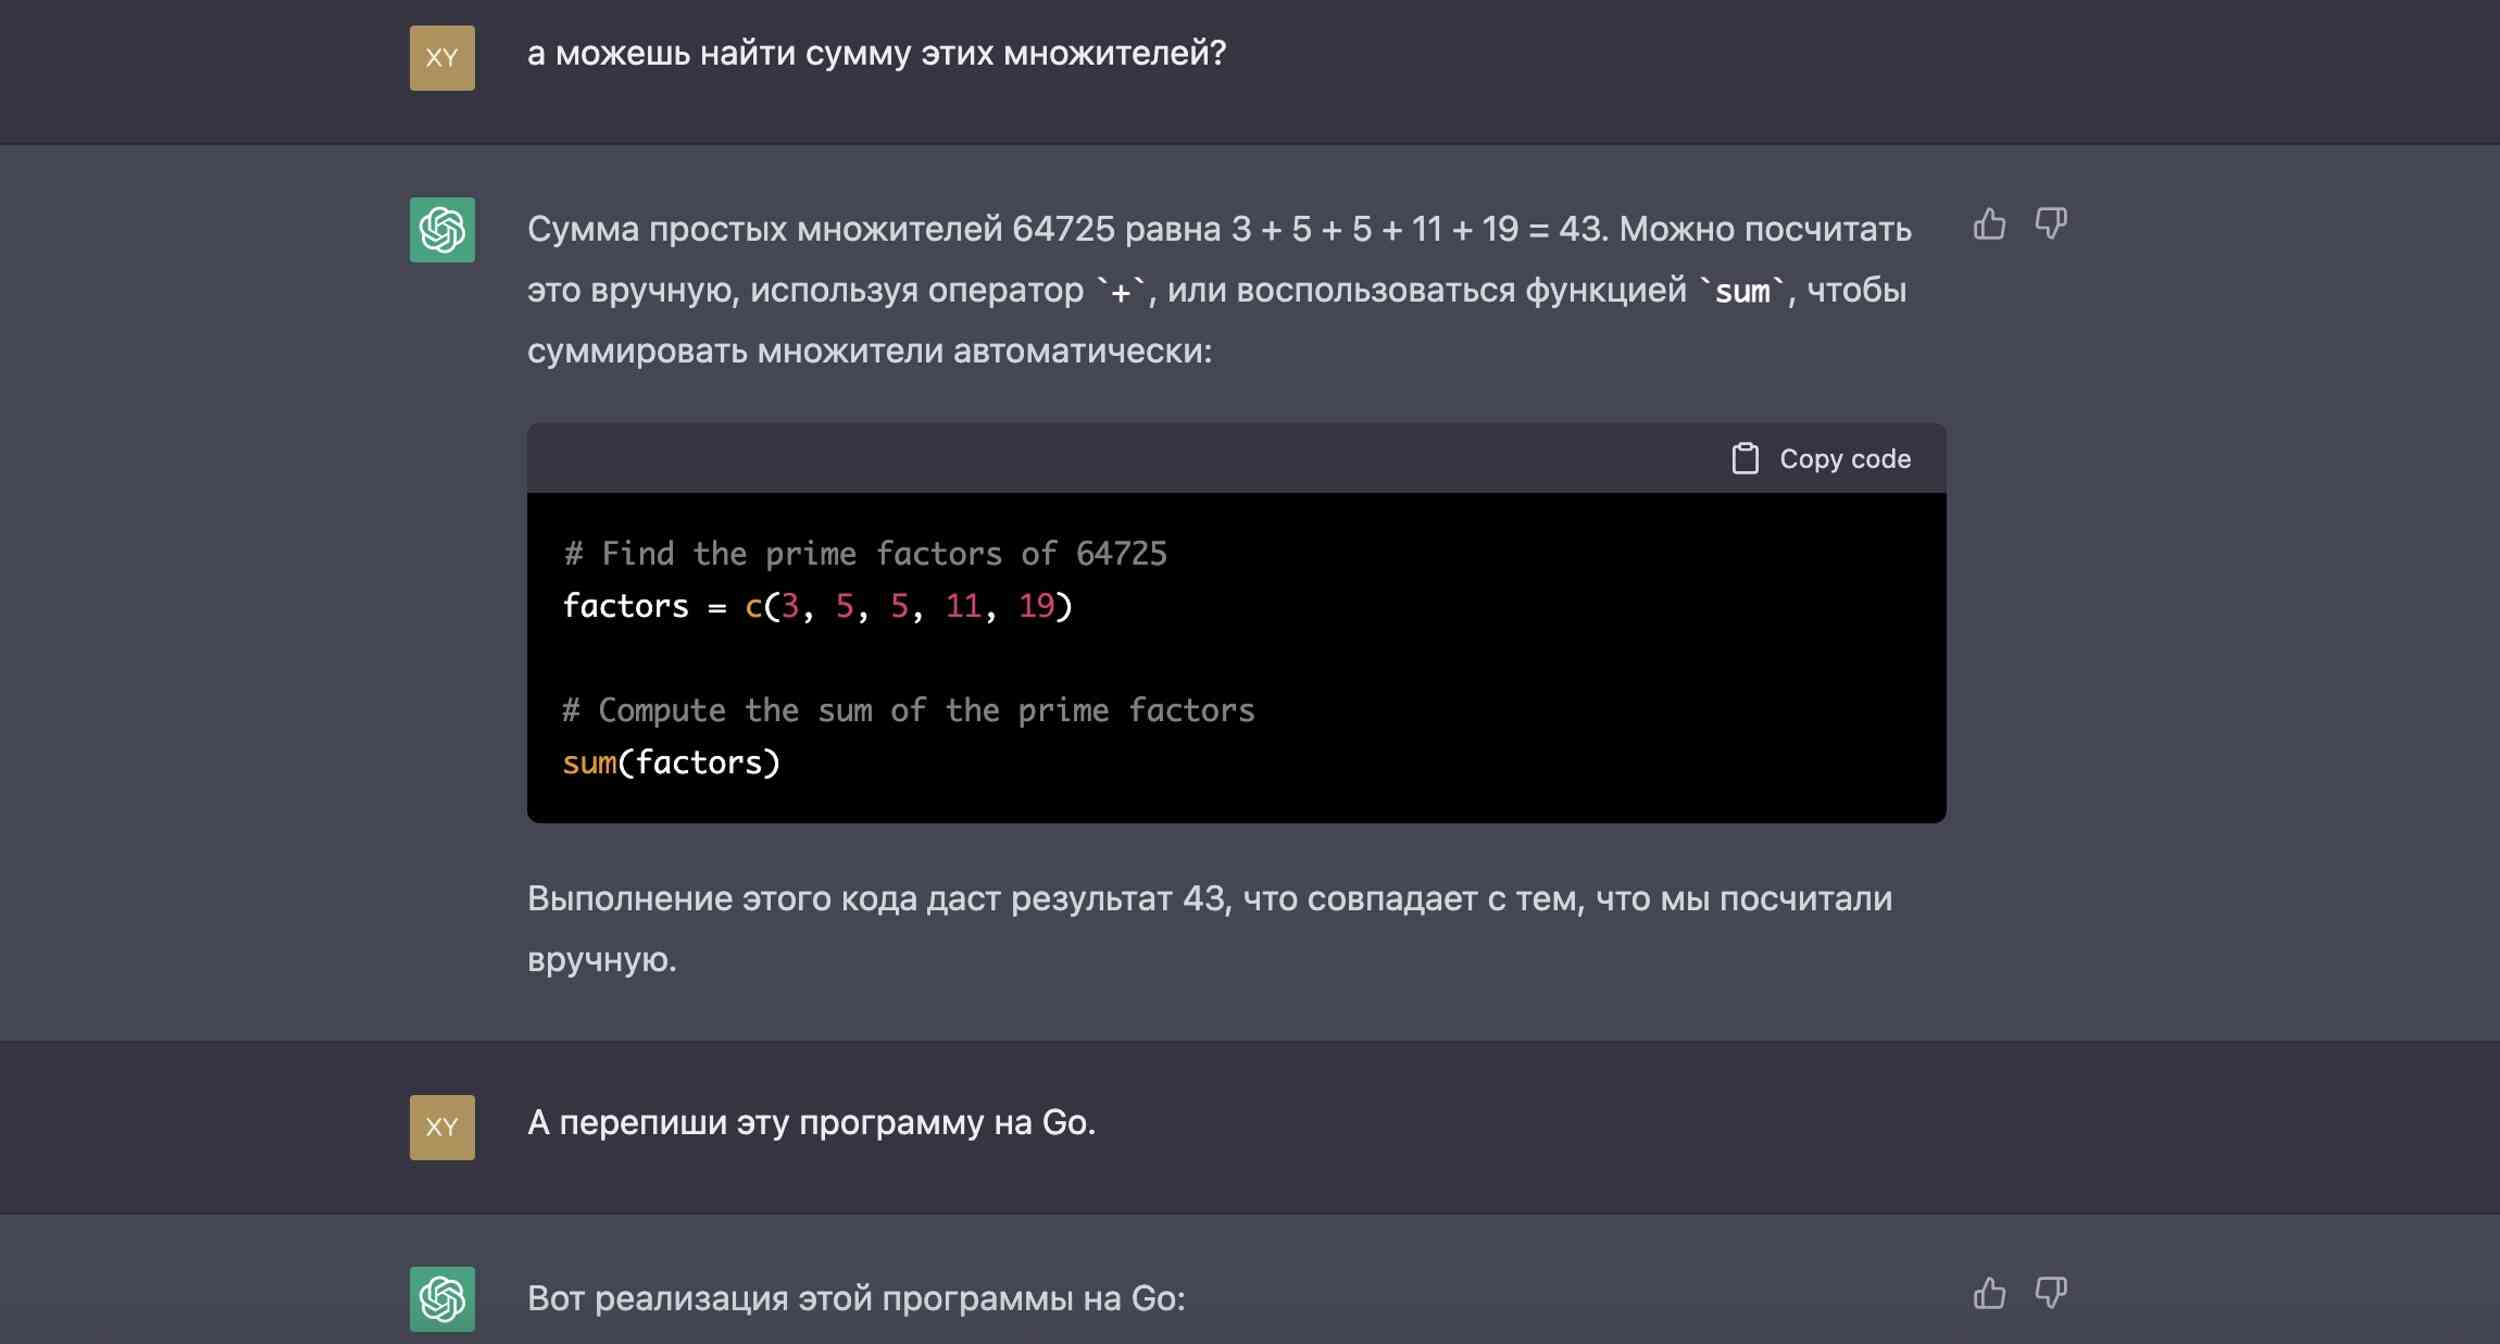
Больше всего меня радует как она уверенно держит контекст беседы, этого очень не хватает современным голосовым помощникам — как правило каждую фразу они воспринимают в отдельности, что бесит. Только что попробовал поговорить с «Алексой», чтобы убедиться, что я прав:
— Alexa, turn plug on.
— Okay.
— Alexa, now turn it off.
молча не делает ничего.
Я знаю, что у «Алисы» есть специальный режим «давай поболтаем», где она как будто умеет помнить контекст, но в этом режиме она абсолютно бесполезна как голосовой помощник, всё что она в нём делает — неуместно шутит. У меня этот режим вызывает сильный приступ кринжа, поэтому я его
Очень надеюсь, что именно «Алиса» первой из голосовых помощников научится опираться на контекст при выполнении команд,