программирование
99 бутылок: язык B («Би»)
В последнее время я довольно много пишу на Си,
При этом ни в одной проштудированной мной статье нет ни одной даже самой простенькой программы на Би, а я человек любопытный. В общем, я решил сам посмотреть и вам показать.
81. B (язык «Би»), после появления Си, был полностью вытеснен последним и сейчас совершенное не используется. В отличие от, например, Кобола, который старше на десять лет, но при этом вполне ещё встречается.
Думаю, причин тут несколько.
Язык Би и правда очень похож на Си, в этом можно убедиться, взглянув на написанную мной программу. Что тут режет глаз сишному программисту? Прежде всего — отсутствие типов у заголовка функции, импорта функции printf и странное ключевое слово extrn внутри функций. extrn означает, что этот символ (в терминах компилятора) пришёл из внешней зоны видимости. Современное extern явно произошло от него, только значение немного поменялось.
Немного непривычно, что все переменные объявлены как auto, но в современном Си так тоже можно. auto, в данном случае, — класс хранения. В современном Си это класс хранения
Впрочем, в стандарте Си23 auto теперь означает автоматический вывод типа, что для совместимости с Би подходит ещё больше, так как, если приглядеться, строковые массивы («строки») в Би не выделены в отдельный тип.
Из того, что заметить чуть сложнее — экранирующий символ в строке не обратный слэш, а «звёздочка» (*), поэтому символ перевода строки не \n, а *n.
Ещё немного странно, что тут цикл while, а не for, но сильно это в глаза не бросается. В «Би» цикла for просто нет, поэтому вот так.
Вообще, ощущение такое, что Си взял от Би буквально всё, но, как ни странно, это не так. В Би есть конструкции ===, =!=, =<= и =>=. Наверное они
Кроме того, другая почти вся стандартная библиотека. Совпадают всего несколько функций, по больше части это
/* Beer song. Evgeny Stepanischev, Dec 2024 */
print_bottles(b, tail) {
  extrn printf;
  auto s;

  s = "s";

  switch (b) {
    case 0: printf("No"); break;
    case 1: printf("%d", b); s = ""; break;
    default: printf("%d", b);
  }

  printf(" bottle%s of beer%s", s, tail);
}

main() {
  extrn printf, print_bottles;
  auto beer;

  beer = 99;
  while (beer) {
    print_bottles(beer, " on the wall, ");
    print_bottles(beer, "!*n");

    beer--;

    printf("Take one down, pass it around.*n");
    print_bottles(beer, " on the wall!*n*n");
  }

  printf("No more bottles of beer on the wall, ");
  printf("no more bottles of beer.*n");
  printf("Go to the store and buy some more,*n");
  printf("99 bottles of beer on the wall...*n");
}
Я долго пытался найти хоть
В итоге, остановился на
Нечётные числа: uint32_t
В программе есть место жёстко завязанное на тип, — печать числа, а мне хотелось сделать так, чтобы при смене типа ничего не ломалось. Поэтому я решить попробовать обобщённое программирование. Его в Си мне использовать ещё не приходилось, вот и выпал случай.
Заодно попробовал в действии функции __builtin_*_overflow, позволяющие использовать математику с контролем переполнения. Я только недавно задумался о том, что они должны бы быть в языке, а до этого переполнение я проверял дедовским способом — смотрел не стал ли результат меньше аргумента.
Обобщённое программирование выглядит следующим образом:
#define PRINT_U(x) ({ \
    _Generic((x), \
        uint128_t: printf_u128, \
        uint64_t: printf_u64, \
        uint32_t: printf_u32 \
    ); \
})(x)
Тут у меня макрос PRINT_U зависит от типа аргумента, а выбор делается при помощи стандартной конструкции _Generic — она принимает аргумент и, в зависимости от того выражение какого типа было передано, возвращает одно значение из указанного списка.
static void printf_u128(const uint128_t v) {
    unsigned long long low, high;

    #if __BYTE_ORDER__ == __ORDER_LITTLE_ENDIAN__
        low  = MASK64(v);
        high = MASK64(v >> 64);
    #else
        high = MASK64(v);
        low  = MASK64(v >> 64);
    #endif

    printf("0x%016llX%016llX\n", high, low);
    fflush(stdout);
}

static inline void printf_u64(const unsigned long long v) {
    printf("0x%016llX\n", v);
    fflush(stdout);
}

static inline void printf_u32(const unsigned int v) {
    printf("0x%08X\n", v);
    fflush(stdout);
}
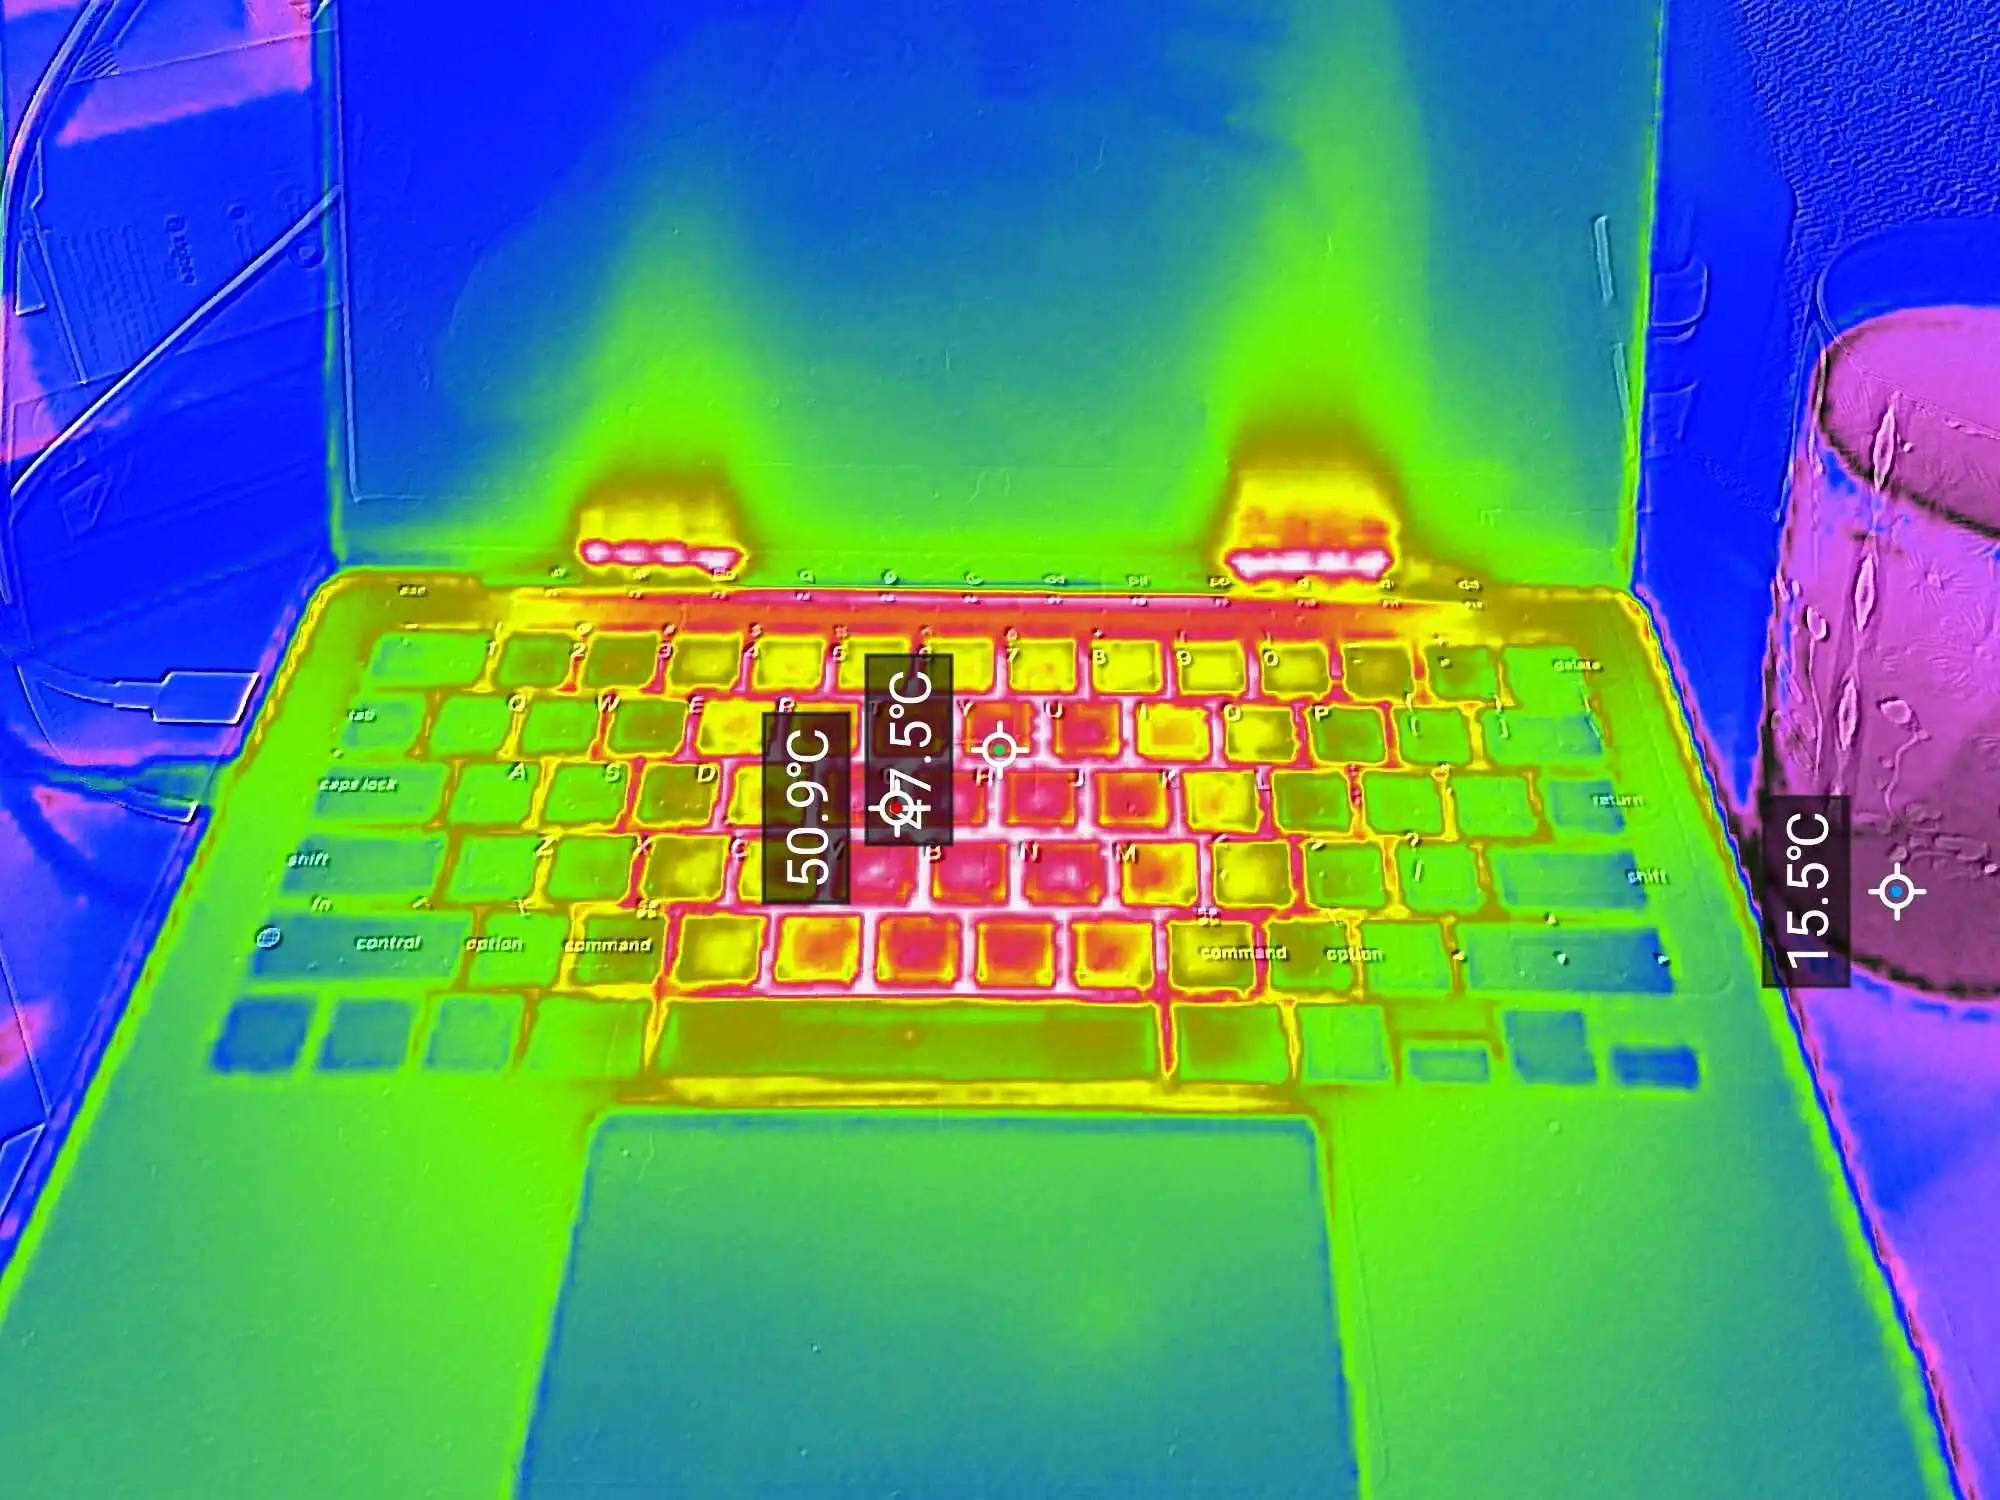
Пока отлаживал, нашёл пару досадных багов в исходной программе. Получается, зря мой ноутбук трудился, результат всё равно можно было бы выкинуть.
Функции переполнения у меня используются вот так:
#define MUL2_ADD1(x) ({ \
    typeof(x) y; \
    __builtin_mul_overflow(x, 2, &y) || __builtin_add_overflow(y, 1, &y) ? 0 : y; \
})
Были сомнения будут ли они работать
Любопытно, что мой ноутбук на процессоре M3 Max справился с перебором за 57 минут, тогда как компьютер с Intel Core
В результате нашлось 14434686 значений, из них нечётных подряд — 172 значения, потом появляются «дырки».
Нечётные числа: прогресс
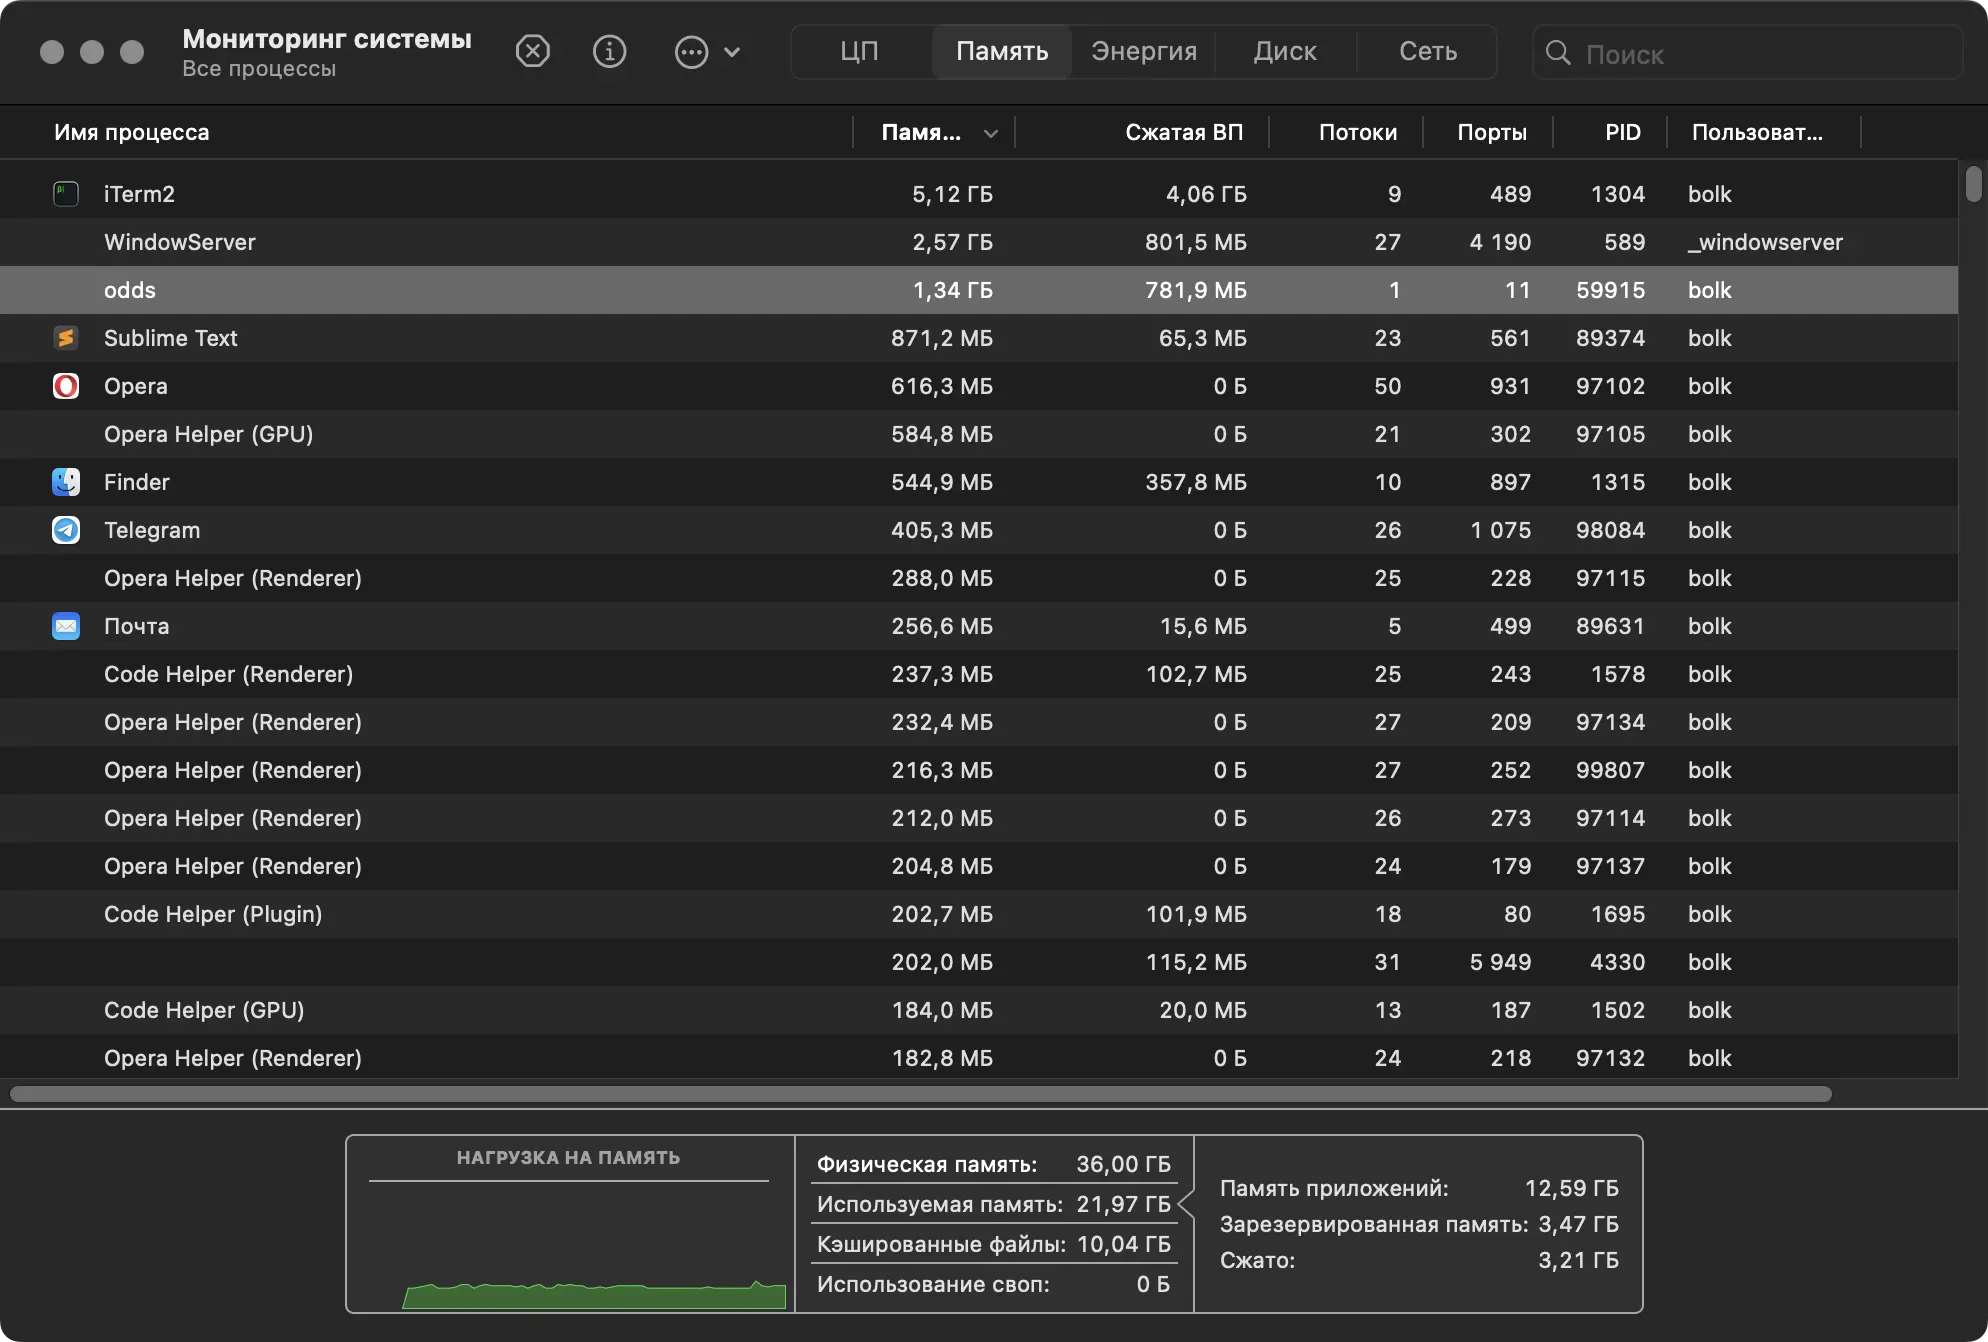
Пока по поиску нечётных чисел прогресс такой. Программа работает уже чуть больше 25 часов. Самое большое найденное на этот момент число — 340281726619687019118949463859138658303 или 0xFFFFE06E43129C9EBA1E335BA7FFFFFF в шестнадцатеричном виде. Как мы видим, предел точности близок.
Всего пока найдено 36,5 миллионов чисел, список чисел занимает 1,2 гигабайта.
Добавлено:
Добавлено:
Добавлено:
Добавлено: 63 часа работы, найдено 57,3 миллиона чисел, новое самое большое число — 0xFFFFE0EC9B9F17FFFFFFFFFFFFFFFFFF или 340281736629840009040727513758703812607.
Нечётные числа
Что же я там считаю такое, что мне понадобились
Коллега в офисе, который
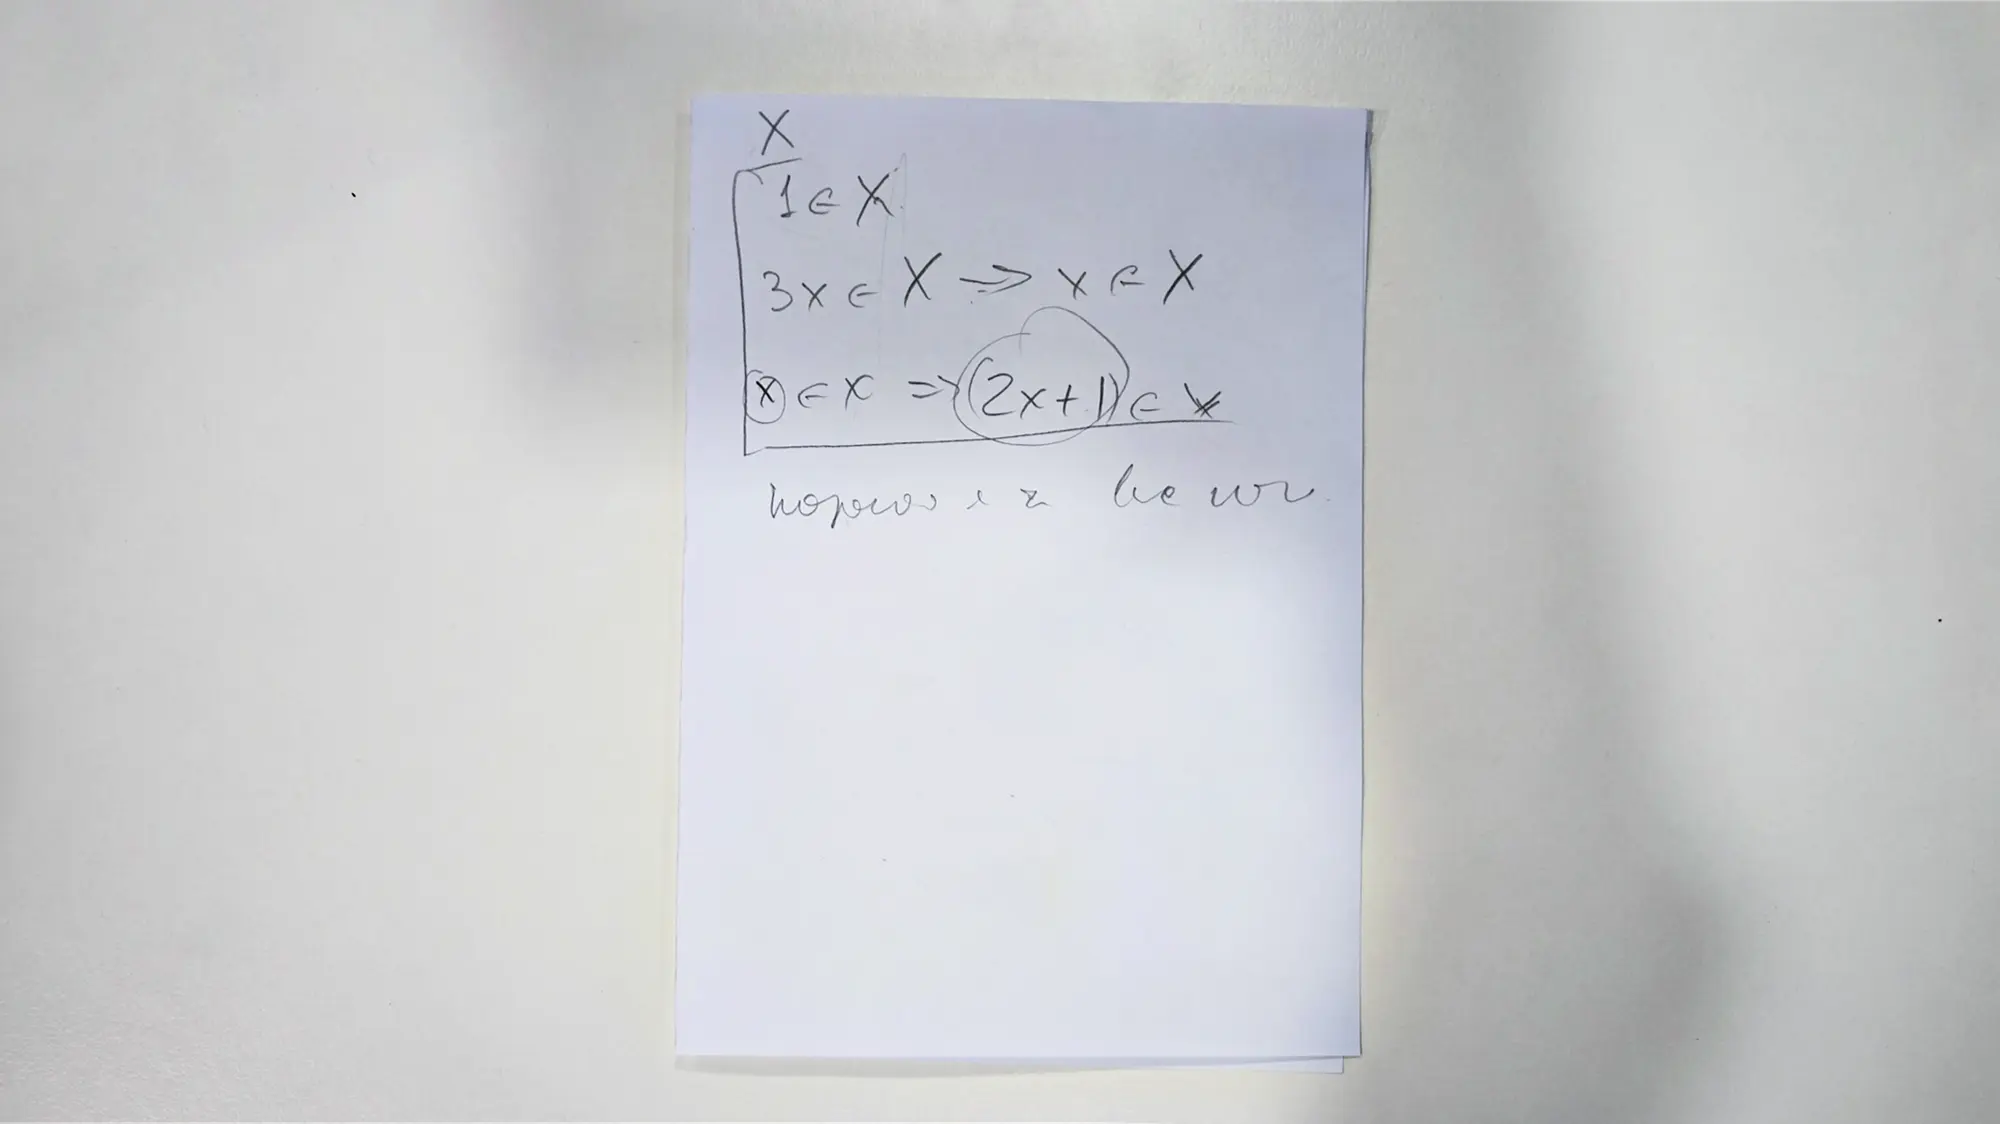
Формулировка у неё была очень простая.
Дано множество X. Единица принадлежит X. Если 3×x принадлежит X, то и x принадлежит X. Если x принадлежит X, то и 2×x + 1 принадлежит X. При этом x — натуральное, разумеется.
Требуется доказать, что таким образом можно получить множество всех натуральных нечётных чисел. Авторы статьи, кстати, были убеждены, что найти доказательство у читателей не получится.
Упомянутый коллега у себя в университете при помощи студента, Фортрана и Пролога пытался проверить эту теорему по следующему алгоритму.
Берём число, например, «9». Оно могло быть получено, согласно перечисленным утверждениям, двумя путями: либо
В этой задаче очень быстро растёт разрядность, поэтому в те времена рассчитать даже первую сотню чисел было достаточно проблематично.
В общем, я решил с этой задачкой побаловаться.
Для начала написал программу, которая вычисляет эти числа перебором. Начинаем, понятное дело, с единицы, следующее число получаем по формуле 2×x + 1, потом, пока число делится на три, делим и выводим эти числа, считая для каждого ещё и 2×x + 1 и так далее. Кроме того, пришлось ещё запоминать все найденные числа, чтобы избегать циклов.
Первую версию я написал с использованием рекурсии, но программа падала примерно через полторы минуты работы — стек просто кончался. Пришлось переписать. Новая версия работает уже несколько часов на моём ноутбуке и вычислила за это время уже почти 17 миллионов чисел. Оставлю её на ночь, интересно, закончит ли она к утру.
128-битный тип в Си
В одной из программ на Си мне понадобился
Мой компилятор _BitInt(128) прекрасно поддерживает, казалось — счастье так близко, но…
Каково же было моё удивление и разочарование, когда оказалось, что в языке нет ни способа вывести его на экран (у printf нет необходимого спецификатора формата), ни способа задать константу такого размера!
( (_BitInt(128) ) 0xFFFFFFFFFFFFFFFF << 64) | 0xFFFFFFFFFFFFFFFF
PowerShoot

Ну
Играть, правда, получится только на «МакБуке». Думаю, несложно будет адаптировать игру под терминал любой операционной системы, было бы желание.
Геймплей простой — на вас бегут враги, надо убивать их бомбами. Игрок бросает бомбу, когда «МакБук» подключается к зарядке. Чтобы бросить две бомбы, надо подключить его, потом отключить, потом снова подключить.
Врагов больше двух не бывает, но сложность в том, что игра реагирует на подключение зарядки с задержкой. Кроме того, можно в теории убиться собственной бомбой — пространство зациклено.
Добавлено: как справедливо заметил один из читателей, такие действия могут влиять на оставшееся количество циклов зарядки батареи ноутбука, но прошу не относиться к этой игре серьёзно, она, конечно же, сделана была в шутку, чтобы развеяться.
Bash HTTPd
У писателя Леонида Каганова, который в последние годы ушёл в айти, началась
Я ему сегодня утром пытался хоть
В процессе там понадобился
Обошлись
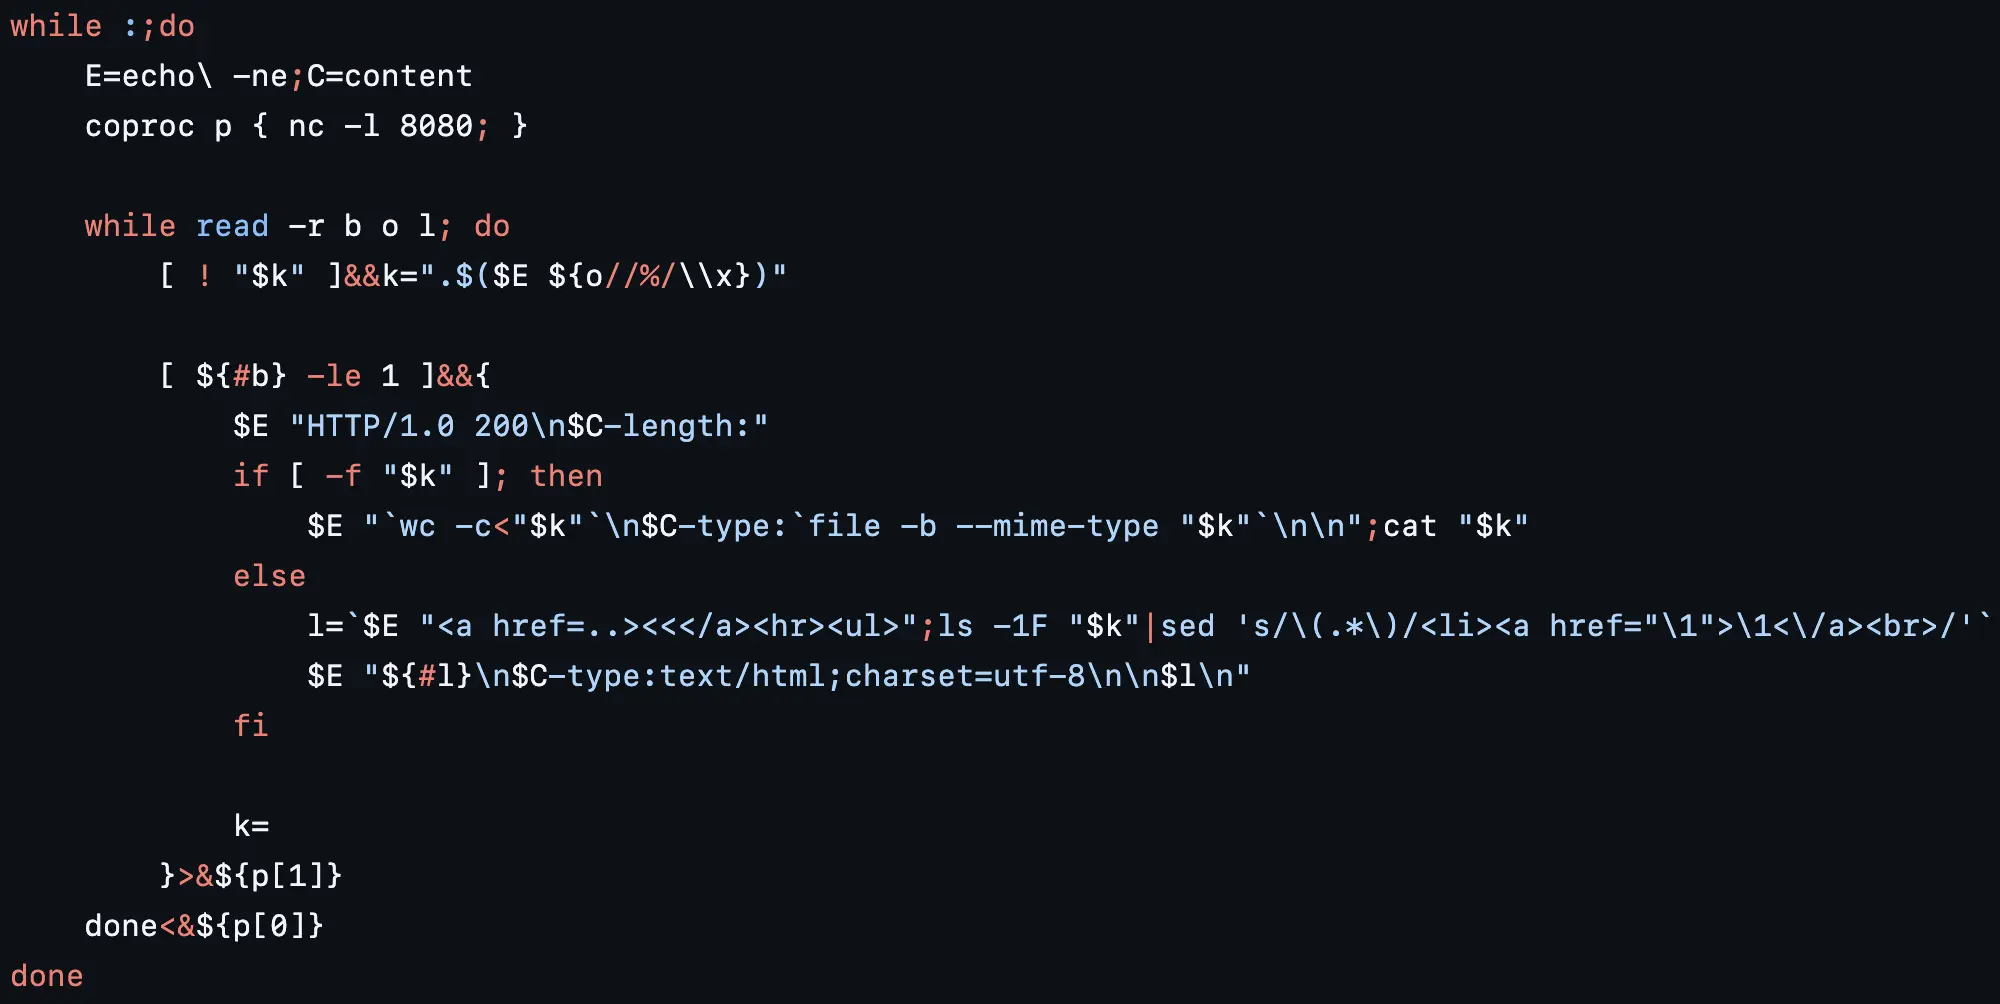
В общем, мне стало
В процессе код стал занимать меньше места (моя минифицированная версия на 25 байт короче), научился обрабатывать имена, содержащие пробелы и национальные символы и заработал не только под «Линуксом», но и под «Макосью».
Тип «‟char”»
Недавно я узнал, что, кроме text, varchar и char, в Постгресе есть ещё и строковый тип "char", именно так, в кавычках. Используется во внутренних таблицах Постгреса для простого перечисления. Интересен тем, что занимает ровно один байт, в отличие от более известных типов, которые во внутреннем представлении хранят ещё и свою длину, поэтому всегда занимают больше.
Использования его в своих таблицах, наверное, лучше избегать, но знать про него интересно. Кстати, есть ещё и тип name, который всегда занимает 64 байта и используется для хранения имён объектов, но, как по мне, он не такой интересный.
Perl 1
Перл — один из языков, которые помогли мне
Я тут недавно сообразил, что программирую на ПХП с третьей версии, однажды попробовал в действии вторую версию
К счастью, его исходники довольно просто найти, причём

К первой версии идёт пятьдесят тестов, написанных на Перле тех времён. Я бегло их просмотрел и, на первый взгляд, язык как будто мало изменился, тем не менее
Для интереса попробовал запустить небольшую программульку для подсчёта количества счастливых билетов, которую я
for ($i = 0; $i <= 999999; $i++)
{
    $a = ('0' x (6 - length($i))) . $i;
    $c++ if (substr($a, 0, 1) + substr($a, 1, 1) + substr($a, 2, 1)) ==
    (substr($a, 3, 1) + substr($a, 4, 1) + substr($a, 5, 1));
}
print "$c\n";
Вот что пришлось исправить: изменить синтаксис цикла, ну и скобок побольше наставить.
Производительность, кстати, изменилась значительно — первая версия выполняет эту программу за 1,7 секунд, а современный Перл на том же оборудовании — за 0,8 секунды.
Bash The Wumpus
Образовалась на днях у меня в голове доброкачественная идея — сделать
Директории будут комнатами, ходить
Для реализации выбрал тот же классический квест
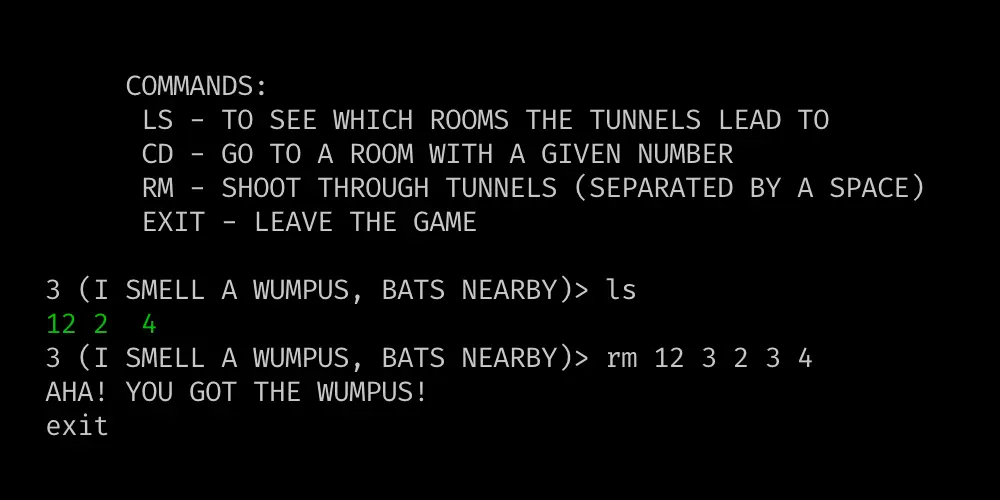
В соответствии с идеей, помещения у меня представлены директориями, а переходы между ними — символическими ссылками. Соответственно, Вампус и прочие опасности, — ямы и летучие мыши, стали файлами.
В первой версии у меня всё было организовано обычными командами. Кроме упомянутой cd, вполне естественным способом заработали ls и pwd, а так же команда rm, которая уничтожала
К сожалению, это было слишком похоже на «молдавский вирус» («ввиду общей отсталости развития высоких технологий нашей страны, пожалуйста, сотрите сами несколько самых нужных вам файлов, а затем разошлите меня по почте своим друзьям»), пришлось добавить командам
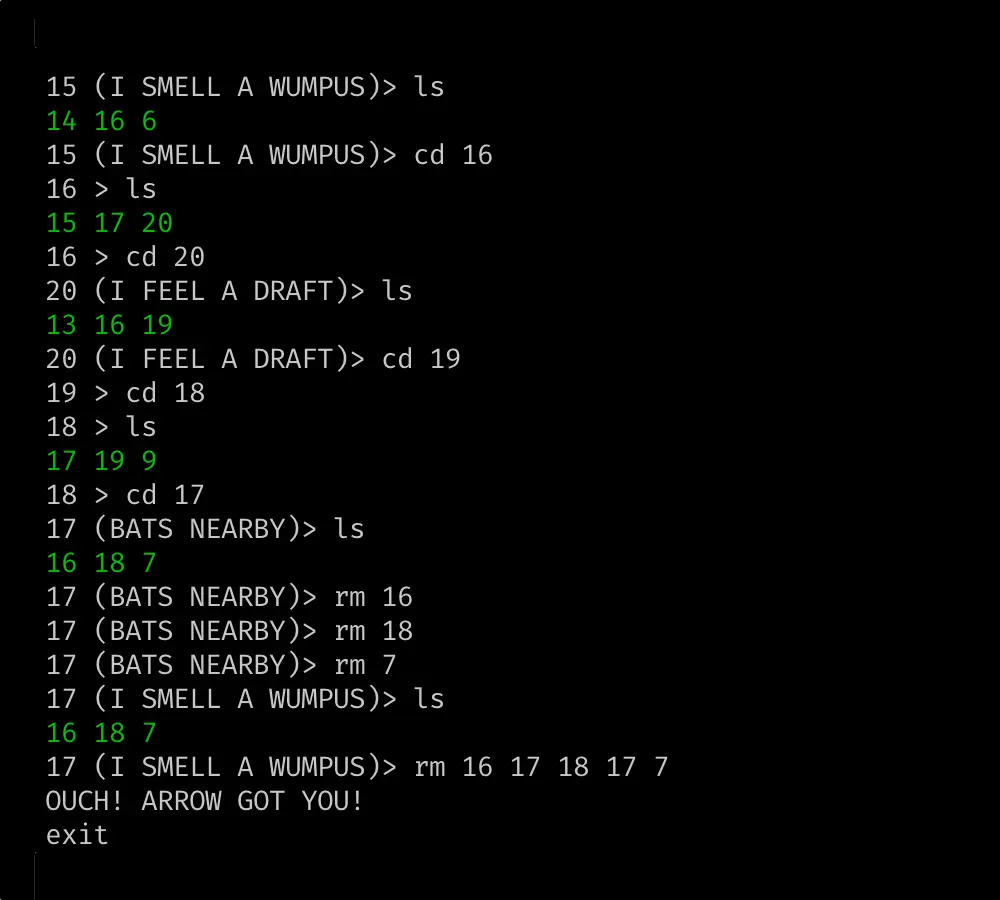
Сначала я сделал проверки через trap сигнала DEBUG и обработку произошедшего через скрипт, который запускается из переменной подсказки PS1, но в итоге пришлось подменить ряд команд алиасами и вызовами функций.
Чтобы сохранить вайб консоли семидесятых, сообщения в игровом процессе и инструкцию я взял из оригинальной игры и оставил всё в верхнем регистре, как и в оригинале.
Поскольку команды подаются в консоли, можно выиграть почти сразу, если знать парочку фокусов. Я постарался осложнить их использование, но все возможности не закрыл, это противоречит изначальной идее.
Игра, как обычно, выложена на «Гитхабе».
Си 23
Посмотрел список изменений, в глаза мне бросилось следующее.
Удалили старый синтаксис функций, где можно было описывать типы аргументов после определения функций. А я про него и
Атрибуты функций можно теперь писать в синтаксисе Си++, то есть в виде [[атрибут]]. Это очень хорошо. Так они лучше различимы, в отличие от спецификаторов, и имеют собственное пространство имён.
Изменили действие ключевого слова auto. В Си оно обозначало класс хранения, причём
Функции с пустым списком аргументов будут обрабатываться, как функции без аргументов. Это тоже хорошо, потому что раньше было неочевидно. В своё время для меня открытием было, что функции без аргументов должны в Си задаваться через синтаксис func(void), правда я в коде так всё равно не делаю.
Прекращена поддержка триграфов. Это, конечно, хорошо, но жалко. Речь идёт об альтернативных конструкциях в языке, которые были введены
Добавили конструкцию #embed, которая позволяет включать в код бинарные данные. Тоже здорово, в игре «Морской бой», выпущенной ко Дню радио мне пришлось включать игру на Луа внутрь сишного кода внешними утилитами, а теперь можно это делать одной директивой.
Остальные изменения тоже полезны, буду знакомиться, но эмоционального отклика не вызвали.
«Вампус» для The Sensor Watch
Мою игру для часов, порт текстового квеста
Вчера разобрался с миганием текущего сегмента, сделал его быстрее,
Я ещё и ошибку там поправил, анализатор при компиляции мне её нашёл — я проверял, что после вычитания количество стрел будет меньше нуля, что означает, что стрелы кончились, при этом тип у меня был беззнаковый, то есть меньше нуля числа в этой переменной стать просто не может.
Марковские цепи
Сейчас время колоссального интереса к нейросетям, видимо поэтому меня не оставляет мысль вставить в игру
Но вставлять в игру, занимающую около мегабайта, любую, даже самую маленькую БЯМ (большую языковую модель) — странная идея. Размер возрастёт в десятки раз, а фана будет — чуть.
Поэтому я решил попробовать использовать марковские цепи. Марковская цепь — это, если очень упрощать, состояния и вероятности перехода между ними.
Засовываем в неё готовый осмысленный текст, цепь подсчитывает вероятности перехода между токенами (чаще всего это слова) и дальше её можно попросить продолжить произвольный текст на ту же тему.
У меня была идея скормить ей достаточное количество разговоров из книг «Слова пацана» и «Казанский феномен: миф и реальность», чтобы получать
Конечно, я посидел над этом идеей всего один вечер, но, кажется, качественного скачка не произойдёт, сколько не сиди. Удачные диалоги встречаются, но чаще всего видно, что модель мира там отсутствует полностью.
Зато, когда я скормил цепи тексты матерных загибов, получился довольно качественный генератор мата, правда с очень архаичным языком. Там, среди отборного мата, попадается упоминание небесного царя, архиереев и прочей религиозной атрибутики. Что неудивительно, конечно, — этим загибам не одна сотня лет.
Примеры приводить я не буду, мне
Не знаю, продолжать ли заниматься этой идеей или нет. Пока не решил. В игре есть несколько багов, которые тянутся ещё из оригинального кода, можно было бы их поправить вместо этого.
PVS-Studio и «Гопник-2»
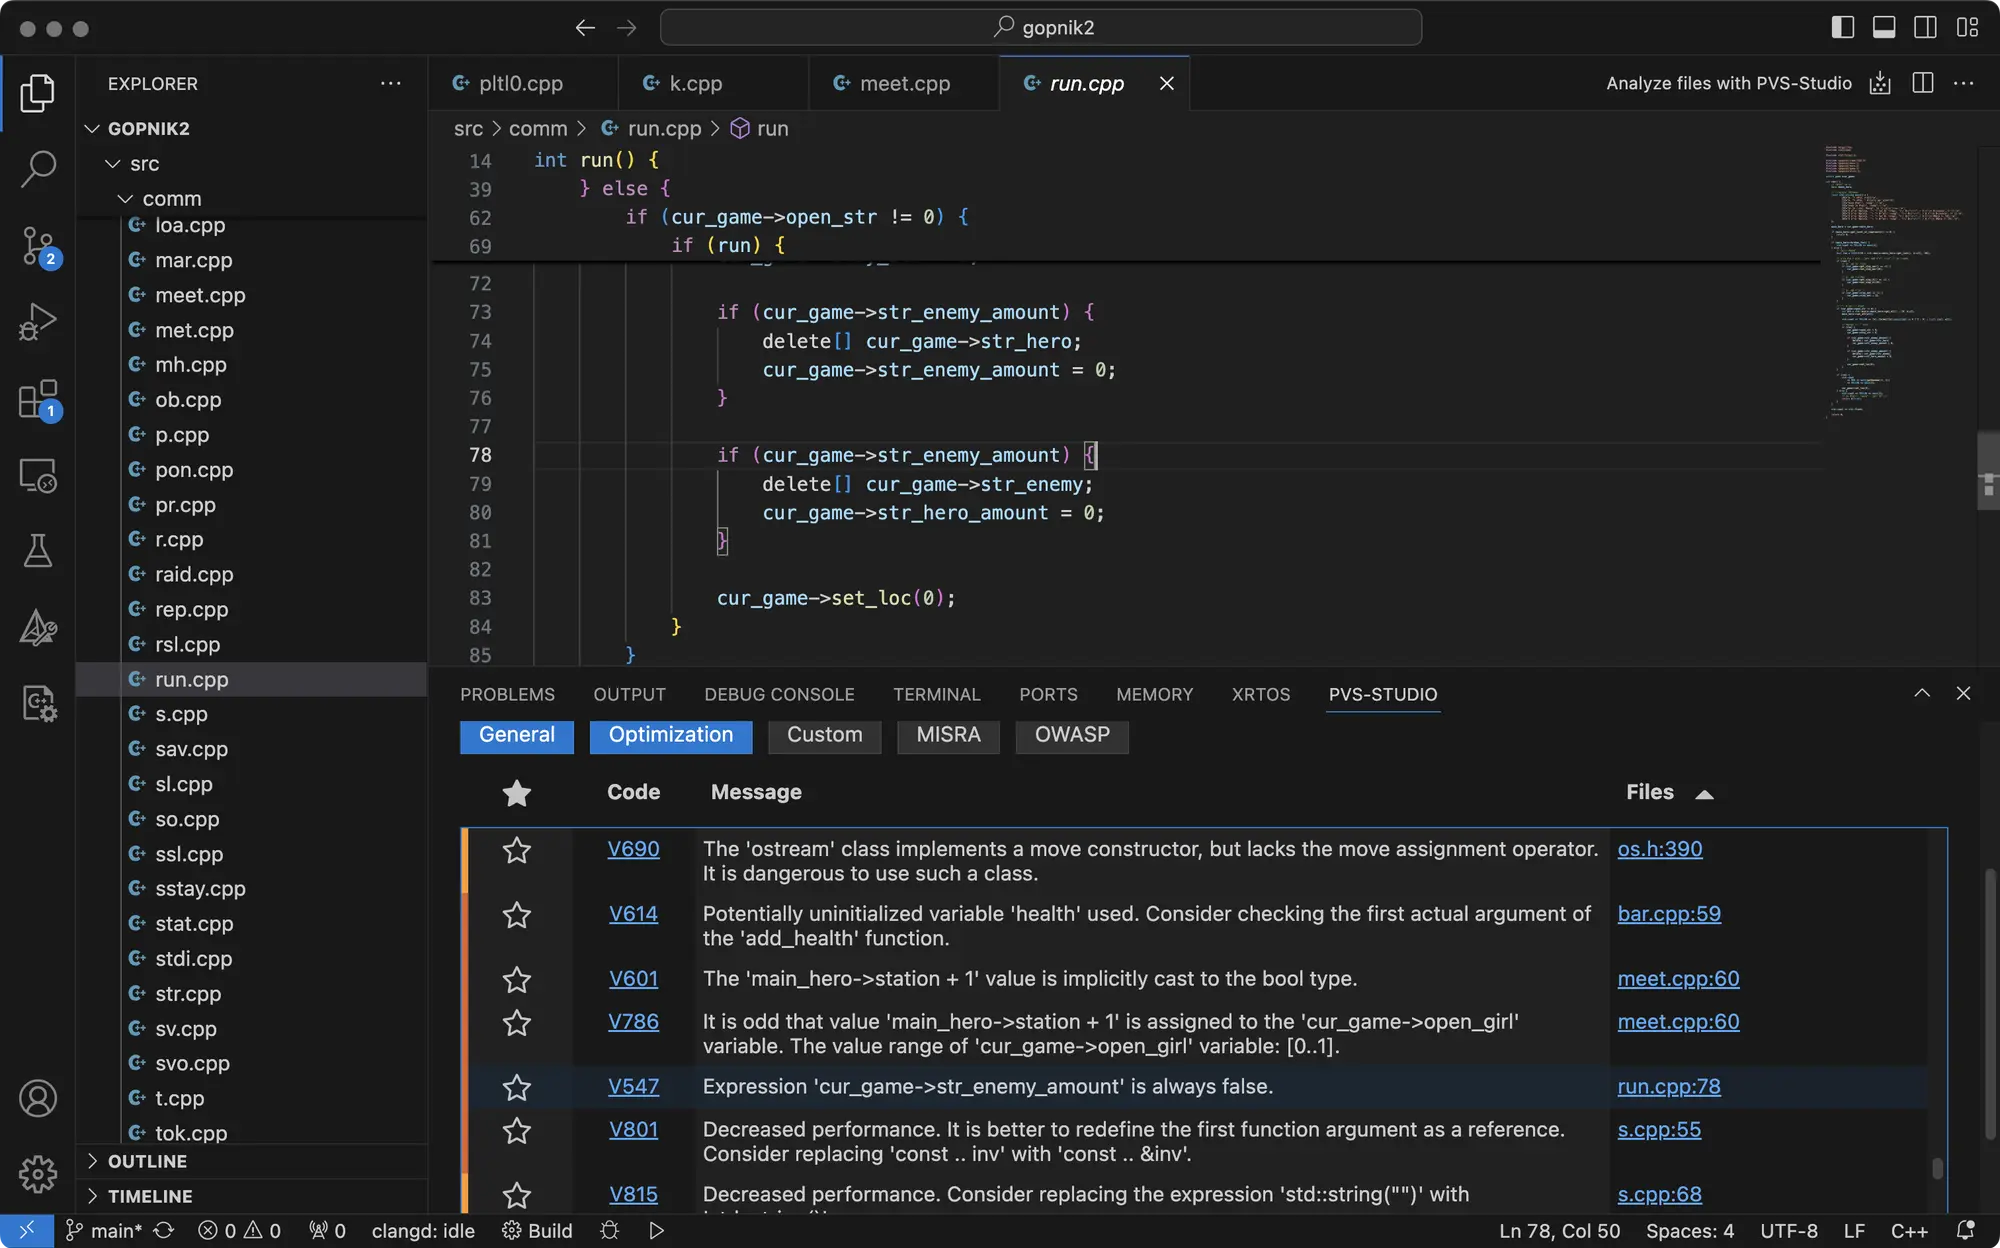
Много читал об инструменте статического анализ
Нашлось несколько интересных ошибок. На скриншоте одна из них. Как видно, str_enemy_amount проверяется два раза, тогда как после первого условия там гарантировано ноль. Очевидно автор этого куска кода его скопипастил, но забыл во втором куске исправить enemy на hero.
Я бегло посмотрел все ошибки, которые он мне выдал, надо будет внимательно посмотреть каждую, но как будто бы всё по делу, ноль ложных срабатываний.
В какой кодировке?
Попался мне недавно на глаза вот этот разворот из детской книжки «Энциклопедия профессора Фортрана»

Сразу бросается в глаза, что бинарные строки справа не восьмибитные, как мы все привыкли, а на бит короче. Ещё, при внимательном рассмотрении, в закодированных числах узнаются пробелы, у них код 32 или 0100000. Только первый
Всё это меня очень заинтересовало, я отложил себе эту картинку, а сегодня, по пути домой, разобрался в этих странностях.
Воспользовавшись программой для распознавания, я перевёл текст на картинке в буквы и цифры, вырезал оттуда закодированное и попробовал перегнать этот кусок в буквы. Получилась следующая строка: pro~itajte glawu "qzyki programmirowaniq".
Теперь осталось понять что это за кодировка. Не уверен, что я
Латинские символы видно, потому что эта кодировка содержит в себе несколько наборов символов, которые надо переключать специальным кодом. Русские символы находятся в тех же позициях, что и латинские, а поскольку кодировка
В конечном счёте, я написал небольшую программу на Перле, чтобы вывести строку на русском:
#!/usr/bin/perl
use Text::Iconv;

my @codes = qw(
    1110000 1110010 1101111
    1111110 1101001 1110100
    1100001 1101010 1110100
    1100101 0100000 1100111
    1101100 1100001 1110111
    1110101 0100000 0100010
    1110001 1111010 1111001
    1101011 1101001 0100000
    1110000 1110010 1101111
    1100111 1110010 1100001
    1101101 1101101 1101001
    1110010 1101111 1110111
    1100001 1101110 1101001
    1110001 0100010
);

$conv = Text::Iconv->new("KOI-7", "UTF-8");

# ПРОЧИТАЙТЕ ГЛАВУ "ЯЗЫКИ ПРОГРАММИРОВАНИЯ"
print $conv->convert(chr oct "0b$_") for @codes, "\n";
Перл, конечно, малопопулярный язык, но тут вполне читаемый даже для тех, кто его не знает. Его я выбрал
В конечном счёте раскодированный текст выглядит так: ПРОЧИТАЙТЕ ГЛАВУ "ЯЗЫКИ ПРОГРАММИРОВАНИЯ". Лобастый Новосельцев немного нас обманывает.
Casio WQV-3
К заметке, где я писал про камеру для «Флиппера», один из читателей прислал ссылку на часы «Casio
Разумеется я загорелся их купить.
На «Ебее» их можно найти без проблем, но с пересылкой часов через границу сейчас большие проблемы. Без особой надежды я пошерстил «Авито» и оказалось, что, хотя первой модели часов там нет, зато лежит третья, которую я тут же себе купил и ношу уже несколько дней.
Оцените какой
Всего в линейке таких часов было четыре модели с номерами «1», «2», «3» и,
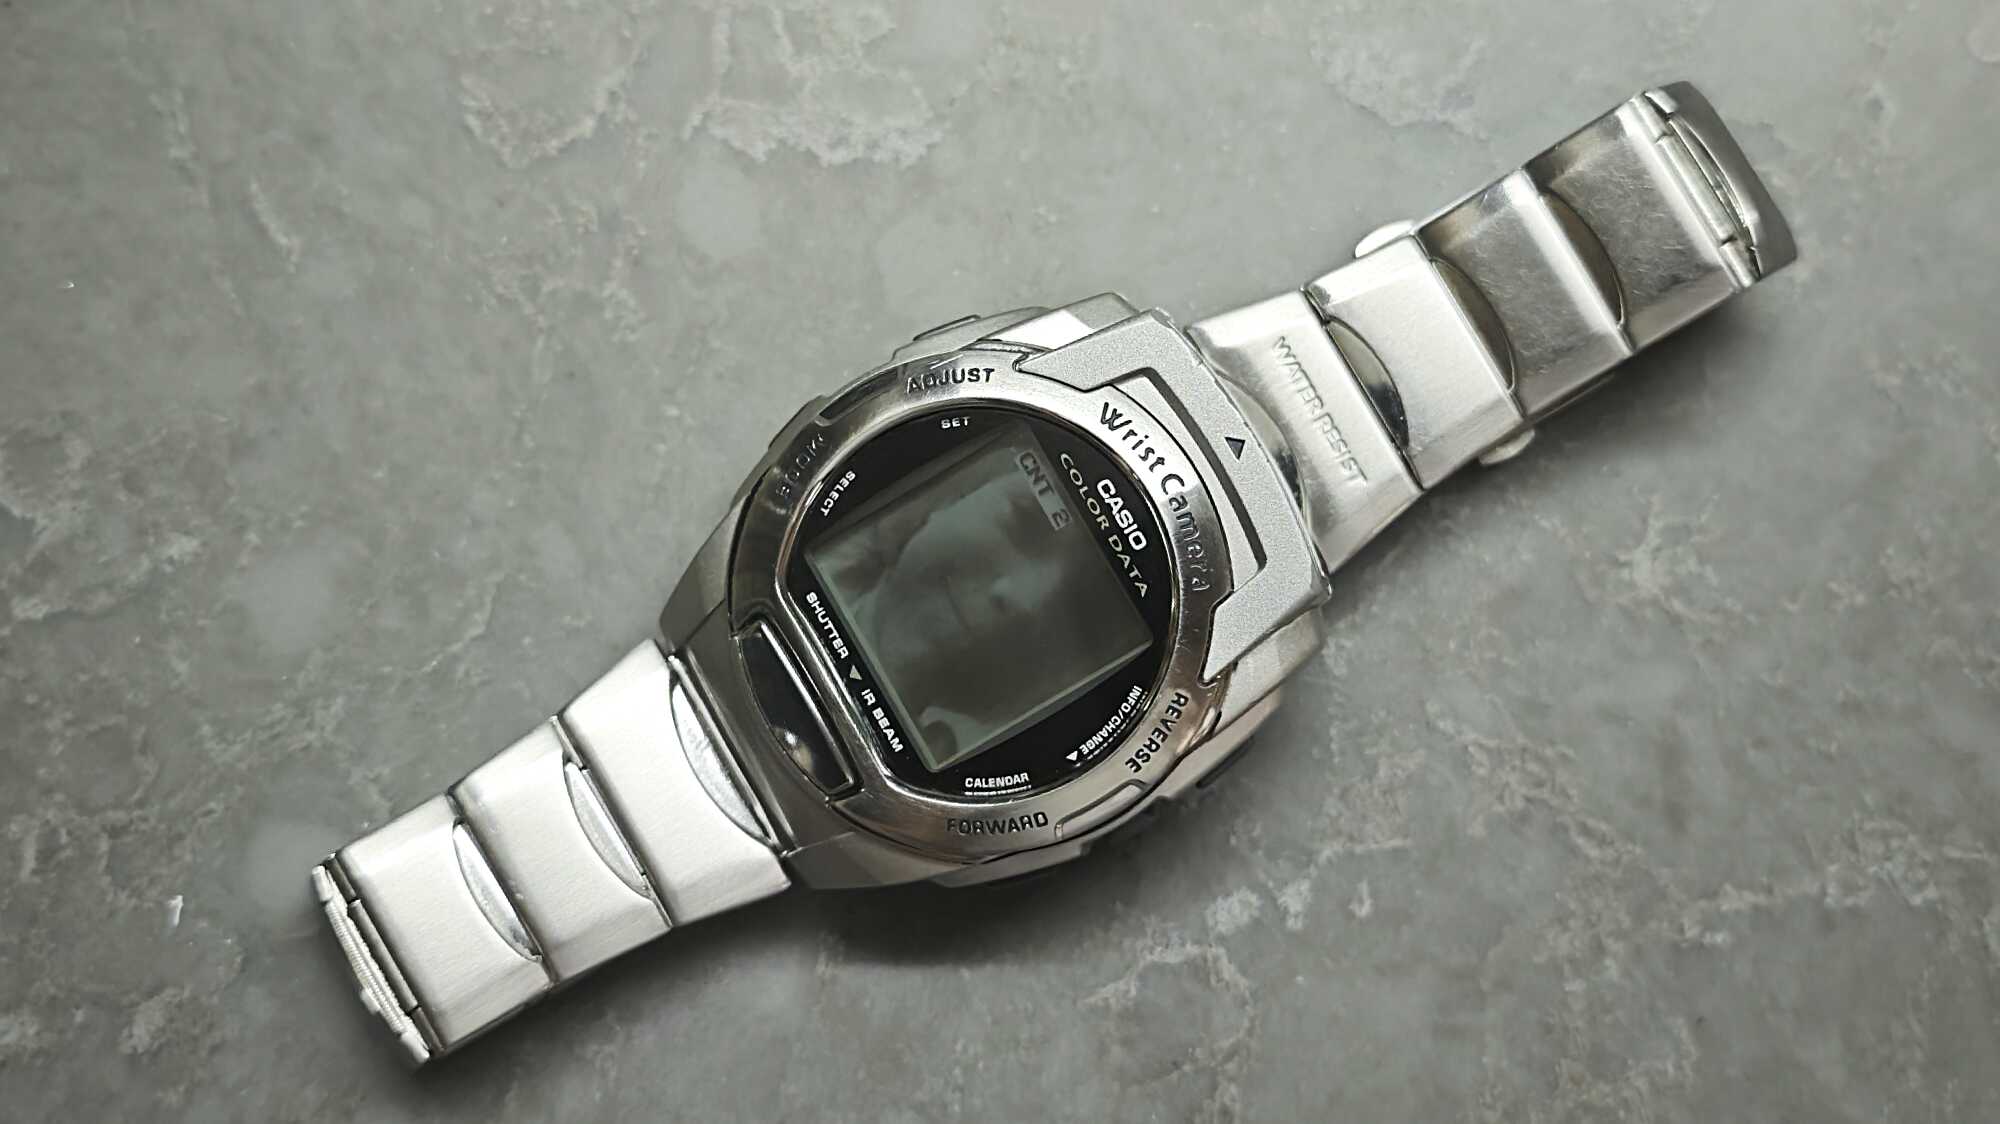
Конечно снимки хочется из часов
Под рукой, из того, что поддерживает инфракрасный обмен, у меня только «Флиппер». В принципе, если знать протокол, можно под него написать программу, которая списывала бы снимки на карточку, оттуда перекинуть на ноутбук — ноль проблем.
Описание протокола найти было нетрудно. Но позже оказалось, что в третьей модели «Касио» перешли на некий стандартный протокол передачи, а его описание я ещё даже не искал. Возможно, раз протокол стандартный, снимки можно получить
Я немного посмотрел АПИ для работы с инфракрасником во «Флиппере» и, пока не забыл узнанное, сделаю заметки для себя.
Для передачи сигналов подойдёт одна из двух функций. Если повезёт это будет infrared_send, которая принимает команды в одном из стандартных кодеков, либо infrared_send_raw_ext, где придётся возиться с ручным кодированием битов.
Зависит от того, что за кодировка сигналов используется в этом самом «стандартном протоколе». Если это
Наименее очевидными были для меня тайминги. Я
Программа с именем 0xFF
В ДОСе, как может
Поэтому странно, что пробельных символов в ней два, один из них — обычный пробел с кодом 32, именно его операционная система считает пробелом, второй — с кодом 255, он выводится как пробел, но считается обычным символом.
Не помню, использовалось ли это свойство
А 255 символ запретили? 30 лет назад, еще под MSDOS, переименовали утилиту переворота экрана в 255 символ и вставили в autoexec.bat. Хозяин компа уже психовать начал и монитор переворачивать :)) Показали ему прикол…
Ну то есть переименовали программу так, чтобы её имя выглядело как пробельный символ и добавили её в скрипт автозагрузки. Хозяин компьютера, видимо, проверял скрипт, ничего не находил и не понимал что происходит.
Мне стало интересно проверить — действительно ли это работает? Благо ДОС можно сейчас запустить даже в браузере.
Тут надо пояснить, что «настоящий» пробел для этого не годится — ДОС просто не распознает его в автозагрузке как имя файла для запуска.
Я не знаю как раньше вводили символ с кодом 255 в командную строку, поэтому просто набросал программу на ассемблере, которая переименовывает файл mem.exe (которая обычно есть в составе ДОСа) в .com:
org 100h

section .data
    oldName db 'MEM.EXE', 0
    newName db 255, '.COM', 0

section .text
global _start

_start:
    mov ah, 56h
    lea dx, oldName
    lea di, newName
    int 21h

    mov ax, 4C00h
    int 21h
Необходимое пояснение: расширение обязательно, иначе ДОС не поймёт, что файл запускаемый. При запуске его можно не указывать — операционка догадается сама что именно подставить.
На следующем шаге я скомпилировал программу у себя прямо в «МакОСи» и вывел в шестнадцатеричном виде:
$ hexdump -C <(nasm -f bin rename.asm -o /dev/stdout)
00000000  b4 56 8d 16 14 01 8d 3e  1c 01 cd 21 b8 00 4c cd  |.V.....>...!..L.|
00000010  21 00 00 00 4d 45 4d 2e  45 58 45 00 ff 2e 43 4f  |!...MEM.EXE...CO|
00000020  4d 00                                             |M.|
00000022
Далее набрал её в кодах при помощи команды DEBUG и запустил. В текущей директории появилась программа с нужным именем:

Для последнего шага мне нужно было
Попробовал запустить, сработало!
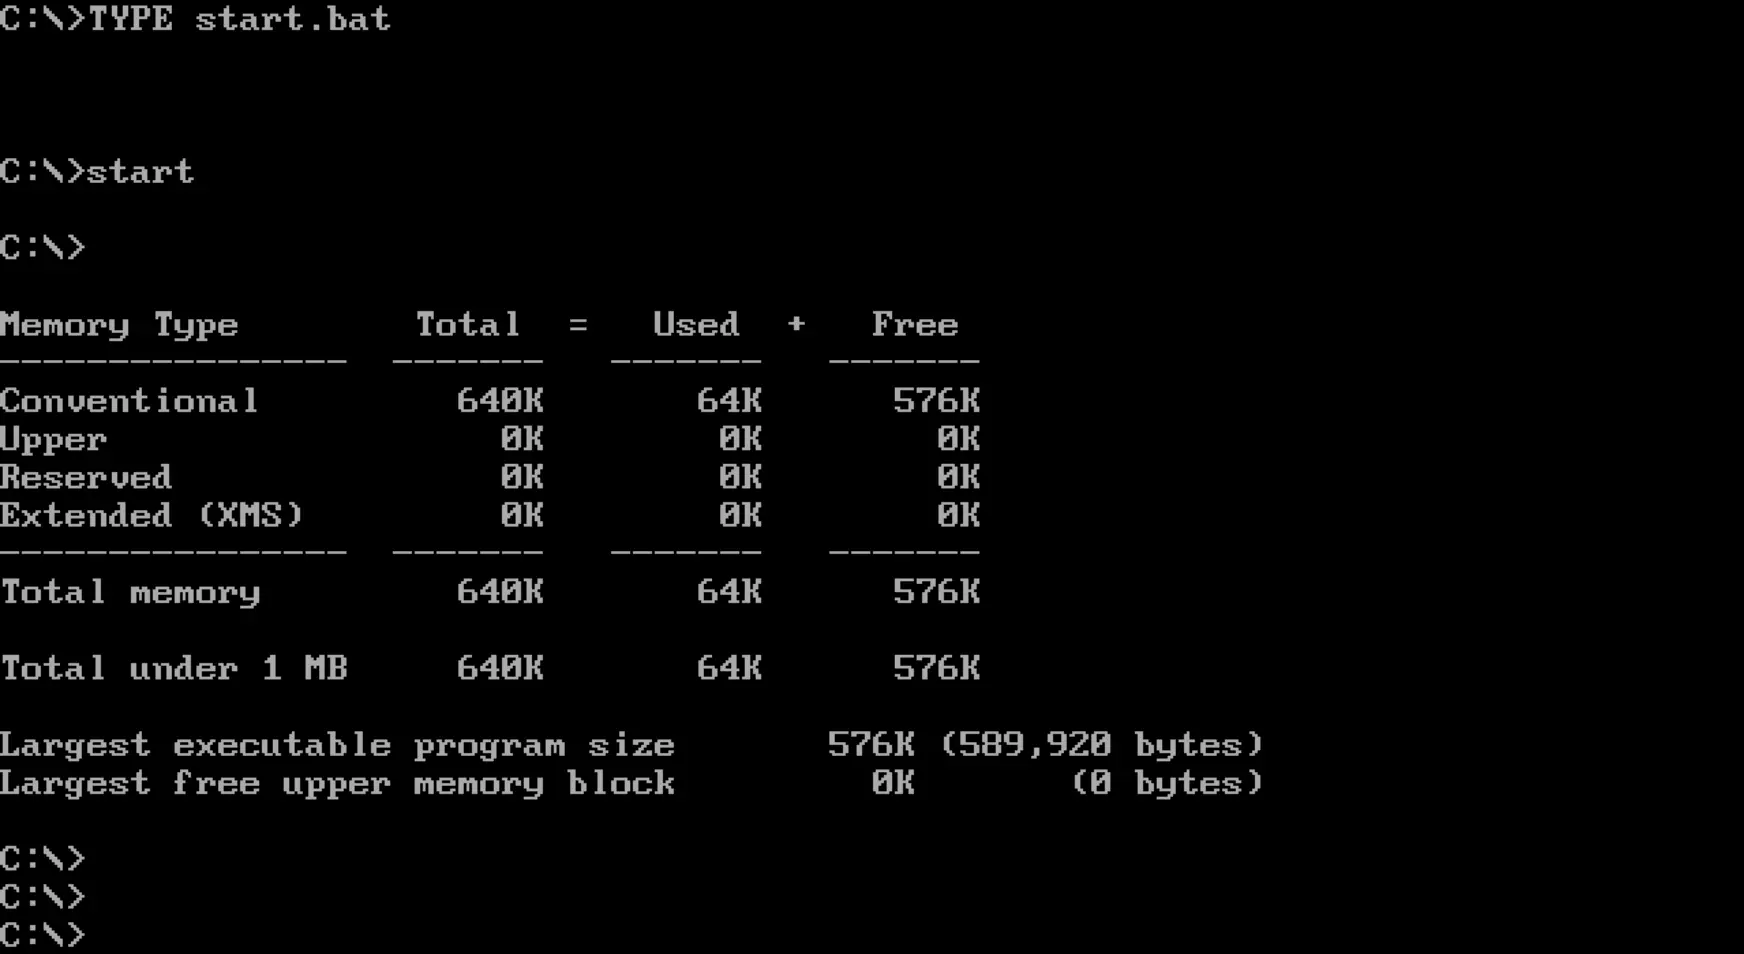
Замена цифр
Придумал тут штуку интересную. Как у я уже писал ранее, полюбилось мне
Сначала я сделал достаточно просто, — отредактировал раскладку, которой я пользуюсь. Мне не нравилось это решение, так как пришлось выкинуть из неё
А сегодня мне пришло в голову решение лучше — попробовать обойтись функцией «Замены текста», которая встроена в «МакОСь». Мысль простая — заменять двоеточие и две цифры на то же самое, но без двоеточия и в верхнем индексе. Сначала я пытался набрать всё нужное руками, а потом случайно нашёл функцию импорта.
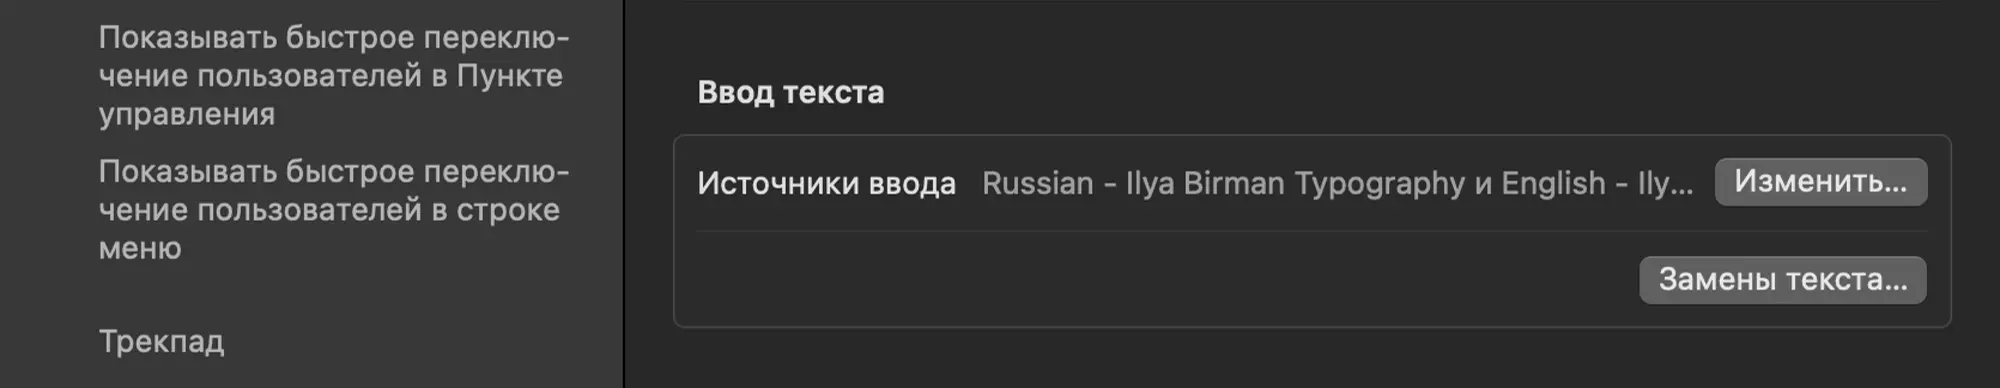
Формат для импорта оказался довольно простым. После того как я в нём разобрался, накидал небольшую программу на «Пайтоне», которая мне за мгновение сформировала нужный файл.
print("""
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE plist PUBLIC "-//Apple//DTD PLIST 1.0//EN" "http://www.apple.com/DTDs/PropertyList-1.0.dtd">
<plist version="1.0">
<array>""")

trans = str.maketrans("0123456789", "⁰¹²³⁴⁵⁶⁷⁸⁹")

for i in range(0, 60):
	print(f"""
	<dict>
		<key>phrase</key>
		<string>{f"{i:02d}".translate(trans)}</string>
		<key>shortcut</key>
		<string>:{i:02d}</string>
	</dict>""")


print("</array></plist>")
Чтобы его импортировать, нужно перейти в «Системные настройки…», оттуда в «Клавитуру», там нажать на кнопку «Замены текста…» и перетащить на открывшийся список получившийся файл.
После этого можно проверить что получилось, — если написать в любом месте «13:00», оно должно само преобразоваться в «13⁰⁰».
Доделал приложение пароля для «Войи»
Глаза боятся, руки делают.
Начал потихоньку — накидал сначала

В этот раз столкнулся
Чтобы получить стрелку в другу строну, повернул её в редакторе, проделал всё то же, что с первой, но при отображении стрелка получалась
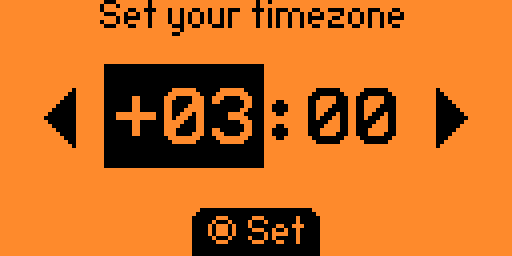
Как я уже рассказывал, инструментарий для компиляции программ сам конвертирует картинки в нужный «Флипперу» формат. Я не ковырял, но по виду это обычный XBM — формат двухцветной
Предполагаю, что при преобразовании входного изображения в двухцветное, используется
Сначала я решил это проверить. Поводил «пипеткой» на картинке, не нашёл. Нарисовал заново. Это ситуацию не исправило. Решил посмотреть в бинарном виде сконвертированные файлы, оказалось сложновато, плюнул. Пошёл смотреть в чём разница у исходных файлов. Оказалось, что один у меня в формате
Подумал, что проблема в этом, но как преобразовать одно в другое сходу не разобрался. Утилитой magick начал конвертировать проблемную картинку в PNG, перебирая все известные мне ключи подряд, пока в один момент дырки не пропали. Я так и не выяснил какое сочетание настроек мне помогло, потому что в процессе потерял исходную «дырявую» картинку, а делать новую не хотелось — мне ещё предстояло много программировать.
«Что это было, Бэрримор» — непонятно до сих пор, но на всякий случай записываю себе этот случай, чтобы в следующий раз хотя бы примерно понимать как с ним бороться.
Оператор «__has_include»
Одна штука мне очень не нравилась в программировании под «Флиппер». Фреймворк устроен так, что картинки, используемые в приложениях, должны внедряться определённым способом.
А именно — в манифесте приложения, в директиве fap_icon_assets мы указываем папку, каждая картинка в которой, позже, на этапе сборки, будет преобразована в специальный массив. Этот массив всегда называется I_имя_файла_картинки. Массивы засовываются в файл со специальным именем, который надо импортировать в код через #include.
Поскольку это происходит во время сборки, редактор (я использую «Визуал Студио Код») этот файл не видит, поэтому подчёркивает мне его импорт и все использования массивов, которые в нём описаны, как ошибку.
Лично меня такое раздражает. В редакторе мне хочется видеть полное отсутствие ошибок.
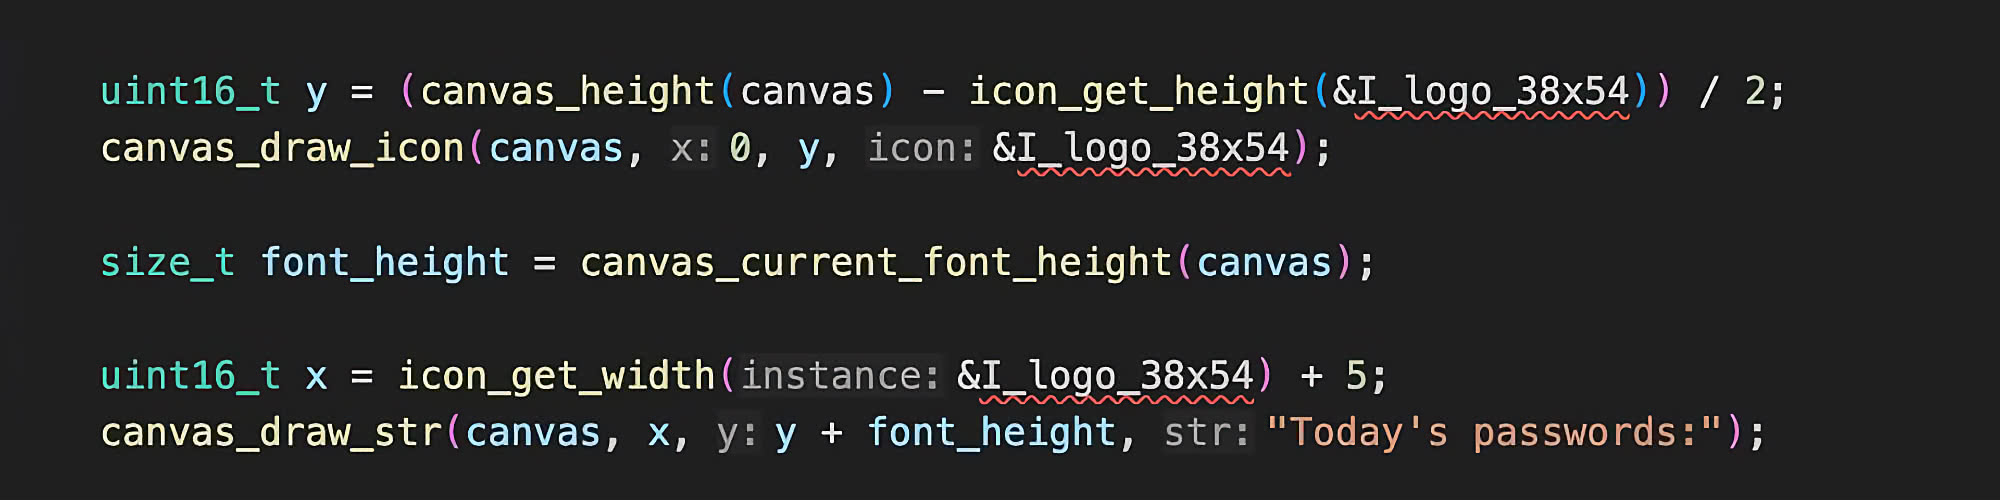
В «Виселице» я с этим смирился, а сегодня
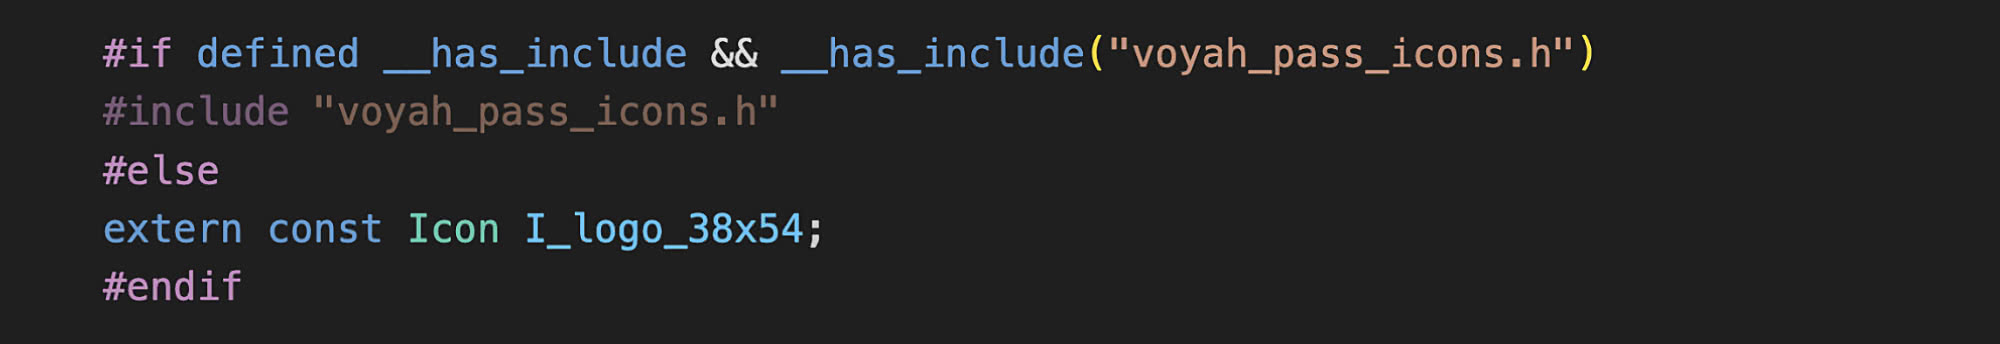
Получается, что если файл для импорта ещё не готов, то мы его не импортируем, а нужный нам массив объявляем, как имеющий внешнюю реализацию. В итоге, в редакторе ошибок не остаётся.