эр
XBM vs. Брайль
Мне в комментариях к предыдущей заметке задали в вопрос — а насколько графика, представленная шрифтом Брайля, проигрывает по размеру формату XBM? Я прикинул, что должна даже выигрывать —
Давайте посмотрим
#define bullet_width 7
#define bullet_height 7
static char bullet_bits[] = {
   0x1c, 0x3e, 0x5f, 0x3f, 0x5d, 0x2a, 0x14};
Что мы тут видим? Почти восемьдесят байт служебной информации, форматирование, от которого, впрочем, можно избавиться и информация о пикселях. Причём пиксели задаются группами по восемь числом в шестнадцатеричном виде и каждое такое число занимает пять байт вместе с запятой.
В итоге размер файла можно примерно оценить на как 77 + 7×7/(8/5) ≈ 107 байт. В реальности чуть больше
Если же перевести эту картинку в шрифт Брайля, то всё получится куда компактнее. Каждый символ шрифта занимает три байта и кодирует сразу восемь точек (2×4), плюс надо учесть в расчётах переводы строк: ceil(7/4) × (ceil(7/2) × 3 + 1) = 26 байт.
А есть ли условия, при которых XBM был бы компактнее его представления в Брайле?
Логика подсказывает, что это должны быть
Я наугад выбрал разрешение 1×100 и угадал: 77 + 1×100/(8/5) ≈ 140 байт против ceil(1/4) × (ceil(100/2) × 3 + 1) = 151 байт.
Добавлено позднее: я не знаю как решить задачу нахождения этого порога аналитически, поэтому решил перебором, написав программу на языке R:
lhs <- \(w, h) ceiling(w/4) * (3 * ceiling(h/2) + 1)
rhs <- \(w, h) 77 + (5 * w * h) / 8

holds <- \(w, h) lhs(w, h) > rhs(w, h)

W <- 500
H <- 500

min_h <- \(w) { i <- which(holds(w, 1:H))[1]; if (is.na(i)) NULL else i }
min_w <- \(h) { i <- which(holds(1:W, h))[1]; if (is.na(i)) NULL else i }

for (w in 1:W) {
  if (is.null(h <- min_h(w))) break
  cat(sprintf("w = %d, h min = %d\n", w, h))
}

for (h in 1:H) {
  if (is.null(w <- min_w(h))) break
  cat(sprintf("h = %d, w min = %d\n", h, w))
}
Получились следующие значения:
w = 1, h min = 87
w = 2, h min = 299
h = 1, w min = 201
То есть картинки 1×87, 2×299 и 201×1 (бо́льшую сторону можно увеличивать, это увеличит разрыв) занимают в Брайле больше, чем в XBM. В реальности это не точные границы, так как внутри XBM указывается название картинки, которое может быть разного размера.
Задача «Шпионы и яд»
Давно хотел проверить не забыл ли я язык «Эр» («R»).
А тут — оказия, у Романа Парпалака в блоге появилась небольшая заметка о задаче «Шпионы за круглым столом»:
На банкете за круглым столом сидят n шпионов. Каждый шпион независимо от остальных случайным образом выбирает одного из двух соседей — левого или правого — и подсыпает яд ему в бокал. Каково математическое ожидание числа выживших шпионов?
Он там её решает аналитически, а я подумал, что это удобный случай запрограммировать

Написал сначала, разумеется, «в лоб» — цикл в цикле в цикле: для каждого числа шпионов цикл по количеству экспериментов, где каждый шпион в цикле решает кого он будет травить. Получилось медленно — «Эр» не очень быстрый язык.
После чего я сделал всё более параллельно — сначала готовлю матрицу выбора, где строки — эксперименты. Каждый элемент матрицы содержит выбор — будет отравлен сосед слева или справа. Следующим шагом преобразую эту матрицу в другую, которая содержит уже позиции отравляемых за столом. Дальше в строках подсчитываются уникальные значения и получается количество отравленных. Если вычесть его из количество шпионов за столом, получится количество выживших. После этого уже совсем просто подсчитать требуемое.
С матрицами получилось намного быстрее, но недостаточно. Поэтому я применил ещё и модуль parallel, который умеет раскидывать задачи по ядрам. Там используются немного другие функции, но в остальном всё работает так же.
Если
Азбука Морзе на R
Вдохновившись статьёй с «Хабра», где автор, перекрыв несколько магических методов у объекта в Пайтоне, смог закодировать операторами азбуку Морзе, решил сделать то же на «Эре». Душа требует веселья, а я кажется с прошлого года ничего не писал на этом языке.

Принцип в основном тот же, что и в оригинальной статье — плюс кодирует «точку», «минус» — тире, а вся магия происходит
Обратите внимание, это не строка, это выражение языка «Эр», которое, будучи выполненным, выводит закодированную строку:

У меня специальным символом, в котором хранится объект является точка. Точка не имеет никакого специального значения и является просто частью алфавита, который можно использовать в идентификаторах. В оригинальной программе используется подчёркивание, но в «Эре» его так использовать нельзя.
У объекта, хранящегося в точке перекрыты унарные и бинарные плюс и минус (а так же специальный метод show, чтобы вывести хвост на экран), поэтому когда мы этими операторами записываем код Морзе, например, так:
++++-.++---.На самом деле «Эр» видит код
+(+(+(+(-.)))) + +(-(-(-.)))Унарные операторы применяются к объекту, который копит в своём стеке факт применения и порядок, в котором это было сделано, потом то же делается для второго объекта и в конце применяется бинарный оператор, который выводит на экран левый аргумент и создаёт новый объект из правого.
Можно было бы переливать стек левого операнда в правый, но я не стал так делать для упрощения кода.
То, что получилось лежит на гитхабе. Там же лежит метод toMorseStr, которым можно перекодировать любую латинскую фразу в нужную последовательность.
«Жизнь» Конвея на «R» ★
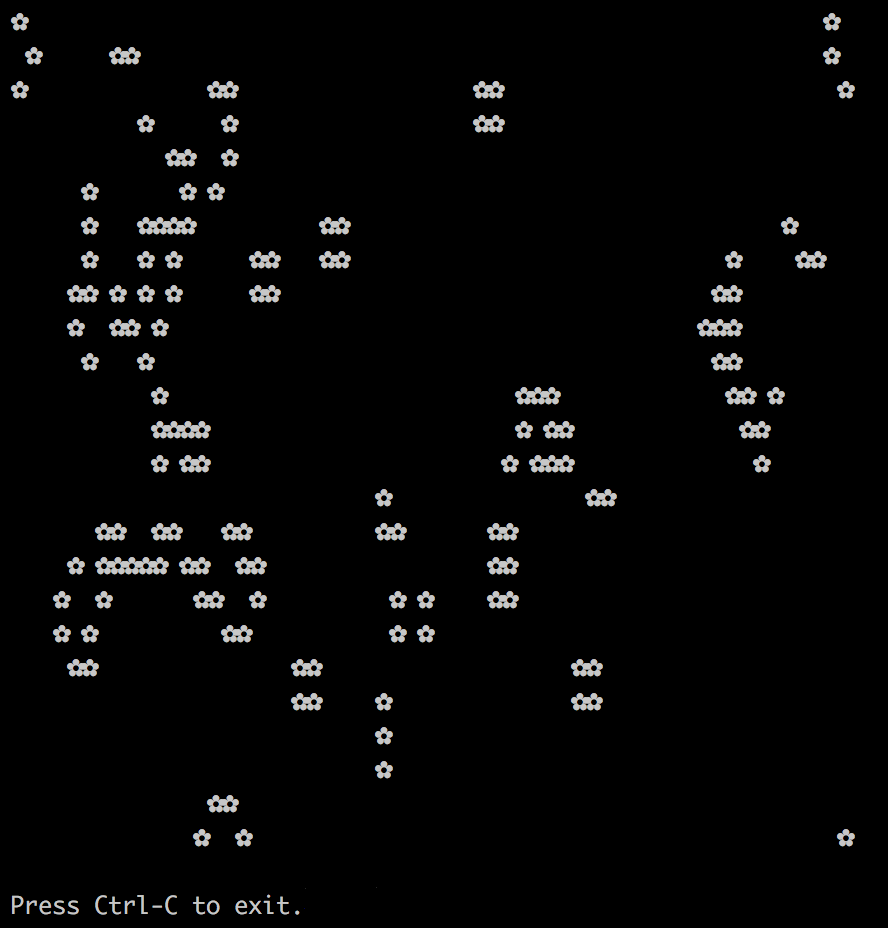
Игра «Жизнь» знакома, наверное, каждому программисту. Интересна она тем, что этот незатейливый алгоритм оказал существенное влияние на целый ряд научных дисциплин.
Не помню, чтобы я её
Сегодня ночью постарался написать классическую версию игры «Жизнь» на языке «Эр». Мне показалось это интересной задачей, так как «Эр» очень удобным образом позволяет работать со множествами так, как будто это скалярные значения.
Это можно увидеть почти сразу, в строке, где создаётся матрица случайных значений:
life <<- matrix(as.integer(runif(rows * cols) < ratio), rows, cols)Сравнение с переменной ratio и вызов as.integer тут применяется к каждому значению из множества, генерируемого функцией runif (Random Uniform Distribution, генерирует случайные значения с нормальным распределением). Так матрица игры заполняется случайными нулями и единицами.
Ниже по коду довольно много манипуляций с этой матрицей и выполнение правил алгоритма за счёт конструкций языка занимает всего несколько строк.
Суть такова: матрица двигается во все восемь направлений (с шагом 45°), все получившиеся матрицы складываются, это позволяет оценить количество соседей любой клетки в каждом из направлений. Далее в две строки выполняются основные условия:
# Any dead cell with exactly three live neighbours becomes a live cell
life.new[life == 0 & life.neighbors == 3] <- 1
# Any live cell with fewer than two or more than three live neighbours dies
life.new[life == 1 & (life.neighbors < 2 | life.neighbors > 3)] <- 0
Тут участвуют три матрицы: life — поле игры на предыдущем шаге, life.new — поле игры на текущем шаге и life.neighbors — матрица соседей (точка в «Эре» не имеет специального значения). Как видите матрица сравнивается с числом, как будто она скаляр, результат этой операции тоже матрица, но из булевых значений, в каждой клетке — результат операции. Такую матрицу можно использовать как индекс, в результате чего вернутся только те ячейки, по адресам которых в булевой матрице было TRUE.
Дальше просто, поскольку ячейки возвращаются по ссылке, им скопом присваивается требуемое значение.
99 бутылок: R
60. R. Как многие наверное помнят, в качестве хобби я время от времени пишу на разных языках программирования американскую «Песню о пиве»
Это довольно известное развлечение — реализовывать на куче языков
Я выбрал именно «Песню о пиве», так как не всем языкам из моего списка, под силу
# Written by Evgeny Stepanischev, 2017

bottles <- function(beer) {
    ifelse(beer == 0, "no bottles",
        ifelse(beer > 1, paste(beer, "bottles"),  "1 bottle")
    )
}

for (i in 99:1) {
    paste(bottles(i), "of beer") -> b

    cat(b, " on the wall, ", b, ".\n", sep = "")
    cat("Take one down and pass it around,", bottles(i - 1), "of beer on the wall.\n\n")
}

cat("No more bottles of beer on the wall, no more bottles of beer.\n")
cat("Go to the store and buy some more, 99 bottles of beer on the wall.\n")Вызов C из R
Заинтересовался темой вызова функций Си из языка «Эр». Обнаружилось целых два интерфейса: простоватый вызов «.C» и более сложный «.Call», к сожалению ни один из них не предназначен для вызова произвольного кода — со стороны Си в каждом из случаев следует соблюдать некоторые соглашения.
Я решил попробовать подёргать функции библиотеки libmagic, поскольку
Так как .C не умеет работать с возвращаемыми из функции значениями (возможен возврат только через параметр), да и передаётся всё как указатели, пришлось даже для этой простой задачи написать обёртку. Скомпилировать её можно командой make, либо запустить руками строчку компиляции из файла сборщика.
Программа на «Эре» небольшая, бо́льшую часть занимает определение констант. Внутри захардкожен пример использования, так как библиотеку я делать не намерен, он там так и останется.
Примечание: я знаю, что функция strdup не является переносимой, но мне, если честно, всё равно, не хочется ради исследования принципа тащить в код её реализацию.
Применил «R» на практике
Каждый год я стараюсь, если не выучить, то познакомиться с одним или несколькими языками программирования. В основном, чтобы прочувствовать
Научившись их применять в языке, растёшь как профессионал, приобретаешь новые навыки и новые способы мышления. Стараюсь выбирать языки именно с таким прицелом, и если этого не происходит, испытываю сожаление от потраченного времени.
Тем не менее, не чураюсь применения языков на практике, в работе. Так в «Яндексе» я внезапно несколько лет попрограммировал на «Пайтоне», который выучил по забытой соседом на общей кухне книжке, а на текущем месте работы написал специализированную СУБД на «Гоу».
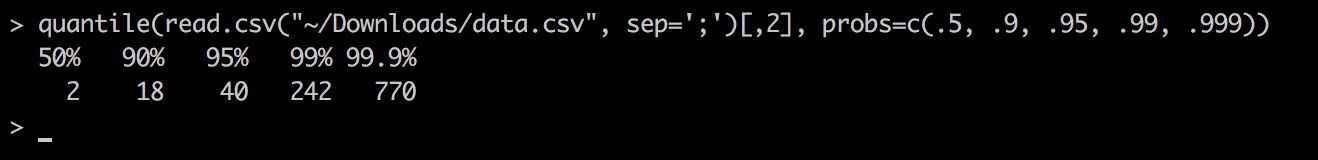
А вчера случилось написать по работе строчку на языке «Эр» (который я сейчас изучаю), всего одну, но полезную — нужно было посчитать различные квантили по количеству страниц на документ, программа с результатом на скриншоте — там загружается файл, где разделитель полей — точка с запятой, из загруженных данных выбирается второй столбец и считаются указанные квантили.
Интерпретатор Brainfuck на языке R
В качестве упражнения написал тривиальный интерпретатор «Брейнфака» на языке «Эр», никаких оптимизаций, кроме преподсчёта переходов. Даже на версию без поддержки вложенных циклов ушло прилично времени — некоторые вещи у меня пока со скрипом идут. Зато воспользовался разными структурами данных и сделал класс на RC (в языке «Эр» три встроенных способа работы с классами).
Аналог defer в языке R
В Гоу есть интересная конструкция (defer) — её содержимое выполняется, когда заканчивает работу функция, в которой эта конструкция объявлена, очень удобно память освобождать или другие ресурсы. Я накидал небольшой пример, чтобы было понятно:
package main

import (
    "bufio"
    "fmt"
    "os"
)

func readFile(filename string) (out []string) {
    file, _ := os.Open(filename)
    defer file.Close()

    b := bufio.NewReader(file)

    for {
        if str, err := b.ReadString('\n'); err != nil {
            break
        } else {
            out = append(out, str)
        }
    }

    return out
}

func main() {
    var lines []string

    for _, line := range readFile("/etc/passwd") {
        if line[0] != '#' {
            lines = append(lines, line)
        }
    }

    fmt.Println(lines)
}
В примере одна функция построчно читает файл и возвращает массив строк. Её использует основная функция (main), чтобы прочитать файл с информацией о пользователях в системе, удалив оттуда комментарии — строки, начинающиеся с «#». Обработку ошибок я не стал делать — и без этого длинновато вышло.
В фунции чтения файла блок defer вызовется как только мы покинем функцию и закроет используемый файл. Такой способ лучше, чем отсутствующий «Гоу» блок try…finally, так как позволяет указать способ освобождения ресурса очень близко к началу его использования.
Есть языки, которые, на мой взгляд, решают эту задачу ещё лучше (например, Пайтон со своим with), но у Гоу своя атмосфера и выбранное решение отвечает духу языка.
«Эр» на «Гоу» совсем не похож, у языков совершенно разные идеологии, поэтому я очень удивился, обнаружив в «Эр» тот же подход, что выбран в «Гоу».Тот же пример на «Эре»:
readFile <- function(filename) {
    f <- file(filename, 'r')
    on.exit({
        close(f)
    })

    return(readLines(f))
}

lines <- readFile('/etc/passwd')
print(lines[!grepl('^#', lines)])
Конструкция on.exit делает тут ровно то же, что defer в «Гоу». Нельзя не заметить, что программа стала гораздо компактнее, но в многословности Гоу обвинить нельзя —
ООП в R
Я думал, нет, даже надеялся, что присваивания в «Эр» единственная запутанная вещь.
Я надеялся, что это отражение некой эволюции, но нет, некоторые апологеты языка рекомендуют использовать разные реализации в разных случаях, говорят, что каждая из систем несёт в себе определённые удобства.
Удобства я пока не ощутил, каждая из система плоха, на мой вкус, зато изучая здешние объектные модели, наткнулся на интересное.
Каждая функция создаёт, как обычно, свою зону видимости, насколько я понял, тут она зовётся «окружением», причём из вложенной функции можно обращаться в окружения выше, если я правильно понимаю, сколь угодно далеко, пока не упрёшься в глобальное окружение — верхний уровень программы.
Самое интересное, что окружениями можно манипулировать — это обычные объекты, которые содержат в себе текущие переменные. В итоге сэмулировать собственный класс без затей и претензий можно вот так:
NewCat <- function() {
    phrase <- 'Meow'

    say <- function() {
        print(phrase)
    }

    environment()
}

cat = NewCat()
cat$phrase # Meow
cat$say() # Meow
В «Эр» функции возвращают последнее значение, тут последним создаётся объект окружения, который возвращает в себе свою зону видимости и с которым можно работать как со списком (доллар — такой синтаксический сахар обращения к элементу списка).
При желании достаточно многое можно сделать с таким подходом (наследование, например), но я всё же буду изучать более естественные способы создания объектов.
Присваивания в R
В языке много необычного, но почти сразу бросается в глаза наличие целой кучи операций присваивания, большинство из которых, правда, являются альтернативными способами записать одно и то же. Значительная часть операций несут в себе очень чёткую логику, а в двух из них такая восхитительная путаница, что даже опытные программисты на «Эре» иногда не знают как это всё работает. О них и хочу рассказать.
Сначала небольшой исторический очерк.
В далёком 1964 году на свет появился язык программирования APL — функциональный язык программирования, предтеча разных там «Матлабов» и иже с ними. Язык вводил для своих нужд целую кучу специальных значков в качестве операторов, так что программисты даже использовали специальные накладки на клавиатуры, либо рисовали спецсимволы фломастерами.
Вот так, например, выглядит на «АПЛе» гиковская игра «Жизнь»:
life←{↑1 ⍵∨.∧3 4=+/,¯1 0 1∘.⊖¯1 0 1∘.⌽⊂⍵}Стрелка слева от слова «life» — операция присваивания, примерно в таком виде она по наследству перешла во многие математические языки, в том числе и в «Эр». Обычное «равно» же в «Эре» использовалось для другой цели — присвоения значений именованным параметрам:
op <- function (..., func) print(get(func)(...))
op(1, 2, 3, 4, 5, func = "sum") # =15
op(4, 2, func = "/") # =2
Пример выше иллюстрирует использование обоих операторов — стрелкой мы присваиваем переменной тело анонимной функции, которая принимает неограниченное количество параметров и один именованный параметр, а ниже указываем значение именованного параметра через «равно».
Как видите, символ деления вполне подходит в качестве имени функции, но об этом
Присваивание стрелкой и наличие в языке «равно», которым нельзя присваивать значения переменным, приводило новичков в замешательство, так что под влиянием более современных языков («Си», «Джавы» и так далее) случилось непоправимое — «равно» стало использоваться и для присваивания тоже, что только усугубило путаницу:
# Присваивание переменной «x» значения «1»
x = 1
f <- function(x) print(x)
# Вызов функции «f» со значением «5» аргумента «x»
f(x = 5)
# Вызов функции «f» с присваиванием переменной «x» значения «5»
# и передачей этого же значения в качестве первого аргумента
f((x = 5))
Казалось бы все операции выше выглядят вполне логично и «равно» тут исправно выполняет новую роль. Но увы. Дело в том, что «Эр» — язык «ленивых» вычислений, выражения в аргументах передаются в функцию не значениями, а промисами, которые будут вычислены в момент использования.
Это означает, в частности, что если аргумент не использовался в функции (выполнение пошло
x = 1
f <- function(x) TRUE
f((x = 5))
print(x) # выведется единица
Так как первый аргумент в функции использован не был, то переданное выражение вычислено не было, а значит и переменная «x» своего значения не изменила. Возможно новичкам и стало проще, но наравне с этим на поле языка рассыпалось несколько новых интересных грабель.
Есть и ещё проблемы. Операции «стрелка» и «равно» имеют разный приоритет и их лучше не использовать в цепочках присваиваний вместе:
# работает, вычисляется справа налево, трактуется как a = (b = 5)
a = b = 5
# работает, вычисляется справа налево, трактуется как a <- (b <- 5)
a <- b <- 5
# выдаст ошибку, так как «стрелка» имеет приоритет выше: (a <- b) = 5
a <- b = 5
# работает, так как «стрелка» имеет приоритет выше: a = (b <- 5)
a = b <- 5
Вообще, конечно, не всё так страшно — можно это всё либо понять (что почти никто не делает), либо запомнить несколько нехитрых правил (прочитав пару хороших книг по языку), либо набить шишки на практике (что чаще всего и происходит).
Счастливые билеты
Мы тут недавно с одним товарищем разговорились про точное количество «счастливых» билетов. В ответ я вспомнил, что
На что товарищ прислал мне ссылку на выписку из статьей о счастливых билетах журнала «Квант». Там, помимо перебора, предлагается несколько методов вычисления, в частности есть даже интеграл:
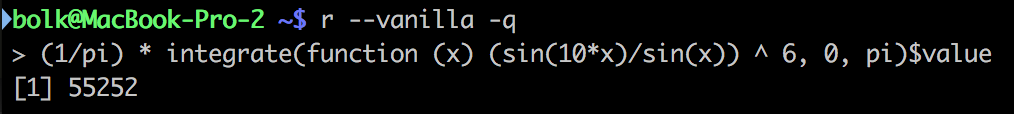
Вообще статьи интересные, умели же раньше писать! Кстати, стало интересно насколько сейчас плох
Вариант на R, который я наскорую написал по мотивам второй статьи из подборки выглядит вот так:
N <- function (n, k) {
    if (n == 1)
        ifelse(k >= 0 & k <= 9, 1, 0)
    else
        sum(sapply(0:9, function (l) N(n-1, k-l)))
}

lucky <- function (n) {
    0 -> s
    for (k in 0:999) {
        N(3, k) -> v

        if (v == 0) {
            break
        }

        s + v * v -> s
    }

    s
}

print (lucky(3))
Выполняется вместе с запуском интерпретатора за треть секунды, если