программирование
Надо бы добавить мой strlen во «Флиппер»
Можно подумать, что я забросил возню с «Флиппером», так как
До недавнего времени я её надеялся ускорить, поэтому пытался вносить
Будем считать, что с этим вопросом я закончил, хочу теперь попробовать добавить этот код в прошивку «Флиппера». Остались сделать два шага.
На замерах моя реализация обогнала встроенную на порядок — восемь секунд против 55 на двух миллионах итераций по небольшой строке. Но теперь надо воткнуть её в прошивку, чтобы учесть влияние реализации строкового типа FuriString, в котором будет использоваться эта функция и провести новые замеры. Надеюсь сделать это в ближайшие выходные.
Второй шаг для меня сложнее. У меня уже есть выписанная прошивка «Флиппера», в которой торчит непринятый коммит. Я никогда раньше не создавал на «Гитхабе» два разных запроса в рамках одного чужого проекта, не знаю как это делается. Если
Шутка, которая не работает
Тут в чате бывших коллег, где мы постим мемы, пробежала картинка, которая больше повеселила меня не смыслом, который в неё вкладывал автор, а тем, что на системе, под которую написан код на ней (Виндоуз, очевидно), она не выполнится.
Проблема тут в том, что вызов os.remove умеет удалять только файл, тогда как System32 — папка, знакомая многим пользователям Виндоуз. Я не уверен точно, но думаю, что при её удалении система будет сопротивляться. Она, вроде,
Возможно, кстати, код и не предполагалось делать рабочим, а шутка немного тоньше — ведь вызов os.remove можно прочитать как «удалить операционную систему», не знаю, я в любом случае хотел рассказать не об этом.
Дело в том, что шутка написана под ОС, под которой она работать не будет, но смешно то, что под ОС, на которую она рассчитана не была, она вполне может заработать.
В Линуксе или МакОСи надо в любом месте, где будет запускаться эта программа, создать папку C:, в ней — папку Windows, а в ней — файл System32, который и удалится, если выпадет искомое число на рандомайзере.

Замеры strlen_uft8 на «Флиппере Зеро»
Ну что же, я наконец сравнил свой вариант функции определения длины строки в кодировке
Оказалось, что обычные функции замера времени под «Флиппером» не работают. мне не удалось получить значение текущего времени ни одним из способов к которым я привык на Си, поэтому опять пришлось читать исходники прошивки «Флиппера».
В итоге обнаружился метод, выводящий затраченное время с секундной точностью:
FuriHalRtcDateTime curr_dt;
furi_hal_rtc_get_datetime(&curr_dt);
uint32_t start = furi_hal_rtc_datetime_to_timestamp(&curr_dt);

for (int i = 0; i<1000000; i++)
len += strlen_utf8("This is a test и русских букв тоже");

furi_hal_rtc_get_datetime(&curr_dt);
uint32_t stop = furi_hal_rtc_datetime_to_timestamp(&curr_dt);
Хотелось бы точнее, но этого, в принципе, хватает, чтобы понять какая функция быстрее и на сколько. Надо просто сделать очень много итераций. Я попробовал запускать на миллионе и десяти миллионах.
В итоге, на десяти миллионах наивная реализация выполняется примерно за 80 секунд, моя и чужая быстрая — около 50, явного лидера из этих двух реализаций выделить не удалось. Все замеры делал несколько раз.
DSP SIMD для Flipper Zero
В этом версии нет никакой защиты цикла от чтения за границей буфера, мне показалось, что во «Флиппере» это неважно, но возможно это не так.
Ну что ж, разобрался я что за зверь такой этот DSP SIMD и запрограммировал на нём векторизированную версию функции для измерения длины строки.
Сегодня описывать и замерять уже не буду, и так времени много ушло, но по крайней мере всё работает на настоящем «Флиппере».
Сразу можно заметить, что вектора тут вдвое короче — всего четыре байта, да и функций для работы с ними гораздо меньше, но этого набора оказалось достаточно, чтобы всё векторизовать.
#include <arm_acle.h>

size_t strlen_arm_utf8(char * str) {
    uint32_t len = 0;
    int8x4_t zero = 0x00000000;
    int8x4_t one  = 0x01010101;
    int8x4_t threshold = -1077952577; // -65, -65, -65, -65

    for (;;) {
        uint8x4_t result;
        int8x4_t vec = *(int8x4_t *) str;

        __uadd8(0xFFFFFFFF, vec); result = __sel(zero, one);
        if (result > 0) {
            if (result == 0x01000000) {
                __ssub8(threshold, vec); result = __sel(zero, one);
                return __usada8(result, 1, len);
            }
            break;
        }

        __ssub8(threshold, vec); result = __sel(zero, one);
        len = __usada8(result, zero, len);

        str += sizeof(uint8x4_t);
    }

    for (signed char c; (c = *str); str++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}ARM бывают разные
Преодолев внутреннее сопротивление, я
Во «Флиппере» стоит процессор ARM, а они, как оказалось, бывают очень разные.
Я ещё в самом начале посмотрел спецификацию процессора «Флиппера» и, увидев слово SIMD, совершенно успокоился — в моём понимании это означало, что я могу использовать любые команды векторизации, которые мне необходимы. Тут я немного поторопился, но меня подгоняло желание разобраться как устроена векторизация. Теорию я знал, а тут подвернулась, пусть немного синтетическая, но задача, которую руки чесались решить.
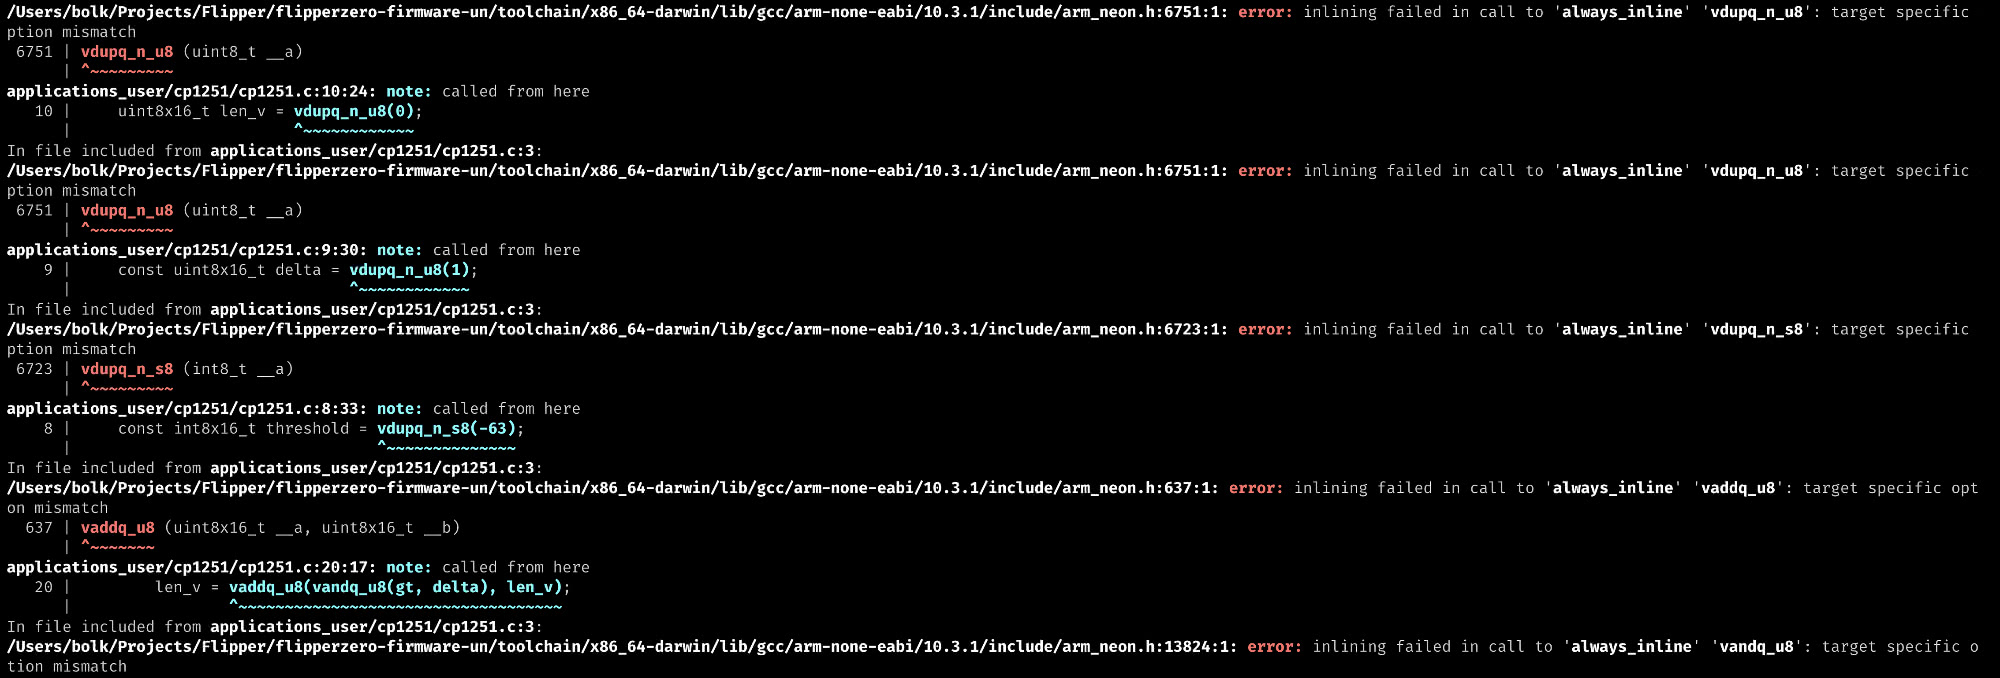
Как я уже говорил, мне захотелось срезать углы, поэтому функцию до этого момента я писал на своём ноутбуке, раз так случилось, что у меня на нём тоже процессор ARM. И лишь сегодня я попробовал вставить её в одну из своих программ и собрать её для «Флиппера».
Сначала компилятор заявил мне, что не нашёл некоторые векторные функции, в частности функцию нахождения минимума vminvq_u8 и суммы vaddvq_u8.
Ветку с vminvq_u8 я временно убрал, а функцию суммы vaddvq_u8 решил заменить на поэлементное сложение (vaddq_u8), которая, вроде, компилятору знакома.
Мысль простая — в векторах, сумму которых мы находим, на каждой позиции нули и единицы, поскольку каждый элемент вектора у нас восьмибитный, в общем случае у нас поместится результат 255 операций, а потом я могу просто просуммировать элементы циклом.
uint8x16_t len_v = vdupq_n_u8(0);
int reset = 0;

// тут у нас цикл
uint8x16_t gt = vcgtq_s8(operand, threshold);
len_v = vaddq_u8(vandq_u8(gt, delta), len_v);

if (++reset >= 255) {
    for (size_t i = 0; i < sizeof(uint8x16_t); i++) {
        len += *((uint8_t *)&len_v + i);
    }

    reset = 0;
    len_v = vdupq_n_u8(0);
}
Я был очень доволен решением (оно не совсем моё, его мне навеял код, используемый в PHP), но оказалось, что оно тоже не компилируется.
Сборка заругалась на ошибку target specific option mismatch, означающую, что указанное при компиляции железо не поддерживает те возможности, которые я пытаюсь использовать в коде. Пришлось лезть в тулчейн, чтобы разобраться какие ключи компиляции сейчас используются.
В файле compile_commands.json можно увидеть, что при сборке используется ключ -mfpu=fpv4-sp-d16, тогда как мне, чтобы использовать нужные команды векторизации нужен ключ -mfpu=neon.
Так как ключи компиляции указывали разработчики «Флиппера», думаю, они в точности знали в какие значения их выставить. Согласно спецификации на борту использованного во «Флиппере» процессора SIMD есть, но, видимо,
Пора перенести измерение длины на «Флиппер»
Кажется я то ли прокрастинирую, то ли боюсь неудачи. Предполагалось, что векторизованный алгоритм измерения длины строки в кодировке
Он вполне может не скомпилироваться — не уверен, что на «Флиппере» есть
Чуть более быстрый подсчёт длины строки в UTF-8
Сегодня очень плохо спал — всё время просыпался, потом долго ворочался, не мог уснуть. Утром оказалось мозг никак не мог успокоиться после вчерашней заметки про разбор быстрого алгоритма для подсчёта длины строки в
Вчера я остановился на том, что у разбираемого способа есть две очевидные недоработки — ненужное вычисление, которое решается инвертированием условия и подсчёт «хвоста», который всегда вычисляется «классическим» способом — без векторизации, хотя если строка у нас кратна вектору, можно было бы этого избежать.
Первый недостаток исправлялся очень просто, а хорошая реализация второй проверки мне вчера в голову не пришла.
Зато, когда я проснулся, она уже была у меня в голове. Всего три операции — первой получаем вектор, где на позициях с ненулевым байтом записывается 255, потом делается операция «И» с номерами позиций и весь вектор суммируется.
В итоге, если ноль стоит в векторе только на крайней правой позиции, у нас получается сумма арифметической прогрессии без последнего элемента.
По замерам такой вариант чуть быстрее.
size_t strlen_utf8(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-63);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            uint8x16_t pos = {1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16};
            uint8_t sum = vaddvq_u8(vandq_u8(vtstq_u8(operand, operand), pos));

            // арифметическая прогрессия без последнего члена
            if (sum == 16*(16+1) / 2 - 16) {
                uint8x16_t gt = vcgtq_s8(operand, threshold);
                return len + vaddvq_u8(vandq_u8(gt, delta)) - 1;
            } else {
                break;
            }
        }

        uint8x16_t gt = vcgtq_s8(operand, threshold);
        len += vaddvq_u8(vandq_u8(gt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Разбор быстрого подсчёта длины строки в UTF-8
Давайте попробуем
Напомню как выглядел код:
size_t strlen_php(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-64);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            break;
        }

        uint8x16_t lt = vcltq_s8(operand, threshold);
        len += sizeof(uint8x16_t) - vaddvq_u8(vandq_u8(lt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Для ускорения подсчёта в алгоритме используется векторизация, — это когда мы работаем с пачкой чисел, делая над каждым из них
Вектор загружается функцией vld1q_s8, где коды символов считываются по адресу, записанному в указателе p. В дальнейшем мы будем его сдвигать на размер вектора, чтобы забирать следующую пачку данных.
Ниже используется функция vminvq_u8, которая вычисляет минимальное значение в векторе, рассматривая его как набор байтов без знака. Если там ноль, значит строка кончилась и в нашем векторе — хвост, который надо досчитать обычным способом, без вектора. Тут можно было бы проверить на какой позиции слева находится признак конца строки, если на самой последней, то строка была кратна вектору. Но я не стал заморачиваться. Но такая проверка оказалась медленнее подсчёта длины хвоста обычным способом.
Дальше функция vcltq_s8 сравнивает каждый байт в векторе со значением −64 — это значение загружается в каждый элемент вектора для сравнения функцией vdupq_n_s8.
Результирующий вектор заполняется значениями 0 или 255, в зависимости от результата сравнения. Функция vandq_u8 производит операцию «И» с единицей, после чего у нас в векторе ноль остаётся неизменным, а 255 превращается в единицу. Эти единицы мы суммируем функцией vaddvq_u8.
Теперь у нас получился вектор, в котором подсчитаны все внутренние байты символов, а чтобы подсчитать внешние, надо вычесть это число из длины вектора. Правильнее было бы инвертировать сравнение, до этого в разгаре экспериментов просто не дошли руки.
Полученное число мы добавляем к вычисляемой длине и сдвигаем указатель. В конце досчитываем хвост обычным циклом. Конец алгоритма.
Определяем границу символа в UTF-8
В Телеграме попросили рассказать как работает код, который я приводил вчера в заметке про ускорение функции, возвращающей количество символов в строке с кодировкой
Там действительно есть что рассказать, но рассказ придётся разбить на несколько частей. Я постараюсь по возможности не погружаться в дебри. В этой части начну с того, что расскажу чем вообще необычна эта кодировка.
Все кодировки условно можно разделить на две части: кодирующие символ фиксированным или переменным количеством байт. К первым можно отнести, например, CP1251,
Справедливости ради, есть и другие виды кодирования, но нам их рассматривать ни к чему.
Тут важно то, что для строки в
Посмотрим на картинку из «Википедии», которая показывает как устроена эта кодировка:

Тут нам интересна только колонка «шаблон», где видно, что все «внутренние» байты символов начинаются с одной и той же сигнатуры — старший бит установлен, младшие — сброшены.
То есть, байты в диапазоне от 10000000 до 10111111 (в бинарном представлении) — внутренние байты, остальные — начало символа. Опять же, согласно таблице начала попадают в диапазоны 00000000-01111111 и от 11000000 до 11011111.
Умные люди заметили одну закономерность, сейчас мы её тоже увидим. Давайте напишем небольшую программу:
#include <stdio.h>

int main() {
    const signed char arr[] = {
        0b10000000, 0b10111111, 0b00000000, 0b01111111, 0b11000000, 0b11011111
    };

    for (int i = 0; i < sizeof(arr) / sizeof(arr[0]); i++) {
        for (int b = 128; b; b >>= 1) {
            printf("%d", (arr[b] & i) > 0);
        }

        printf(" % d\n", arr[i]);
    }
}
Вот что она выводит (диапазон, в котором находятся внутренние байты, я выделил другим цветом):
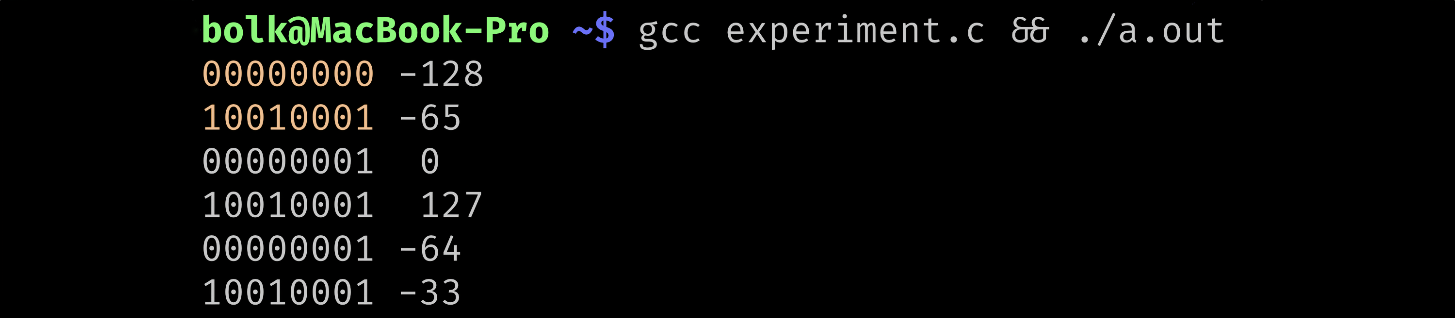
Закономерность в том, что все внутренние байты в знаковом представлении по значению меньше −64. Это довольно дешёвая проверка с точки зрения машинного кода, что очень хорошо, так как наша цель — производительность.
Про остальное — в следующий раз.
UTF-8 на ARM
Пока проект внедрения Юникода во «Флиппер Зеро» на паузе, — разработчики занимаются обновлением одной из важных библиотек, я вспомнил, что
Например,
Любопытно посмотреть как обстоят дела с ускорением таких вещей на процессоре, который установлен на «Флиппере». Правда до него у меня руки ещё не дошли, но я уже потренировался на своём «Макбуке», благо тут процессор той же архитектуры.
Идея всё та же — векторизация. За референс я взял наивную реализацию с перебором по одному байту:
size_t strlen_naive(const char* str) {
    size_t len = 0;
    char ch;

    while ((ch = *str++)) {
        len += (ch & 0b11000000) != 0b10000000;
    }

    return len;
}
Попробовал несколько вариантов, но лучше всех показали себя две функции: та, которую я упоминал в первом абзаце и переделанная нашими общими с братишкой усилиями реализация, найденная в недрах PHP.
После переделки она стала выглядеть так:
size_t strlen_php(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-64);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            break;
        }

        uint8x16_t lt = vcltq_s8(operand, threshold);
        len += sizeof(uint8x16_t) - vaddvq_u8(vandq_u8(lt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Повторюсь, у меня пока не дошли руки попробовать это всё на «Флиппере», но на моём «Макбуке» результаты выглядят следующим образом. Это десять тысяч прогонов на русскоязычном тексте, размер которого чуть больше ста тысяч символов.
Name   Length  Time
----   ------  ----
PHP    117465   97797
Fast   117465  143780
Naïve  117465  531535
Не скажу, что я делал всё как положено, — надо бы считать среднее и отклонение, разносить по разным файлам, научиться прибивать процесс к производительным ядрам, но разница в результатах достаточно показательна (я запускал несколько десятков раз), поэтому, как мне кажется, и так нормально.
Цифры в попугаях (больше — хуже), которые выдаёт сишная функция clock(), компилировал компилятором Clang 15 с ключом -O3.
Что там дальше с Юникодом под Flipper Zero?
Наверняка вам интересно, что там происходит с моим
Тем не менее всё равно напишу. Проект пока на паузе.
Причина — разработчики прошивки решили обновить фреймворк «U∞g²», который используется для вывода текста. Дело хорошее, но поскольку мои правки зависят от этого фреймворка, придётся подождать его обновления.
Что там в нём изменится мне интересно, можно бы посмотреть, но форсировать не буду, обновится — гляну.
А пока заметил, что переписать придётся ещё одну функцию — elements_multiline_text_aligned. Когда просматривал, не заметил, что в ней используется местный аналог printf, который с Юникодом сроду не работал:
if((start[chars_fit] == '\n') || (start[chars_fit] == 0)) {
    line = furi_string_alloc_printf("%.*s", chars_fit, start);
} else if((y + font_height) > canvas_height(canvas)) {
    line = furi_string_alloc_printf("%.*s...\n", chars_fit, start);
} else {
    chars_fit -= 1; // account for the dash
    line = furi_string_alloc_printf("%.*s-\n", chars_fit, start);
}
Конкретно это место никак не зависит от «U∞g²», можно бы и заняться. Но пока у меня с новогодними праздниками не задалось — всё ещё работаю, плюс немного заболел — горло болит и кашель. Разгребусь, выздоровлю и займусь.
«Трубо Паскакаль»
В конце
Это был хоть и случайный, но удачный выбор, — позже появилась совершенно гениальная среда разработки «Делфи», где я заработал немало масла на свой хлеб. Кроме того, в Университете всё программирование преподавалось на Паскале, очень выручило, что я знал тогда этот язык.
До «Делфи» разработка происходила в среде «Турбо Паскаль», глядя в синие окошки которой, я провёл
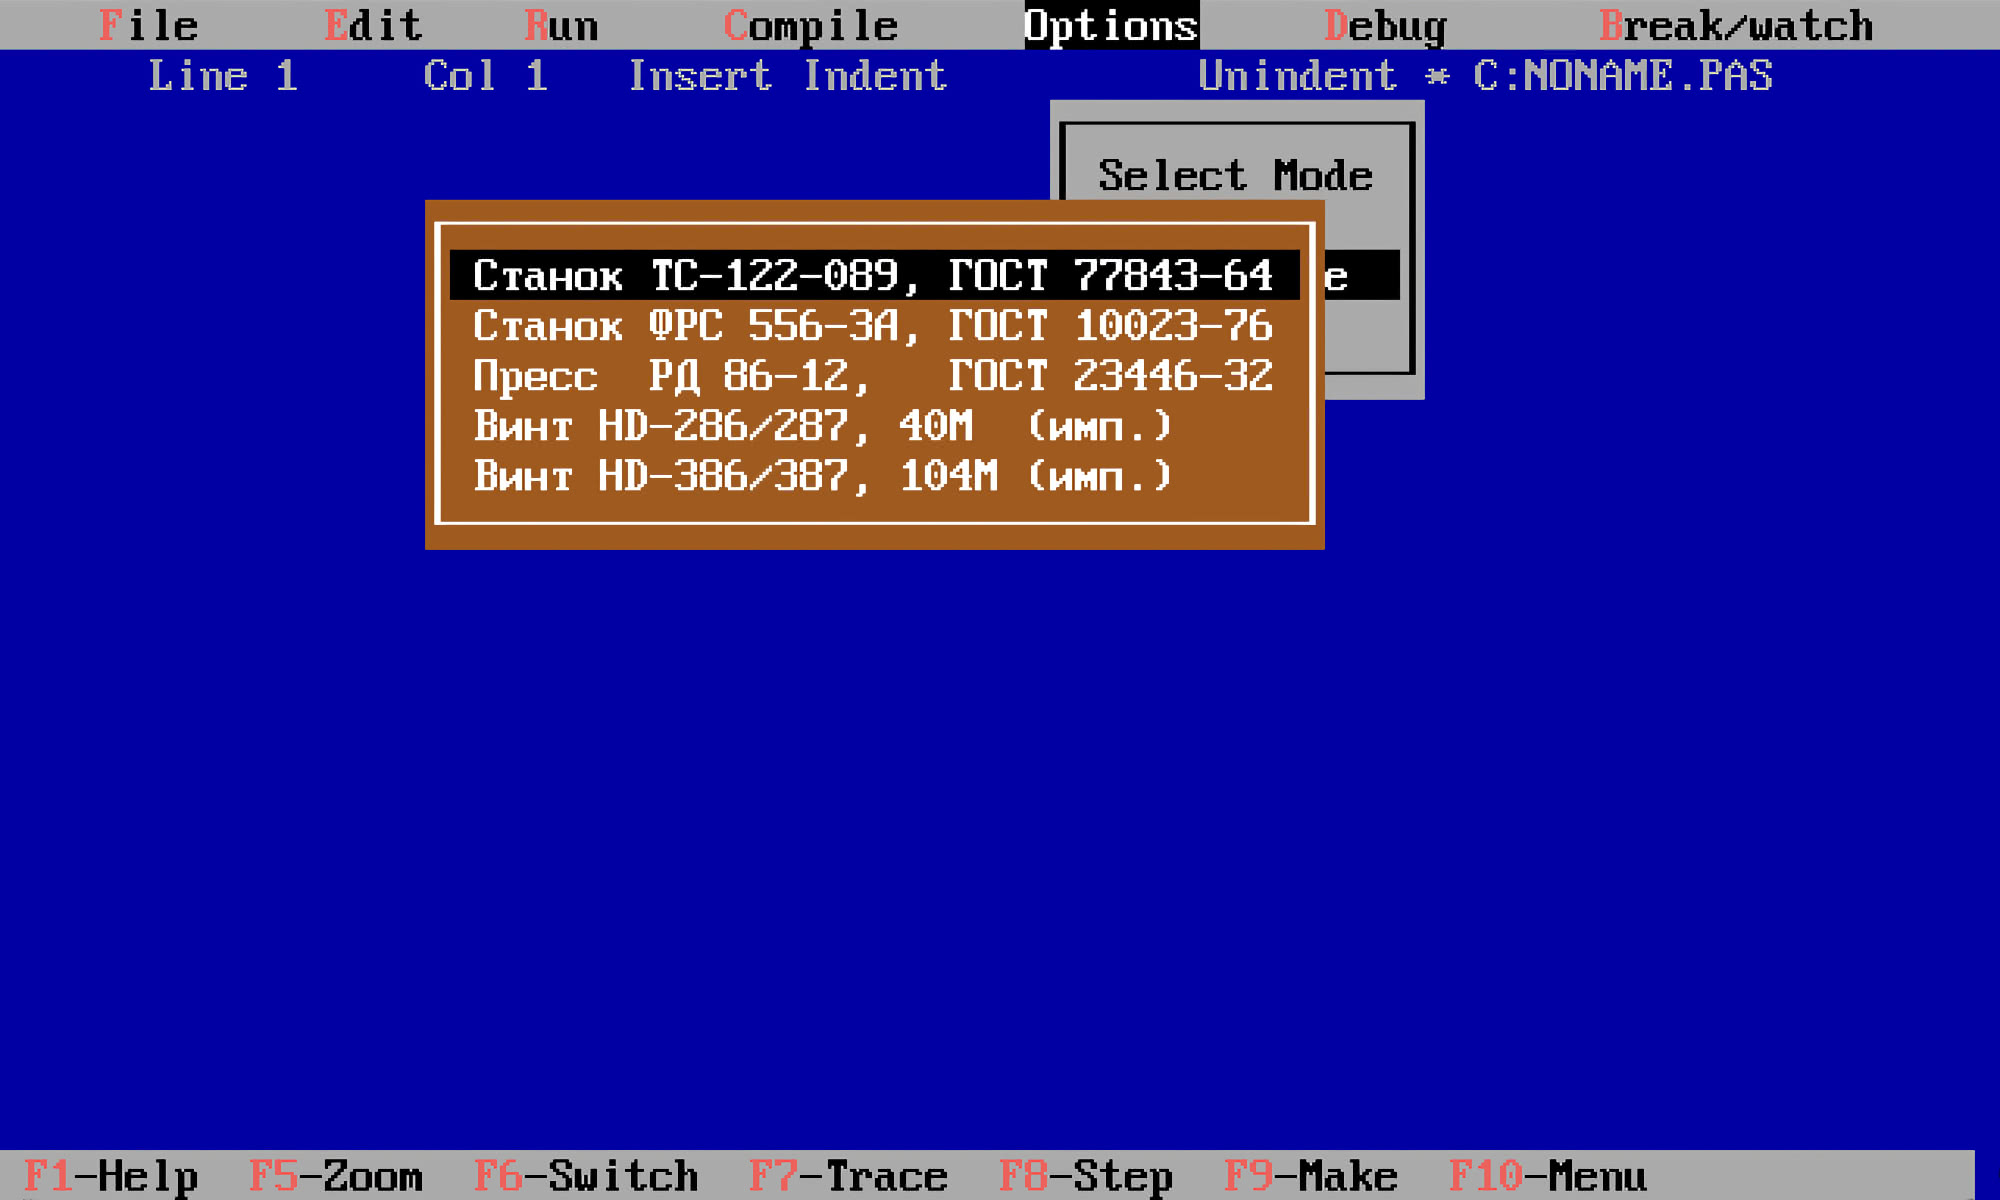
Поэтому, наверное, понятно, почему когда я в комментариях к одной из статей на «Хабре» увидел упоминание пародийной программы «Трубо Паскакаль», не смог пройти мимо.
Программа поверхностно имитирует «Турбо Паскаль», где в меню спрятаны разные приколюхи. Если вы
У меня есть шутка про UDP, но боюсь она до вас не дойдёт…
Сегодня день, чтобы шутить мою любимую профессиональную шутку:
Q. Why do programmers confuse Halloween and Christmas?
A. Because 31 Oct = 25 Dec
В этом году, кстати, в моём личном рейтинге её перебила другая шутка, которая к дате не привязана:
> isNaN("grandma")
> true
UTF-8 в elements_scrollable_text_line и elements_string_fit_width
Решил ковать железо, пока горячо — раз дали шанс, постараюсь довести поддержку
Тем не менее, поначалу я всё равно приуныл, — там вполне есть где накосячить, значит результат надо тестировать. У «Флиппера» нет эмулятора, получается надо компилировать прошивку, потом заливать её в устройство, делать примеры и уже на них смотреть что пошло не так. Долго и трудоёмко.
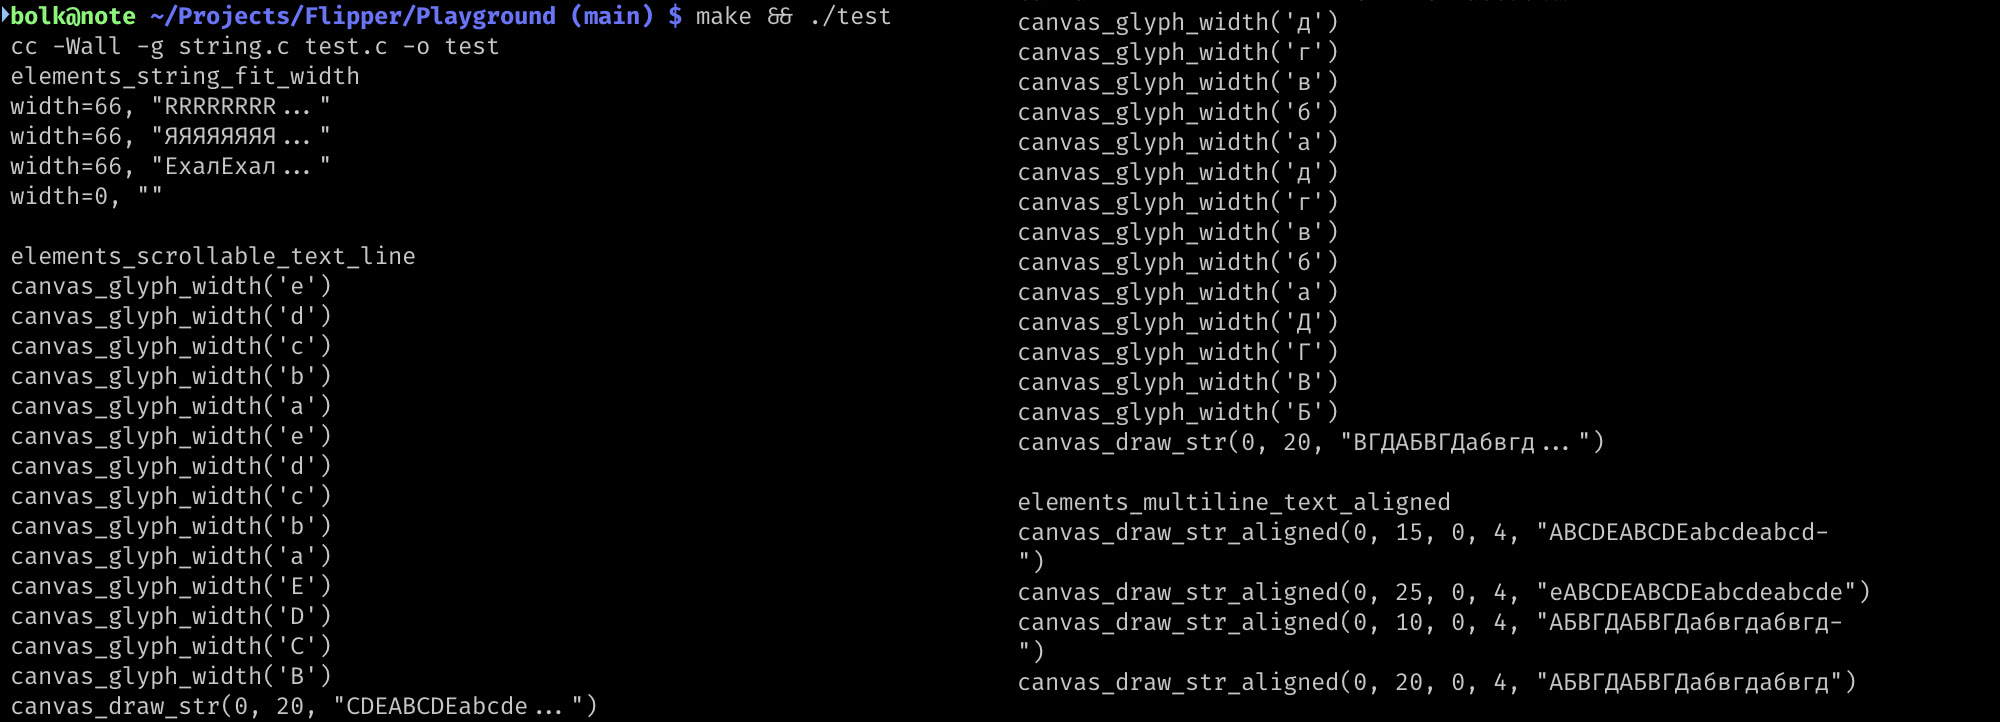
Поэтому я пошёл другим путём — выковырял из прошивки функции, которые надо изменить, а с ними и все их зависимости, заменив вывод на экран печатью имени и параметров вызываемых функций.
Идея простая — параметры и списки вызова функций должны совпадать до и после моих изменений. Этого, кстати, в полном объёме добиться не удалось — я быстро нашёл в каждой из трёх функций по ошибке, так что сравнивать пришлось две исправленные версии.
Работу я разбил на два этапа — пока закоммитил только функции elements_scrollable_text_line и elements_string_fit_width. Функцию elements_text_box перепишу попозже, она объёмная, если найдутся замечания по ревью текущего коммита, добью сначала их, так проще.
Работа над Юникодом во «Флиппере Зеро»
Вот что значит живой, развивающийся проект. Стоило закоммитить в репозиторий «Флиппера Зеро» своё второе предложение по улучшению поддержки Юникода во «Флиппере», почти сразу его рассмотрели и дали обратную связь. Так далеко не всегда бывает.
Похоже зря я опасался, что поддержка Юникода никому не нужна, пока всё идёт очень гладко. Одно одобрение коммита из необходимых трёх я получил, но мне напомнили, что работа ещё не окончена.

Я это понял и сам, но, честно сказать, всего за несколько минут до того как получил сообщение от ревьювера. Мои правки пока касались только вывода текста, тогда как во «Флиппере» поверх него работает АПИ, позволяющее выводить ещё и различные элементы интерфейса — окошки, кнопки и тому подобное.
Весь список публичных функций, потенциально нуждающихся в исправлении, можно легко получить:
< targets/f7/api_symbols.csv awk -F, '$3~/^elements_/&&/char|String/{print$3}'
elements_bubble_str
elements_button_center
elements_button_left
elements_button_right
elements_multiline_text
elements_multiline_text_aligned
elements_multiline_text_framed
elements_progress_bar_with_text
elements_scrollable_text_line
elements_string_fit_width
elements_text_box
До этого всё решалось заменой функций нижележащего фреймворка, тут же проблемы чуть посложнее — функции перебирают строки побайтово, а мне надо их переделать на посимвольный перебор.
Не везде, кстати, побайтовый перебор является проблемой. В первой же функции по списку всё будет работать нормально и без правок:
uint8_t lines = 1;
const char* t = text;
while(*t != '\0') {
    if(*t == '\n') {
        lines++;
        uint16_t temp_width = canvas_string_width(canvas, t + 1);
        str_width = temp_width > str_width ? temp_width : str_width;
    }
    t++;
}
Тут идёт подсчёт количества строк и вычисление их максимальной ширины. Для этого функция разбивает последовательность байтов по символу перевода строки — \n. Это работает, так как кодировка
В других же случаях
CP1251 во «Флиппере Зеро»
— Прощай, Фариа. Дни, проведённые с тобой, я запомню, как самые счастливые дни моей жизни. Но и я больше не жилец, потому что отсюда выходят только мертвецы.
— Сын мой, если отсюда выходят только мертвецы, то превратитесь в мертвеца!
Фильм «Узник замка Иф», 1988
С тех пор как я научился выводить во «Флиппере Зеро» русские буквы и написал игру «Виселица», мне всё не нравилось, что найденный способ не даёт возможности воспользоваться всем тем, что даёт фреймворк устройства — выравниванием, окнами и прочим.
К сожалению, всё АПИ так устроено, что на вход можно подавать только char, то есть только те символы, коды которых помещаются в байт, в данном случае.
Когда я научился манипулировать шрифтами, которые использует «Флиппер», мне пришло в голову, что если всё, что у нас есть должно поместиться в байт, то почему бы не сделать шрифт в однобайтной кодировке?
Я, конечно, не сомневался, что это заработает, но попробовать не помешало. Много времени не заняло. Взял русский пиксельный шрифт, преобразовал его в формат BDF утилитой otf2bdf, сдвинул русские буквы на их места в кодировке CP1251 и проверил работает ли это на самом деле.
Основной код выглядит следующим образом:
canvas_clear(canvas);
canvas_set_color(canvas, ColorBlack);
canvas_set_custom_u8g2_font(canvas, silkscr_rus);

char* str = recode_to_cp1251("ВЫВОД РУССКОГО ЯЗЫКА В КОМПОНЕНТ");
elements_multiline_text_aligned(canvas, 0, 0, AlignLeft, AlignTop, str);
free(str);
Текст приходится кодировать, но это единственное неудобство. Если всё что нужно помещается в байт, то способ рабочий.

BaSiX
Волею судеб попалась на глаза старая заметка, где я писал, что
То был
Нашёлся без проблем, интерпретатор называется BaSiX и реализует весьма небольшое подмножество бейсика, всего несколько команд, на котором
К сожалению, я совсем не знаю TeX, но подозреваю, что автору пришлось немало потрудиться, чтобы реализовать хотя бы то, что есть на этом языке —
Попробовал реализовать на BaSiXе вычисление значения числа «Пи» рядом Лейбница, получилось приближенное значение с небольшой ошибкой в четвёртом знаке после запятой.
00 print "Leibniz formula for PI. 2023. https://bolknote.ru"
10 let num=4000000
20 let den=1
30 let sum=0
40 let sign=1
50 if sign then let sum=sum+num/den
60 let sign=1-sign
70 if sign then let sum=sum-num/den
80 let den=den+2
90 if den<18663 then goto 50
100 print sum
run
Дробных чисел интерпретатор не поддерживает (и отрицательные числа, кстати, тоже), поэтому число «Пи» у меня выводится как целое: 3141699, но если поставить запятую на требуемую позицию, то будет довольно близко к 3,141592….
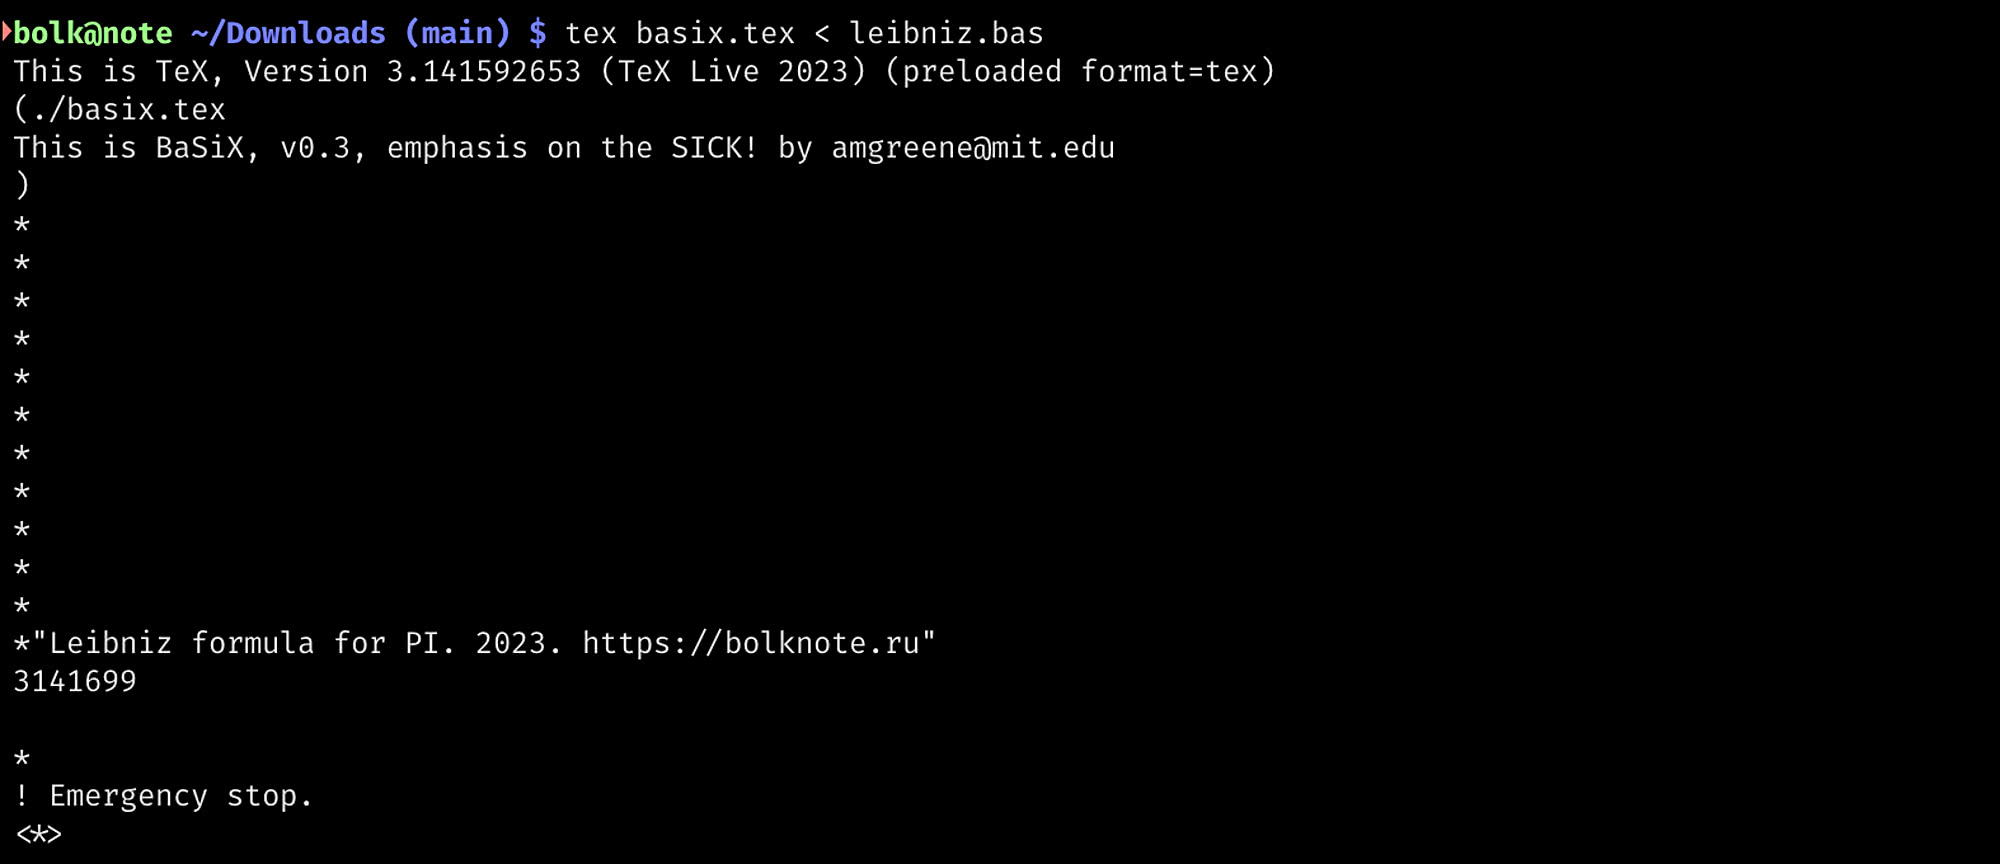
Ничего сложнее этого (например, «песню о пиве») написать не получится — в языке нет почти ничего для работы со строками, например у оператора print только один аргумент и тот выводится исключительно с переводом строки в конце.
Я пытался вчера вечером допилить интерпретатор при помощи ЧатаГПТ 3.5, но для кованого мешка такое слишком сложно.
«Дар агачы»
Давно появилась идея прикрутить к моей игре «Виселица» под «Флиппер Зеро» татарский язык. Я
Вчера из Института прикладной семиотики АН РТ прислали словарь татарских существительных. Я убрал из него все русские слова (в татарском немало заимствований из русского) и попробовал поиграть.
К сожалению, возникла проблема. В игре я использую два шрифта — 6×12 с нормальным начертанием и 6×13 с жирным. Шрифты готовые, взяты из фреймворка U∞g², я их только переупаковываю, чтобы в них оказались только те буквы, которые я использую в игре.
Оказалось в шрифте 6×13 нет татарских букв! Я этот момент проморгал, думал разница только в размерах. Клавиатуру я печатаю 6×12, поэтому проблему увидел только когда стал выводить татарские слова из словаря (там единственное место, где используется 6×13).
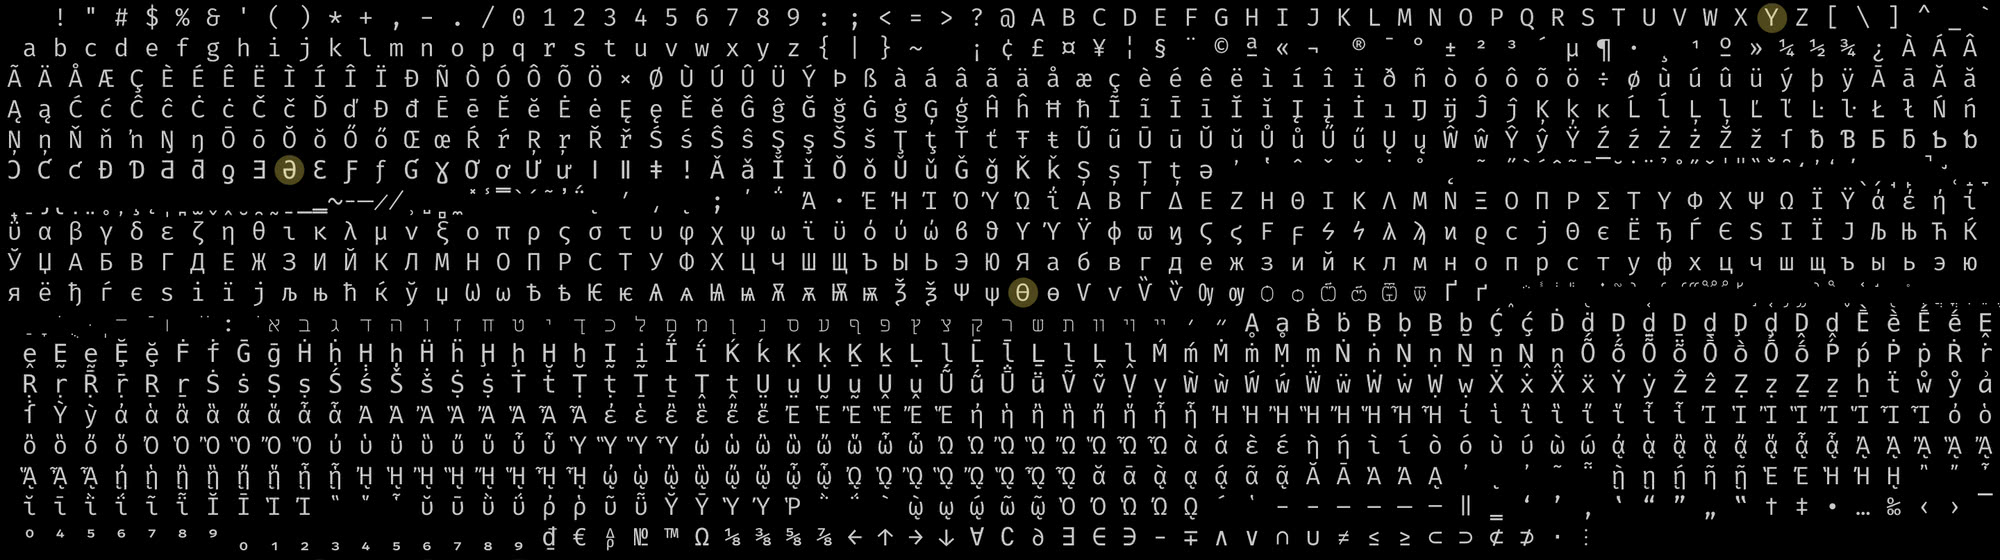
Попробовал посмотреть какие буквы есть в шрифте, чтобы подобрать похожие. Это несложно сделать в командной строке:
awk '/^ENCODING/{print $2}' 6x13B.bdf | xargs -n1 printf '%x\n' |
while read -r line; do printf "\\u$line "; done
Из того что есть нашлись замены для Ә, Ө и Ү, а вот для Җ, Ң и Һ похожих букв не обнаружилось.
Мысли у меня пока две: либо нарисовать недостающие буквы и научиться их добавлять в шрифт, либо обнаруживать ситуацию, когда нужных букв нет в шрифте 6×13 и переключаться на 6×12. Возможно в виде быстрого исправления я выберу второй вариант, а потом попробую реализовать первый.
Поддержка Юникода во «Флиппере Зеро»
Если помните,
Видно, что авторы не подумали о поддержке Юникода, поэтому он там работает
Ситуацию можно было бы немного улучшить простым патчем — надо всего лишь поменять в функции canvas_glyph_width тип входного параметра с char на uint16_t (эта функция возвращает ширину символа в пикселях) и она начнёт работать с кодировкой
Две недели назад я подумал — почему бы не попробовать предложить этот патч авторам прошивки. Если не примут, то может быть хоть в дискуссию вступят, всё польза. Скачал разработческую версию ядра, сделал правку и закинул патч.
Сегодня патч приняли без лишних слов. Вот это да, не ожидал! Справедливости ради, это небольшое изменение, которое не должно ничего сломать. Теперь хорошо бы подумать как сделать так, чтобы в остальном АПИ поддержка Юникода заработала. А там, кажется, малой кровью не обойдёшься.

Расширения GCC
Я с первого приложения использую атрибут __cleanup__, но там я ещё скромничал — он используется только один раз. А теперь осмелел и завёл себе макрос с __auto_type, о применении которого мечтал со времён случайного опыта программирования на Си++. Теперь и определения переменных идут стройными рядами, и задумываться о подходящих типах не приходится.
Братишка мне давно говорит, чтобы я не мучился со своим Си и писал на Си++, но ничего не могу с собой поделать: не люблю этот язык, просто