программирование
«Ahorcado»
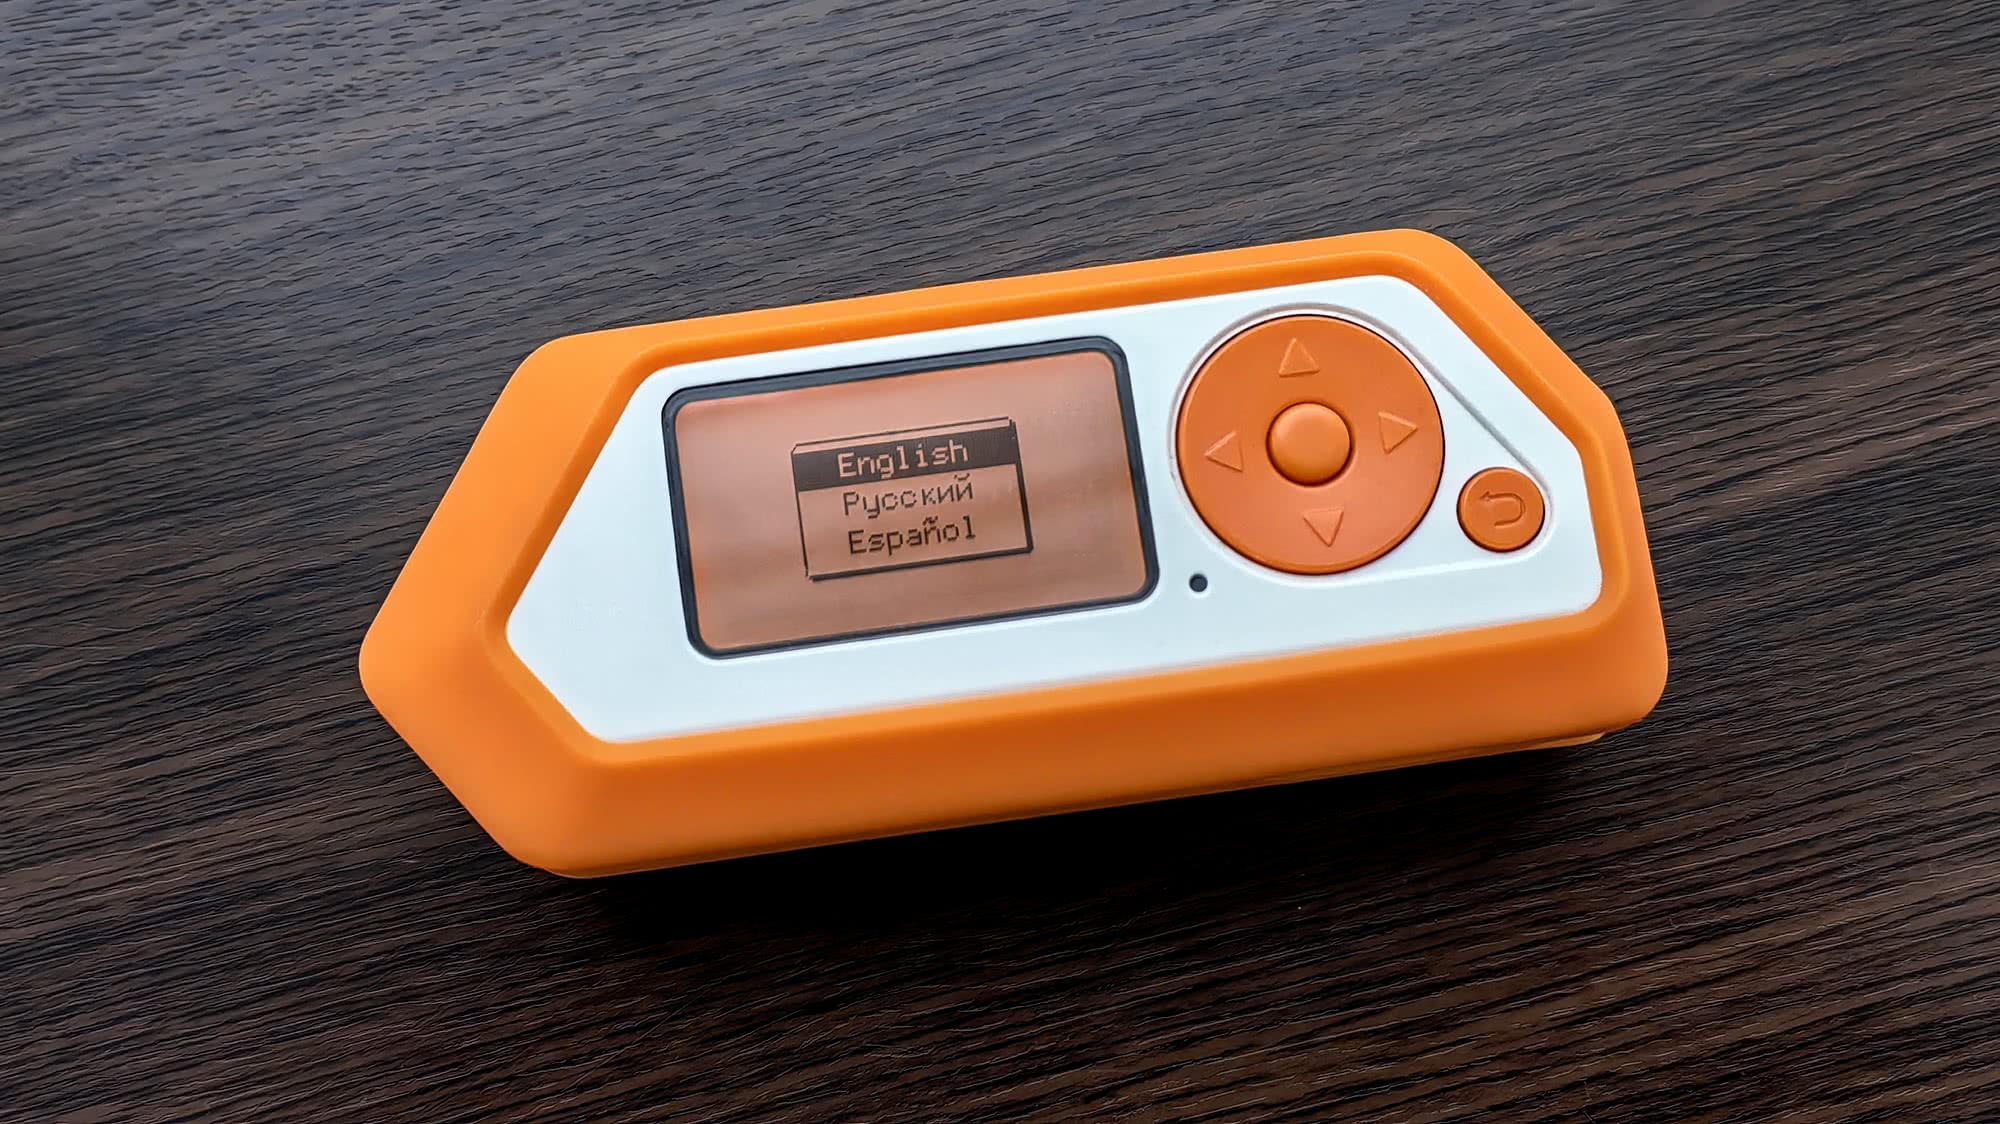
Загвоздка в том, что у меня в игре основной шрифт кириллический — я взял готовый шрифт из прошивки, а в этом шрифте нет «ñ» и других необходимых в испанском символов. Лучшее решение, которое мне пришло тогда в голову, — смотреть что за символ мы сейчас выводим и переключать шрифты, если в текущем нет нужного символа.
Посидел вечерок, всё неплохо заработало. Но когда рассказывал о своём решении братишке, он спросил меня почему я не попытался сделать свой шрифт, где есть все нужные мне символы. Такая мысль приходила мне в голову, но Си я знаю, а как создать свой шрифт для «Флиппера» — нет.
Но сказанное братом засело в голове и не давало покоя, тем более, что переключение шрифтов было очень похоже на крайне неизящный костыль. Пришлось разобраться с тем как собрать свой шрифт.
Оказалось, это совсем несложно — во фреймворке U∞g2 есть исходники тех же шрифтов, которые использует «Флиппер», и утилита bdfconv, которая умеет их пересобирать. А на специальной странице можно сгенерировать себе необходимую для сборки командную строку.
В ближайший свободный вечер хочу накидать код, который поможет собирать шрифт посимвольно — определит какие буквы используются у меня в программе и выдаст точные диапазоны. А то я пока помещаю символы целыми алфавитами, очень неэкономно.
«Виселица»: правлю баги
Игрушка «Виселица» для «Флиппера Зеро», которую мы
Один из пользователей пожаловался, что слова с русской буквой «Р» отображаются иногда
Проблема оказалось в сочетании того как я кодирую символы русских слов и следующей строки кода:
furi_string_trim(line);Для экономии места и производительности словарь у меня хранится в кодировке
Вызов furi_string_trim мне нужен, чтобы срезать перевод строки, после её считывания. Только я не учёл, что срезаются там все пробельные символы, включая урезанную до одного байта букву «Р».
В общем, создал себе проблем на ровном месте. Надо было хранить буквы как есть и не выпендриваться. Впрочем, баг правится просто:
furi_string_trim(line, "\n");Сжатие инструкций для CFR[]
Выложил свою программу для перевода растра в инструкции для интерпретатора CFR[]. Написана, к слову, на «Гоу».
Самая интересная часть там — про оптимизацию.
Я реализовал довольно очевидную идею — делаем две переменные, одна указывает на начало инструкций, вторая — на середину. Вырезаем подстроку между двумя этими индексами, ищем её сразу за правым индексом, если находим, заменяем на вырезанное, оборачивая в цикл и начинаем сканировать заново. Если не находим, сдвигаем сначала правый указатель к началу, повторяем поиск, потом левый к центру, повторяем поиск. Естественно по ходу надо отбрасывать куски, где не сбалансированы скобки, это совсем просто.

Кроме того, у нас есть восемь вариантов обхода картинки — по двум направлениям из каждого угла, что, если нет симметрии, даёт восемь разных наборов инструкций, которые сжимаются
При этом немного смещается координаты отрисовки картинки. Её можно было бы возвращать обратно, но зачем? Интерпретатор и так рисует в центре холста, так что сдвиг — это не принципиально, только размер кодирующей последовательности увеличится.
CFR[]
Прикольную штуку увидел на «Хабре» — минималистичный язык CFR[] для рисования картинок. Тамошнему народу
Синтаксис односимволный, C — циклическая смена цвета (доступно семь цветов), F — рисование со сдвигом по текущему направлению, R — смена направления на 45° по часовой стрелке и пара

Лучше всего таким способом рисовать
Состряпал небольшую программу, которой попереводил разные картинки в инструкции CFR[]. В ограничение до обидного мало что влезает, но небольшие надписи писать можно.
Пилю «Виселицу»
Не то, чтобы я не понимал, что сообщество владельцев «Флиппера» относительно небольшое, всё же это очень специфический инструмент, но всё же не ожидал, что написанная за выходные игрушка удостоится такого внимания.
Только выложил её на «Гитхаб», как мне написал автор одной из популярных альтернативных прошивок, прислал патч, исправляющий некую ошибку и попросил английскую версию, — хочет включить игру в свою прошивку.

Доброе слово и кошке приятно, поэтому вот уже несколько дней пилю поддержку других языков.
Для начала переделал сборку на другой инструментарий — ранее игра не собиралась через более распространённый uFBT, потому что мой код использовал
Для поддержки английского пришлось довольно много переделать, всё что осталось сейчас — вывести меню, наверное сегодня уже доделаю. Я замахнулся на конфигурируемую поддержку, по моей идее, можно будет очень просто добавить любой язык, для которого есть шрифт.

В итоге, файл описания выглядит как текстовый файл, где первой строкой написано название словаря, ниже стоит цифра, показывающая сколько букв будет выведено в строке, при рисовании клавиатуры, ещё ниже — зазор между буквами в угадываемом слове в пикселях, потом цифра, про которую я расскажу дальше, ниже — шестнадцатеричные коды букв в кодировке
Если открыть словарь для английского языка обычным текстовым редактором, то внутри будет текст, с русским такой номер не пройдёт. Объясню почему.
Когда я только начал программировать игру, начал я с упаковки русского словаря в программный код и генерации случайного слова. Оказалось, что быстро выбрать случайное слово
В словаре так и сделано. Поскольку внутри программы я храню различные состояния в виде массива, мне нужно знать минимальный получившийся код символа, чтобы вычитать его, преобразовывая код в смещение в массиве. Для русского языка минимальный код будет у буквы А — 0x10, как я показывал выше, то его и нужно записать в файл описания языка. Цифра 16 в нём — это и есть 0x10 в десятичной кодировке.
Надеюсь сегодня допишу всё что нужно и выложу новый вариант.
Пишем на «Флиппере Зеро» по-русски
★
Вкратце: в русским текстом работать можно, но сложно, код лежит на «Гитхабе».
Не мог не обратить внимание, что несмотря на приличное количество русскоязычных авторов программ для «Флиппера Зеро» и российское происхождение устройства, в софте под него нигде не обнаружилось ни одной буквы
Стало интересно — а есть ли вообще в устройстве поддержка русского языка? Сел вечерком за исходники прошивки и оказалось, что однозначного ответа на заданный вопрос нет. Частичная поддержка есть и её можно заставить работать, но она работает как будто по недосмотру — никто её не собирался делать, так случайно вышло.

Сейчас расскажу, что я имею ввиду и постараюсь покороче, никто сейчас не любит длинные тексты.
Внутри «Флиппера» довольно много всякого АПИ для вывода текста, от незатейливого, выводящего строку в заданные координаты, до довольно навороченного, умеющего переносить и выравнивать текст. К сожалению, с русскими буквами оно работать не умеет.
Под капотом у этого АПИ — очень известная в своей нише библиотека U∞g2, у которой по историческим, видимо, причинам есть два набора функций для работы со строками. Одни принимают только однобайтовую кодировку ASCII, другие работают в Юникоде.
АПИ «Флиппера», к сожалению, использует функции, которые с Юникодом работать не умеют. К счастью,
Первый из них — canvas_set_custom_u8g2_font.
Чтобы
Вот как я это делаю:
#include <u8g2/u8g2_fonts.c>
// …
canvas_set_custom_u8g2_font(canvas, u8g2_font_haxrcorp4089_t_cyrillic);
Файл u8g2/u8g2_fonts.c внутри себя содержит шрифты в особом формате, можно открыть его прямо в текстовом виде и посмотреть как всё устроено.
Шрифт мы выбрали, теперь надо
Плохая новость в том, что строки в коде мы обычно пишем в кодировке
Но canvas_draw_glyph, как можно понять из названия, выводит только один символ. Как же вывести строку? Достаточно просто — надо вывести её посимвольно, сдвигая координату на ширину символа. Звучит просто, но как это сделать?
Тут нас ждёт очередная засада. Дело в том, что canvas_glyph_width, которая должна бы это делать, принимает на вход только char, при том, что нижележащая u8g2_GetGlyphWidth преспокойно работает с Юникодом.
Поэтому я сделал просто — выдрал реализацию u8g2_GetGlyphWidth себе в исходники. В итоге мякотка моего решения выглядит вот так:
void unicode_draw_utf8_str(Canvas* canvas, uint8_t x, uint8_t y, char* str) {
    FuriStringUTF8State state = FuriStringUTF8StateStarting;
    FuriStringUnicodeValue value = 0;

    for(; *str; str++) {
        furi_string_utf8_decode(*str, &state, &value);
        if(state == FuriStringUTF8StateError) furi_crash(NULL);

        if(state == FuriStringUTF8StateStarting) {
            canvas_draw_glyph(canvas, x, y, value);
            x += unicode_GetGlyphWidth(&canvas->fb, value);
        }
    }
}
Тут unicode_GetGlyphWidth — скопированная реализация u8g2_GetGlyphWidth, а furi_string_utf8_decode используется для кодирования
Моя первая программа под Flipper Zero
Вчера вечером
Как я уже писал, документации на удивление мало, пришлось налегать на чужие исходники. Если касаться темы прокрутки экрана, то, по всей видимости, существуют два способа: перерисовывать экран самостоятельно, вызывая каждый раз компонент полосы прокрутки с нужным значением или заморочиться с созданием так называемой «сцены», разместить на ней виджет прокручиваемого текста и засунуть туда весь текст, который надо прокручивать, целиком.
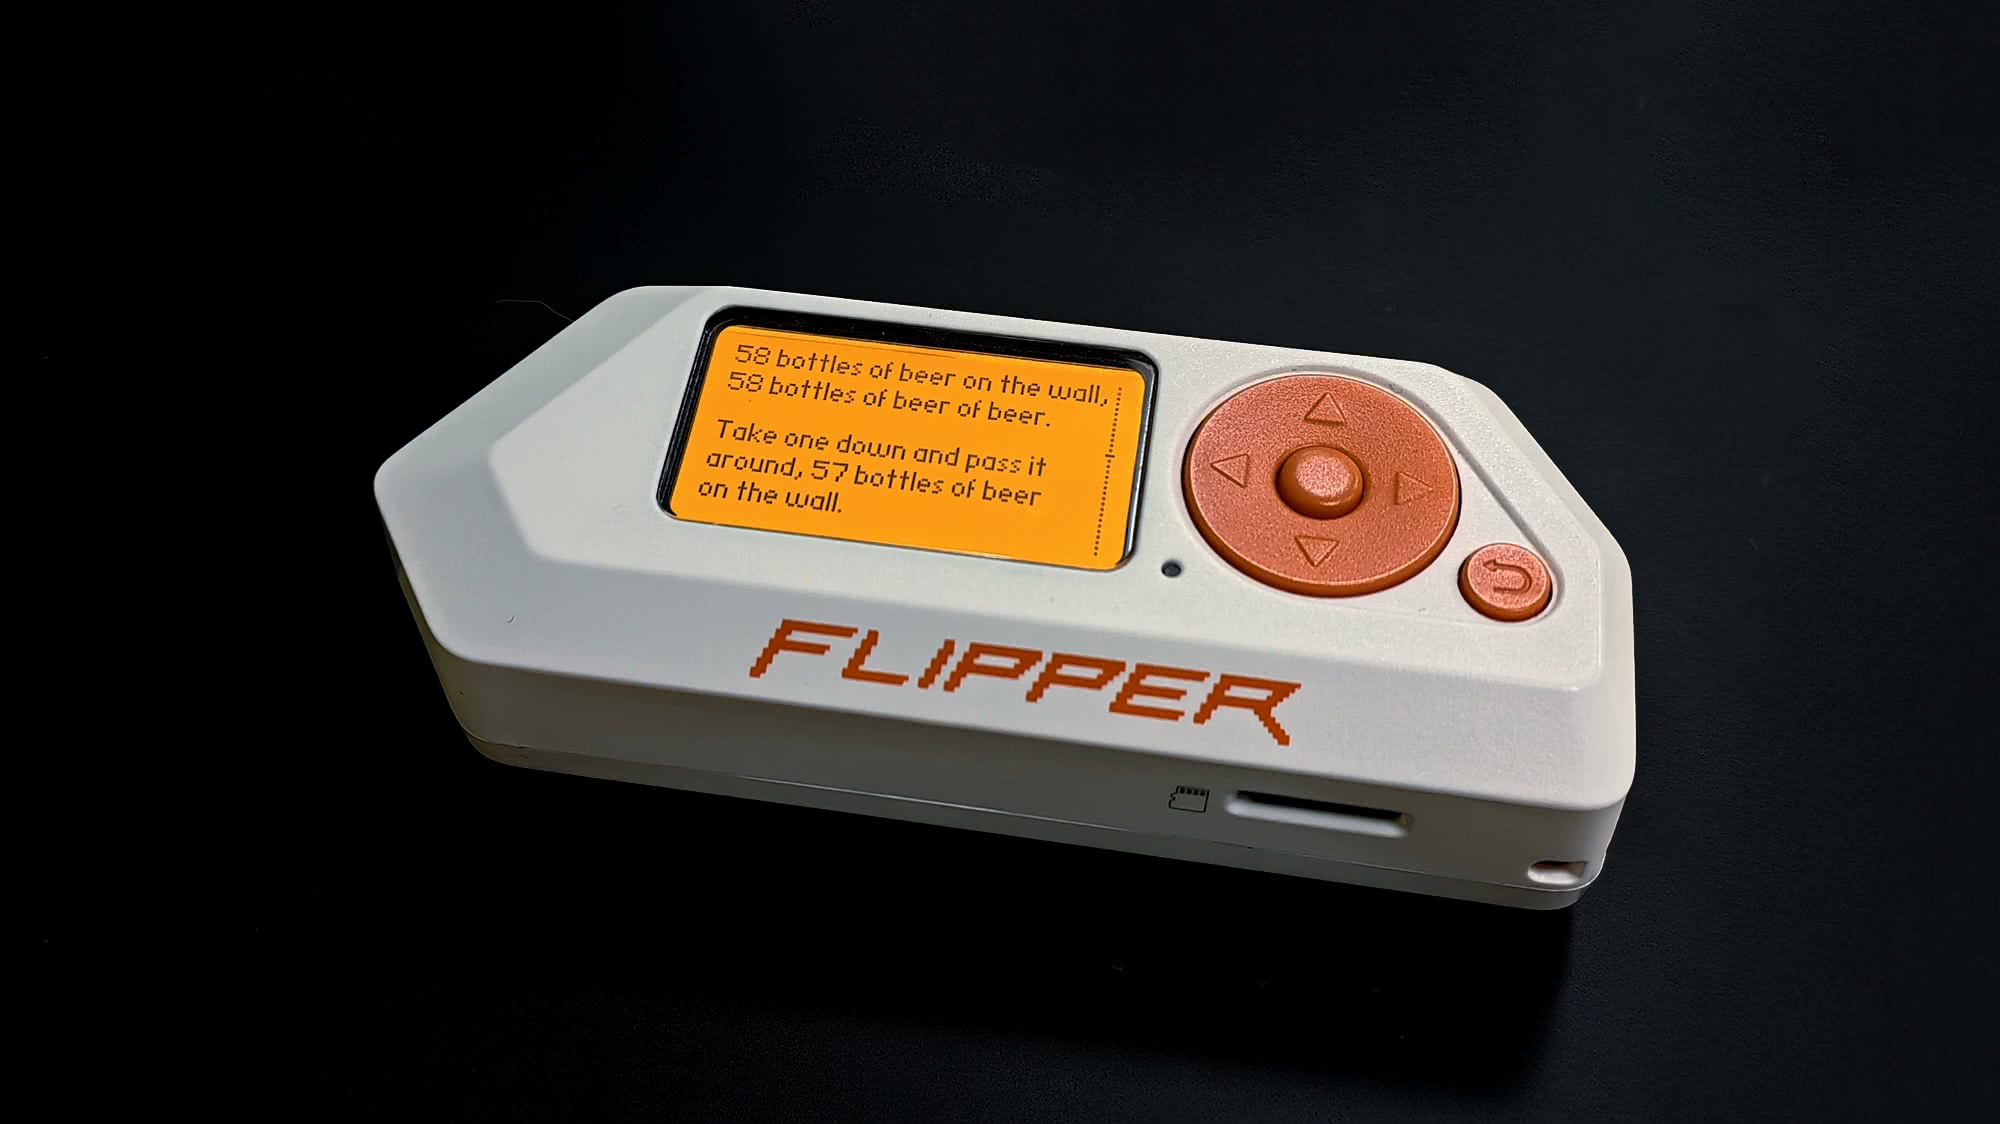
Второй способ больше подходит для многоэкранных приложений, поэтому его я не выбрал — для моих целей там слишком много мороки. Поэтому в этой части всё получилось достаточно просто:
void beer_render_callback(Canvas* canvas, void* ctx) {
    // …
    elements_scrollbar(canvas, BEER_MAX - pos, BEER_MAX + 1);
    // …
}

int32_t beer_main(void* p) {
    // …
    switch (event.key) {
        case InputKeyDown:
            if (app->pos > 0) app->pos--;
            break;

        case InputKeyUp:
            if (app->pos < BEER_MAX) app->pos++;
            break;

        default:
            break;
    }

    view_port_update(app->view_port);
    // …
}
В цикле опроса клавиатуры ловим клавиши «вверх» и «вниз», в соответствии с клавишей увеличиваем или уменьшаем счётчик, после чего вызываем перерисовку, в коллбеке которой выводим экран и полосу прокрутки с правильной позицией.
Возможно сделаю ещё автоскроллинг экрана на длинное нажатие клавиши, но пока не уверен, что мне хочется — может лучше
Программирую под Flipper Zero
Мне месяц назад на день рождения подарили «Флиппер Зеро» — «перочинный ножик для хакера». Довольно известное в узких кругах устройство, очень занятное. Но об этом
Давно подмывало
В интернете есть несколько статей о том как начать, которые мне очень помогли. Довольно быстро я научился собирать первое приложение, которые выводит строчку текста и опрашивает клавиатуру. По пути поразился сколько бойлерплейта (шаблонного почти одинакового для каждого приложения кода) пришлось написать. Очень не хватает
Пока застопорился — не пойму как прокручивать экран и есть ли
Не «Пайтоном» единым
Писал недавно про засилье «Пайтона» — там, где надо изобразить компьютерную программу, сейчас в основном используют в качестве основы именно этот язык, исключения встречаются всё реже.
И вот на днях, на конференции «Казан Диджитал Вик» встретил одно из приятных исключений — на одном из участников гонок на беспилотных миниавтомобилях была футблока

Это единственный язык, кстати, который я прочно забыл. Непонятно почему — писал на нём всё детство, а в Университете делал на «Делфи» (это диалект) несколько дипломных работ за деньги.
То есть плотненько работал с ним несколько лет, но когда два года назад поковырялся в нём в рамках решения одной из задач для программисткого
Invalid page in block XXX of relation YYY
Несколько раз в жизни сталкивался с ситуацией, когда «Постгрес» при попытке выполнить запрос, возвращает
Уже два раза я попадал в ситуацию, когда бакапа у клиента
Первым делом, разумеется надо отключить пользователей от базы данных, чтобы предотвратить её дальнейшее разрушение.
Второе, что надо сделать — посмотреть какая сущность у нас развалилась. Это можно сделать следующим запросом:
SELECT 23665::regclass::text;
    text
-------------
 some_items
Если это индекс, просто удаляем его и пытаемся снять полный дамп базы данных, записав какой индекс мы удалили. Подобные ошибки могут быть в других частях базы, поэтому повторяем до успеха.
Всё несколько хуже, есть речь идёт о таблице. Для начала надо определить строки с какими ID теперь недоступны и сдампить таблицу пока без них. Для этого я написал достаточно прямолинейную хранимую процедуру, которая пытается получить каждую строку, которая должна существовать и, если не удаётся, сообщает строка с каким ID недоступна.
CREATE OR REPLACE FUNCTION check_table(table_name TEXT) RETURNS VOID AS $$
DECLARE
    min_id INT;
    max_id INT;
    current_id INT;
BEGIN
    EXECUTE 'SELECT MIN(id), MAX(id) FROM ' || table_name INTO min_id, max_id;

    current_id := min_id;

    WHILE current_id <= max_id LOOP
        BEGIN
            EXECUTE 'SELECT * FROM ' || table_name || ' WHERE id = $1' USING current_id;
        EXCEPTION
            WHEN SQLSTATE 'XX001' THEN
                RAISE NOTICE 'Ошибка при обработке id: %', current_id;
        END;

        current_id := current_id + 1;
    END LOOP;
END
$$ LANGUAGE plpgsql;
Добавлено позднее: позже я написал другую функцию, которая учитывает, что разрушенные данные могут лежать в «тостах».
Дальше таблицу надо сдампить, составив SELECT, исключающий сбойные участки. Я, обычно, делаю ряд запросов, соединённых через UNION ALL и подставляю его в COPY, предварительно выключив последовательное сканирование таблицы (SET enable_seqscan = OFF).
Если этого не сделать, «Постгрес» обязательно займётся сканированием таблицы, так как нужна она почти вся, а там у нас сбойные участки. Отключив этот метод сканирования, мы заставляем обращаться к таблице через первичный индекс, если он, конечно цел. Хуже, когда разрушен и он.
Я с такой ситуацией ещё не сталкивался, но если столкнусь, буду думать над проверкой строк через ctid.
В общем, должен получиться примерно такой запрос:
SET enable_seqscan = OFF;

COPY (
SELECT * FROM some_items WHERE id < 100500 UNION ALL
SELECT * FROM some_items WHERE id > 100500 AND id < 100800 UNION ALL
SELECT * FROM some_items WHERE id > 100800
) TO '/tmp/some_items-table.dump'
После того как мы определили и сдампили все сбойные таблицы, можно сдампить остальную базу данных следующей командой:
pg_dump --exclude-table-data=some_items -j10 -Fd -Z1 -f /dump_directory dbnameКак видно, мы дампим структуру, но не данные сбойной таблицы (ключ —exclude-table-data можно указать несколько раз), при этом параметр -Fd нужен, чтобы мы могли снимать дамп параллельно сразу несколькими процессами, -j задаёт количество этих процессов, ключ -f указывает директорий, куда будет записан бакап, а -Z1 регулирует степень сжатия, —с уровнем 1 снятие дампа идёт с максимальной скоростью.
Наконец, успех: основная база лежит единым куском, сбойные таблицы сняты отдельными дампами. Что ещё можно сделать?
В одном из случаев у меня были несколько реплик, которые развалились
Если реплики нет, можно посмотреть какие индексы есть на сбойной таблице. Не исключено, что критичные столбцы покрыты индексами, которые остались целыми.
Данные из индексов можно вытащить, сделав запрос так, чтобы он затрагивал только столбцы, которые есть в индексе. Если в интересующем нас индексе нет ключевого столбца, не беда, там есть технический столбец ctid, по которому потом можно соединить данные построчно.
Если строки восстановить не удалось, а на таблицу ссылаются другие таблицы, надо заполнить недостающее любым мусором, чтобы внешним ключам было куда ссылаться.
Итак, теперь у нас есть большой дамп почти всей базы данных и один или несколько дампов таблиц. Как же всё соединить на другом сервере? Последовательность следующая.
Для начала восстанавливаем основную базу данных, но без индексов и внешних ключей:
pg_restore -d dbname -Fd /dump_directory --section=pre-data --section=data -j10Потом заливаем дампы отдельных таблиц, после чего доливаем индексы и внешние ключи:
pg_restore -d dbname -Fd /dump_directory --section=post-data -j10Если всё сделано правильно, должна получиться консистентная база данных. Осталось разобраться с двумя вещами: создать удалённые ранее индексы, если таковые были и, если вы создавали мусорные строки, то надо понять как с ними быть дальше. Например, удалить их или заполнить значениями «данные утеряны».
КБ и Кб
Я работают в айтишной компании и меня удивляет как много людей путают «КБ» (килобайты) и «Кб» (килобиты), «МБ» (мегабайты) и «Мб» (мегабиты) и так далее. Такая подробность может дорого обойтись, ведь разница между ними в восемь раз, регистр одной буквы изменит контрактные обязательства на невыполнимые и приехали.
Я в своё время придумал такое правило — байт («Б») больше бита («б»).
Ещё о печати строк в SectorC (лонгрид)
Недавно познакомился с интересным компилятором подмножества языка Си — SectorC. Он интересен тем, что влезает в один сектор (512 байт), но позволяет писать вполне реальные программы. В реализованном языке очень многого нет, тем не менее, это очень интересное достижение и мне было интересно поразбираться как всё сделано. Кстати, результат автора мне удалось в несколько приёмов уменьшить на несколько байт.
Для того, чтобы рассказать в чём смысл, надо для начала немного углубиться в то как работает этот компилятор.
Компилятор, когда разбирает код, делит его на токены по пробелу, после каждый токен хешируется функцией atoi в двухбайтовое число и уже по нему определяется является ли встреченное ключевым словом языка, либо именем функции или переменной.
В последнем случае, имя, преобразованное в число, будет в машинных кодах использовано как смещение, указывающее на ячейку со значением переменной или с указателем на тело функции.
Отсюда следует, что последовательно называющиеся переменные — a, b, c и так далее, с будут в памяти располагаться последовательно со смещением в два байта, точностью до переполнения. При этом их даже не обязательно определять — переменная с любым именем существует с начальным нулевым значением.
Идём дальше.
В языке есть любопытная операция — &, позволяющая получить адрес переменной, который, напомню, равен одновременно хешу (atoi) к её имени. Для однобуквенных имён это позволяет по полученному адресу восстановить код символа — надо поделить полученное значение на два и добавить 48 — код символа 0.
Таким образом, передав в функцию адреса & H, & e, & l, & l, & o, мы сможем восстановить из них символы и составить из них слово Hello. Если записать эти адреса в переменные, которые располагаются в памяти подряд, можно, читая память последовательно, выводить закодированную строку.
Есть ли в языке способ прочитать
Теперь всё вышесказанное можно соединить в следующий довольно компактный код:
void print_str()
{
    print_str_pointer = & _0;
    while( *(int*) print_str_pointer ){
        print_ch = ( *(int*) print_str_pointer >> 1 ) + 48; print_char();
        print_str_pointer = print_str_pointer + 2;
    }
}

void main()
{
    _0 = & H; _1 = & e; _2 = & l; _3 = & l; _4 = & o; _5 = 0;
    print_str(); // Hello
}
Простейший HTTP-прокси
У Романа Парпалака прочитал про «простейший HTTP-прокси». Ну нет, действительно простейший HTTP-прокси
Выглядит он так:
<?php readfile($_SERVER["REQUEST_URI"]);Запускается так:
php -S 127.0.0.1:8080 proxy.phpА вот так работает:

return в SectorC
Вчера перед сном пришло в голову, что один из недостатков языка SectorC, — отсутствие конструкции return, можно отчасти компенсировать средствами самого языка. Достаточно написать функцию return(), которая будет делать две вещи — возвращать значение (об этом ниже) и прерывать выполнение функции из которой её вызвали.
Я уже достаточно знаю об его внутренностях, чтобы понимать как это можно сделать.
Второе реализовать совсем просто, тут мне помогает некогда богатый опыт программирования на Ассемблерах. SectorC транслируется напрямую в машинный код, а значит адреса возвратов из функций хранятся на стеке. Так что надо всего лишь удалить верхний адрес возврата и мы вернёмся не в функцию, которая нас вызвала, а на уровень выше. Я делаю это командой pop ax.
Теперь посмотрим на первую задачу.
Как я уже писал язык устроен так, что присваивание переменных друг другу происходит через регистр AX, таким образом, присваивая переменную самой себе, мы помещаем её в этот регистр. Этот факт используется в стандартной библиотеке языка, так что можно считать, что это стабильное поведение.
Напрашивается следующая реализация, — перед вызовом присваиваем возвращаемую переменную самой себе, в функции return() записываем содержимое AX
Моя реализация вместе с примером использования ниже:
void return()
{
    // mov [&return], ax
    asm 163; asm 236; asm 229;
    // pop ax (clear stack from prev return address)
    asm 88;
}

void random()
{
    // xor ax, ax    int 0x1A         xchg ax, dx
    asm 49; asm 192; asm 205; asm 26; asm 146;
    // xor dx, dx    mov cx, 10
    asm 49; asm 210; asm 185; asm 10; asm 0;
    // div cx         inc dx  xchg ax, dx
    asm 247; asm 241; asm 66; asm 146;
    return();
}

void function()
{
    i = 0; while( i < 20 ){
        random();
        if( i >  return ){
            i = i; return();
        }
        i = i + 1;
    }

    i = 0; return();
}

void main()
{
    function();
    print_num = return; print_u16();
}
Кстати, возникает любопытный сторонний эффект — так как через AX делается не только присваивание, а вообще все операции, то функция return() захватывает любое последнее вычисленное выражение, что тоже может быть удобно.
Деление в SectorC
Очень неудобно, что в языке SectorC нет деления. Я сначала думал, что это
Но сегодня для интереса я попытался добавить в код новый токен для деления и оказалось, что места хватает. Закинул автору
Впрочем, SectorC устроен так, что в программе можно использовать машинные коды. Можно написать деление прямо в них, если воспользоваться ассемблером.
При этом надо знать две вещи: присваивание значения переменной происходит через регистр AX, так что присвоив переменную саму себе, можно записать в AX её значение, и второе — если посчитать atoi (см. мою вчерашнюю заметку) для имени переменной и умножить получившееся число на два, можно получить ячейку, где хранится значение этой переменной.
Так вычисленный результат можно будет положить куда вздумается.
Объединив всё вышесказанное, получим такой результат:
int div_a; int div_b; // input
int div_result;

void div()
{
    div_b = div_b;             // mov ax, [&div_b]
    asm 145;                   // xchg cx, ax
    asm 49; asm 210;           // xor dx, dx
    div_a = div_a;             // mov ax, [&div_a]
    asm 247; asm 241;          // div cx

    asm 163; asm 48; asm 193;  // mov [&div_result], ax
}

void main()
{
    div_a = 35500; div_b = 113; div();
    print_num = div_result; print_u16(); // «314»
}SectorCFuck
Очень интересно устроен разбор файла программы в компиляторе SectorC, который я ковыряю вечерами из любви к ненормальному программированию. Для тех, кто успел позабыть, напомню — этот компилятор занимает один сектор (512 байт) и способен выполнять программу на подмножестве Си.
Когда смотришь на код такого маленького объёма, сразу возникает вопрос — каким чудом удалось туда запихнуть грамматику языка Си, даже если
Автор использует реализацию функции atoi, которая превращает любые строки в шестнадцатибитное числа:
unsigned short sectorc_atoi(const char *s)
{
    unsigned short n = 0;
    for (;;) {
        char c = *s++;
        if (!c) break;

        n = 10 * n + (c - '0');
    }

    return n;
}
Все токены, которые встречаются в программе, обязательно разделяются пробелами (за исключением ;, для него есть специальная обработка). Это позволяет довольно просто парсить программу — любой токен скармливаем atoi, получаем число и по таблице смотрим с чем имеем дело.
Если в таблице число не находится, значит это переменная, её численное значение, умноженное на два, даёт двухбайтовую область памяти, где надо взять значение. Для чисел, видимо, есть
Перед запуском программа проходит через линтер, который не является частью компилятора. Он нужен для поиска ошибок в коде и коллизий в получившихся хешированных значениях. В последнем случае линтер останавливается с ошибкой, показывая хеши каких токенов совпали между собой.
Если линтер выключить, можно достигнуть интересного эффекта. Для каждого токена можно вычислить коллизию позаковыристей и написать всю программу без букв и цифр. SectorC как будто бы «из коробки» предназначен для запуска обфусцированного кода.
Ниже программа, выводящая «Hello» (её надо запускать без линтера):
<**^ ')'|] /=]
    -_.@" -[ )~( /@< $^+>\() /<'
    -_.@" -[ /<'' /@< $^+>\() /<'
    -_.@" -[ ,[~ /@< $^+>\() /<'
    -_.@" -[ +^^` /@< $^+>\() /<'
    -_.@" -[ /<(' /@< $^+>\() /<'
,[_
Я поленился и не стал рассчитывать разные значения для одинаковых токенов, которые упоминаются несколько раз, но можно сделать и это, тогда восстановление исходного текста будет безумно затратной задачей.

Обфусцированный таким образом листинг, запускающий файл и программу для поиска коллизий выложил на «Гитхаб», можно посмотреть подробности там.
Кстати, такое развлечение, когда мы не используем в программе
Свёртка строк на SectorC (лонгрид)
Вчера я обещал рассказать что я придумал, чтобы компактнее выводить строки в языке SectorC. Напомню, это компактный компилятор подмножества Си, который занимает один сектор (512 байт).
Для начала посмотрим что доступно в компиляторе для вывода текста. В самом языке для этого ничего нет, но если заглянуть в стандартную библиотеку языка, которая подключается автоматически, то можно увидеть там функции print_char(), print_u16() и print_i16(), предназначенные, соответственно, для вывода символа, заданного его кодом, целого числа без знака и целого числа со знаком.
Соответственно вывод «Hello» выглядит так:
print_ch =  72; print_char(); // H
print_ch = 101; print_char(); // e
print_ch = 108; print_char(); // l
print_ch = 108; print_char(); // l
print_ch = 111; print_char(); // o
Очень многословно. Когда я вчера написал «песню о пиве» в таком формате, программа получилась чересчур длинной. Мне захотелось
Код задаётся целым типом int, который имеет в этом языке 65536 значений. Поскольку мне нужны не все буквы, выглядит так как будто в одно число можно запихнуть несколько знаков. Но сколько?
Для начала посмотрим сколько символов вообще используется. Цифры меня не интересуют (числа выводятся отдельной функцией), поэтому выкинем их:
import sys
from collections import Counter
data = Counter(x for x in ''.join(sys.stdin.readlines()) if x > '9' or x < '0')

print(data)
Вот что получилось:
Counter({' ': 2306, 'e': 1305, 'o': 1108, 't': 903, 'l': 702, 'b': 601, 'n': 600, 'a': 598, 's': 497, 'r': 403, 'f': 300, 'w': 300, '\n': 298, 'd': 298, 'h': 202, ',': 200, '.': 200, 'u': 100, 'T': 99, 'i': 99, 'k': 99, 'p': 99, 'm': 4, 'G': 1, 'N': 1, 'y': 1})Двадцать шесть символов. Жаль не шестнадцать, было бы удобно хранить — как я говорил выше, значений в целом типе помещается 65536 штук. Какая связь? Чтобы это понять, разберёмся откуда взялось число 65536.
Оно вытекает из особенностей машинного хранения. Минимальная единица хранения — бит, хранит всего два состояния, — биты, в свою очередь, собраны по восемь штук в байты. Тип int в данном случае — это два байта.
Отсюда получается, байт — восемь бит по два значения или 2⁸ = 256 значений, два байта — 256² = 65536. В десятичной системе выглядит довольно бессмысленно, но если перейти на шестнадцатеричную, где цифры записываются от 0…9, A…F, с префиксом 0x (он ставится чтобы различить две формы записи числа), то становится понятнее.
Тогда число 65536 будет выглядеть как 0xFFFF — визуально распадается на два байта по 256 (0xFF) значений или на четыре полубайта по 16 (0xF).
Я решил хранить символы в полубайтах. Поскольку символов у меня 26, а в полубайте помещается 16 значений, то одно значение пришлось занять префиксом — если он встречается, то мы используем вторую таблицу символов. Под префикс я выделил 0xF. Таким образом, в одном int можно закодировать от двух до четырёх символов.
Например, число 0x2F40 или 0x2 0xF 0x4 0x0 означает, что мы смотрим второй символ в первой таблице, потом переключаемся на вторую (так как встретили 0xF) и смотрим там четвёртый символ, а символ 0x0 имеет специальное значение, — он не выводится и нужен для того, чтобы у нас была возможность закодировать строку, которая короче, чем могла бы поместиться.
В первую таблицу я поместил самые часто встречающиеся символы, во вторую — те, что встречаются реже. Получилось намного компактнее. Например, строка «hello» в моём алфавите выводится вот так:
s = 21023; ps(); s = 53; ps(); // 0x521F, 0x35Поскольку по техническим причинам число проще обрабатывать с конца, то я разворачиваю ту часть строки, которая кодируется. Это легко заметить по тому, что префиксное значение 0xF у меня находится в конце числа 0x521F.
Код для преобразования строк в такую форму выглядит следующим образом:
input = 'hello'

from itertools import *
# основная таблица
t0 = [' ', 'e', 'o', 't', 'l', 'b', 'n', 'a', 's', 'r', 'f', 'w', '\n', 'd']
# и дополнительная
t1 = ['h', ',', '.', 'u', 'T', 'i', 'k', 'p', 'm', 'G', 'N', 'y']

# поиск символов в таблицах
def conv(ch):
    try:
        yield t0.index(ch) + 1
    except ValueError:
        yield 0xF
        yield t1.index(ch) + 1

# подготовка к разбиению по группам, которые будут кодироваться вместе
def make_shifter():
    pos = 0
    gr  = 0

    def shifter(v):
        nonlocal pos
        nonlocal gr

        if pos == 4:
            pos = 0
            gr += 1

        # префикс переключения таблиц не может остаться в одиночестве,
        # поэтому мы не можем оставить его в хвосте
        if pos == 3 and v == 0xF:
            pos = 1
            gr += 1
        else:
            pos += 1

        return (v, gr, )
    return shifter

shifter = make_shifter()

# нумеруем группы символов
gen = (shifter(x) for x in chain(*(conv(ch) for ch in input)))
# собираем группы символов вместе
gen = groupby(gen, key = lambda x: x[1])

# двигаемся по собранным группам, собираем их в число
for x in gen:
    sum = 0
    for y in list(x[1])[::-1]:
        sum *= 16
        sum += y[0]

    print("s = {}; ps(); ".format(sum))
Теперь только осталось запрограммировать декодирующую часть в SectorC. У нас будет две функции — одна достаёт из числа по одном полубайту за раз, вторая преобразовывает полубайт в соответствующий символ. Как всё работает в деталях объяснять не буду, покажу с минимальными комментариями.
Первая выглядит совсем просто:
int s; // input
void ps() {
    while( s ){
        c = s & 15;
        c2c();
        s = s >> 4;
        if( s == ( 0 - 1 ) ){ s = 0; } // signed workaround
    }
}
Напоминаю, что вы языке у функции нет аргументов и возможности вернуть значение — всё делается через глобальные переменные, поэтому код выглядит странновато.
Строка с комментарием нужна, так как число у нас знаковое (то есть возможные 65536 значений делятся пополам, часть значений считается отрицательным, другая часть — положительными). У отрицательных чисел есть особенность — битовый сдвиг (>>) хоть и считается эквивалентом деления на два, но из минус единицы ноль не делает.
c2c тут — как раз функция, которая должна преобразовывать код в символ (
Сначала я так и сделал, но выглядело, опять же, громоздко. В итоге, переделал чуть попроще: код сравнения выделил в короткую функцию x(), а пару что во что превращается закодировал в один int:
int c; // input
int x;
void x() { if( c == ( x >> 8 ) ){ print_ch = x & 255; } }
После такого кодирования функция
void c2c() {
    c = c + shift;
    x =  288; x(); x =  613; x(); x =  879; x(); x = 1140; x(); x = 1388; x();
    x = 1634; x(); x = 1902; x(); x = 2145; x(); x = 2419; x(); x = 2674; x();
    x = 2918; x(); x = 3191; x(); x = 3338; x(); x = 3684; x(); x = 4200; x();
    x = 4396; x(); x = 4654; x(); x = 4981; x(); x = 5204; x(); x = 5481; x();
    x = 5739; x(); x = 6000; x(); x = 6253; x(); x = 6471; x(); x = 6734; x();
    x = 7033; x();

    if( c != 15 ){ print_char(); }
    shift = 0; if( c == 15 ){ shift = 15; }
}
Как видите, код 0xF (15) устанавливает флаг сдвига значений shift, который в следующий раз складывается с кодом (c + shift) и сдвигает значение на следующем декодировании. Заметно, что нигде нет else, потому что этого оператора в языке тоже нет!
Как будто бы рассказал всё.
Вместо вывода — интересный своей компактностью компилятор, автору моё уважение, — я даже и не подозревал, что в таком малом объёме можно уложить полноценный язык! Очень и очень круто!
99 бутылок: SectorC
Мне тут попеняли в комментариях, что я совсем забросил раздел, в котором я пишу на разных языках программирования американскую считалочку про пиво на стене. Я
Пора возобновить.
76. SectorC — очень маленький компилятор подмножества языка Си. Помещается в один сектор — 512 байт, отсюда и название. Язык очень сильно урезанный, но всё равно меня поражает как автор запихнул имеющееся в такой малый объём.
В языке нет строк и операторов
Самые распространённые в выходном тексте буквы я кодирую полубайтом от 0x1 до 0xE, а более редкие — байтом от 0xF1 до 0xFC. Завтра попробую описать это чуть подробнее.
Немного так же печалит, что нет локальных переменных, параметров и возвращаемых значений — всё передаётся через глобальные переменные, как в ранних Бейсиках. Кроме того, немного
// Written by Evgeny Stepanischev https://bolknote.ru
// SectorC

int c; // input
int shift; int x;

void x() { if( c == ( x >> 8 ) ){ print_ch = x & 255; } }
void p() { print_ch = c; print_char(); }

void c2c() {
    c = c + shift;
    x =  288; x(); x =  613; x(); x =  879; x(); x = 1140; x(); x = 1388; x();
    x = 1634; x(); x = 1902; x(); x = 2145; x(); x = 2419; x(); x = 2674; x();
    x = 2918; x(); x = 3191; x(); x = 3338; x(); x = 3684; x(); x = 4200; x();
    x = 4396; x(); x = 4654; x(); x = 4981; x(); x = 5204; x(); x = 5481; x();
    x = 5739; x(); x = 6000; x(); x = 6253; x(); x = 6471; x(); x = 6734; x();
    x = 7033; x();

    if( c != 15 ){ print_char(); }
    shift = 0; if( c == 15 ){ shift = 15; }
}

int s; // input
void ps() {
    while( s ){
        c = s & 15;
        c2c();
        s = s >> 4;
        if( s == ( 0 - 1 ) ){ s = 0; } // signed workaround
    }
}

void bottle()  { s = 17249; ps(); s = 596; ps(); }
void of_beer() { s = 6961; ps(); s = 41510; ps(); }
void on_wall() { of_beer(); s = 5937; ps(); s = 8692; ps(); s = 22721; ps(); print_char(); }
void o_more()  { s = 40723; ps(); s = 675; ps(); }

int b; // input
void bottle_b() {
    if( b == 0 ){ s = 55; ps(); }
    if( b > 0 ){ print_num = b; print_u16(); }
    bottle();
    if( b != 1 ){ c = 115; p(); } // s
}

void main() {
    shift = 0; b = 99;

    while( b > 0 ){
        bottle_b(); on_wall();

        s = 303; ps(); /* ', ' */ bottle_b(); of_beer();
        c = 46; p(); // '.'
        print_newline();
        b = b - 1;

        s = 2143; ps(); s = 4735; ps(); s = 4723; ps(); s = 31806; ps();
        s = 59265; ps(); s = 35057; ps(); s = 409; ps(); s = 5231; ps();
        s = 936; ps(); s = 59215; ps(); s = 303; ps();

        bottle_b(); on_wall(); c = 46; p(); // '.'
        print_newline(); print_newline();
    }

    c = 78;  p(); /* 'N' */ o_more(); bottle(); c = 115; p(); // 's'
    on_wall();
    s = 28975; ps(); /* ', n' */ o_more(); bottle(); c = 115; p(); // 's'
    on_wall();
    c = 46;  p(); // '.'
    print_newline();

    s = 5039; ps(); s = 16692; ps(); s = 4639; ps(); s = 41801; ps();
    s = 30738; ps(); s = 1566; ps(); s = 53071; ps(); s = 913; ps();
    s = 4767; ps(); s = 41887; ps(); s = 4850; ps();
    b = 99; bottle_b(); on_wall(); c = 46; p(); // '.'
}Модуль scalar_objects
Очень мне нравится идея навести порядок в функциях ПХП при помощи присобачивания к примитивным типам
К именованию встроенных функций есть много претензий:
- различный стиль наименований: html_entity_decode, но htmlentities;
- неинтуитивность некоторых названий: strcspn, strpbrk;
- разный порядок параметров: strpos($haystack, $needle), array_search($needle, $haystack);
Считается, что это один из серьёзных недостатков ПХП. Напрашивается очевидное решение — сделать всем проблемным функциям алиасы, но так язык замусорится ещё сильнее.
А вот добавив псевдометоды у примитивных типов, можно сразу сразу сделать хорошо. Один из контрибьютеров даже сделал модуль, который показывает как это могло бы выглядеть:
declare(strict_types=1);

class IntHandler {
    public static function abs(int $self): int {
        return abs($self);
    }

    public static function div(int $self, int $other): int {
        return intdiv($self, $other);
    }

    public static function sqrt(int $self): float {
	return sqrt($self);
    }
}

register_primitive_type_handler('int', 'IntHandler');

$i = -5;
var_dump($i->abs()->div(2)->sqrt()); // 1.4142135623730951
Разумеется, если это решение поместить в язык, никаких классов регистрировать не надо будет, так что можно смотреть только на последнюю строку.
Кроме того, повышается читаемость. Сравните два подхода
$result = substr(strtr(rtrim($className, '_'), '\\', '_'), 15);
$result = $className->trimRight('_')->replace('\\', '_')->slice(15);
Как по мне, очень хорошее решение, совершенно непонятно почему оно ещё не в языке.
«Гопник-2»: убрал printf
Закончил убирать функцию printf, сегодня вколотил последний гвоздь в крышку её гроба. Я
В процессе замены встретилось вот такое. Загадка, всё ли хорошо в следующем коде?
std::cout << fmt::format(" {}(+{})", main_hero->inv[i].name, main_hero->inv[i].armo)Мой компилятор считает, что всё, но сборка на «Гитхабе» падает с ошибкой «Binding packed field error».
Получается, я по неведомой причине не могу обратиться по ссылке на поле внутри упакованной структуры (fmt::format принимает параметры по ссылке).
Структуру я пакую, чтобы нивелировать различия на бинарном уровне между компиляторами, — так как я её сохраняю и восстанавливаю как есть. В общем, от упаковки не отказаться, пришлось присвоить значения промежуточным переменным:
const auto name = main_hero->inv[i].name;
const auto armo = main_hero->inv[i].armo;

std::cout << fmt::format(" {}(+{})", name, armo);
Выглядит, как костыль, но самое главное — почему один компилятор требует промежуточные переменные, а другой умеет и без них?
Я бы понял, если бы «Гитхаб» собирал мне бинарники