Прощай, iPhone!
Хорошо бы, чтобы состояние Caps Lock привязывалось к текущему приложению
В Windows очень разумно сделано переключение раскладки — переключается не сразу во всей системе, а в текущем приложении, в отличие от Mac OS (кажется, там это недавно поправили). В самом деле, я могу писать письмо
В родимом Татарстане у человека легко может стоять до пяти раскладок (русская, английская, татарская в двух ипостясях, арабская и турецкая, скажем).
Мне удобно, чтобы раскладка сохранялась, ведь в каждом окне я могу писать на разных языках.
К сожалению, разработчики не пошли чуть дальше и не выдрали к чертям кнопку Caps Lock не наделили той же функцией, ведь если я пишу
Привет из прошлого

Сфотографировано в помещении бывшего печатного цеха в Екатеринбурге.
Как мы видим, цех просуществовал, как минимум
Доделаю новый дизайн сайта, надо будет выложить.
Москва ✈ Казань ✈ Москва
С третьего по седьмое ноября мы в Казани.
Эпидемия самолётов?
У нас что, самолёты мрут, как мухи? Эпидемия?
Позвонили из авиакомпании «Татарстан». Пару месяцев назад мы покупали билеты, чтобы слетать на Новый год в Казань, туда купили у «Авиановы», обратно было выгодно «Аэрофлотом». Обе компании отменили те свои рейсы. Мы купили новые билеты, в Казань купили у «Трансаэро», обратно — у «Татарстана».
Теперь «Татарстан» тоже отменяет рейс. Страннее всего то, что рейс не «чиповый», по вполне нормальной цене.
Мы попросили возврат денег, купили обратный у «Аэрофлота», на другой день.
Добавлено позднее: звонили из «Аэрофлота», завтра надо в офис компании,
Как работают дисконты
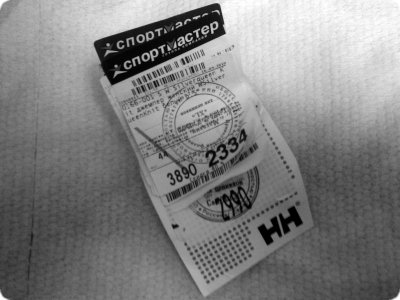
По ценнику очень хорошо видно частую практику дисконтных магазинов — товар впервые «вышел на арену» по цене 2990 рублей, в Самаре, оттуда переехал в Москву, где цена повысилась до 3890, оттуда попал в Казань, где ему сделали скидку до 2334.
По последнему налепленному ценнику скидка 40%, от самарской цены — около 20%. Какая цена была до того как товар попал в дисконт, не знаю, может ещё ниже.
Canon EOS 550D
Мы с женой
Раз уж родители и братишка тоже вложились в покупку, последовали многочисленным советам фотографов — взяли сразу и объектив Tamron Canon SP AF
Карточку взяли на 4ГБ, мне кажется, нам пока хватит. 2ГБ на мыльнице нам хватало.
Тест на внимательность
Стащу у Экслера ссылку — тест на внимательность.
Задание 1: найдите букву «C» среди «О»
OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOCOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO OOOOOOOOOOOOOOOOOOOOOOOOOOOOOOO
Задание 2: теперь найдите цифру 6
99999999999999999999999999999999999999999999999 99999999999999999999999999999999999999999999999 99999999999999999999999999999999999999999999999 69999999999999999999999999999999999999999999999 99999999999999999999999999999999999999999999999 99999999999999999999999999999999999999999999999
Задание 3: теперь найдите букву «N»
MMMMMMMMMMMMMMMMMMMMMMMMMMMMNMM MMMMMMMMMMMMMMMMMMMMMMMMMMMMMMM MMMMMMMMMMMMMMMMMMMMMMMMMMMMMMM MMMMMMMMMMMMMMMMMMMMMMMMMMMMMMM MMMMMMMMMMMMMMMMMMMMMMMMMMMMMMM
Я, кстати, нахожу очень быстро — доли секунды. Сначала глазом зацепляю нерегулярность, потом фокусируюсь и смотрю что там такое. Я так же ошибки в исходниках ищу, кстати.
Наконец-то купил билеты в «Аэрофлоте»
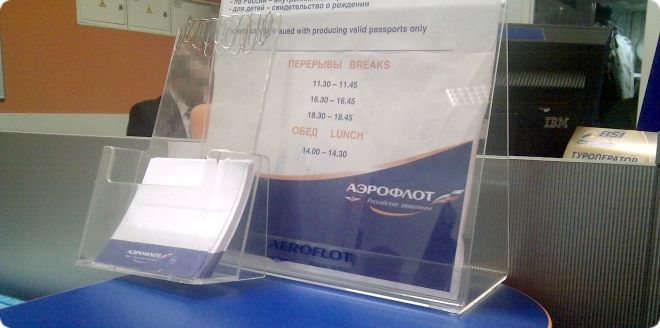
Надеюсь, эпопея с самолётами завершилась. Сегодня сходит в офис «Аэрофлота» и купил билет.
«Аэфрофлот» — чёртов совок, четыре перерыва в день, конская очередина, работают два окна из восьми и, думаете, они извинились за то, что сняли деньги с карточки и не смогли мне отдать билет? Как бы не так!
Они продали мне билет заново, содрав ещё 700 рублей «за обслуживаение», то есть за то, чтобы денежку у меня принял не бездушный робот, а испуганная кассирша, печатающая двумя пальцами.
PHP, UTF-8: седьмой этап, давайте что-нибудь сделаем с регулярными выражениями
В прошлый раз я рассматривал, по сути, самый сложный этап — замену всех вхождений $var[$index] и им подобных на вызов моей функции. В процессе замены я несколько раз корректировал заметку и доводил некоторые вещи руками.
В самой первой части я рассказывал о том как можно решить проблему К сожалению, этот «глагол» появился только в PCRE 8.10, а в самом последнем PHP, на сегодняшний момент, содержится 8.02. Как я говорил ранее, новый PCRE можно вкомпилить в PHP при помощи специального ключа. Внутренние сервисы, где я работаю, используют Поскольку мы сейчас переходим постепенно на новую версию Ubuntu (с Hardy Heron на Lucid Lynx), то часть машин у нас пока на Цапле, а часть — уже на Рыси. Это значит, что пакетов нужно будет собрать шесть. Дело это непростое. Я решил попробовать «выдрать» из внутренностей PHP модуль PCRE, переименовать его функции и константы и поставить его как простой подключаемый модуль. Мне удалось сделать, модуль «свежего PCRE» (можно скачать в разделе «Храню»). Модуль называется ygx, все функции начинаются с префикса «ygx_», константы — с «YGX_». Что это за сокращение, не спрашивайте, когда я начинал работать, я это знал, а сейчас забыл. Сложнее всего было корректно переименовать только те функции, типы, константы и так далее, которые видно в PHP, не задев всё то, что импортируется из внешней библиотеки PCRE. Ставится модуль примерно следующим образом: потом нужно прописать в php.ini строку «extension=ygx.so», перезапустить Поскольку к этому моменту все вызовы функций PCRE у меня заменены на вызовы одноимённых методов статического класса UTF, то мне нужно поменять «preg_» на «ygx_» только в одном месте — внутри методов этого класса.Что же дальше?
mkdir /tmp/pcre
cd !:1
wget ftp://ftp.csx.cam.ac.uk/pub/software/programming/pcre/pcre-8.10.tar.bz2
tar xvfj pcre-8.10.tar.bz2
cd pcre-8.10
./configure --prefix=/usr/local/pcre-8.10 --enable-utf8 --enable-unicode-properties --disable-static
make && make install
cd -

wget /files/php_fresh_pcre.zip
unzip php_fresh_pcre.zip
phpize
./configure --with-ygx-regex=/usr/local/pcre-8.10
make && sudo make install
phpize --clean
cd ; rm -rf /tmp/pcre
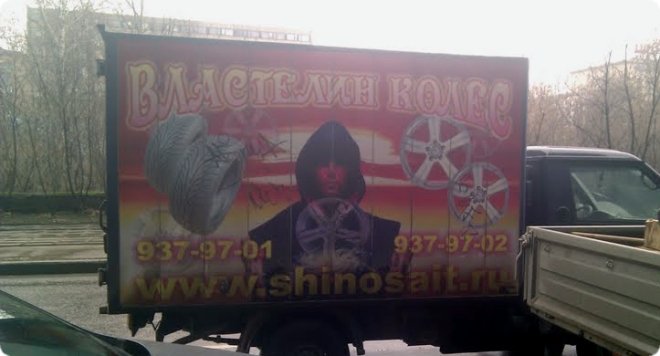
Креатив: «Властелин колёс»
Как там штанга?
После последнего серьёзного отравления резко ухудшилось здоровье, я потерял в весе около 5 кг, ухудшилась выносливость. В последнее время на спортивном поприще я был занят только тем, что выравнивал результат на состояние до отравления.
Сейчас уже
Что за проект я перевожу на UTF: FAQ

Из комментариев на одном из сайтов Димы видно, что люди делают
Так что небольшое FAQ.
В: Долго ещё до конца сериала? О: Следующая часть будет последней.
B: Что за проект переводится
B: Зачем переводится? О: Все остальные внутренние сервисы «Яндекса»
B: Нельзя ли переписать это всё на другой язык, где нет проблем
В: Зачем нужно было всё автоматизировать? О:
В: Почему бы нанять сотню студентов, за копейки, чтобы они сделали замены руками? О: За этими студентами нужно проверять работу, кто это будет делать? Я за собой вычитывал исходники, распечатывал листы diff’ов, уходил
День рождения сайта
Сегодня, кстати, моему сайту исполняется 10 лет. Я планировал к этому сроку выложить старые материалы, сменить дизайн, но ничего не успел, задача перевода Вики
Буду делать потихоньку.
Не удаётся установить доверительные отношения
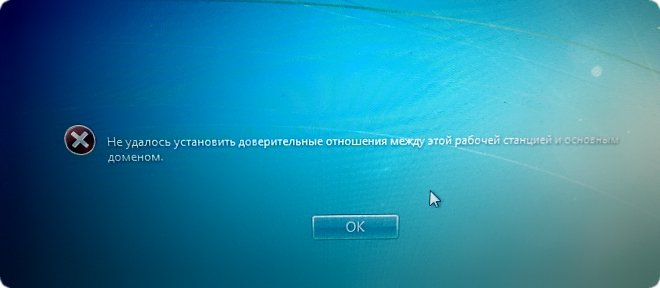
Моему ноутбуку нужен психолог.
Вред различных наркотиков

В авторитетном медицинском журнале The Lancet появилась статья «Drug harms in the UK: a multicriteria decision analysis» (подробности лучше посмотреть на сайте DocMe, там бесплатно).
Для тех, кто не понимает английский, цветом синего оттенка выделен вред для окружающих, бежевым — для употребляющего.
Из графика следует, что алкоголь вреднее для потребляющего, чем кокаин, табак, амфетамин, конопля, кетамин, метадон, бутират, ЛСД, экстази, наркотические грибы и ещё бог знает что, я даже в фильмах такие названия не слышал.
Кстати, в России курит 40% населения страны, это первое место среди всех стран, которые считаются основными потребителями табака. Я даже не думал, что всё настолько плохо. Заметьте, где на графике табак, он чуть менее вреден, чем «кокс»!
Авторы книг, опишите персонажа сразу или никогда
Читаю книгу Найджела Воттса «Как написать повесть». Не то, чтобы я задумал написать повесть в ближайшее время, но всегда интересовало стоит ли за этим
Наткнулся в книге на описание одной из ошибок автора, которую я часто замечаю в книгах — когда чересчур долго тянут с описанием местности, погоды, действующего героя или вводят
Несколько таких ошибок подряд сильно раздражают: только представил себе персонажа, а оказывается, что он не так одет, другого пола, да ещё и с рогами. По ощущениям как будто начал бежать и споткнулся.
Авторы! Не делайте так!
У Воттса на эту тему сказано кратко и по делу. Рекомендую.
Добавлено: я, конечно же, не имею ввиду литературный приём, когда детали не раскрываются
Ещё про алкоголь
Кстати сказать, самая низкая смертность в России — в тюрьмах. Примерно в три раза ниже, чем на свободе среди мужчин того же возраста. Там все ужасно — и туберкулез, и психологическая обстановка, и питание — зато доступа к алкоголю в тюрьмах нет
Из статьи в Эсквайере «Море внутри».
«Как пилят в Транснефти»
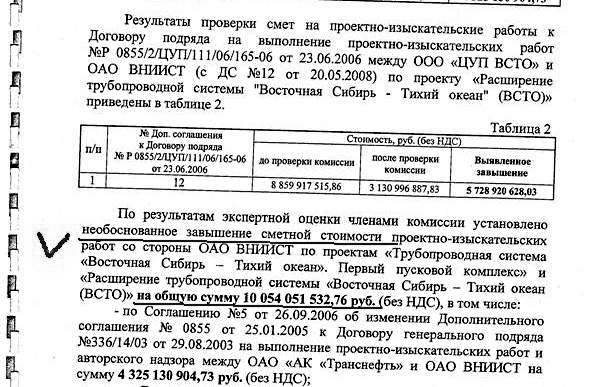
Новое расследование Навального «Как пилят в Транснефти»:
Еще раз обращаю внимание: это не мой доклад, это не мнение аналитиков или экспертов. Это официальные материалы компании Транснефть, подготовленные и подписанные десятками ее сотрудников. (…) Всего, по нашей оценке, по ходу этой истории было украдено не менее 4 млрд долларов.
На скриншоте — одна из страниц (как утверждает Навальный) официального расследования, по ссылке можно скачать его полностью (17,5МБ текста, несколько сотен страниц).
Кроссбраузерный data URI в CSS-файлах (подробно)
Кстати, всё забываю порекомендовать статью Banderlog’а, который написал её по мотивам моей статьи «Кроссбраузерный data URI
Статья на Хабре называется «К вопросу о кроссбраузерных Data URI».
Перевод часов — экономия 0,3%?
Леонид Каганов написал статью «Откуда берется ток, и зачем мы переводим часы».
Ко всему прочему для меня, простого горожанина, остается загадкой, что
все-таки такое — экономия энергии и чья она, экономия? Ктоэкономит-то? Я не понимаю. Город лег спать на час раньше, поэтому горожане на час меньше жгли свет в своих домах. Фонари все равно горят до утра — им дела нет. Троллейбус объедет маршрут те же 20 раз по суточному расписанию, ему перевод стрелок без разницы, если не считать три несчастные лампочки в салоне. Помидоры в теплице тоже часов не переводят. Речь только об освещении людей — чтобы световой день больше совпадал с нашим циклом бодрствования, чтобы меньше гореть лампам в зданиях. Экономическая выгода? Ну так замени свои лампочки на энергосберегающие — вот тебе 60% экономии, а не 0,3%. А замени на светодиодные — экономия и вовсе 90%…
Что-что ты там говоришь, читатель? Слишком дорогие пока светодиодные лампы, ты не готов на них тратиться? Верно. Получается, ты для себя решил, что оставить в квартире старые лампы тебе будет дешевле. Тебе. А экономия для энергетической отрасли тебя не волнует? Почему? Наверно потому, что она здесь ни при чем — ведь ты платишь за свет свои деньги, а не получаешь его бесплатно, верно? Поэтому тебе и решать, менять лампочки в целях экономии или не менять.
У меня ощущение, что Леонид несколько передёргивает, так как мне лично понятно кто экономит — «традиционные» офисы, заводы, кто ещё. «Традиционные», потому что в необычном «Яндексе» экономия вряд ли
Но по словам энергетиков экономия составляет смешные 0,3%! Было бы
Как заменить одну строку на другую в файле (Linux)
Устал я от долгих споров, давайте
Вот несколько способов, которые я знаю.
replace 'hello' 'bye, bye!' -- myfileСамое замечательное, что она умеет менять пары подстрок, что позволяет производить такие замены:
bolk-dev ~ $ echo ABBA | replace A B B A  --
BAAB
Второй способ — создать временный файл, заменить в нём символы или подстроки
T=`/bin/tempfile`
sed 's/hello/bye, bye!/g' myfile > $T
mv $T myfile
Сразу в тот же файл записывать результат нельзя, операция „>“ сразу же откроет файл на запись и обнулит его. Поможет утилита sponge (входит в пакет moreutils):
sed 's/hello/bye, bye!/g' myfile | sponge myfileОна запишет stdin в файл разом, после того как все данные будут получены.
Добавлено: Азат в комментариях подсказывает, что можно воспользоваться ключом
sed -i 's/hello/bye, bye!/g' myfileНачали ходить на скалодром
Мы с женой начали ходить на скалодром (Лена, спасибо, что вытащила нас!), пока были на двух занятиях, а я заметил странную вещь. Больше всего у меня после занятий устают пальцы, предплечья каменеют, пальцы не сгибаются и почти не держат, это не странно, странно то, что на следущее утро могут побаливать любые мышцы, только не те, которые отвечают за пальцы.
Сегодня болят
Кстати, зря я вчера сходил на тренировку. Ещё с утра ощущал себя
«Китайский спортсмен Ля Х… (кто?) стал победителем в тяжелой атлетике»
Кроме того, возможны звукосочетания, вызывающие в принимающем языке нежелательные ассоциации с лексикой сниженного регистра, включая вульгаризмы и бранные слова (…) Можно привести также в пример и имя персонажа шекспировской пьесы «Зимняя сказка» Perdita (…)
У Шекспира оно несёт ещё и смысловую нагрузку, будучи образовано от латинского причастия со значением «потерянная»; (…) весьма удачным представляется решение выдающегося переводчика В. В. Левика, назвавшего этот персонаж именем Утрата.
(…)
Принцип благозвучия учтён и в правилах практической транскрипции китайских имён, которые приходится передавать при переводе с языков, пользующихся латиницей, на русский язык (см. приложение 5.6; например, слог hui передаётся
по-русски соответствиями хуэй или хой).
Из книги «Имена собственные на стыке языков и культур» Д. И. Ермоловича.
В Китае достаточно распространены (для того чтобы попасть в нашу прессу) фамилии, от которых у русского интеллигента уши завянут. Мне всё хотелось узнать — а почему
Оказывается, имена, фамилии, названия изменяли, чтобы звучали благозвучно.
Это, кстати, общая проблема. Для уха англоговорящих вряд ли благозвучны фамилии Аршавин (arse shaving), Жирков (jerk off), Шитиков (shit), в Татарстане веселье вызывает марки Petek (похоже на «бетэк»)
Даже создатели Dojo не читают документацию
Class Sample
  Public Property Let someprop(val)
    …
  End Property
  Public Property Set someprop(val)
    …
  End Property
  Public Property Get someprop
    …
  End Property
End Class
Два вида сеттеров связаны с тем, что в VBScript довольно чётко различаются передача по ссылке и по значению (например, можно в параметрах функции указать «ByRef» или «ByVal»), кроме того, у сеттеров и геттеров есть ещё один параметр, благодаря чему можно перехватывать вызов методов и делать совсем уж странные, с точки зрения JavaScript, штуки.
Впрочем, к чёрту подробности.
Один из разработчиков
Но в IE уже есть специальный метод объекта window, который занимается тем же — execScript, вторым параметром надо задать «vbscript» и voilà!, мы вызываем VBScript из JavaScript.
Я этот метод
Туляки подковали-таки блоху!
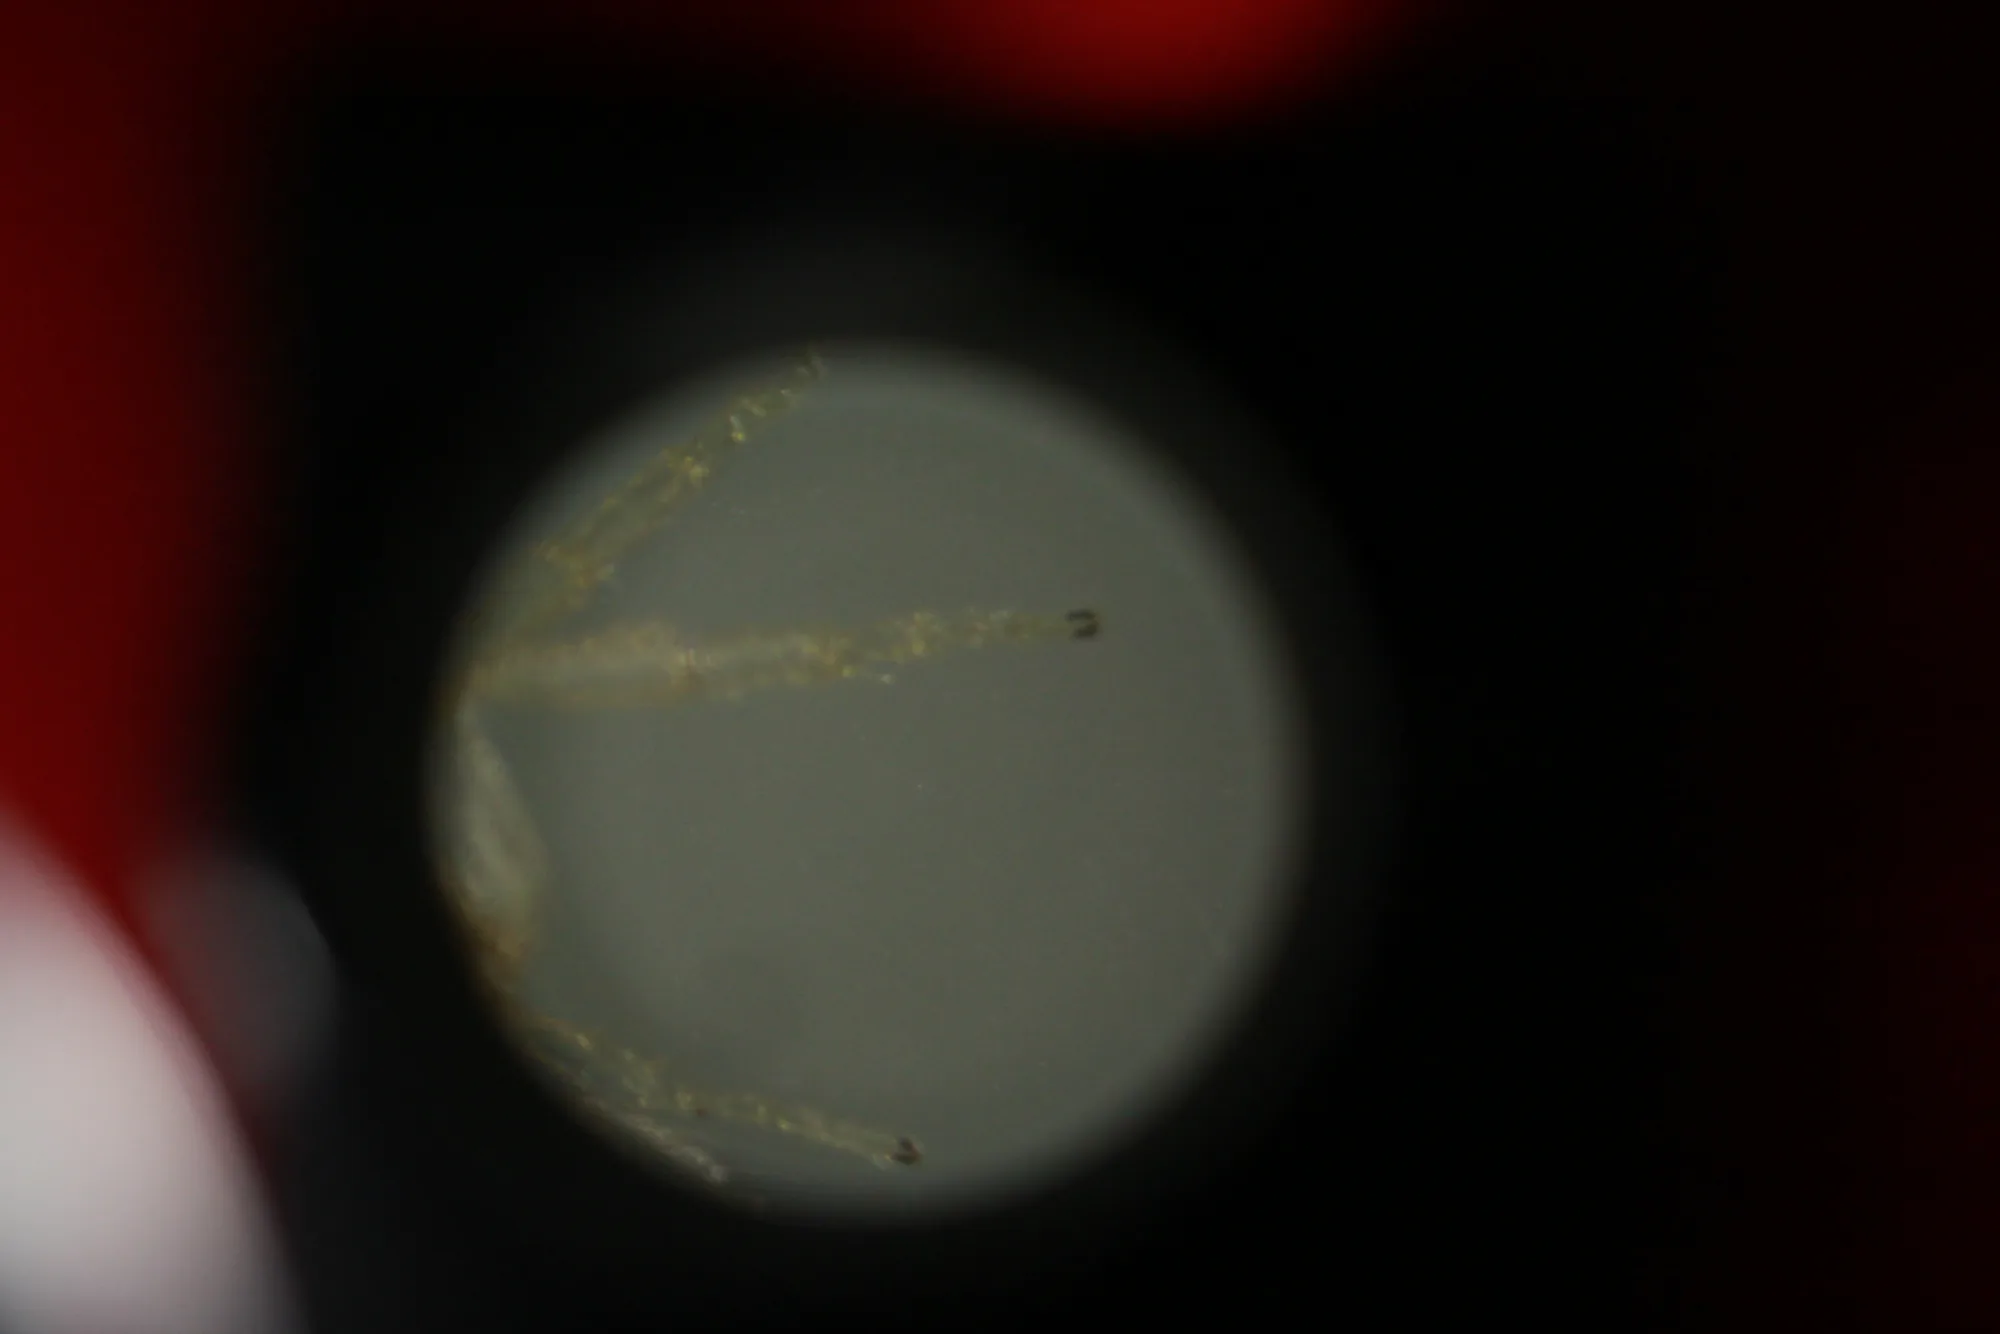
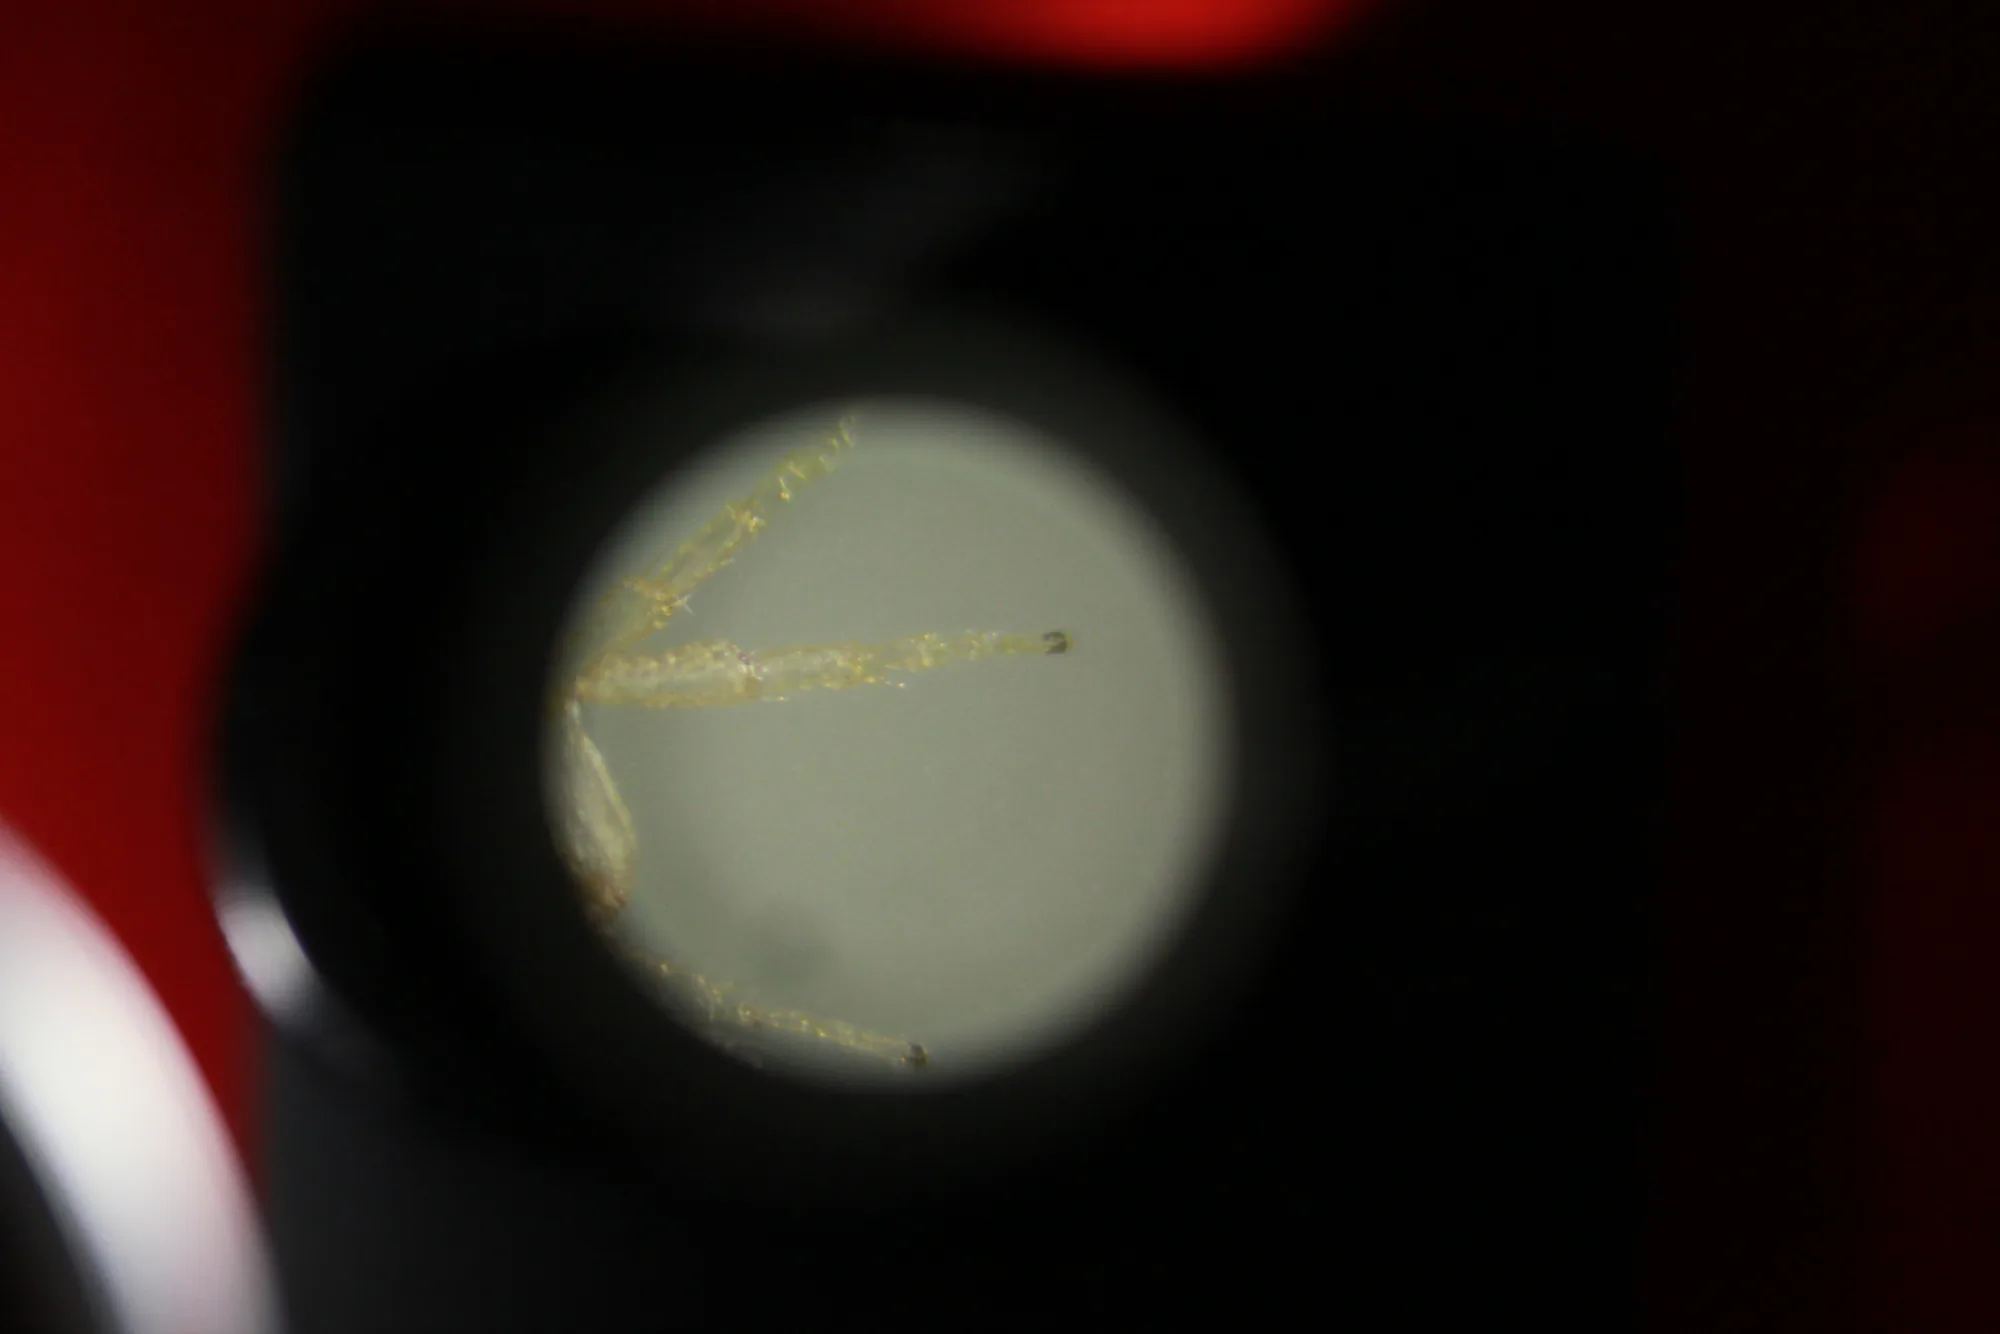
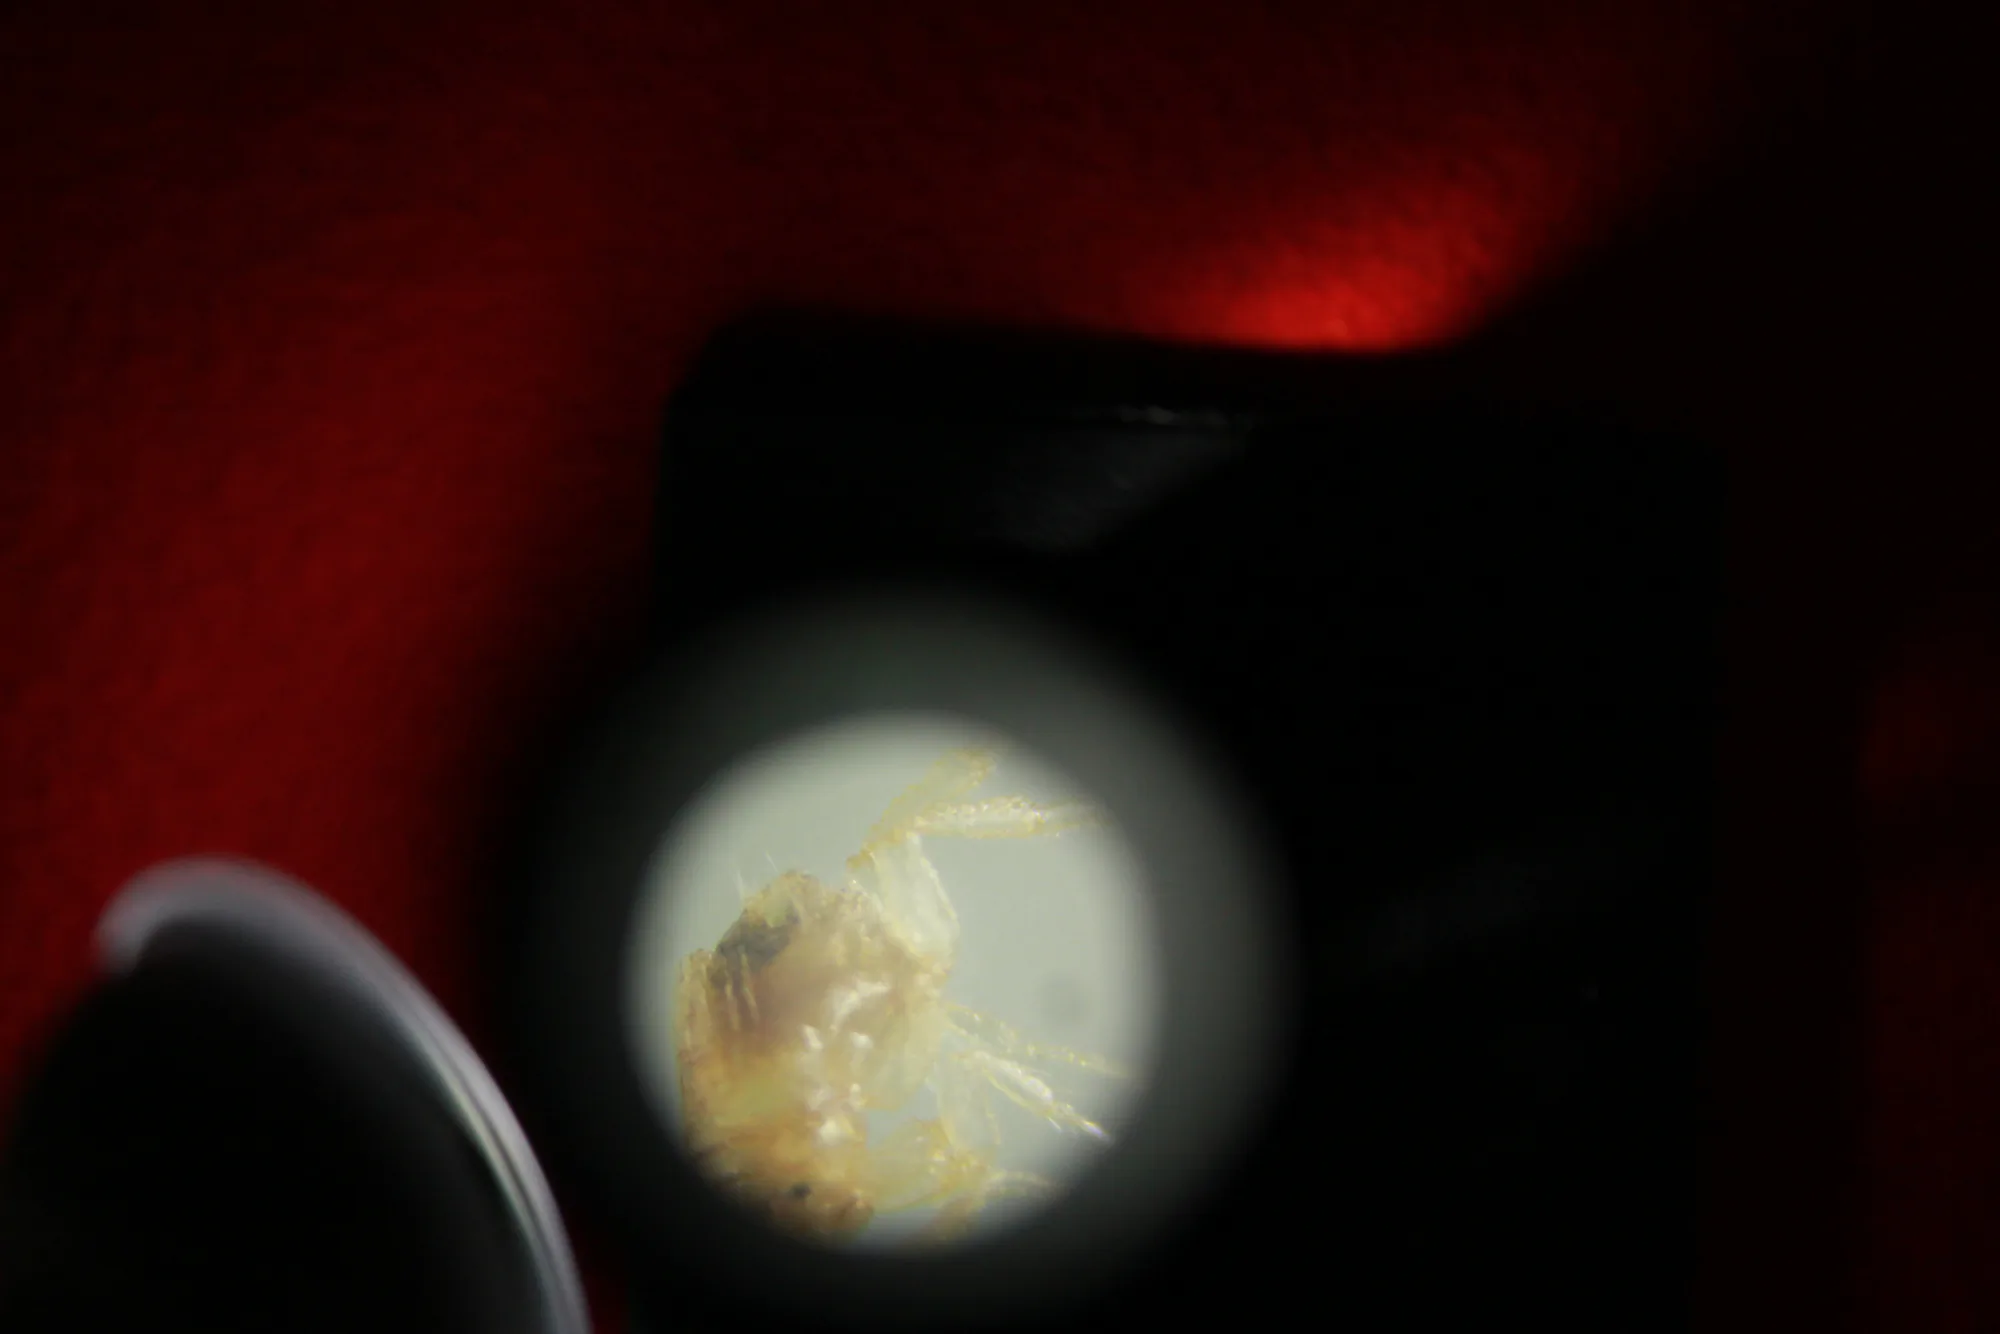
Были сегодня в Туле, заезжали в оружейный музей. Спешим сообщить, что у англичан ружья кирпичом не чистят, что тульские левши
На снимках — натуральная блоха с четырьмя подковами, каждая крепится тремя гвоздями, каждая подкова размером 0,045×0,05 мм.
Снимал через микроскоп, фокус пришлось выставлять вручную, так что
Добавлено: выложил остальные фотки из тульского государственного музея оружия.
Макретинговое ISO
Стараюсь время от времени читать статьи про фотографию (предмет оказался очень сложным), просматриваю свои снимки, пытаюсь оценить ошибки, ну и смотрю на альтернативные прошивки, CHDK и прочее.
Вчера
Я тогда не понял что это и даже удивился — зачем
Зачем нужна «низкая» чувствительность, если «высокая» удобнее — и выдержки короче, и диафрагму можно зажать, и никаких проблем со смазом, и в сумерках и помещении без вспышки… Разгадка проста — на самом деле у матрицы всего ОДНА чувствительность — та самая «низкая», а все остальные получаются путём усиления сигнала.
То есть на самом деле чувствительность матрицы Canon Mark II 5D — 73, максимальная ISO в 25600, которую выжимает этот дорогущий аппарат, достигается путём простого усиления сигнала с матрицы, что увеличивает так же шумы.
Думаю, поэтому ISO в документации и задирается — чем меньше приходится усиливать, тем лучше. Очевидно так же, что чем качественнее компоненты фотоаппарата, тем меньше должно быть шумов (в разумных пределах), тем больше сигнал можно усилить.
В статье так же рассказывается (с разных точек зрения), почему при выборе фотоаппарата смотреть надо не на мегапискели, а на физический размер матрицы. С точки зрения ISO аргумент такой:
если у камеры А матрица по площади в N раз меньше матрицы камеры Б, то для достижения одинакового уровня шумов на камере Б нужно выставлять ISO в N раз больше, чем на камере А
Кстати, физические размеры матрицы влияют и на размер фотоаппарата, это одна из причин почему наша миниатюрная «мыльница» Sony Cybershot
Отсюда и компактность объективов — чем меньшее пятнышко нужно освещать, тем меньше размер объектива. Впрочем, не буду пересказывать статью. Вывод один: миниатюрность = смерть качеству.
Видеокамеры и фотоаппараты видят ИК-излучение
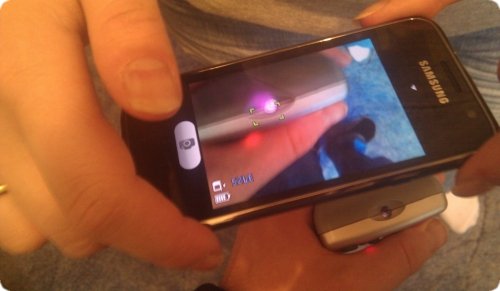
Как оказывается, мало людей знают, что любая мыльница или камера сотового «видят» инфракрасное излучение от пультов бытовой техники.
Я многие годы показываю этот фокус и все удивляются. Обычно я так проверяю работает ли пульт, если техника
Датчик у видео- и фотокамер воспринимает более широкую гамму, чем человеческий глаз, и, если в камере нет теплового фильтра, излучение попадает на датчик и его видно как яркое пятно на дисплее камеры (потому что на дисплей попадает сигнал, а отображать дисплей умеет только цвета, доступные человеческому глазу).
Стоп-лист доменной зоны .рф
У Носика просто чудесное расследование, связанное
Им послужил некий электронный «Словарь русских матерных слов», где выражения
из стоп-листа не только собраны в одном месте, но ещё и популярно растолковываются для непонятливых.Именно этот словарь, с незначительными сокращениями и необъяснимыми дополнениями (вроде «ахунехо»), умельцы из Координационной группы домена .РФ закачали в свою базу в качестве
стоп-листа. Очевидно, включение имён из этого словаря в список запретных слов означает полное согласие администрации зоны РФ с предложенными там толкованиями.Знакомство с этим словарём (ещё более нелепым, чем составленный на его основе
стоп-лист) позволяет, наконец, понять, чем не угодили РуЦентру «щекотильник», «армячок», «бикса», «рехем» и «девство». Заодно из словаря можно выяснить предположительное значение всех тех заковыристых матюгов, с которыми мы до прочтениястоп-листа не сталкивались.
Риторический вопрос
Иногда сталкиваюсь с тем, что люди не понимают что такое «риторический вопрос». Фразу «риторический вопрос не требует ответа» воспринимают как определение, тогда как это свойство.
Риторический вопрос — это приём риторики, фигура речи, это вопрос, на который ответ не ожидается, потому что он общеизвестен или будет дан дальше тем, кто вопрос задал.
Например, фраза «пора валить из Рашки?», которой хлюпает носом аудитория «Хабры», вполне себе риторический вопрос — она не подразумевает, что возможный собеседник обдумает пора или нет валить и даст ответ, а призывает поужасаться
Добавлено: в комментариях жалуются, что заметка получилось непонятной. Не ожидал, что такой простой предмет может быть таким сложным для понимания. В «Википедии» нашлась статья по этой теме. Можно почитать её, если моя заметка ничего не прояснила.
PHP, UTF-8: восьмой этап, заключительный
Прошло уже немало времени, с тех пор как я описал предыдущий этап перевода
Для начала надо понять что же делать с чтением и записью файлов. Нет никакого автоматического способа решить что делать с этими операциями в вашем проекте, хорошие новости заключаются в том, что, скорее всего, ничего делать не придётся. Мне не пришлось, хотя, чтобы это понять, нужно было исследовать исходники. Побайтовое чтение файлов — редкая операция в мире Даже в том случае, если вы производите с файлом Для другой операции, нам понадобится четыре метода в классе работы с UTF (напоминаю, что константа ON этого класса определяет включена ли поддержка UTF): метод charset возвращает Замены очевидны: везде, где в коде встречается Потом нужно проверить все места, где встречаются вызовы chr и ord («egrep ’\\b(ord|chr)’ -R .») и проверить не нужно ли переписать После этого осталось только перекодировать исходный код: И базу: В процессе пуска проекта выяснилась ещё одна немаловажная подробность (спасибо Саше Покатилову): оказывается, несмотря на то, что установки локали (setlocale) никак не влияет на функции сортировки в PHP, она влияет на некоторые функции работы с файлами (dirname, basename и некоторые другие), вот цитата из описания функции dirname: dirname() is locale aware, so for it to see the correct directory name with multibyte character paths, the matching locale must be set using the setlocale() function. Поэтому не забывайте выставлять локаль, если пользуетесь этими функциями. Дополнено: внезапно нашлись неприятные грабли, будьте осторожны: функция preg_match_all (и preg_match) с ключём PREG_OFFSET_CAPTURE возвращает бинарное смещение в строке (т. е. указывающее не на байт, а на символ), даже Я поступил просто — написал простую функцию, которая корректирует выходные значения. Идея простая: отрезаем при помощи substr строку до смещения, потом измеряем её Еще позднее: оказывается и параметр offset (последний параметр в preg_match и preg_match_all) работает с бинарным смещением, И ещё позже: а вот вам ещё сюрприз: модуль Multibyte String считает, что кодировка И ещё сильно позже: strftime тоже использует локаль.Что же дальше?
# вот эти файлы перекодировать не надо, они у меня уже в UTF-8
SKIPIT='./php/Utf.php|./php/UtfReverseString.php|./php/UtfString.php'
tmp=`tempfile`

for line in $(find -name '*.php' -or -name '*.tpl' -or -name '*.inc' | egrep -v "$SKIPIT"); do
    iconv -fcp1251 -tutf8 "$line" -o "$tmp"
    [ -e "$tmp" ] && mv -f "$tmp" "$line"
donemysqldump -pпароль -uпользователь --add-drop-table --create-options --default-character-set=utf8 --order-by-primary -q база |
sed -e 's/cp1251;$/utf8;/mg' |
mysql -pпароль -uпользователь база