программирование
Goto
Нередко в разговорах программистов всплывает тема оператора «goto». Например, сообщество крупно побурлило после появления его в ПХП. Многие считают, что оператор вредный, его появление в языке «понижает» язык в классе до Бейсика (хотя современные Бейсики — очень мощные языки) и он несёт только вред.
Грустно то, что обычно критики предоставляют аргументы на уровне вкусовщины, даже не пытаясь сформулировать аргументы, видимо считая, что уровень «плохо, потому что goto» достаточен.
Попробую возразить.
С последним аргументам в спорах обычно не соглашаются, говорят, что goto как правило умеет больше, чем эта пара операторов. Тут надо отступить и вспомнить чем вообще был плох обсуждаемый оператор.
Плох он, вообще говоря,
Так вот, всего этого современный оператор просто не умеет. Современный goto — тёзка того старого, плохого, сейчас он умеет переходить на метку, но не на всякую, а с огромным количеством ограничений и его использование не более вредно или стыдно, чем использование break или continue.
Тип ключей в PHP
Наткнулись с коллегами на странную вещи в ПХП: тип имени свойства. Непонятно? Давайте посмотрим на код. Как вы думаете, есть ли
$first = (object) [ 1 => 1 ];
$second = new stdClass(); $second->{1} = 1;
В первом случае массив получает тип «объект» (и в этом случае ПХП создаёт экземпляр класса stdClass, используя ключи и значения массива как имя и значение свойства соответственно), во втором случае сразу создаётся экземпляр класса и его свойству с именем «1» присваивается значение.
Невооружённым взглядом различий не видно, но если попытаться обратиться к этим свойства, то сразу увидим
var_dump(
  $first->{1}, // выведет «Notice: Undefined property: stdClass::$1»
  $second->{1} // выведет значение «1»
);
При этом свойство существует: var_dump обоих объектов его покажет и после преобразования переменной в массив, мы так же получим искомое. Тем не менее у первого объекта нельзя никаким образом обратиться к этому свойству: удалить его, прочитать, перезаписать! Всё проясняет следующий код:
$first = (object) [ 1 => 1 ];
$first->{1} =2;
var_dump($first);

/* у нас получился объект, у которого два свойства с одним именем,
но разными типами(!) имени, у одного он строка, у второго — число

object(stdClass)#1 (2) {
  [1]=>
  int(1)
  ["1"]=>
  int(2)
}
*/

var_dump((array) $first);

/* попытка преобразовать его в массив, приводит к появлению
неожиданного уродца — массива у которого два ключа с одним и тем
же именем, но разными типами…

array(2) {
  [1]=>
  int(1)
  ["1"]=>
  int(2)
}
*/

$arr = [ 1 => 1 ];
$arr["1"] = 2;
var_dump($arr);

/* …который вряд ли можно создать каким-то ещё способом

array(1) {
  [1]=>
  int(2)
}
*/
К свойству с числовым именем нельзя обратиться по имени, у ПХП просто нет конструкций для этого! Тем не менее, var_dump и foreach его видят! У массива всё ровно наоборот — по имени нельзя обратиться к свойству со строчным именем, если есть числовое.
Вот такие неожиданные открытия в ПХП. Я думаю, что это сделано для того, чтобы сохранить тип ключа массива в преобразованиях из объекта и обратно, но это решение теперь даёт странные сторонние эффекты. Например, перебирая такой массив через foreach можно столкнуться с ситуацией, когда удалить свойство из объекта по имени не удаётся. Или при итерации массива по известным ключам, мы будем получать одно и то же значение два раза (возвращаться всегда будет только то, которое записано по числовому имени).
В общем, масса интересных граблей насыпана в этом месте! Счастливой прогулки!
PHP 5.6alpha3
Я уже писал о том что появилось в ПХП 5.6. Четыре дня назад вышла новая альфа, а с её появлением в языке одним магическим методом стало больше. Добавился метод «__debugInfo», теперь он вызывается функцией var_dump выводится объект.
У объектов и ранее была возможность влиять на вывод этой функцией, но тогда это было доступно только для экземпляров, классы которых были написаны на Си, теперь же эта возможность есть в ПХП.
Пример использования:
class File {
  // «ресурс (поток)» — не очень-то информативно…
  private $fp;

  // …в отличие от его метаданных
  public function __debugInfo() {
    return $this->fp ? stream_get_meta_data($fp) : [];
  }

  public function open($filename, $mode = 'r'){
    $this->fp = fopen($filename, $mode);
  }
}

$f = new File;
var_dump($f); // object(File)#1 { }
$f->open('http://php.net');
var_dump($f);
/*
object(File)#1 {
  ["wrapper_type"]=>
  string(4) "http"
  ["stream_type"]=>
  string(10) "tcp_socket"
  и так далее...
*/
Мне тут же стало интересно — можно ли сделать метод __debugInfo приватным? Оказывается нельзя, интерператор ругается:
Warning: The magic method __debugInfo() must have public visibility and cannot be static in /Users/bolk/example.php on line 3
object(Dumb)#1 (0) {
}
И, кстати, сразу нашёл баг — стоит в этом магическом методе вернуть себя же (массив, состоящий из переменной $this), как var_dump зацикливается, а если вернуть $GLOBALS получим Segmentation fault: 11.
В принципе, это закономерно — ведь это
«Функция» include
Один из читателей в комментариях к статье про ошибочное толкование пхпешной конструкции «print» как функции, поделился более интересным случаем — таким же заблуждением относительно include.
Речь идёт об использовании include в выражениях, например:
$x = include("value.php") + 1;Хотя я ни разу не сталкивался с этой проблемой (зато видел проблемные ситуации с print), пример, готов признать, более жизненный — такое использование имеет смысл и наверняка встречается нередко.
Тут используется
Пример же иллюстрирует ровно ту же проблему, что и в случае с print: если программист не знает в чём различие конструкции и функции, он посчитает, что тут к возращаемому значению добавится единица.
На самом деле, скобки не являются часть конструкции include (она в скобках не нуждается), для неё скобки — просто часть единого аргумента «(„value.php“) + 1» и на вход include поступит значение «1», а это вряд ли то, чего программист добивался в этом примере.
В документации к ПХП написано как следует поступать в этом случае:
// неправильно, будет трактоваться как include(('vars.php') == 'OK'), т.е. include('')
if (include('vars.php') == 'OK') {
    echo 'OK';
}

// а вот так — правильно
if ((include 'vars.php') == 'OK') {
     echo 'OK';
}«Функция» print
Одним из распространённых заблуждений программистов на ПХП является то, что конструкция print является, якобы, функцией. На самом деле никакая она не функция — ей даже скобки не нужны, чтобы работать. Но с функцией print роднит то, что при вызове в составе выражения она всегда возвращает «1».
Весь ужас этого заблуждения как раз в использовании этой конструкции со скобками. Я программирую на ПХП уже около 15 лет, но всего пару раз за это время видел как это заблуждение рождает проблемы, но зато какие!
Я, понятное дело, напишу утрированный случай, чтобы проиллюстрировать проблему. Как думаете, что выведет следующий код?
var_dump(print("xaxa") + 1);По идее, должна выполниться «функция» print, вывести «xaxa», вернуть «1», которая сложится со второй единицей и var_dump выведет их сумму — «2».
Как бы не так! На самом деле, с точки зрения конструкции print (которой не нужны скобки) ей передали аргумент «(„xaxa“) + 1». При их складывании левая часть преобразуется к числу и получается «0», сумма нуля и единицы — «1», вот print его и напечатает, потом вернёт единицу, которую напечатает var_dump.
АрхиКАПТЧА
Некоторые архивы сейчас выставляют свои фонды в интернет — работать с бумажном документом сложно (с микрофильмами ещё сложнее), кроме того это всё ветшает, выцветает. К сожалению, на этом плюсы «цифры» кончаются, я знаю очень мало архивов, которые, кроме сканирования, ещё и распознали свои архивы.
Отсканировать, да ещё и распознать это всё — огромные деньги (тем более, что есть много рукописных документов, их автоматически не распознать, значит — нужно нанять людей, это ещё бо́льшие деньги).
Мне архивы откровенно жалко, столько информации безвозвратно теряется, а что делать их работники не понимают. Хуже всего, что способ есть, дешёвый, почти бесплатный — добровольцы выстоятся в очередь, только руку протяни.
Для начала, как запустить процесс сканирования документов? Да он уже запущен! Большинство исследователей приходит в архив и платит деньги за то, чтобы им дали скан
Я бы свои документы с удовольствием туда положил, чтобы они не потерялись, если мой диск прикажет долго жить. Можно это всё обвязать социальщиной — лайками, ачивками, комментариями.
С распознаванием не сложнее. Многие знают проект «РеКАПТЧА» по распознаванию текста из книг.
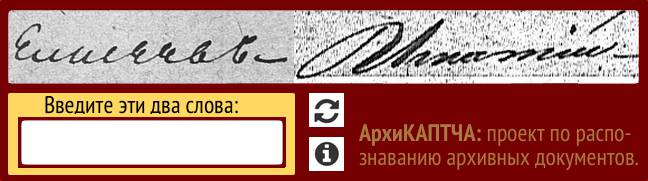
Делаем на логине в наш электронных архив такую же «АрхиКАПТЧу», заставляем людей подтвердить, что они не роботы и распознать пару слов из документа.
Для тех, кто не знает «РеКАПТЧА» работает следующим образом: нужно распознать и ввести два слова, одно из которых системе известно, а второе — нет. Известное используется для проверки, что это не робот пытается войти, неизвестное, в этом и смысл — чтобы человек его распознал. Когда по неизвестному слову накапливается достойная статистика, в качестве верного варианта выбирается то, что чаще всего вводили.
Чтобы роботы не смогли ничего прочесть, в КАПТЧу обычно вводят искажения. В случае архива даже искажать ничего больше не надо — и так всё написано достаточно неразборчиво, роботы пока такое не читают. Например, в моём примере первое слово — «Елисеевъ», второе — «Игнатій».
Можно было бы помочь архивам — взять на себя такой некоммерческий проект, но ведь это
Вот бы «Яндексу» этим заняться, на манер гугловского проекта «Книги».
Как быстрее измерить длину строки в Go?
Интересная штука, с которой сталкиваются начинающие разработчики в Гоу — как измерить длину строки в этом языке. То есть речь не идёт даже о быстроте, как, чёрт возьми, вообще это сделать?
Встроенная функция len возвращает длину в байтах, именно поэтому англоязычные разработчики часто и не знают, что проблема есть — строки латиницы, что в байтах, что в символах (в Гоу они называются «руны») занимают одинаково.
Я знаю два способа измерить длину строки:
package main

import ("io/ioutil"; "unicode/utf8")

func main() {
    bytes, _ := ioutil.ReadFile("test.txt")

    // считаем сколько рун встречается в строке
    print(utf8.RuneCountInString(string(bytes)))

    print("\n")

    // считаем длину массива рун
    print(len([]rune(string(bytes))))
}
По работе понадобилось измерить длину строки быстро — у меня здоровый цикл, где она постоянно измеряется, оказалось, что в тысяче итераций на тексте книги «На всех пара́х» Терри Пратчетта разница в две секунды — выигрывает преобразование в массив «рун».
Нужен быстрый способ — используйте len([]rune(…)).
PHP 5.6
Немного времени осталось до выхода PHP 5.6. Похоже, авторы взяли в привычку добавлять в каждой версии в язык несколько нововведений. Сейчас эта версия в стадии альфы, это означает, что до беты может добавиться
echo 2**3, "\n", // восемь
-2**2, "\n", // минус четыре
2 ** 3 ** 2; // 512
«Крышка» (^), которая во многих языках занята под степень, в ПХП занята под «исключающее или», поэтому сделали две «звёздочки», как в Пайтоне. Из приведённых примеров мы видим, что «вес» унарного минуса ниже, чем у степени — он применяется уже к результату, об этом надо помнить, лично я бы ожидал, что в степень будет возведено отрицательное число. И, кстати, сама операция является правоассоциативной (последний пример).
$a = gmp_init(2);
$b = gmp_init(3);

$c = $a**2 + $b;

echo $c, "\n"; // выведет 7
var_dump($c); // покажет объект класса GMP, у которого есть свойство num=7
echo array_sum([1,2,gmp_init(-3)]); // 3, печаль
Кроме этого, переход к объектам (от ресурсов) позволит сериализовать эти числа, что является хорошим бонусом. Увы, не всё ещё гладко — последний вызов (где суммируется массив) возвращает число три, а не ноль.
const alf = 2;
const bolk = alf*alf . alf; // работает новый синтаксис

echo bolk, "\n"; // 42

define("TEST", alf*alf . alf); // работает старый синтаксис
echo TEST, "\n"; // 42// сколько бы аргументов после первого не было, они попадут в $params массивом
function query($query, ...$params) {
$stmt = $this->pdo->prepare($query);
$stmt->execute($params);
return $stmt;
}Синтаксис с тремя точками используется в Си, Джаве и новой версии Джаваскрипта. Что интересно, с новым синтакисом работает и указание типа аргумента, и передача по ссылке. Ограничения этого синтаксиса вполне понятные — такой аргумент должен быть всегда последним (и/или единственным), задавать значения
// всё это неправильно:
function fn(...$args, $arg) // такой агрумент не первый
function fn(...$args1, ...$args2) // не единственный
function fn($arg, ...$args = []) // задано значение по-умолчанию
Выбор именно такого синтаксиса основывался на следующих вещах:
// выглядит как будто мы требуем, чтобы $args был массивом, что бесполезно — $args уже
// массив, по определению; на самом деле этот синтаксис должен иметь значение «каждый переданный
// в $args элемент — массив»
function fn(array $args...)
// будет путать ребят, которым приходится программировать и на Си тоже — очень похоже
// на указатель
function fn(Char *$args)
// в Си# используется ключевое слово «params», для ПХП не подходит, так как будет путаница
// с указанием типа
function fn(params $args)$a = $b = 2;
$c = ['a', 'b'];
var_dump(call_user_func_array('compact', $c)); // прежний синтаксис
var_dump(compact(...$c)); // новый синтакисис
var_dump(compact(...$c, 'c')); // можно ещё и так, будут переданы как аргументы 'a', 'b' и 'c'
var_dump(...new ArrayIterator([1, 2, 3])); // даже так работает! утиная типизация во всей красе
var_dump(...[1 => 1, 3 => 1]); // будет переданы два параметра, без пропусков в номерации
var_dump([...$c, $a]); // а вот так, увы, нельзя
list($k, ...$d) = $c; // так тоже нельзя
echo ...$c; // даже так нельзя!К сожалению, ПХП традиционно не радует согласованностью синтаксиса и последняя группа выражения не работает. Кстати, синтаксис в тремя точками улучшает картину производительности вызова функций с переменным числом аргументов.
Но даже с этими недостатками, нововведение хорошее. Посмотрите как чудесно выглядит каррирование в новом синтаксисе:
function bind(callable $function, ...$boundArgs) {
    return function(...$args) use($function, $boundArgs) {
        return $function(...$boundArgs, ...$args);
    }
}

$arrayToLower = bind('array_map', 'strtolower');

$arrayToLower(['Foo', 'BAR', 'baZ']); // вернёт ['foo', 'bar', 'baz']Как получить значения всех ключей в Memcached
В комментариях к одной из статей на «Хабре» привели однострочник для командной строки, чтобы вывести содержимое всех ключего локального memcached, я его прямо там причесал, но подумал, что он может мне и самому в будущем пригодиться. Переношу сюда:
nc localhost 11211 <<<"stats items" | awk -F: '/STAT items:[0-9]+/{if (!a[$2]++) print $2}' |
xargs -I{} echo 'stats cachedump {} 100' | nc localhost 11211 | awk '/ITEM/{print $2}' | xargs -n1 echo get |
nc localhost 11211
Без использования awk:
nc localhost 11211 <<<"stats items" | sed -n '/STAT/{s/[^:]*:\([^:]*\).*/stats cachedump \1 100/;p}' | sort -u |
nc localhost 11211 | sed -n '/ITEM/{s/[^ ]* \([^ ]*\) .*/get \1/;p}' | nc localhost 11211
Без использования awk и sed:
nc localhost 11211 <<<"stats items" | grep -Po '(?<=STAT items:)\d+' | sort -u |
xargs -I. echo stats cachedump . 100 | nc localhost 11211 | grep -oP '(?<=ITEM )\S*' |
xargs -n1 echo get | nc localhost 11211Почему у null в JS тип «object»?
На «Хабре» вышла статья, проливающая свет на загадку — почему же у null в Джаваскрипте тип «объект». Причём, если попытаться этому «объекту» добавить
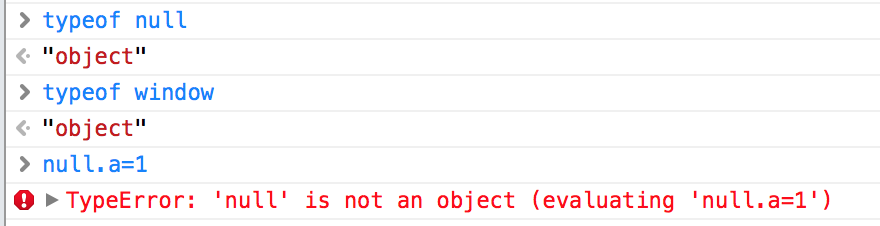
Вообще, я этому особого значения не придавал. Ну да, примитивное значение, имеет тип объект, хотя по факту им не является, смысла я в этом не вижу, это мешает, но поменять это нельзя.
Оказывается, это баг. Точнее даже не баг, а просто «так получилось». В ранних интерпретаторах Джаваскрипта тип хранился в первых трёх битах значения. Для типа «а это у нас null» значения не хватило, ему дали тип «объект», а под значение выделили нулевой указатель. Ну typeof, особо не заморачиваясь, выдавала object.
К сожалению, программисты поленились сделать дополнительную проверку. Можно было при наличии нулевого указателя попросить typeof выводить «null» и дело в шляпе. Сейчас, как оказалось, куча кода завязано на это поведение и ломать уже ничего никто не будет.
DBF → text
Попросили сконвертировать кучу досовских файлов формата DBF (dBase)
#!/bin/bash
[ -e converted ] || mkdir converted

# ищем все файлы dbf
find . -iname '*.dbf' | while read name; do
    echo "$name"

    # файл куда будет выгружен результат
    outname=converted/$(tr / '_' <<< "${name/./}").txt

    # есть ли файл memo?
    memo=${name%.*}.DBT
    if [ -e "$memo" ]; then
        # не добавлять удаление таблицы, кодировка CP866
        pgdbf -D -s cp866 -m "$memo" "$name"
    else
        pgdbf -D -s cp866 "$name"
    fi |
    grep -vE '^(BEGIN|\\COPY|\\\.|COMMIT)' |
    (
        # ↑↑↑ срезаем лишнее от утилиты pgsql
        read header
        # CREATE TABLE преобразуем в заголовок
        if [[ "$header" == 'CREATE TABLE'* ]]; then
            grep -o "(.*)" <<< "$header" |
            sed -e 's/ [^ ,]*,//g;s/ [^ ]*$//;s/(//' | tr ' ' '\t'
        else
            echo "$header"
        fi

        # остальное — без измненений
        cat
    ) > "$outname"
done_Noreturn в C11
Си — язык на котором я программирую редко, но всё же такое случается. Соответственно слежу что там появляется нового (кстати, есть ребята, которые понятия не имеют, что этот язык вообще развивается).
В относительно недавно вышедшей редакции
Смысла этого я не понимал,
Я noreturn никогда не пользовалась, но насколько я знаю он нужен, когда функция вообще не возвращает значение. В void функции можно сказать ’return;’
Noreturn-функции либо бросают исключения, либо говорят exitв какой-то момент. Если компилятор знает, что из функции возврата нет, то может сделать соответствующую оптимизацию.За Си не слежу, мне здесь C# полезнее, чем С.
Чуть подробнее об этом написано в описании атрибута «noreturn» компилятора gcc (там есть аналог в виде расширения языка) на примере функции fatal:
The noreturn keyword tells the compiler to assume that fatal cannot return. It can then optimize without regard to what would happen if fatal ever did return. This makes slightly better code. More importantly, it helps avoid spurious warnings of uninitialized variables.
The noreturn keyword does not affect the exceptional path when that applies:
a noreturn-marked function may still return to the caller by throwing an exception or calling longjmp.Do not assume that registers saved by the calling function are restored before calling the noreturn function.
В общем, примерно понятно, хотя, на мой взгляд, всё равно выглядит как микрооптимизация.
«Taint» в Перле
Спасибо провидению, в своё время мне удалось несколько лет попрограммировать на Перле. Язык (заслуженно) ругают, но там есть много интересных вещей, которые не грех бы перенести и в другие языки.
Например, хорошей вещью, на мой взгляд, является «taint» («загрязнение») — это специальная метка на переменной, что в ней лежат недоверенные данные, смешивание доверенных и недоверенных данных приводит к «загрязнению» результата. Недоверенными данными является весь ввод — то, что пришло со входного потока, прочитано из файлов и так далее, доверенными — то, что произвела сама программа. Например:
my $a = "hello"; # доверенные данные
my $b = <>; # «загрязённые» (строка, прочитанная из входного потока)

$a .= $b; # данные в переменной $a стали «грязными»
«Грязные» данные (если включен соответствующий режим), при попадании в операции, где они могут представлять угрозу для безопасности (например, пользовательский ввод напрямую попадает в функцию языка для удаления файла), генерируют специальное сообщение.
Вот, например, что будет если я добавлю в конец предыдущего кода вызов unlink (эта функция удаляет файл в Перле) с переменной «a», в качестве аргумента:
Insecure dependency in unlink while running with -T switch at sample.pl line 6, <> line 1Причём выполнение программы прервётся в этом месте.
«Грязные» данные можно отчистить, например, пропустив их через регулярное выражение (предполагается, что в этом случае вы проверяете их на корректность и выбираете только то, что безопасно для вашей программы), за подробностями отсылаю в документацию, она простая и понятная, даже если вы плохо знаете английский.
Было бы полезно иметь такой же механизм в ПХП — это помогло бы свести многие уязвимости к нулю, например, внедрение скриптов в код ХТМЛ
Справедливости ради, «taint» есть не только в Перле, насколько я знаю, этот же механизм используется в Руби и одно время был реализован в ДжаваСкрипте.
Массив с конца: ~n
Чудесное нашлось в комментариях на «Хабре»: логичный, на мой взгляд, способ получать значения с конца массива. Способ, вообще говоря, для «Пайтона», но и для «ПХП» можно применить.
В «Пайтоне» есть такая проблема, даже не то чтобы проблема, скорее мелкое неудобство, что списки, если их считать с начала, нумеруются с нуля, а если с конца — с минус единицы:
>>> print([1,2,3][0], [3,2,1][-1])
(1, 1)
Лично я к этому так привык, что в нелогичность такого поведения сразу и не вник. Неудобство становится более очевидным, если от фиксированных значений перейти к переменным:
>>> i=2
>>> print([1,2,3,4][i], [4,3,2,1][-i-1])
(3, 3)
Чтобы брать значения с конца, везде, как приклееную, приходится таскать эту дурацкую минус единицу. Но есть способ лучше, более того, я им иногда пользовался,
>>> i=2
>>> print([1,2,3,4][i], [4,3,2,1][~i])
(3, 3)
>>> print([1,2,3][0], [3,2,1][~0])
(1, 1)
Для тех, кто не понимает смысла операции «тильда» можно объяснить, что без тильды значения берутся с начала, с тильдой — с конца. Здо́рово!
Обычно в таких случаях возражают, что новички будут путаться. Это
Ленивая загрузка в ИЕ11
В IE11 интересную штуку сделали — ленивую загрузку. Можно пометить картинку (включая внедрённые тегом SVG), теги для воспроизведения видео и аудио, скрипты и многое другое специальным атрибутом lazyload, который означает «начать загружать, когда загрузится всё важное».
Иногда может быть удобно, для оптимизации скорости загрузки страницы, попросить браузер не загружать пока
<img src="avatar-3132.png" width="200" height="200" lazyload="1">Можно добавить этот атрибут к банерам (на что мало кто согласится), большим графическим оформительским элементам (чтобы пользователь быстрее начал читать статью), фоновой музыке (правда она редко бывает вообще уместна) и т. п.
CSS parent selector
Тема родительского селектора в ЦСС всплывает ужа давно, если не ошибаюсь, в Вебките даже
Что такое родительский селектор? О, это очень простая и мощная штука, к примеру, если клиент выбрал
.window < :checked { /* экспериментальный синтаксис родительского селектора из Вебкита */
    display: none;
}
Сразу скажу, задумка мощная, а реализация плохая. Какую проблему тут видно сразу? Непонятно что значает этот знак. Непосредственного родителя мы здесь выбираем или любого? Если непосредственного, как выбрать любого и наоборот?
Все синтаксисы родительского селектора (включая, например, :parent) грешат
Мне бы хотелось видеть абсолютную гибкость в отношении родительского селектора и мне кажется, синтаксис тут напрашивается сам собой:
.window > (:checked ~ :checked) {
    display: none;
}
Всё сразу становится логично, на мой взгляд: применить стиль к тегу с классом window, у которого два непосредственных
Скачивалка с самарского архива
Несколько читателей сообщили, что моя скачивалка архивов ЭлАра не работает — самарский архив
Вчера мне понадобились документы оттуда, поэтому я её немного подпилил под новые реалии. Разрешение файлов пришлось убавить, но лично мне это дискомфорта не доставляет, а скачивается намного быстрее. В общем, новая версия лежит там же.
Чтобы вытащить из страницы список картинок, которые нужно качать, можно воспользоваться следующим способом: открываем консоль браузера и пишем туда следующее:
console.log("dxo.itemsValue=['"+
window['MainPlaceHolder__storageViewerControl__storageFilesViewerControl_FilesDropDownList_DDD_L'].
itemsValue.join("','")+"'];")
Вывод нужно скопировать в файл и натравить на него скачиватель. Параметры остались неизменными.
Ещё про «Словохват»

Хорошая иллюстрация на тему как можно ускорить программу на порядок, убрав из неё одно слово. Первый и второй запуск отличаются только одним — в первом случае в моей программе для игры в «Словохват» присутствует преобразование типа set в tuple, а во втором этого нет.
Поиск наличия значения в set происходит многократное быстрее.
Кстати, в «Словохвате» можно использовать ещё и названия городов, а в моём словаре их нет. Но ничего не мешает использовать два и более словаря. Например, я скачал первый попавшийся словарь российских городов (он там в формате Экселя) и теперь использую и его:
cat <(unzip -p /Users/bolk/Downloads/spisokl-gorodov.xlsx xl/sharedStrings.xml |
awk -v RS=t '/^>.*<\/$/ {gsub("[<>/]", ""); print $0}' |
tr "[:upper:]" "[:lower:]" |
iconv -f utf8 -t cp1251) ~/Downloads/lop2v2/lop2v2.txt |
pypy slovohod.py /dev/stdin моибуквы«Словохват»
Вчера подсел на игру «Словохват», вроде игра незамысловатая, но очень интересная.

Смысл — занять одну из клеток противника, помеченного «звёздочкой», в терминах игры это называется «столица». Чтобы занять клетку, нужно придумать слово с буквой, которая написана на этой клетке, причём нужно уложиться в отведённое время — сверху тикает таймер.
Клетку можно использовать, только если она примыкает к клетке вашего цвета. Клетки чужого цвета захватываются по тому же правилу, но в первый раз они становятся серыми и только в следующий — вашего цвета.
На медиане поля действуют ещё
У автора получилась неплохая такая тактическая игра. Мне играть было скучновато — очень лень выдумывать слова, поэтому я написал небольшую программу на Пайтоне, которая работает со словарём под редакцией профессора Лопатина, ей нужно задать файл словаря и буквы, которые у вас есть, она придумает слово:

Работает неспешно, я оптимизировать не стал, времени, даваемого игрой, на поиск вполне хватает (по крайней мере на моём ноуте). Если
У меня на каждом запуске словарь преобразуется заново. Естественно, в словаре, помимо разрешённых частей речи, есть прилагательные, глаголы и так далее — их я не отфильтровываю, в словаре нет для этого информации.
# coding: utf-8
import itertools
import sys
import codecs

# дружим с консолью
sys.stdin = codecs.getreader('utf-8')(sys.stdin)
sys.stdout = codecs.getwriter('utf-8')(sys.stdout)

# строки с пропусками любых букв в любом количестве
def combinations(str):
    for l in xrange(2, len(str)+1):
        yield itertools.combinations(str, l)

# собираем каждую в строку
def iterstr(str):
    for s in itertools.chain(*combinations(str)):
        yield u''.join(s)

# все наши комбинации
def uniqcombinations(str):
    return set(iterstr(sorted(str)))

# проходим по словарю
def iterdict(name, min, max):
    with open(name, 'r') as f:
        for line in f:
            line = line.strip().decode('cp1251')

            # текущее слово должно содержать только буквы и быть не больше искомого слова
            if max >= len(line) >= min and line.isalpha():
                yield u''.join(sorted(line)), line

# ищем наше слово
def find(word, dictname):
    words = uniqcombinations(word)

    for line, original in iterdict(dictname, 3, len(word)):
        if line in words: print(original)

# запуск программы и небольшая помощь
try:
    find(sys.argv[2].decode('utf-8'), sys.argv[1].decode('utf-8'))
except IndexError:
    print(u'Запуск: {0} <словарь> <буквы в наличии>'.format(sys.argv[0]))
Писал именно на Пайтоне
Если вы думаете, что выиграть можно бездумно подставляя слова из моей программы, то сильно ошибаетесь — на сайте попадаются противники, которые вас с таким подходом разнесут в пух и прах.
Оглядываясь на шахматы на sed (SedChess) ★
Это информационный пост, больше для себя. Для того, чтобы не забыть выводы и ощущения от сделанного.
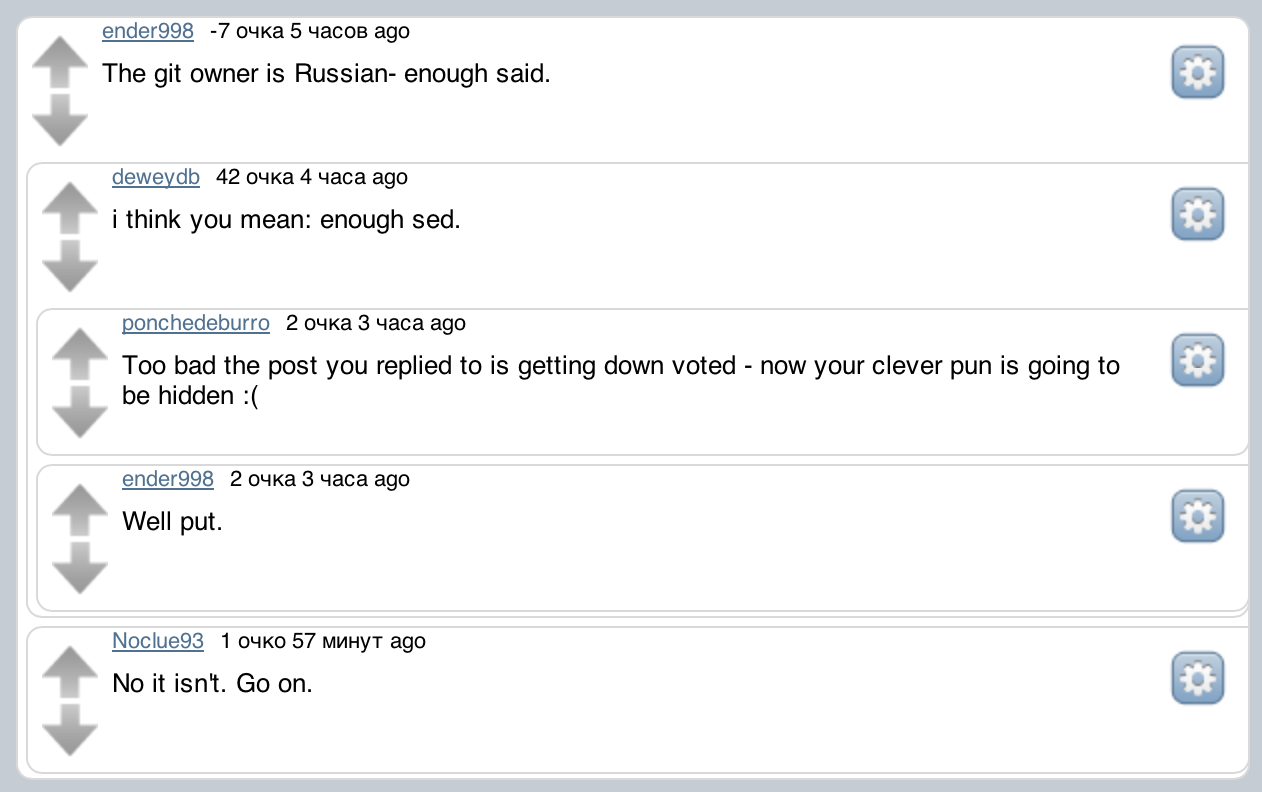
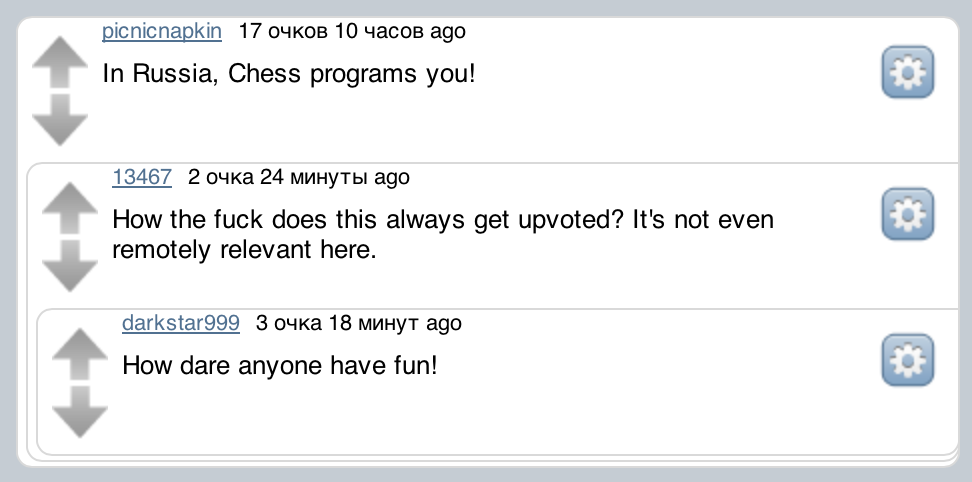
Несколько месяцев назад я написал шахматы на утилите «сед», ненадолго заинтересовав публику. Особенно доставляли комментарии на «Реддите» — кажется, я поддержал имидж русских программистов, как людей для которых нет ничего невозможного.
Пара комментариев оттуда:
Заодно мои «шахматы» попали на «ЛОР», «ОупенНет» и многие другие ресурсы (например, в английской «Википедии» в статье про sed, появилась ссылка на меня).
Проект (если такое официальное слово вообще применимо к этой развлекухе) оказался полезен для меня лично: я глубже понял sed, потренировал мозг
Сохранился один лист из блокнота на котором я расписываю как движется
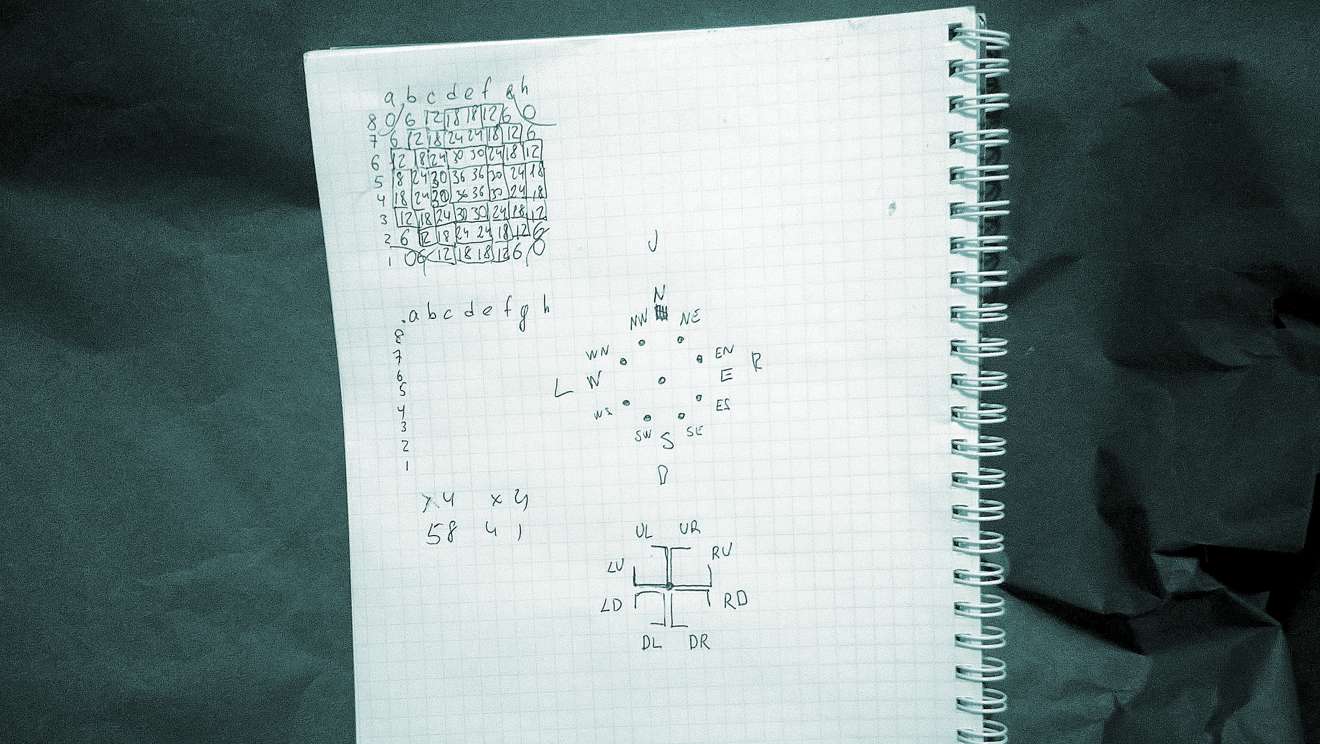
Ещё один плюс — мне много пришлось поупражняться в борьбе с собственной ленью и желанием бросить проект, когда я встречался с трудностями, которые казались непреодолимыми или заставляли переделывать половину проекта.
Конечно, мной двигали вовсе не рациональные побуждения, а желание сделать
Тяга делать