программирование
Локальные переменные
В прошлом я несколько лет программировал на Перле, очень любил этот язык и неплохо знал, до сих пор могу без особых проблем читать программы на нём. Прошло немало лет, наиболее часто я теперь использую ПХП и Джаваскрипт, на Перле не пишу вовсе (хотя в «Яндексе» был краткий эпизод — написал небольшой пример для документации
Вообще я сейчас считаю, что будущее скорее за языками с лаконичным синтаксисом (Пайтон), чем за тем, у кого он сверхнасыщен (Перл, Руби).
Тем не менее, некоторых вещей из Перла мне до сих пор нехвает в других языках. Я научился без этого обходиться, но много лет меня не отпускает чувство, что у меня
Например, локальные переменные. В ПХП часто приходится смотреть (особенно, если достаётся
В Перле такой проблемы нет — там локальную переменную можно создать почти в любом месте, произвольном месте кода, просто поставив фигурные скобки — так создаётся новый лексический блок, у которого могут быть свои локальные переменные:
my @a = (1, 2, 3);
my @b = ('a', 'b', 'c');

for my $i (@a) { # первая переменная $i
     for my $i (@b) { # вторая переменная $i, перекроет первую только внутри цикла
         print $i . "\n";
    }

    {
         my $i = 'end'; # третья переменная $i, перекроет первую только в этом блоке
         print $i . "\n";
    }

    print $i . "\n"; # выводится первая переменная $i
}
Конечно, я не призываю именно так писать код — во вложенных циклах с одной и той же переменной легко запутаться, просто иллюстрирую принцип.
В Джаваскрипте ситуация меняется, появилась конструкция «let» (впрочем, раньше её можно было эмулировать), а ПХП ничего похожего так и нет. Я переписывался с разработчиками много лет назад на эту тему, но воз и ныне там.
Сейчас есть возможность опубликовать предложение, описав его в виде RFC — эта новая процедура появилась недавно, если предложение понравится, то синтаксис имеет все шансы попасть в язык. Надо будет
Проблема в стемере для PHP
В модуле stem для ПХП обнаружилась неожиданная проблема. Этот модуль — стеммер, позволяющий обрезать окончания слов для того, чтобы искать потом по тексту без учёта падежей и склонений.
Для русского языка в нём целых две функции — для кодировки
Я обратил внимание, что из командной строки код с этим модулем работает нормально, а в рабочем проекте кодировка портится — как будто стеммер
У меня возникла мысль, что дело в выставляемой локали, мы провели эксперимент — так и есть, дело в этом. Такой код работать правильно не будет:
setlocale(LC_TIME, 'ru_RU.cp1251');
echo stem_russian_unicode(iconv('windows-1251', 'utf-8', 'Приветы'));
Кодировка получится битой. Перед вызовом функций стеммера нужно переставлять кодировку (setlocale)
// файл stem.c
     php_strtolower(z->p, arglen); // ← вот искомый вызов
     stem(z);
     z->p[z->l]= '\0';

// … ищем эту функцию в исходниках PHP…
// string.c из PHP
    PHPAPI char* php_strtolower(char * s, size_t len) {
        unsigned char *c, *e;

        c = (unsigned char *)s;
        e = c+len;

        while (c < e) {
            *c = tolower(*c); // ← а это проблемное место
            c++;
        }
         return s;
    }
Согласно манам, функция tolower ориентируется в своей работе на локаль, в этом и проблема.
Igbinary и PHP serialize
Если вкратце, модуль igbinary в ПХП — замена встроенным функциям сериализации. Встроеные функции хороши только в одном — сериализованное значение получается читаемым (хотя, на мой взгляд, JSON всё же получше будет).
Igbinary пренебрегает читаемостью (это вообще бинарный формат) в пользу скорости и компактности. Вчера ночью я перевёл пару мест в одном из проектов нашей компании, а утром мой друг, И. Б., кинул мне ссылку на статью, где сравнивается скорость работы встроенных функций и igbinary, причём в тестах на сохранение строк последний сливает первому.
Удивительный результат, так как, например, с числами всё иначе — там разница в несколько раз в пользу igbinary (в случае типа с плавающей запятой — более почти в 20), что же за проблема со строками?
У меня возникло подозрение, что я знаю в чём дело. Обычно, когда я изучаю новый модуль, я смотрю так же и на его настройки. Вчера я тоже их просматривал (в этом модуле их
Опция хорошая — помогает экономить память (например, при сериализации в memcached), работает она очень просто — при сериализации, если в данных попадается строка, проверяем не встречалась ли такая же строка ранее, если встречалась, повторно строку не сохраняем, сохраняем лишь ссылку на предыдущее вхождение.
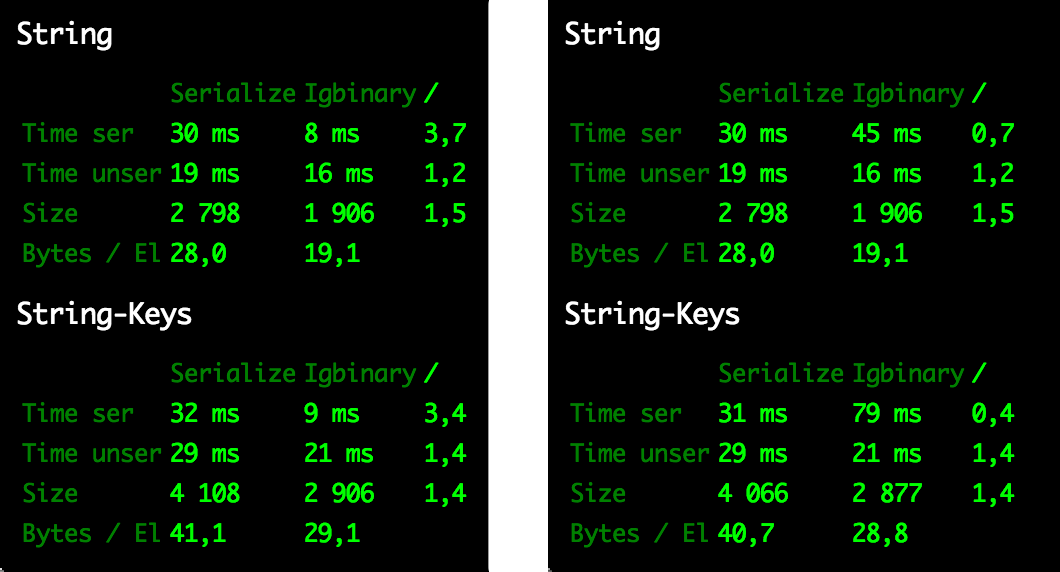
Как видите, разница разительная. Так что если вы ставите igbinary для скорости, то эту опцию лучше бы выключить.
IE 10 CSS hack
Придумал CSS-хак для Эксплорера
@media , {
    .:valid, body {
        background: red; /* будет красным в Internet Explorer 10 (режим совместимости) */
    }
}
Проверил при помощи сайта «Браузер шотс» ложные срабатывания, как будто всё в порядке, их нет. Не проверял на IE11, не знаю будет ли там работать. Если
Так же придумал новый хак для обычного режима IE 10:
@media all\0 {
    _:valid, body {
        background: red; /* будет красным в IE 10 */
    }
}
И ещё один:
_:valid\0, body {
    background: green; /* будет зелёным в IE10 */
}
Так же не тестировал на IE11 (мне негде).
max_matches, cutoff и limit в «Сфинксе»
Вчера температурил, хотя хотелось спать (всю неделю не высыпался), не мог уснуть — голова болела. Поэтому до 11 вечера общался по скайпу Андреем Аксёновым, автором «Сфинкса», хотелось выяснить некоторые туманные для себя вещи.
Например, в SphinxQL есть три способа ограничить количество выдаваемых результатов — limit, max_matches и cutoff. Разница между первыми двумя мне быстро стала очевидной после чтения документации, а что такое cutoff я не понимал. В доке написано следующее:
«cutoff» — integer (max found matches threshold)
В общем, я узнал, давайте расскажу.
Рассмотрим вот такой запрос, что здесь значит каждая цифра?
SELECT * FROM documents
WHERE orgid IN (5,10,222)
ORDER BY timestamp DESC
LIMIT 500, 1000
OPTION max_matches=2000, cutoff=5000
«Сфинкс» хранит результат запроса в памяти. Чтобы однажды не сожрать всю память, есть параметр max_matches, он определяет размер буфера, куда будут складываться результаты.
Если убрать в нашем запросе параметр cutoff, «Сфикс» пройдётся по индексу «documents», складывая выбранное в соответствии с критерием, в буфер размером в 2000 строк (на самом деле, насколько я понял, буфер хранит не сами строки, а их идентификаторы), располагая данные в порядке сортировки (priority queue).
После того как весь индекс был просмотрен, мы выдаём 1000 строк из буфера, начиная с пятисотой позиции (LIMIT 500,1000).
Теперь вернём cutoff. Этот параметр означает, что мы остановимся не после того как просмотрим весь индекс, а как только будут просмотрены 5000 строк, совпавшие с критерием. Это, очевидно, инструмент тонкой настройки, который позволяет принести в жертву производительности полноту поиска.
-khtml-border-radius
На «Хабре» постоянно всплывает тема того, что, якобы, никогда не существовало свойства «-
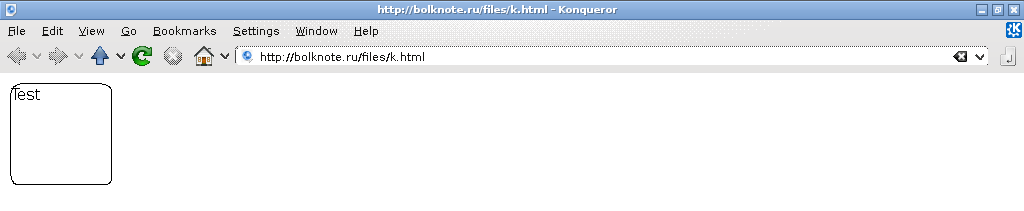
Вот на скриншоте вверху версия 4.4 отображает свойство -
Загадки «Сфинкса»
Сейчас много текста будет, напрягитесь.
«Сфинкс» — это довольно известный поисковый движок, разработанный Андреем Аксёновым. Время от времени мне приходилось использовать его в своих проектах и каждый раз качеством получившегося решения я был доволен, тем более, что за проходившее время он обрастал новыми интересными возможностями.
В первый раз сталкиваюсь с проектом, где использование «Сфинкса» возможно только с некоторым количеством костылей, которыми решение обрастает и меня всё меньше устраивает получившееся. Хочу описать проблемы, с которыми я столкнулся, возможно
«Сфинкс» хорош поиском по одной сущности, это, пожалуй всё. Богатство, описанное документации может создать обманчивое ощущение, что он может больше, но это не так. Моей ошибкой было решение использовать его в поиске по связанным сущностям. Это то, что «Сфинкс» умеет плохо. И хотя то, что получилось работает по скорости выше предыдущего решение, прокручивая в голове исходный код, я пла́чу мысленными кровавами слезами.
Так получилось, что искать мне нужно по наборам сущностей, связанных между собой. Получилось аж пять индексов. Объём данных не даёт надежды упихать всё в плоскую структуру — избыточность ужасает. Например, есть документы (Д) и резолюции к ним (Р), отношение один ко многим. Если попробовать положить эту структуру в одну таблицу, избыточность будет на уровне Д×Рср (Рср — резолюций на документ в среднем). Причём «Д» на уровне миллионов. И это только две сущности. Немаловажно, что «Д» и «Р» — сущности с целой кучей полей, в том числе полнотекстовых.
Выход есть. В поиске мы смотрим по каким сущностям надо искать, ищем по первой, берём оттуда найденные идентификаторы, подставляем во второй поисковый запрос вместе с критериями и так далее. Это костыль номер раз. Форма поиска устроена таким образом, что использование любого фильтра, как правило, ограничивает количество данных в выборке очень сильно, и всё равно это тысячи айдишников.
Второй костыль нужен, чтобы обойти принципиальное ограничение «Сфинкса» — у него есть параметр (указывается в конфиге), ограничивающий максимальное количество возвращаемых данных. Причём в миллионы (наш объём) его поставить нельзя — максимум в десятки тысяч, не рассчитан «Сфинкс» на большее, да и памяти не напасёшься. Всё бы ничего, но когда мы ищем пересечения сущностей (Д×Р), то, что нам вернул «Сфинкс» со своим лимитом, может и не иметь пересечений — они могут быть за горизонтом выдаваемых данных.
Костыль номер два я походя описывал — если мы обнаруживаем, что айдишники вернулись не все, то делаются ещё запросы, которые я назвал «докачивающими», делается тот же самый поисковый запрос, за исключением айдишников, которые уже попали. Работает, естественно, только с данными отсортироваными по ID.
Как только появились «докачивающие» запросы, то минус один выходной ушёл у меня на костыль номер три — я сделал сбор статистики запросов и оптимизацию порядка выполнения запросов. Вот как всё работает.
У нас, как я уже сказал, может быть от одного до пяти задействованных индексов, в зависимости от того что пользователь в форму введёт. В запрос к каждому следующему передаются идентификаторы из предыдущего. Как только один из запросов вернул пустоту, дальше можно не продолжать — пересечение с пустотой даёт пустоту.
Теперь следите за мыслью. Не знаю очевидно или нет, но логически всё равно в каком порядке будут опрашиваться индексы — результат будет тот же. Например, Р ∩ Д = Д ∩ Р. Зато если впереди поставить запросы, которые вернут меньше айдишников, следующим будет полегче. Скажем, на запрос пользователя у нас вернулось 80 тысяч документов и пять тысяч резолюций. Расточительнее сделать запрос к документам первым и подставить потом 80 тысяч айдишников во второй запрос, чем выбрать сначала пять тысяч резолюций, а потом передать их в запрос к документам.
Но как узнать какой запрос надо выполнить первым? Поможет сбор статистики.
Я рассуждал так. Поскольку у нас в поисковой форме все атрибуты запрашиваются с критерием «И» (например: год=2011 И организация=5), то чем больше разнообразных критериев запрошено, тем меньше объём выборки, значит надо как минимум запомнить какие атрибуты интересовали пользователя, тем более, что они
В итоге при каждом поиске пользователя я кладу его запрос в специальный стек, плюс указываю какие атрибуты в каком количестве он запрашивал. Эта информация может выглядеть
В офлайне (ночью, например) срабатывает скрипт, который запускает полученный запрос и смотрит сколько данных получается, если этот запрос выполнится первым (без переданных айдишников). Из информации об атрибутах делается хеш и к нему приписывается полученный результат, учитываются предыдущие результаты по тому же хешу и в другую таблицу записывается пара хеш и средняя оценка значений возвращаемых запросом такого рода.
В дальнейшем, когда пользователь будет искать, мой код смотрит в эту статистику, оценивает характер запроса по описанном алгоритму и сортирует запросы к индексу так, чтобы первыми стояли индексы, которые вероятно дадут меньше результатов.
Массовых испытаний ещё не было, но в тех частных случаях, которые я рассмотрел, ускорение бывает до двух раз (чаще всего, конечно, прирост не столь значителен или его нет). Больше всего выигрыш получается, если удаётся избавиться от «докачивающих» запросов.
Задача была интересной, а вот костыли не радуют. Либо надо научиться с ними жить, либо думать о переходе
PHPFuck
JSFuck у нас уже был (это намёк на язык Брейнфак, а не ругательство), почему бы не изобрести PHPFuck?
Часа полтора потратил на скрипт, который выводит слово «Hello!»:
<?
$__=$_[$_[]++].=$_;$_[!_]+=++$_[!_];@$$_=($_[$$_][$_]&$_[$$_][$_[!_]]).$_[$$_][$_];
$_[]=&$$_;@$$_.=$_[!!_][$__]^$__[$_[!_]]|$__[!_];$___=$__[!_]|_&~$__[!!_];
@$$_.=++$___.($__[$_]^_^$__[$_[!_]]).($_[!!_][!$_]^$_[_==_][$_[!_]>>!!_]^_);
$___&=$__[$_[!_]];$___.=${$_}[!_]^${$_}[$_[!_]]|$__[!_].($$$_=$__[!_]^_^$__[!!_]).
$$$_.($_[_]=$__[$_[!_]]^_^${$_}[$_[!_]>>!!_]);$$_($___.
(~${$_}[~-$_[!_]]&$___[$_[!_]]).($_[_]&~$___[!!_]));
Это настоящий код на PHP, он работает и выполняет заявленное. За вдохновение спасибо неизвестному автору бэкдора, как только я увидел код, понял, что так написать можно что угодно.
Что вкратце происходит у меня. Я создаю массив, привожу его к строке, получается слово «Array» (это такая особенность PHP, если кто не знает), потом при помощи бинарных операций над буквами (с буквами можно использовать «~», «&», «|», «^», а так же операцию инкремента, получая другие буквы), собираю из этого слова слово «printf» (точнее «prINTf», функции в PHP регистронезависимые), которое в дальнейшем будет использовано в качестве имени функции. Потом из двух слов — «Array», «prINTf» и знака подчёркивания теми же бинарными преобразованиями получаю «Hello!» с переводом строки.
Например, буква «N» получается операцией «A» | «_» | ~«r» с последующим инкрементом результата, а «l» (латинская «эл») — «A» ^ «r» ^ «_». Подчёркивание можно использовать без кавычек — все незакавыченные идентификаторы PHP рассматривает как строки.
В конце просто вызываю функцию, передавая ей полученную строку.
Размытие шрифта на Ретине в Сафари
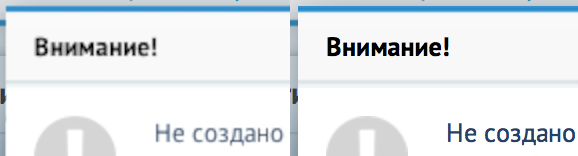
Как и ожидалось, Ретина ещё
Заменили на обычное свойство opacity, стало выглядеть, как на скриншоте справа.
SVG с fallback на не векторные форматы
Нравятся мне такие вещи. Алексей Тен из Яндекса придумал очень изящный способ внедрения СВГ в код с возвратом к растровому формату, если браузер не поддерживает СВГ:
<svg width="96" height="96">
    <image xlink:href="svg.svg" src="svg.png" width="96" height="96"/>
</svg>
Принцип виден из кода, я думаю, но я всё же расшифрую. Если браузеры поддерживают внедрение СВГ в ХТМЛ, то почти весь выше приведённый код будет для них значимым: кроме атрибута «src», его у тега СВГешного image не бывает и он будет отброшен. Соответственно, картинка загрузится из файла svg.svg.
Если же браузер СВГ в таком виде не понимает, то будет отброшен тег svg и атрибут «xlink:href», а тег image будет преобразован в img — это старая особенность браузеров, которой я тщетно пытался придумать применение. В этом случае будет загружен svg.png.
Я уже на сайте в одном месте использую этот трюк.
Немаловажное про генераторы в PHP
Наткнулся на важный пост о генераторах в ПХП, я их попробовал использовать, ещё когда они были в альфе. Хорошая штука, мне после Пайтона их в языке не хватало.
Суть же рассматриваемой проблемы в следующем. Смотрите, вот функция, которая возвращает построчно файл и пример её вызова:
function getLines($file) {
    $f = fopen($file, 'r');
    while ($line = fgets($f)) {
        yield $line;
    }
    fclose($f);
}

foreach (getLines("file.txt") as $line) {
     echo $line;
}
Пока всё чудесно, ничего странного и необычного, а теперь представьте, что нам нужно прочитать только четыре первые строки:
foreach (getLines("file.txt") as $n => $line) {
    if ($n > 5) break;
    echo $line;
}
Если в файле их было больше, то в функции getLines вызов fclose не выполнится никогда — до него программа просто не дойдёт, файл останется открытым, память занятой и так далее. Плохо. Что делать?
Оказывается, документация обходит этот вопрос стороной, а вот автор введения в ПХП этой конструкции позаботился о том, чтобы эту тему раскрыть — если прочитать соответствующий RFC, становится ясно как быть.
Оказывается, при высвобождении ссылки на генератор, внутри его обязаны выполнится все блоки finally, т. е. вышеприведённый код нужно переписать следующим образом:
function getLines($file) {
    $f = fopen($file, 'r');
    try {
        while ($line = fgets($f)) {
            yield $line;
        }
    } finally {
        fclose($f);
    }
}Siege с патчами
Сомневаюсь, что
Я сделал версию со своими патчами, положил на Гитхабе.
Т. е. можно сделать
HOST=http://example.org
USER=bolk
PASS=password

{$HOST}/login.php?user={$USER}
# предыдущий урл редиректит нас на /list.php?list_id=5&SESSION=некое-значение
# SESSION теперь нужно будет добавлять в каждый следующий урл:
{$HOST}/list_detail.php?SESSION={{SESSION}}
Есть ещё специальная переменная {{QUERY_STRING}}, которая подставляет строку запроса из урла редиректа целиком, а так же две переменные — {{:PID}} (текущий айди процесса) и {{:RND}} (случайное число), которые я использовал для отладки, да так и не убрал.
Я не делал проверки на выделение памяти (выделяется крошечное её число) и в паре мест использовал статический буфер (так что если у вас будет урл больше
Баг в Siege 3.0.2
Сегодня на работе патчил утилиту Siege, она применяется для простенького нагрузочного тестирования. Нужно было несколько расширить её возможности. Попутно нашёл баг — время от времени под «Маком» (не знаю, проявляется ли баг на других платформах, по идее, должен) не раскрывались переменные в строках запроса.
Баг плавающий, так как всё зависит от того в каких адресах выделится память для файла урлов. Сделал патч, может пригодится кому:
diff -urd --ignore-blank-lines --minimal src/cfg.c.orig src/cfg.c
--- src/cfg.c.orig	2013-07-20 00:26:04.000000000 +0400
+++ src/cfg.c	2013-07-20 00:26:10.000000000 +0400
@@ -168,18 +168,17 @@
 BOOLEAN
 is_variable_line(char *line)
 {
-  int pos;
-  int x;
+  char *pos, *x;
   char c;

   /**
    * check for variable assignment; make sure that on the left side
    * of the = is nothing but letters, numbers, and/or underscores.
    */
-  pos = (int)strstr(line, "=");
-  if(pos > 0){
-    for(x = 0; x < (pos - (int)line); x++){
-      c = line[x];
+  pos = strstr(line, "=");
+  if(pos != NULL){
+    for (x = line; x < pos; x++) {
+      c = *x;
       /* c must be A-Z, a-z, 0-9, or underscore. */
       if ((c < 'a' || c > 'z') &&
(c < 'A' || c > 'Z') &&Оптимизация картинок поворотом
Есть такой старый трюк, который с развитием CSS получил новое прочтение. Дело в том, что при упаковке изображения в графические форматы, в основном, сканируют и упаковывают изображение, двигаясь по его линиям слева направо. Первом об этом на русском языке написал, думаю, Лебедев, вот что написано в книге «Реактивные вебсайты», соавтором которой я являюсь:
Изображения GIF хорошо поддаются оптимизации. В параграфе №8 «Ководства» Артемия Лебедева есть небольшое, но интересное исследование особенностей этого формата. Вывод из параграфа простой: чем больше на картинке горизонтальных линий одного цвета, тем лучше сжимается изображение. Алгоритм компрессии LZW, применяемый в GIF, вообще лучше сжимает регулярные горизонтальные структуры в пределах одной линии.
Соответственно, если есть возможность повернуть картинку, то, бывает, она сжимается лучше.
Но не всегда так везёт, гораздо чаще, согласитесь, встречаются изображения, которые повернуть нельзя. Значит о способе забываем?
Вот тут нам и пригодятся нововведения в ЦСС. Берём свою картинку, сохраняем ещё три копии повёрнутые на 90°, 180° и 270°, а потом все четыре изображения оптимизируем, выбираем то, которое меньше занимает. А дальше просто поворачиваем его при помощи ЦСС (я ещё фильтр для старых ИЕ добавил и некоторые свойства для других браузеров):
.rotate90 {
    filter: progid:DXImageTransform.Microsoft.BasicImage(rotation=1); /* IE 5.5+ */
    -ms-filter: "progid:DXImageTransform.Microsoft.BasicImage(rotation=1)"; /* IE 8 */
    -ms-transform: rotate(90deg); /* IE 9 */
    -o-transform: rotate(90deg); /* Opera 10.5+ */
    -webkit-transform: rotate(90deg); /* Chrome, Opera 15+, Safari 3.1+, Android 2.1+, iOS 3.2+ */
    -moz-transform: rotate(90deg); /* FF 3.5+ */
    transform: rotate(90deg); /* FF 16+, IE 10+, Opera 12.1-14.99 */
}
Картинка поворачивается браузером и визуально остаётся как была.
Вообще, конечно, можно поворачивать на любой угол, если фон картинки прозрачный или совпадает с окружающим фоном, но в старых ИЕ для этого придётся использовать другой фильтр — Matrix, формула расчёта параметров такая:
progid:DXImageTransform.Microsoft.Matrix(
  M11 = cos(угол),
  M12 = -sin(угол),
  M21 = sin(угол),
  M22 = cos(угол),
  sizingMethod = 'auto expand'
);
Метод не лишён недостатков, конечно.
Под водой
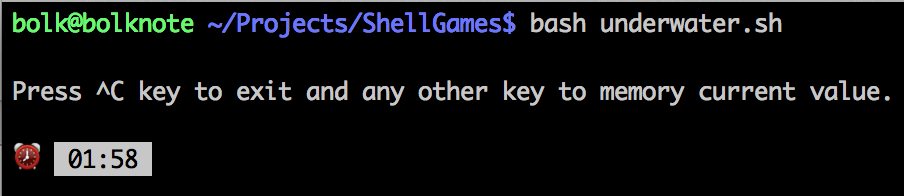
Решил потренировать задержку дыхания под водой,
Написал таймер сам, на баше. Запускается в консоли, прерывается по комбинации Ctrl+C, любая другая клавиша — сохранение на экране промежуточного результата.
Кроме того, мой таймер произносит сколько минут прошло — «one minute», «two minutes» и так далее, а каждую половину произносит слово «middle».
Громкости моего ноута за глаза хватает, чтобы услышать таймер в ванне, под водой. Без отсчёта держаться
Пятничная загадка для PHPшников
В ЖЖ увидел прекрасное — загадку про ПХП.
Те, кто знает этот язык, скажите, почему этот код не выдаёт ошибок или предупреждений (все ошибки, конечно, включены):
<?php
//bolknote.ru
?>ReactOS/Windows *CriticalSection API → Linux
Вчера портировал часть «РеактОС» под Линукс, пришлось разобраться что делает небольшой фрагмент АПИ Виндоуз («РеактОС» — это операционная система, совместима с Виндоуз).
Функции оказались небольшими, но вдруг
#include <pthread.h>

inline void InitializeCriticalSection(CRITICAL_SECTION *cs)
{
    pthread_mutexattr_t mAttr;
    pthread_mutexattr_settype(&mAttr, PTHREAD_MUTEX_RECURSIVE_NP);
    pthread_mutex_init((pthread_mutex_t *) (void *) cs, &mAttr);
    pthread_mutexattr_destroy(&mAttr);
}

inline void DeleteCriticalSection(CRITICAL_SECTION *cs)
{
    pthread_mutex_destroy((pthread_mutex_t *) (void *) cs);
}

inline void EnterCriticalSection(CRITICAL_SECTION *cs)
{
    pthread_mutex_lock ((pthread_mutex_t *) (void *) cs);
}

inline void LeaveCriticalSection(CRITICAL_SECTION *cs)
{
    pthread_mutex_unlock ((pthread_mutex_t *) (void *) cs);
}
После этого все другие обращения к структуре CRITICAL_SECTION нужно, конечно, убрать, иначе код будет падать.
SVG-спрайты
Вчера ночью, эксперементируя с различными способами внедрения картинок в ХТМЛ, я понял, что уже все браузеры (кроме «Оперы Мини»), понимают СВГ прямо в коде страницы. А это значит, можно отказаться от CSS-спрайтов в пользу того, что можно назвать «SVG-спрайтами»:
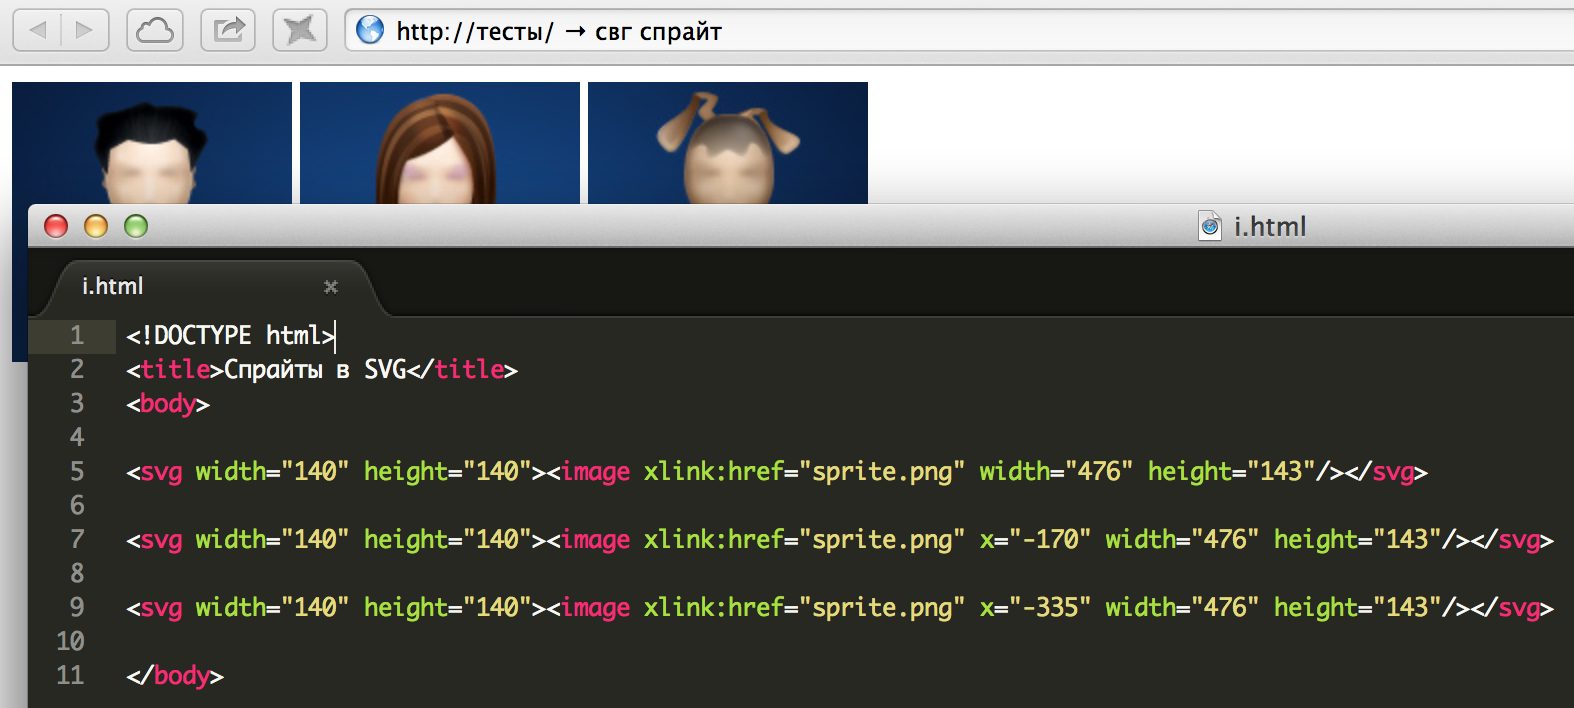
Принцип,
Думаю, всем понятен код: в теге svg задаются размеры кусочка спрайта, в image обязательно нужно указать полные размеры картинки (для Ретины можно указать их в два раза меньше, если спрайт подготовлен к этому типу экранов), при помощи параметров x и y позиционируем в каком именно месте спрайта расположена наша картинка.
В комментариях спрашивают зачём это всё надо, чем это лучшее спрайтов в ЦСС.
Ну,
«Яндекс.Фотки» и Ретина
Мне нравятся «Яндекс.Фотки». Не за архаичный дизайн и вёрстку таблицами, конечно, а за отсутствие ненужных мне сервисов и безразмерное (действительно безразмерное) хранилище.
Не нравится только, что я на Ретине не могу выдеть свои фотографии в том качестве, в каком мог бы. Я сейчас болею, кашляю, чтобы никого не будить, ушёл на кухню и сделал userjs для браузера «Сафари», который меняет дизайн «Фоток» и просмотр фотографий так, чтобы им было приятнее пользовать на Ретине.
Может ещё
// ==UserScript==
// @name      Retina Yandex Fotki
// @include   http://fotki.yandex.ru/*
// ==/UserScript==
(function () {
    function $(sel, attrs) {
        var os = typeof sel == "object" ? [sel] : document.querySelectorAll(sel);
        for (var e = 0, l = os.length; e < l; e++) {
            var o = os[e];
            for (var i in attrs) {
                if (attrs.hasOwnProperty(i)) {
                    if (typeof attrs[i] == 'number') {
                        attrs[i] *= o[i] || document.defaultView.getComputedStyle(o, null)[i];
                    }
                    o[i] = o.style[i] = attrs[i];
                }
            }
        }
        return os[0];
    }
    var img = document.querySelector(".js-img-link img");
    if (img) {
        $(".js-img-link img", {
            marginLeft: 1280 - img.width * 2 + 'px',
            zoom: '.5',
        });
        $(".b-preview__size_xxxl", {
            width: Math.max(640, img.width / 2) + 'px',
            height: img.height / 2 + 'px',
            overflow: 'hidden',
        });
    }
    $(".b-head-logo__img", {
        src: 'http://yandex.st/morda-logo/i/logo.svg',
        width: '89px',
        height: '60px',
        marginBottom: '-30px',
        position: 'relative',
        zIndex: '-1',
    });
    $(".b-head-menu .an-upload", {
        width: '80px',
        height: '17px',
    });
    var img = $(":-webkit-any(.user100, .b-userpic-small) img", {
        width: '40px',
        height: '40px',
        float: 'left',
    });

    if (img && img.src.substr(-6) == '-small') {
        img.src = img.src.substr(0, 84) + 'normal';
        $(img, {
            width: '20px',
            height: '20px',
        });
    }
    $(".b-round", {
        display: 'none',
    });
    $(":-webkit-any(.b-preview, .b-foto-actions, .b-foto-listing-i)", {
        borderRadius: '0px',
        webkitBorderRadius: '0px',
        backgroundColor: 'inherit',
    });
    var imgs = document.getElementsByTagName('img');
    for (var i = 0, l = imgs.length; i < l; i++) {
        imgs[i].src = imgs[i].src.replace(/S$/, 'M').replace(/XM$/, 'S').replace(/XS$/, 'S');
    }
})();
Сложнее всего было
Malbolge
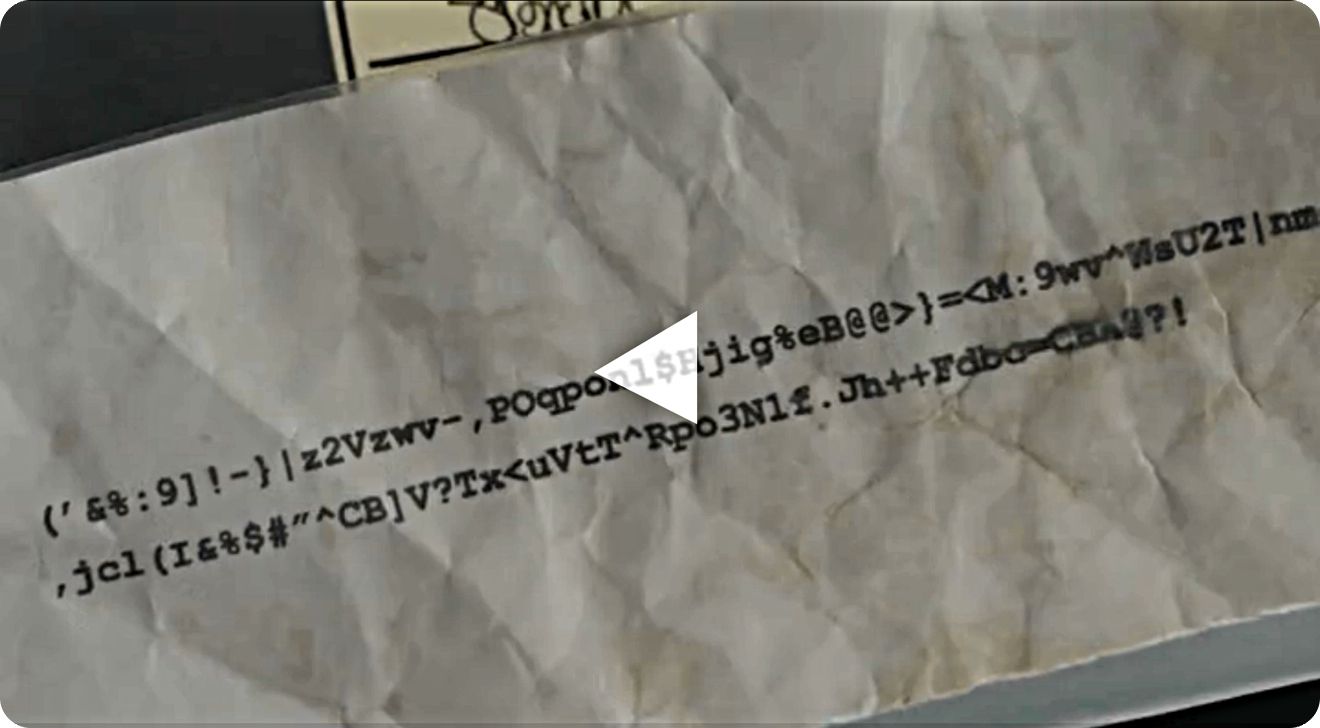
В десятой серии сериала «Элементарно» внезапно для меня в сюжете используется эзотерический язык программирования «Малболж». Я им немного интересовался, но программировать на нём так тяжело, что даже простые программы, в основном, сгенерированы компьютером.
Когда я увидел текст этой программы, конечно, сразу загорелся посмотреть что там выводится, но оказалось, что это даже не программа, а просто фрагмент «Hello, world.», да ещё и с несколькими опечатками (первые две ошибки — символы №№ 9 и 15):
('&%:9]!-}|z2Vzwv-,POqponl$Hjig%eB@@>}=<M:9wv^WsU2T|nm-
,jcl(I&%$#"^CB]V?Tx<uVtT^Rpo3Nlf.Jh++Fdbc=CBA9?!
Жаль, можно было бы