Go и Oracle
На работе произошло

Проблемы начались, когда я попытался подключиться из прототипа к СУБД «Оракл» (такое было условие задачи). Сначала я, как и наверное многие до меня, нашёл драйвер
Для начала, проблема возникла с кодировкой. У нас в базе используется кодовая таблица 1251. Сначала (тут я сам дурак) мне показалось, что драйвер не учитывает кодировку из переменных откружения (проблема оказалась
charset := C.CString(charset_dsn)
defer C.free(unsafe.Pointer(charset))

env := new(C.OCIEnv)
rv = C.OCIEnvNlsCreate(
    (**C.OCIEnv)(unsafe.Pointer(&env)),
    C.OCI_DEFAULT | C.OCI_OBJECT,
    nil, nil, nil, nil, 0, nil, 0, 0,
)
charset_id := C.OCINlsCharSetNameToId(unsafe.Pointer(env), (*C.oratext)(unsafe.Pointer(charset)))

rv = C.OCIEnvNlsCreate(
    (**C.OCIEnv)(unsafe.Pointer(&conn.env)),
    C.OCI_DEFAULT | C.OCI_OBJECT | C.OCI_THREADED | C.OCI_NO_MUTEX,
    nil, nil, nil, nil, 0, nil,
    charset_id, charset_id,
)
Этот код должен работать вместо OCIEnvInit, если нужно использовать кодировку. Но, повторюсь, это проблема не драйвера, просто этот тот случай, когда «ложечки нашлись, а осадок остался».
Потом оказалось, что в драйвере нет превыборки (prefetch),
Я подумал, что постоянно решать проблемы драйвера — не мой путь и нашёл прекрасный Goracle, чуть более сложный, но обладающий всеми мыслимыми возможностями, порт с пайтонячего драйвера, написанного на Си.
Единственная неприятность — драйвер все строки возвращает в кодировке
DBF → text
Попросили сконвертировать кучу досовских файлов формата DBF (dBase)
#!/bin/bash
[ -e converted ] || mkdir converted

# ищем все файлы dbf
find . -iname '*.dbf' | while read name; do
    echo "$name"

    # файл куда будет выгружен результат
    outname=converted/$(tr / '_' <<< "${name/./}").txt

    # есть ли файл memo?
    memo=${name%.*}.DBT
    if [ -e "$memo" ]; then
        # не добавлять удаление таблицы, кодировка CP866
        pgdbf -D -s cp866 -m "$memo" "$name"
    else
        pgdbf -D -s cp866 "$name"
    fi |
    grep -vE '^(BEGIN|\\COPY|\\\.|COMMIT)' |
    (
        # ↑↑↑ срезаем лишнее от утилиты pgsql
        read header
        # CREATE TABLE преобразуем в заголовок
        if [[ "$header" == 'CREATE TABLE'* ]]; then
            grep -o "(.*)" <<< "$header" |
            sed -e 's/ [^ ,]*,//g;s/ [^ ]*$//;s/(//' | tr ' ' '\t'
        else
            echo "$header"
        fi

        # остальное — без измненений
        cat
    ) > "$outname"
doneУ меня тут что, демократией намазано?
Время от времени в комментариях всплывают идиоты, которые
Раньше я пытался понять что ими движет, но так и не смог разобраться, теперь просто посылаю.
Что почитать перед выходными
Костя Коломеец, который руководит внутренними сервисами в «Яндексе», рассуждает о том почему быстрый рост убивает компании и что с этим можно сделать.
Статья «Они выбрали Россию: Истории из жизни иностранцев в РФ» пытается приятно романтизировать российскую действительность. Прочитайте, если вам уже невмоготу, а «трактор» не решились. Красиво написано, чтение доставляет удовольствие, вселяет оптимизм.
В ЖЖ Артемий Лебедев рассказывает о недавно найденных в Америке, ранее неизвестных фотографиях России 1917 года. Их автор — Джон Рахилл, выпускник Йельского университета, изучавший «вклад христианства в социализм». Фотографий около 500, пока в интернете доступно около десятка. От каждой веет
Станислав Садальский, так же (в ЖЖ), показывает неизвестную грань известного актёра кино — Юрия Богатырёва, ныне уже покойного. Оказывается, Юрий Георгиевич ещё и рисовал в очень интересной манере, мечтал о выставке.
Андреян Максимович Мизгирев
Есть у меня в дереве предков такой товарищ — Андреян Максимович Мизгирев, прапрапрапрадед, родился в 1817 году в Письмянской Ясашной слободе (ныне — Старая Письмянка в Татарстане). Как правильно читается фамилия, я не знаю, но вероятнее всего — без буквы «ё», образована она по всей видимости, от прозвища «мизгирь» — «коротышка», «мозгляк».
Андреяну
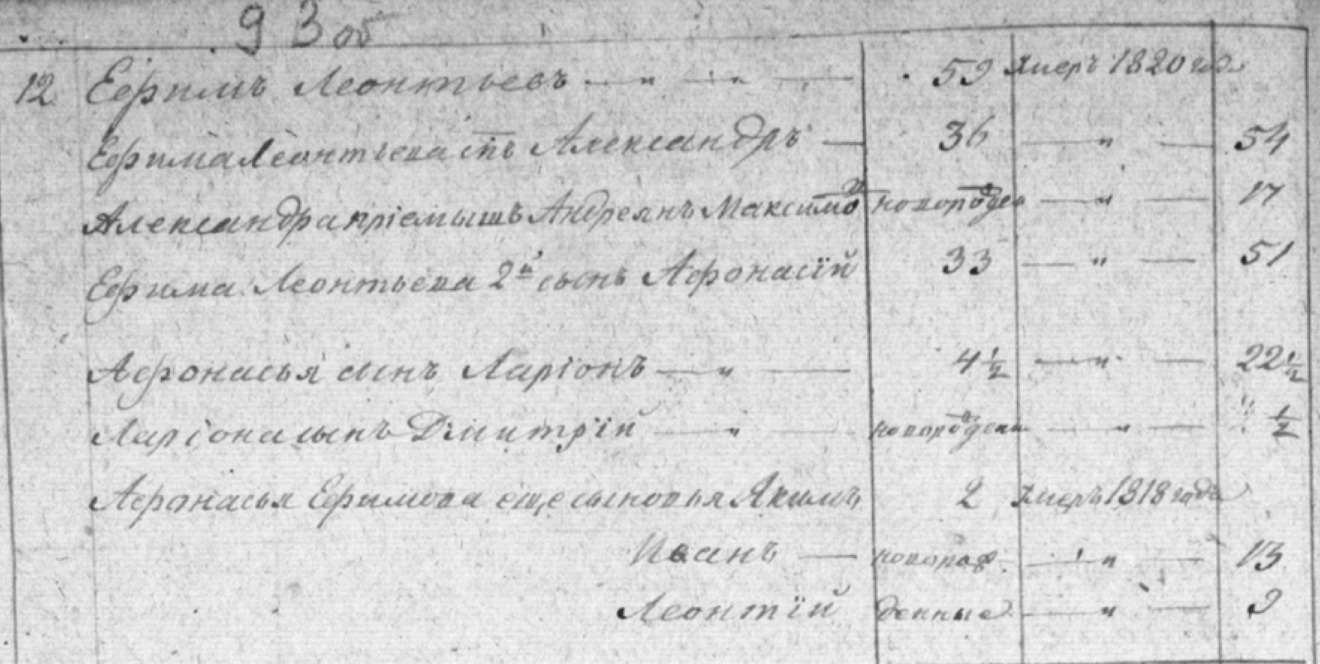
Вопрос: кто же родители?
Как будем отвечать?
У меня есть только бумаги за 1795, 1811, 1816, 1834, 1850, 1859 и 1864 года. В разнообразных архивах можно выудить
Первая моя мысль — ну, ок, родители явно умерли между 1817 и 1834, можно попробовать поискать кандидата на отцовство: выписать всех Максимов из 1816 и посмотреть кто не дожил до 1834, если повезёт, это будет
Такой человек нашёлся, как раз только один — Максим Максимович, 1757 года рождения, которому на момент рождения моего предка должно быть 60. Умер в 1819 году, через два года после рождения предполагаемого сына. Жене Татьяне должно было быть на момент родов 41 (по переписи 1816 года) или 57 (по переписи 1795).
Из этого можно сочинить такую историю с большой натяжкой: возраст Татьяны в 1816 не ошибка переписчика, а у Максима Максимовича было две жены Татьяны, вторая из них в 41 год родила сына от мужчины которому 61. Примерно представляя уровень медицины в то время, мне очень сложно в это поверить. Но допустим.
По наитию я решил просмотреть семейный список 1864 года по этому населённому пункту. В нём на оборотной стороне часто бывают любопытные заметки и там я наткнулся на фразу, которая проясняет всё:
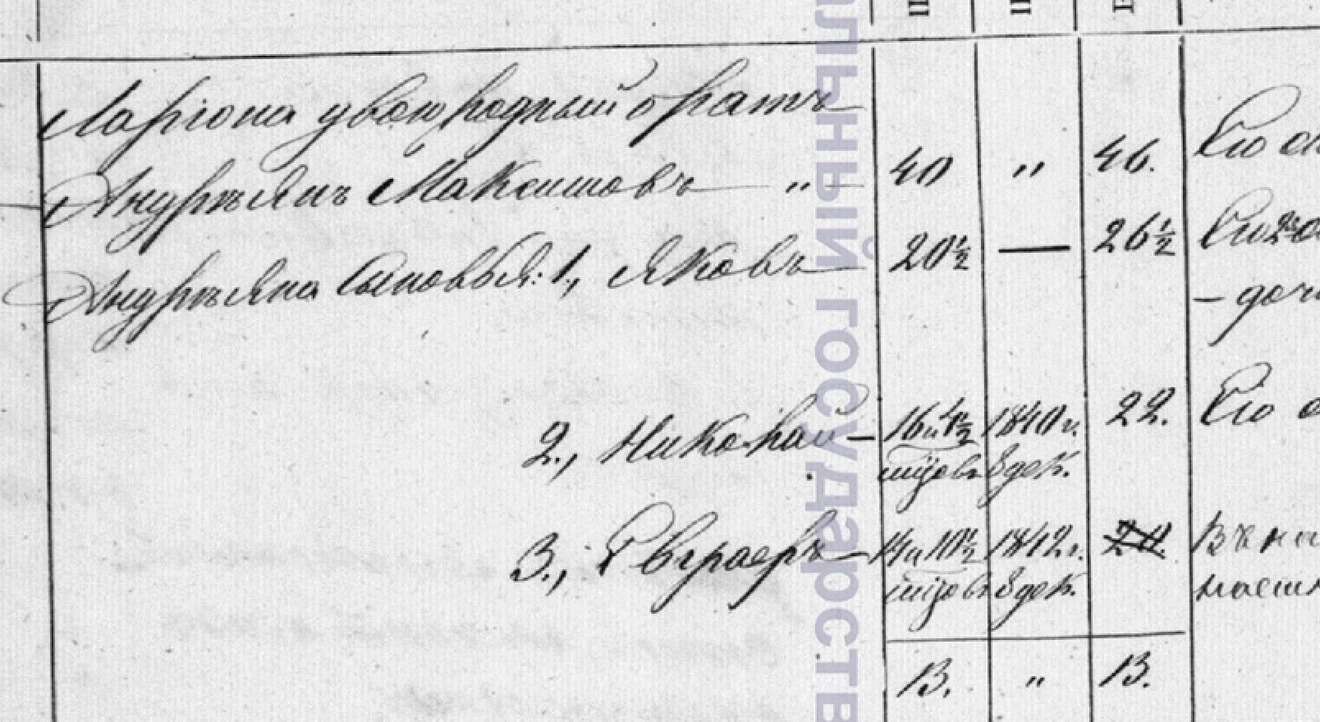
Мой Андреян Максимович — двоюродный брат Лариона (Афонасьевича, отчество есть на другой странице). Смотрим на первый скан и видим там Афонасия Ефимовича с сыном Ларионом, именно эта большая семья и приютила моего предка.
Значит, подумал я (вот оно, патриархальное мышление!), есть некий Максим Ефимович, брат Афонасия, который и является отцом моего Андреяна. Смотрю на мой список, где я выписал всех Максимов, а там только Максимович, Алексеевич и три Степановича.
Я, конечно, быстро догадался, что брата этого нет, есть сестра, которая и является матерью моего предка. Видимо, замуж она вышла
Почему у null в JS тип «object»?
На «Хабре» вышла статья, проливающая свет на загадку — почему же у null в Джаваскрипте тип «объект». Причём, если попытаться этому «объекту» добавить
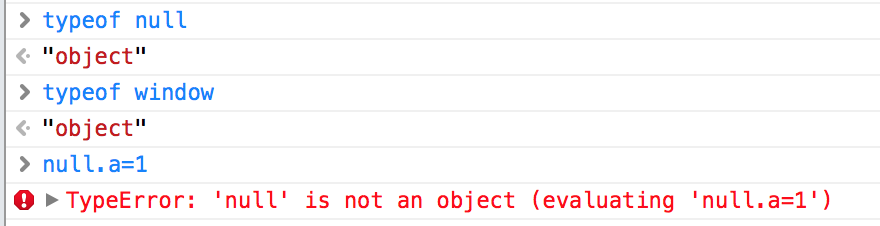
Вообще, я этому особого значения не придавал. Ну да, примитивное значение, имеет тип объект, хотя по факту им не является, смысла я в этом не вижу, это мешает, но поменять это нельзя.
Оказывается, это баг. Точнее даже не баг, а просто «так получилось». В ранних интерпретаторах Джаваскрипта тип хранился в первых трёх битах значения. Для типа «а это у нас null» значения не хватило, ему дали тип «объект», а под значение выделили нулевой указатель. Ну typeof, особо не заморачиваясь, выдавала object.
К сожалению, программисты поленились сделать дополнительную проверку. Можно было при наличии нулевого указателя попросить typeof выводить «null» и дело в шляпе. Сейчас, как оказалось, куча кода завязано на это поведение и ломать уже ничего никто не будет.
Конон-варвар Иванович

Вот ты какой, простой русский парень
Как получить значения всех ключей в Memcached
В комментариях к одной из статей на «Хабре» привели однострочник для командной строки, чтобы вывести содержимое всех ключего локального memcached, я его прямо там причесал, но подумал, что он может мне и самому в будущем пригодиться. Переношу сюда:
nc localhost 11211 <<<"stats items" | awk -F: '/STAT items:[0-9]+/{if (!a[$2]++) print $2}' |
xargs -I{} echo 'stats cachedump {} 100' | nc localhost 11211 | awk '/ITEM/{print $2}' | xargs -n1 echo get |
nc localhost 11211
Без использования awk:
nc localhost 11211 <<<"stats items" | sed -n '/STAT/{s/[^:]*:\([^:]*\).*/stats cachedump \1 100/;p}' | sort -u |
nc localhost 11211 | sed -n '/ITEM/{s/[^ ]* \([^ ]*\) .*/get \1/;p}' | nc localhost 11211
Без использования awk и sed:
nc localhost 11211 <<<"stats items" | grep -Po '(?<=STAT items:)\d+' | sort -u |
xargs -I. echo stats cachedump . 100 | nc localhost 11211 | grep -oP '(?<=ITEM )\S*' |
xargs -n1 echo get | nc localhost 11211…И в воздух яблоки бросали…
По меткому выражению одного товарища с работы, я окончательно примкнул к фанбоям Эпла — приобрёл себе свитер со Стивом Джобсом. Свитер сделан на заказ (и существует пока в одном экземпляре).
Спереди — известная фотография, справа, на плече — логотип Эпла, чёрный цвет и высокое горло — аллюзия на любимые водолазки Стива.
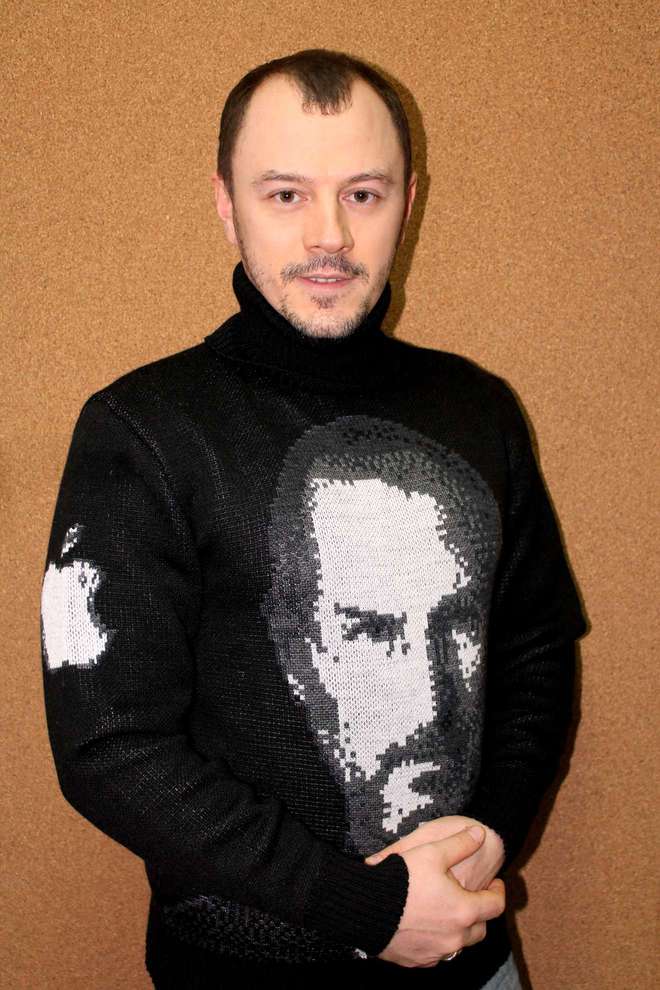
Связали мне его в «Свитеррариуме» — это казанская компания, специализирующая на вязке под заказ, существует уже более двух лет, за это время связала уже более сотни свитеров. Качество вязки, на мой взгляд, отличное.
Жаль, что у компании были трудные времена с оборудованием и свитер пришлось ждать почти два месяца. За это время я похудел на 12 килограмм и мерки пришлось снимать заново. К счастью, сейчас всё устаканилось — была куплена новая вязальная машина — PASSAP E8000 и теперь на заказ будет уходить примерно две недели. Вот она на снимке ниже:
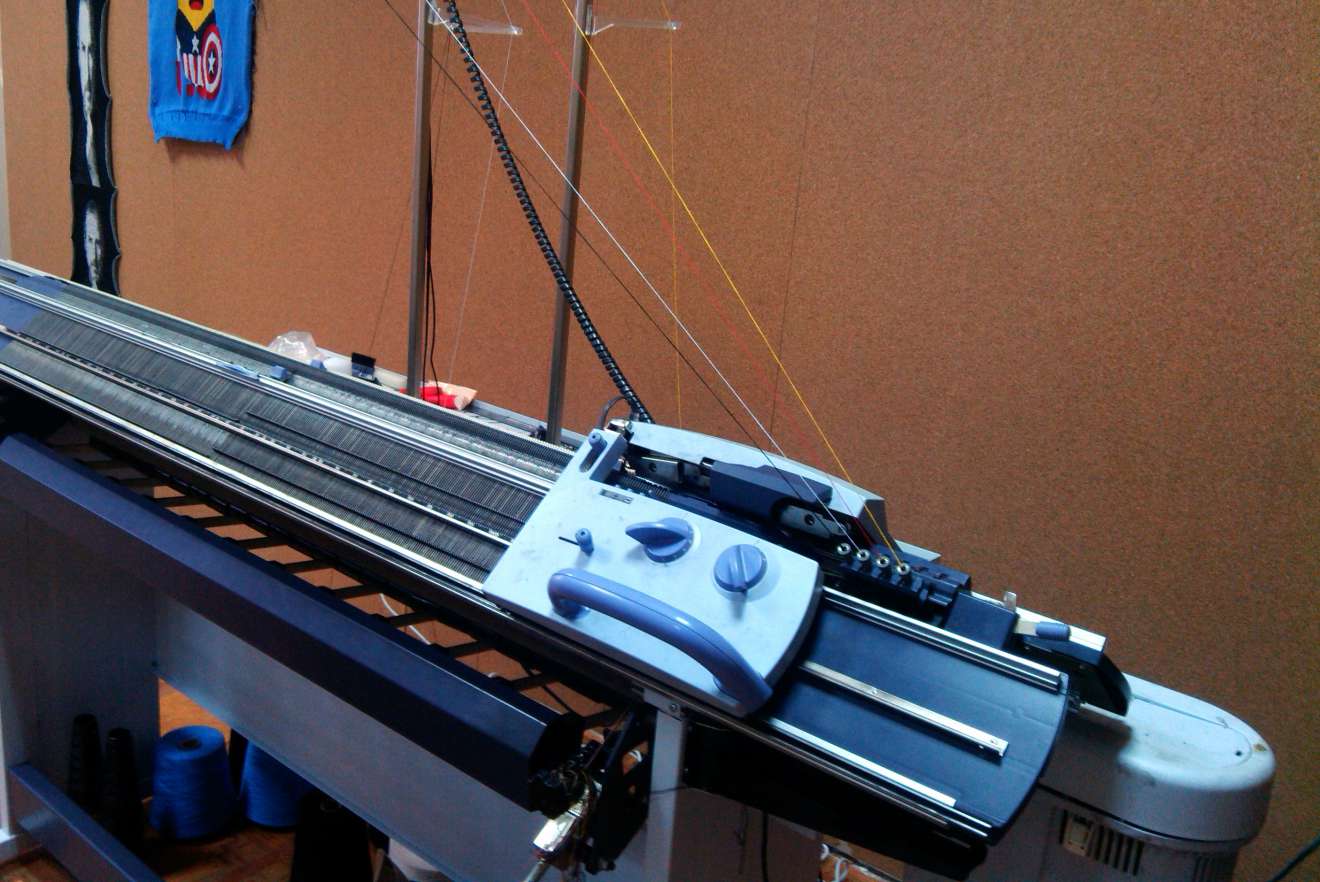
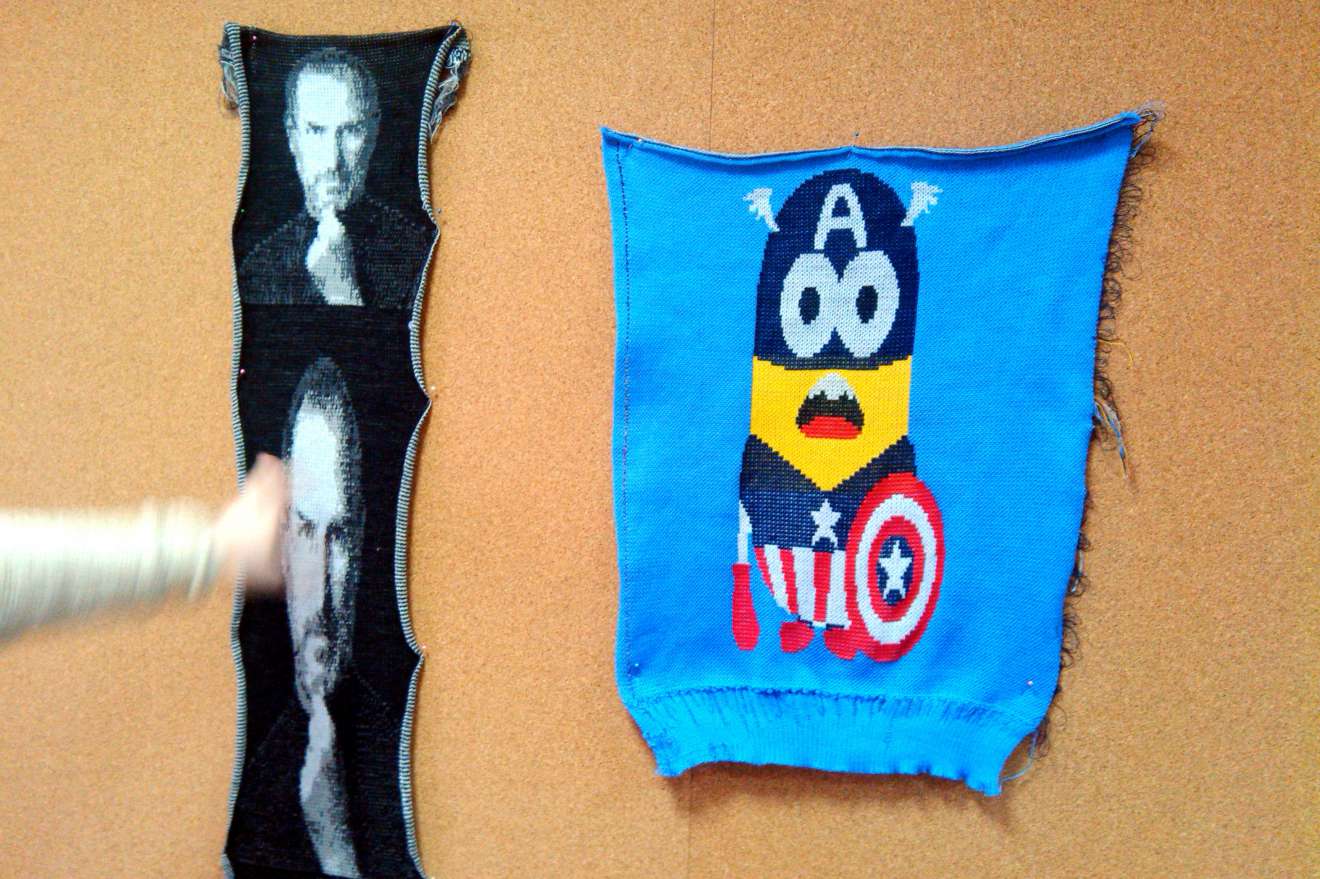
Собственно, эти два месяца ушли на приобретение машинки, её перевозку и учёбу. Мой свитер был готов по частям
Думаю, зададут вопрос про цены (тем более, заказы из других городов выполняются без проблем), я потрудился их уточнить специально по этому поводу. Мой свитер обошёлся в 3,5 тысячи. Цены на свитеры с рисунком начинаются с трёх тысяч (исключение — «свитер с оленями», его часто заказывают, он стоит 2,7). У меня от базовой цены есть опции — четыре цвета и высокое горло.
Цены на опции такие: молния, карманы, капюшон, большой размер — всё по триста рублей, высокое горло и каждый дополнительный цвет — плюс 200. Если выбираются несколько пунктов, то скопом они стоят дешевле.
Что почитать в выходные
Яна Франк (более известная как «Миумау») немного рассуждает о сомнительном знаке равенства между безумными поступками и романтикой, а так же приводит одну историю в образец настоящего романтического поступка. Склонен с ней согласиться, мне дикие выходки куда менее симпатичны таких вот доместикацированных поступков.
«
Ксения Подорова написала небезынтересную статью «Кто ходит в школу по утрам…» о самостоятельном домашнем обучении, без посещения школы (точнее её дети школу
Статья «Старообрядчество в фотографиях М.П. Дмитриева» мне прежде всего интересна лицами и интерьерами, все собранные фотографии сделаны в между 1894 и 1913 годами, что позволяет хоть немножечко представить ту атмосферу, в которой жили мои предки в то время (а по меньшей мере одна ветка — Онуфриевы, у меня из старообрядцев). Посмотрите, может и вас зацепит запечатлённая мрачная Россия.
PHP 5.6
Немного времени осталось до выхода PHP 5.6. Похоже, авторы взяли в привычку добавлять в каждой версии в язык несколько нововведений. Сейчас эта версия в стадии альфы, это означает, что до беты может добавиться
echo 2**3, "\n", // восемь
-2**2, "\n", // минус четыре
2 ** 3 ** 2; // 512
«Крышка» (^), которая во многих языках занята под степень, в ПХП занята под «исключающее или», поэтому сделали две «звёздочки», как в Пайтоне. Из приведённых примеров мы видим, что «вес» унарного минуса ниже, чем у степени — он применяется уже к результату, об этом надо помнить, лично я бы ожидал, что в степень будет возведено отрицательное число. И, кстати, сама операция является правоассоциативной (последний пример).
$a = gmp_init(2);
$b = gmp_init(3);

$c = $a**2 + $b;

echo $c, "\n"; // выведет 7
var_dump($c); // покажет объект класса GMP, у которого есть свойство num=7
echo array_sum([1,2,gmp_init(-3)]); // 3, печаль
Кроме этого, переход к объектам (от ресурсов) позволит сериализовать эти числа, что является хорошим бонусом. Увы, не всё ещё гладко — последний вызов (где суммируется массив) возвращает число три, а не ноль.
const alf = 2;
const bolk = alf*alf . alf; // работает новый синтаксис

echo bolk, "\n"; // 42

define("TEST", alf*alf . alf); // работает старый синтаксис
echo TEST, "\n"; // 42// сколько бы аргументов после первого не было, они попадут в $params массивом
function query($query, ...$params) {
$stmt = $this->pdo->prepare($query);
$stmt->execute($params);
return $stmt;
}Синтаксис с тремя точками используется в Си, Джаве и новой версии Джаваскрипта. Что интересно, с новым синтакисом работает и указание типа аргумента, и передача по ссылке. Ограничения этого синтаксиса вполне понятные — такой аргумент должен быть всегда последним (и/или единственным), задавать значения
// всё это неправильно:
function fn(...$args, $arg) // такой агрумент не первый
function fn(...$args1, ...$args2) // не единственный
function fn($arg, ...$args = []) // задано значение по-умолчанию
Выбор именно такого синтаксиса основывался на следующих вещах:
// выглядит как будто мы требуем, чтобы $args был массивом, что бесполезно — $args уже
// массив, по определению; на самом деле этот синтаксис должен иметь значение «каждый переданный
// в $args элемент — массив»
function fn(array $args...)
// будет путать ребят, которым приходится программировать и на Си тоже — очень похоже
// на указатель
function fn(Char *$args)
// в Си# используется ключевое слово «params», для ПХП не подходит, так как будет путаница
// с указанием типа
function fn(params $args)$a = $b = 2;
$c = ['a', 'b'];
var_dump(call_user_func_array('compact', $c)); // прежний синтаксис
var_dump(compact(...$c)); // новый синтакисис
var_dump(compact(...$c, 'c')); // можно ещё и так, будут переданы как аргументы 'a', 'b' и 'c'
var_dump(...new ArrayIterator([1, 2, 3])); // даже так работает! утиная типизация во всей красе
var_dump(...[1 => 1, 3 => 1]); // будет переданы два параметра, без пропусков в номерации
var_dump([...$c, $a]); // а вот так, увы, нельзя
list($k, ...$d) = $c; // так тоже нельзя
echo ...$c; // даже так нельзя!К сожалению, ПХП традиционно не радует согласованностью синтаксиса и последняя группа выражения не работает. Кстати, синтаксис в тремя точками улучшает картину производительности вызова функций с переменным числом аргументов.
Но даже с этими недостатками, нововведение хорошее. Посмотрите как чудесно выглядит каррирование в новом синтаксисе:
function bind(callable $function, ...$boundArgs) {
    return function(...$args) use($function, $boundArgs) {
        return $function(...$boundArgs, ...$args);
    }
}

$arrayToLower = bind('array_map', 'strtolower');

$arrayToLower(['Foo', 'BAR', 'baZ']); // вернёт ['foo', 'bar', 'baz']Терри Пратчетт. «На всех пара́х»
Как быстрее измерить длину строки в Go?
Интересная штука, с которой сталкиваются начинающие разработчики в Гоу — как измерить длину строки в этом языке. То есть речь не идёт даже о быстроте, как, чёрт возьми, вообще это сделать?
Встроенная функция len возвращает длину в байтах, именно поэтому англоязычные разработчики часто и не знают, что проблема есть — строки латиницы, что в байтах, что в символах (в Гоу они называются «руны») занимают одинаково.
Я знаю два способа измерить длину строки:
package main

import ("io/ioutil"; "unicode/utf8")

func main() {
    bytes, _ := ioutil.ReadFile("test.txt")

    // считаем сколько рун встречается в строке
    print(utf8.RuneCountInString(string(bytes)))

    print("\n")

    // считаем длину массива рун
    print(len([]rune(string(bytes))))
}
По работе понадобилось измерить длину строки быстро — у меня здоровый цикл, где она постоянно измеряется, оказалось, что в тысяче итераций на тексте книги «На всех пара́х» Терри Пратчетта разница в две секунды — выигрывает преобразование в массив «рун».
Нужен быстрый способ — используйте len([]rune(…)).
Жили-были
Помните стандартное начало многих русских сказок —
Это остатки давнепрошедшего времени в нашем языке — оно используется для событий, которые уже давно прошли или были до другого прошлого действия. Для его образования использовался глагол «быть», его же уши торчат из фраз «я уже было ушёл», «я подумал было» и так далее.
Так что
Фотнул мультифору в толчёнке
Прочитал статью «Толчёнка, свечка и вехотка» про городские диалекты, задумался — а есть ли у нас в Казани свои диалектные слова? Кроме «айда» ничего и не вспоминается, но это слово и в остальной России хорошо знакомо.
А вот Новосибирск такими словами похвастаться может — с «вехоткой» (это они так мочалку называют) и «мультифорой» (это файлик) я познакомился только в «Яндексе», там новосибирцев было навалом, едва ли не больше, чем выходцев из любого другого города.
Красноярск может похвататься словом «козный», Омск — «сигнашкой», Иркутск — «шанхайкой», Екатеринбург — «хлюздой», неужели у Казани ничего нет?
АрхиКАПТЧА
Некоторые архивы сейчас выставляют свои фонды в интернет — работать с бумажном документом сложно (с микрофильмами ещё сложнее), кроме того это всё ветшает, выцветает. К сожалению, на этом плюсы «цифры» кончаются, я знаю очень мало архивов, которые, кроме сканирования, ещё и распознали свои архивы.
Отсканировать, да ещё и распознать это всё — огромные деньги (тем более, что есть много рукописных документов, их автоматически не распознать, значит — нужно нанять людей, это ещё бо́льшие деньги).
Мне архивы откровенно жалко, столько информации безвозвратно теряется, а что делать их работники не понимают. Хуже всего, что способ есть, дешёвый, почти бесплатный — добровольцы выстоятся в очередь, только руку протяни.
Для начала, как запустить процесс сканирования документов? Да он уже запущен! Большинство исследователей приходит в архив и платит деньги за то, чтобы им дали скан
Я бы свои документы с удовольствием туда положил, чтобы они не потерялись, если мой диск прикажет долго жить. Можно это всё обвязать социальщиной — лайками, ачивками, комментариями.
С распознаванием не сложнее. Многие знают проект «РеКАПТЧА» по распознаванию текста из книг.
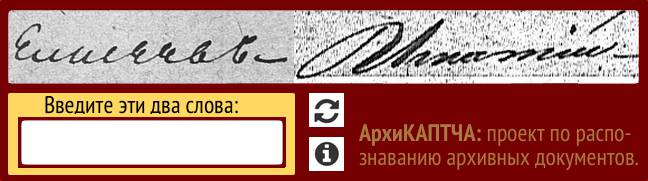
Делаем на логине в наш электронных архив такую же «АрхиКАПТЧу», заставляем людей подтвердить, что они не роботы и распознать пару слов из документа.
Для тех, кто не знает «РеКАПТЧА» работает следующим образом: нужно распознать и ввести два слова, одно из которых системе известно, а второе — нет. Известное используется для проверки, что это не робот пытается войти, неизвестное, в этом и смысл — чтобы человек его распознал. Когда по неизвестному слову накапливается достойная статистика, в качестве верного варианта выбирается то, что чаще всего вводили.
Чтобы роботы не смогли ничего прочесть, в КАПТЧу обычно вводят искажения. В случае архива даже искажать ничего больше не надо — и так всё написано достаточно неразборчиво, роботы пока такое не читают. Например, в моём примере первое слово — «Елисеевъ», второе — «Игнатій».
Можно было бы помочь архивам — взять на себя такой некоммерческий проект, но ведь это
Вот бы «Яндексу» этим заняться, на манер гугловского проекта «Книги».
«Функция» print
Одним из распространённых заблуждений программистов на ПХП является то, что конструкция print является, якобы, функцией. На самом деле никакая она не функция — ей даже скобки не нужны, чтобы работать. Но с функцией print роднит то, что при вызове в составе выражения она всегда возвращает «1».
Весь ужас этого заблуждения как раз в использовании этой конструкции со скобками. Я программирую на ПХП уже около 15 лет, но всего пару раз за это время видел как это заблуждение рождает проблемы, но зато какие!
Я, понятное дело, напишу утрированный случай, чтобы проиллюстрировать проблему. Как думаете, что выведет следующий код?
var_dump(print("xaxa") + 1);По идее, должна выполниться «функция» print, вывести «xaxa», вернуть «1», которая сложится со второй единицей и var_dump выведет их сумму — «2».
Как бы не так! На самом деле, с точки зрения конструкции print (которой не нужны скобки) ей передали аргумент «(„xaxa“) + 1». При их складывании левая часть преобразуется к числу и получается «0», сумма нуля и единицы — «1», вот print его и напечатает, потом вернёт единицу, которую напечатает var_dump.
Мирон Петрович Сидоров
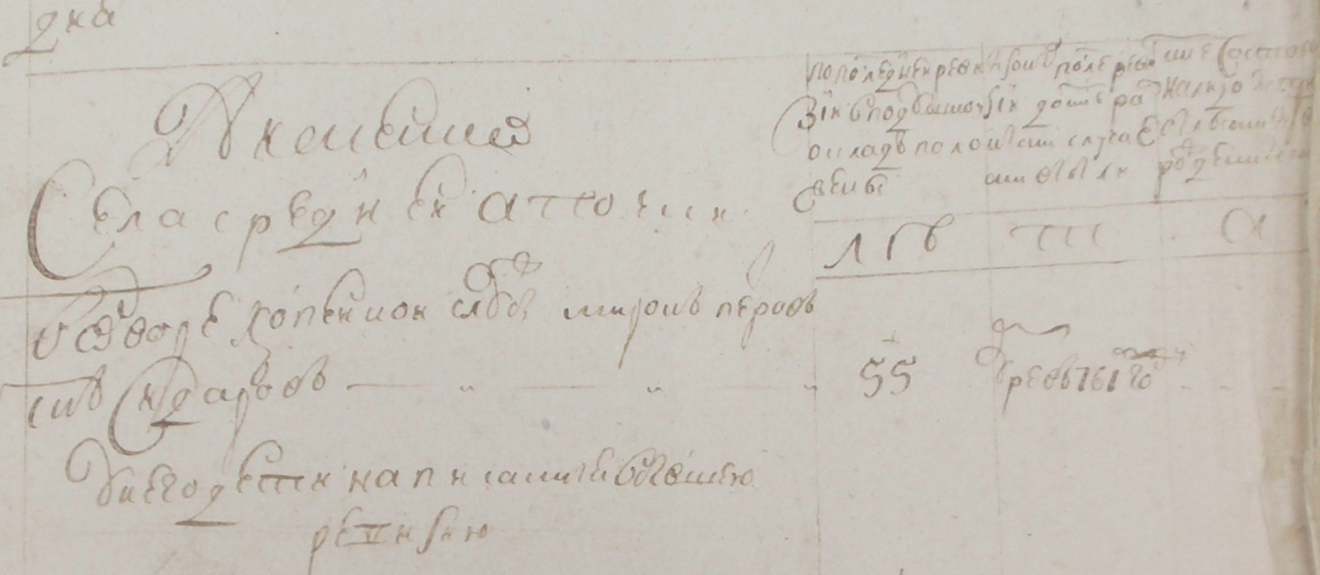
У меня тут небольшое событие произошло в дереве — появился первый предок с достоверной датой рождения
На фотографии ревизская сказка 1762 года, где указан Мирон Петров(ич) сын Сидоров, живший в селе Средние Апочки (это под Курском), как видно на предыдущую ревизию (1744 года) ему было 55 лет, что даёт нам 1689 год рождения. Рядом, кстати, написан и год смерти — 1761.
Так что теперь самый старый предок с известным мне годом рождения — Мирон Петрович Сидоров, 1689—1761, однодворец из села Средние Апочки.
А ещё незаметно для себя я начал неплохо понимать скоропись 17—18 веков, вроде той, что на снимке — тут я бегло понимаю почти всё, кроме пары слов, которые нужно разбирать тщательнее.
Обратите внимание, кстати, на цвет чернил — он ржавый