Вот вам загадки, разминка для ума (уже всё разгадали)
Мы тут в выходные (у нас в Татарстане на этой неделе три выходных) изрядно поездили и случайно попали в Музей купеческого быта Козьмодемьянска, где очаровательная смотрительница по ходу повествования просила угадать предназначение некоторых вещей, там выставленных.
Хочу вам переадресовать те же загадки, плюс загадать собственные. Все фото из упомянутого музея, последняя — исключение, она из Этнографического музея того же города.
Итак, попробуйте догадаться, что на каждом фото.

На первой фотографии обратите внимание на стекляшку из прозрачного стекла почти в центре кадра. Для чего она, как вы думаете?
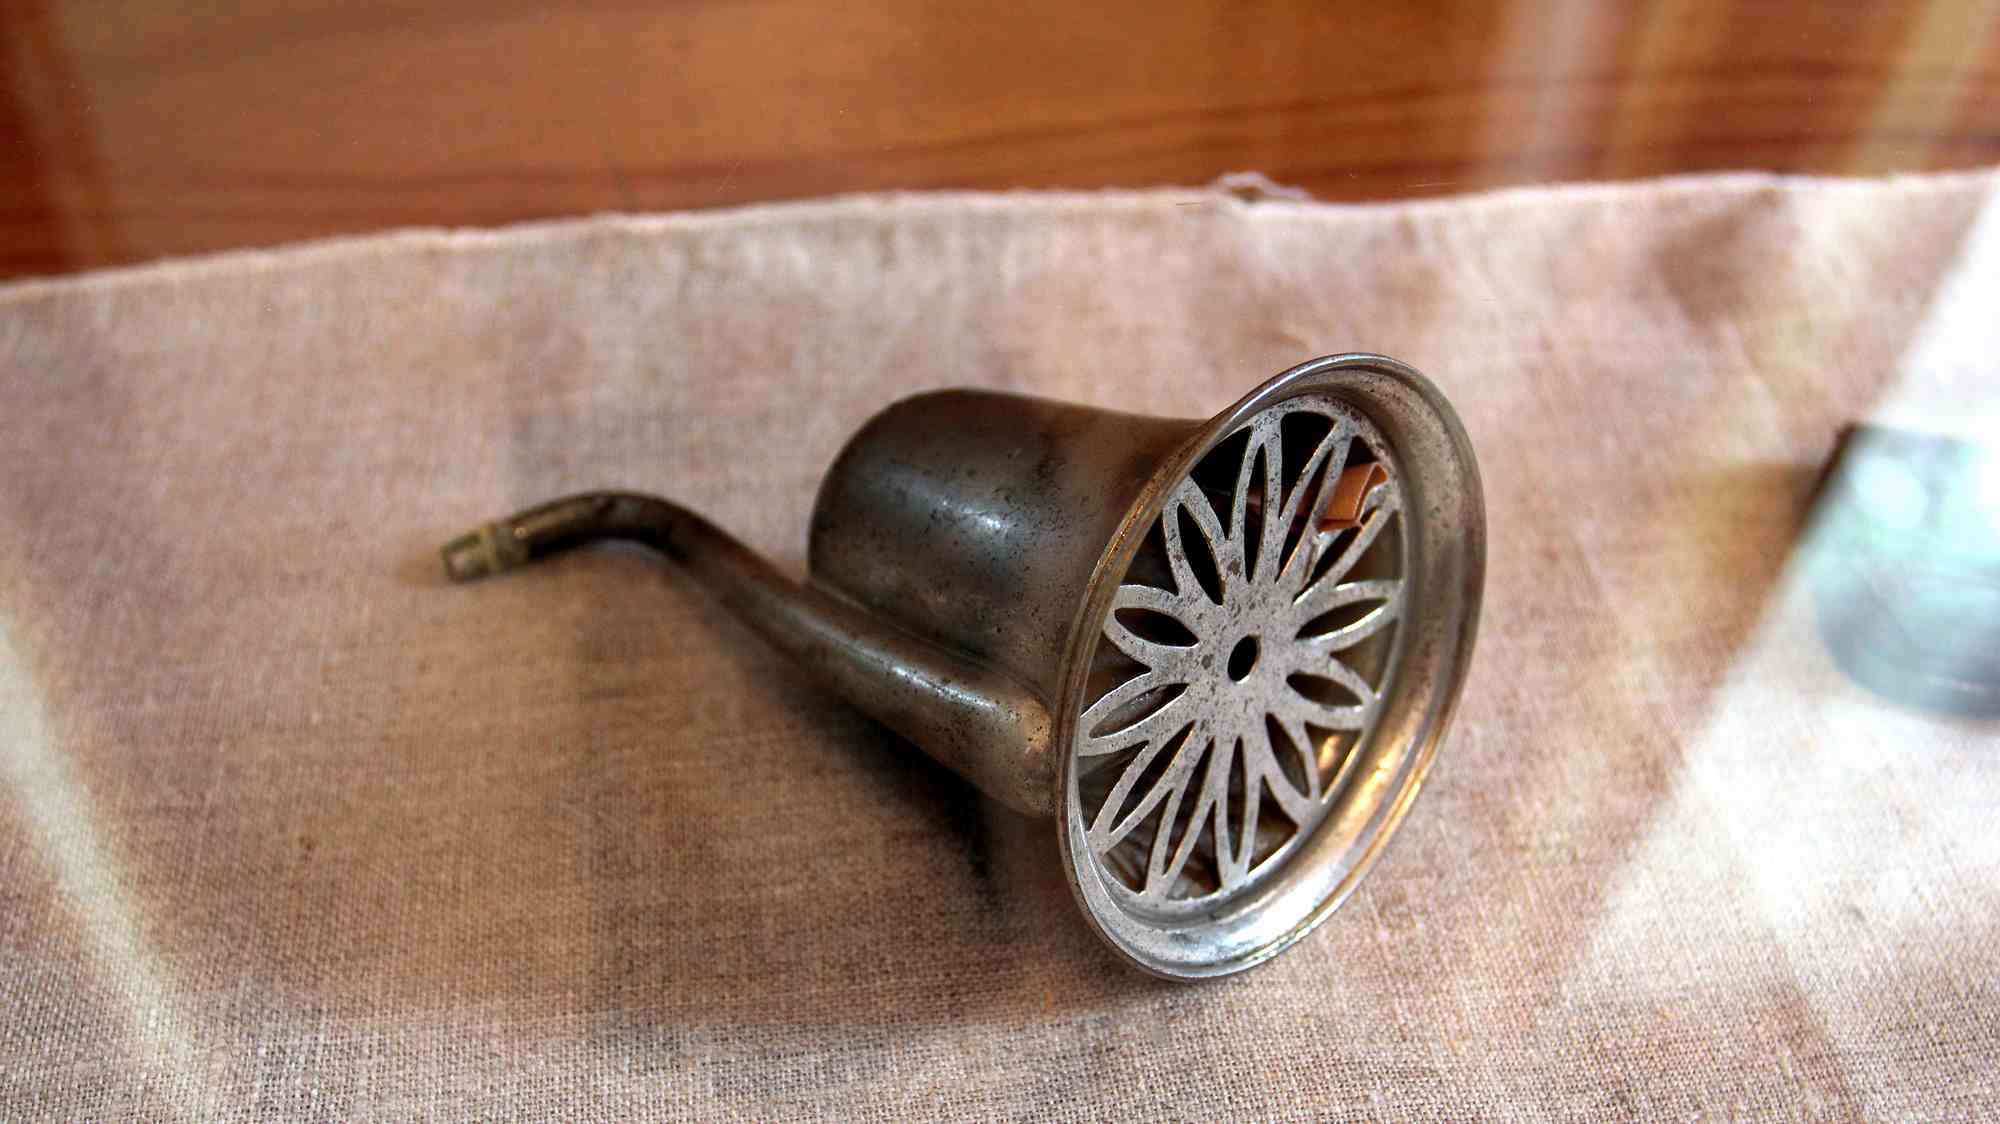
Единственная штука на фото, для чего она использовалась?
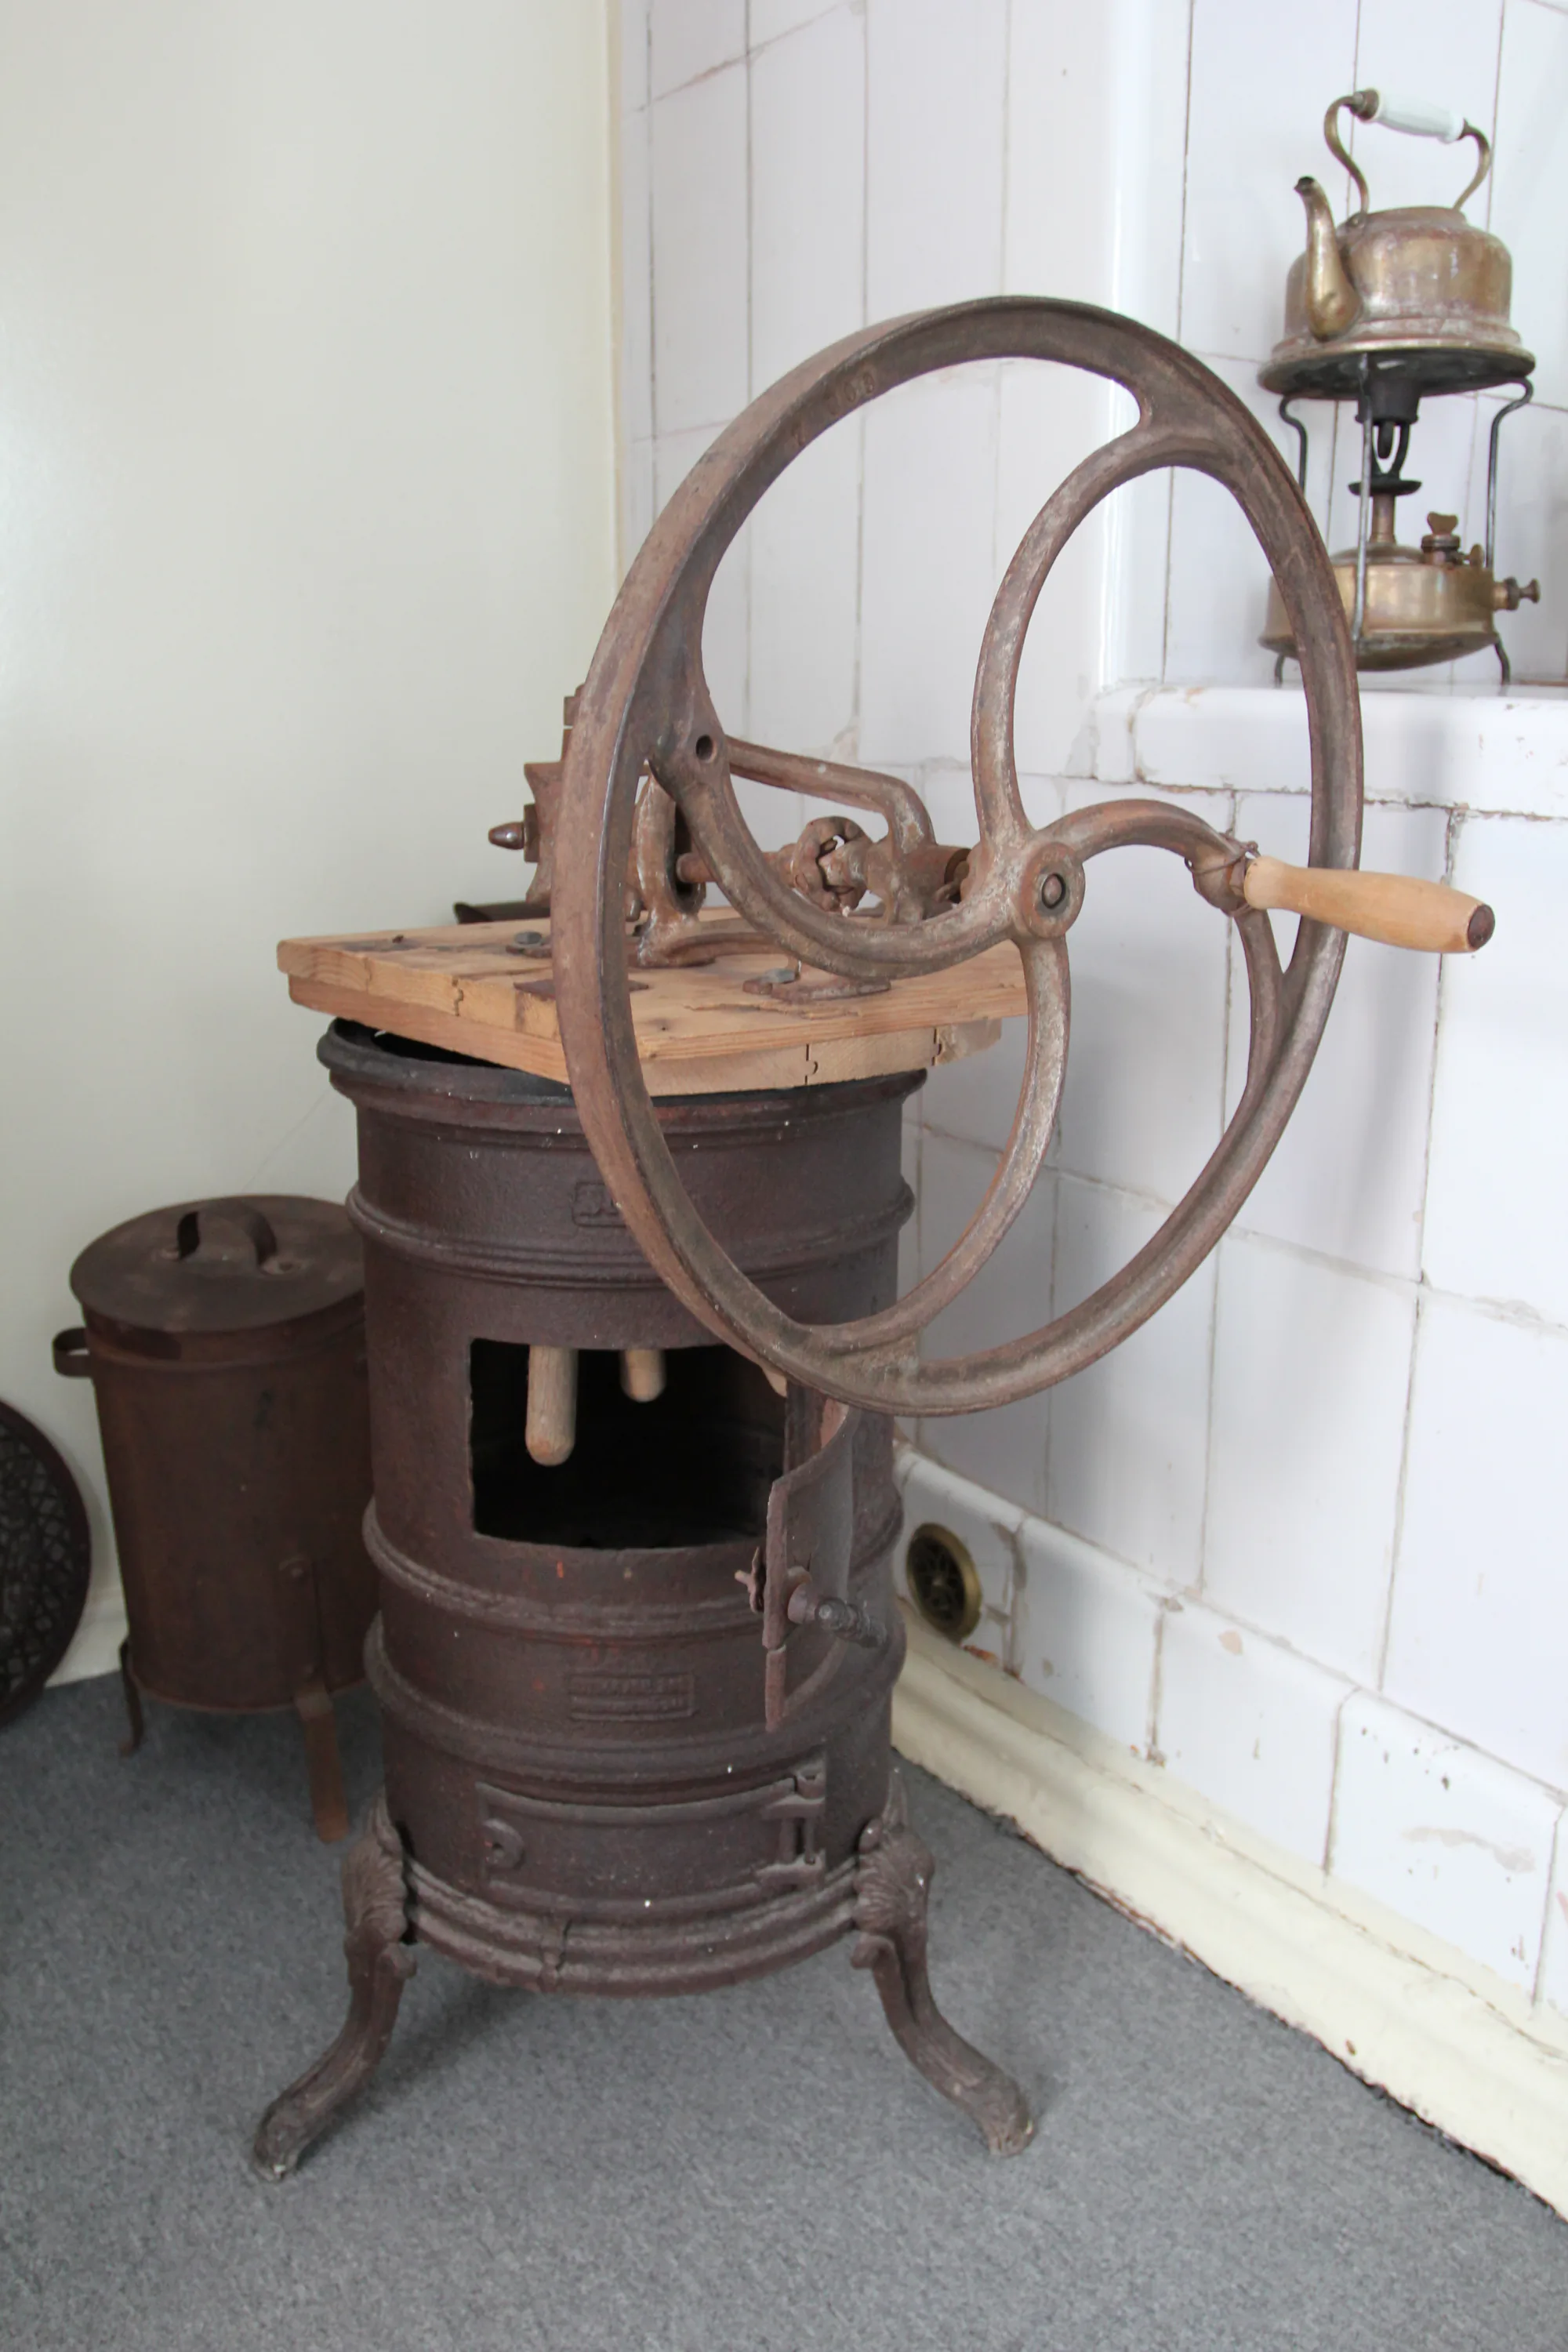
На ржавой буржуйке лежит некий предмет, к буржуйке отношения не имеет, они вряд ли
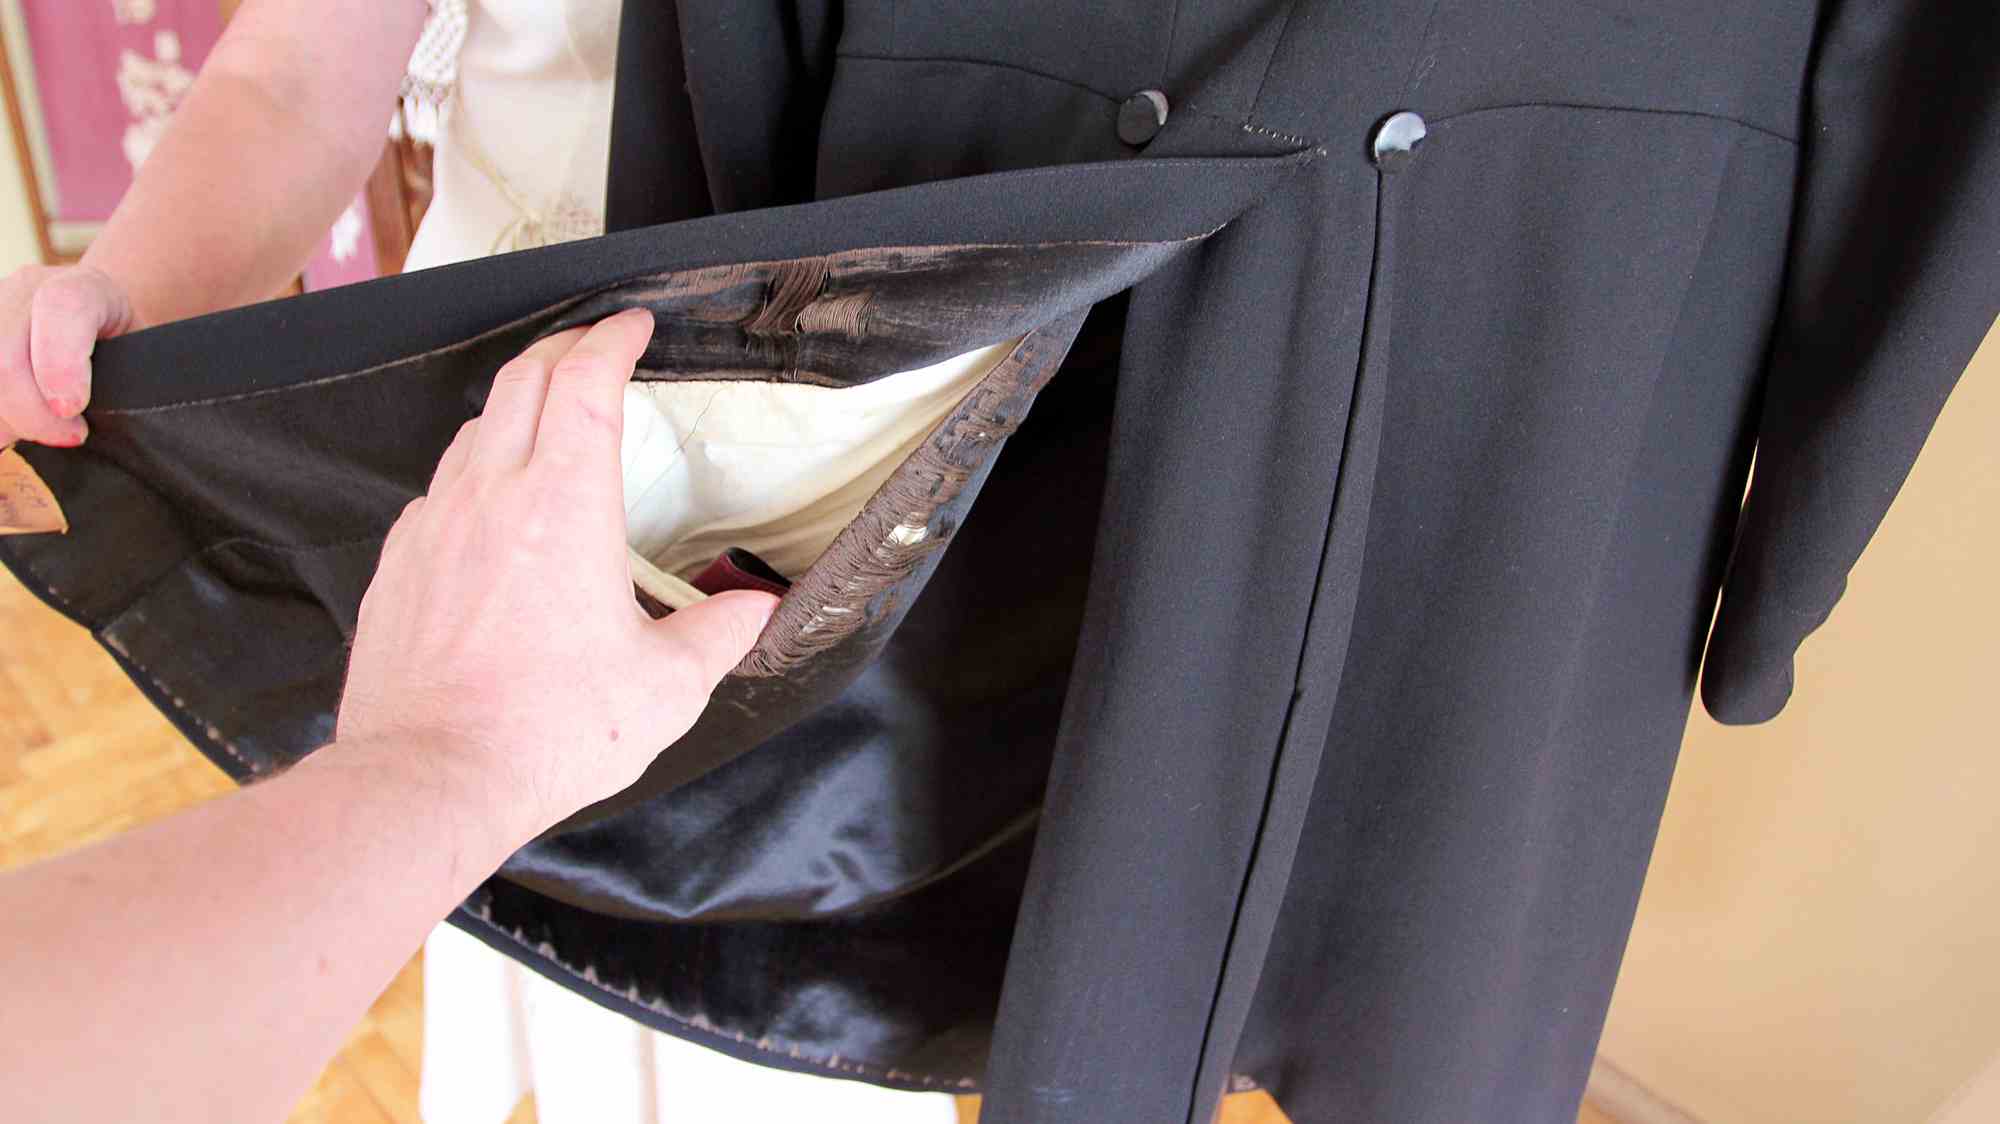
Что за дыра сзади на фраке, она была сделана с ведома хозяина фрака? Для чего эта дыра могла быть использована?
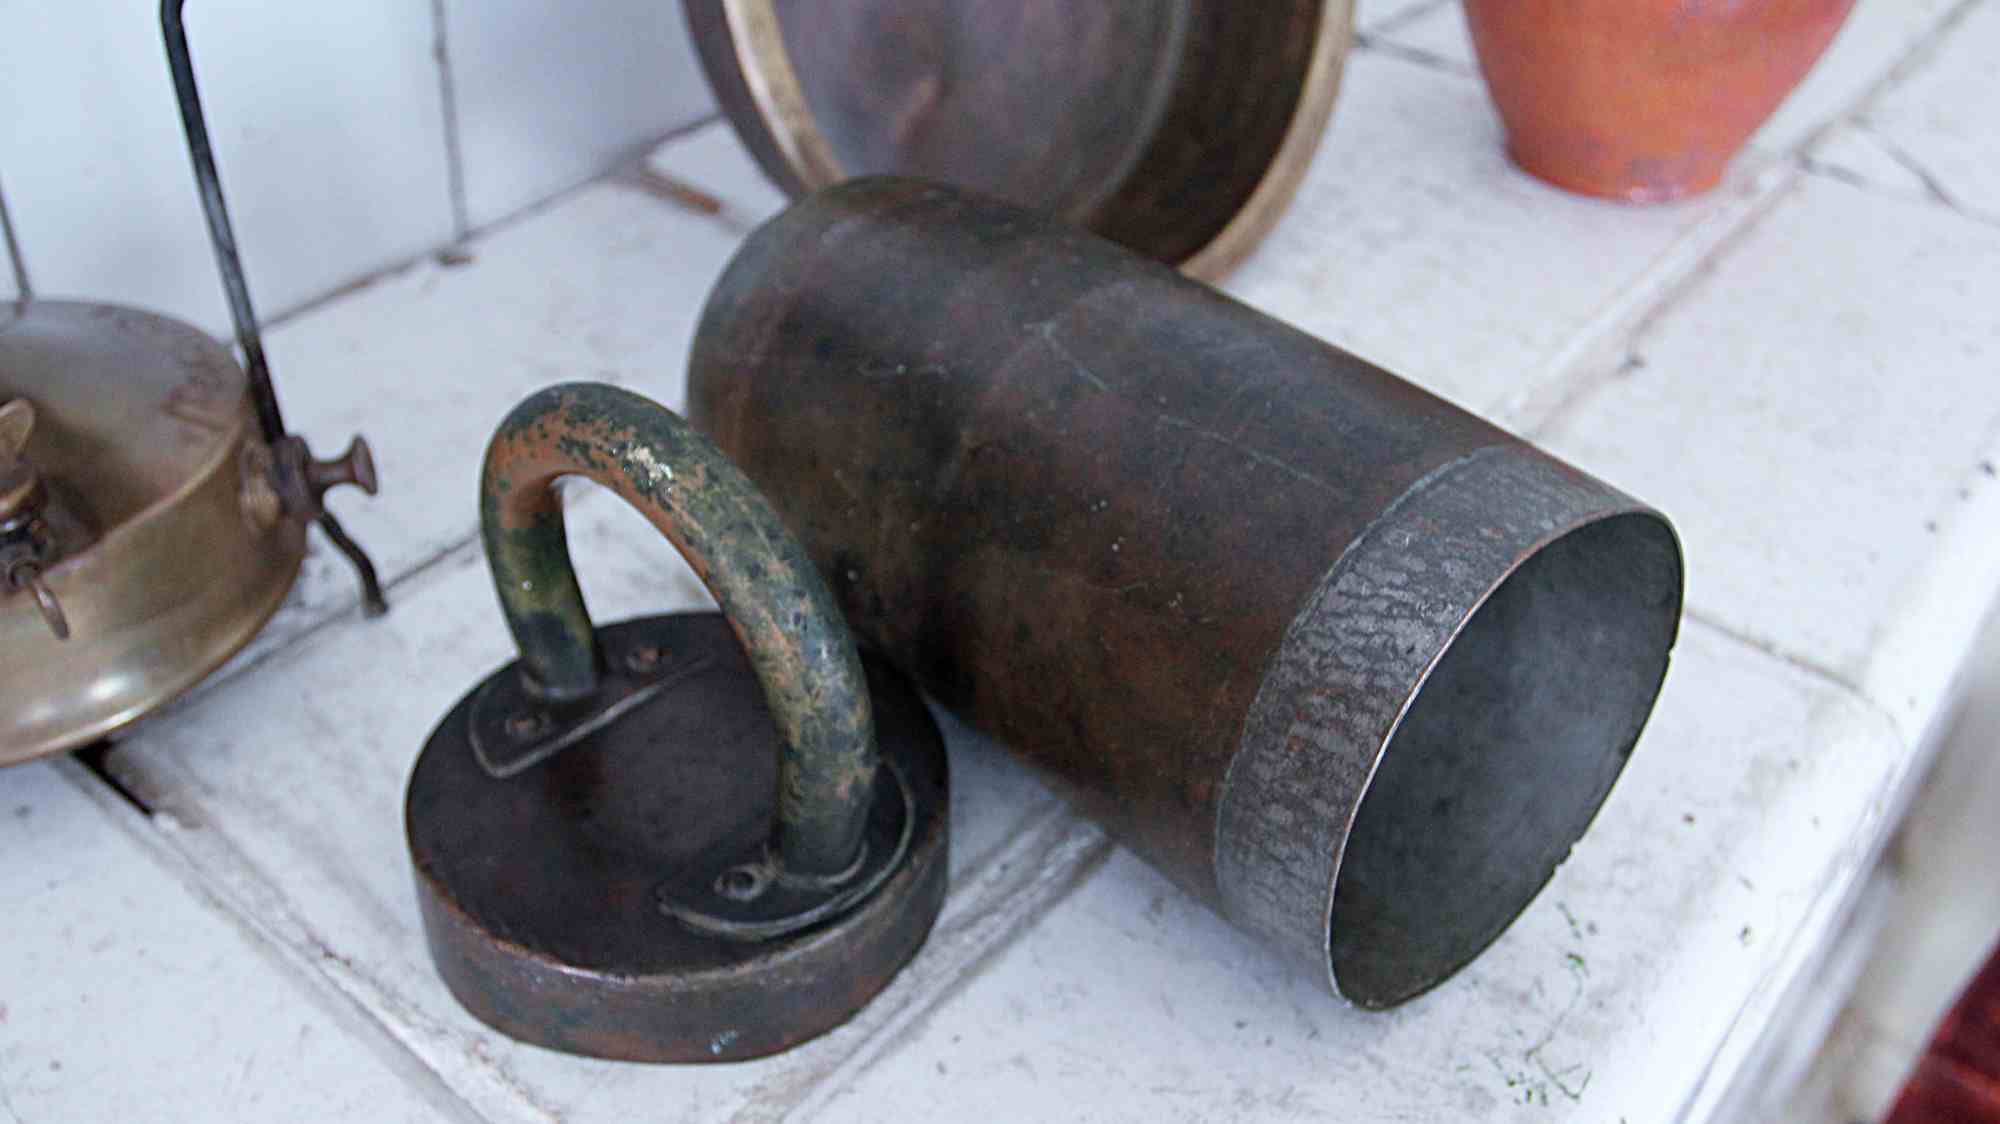
Эта штука с крышкой — это что?
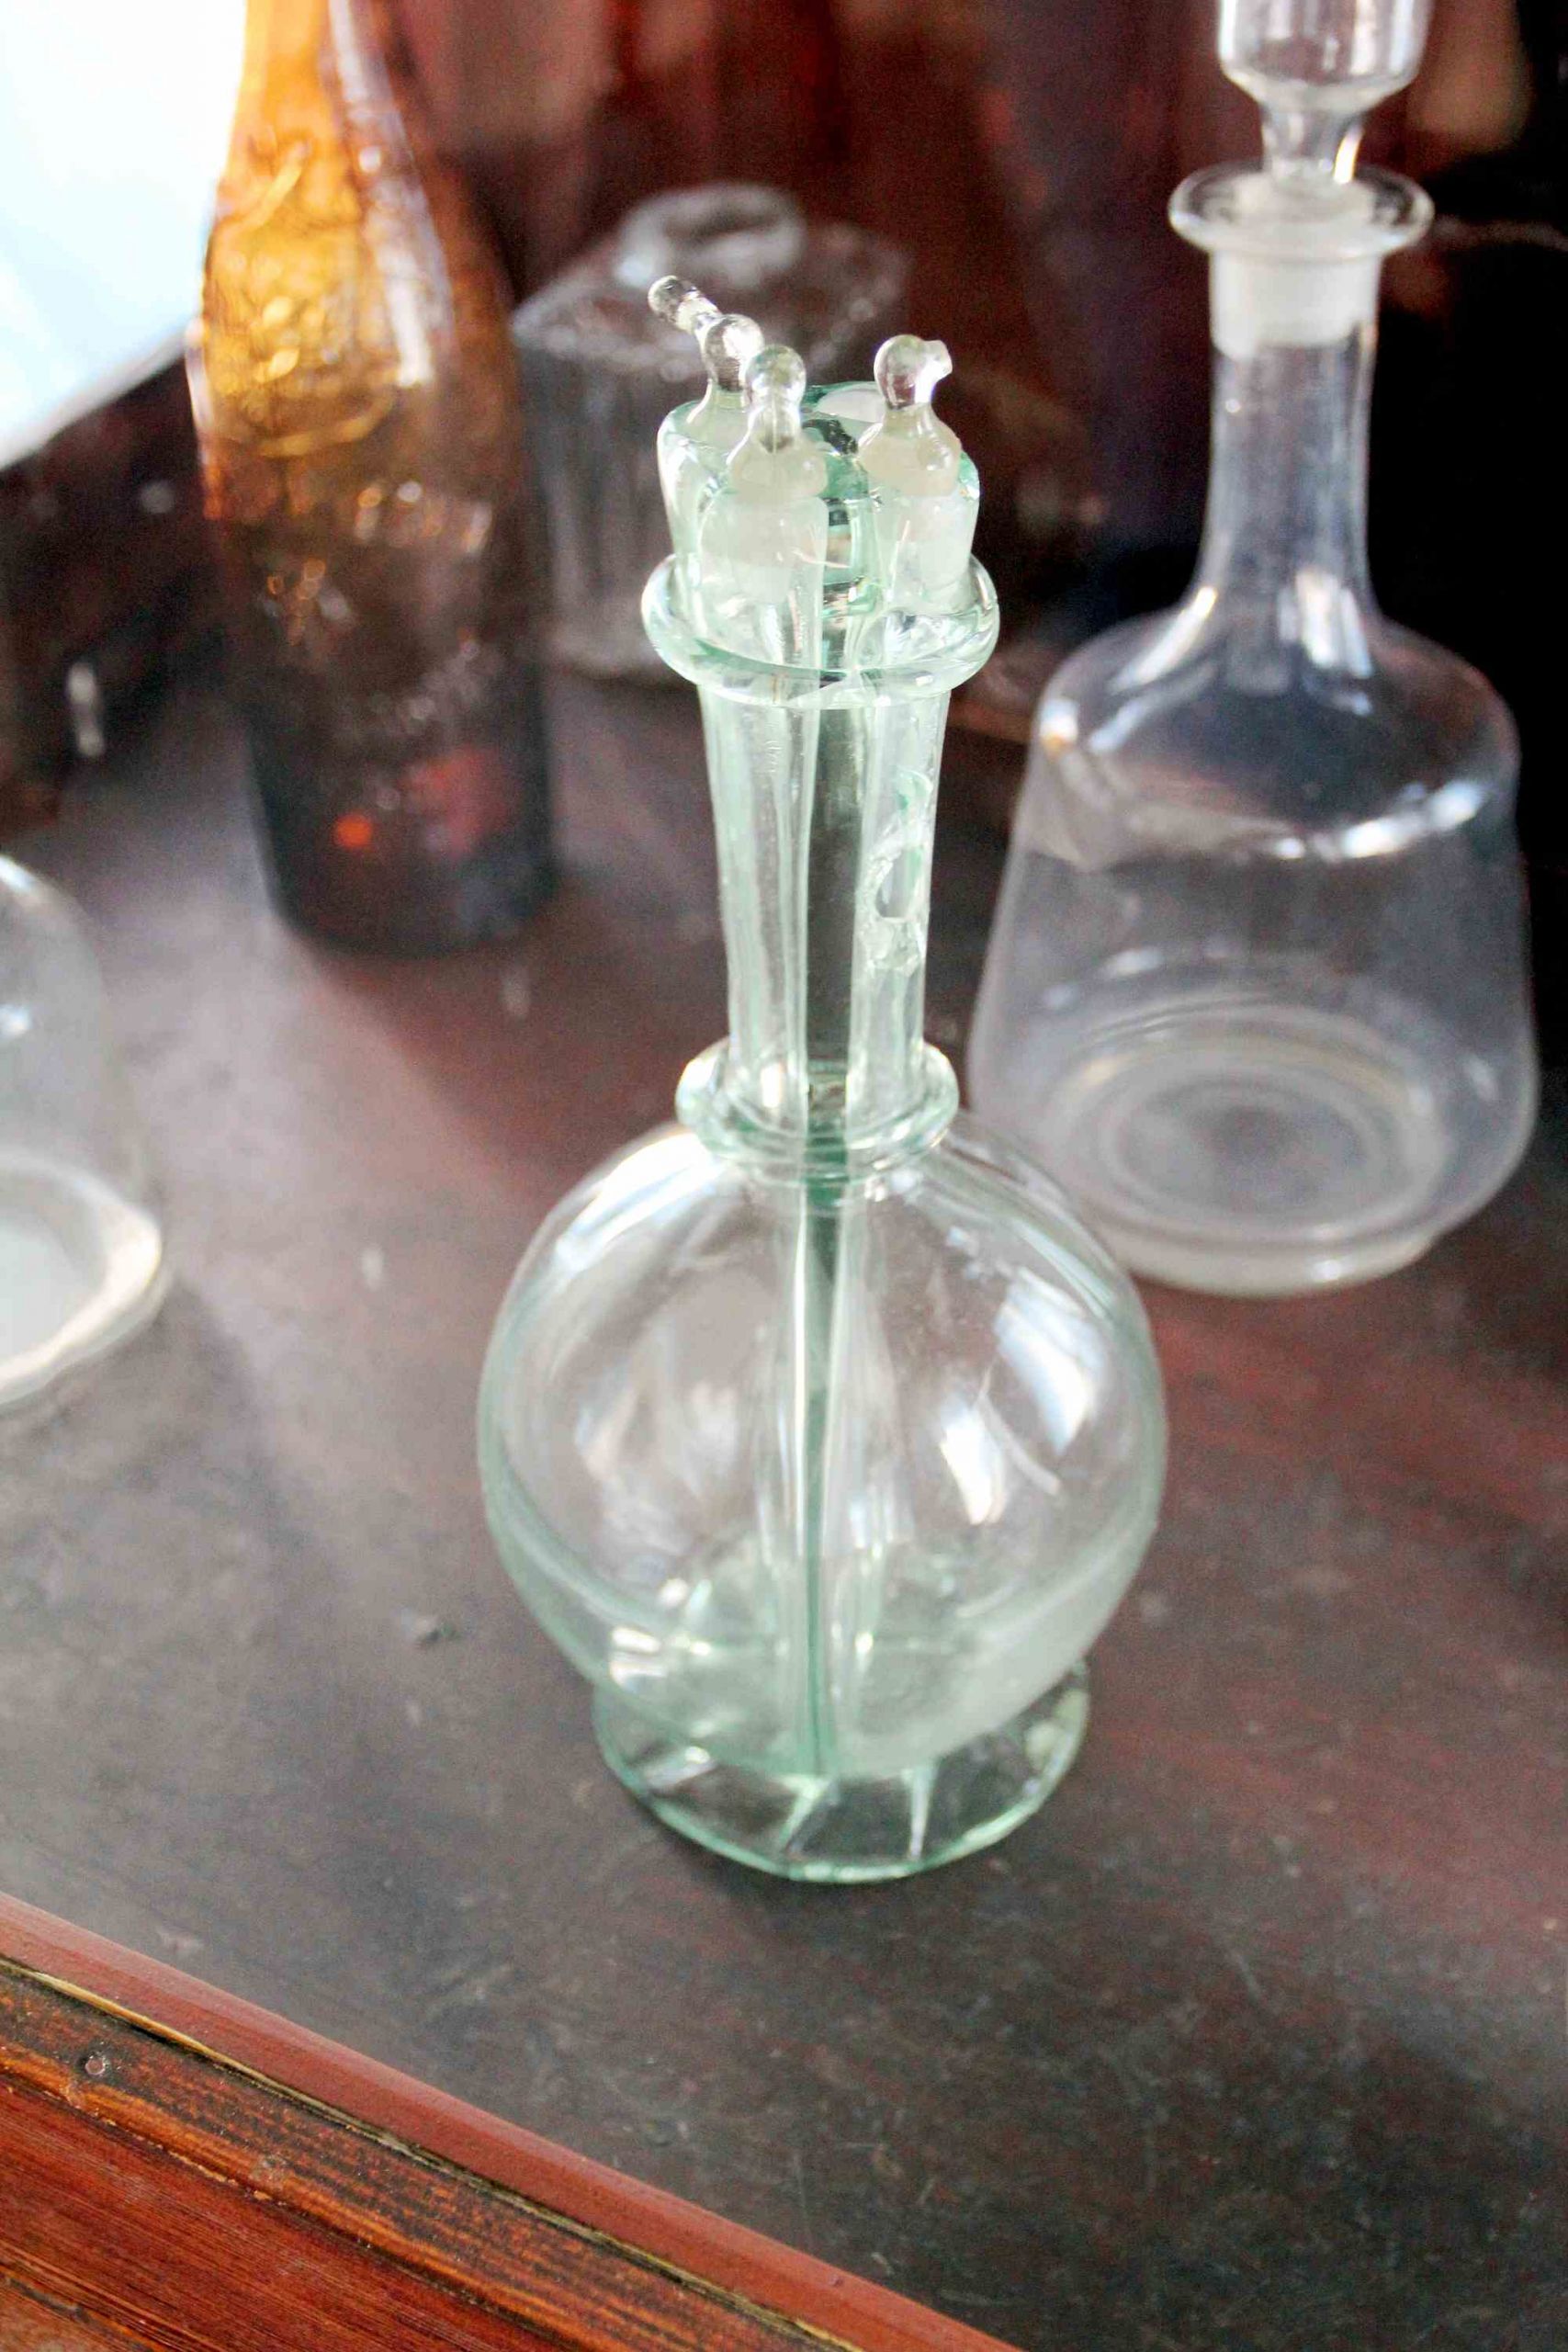
Странный графин на переднем плане, для чего он использовался? Почему он такой странный?
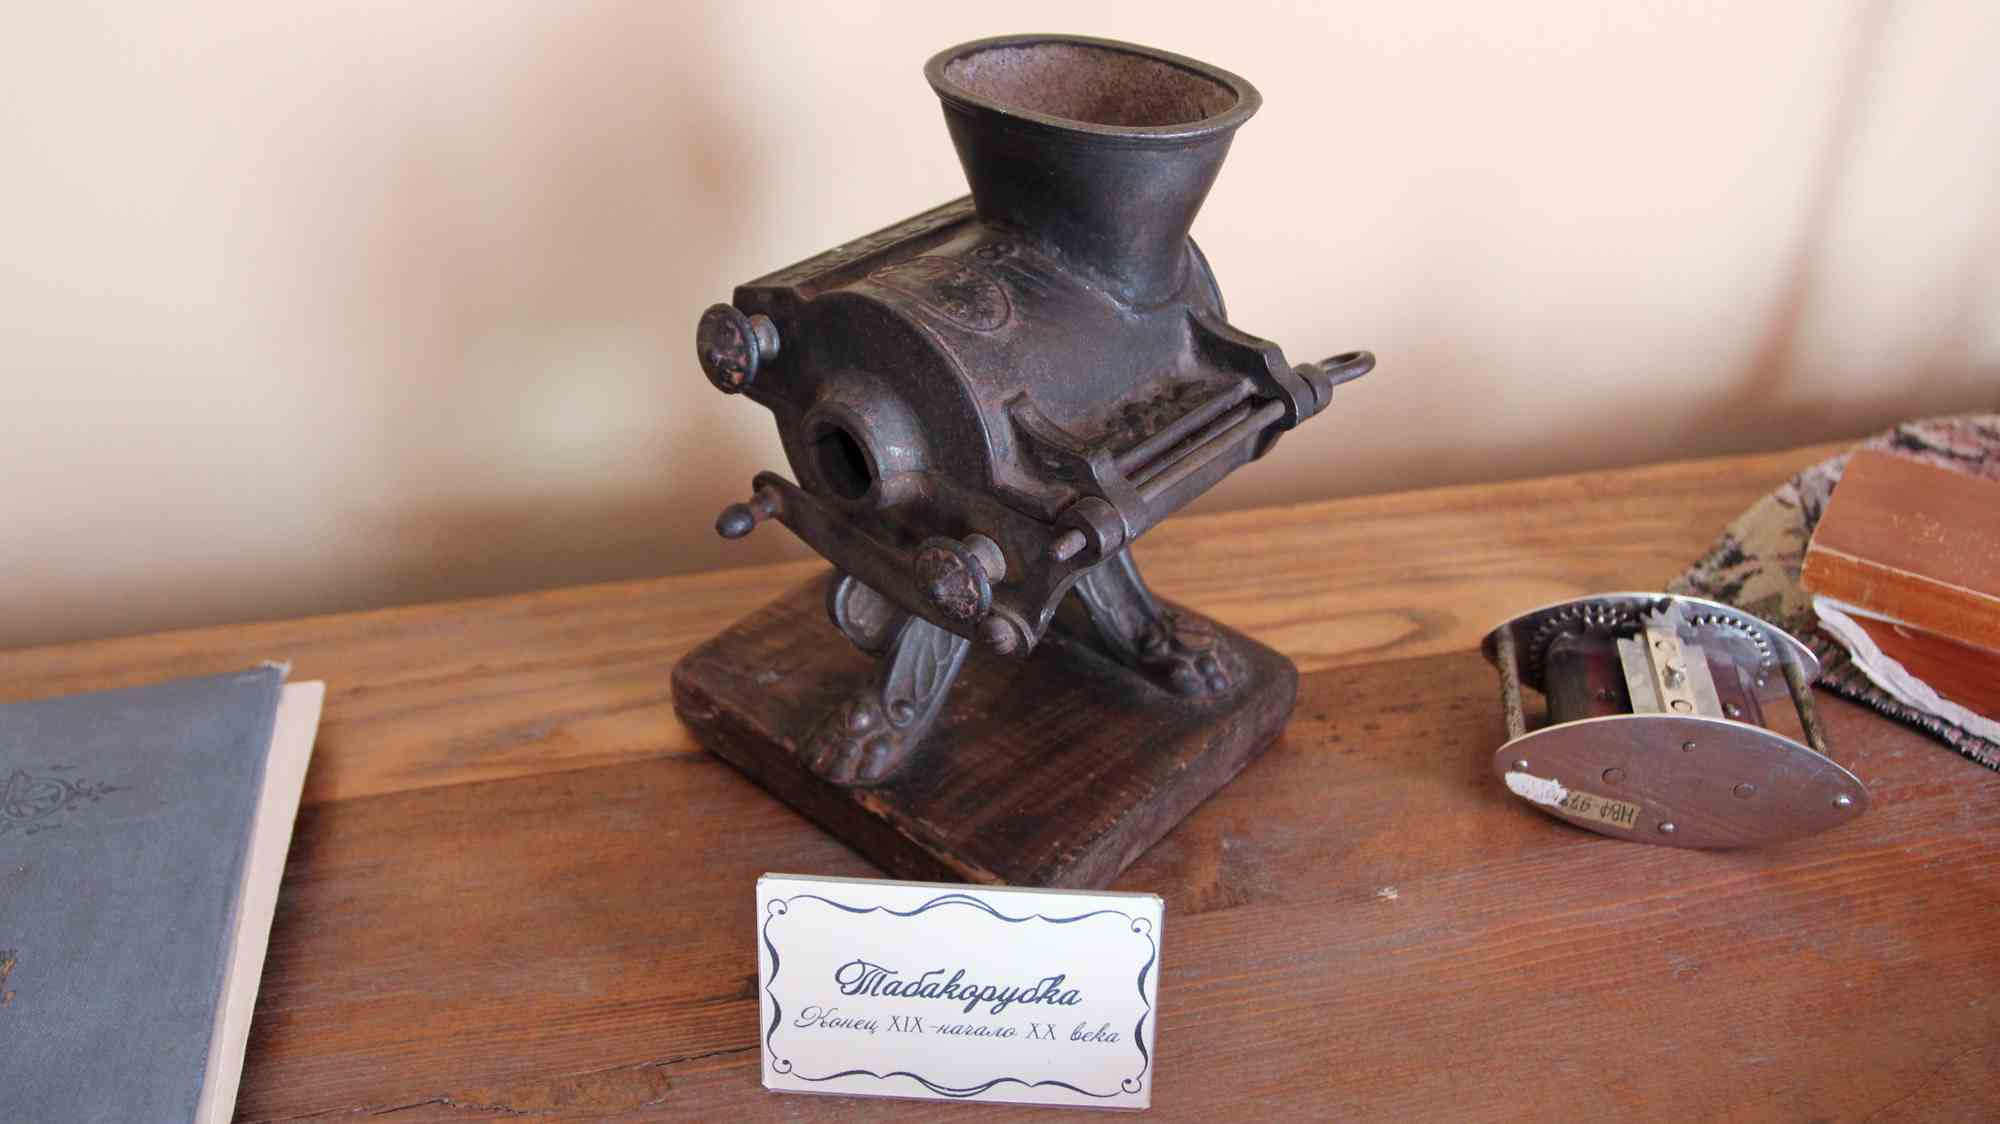
Справа от табакорубки находится металлический предмет. Что это?
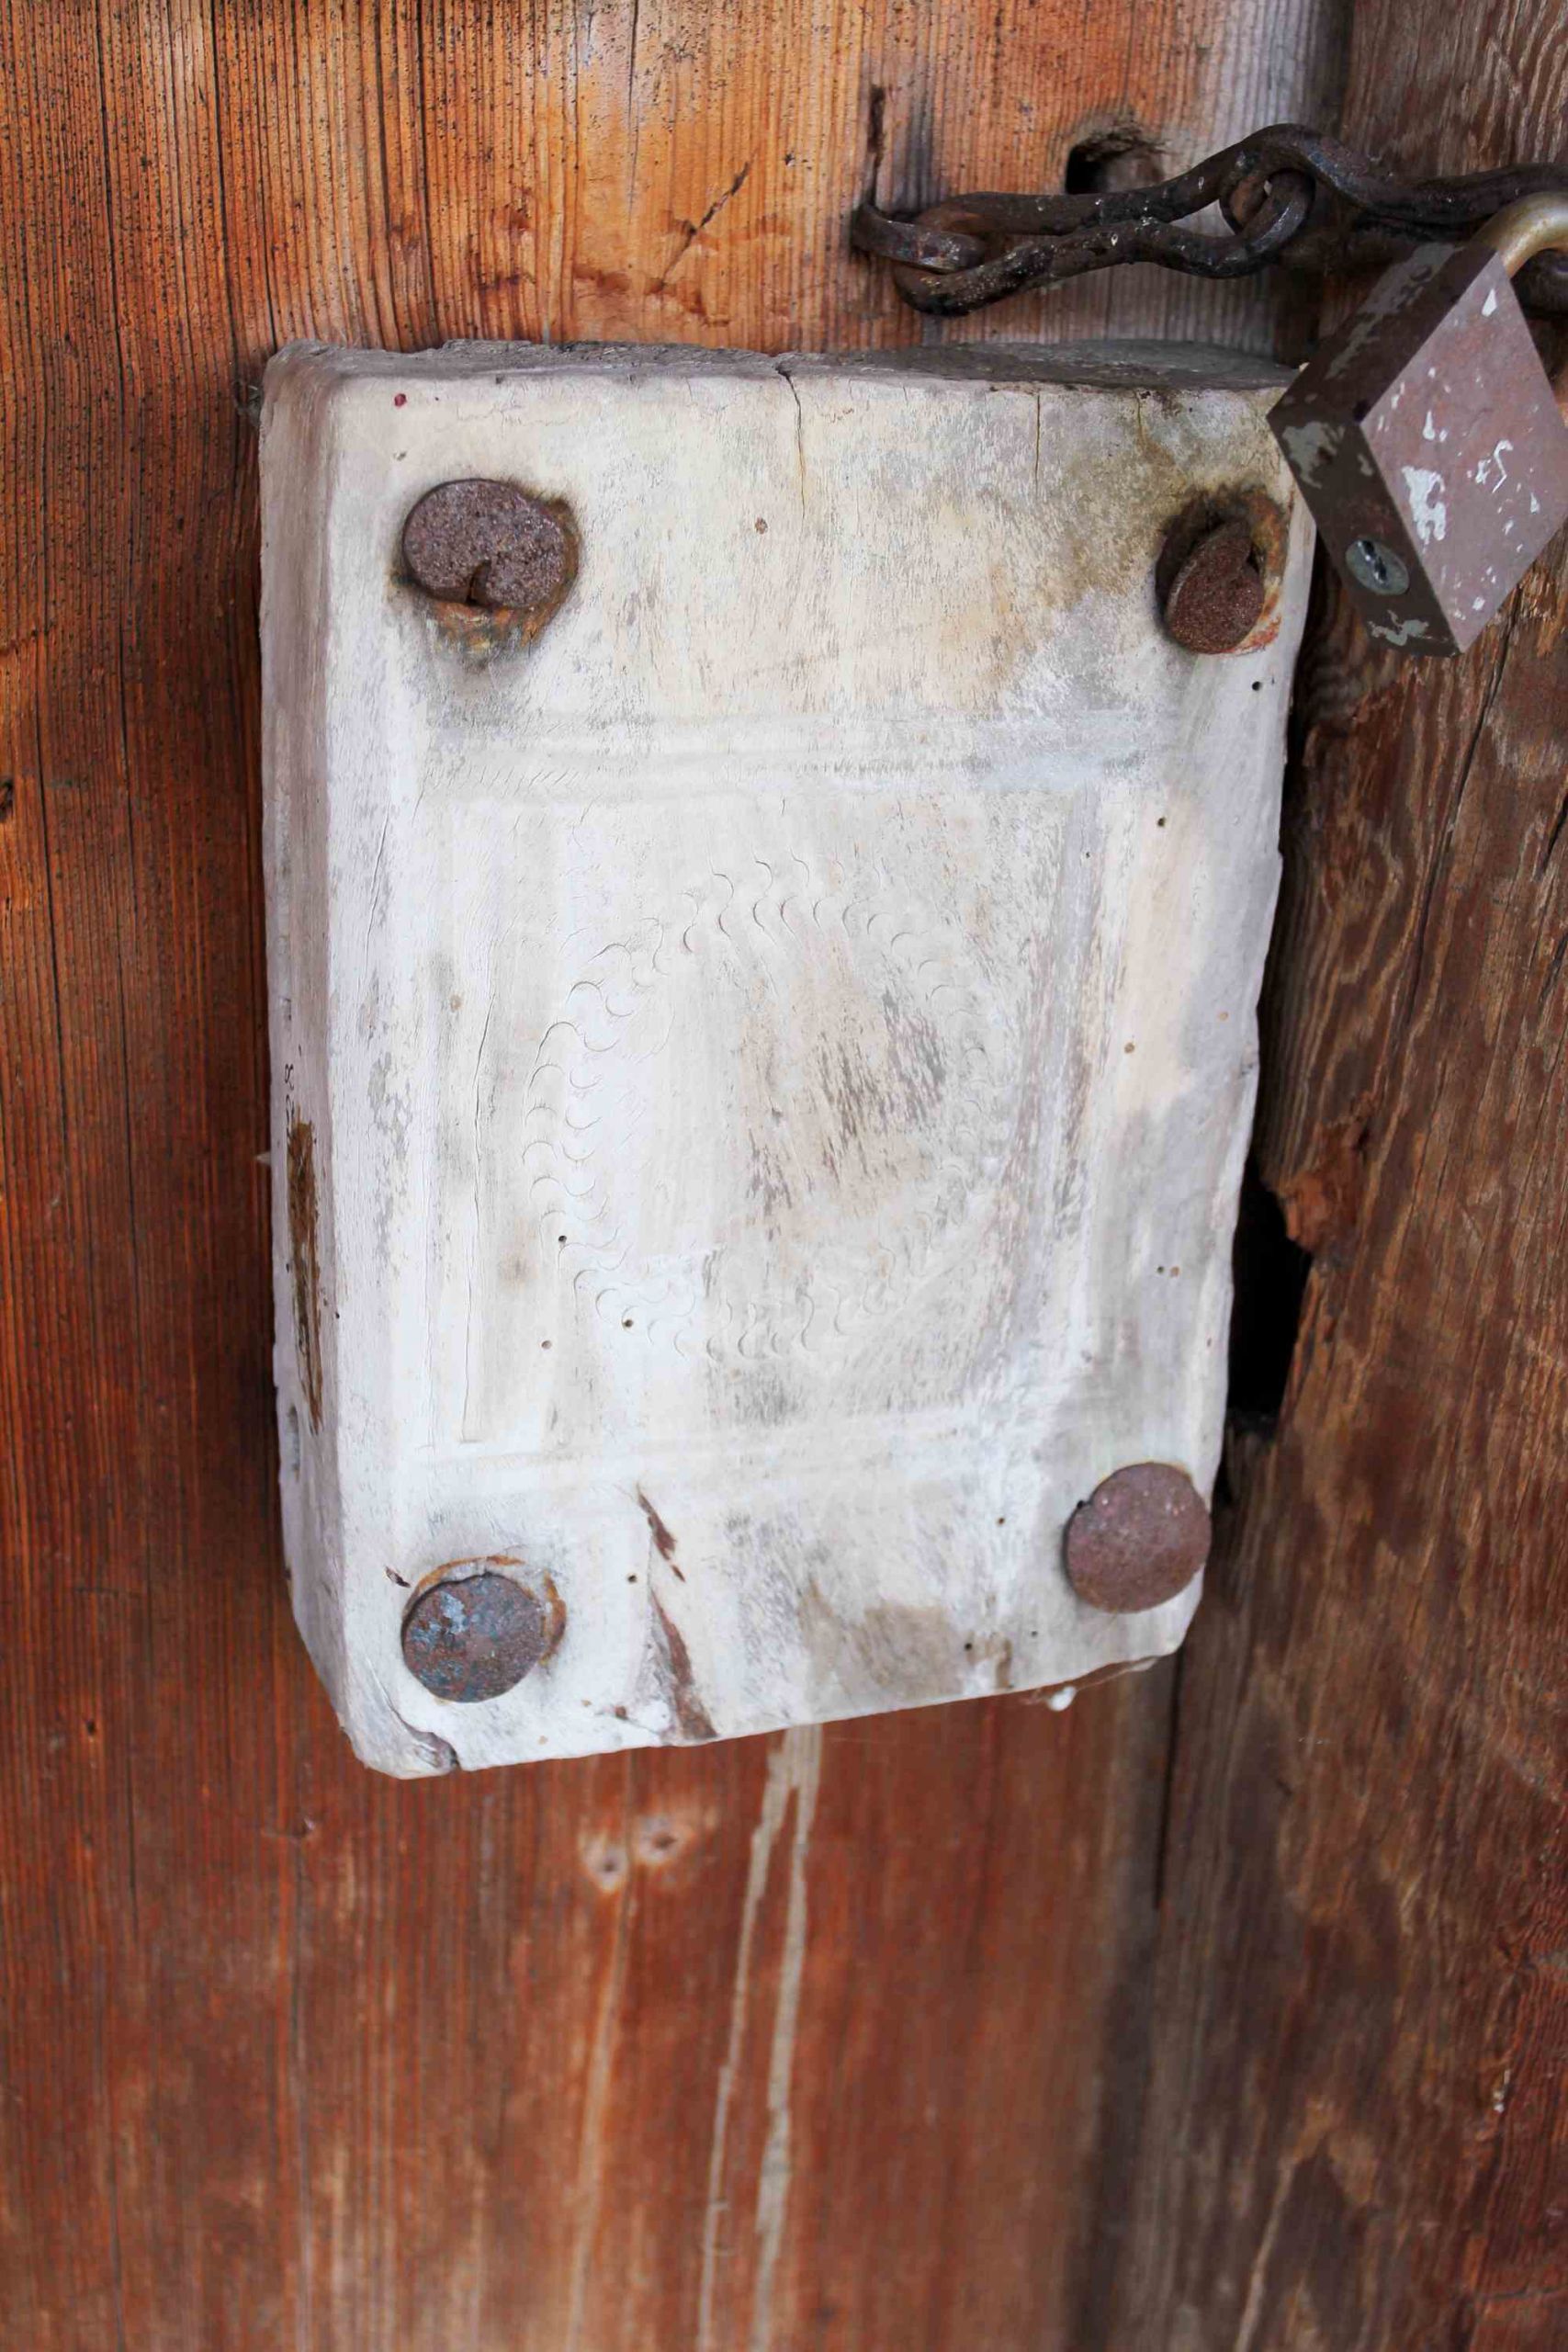
Прямоугольный деревянный предмет на двери — это что?
SVG с fallback на не векторные форматы
Нравятся мне такие вещи. Алексей Тен из Яндекса придумал очень изящный способ внедрения СВГ в код с возвратом к растровому формату, если браузер не поддерживает СВГ:
<svg width="96" height="96">
    <image xlink:href="svg.svg" src="svg.png" width="96" height="96"/>
</svg>
Принцип виден из кода, я думаю, но я всё же расшифрую. Если браузеры поддерживают внедрение СВГ в ХТМЛ, то почти весь выше приведённый код будет для них значимым: кроме атрибута «src», его у тега СВГешного image не бывает и он будет отброшен. Соответственно, картинка загрузится из файла svg.svg.
Если же браузер СВГ в таком виде не понимает, то будет отброшен тег svg и атрибут «xlink:href», а тег image будет преобразован в img — это старая особенность браузеров, которой я тщетно пытался придумать применение. В этом случае будет загружен svg.png.
Я уже на сайте в одном месте использую этот трюк.
Размытие шрифта на Ретине в Сафари
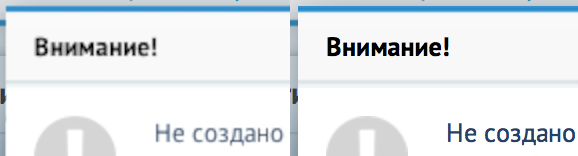
Как и ожидалось, Ретина ещё
Заменили на обычное свойство opacity, стало выглядеть, как на скриншоте справа.
Скачивалка документов из архивов ЭлАра (теперь можно указать страницы)
Программа для скачивания документов из архивов ЭлАра (инструкция есть у меня в блоге) неожиданно оказалась одной из самых популярных из того, что я делал.
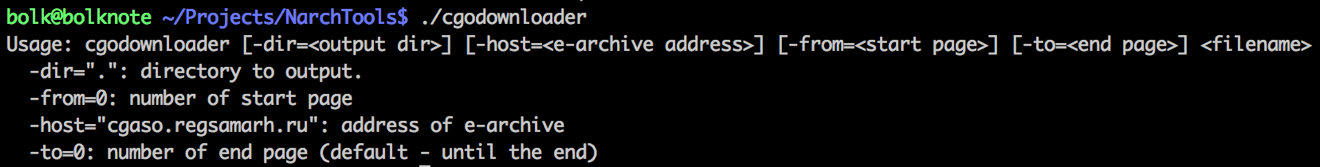
Мне постоянно пишут благодарственные письма, а иногда — свои пожелания. Самое частое — сделать указание диапазона страниц для скачивания. Сегодня я эту возможность добавил, программа лежит на том же месте.
Опять на «Баше»
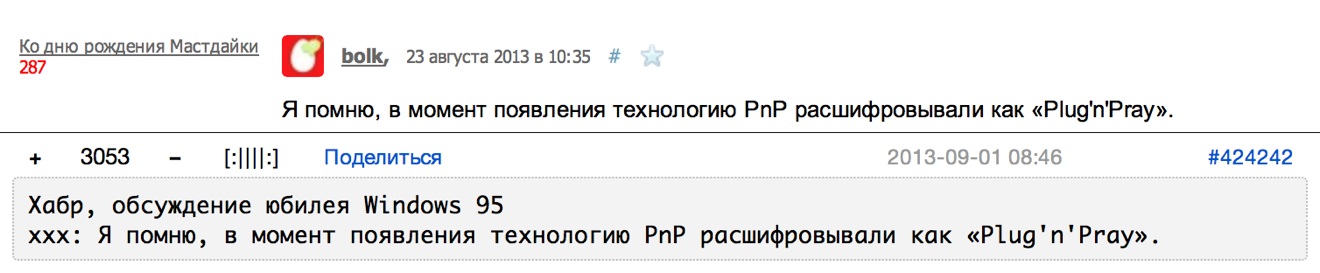
Давненько «Баш» не читал, оказалось опять туда попал и опять с «Хабра», правда на этот раз мой ник не указали, но это и правильно, наверное — я, по сути, просто повторил старую полузабытую шутку.
NOT BETWEEN в «Сфинксе»
Я на этой неделе важный проект сдаю, мы там поиск на «Сфинксе» используем. «Сфинкс» поддерживает специальный язык запросов — SphinxQL, отличная штука, очень похожая на SQL, только, к сожалению, очень урезанный.
Понадобилось сделать запрос, содержащий NOT BETWEEN, а как назло оказалось, что такую конструкцию «Сфинкс» пока (?) не поддерживает. На всех форумах плач и стенания, решения нет.
Зато наткнулся на функцию INTERVAL, которая умеет вычислять не попадает ли указанное в заданный интервал и выдавать, в зависимости от этого ноль или один. Прикинул, должно помочь и действительно, такой запрос вычисляется на ура:
SELECT document_id, INTERVAL(document_id, 1447, 23007) AS intr
FROM cardsmain, cardsdelta
WHERE intr=036
Формально у меня сегодня праздник — 36 лет, честно сказать настроения веселиться

Ну, подведу итоги, как это водится у меня каждый год. По сравнению с прошлым годом изменения следующие:
- написал шахматы на утилите sed (играете с компьютером), которые получили мировую известность (например, всплыли на Реддите)
- сделал подсветку кода на Брейнфака для библиотеки hightlight.js (и вообще поучаствовал в проекте —
кое-что почистил, дописал правила и т.п.) - уделил немало внимания одному из моих хобби — постполомничеству, посетил с десяток разрушающихся церквей Татарстана и даже одну настоящую ветрянную мельницу начала прошлого века
- в другом своём хобби — исследования своего дерева предков, на двух ветках достиг
12-го колена - увы, не принял приглашение в ирландский «Гугл»
- походил пару месяцев на йогу, вставая в пять утра
- судил Microsoft Image Cup 2013 в Казани
по-моему, отлично разыграл всех на первое апреля- переосмыслил старый трюк с поворотом картинок для экономии, придумал новую технику подчёркивания ссылок, способ узнать печатал ли
кто-то страницу на принтере, SVG-спрайты,
а так же практичный способ подменять картинки для «Ретины» - увлёкся самодельным «умным домом»
- первый раз в жизни выбрал и купил машину для нашей семьи (при живейшем участии жены, естественно)
- придумал как совмещать JS и Брейнфак в одном коде
- ознакомился с Си# на уровне «читаю без словаря, пишу со словарём» и переписал на нём свой MacGreener, изучил шаблонизатор Twig и SphinxQL
- съездил в Тольятти, Ижевск, Волгоград, Козьмодемьянск,
Йошкар-Олу , два раза в Ульяновск и повторно в Самару, летал в ОАЭ (эмират Фуджейра, был в Дубай иАбу-Даби ) и Грузию (был в Тбилиси, Цинандали, Греми, Сигнахи, Го́ри, в Алазанской долине)
- прочитал 29 книг (фу как мало,
когда-то читал более 80) - вступил в Татарстанское республиканское отделение Всероссийского общества охраны памятников истории и культуры (ТРО ВООПИиК)
- программировал разные мелочи: «теннис» на CSS, лабиринт на заднем фоне, разворот односвязного списка за O(n) на Гоу, на нём же реализовал алгоритм линейного счётчика,
баловался рисованием картинок цветными символами Юникода, придумал головоломку для верстальщиков
(отгадку тоже описал), придумал библиотеку для программирования вООП-стиле на «Баше», основываясь на баге «Вебкитов» написал «магический экран» на чистом ЦСС, Юникодные часы, популярную утилиту для скачивания документов с АИС ЦГАСО, скрипт, проверяющий какие графические форматы поддерживает ваш браузер, Siege с патчами, запрограммировал несколько способов отключения «Мака»: если уходим от него со смартфоном, поднимаем со стола (MacGreener), машем перед ним руками, доработал «Яндекс.Фотки» до «Ретины» и несколько раз попал на «Башорг»
Не так уж, вроде, и мало что сделал за год.
Финский паспорт
Это, ребята, финский паспорт. Кайф!
Как два пальца
2 рубля уже считались какими—никакими деньгами. Например, когда голосовали на дороге, чтобы редкие автомобилисты подвезли (такси было маловато), то голосовали либо двумя пальцами, либо тремя. 2 рубля или 3 рубля. Если 2 рубля, то можно было простоять так долго, какой—нибудь дедок на запорожце без ушей может остановится. За три рубля желающих находилось уже много, практически останавливались сразу. Кстати, эта традиция сохранилась до сих пор. Обратите внимание, что многие голосуют на маршрутку именно двумя пальцами.
— цитата из воспоминаний советских времён,
PHPFuck
JSFuck у нас уже был (это намёк на язык Брейнфак, а не ругательство), почему бы не изобрести PHPFuck?
Часа полтора потратил на скрипт, который выводит слово «Hello!»:
<?
$__=$_[$_[]++].=$_;$_[!_]+=++$_[!_];@$$_=($_[$$_][$_]&$_[$$_][$_[!_]]).$_[$$_][$_];
$_[]=&$$_;@$$_.=$_[!!_][$__]^$__[$_[!_]]|$__[!_];$___=$__[!_]|_&~$__[!!_];
@$$_.=++$___.($__[$_]^_^$__[$_[!_]]).($_[!!_][!$_]^$_[_==_][$_[!_]>>!!_]^_);
$___&=$__[$_[!_]];$___.=${$_}[!_]^${$_}[$_[!_]]|$__[!_].($$$_=$__[!_]^_^$__[!!_]).
$$$_.($_[_]=$__[$_[!_]]^_^${$_}[$_[!_]>>!!_]);$$_($___.
(~${$_}[~-$_[!_]]&$___[$_[!_]]).($_[_]&~$___[!!_]));
Это настоящий код на PHP, он работает и выполняет заявленное. За вдохновение спасибо неизвестному автору бэкдора, как только я увидел код, понял, что так написать можно что угодно.
Что вкратце происходит у меня. Я создаю массив, привожу его к строке, получается слово «Array» (это такая особенность PHP, если кто не знает), потом при помощи бинарных операций над буквами (с буквами можно использовать «~», «&», «|», «^», а так же операцию инкремента, получая другие буквы), собираю из этого слова слово «printf» (точнее «prINTf», функции в PHP регистронезависимые), которое в дальнейшем будет использовано в качестве имени функции. Потом из двух слов — «Array», «prINTf» и знака подчёркивания теми же бинарными преобразованиями получаю «Hello!» с переводом строки.
Например, буква «N» получается операцией «A» | «_» | ~«r» с последующим инкрементом результата, а «l» (латинская «эл») — «A» ^ «r» ^ «_». Подчёркивание можно использовать без кавычек — все незакавыченные идентификаторы PHP рассматривает как строки.
В конце просто вызываю функцию, передавая ей полученную строку.
Загадки «Сфинкса»
Сейчас много текста будет, напрягитесь.
«Сфинкс» — это довольно известный поисковый движок, разработанный Андреем Аксёновым. Время от времени мне приходилось использовать его в своих проектах и каждый раз качеством получившегося решения я был доволен, тем более, что за проходившее время он обрастал новыми интересными возможностями.
В первый раз сталкиваюсь с проектом, где использование «Сфинкса» возможно только с некоторым количеством костылей, которыми решение обрастает и меня всё меньше устраивает получившееся. Хочу описать проблемы, с которыми я столкнулся, возможно
«Сфинкс» хорош поиском по одной сущности, это, пожалуй всё. Богатство, описанное документации может создать обманчивое ощущение, что он может больше, но это не так. Моей ошибкой было решение использовать его в поиске по связанным сущностям. Это то, что «Сфинкс» умеет плохо. И хотя то, что получилось работает по скорости выше предыдущего решение, прокручивая в голове исходный код, я пла́чу мысленными кровавами слезами.
Так получилось, что искать мне нужно по наборам сущностей, связанных между собой. Получилось аж пять индексов. Объём данных не даёт надежды упихать всё в плоскую структуру — избыточность ужасает. Например, есть документы (Д) и резолюции к ним (Р), отношение один ко многим. Если попробовать положить эту структуру в одну таблицу, избыточность будет на уровне Д×Рср (Рср — резолюций на документ в среднем). Причём «Д» на уровне миллионов. И это только две сущности. Немаловажно, что «Д» и «Р» — сущности с целой кучей полей, в том числе полнотекстовых.
Выход есть. В поиске мы смотрим по каким сущностям надо искать, ищем по первой, берём оттуда найденные идентификаторы, подставляем во второй поисковый запрос вместе с критериями и так далее. Это костыль номер раз. Форма поиска устроена таким образом, что использование любого фильтра, как правило, ограничивает количество данных в выборке очень сильно, и всё равно это тысячи айдишников.
Второй костыль нужен, чтобы обойти принципиальное ограничение «Сфинкса» — у него есть параметр (указывается в конфиге), ограничивающий максимальное количество возвращаемых данных. Причём в миллионы (наш объём) его поставить нельзя — максимум в десятки тысяч, не рассчитан «Сфинкс» на большее, да и памяти не напасёшься. Всё бы ничего, но когда мы ищем пересечения сущностей (Д×Р), то, что нам вернул «Сфинкс» со своим лимитом, может и не иметь пересечений — они могут быть за горизонтом выдаваемых данных.
Костыль номер два я походя описывал — если мы обнаруживаем, что айдишники вернулись не все, то делаются ещё запросы, которые я назвал «докачивающими», делается тот же самый поисковый запрос, за исключением айдишников, которые уже попали. Работает, естественно, только с данными отсортироваными по ID.
Как только появились «докачивающие» запросы, то минус один выходной ушёл у меня на костыль номер три — я сделал сбор статистики запросов и оптимизацию порядка выполнения запросов. Вот как всё работает.
У нас, как я уже сказал, может быть от одного до пяти задействованных индексов, в зависимости от того что пользователь в форму введёт. В запрос к каждому следующему передаются идентификаторы из предыдущего. Как только один из запросов вернул пустоту, дальше можно не продолжать — пересечение с пустотой даёт пустоту.
Теперь следите за мыслью. Не знаю очевидно или нет, но логически всё равно в каком порядке будут опрашиваться индексы — результат будет тот же. Например, Р ∩ Д = Д ∩ Р. Зато если впереди поставить запросы, которые вернут меньше айдишников, следующим будет полегче. Скажем, на запрос пользователя у нас вернулось 80 тысяч документов и пять тысяч резолюций. Расточительнее сделать запрос к документам первым и подставить потом 80 тысяч айдишников во второй запрос, чем выбрать сначала пять тысяч резолюций, а потом передать их в запрос к документам.
Но как узнать какой запрос надо выполнить первым? Поможет сбор статистики.
Я рассуждал так. Поскольку у нас в поисковой форме все атрибуты запрашиваются с критерием «И» (например: год=2011 И организация=5), то чем больше разнообразных критериев запрошено, тем меньше объём выборки, значит надо как минимум запомнить какие атрибуты интересовали пользователя, тем более, что они
В итоге при каждом поиске пользователя я кладу его запрос в специальный стек, плюс указываю какие атрибуты в каком количестве он запрашивал. Эта информация может выглядеть
В офлайне (ночью, например) срабатывает скрипт, который запускает полученный запрос и смотрит сколько данных получается, если этот запрос выполнится первым (без переданных айдишников). Из информации об атрибутах делается хеш и к нему приписывается полученный результат, учитываются предыдущие результаты по тому же хешу и в другую таблицу записывается пара хеш и средняя оценка значений возвращаемых запросом такого рода.
В дальнейшем, когда пользователь будет искать, мой код смотрит в эту статистику, оценивает характер запроса по описанном алгоритму и сортирует запросы к индексу так, чтобы первыми стояли индексы, которые вероятно дадут меньше результатов.
Массовых испытаний ещё не было, но в тех частных случаях, которые я рассмотрел, ускорение бывает до двух раз (чаще всего, конечно, прирост не столь значителен или его нет). Больше всего выигрыш получается, если удаётся избавиться от «докачивающих» запросов.
Задача была интересной, а вот костыли не радуют. Либо надо научиться с ними жить, либо думать о переходе
Кара «Сфинкса»
У меня в комментариях к предыдущему посту появился Аксёнов и утверждает, что я не разгадал три загадки «Сфинкса» и буду убит (по нынешним временам это интеллектуальный юмор, будьте осторожны!). Не пропустите.
Если отбросить шутки в сторону, Андрей, спасибо, ты разъяснил некоторые туманные моменты (правда, вопросы ещё остались, ответь на них, если не сложно) и подтолкнул к новым исследованиям.
-khtml-border-radius
На «Хабре» постоянно всплывает тема того, что, якобы, никогда не существовало свойства «-
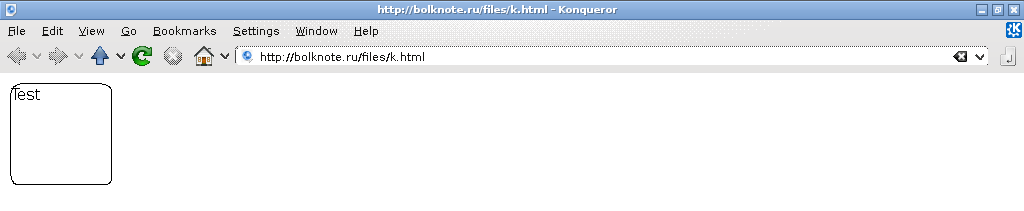
Вот на скриншоте вверху версия 4.4 отображает свойство -
max_matches, cutoff и limit в «Сфинксе»
Вчера температурил, хотя хотелось спать (всю неделю не высыпался), не мог уснуть — голова болела. Поэтому до 11 вечера общался по скайпу Андреем Аксёновым, автором «Сфинкса», хотелось выяснить некоторые туманные для себя вещи.
Например, в SphinxQL есть три способа ограничить количество выдаваемых результатов — limit, max_matches и cutoff. Разница между первыми двумя мне быстро стала очевидной после чтения документации, а что такое cutoff я не понимал. В доке написано следующее:
«cutoff» — integer (max found matches threshold)
В общем, я узнал, давайте расскажу.
Рассмотрим вот такой запрос, что здесь значит каждая цифра?
SELECT * FROM documents
WHERE orgid IN (5,10,222)
ORDER BY timestamp DESC
LIMIT 500, 1000
OPTION max_matches=2000, cutoff=5000
«Сфинкс» хранит результат запроса в памяти. Чтобы однажды не сожрать всю память, есть параметр max_matches, он определяет размер буфера, куда будут складываться результаты.
Если убрать в нашем запросе параметр cutoff, «Сфикс» пройдётся по индексу «documents», складывая выбранное в соответствии с критерием, в буфер размером в 2000 строк (на самом деле, насколько я понял, буфер хранит не сами строки, а их идентификаторы), располагая данные в порядке сортировки (priority queue).
После того как весь индекс был просмотрен, мы выдаём 1000 строк из буфера, начиная с пятисотой позиции (LIMIT 500,1000).
Теперь вернём cutoff. Этот параметр означает, что мы остановимся не после того как просмотрим весь индекс, а как только будут просмотрены 5000 строк, совпавшие с критерием. Это, очевидно, инструмент тонкой настройки, который позволяет принести в жертву производительности полноту поиска.
Как правильно поглощать Бизнес-линч

Кажется, очень мало немного знакомых использует рубрику «
Над каждой картинкой есть переключалка между оригиналом и версией с комментариями, большинство сразу включают комментарии. Напрасно. Правильный способ — рассмотрев оригинал, вдумчиво проанализировать что в нём хорошо и что плохо и только после этого сравниться с тем, что написали лебедевцы.
За годы пользования этой техникой, мои показатели сильно улучшились, я стал понимать что хорошего или плохого находят комментаторы в присылаемом
Сразу скажу, я не считаю лебедевцев непогрешимыми, но, к счастью, избавлен от болезни многих «учитель ни в чём не ошибается или он не учитель». Учителя ошибаются и есть целые области и материки знаний где они профаны. Как бы то ни было, у Студии Лебедева однозначно есть чему учиться, тем более мне — я дизайном занимаюсь весьма однобоко.
Ещё немного про «неглупый дом»
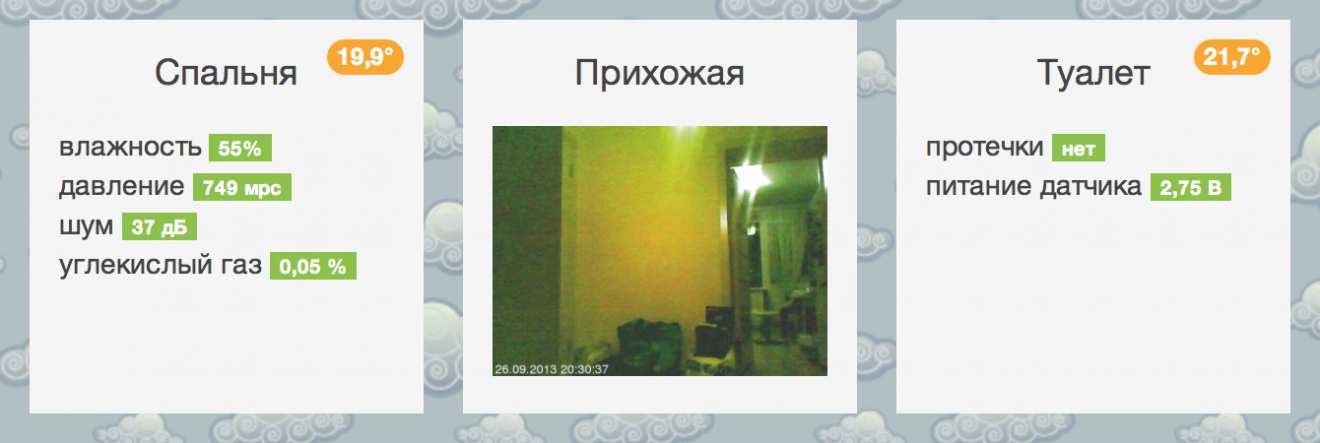
Жена попросила добавить время на обновляющиеся фото прихожей нашего доморощенного «умного дома». Мне не жалко, я дописал.
Заодно устранил переодическое зависание команды получающий фото с камеры и добавил обновление скриншота каждый 15 секунд (теперь программа делает три фото каждый свой запуск из крона):
#!/bin/bash

TEMP=$(/bin/tempfile) || exit
trap "/bin/rm -f -- $TEMP" exit

for i in {0..2}; do
    # убиваем зависшие процессы
    /usr/bin/killall streamer 2>&-

    # снимаем скриншот
    /usr/bin/streamer -j 85 -o "$TEMP" -f jpeg -s 640x480 2>&- || exit

    # повышаем ему яркость
    /usr/bin/mogrify -modulate 300,100 "$TEMP"

    # печатаем дату
    TIME=$(/bin/date +'%d.%m.%Y %H:%M:%S')
    /usr/bin/mogrify -pointsize 24 -fill white -gravity SouthWest -draw 'text 5,5 "'"$TIME"'"' "$TEMP"

    # льём на сервер
    /usr/bin/curl -F p=@"$TEMP" http://example.org/api/pict.php >&- 2>&-

    # спим 15 секунд
    sleep 15
done
Вот как стало выглядеть (это небольшой кусочек, всего там пока шесть квадратов, поскольку я лимит расходов исчерпал ещё в прошлом месяце, нового ничего не заказывал):
Вообще, у меня в ближайших планах было присоединить к этой системе видеоглазок (я уже пару месяцев использую «Falcon Eye
План у меня был такой — купить карту СД
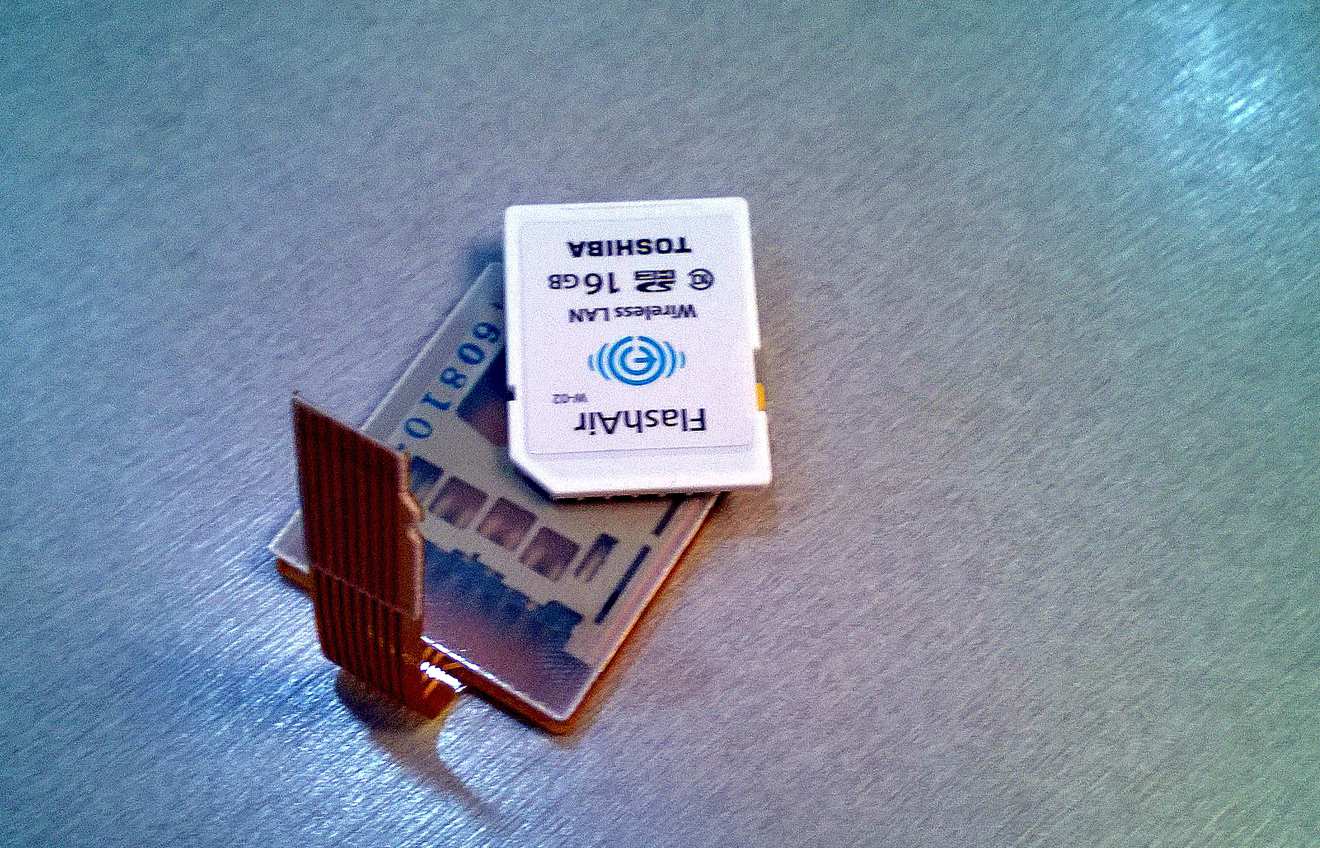
Но переходник, как видно на фото, оказался монструозных размеров, в корпус видеоглазка не помещается. Сейчас надежда — попробовать напаять шлейф переходника прямо на карту, в таком виде всё может поместиться, но нужен умелец с нормальной паяльной станцией, чтобы не перегреть и не спалить карту.
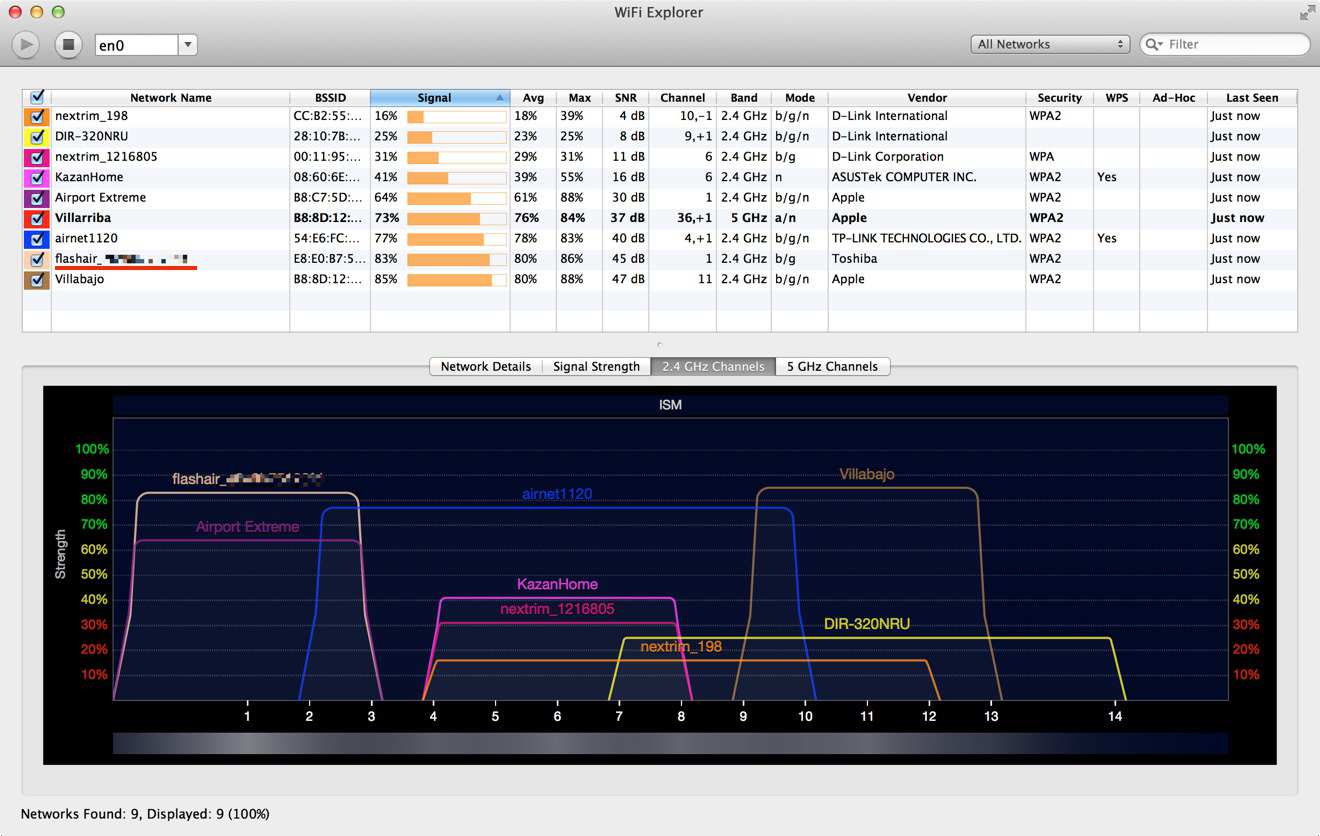
Cпециально проверил, тянет ли видеоглазок карту памяти, стоит подключить — сразу становится видно новую
Перспектива
Антрополог Колин Тёрнбулл (Turnbull, 1961) однажды оказался (…) в такой ситуации. Он путешествовал по Африке, изучая народ мабхути, обитающий в лесах Итури на склонах гор Рувензори.
Эти люди всю свою жизнь проводят в густом тропическом лесу. В качестве проводника и переводчика с Тёрнбуллом ездил
ЗЗ-летний молодой человек по имени Кенге, который помогал ему общаться с разными племенами. Однажды оба они заехали дальше, чем обычно, на земли, расчищенные от леса некой миссионерской группой.В этой поездке Кенге увидел много такого, о чем прежде даже не подозревал. Особый интерес у него вызвали странные размытые очертания вдалеке. Что это? Облака? Тёрнбулл объяснил, что это горы, куда они, собственно, и направляются. Затем вдалеке, на расстоянии нескольких миль, появились буйволы.
Кенге спросил, что это за букашки, — ведь они казались такими крошечными! Тёрнбулл объяснил, что на самом деле это буйволы, которые размерами вдвое превосходят знакомых Кенге животных. Кенге недоверчиво рассмеялся и попросил не рассказывать ему «таких глупых историй».
Тёрнбулл продолжал настаивать. Тогда его спутник начал разговаривать сам с собой, «за отсутствием более разумного собеседника». Однако, когда они подъехали к буйволам поближе, видимый размер животных волшебным образом увеличился, и Кенге откровенно испугался.
— из книги «Псевдонаука и паранормальные явления. Критический взгляд» Джонатана Смита.
Дажевино
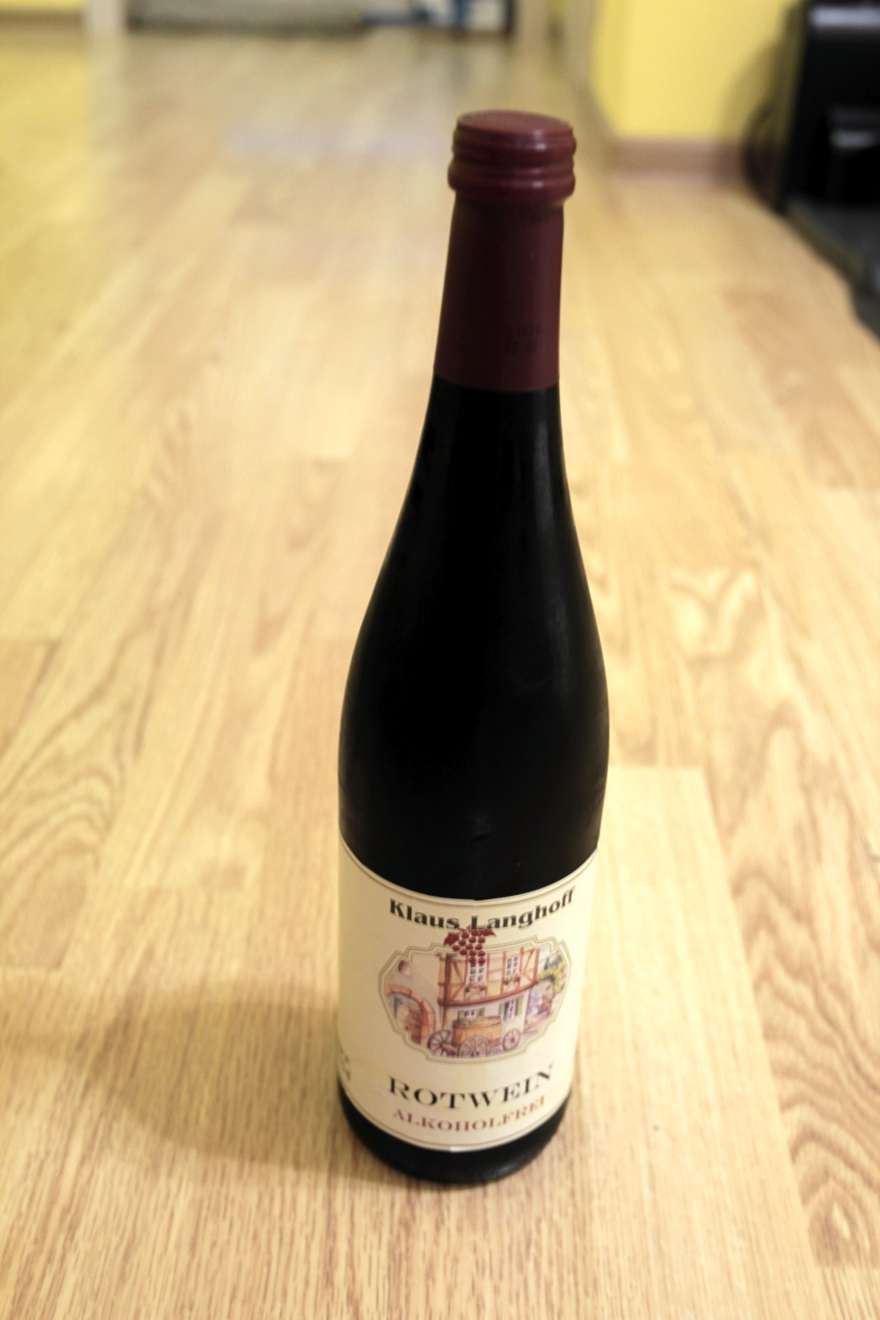
Нет ничего страшнее для пьющего, чем нечто под названием «дажевино». Когда я говорю, что я не пью, глаза вопрошающего округляются и он в ужасе произносит «дажевино».
Душеспасительные беседы про алкоголь я провожу реже, чем может показаться при прочтении моего блога, но они случаются. В ходе бесед часто происходит один и тот же диалог, в котором начисто отсутствует трезвый взгляд на вещи у одной из сторон.
После «дажевина» я обычно спрашиваю чем же так оно нравится собеседнику. Ответ один и тот же — конечно вкус, как много теряет тот, кто этого вкуса себя лишает, что привкус спиртного даже не нравится (или пьют
На что я обычно замечаю, что вкуса я себя не лишаю — ведь есть вино безалгокольное, выбор, конечно, в таком случае, ниже, но он есть. У нас обычно продаются немецкие вина — Клаус Лангхофф, Петер Мертес…
Тут любой собеседник всегда прерывает
В этот момент я перестаю
Дажевино!
Закрой глазки и получи послание
Забавное совпадение. Все, наверное, в детстве читали сказки Андерсена. Помните такого персонажа у него — Оле Лукойе, он приходил к детям и хорошим показывал сны. Википедия говорит, что имя образовано из двух частей: Оле — датское мужское имя, а Лукойе переводится как «закрой глазки».
А в книге Абсентиса «Христианство и спорынья» упоминается растение ололиукуи, которое использовали ацтекские жрецы. Вот что писал испанский врач Франциск Эрнандес в 1651 году:
Когда их жрецы хотели вступить в общение с богами и получить от них послание, они ели это растение, чтобы вызвать у себя бред. Перед ними появлялись тысячи видений и дьявольских галлюцинаций.
Интересно, знал ли Андерсен об этом растении, когда придумывал имя для своего персонажа?
«Неглупый дом»: входная дверь
Разобрался
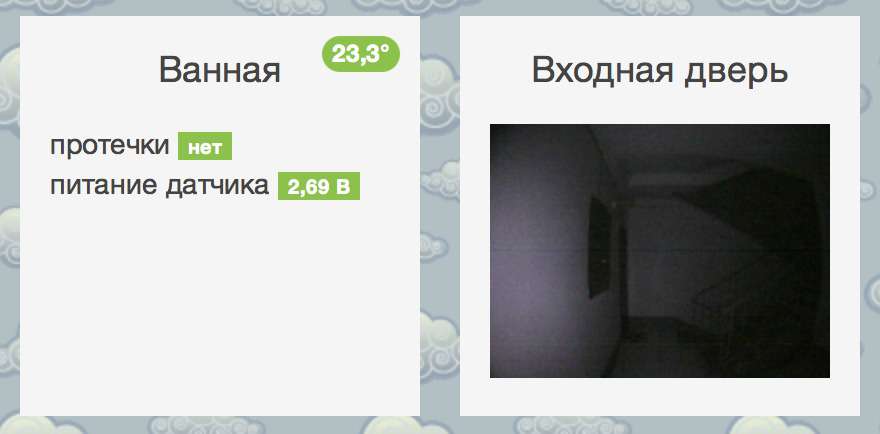
Как я уже писал, основная трудность была в том, чтобы приделать
Вырезал ножом подходящую нишу, запихал внутрь карточку вместе с переходником:
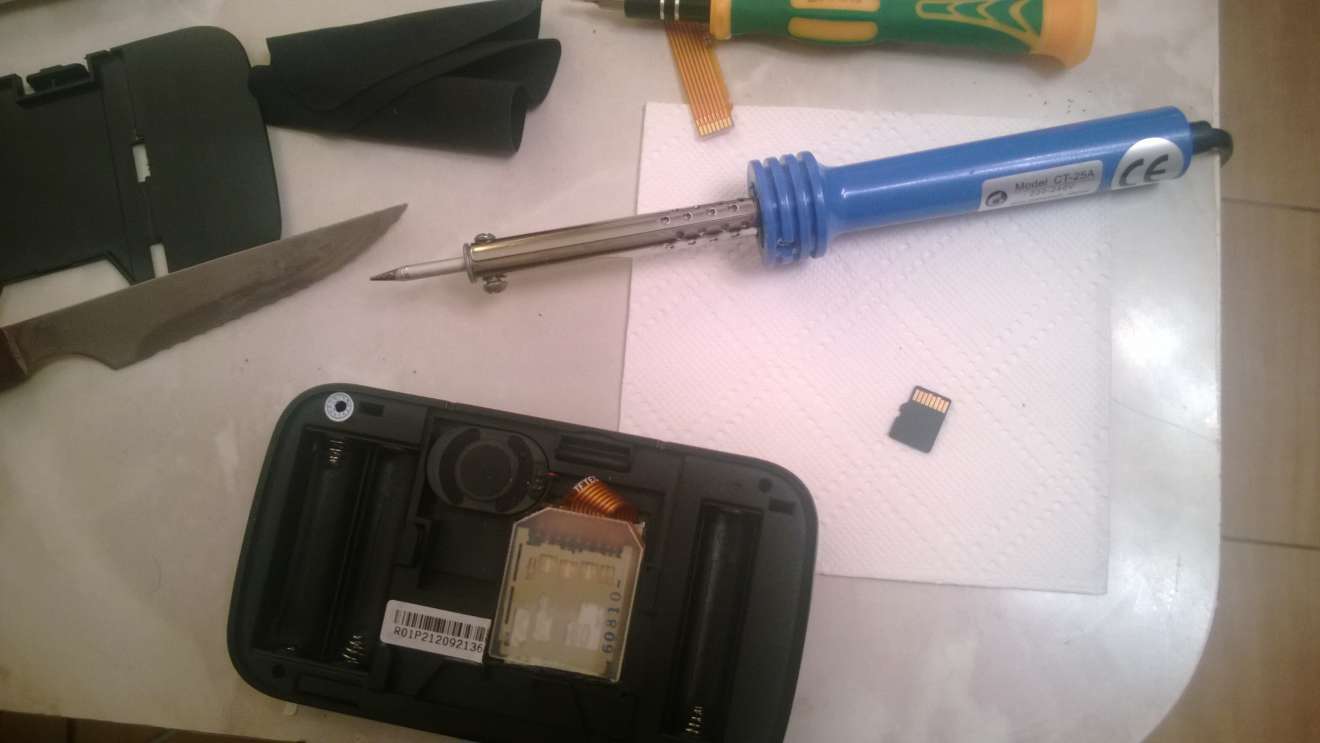
Отыскать паяльник
Вторую точку к смартбуку я добавил через утилиту wpa_cli по инструкции, найденной в интернете. Скрипт для заливки данных получился на этот раз развесистым:
# переключаюсь на точку доступа в карте
/sbin/wpa_cli select_network 1
/sbin/dhclient wlan0

# текущая дата и временный файл
DATE=$(/bin/date +%d-%m-%Y)
TEMP=$(/bin/tempfile) || exit
trap "/bin/rm -f -- $TEMP" exit

/usr/bin/touch /tmp/eye.current

# смотрим снимки за сегодня, выбираем первый, который ещё не заливали, скачиваем
for file in $(/usr/bin/curl -s "http://eye/command.cgi?op=100&DIR=/$DATE" | /usr/bin/awk -F, "/$DATE/ {print \$2}"); do
    echo $DATE/$file
done |
/usr/bin/diff /tmp/eye.current - | /usr/bin/awk '/^>/ {print $2}' |
/usr/bin/head -1 | /usr/bin/tee -a /tmp/eye.current | {
    read FILE && /usr/bin/curl -s "http://eye/$FILE" > "$TEMP"
}

# переключаемся обратно на интернет
/sbin/wpa_cli select_network 0
/sbin/dhclient wlan0

# если с карты что-то слили, заливаем это на сервер
[ -s "$TEMP" ] && /usr/bin/curl -F p=@"$TEMP" http://example.org/api/pict.php
Пока есть
Если кому интересно, переходник использовал китайский, купил за 160 рублей