программирование
Вайбкодинг: как убить трёхчасовую работу
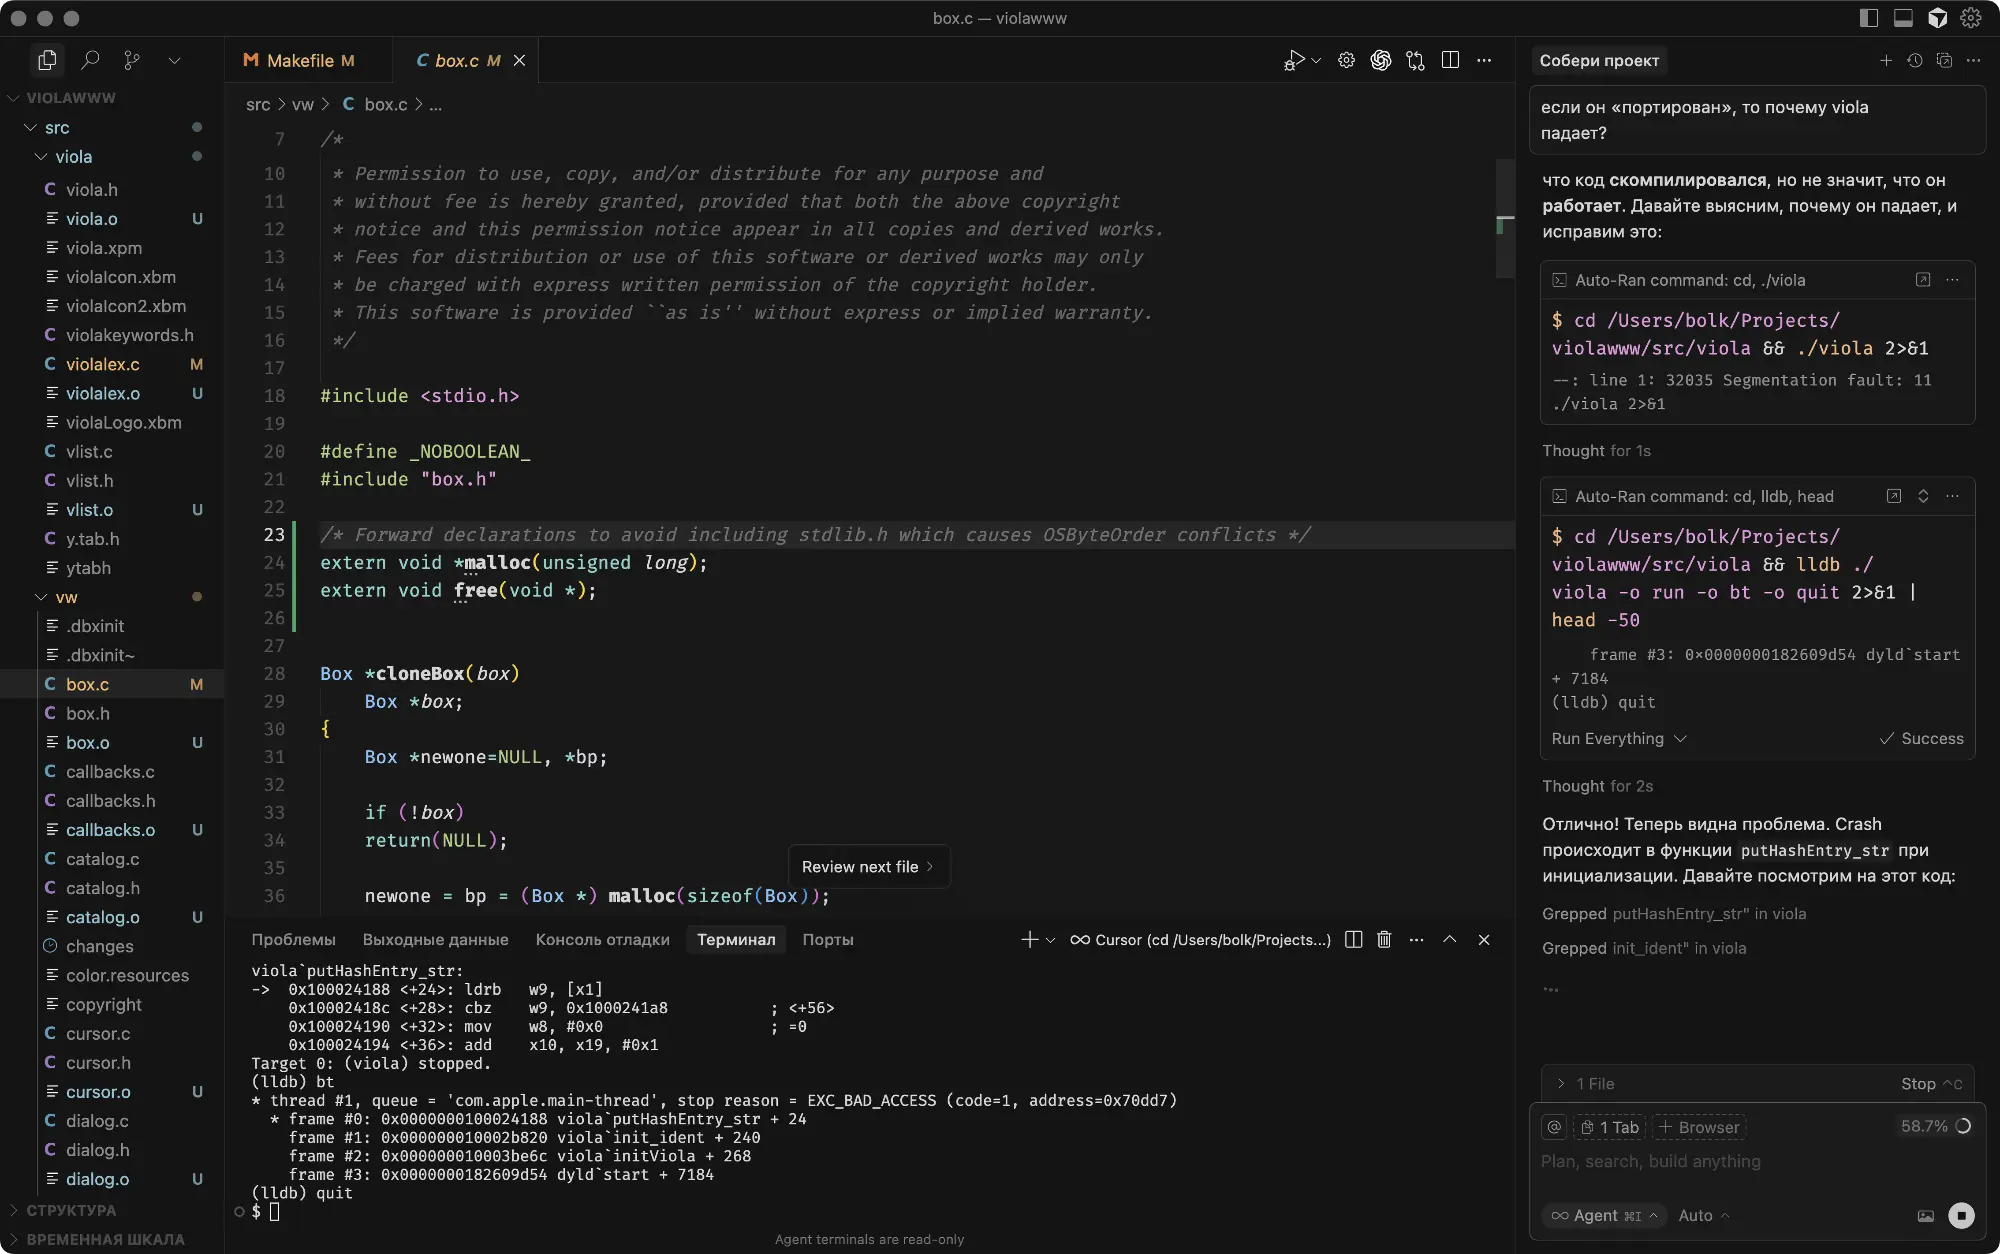
Недавно я реализовывал поддержку стилевых таблиц в браузере «Виола», который я ковыряю в свободное время. Делал при помощи нейросетей, но вайбкодинга не вышло — программировать пришлось дуэтом, очень уж сложная задача. В итоге я потратил около
Пока мы программировали, сделали очень много различного вывода в консоль для отладки состояний объектов. Это очень помогает оценить что происходит внутри.
И вот, настал момент, когда всё заработало как надо — все написанные мной тесты пройдены, осталось убрать лишний вывод в консоль и закоммитить. Чтобы самому с этим не возиться, я попросил убрать весь вывод нейросеть, а сам пошёл налить чаю.
Когда пришёл, всё уже было готово, но я решил проверить перед коммитом — всё ли в порядке. Скомпилировал, запустил один из тестов… и всё развалилось. В сердцах пишу в чат с нейросеткой капсом: «ЧТО ТЫ НАДЕЛАЛ, ТЫ ВСЁ ИСПОРТИЛ». Понимаю, что бесполезно, но на меня так накатило, что
И сетка в чате пишет в режиме размышления: «понятно, пользователь
На меня тут нашло

Транслит в «Виоле»
Пытаюсь улучшить транслит в браузере «Виола», который я продолжаю ковырять. Напомню: чтобы не менять шрифты, я сделал транслитерацию для языков, буквы которых отсутствуют в кодировке
Кодировка сейчас обрабатывается в три прохода.
На первом шаге я определяю кодировку страницы: смотрю её в заголовке Content-Type или в
Если кодировка отличается от
На втором шаге перегоняю текст в транслит при помощи ICU, для русских букв использую таблицу BGN, для остальным — то, что там работает
И на третьем шаге я опять вызываю iconv в режиме TRANSLIT, чтобы перегнать оставшиеся значки — то, что буквами не является, всякие там буллиты, кавычки и так далее.
Проблема в том, что я давно разучился бегло читать транслит, поэтому приходится прикладывать усилия. Варианта три: ничего с этим не делать, взять шрифты, которые содержат русские буквы, или переделать транслит так, чтобы его было проще читать.
Результат моих усилий — на скриншоте. Кажется, вариант по центру читается проще, чем правый. Но есть очевидные проблемы с буквами «ц» и «щ»: они у меня передаются как «u,» и «w,» соответственно, и этот знак запятой здорово сбивает темп чтения — заставляет спотыкаться. Пока думаю дальше.

STG: таблицы стилей в «Виоле»
Чем меня в своё время поразила «Виола» в самое сердечко, — предвосхищением идеи стилевых таблиц и браузерного языка программирования. Мне очень нравятся такие пророческие находки, хочется увидеть как они были сделаны и как автор до этого вообще дошёл.
«Википедия» в своё время заронила интерес, но полностью тему не раскрыла — про стилевые таблицы этого браузера там написано совсем мало, да ещё и с ошибками, как я смог убедиться. «Спецификация», если так можно назвать страницу, сохранившуюся благодаря стараниям
Оказалось — показалось, в браузере было реализовано даже меньше.
Несмотря на простоту спецификации, «Виола» мало что из описанного умела, пришлось дописать. Сейчас всё, надеюсь, работает так, как задумывал автор. Интересный момент — код на Си только парсит стили, остальным занимается интерпретируемый код, написанный на языке программирования, реализованный в браузере.
Стилевые таблицы подключаются тегом LINK и имеют расширение .stg, хотя это не обязательно, но в спецификации так:
<link rel="style" href="HTML_sodium.stg">Таблиц может быть подключено много и они работают «вниз», то есть от момента включения в код ниже места включения применяются стили, которые там описаны.
Селекторов всего два — можно выбрать тег или стиль тега (это работает немного не так как в CSS):
(BODY,SECTION
     BGColor=green
     FGColor=red
     (P)
     (KBD
          BDColor=black
          border=1
     )
)
Что тут написано? Что в тегах BODY и SECTION будет зелёный фон и красный цвет шрифта, а кроме того эти атрибуты унаследуют теги P и KBD, причём у последнего будет ещё и чёрный бордюр.
Атрибутов, к слову немного, в основном это характеристики шрифтов, цвет, бордюр
Ещё есть стилизованный браузером элементы, некие встроенные стили (например, WARNING, NOTE и так далее), которые можно навешивать на произвольные теги при помощи атрибута STYLE. На картинке пример того как выглядит встроенный стиль WARNING: оранжевый бордюр и картинка.
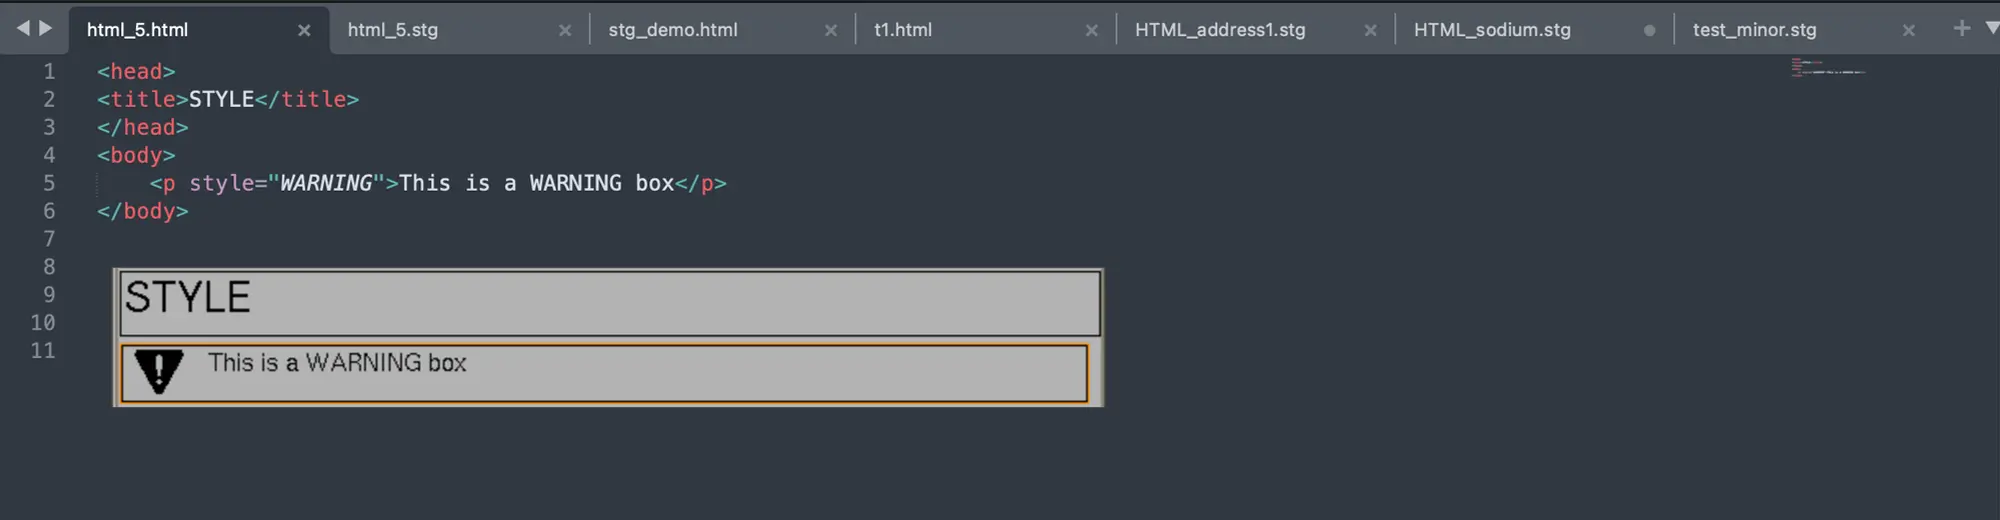
К тегам, помеченным атрибутом STYLE тоже можно применять собственные стили:
(P
    BGColor=white
    FGColor=black
    {STYLE "WARNING"
        FGColor=red
        fontSlant=italic
    }
)
У тега P здесь белый фон и чёрный цвет шрифта, а если у него есть атрибут STYLE, равный WARNING, то добавляются ещё два стиля, определяющие красный шрифт наклонного начертания.
В коде как будто бы есть небольшой намёк на то, что селектор должен работать и с другими атрибутами (да и синтаксис стилевых таблиц это позволяет), но в спецификации про это нигде не сказано. Я пока тоже не реализовал.
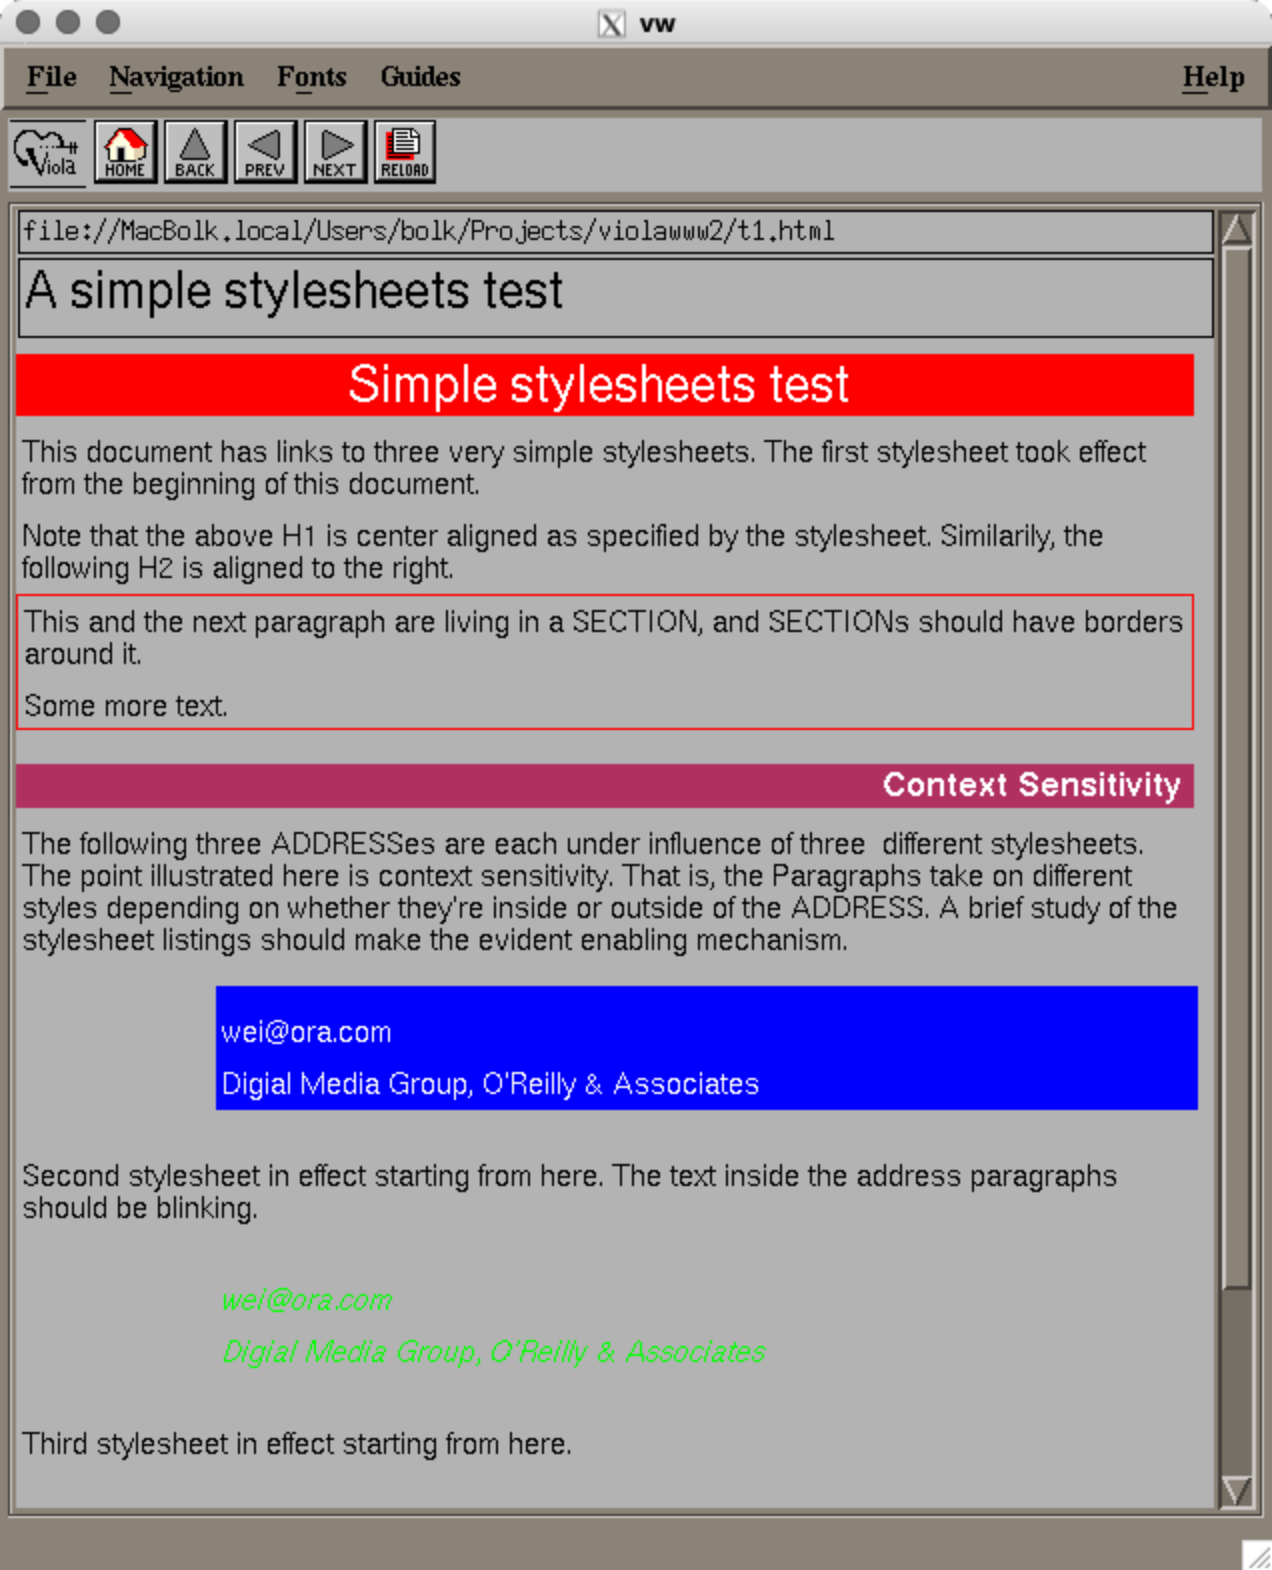
На второй картинке тест со страницы спецификации, который проходит дописанный браузер. В самом тесте, кстати, тоже были две ошибки — не закрытая скобка и неправильные стили синего блока.
Продолжаю возиться с «Виолой»
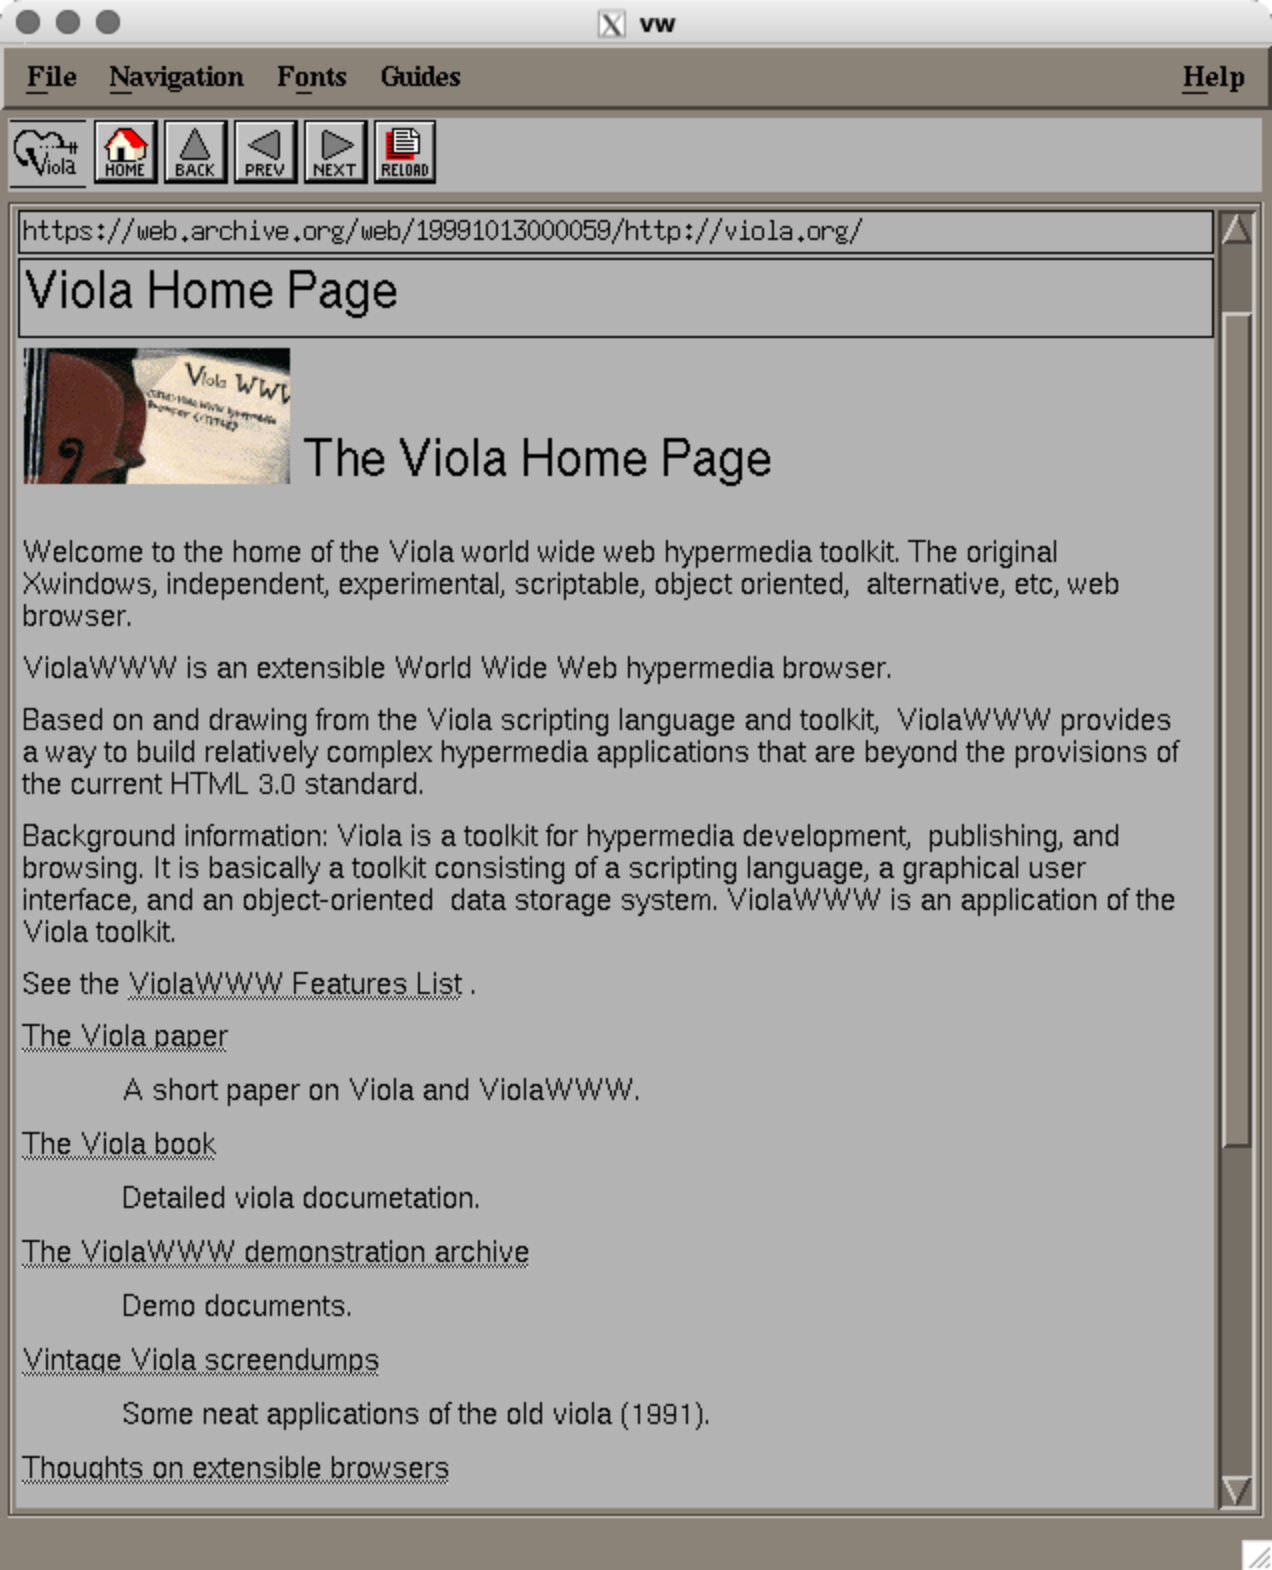
Продолжаю понемногу возиться с браузером «Виола», оживлением которого я недавно занялся. Благодаря нейросетям, на это ушли не годы, а всего несколько дней.
Чтобы не нарушать аутентичность, решил править только ошибки — их там нашлось и ещё найдётся немало — и доработать работу с сетью. Добавил менеджер соединений, поддержку HTTPS и транслитерацию кодировок: иначе пришлось бы заменять шрифты, а это в мои планы не входит. Кроме того, сделал забавную вещь — поддержку протокола
Если желаете тоже прикоснуться к истории, проект лежит на «Гитхабе», можно попробовать себе его собрать. Только сразу скажу — я собираю под «МакОС», под другие платформы без переделки собрать не получится.
Наблюдение за вайбкодингом
Хочу поделиться списком наблюдений, которые я сделал, пока нейросеть мне вайбкодила исправления для запуска браузера ViolaWWW.
Для начала хочу сказать, что в процессе переписывания кода возникло огромное количество задач. В основном — скучных и рутинных: множество очевидных и мелких правок, с которыми нейросеть справилась на «ура», тогда как я бы в них просто утонул. А вот перед более комплексными задачами она иногда пасовала, хотя мне они были вполне по плечу.
Теперь — по пунктам.
Приходилось разбираться в ситуации и разрывать этот цикл вручную. Бывали и моменты, когда ей не хватало идей — нейросеть явно не понимала, как исправить проблему, которую сама же обнаружила, поэтому пыталась подставить достаточно странные костылики. Ту я тоже
Мы сейчас продолжаем переводить приложение на 64 бита (не все куски кода переведены), поэтому я попросил сделать команду make, которая подсвечивает ошибки усечения типа (ключ
Браузер ViolaWWW ожил
Пожалуй он заслуживает быть вписанным в историю развития интернета!
В последний раз браузер, думаю, компилировали
Но теперь ведь у нас есть нейросети! В итоге, я запустил редактор «Курсор», дав ему утром задание успешно запустить браузер, и вечером получил работающее приложение. Мы даже добавили в него поддержку русских букв!
Не скажу, что всё прошло гладко, иногда мне приходилось направлять нейросеть на верную дорогу, но такое было всего несколько раз. Вряд ли я сделал бы такое количество исправлений самостоятельно — потребовались бы
За один рабочий день нейросеть портировала этот брайзер под «МакОС» и перевела

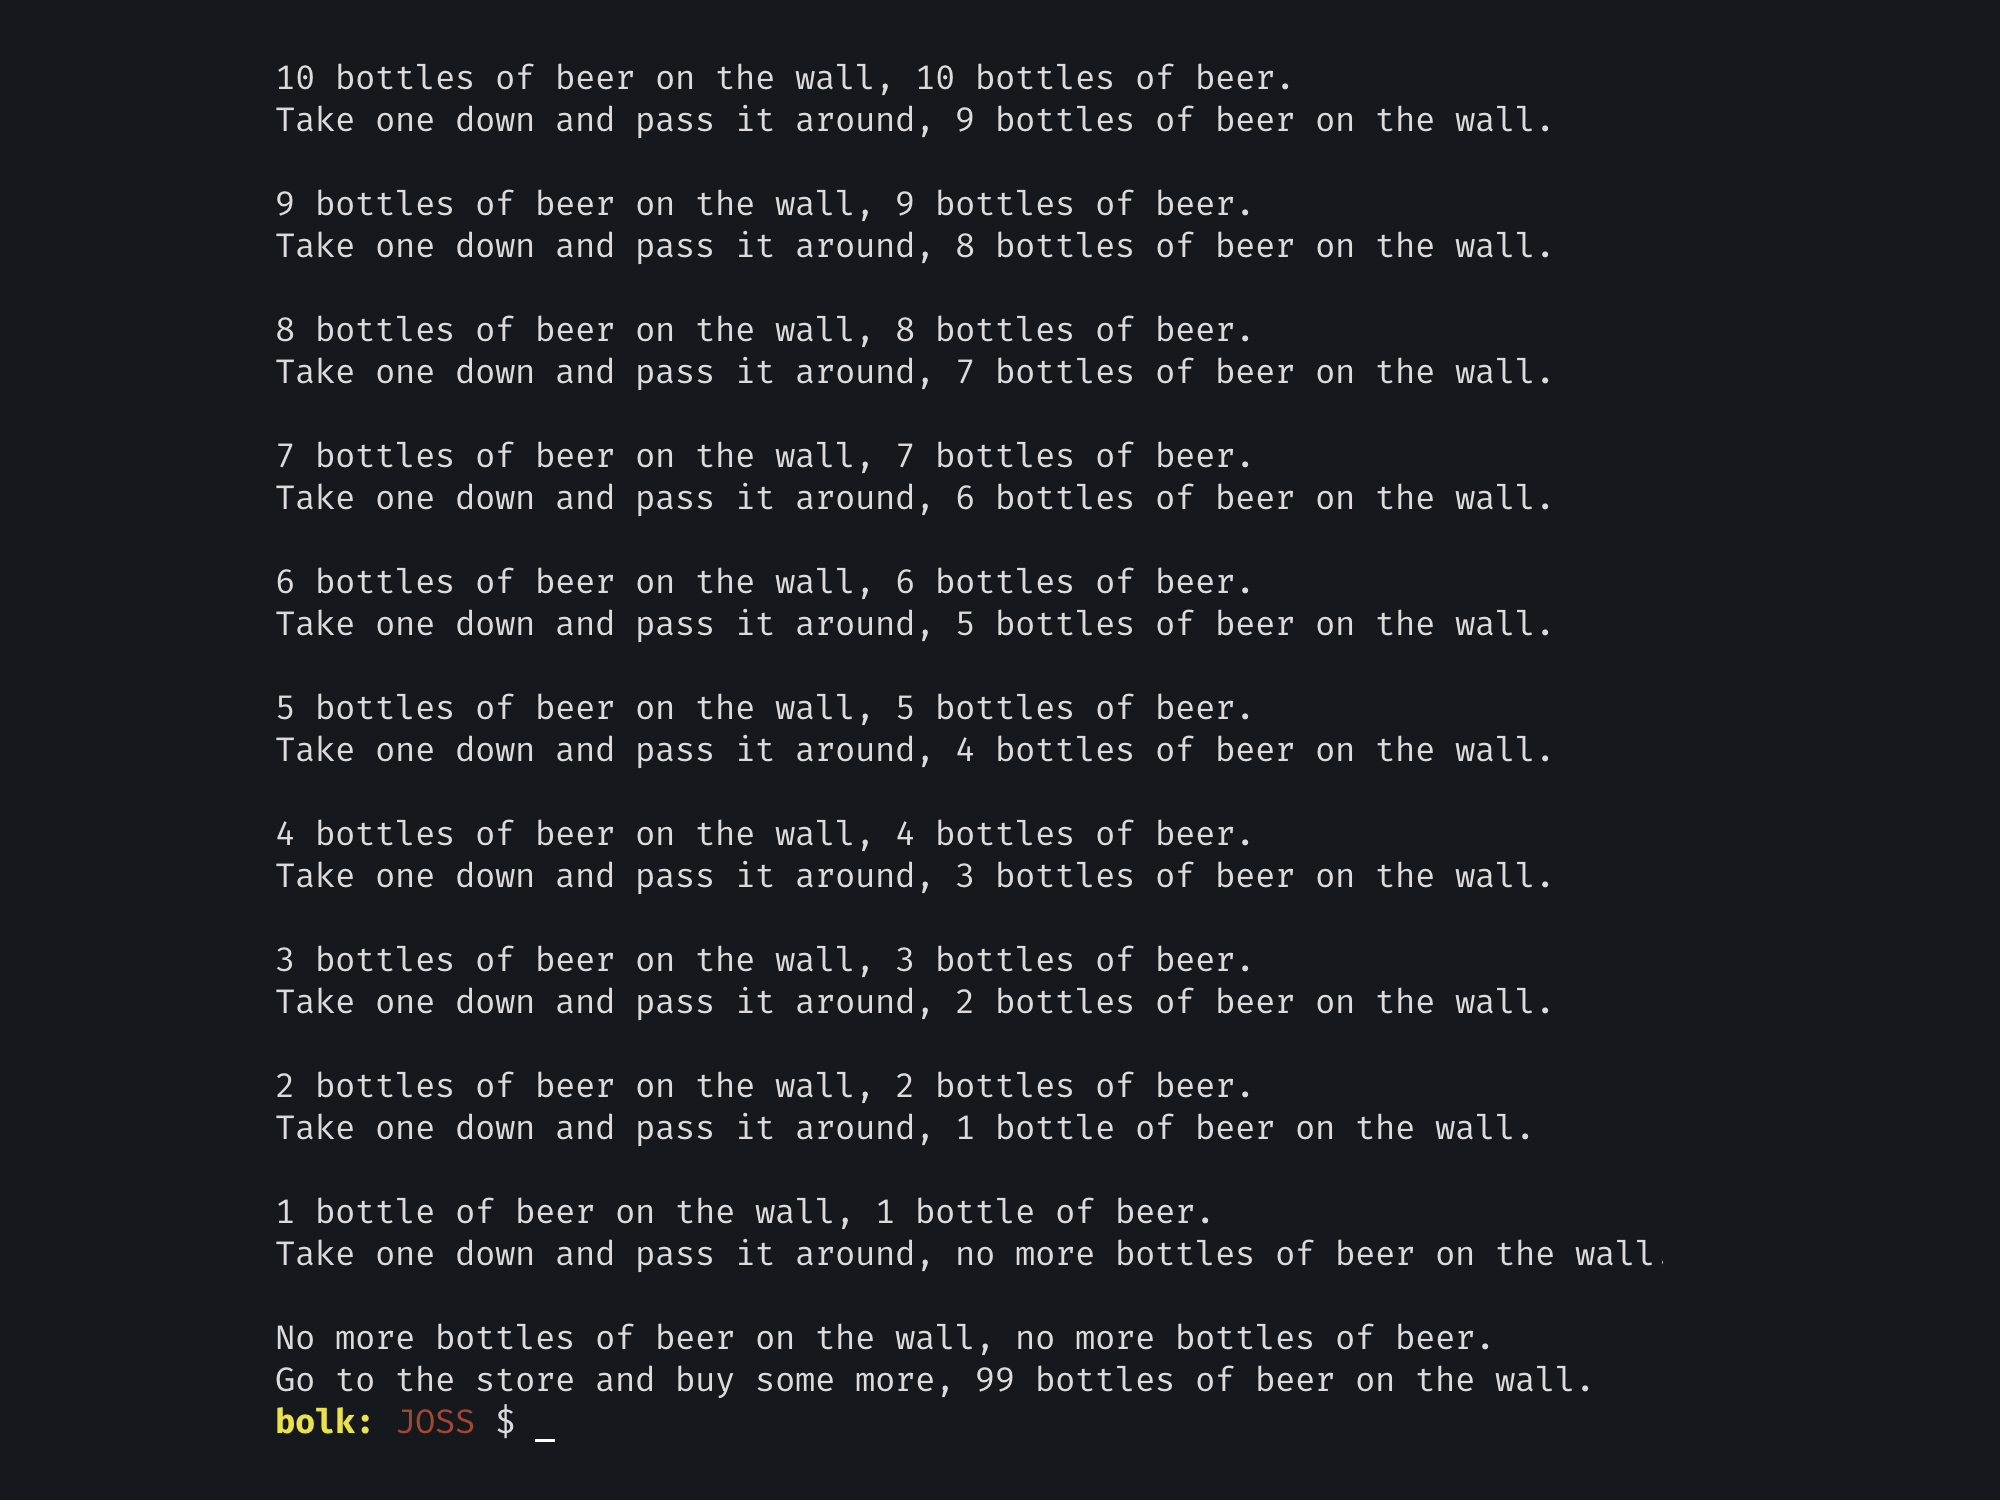
99 бутылок: JOSS
Продолжают писать американскую считалочку «песня о пиве» на всяких странных и не очень языках программирования.
85. JOSS (JOHNNIAC Open Shop System) — язык, созданный Клиффордом Шоу в RAND Corporation в 1963 году для машины JOHNNIAC.
Именно в этом языке впервые появились условные выражения, диапазоны, функции и компактный синтаксис ветвлений, позволявший записывать целые решения в одну строку. Из «Джосса» выросли TELCOMP, STRINGCOMP, CAL, MUMPS, «Фокал» и «Бейсик» — целое поколение языков, унаследовавших его простоту и интерактивность.
Что в «Джоссе» необычного? Из тех языков, с которыми наиболее вероятно столкнуться в реальной жизни, он, разумеется, напоминает
Ну и мелочи: перевод строки обозначается подчёркиванием (_), умножение — интерпунктом (·), «звёздочка» при этом служит для экспоненты, «неравно» записывается отдельным символом (≠). Таких деталей в «Джоссе» много — перечислять можно долго.
* "99 Bottles of Beer," written in JOSS on Oct 16, 2025
* by Evgeny Stepanishchev (https://bolknote.ru)

Let b(n)=[n=1:" bottle"; n≠1:" bottles"].

1.1  Set n=99.
1.2  Do part 2 for i=n(-1)1.
1.3  Do part 3.
1.4  Stop.

2.1  Set j=i-1.
2.2  Type i, b(i), " of beer on the wall, ", i, b(i), " of beer.".
2.3  Type "Take one down and pass it around, no more bottles of beer on the wall." if j=0.
2.4  Type "Take one down and pass it around, ", j, b(j), " of beer on the wall." if j>0.
2.5  Type _.

3.1  Type "No more bottles of beer on the wall, no more bottles of beer.".
3.2  Type "Go to the store and buy some more, 99 bottles of beer on the wall.".

Go.
Язык давно уже не используется, поэтому мне не удалось найти, где можно было бы выполнить на нём программу. Обычно в таких случаях я просто пишу код по описанию, не проверяя его, но здесь впервые пошёл другим путём — написал несколько тестов и «завайбкодил» интерпретатор по описанию, взятому из «Википедии».
Колеблюсь, выкладывать его или нет. С одной стороны, кому он нужен — интерпретатор давно почившего языка? С другой стороны, вдруг
Утилита cdecl
Какая интересная утилита есть, оказывается, а я и не знал! Позволяет по любой декларации типа в языке Си получить описание на английском или наоборот — свернуть такое описание в тип. Вот примеры:
cdecl> explain char *(* const volatile (*(*hydra)(int (*)(void), char * const * restrict))[13]) (unsigned long, char * const [static 3]);
declare hydra as pointer to function (pointer to function (void) returning integer, restricted pointer to constant pointer to character) returning pointer to array 13 of constant volatile pointer to function (unsigned long integer, non-empty array 3 of constant pointer to character) returning pointer to character

cdecl> declare fp as pointer to function (pointer to char) returning pointer to array of pointer to char
char* (*(*fp)(char*))[];Модели BitNet
Эксперементировал сегодня ночью с моделями BitNet. Это небольшие (1—2 миллиарда параметров) модели очень низкой битности — 1,58 бит. Причём это не квантизация, они сразу так обучены. Интересны тем, что работают настолько быстро, что их можно запускать без графических ускорителей.
Было интересно посмотреть с какими типами задач они способны справиться.
Давал несложные задачи генерации текста, выделения сущностей, классификации, перевода с английского на русский, написания эскуэля,

На скриншоте у меня задача по написанию крайне простого эскуэля. Выглядит хорошо, задача решена, но это верхний предел этой модели — если дать ещё одну таблицу, всё сыпется в половине моих тестов. А если в задачу добавить ещё и LEFT JOIN, то тесты не проходят вообще — модель ни разу ничего адекватного не написала даже с очень детальными подсказками.
Поразительно, конечно, что сети такой низкой битности вообще
Ошмётки в консоли
Как известно, много лет назад «Эпл» перешла с процессоров «Интел» на собственные, основанные на архитектуре «АРМ». Процессоры несовместимы, однако бинарные программы, скомпилированные под «Интел», продолжают работать — в «МакОС» встроен специальный транслятор, который обеспечивает такую возможность.
Много лет я таскаю с собой различные утилиты, которые при переходе с одного «Макбука» на другой автоматически копируются при помощи встроенной в ОС процедуры миграции. Однако некоторое время назад я занялся тем, что с помощью brew перевёл всё это бинарное хозяйство на «АРМ».
По пути у меня
Я всю голову сломал, пытаясь понять что же произошло, даже переставил себе iTerm2, думал дело в нём, но не помогло. Подумал, что может у меня
Тут я
Оказывается библиотека readline, отвечающая за редактирование текста в командной строке, неправильно считает длину строки, если в ней есть управляющие символы, — например, задающие цвет. Чтобы всё работало как надо, их надо обрамлять специальными последовательностями \[ и \]. Если я
В общем, я заменил приглашение с
PS1='\e[33;1m\u: \e[31m\W$(__git_ps1)\e[0m \$ 'на
PS1='\[\e[33;1m\]\u:\[\e[0m\] \[\e[31m\]\W$(__git_ps1)\[\e[0m\] \$ 'и всё заработало как надо.
Имя-эксплоит
Читал недавно про человека, сейчас уже покойного, фамилия которого состояла из более чем шести сотен букв.
В газете «The Free
Я, конечно, сразу вспомнил известный комикс XKCD.
И хотя история вполне вероятная, — не исключено, что в программе не проверялись границы буфера при вводе фамилии и это послужило причиной зависания, всё же я думаю, что это журналистское преувеличение и в реальности проблема была в том, что столь длинная строка просто не поместилась в нужное поле.

Если кому интересно, то согласно «Книге рекордов Гиннеса», его звали так:
Adolph Blaine Charles David Earl Frederick Gerald Hubert Irvin John Kenneth Lloyd Martin Nero Oliver Paul Quincy Randolph Sherman Thomas Uncas Victor William Xerxes Yancy Zeus Wolfeschlegelsteinhausenbergerdorffwelchevoralternwarengewissenhaftschaferswessenschafewarenwohlgepflegeundsorgfaltigkeitbeschutzenvonangreifendurchihrraubgierigfeindewelchevoralternzwolftausendjahresvorandieerscheinenvanderersteerdemenschderraumschiffgebrauchlichtalsseinursprungvonkraftgestartseinlangefahrthinzwischensternartigraumaufdersuchenachdiesternwelchegehabtbewohnbarplanetenkreisedrehensichundwohinderneurassevonverstandigmenschlichkeitkonntefortpflanzenundsicherfreuenanlebenslanglichfreudeundruhemitnichteinfurchtvorangreifenvonandererintelligentgeschopfsvonhinzwischensternartigraum.
Какой RLE лучше-2
Они
Оказалось, что более сложным алгоритмом я кодирую неправильно, так как в нём потенциально есть несколько стратегий кодирования одной и той же последовательности, чего я не увидел и не учёл в своей программе. На это мне попенял читатель, который мне
У меня всё никак не доходили руки аккуратно переписать свой скрипт, чтобы учесть замечание, но сегодня я не вытерпел и сделал некрасиво, практически перебором. Правда двухбайтный счётчик повторов делать не стал, наверное он тоже повлиял бы, но пока
В общем, новые результаты такие. Использовал на той же папке, что и в прошлый раз, но с той поры её состав немного поменялся. Алгоритм, который вспомнил я, лучше сжал 440 файлов, который предложил читатель — 4159, не удалось сжать вообще — 2507 файлов.
Прежний результат был такой: 1811 лучше сжал «мой» алгоритм, 2152 — читательский, в 3193 случаях не справился ни один из алгоритмов.
В общем, соотношение сильно изменилось.
Какой RLE лучше?
У меня тут в комментариях на сайте интересная дискуссия развернулась — есть ли преимущество у реализации RLE, которую я описывал, по сравнению с другим алгоритмом, который вспомнил один из читателей.
Для меня вполне очевидно, что на разных данных каждый из них может выиграть. Но что насчёт реальной жизни?
Я написал небольшую программу на Пайтоне, которая считает сколько занял бы файл, если его сжимать каждым из алгоритмов, а потом прогнал её на каждой из 7000+ файлов в моей папке «Загрузки».
Какой же итог? В 1811 случаях выиграл алгоритм, который вспомнил я, в 2152 — который вспомнил читатель, в 3193 случаях оба алгоритма сделали только хуже — файл стал длиннее.
В итоге, если бы мы писали утилиту для сжатия, можно было бы использовать все три метода (включая сохранение файла в исходном виде), указав в начале файла кодовый байт означающий метод сжатия.
from itertools import groupby
from math import ceil
import os
import sys

try:
    filename = sys.argv[1]
except IndexError:
    filename = __file__

def reader(filepath):
    with open(filepath, "rb") as f:
        while chunk := f.read(4096): yield from chunk

def mark(x, y):
    if x == y: return (x, y)

    c1, c2 = (32, 31) if x < y else (31, 32)
    return (f'\x1B[{c1}m{x:+d}', f'\x1B[{c2}m{y:+d}')

flen = os.path.getsize(filename)

grouped_same = (tuple(x[1]) for x in groupby(reader(filename)))
chains = groupby(grouped_same, lambda it: len(it) == 1 or object())

bolk = maks = 0

for diff, x in chains:
    x = tuple(x) if diff is True else tuple(x)[0]
    l = len(x)

    if diff is True:
        bolk  += l                       #                {x} {y} {z}…
        maks  += l + ceil(l / (128 + 1)) # {l & 0x7F - 1} {x} {y} {z}…
    else:
        bolk  += (2 + 1) * ceil(l / (255 + 2)) # {x}            {x} {l}
        maks  += (1 + 1) * ceil(l / (128 + 2)) # {l & 0x7F - 2} {x}


bdiff, mdiff = mark(bolk - flen, maks - flen)

print(f'Len\t{flen}')
print(f"Bolk's\t{bolk}\t{bdiff}\x1B[0m")
print(f"Maks'\t{maks}\t{mdiff}\x1B[0m")
Добавлено позднее: в комментариях есть замечания к реализации, которые я учёл позднее.
RLE в bzip2
Очень меня поразил тот факт, что внутри очень эффективного архиватора bzip2 работает алгоритм RLE. Да, после очень хитрых перестановок данных, но RLE!
Это очень простое семейство алгоритмов сжатия, с которым я познакомился ещё в то время, когда у меня был «Спектрум».
У него может быть много разных реализаций, но та, что я тогда программировал, выглядела следующим образом.
Последовательности одинаковых значений мы кодируем как один и тот же байт, записанный дважды, плюс счётчик — сколько таких байтов надо дописать; остальное оставляем как есть.
Например:
01 02 03 03 03 03 03 03 03 04 04 04 → 01 02 03 03 05 04 04 01
Как я уже написал, могут быть варианты. Например, можно счётчик делать больше, чем один байт или записывать количество повторений около каждого байта, всё зависит от характера сжимаемых данных, но суть
MS-DOS Siberian edition
Думаю на Земле живёт очень мало людей, которые хоть раз компилировали бы
Вроде там утекли и более свежие версии, но зачем нарушать закон, если всё равно какую версию собирать?
Собирал я её
Теперь у меня есть «
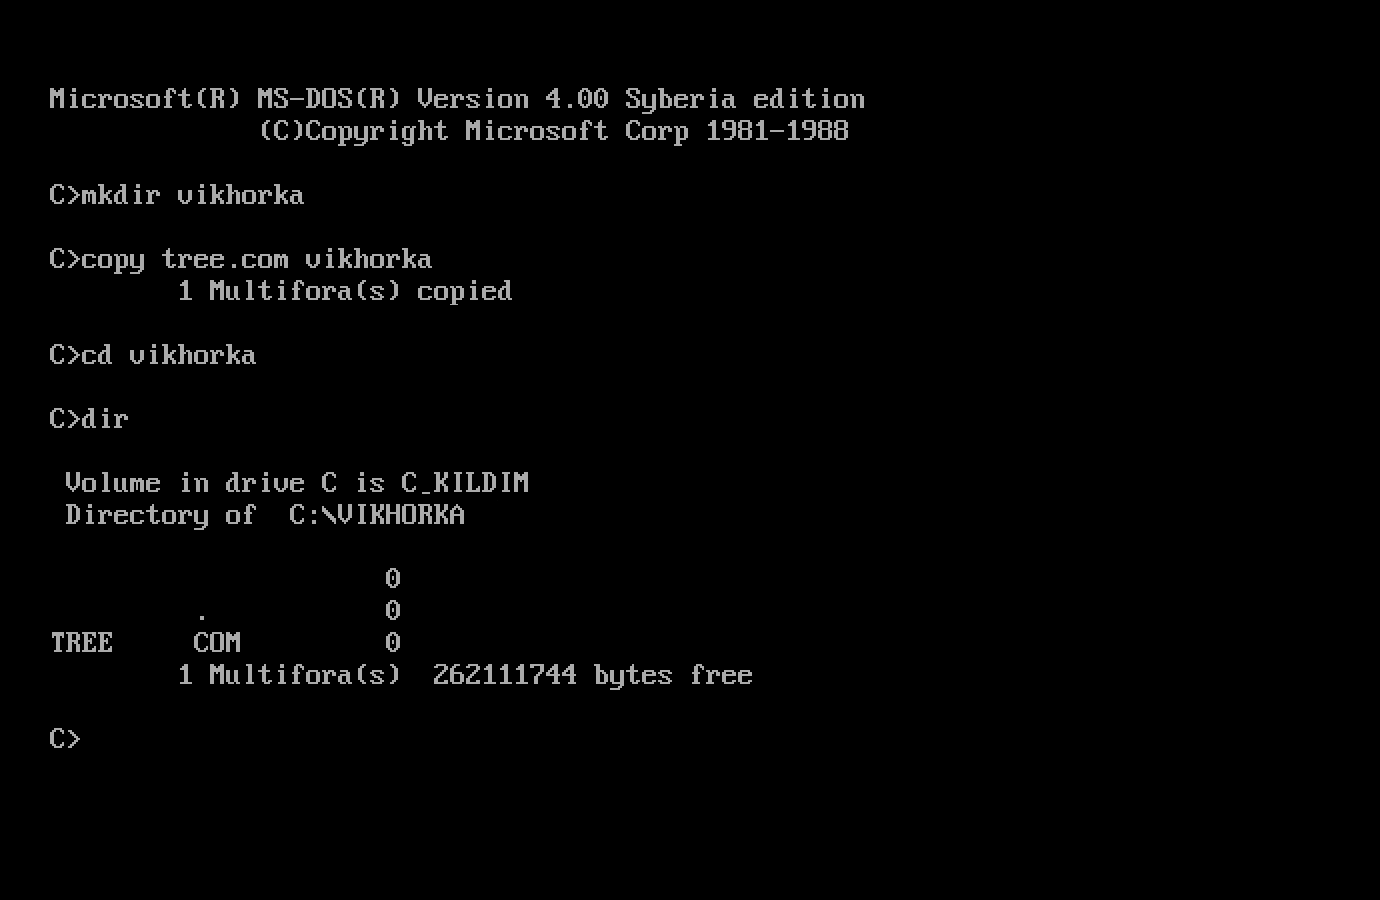
Дополнено: дважды ошибся — Syberia вместо Siberian и vikhorka вместо vikhotka. Первое понятно — так называлась игра, которую у нас перевели как «Сибирь», вот у меня и застряло, а второе вспомнил неправильно — больше десяти лет не слышал этого слова.
99 бутылок: AkRScript
В полку странных языков программирования, на которых я писал «песню о пиве», прибыло.
84. AkRScript — самодельный скриптовый язык программирования, написанный в середине десятых годов владельцем
Он его оживил в эмуляторе и выложил несколько программ, написанных на AkRScript, что и позволило мне разобраться в том как этот язык устроен.
Синтаксис, как это часто бывает у самодельных языков, совершенно вырвиглазный. Зато есть все основные примитивные типы данных — строка, число, массив, хеш и даже лямбды. Программирование процедурное, функции возможны только в виде лямбд. У меня в коде тоже есть одна такая, её легко узнать — они всегда начинаются с тильды и заканчиваются обратным апострофом; параметры передаются подстановками $A1, $A2 и так далее.
Процедуры можно описывать двумя способами — через ключевое слово subp и при помощи subp opcode. Отличия существенные — обычную процедуру приходится вызывать через оператор csp, а опкод вызывается как оператор. Кроме того, в обычную процедуру параметры передаются через глобальные переменные, тогда как опкод может получать их через стек, снимая с него значения оператором pop.
Дополнено: автор написал, что процедуры, вызываемые через csp тоже, вроде бы, могут забирать параметры через pop. Звучит логично, но проверять это я уже не буду.
Параметры передаются через пробел, включая выражения, которые должны обрамляться обратными апострофами.
С пробелами у языка сложные отношения — в параметрах они могут срезаться даже внутри строк, поэтому, чтобы не мучиться с ними, я завёл себе переменную sp, куда поместил неразрывный пробел и расставлял его везде, где сталкивался с трудностями.
-- "99 Bottles of Beer," written in AkrScript on August 9, 2025
-- by Evgeny Stepanishchev (https://bolknote.ru)

clrs

-- тут в скобках стоит неразрывный пробел (код 0xA0)
assign sp " "

subp opcode plural
assign _s s
assign _b `pop`

chk `cmp b 1` ~assign _s ""`
cno b ~assign _b No`
assign out `add _b sp bottle _s sp "of beer"`

mkill "_s"
mkill "_b"
ret

assign b 99

plural b

whi `gt b 0`

prnt out sp "on the wall, " out "!"
prnt "Take one down, pass it around,"

assign b `sub b 1`

plural b

prnt out sp "on the wall!"
prnt
ret

prnt "No more bottles of beer on the wall, no more bottles of beer."
prnt "Go to the store and buy some more, 99 bottles of beer on the wall."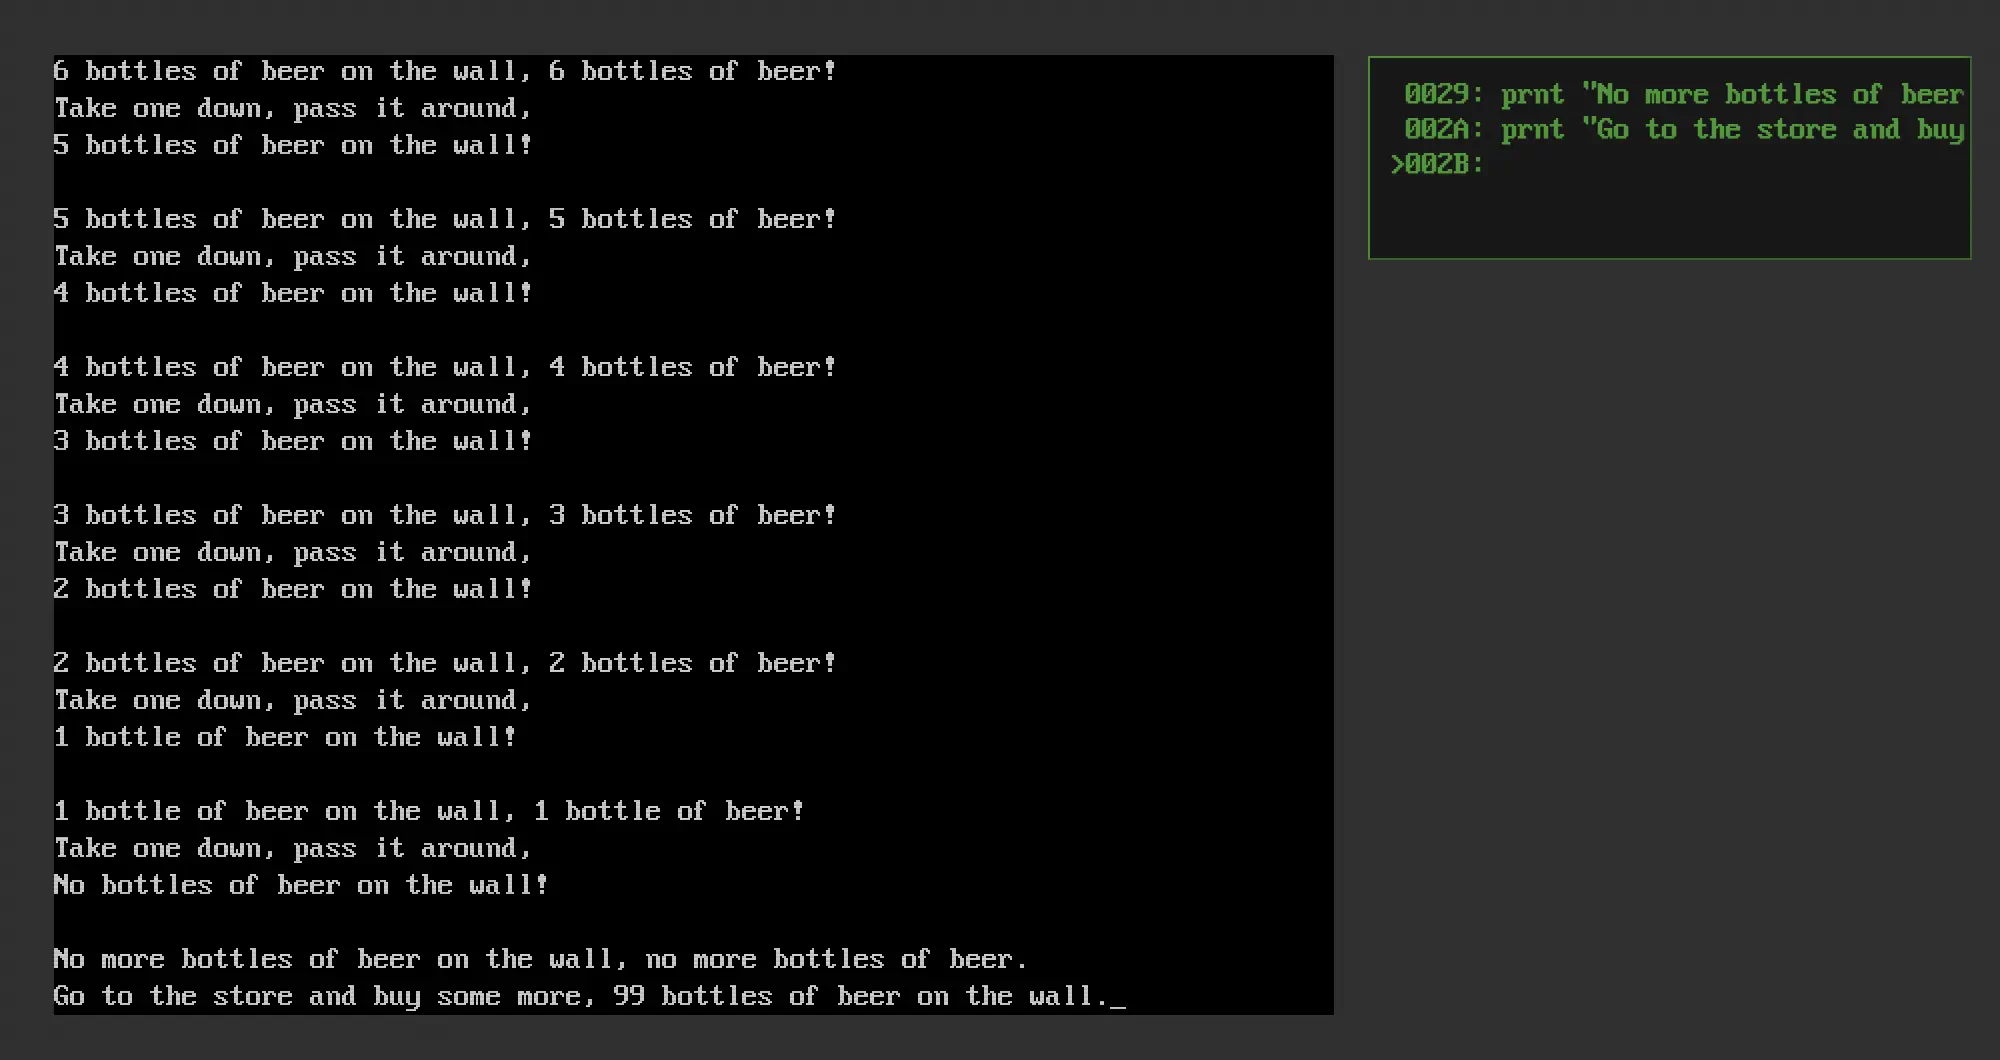
Ковыряю bc
Ковырял сегодня bc на досуге, ту версию, которая помощнее.
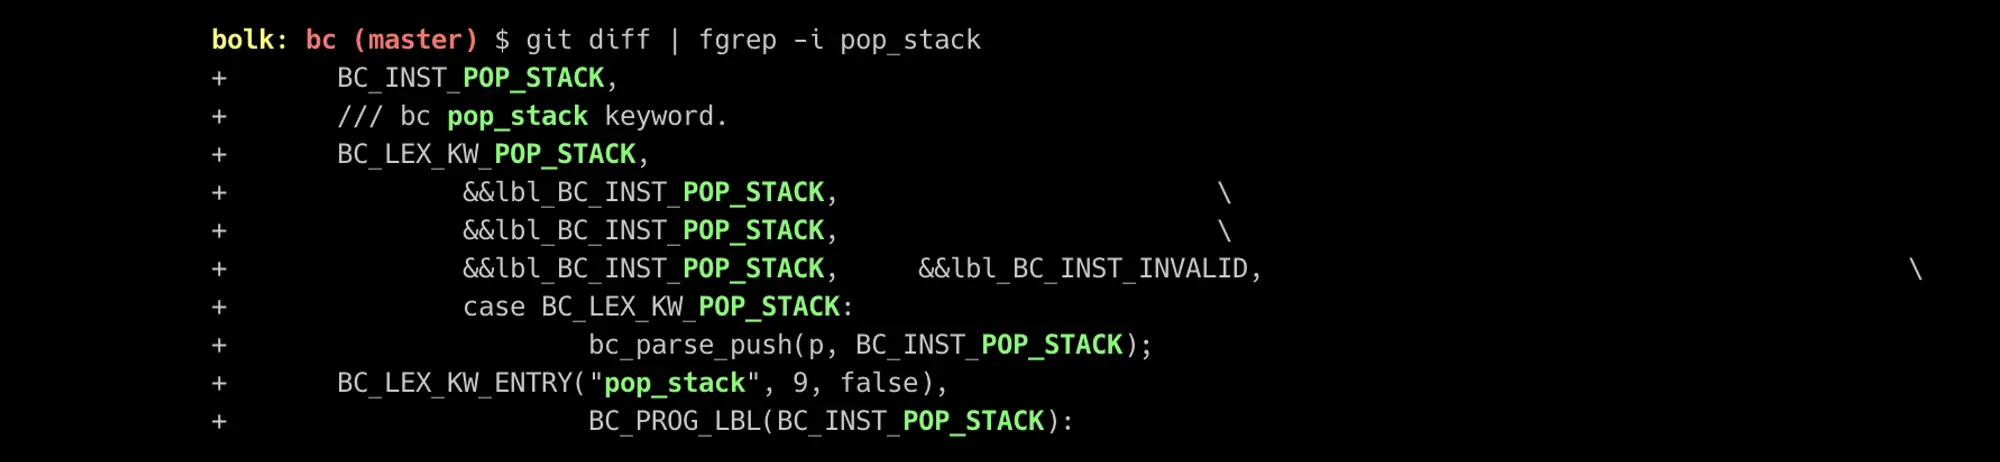
На скриншоте — количество мест, в которые пришлось её прописать. И только в одном из этих мест хранится её реализация. Взял за образец другие объявленные функции, поэтому не имею не малейшего понятия почему так много где пришлось её прописывать, не успел разобраться.
Лучше расскажу что именно я придумал добавить в язык. В bc есть несколько глобальных переменных, которые очень много на что влияют. Две, наверное, самые важные — это ibase и scale. Очень часто их приходится сохранять в начале и восстанавливать в конце своих функций, особенно библиотечных.
У более продвинутого bc есть специальный ключ, который, если его указать, меняет это поведение — при входе в каждую функцию значения этих и других глобальных переменных будут записываться в специальный стек, а на выходе — восстанавливаться оттуда.
Но библиотечные функции, всё одно, пишут, для универсальности, не рассчитывая на то, что этот флаг установлен. Вот, например, библиотечная функция косинуса:
define c(x){
    auto b,s
    b=ibase
    ibase=A
    s=scale
    scale*=1.2
    x=s(2*a(1)+x)
    scale=s
    ibase=b
    return(x/1)
}
Вот я и подумал, чтобы бы неплохо придумать директиву, при указании которой такой стек, для помеченной ею функции, всегда включался бы; а кроме того, была бы полезна функция, которая восстановила бы значения глобальных переменных ещё до выхода из функции. Иногда это необходимо, чтобы вернуть число в соответствии с установленными в них параметрами.
Функция косинуса с этими новыми возможностями выглядела бы так:
define stack c(x){
    ibase=A
    scale*=1.2
    x=s(2*a(1)+x)
    pop_stack()
    return(x/1)
}
Завтра ещё потестирую и попробую закинуть код автору bc, вдруг понравится изменение.
Добавлено позднее: Автор bc написал, что идея у меня интересная, но его жизнь серьёзно изменилась и теперь он не будет заниматься проектом бесплатно. Видимо крепко его прижало. Учитывая низкую популярность bc, можно сказать, что этот проект умер, если у него не найдётся новый мантейнер, что маловероятно.
99 бутылок: HolyC
История появления языка, на котором написана сегодняшняя «песня о пиве», довольно занятна.
Его автор, Терри Дэвис — гениальный одиночка и бывший инженер компании Ticketmaster, который посвятил более десяти лет созданию собственной операционной системы TempleOS. Страдая от шизофрении, он считал, что действует по воле Бога, который лично поручил ему создать «божественную ОС». Несмотря на тяжёлое психическое состояние, Дэвис самостоятельно написал компилятор, ядро, графическую оболочку и язык программирования — в полном одиночестве и с поразительной продуктивностью.
83. HolyC — тот самый язык, разработанный Терри. Выглядит он довольно интересно. Сильно напоминает Си, но имеет много интересных особенностей, некоторые из которых сразу бросаются в глаза, даже в моей небольшой программе.
Чуть менее заметная деталь — оператор case может не иметь аргумента, в таком случае используется автоикрементное значение, начинающееся с нуля. В HolyC вообще довольно много интересного синтаксического сахара.
Поражает, как много может создать в одиночку человек, заражённый
// "99 Bottles of Beer," written in HolyC on July 9, 2025
// by Evgeny Stepanishchev (https://bolknote.ru)

auto Bottle(U8 b)
{
  U8 *bottles, *ret;

  switch (b) {
    case:
      bottles = StrNew("No bottles");
      break;
    case:
      bottles = StrNew("1 bottle");
      break;
    default:
      bottles = StrPrint(NULL, "%d bottles", b);
      break;
  }

  ret = StrMerge(bottles, " of beer");
  Free(bottles);
  return ret;
}

U0 Main()
{
  U8 *bottles, b = 99;

  while (b) {
    bottles = Bottle(b);
    "%s on the wall, %1$s!\n", bottles;
    Free(bottles);

    bottles = Bottle(--b);
    "Take one down, pass it around,\n";
    "%s on the wall!\n\n", bottles;
    Free(bottles);
  }

  "No more bottles of beer on the wall,\n";
  "No more bottles of beer!\n";
  "Go to the store and buy some more,\n";
  "99 bottles of beer on the wall!\n";
}JavaScript™
Поразительно! Сегодня я узнал, что «JavaScript» — зарегистрированная торговая марка, принадлежащая компании «Оракл». Она попала к «Ораклу» вместе с другими активами компании «Сан Микросистемс» при её поглощении
Большое везение, что «Оракл» до сих пор не попыталась
Автор Node.js пытается добиться отмены регистрации торговой марки, аргументируя это повсеместным использованием этого названия. Прецеденты есть, насколько я знаю, может и получиться.
Другим выходом из ситуации было бы ещё переименование языка в EMCAScript или в LiveScript — оба названия имеют отношение в ДжаваСкрипту. Но этот путь, как мне представляется, сложнее первого.
Scratch на каникулах
Ещё до отъезда к дедушке и бабушке дочка, с моей подачи, увлеклась программированием на «Скретче» — иногда по вечерам делала на нём
На мой импульс позже наложился лагерь, куда мы её отдали на неделю между каникулами и отъездом, — там тоже был «Скретч». В лагере они программировали мультики, что ещё больше закрепило интерес — дочка
Думал на каникулах интерес сойдёт на нет, но как бы не так. Сейчас в её «детском гитхабе» уже 15 проектов, часть из них — вариации одного и того же, но, судя по активности, она и по числу оригинальных проектов меня скоро перегонит.