программирование
Как обойти баг со сложными селекторами CSS3 в «Вебките»
В «Вебките» (а значит в «Хроме» и «Сафари») есть баг с поддержкой сложных селекторов CSS3. Насколько мне рассказывали, это даже не баг, а сознательное решение. Относится он к сложным селекторам, связанным с «:target», «:checked» и ещё некоторым. Смысл в том, что у браузера как будто нет внутренних проверок на то, что условия поменялись (изменился элемент, на который должен указывать «:target», например) и надо переприменить селекторы к элементам.
Оказывается есть способ «подтолкнуть» браузер к этой проверке. Достаточно сделать пустую анимацию на нужном элементе. Вероятно это снижает производительность, так что осторожно, но зато работает:
section {
    -webkit-animation: 0.1s hack infinite;
}

@-webkit-keyframes hack {
    from {margin: 0; padding: 0;}
    to {margin: 0; padding: 0;}
}
Теперь в теге «section» эти сложные селекторы будут срабатывать.
ПХП и Винда
Порядка полугода назад разговаривали
А тут, на днях, нужно было продумать
По задумке внешний клиент дёргает «ручку» у сервиса, получает некий идентификатор и ждёт до поры до времени. Работа сервиса же
Функция не заработала правильно ни с «Апачем», ни с «Энжиникс», в комментариях пользователей к документации есть одинокий комментарий
Note that register_shutdown_function() does not work under Apache on Windows platforms. Your shutdown function will be called, but the connection will not close until the processing is complete. Zend tells me that this is due to a difference between Apache for *nix and Apache for Windows.
Похоже с тех пор ничего не изменилось. Ну хорошо, я вспомнил, что в последние ПХП входит патч
Решили не перебирать больше решения, а сразу перейти на запуск отдельного фонового процесса. Оказалось и это не тривиально сделать. Под «Виндой» нужно это делать следующим образом:
$commandline = 'start /b тут-программа-которую-надо-запустить';
pclose(popen($commandline, 'r'));
Сплошные приключения.
%u → UTF-8
Столкнулся сегодня с задачей — надо сконвертировать пришедшую из JavaScript строку (в ней символы Юникода в виде «%uXXXX»)
echo json_decode(str_replace('%u', '\\u', json_encode($str_from_javascript)));ChinesePython
А вы знали, что существует ChinesePython? Выглядит как настоящий, но не радует.
Язык полностью переведён на китайский, включая ключевые слова, встроенные типы и так далее, код основан на Пайтоне 2.1.3. Вот пример того как смотрится программа на этом языке:
載入 系統
文件名 = 系統.參數[1:]

定義 修正行尾(文件):
    內文 = 打開(文件名).讀入()
    內文 = 內文.替換('\n\r','\n')
    傳回 內文

取 文件 自 文件名:
    寫 修正行尾(文件)
«載入 系統» — это «import sys». Эта же программа на традиционном Пайтоне выглядит вот так:
import sys
filenames = sys.argv[1:]

def fixline(filename):
    text = open(filename).read()
    text = text.replace('\n\r','\n')
    return text

for file in filenames:
    print fixline(file)
Основная цель создания интерпретатора на китайском, по словам автора — популяризация программирования. Начинающий китайский программист, вместо того, чтобы учить недоанглийский, который всё равно не позволит ему говорить на этом языке, но позволит понимать слова Пайтона и называть переменные на корявеньком английском, может сосредоточиться на концепциях, алгоритмах и тому подобном.
Ерунда на itertools и генераторах
Я люблю itertools и генераторы в Пайтоне,
Прочитал тут на «Хабре», что дробь 1/998001 даёт последовательность из чисел от нуля до 997. Вот я и написал код с использованием генераторов и itertools, который берёт эту дробь и выводит из неё все числа последовательно, пока не попадутся числа с разницей не равной единице.
from decimal import Decimal, getcontext
from itertools import groupby, islice, izip, takewhile, chain, imap

getcontext().prec = 3000

n = (
    groupby(
        enumerate(
            islice(str(1 / Decimal(998001)), 2, None)
        ),
        lambda n: n[0] // 3)
    )

n = (int(''.join(n[1] for n in n[1])) for n in n)

n = chain(*takewhile(lambda n: n[1] - n[0] == 1, izip(n, n)))

print ', '.join(imap(str, n))
Кстати, для вычисления дроби с точностью до трёхтысячного знака, используется модуль decimal.
Подумалось, что многим, наверное, было интересно сравнить как выглядит эквивалентный код на Пайтоне без всех этих страшных (на взгляд большинства) ленивых выражений. А то некоторые ребята по моей вине уже думают, что Пайтон
from decimal import Decimal, getcontext

getcontext().prec = 3000

number, prev, out = str(1 / Decimal(998001)), -1, []

for i in xrange(2, len(number), 3):
    curr = int(number[i:i+3])

    if curr - prev != 1: break

    prev = curr
    out.append(str(curr))

print ', '.join(out)Некоторые проблемы SQLite
Товарищ Адепт пишет в ЖЖ про проблемы SQLite. Если вкратце, то выявлены минимум две проблемы.
SQLite при снятии дампа «CREATE VIEW» выписываются в порядке создания. Если у нас две вьшки, «A» и «Б», созданные в порядке перечисления и мы пересоздаём вьюху «А» с использованием «Б», то при заливке дампа будет ошибка —
Если создана вью, в конце которой комментарий стоит, то и в дампе будет комментарий в конце строки создания, экранирующий конечную точку с запятой.
create view commented_view
  as select something
       from some_table -- pretty useless view;
create view another_view as…Стеганография и пробел нулевой длины
Болею, не спится мне. Вспомнил старую свою идею.
В Юникоде есть такой символ замечательный — пробел нулевой длины (код 0x200B), на печать не выводится, понимается всеми современными браузерами и большинством редакторов. Интервала между буквами, как следует из названия, не даёт.
Идея простая, позволяет прятать в текст другой текст, так, чтобы первый не менялся, а второй всегда копировался вместе с первым. Основная мысль — пользуясь буквами исходного текста, как разделителем, ставим между ними столько пробелов нулевой длины, чтобы их число равнялось коду скрываемого символа.
Например. Дан текст: «Болк», в нём надо скрыть короткий текст: «yes». Я взял английские символы, чтобы не заморачиватсья с кодировкой.
Коды символов «yes» — 121, 101, 115. Значит текст приобретает следующий вид:
[121 символ пробела нулевой длины]Б[101 символ пробела нулевой длины]о[115 символов пробела нулевой длины]лк
Можно, кстати, вычитать из кода символа 31, если мы не планируем использовать символы перевода строки и табуляции в скрываемом тексте. Небольшой код на Пайтоне, приведённый ниже, иллюстрирует идею.
# Example by Evgeny Stepanischev
from itertools import groupby, izip_longest
import sys
import codecs
sys.stdin = codecs.getreader('utf-8')(sys.stdin)
sys.stdout = codecs.getwriter('utf-8')(sys.stdout)
toenc = 'Evgeny Stepanischev'
input = sys.stdin.read()
def decode(input):
return ''.join(chr(31+len(list(x[1])))
for x in groupby(input, lambda x: x == u"\u200b") if x[0])
def encode(input):
if len(input) < len(toenc):
raise ValueError()
return ''.join(x[0] + x[1]
for x in izip_longest((u"\u200b" * (ord(x)-31)
for x in toenc), input, fillvalue=''))
print(encode(input) if input.find(u"\u200b") == -1 else decode(input))Если на вход ему подать текст без пробелов нулевой длины, он добавит в него скрытый текст, иначе попытается его оттуда извлечь.
В принципе, этот подход можно применять в вебе для маркировки своих текстов — браузеры, кроме вымирающих, нормально относятся к этому символу и отображают его адекватно.
Конечно, важна длина текста — таким способом не скрыть текст, длина которого много больше исходной, но способ можно и улучшить в этом смысле. Например, в качестве прерывающего символа выбрать
О закладках в БИОСе
Показали хорошую статью на «Ксакепе»: «Китайские закладки: непридуманная история о виртуализации, безопасности и шпионах», читается как детектив, хотя сомнений в том, что это может быть правдой у меня нет.
CSS hack: firefox 3.5+
Для «Файерфокса» есть простой, не то чтобы даже
body {
    background-color: red;
    background-color: -moz-initial; /* для FF — значение свойства по-умолчанию */
}

.blk {
    display: none; /* для всех браузеров блок скрыт, */
    display: -moz-initial; /* кроме FF */
}
Браузеры на основе «Вебкит» так же поддерживают это значение (со 125 сборки), правда безо всякого префикса.
С Новым годом, что ли?
Я тут, чтобы мозг совсем не расслаблялся на праздниках, убил около часа и вручную сделал на Яваскрипте небольшое поздравление с Новым годом:
[][([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})
[-~[]]+([]+[][{}])[-~[]]+([]+!{})[!![]+!![]+
!![]]+([]+!![])[+![]]+([]+!![])[+!![]]+
([]+!![])[-[~[]+~[]]]+([]+{})[-~[]+(!![]<<!![]+
!![])]+([]+!![])[+![]]+([]+{})[-~[]]+([]+!![])
[+!![]]][([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})
[-~[]]+([]+[][{}])[-~[]]+([]+!{})[!![]+!![]+!![]]+
([]+!![])[+![]]+([]+!![])[+!![]]+([]+!![])
[-[~[]+~[]]]+([]+{})[-~[]+(!![]<<!![]+!![])]+
([]+!![])[+![]]+([]+{})[-~[]]+([]+!![])[+!![]]]
(([]+!![])[+!![]]+([]+{})[-~[]<<[-~[]+-~[]]]+
([]+!![])[-[]]+([]+[][{}])[-[]]+([]+!![])[+!![]]+
([]+[][{}])[-~[]]+([]+{})[~[]+(+!![]<<!![]+!![]+
!![])]+([]+![])[!![]+!![]+!![]]+([]+![])[!![]<<!![]+
!![]]+([]+![])[!![]+!![]]+([]+![])[-[]])()
[([{}-{}]+[])[-~[]]+([]+![])[!![]+!![]]+([]+![])
[!![]<<!![]+!![]]+([]+!![])[-~[]]+([]+!![])[+[]]](
[][([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})
[-~[]]+([]+[][{}])[-~[]]+([]+!{})[!![]+!![]+
!![]]+([]+!![])[+![]]+([]+!![])[+!![]]+
([]+!![])[-[~[]+~[]]]+([]+{})[-~[]+(!![]<<!![]+!![])]+
([]+!![])[+![]]+([]+{})[-~[]]+([]+!![])[+!![]]]
[([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})[-~[]]+
([]+[][{}])[-~[]]+([]+!{})[!![]+!![]+!![]]+
([]+!![])[+![]]+([]+!![])[+!![]]+([]+!![])
[-[~[]+~[]]]+([]+{})[-~[]+(!![]<<!![]+!![])]+
([]+!![])[+![]]+([]+{})[-~[]]+([]+!![])[+!![]]]
(([]+!![])[+!![]]+([]+{})[-~[]<<[-~[]+-~[]]]+
([]+!![])[-[]]+([]+[][{}])[-[]]+([]+!![])
[+!![]]+([]+[][{}])[-~[]]+([]+{})[~[]+(+!![]<<!![]+
!![]+!![])]+([]+![])[!![]+!![]+!![]]+([]+![])
[!![]<<!![]+!![]]+([]+![])[!![]+!![]]+([]+![])
[-[]])()[([]+![])[-~[]]+([]+!![])[+![]]+([]+{})
[-~[]]+([]+{})[!![]+!![]]](([]+![])[-~[]]+
([][([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})[-~[]]+
([]+[][{}])[-~[]]+([]+!{})[!![]+!![]+!![]]+([]+!![])
[+![]]+([]+!![])[+!![]]+([]+!![])[-[~[]+~[]]]+
([]+{})[-~[]+(!![]<<!![]+!![])]+([]+!![])[+![]]+
([]+{})[-~[]]+ ([]+!![])[+!![]]]+[])[(-~[]+[+![]])-!![]])+
([]+![])[-~[]]+
(/!/[([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})[-~[]]+([]+[][{}])
[-~[]]+([]+!{})[!![]+!![]+!![]]+([]+!![])[+![]]+([]+!![])[+!![]]+([]+!![])
[-[~[]+~[]]]+([]+{})[-~[]+(!![]<<!![]+!![])]+([]+!![])[+![]]+([]+{})
[-~[]]+([]+!![])[+!![]]]+[])[+!![]+[!![]<<!![]-~[]]]+
(/!/[([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})[-~[]]+([]+[][{}])
[-~[]]+([]+!{})[!![]+!![]+!![]]+([]+!![])[+![]]+([]+!![])[+!![]]+([]+!![])
[-[~[]+~[]]]+([]+{})[-~[]+(!![]<<!![]+!![])]+([]+!![])[+![]]+([]+{})
[-~[]]+([]+!![])[+!![]]]+[])[+!![]+[!![]<<!![]-~[]]]+
([]+[~[]/[]])[[[!![]+!![]]*[!![]+!![]]]*[!![]+!![]]]+
([]+{})[~[]+(+!![]<<!![]+!![]+!![])]+
([]+[][{}])[-~[]]+
([]+{})[-~[]<<[-~[]+-~[]]]+
([][([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})
[-~[]]+([]+[][{}])[-~[]]+([]+!{})[!![]+!![]+!![]]+([]+!![])
[+![]]+([]+!![])[+!![]]+([]+!![])[-[~[]+~[]]]+([]+{})[-~[]+
(!![]<<!![]+!![])]+([]+!![])[+![]]+([]+{})[-~[]]+([]+!![])
[+!![]]][([]+{})[-~[]+(!![]<<!![]+!![])]+([]+{})[-~[]]+
([]+[][{}])[-~[]]+([]+!{})[!![]+!![]+!![]]+([]+!![])[+![]]+
([]+!![])[+!![]]+([]+!![])[-[~[]+~[]]]+([]+{})[-~[]+
(!![]<<!![]+!![])]+([]+!![])[+![]]+([]+{})[-~[]]+([]+!![])
[+!![]]](([]+!![])[+!![]]+([]+{})[-~[]<<[-~[]+-~[]]]+
([]+!![])[-[]]+([]+[][{}])[-[]]+([]+!![])[+!![]]+([]+[][{}])
[-~[]]+([]+{})[~[]+(+!![]<<!![]+!![]+!![])]+([]+![])
[!![]+!![]+!![]]+([]+![])[!![]<<!![]+!![]]+([]+![])
[!![]+!![]]+([]+![])[-[]])()+[])[([]+![])[!![]+!![]+
!![]]+([]+![])[!![]+!![]]+([]+[][{}])[!![]+(!![]<<!![]+!![])]+
([]+{})[!![]+(!![]<<!![]+!![])]+([]+!![])[!![]+!![]+!![]]](~[]+~[])[-[]]+
([]+{})[~[]+(+!![]<<!![]+!![]+!![])]+
(~[]/[]+[])[-~[]<<-(~[]+~[]+~[])]+
([~[]<[]]+[])[-[~[]+~[]+~[]]]+
([{}-{}]+[])[-~[]]+
 ([]+!![])[+!![]]+
(/!/+[])[-~[]])
Запускать лучше всего в консоли браузера (в Firebug, Dragonfly и так далее). Цели сократить код у меня не было, более того,
Если
Обработка данных интернет-клиента «Альфа-банка»
Накидал небольшую программу для обработки данных
Программа на Пайтоне:
# coding: utf-8
import sys
import re
from datetime import date
from itertools import islice

output = []

with open(sys.argv[1], 'r') as f:
    for line in islice(f, 1, None):
        n, detail, arr, flow = line.decode('cp1251').split(';')[4:8]

        if n[:4] == 'BERR' or n[:6] == 'CASHIN': continue
        flow = float(flow.replace(',', '.'))

        if flow > 0:
            dates = re.findall(r'\d{2}\.\d{2}\.\d{2}', detail, re.UNICODE)

            if dates:
                d = min(date(*(int(x) for x in d.split('.')[::-1])) for d in dates)
                output.append({
                    'detail': detail,
                    'flow': flow,
                    'date': d,
                })

for k in sorted(output, lambda x, y: cmp(x['date'], y['date'])):
    data = zip(('y', 'm', 'd',), k['date'].timetuple()[:3]) + k.items()

print "%(d)02d.%(m)02d.%(y)02d %(flow)09s %(detail)s" % dict(data)Библиотеки Джаваскрипта на сторонних сайтах
Наверное, большинство почувствовало вчера, что большинство сайтов «Гугла» были неработоспособны. Не знаю с чем там были связаны проблемы, мне и не интересно, интересно другое — не работали и некоторые сайты, которые сервисами «Гугла» не являются. Например, мой любмый «Стековерфлоу».
Догадываетесь почему?
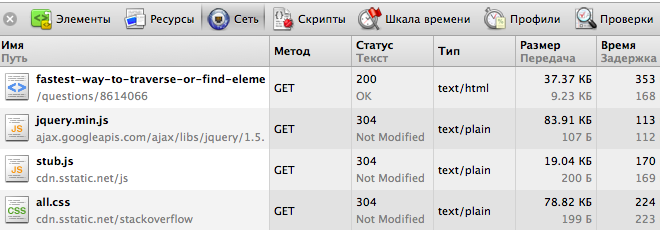
Догадываетесь, наверное, по картинке видно, да и заголовок подсказывает. «Стековерфлоу» грузит библиотеку jQuery со специального сервиса «Гугла», вся разгадка.
Даже не знаю как относиться к этой истории. С одной стороны, хочется немедленно перестать пользоваться хостингами
Почему надо хорошо знать свой инструмент
Каждый раз, когда я рассказываю в блоге как я провожу собеседование программистов, я получаю груду комментариев вида «я плохо знаю язык и считаю, что это нормально, а ты собеседуешь неправильно, нельзя требовать от людей хорошего знания языка». Я уж думал, что я последний человек на Земле, который считает, что инструмент надо знать хорошо (справедливости ради, некоторые комментаторы меня в этом поддерживали).
Ан нет, отличная презентация Олве Маудала и Джона Джаггера «Deep C (and C++)» даёт надежду, что я не последний и хорошо показывает различия между посредственным знанием и хорошим.
Первый язык программирования высокого уровня — Планкалкюль ★
Планкалкюль (Plankalkül) — первый в мире язык программирования высокого уровня, разработанный немецким инженером Конрадом Цузе между 1942 и 1946 годами для его компьютера «Z4».

Шла Вторая Мировая Война, Цузе работал в отрыве от учёных других стран, совершенно самостоятельно. За это время он создал не только язык программирования, но и написал на нём 49 страниц программ для оценки шахматных позиций. Полностью его работа была опубликована много позже, в 1972.
Только в 1957 году (работы были начаты в 1954) появился Фортран — язык, который большинство считает первым языком высокого уровня.
«Z4» был
Диалект, который реализуется, назван
Язык довольно богатый, на мой взгляд, для сороковых
Все переменные делятся на четыре вида.
- Variablen (Входные переменные) — это входные переменные подпрограмм, доступны только для чтения начинаются с буквы V и номера;
- Zwischenwert (Значения промежуточные), доступны для чтения и записи, предназначены для хранения промежуточных вычисляемых значения, начинаются с Z и номера;
- Resultatwerte (Результат) — в этих переменных возвращается результат вычисления, начинаются с R и номера;
- Indizes (Индексы) — переменные цикла (аналога for), начинаются с i, дальше может быть номер, номер необходим для организации вложенных циклов.
Доступны три типа переменных. Несмотря на то, что «Z4» умел оперировать числами с плавающей точкой, интерпретатор этого не умеет.
Для целого неотрицательного указывается размерность в битах. Есть две формы записи 0 — один бит, n.0 — «n» бит, например, 8.0 — один байт (8 бит). Кортеж указывается в скобках, например (3.0, 4.0) — это две переменные в три и четыре бита, кортеж должен иметь более одного элемента. Массив записывается через точку, к примеру: 4.5.0 — массив из четырёх элементов по пять бит в каждом, 32.(0, 8.0, 16.0) — 32 кортежа, в каждом из которых три переменных: один бит, восемь и шестнадцать.
«Планкалкюль» явно можно сильно упростить по синтаксису, но современный диалект почти в точности копирует ту запись, которую использовал Цузе, я полагаю, что такой синтаксис родился
Одна из них вычисляет указанное (по порядку) число Фибоначчи:
P0 FactEvgenyStepanischev (V0[:4.0]) => (R0[:10.0])
(0, 1) => (Z0[:10.0], Z1[:10.0])

W1 (V0[:4.0]) [
    i > 0 -> (Z0[:10.0] + Z1[:10.0], Z1[:10.0] - Z0[:10.0]) => (Z1[:10.0], Z0[:10.0])
]

Z1[:10.0] => R0[:10.0]

END
Запускать следует так: открываете страницу с интерпретатором, копируете в окно мою программу, нажимаете «Compile», открывается отдельное окно
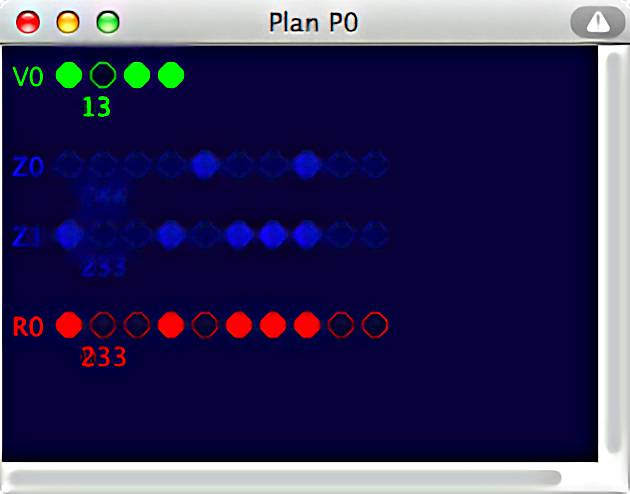
Подпрограммы в языке начинаются с символа P и уникального номера, дальше идёт имя, по которому её можно будет вызвать, у меня подпрограмма называется FactEvgenyStepanischev, заканчивается подпрограмма ключевым словом END (в оригинальном Планкалкюле его не было).
У подпрограммы описываются принимаемые и возвращаемые значения, у меня используется одна переменная на вход, размерностью 4 бита и одна на выход, размерность в 10. Первой строкой присваиваются значения «ноль» и «один» промежуточным переменным Z0 и Z1. Тип переменных приходится указывать при каждом их использовании, преобразовать переменную в другой тип нельзя.
Ниже идёт цикл for (W1), поскольку номер переменной цикла я не указал (указывается в первых квадратных скобках, которые тут опущены), используется переменная цикла i, без номера. В круглых скобках указывается количество повторений, а в последующих квадратных — тело цикла. Подробности можно найти в описании.
Операция «стрелка» (->) — условная конструкция, часть справа будет выполнена, если выражение слева истинно. В диалекте работают только самые простые выражения, например цикл туда подставить можно, но кнопка «Run» в аплете у меня не появилась, поэтому я ограничился присваиванием внутри цикла.
Я тут использовал комплексное присваивание, которое хорошо знакомо тем, кто использует Перл, Пайтон или ПХП, но работает оно иначе — присваивания выполняются последовательно, слева направо, поэтому я не могу ограничиться,
(Z0[:10.0] + Z1[:10.0], Z1[:10.0]) => (Z1[:10.0], Z0[:10.0])результат будет не тот, который ожидается.
В конце я присваиваю промежуточное значение результирующему значению подпрограммы.
Кроме этого в языке почти ничего и нет. Обращение к элементам массива, вызов функции и цикл while описывать отдельно смысла не имеет, они выглядят достаточно естественно в рамках этого синтаксиса. Все операции, поддерживаемые языком (их немного — логические операции, битовые операции и четыре арифметические действия) выглядят привычно.
Многозадачность в «Гоу»
В прошлой своей записи я упомянул многозадачность в «Гоу», а сейчас вспомнил, что я ни разу не показывал как же она там выглядит с точки зрения простого программиста. Покажу на примере.
Предположим, нам нужно вычислить
package main

import (
    "io"
    "os"
    "crypto/sha512"
    "encoding/hex"
    "runtime"
    "strconv"
)

func main () {
    ch := make(chan string)

    N := 3

    runtime.GOMAXPROCS(N)

    for i := 0; i<N; i++ {
        go func (name string, num int, ch chan string) {
            if f, err := os.OpenFile(name, os.O_RDONLY, 0666); err == nil {
                defer f.Close()
                h := sha512.New()

                io.Copy(h, f)

                ch <- strconv.Itoa(num) + ". " + hex.EncodeToString(h.Sum())
            } else {
                panic("Cannot open file")
            }
        }(os.Args[0], i, ch)
    }

    for ; N > 0; N-- {
        print(<-ch, "\n")
    }
}
Что здесь происходит.
Первая строка объявляет имя модуля, для основного модуля программы это имя должно быть «main», эта конструкция скажет компилятору, что именно тут находится входная точка нашей программы. На первый взгляд кажется, что в основном модуле можно было бы просто не указывать имя, но язык придерживается хорошего принципа «явное лучше неявного», чем он мне очень симпатичен.
Дальше, очевидно, подключаются модули, в языке базовых функций почти нет, поэтому даже для такой небольшой программы мне понадобилось шесть модулей: «io» для копирования данных из одного потока в другой, «os» для работы с файлом, «crypto/sha512» для хеширования, «encoding/hex» для кодирования получившейся
Функция main — входная точка основного модуля программы, именно она (как в «Си») вызывается в самом начале.
Далее я создаю (make) небуферизированный «канал» и объявляю, что по нему будут идти строки, конструкция «:=» многим напоминает Паскаль, но отношения к нему не имеет, это синтаксический сахар для создания локальной переменной. «Канал» — это хорошее, говорящее название, хорошо отображающее суть, это действительно канал общения
В цикле создаются и сразу запускаются в фоне (конструкцией «go») на выполнение N
Внутри
Цикл не ждёт выполнения
Дальше идёт второй цикл, где N раз запускается команда на чтение из канала („… <- ch»).
Чтобы убедиться, что
У такой лёгкости использования есть свои ограничения, но об этом
Какой язык программирования изучать на перспективу
Меня тут недавно спросили — какой язык программирования следует изучить на перспективу. Я ответил в том духе, что никаких формальных признаков того, что язык будет перспективен лет через пять, не существует и до сих пор думаю, что прав. В самом деле, если взять «моду» на языки за последние десять лет, видно, что их успех определяется подводными течениями, которые со стороны увидеть трудно, компании неисповедимы, могут «выстрелить»
Правда потом, по пути домой я задумался над этим более глубоко и теперь считаю, что популярность должны набирать языки, в которых легко, на уровне языка, делается параллелизация. Дома у меня меня ремонт сейчас
Над цифрами выше трудятся уже только оверклокеры, заливая штаны жидким азотом. Гонка частот уже, кажется, остановлена, началась гонка за количество ядер. Недавно был выпущен первый смартфон с четырьмя процессорами, а рабочая станция «Мак Про» поставляется в топовой конфигурацией с 12 процессорами. Сегодня на «Хабре» появилась новость о процессоре GA144, который будет продаваться за шестьсот рублей. У него 144 ядра.
Не говоря уже о GPU, у которых количество ядер приближается к тысячам.
Если взять
Причём «легко» не обязательно даже так, как это сделано в «Гоу» (хотя и желательно) — отдельной конструкцией языка (go), нет нужды сводить к этому всю идеологию языка, как в «Эрланге», просто чтобы это делалось, в тривиальных случаях,
Например, на «Пайтоне»
@fork
def sort(arr):
    arr.sort()
    return arr

 # тут функция начала фоном работать
result = sort(somearray)

… много кода …

# а тут уже доступны результаты, если недоступны, то будем ждать
print([el for el in result if el])
Да, это не особо эффективно, нас уже приучили разбрасываться памятью, но ещё не приучили с лёгкостью разбрасываться ядрами, ничего привыкнем, когда их станет, как грязи.
Пока, наверное, верится с трудом. Но мой первый
«Здравствуй, мир» на Коболе
Я
Вот так выглядит моя первая программа на Коболе:
000100*Моя первая программа на Коболе
000200 IDENTIFICATION DIVISION.
000300 PROGRAM-ID. hw.
000400 AUTHOR. Evgeny Stepanischev
000500 PROCEDURE DIVISION.
000600      DISPLAY "Привет, мир!".
000700      STOP RUN.
Первые шесть символов каждой строки — её номер, как легко догадаться. В современном Коболе их можно опустить (OpenCobol поддерживает этот синтаксис с ключом
В старом Коболе очень жёсткий порядок всего и вся. Мало того, что секции программы должны быть описано в строгом порядке, так ещё и столбец тоже имеет значение! То есть Кобол строго следит за отступами. Например, мой код с DISPLAY и STOP RUN начинается
Язык очень многословный и имеет целую тучу зарезервированных слов, некоторые из которых весьма доставляют:
bolk@Bolk ~/Projects/Cobol  $ cobc --list-reserved | wc -l
     530

bolk@Bolk ~/Projects/Cobol  $ cobc --list-reserved | egrep '[[:digit:]]' | egrep -v 'UTF|UCS|FLOAT'
COMP-1				(Y)
COMP-2				(Y)
COMP-3				(Y)
COMP-4				(Y)
COMP-5				(Y)
COMPUTATIONAL-1			(Y)
COMPUTATIONAL-2			(Y)
COMPUTATIONAL-3			(Y)
COMPUTATIONAL-4			(Y)
COMPUTATIONAL-5			(Y)
STANDARD-1			(Y)
STANDARD-2			(Y)
SUB-QUEUE-1			(N)
SUB-QUEUE-2			(N)
SUB-QUEUE-3			(N)
Как я буду учить это всё великолепие, пока не знаю, не уверен, что интерес к языку у меня настолько глубок. Впрочем, может оказаться, что бо́льшая часть из указанных 530 зарезервированных слов нужны в жизни очень редко. А ещё, бегло пробежавшись по документации, я нашёл большое количество синонимов. За примерами далеко ходить не надо,
Как заменить табы, используя sed
Утилита командной строки sed (это потоковый редактор),
Я немного поэксперементировал, оказалось, что sed вполне воспринимает этот символ как таковой, а все «магические выражения» не работают. Поскольку «таб» имеет специальное значение в командной строке, ввести его можно либо через комбинацию Ctrl+V, tab, либо Ctrl+V, Ctrl+I. Во многих шеллах (например, в bash, ksh, sh) сработает специальный синтаксис с долларом, как в примере ниже.
Например, если вам надо заменить последовательные «табы» на один, то это может выглядеть вот так:
sed $'s/\t\t*/\t/g' sample.txt # именно \t\t*, а не \t+

# или

sed -E $'s/\t+/\t/g' sample.txt # в Линуксе ключ „-r“
Если вы знаете как в sed можно работать с tab проще, расскажите, пожалуйста, в комментариях.
Почему не следует расширять встроенные типы JavaScript
На Хабре хорошая статья — «
Зачем я учу языки программирования
Наверное многие заметили что время от времени я глубоко погружаюсь
Недавно я написал, что поставил себе Кобол на Мак, у многих возник вполне закономерный вопрос — зачем?
Тут дело несколько в ином. Я хочу увидеть как всё начиналось, Кобол — один из первых языков с читаемым англоязычным синтаксисом, с революционными идеями, которые теперь кажутся очень странными. Есть и ещё причина. На Коболе до сих написано больше всего кода (по крайней мере в банковской сфере и правительственной), специалисты по Коболу стоят очень дорого (просто потому что их очень мало), и мне показалось забавным увеличить свою стоимость как программиста изучением Кобола. Это не значит, что я хотел бы программировать на этом языке профессионально. Упаси боже.