GPU: RTX 6000 Pro vs H100 на FP8
Так, кто там у меня в комментариях в телеграмном канале спрашивал о сравнении наших графических ускорителей при работе с сетями, квантованными до FP8 (однобайтового типа с плавающей точкой)?
Табличка ниже, использовался «Квен 3.5» с 35 миллиардами параметров (A3B).
Что мы тут видим? А видим мы очень интересную штуку: оказывается, ускорители H100 бывают очень разными. Инференс нашей тестовой модели показывает, что NVIDIA H100 NVL
Сравнение полноразмерного «Квена 3» я уже у себя публиковал.

Чтение образов NeXTSTEP
Если вам (ну вдруг)
Мне пришлось заняться этим вопросом, потому что я надеялся, что внутри одного из найденных образов этой системы меня могут ждать новые открытия, связанные с браузером «Виола».
Пользоваться утилитой не очень удобно, особенно если не вполне ясно что ищешь, но её довольно просто подключить к известному файловому менеджеру mc (Midnight Commander).
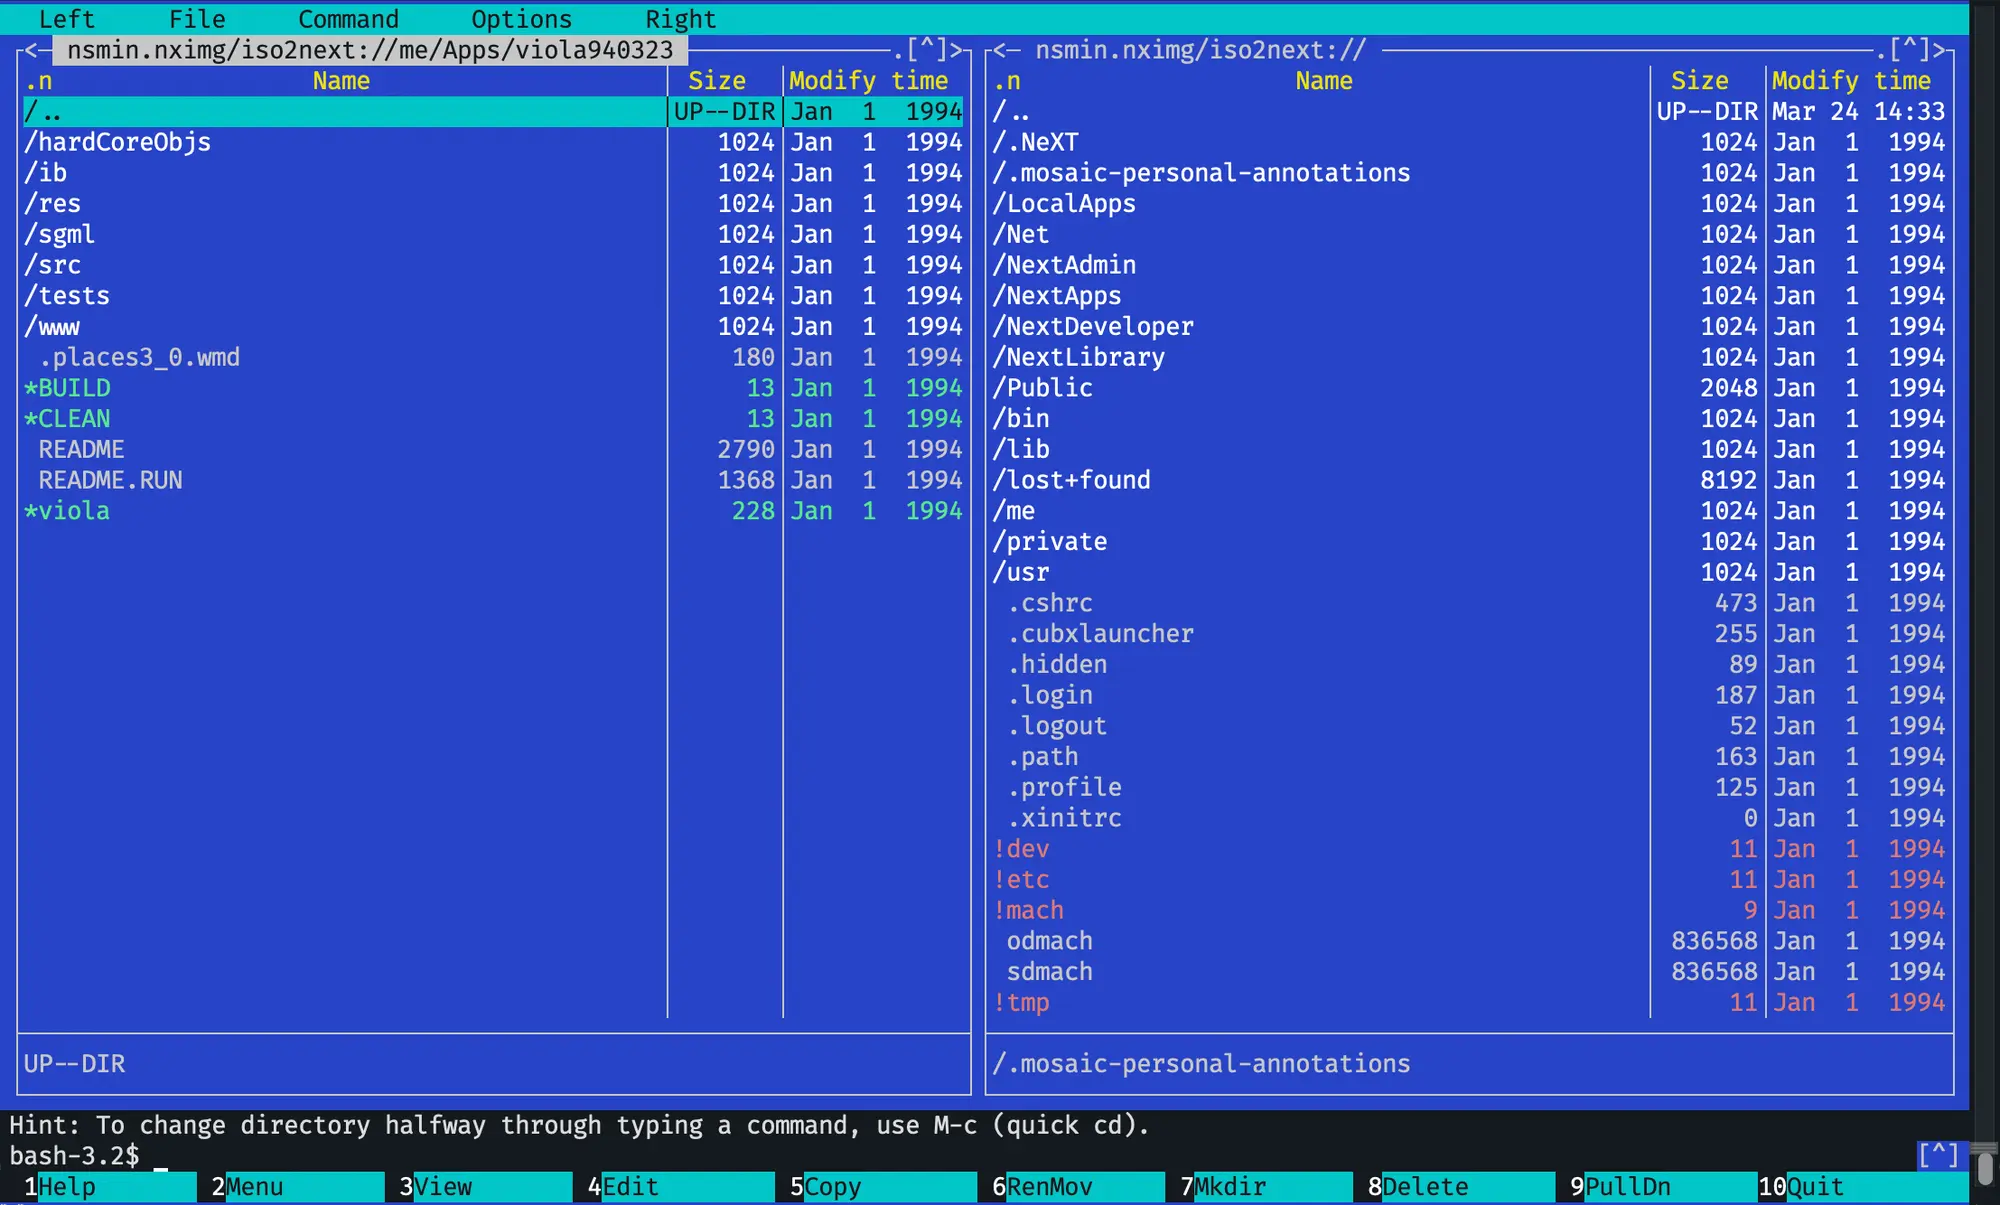
Достаточно написать обёртку, которая принимает на вход две команды — list (выдача списка файлов в директории) и copyout (копирование указанного файла в указанный путь), — и всё заработает.
Правда у исходной утилиты в листинге отсутствуют некоторые необходимые поля (в частности — дата), поэтому мне пришлось добавить заглушки на эти позиции. Я уже отправил автору утилиты патч, который устраняет этот недостаток (заодно я пару багов нашёл и исправил).
К сожалению, ничего полезного внутри образа я не нашёл, но опыт интересный.
Обработка фоток ИИ
После критики в комментариях вернулся к консервативной обработке фоток — вручную выравниваю вертикали и тяну яркость с контрастностью. Нейросетями решил пользоваться только в крайних случаях, например, когда надо иллюстрацию к идее нарисовать или уж совсем убитую фотку вытянуть (но в этом случае буду подписывать, что это реконструкция).
TOIlet: цветные шрифты
Вчера я писал, что цветные шрифты — не самое важное расширение стандарта FIGlet. От своих слов я не отказываюсь, но это расширение точно одно из самых весёлых.
Напомню, что это шрифты, которые составлены из текстовых символов. Они могут использовать там, где, кроме текста, ничего нет — например, в текстовых файлах, в письмах без оформления, в консоли и так далее.
Идея цветных шрифтов простая: в консоли можно использовать цвета, которые задаются специальными управляющими последовательностями. Терминал не выводит их на экран как текст, а воспринимает как команды. Например: «с этого места рисуй всё зелёным».
Таких последовательностей довольно много, но для управления цветом обычно используют несколько основных режимов.
Немного истории. Сначала появились базовые цвета — классический набор из восьми цветов. Потом к нему добавили яркие варианты, и в результате получилась
Терминалы работают с разными палитрами, что они, как правило, умеют сообщать через переменные окружения. Например, у меня на «Маке» есть переменная COLORTERM со значением truecolor, что означает, что моему терминал можно отсылать

Когда я начал разбираться с форматом шрифтов TOIlet и библиотекой libcaca, которая их отображает (автор большой оригинал, да), оказалось, что внутри реализована идея цветных шрифтов, но ни одного примера такого шрифта нет. Судя по коду, он слегка не дописан, но тем не менее, вполне работоспособен, жаль только автор остановился на палитре из 16 цветов.
Так что, первое, что я сделал — создал из набора стандартных эмодзи цветной шрифт в формате TOIlet, где смайлики составлены из раскрашенных юникодных блочных символов. Результат мне не особо понравился. Например, местами некоторые оттенки жёлтого у меня съехали в белый
Я подумал, что было бы здорово расширить формат, но так, чтобы утилита toilet
Если посмотреть как libcaca парсит управляющие коды, то мы заметим, что парсер достаточно вольно обращается с грамматикой, не реагируя на некоторые ошибки, например, он пропускает все управляющие числа большие 107.
for(j = 0; j < argc; j++)
{
    /* Defined in ECMA-48 8.3.117: SGR - SELECT GRAPHIC RENDITION */
    if(argv[j] >= 30 && argv[j] <= 37)
        im->fg = ansi2caca[argv[j] - 30];
    else if(argv[j] >= 40 && argv[j] <= 47)
        im->bg = ansi2caca[argv[j] - 40];
    else if(argv[j] >= 90 && argv[j] <= 97)
        im->fg = ansi2caca[argv[j] - 90] + 8;
    else if(argv[j] >= 100 && argv[j] <= 107)
        im->bg = ansi2caca[argv[j] - 100] + 8;
    else switch(argv[j])
    {
        // парсятся 1—9, 21-29, 38, 39, 48—50

        default:
            debug("ansi import: unknown sgr %i", argv[j]);
            break;
        }
    }
}
Поэтому идея возникла такая. При кодировании цвета TOIlet использует цвет фона и шрифта, чтобы точнее имитировать пиксели в текстовом режиме. Иногда используется только один из них, чтобы реализовывать условную прозрачность. Это я пишу, чтобы рассказать, что у нас есть три варианта — указан цвет фона, указан цвет шрифта или указаны оба.
Если сразу за цветом в палитре из 16 цветов писать значение цвета, к которому я прибавлю такое число, чтобы оно гарантировано пропускалось парсером libcaca, то смогу спрятать от него там более точные значения цвета.
Например: \e[31;287;41;297m. Тут \e[ — начало специальной последовательности управляющих кодов (\e в реальности — символ с кодом 27, он никак не отображается, а только говорит, что дальше идёт команда).
Потом 31 — установка фона в красный, 287 — код цвета
Следующим идёт, как возможно вы уже догадались, установка цвета шрифта, 41 — это тоже красный цвет, но для шрифта, коды разные, надо же отличать что именно мы устаналиваем. За ним — 297, принцип тот же, но так как тут значение идёт сразу после кода установки цвета шрифта, то мы понимаем, что и тут ставится цвет шрифта.
Символ m закрывает управляющую последовательность.
Таким образом утилита toilet и её библиотека libcaca увидят последовательность \e[31;41m, а мой парсер выкинет числа
При этом, если мой парсер таких числе не видит, то он читает цвет
С цветом RGB работает всё так же, только прибавляем 512. Правда цвет у меня кодируется в обратном порядке — BGR, потому что синяя компонента у́же всего используется в эмоджи, а красная — шире, поэтому если развернуть значения, числа получаются меньше и шрифт становится компактнее. Я думаю это оттого, что синий цвет хуже распознаётся глазом, недаром все градиенты во времена эпохи 256 цветов на мониторах старались делать синими.
Шрифты, конечно, получаются просто огромными — по несколько мегабайт, но здесь помогает сжатие: и FIGlet, и TOIlet поддерживают сжатые шрифты.
Для конвертации эмодзи я написал конвертер на «Пайтоне», который преобразует их в шрифт отдельно в 256 цветах и в полноцветной палитре: хранить все варианты цветов было бы слишком накладно. А библиотека при отображении уже сама приближает цвет, если это требуется для конкретного терминала.
Вот, кстати, где ИИ сильно у меня начал буксовать — на задаче как компактнее спрятать новые цвета в старом формате. Сначала пришлось подумать самому, а потом уже пошло веселее — «Опус 4.6», который я не устаю нахваливать, подхватил идею и мы с ним быстро проверили различные гипотезы.
Добавлено позднее: реализацию всего вышесказанного можно увидеть в моём репозитории на «Гитхабе».
Figlet: шрифты из текста
Думаю, когда человек впервые увидел слова, которые вывел первый компьютер на первый дисплей, сразу же захотел большего — вывести туда ещё и картину. Но первые дисплеи были

С этим типом «графики» (не уверен, нужны ли кавычки) я впервые столкнулся за первым компьютером, на котором начал программировать, —
Позже, когда у меня появился ПК, такого рода графика мне время от времени встречалась в различных текстовых файлах. Особенно часто её использовали как одну из форм самовыражения ребята, пиратившие софт. В их сопроводительных файлах её было навалом. А когда я попал в интернет
                          ________________
                         /      MAKE      \
          ___________   /   AMERICA GREAT  \
       (_(  ___ ___  )  \      AGAIN!      /
       /_/-( c) (c )< \  \   _____________/
       | |    <_      |   | /
       |_| '  ()  '   | ___/
      __\_  ( __ )  _/__
  / /|   \        /    |\ \
 (    )    ~      ~    (    )
(    |\  ( .     . )   /|    )
 (   ) \  --     --   / (   )
 |  ,| |     ___     | ,|   |
 \__/ \|  / - | - \  |/ \__/
  \oooO\_____________/Oooo/
        \   _____   /
         \. p | m ./
         | \_____/ |
        /    / \    \
       (____)  (____)
      /_____|  |_____\
    ___|   |    |   |___
   (_______|    |_______)
Не скажу, что я специально искал
Среди такой графики попадались и надписи, сделанные подобным образом, — странная, казалось бы, идея: писать буквы другими буквами. Но таким способом можно было имитировать различные шрифты или, например, рукописное начертание.
 ,ggggggggggg,     _,gggggg,_      ,ggggggggggg,     _,gggggg,_      ,ggg,        gg
dP"""88""""""Y8, ,d8P""d8P"Y8b,   dP"""88""""""Y8, ,d8P""d8P"Y8b,   dP""Y8b       88
Yb,  88      `8b,d8’   Y8   "8b,dPYb,  88      `8b,d8’   Y8   "8b,dPYb, `88       88
 `"  88      ,8Pd8’    `Ybaaad88P’ `"  88      ,8Pd8’    `Ybaaad88P’ `"  88       88
     88aaaad8P" 8P       `""""Y8       88aaaad8P" 8P       `""""Y8       88aaaaaaa88
     88""""Y8ba 8b            d8       88"""""    8b            d8       88"""""""88
     88      `8bY8,          ,8P       88         Y8,          ,8P       88       88
     88      ,8P`Y8,        ,8P’       88         `Y8,        ,8P’       88       88
     88_____,d8’ `Y8b,,__,,d8P’        88          `Y8b,,__,,d8P’        88       Y8,
    88888888P"     `"Y8888P"’          88            `"Y8888P"’          88       `Y8
В 1991 году
Когда я ей заинтересовался в двухтысячных, по сети уже гуляло несколько сотен разных шрифтов. Восемьсот или около того. Мне очень хотелось разобраться как это всё работает.
Я тогда писал много пакетов для ПХП, мне очень нравился этот язык и очень хотелось

Основное отличие — шрифты стали юникодными: для поддержки символов за пределами одного байта больше не приходится делать отдельный файл с перекодировкой. Кроме того, появились цветные шрифты, но это, на мой взгляд, всё же менее важно.
Когда я начал переписывать свою библиотеку с помощью ИИ, я даже не подозревал, насколько глубока кроличья нора. В очередной раз хочу сказать, насколько сильно ИИ уже изменил и ещё изменит расклад в разработке. Если бы я переписывал эту библиотеку исключительно вручную, мне пришлось бы пойти на ряд компромиссов ради экономии времени. ИИ же позволяет удовлетворить перфекционизм почти любого уровня — только плати деньги.
Раздача интернета и «Айфон»
Столкнулся тут с одной странной штукой. Недавно жена решила сменить оператора в машине, чтобы платить поменьше: старый оператор не только поднял цены, но, похоже, ещё и начал мухлевать с трафиком. Новая симка в машине пока нормально не прижилась — надо разбираться, но всё
Но вот странность: у меня всё работает нормально, а у жены на «Айфоне» «Режим модема» включается, но машина эту точку доступа просто не видит. Решил разобраться — и выяснилось, что мой смартфон её тоже не видит.
На этом месте я, честно говоря, приуныл: первой мыслью было, что проблема в железе. Но потом
Мы с женой пользуемся
Так и оказалось. Поменял APN — и всё сразу заработало.
Что особенно прекрасно: «Айфон» вообще никак не пытался объяснить, в чём проблема. Просто делал вид, что всё в порядке: «Режим модема» включался, но точка доступа при этом фактически не поднималась.
Но что ещё страннее, — потом я вспомнил, что я у себя на «Андроиде» настройки тоже много лет не трогал, но у меня точка доступа работает нормально.
Возвращение Text_Figlet
Нейросеть «Опус 4.6», конечно, жрёт невероятное количество денег.
Я сделал небольшую паузу в парном программировании с ней, но недавно не выдержал, потому что решил потихоньку заняться тем, до чего у меня много лет не доходили руки, — закончить или переделать некоторые проекты. Наверное,
У меня уже много лет чешутся руки переделать мою старенькую библиотеку Text_Figlet. Это, наверное, самое популярное моё детище — она время от времени встречается мне
Библиотека написана на ПХП и умеет выводить текст специальными
«Смашинг» был сделан только по горизонтали; вертикальный алгоритм я в своё время не дописал, и этот факт — одна из причин, почему мне захотелось вернуться к библиотеке.
 _  _     _ _                        _    _ _

| || |___| | |___    __ __ _____ _ _| |__| | |

| __ / -_) | / _ \_  \ V  V / _ \ '_| / _` |_|

|_||_\___|_|_\___( )  \_/\_/\___/_| |_\__,_(_)

                 |/
В итоге я так разогнался, что полностью переписал библиотеку при помощи нейросетей, реализовав всё задуманное и даже больше — например, добавил поддержку шрифтов «TOIlet» и цветных фильтров для них, а также покрыл всё тестами и подготовил библиотеку к установке через «композер».
Звуки китов
Очень люблю истории о том, как учёным удаётся найти
Вчера прочитал, что исследователи и архивисты Океанографического института
В то время исследователи на борту
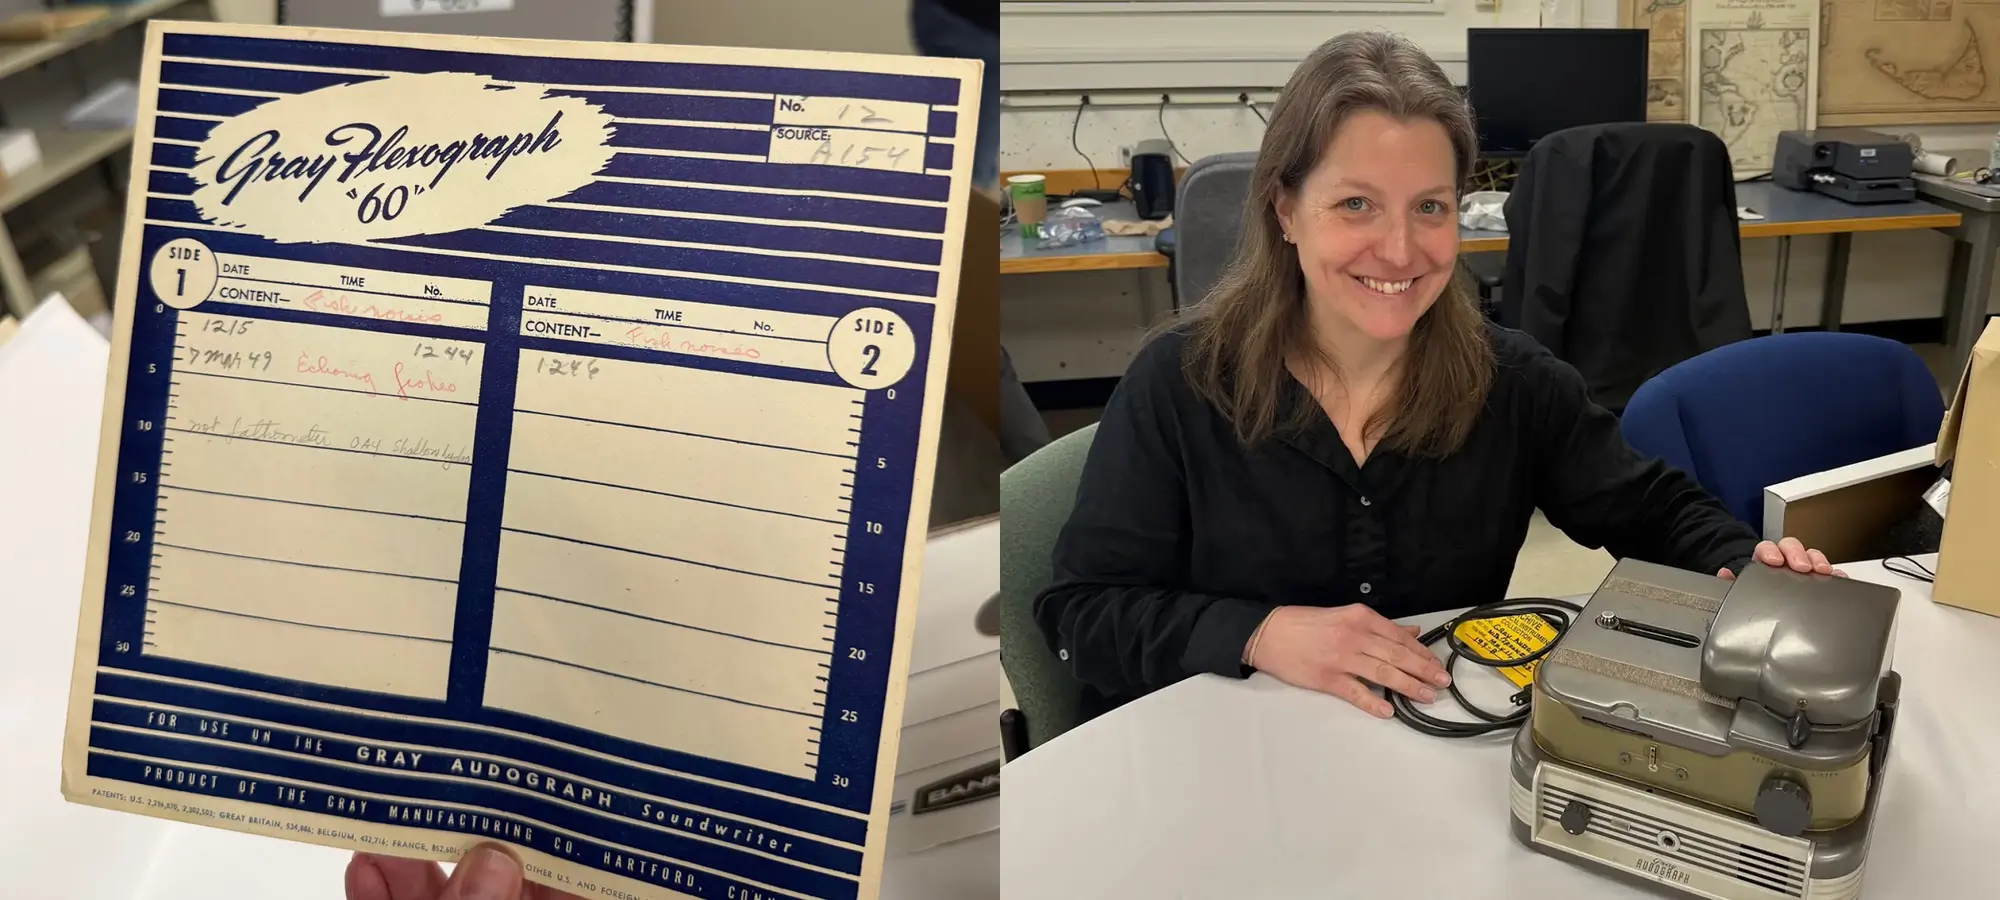
На фотографии слева конверт в котором хранилась найденная запись, а справа — диктофон, который записывал звук.
В статье, которую я читал, говорилось, что учёных поразило, насколько тише был тогда океан: сегодня уровень шумового загрязнения в нём значительно выше. Эта запись ценна ещё и как редкая акустическая точка отсчёта — она позволяет хотя бы приблизительно понять, как звучал океан до эпохи нынешнего интенсивного судоходства и других антропогенных шумов.
Меня же поразило другое: я никогда не задумывался, что пение китов вообще можно услышать человеческим ухом. Видимо, я путал его со звуками дельфинов: у зубатых китообразных, к которым относятся и дельфины, многие сигналы действительно лежат в очень высоком, в том числе ультразвуковом диапазоне.
Я попробовал разобраться подробнее и, насколько понял, обобщать тут нельзя: у разных китов всё
А вот у некоторых других усатых китов, например синих, сигналы часто уходят в слишком низкие частоты и воспринимаются уже не как обычный звук, а скорее как низкочастотная вибрация — или вовсе остаются за пределами слуха человека.
GPU: RTX 6000 Pro vs H100
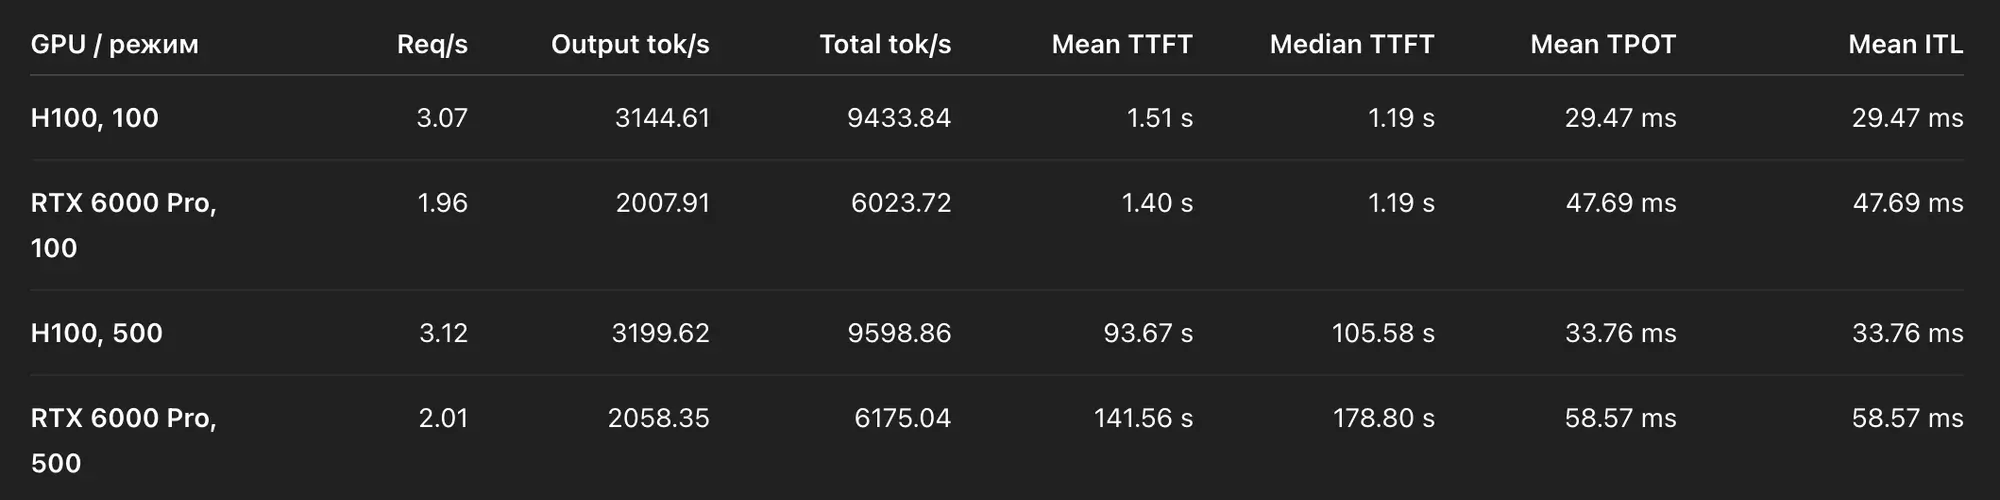
Провели тестирование графического ускорителя NVIDIA RTX 6000 Pro WE в сравнении с NVIDIA H100. Тестировали в разных режимах, с нейросетью «Квен3» с 30 миллиардами параметров, без квантования. Тесты включали и синтетику, и реальные наши задачи; мы даже подключили ускоритель к «боевой» инсталляции и наблюдали за разницей. Обучение не тестировали, так как у нас таких задач почти нет: нас больше интересовало, как будут вести себя большие языковые модели.
Все цифры публиковать не буду, но небольшую статистику по синтетическому тесту всё же приведу. Вывод такой: на реальных наших данных разницы мы не заметили, а в синтетике H100 производительнее в 1,55—1,6 раза.
Учитывая разницу в стоимости примерно в три раза, RTX 6000 Pro выглядит более выгодным вариантом для покупки, но с оговоркой: для моделей, которые не помещаются в память одной карты, H100 (или ещё более старшие модели) предпочтительнее, так как у таких карт есть собственная высокоскоростная шина для обмена данными, и общая производительность такого решения должна превосходить производительность карт RTX 6000 Pro, соединённых по обычной шине.
Опознать по голосу

Кажется, я очень неплохо распознаю лица, лучше среднего человека: например, я сразу понял, что Леса Гроссмана в фильме «Солдаты неудачи» (2008) играет Том Круз, едва он появился в кадре. Насколько я знаю, мало кто понял, что это он. Или я не путаю Натали Портман и Киру Найтли, да и вообще многих актёров, которых большинство людей считает почти неразличимыми.
Но вот с голосами
Недавно
У вас так же?
ИИ: поиск уязвимостей
Изучил несколько статей о поиске уязвимостей с помощью нейросетей. Вынужден признать, что не всё так просто, как я полагал ранее. По всей видимости, нейросети всё же способны
Во многих статьях фигурирует «Опус 4.6», что полностью совпадает с моими ощущениями: эта сеть — действительно ощутимый шаг вперёд. Но использовать её пока очень дорого: бюджет на токены она поедает очень быстро. Я пока поставил на паузу «Виолу» и решил, что это хобби съедает слишком много денег.
Вернёмся к уязвимостям. На «Хабре» есть очень показательная статья — «Техдиректор Microsoft Azure с помощью Claude AI обнаружил ошибки
Анализаторы кода не использовались, да и вряд ли они есть для настолько старого ассемблера. Так что в этом смысле это должен быть довольно чистый эксперимент. Моя прежняя попытка читать ассемблерный код нейросетями показала, что существующие на тот момент нейросети справлялись не очень, но видимо «Опус 4.6» продвинулся и в этом.
В общем, думаю, в этом году отрасль побьёт все рекорды по объёму выплат в рамках программ вознаграждения за поиск уязвимостей. Наверняка компании пересмотрят свои программы и будут самостоятельно привлекать нейросети.
Хищные растения
Выбирая дочке подарок на 8 Марта, гулял по одному из местных торговых центров, где проводилась
Я даже купил себе
В торговом центре продавалось несколько видов хищных растений — росянка, жирянка и мухоловка. Я, так и не определившись, купил всё, что было. Теперь у нас дома надо кормить ещё один комплект существ. Впрочем, надеюсь, с приходом весны они сами себе
Дочка каждое утро льёт воду из пипетки в оба горшка — именно так их и положено поливать, — и сделала попытку покормить растения белковым кормом для улиток. Вроде бы им не понравилось:
А сегодня мы обнаружили, что одна из жирянок выпустила очень трогательный розовый цветочек, смотрится очень красиво. Сфотографировал на память.

Удаление родинок
За прошлый год у меня на шее выросла длинная родинка, которая мне очень не нравилась. Вообще, у меня на теле было несколько таких, но жить они мне не мешали, потому что находились в местах, скрытых под одеждой.
Я сразу решил её удалить,
В общем, недавно я решил, что время пришло. Выбрал клинику так, как обычно делаю в последнее время: дал нейросети задание составить для меня рейтинг, потом почитал отзывы, записался на приём и пошёл удалять.
Изначально мысль была такая — начать с одной, а потом, возможно, сходить на второй приём и удалить остальные. Но в процессе приёма врач настолько расположил меня к себе, что я попросил удалить всё, что он посчитает нужным.
В итоге вчера мне удалили 26 родинок, большинство из которых едва выступали над кожей. Теперь неделю нужно будет обрабатывать ранки два раза в день раствором, который мне выдали в клинике, а затем ещё около месяца наносить на них специальный спрей, чтобы снизить риск образования рубцов.
Вся процедура прошла очень быстро и относительно комфортно. Всё, что я чувствовал, — это уколы лидокаина и лёгкий запах горелой кожи. Я думал, что когда анестезия отойдёт, буду сходить с ума от боли, но на практике ранки почти не ощущаются, даже когда трутся об одежду.
Учитывая почти полную безболезненность процедуры (за исключением самих уколов), ожидаемый результат, как мне кажется, того стоит: родинка на шее меня очень раздражала, а некоторые другие родинки иногда могли травмироваться в походах, что, вроде, некоторыми врачами считается опасным.
Актёр Дэвид Кэррадайн
По случаю выходного дня сегодня пересматривал комедию «Большой Стэн» (2007). Не великое кино, но, как по мне, фильм неплохой — самое то, чтобы снять напряжение рабочей недели. В фильме есть персонаж Мастер — явная пародия на Билла из тарантиновской дилогии «Убить Билла». Ещё обоих персонажей играет один и тот же актёр — Дэвид Кэррадайн.
Закончив просмотр, я понял, что не могу вспомнить, где он ещё играл, и пошёл в «Википедию» смотреть его фильмографию, попутно отметив, что актёр умер в 2009 году.
Каково же было моё удивление, когда я обнаружил, что и после смерти актёр,
Больше половины вышли на следующий год после его смерти, что легко объяснимо, конечно, но как быть с остальными? Я сначала подумал, что речь идёт
Оказалось, что всё проще — актёра частенько приглашали сниматься на небольшие роли независимые студии
Некоторые из таких фильмов долго лежали
Отгадки на загадки из музея МВД
Публикую отгадки на загадки из музея МВД.
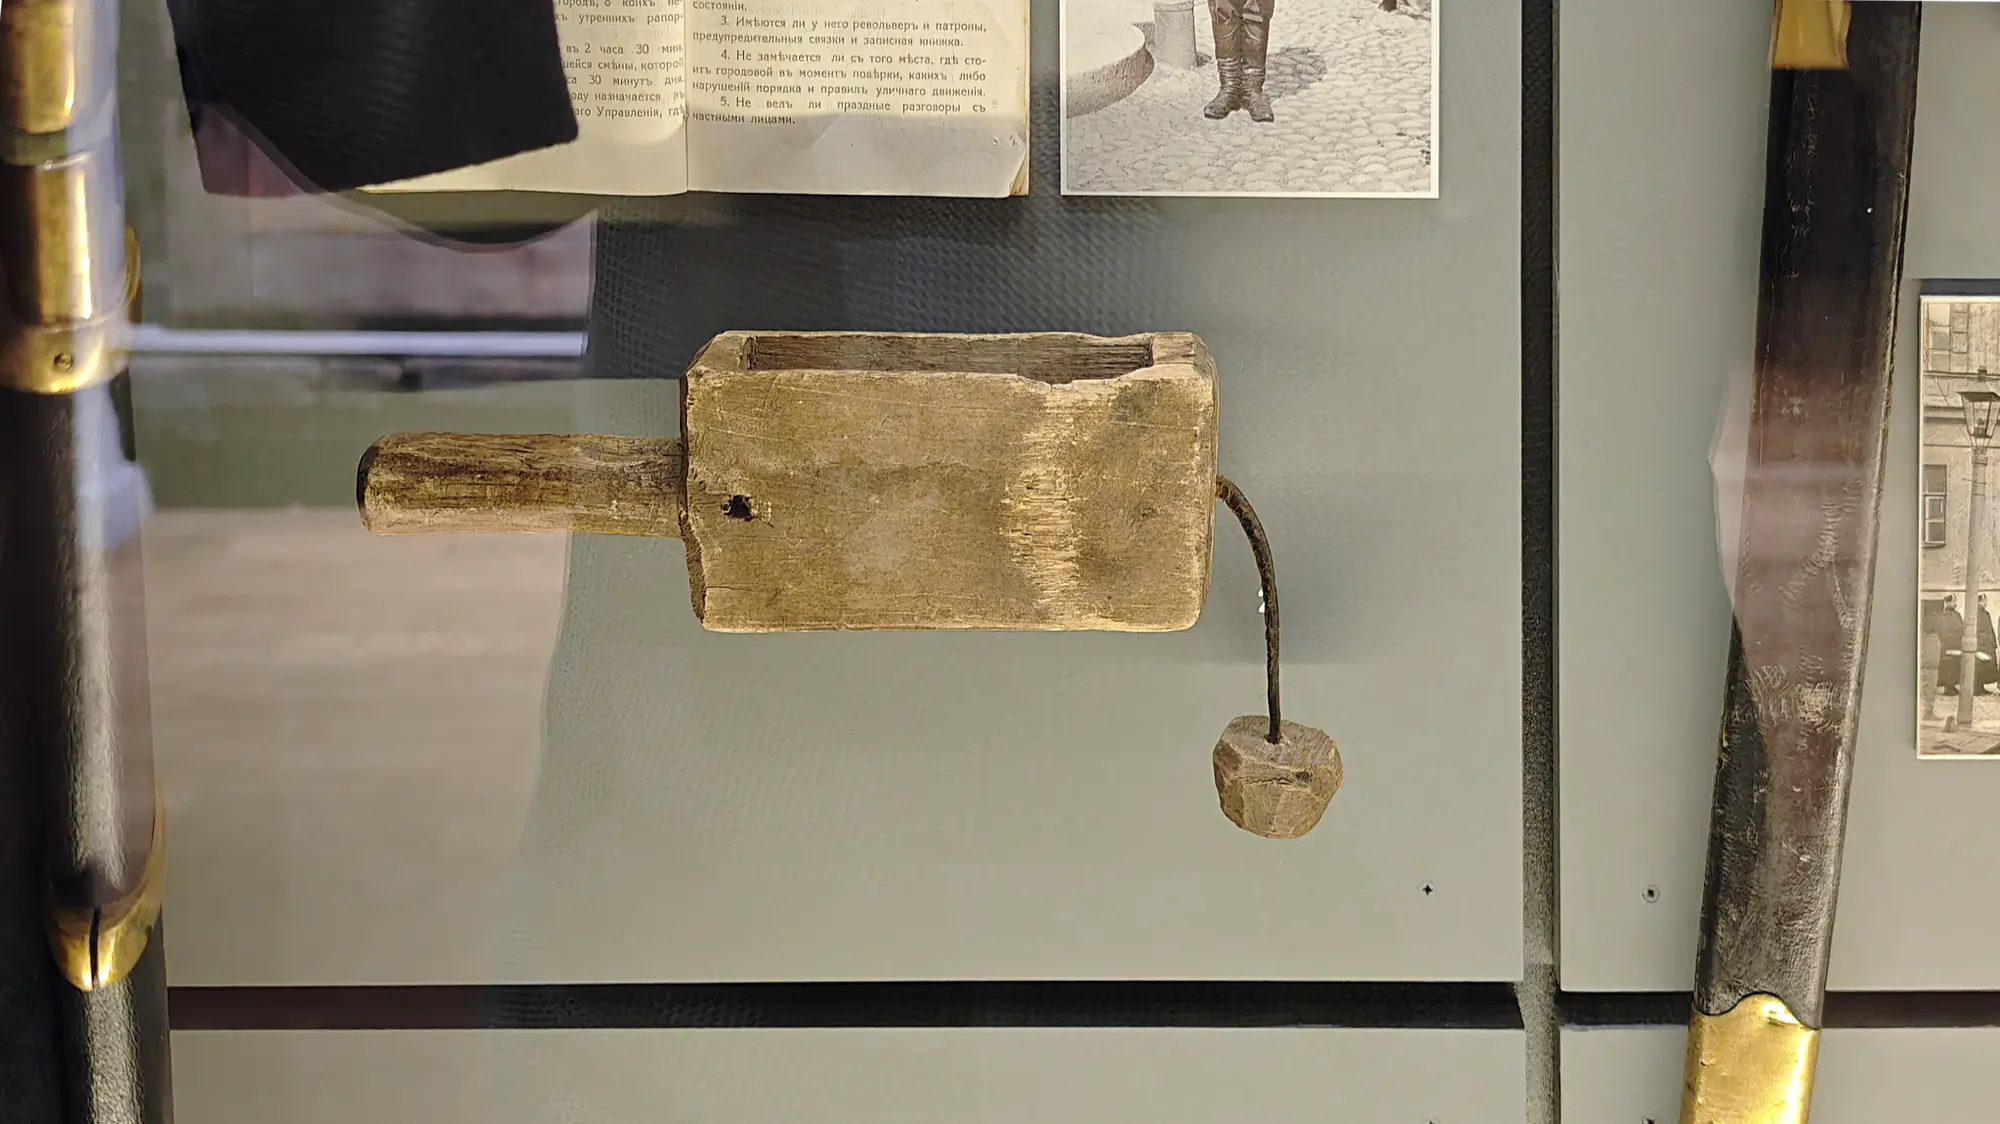
С первой загадкой проблем особых не возникло — в разных местах, где я опубликовал эти загадки, читатели легко опознали колотушку ночного сторожа. Звук колотушки означал, что сторож
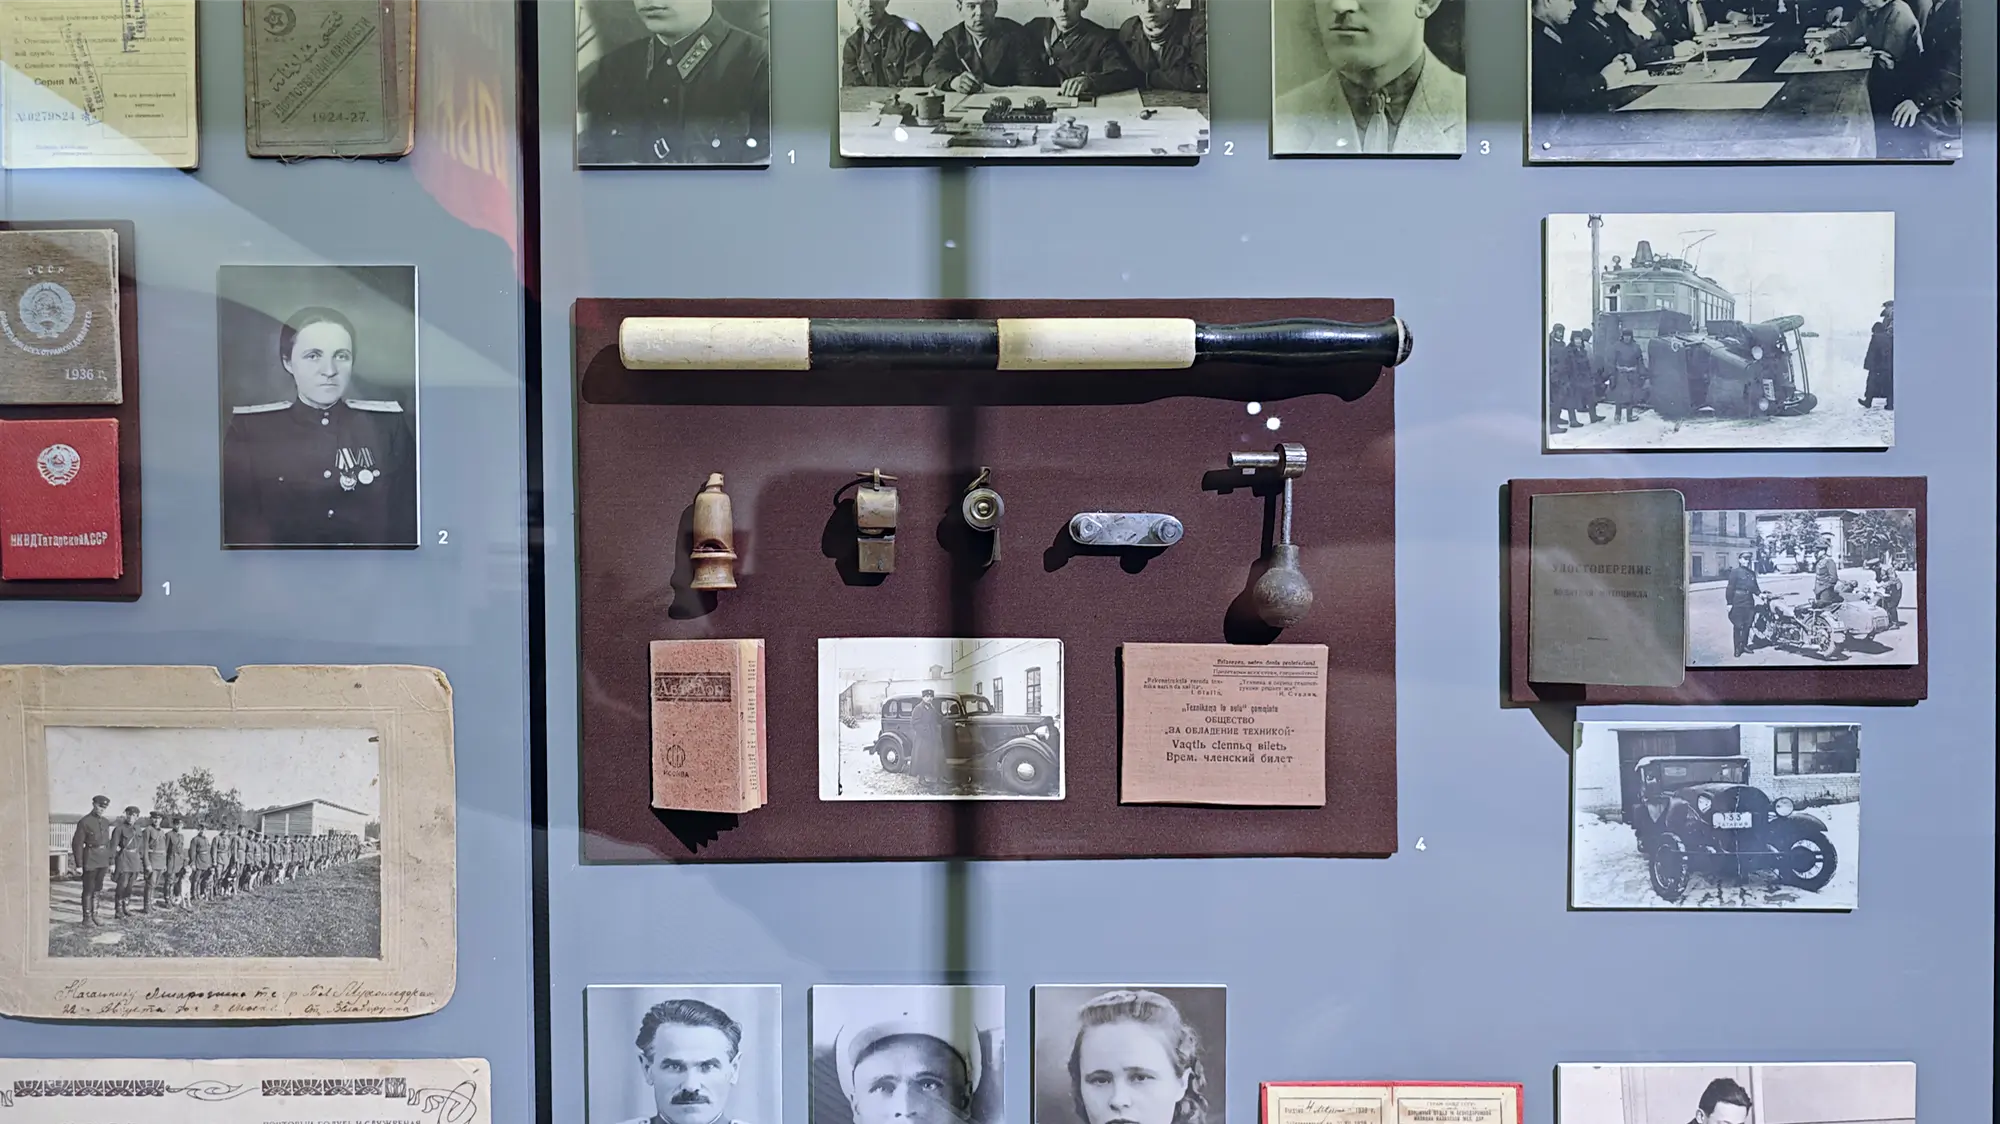
Я думал, что больше всего проблем будет с третьей загадкой, но читатели верно достроили логический ряд по окружающим предметам и догадались, что это ключ для ручного переключения светофора.
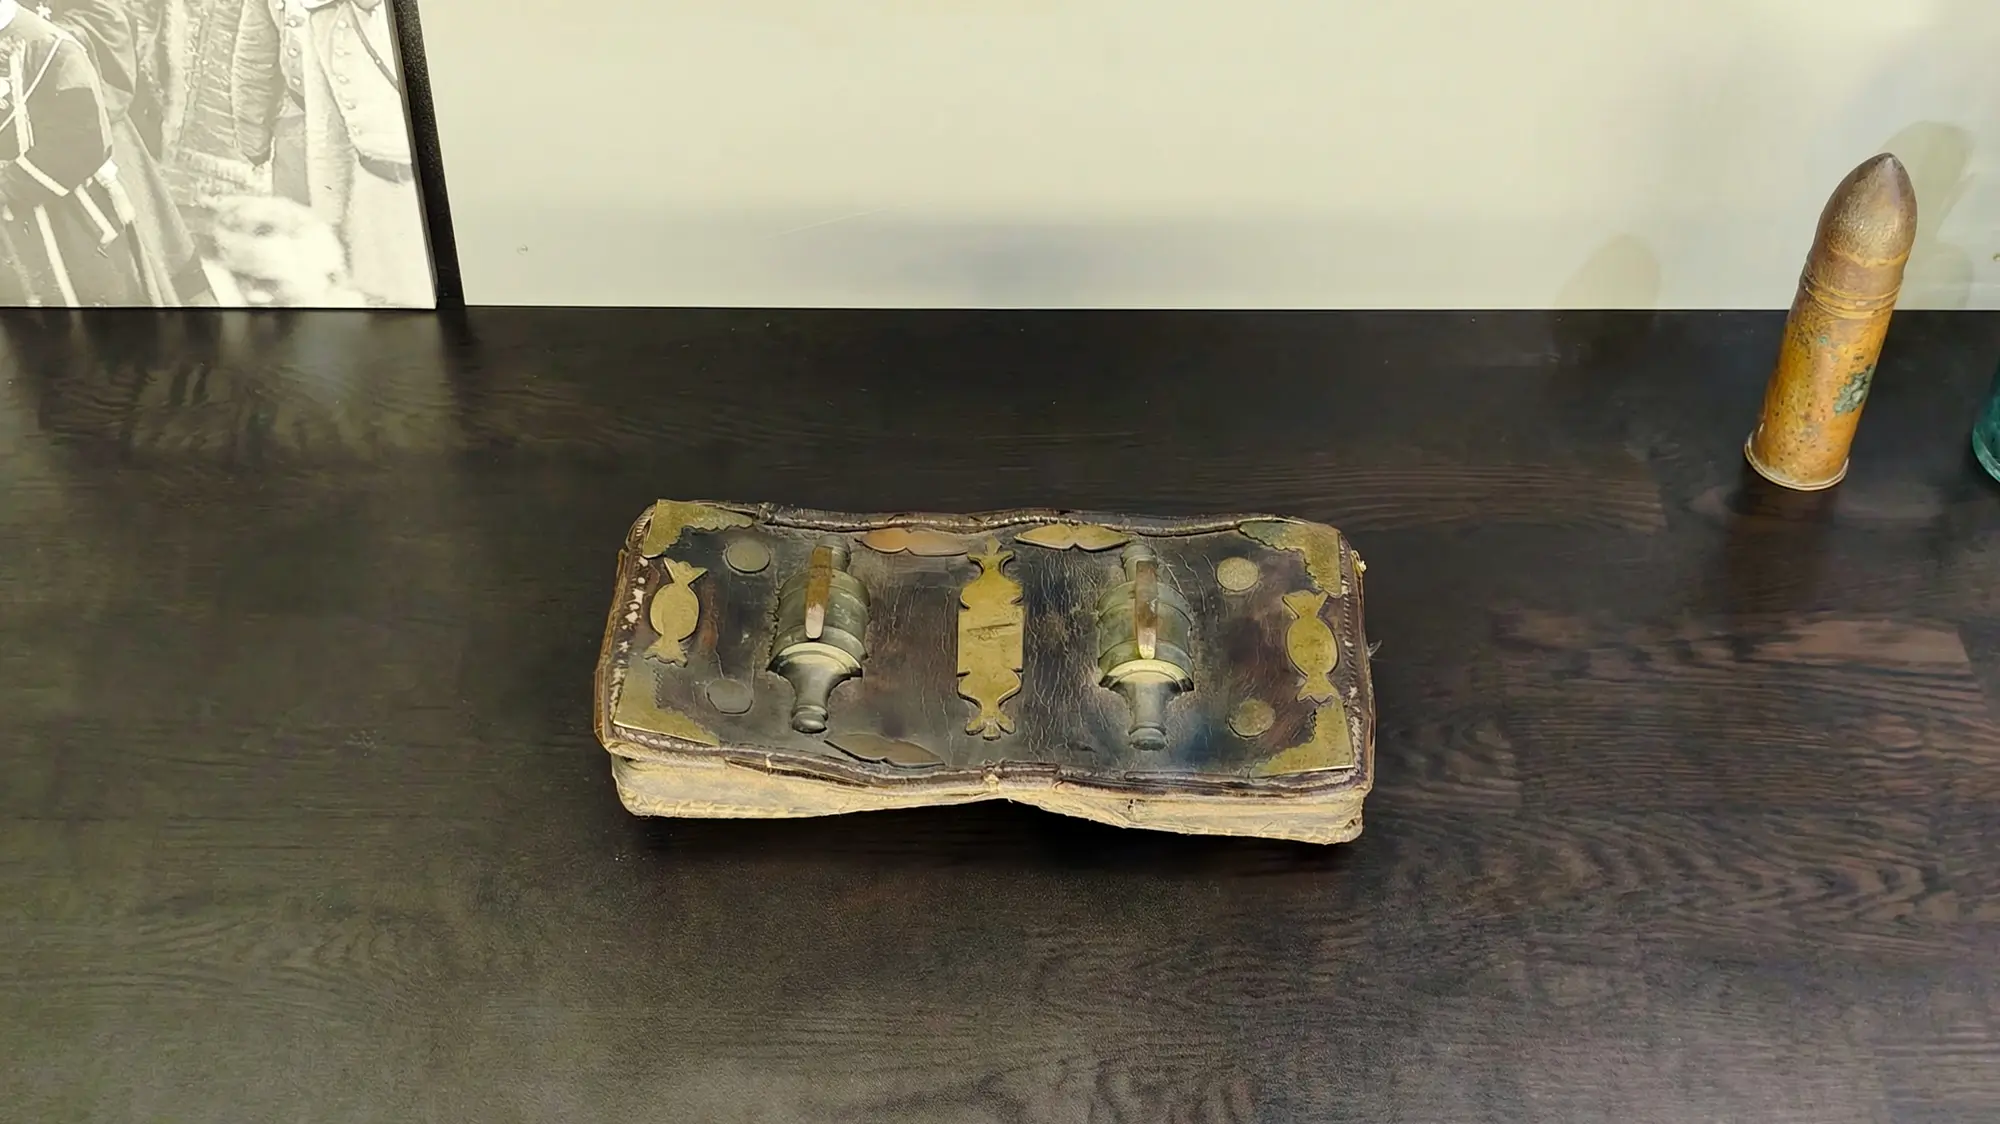
А вот назначение второго предмета никто не угадал. Это подхомутник — штука, которую кладут под хомут на шею лошади, чтобы снизить давление и уменьшить трение.
Загадки из музея МВД
Разбирал тут на днях фотки из казанского музея МВД, где я побывал несколько месяцев назад и понял, что не выложил подборку фотографий с загадками, которые я иногда загадываю читателям по случаю, если в музеях, которые я посещаю, есть
Первая загадка — самая простая. Догадайтесь что за предмет. Имеет непосредственное отношение к охране правопорядка.
Вторая загадка сложнее. Этот предмет хоть и лежит в музее МВД, но в принципе мог бы лежать в любом нетематическом сельском музее.
Третья загадка — самая сложная. Из разряда «если не знаешь, то не догадаешься», по крайней мере я бы не догадался. Для чего предназначался
Ответы выложу
Дополнено: отгадки выложил отдельным постом.
ИИ: поиск ошибок в bc
Много наслышан о том, что сейчас некоторые проекты с открытым кодом переживают настоящий шквал заявок от вайбкодеров, едва отбиваясь от некачественного кода и исправлений несуществующих проблем. Впрочем, есть и положительный опыт — я встречал несколько новостей о том, что искусственный интеллект успешно нашёл и исправил
Очень интересно стало — а как ИИ вообще ищет такие проблемы? Ведь все взаимосвязи в коде он, в силу известных ограничений, просмотреть не может, может речь
Поэтому решил посмотреть как будет действовать нейросеть «Опус 4.6» на хорошо знакомом мне проекте — калькуляторе bc, работающем в командной строке. Я выбрал версию для «Линукса», так как там меньше кода.
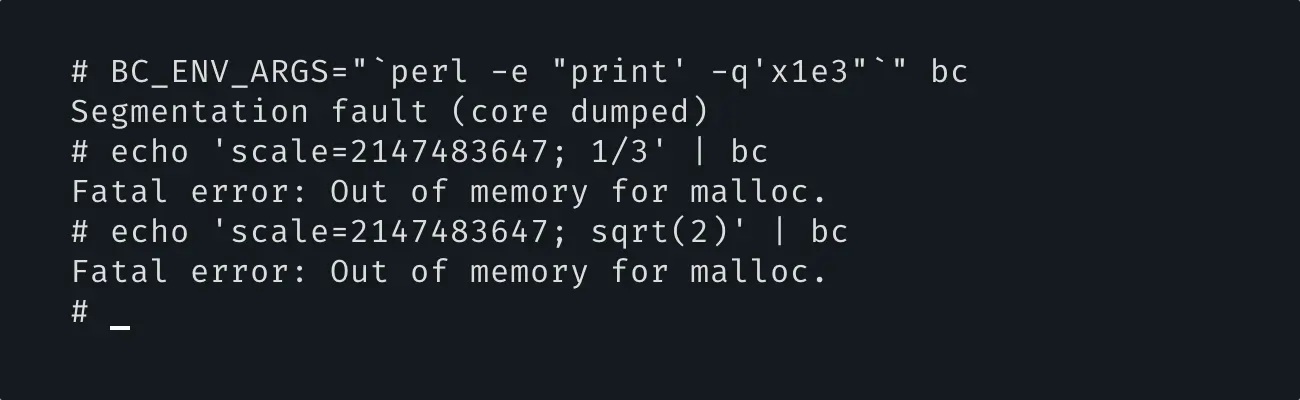
Я написал небольшой промпт, в котором попросил найти мне переполнения стека, ошибки выделения и памяти и прочие проблемы, характерные для программ на Си. Что интересно, такие проблемы нашлись! Но как же «Опус» это сделал?
Ларчик открывался просто — нейросетка подключила к проекту ASan и UBSan — стандартные инструмент для поиска ошибок работы с памятью, знаковых переполнений, деления и ноль и так далее, а после проанализировала их вывод. Никаких чудес.
30 лет серверному ДжаваСкрипту!
Поздравляю всех фронтендеров с юбилеем серверного ДжаваСкрипта — ровно тридцать лет назад вышел Netscape Enterprise Server 2.0 с поддержкой технологии SSJS (
Код можно было писать прямо внутри страницы (как в ПХП, например), оборачивая куски, выполняемые на сервере при помощи тега SERVER:
<SERVER>
write("Click a link to display an image:<P>")
cursor = database.cursor("select * from rockStarBios")
while(cursor.next()) {
    write(cursor.photos.blobLink("image/gif", "Image " + cursor.id))
    write("<BR>")
}
cursor.close()
</SERVER>
Позднее он на этом поле проиграл конкуренцию «Микрософту» и их технологии «Активных Серверных Страниц» (ASP), где можно было программировать на JScript (был такой диалект «ДжаваСкрипта») или VBScript и исчез с радаров.
Добавлено: оказывается я сам эту дату и раскопал, и даже в «Википедию» добавил.
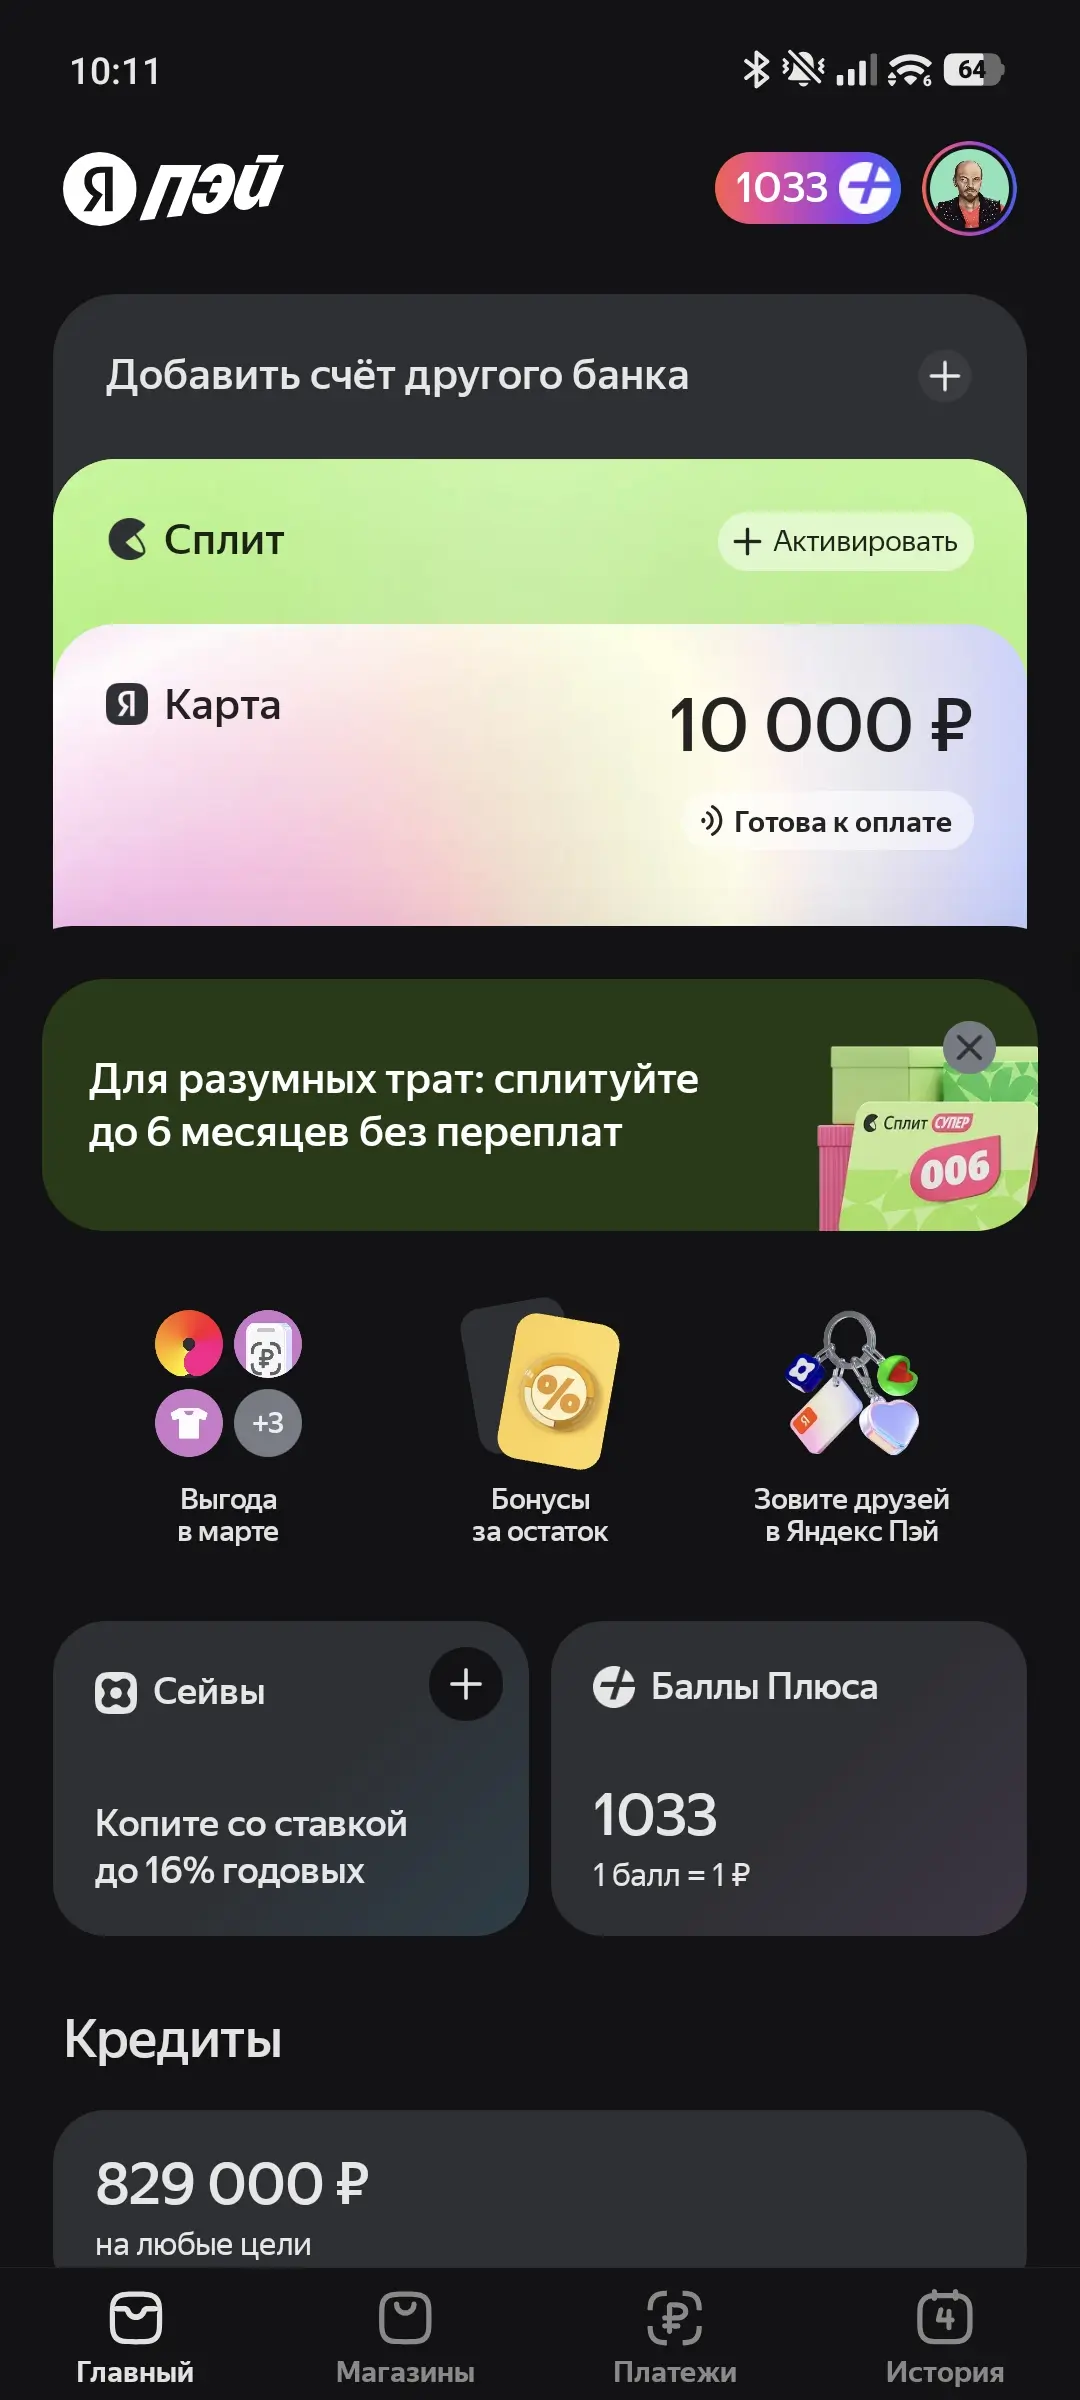
«Сплитуйте»
Бывает у вас, что
Я не припомню, чтобы меня раньше так
Платёжная система «Яндекса», конечно, очень старается, чтобы натащить и другого подобного мусора в наш язык. Кроме «сплитования» в ней есть ещё и «сейвы», а сама она называется «Пэй».
Книги: «Детективное агентство Дирка Джентли»
Очень люблю сериал «Холистическое детективное агентство Дирка Джентли». Смотрел его ещё в момент выхода, в 2016 году, и даже недавно показал дочке. Там всего два сезона, и я очень жалею, что сериальная история героев на этом закончилась.
Я
Узнав, кто автор, я даже обрадовался: серия, которую открывает книга «Автостопом по Галактике», мне в своё время очень понравилась. Так что я подумал, что книги про Дирка Джентли тоже придутся мне по душе — раз сериал оставил такие приятные впечатления.
К сожалению, оказалось, что книга и сериал — это два разных мира. Я прочитал больше половины первой книги, но пока не увидел ничего, даже отдалённо напоминающего события из сериала, кроме того, что одного из героев зовут Дирк Джентли. Да и то, как оказалось, это не его настоящее имя.
Я пока даже не понял, нравится мне книга или нет. Несмотря на мои усилия, полюбить её не удаётся, но бросать не хочется — верю в Дугласа Адамса. Может, перевод неудачный?