программирование
Счастливые билеты
Мы тут недавно с одним товарищем разговорились про точное количество «счастливых» билетов. В ответ я вспомнил, что
На что товарищ прислал мне ссылку на выписку из статьей о счастливых билетах журнала «Квант». Там, помимо перебора, предлагается несколько методов вычисления, в частности есть даже интеграл:
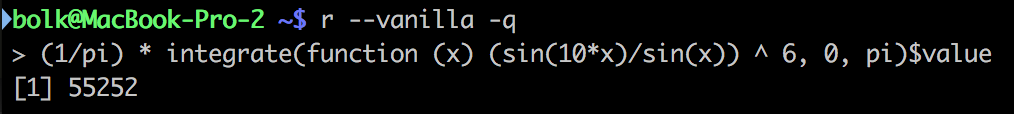
Вообще статьи интересные, умели же раньше писать! Кстати, стало интересно насколько сейчас плох
Вариант на R, который я наскорую написал по мотивам второй статьи из подборки выглядит вот так:
N <- function (n, k) {
    if (n == 1)
        ifelse(k >= 0 & k <= 9, 1, 0)
    else
        sum(sapply(0:9, function (l) N(n-1, k-l)))
}

lucky <- function (n) {
    0 -> s
    for (k in 0:999) {
        N(3, k) -> v

        if (v == 0) {
            break
        }

        s + v * v -> s
    }

    s
}

print (lucky(3))
Выполняется вместе с запуском интерпретатора за треть секунды, если
PostgreSQL и PHP — слон слону не товарищ
Продолжаю серию удивительных открытий в мире перехода на «Постгрес». В документации к функции pg_execute есть малозаметное примечание к последнему параметру — в нём передаются значения для запроса:
Warning Elements are converted to strings by calling this function. |
Думаю мало кто обращает на него внимания, собственно, я тоже не обращал. Прежде чем двинуться дальше, разберёмся — что же здесь написано?
Перевод такой: все значения, которые передаются, приводятся к строкам. Код, который это выполняется выглядит так (взял из ПХП 7.2):
if (num_params > 0) {
        int i = 0;
        params = (char **)safe_emalloc(sizeof(char *), num_params, 0);

        ZEND_HASH_FOREACH_VAL(Z_ARRVAL_P(pv_param_arr), tmp) {
                ZVAL_DEREF(tmp);
                if (Z_TYPE_P(tmp) == IS_NULL) {
                        params[i] = NULL;
                } else {
                        zval tmp_val;

                        ZVAL_COPY(&tmp_val, tmp);
                        convert_to_cstring(&tmp_val);
                        params[i] = estrndup(Z_STRVAL(tmp_val), Z_STRLEN(tmp_val));
                        zval_ptr_dtor(&tmp_val);
                }
                i++;
        } ZEND_HASH_FOREACH_END();
}

pgsql_result = PQexecParams(pgsql, query, num_params,
                                NULL, (const char * const *)params, NULL, NULL, 0);
Вышеупомянутое примечание есть только у этой функции, но на деле в любом месте, где привязываются значения, всё выглядит примерно так же (это касается и модуля ПДО).
Думаю, это связано с типизацией «Постгреса». Взять к примеру числа — два числовых типа ПХП нельзя адекватно преобразовать в россыпь типов «Постгреса», а если привести к неверному типу будут проблемы — в этой СУБД есть понятие перерузки функций, то есть функция выбирается не только по имени, но и по числу и типам параметров.
Поэтому и выбраны строки — они приведутся к нужному числовому типу сами собой, со строками это работает. К сожалению в этом преобразовании кроются и проблемы.
Ещё когда мы работали только с «Ораклом», заметили, что если вместо чисел привязывать строки, то иногда планы выполнения запросов меняются в худшую сторону. Лёгкость обращения с типами в ПХП иногда к этому приводит — переменная, используемая для хранения числа, имеет строковый тип.
К счастью, в оракловом модуле это легко решается — при привязке надо всего лишь указать, что тут мы имеем ввиду число, сами собой совершатся нужные преобразования и «Оракл» так устроен, что никаких проблем это не породит.
В «Постгресе» проблемы будут, я их описал выше, так ещё и способа хорошего нет — все функции любого модуля для работы с этой базой, доступные в ПХП любой версии, преобразуют все числа в строки. К несчастью, в «Постгресе» проблема изменения планов тоже имеет место — недавно наткнулись на запрос, который через ПХП выполняется почти полторы секунды, а через консольный клиент — меньше миллисекунды.
Мой братишка придумал оригинальное решение — определять позиции на которых мы привязываем числа и автоматически внутри нашего фреймворка в этом месте запроса указывать тип bigint явным образом. То есть добавлять после плейсхолдера параметра конструкцию «::bigint».
Пришлось изменить несколько наших хранимых процедур, но в целом всё плошло довольно гладко.
Ускорение пользовательских функций в PostgreSQL
Мы ещё в процессе перевода последних наших проектов с «Оракла» на «Постгрес», поэтому всё ещё не закончили избавляться от характерных для диалекта «Оракла» функций, тащим их с собой — пока так проще.
В попытке
Ниже две функции на разных языках, поддерживаемых «Постгресом», по смыслу идентичные — обе представляют собой замену функции NVL2 «Оракла» над целыми числами:
CREATE FUNCTION nvl2_plpgsql(a numeric, b numeric, c numeric) RETURNS numeric AS '
BEGIN
  IF a IS NULL
    THEN RETURN c;
    ELSE RETURN b;
  END IF;
END;
' LANGUAGE plpgsql IMMUTABLE;

CREATE FUNCTION nvl2_sql(a numeric, b numeric, c numeric) RETURNS numeric AS '
SELECT CASE WHEN a IS NULL THEN c ELSE b END;
' LANGUAGE SQL IMMUTABLE;
Будет ли
p95=# EXPLAIN ANALYZE SELECT nvl2_plpgsql(g, 0, 0) FROM generate_series(1, 10000000) _(g); Planning time: 0.066 ms Execution time: 38881.927 ms p95=# EXPLAIN ANALYZE SELECT nvl2_sql(g, 0, 0) FROM generate_series(1, 10000000) _(g); Planning time: 0.253 ms Execution time: 15435.231 ms |
Как ни странно, функция на чистом ЭсКуЭле быстрее. Судя по моим экспериментам, так всегда. Иногда результаты различаются вдвое, иногда на порядок — зависит от того, что она делает, но как правило быстрее, обратных примеров я ещё не встречал.
Это неплохое подспорье, так как у нас такие функции встречаются не только в самих запросах, но и в функциональных индексах, значит ускорятся не только чтения, но и вставки.
Mosh

Погонял несколько дней в качестве клиента «мош» — «мобильный шелл». Хорошая штука, логинится через эсэсаш, далее поднимает на удалённой стороне свой сервер и открывает свой шифрованный канал через ЮДиПи. Ключи авторизации тоже естественно поддерживаются.
Штука в том, что при разрыве соединения сессия не пропадает, а терпеливо ждёт возобновления — такая помесь эсэсаша и скрина, смены айпи ей тоже не страшны. Другая фишка — если канал пропал или на нём высокие задержки, делаются локальные предсказания поведения курсора, то есть можно печатать и передвигаться по тексту, даже если соединения нет.
Пока всё работает не очень стабильно, но всё равно выглядит как шаг вперёд. У меня время от времени пропадают буквы на выводе самых обычных команд, иногда по экрану скачет курсор или текст выводится не в том месте, но в целом пользовать можно.
Ставится просто — поддерживаются все основные системы, ставите на обе стороны, запускаете из командной строки (mosh имя_сервера вместо ssh имя_сервера) и всё работает.
Запрос на pg_field_type
Страшно удивился, когда увидел в логах «Постгреса» запрос, которого не было в коде нашего продукта:
select oid,typname from pg_typeПроблемы, конечно, особой в этом нет — запрос плёвый, тем более он выполняется только при первом вызове pg_field_type,
Коммит миграций кусками с помощью psql
Я ещё не так давно работаю с «Постгресом» и раз в месяц натыкаюсь
Недавняя ситуация — дано: миграция, которая обновляет более половины полей таблицы с более чем полумиллиардом записей и содержит в себе довольно затратный по процессорному времени запрос.
В «Оракле» такую миграцию наши ребята, насколько я знаю, разбивали хранимой процедурой на части и коммитили внутри кусками по миллиону, в «Постгресе» так нельзя — блок на языке PL/pgSQL выполняется в собственной транзакции и она прервётся при попытке сделать COMMIT. Автономных транзакций нет.
Испытания на тестовом стенде, приближенном к промышленному, показали, что единым куском обновить не получится — на мастере и слейве первой очереди кончилось место и стенд развалился. Надо было найти
Гугление рецептов принесло способ, который заключается в том, что мы создаём соединение из базы в в себя же и шлём запросы в это соединение. Говорят работает, но способ мне показался муторным, пришлось придумать свой.
DO $$
  DECLARE
    max_id table.id % TYPE;
    query TEXT;
BEGIN
  -- делим таблицу на куски по миллиону, теперь в max_id у нас номер последнего куска
  SELECT CEIL(MAX(id)::float/1000000) INTO max_id FROM mytable;

  -- очищаем файл /tmp/sqlquery
  COPY (SELECT '') TO '/tmp/sqlquery';

  -- айдишники в моём конкретном случае идут с единицы, но более правильно идти с минимума до максимума с шагом
  FOR i IN 0..max_id LOOP
        query = FORMAT(
            'UPDATE mytable '
            'SET something=value '
            'WHERE id BETWEEN ' || i*1000000+1 || ' AND ' || (i+1)*1000000 || ';'
        );

        -- запуск /bin/cat нужен, чтобы дописывать в файл
        EXECUTE  'COPY (SELECT ' || quote_literal(query) || ') TO PROGRAM ''/bin/cat >> /tmp/sqlquery''';
  END LOOP;
END$$;

-- запуск запроса
\i /tmp/sqlquery
Я воспользовался тем, что в накатке миграции у нас участвует утилита psql — официальный консольный клиент к «Постгресу», помимо команд СУБД она умеет выполнять свои собственные команды, чем я и пользуюсь — собираю нужные запросы в файл и запускаю его на выполнение в последней строке.
Обратите внимание на вызов /bin/cat — это важно, так как команда COPY сама не умеет добавлять
Скриптование меню в статус-баре
В «Маке» очень нехватает одной вещи — лёгкого создания собственных меню
Если кому интересно, то последовательность его прикручивания к системе примерно такова (bolk — моё имя пользователя и требуется установленный brew):
mkdir -p /usr/local/Cellar/ScriptableStatusBar/0.1/bin/
mv ~/Downloads/ScriptableStatusBar-release/usr/local/bin/sbar !:2
mv ~/Downloads/ScriptableStatusBar-release/Applications/
    /usr/local/Cellar/ScriptableStatusBar/0.1
brew link ScriptableStatusBar
open /usr/local/Cellar/ScriptableStatusBar/0.1/Applications/

# Тут надо утянуть открывшееся приложение в «Объекты входа»
# и ещё запустить его в открывшемся окне, разрешив ему в принципе запускаться
Очень неудобно и несколько недоделано. Хотелось бы, чтобы из шелла можно было добавить/удалить пункт меню и сменить иконку. Сейчас это тоже можно, но полной переинициализацией и, кроме того, убъёшься всё экранировать.
Вооружившись несложной инструкцией, делаем несколько магических пассов:
cat>~/lockkeyboard.sh<<LOCK
#!/bin/ksh

kext=/System/Library/Extensions/AppleUSBTopCase.kext/Contents/PlugIns/AppleUSBTCKeyboard.kext/
case "$1" in
    unlock )
        /sbin/kextload "$kext"
        ;;
    lock )
        /sbin/kextunload "$kext"
        ;;
esac
LOCK

sudo chown root:staff ~/lockkeyboard.sh
sudo chmod 750 ~/lockkeyboard.sh

sudo cp /dev/stdin /private/etc/sudoers.d/lockkeyboard<<SUDO
bolk    ALL= NOPASSWD: /Users/bolk/lockkeyboard.sh
SUDO

sbar set locker ?\
    'Lock:/usr/bin/sudo /Users/bolk/lockkeyboard.sh lock'\
    'Unlock:/usr/bin/sudo /Users/bolk/lockkeyboard.sh unlock'\
    'Quit:/usr/local/bin/sbar remove locker'
И получаем малофункциональную такую менюшечку для блокировки клавиатуры (кстати и увы, если компьютер с заблокированной клавиатурой, у вас уйдёт в блокировку

В принципе можно даже сэмулировать защёлкивание замка и смену пунктов меню «Lock» на «Unlock» и обратно (для этого нужно просто пересоздавать меню после каждой из этих команд с другими пунктами и другим замочком), но это ещё полэкрана костылей, которые мне совсем не хочется на вас вываливать.
Кстати, пункты в меню добавляются в произвольном порядке — программе совершенно плевать в каком порядке вы их задали в параметрах.
Сила .ssh/config
Извечная задача получить доступ к одной машине через другую чаще всего решается при помощи SSH-туннелей — удобно, пока не приходится получать доступ к группе машин. Недостаток традиционного решения — не всегда удаётся придумать удачное правило выбора портов, чтобы не запутаться как мы должны соединяться, чтобы попасть на нужную машину.

К счастью, есть решение лучше, которое позволяет соединяться через SSH наиболее естественным способом — как будто у нас есть прямой доступ.
Тут нам пригодится файл ~/.ssh/config, служащий для конфигурирования SSH-соединений, я обычно туда вписываю символические имена вместо
Например на картинке выше у меня конфигурация, которая позволяет к любому
Таким образом получается соединение, весь трафик которого без изменений попадает на нужный нам адрес, а уже в этом соединении мы выполняем обычный логин на нужную нам машину. Все аутентификации у меня, естественно, сделаны через сертификаты.
Особенности смены типа в PostgreSQL: text → bytea
При обыденной смене типа колонки в «Постгресе» с текстового типа на бинарный получил ошибку «ERROR: invalid input syntax for type bytea». Запрос довольно рядовой и сюрпризов я не ожидал:
ALTER TABLE tbl ALTER COLUMN colmn TYPE bytea USING colmn::bytea;Решения нагуглить не удалось, поэтому начал исследовать проблему сам. Бинарным поиском нашёл строку на которой запрос запнулся, потом так же вычислил символ. Им оказался обратный слэш. Заэкранировал его и ошибка пропала:
ALTER TABLE tbl ALTER COLUMN colmn TYPE bytea USING REPLACE(colmn, '\', '\\')::bytea;Всё отработало нормально, сконвертировалось, слеши получаются из базы как и ожидается — одинарными.
💢 OCI8: проблемы с переходом на PHP7
Ещё в копилку проблем с ПХП7: если при привязке переменных в Оракле (bind) поля типа LONG/LOB не находятся в конце списка, то вы получите ошибку
💢 Проблема с переходом на PHP7: Memcached, часть вторая
В прошлый раз я писал о проблемном Мемкешд в ПХП7 и оказалось, что я не совсем прав. Проблема есть, но её корень я понимал неверно.
Черновым кодом это выглядит примерно так (должно работать, но я его не запускал):
if (version_compare(phpversion('memcached'), '3.0.0-dev', '<')) {
    // работаем по-старому
    return $memcached;
} else {
    // возвращаем обёртку
    return new class($memcached) {
        use \Core\ProxyTrait;

        public function __construct($mc)
        {
            $this->setObject($mc);
        }

        public function get($key, callable $cache_cb = null, &$cas_token = null)
        {
            $result = $this->obj->get($key, $cache_cb, Memcached::GET_EXTENDED);

            if ($result === Memcached::GET_ERROR_RETURN_VALUE) {
                return false;
            }

            if ($result) {
                $cas_token = $result['cas'];
                return $result['value'];
            }

            return $result;
        }

        public function getMulti(array $keys, array &$cas_tokens = null, int $flag = null)
        {
            $result = $this->obj->getMulti($keys, Memcached::GET_EXTENDED | $flag);

            if ($result === Memcached::GET_ERROR_RETURN_VALUE) {
                return false;
            }

            if ($result) {
                $values = [];
                $cas_tokens = [];

                foreach ($result as $key => $d) {
                    $values[$key] = $d['value'];
                    $cas_tokens[$key] = $d['cas'];
                }

                return $values;
            }

            return $result;
        }
    }
}
Вся мякотка в последнем параметре Memcached::GET_EXTENDED, он заставляет возвращать соответствующие методы не искомое значение, а массив, содержащий в том числе и cas.
Неприятно, что в этой версии ПХП модуль для работы с Мемкешд помечен как «разработческий». В этом свете мне
💢 Проблема с переходом на PHP7: Memcached
ПХП7 — огромный шаг для интерпретатора ПХП в плане производительности и потребления памяти, поэтому есть большой соблазн начать переводить на него свои продукты. К сожалению, возросшие показатели дались не бесплатно, а путём сломанной в некоторых местах обратной совместимости, самая яркая проблема, которая из этого вытекает — все модули без исключения надо модифицировать.
Поэтому этот шаг, к ПХП7 очень труден для больших проектов, вроде тех, который разрабатываем мы. Тем не менее, мы медленно, но верно движемся в финишу. Вчера столкнулись с неожиданной сложностью, на которую мне пришлось потратить вечер.
Оказалось, что в модуле Мемкешд для ПХП7 нет реализации получения токена cas в методах get и getMulti (наверняка нет ещё
Method [ <internal:memcached> public method get ] {

  - Parameters [2] {
    Parameter #0 [ <required> $key ]
    Parameter #1 [ <optional> $cache_cb ]
  }
}
Как видите, параметра cas нет вообще (он должен быть последним). Это печальное обстоятельство подтолкнуло меня к исследованию и к ночи я сделал решение. Возможно
class MemcachedPHP7
{
    use \Core\ProxyTrait;

    public function __construct($mc)
    {
        $this->setObject($mc);
    }

    public function get($key, callable $cache_cb = null, &$cas_token = null)
    {
        switch (func_num_args()) {
            case 1:
                return $this->obj->get($key);
            case 2:
                return $this->obj->get($key, $cache_cb);
            default:
                if ($this->obj->getDelayed([$key], true) === false) {
                    return false;
                }

                $res = $this->obj->fetchAll();

                if ($res === false || !$res) {
                    if ($cache_cb !== null) {
                        if ($cache_cb($this->obj, $key, $value)) {
                            $this->obj->set($key, $value);
                        }
                    } else {
                        $value = false;
                    }
                } else {
                    $cas_token = $res[0]['cas'];
                    $value = $res[0]['value'];
                }

                return $value;
        }
    }

    public function getMulti(array $keys, array &$cas_tokens = null)
    {
        if (func_num_args() === 1) {
            return $this->obj->getMulti($key);
        } else {
            if ($this->obj->getDelayed($keys, true) === false) {
                return false;
            }
            $res = $this->obj->fetchAll();

            if ($res === false) {
                return false;
            }

            $cas_tokens = [];
            $values = [];

            $results = array_column($res, null, 'key');

            foreach ($keys as $key) {
                $cas_tokens[$key] = $results[$key]['cas'];
                $values[$key] = $results[$key]['value'];
            }

            return $values;
        }
    }
}
Трейт ProxyTrait я тут не привожу, там идея простая — он тупо проксирует всё, что получает через магические методы __get, __set, __call и прочие, setObject — метод этого трейта. Очень удобно, если надо оставить всё как есть, за исключением
В остальном всё основано на том, что в методе getDelayed реализация токена cas есть, его я и использую, чтобы заткнуть эту дыру в функциональности. Работает всё так же как в ПХП 5.6, за исключением того, что в методе getMulti нет реализации последнего параметра — флага, вместо этого всё работает так, как будто он установлен, это ничему не мешает.
🐘 «Синхронная реплика» PostgreSQL
Я в последнее время был очень сильно занят — мы переводили одну из наших крупных инсталляций документооборота на «Постгрес» (правда перевод самой крупной впереди, но у меня чувство, что мы будем ждать следующие версии).
Много любопытного я узнал об этой СУБД, возможно
На «Постгресе» мы, конечно, захотели аналога и, казалось, нашли его —
Наши нагрузочные испытания показали, что на пиковых нагрузках синхронные реплики никакие не синхронные, оказалось, что «синхронность» реплики только в том она говорит мастеру «я всё приняла», когда данные попали на диск и именно в этот момент.
Когда нагрузка близка к пиковой, данные физически на диске есть, а логически они ещё не считываются. То есть это скорее пригодно для того, чтобы в случае смерти мастера быстро поменять его на реплику, чем для схемы с распределением нагрузки.
Это будет исправлено в будущей 9.6, а пока живём с тем, что есть.
🐘 Подготовленные планы в PostgreSQL
Но вот какая неприятность — при подключении любого балансировщика нагрузки, совершенно неочевидно куда улетает ваш план и таблица в приложении не помогает — она единая, а серверов может быть несколько, у каждого свои планы подготовленные. Если мы начнём подготавливать его заново, а он уже есть, получим ошибку, что план уже существует.
Какой выход? Краткий ответ: пока никакой.
Самый очевидный — игнорировать такие ошибки. К сожалению, он не подойдёт — если ошибка произойдёт в транзакции, «Постгрес» её просто откатит. Второй выход — не использовать подготовленные планы. Я пока нашёл третий — мы используем планы только если уверены, что они пойдут на мастер — это запросы на изменение
С другой стороны у меня появилась идея — добавить в эскуэль конструкцию PREPARE IF NOT EXISTS, ребята из, с которыми я обсуждал эту идею, PostgresPro уже сделали несколько версий патча.
Основа идеи — всегда слать запрос на компиляцию плана, но если он уже был скомпилирован, ничего не делать. Мы его уже погоняли (оттуда и цифры первого абзаца), но на этом пути больше трудностей, чем себе можно представить — в частности, надо патчить ещё и продукты для балансировки и расширять его клиентский протокол.
Очень надеюсь, что патч доведут до ума и мы скоро сможем его использовать.
🐘 «Рекурсивные» запросы в PostgreSQL
Одна из главных бед «Постгреса» — бедные (по сравнению с «Ораклом») «рекурсивные» запросы. Подробнее об этом
Если вы знаете рецепт лучше, поделитесь, пожалуйста.
Как я уже рассказывал, поскольку продукт у нас мигрирует с «Оракла» на «Постгрес», мы сейчас живём сразу на двух базах и некоторые виды запросов строят унифицированные билдеры.
Есть такой и для «рекурсивных» запросов. Нередко «рекурсивный» запрос приходится строить, выбирая не из таблицы, а из подзапроса. Наш билдер был устроен таким образом, что подобный запрос он строил по следующему образцу:
WITH RECURSIVE prior AS (
    WITH virtual AS (
        -- тут у нас подзапрос
    )
    SELECT … FROM virtual WHERE …некий критерий…
    UNION ALL
    SELECT … FROM virtual INNER JOIN prior …критерий соединения…
)
SELECT … FROM prior…
Ну вот
Эффективнее оказалось убрать внутренний WITH и повторить запрос дважды — в выборе первой строки и внутреннем соединении. Но беда в том, что билдер так сделать не может, а чтобы его научить, нужно было написать парсер запросов — так как критерии соединения должен содержать правильные алиасы. Оборачивание же части запроса в подзапрос тоже даром не проходит — стоимость запроса вырастает.
Я перебрал несколько решений, которые пришли мне в голову и остановился на следующем: в данный момент билдер создаёт временную «вьюху» с определённым именем, которое указывается в качестве источника запроса. Выглядит это так:
CREATE OR REPLACE TEMP VIEW некоеимя AS (
    -- тут у нас подзапрос
);
WITH RECURSIVE prior AS (
    SELECT … FROM некоеимя WHERE …некий критерий…
    UNION ALL
    SELECT … FROM некоеимя INNER JOIN prior …критерий соединения…
)
SELECT … FROM prior…
Выходит достаточно эффективно, но смущают две вещи:
👁 Глаз следящий
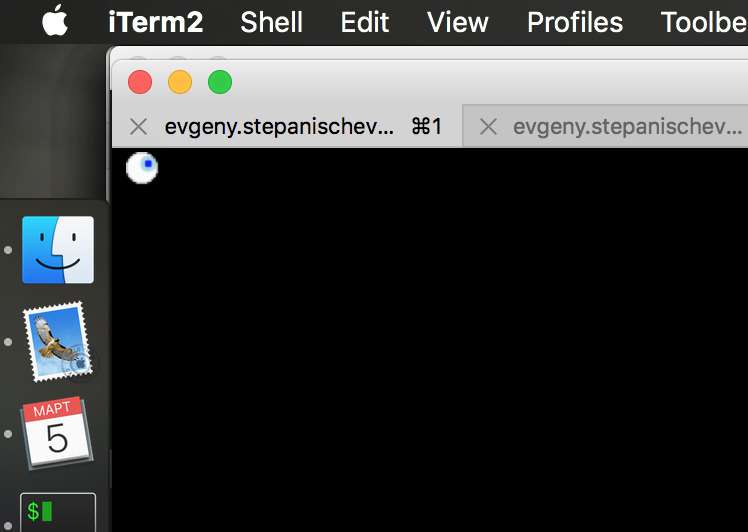
Обновилась до версии 2.9 моя любимая
Протокол довольно простой:
ESC ] 1337 ; File = [необязательные параметры] : изображение в формате base64 ^GРешил немного с ним побаловаться, результат на скриншоте — небольшая программа на «баше» — глаз, который следит за указателем мыши.
Пришлось разобраться с тем как вообще получают координаты мыши в консоли, плюс вспомнить школьную геометрию. Синусы, косинусы, вот это всё, неявно вычисляются через awk и используются для определения где нужно рисовать зрачок.
Чем дальше курсор находится от глаза, тем больше событий мыши получает консоль во время перемещений по окружности вокруг него.
Для запуска требуется iTerm2 2.9 и выше и Imagemagick.
🐘 PostgreSQL, PHP и подготовленные запросы
Одно из отличий «Постгреса» от «Оракла» — подготовленные планы запросов лежат не в разделяемом ресурсе, а в неком хранилище в рамках одного соединения. Программист, в рамках каждого соединения, должен подготовить их оператором PREPARE, в который передаётся выбранный идентификатор запроса и сам запрос, а потом выполнить его при помощи оператора EXECUTE, используя в качестве параметра переданный при подготовке идентификатор и значения параметров.
Польза подготовленных запросов в том, что можно единожды (за время жизни соединения, напоминаю) подготовить запрос, то есть попросить «Постгрес» выполнить его компиляцию в стандартное представление и оптимизацию, а после многократно его использовать, что очевидным образом поднимает производительность приложения.
Схема работы тут очень простая: вычисляем от запроса хеш, ищем его в специальном массиве, если не находим, подготавливаем запрос, используя хеш в качестве идентификатора, после чего хеш добавляем в специальный массив. После чего выполняем подготовленный запрос.
Если план запроса больше не нужен, его можно удалить по идентификатору оператором DEALLOCATE, если же в качестве параметра передать ключевое слово ALL, то будут уничтожены все подготовленные в этом соединении планы. С закрытием соединения, планы так же исчезают.
Теме работы «Постргеса» с ПХП удивительно мало посвящено в руководстве к языку, так что пришлось произвести ряд самостоятельных исследований. Основной вопрос, на который я хотел для себя ответить — есть ли
Оказалось, что это вполне возможно. В ПХП есть «постоянные соединения» — обрабатывающий процесс интерпретатора держит открытым соединение с базой, передавая его новому скрипту, это уменьшает затраты, так как стадия установки соединения и авторизации выполняется только в первый раз.
С открытым соединением в скрипт попадают и подготовленные запросы из предыдущего сеанса, остаётся только
Код всего описанного выглядит вот так, я его упростил и переписал процедурно:
// открываем постоянное соединение с базой
$con = pg_pconnect($connection_string);

// загружаем подготовленные запросы
$res = pg_query("SELECT name FROM pg_prepared_statements");
$prepared = array_fill_keys(pg_fetch_all_columns($res), true);
pg_free_result($res);

// хеш от запроса, tiger — быстрый алгоритм, я люблю его использовать
$hash = base64_encode(hash('tiger160,3', $sql, true));

// смотрим — был ли уже подготовлен такой запрос
if (!isset($prepared[$hash])) {
    $prepared[$hash] = true;
    pg_prepare($con, $hash, $sql);
}

// выполняем запрос
$res = pg_execute($con, $hash, $params);
Общая идея, думаю, понятна из кода. Пока для меня остаётся открытым вопрос «просачиваются» ли в переданное соединение незакрытые транзакции или временные таблицы (предыдущий его владелец, например, мог умереть
Надо заметить, что модуль «Постгреса» в ПХП в каждое соединение, перед его передачей в приложение, посылает команду RESET ALL, но она, насколько я понял из руководства, лишь сбрасывает различные конфигурационные переметры времени выполнения на значения
🚨 Особенности перехода с «Оракла» на «Постгрес»
В комментариях пообещал поописывать свой опыт перевода продукта с «Оракла» на «Постгрес», особенно в особенностях, которым очень мало уделено внимания на просторах интернета. Начну с простого, зато сразу целой пачкой. Примеры я, естественно, упростил, чтобы максимально выпукло продемонстрировать различия.
У нас довольно много генерируемых простых запросов, иногда они генерировались не очень аккуратно. «Оракл» такое прощает, а «Постгрес» — нет. Запрос, где одни и те же таблицы соединяются дважды «Постгресу» не по вкусу:
SELECT * FROM test INNER JOIN test1 USING(n) INNER JOIN test USING(n);

ERROR:  table name "test" specified more than once
«Постгрес» очень трепетно относится к тому, чтобы у подзапроса был алиас, даже если он потом нигде не используется:
SELECT * FROM (SELECT * FROM test);

ERROR:  subquery in FROM must have an alias
СТРОКА 1: SELECT * FROM (SELECT * FROM test);
                        ^
ПОДСКАЗКА:  For example, FROM (SELECT ...) [AS] foo.
В «Постгресе», в запросах на обновление нельзя указать алиас. Тут это логично, так как синтаксис подзапросов в этом случае у этой СУБД совершенно иной — они указываются в специальном месте.
UPDATE test t SET t.n=1;

ERROR:  column "t" of relation "test" does not exist
СТРОКА 1: UPDATE test t SET t.n=1;
Если «Оракл» спокойно относится к двум и более таблицам с одним алиасом, то «Постгресу» от этого плохеет. Жаль, иногда удобно объединить несколько таблиц алиасом прямо на месте и работать дальше с ним, как с единой таблицой.
SELECT t.n FROM test t, another_test t;

ERROR:  table name "t" specified more than once
В «Оракле» ключевое слово FROM не обязательно в запросах на удаление. У нас было несколько запросов без него.
DELETE test;

ERROR:  syntax error at or near "test"
СТРОКА 1: DELETE test;
В следующий раз буду описывать более комплексные примеры.
✨ Двойные миграции (Оракл+Постгрес)
У нас идёт замена в наших продуктах сильно платного «Оракла» (это база данных) на бесплатный «Постргес». Несмотря на ударные темпы, продолжаться это ещё будет долго. Продуктов много, несмотря на то, что начали мы ещё в прошлом году, весь этот год будем жить сразу на двух базах.
В этой связи, когда есть различия, приходится миграции писать в двух комплектах — под каждый диалект. Я придумал как писать их так, чтобы каждая БД видела куски кода, предназначенные только ей.
Например:
CREATE UNIQUE INDEX dn_part_num_org_n_cat ON document_n(/*/**/
CASE WHEN d_deleted = 0 AND num IS NULL AND n=0 AND category=0 THEN id END,
CASE WHEN d_deleted = 0 AND num IS NULL AND n=0 AND category=0 THEN org_id END);
--*/ id, org_id) WHERE d_deleted=0 AND num IS NULL AND n=0 AND category = 0;
Часть с /*/**/ и до —*/ видит только «Оракл» — для него это выглядит так: комментарий открывается, сразу закрывается, идёт код, который он и воспринимает, а последняя строка закоментирована при помощи двух минусов — это стандартный коментарий в эскуэле.
«Постгрес» эту часть не видит — он поддерживает вложенные коментарии, поэтому его интерпретация другая: открываются два комментария, первый закрывается сразу, а второй — на последней строке, остаток которой «Постгрес» воспринимает как часть кода.
🎱 Сложности при написании «99 бутылок» на «Электронике МК-61»
★

Как и обещал в прошлый раз, хочу рассказать с какими сложностями мне пришлось столкнуться при написании «Песни о пиве» на программируемый калькулятор «Электроника
Калькулятор попал ко мне для передачи в компьютерный музей, который готовится к открытию в высшей школе «ИТИС» и у меня
В процессе изучения я наткнулся на заинтриговавшую меня вещь. В некоторых операциях калькулятор переключался в режим шестнадцатеричного счисления, о чём сигнализировала восьмёрка и точка в первом разряде.

Как видно по таблице выше, отображение этих чисел сильно отличается от общепринятого (как правило для цифр больше девятки используются латинские буквы от A до F) и я не мог не отметить, что с их помощью легко написать английское «beer» («пиво»).
Тем более мне очень повезло в том, что индикацией этого режима является именно восьмёрка, стоящая спереди — так похожая на первую букву в нужном мне слове. Как вы теперь понимаете, на экране в моей программе написано не «BEEr», с точки зрения калькулятора там одни числа и индикатор режима — «8.EEГ» или «EED» в привычной записи (десятичное «3821»).
Так же я воспользовался тем, что «F» в этой странной нотации — пробел, что позволило мне отделить число от «надписи». Дальнейшее — дело техники.
Листинг из предыдущего поста начинается с подготовки данных в регистрах — нескольких масок на которые битовыми операциями в дальнейшем наложатся числа так, чтобы получилась нужная мне «строка». Настоящая программа начинается с нажатий на «В/О» и «ПРГ», и активно пользуется подготовленными данными.
Маски и оставшиеся числа побитно накладываются двумя подпрограммами — по отдельности на диапазоны
Для примера кусочек подпрограммы, номер слева соответствует номеру инструкции при вводе в калькулятор и каждую строку я прокомментирую, но следует понимать, что в реальности эти комментарии частью программы не являются:
// когда что-то попадает в «X» предыдущее значение смещается в «Y» (там стек из 4 позиций)
45 1 // «1» кладётся в регистр «X», входной параметр сместился в «Y»
46 + // Y + 1, передаётся в «X», это коррекция данных после операций, которые шли выше
47 К П→Х 7 // в «X» помещается число из регистра (маска), указанного в регистре №7
48 + // Y+X → X
49 ИНВ // инвертирование битов в «X», сейчас на экране написано «8.EEГ» плюс некий пока мусорный символ
50 К П→Х 8 // в «X» помещается число из регистра, указанного в регистре №8
51 ^ // операция «И», на экране — «8.EEГ», из некого символа получилось требуемое число
52 В/О // возврат из подпрограммы
Десятки и единицы выбираются адресами масок, которые я передаю при помощи косвенной адресации, хорошо, что такое вообще есть в языке — это позволяет эффективно пользоваться подпрограммами.
Подпрограмма вызывается два раза с разными параметрами — для десятков и единиц, получаются две маски, которые позднее накладываются друг на друга.
Сильно расстраивает отсутствие памяти для долговременного хранения, в устройстве хоть и есть батарейный отсек, но при любом сбое питания (батарейки сели, а блок питания не подключен), память калькулятор сбрасывается и программу придётся набрать заново. То же ожидает и в случае, если одну программу нужно будет заменить другой — хотя программы можно запускать с произвольного адреса, много их в память не уместится — её ёмкость всего 105 инструкций.