программирование
Банан велик, а кожура еще больше
Много
А тут братишка прислал в «Телеграм» кусок кода, который всплывает на «Стек Оверфлоу» не первый год:
console.log(0 >= null); // выведет true
console.log(0 > null || 0 == null); // выведет false
Странное поведение, как ни крути, ведь даже название операции «больше или равно» раскладывается на две — либо «больше», либо «равно». Казалось бы оба варианта должны давать одинаковый результат.
Решил я полюбопытствовать есть ли объяснение этому феномену.
Во всех браузерах работает одинаково странно, а это значит, что
Let r be the result of performing abstract relational comparison lval < rval
If r is true or undefined, return false. Otherwise, return true
Что означает примерно следующее: если нам надо выполнить операцию
PHP8 ★

Пока всё прогрессивное человечество переходит на ПХП7, а менее прогрессивное до сих пор чахнет
В официальной вики есть страница, где можно ознакомиться с довольно пока скудным списком предложений на восьмую версию. Меня больше всего заинтересовали два изменения, серьёзно ломающие обратную совместимость:
Изменение оправдано унификацией синтаксиса — сейчас используемая сущность выводится из контекста, скажем статические свойства начинаются с доллара, а методы — нет, но если имя метода хранится в переменной, синтаксис разваливается — нет способа указать что же имел ввиду программист.
Или вот похожий пример с константой:
class Sample
{
    const test = 'const';
    public static $test = 'variable';
}

$test = 'test';
// что ты такое?
var_dump(Sample::$test);
// на самом деле вернётся «variable», очевидно; константу придётся получить так:
var_dump(constant("Sample::$test"));
В действительности можно было бы выкрутиться скобками (сейчас так можно вызывать анонимную функцию, записанную в свойство класса), не знаю рассматривали ли такой вариант, но возможно он менее интуитивен.
// так можно было бы получать константу по имени в переменной (не работает!)
var_dump(Sample::($text));
Самым серьёзным внутренним изменением нового релиза, вероятно будет добавление JIT, Дмитрий Стогов, человек, которому мы обязаны фантастическим ускорением в «семёрке», ещё в позапрошлом году написал в рассылку php.internals, что работа над динамической компиляцией начата. Получившийся к тому времени прототип показал 20% прироста на синтетических тестах и снижение производительности на реальных приложениях.
Кстати, это не первая попытка совместить динамическую компиляцию и ПХП, в языке HHVM, диалекте ПХП от «Фейсбука», такая компиляция даёт хороший прирост в скорости. Да и Дмитрий сотоварищи ещё
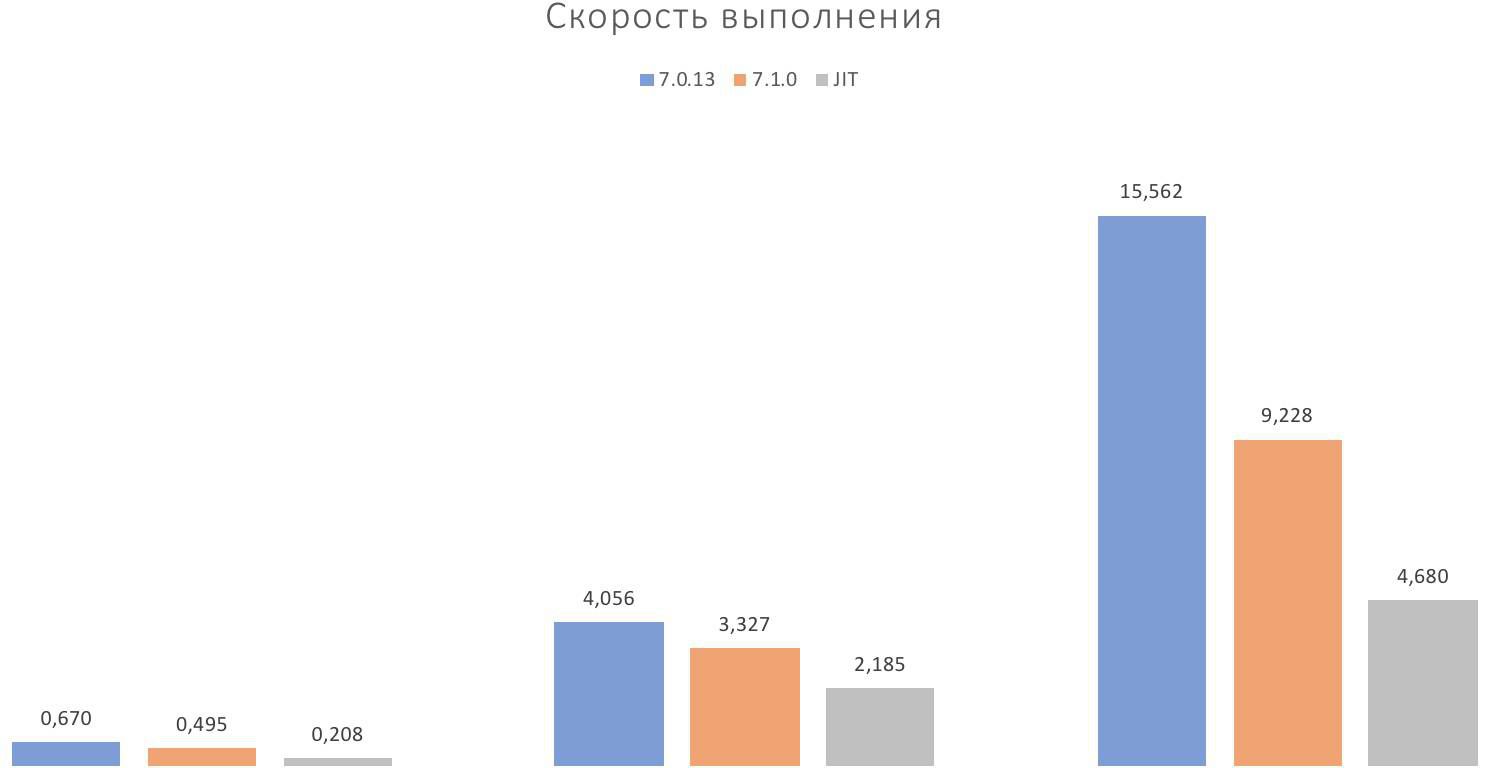
Более свежий тест того, что будет в ПХП8 показывает, что на трёх тестах (два стандартных зендовских теста и построение множества Мандельброта) динамическая компиляция уделывает версию 7.1.0 примерно вдвое. Это отличный результат! Но понятно, что в реальной жизни всё будет скромнее.
Когда же выйдет «восьмёрка»? Дата, увы, неизвестна, но есть предположение, что новую мажорную версию вряд ли можно ожидать раньше сентября 2021 года.
Баг ★
Принято считать, что слово «баг» появилось 9 сентября 1946 года, когда Грейс Хоппер, которая работала в тот момент в Гарвардском университете с ЭВМ «Марк II», проследила ошибку в работе программы до реле машины, куда попал мотылёк. Грейс вклеила насекомое в технический журнал, сопроводив шуткой «Первый реальный случай обнаружения жучка» («First actual case of bug being found»).
На самом деле это одна из версий проникновения термина в среду компьютерщиков. В выпущенном в 1892 году «Стандартизованном словаре электротехники» можно прочитать:
Баг — это любая неисправность или дефект в электрических соединениях или работе электрических аппаратов
Как видим слово появилось раньше 1946 и даже не в 20 веке. По одной из версий термин придумал и популяризировал Томас Эдисон — известный американский предприниматель, Стив Джобс своего времени.

В своих письмах и дневниковых заметках он нередко употребляет это слово. Выше — скан его письма от 3 марта 1878 года (оригинал можно купить за пару тысяч долларов). В пятой строчке, сразу после артикля, написано «bug».
Употреблял ли Эдисон это слово в знакомом нам значении? Да! Так 18 ноября 1878 года он написал Тивадару Пушкашу (венгерскому учёному, физику, и изобретателю первой в мире телефонной станции):
Так было со всеми моими изобретениями. Первый шаг — интуиция, которая приходит как вспышка, затем возникают трудности — устройство отказывается работать, и именно тогда проявляются «баги» — как называют эти мелкие ошибки и трудности — и требуются месяцы пристального наблюдения, исследований и усилий, прежде чем дело дойдёт до коммерческого успеха или неудачи.
Так что термину в этом году исполняется по меньше мере 140 лет.
Переезд на PHP7
В почте попросили описать переезд на ПХП7, с какими сложностями встретились, как они решались. Опишу, пока не забыл — я этим занимался почти в одиночку, так как задача не была приоритетной. Я считал, что мы сможем получить хороший прирост производительности, поэтому сам её и делал в свободное время.
Если кому интересно, загруженность серверов, где крутится ПХП, действительно упала, примерно в 1,5—1,7 раза.
Вообще говоря, у ПХП есть довольно детальные описания того, что может пойти не так при смене версий, достаточно заглянуть в раздел «Изменения, ломающие обратную совместимость» нужной версии. Там можно сразу прикинуть что придётся поменять в коде, если вы хорошо его знаете.
Ниже мой собственный опыт.
Сначала я составил список всех модулей ПХП, которые у нас используются — натурально выписал из зависимостей пакета нашего продукта в табличку в местной «вики». На тот момент не все модули поддерживали «семёрку», поэтому к табличке я иногда возвращался и вносил изменения, если они случались.
Когда в табличке без поддержки остался единственный модуль ctwig от шаблонизатора «Твиг», решил, что без него мы можем обойтись — к этому времени в интернете появились замеры скорости и «Твиг» без модуля под «семёркой» демонстрировал похожие результаты с «пятёркой» и модулем.
Дальше я проверил не используются ли у нас
find . -type f \( -name '*.php' -o -name '*.inc' \) -exec php -l {} \; |
fgrep -v 'No syntax errors'
У нас, к слову, было несколько таких мест — например, был объявлен класс с разными полезными штуками для обработки строк, который назывался String. Так больше нельзя — зарезервированное слово.
Посложнее с обработкой исключений — класс Exception перестал быть базовым и если требуется ловить все исключения, то в «семёрке» лучше всего перехватывать всё, что реализует интерфейс Throwable.
У нас необработанные кодом исключения ловятся и пишутся в логи, для этого в нескольких местах кода есть перехват всего подряд. Выглядело это примерно так:
try {
    // … какой-то код
} catch (Exception $e) {
   DI::log->get('exception')->error($e);
   throw $e;
}Несложными регулярками поискал различные непрямые выражения, там теперь тоже есть разница, нашёл всего несколько штук и поправил.
Потом я
Далее в дело вступили тестеры и программисты — в основном были исправления, связанные с тем, что в «семёрки» некоторые вещи устарели, ничего сверх этого я не припомню.
В целом мне кажется, переход прошёл безболезненнее, чем можно было бы ожидать —
Сдутие таблиц без блокировки
Братишка прислал ссылку на интересную статью — «Reducing bloat without locking». Речь идёт о так называемом «распухании» (bloating) таблиц в «Постгресе».
Подробно суть в трёх предложениях не объяснить, если вкратце, то механизм изоляции в транзакциях у «Постгреса» устроен так, что при обновлении и удалении строк в таблицах могут образовываться «дыры», которые увеличивают общий объём таблицы. Если происходят вставки или обновления и новые данные помещаются в неиспользуемое пространство, то «дыры» могут со временем заполняться. Но иногда «дыр» остаётся много и это проблема с которой надо
Вот например создадим таблицу из тысячи строк, посмотрим сколько страниц она занимает, потом удалим половину строк и снова посмотрим количество занятых страниц:
test=> CREATE TABLE test AS SELECT generate_series(1, 1000) id;
SELECT 1000
test=> SELECT MAX(ctid) FROM test;
  max
--------
 (4,96)
(1 row)
test=> DELETE FROM test WHERE id & 1 = 1;
DELETE 500
test=> SELECT MAX(ctid) FROM test;
  max
--------
 (4,96)
(1 row)
ctid — это специальный внутренний столбец «Постгреса», который отображает физическое расположение строки. Для каждой строки в нём записано два числа — номер страницы, где располагается строка и порядковый номер строки в странице.
Как видим, таблица «распухла» — половина строк удалена, а количество занимаемых страниц не изменилось. Что же можно сделать? Давайте попробуем команду VACUUM:
test=> VACUUM VERBOSE test;
INFO:  vacuuming "public.test"
INFO:  "test": found 0 removable, 500 nonremovable row versions in 5 out of 5 pages
DETAIL:  0 dead row versions cannot be removed yet.
There were 500 unused item pointers.
Skipped 0 pages due to buffer pins.
0 pages are entirely empty.
CPU 0.00s/0.00u sec elapsed 0.00 sec.
VACUUM
Увы, ничего не изменилось — она умеет урезать страницы только если они находятся в конце и полностью свободны.
Что же делать? Можно выполнить VACUUM FULL — эта команда полностью перельёт таблицу на новое место, избавив нас от «дыр», но во время работы таблица будет эксклюзивно заблокирована, для больших таблиц, да ещё в продуктиве это непозволительно.
Другой способ — перенести строки с последних страниц в «дыры» на первых, освободив таким образом несколько страниц в конце. Попробуем:
test=> BEGIN;
BEGIN
test=> UPDATE test SET id=id WHERE ctid>='(3,0)';
UPDATE 161
test=> UPDATE test SET id=id WHERE ctid>='(3,0)';
UPDATE 161
test=> UPDATE test SET id=id WHERE ctid>='(3,0)';
UPDATE 48
test=> UPDATE test SET id=id WHERE ctid>='(3,0)';
UPDATE 48
test=> UPDATE test SET id=id WHERE ctid>='(3,0)';
UPDATE 34
test=> UPDATE test SET id=id WHERE ctid>='(3,0)';
UPDATE 0
test=> COMMIT;
COMMIT
В одной транзакции мы обновили все строки, которые располагаются на первой странице и дальше. Попробуем теперь сделать VACUUM:
test=> VACUUM VERBOSE test;
INFO:  vacuuming "public.test"
INFO:  "test": removed 452 row versions in 2 pages
INFO:  "test": found 452 removable, 500 nonremovable row versions in 5 out of 5 pages
DETAIL:  0 dead row versions cannot be removed yet.
There were 469 unused item pointers.
Skipped 0 pages due to buffer pins.
0 pages are entirely empty.
CPU 0.00s/0.00u sec elapsed 0.00 sec.
INFO:  "test": truncated 5 to 3 pages
DETAIL:  CPU 0.00s/0.00u sec elapsed 0.00 sec.
VACUUM
Как видимо команда удалила две неиспользуемые страницы и уменьшила общее количество страниц с пяти до трёх.
Идея, описанная в статье, лежит в основе скрипта pgcompacttable из инструментария компании «Дейта Игрет».
Две раздражающие частности в PHP
В ПХП немало глобальных проблем, которые многих раздражают, об этом написано много статей. Но есть две частные проблемы, два примера неинтуитивного поведения, которые рождают досадные баги на ровном месте. Они раздражают лично меня.
На текущем месте я работаю более шести лет и прежде чем у нас появилось ревью кода до пуша, в общую ветку регулярно попадали результаты недопонимания работы двух функций, которые порой рождали весьма причудливые баги.
Первый относится к функции exec. Свой второй параметр она получает по ссылке и выводит туда массив строк, которые выдаёт запускаемая команда. Беда возникает в следующем коде:
exec('1st command', $out, $ret);
// … проверяем $ret, делаем что-то полезное с $out
exec('2nd command', $out, $ret);
// … проверяем $ret, делаем что-то полезное с $out
Дело в том, что вторая команда exec не очистит второй параметр и добавит в него вывод второй команды. Таким образом вызов двух команд склеится, а это не то, что мы обычно ожидаем.
Такое поведение описано в руководстве и возможно это полезно для цикла с накоплением, но в общем случае контринтуитивно.
Второй раздражающей частностью является результат работы array_unique. Опять же, особенность описана в руководстве, но про неё нередко забывают: эта функция сохраняет ключи массива. Вот как это выглядит на практике:
var_dump(array_unique([1,1,2]));
/* array(2) {
  [0]=>
  int(1)
  [2]=>
  int(2)
} */
В случае ассоциативного массива претензий нет, это необходимо, возможно есть случаи, когда это полезно и для обычного массива, но чаще всего пропуски в ключах мешают в самых неожиданных местах.
Самый замысловатый баг, который я помню был таким. Результирующий массив превращался в джейсон-строку и передавался микросервису на Гоу. Чаще всего значения были уникальными и всё работало как ожидается.
Но однажды звёзды сошлись так, что уникальность нарушилась и в результате работы array_unique в массиве появились пропуски. В обычный массив такое в джейсоне превратить нельзя, поэтому ПХП сделал из него объект с числовыми ключами. Гоу такое не простил — у него статическая типизация и в него нельзя пихать всякое.
Микросервис выдал ошибку в лог, данные не принял. У тестеров возникла очень странная ошибка, которая повторялась
Увы, но документацию к языкам сейчас никто подробно не читает, а если читает, то такие особенности не помнит — такова данность и ничего не изменить. Хотелось бы чтобы в языках было меньше такого поведения, либо чтобы специализированные редакторы
Особенность языка Postscript
Есть вы вдруг заинтересовались и прочитали программу «99 бутылок» на Постскрипте, то даже при полном незнании языка, примерно понятно где у него аналоги функций, блоков, ветвлений и прочих сущностей.
Единственная конструкция, которая должна смущать, это место, где происходит печать числа:
% печать числа
//=string cvs print
Дело в том, что операторы show и print, принимают на вход только строку, поэтому число на входе надо преобразовать. Для этого используется оператор cvs, на мой взгляд очень странный — он требует не один, как можно было бы ожидать, а два параметра — число, которое будет преобразовано и строку, которую оператор снимет со стека и положит вместо неё преобразованное в строку число. Причём по размеру строка должна быть не короче, чем строковое представление числа, которое мы надеемся преобразовать. Иначе мы получим ошибку «rangecheck». Видимо строковый параметр используется как
Чаще всего cvs используется так (правда это прямо запрещено стилем кодирования Постскрипта, рекомендуется использовать не готовую строку, а формировать пустую строку оператором string, но всё равно широко встречается):
% печать числа 42
42 (  ) cvs print
Кладём на стек «42», потом строку из двух пробелов (скобки задают строку в Постскрипте), далее вызываем cvs, которая берёт со стека два значения, работает с ними и кладёт обратно строку, содержащую преобразованное число, print берёт значение со стека и выводит в консоль.
Но если места нужно много, нередко используют оператор =string, который кладёт на стек буфер в 128 байт, его хватит всем — таких больших числе в языке нет, любое гарантированно поместится:
% печать числа 10000000000, cvi нужно, чтобы преобразовать плавающее 1e+10 в целое
1e+10 cvi =string cvs print
Пока, надеюсь, всё просто и понятно. Далее надо знать такую вещь. Конструкция «{…}» кладёт на стек специальный тип — исполняемый блок, посмотрим как он выглядит на стеке:
% посмотрим как выглядит исполняемый блок на стеке:
{1e+10 cvi =string cvs print} ==
% выведет {1e+10 cvi =string cvs print}
Оператор «два равно» берёт значение со стека и выводит его на экран. Как видим блок попал на стек в неизменном виде. И вот тут можно сделать микрооптимизацию — если этот кусок кода кладётся не на стек, а в словарь (можно считать, что будет создана именованная функция) и мы рассчитываем вызвать его несколько раз, вызов =string можно сразу раскрыть в строку — это делается двумя слешами.
Два слеша — специальная конструкция, которая похожа на вызов анонимной функции по месту определения, в данном случае мы выполняем ровно один оператор и на стеке внутри блока кода мы увидим не вызов, а порождённую им строку:
{1e+10 cvi //=string cvs print} ==
% выведет {1e+10 cvi (x255Unicode\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000\000...) cvs print}99 бутылок: Postscript
62. Postscript — интерпретируемый стековый язык программирования. Предназначен для стандартизации вывода документов на различные устройства.
Люди на нём программы пишут крайне редко, в основном это делают другие программы — например, при печати на принтер. Этот же язык программирования используется внутри формата PDF.
Язык строго типизирован, система типов включает: целые числа, числа с плавающей запятой, логический тип, строку, массив, процедуру, словарь и имя. Для всех операций используется стек и обратная польская запись.
%!
%%Title: (Beer song)
%%Creator: Evgeny Stepanischev
%%EndComments

/beer % (int) -> (int)
{
	dup 0 eq {
		(no bottles) print
	} {
		dup 1 eq {
			(1 bottle) print
		} {
			dup //=string cvs print ( bottles) print
		} ifelse
	} ifelse
} bind def

99 -1 1 {
	beer ( of beer on the wall, ) print beer (\n) print
	(Take one down and pass it around, ) print
	dup 1 sub beer pop
	( of beer on the wall.\n\n) print
} for

(No more bottles of beer on the wall, no more bottles of beer.
Go to the store and buy some more, 99 bottles of beer on the wall.) print

quitКвантовые компьютеры
Долгое время я почти не интересовался квантовыми компьютерами — они существовали лишь в мире идей, причём идей сложных, что из этих идей удастся воплотить на практике в ближайшее время понятно не было.
Тем не менее, глаз цеплялся
А в прошлом году компания «АйБиЭм» предоставила удалённый доступ к своему квантовому компьютеру всем желающим — достаточно было записаться и дождаться своей очереди (назад во времена майнфрэймов, хаха). И я решил узнать в подробностях что же такое квантовые компьютеры — куда идёт этот поезд и надо ли на него запрыгивать.
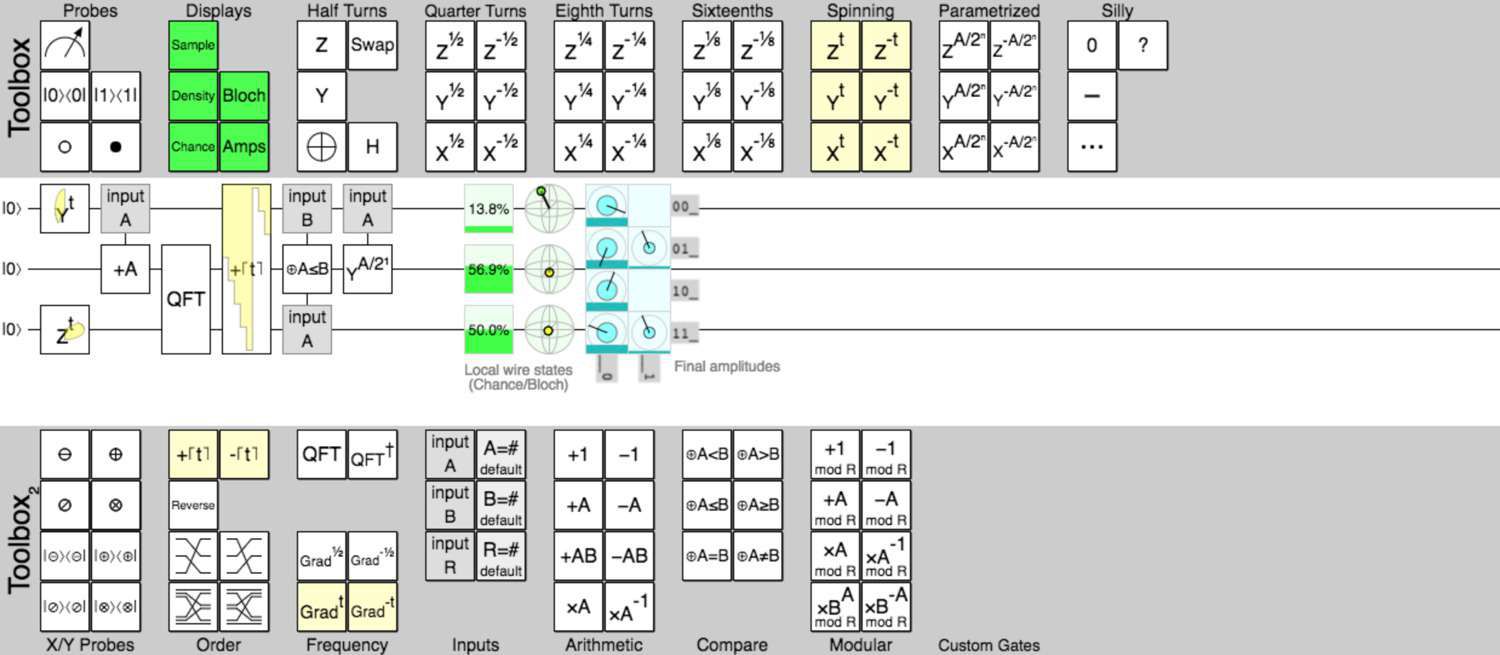
Прочитал несколько статей, посмотрел пару эмуляторов (один из эмуляторов на скриншоте выше) и вот какой вывод сделал.
Квантовые компьютеры в данный момент не являются самостоятельными устройствами — это специализированные чипы, вроде ЦСП, так что правильнее было бы их назвать не компьютерами, а сопроцессорами.
Квантовые сопроцессоры (КС) интересны тем, что имеют колоссальное преимущество в скорости выполнения отдельных алгоритмов, их появление — угроза многим алгоритмам криптографии, например, старичку RSA. Задача перебора его ключей не по плечу классическим компьютерам за разумное время, но с ней справится квантовый сопроцессор с достаточным количеством кубитов.
Думаю появление на рынке гибридов — обычных компьютеров с КС, уже не за горами, а там чипы обрастут соответствующими АПИ, мясом и встроятся в обычные распространённые языки программирования. Специализированные языки программирования уже существуют.
Кажется квантовые компьютеры компании
Азбука Морзе на R
Вдохновившись статьёй с «Хабра», где автор, перекрыв несколько магических методов у объекта в Пайтоне, смог закодировать операторами азбуку Морзе, решил сделать то же на «Эре». Душа требует веселья, а я кажется с прошлого года ничего не писал на этом языке.

Принцип в основном тот же, что и в оригинальной статье — плюс кодирует «точку», «минус» — тире, а вся магия происходит
Обратите внимание, это не строка, это выражение языка «Эр», которое, будучи выполненным, выводит закодированную строку:

У меня специальным символом, в котором хранится объект является точка. Точка не имеет никакого специального значения и является просто частью алфавита, который можно использовать в идентификаторах. В оригинальной программе используется подчёркивание, но в «Эре» его так использовать нельзя.
У объекта, хранящегося в точке перекрыты унарные и бинарные плюс и минус (а так же специальный метод show, чтобы вывести хвост на экран), поэтому когда мы этими операторами записываем код Морзе, например, так:
++++-.++---.На самом деле «Эр» видит код
+(+(+(+(-.)))) + +(-(-(-.)))Унарные операторы применяются к объекту, который копит в своём стеке факт применения и порядок, в котором это было сделано, потом то же делается для второго объекта и в конце применяется бинарный оператор, который выводит на экран левый аргумент и создаёт новый объект из правого.
Можно было бы переливать стек левого операнда в правый, но я не стал так делать для упрощения кода.
То, что получилось лежит на гитхабе. Там же лежит метод toMorseStr, которым можно перекодировать любую латинскую фразу в нужную последовательность.
Проблема при апгрейде Постгреса
Несколько месяцев назад, после прогона на тестовом стенде очередного мажорного обновления Постгреса на одном из проектов, нагрузочные испытания дали плохую картину.
Я в обновлении не участвовал, но наблюдал вполглаза. Заинтересовался что дало такой результат —
Посмотрел какие запросы вылезли наверх в «Барсуке», глазам не поверил — запросы довольно простые, с чего бы им тормозить, посмотрел планы и причину нашёл довольно быстро. Но обо всём по порядку.
Миграцию с одной версии на другую делали полным дампом — идея была под шумок избавиться ещё и от распухания (bloat) таблиц. Не в первый раз такое делали, да и способ довольно обычный.
Но оказалось, что вместе с обновлением админы
А когда восстанавливались из дампа, вот что пошло не так:
sed=> CREATE INDEX du_uid_did ON document_user USING btree (user_id, document_id);
ERROR: temporary file size exceeds temp_file_limit (4194304kB)
Так как проблем никто не ожидал, в лог наливки данных не заглянули, а там процесс прервался на попытке создания одного из индексов. Как результат — не создались этот индекс и все идущие за ним (ещё две штуки), сканирование по индексам в некоторых запросах сменилось на последовательный скан по таблице и всё стало плохо.
Правда выигрывает

Отличную игру подсмотрел у Сэма — в ней одиннадцать уровней, в каждом на экране функция, которая должна вернуть «true», аргумент функции вы пишете сами, причём его длина должна быть минимальной. На каждом уровне указан абсолютный минимум.
Мне пока не удалось победить уровнь №6 (30 символов против 22) и 10 (29 против 27), не хватило свободного времени на работе, чтобы додумать, попробую в выходные.
Решил все. №10 — утром, №6 — уже к полуночи. С номером шесть возился очень долго — пришлось через рефлексию отобрать все функции, которые не имеют обязательных параметров, просмотреть большинство и отбросить кучу интересных, но тупиковых идей.
Выделение памяти (ассемблер под Линукс)
До переезда блога на новый движок я писал аналог команды tee на ассемблере. Тогда передо мной стояла проблема выделения памяти — в команду может быть передано несколько имён файлов, я не знаю сколько, их нужно будет открыть, а под открытые файлы нужно место.
Программу я закончил,

Как я уже упоминал, есть два способа выделить память под Линуксом — sys_brk и sys_mmap. Второй способ используется, когда памяти надо выделить много, очевидно это не мой случай, поэтому я использовал вызов sys_brk. Этот вызов двигает границу так называемой «кучи» (Runtime heap на картинке) вверх (к старшим адресам) и в получившемся пространстве можно
Код выглядит так:
mov rax, 12 ; sys_brk
xor rdi, rdi ; в rdi записываем ноль (получить текущий адрес)
syscall

cmp rax, 0
jl memory_error ; обработка выделения памяти

; в rax у нас указатель на текущую границу кучи
; новый адрес нужно записать в регистр rdi
mov rcx, size ; количество хидеров файлов, которые надо хранить
lea rdi, [rcx * 8 + rax] ; каждый хидер занимает восемь байт
mov rax, 12 ; sys_brk
syscall
То есть получаем старый адрес, прибавляем сколько надо, устанавливаем новый адрес. Все менеджеры памяти Линукса (включая известнейший вызов malloc с Си), используют один из этих двух вызовов или их комбинацию.
Сложнейшие из них умеют сочетать различные стратегии выделения и управлять памятью внутри уже выделенных кусков, разбивая память на более мелкие регионы под нужды приложения, а так же бороться с фрагментацией, которая неизбежно появляется в процессе.
Особенность PHP 7.2 (и 7.1)
Потихоньку смотрю как наш продукт запускается на ПХП версии 7.2 — у нас сейчас используется 7.0, но очень хочется двинуться дальше. В хитросплетениях кода нашёл очень странный баг интерпретатора, который был разбросан по разным строчкам кода, а в сконцентрированном виде он выглядит так:
$arr = [[1]];
array_walk($arr, function(){});
array_map('array_shift', $arr);
var_dump($arr);
В ПХП 7.0 массив выведется в неизменном виде, а в версии 7.2 (и 7.1, как оказалось) единица исчезнет. Очевидно, что array_walk создаёт
ProxyJump ★
Host 10.1.10.*
        IdentityFile ~/.ssh/id_rsa
        #ProxyCommand /usr/bin/ssh -W %h:%p bolk@rptn.tunnel
        ProxyJump rptn.tunnel
Возможности её у́же, зато пользоваться ею проще. Кроме указания в конфиге, её просто использовать и из командной строки, как ключ, причём цепочки выстраиваются очень просто:
ssh -J bolk.sed-php7:2258,rptn.tunnel 10.1.10.158Сейчас в большинстве случаев использую именно этот ключ. С его помощью указывать туннели до того просто, что я даже не утруждают с занесением в конфигурационный файл.
DevelNext
Понадобилось тут по работе быстро накидать графическую утилиту под Виндоуз, пока шли совещания погуглил инструменты и случайно наткнулся на «ДевелНекст» — развитие «ДевелСтудио», о которой я писал восемь лет назад.
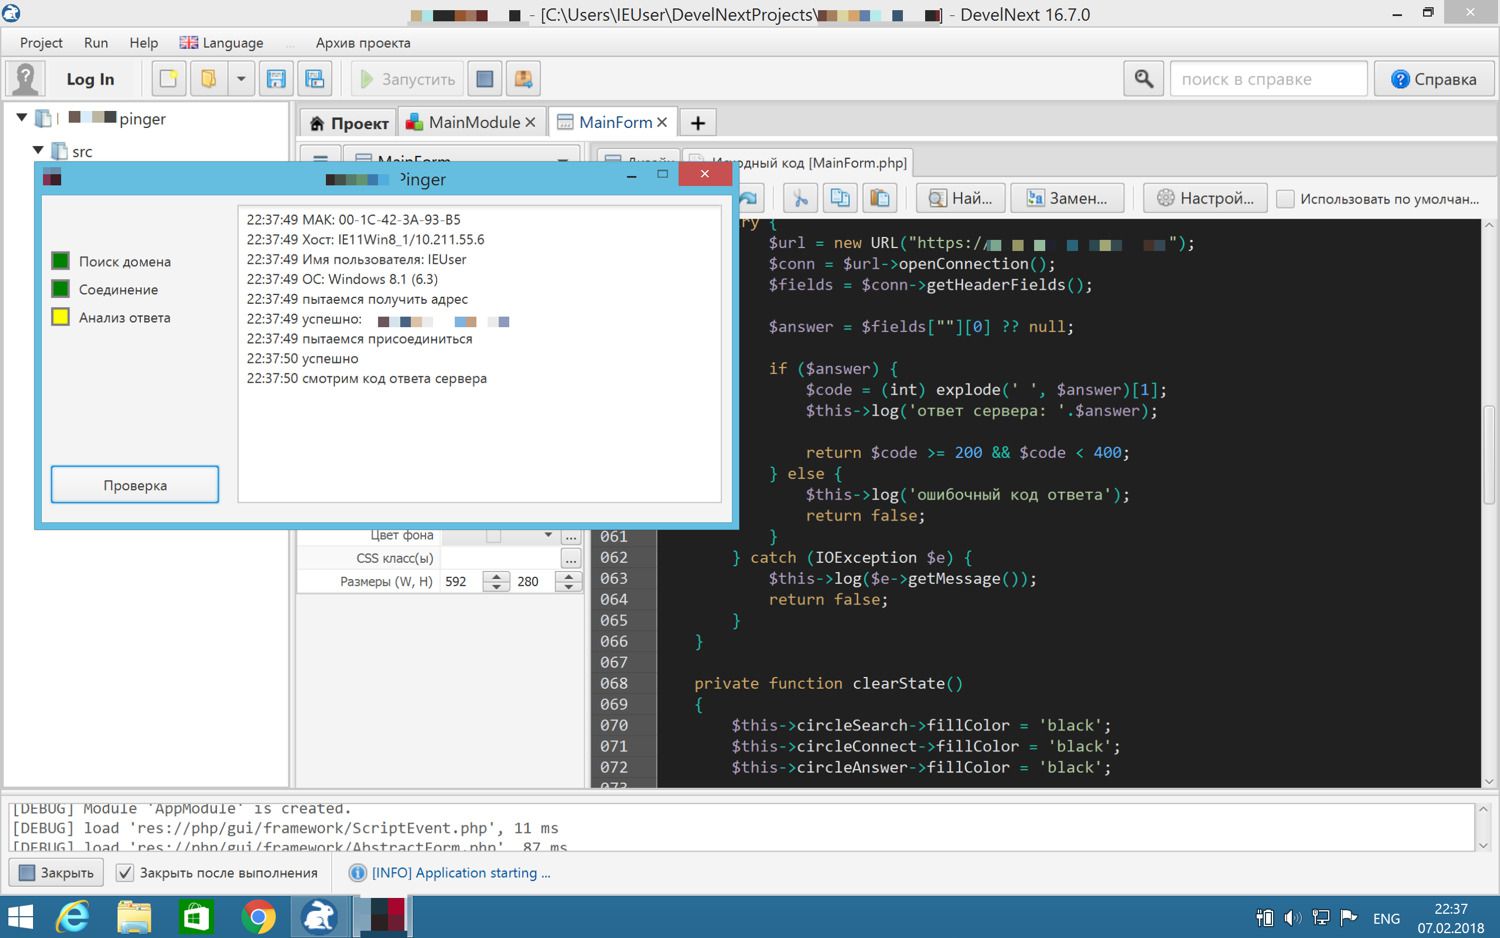
Внутри у неё свой диалект ПХП (JPHP), написанный на Джаве. Отличия от обычного интерпретатора, в основном, в стандартных функциях — они присутствуют не все, но чаще всего есть
С документацией на сайте
Первую версию программы я накидал очень быстро, а потом встрял — мне нужно было по мере выполнения программы показывать индикацию, а она прорисовывалась только после завершения всей работы.
Потерял много времени, пытаясь найти пропавшую с сайта документацию — я догадывался, что всю работу надо выполнять в отдельном треде, чтобы не мешать интерфейсу прорисоваться, но не знал как это сделать. Пока случайно не попал в подраздел «Разного» — оказалось там притаилось решение моей проблемы.
Причём как оказалось, работать надо не просто в отдельном треде, так ещё и изменения интерфейса делать разрешается только через специальную обёртку — функции uiLater и uiLaterAndWait. Пример из документации:
$this->label->text = 'Поток выполняется...';

$thread = new Thread(function () {
    sleep(3); // ждем 3 сек.

    uiLater(function() {
        $this->label->text = 'Поток выполнен.';
    });
});

$thread->start();
На выходе получается обычный запускаемый файл (в моём случае — 3,3 мегабайта, немного по нынешним временам). Внутри — судя по всему, интерпретатор Джавы и скомпилированная
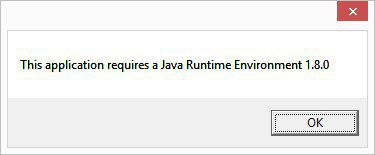
К сожалению, сразу нашёлся баг — если на компьютере пользователя установлена Джава младше версии 1.8, программа запускаться отказывается. Автор «ДевелНекста» вызвался помочь исследовать эту проблему, надеюсь скоро исправит.
Разобрался: ларчик просто открывался! Я так был уверен, что должен получиться всего один файл, что не понял, что папку jre (где и лежит Джава) надо тоже копировать. Это уже менее интересно, конечно.
Моно-но аварэ
Вчера нашёл в себе силы оторваться от вечернего сериальчика и сесть за ассемблер, в итоге моя неповторимая поделочка уже может почти всё, что и жалкий оригинал.
Пока писал, обнаружилась несколько занятных вещей. Ниже серьёзный тон и если вам не нравится программирование, можете смело пропустить этот пост, да и картиночек не будет, совсем печально.
В прошлой версии своей утилиты я сначала пытался файл открыть, если не получалось, то создать. Вообще, есть такой флаг O_CREAT, который можно указать в качестве режима открытия и если файл не существует, он создаётся. У меня не создавался. Я не понимал почему и понял лишь когда запустил strace. Оказалось, что константы, которые я взял
Вторая вещь — я очень давно не программирую на ассемблере и растерял большинство лучших практик. Вот например я не помню как лучше — когда подпрограмма сохраняет регистры, которая она портит или наоборот. Вроде первый вариант выглядит
Ну и последнее, самое интересное. Утилита работает с файлами, а файловые хендлеры надо
Получаются всего несколько вызовов — мне нужен sys_mmap или sys_brk, первый работает с памятью от четырёх килобайт, второй и с менее значительными кусками. Хотя первый вызов мне интереснее, но выглядит он как попытка выстрелить из пушки по воробьям, попробую использовать второй.
Вообще всё это конечно очень непрактично, зато очень увлекательно —
Ассемблер под Линукс ★
Заметка про полноту по Тьюрингу команды присваивания в ассемблере натолкнула меня на мысль, что я
Тогда не довелось, решил вчера попробовать. Теорию в очень общих чертах я знал — есть системные вызовы (сисколы), которые можно дёргать
MOV RAX, 3 ; sys_read
MOV RBX, 0 ; stdin
MOV RCX, string ; адрес строки, которую выведем на экран
MOV RDX, len ; длина строки
INT 0x80
Но я
MOV RAX, 0 ; sys_read
MOV RDI, 0 ; stdin
MOV RSI, string ; адрес строки, которую выведем на экран
MOV RDX, len ; длина строки
SYSCALL
К тому времени меня посетила мысль сделать простенький аналог линуксовой утилитки tee, но для этого нужно было
Так как системный вызов для открытия файла (sys_open) как раз требует на вход сишную строку, я передал указатель, который взял со стека, в сискол, ожидая, что всё заработает. Это было моей ошибкой. Я потратил не меньше часа, разбираясь, что я сделал не так, перебирал способы передачи параметров, ползал по стеку при помощи отладчика gdb, ничего не помогало, пока не забрезжила догадка, что сами параметры командной строки тоже лежат на стеке и системному вызову это может не нравится.
Попробовал скопировать строку оттуда в данные и всё заработало. Не знаю что это было, пока не гуглил, возможно сделано из соображений безопасности. Времени потерял изрядно.
Пока получилась очень простая утилитка, но хочу её дописать как выпадет свободный вечер — сделать поддержку указания нескольких файлов и флага для режима присоединения. Размер радует, кстати, — всего 752 байта.
Дизассемблируй это ★
В моей жизни последовательно сменяли друг друга три ассемблера. Первый, для компьютера
В те времена я думал, что всю жизнь буду программировать на ассемблере, на деле же последнюю программу на нём написал в начале
В ассемблере есть такая команда — MOV (в некоторых ассемблерах — LD), записывает содержимое одного аргумента в другой. Сейчас набор комманд разросся, аргументом может быть почти что угодно — регистр, ячейка в памяти, сумма некоторого числа, одного регистра и другого, умноженного на число, но по сути это всегда присваивание.
И вот оказалось, что эта команда — полная по Тьюрингу. Звучит невероятно, но это так. Некие ребята заморочились и сделали компилятор, который компилирует любую программу на Си в последовательность команд MOV. Причём им даже ДУМ удалось скомпилировать, правда один кадр рисуется семь часов. Кстати, такая программа неуязвима для горюшка века — Мелтдауна и Спектра.
Есть небольшая (на 156 страниц и 90% воды) презентация, достаточно популярно объясняющая как этого удалось достичь, но для её чтения надо знать ассемблер, поэтому я позволю себе раскрыть детали трансляции двух инструкций, чтобы пояснить принцип для тех, кто ассемблера не знает или ленится причитать.
Например, сравнение двух чисел делается при помощи следующего псеводокода:
mov [X], 0
mov [Y], 1
mov R, [X]
У нас есть два числа в аргументах «X» и «Y», результат сравнения которых попадает в «R» — там будет ноль, если числа не равны и единица в противном случае. Как же это работает?
Первой командой ноль записывается в ячейку по адресу «X». Это ассемблер, у нас тут всё — число, остальное — человеческие интерператации, поэтому записанное в «X» мы используем как адрес. Второй командой единица записывается в ячейку по адресу «Y». Третьей командой мы читаем значение по адресу «X» и если значения в «X» и «Y» совпадают, то ноль перетрётся единицей (и она попадёт в R), если нет, то в ячейке по адресу «X» ноль останется (который попадёт в R).
Несложно. Но из кода выше непонятно как получаются другие необходимые инструкции. Увы,
Возьмём, например, логическое «ИЛИ» («OR»), тут чуточку сложнее:
OR_ADDRS: dd OR_0, OR_1
OR_0: dd 0, 1
OR_1: dd 1, 1
; …
mov eax, X
mov edx, [OR_ADDRS + eax]
mov eax, Y
mov eax, [eax + edx]
mov R, eax
Во всех логических операциях ребята используют записанные заранее неизменяемые массивы значений.
Что тут происходит? В регистр (переменную, с которыми работает процессор) «eax» записывается значение «X» (возможные входные значения у нас тут — ноль или единица, численное представление булевых значений).
Далее в регистр «edx» записывается число из адреса, который является суммой адреса массива OR_ADDRS и содержимого регистра eax. Таким образом в eax попадёт OR_0 или OR_1, в зависимости от того былы записаны в eax ноль или единица. Эти значения — тоже числа и являются адресами двух других массивов из двух элементов.
Далее в eax мы записываем аргумент Y, его значение складывается с адресом полученным на предыдущем шаге и из получившегося адреса мы читаем записанное там значение. В переводе на ПХП получается следующее:
function mov_or(int $X, int $Y): int
{
    define('OR_0', [0, 1]);
    define('OR_1', [1, 1]);

    define('OR_ADDRS', [OR_0, OR_1]);

    $R = OR_ADDRS[$X][$Y];

    return $R;
}
Кстати, интересно, что у знаменитого дисассемблера «ИДА» от полученной таким образом программы крепко уносит крышу — при попытке отладки диссасемблер не видит никаких ветвлений и падает на анализе кода. Получился бы неплохой метод защиты от анализа, если бы не производительность.
Что есть истина?
У нашего бывшего сотрудника в фейсбуке увидел ссылку на любопытную задачку — может ли (a == 1 && a == 2 && a == 3) быть «истиной» в ДжаваСкрипте?
Не заглядывая в статью, я предложил два варианта, вполне очевидный первый:
a = ((counter) => ({valueOf:() => ++counter}))(0)
// {valueOf: ƒ}
a == 1 && a == 2 && a == 3
// true
И второй — на суррогатных парах. Но по ссылке есть ряд других занимательных способов — через геттеры, похожие символы Юникода (мне приходил в голову такой вариант, но я не смог подобрать три символа, одинаковых на вид), другие специальные методы и прочее. Больше всех мне понравился такой способ:
a = [1,2,3];
a.join = a.shift;

a == 1 && a == 2 && a == 3
// true
Очень просто и элегантно — массив при преобразовании в скаляр в ДжаваСкрипте, всегда сначала преобразуется в строку значених, объединённых через запятую. В коде выше метод для объединения заменяется методом, который забирает из массива первый элемент. И всё работает как требуется — при каждом сравнении массива с числом, забирается первый элемент массива.