php
Стоимость вызова функции в ПХП
В комментариях к предыдущей заметке мне напомнили о немаловажной подробности, которую я упустил из вида в прошлый раз — в ПХП вызов функции дорогое удовольствие. Как пишут на демотиваторах «по возможности избегайте этого».
Например, если в прошлом примере с массивами array_push заменить на добавление элемента в массив через „[]“, то производительность сразу возрастёт на 0,04 секунды.
В самом деле, есть масса ситуаций, когда вызов функции можно заменить конструкцией или получением данных из константы, так же существуют частные случаи, когда такая замена возможна:
# занесение элемента в массив:
array_push($stack, $element);
$stack[] = $element;

# получение версии ПХП, есть ещё
# PHP_MAJOR_VERSION, PHP_MINOR_VERSION, PHP_RELEASE_VERSION, PHP_VERSION_ID и PHP_EXTRA_VERSION
if (phpversion() === "5.0.0") {}
if (PHP_VERSION === "5.0.0") {}

# способ подключения ПХП
if (php_sapi_name() === 'cli') {}
if (PHP_SAPI === 'cli') {}

# проверка существования ключа, но, увы, это не одно и тоже:
# isset не покажет true, если ключ существует, но значение null
if (array_key_exists('key1', $arr) && array_key_exists('key2', $arr)) {}
if (isset($arr['key'], $arr['key2'])) {}

# для массивов, ключи которых не перекрываются (операция «+» добавит только те ключи,
# которые отсутствуют в первом массиве)
$arr = array_merge($arr1, $arr2);
$arr = $arr1 + $arr2;

# операционная система
if (php_uname('s') === 'Darwin') {}
if (PHP_OS === 'Darwin') {}

# получение переменной окружения. Есть отличие: массив $_ENV может быть перезаписан другим кодом,
# при этом реальное значение переменной окружения не изменится, кроме того,
# getevn не сгенерирует предупреждение, если значения с таким ключом нет
if (getenv('VARNAME') === 'value') {}
if ($_ENV['VARNAME'] === 'value') {}
Наверняка есть и ещё случаи, которые я не смог сходу вспомнить, буду благодарен, если
Производительность различных реализаций стека в ПХП

Я совсем перестал писать на технические темы в блоге. Это объяснимо: я много разрабатываю, но поделиться нечем, всё это весьма специфично для системы документооборота. Недавно, например, я думал над тем какой бы язык применить для описания фильтров в системе. Они должны срабатывать много и часто, и опосредованно управлять движением документов. Пользователь писать самостоятельно их не будет (или почти не будет), они будут составяться «конструктором», но система
Выбрал обратную польскую запись. Она компактна, просто парсится, для неё не нужно строить дерево, там нет скобок, но при этом по мощности польностью эквивалентна привычной всем со школы записи. Идея в том, что сначала на стек записываются операнды, а потом указывается операция, которая берёт их со стека и записывает обратно результат:
# традиционная запись:
(5 + 7) * 3
# обратная польская:
5 7 + 3 *
# а можно так:
3 5 7 + *
Так как упор на производительность, я реализовал простенькую стековую машинку с операциями сложения, вычитания, умножения, проверки на равенство и дублирования вершины стека с использованием простых массивов, ArrayObject и SplStack, чтобы проверить как в ПХП (на котором пишется наша система) дела с производительностью стека. ArrayObject тут скорее для полноты картины, так как у него нет метода pop, который доставал бы элемент с вершины, так что пришлось заменить его на отдельную функцию.
Результаты следующие:
mac@mac ~/Sites/test  $ php autoc/stack.php
Array: 0.27216792106628
Array Object: 0.7418909072876
SplStack: 0.29819416999817
Как видно, примитивные типы
Для интереса, релизовал примерно то же самое на Пайтоне (только DUP немного иначе работает, для скорости):
from __future__ import print_function
import time

input = '10 20 100 + - 20 * DUP 10 20 + * =';
operations = {
    '+': lambda: stack.append(stack.pop() + stack.pop()),
    '-': lambda: stack.append(stack.pop() - stack.pop()),
    '*': lambda: stack.append(stack.pop() * stack.pop()),
    '=': lambda: stack.append(stack.pop() == stack.pop()),
    'DUP':  lambda: stack.append(stack[0]),
    'DUMP': lambda: print(stack)
}

t = time.time()

for x in xrange(0, 10000):
    stack = []

    for chunk in input.split(' '):
        operations.get(chunk, lambda: stack.append(int(chunk)))()

print('Python list: %f' % (time.time() - t))
Время выполнения — 0,56 секунды, то есть на ПХП быстрее. Зато, если запустить этот код через PyPy (это интерпретатор с JIT), то результат куда более впечатляет — 0,10 секунды.
Размер имеет значение
Такая ещё вещь в ПХП вызывает мою искреннюю печаль. В руководстве написано, что при приведении переменной к булевскому типу, строка «"0"» трактуется как false:
var_dump( (bool) "0"); // false
var_dump( (bool) "00"); // true
Сделано это по определённым причинам. ПХП, исторически, был языком не просто для чайников, а для фанерных чайников, когда снаружи приходят параметры в GET или POST запросе, ПХП их раскладывает в специальные переменные, но все данные имеют тип «строка» (иногда — массив строк).
Дальше, и тут есть своя логика, если снаружи приходит ноль, ПХП решает
Поэтому я называю ПХП языком не с «динамическим приведением типов», а с «нестабильным приведением типов». Потому что его правила приведения содержат исключения.
Такой «строковый ноль» может привести к сюрпризам:
var_dump(array_filter( [ 0, null, false, "00", "0" ])); // останется один элемент — "00"
var_dump(in_array("0", [ false ])); // true
Или вот, например, поведение конструкции «empty» с той же строкой (именно из документации по этой конструкции я узнал о существовании такого нуля, ещё в ПХП3):
$z = "0"; $zz = "00";
var_dump(empty($z)); // true
var_dump(empty($zz)); // false
При этом, один пробел и всё, ноль перестаёт быть «магическим»:
var_dump(in_array(" 0", [ false ])); // false☁ == ☀
Как знают программисты на ПХП, у этого языка есть одна неприятная особенность: при сравнении с приведением типов („==“) ПХП всё, что по его мнению похоже на число, преобразует в число:
If you compare a number with a string or the comparison involves numerical strings, then each string is converted to a number and the comparison performed numerically.
Причём, «похоже на число» — это не обязательно нечто десятичное:
var_dump("0x01" == "1"); // true
// но при этом
var_dump("0b01" == "1"); // false
var_dump("014" == "12") // false
Эта проблема косвенно проявляется при поиске в массиве. Казалось бы, строкового значения «1.5» в массиве нет:
var_dump(in_array("1.5", ["01.5000"])); // true
// правда есть специальный флаг для строгого стравнения, о котором почему-то мало кто знает:
var_dump(in_array("1.5", ["01.5000"], true)); // false
Но настоящая проблема вот в чём. ПХП, конечно, смотрит, похожа ли строка на то, что он считает числом, но никак не проверяет сможет ли он «съесть то, что укусил»:
var_dump("10000000000000000000000000000000" == "10000000000000000099999999999999"); // trueСюрприз?
Почему так происходит. Всё очень просто. ПХП решает: внутри строки одни цифры, нужно преобразовать в число, в целый это не помещается, поэтому преобразую в число с плавающей точкой. Но число с плавающей точкой хранится с некой точностью, такова плата за его быструю обработку машиной.
В итоге при конвертации происходит потеря точности, левая и правая часть конвертируются в 1e31 (единица с с 31 нулём), которые равны между собой. Это может произойти, например, тогда, когда мы сравниваем «двумя равно» пару хешей, которые содержат только цифры.
Вывод: используете всегда только строгое равенство („===“) и вызовы функций сравнения с флагами, отключающими приведение типов, если только вы чётко не понимаете когда это правило можно нарушить. Но.
Есть конструкция, которой мы управлять не можем:
switch ("1.5") {
    case "0001.500": echo "пичалька"; // ещё какая!
}
Конструкция «switch» всегда использует нестрогое сравнение, об этом нужно помнить.
Чем плох ПХП
На «Хабре» появился перевод статьи «PHP: фрактал плохого дизайна». Отличная статья, расставляющая все точки над «ё» в этом вопросе. Кстати, вот штука, которую я не знал:
bolk@Bolk ~  $ php <<PHP
> <?
> function __lambda_func() {
> };
>
> create_function('', 'return;');
> PHP

Fatal error: Cannot redeclare __lambda_func() (previously declared in -:3) in -(5) : runtime-created function on line 1
ПХП, при использовании функции create_function сначала создаёт функцию __lambda_func (чтобы потом её переименовать), а если она уже
PHP 5.4
Поставил себе на ноут ПХП 5.4, смотрю как работает. Трейты, конечно, приятная штука, но гораздо важнее, что синтаксис в порядок стали приводить. К сожалению, с первой попытке порядок навести не удалось, но стало гораздо логичнее.
class B {
   function arr() {
       return [
           'i' => 0b101,
           'f' => function () {
               return ['i' => 1];
            }
       ];
   }
}

var_dump((new b)->arr()['i']); // works!
var_dump(call_user_func((new b)->arr()['f'])['i']); // still works…
var_dump((new b)->arr()['f']()); // don't :(
В примере дан класс «B», метод «arr» которого возвращает массив из двух элементов. По индексу «i» там число, по «f» — анонимная функция, которая так же возвращает массив. В новом (5.4) ПХП есть возможность получить элемент массива, возвращаемый функцией, не присваивая его переменной (и, кстати, вызвать метод объекта сразу после его создания).
Но увы, пока нельзя так же вольно обращаться с функциями, приходится их оборачивать в «call_user_func». Но я рад, что ПХП постепенно избавляется от своих болезней.
Обратите внимание на более короткий синтаксис массивов. Это начинает походить на своеобразный стандарт уже.
Что нового в ПХП 5.4
Илья Альшанетский (это один из разработчиков ПХП) подготовил презентацию в формате ПДФ о том о самых важных нововведениях ПХП 5.4.
ПХП и Винда
Порядка полугода назад разговаривали
А тут, на днях, нужно было продумать
По задумке внешний клиент дёргает «ручку» у сервиса, получает некий идентификатор и ждёт до поры до времени. Работа сервиса же
Функция не заработала правильно ни с «Апачем», ни с «Энжиникс», в комментариях пользователей к документации есть одинокий комментарий
Note that register_shutdown_function() does not work under Apache on Windows platforms. Your shutdown function will be called, but the connection will not close until the processing is complete. Zend tells me that this is due to a difference between Apache for *nix and Apache for Windows.
Похоже с тех пор ничего не изменилось. Ну хорошо, я вспомнил, что в последние ПХП входит патч
Решили не перебирать больше решения, а сразу перейти на запуск отдельного фонового процесса. Оказалось и это не тривиально сделать. Под «Виндой» нужно это делать следующим образом:
$commandline = 'start /b тут-программа-которую-надо-запустить';
pclose(popen($commandline, 'r'));
Сплошные приключения.
%u → UTF-8
Столкнулся сегодня с задачей — надо сконвертировать пришедшую из JavaScript строку (в ней символы Юникода в виде «%uXXXX»)
echo json_decode(str_replace('%u', '\\u', json_encode($str_from_javascript)));Сканирование по фамилии на сайте MyHeritage
Я «дерево» своих родственников храню на сайте «MyHeritage» (сейчас там 543 человека, но это включая очень дальних). На сайте есть интересная функция,
На сайте зарегистрирован 61 миллион пользователей и заведено 861 миллион профилей, так что функция имеет смысл. Наша с женой практика это подтверждает — нашлись три дерева её родственников.
У меня из родни пока никто не нашёлся, поэтому я решил поискать сам. Написал скрипт, который сканирует выдачу поиска по сайту и выдаёт администраторов найденных сайтов. Открываете полученные УРЛы в браузере и пишете всем им письмо. Автоматическую рассылку я делать не стал, смысла нет, на сайте полный набор защиты — разные виды «капчи» и лимит на количество сообщений в сутки. У меня получилось порядка 35 ссылок на мою фамилию, ради этого делать полную автоматику не интересно. Код скрипта.
<?php
    $SURNAME = array('Иванов', 'Иванова');
    $EXCLUDETREE = array(111111); // дерево, которое надо пропустить (например, ваше собственное)

    $MANMASK = 'http\://www\.myheritage\.com/person\-(\d+)_(\d+)_(\d+)/[^"]+';
    $CONTACTMASK = 'contactWebmasterViaInbox\((\d+)\)';
    $CONTACTURL = 'http://www.myheritage.com/site-%d/t?lang=RU';
    $URL = 'http://www.myheritage.com/FP/smart-research-search.php?offset=%d&l=%s';

    $trees = array();

    $context = stream_context_create(array(
        'http' => array(
            'method' => 'GET',
            'header' => "User-agent: Opera/9.80 (Darwin x86_64; U; Edition Next; ru) Presto/2.10.238 Version/12.00\r\n".
                        "Accept-encoding: gzip",
            'protocol_version' => PHP_VERSION >= 5.3 ? '1.1' : '1.0',
            'timeout' => 5,
        )
    ));

    foreach ($SURNAME as $surname) {
        echo 'Поиск по фамилии «', $surname, "».\n";

        for ($i = 0;;$i += 10) {
            echo 'Смещение: ', $i;

            $content = DecodeResponse(file_get_contents(sprintf($URL, $i, urlencode($surname)), false, $context), $http_response_header);

            echo ", длина полученного документа: ", strlen($content), " байт, ";

            if (preg_match_all("!$MANMASK!", $content, $m)) {
                echo 'найдено записей: ', $peoplecount = count($m[0]), ".\n";

                $trees = array_merge($trees, $m[3]);
            } else {
                $peoplecount = 0;
                echo "записей не найдено.\n";
            }

            if ($peoplecount != 10) {
                break;
            }
        }
    }

    $trees = array_diff(array_unique($trees), $EXCLUDETREE);

    echo 'Найдено деревьев: ', count($trees), ".\n";

    foreach ($trees as $id) {
        $content = DecodeResponse(file_get_contents(sprintf($CONTACTURL, $id), false, $context), $http_response_header);

        if (preg_match("!$CONTACTMASK!", $content, $m)) {
            echo "http://www.myheritage.com/FP/inbox.php?lang=RU&compose=1&recipient={$m[1]}&type=1\n";
        }
    }

    function DecodeResponse($content, $headers) {
        foreach ($headers as $header) {
            if (stripos($header, 'Content-Encoding:') === 0 && strpos($header, 'gzip') !== false) {
                return gzinflate(substr($content, 10));
            }
        }

        return $content;
    }
Картинка на чистом CSS-2

Я тут всё это время думал как дёшево улучшить свой конвертор картинок в чистый CSS и придумал.
Выкинул 89 79. Это уже неплохо, в сжатом (gzip) виде этот код занимает 19КБ, что всего в два с половиной раза больше, чем исходное изображение в PNG. Результат можно сильно улучшить, если отказаться от повтора цвета, но изображения с мелкими деталями (с текстом, например) пострадают.
Кстати говоря, логотип студии Лебедева при конвертации из PNG (6,7КБ) уменьшился до 1,6КБ 1,3КБ. Это уже реальная экономия, если бы не префиксы браузеров.
Отказ от радиального градиента в пользу линейного позволил мне кодировать целую строку изображения одной конструкцией, что, в свою очередь, позволило сильно экономить на повторяющихся байтах (кстати, можно попробовать группировать пиксели по вертикали и горизонтали, а потом выбирать лучший вариант).
Кстати этот раз «Опера», увы, не смогла показать картинку, так как, похоже, не поддерживает позиционирование для линейных градиентов.
Добавлено позднее: сделал оптимизацию, теперь конвертор делает два прогона: один просматривает пиксели по горизонтали, второй по вертикали. Выбирается тот, который даёт наименьший результат.
Ключи запуска те же.
<?
// ffccbb → fcb
// ff0000 → red
// abcdef → abcdef
function Bo_shortcolor($color) {
    static $shortnames = array(
        "c0c0c0" => "silver",
        "808080" => "gray",
        "800000" => "maroon",
        "ff0000" => "red",
        "800080" => "purple",
        "008000" => "green",
        "808000" => "olive",
        "000080" => "navy",
        "008080" => "teal",
        "f0ffff" => "azure",
        "f5f5dc" => "beige",
        "ffe4c4" => "bisque",
        "a52a2a" => "brown",
        "ff7f50" => "coral",
        "ffd700" => "gold",
        "808080" => "gray",
        "008000" => "green",
        "808080" => "grey",
        "4b0082" => "indigo",
        "fffff0" => "ivory",
        "f0e68c" => "khaki",
        "faf0e6" => "linen",
        "800000" => "maroon",
        "000080" => "navy",
        "808000" => "olive",
        "ffa500" => "orange",
        "da70d6" => "orchid",
        "cd853f" => "peru",
        "ffc0cb" => "pink",
        "dda0dd" => "plum",
        "800080" => "purple",
        "ff0000" => "red",
        "fa8072" => "salmon",
        "a0522d" => "sienna",
        "c0c0c0" => "silver",
        "fffafa" => "snow",
        "d2b48c" => "tan",
        "008080" => "teal",
        "ff6347" => "tomato",
        "ee82ee" => "violet",
        "f5deb3" => "wheat",
    );

    $c = strtolower($color);
    if (isset($shortnames[$c])) {
        return $shortnames[$c];
    }

    if ($c[0] == $c[1] && $c[2] == $c[3] && $c[4] == $c[5]) {
        return '#' . $c[1] . $c[3] . $c[5];
    }

    return '#' . $c;
}

class Bo {
    public function __get($num) {
        return $num ? $num . 'px' : 0;
    }
}

function Bo_convert_helper($im, $lim1, $lim2, $getpix, $dotmask, $z) {
    $end  = $lim1 - 1;
    $dots = array();

    for ($o1 = 0; $o1<$lim2; $o1++) {
        $coll = array();
        $prev    = null;
        $start   = 0;

        for ($o2 = 0; $o2<$lim1; $o2++) {
            $pixel = $getpix($im, $o2, $o1);

            if ($prev !== null && $prev !== $pixel || $o2 == $end) {
                if ($prev !== null) {
                    $color = Bo_shortcolor(vsprintf('%02x%02x%02x', $prev));

                    $coll[] = "$color {$z->$start},$color {$z->$o2}";
                }

                if ($o2 == $end && $prev != $pixel) {
                    $color = Bo_shortcolor(vsprintf('%02x%02x%02x', $pixel));
                    $cell[] = "$color {$z->$o2}";
                }

                $start = $o2;
            }

            $prev = $pixel;
        }

        $dots[] = sprintf($dotmask, implode(',', $coll), $z->$o1);
    }

    return $dots;
}


function Bo_convert($filename, $prefix = '') {
    $z = new Bo();

    if (!file_exists($filename) && !is_readable($filename)) {
        throw new Exception('File not found.');
    }

    $types = array(
        IMAGETYPE_JPG => 'jpeg',
        IMAGETYPE_PNG => 'png',
        IMAGETYPE_GIF => 'gif',
    );

    $imagedata = @getimagesize($filename);
    if (!is_array($imagedata) || !isset($imagedata[2]) || !isset($types[$imagedata[2]])) {
        throw new Exception('Unknown image format');
    }

    $im = call_user_func("imagecreatefrom" . $types[$imagedata[2]], $filename);
    $sw = $w = imagesx($im);
    $sh = $h = imagesy($im);

    $hfunc = create_function('$im, $x, $y', 'return imagecolorsforindex($im, imagecolorat($im, $x, $y));');
    $hmask = "{$prefix}linear-gradient(0,%s) 0 %s";

    $hdots = join(',', Bo_convert_helper($im, $w, $h, $hfunc, $hmask, $z));

    $vfunc = create_function('$im, $y, $x', 'return imagecolorsforindex($im, imagecolorat($im, $x, $y));');
    $vmask = "{$prefix}linear-gradient(90,%s) %s 0";

    $vdots = join(',', Bo_convert_helper($im, $h, $w, $vfunc, $vmask, $z));

    if (strlen($hdots) > strlen($vdots)) {
        $dots = $vdots;
        $sw = 1;
    } else {
        $dots = $hdots;
        $sh = 1;
    }

    return <<<HTML
<head>
<title>$filename converted in background by Evgeny Stepanischev //bolknote.ru</title>
<style text="text/css">
    div {
        background: $dots;
        background-repeat: no-repeat;
        {$prefix}background-size: {$sw}px {$sh}px;
        background-size: {$sw}px {$sh}px;
        width: {$w}px; height: {$h}px;
    }
</style>
<body>
<div></div>
</body>
HTML;
}

if ($_SERVER['argc'] < 2) {
    echo <<<HELP
Image to background CSS convertor v2 by Evgeny Stepanischev. //bolknote.ru Nov 2011

Usage: {$_SERVER['argv'][0]} filename [prefix]

filename  - image file name (PNG, JPEG or GIF)
prefix    - your browser name (Opera, IE, FF, Safari, Chrome)

HELP;
exit;
}

$browsers = array(
    'ie'     => '-ms-',
    'opera'  => '-o-',
    'safari' => '-webkit-',
    'chrome' => '-webkit-',
    'chromium' => '-webkit-',
    'ff' => '-moz-',
    'firefox' => '-moz-',
);

if (isset($_SERVER['argv'][2])) {
    $type = strtolower($_SERVER['argv'][2]);
    $prefix = isset($browsers[$type]) ? $browsers[$type] : '-' . $type . '-';
} else {
    $prefix = '';
}

try {
    echo Bo_convert($_SERVER['argv'][1], $prefix);
} catch (Exception $e) {
    echo "Error: ", $e->getMessage(), "\n";
    exit(1);
};Хочу поменять библиотеку для OpenID на сайте
Хочется поменять библиотеку, которую я использую для OpenID на сайте. Я сейчас использую Janrain OpenID, но она давно не обновлялась, генерирует варнинг и только с костылями и патчами работает с реализацией OpenID в ЖЖ
Посоветуйте
Требования — библиотека должна поддерживать OpenID 1.x и 2.x, SREG, предоставлять возможность хранить данные где я укажу (мне нужно на диске, а не в БД) и не должна использовать экзотические модули.
Картинка на чистом CSS
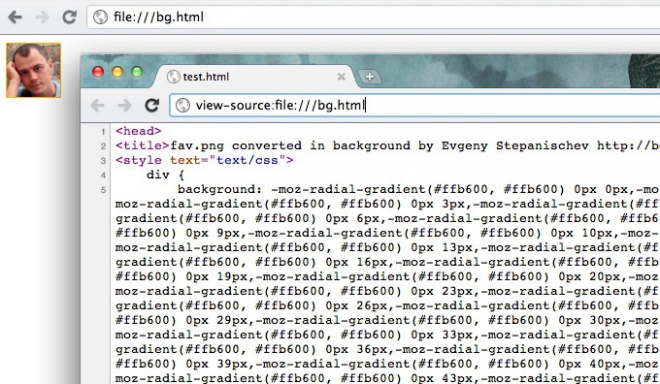
Сейчас CSS позволяет делать всё более интересные вещи. Раз уж сегодня короткий день, за 20 минут из «сэкономленного» часа накидал программу, которая конвертирует любую картинку (в форматах PNG, JPEG или GIF) в чистый CSS (без использования dataURI). Каждая точка кодируется через одну конструкцию
Если заморачиваться серьёзно, то можно выявлять в картинке области с градиентом (так делается в формате PNG для упаковки) и покрывать их целиком одной конструкцией, а так же оптимизировать наложением линейных градиентных областей с прозрачностью (через rgba или hsla). Достаточно интересная программисткая задача, кстати.
Самую очевидную оптимизацию я сделал в пробке по работе домой — выделил самый частый цвет и пустил его на фон, выиграл примерно 11,5КБ на картинке в примере.
За 20 минут я только успел сделать небольшой конвертор (результат работы можно посмотреть в разделе «Храню», только для «Хрома»). Так как синтаксис завязан на префиксы, то я в генераторе сделал указание браузера под который нужно сгенерировать код (поддерживаются: IE, Opera, Firefox и Chrome). Всё это весьма расточительно, картинка 75×75 занимает 164КБ.
У меня заработало для «Хрома» и «Файэрфокса», под «Оперой» не завелось, лень проверять что она не поддерживает, IE попробовать не могу — его не бывает на «Маках». Код конвертора
// Конвертор картинки в чистый CSS, / ноябрь 2011

<?
// ffccbb → fcb
// ff0000 → red
// abcdef → abcdef
function Bo_shortcolor($color) {
    static $shortnames = array(
        "#000080" => "navy",
        "#008000" => "green",
        "#008080" => "teal",
        "#4b0082" => "indigo",
        "#800000" => "maroon",
        "#800080" => "purple",
        "#808000" => "olive",
        //"#808080" => "gray",
        "#808080" => "grey",
        "#a0522d" => "sienna",
        "#a52a2a" => "brown",
        "#c0c0c0" => "silver",
        "#cd853f" => "peru",
        "#d2b48c" => "tan",
        "#da70d6" => "orchid",
        "#dda0dd" => "plum",
        "#ee82ee" => "violet",
        "#f0e68c" => "khaki",
        "#f0ffff" => "azure",
        "#f5deb3" => "wheat",
        "#f5f5dc" => "beige",
        "#fa8072" => "salmon",
        "#faf0e6" => "linen",
        "#ff0000" => "red",
        "#ff6347" => "tomato",
        "#ff7f50" => "coral",
        "#ffa500" => "orange",
        "#ffc0cb" => "pink",
        "#ffd700" => "gold",
        "#ffe4c4" => "bisque",
        "#fffafa" => "snow",
        "#fffff0" => "ivory",
    );

    $c = strtolower($color);
    if (isset($shortnames[$c])) {
        return $shortnames[$c];
    }

    if ($c[0] == $c[1] && $c[2] == $c[3] && $c[4] == $c[5]) {
        return '#' . $c[1] . $c[3] . $c[5];
    }

    return '#' . $c;
}

function Bo_convert($filename, $prefix = '') {
    if (!file_exists($filename) && !is_readable($filename)) {
        throw new Exception('File not found.');
    }

    $types = array(
        IMAGETYPE_JPG => 'jpeg',
        IMAGETYPE_PNG => 'png',
        IMAGETYPE_GIF => 'gif',
    );

    $imagedata = @getimagesize($filename);
    if (!is_array($imagedata) || !isset($imagedata[2]) || !isset($types[$imagedata[2]])) {
        throw new Exception('Unknown image format');
    }

    $im = call_user_func("imagecreatefrom" . $types[$imagedata[2]], $filename);
    $w  = imagesx($im);
    $h  = imagesy($im);

    // Самый частый цвет идёт на background-color
    $colorfreq = array();
    for ($x = 0; $x<$w; $x++) for ($y = 0; $y<$h; $y++) @$colorfreq[imagecolorat($im, $x, $y)]++;

    $bg = array_search(max($colorfreq), $colorfreq);

    for ($x = 0; $x<$w; $x++)
    for ($y = 0; $y<$h; $y++) {
        $pixel = imagecolorat($im, $x, $y);
        if ($pixel != $bg) {
            $color = Bo_shortcolor(sprintf('%06x', $pixel));

            $dots[] = "{$prefix}radial-gradient($color,$color) {$x}px {$y}px";
        }
    }

    $dots = join(',', $dots);
    $bg   = Bo_shortcolor(sprintf('%06x', $bg));

    return <<<HTML
<head>
<title>$filename converted in background by Evgeny Stepanischev //bolknote.ru</title>
<style text="text/css">
    div {
        background: $dots;
        background-repeat: no-repeat;
        {$prefix}background-size: 1px 1px;
        background-color: $bg;
        background-size: 1px 1px;
        width: {$w}; height: {$h};
    }
</style>
<body>
<div></div>
</body>
HTML;
}

if ($_SERVER['argc'] < 2) {
    echo <<<HELP
Image to background CSS convertor by Evgeny Stepanischev. //bolknote.ru Nov 2011

Usage: {$_SERVER['argv'][0]} filename [prefix]

filename  - image file name (PNG, JPEG or GIF)
prefix    - your browser name (Opera, IE, FF, Safari, Chrome)
HELP;
exit;
}

$browsers = array(
    'ie'     => '-ms-',
    'opera'  => '-o-',
    'safari' => '-webkit-',
    'chrome' => '-webkit-',
    'chromium' => '-webkit-',
    'ff' => '-moz-',
    'firefox' => '-moz-',
);

if (isset($_SERVER['argv'][2])) {
    $type = strtolower($_SERVER['argv'][2]);
    $prefix = isset($browsers[$type]) ? $browsers[$type] : '-' . $type . '-';
} else {
    $prefix = '';
}

try {
    echo Bo_convert($_SERVER['argv'][1], $prefix);
} catch (Exception $e) {
    echo "Error: ", $e->getMessage(), "\n";
};
Черновики у меня в комментариях
Мне тут хочется пару проектов на PHP доделать, а я
В том числе сделал то, что давно просили — черновики в комментариях. Работает только в современных браузерах — IE 8.0+, FF 3.5+, Safari 4.0+, Chrome 4.0+, Opera 10.5+, а так же iOS 2.0+ и Андроид 2.0+. Только такой список, так как сохранение происходит в localStorage.
localStorage — это клиентская база данных «ключ и значение», которые есть сейчас уже во всех распространённых браузерах. Преимущество хранения черновиков именно в ней — черновик сохраняется вне зависимости от того рухнул сервер или нет, ведь localStorage сохраняет данные на диске клиента.
Кстати, я делал библиотеку эмуляции localStorage для IE 6 и 7 (используется behavior userData), но у себя использовать не буду, ни к чему поощрять некрофилию.
Работает всё следующим образом (детально можно посмотреть в исходниках любой страницы с комментариями): когда пользователь делает паузу в наборе комментария, мой JS вызывает localStorage.setItem, где ключём является URL страницы плюс имя поля (у меня их три — имя пользователя, сам комментарий и кому этот комментарий был адресова).
После отправки комментария в теле полученной страницы приходят вызовы localStorage.removeItem, которые удаляют сохранённые значения.
Наконец, если страница была загружена не в результате отправки комментария, вызываются localStorage.getItem, чтобы получить сохранённые значения и подставить их в соответствующие поля.
Код, с использованием JQuery, получился вот такой:
// globalStorage — это для FF 2.0, но я не уверен, что это правда работает
var storage = window.localStorage || window.globalStorage && window.globalStorage[location.hostname] || null;

if (storage) {
    var savedraft = function s() {
         if (s.hnd) {
             clearTimeout(s.hnd);
         }

         var o = $(this);

         s.hnd = setTimeout(function() {
             try { // если не хватит места, будет исключение
                 var prefix = location.pathname + '#';
                 storage.setItem(prefix + o.attr('name'), o.val());
                 storage.setItem(prefix + '?', +new Date()); // сохраняю время, возможно в будущем буду подчищать старые черновики
             } catch (o) {}
        }, 500);
    }

    // каждый элемент, который надо сохранять, имеет класс draft
    $.each($('.draft'), function(_, value) {
        var o = $(value),
              key = location.pathname + '#' + o.attr('name'),
              v = storage.getItem(key);

    if (savedsuccessfully) { // внешний флаг, что черновик больше не нужен — всё сохранено на сервере
                  storage.removeItem(key);
              } else if (v !== null) {
                  o.val(v);
              }
              o.keypress(savedraft).change(savedraft);
        })
    }
localStorage не резиновое, у разных браузеров значения различаются, но в целом, там около 5МБ на домен, да и диск пользователя забивать жалко. Поэтому я сохраняю время записи, возможно
Перевёл свой сайт на PHP 5.3.4
Решил поднять свои старые проекты на PHP под MacOS, чтобы на ноуте их нормально разрабатывать. В том числе, перетащил свой сайт. У меня движок сплошной эксперимент, так что используются различные тонкие вещи (например, ленивые вычисления при помощи __toString), которые в PHP 5.3 (который у меня на «Маке»)
Мелочи вспоминать не хочется, из того что запомнилось — PHP 5.3 нервно,
С веткой PHP 5.3 я почти не работал, когда эта версия стала появляться в пакетах стабильных версий систем, я уже перешёл на «Пайтон».
UTF-8: быстрые регулярные выражения в PHP
Утром я написал пост о производительности различных движков регулярных выражений, а весь день перебирал разные варианты, смотрел подробности и так далее.
Как я уже писал, мне понравилась библиотека RE2, я даже скомпилировал её и посмотрел, к сожалению, оказалось, что она использует треды, а в PHP с этим не очень (не все модули PHP thread safe, поэтому чаще всего PHP собирается без поддержки тредов).
Я уже начал смотреть другие библиотеки, когда Алексей Захлестин напомнил мне про модуль PHP Multibyte String (функции mb_*), который содержит в себе движок регулярных выражений Oniguruma.
Я всегда плохо относился к этому движку, так как считал, что у него очень бедные возможности для работы
Сегодня я присмотрелся к движку получше. Конечно, PCRE он не заменит, но некоторых случаях вполне сможет его подменить как быстрый аналог, только надо применять несколько правил (речь идёт о версии 4.7.1, которая в PHP):
Я погонял тесты, сравнивал PCRE в режиме полном
bolk-dev ~/regexp-benchmark $ php test.php
PCRE Full UTF-8: 1.0458080768585
Oniguruma:         0.24942803382874
UTF-8: как быстрее получить длину строки
Как я уже писал, сегодня ночью я наткнулся на вариант измерения длины
Сегодня я почистил код (в PHP известна бинарная длина строки, поэтому я убрал проверки на символ с кодом ноль и соптимизировал код), сгенерировал таблицу HammingWeight, которая отсутствует в коде автора и перевёл проверку в двух крайних циклах на подобную таблицу.
Потом это всё скомпилировал и погонял тесты.
Сначала я получил очень странные результаты и только потом понял что случилось. В общем, разрыв в скорости функций (mb_strlen и той, что на SSE2) тем больше, чем ближе тестируемая строка к однобайтовой. Чаще всего, с SSE2 быстрее встроенной в PHP в 5—8 раз:
thasonic-dev ~/uni/futf-0.1 $ php ../test/test_strlen.php | sort -k2 -t:
SSE2 UTF-8:                 0.025604963302612
mb_strlen:                   0.15917205810547
strlen/utf8_decode:   0.62052989006042
Что совсем странно, прежнего впечатляющего результата с прежними данными и функциями я получить не смог, правда, есть подозрение, что за ночь сменилось оборудование (были аппаратные проблемы на машине) на сервере, где я производил замеры.
В общем, о приросте в 24 раза остаётся только мечтать.
Похоже, это почти предел на сегодняшний момент. Единственная возможность ускорения, которая приходит в голову — использовать GPU на видеокарте. Например, видеокарта GTX275 управляется с 16000 потоков (!), что позволяет подсчитать длину строки порциями по 15,5КБ!
Но это больше из разряда
Так что оставлю как есть, займусь переписываем substr в SSE2, а потом выложу всё в открытый доступ.
Добавлено позднее: в следующем году Intel и AMD выпустят процессоры, поддерживающие набор комманд AVX, интересно там то, что размер регистров SIMD (которые используются и в SSE) расширяется до 256 бит. То есть через
UTF-8: как быстро получить подстроку (+новый вариант strlen)
Из кода быстрой функции strlen
Я вкомпилил эту функцию в PHP, помог найти ошибки и отладить и сделал замеры:
bolk-dev ~/uni/futf-0.1 $ php ../test/test_substr.php  | sort -k2 -t:
Fast UTF-8: 0.18010711669922
mb_substr:  0.87068700790405
Разница примерно в 4 раза. Я ещё попробовал отрезать строку через функцию preg_match, сравнимо по скорости с mb_substr, но медленнее и есть ограничение — квантификатор preg_match не захватывает больше 65535 символов.
Добавлено позднее: после того как мы отладили эту функцию, я вспомнил про команды ассемблера SSE — это наборы команд (сейчас их пять — SSE1, 2, 3, 4.1 и 4.2), которые оперируют восемью регистрами размером 128 бит.
Как я рассказывал, самый быстрый алгоритм для strlen, который я нашёл, работает следующим образом: сначала указатель на строку первым циклом выравнивается по границе 4 или 8 байт (в зависимости от архитектуры процессора), чтобы процессор смог быстрее читать дальше, потом, работая сразу с числом длиной 4 или 8 байт, одной операцией подсчитывается сколько в выделенной строке содержится начальных байт символов.
Если внутри нашего рабочего участка встречается символ с кодом ноль (признак конца строки), то происходит выход в последний цикл, который занимается тем, что просматривает побайтно получившийся «хвост».
Час назад я поставил себе gcc под Windows и стал потихоньку писать примерный код, читать документацию, изучать команды в интернете, пока совершенно случайно не наткнулся на уже готовый вариант, написанный с применением инструкций SSE2.
Нашёл в интернете тест для таких функций, включил туда найденную и сделал замеры:
C:\MinGW\bin\test.exe
cp_strlen_utf8:          0.105706
cp_strlen_utf8_sse2: 0.030002
В 3,5 раза обгоняет предыдущий вариант, то есть, смею надеяться, обгонит встроенную в PHP функцию примерно в 24 раза. Завтра попробую.
Немаловажно, что даже на машинах с архитектурой 32 бита рассматриваемый вариант покажет ту же скорость, что и на машинах 64 бита.
Судьба PHP6
Поговорил с одним из разработчиков PHP по поводу судьбы PHP6, самое ожидаемое изменение которого — переход на юникодные строки. Так вот Антон Довгаль рассказал, что проект, по сути, заброшен. Те несколько человек, которые занимались проектом, либо уволились, либо потеряли к нему интерес и сейчас считается, что поддержка юникодных строк в языке не так уж и нужна.
На примере своего опыта разработки и перевода проектов на PHP
То, что в PHP приходится для поддержки Юникода работать
Работать в PHP
Если бы этот язык нативно поддерживал
UTF-8: как быстрее измерить длину строки в PHP
Я потихоньку буду писать как получается оптимизировать самые важные функции работы
Сейчас, после перевода «Вики» мы столкнулись с тем, что некоторые операции занимают непозволительно много времени.
Простые оптимизации я уже применил: выкинул из класса
Одна из самых частоиспользуемых функций — strlen, которая определяет длину строки. Я всегда считал, что самый быстрый способ подсчитать длину
Мои тесты показывают что это не так. Самый быстрый способ (по крайней мере в PHP 5.3.2) — это mb_strlen, strlen/utf8_decode — на втором месте, потом идёт sizeof+preg_split, а самый медленный — iconv_strlen.
Для интереса я вкомпилил в PHP функцию для быстрого подсчёта длины строки
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
Fast UTF-8: 0.68232107162476
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это тысяча итераций на файле в 400КБ.
Я оставил функцию mb_strlen.
Добавлено позднее: другая быстрая функция дала ещё худший результат: 0,79, против прежнего варианта в 0,68.
Добавлено ещё позже: а вот третья функция показала действительно впечатляющие результаты:
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
More Fast UTF-8:  0.12948799133301
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это уже дело — она почти в 7 раз быстрее лучшего результата PHP.
Вкратце, алгоритм такой: строка циклом выравнивается по границе четырёх
Добавлено через несколько дней: есть и ещё более быстрая функция.