Порисовал немного на теге CANVAS, ничего интересного

Попробовал порисовать на теге CANVAS, хотелось хоть
<canvas width="500" height="240"></canvas>
<script type="text/javascript">
(function (c) {
    var img = c.createImageData(500, 240);

    var putPixel = function (x, y, c) {
        var index = (x + y * 500) << 2;

        for (var i = 0; i<4; i++) {
            img.data[index+i] = c[i];
        }
    };

    var x = 0, y = 0, color, leaf, idx,
    k = [
          [ 0.00, 0.00, 0.00, 0.16, 0.00, 0.00 ],
          [ 0.85, 0.04,-0.04, 0.85, 0.00, 1.60 ],
          [ 0.05,-0.26, 0.23, 0.22, 0.00, 1.60 ],
          [-0.15, 0.30, 0.26, 0.24, 0.00, 0.44 ],
    ];

    for (var i = 0; i<200000; i++) {
        leaf = Math.random();

        if (leaf <= 0.010) leaf = 0; else
        if (leaf <= 0.860) leaf = 1; else
        if (leaf <= 0.930) leaf = 2; else
        leaf = 3;

        x = x * k[leaf][0] + y * k[leaf][1] + k[leaf][4];
        y = y * k[leaf][2] + y * k[leaf][3] + k[leaf][5];

        putPixel(parseInt(y * 55), 120 - parseInt(x * 40), [10, 100, 20, 255]);
    }

    c.putImageData(img, 0, 0);
})(document.getElementsByTagName('canvas')[0].getContext('2d'));
</script>ГИМП — говно
Похоже весь opensource служит одной цели — чтобы мы, когда покупаем программы, могли сравнить и увидеть за что платим.
Скачал бесплатный графический редактор ГИМП, чтобы подредактировать пару фотографий. В диалоге открытия файла, чтобы ГИМП показал мне миниатюру файла, мне предлагается кликнуть сначала на файл, потом на место, где должна появиться миниатюра! Два клика и куча движений мышью на каждый из 120 файлов, в котором я хочу найти нужный.
И вот так там всё.
Just5 CP10 BestInSpacephone и CP11
Компания Just5 известна в России, в основном, как производитель «телефонов для пожилых» — большие кнопки, крупные цифры, упрощённый интерфейс, монохромный экран. Ниша, может, и небольшая, но в ней свои покупатели. Телефон CP11, на мой взгляд, продолжает эту линейку, хотя он стал куда более стильным и явно позиционируется как телефон для всех возрастов.
Из сразу заметных изменений в нём — выдвижной экран и термометр, показывающий температуру окружающей среды.
Модели Just5 CP10 Spacephone и BestInSpacephone это нечто куда более интересное. Не секрет (я наблюдаю по своим друзьям и знакомым), что далеко не всем нужен смартфон, есть ребята, которым нужен простенький телефон из разряда «чтобы звонил».
Традиционно эта ниша была занята самыми младшими моделями «Нокий», надёжными, недорогими и функциональными. Just5 пытается прорваться на эту нишу, тем более, что «Нокия» стремительно теряет там свои позиции, снимая с производства всё, что не содержит камеры и не обладает цветным экраном.


Тут Spacephone разных цветов и, выпущенный ограниченным тиражом, разноцветный BestInSpacephone, похоже, попадут в точку. По крайней мере у нас в офисе двое людей сразу захотели себе такой телефон, стоило мне только открыть коробку.
Кнопка «SOS» (вызывающая заранее задаваемый номер и включающая сирену), видимо, идеологически меняет свою функцию. Из кнопки «скорую мне, помогите», превращается «милиция, помогите».


Обе модели, которые попали мне в руки, обладают схожей комплектацией — аккуратная коробка, инструкция, наклейка с эмблемой Just5, аккумулятор, зарядник, гарнитура, сам телефон и (у CP11) — кредл. Телефоны хорошей сборки, а инструкция заслуживает всяческих похвал, хорошо структурированна, написана понятным языком.
Для телефона, претендующего занять нишу «просто позвонить», в этих моделях, пожалуй, даже слишком много возможностей. Помимо едва достойных упоминания будильника, калькулятора, планировщика и часов, в телефоне есть ещё
Отдельно стоит отметить время работы — небольшой (по нынешним временам) экран, отсутствие цвета, камеры, Bluetooth, WiFi, NFC, сетей третьего поколения и так далее, позволяют работать телефонам Just5 несколько дней. Впрочем, аккумулятор можно было сделать и помощнее, чтобы заряжать нужно было раз в неделю или реже.
Теперь о плохом: интерфейсно телефон слабо продуман, я не имею возможности сейчас сравнить CP10 и CP11 с девятой моделью, возможно


Итак, достоинства: отлично лежит в руке, хорошая сборка, необычный дизайн, долгое время работы, почти ничего лишнего, радио работает без гарнитуры.
Недостатки: высокая цена (4500 рублей за каждую из моделей), непродуманный интерфейс.
Ещё раз спасибо
UTF-8: быстрые регулярные выражения в PHP
Утром я написал пост о производительности различных движков регулярных выражений, а весь день перебирал разные варианты, смотрел подробности и так далее.
Как я уже писал, мне понравилась библиотека RE2, я даже скомпилировал её и посмотрел, к сожалению, оказалось, что она использует треды, а в PHP с этим не очень (не все модули PHP thread safe, поэтому чаще всего PHP собирается без поддержки тредов).
Я уже начал смотреть другие библиотеки, когда Алексей Захлестин напомнил мне про модуль PHP Multibyte String (функции mb_*), который содержит в себе движок регулярных выражений Oniguruma.
Я всегда плохо относился к этому движку, так как считал, что у него очень бедные возможности для работы
Сегодня я присмотрелся к движку получше. Конечно, PCRE он не заменит, но некоторых случаях вполне сможет его подменить как быстрый аналог, только надо применять несколько правил (речь идёт о версии 4.7.1, которая в PHP):
Я погонял тесты, сравнивал PCRE в режиме полном
bolk-dev ~/regexp-benchmark $ php test.php
PCRE Full UTF-8: 1.0458080768585
Oniguruma: 0.24942803382874Производительность различных библиотек регулярных выражений
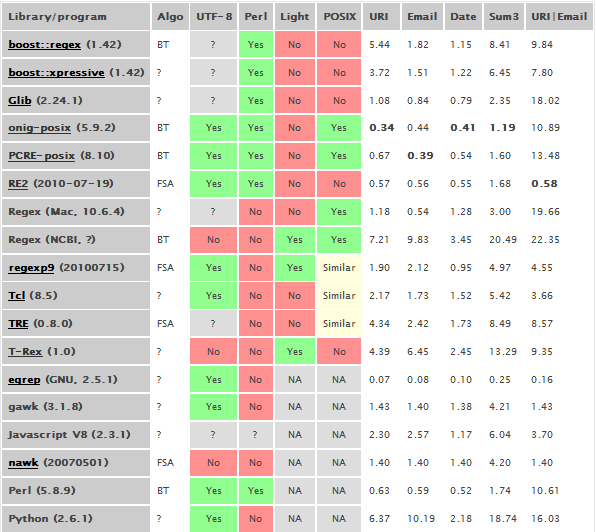
Много читал с утра о библиотеках регулярных выражений. Хочется найти такую, чтобы работала
Автор сравнивает по скорости обработки три регулярных выражения, правда довольно несложных, на приличного объёма тексте. Но даже и на этих несложных регулярках есть явные аутсайдеры — например, Python (хотя другие тесты дают другие результаты).
Жалко автор не составил такую же таблицу для режима
Например, мне из таблицы понравилась библиотека RE2, она показывает хорошие результаты, при этом в последнем тесте вырывается далеко вперёд. Правда в ней не реализована часть синтаксиса (например, нет backreferences), но это я бы пережил. А вот насколько она эффективная в режиме
Кстати, скрипты для тестирования доступны для скачивания. Можно попробовать переключить пару библиотек
Добавлено позднее: раз доступны скрипты тестирования, я решил посмотреть не находится ли уже RE2 в режиме
RE2 p(argv[1]);
buf = (char*)calloc(BUF_SIZE, 1);
while (fgets(buf, BUF_SIZE - 1, stdin)) {
        ++l;
        for (q = buf; *q; ++q); if (q > buf) *(q-1) = 0;
        if (RE2::PartialMatch(buf, p))
                printf("%d:%sn", l, buf);
}
free(buf);
Чтобы выключить режим
Пешая доступность от метро МК «Царицыно»?
Мне нравится микрорайон «Царицыно», куда мы с женой переедем уже в следующем году. Нравятся все инициативы застройщика — по благоустройству района, страхованию и так далее, не нравится когда меня обманывают.
Последняя новость — застрощик организует пешеходную трассу до ближайшего метро:
Партнерами было принято решение организовать дополнительный пешеходный переход, лестницу с выходом с ул. Липецкая на Каспийскую улицу, а так же разработать комплекс других мер, позволяющих оптимизировать пешеходный путь от мкр. «Царицыно» до станции метро «Царицыно».
(…) После реализации проекта, для пешеходов время в пути от мкр. «Царицыно» до станции метро «Царицыно» составит 15 минут. То есть, отныне метро будет находиться в пешеходной доступности для владельцев квартир в мкр. «Царицыно».
Есть такие «Методические рекомендации по регулированию пешеходного движения», указания 1977 года, но не думаю, что с тех пор скорость пешехода выросла. Из него следует, что средняя скорость движения пешехода по тротуару — 1,25 м/c, впрочем, там ещё есть скорость движения по наземному пешеходному переходу — 1,4 м/c. Возьмём эту цифру.
«Яндекс.Карты» сообщают нам, что от корпуса №8 в районе застройки, до ближайшей точки входа метро «Царицыно» — 1,831 километр. По прямой!.
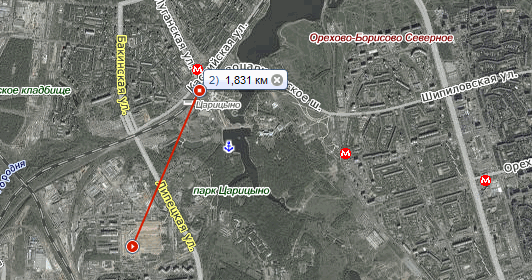
Нехитрые вычисления: 1831 / 1,4 = 1307,86 секунд или 22 минуты. Двадцать две минуты только по прямой, да ещё и довольно бодрым шагом. Я очень сомневаюсь, что застройщик сможет обеспечить пешеходов прямой, как стрела, дорогой до метро. Скорее всего, дорога до метро займёт от получаса, а это уже совсем другая цифра.
Прозрачный фон SVG в Хроме и Сафари
Владислав Шкодин написал статью на «Хабре», где рассказал как ему удалось победить старый баг в движке WebKit — если вставить SVG с прозрачным фоном в тег OBJECT, что «Сафари» и «Хром»
Решение очень простое. Прямо внутри файла SVG, после тега svg нужно написать следующее:
<style>
    svg { -webkit-background-clip: text; }
</style>
UTF-8: как быстрее получить длину строки
Как я уже писал, сегодня ночью я наткнулся на вариант измерения длины
Сегодня я почистил код (в PHP известна бинарная длина строки, поэтому я убрал проверки на символ с кодом ноль и соптимизировал код), сгенерировал таблицу HammingWeight, которая отсутствует в коде автора и перевёл проверку в двух крайних циклах на подобную таблицу.
Потом это всё скомпилировал и погонял тесты.
Сначала я получил очень странные результаты и только потом понял что случилось. В общем, разрыв в скорости функций (mb_strlen и той, что на SSE2) тем больше, чем ближе тестируемая строка к однобайтовой. Чаще всего, с SSE2 быстрее встроенной в PHP в 5—8 раз:
thasonic-dev ~/uni/futf-0.1 $ php ../test/test_strlen.php | sort -k2 -t:
SSE2 UTF-8:                 0.025604963302612
mb_strlen:                   0.15917205810547
strlen/utf8_decode:   0.62052989006042
Что совсем странно, прежнего впечатляющего результата с прежними данными и функциями я получить не смог, правда, есть подозрение, что за ночь сменилось оборудование (были аппаратные проблемы на машине) на сервере, где я производил замеры.
В общем, о приросте в 24 раза остаётся только мечтать.
Похоже, это почти предел на сегодняшний момент. Единственная возможность ускорения, которая приходит в голову — использовать GPU на видеокарте. Например, видеокарта GTX275 управляется с 16000 потоков (!), что позволяет подсчитать длину строки порциями по 15,5КБ!
Но это больше из разряда
Так что оставлю как есть, займусь переписываем substr в SSE2, а потом выложу всё в открытый доступ.
Добавлено позднее: в следующем году Intel и AMD выпустят процессоры, поддерживающие набор комманд AVX, интересно там то, что размер регистров SIMD (которые используются и в SSE) расширяется до 256 бит. То есть через
UTF-8: как быстро получить подстроку (+новый вариант strlen)
Из кода быстрой функции strlen
Я вкомпилил эту функцию в PHP, помог найти ошибки и отладить и сделал замеры:
bolk-dev ~/uni/futf-0.1 $ php ../test/test_substr.php  | sort -k2 -t:
Fast UTF-8: 0.18010711669922
mb_substr:  0.87068700790405
Разница примерно в 4 раза. Я ещё попробовал отрезать строку через функцию preg_match, сравнимо по скорости с mb_substr, но медленнее и есть ограничение — квантификатор preg_match не захватывает больше 65535 символов.
Добавлено позднее: после того как мы отладили эту функцию, я вспомнил про команды ассемблера SSE — это наборы команд (сейчас их пять — SSE1, 2, 3, 4.1 и 4.2), которые оперируют восемью регистрами размером 128 бит.
Как я рассказывал, самый быстрый алгоритм для strlen, который я нашёл, работает следующим образом: сначала указатель на строку первым циклом выравнивается по границе 4 или 8 байт (в зависимости от архитектуры процессора), чтобы процессор смог быстрее читать дальше, потом, работая сразу с числом длиной 4 или 8 байт, одной операцией подсчитывается сколько в выделенной строке содержится начальных байт символов.
Если внутри нашего рабочего участка встречается символ с кодом ноль (признак конца строки), то происходит выход в последний цикл, который занимается тем, что просматривает побайтно получившийся «хвост».
Час назад я поставил себе gcc под Windows и стал потихоньку писать примерный код, читать документацию, изучать команды в интернете, пока совершенно случайно не наткнулся на уже готовый вариант, написанный с применением инструкций SSE2.
Нашёл в интернете тест для таких функций, включил туда найденную и сделал замеры:
C:\MinGW\bin\test.exe
cp_strlen_utf8:          0.105706
cp_strlen_utf8_sse2: 0.030002
В 3,5 раза обгоняет предыдущий вариант, то есть, смею надеяться, обгонит встроенную в PHP функцию примерно в 24 раза. Завтра попробую.
Немаловажно, что даже на машинах с архитектурой 32 бита рассматриваемый вариант покажет ту же скорость, что и на машинах 64 бита.
99 бутылок: КуМир
47. КуМир — очередной неинтересный язык программирования «Комплект учебных Миров или Миры Кушниренко».
В 1995 году «КуМир» (о ужас!) был рекомендован Министерством образования РФ в качестве основного учебного материала по курсу «Основы информатики и вычислительной техники» на основе учебника А. Г. Кушниренко, Г. В. Лебедева и Р. А. Свореня.
Совершенно неинтересно про него рассказывать, если честно, хотя среда разработки очень неплоха в плане диагностики ошибок.
Добавлено позднее: Язык оказался диалектом или реализацией уже известного мне языка «РАЯ».
| написал Евгений Степанищев bolknote.ru

алг песня про пиво
нач
    цел пиво
    нц для пиво от 99 до 1 шаг -1
        вывод сколько пива(пиво), ' on the wall, ', нс
        вывод 'Take one and pass around,', нс
        вывод сколько пива(пиво-1), ' on the wall.', нс, нс
    кц
    вывод "No more bottles of beer...", нс
    вывод "Go to the store and buy some more...", нс
    вывод "99 bottles of beer."
кон

алг лит сколько пива(цел пиво)
нач
    если пиво = 0 то
        знач:="No"
    иначе
        знач:=цел_в_лит(пиво)
    все

    знач:=знач + ' bottle'

    если пиво <> 1 то
        знач:=знач+'s'
    все
конПосмотрел на Perl6
Очень давно хотел посмотреть во что превратился Perl6 за те годы, что я его не видел. Посвятил четыре часа своей жизни на изучение. Что я хочу сказать, богатейший язык при беднейшей документации. Синтаксис, как и положено языку Perl, позволяет сделать одно и то же миллионом различных способом, 99% из которых нечитаемы.
Я в восторге.
К сожалению, не всё описанное в документации работает (например, lvalue-метод substr класса Str у меня работать отказался),
Сегодня на «Хабре» появилась интересная статья, где описывался нормальный алгоритм Маркова для деления двух целых чисел с точностью 4 знака после запятой в унарной системе счисления. То есть: |/|||| = 0.25, ||/||| = 0.6666 и так далее.
Замены в статье уже описаны, осталось реализовать алгоритм (в заменах я поменял пустую строку на два апострофа: ’’). Привожу с сокращением списка замен:
use v6;

my $входная = '||/|||';
my @замены  = <%* *% %| %* *| ** |* t t* *t …тут просто замены через пробел… p^ '' p .FIN _ .FIN>;

loop {
    my $нашёл = Bool::False;
    my $начтонадо;

    for @замены -> $что, $начто {
        my $где = $входная.index($что);

        if defined $где {
            $нашёл = Bool::True;

            given $начто {
                when <''>  {
                    $начтонадо = ''
                }
                when /FIN/ {
                    ($начтонадо = $начто) ~~ s[FIN] = '';
                    $нашёл = Bool::False;
                }
                default    {
                    $начтонадо = $начто
                }
            }

            #`{
                К сожалению, lvalue метод не сработал:
                $входная.substr($где, $что.chars) = $начтонадо;

                выдаёт «cannot modify readonly value
            }

            $входная = $входная.substr(0, $где) ~ $начтонадо ~ $входная.substr($где + $что.chars);
            say $входная;
            last;
        }
    }

    last unless $нашёл;
}
END {
    $входная.say;
}
К сожалению, не удалось использовать итераторы, они недостаточно хорошо описаны,
Меня очень радует нативная поддержка Unicode, которая реализована куда глубже, чем в Python, к примеру, конструкция языка >> может быть заменена на », в качестве ограничителей (например, многострочного комментария) можно использовать символы 「 и 」, а say "Ⅰ".succ правильно выдаёт Ⅱ).
Наворотили в языке много. Отдельной строкой — регулярные выражения. Синтаксис совсем другой, мне кажется более продуманным, чем тот, что сейчас в Perl5 (и тем более в PCRE), возможностей стало больше, а выражения выглядят аккуратнее.
Музей Булгакова в доме 302 бис
Побывали на экскурсии музея «Булгаковский дом», вроде ничего особенного, но интересно. Мне понравилось ходить по музею, несмотря на то, что вещей Булгакова почти не сохранилось (например, в музее в Киеве, где Булгаков родился, нет ни одной), там было много вещей то эпохи.
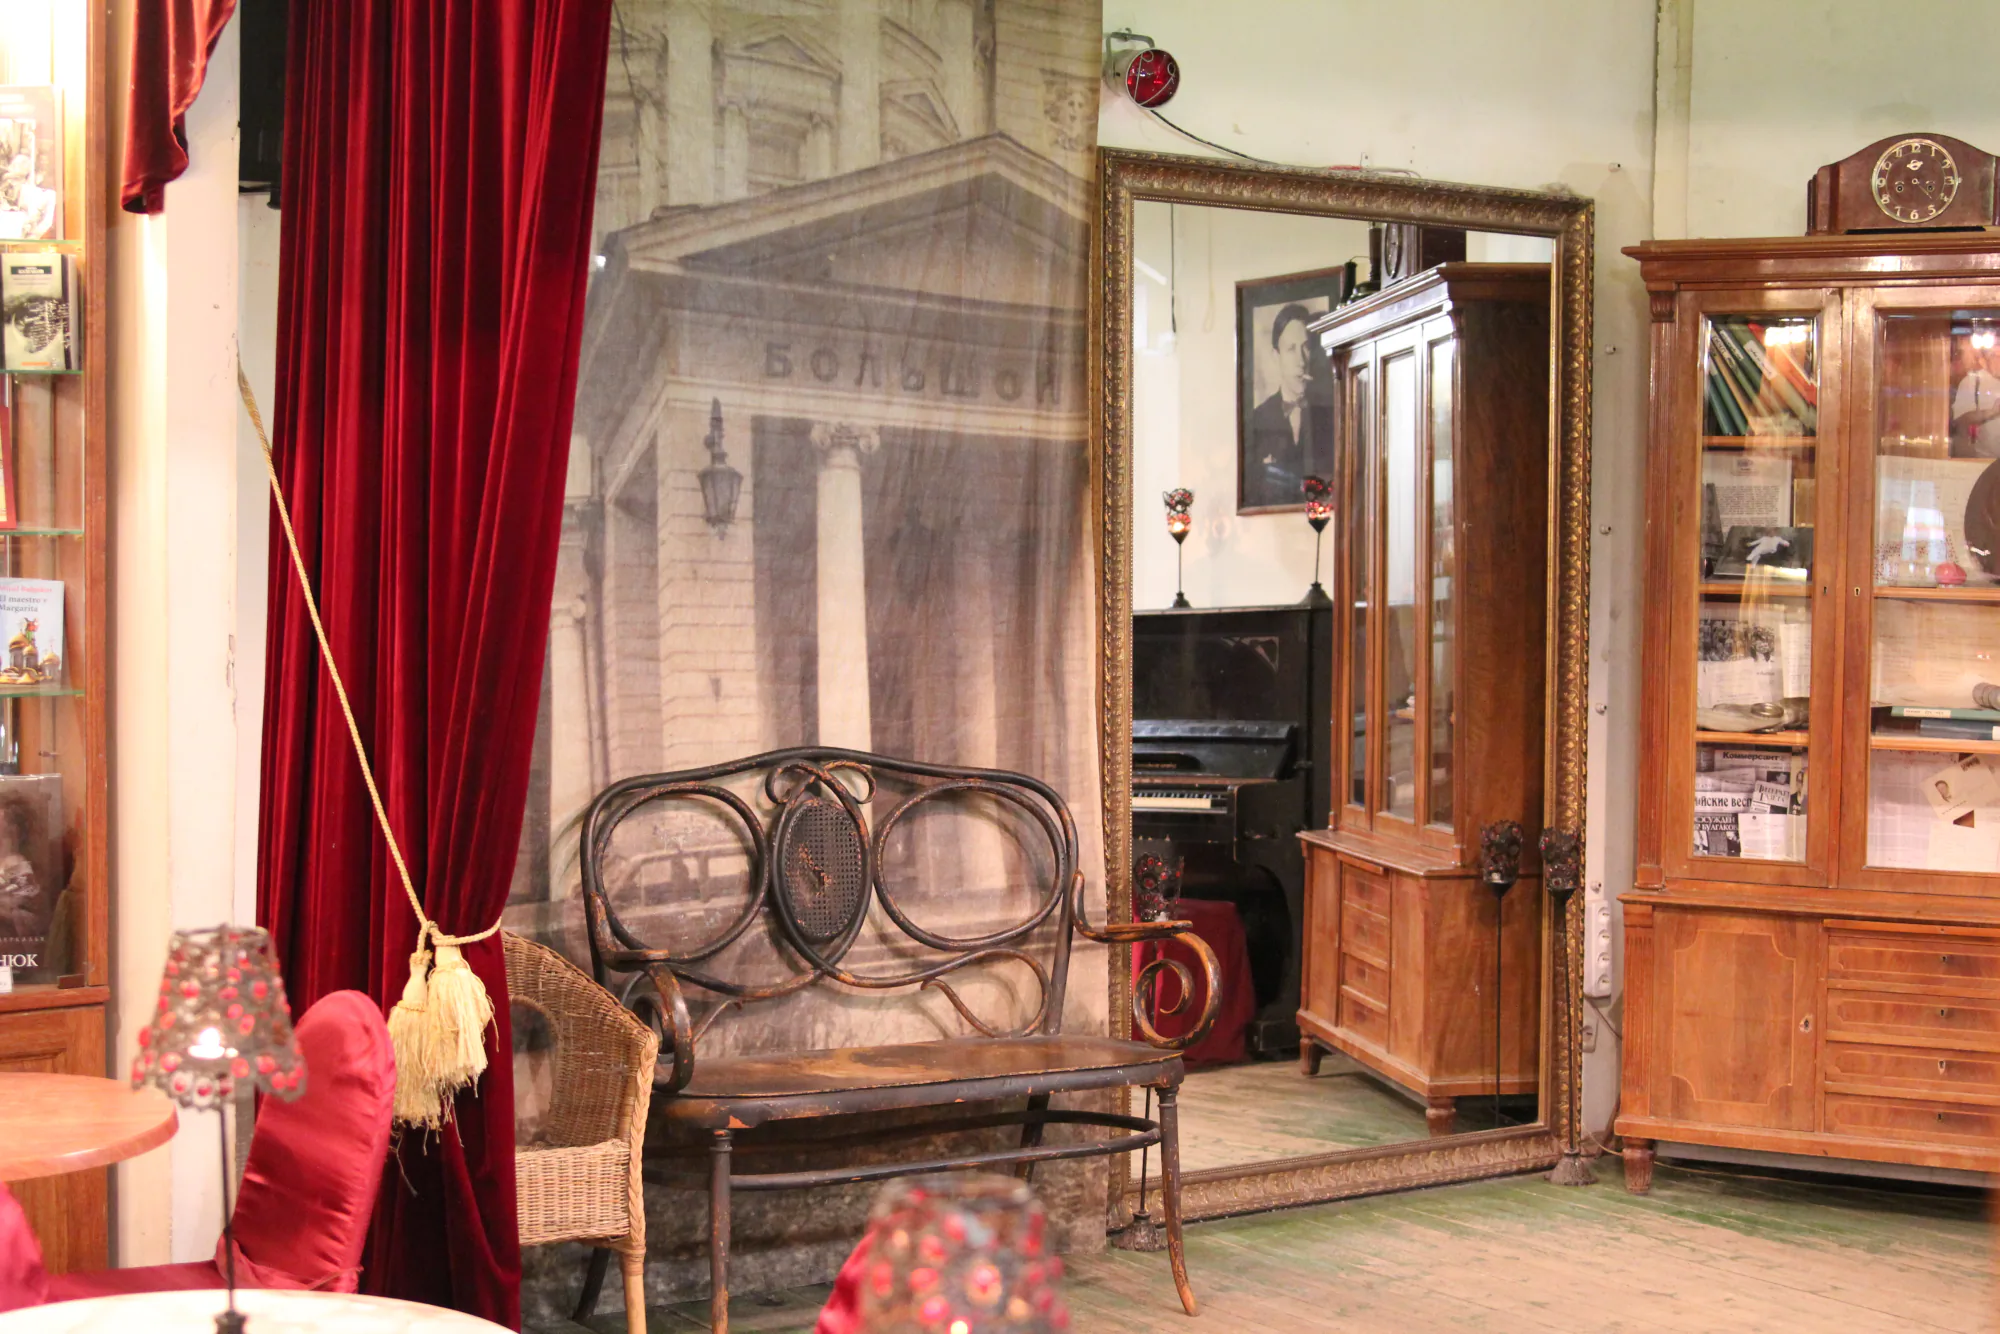
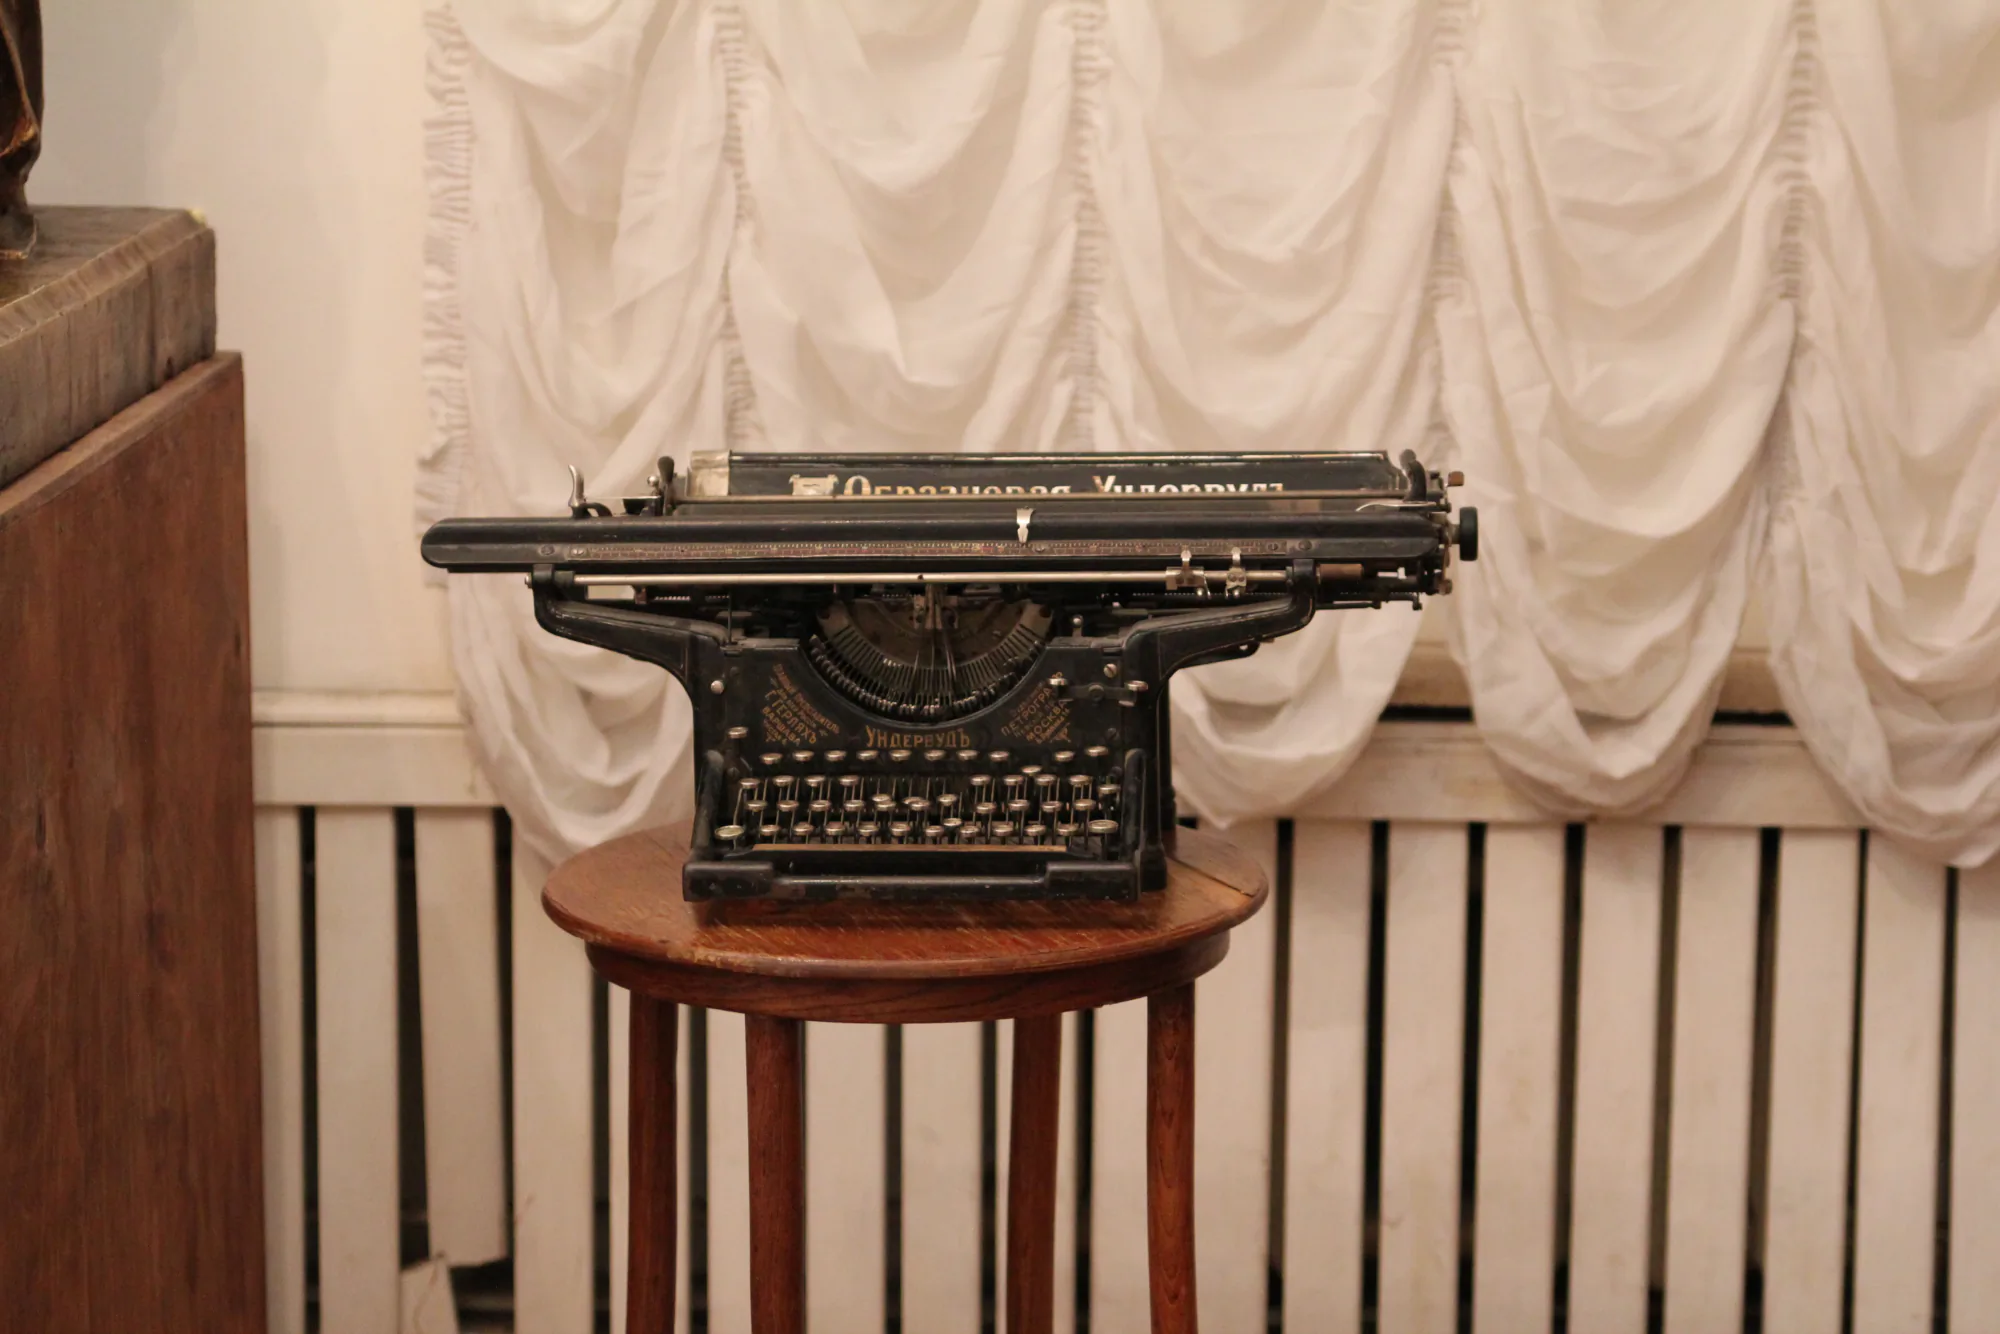
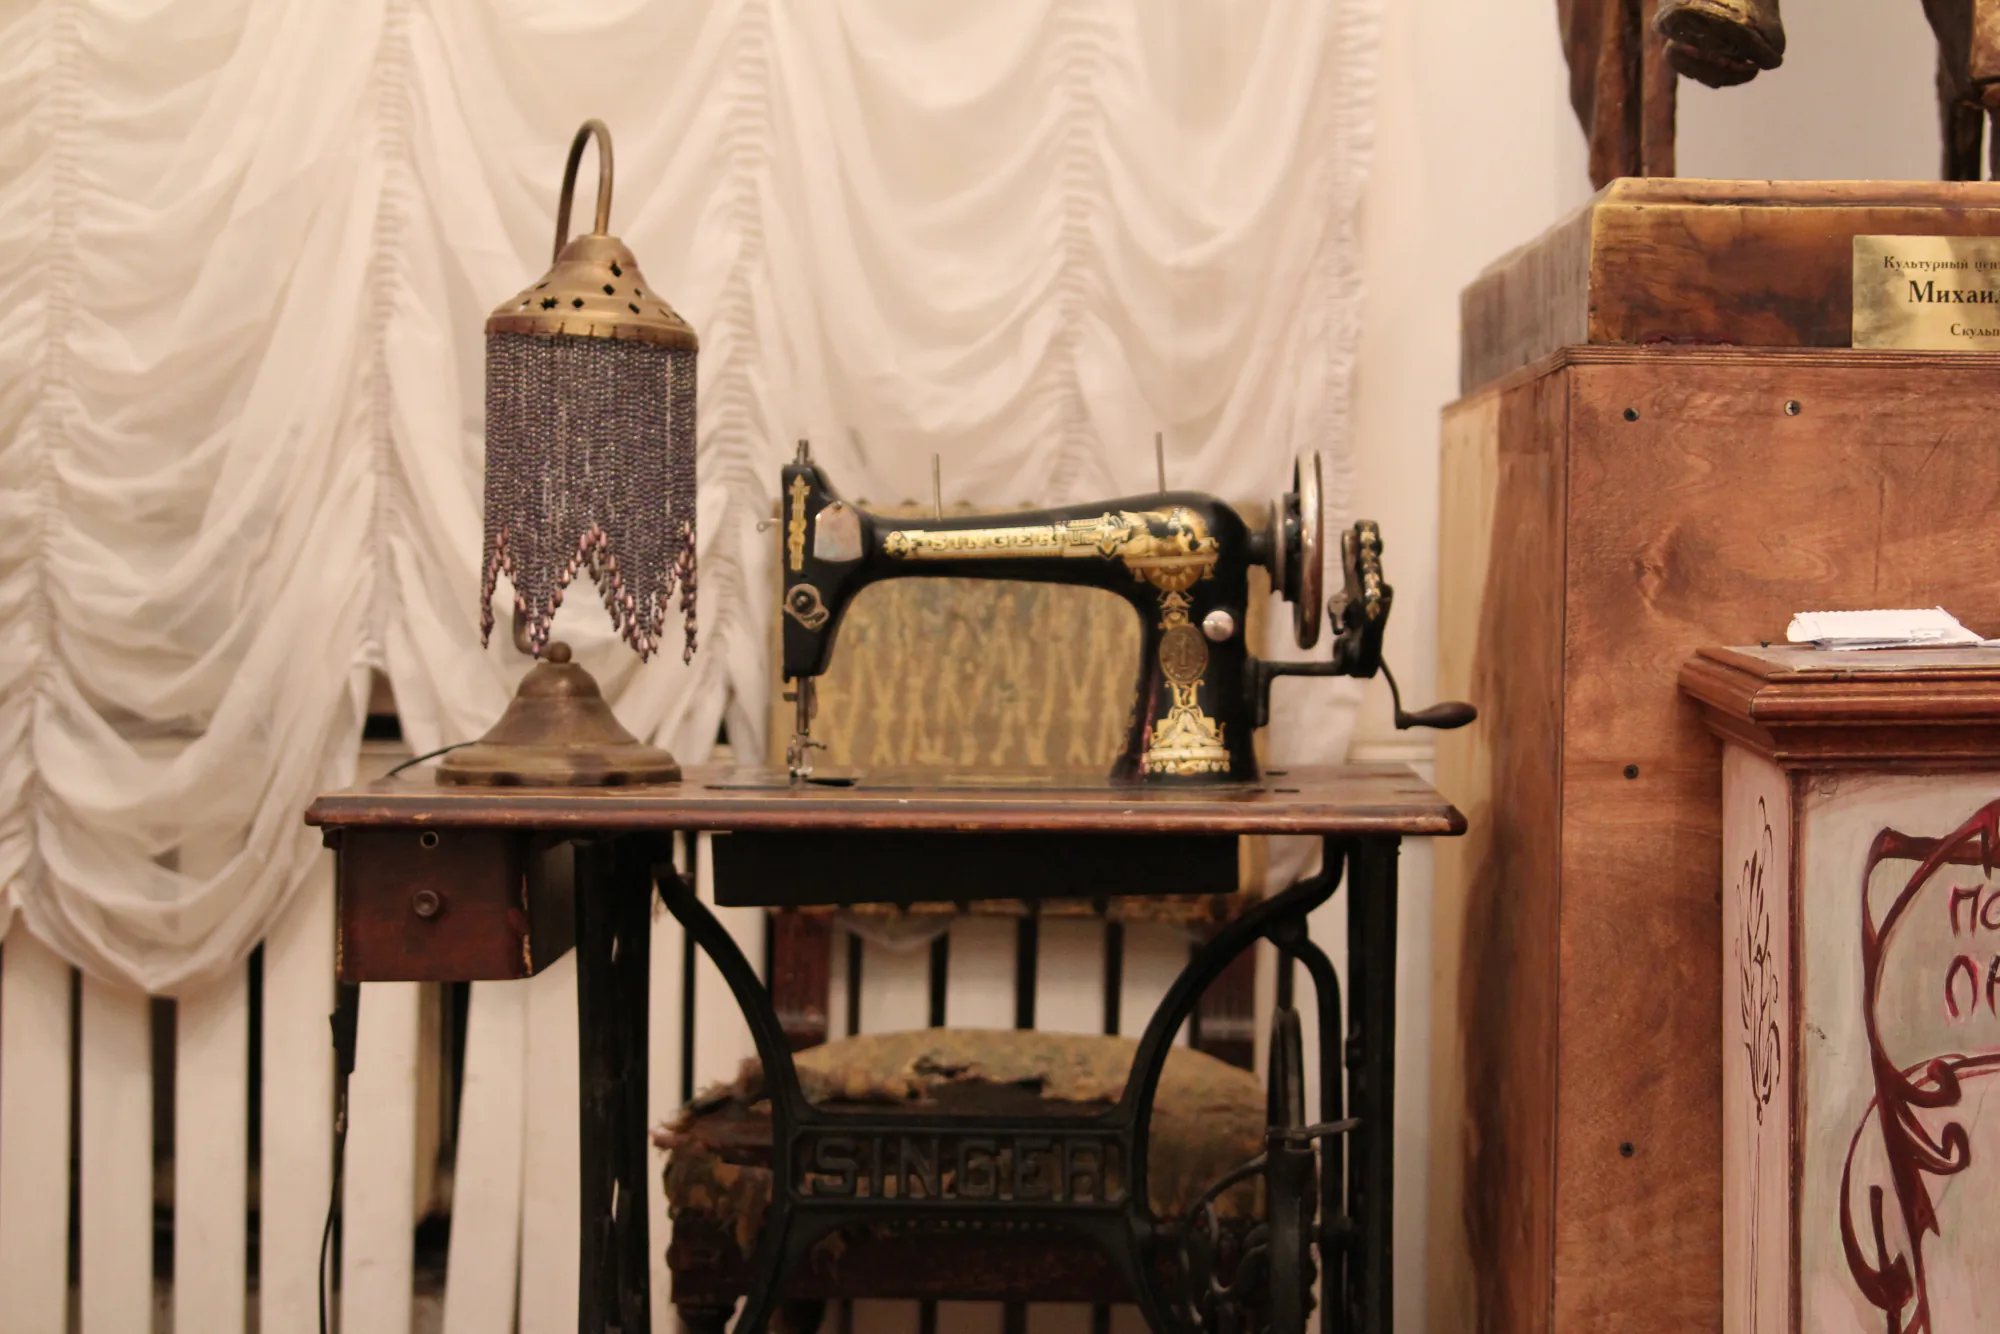
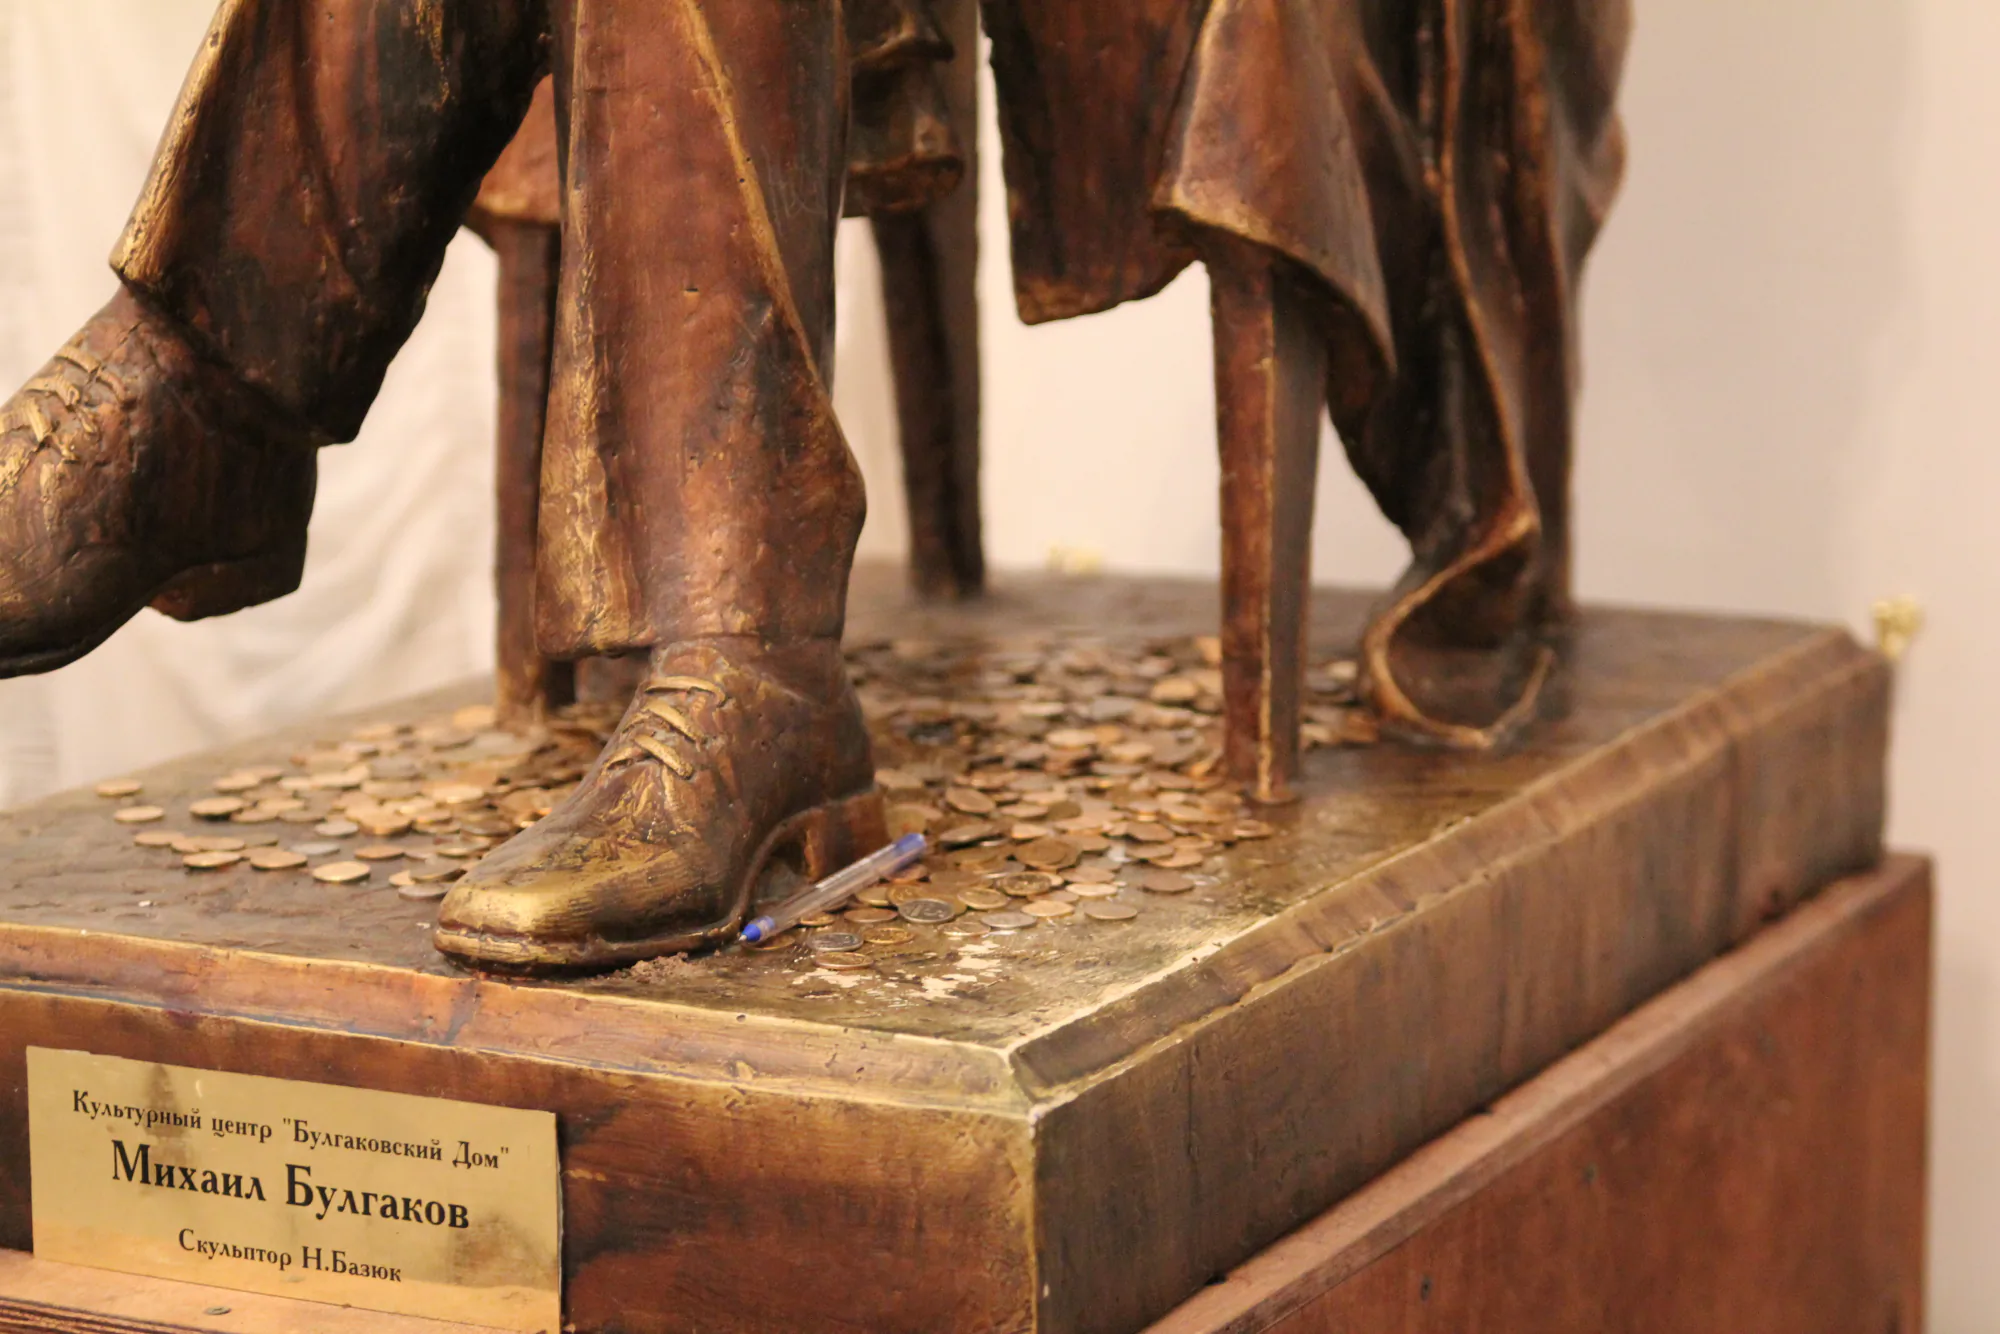
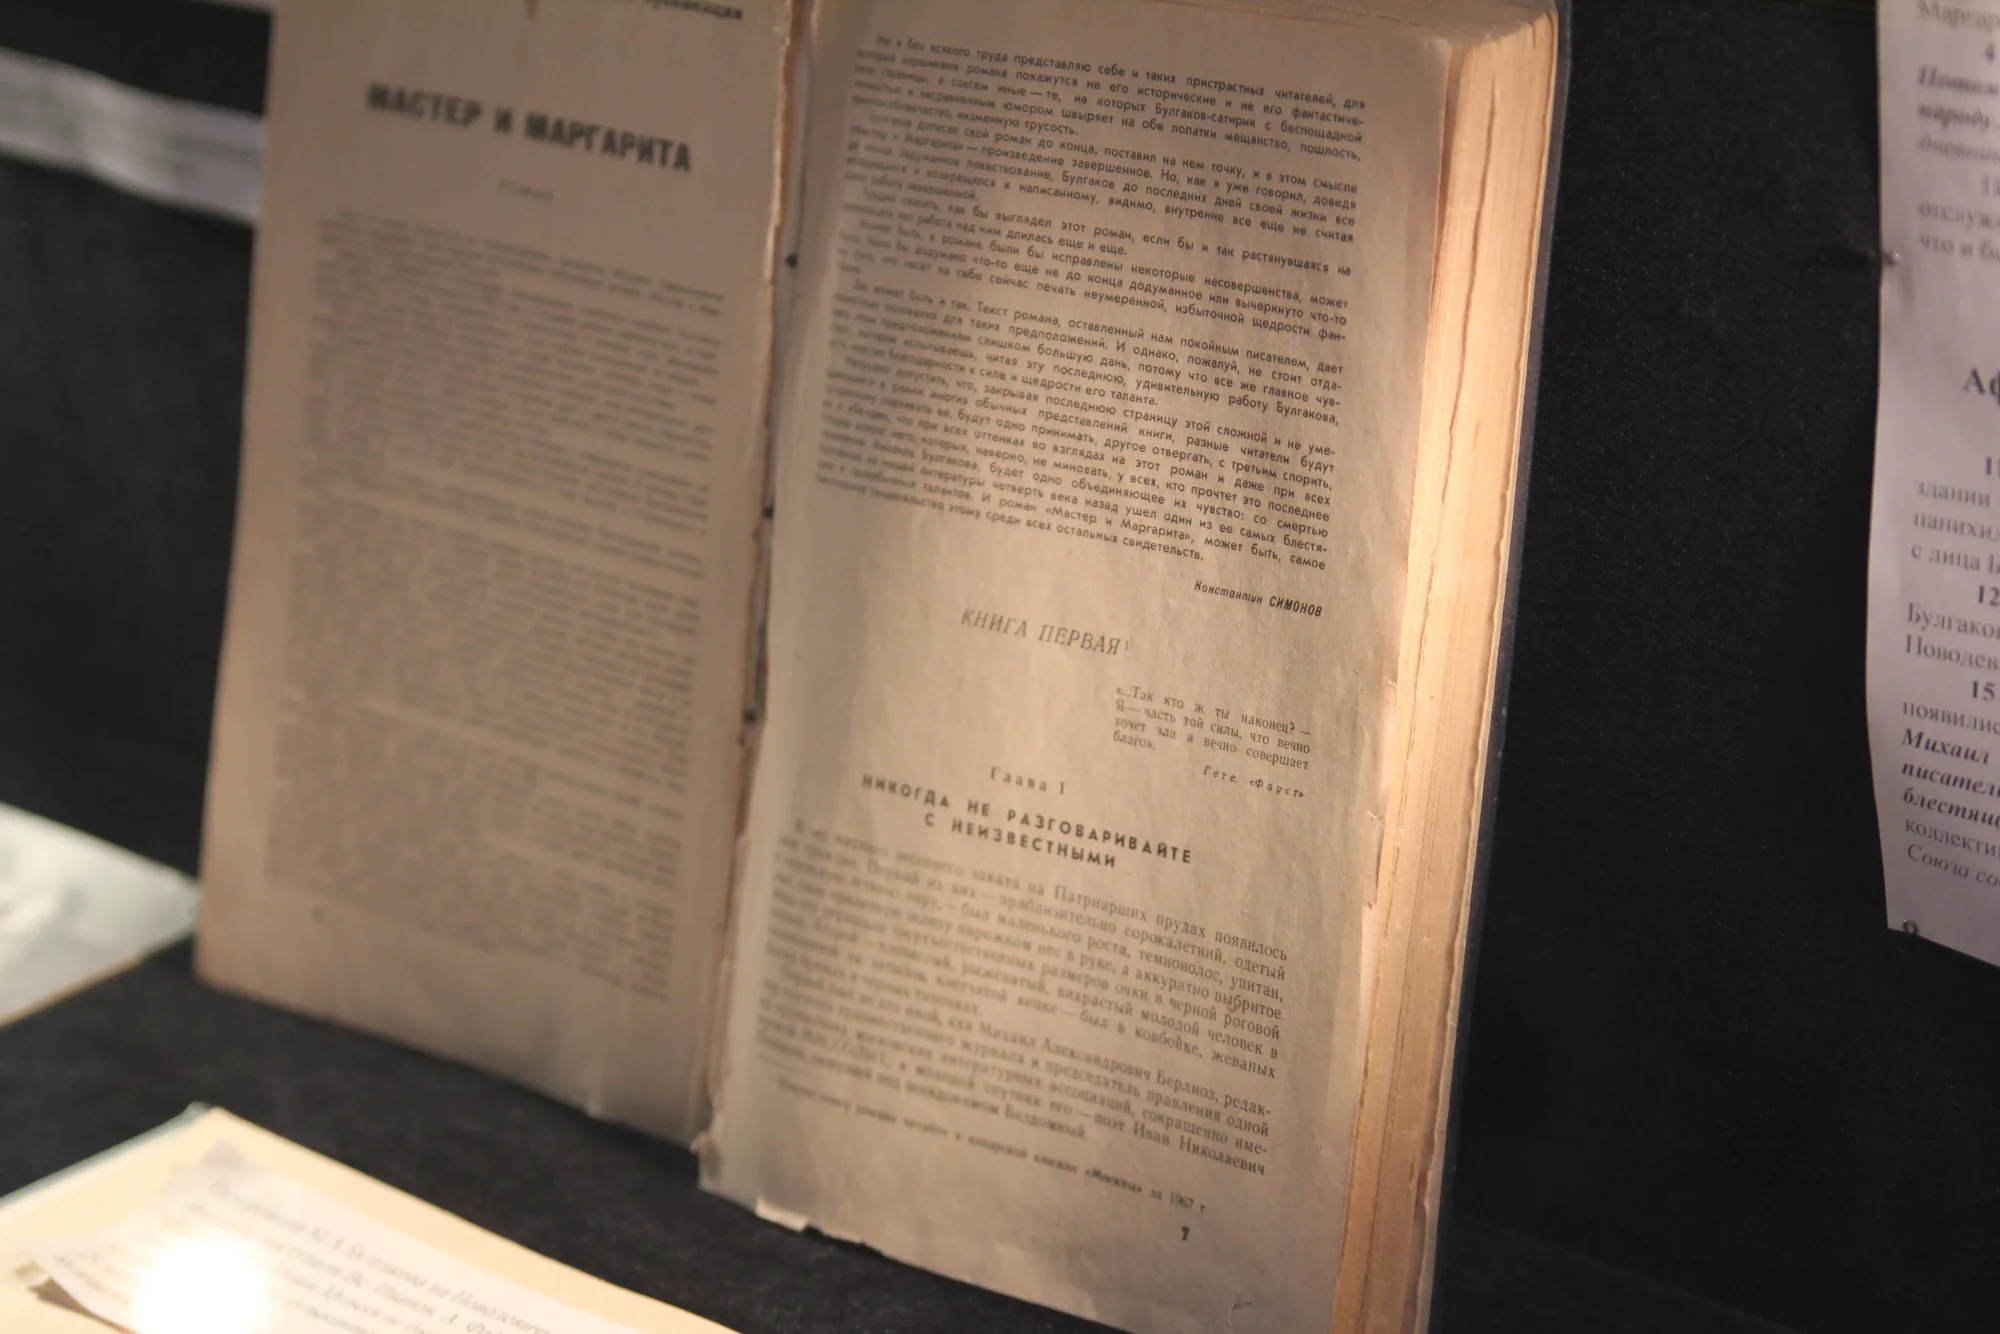
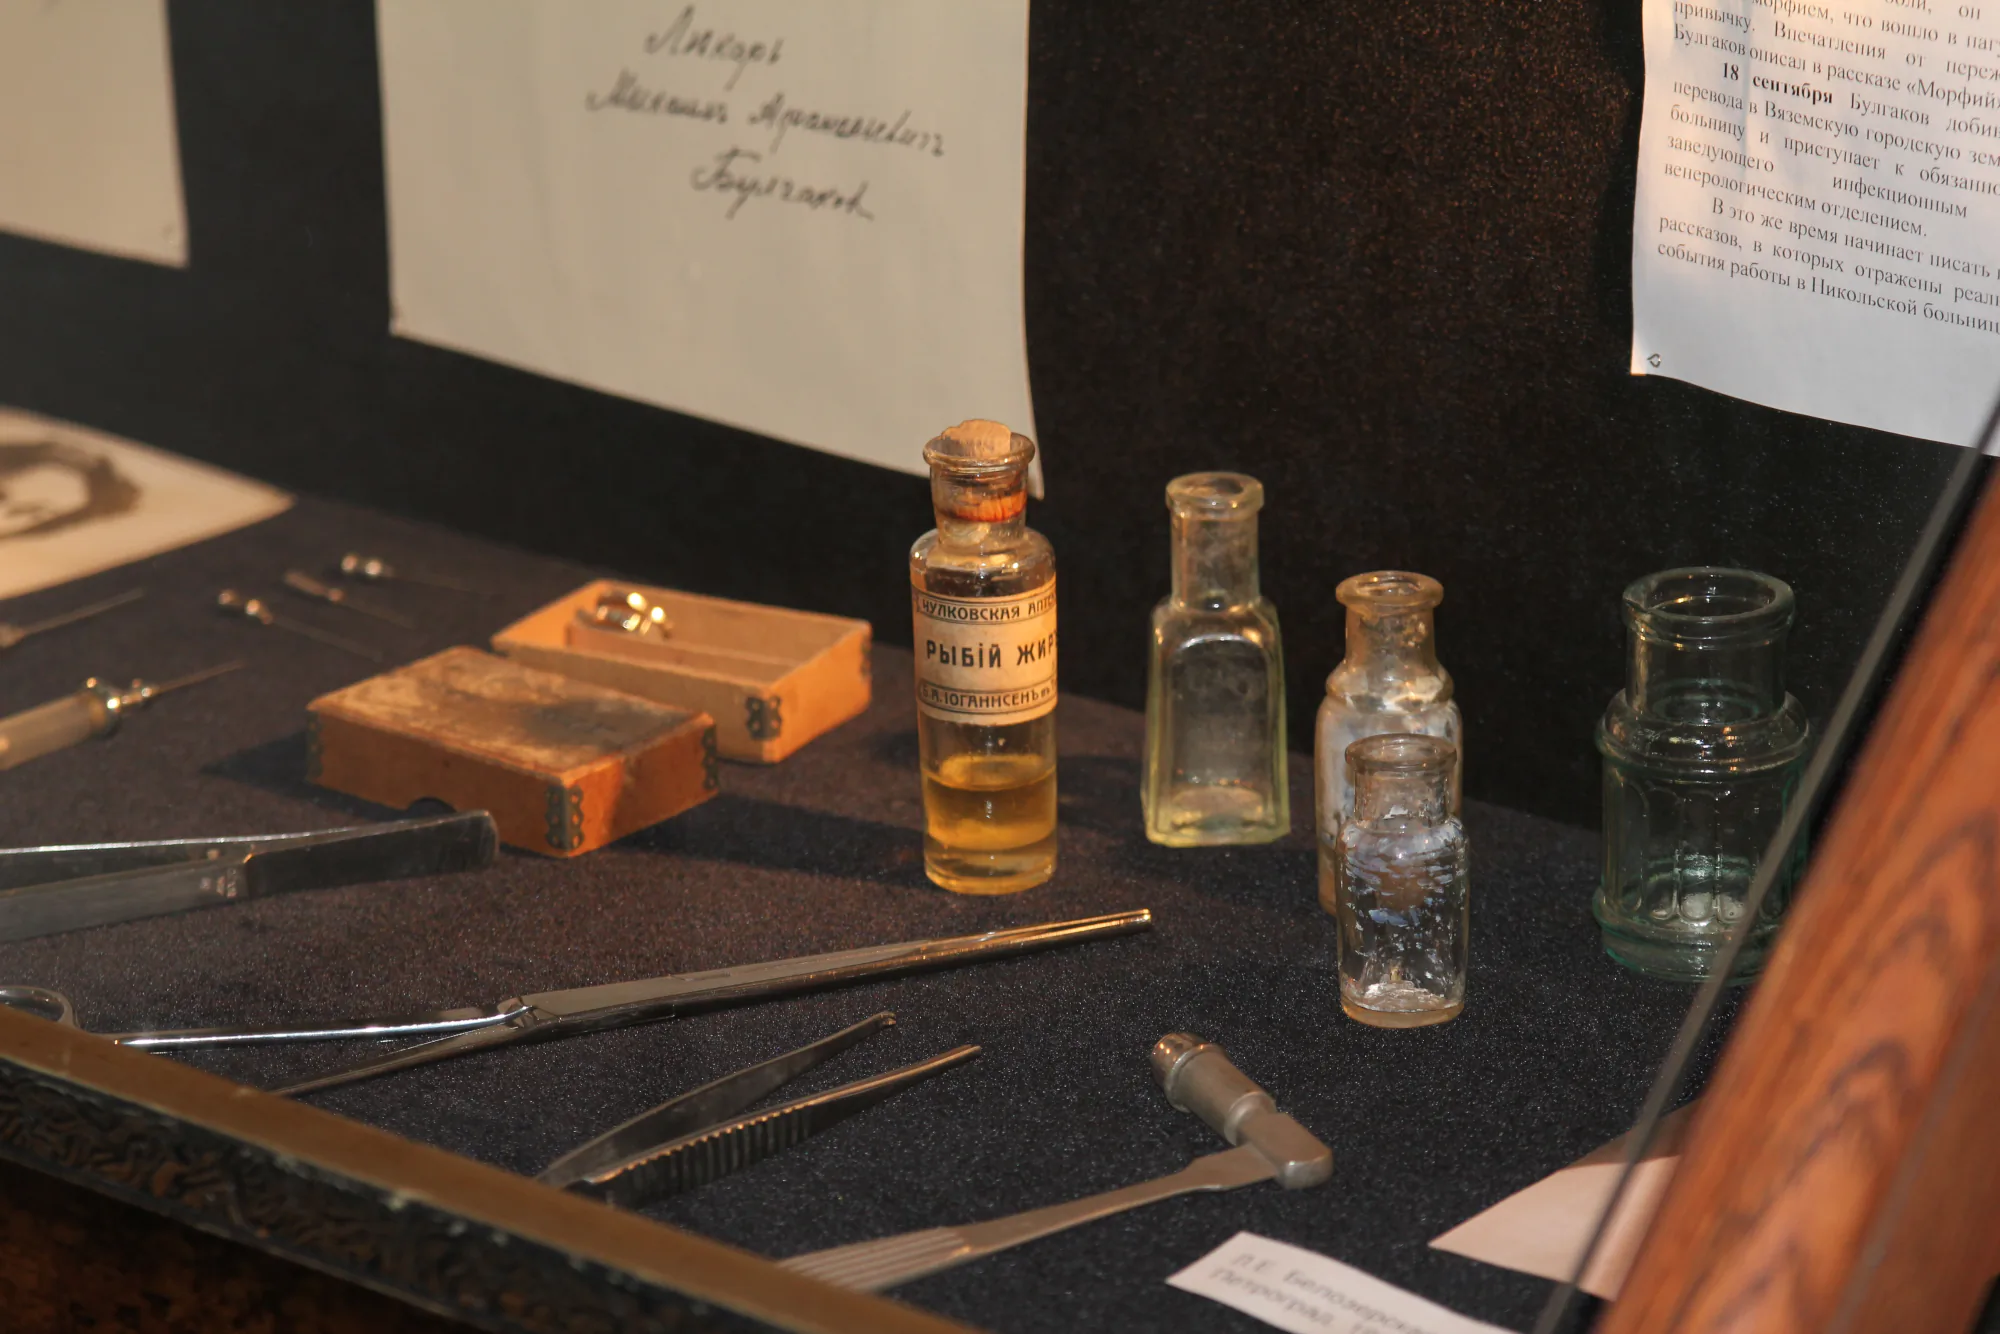
В альбомах на «Яндекс.Фотках» есть остальные фотографии.
Посмотрел на новые телефоны Just5
Взял потестировать два телефона фирмы Just5 — модели CP11 и CP10 с цветными кнопками. Напомню, что Just5 выпускает телефоны в нише «для пожилых», ниша новая, поэтому мне интересно.
Поверчу в руках, потом поделюсь впечатлениями (спасибо
Но самое интересное, что мне показали две инженерные модели — угловатый телефон, похожий на CP11, где у каждой кнопки свой цвет и совсем новый телефон с металлическим задником, цветным экраном, Bluetooth и камерой. Последняя модель мне показалась очень странной, ведь по идее, ниша таких телефонов — очень простые устройства, а тут явный уход не в ту совершенно сторону.
К сожалению, сфотографировать их было нельзя.
«Это не власть, если не от Бога»
Наткнулся на развенчивание ещё одного заблуждения, связанного с неверным переводом Библии (самые известные — «верблюд» вместо «каната» во фразе про игольное ушко и «не убивай», вместо «не убивай намеренно» в заповедях).
Обсуждаемая фраза там приведена неточно (без диакритических знаков), так что я передам только общий смысл, а не цитату. Смысл в том, что фраза греческой Библии «οὐ γὰρ ἔστιν ἐξουσία εἰ μὴ ὑπὸ θεοῦ», которая в синоидальном переводе Библии стала «нет власти не от Бога» на деле переводится как «не власть, если не от Бога», с тем смыслом, что не одобренная Богом власть не легитимна.
Я походил по словарям, на мой взгляд, подтверждается:
οὐ (not, no) — http://en.wiktionary.org/wiki/οὐ
γάρ (and, as, because, for) — http://concordance.biblos.com/gar.htm
ἔστιν (there is) —
ἐξουσία (power) — http://en.wiktionary.org/wiki/ἐξουσία
εἰ (if) — http://en.wiktionary.org/wiki/εἰ
μὴ (no) —
ὑπὸ (under) —
θεοῦ (of God) —
Карта тела от «Гугла»
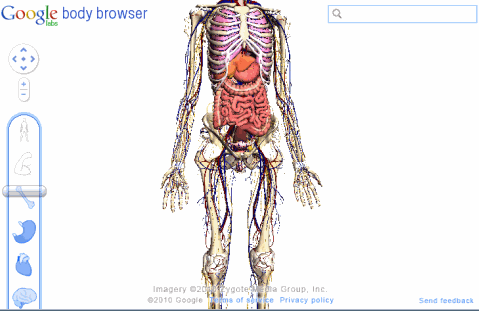
Сегодня уже все написали о сервисе «Google body browser». Работает только в браузерах, поддерживающих WebGL (на данный момент — FireFox 4.0b7 и свежие версии «Хрома»).
Я наверное час утром изучал внутреннее устройство человека (там можно включить названия органов и регулировать «прозрачность»). Вот вы знаете где у вас в точности находится желудок, поджелудочная, селезёнка?
Ближе к народу
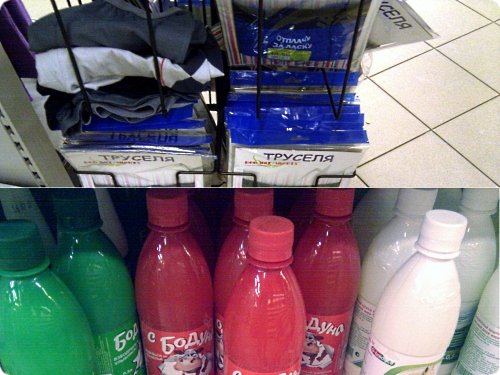
Сфотографировал в казанском супермаркете «Перекрёсток».
Судьба PHP6
Поговорил с одним из разработчиков PHP по поводу судьбы PHP6, самое ожидаемое изменение которого — переход на юникодные строки. Так вот Антон Довгаль рассказал, что проект, по сути, заброшен. Те несколько человек, которые занимались проектом, либо уволились, либо потеряли к нему интерес и сейчас считается, что поддержка юникодных строк в языке не так уж и нужна.
На примере своего опыта разработки и перевода проектов на PHP
То, что в PHP приходится для поддержки Юникода работать
Работать в PHP
Если бы этот язык нативно поддерживал
Новый год в Казани
Новый год мы проводим в Казани. Вылетаем из Москвы
UTF-8: как быстрее измерить длину строки в PHP
Я потихоньку буду писать как получается оптимизировать самые важные функции работы
Сейчас, после перевода «Вики» мы столкнулись с тем, что некоторые операции занимают непозволительно много времени.
Простые оптимизации я уже применил: выкинул из класса
Одна из самых частоиспользуемых функций — strlen, которая определяет длину строки. Я всегда считал, что самый быстрый способ подсчитать длину
Мои тесты показывают что это не так. Самый быстрый способ (по крайней мере в PHP 5.3.2) — это mb_strlen, strlen/utf8_decode — на втором месте, потом идёт sizeof+preg_split, а самый медленный — iconv_strlen.
Для интереса я вкомпилил в PHP функцию для быстрого подсчёта длины строки
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
Fast UTF-8: 0.68232107162476
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это тысяча итераций на файле в 400КБ.
Я оставил функцию mb_strlen.
Добавлено позднее: другая быстрая функция дала ещё худший результат: 0,79, против прежнего варианта в 0,68.
Добавлено ещё позже: а вот третья функция показала действительно впечатляющие результаты:
bolk-dev ~/uni/ $ php ../test/test_strlen.php | sort -k2 -t:
More Fast UTF-8:  0.12948799133301
mb_strlen: 0.88710689544678
strlen/utf8_decode: 1.5211808681488
Это уже дело — она почти в 7 раз быстрее лучшего результата PHP.
Вкратце, алгоритм такой: строка циклом выравнивается по границе четырёх
Добавлено через несколько дней: есть и ещё более быстрая функция.
Как я читаю книги
Меня время от времени спрашивают, как я успеваю так много читать, есть ли у меня методика, всё ли я запоминаю и так далее. Решил ответить одним постом.
Для начала, я совсем не считаю, что читаю много. Помилуйте, разве 70 книг в год — много? Это 5—6 книг в месяц. В детстве, когда у меня было больше свободного времени, в некоторые дни я читал по две книги среднего объёма. Вот это было много. Сейчас я читаю примерно по два часа в день, преимущественно, в метро, иногда — перед сном.
Я читаю довольно быстро, никакие специальные методики я не применяю, хотя и учился одно время (терпения не хватило) методике, которая позволяет выхватывать глазами целую строку. Я же определяю слово по рисунку, имя или незнакомое слово я могу распознавать, однажды увидев, но часто не способен сказать, как это произносится. Поэтому я почти никогда не знаю как зовут героев книги.
Вся литература для меня чётко делится на два класса: развлекательный и познавательный.
От литературы первого типа у меня ничего в памяти не остаётся, я развлекаюсь, получаю удовольствия от чтения, от эмоций, от фантазии на тему книги, потом всё уходит. Никаких глубоких моральных выводов я не делаю, для меня развлекательная литература без пророка.
Через
Познавательную литературу я читаю внимательно. Сейчас я читаю книгу «Агрессия» Конрада Лоренца, это научная книга о внутривидовой агрессии. Я прочитал 1/5 книги и сделал уже пять закладок. Я читаю электронные книги, там это просто. После прочтения книги, я просматриваю закладки, разбираюсь что меня зацепило, иногда, редко, пишу небольшие посты по ним в блог.
Такие книги я помню много дольше, иногда — всю жизнь, хоть иногда могу забыть название или (чаще) — автора.