Небольшой отпуск
У меня тут небольшой отпуск — взял со среды неделю, чтобы посидеть в тишине. На Новогодних почилить не получилось — работа не позволила. А тут ещё и жена на защиту тренерского диплома по психологии в Москву улетела и, чтобы не мучаться проблемой того, кто будет забирать дочку из школы (её надо забирать раньше, чем я заканчиваю работу), решил убить двух зайцев одним махом.
Заставляю себя не думать о работе, но по инерции мысли всё равно туда скатываются. Ну хотя бы рабочие чаты удаётся не читать. А вот что не удаётся — это выспаться. Я, как уже много раз писал, — «сова», а поскольку дочку надо отправлять в школу (она ездит на школьном автобусе), вставать приходится в обычные 6:30 утра.
Тем не менее, потихоньку отдыхаю, размякаю, чувствуется как разжимается кулак постоянной концентрации в голове. Неделя — это мало, конечно, но больше пока не могу себе позволить.
Замеры strlen_uft8 на «Флиппере Зеро»
Ну что же, я наконец сравнил свой вариант функции определения длины строки в кодировке
Оказалось, что обычные функции замера времени под «Флиппером» не работают. мне не удалось получить значение текущего времени ни одним из способов к которым я привык на Си, поэтому опять пришлось читать исходники прошивки «Флиппера».
В итоге обнаружился метод, выводящий затраченное время с секундной точностью:
FuriHalRtcDateTime curr_dt;
furi_hal_rtc_get_datetime(&curr_dt);
uint32_t start = furi_hal_rtc_datetime_to_timestamp(&curr_dt);

for (int i = 0; i<1000000; i++)
len += strlen_utf8("This is a test и русских букв тоже");

furi_hal_rtc_get_datetime(&curr_dt);
uint32_t stop = furi_hal_rtc_datetime_to_timestamp(&curr_dt);
Хотелось бы точнее, но этого, в принципе, хватает, чтобы понять какая функция быстрее и на сколько. Надо просто сделать очень много итераций. Я попробовал запускать на миллионе и десяти миллионах.
В итоге, на десяти миллионах наивная реализация выполняется примерно за 80 секунд, моя и чужая быстрая — около 50, явного лидера из этих двух реализаций выделить не удалось. Все замеры делал несколько раз.
Энтекофобия
Например, если мне надо отсчитать четырнадцать повторов, я лучше разобью это число на десять и четыре, на два раза на семь или ещё
«Щенячья школа»
Интересно, что дочка частенько вдохновляется в своих поделках фильмами, которые мы смотрим. Если они ей нравятся, разумеется.
Недавно смотрели документальный фильм про обучение
После него у нас появилось несколько собак, собранных из «Лего» и бумажный двухэтажный приют для щенков, сделанных из пластика и пластелина.


DSP SIMD для Flipper Zero
В этом версии нет никакой защиты цикла от чтения за границей буфера, мне показалось, что во «Флиппере» это неважно, но возможно это не так.
Ну что ж, разобрался я что за зверь такой этот DSP SIMD и запрограммировал на нём векторизированную версию функции для измерения длины строки.
Сегодня описывать и замерять уже не буду, и так времени много ушло, но по крайней мере всё работает на настоящем «Флиппере».
Сразу можно заметить, что вектора тут вдвое короче — всего четыре байта, да и функций для работы с ними гораздо меньше, но этого набора оказалось достаточно, чтобы всё векторизовать.
#include <arm_acle.h>

size_t strlen_arm_utf8(char * str) {
    uint32_t len = 0;
    int8x4_t zero = 0x00000000;
    int8x4_t one  = 0x01010101;
    int8x4_t threshold = -1077952577; // -65, -65, -65, -65

    for (;;) {
        uint8x4_t result;
        int8x4_t vec = *(int8x4_t *) str;

        __uadd8(0xFFFFFFFF, vec); result = __sel(zero, one);
        if (result > 0) {
            if (result == 0x01000000) {
                __ssub8(threshold, vec); result = __sel(zero, one);
                return __usada8(result, 1, len);
            }
            break;
        }

        __ssub8(threshold, vec); result = __sel(zero, one);
        len = __usada8(result, zero, len);

        str += sizeof(uint8x4_t);
    }

    for (signed char c; (c = *str); str++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}ARM бывают разные
Преодолев внутреннее сопротивление, я
Во «Флиппере» стоит процессор ARM, а они, как оказалось, бывают очень разные.
Я ещё в самом начале посмотрел спецификацию процессора «Флиппера» и, увидев слово SIMD, совершенно успокоился — в моём понимании это означало, что я могу использовать любые команды векторизации, которые мне необходимы. Тут я немного поторопился, но меня подгоняло желание разобраться как устроена векторизация. Теорию я знал, а тут подвернулась, пусть немного синтетическая, но задача, которую руки чесались решить.
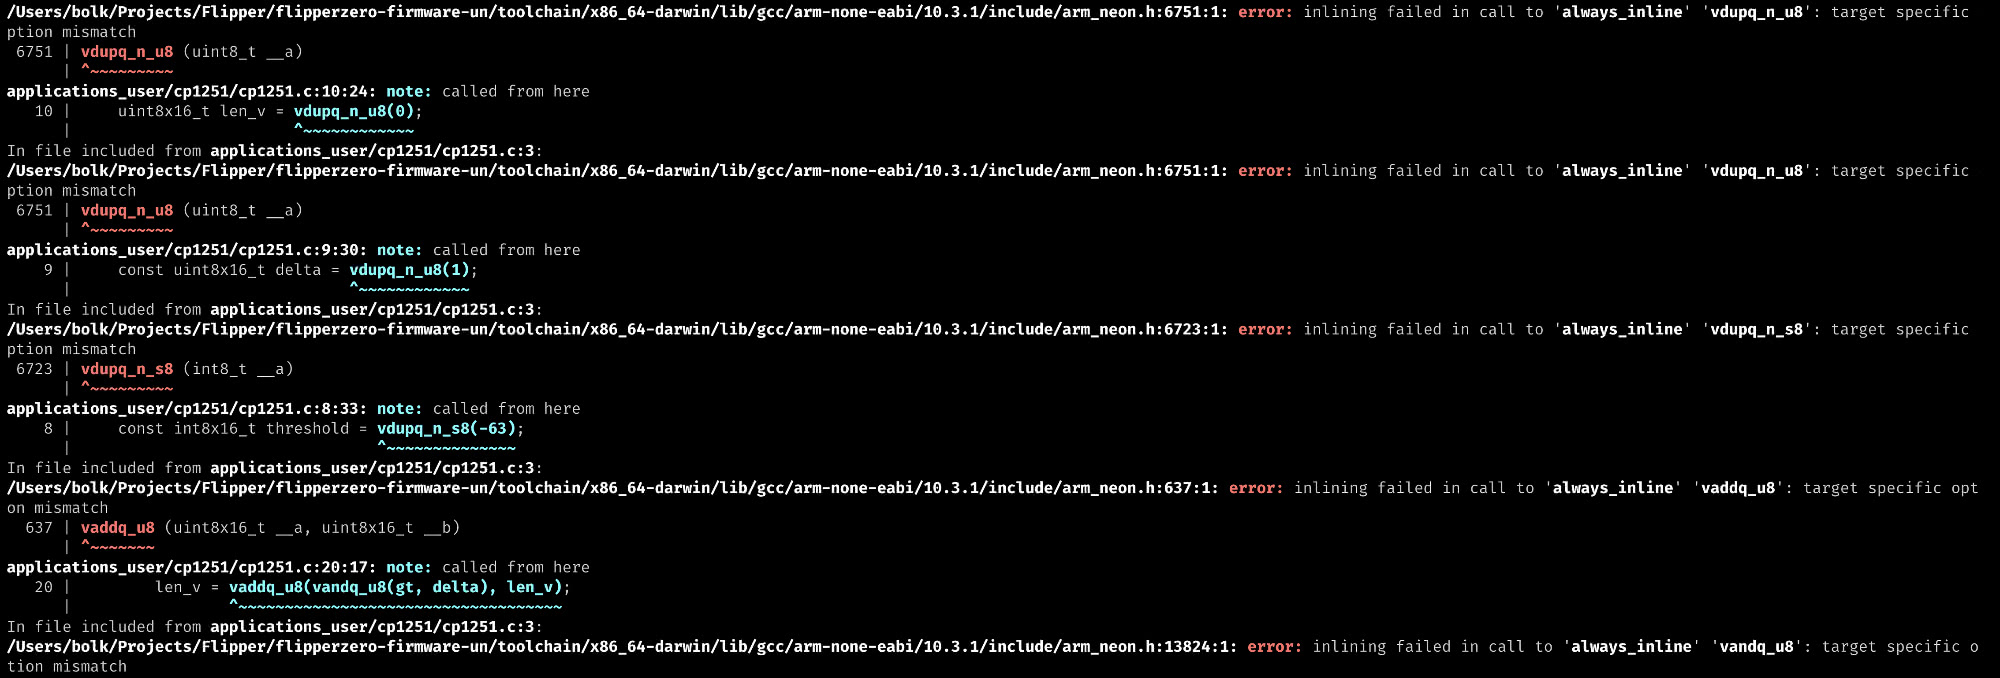
Как я уже говорил, мне захотелось срезать углы, поэтому функцию до этого момента я писал на своём ноутбуке, раз так случилось, что у меня на нём тоже процессор ARM. И лишь сегодня я попробовал вставить её в одну из своих программ и собрать её для «Флиппера».
Сначала компилятор заявил мне, что не нашёл некоторые векторные функции, в частности функцию нахождения минимума vminvq_u8 и суммы vaddvq_u8.
Ветку с vminvq_u8 я временно убрал, а функцию суммы vaddvq_u8 решил заменить на поэлементное сложение (vaddq_u8), которая, вроде, компилятору знакома.
Мысль простая — в векторах, сумму которых мы находим, на каждой позиции нули и единицы, поскольку каждый элемент вектора у нас восьмибитный, в общем случае у нас поместится результат 255 операций, а потом я могу просто просуммировать элементы циклом.
uint8x16_t len_v = vdupq_n_u8(0);
int reset = 0;

// тут у нас цикл
uint8x16_t gt = vcgtq_s8(operand, threshold);
len_v = vaddq_u8(vandq_u8(gt, delta), len_v);

if (++reset >= 255) {
    for (size_t i = 0; i < sizeof(uint8x16_t); i++) {
        len += *((uint8_t *)&len_v + i);
    }

    reset = 0;
    len_v = vdupq_n_u8(0);
}
Я был очень доволен решением (оно не совсем моё, его мне навеял код, используемый в PHP), но оказалось, что оно тоже не компилируется.
Сборка заругалась на ошибку target specific option mismatch, означающую, что указанное при компиляции железо не поддерживает те возможности, которые я пытаюсь использовать в коде. Пришлось лезть в тулчейн, чтобы разобраться какие ключи компиляции сейчас используются.
В файле compile_commands.json можно увидеть, что при сборке используется ключ -mfpu=fpv4-sp-d16, тогда как мне, чтобы использовать нужные команды векторизации нужен ключ -mfpu=neon.
Так как ключи компиляции указывали разработчики «Флиппера», думаю, они в точности знали в какие значения их выставить. Согласно спецификации на борту использованного во «Флиппере» процессора SIMD есть, но, видимо,
Полтора
Не раз приходила в голову мысль, что «полтора» — это
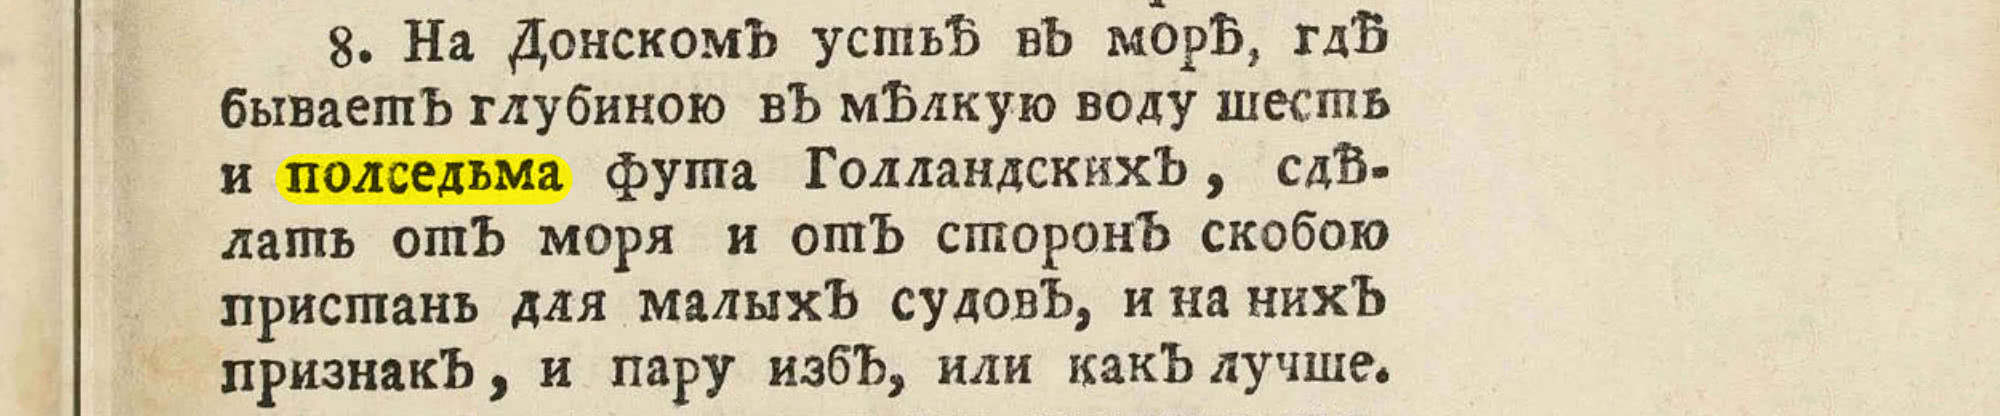
Сегодня я узнал, что «полтора» — это «полвтора». Была
Полвторого на часах — это ровно то же самое.
Пора перенести измерение длины на «Флиппер»
Кажется я то ли прокрастинирую, то ли боюсь неудачи. Предполагалось, что векторизованный алгоритм измерения длины строки в кодировке
Он вполне может не скомпилироваться — не уверен, что на «Флиппере» есть
Лайфхак: как надеть ботинок
От чего мои читатели, кажется, были до сих пор избавлены, так это от моих ценных лайфхаков. Тем не менее, этот мне нравится настолько, что хочу поделиться им широкой общественностью. Это знание слишком ценно, чтобы им владел я один.
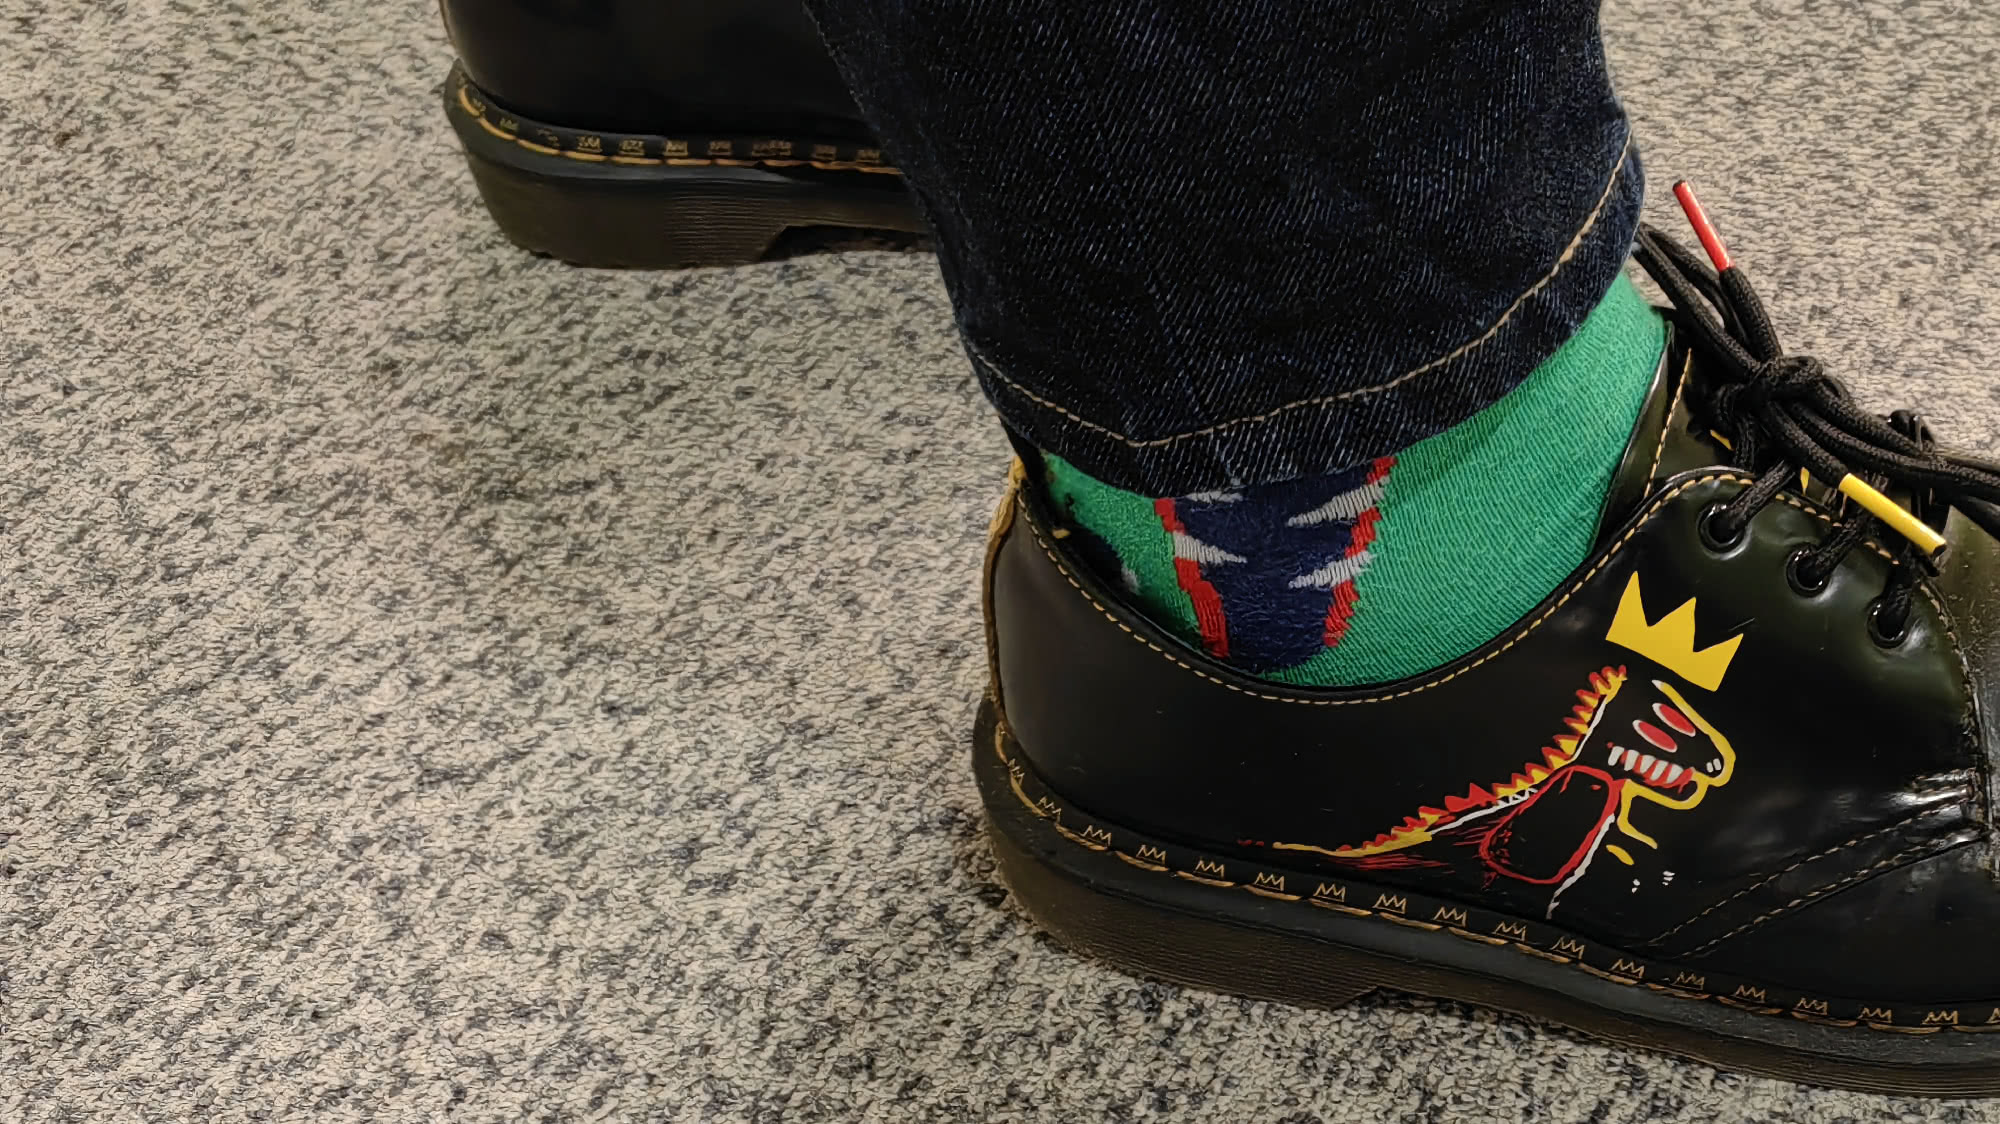
Если вам приходится надевать ботинок с жёстким задником
После этого потихоньку вдавливаем пятку в обувь, а то, что подложили, равномерно и медленно вытягиваем вверх вдоль задней поверхности ноги. Обычно получается почти сразу.
Дискета на 3,5 дюйма
Добавлено: разоблачения не произошло. Дискета действительно 90 миллиметров, у меня просто линейка кривая.
Прочитал в «Википедии», что дискеты 3,5 дюйма, якобы, не такого размера:
Дискета имеет метрический размер (90 мм в ширину и 94 в длину), но запомнилась именно как «трёхдюймовая» (3,5″ — это чуть меньше, 88,9 мм).
Нашёл дома
Померил — около 89 миллиметров, не знаю точно ли 88,9, по линейке особо не прикинешь, но не 90 — точно. Заказал на одном
В «Википедии» опять
Добавлено: в ЖЖ, куда у меня транслируется мой бложек, высказали предположение, что у меня, возможно,

Чуть более быстрый подсчёт длины строки в UTF-8
Сегодня очень плохо спал — всё время просыпался, потом долго ворочался, не мог уснуть. Утром оказалось мозг никак не мог успокоиться после вчерашней заметки про разбор быстрого алгоритма для подсчёта длины строки в
Вчера я остановился на том, что у разбираемого способа есть две очевидные недоработки — ненужное вычисление, которое решается инвертированием условия и подсчёт «хвоста», который всегда вычисляется «классическим» способом — без векторизации, хотя если строка у нас кратна вектору, можно было бы этого избежать.
Первый недостаток исправлялся очень просто, а хорошая реализация второй проверки мне вчера в голову не пришла.
Зато, когда я проснулся, она уже была у меня в голове. Всего три операции — первой получаем вектор, где на позициях с ненулевым байтом записывается 255, потом делается операция «И» с номерами позиций и весь вектор суммируется.
В итоге, если ноль стоит в векторе только на крайней правой позиции, у нас получается сумма арифметической прогрессии без последнего элемента.
По замерам такой вариант чуть быстрее.
size_t strlen_utf8(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-63);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            uint8x16_t pos = {1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16};
            uint8_t sum = vaddvq_u8(vandq_u8(vtstq_u8(operand, operand), pos));

            // арифметическая прогрессия без последнего члена
            if (sum == 16*(16+1) / 2 - 16) {
                uint8x16_t gt = vcgtq_s8(operand, threshold);
                return len + vaddvq_u8(vandq_u8(gt, delta)) - 1;
            } else {
                break;
            }
        }

        uint8x16_t gt = vcgtq_s8(operand, threshold);
        len += vaddvq_u8(vandq_u8(gt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Разбор быстрого подсчёта длины строки в UTF-8
Давайте попробуем
Напомню как выглядел код:
size_t strlen_php(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-64);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            break;
        }

        uint8x16_t lt = vcltq_s8(operand, threshold);
        len += sizeof(uint8x16_t) - vaddvq_u8(vandq_u8(lt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Для ускорения подсчёта в алгоритме используется векторизация, — это когда мы работаем с пачкой чисел, делая над каждым из них
Вектор загружается функцией vld1q_s8, где коды символов считываются по адресу, записанному в указателе p. В дальнейшем мы будем его сдвигать на размер вектора, чтобы забирать следующую пачку данных.
Ниже используется функция vminvq_u8, которая вычисляет минимальное значение в векторе, рассматривая его как набор байтов без знака. Если там ноль, значит строка кончилась и в нашем векторе — хвост, который надо досчитать обычным способом, без вектора. Тут можно было бы проверить на какой позиции слева находится признак конца строки, если на самой последней, то строка была кратна вектору. Но я не стал заморачиваться. Но такая проверка оказалась медленнее подсчёта длины хвоста обычным способом.
Дальше функция vcltq_s8 сравнивает каждый байт в векторе со значением −64 — это значение загружается в каждый элемент вектора для сравнения функцией vdupq_n_s8.
Результирующий вектор заполняется значениями 0 или 255, в зависимости от результата сравнения. Функция vandq_u8 производит операцию «И» с единицей, после чего у нас в векторе ноль остаётся неизменным, а 255 превращается в единицу. Эти единицы мы суммируем функцией vaddvq_u8.
Теперь у нас получился вектор, в котором подсчитаны все внутренние байты символов, а чтобы подсчитать внешние, надо вычесть это число из длины вектора. Правильнее было бы инвертировать сравнение, до этого в разгаре экспериментов просто не дошли руки.
Полученное число мы добавляем к вычисляемой длине и сдвигаем указатель. В конце досчитываем хвост обычным циклом. Конец алгоритма.
Надёжность устройств «умного дома»
Недавно приятель в разговоре про «умный» дом (он тоже потихоньку докупает себе всякие компоненты, но ещё не подключал их друг другу) спросил у меня про надёжность различных компонентов — то есть насколько часто у меня
У меня около семидесяти устройств, это довольно много, но с выходом
Как будто это не так много.
P. S. про Юникод продолжу завтра. По крайней мере так планирую.
Определяем границу символа в UTF-8
В Телеграме попросили рассказать как работает код, который я приводил вчера в заметке про ускорение функции, возвращающей количество символов в строке с кодировкой
Там действительно есть что рассказать, но рассказ придётся разбить на несколько частей. Я постараюсь по возможности не погружаться в дебри. В этой части начну с того, что расскажу чем вообще необычна эта кодировка.
Все кодировки условно можно разделить на две части: кодирующие символ фиксированным или переменным количеством байт. К первым можно отнести, например, CP1251,
Справедливости ради, есть и другие виды кодирования, но нам их рассматривать ни к чему.
Тут важно то, что для строки в
Посмотрим на картинку из «Википедии», которая показывает как устроена эта кодировка:

Тут нам интересна только колонка «шаблон», где видно, что все «внутренние» байты символов начинаются с одной и той же сигнатуры — старший бит установлен, младшие — сброшены.
То есть, байты в диапазоне от 10000000 до 10111111 (в бинарном представлении) — внутренние байты, остальные — начало символа. Опять же, согласно таблице начала попадают в диапазоны 00000000-01111111 и от 11000000 до 11011111.
Умные люди заметили одну закономерность, сейчас мы её тоже увидим. Давайте напишем небольшую программу:
#include <stdio.h>

int main() {
    const signed char arr[] = {
        0b10000000, 0b10111111, 0b00000000, 0b01111111, 0b11000000, 0b11011111
    };

    for (int i = 0; i < sizeof(arr) / sizeof(arr[0]); i++) {
        for (int b = 128; b; b >>= 1) {
            printf("%d", (arr[b] & i) > 0);
        }

        printf(" % d\n", arr[i]);
    }
}
Вот что она выводит (диапазон, в котором находятся внутренние байты, я выделил другим цветом):
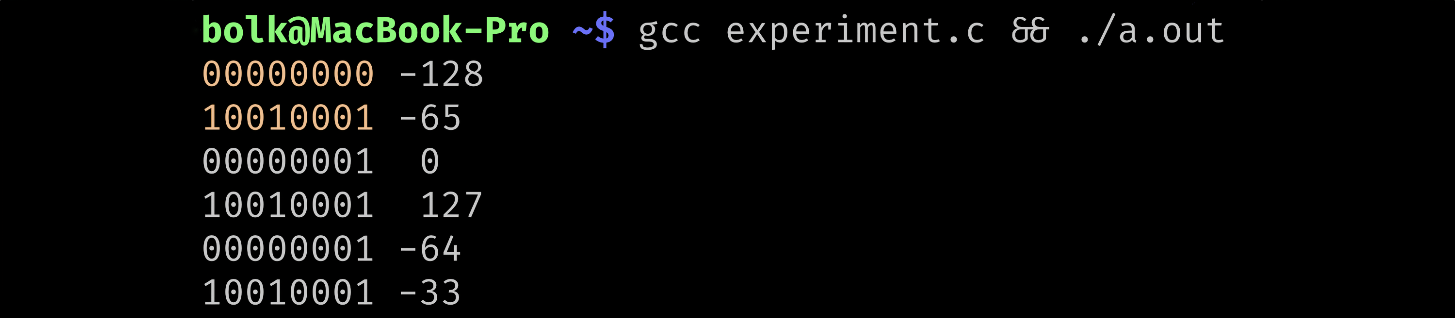
Закономерность в том, что все внутренние байты в знаковом представлении по значению меньше −64. Это довольно дешёвая проверка с точки зрения машинного кода, что очень хорошо, так как наша цель — производительность.
Про остальное — в следующий раз.
UTF-8 на ARM
Пока проект внедрения Юникода во «Флиппер Зеро» на паузе, — разработчики занимаются обновлением одной из важных библиотек, я вспомнил, что
Например,
Любопытно посмотреть как обстоят дела с ускорением таких вещей на процессоре, который установлен на «Флиппере». Правда до него у меня руки ещё не дошли, но я уже потренировался на своём «Макбуке», благо тут процессор той же архитектуры.
Идея всё та же — векторизация. За референс я взял наивную реализацию с перебором по одному байту:
size_t strlen_naive(const char* str) {
    size_t len = 0;
    char ch;

    while ((ch = *str++)) {
        len += (ch & 0b11000000) != 0b10000000;
    }

    return len;
}
Попробовал несколько вариантов, но лучше всех показали себя две функции: та, которую я упоминал в первом абзаце и переделанная нашими общими с братишкой усилиями реализация, найденная в недрах PHP.
После переделки она стала выглядеть так:
size_t strlen_php(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-64);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            break;
        }

        uint8x16_t lt = vcltq_s8(operand, threshold);
        len += sizeof(uint8x16_t) - vaddvq_u8(vandq_u8(lt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Повторюсь, у меня пока не дошли руки попробовать это всё на «Флиппере», но на моём «Макбуке» результаты выглядят следующим образом. Это десять тысяч прогонов на русскоязычном тексте, размер которого чуть больше ста тысяч символов.
Name   Length  Time
----   ------  ----
PHP    117465   97797
Fast   117465  143780
Naïve  117465  531535
Не скажу, что я делал всё как положено, — надо бы считать среднее и отклонение, разносить по разным файлам, научиться прибивать процесс к производительным ядрам, но разница в результатах достаточно показательна (я запускал несколько десятков раз), поэтому, как мне кажется, и так нормально.
Цифры в попугаях (больше — хуже), которые выдаёт сишная функция clock(), компилировал компилятором Clang 15 с ключом -O3.
Глубокая зима
У нас в Казани прям
С новым, 1952 годом
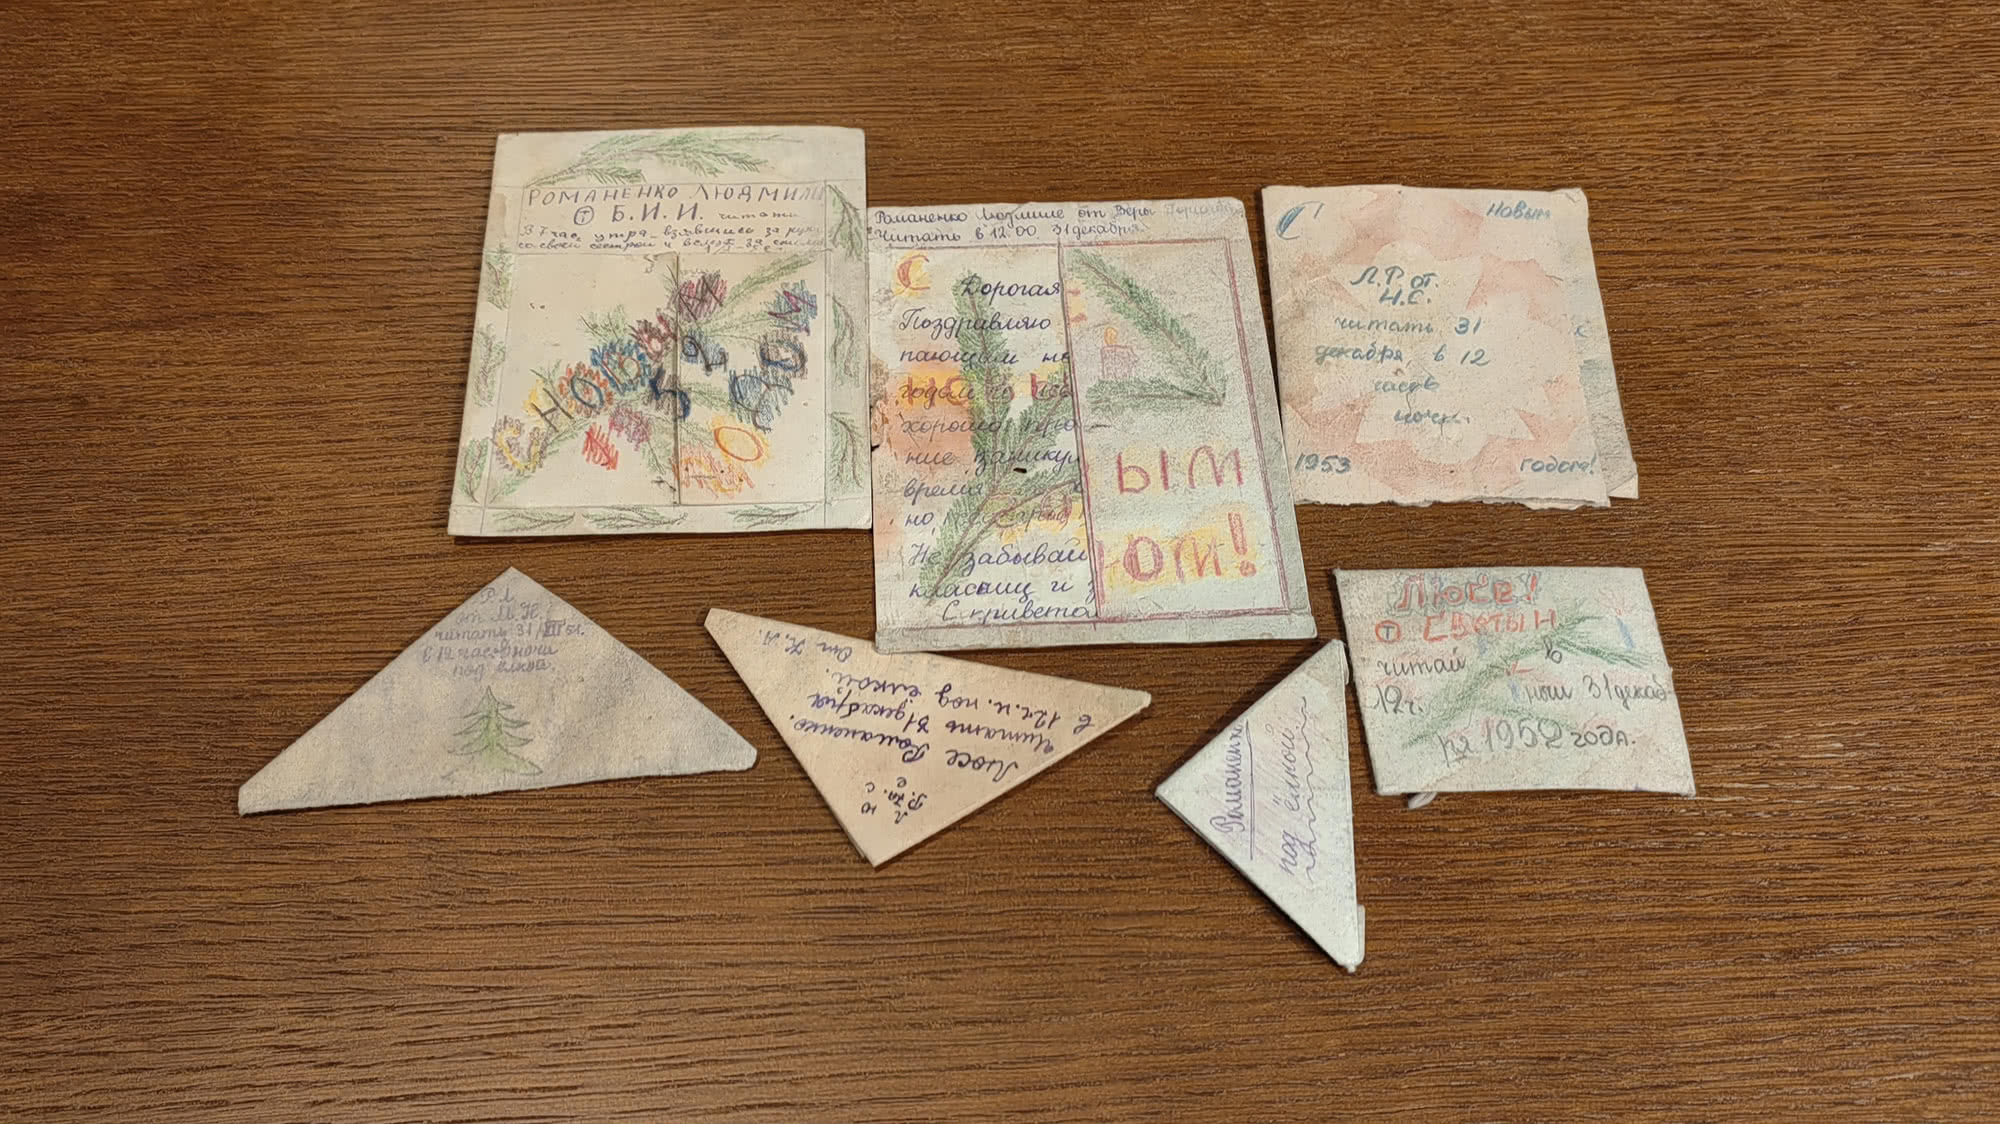
В прошлом году на чердаке одного из казанских домов, куда меня пустили осмотреться, нашёл стопку новогодних писем, датированных
В тот момент у меня возникла идея публиковать каждый день нового года по письму, благо в них нет ничего личного. Но в праздники пришлось работать, я заболел, кроме того наложилась покупка новой машины, поэтому мне было совсем не до этого.
Время я упустил, теперь никак не могу решить — опубликовать их сейчас или потерпеть до нового Нового года. Идея их выложить сюда на даёт мне покоя, но кажется привязать это к праздникам было бы интереснее.
Оpанжевое небо, оpанжевое моpе…
Похоже многие думают, что оранжевый — мой любимый цвет. На прошлой неделе в очередной раз об этом спросили.
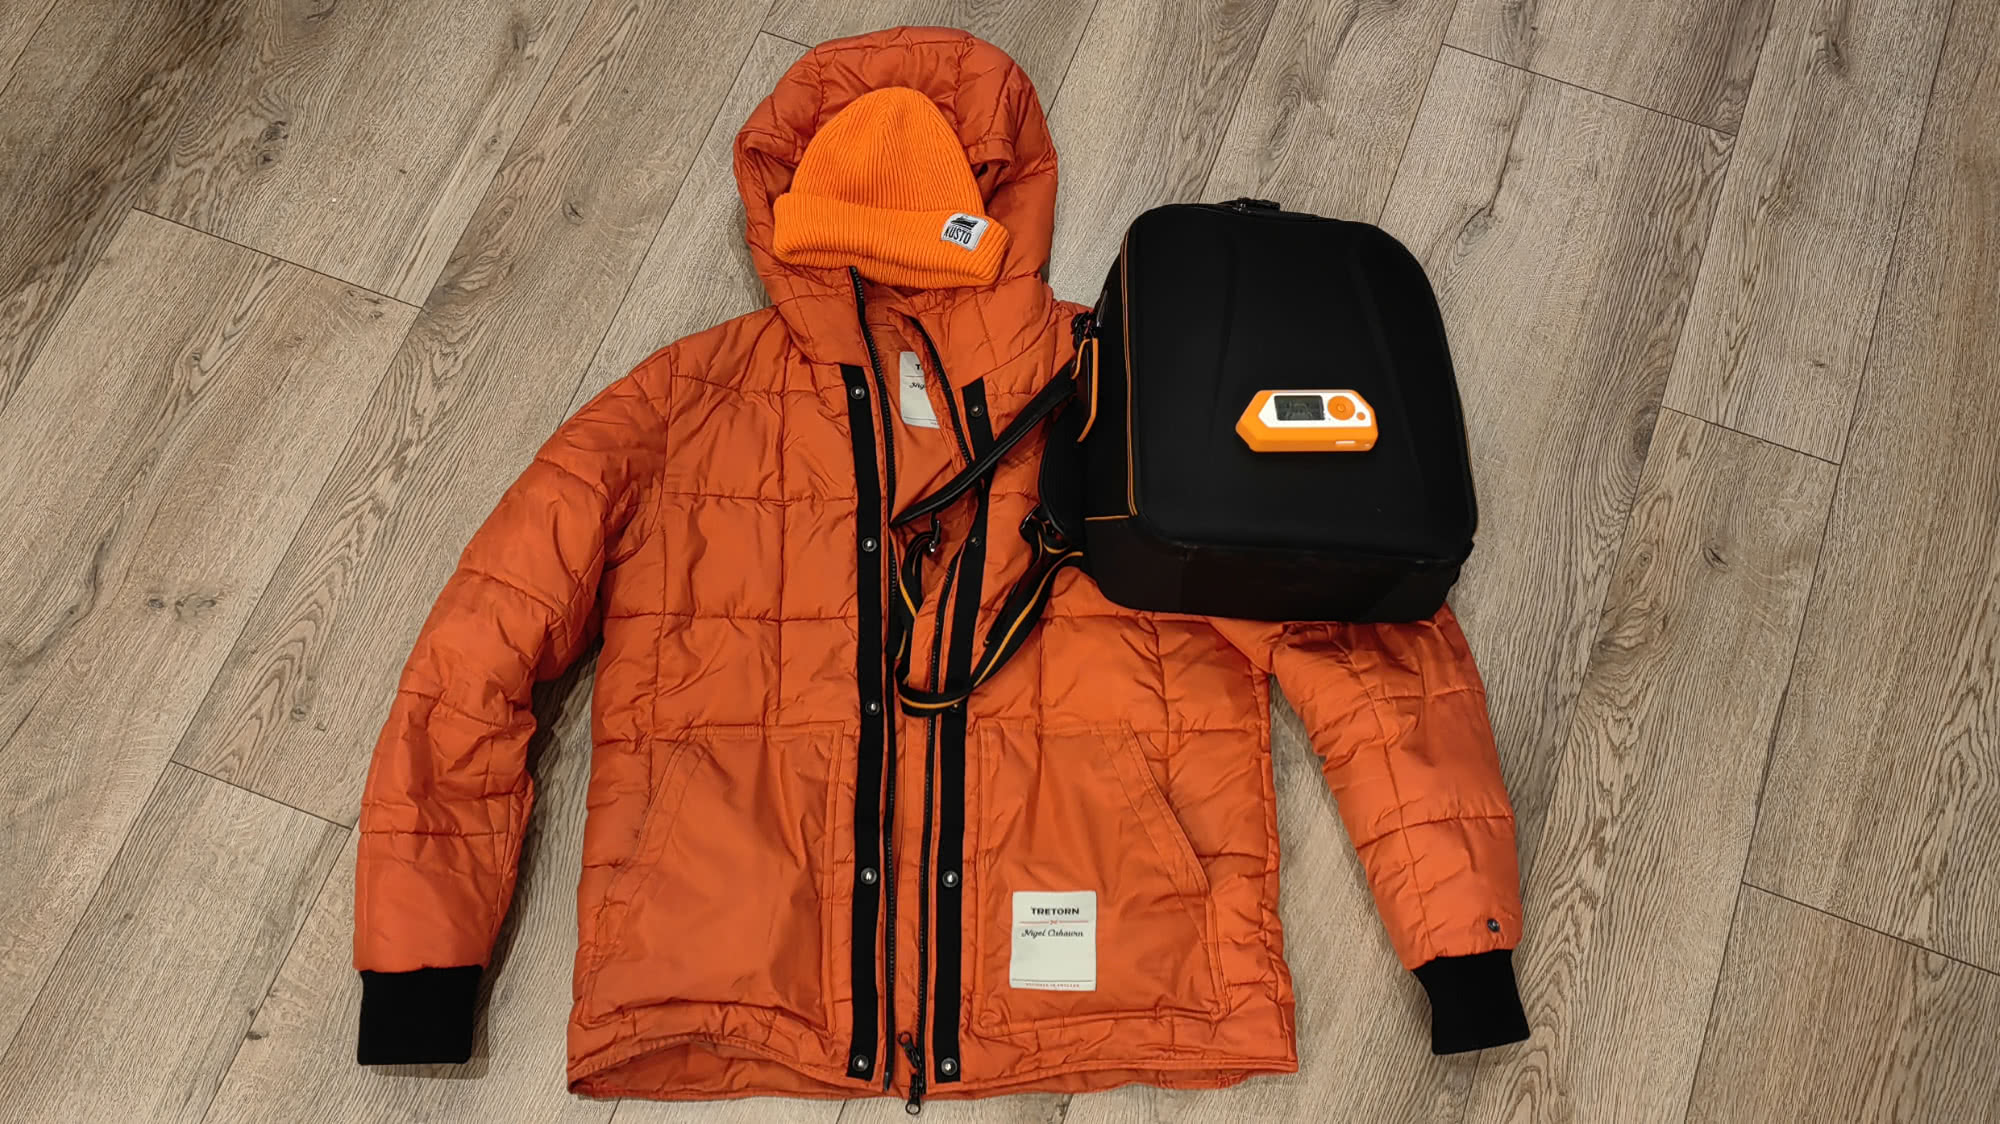
Причина есть — уже не первую зиму хожу в оранжевой куртке, в оранжевой же шапке, с рюкзаком с оранжевыми вставками и даже чехол на «Флиппер Зеро» купил тоже оранжевый.
Вроде никакой особой слабости именно к этому цвету я не питаю,
А вот какой цвет у меня любимый я сказать затрудняюсь, раньше были
«Виселица» в магазине приложений
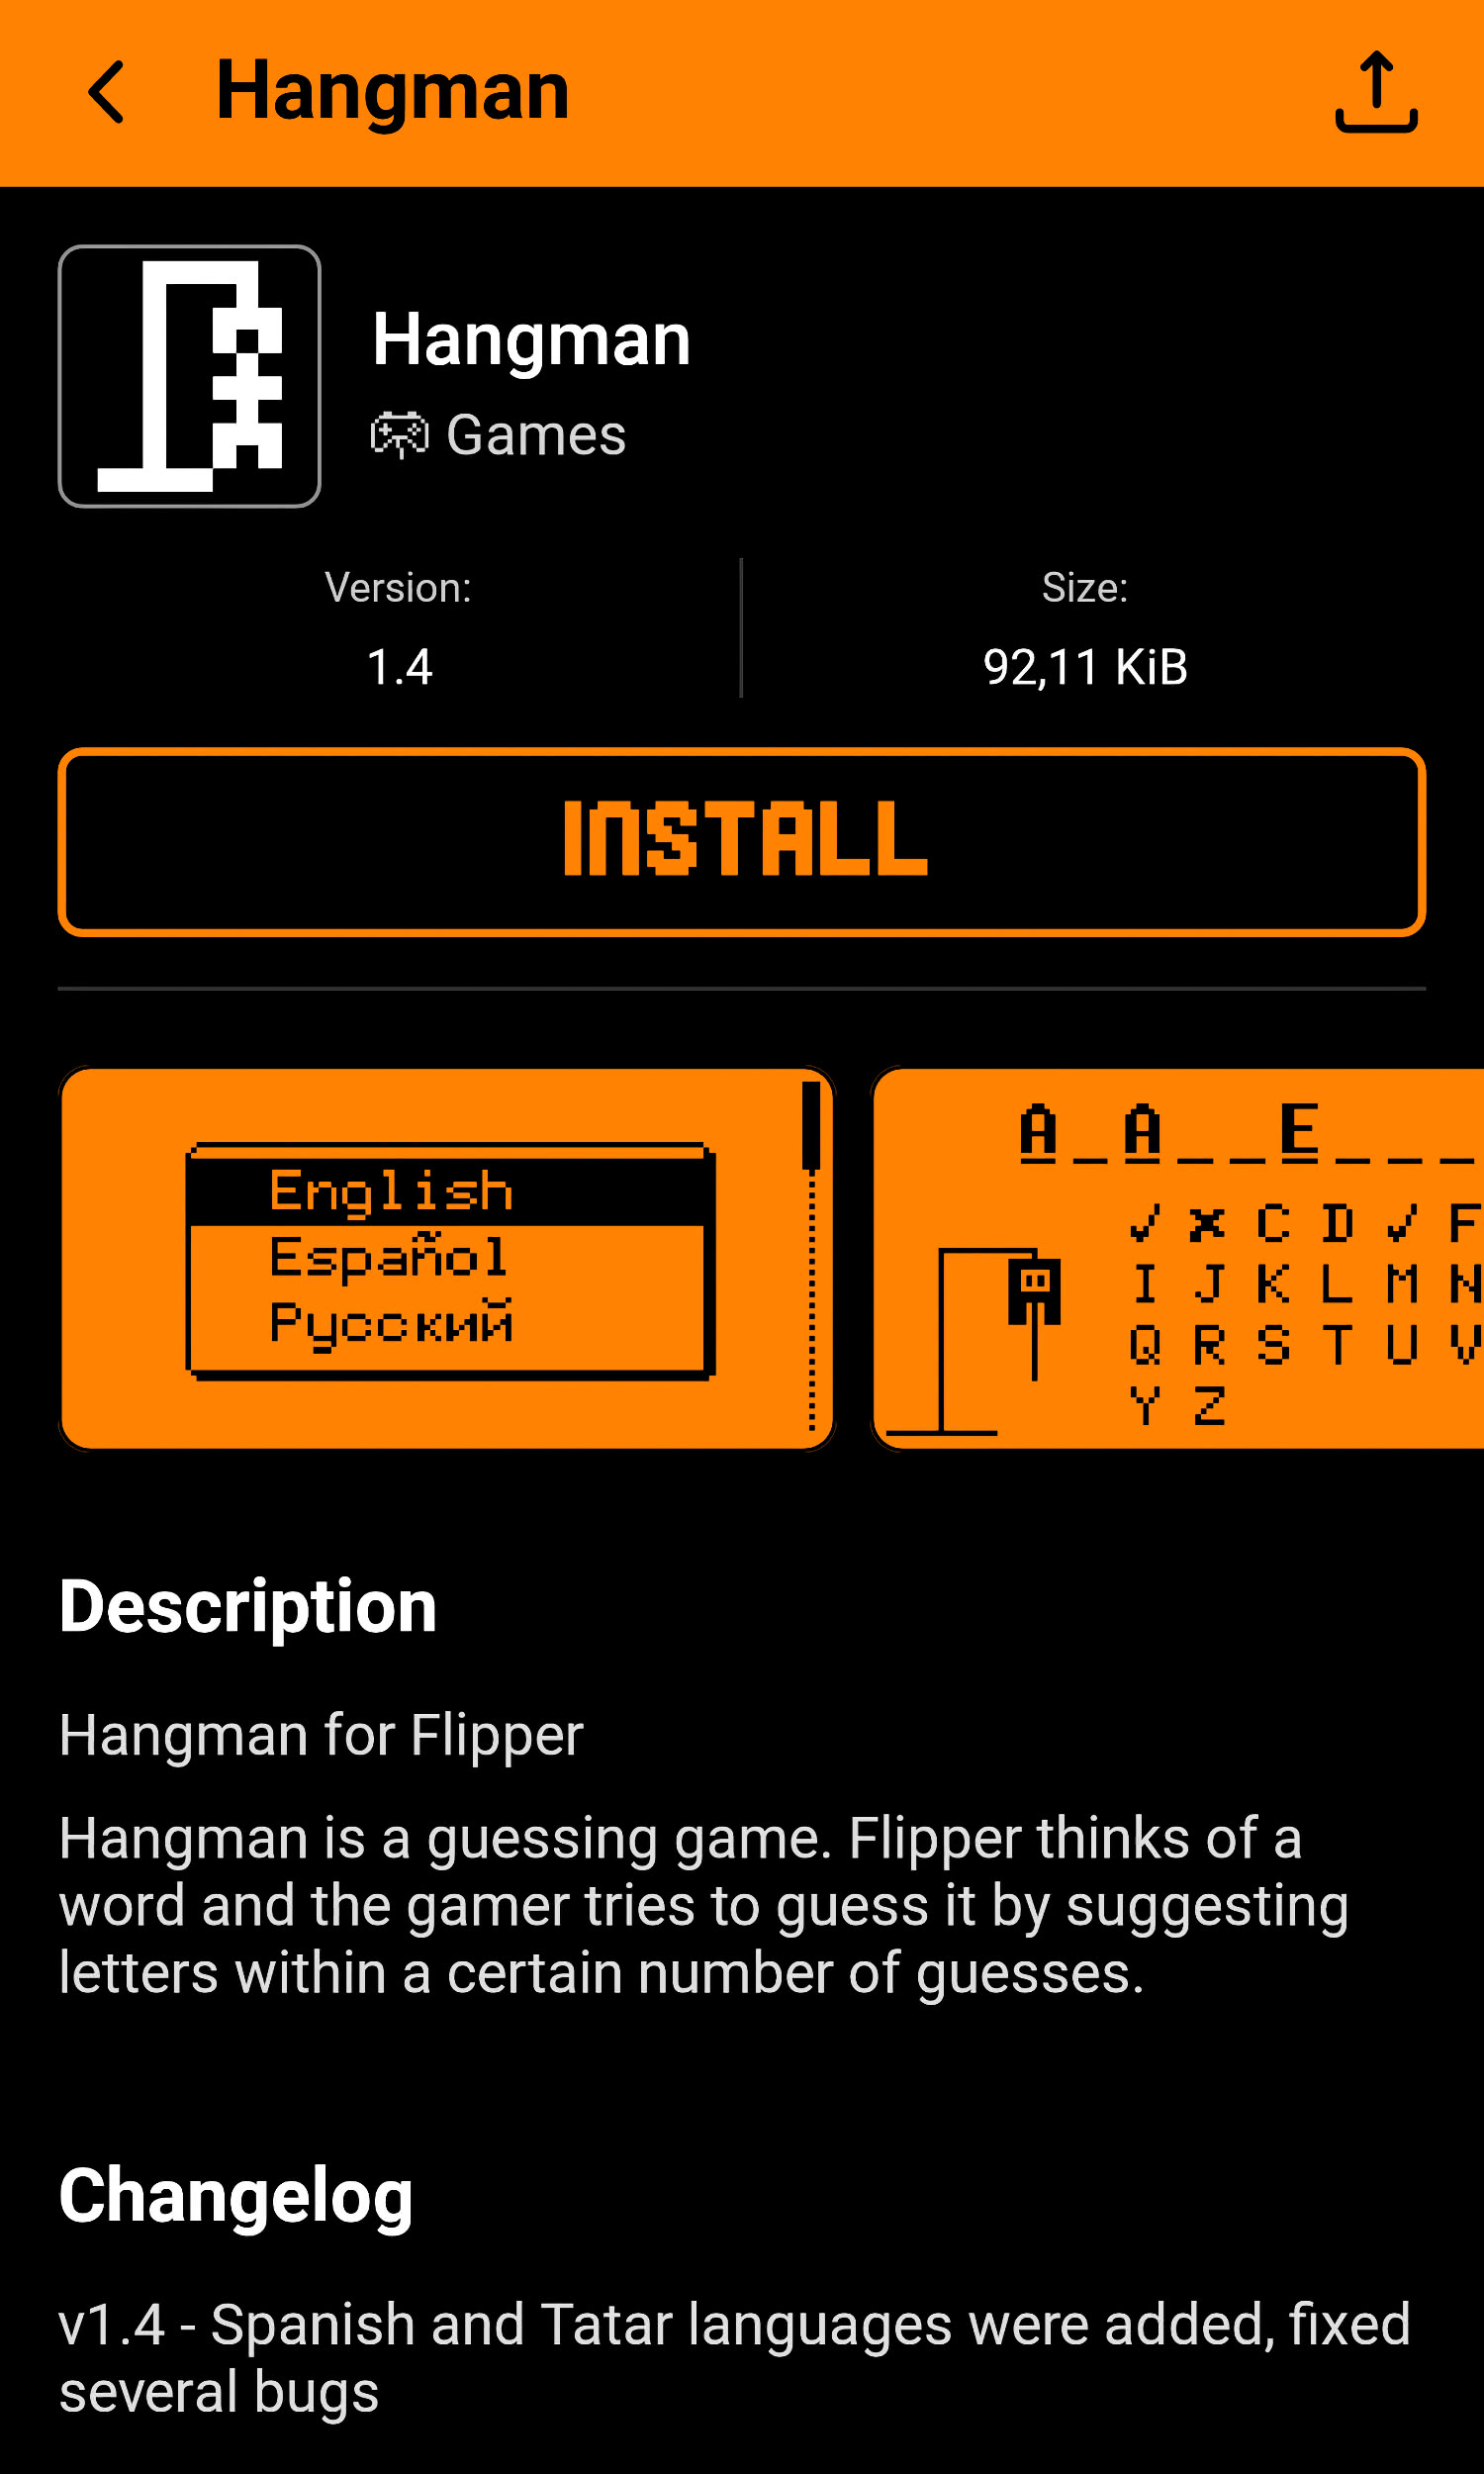
Я долго не знал как выглядит наша с дочкой игра «Виселица» в магазине приложений «Флиппера Зеро» —
А на днях вспомнил, что
Честно сказать, необходимость постоянно использовать
Казань завалило
На днях в Казани выпало
В рабочих чатах причитают ребята с загородной недвижимостью, а у Евы отменили занятия в школе — всё
Обычно я не люблю зиму, но оказалось, что именно такая зима — многоснежная, тёплая мне нравится. С удовольствием смотрю на неё как через окно, так и безо всякой преграды. Собака тоже рада — прыгает по сугробам, как кролик.
Короче, если бы так было все три зимних месяца, я был бы рад, но коммунальщикам пришлось бы несладко.
