Поколение твиттера
Наверное многим известен термин «клиповое сознание», его часто связывают с невозможностью сосредоточится на длинных текстах, следить за длинной логической цепочкой (вспомните «ниасилил, много букв»), хотя правильнее, на мой взгляд его связывать с попыткой справиться с быстрым устареванием знаний. То есть рассматривать причину, а не следствие. И правда, зачем изучать
Я сам частично этому подвержен — мне нравятся блоги, а это признак. Блоги характеризуются небольшим размером поста, хотя мне нравится и художественная литература. Вот что мне не нравится, так это твиттер. Для тех, кто не знаком: это так называемый «микроблогинг», разновидность блога. Размер сообщения в данном микроблоге — 140 символов.
Я легко могу понять почему так популярны блоги: для сознания клипового типа так проще. Почему стал популярен твиттер, я уже тоже начинаю понимать. Рождается новое сознание «стриповое», для которого текст на два абзаца сложен.
Это значит, что поток информации ещё более увеличился за последние годы и люди не успевают её перерабатывать. Наверное, немаловажна и обратная сторона — авторская. В «микроблог» можно писать быстрее, более сыро, на ходу и чаще. Но эту сторону я рассматривать не хочу, не интересно. Хотя, именно этим мне «Твиттер» не нравится — негде развернуться, да и туземная краткость талантом блещет редко.
Мне более интересно, что я теперь знаю почему меня так раздражают «настроения» в «Ярушке»: это микроблогинг (куда люди, якобы, пишут своё настроение) с лёгким форматом, туда можно записать любую короткую фразу, уж совсем не обременяя себя усилиями по вкладыванию в неё смысла. Я, кстати, ничем не лучше: я четыре раза пользовался этой функцией: один раз написал пошлый афоризм, один раз высказал сомнение в полезности «настроений» и два раза процитировал великих (одна цитата из Маяковского, другая — из «Соляриса»). Только второй фразой я хотел
Если вас утомил предыдущий абзац, у вас «стриповое» сознание.
Если вам кажется, что в слове «стриповое» есть
Повторенье — мать ученья
Простите, наболело. Многие товарищи
while True: passЧему учит нас этот бесконечный цикл на «Пайтоне», кроме того, что бесконечность — это очень долго? Не надо забывать, что повторенье только мать ученья. А чтобы ученье зачалось нужен ещё и папа, а чтобы родилось, хорошо бы и акушера под рукой держать.
Девид Блейн, раскукож мой Samsung
Samsung выпустили забавный рекламный ролик обращающий внимание
Его сюжет — мужик ходит по комнате, снимая всё, что там попадается, включая свою подружку и восхищаясь
На «Хабре» довольно быстро заподозрили, зеркала никакого нет и в нём стоит просто
Но помимо мелочей, Samsung прокололась в главном: отражение в чайнике (или что это такое) не совпадает с отражением в «зеркале». И никакие мелочи изучать не надо. Но это только поможет этой рекламе побыстрее забраться нам в головы.
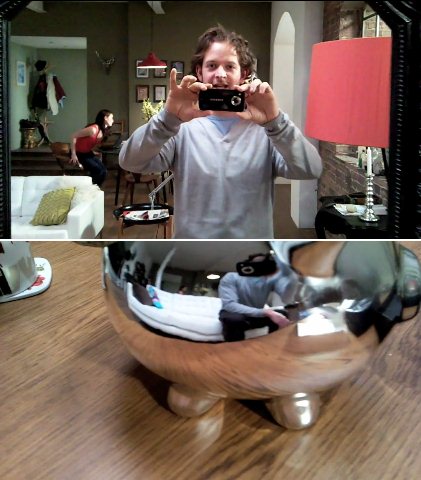
Дополнение от 16 апреля 2009 13:22: мне в комментариях подсказывают, что необходимости
Знаете ли вы JavaScript
У Дмитрия Барановского (это автор Raphaël —
Итак, что выведет каждый кусок кода?
if (!("a" in window)) {
    var a = 1;
}
alert(a);
var b = function a(x) {
x && a(--x);
};
alert(a);function a(x) {
return x * 2;
}
var a;
alert(a);function b(x, y, a) {
arguments[2] = 10;
alert(a);
}
b(1, 2, 3);function a() {
alert(this);
}
a.call(null);I � Unicode
Давайте я вам про Unicode ещё раз расскажу?
Как известно, в памяти компьютера числа представлены битами, которые группируются в байты. Один байт может хранить одно из 256 значений (поскольку состоит из восьми бит, каждый из которых может хранить одно из двух). Следовательно, числа, значения которых > 255 хранятся в больше, чем одном байте.
Например, числа до 65535 можно уместить уже в двух байтах: в так называемом старшем записывается сколько раз полных 256 содержится в числе, а в младшем — остаток: старший × 256 + младший.
В зависимости от типа процессора, порядок, в котором записаны в памяти старшие и младшие байты, различается. Собственно, мне хорошо известны только две системы: младший записывается первым (как в процессорах Intel) и старший записывается первым (в процессорах ARM, которые стоят в смартфонах). Есть ещё смешанная, но с ней я не сталкивался. Системы эти носят имена:
Есть ещё системы, которые умеют переключать порядок (те же ARM) и называются
Термины
Сюрприз для непрограммистов: буквы в памяти компьютера тоже представлены числом. Это просто номер по порядку в компьютерном алфавите. Так девочки в нашем классе «кодировали» записки: вместо букв ставили номер позиции в алфавите.
Было принято очевидное решение — выделять на символ не один байт, а несколько. Так появился стандарт Unicode, где огромному количеству символов дано своё число и закреплены начертания, стандарт дополняется и новые версии выходят почти каждый год.
Система кодирования Unicode, где выделяются два байта, называется
Так как способов хранения чисел, не умещающихся в памяти у нас несколько, то системы подразделяются
Первого апреля
BOM. BOM расшифровывается как «byte order mark» (признак порядка байт) и ставится внутри файлов упомянутых двух- и четырёхбайтных кодировок. Если BOM внутри файла не встретился, принимается порядок
Теперь непрограммистам будет трудно.
Пока всё было достаточно просто, но человечество придумало ещё одну кодировку —
Трудность в том, что
Итак. Каждый символ в кодировке занимает от 1
Тут надо вспомнить что такое биты. Бит — единица информации, мельче не бывает, у него всего два значения — 0 или 1. Байт состоит из 8 битов, биты очень удобно записывать в позиционной двоичной системе: 00001011. «Позиционная» тут означает, что значение числа зависит от его позиции. Кстати, это привычная нам система. В числе «22» две двойки, но у первой значение в десять раз больше, чем у второй. Это десятичная позиционная система. В двоичной, каждая более левая однёрка будет больше в два раза своей соседки.
Таким образом число 1011 расшифровывается из двоичной как 1 × 23 + 0 × 22 + 1 × 21 + 1 × 20 = 1 × 8 + 1 × 2 + 1 × 1 = 8 + 2 + 1 = 11 в десятичной системе.
В первом символе нужно посчитать количество бит со значением «1» до первого нуля. Это общее количество байт, которым записан данный символ. Если количество байт — один (это вроде как специальный признак), то вы нашли не первый байт символа.
У нас в примере количество бит до первого нуля — два. Значит, буква записана двумя символами — первый это тот, на которым мы находимся и второй — который следует за ним. Каждый байт
Могу рассказать
Уточка №4
Не могу не попе*арить прекрасный блог, который радует меня по утрам: «уточка №4». Особенно хороши
Определение UTF-8 на чистом Perl
У нас сейчас смена админов: отдел переходит из ведомства одних админов к другим. Соотвественно, все задачи выполняются сильно медленее. Задача по установке модуля к Perl висит уже несколько дней. Вот и пришлось мне написать на чистом Perl функцию, определяющую
На Perl’e не писал уже очень давно, так что было интересно что я помню. Функцию, в итоге, сохраню здесь, мало ли — понадобится кому.
sub detect_utf8($) {
    my $str = shift;
    my %exclude = map { $_ => undef } (0..191, 194..244);  # RFC 3629

    for (my $i = 0, $l, $len = length $str; $i < $len; $i++) {
        $code = ord substr($str, $i, 1);

        return 0 unless exists $exclude{$code};

        for ($l = 0; $code & 128; $l++, $code = 0xFF & ($code << 1)) {}

        $i += $l - 1 if $l;

        return 0 if $i > $len or $l > 4; # broken
    }

    1;
}
Что можно улучшить: проверять, чтобы дополнительные байты имели старшие биты «10».
Интранет-вики
Мнение о том, что использование
Доступ по паролю
Большое заблуждение, считать, что http://user:password@example.org/ и http://example.org/user/password/ сильно различаются. Ничего подобного. Единственное различие между ними, что если набрать второй адрес руками, то он останется в истории браузера. Для AJAX’а более пригоден второй путь — «logout» делать сильно проще.
Необходимое замечание: речь, конечно же, идёт
Итак http://example.org/jfdhfjhrtjktjkfhdjht/ это вполне себе парольный доступ.
Госпожа Бовари смотрела много голливудских фильмов
Я тут на днях начал читать великолепную (по моим ощущениям) «Госпожу Бовари» Гюстава Флобера, там Бовари чувствует себя потерянной в жизни
Там было все про любовь, там были одни только любовники, любовницы, преследуемые дамы, падающие без чувств в уединенных беседках, кучера, которых убивают на каждой станции, кони, которых загоняют на каждой странице, дремучие леса, сердечные тревоги, клятвы, рыдания, слезы и поцелуи, челны, озаренные лунным светом, соловьиное пение в рощах, герои, храбрые, как львы, кроткие, как агнцы, добродетельные донельзя, всегда безукоризненно одетые, слезоточивые, как урны.
Так вот: не Голливуд виноват. Это всегда было. И Донцову не надо обвинять. В конце концов, не она же эти книги пишет, да и покупает у себя их не она.
Opera и document.all
«Опера» в одно время пыталась притворяться Internet Explorer’ом — копировала его
var isIE = document.all && self.operaВпрочем, на Западе «Опера» не популярна, поэтому «Оперу» не исключают и считают её разновидностью IE.
Так вот, в последние годы «Опера» пытается открестится от своего «иешного» прошлого, например,
В новых «Операх» конструкция alert(document.all ? 1 : 0) выдаст «0», тогда как alert(document.all) — «[object HTMLCollection]». Сделано понятно для чего: обратная совместимость не ломается, но проверка «не IE ли» теперь уже выдаёт false.
libmapi: насколько всё запущено
Похоже, что если некоторая задача программирования достаточно сложна, то рано или поздно Microsoft обязательно напишет API, упрятывающий все неудобства и сложности за простым в использовании интерфейсом.
Однако к MAPI это отношения не имеет
Цитата из книги «Основы MAPI» Ирвинг де ла Круз, Лес Талер, вырванная из контекста.
Python 2.4 не освобождает память
Как я уже не раз говорил, libmapi нещадно течёт. Я сейчас работаю с версией из транка,
Поэтому я изолирую libmapi в отдельном процессе, получаю данные, пока могу и отдаю их «наверх» — родителю, потом делаю новый процесс и получаю следующую пачку. Для того, чтобы отдать данные родителю я использую os.pipe, а данные туда можно передавать только строкой. Так как данные у меня сложные, я их сериализую при помощи cPickle, а для сериализации нужна память.
Где взять память, если всё, что было доступно процессу, съела libmapi? Я пытался выделать память при помощи list(range(20 * 1024 * 1024)), а перед сериализацией удалять, но это не работало. Сегодня я узнал почему. Оказывается Python до версии 2.5 никогда не освобождает память. У меня как раз Python 2.4, приехали.
P.S. Чтобы предотвратить вопросы для чего я делаю list(range(…)), расскажу сразу: для совместимости с Python 3.0, на который мы все
Добавлено позднее.
Я сейчас немного поисследовал, сделал замеры и выяснил, что если обращаться к аллокатору памяти Python напрямую (например, через ctypes), то память возвращается:
from ctypes import *

mem = pythonapi.PyMem_Malloc(c_size_t(100*1024*1024))

pythonapi.PyMem_Free(mem)
В домашнем интранете кто-то неправ!
Моя жена обживает интернет просто семимильными шагами. Не в том смысле, что она его раньше не видела, а в том смысле, что в понимании сетевой культуры, которая её раньше не интересовала, она сильно продвинулась и уже начала переносить её понимание в реальную жизнь. В доказательство, диалог, который произошёл только что:
— Марин, я уже кушать хочу! — Солнце,… я кушать хочу больше тебя, (с угрозой) ты хочешь со мной об этом поспорить?
Часть правды о бытовой химии
Цитирую целиком, ибо мне это кажется достаточно важным:
- Шампунь по составу мало чем отличается от геля для душа, поэтому они легко заменимы.
- Страна производитель — важный показатель качества. Fructis российского производства и французского — разные шампуни. Для развивающихся стран используются более дешевые ингредиенты в меньших количествах (все остальное — вода), производства EU находится под более строгим контролем (меньше риск, что в бадью с вашей любимой помадой упадет бидон с казеиновым клеем, что случается), в Европе строже стандарты качества. Другими словами, для EU делают более дорогой и густой шампунь, чем для российского рынка. Поэтому покупайте то, что сделано в Европе для европейской компании.
- Читайте этикетки. Состав продукта перечисляется по убыванию массы ингредиентов. Например, если написано: «Состав: вода, сода, соль…
какие-то непонятные слова….масло виноградных косточек точка», это значит, что на 99% ваш шампунь состоит из воды. Масло виноградных косточек туда тоже попало, но в виде трех капель на мегатонную бочку. Если описание состава вашего любимого крема для рук начинается со слов «вазелин, парафин», то выбросьте его в форточку и купите банку вазелина. Скорее всего, кроме этих двух ингредиентов и пары отдушек, закодированных в латинские названия, там ничего нет. Да, кстати, как это ни прискорбно, бомбочки для ванн LUSH на 99,9% состоят из соды, поэтому их себестоимость — порядка 30 центов (при цене 300 рублей). Там есть еще пару капель эфирных масел и отдушки, но проще сделать такие бомбочки самим.
- Уважаемые родители, стиральные порошки «Аистенок» и «Ушастый нянь» сделаны в России (читайте второй пункт). «Ушастый нянь» сделан на фабрике «Невская косметика», что,
вообще-то, уже лет 30 как не внушает доверия, «Аист» сделан на неизвестном российском производстве. По составу эти порошки ничем не отличаются от «взрослых порошков» — это все простой маркетинг. Покупайте для своих детей жидкие концентраты, сделанные в Европе.
- Любой стиральный порошок на 80% состоит из балласта, чтобы радовать покупателя большой коробкой. И, кстати, вот эти синенькие и красненькие точечки в стиральном порошке — тоже балласт, а вовсе
не какие-то мифические активные вещества. Покупайте жидкие концентраты — это экономичнее, они не так вредны для природы как порошки, которые попадают в водоемы и рушат экосистему.
- Ополаскиватели для цветного и белого белья по химическому составу идентичны. Различаются только этикетками.
- Самый большой обман в том, что стиральные машинки ломаются от накипи и поэтому надо покупать Calgon. Не верьте! Машинки от этого не ломаются, а стиральный порошок Calgon ничем не отличается от других.
- Грустная новость для российских защитников животных: если на товаре написано, что он не тестировался на животных, это не значит, что в России не пострадал ни один кролик. Дело в том, что для выхода на российский рынок любой косметический продукт должен пройти миллионы СанПинов, которые были придуманы
в 70-80х гг. в СССР, в том числе, пробы на животных. Их никто не отменял даже для Green Mama и Body Shop. Другое дело, что компания может не проводить эти тесты самостоятельно, а отдать свою тушь российскому подрядчику, который и будет закапывать эту тушь в глаза кролику, пока его сетчатка не покраснеет.
Девушка, парень которой долгое время работал на косметические компании и компании, выпускающие бытовую химию, делится откровениями. Про «Калгон», кстати, подтверждаю, я сам
Teamicide — командтоз?
Они вбивают клинья между членами коллектива, часто
из-за зависти, что ДеМарко (DeMarco) и Листер (Lister) называют непереводимым термином teamicide (team — команда, а teamicide — созвучно suicide — самоубийство): непреднамеренный развал ранее сплочённых команд
Из перевода статьи Джоеля Спольски «О вреде премирования».
Такой уж и непереводимый? Я его предлагаю перевести как «командтоз». Достаточно очевидно или надо расшифровать?
P.S. Кстати, хорошая, на мой взгляд, статья про премирование (у Спольски
P.P.S. Смирнов убивает лулзы!
О5 25: JavaScript — не Java!
Ллео, +1, зачетно обосрал JS ))) Ненавижу javascript, а еще заточку на кроссбраузерность, где код JS вырастает раза в 3
из-за разных браузеров. Говно это. Кастрат Java. Долой JS!
Пишет у Каганова в блоге
Ну и про «заточку на кроссбраузерность». Так уже давно никто не делает (если не считать
Libmapi: размер поля

Вот чем я занимался сегодня большую часть рабочего дня: вручную декодировал события, на которых свалились тесты, побайтово. В отличие от машины, я способен распознавать данные по их внешнему виду, например, вижу границы nttimestamp или вижу где начались буквы. Машина без посторонней помощи это не умеет, а потратить времени на помощь ей можно очень много.
Вывод, кажется, такой: в документации от Microsoft поле ReminderSet имеет тип boolean и размер 8 бит, вот по данным кажется, что оно
P.S. Пока тесты не падают. Значит размер поля ReminderSet в структуре ExceptionInfo действительно 32 бита (это структура внутри PidLidAppointmentRecur).
Век живи, век учись, от нехватки памяти умрёшь
Наступил недавно на отличные питонячьи грабли. Хорошие такие, массивные, со специальными шипами на рукоятке.
Есть модуль, внутри него происходит fork — внутри потомка изолируется libmapi, у которой нещадно течёт память. Модуль используется внутри программы, которая перехватывает все exceptions (!). Знаю, что это неправильно, но она это делает в режиме отладки, для отладки и используется.
Загвоздка в том, что
sys.exit пораждает иключение и выходит с его помощью. Если
Windows 7: repair screen
Ну, раз так, давайте я
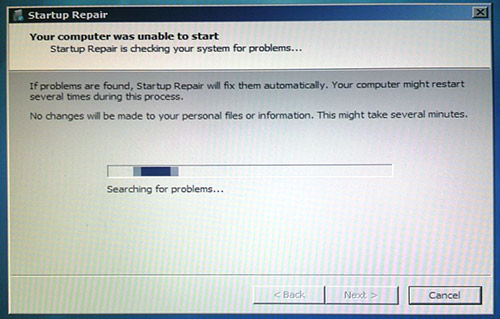
Кардинальное различие в том, что когда раньше Windows
Видимо, сейчас (по крайней мере, если физически всё исправно и загрузочный сектор винта цел) ничего такого не надо. Ура.
P.S. Чтобы не гадали
Мне интересно, что бы мне потребовалось сделать, если бы у меня сломался (единственный)