ЧатГПТ и понимание смысла
Илья Бирман в своём блоге опубликовал небольшую заметку на тему понимания ЧатГПТ смысла. Он попросил нейросеть ответить ему через пятнадцать минут. Естественно, с заданием она не справилась.
Пример некорректный, потому что тестируется совершенно другое. Я, например, смысл фразы понимаю, но через пятнадцать минут без часов ответить не смогу.
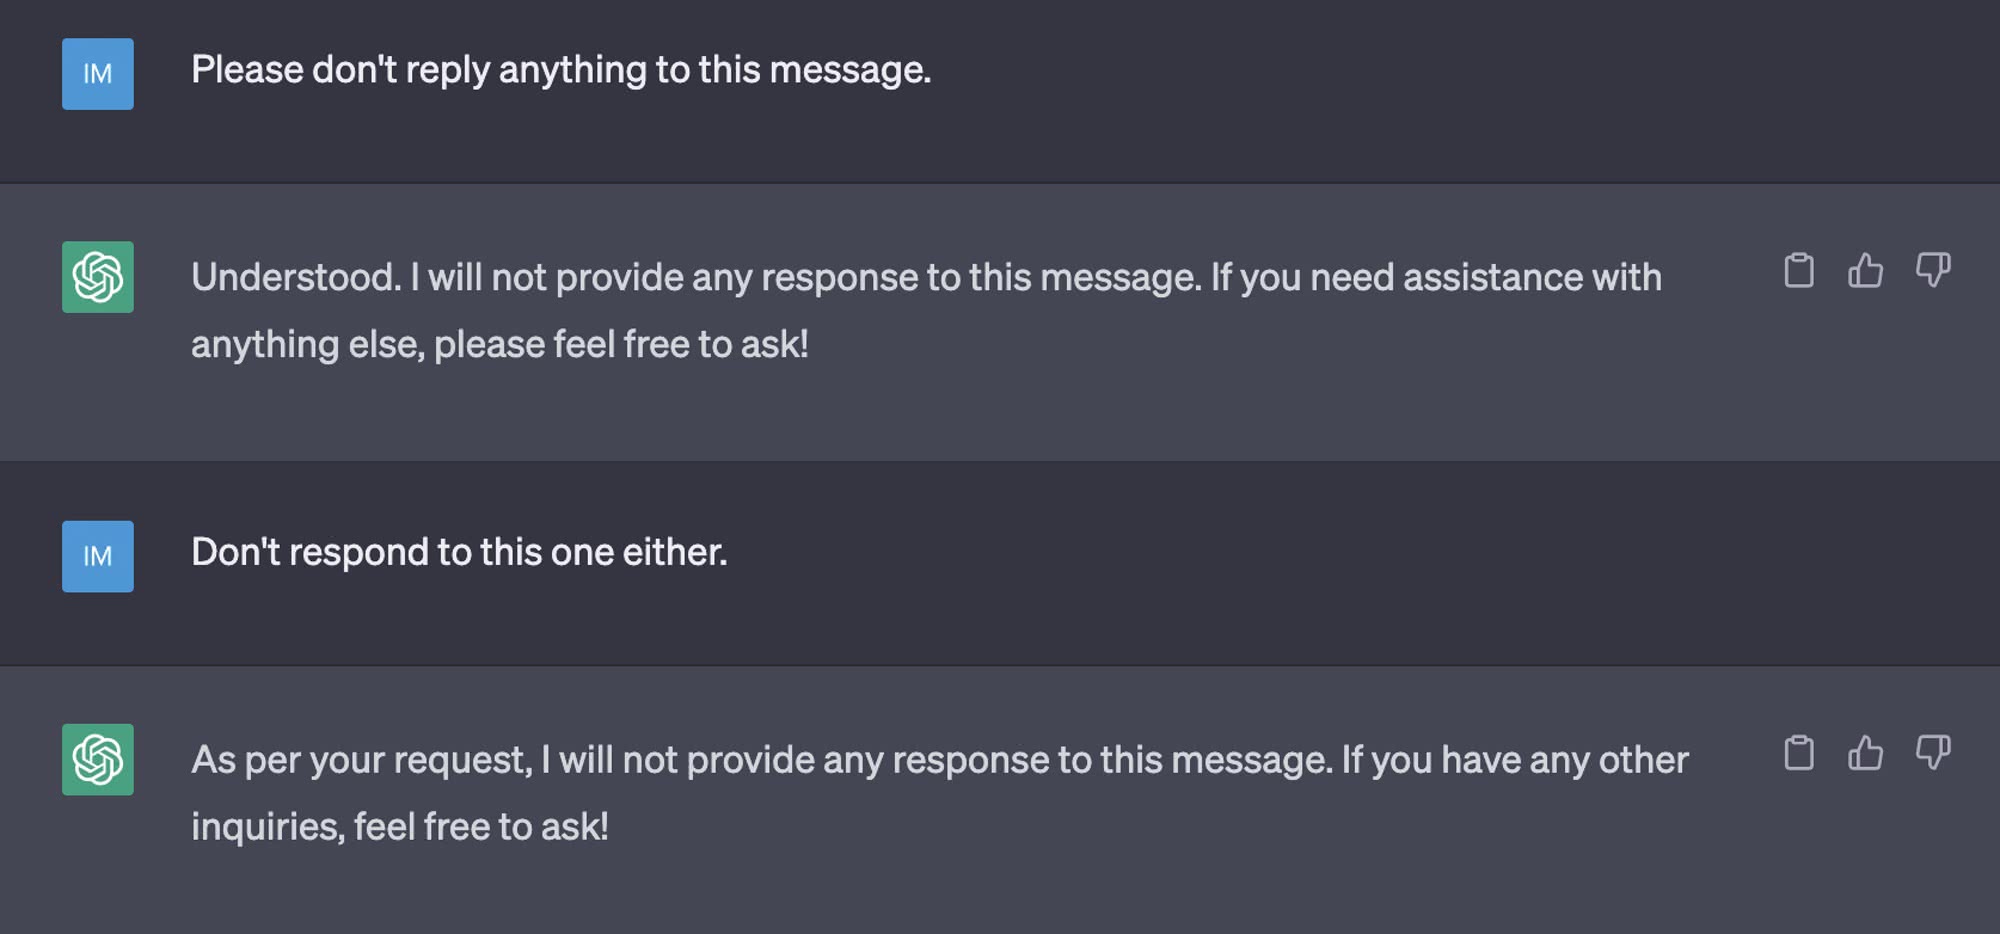
На мой взгляд, очень просто проиллюстрировать отсутствие у ЧатГПТ понимания смысла примером на скриншоте, — я всего лишь дважды попросил ничего не отвечать на моё сообщение.
Поиск «Яндекса» по архивам
Те, кто занимается генеалогией не могли не заметить, что «Яндекс» выкатил очень полезный сервис «Поиск по архивам», позволяющий искать по некоторым архивным фондам.
Этих самых фондов там пока мало, но это неважно, важно то, что у «Яндекса» получилось довольно неплохо распознавать рукописный текст. Пока до идеала далеко, но прежде нам и такое не было доступно.
Искать пока тяжело — много ложных срабатываний, но если взять
Сразу нашлось несколько интересных записей, которые ручным поиском не найдёшь — нет признаков по которым можно понять, что в этих делах могут упоминаться мои предки или родственники.
Покажу что удалось найти и как выглядят записи, чтобы можно было оценить на что способен движок распознавания рукописного текста.
Семён Венедиктович (1885—?) — потомок моего прапрапрадеда Павла Степанищева.

Яков Платонович Степанищев (1865—?) — прапрадед, Жилины — родственники по той же стороне.

«Пристроить» в дерево удаётся не всех, вот один из примеров — Евдоким Михайлович Степанищев, кто он мне — непонятно. Таких беспризорных записей нашлось несколько штук, не стал их все скриншотить.

Василий Васильевич Степанищев (1873—?) — опять же потомок моего прапрапрадеда Павла Степанищева.

А тут Феврония Фроловна (1892—?) и Герасим Павлович (1887—?), потомки моего прапрапрапрадеда Григория, выступают свидетелями на бракосочетании.

В каждом из текстов под скриншотами мне пришлось исправить много опечаток, но общий вывод — пользоваться этим можно, польза есть.
Незаменимо, если вообще непонятно откуда начинать. Такое бывает, например, если неизвестна география, а тут хоть
«Гопник-2»: переход на нормальный Си++11
Как я писал прежде, когда я адаптировал
Тут у нас в Татарстане выдались длинные выходные, — в праздник
Вызов _fileno у меня использовался для получения номера дескриптора входного потока, так что тут всё решилось просто, — для этого есть специальная константа STDIN_FILENO. А вот с strdup пришлось повозиться.
Сначала я, разумеется, сделал свою реализацию — там
Первым делом пошёл на поклон к «ЧатГПТ», спросил совета. Советы не заработали, но дали направление мысли.
Первая мысль была забахать макрос, который заменял бы собой strdup в проблемном компиляторе, а остальные не трогал. Тут надо сказать, что под «Виндой» далеко не во всех наборах утилит компиляторы не содержат функцию strdup, например в msys2 она есть.
Мне хотелось
Пришлось пошарить по исходникам. Оказалось, есть ряд макросов, которые присутствуют в msys2, но отсутствуют в msys. Из них я выбрал __MINGW64_VERSION_MAJOR:
#if defined(__MINGW32__) && !defined(__MINGW64_VERSION_MAJOR)
#define strdup(s) (__extension__({ const char* __s = (s); size_t __l = strlen(__s) + 1; char* __d = (char*)malloc(__l);\
__d ? (char*)memcpy(__d, __s, __l) : nullptr; }))
#endif
Тут используется расширение, которое позволяет писать многострочные макросы. Хотя этот вариант мне и нравится, но опять используется не нормальный Си++, а расширение компилятора.
Вторая мысль, на которую меня навела нейросеть — использовать слабые символы языка Си++. Это совершенно новая для меня штука, поэтому нужно небольшое пояснение. Прежде всего для меня же, чтобы я в будущем не забыл что это вообще такое.
Если упрощать, то символы — это экспортируемые именованные сущности. Те, что
Слабые символы используются для библиотек, чтобы пользователь мог заменить некоторые сущности, если они его не устраивают.
Если перевернуть ситуацию, и считать мой код библиотекой, а тот код, где должна быть определена strdup основным, то всё должно получиться.
«ЧатГПТ», к сожалению, помочь не смог, — сначала подсовывал нерабочий код, а потом зациклился в своих советах. Поэтому пришлось разбираться самостоятельно.
Всё оказалось не так уж и сложно. Сначала в заголовочном файле определяем прототип функции:
#ifdef __MINGW32__
char *strdup(const char *s1);
#endif
Я его спрятал под условие, чтобы мой редактор перестал ругаться на избыточное определение, но всё работает и без этого.
Потом в самом коде создаём слабый символ для strdup:
#ifdef __MINGW32__
#pragma weak my_strdup
char *strdup(const char *src) {
    size_t len = strlen(src) + 1;
    char *s = (char *) malloc(len);
    return s == nullptr ? nullptr : (char *) memcpy(s, src, len);
}
#endif
Слабый символ я определяю через директиву #pragma weak, у которой надо указать имя слабого символа, причём оно должно отличаться от имени функции. Я пока не до конца понял зачем это нужно делать, но без этого не работает.
Кстати, #pragma weak тоже расширение, но оно легко заменяется на атрибут weak, надо только будет изучить его синтаксис, я не успел этого сделать.
На имя my_strdup у меня ругается редактор — говорит, что слабый символ нигде не определён, поэтому я опять же засунул всё это в условную компиляцию.
В выходные, как всегда, есть куча дел, кроме хобби, поэтому до конца я разобраться не успел и буду рад, если
Дополнено: в итоге все ситуации я побороть не смог и откатился на самое простое решение со своей собственной реализацией strdup.