Оглядываясь на шахматы на sed (SedChess) ★
Это информационный пост, больше для себя. Для того, чтобы не забыть выводы и ощущения от сделанного.
Несколько месяцев назад я написал шахматы на утилите «сед», ненадолго заинтересовав публику. Особенно доставляли комментарии на «Реддите» — кажется, я поддержал имидж русских программистов, как людей для которых нет ничего невозможного.
Пара комментариев оттуда:
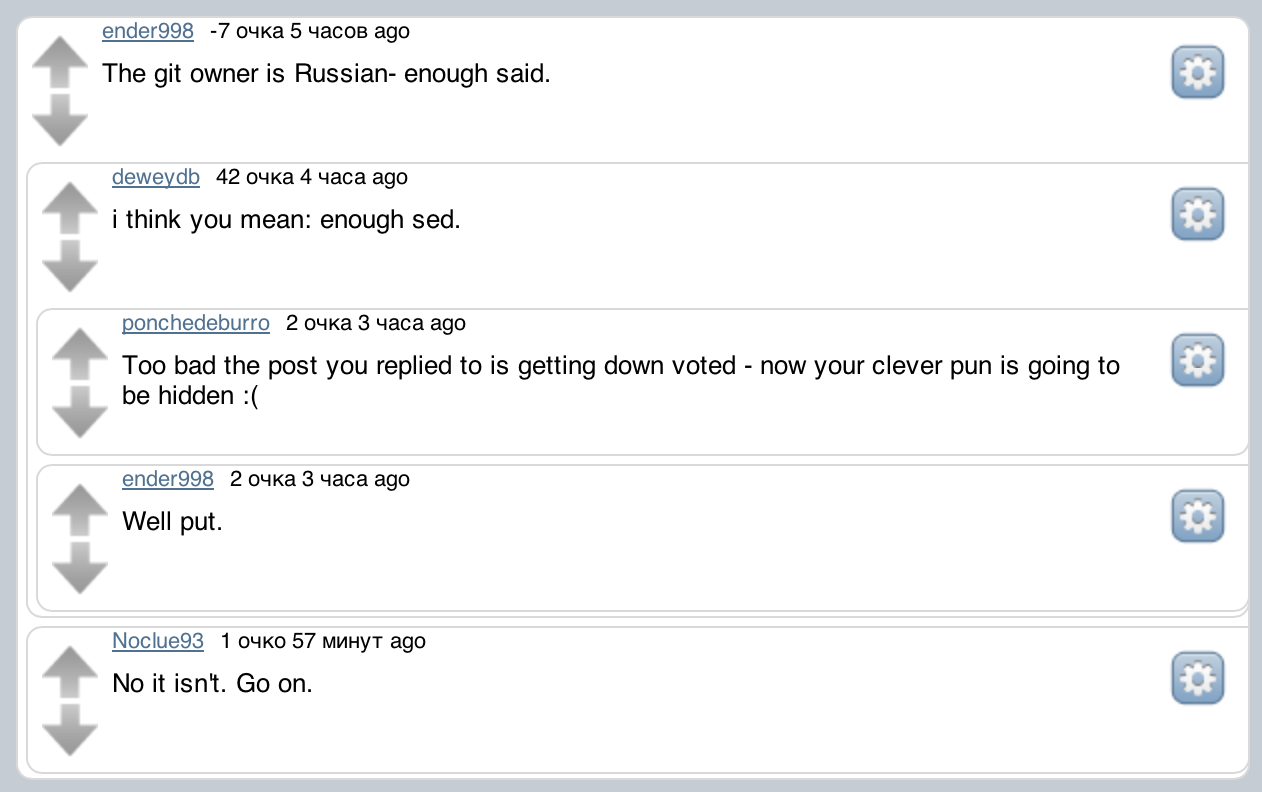
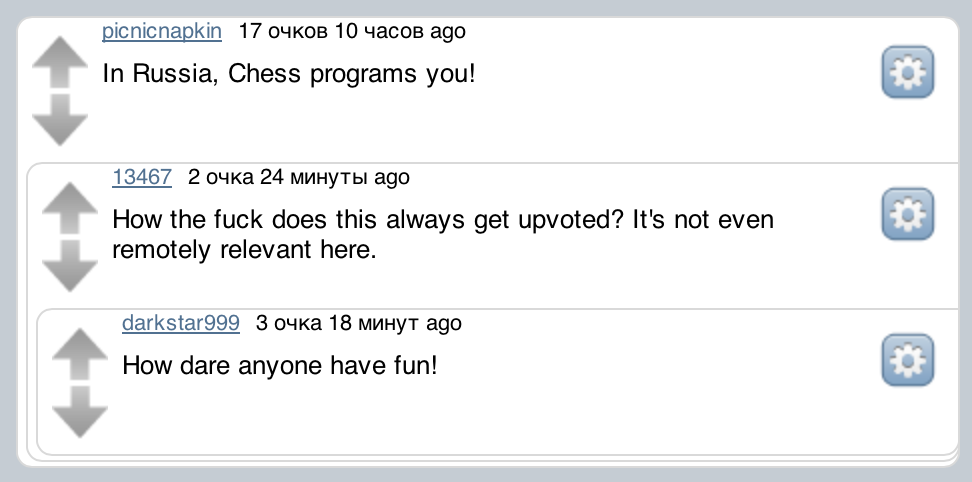
Заодно мои «шахматы» попали на «ЛОР», «ОупенНет» и многие другие ресурсы (например, в английской «Википедии» в статье про sed, появилась ссылка на меня).
Проект (если такое официальное слово вообще применимо к этой развлекухе) оказался полезен для меня лично: я глубже понял sed, потренировал мозг
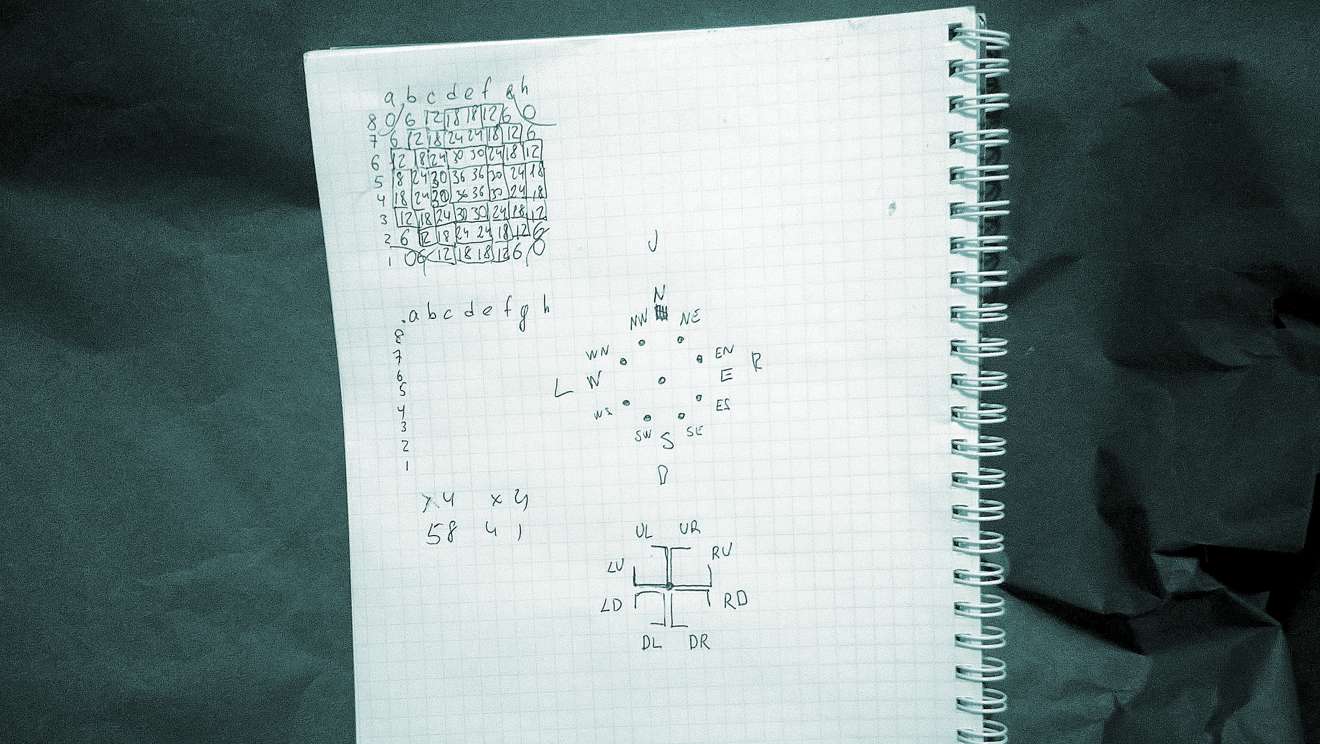
Сохранился один лист из блокнота на котором я расписываю как движется
Ещё один плюс — мне много пришлось поупражняться в борьбе с собственной ленью и желанием бросить проект, когда я встречался с трудностями, которые казались непреодолимыми или заставляли переделывать половину проекта.
Конечно, мной двигали вовсе не рациональные побуждения, а желание сделать
Тяга делать
«Словохват»
Вчера подсел на игру «Словохват», вроде игра незамысловатая, но очень интересная.

Смысл — занять одну из клеток противника, помеченного «звёздочкой», в терминах игры это называется «столица». Чтобы занять клетку, нужно придумать слово с буквой, которая написана на этой клетке, причём нужно уложиться в отведённое время — сверху тикает таймер.
Клетку можно использовать, только если она примыкает к клетке вашего цвета. Клетки чужого цвета захватываются по тому же правилу, но в первый раз они становятся серыми и только в следующий — вашего цвета.
На медиане поля действуют ещё
У автора получилась неплохая такая тактическая игра. Мне играть было скучновато — очень лень выдумывать слова, поэтому я написал небольшую программу на Пайтоне, которая работает со словарём под редакцией профессора Лопатина, ей нужно задать файл словаря и буквы, которые у вас есть, она придумает слово:

Работает неспешно, я оптимизировать не стал, времени, даваемого игрой, на поиск вполне хватает (по крайней мере на моём ноуте). Если
У меня на каждом запуске словарь преобразуется заново. Естественно, в словаре, помимо разрешённых частей речи, есть прилагательные, глаголы и так далее — их я не отфильтровываю, в словаре нет для этого информации.
# coding: utf-8
import itertools
import sys
import codecs

# дружим с консолью
sys.stdin = codecs.getreader('utf-8')(sys.stdin)
sys.stdout = codecs.getwriter('utf-8')(sys.stdout)

# строки с пропусками любых букв в любом количестве
def combinations(str):
    for l in xrange(2, len(str)+1):
        yield itertools.combinations(str, l)

# собираем каждую в строку
def iterstr(str):
    for s in itertools.chain(*combinations(str)):
        yield u''.join(s)

# все наши комбинации
def uniqcombinations(str):
    return set(iterstr(sorted(str)))

# проходим по словарю
def iterdict(name, min, max):
    with open(name, 'r') as f:
        for line in f:
            line = line.strip().decode('cp1251')

            # текущее слово должно содержать только буквы и быть не больше искомого слова
            if max >= len(line) >= min and line.isalpha():
                yield u''.join(sorted(line)), line

# ищем наше слово
def find(word, dictname):
    words = uniqcombinations(word)

    for line, original in iterdict(dictname, 3, len(word)):
        if line in words: print(original)

# запуск программы и небольшая помощь
try:
    find(sys.argv[2].decode('utf-8'), sys.argv[1].decode('utf-8'))
except IndexError:
    print(u'Запуск: {0} <словарь> <буквы в наличии>'.format(sys.argv[0]))
Писал именно на Пайтоне
Если вы думаете, что выиграть можно бездумно подставляя слова из моей программы, то сильно ошибаетесь — на сайте попадаются противники, которые вас с таким подходом разнесут в пух и прах.
Ещё про «Словохват»

Хорошая иллюстрация на тему как можно ускорить программу на порядок, убрав из неё одно слово. Первый и второй запуск отличаются только одним — в первом случае в моей программе для игры в «Словохват» присутствует преобразование типа set в tuple, а во втором этого нет.
Поиск наличия значения в set происходит многократное быстрее.
Кстати, в «Словохвате» можно использовать ещё и названия городов, а в моём словаре их нет. Но ничего не мешает использовать два и более словаря. Например, я скачал первый попавшийся словарь российских городов (он там в формате Экселя) и теперь использую и его:
cat <(unzip -p /Users/bolk/Downloads/spisokl-gorodov.xlsx xl/sharedStrings.xml |
awk -v RS=t '/^>.*<\/$/ {gsub("[<>/]", ""); print $0}' |
tr "[:upper:]" "[:lower:]" |
iconv -f utf8 -t cp1251) ~/Downloads/lop2v2/lop2v2.txt |
pypy slovohod.py /dev/stdin моибуквыНачала фамилий
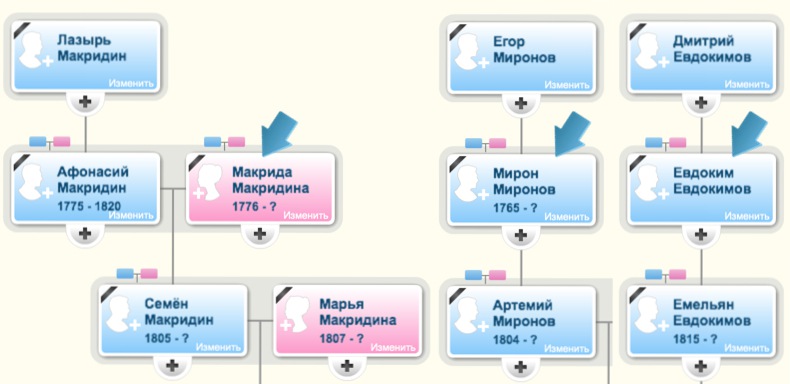
Как я уже рассказывал, если отматывать назад по времени, фамилии в моём роду пропадают примерно в 1888 году. Соответственно, все люди дальше этого года у меня в дереве должны быть без фамилий, но я, для удобства, их им всё равно присваиваю — по потомкам.
А недавно случилось интересное — похоже у трёх веток (на самом деле у четырёх, но одну ещё надо проверить — мои ли предки) нашлись люди, имя которых легло в основу фамилии потомков, причём жили они примерно в одно время — на скриншоте их карточки обозначены стрелками и выровнены по поколениям.
Видимо, когда давали фамилии, происходило
— Чьи будете? — Макридины? — А вы? — Мироновы мы… — А вы чьи? — Евдокимовы…
Т. е. по принадлежности к главе рода. Макрида, видимо, была достаточно властной женщиной, раз мои предки стали не Афанасьевы, а Макридины.
События в дереве
У меня тут несколько примечательных вещей в родовом дереве случилось.
Через восемь лет после брака у Николая и Анастасии ещё не было собственного дома, занимались земледелием, арендуя землю под коноплю, овёс, рожь. В собственности было несколько лошадей, свиней, овец и корова с телёнком.
Впрочем, речь не про них, вот он, Меркул, в те времена, конечно, совсем не Меркулов, эта фамилия появилась намного позже:

Большинство моих предков были крестьяне и фамилий у них до той поры не было, прочие же сословия имели фамилии и раньше. У меня в дереве эти прочие сословия тоже встречаются — в основном, однодворцы. Я не помню, чтобы их вообще хоть
Однодворцы — любопытный социальный класс, стоявший посередине между помещиками и крестьянами. Это, так сказать, бывшие «пограничники», получившие свой статус за службу. Долгое время, по всей видимости, жили герметично, так как считались отдельной этнической группой, а после упразднения сословия влились в число русских.
Куда ни кинь по дереву, мои предки, в основном, родом
Чуть выше я упоминал, что сословие упразднили, видимо, это стало причиной того, что долгое время Степанищевы попадались мне как крестьяне, пока я не наткнулся на ревизскую сказку (перепись населения) 1834 года в самарском архиве, где мои Степанищевы упоминаются с фамилией, да ещё и числятся однодворцами.
Знакомьтесь, Михайла Сергеевич Степанищев, родился в 1770 году, однодворец, мой прапрапрапрадед, чуть ниже на снимке перечислены его потомки:

А вот, собственно, шапка таблицы, в которой числится Михайла Сергеевич:

Разобрать непросто, написано следующее: «269 об ревизская скаска. 1834. года Апреля 21. дня Оренбургской губернии Бугульминского уезда. деревни Андреевки». Ниже: «Мужской пол. Однодворцы».
На обложке «скаски» тоже написано, что это список однодворцев, так что сомнений нет.
В курский архив я пока не обращался — ещё надо проработать то, что ближе. Например, интересные документы есть в архиве Толятти и в Башкортостане. Как бумаги попали в Тольятти я не знаю, а с Башкирией просто — до Оренбуржской эта местность числилась за Уфой, столицей Башкортостана.
Скачивалка с самарского архива
Несколько читателей сообщили, что моя скачивалка архивов ЭлАра не работает — самарский архив
Вчера мне понадобились документы оттуда, поэтому я её немного подпилил под новые реалии. Разрешение файлов пришлось убавить, но лично мне это дискомфорта не доставляет, а скачивается намного быстрее. В общем, новая версия лежит там же.
Чтобы вытащить из страницы список картинок, которые нужно качать, можно воспользоваться следующим способом: открываем консоль браузера и пишем туда следующее:
console.log("dxo.itemsValue=['"+
window['MainPlaceHolder__storageViewerControl__storageFilesViewerControl_FilesDropDownList_DDD_L'].
itemsValue.join("','")+"'];")
Вывод нужно скопировать в файл и натравить на него скачиватель. Параметры остались неизменными.
Средние Апочки
Человеку, исследующему свой род, часто интересно узнать откуда пошла его фамилия, кто были люди, передававшие её из поколения к поколению. Думаю, этому причиной разумная избирательность — через десяток поколений у вас уже более тысячи предков и чувствовать к ним всем родство невозможно, гораздо проще выбрать для эмоциональной связи одну цепочку людей, тем более, что эта цепочка определена довольно понятным способом — в паспорте (чаще всего) стоит именно их фамилия.
Так и со мной — хочется проследить за людьми, о будущем существовании тебя даже не делавшим попыток подумать, но уже тогда несущими в себе частичку меня.
Итак, поиски в архивах дали определённые плоды. Сам я родом из Лениногорска, а если отматывать время назад, мои фамильные предки кратко остановились в Старой Письмянке, потом на несколько поколений осели в Андреевке Бугульминского района, а туда попали
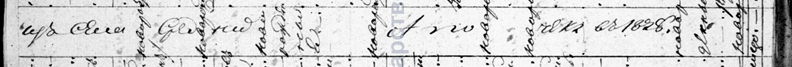
Легенды о курском происхождении моей фамилии я слышу уже больше года, только начал исследовать фамилию, почти сразу узнал, что я «курянин». Правда более точных сведений нехватало, например, была версия, что переселение произошло из деревни Арепьёвка (современное село Репьевка Тимского района).
Теперь место мне известно точно, хотя разобрать почерк на скане было очень тяжело. Помог справочник «Курская губернія. Списокъ населенныхъ мѣстъ по свѣдѣніямъ 1862 года» (издание 1868) — название уезда и волости читалось лучше, найти же на нескольких страницах что же за населённый пункт скрывается за каракулями уже не так сложно:
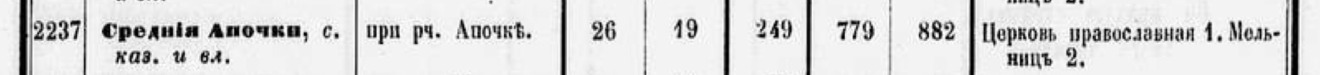
В книге «Россия. Полное географическое описание нашего отечества. Настольная и дорожная книга для русских людей» под редакцией В.П.Семенова и под общим руководством П.П.
В 20 вер.
к з.-с.-з. от ст. Горшечного расположено село Средн. Апочка, уже в Старооскольском уезде Курской губ., имеющее 2200 жит., волостное правление и лавки.
По нынешним временам 2200 жителей — довольно много, но я заметил, что в то время многие сёла имели такую численность. Кстати, церковь, упомянутая в справочнике и дающая населённому пункту статус села, существует и по сей день.
Село тоже существует, я специально выбрал кусок побольше из карт «Яндекса», чтобы было видно где оно располагается по отношению к Старому Осколу — крупному населённому пункту:
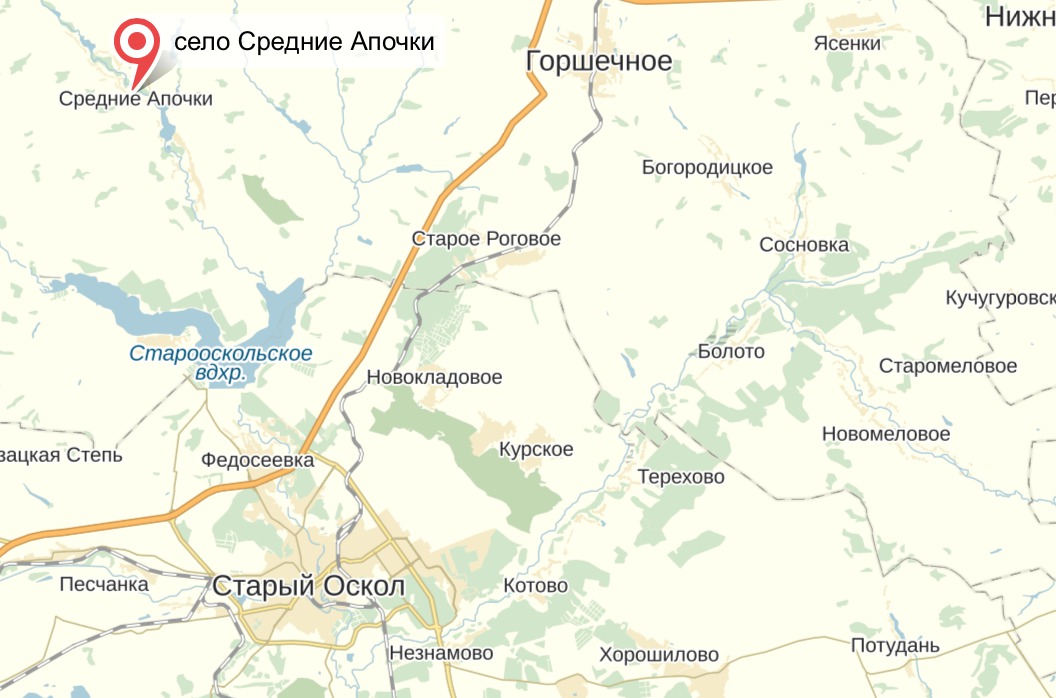
В настоящее время село всё ещё крупное — по состоянию на 2010 год в нём жило 537 человек, немало как мне кажется.
Интересно получилось с названием. Я обыскал весь интернет, но этимология нигде не всплывала, пока мне не попался на глаза город Опо́чка в Псковской области — его история отыскалась быстро.
Ниже два герба — слева самого города, а справа — Опоческого уезда, центром которого был
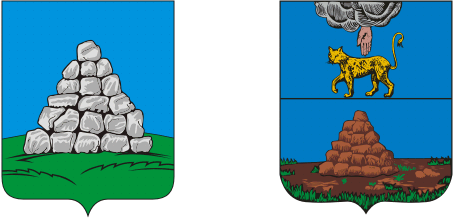
Город стоит на реке Великой, дно которой покрывают камни — порода, которую называют опока, на обоих гербах внизу кучкой сложена именно она. Из опоки была выстроена крепость, которая дала начало городу Опочка.
Вернёмся к селу. Село Средние Апочки расположено на реке Апочке, а местность относилась к Опочинской волости. Думаю, имеет место обычное искажение «Опочка» → «Апочка», тем более, что в названии волости мы видим букву «о». Так что я полагаю, история названия здесь та же.
А ещё на сайте «Наши предки» я нашёл интересную информацию:
Характерным для селений Оскольского уезда является то обстоятельство, что в них не было почти совсем ни крестьян, ни бобылей. На весь уездъ в начале XVII века был только один бобыльский двор. Население Оскольского уезда состояло целиком из детей боярских.
Только в двух деревнях Чуфичевского стана Верхней и Нижней Атаманской жили станичные атаманы, а в сельце Голубине Орлицкого уезда — беломестные казаки.
Так как некоторые мои предки с маминой стороны — именно однодворцы Осколького уезда, а не крестьяне (бобыль — это тоже крестьянин, только безземельный), получается, что я, по всей видимости, боярский потомок. Например, в дереве у меня имеются однодворцы Кандауровы из Нижнего Чуфичева, которые упоминаются в «Писцовой и межевой книги города Обояни и его посады и поместных земель в станах Залесском, Салотинском и Рудовском» от 1684 года:
Въ селѣ помѣщики дѣти боярскiя: … Ондрей Дониловъ сынъ Кондоуровъ, … Ѳедоръ Дѣевъ сынъ Кондоуровъ
Мы, бояре — народ работящий, такая уж наша боярская доля!

Совсем не понимаю людей, которые покупают себе на Новый год пластиковую ёлку из экологических соображений. Из лени — понимаю,
Я признаю на Новый год только настоящие деревья. Пока жена в спортзале, сделал ей сюрприз — приволок из «Леруа Мерлен» нордманскую пихту. Установил дома дедовским способом — в ведро, куда понапихано старых тряпок.
«Защитникам леса» хочу сказать следующее. Ребята, когда вы покупаете бифштекс, вы как себе представляете, откуда берётся мясо? Браконьер идёт в лес, выбирает там самую симпатичную корову и убивает? Нет же? Откуда такая байка про ёлки тогда — про мужичка и ближайший лес? Все, вроде, знают о существовании питомников.
Когда речь идёт о потреблении
Соответственно питомники выращивают туеву хучу ёлок, елей и пихт, чтобы к празднику срубить их и привезти в магазины. Если вы не будете покупать ёлки, вы не сохраните леса. Случатся две вещи: всё что выращено, но не распродано выкинут и в следующем году посадят не ёлки,
Цитату в заголовке, думаю, мало кто узнает. Она из лучшего мульфильма всех времён и народов «Падал прошлогодний снег».
CSS parent selector
Тема родительского селектора в ЦСС всплывает ужа давно, если не ошибаюсь, в Вебките даже
Что такое родительский селектор? О, это очень простая и мощная штука, к примеру, если клиент выбрал
.window < :checked { /* экспериментальный синтаксис родительского селектора из Вебкита */
    display: none;
}
Сразу скажу, задумка мощная, а реализация плохая. Какую проблему тут видно сразу? Непонятно что значает этот знак. Непосредственного родителя мы здесь выбираем или любого? Если непосредственного, как выбрать любого и наоборот?
Все синтаксисы родительского селектора (включая, например, :parent) грешат
Мне бы хотелось видеть абсолютную гибкость в отношении родительского селектора и мне кажется, синтаксис тут напрашивается сам собой:
.window > (:checked ~ :checked) {
    display: none;
}
Всё сразу становится логично, на мой взгляд: применить стиль к тегу с классом window, у которого два непосредственных
В очередной раз на «Баше»
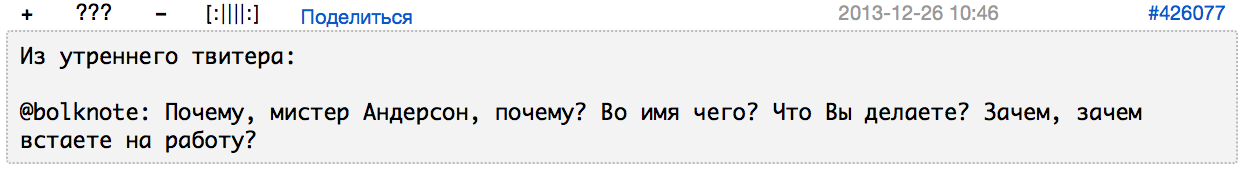
Минута славы на «Баше», на этот раз — из моего твитера.
Однодворцы Широкобоковы
Прокофий Тимофеевич — это прапрадед со стороны матери моего прапрадеда Никанора Ивановича Литвинова про которого я немножко
Два дня бился над почерком изувера, вписавшего в ревизию откуда именно переехали мои предки по этой линии. Самостоятельно разобрал бо́льшую часть слов, а с остатком помогли ребята с генеалогического форума, там есть фантастические умельцы читать чужие закорюки.
Вот вам этот шедевр каллиграфии (правая колонка):
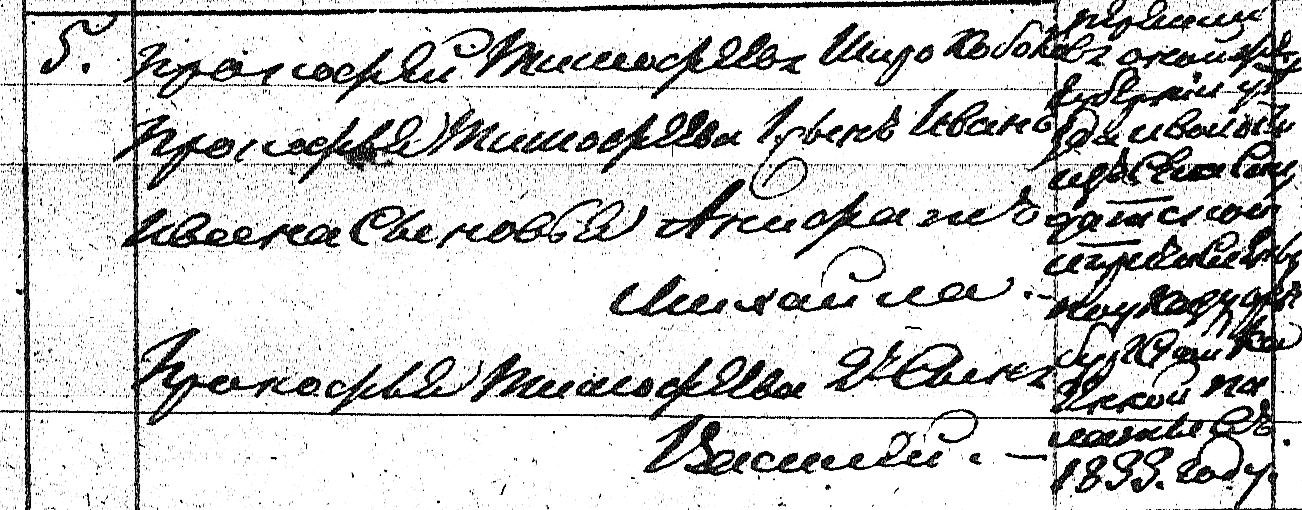
По всей видимости тут написано следующее: «переезд оной же губернии, уезда и волости из села Солдатской причислены по указу Оренбургской казённой палаты в 1833 году». Потомки, если в будущем изобретут роботов, способных проходить каптчи, суйте им архивные документы, посмотрим кто кого.
Переехали они в село Ефановку (сейчас —
Я не смог пока найти ничего со словом «Солдатской» вокруг Бугульмы, кроме слободы Письмянской Солдатской, на карте 1805 года она хорошо видна справа (и до сих пор существует в виде села):
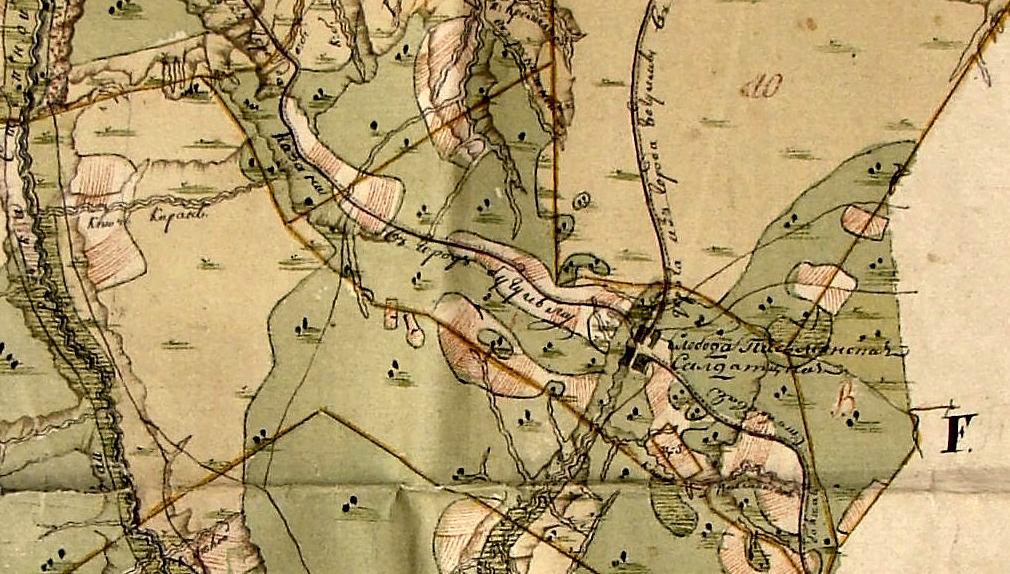
Кстати, оцените: карта нарисована вручную в 1805 году и раскрашена акварельной краской.
Слобода очень старая — существует
Хорошо бы найти список пунктов тогдашнего Бугульминского уезда, но мне пока ещё не удалось это сделать. Мне
Параллельно нужно будет попытаться найти ревизию (перепись) 1816 года по Солдатской Письмянке, по всем признакам она в Башкирском архиве и покопаться там. Причём по этой слободе материалы есть и в Нацархиве Республики Татарстан, мой сканер нашёл документы
Ленивая загрузка в ИЕ11
В IE11 интересную штуку сделали — ленивую загрузку. Можно пометить картинку (включая внедрённые тегом SVG), теги для воспроизведения видео и аудио, скрипты и многое другое специальным атрибутом lazyload, который означает «начать загружать, когда загрузится всё важное».
Иногда может быть удобно, для оптимизации скорости загрузки страницы, попросить браузер не загружать пока
<img src="avatar-3132.png" width="200" height="200" lazyload="1">Можно добавить этот атрибут к банерам (на что мало кто согласится), большим графическим оформительским элементам (чтобы пользователь быстрее начал читать статью), фоновой музыке (правда она редко бывает вообще уместна) и т. п.
Как скачать документы из архива Башкортостана
Мне Архив Башкортостана нравится куда больше самарского — документы заказывать не надо, поиск простой, быстрый, да и документы скачиваются элементарно, очень удобно!
Единственное — если без ухищрений, документы приходится скачивать по одному, а смотреть их с диска всё равно удобнее — загружаются они быстрее, чем через интернет.
Для «Мака» и «Линуксов» подойдёт такой способ: открываем в браузере нужный нам набор документов, вводим в консоль браузера следующую команду:
I = document.querySelectorAll('img[src*=imgt]'), D = [];
for (i in I) if(i*0==0) D.push('wget -O '+('0000'+i).substr(-4)+'.jpg "'+
I[i].src.replace("/imgt", '/img')+'"'); console.log(D.join(';'))
Получившиеся в результате выполнения команды, копируем в командную строку в директории куда нужно скачать документы и дожидаемся окончания.