программирование
Забавный баг в FFI (PHP 7.4.2)
В последнее время очень заинтересовался FFI в ПХП — интерфейсом к языку Си, появившимся в версии 7.4. Очень полезное, как по мне, нововведение, позволяющее расширять язык, обходясь минимальными знаниями о других языках программирования.
Очевидно, потребность
К несчастью, модуль FFI в ПХП
Небольшой код для иллюстрации проблемы:
const IRRELEVANT = "Hello ";

echo IRRELEVANT;  // Выведет «Hello»

FFI::cdef('char *memcpy(char *dst, const char *src, size_t len);')
    ->memcpy("Hello ", "world!", 6);

echo IRRELEVANT; // Выведет «world!»
В чём суть? Мы объявляем константу IRRELEVANT, убеждаемся, что она содержит присвоенное ей значение, потом вызываем через FFI копирование одной строки в другую, и константа внезапно меняет своё значение. Как это произошло? Чтобы понять, немного модифицируем программу.
function memcpy(string $dst, string $src):void
{
    FFI::cdef('char *memcpy(char *dst, const char *src, size_t len);')
         ->memcpy($dst, $src, strlen($src));
}

$rock1 = str_repeat('ROCK', 1);
$rock2 = str_repeat('ROCK', 1);

var_dump($rock1, $rock2); // Выведет «ROCK» два раза

memcpy($rock1, "SOCK");
memcpy($rock2, "LOCK");

var_dump($rock1); // выведет «SOCK»
var_dump($rock2); // выведет «LOCK»
Что у нас тут? Вызов memcpy обёрнут в функцию, которая ничего не возвращает и ничего не должна модифицировать — параметры передаются по значению, а не ссылке. Тем не менее, если вызвать объявленную функцию и передать в неё переменные, их значение будет изменено.
В ПХП для обеспечения производительности используется механизм копирования при записи — если
В силу этой особенности, переменные остаются ссылочными, попадая в таком виде в сишный код, где модифицируются — вызов memcpy меняет первую переданную в него переменную, копируя в неё значение второго параметра.
Кстати, если изменить строку инициализации переменных на вот такую:
$rock1 = $rock2 = str_repeat('ROCK', 1);то после вызовов memcpy обе переменные получат значение «LOCK» — работает тот же самый механизм.
Почему же в первом листинге изменилось значение константы? Сейчас разберёмся, осталось совсем немного.
Ещё одной распространённой техникой увеличения производительности (и снижения потребления памяти заодно) является интернирование, её используют многие интерпретаторы и компиляторы. В общем случае она заключается в том, что
Таким образом константа IRRELEVANT и строка «Hello » в первом параметре — суть одна и та же область памяти. Когда функция memcpy модифицирует эту область, меняются сразу все значения всего, что, для оптимальности, ссылается на это же место. Естественно, константа изменяется тоже.
Поскольку интернирование не работает во время выполнения, результат str_repeat('ROCK', 1); не интернируется и во втором листинге такого эффекта не создаётся.
Как же разорвать эту мистическую связь и заставить работать код так как задумывалось? Для этого нужно, чтобы интерпретатор создал новую область памяти, которую будет портить FFI, не затрагивая нашу переменную. Это можно сделать, например, при помощи уже упомянутой функции str_repeat:
function memcpy(string $dst, string $src):void
{
    // Создаём новое место, которое испортит memcpy
    $dst = str_repeat($dst, 1);
    FFI::cdef('char *memcpy(char *dst, const char *src, size_t len);')
        ->memcpy($dst, $src, strlen($src));
}

$rock = 'ROCK';
var_dump($rock); // Выведет «ROCK»

memcpy($rock, "SOCK");
var_dump($rock); // Так же выведет «ROCK»
Внимание! Это некорректный способ, корректный описан в более поздней заметке.
Естественно, подойдут и substr, и sprintf, и вообще любые функции, в общем случае возвращающие модифицированную строку. Интересно, что implode([$dst]) от бага не защищает, видимо для этого случая внутри работает
Всё описанное верно для версии актуальной на текущий момент — 7.4.2. Надеюсь, в скором времени этот довольно забавный баг устранят и необходимость в таких ухищрениях исчезнет.
PHP: FFI vs. exec
Нередко отсутствующую в ПХП функциональность наскоро заменяют вызовом утилит командной строки. И мне стало интересно взглянуть на досуге — может ли вызов через ffi (интерфейс к Си, который появился в ПХП 7.4) быть хорошей альтернативой.
Говорят, вызов через ffi работает очень медленно, такова природа этого способа (и мы это видим в других языках), это, конечно, очевидно, но медленно насколько?
Для сравнения была взята функция, создающая временный директорий по маске, которую я использовал в одной из заметок, и её аналог, использующий внешнюю утилиту:
$mkdtemp = function (string $template): string {
    $cmd = '/usr/bin/mktemp -d '.escapeshellarg($template);
    $dir = exec($cmd, $out, $ret);

    if ($ret === 0) {
        return $dir;
    } else {
        ['message' => $message, 'type' => $type] = error_get_last();
        throw new RuntimeException($message, $type);
    }
};
Весь код был обёрнут в цикл на 10000 итераций и запущен. Я провёл по десять запусков, а результат усреднил.
Создание директория через ffi заняло примерно 0,77 секунд на 10 тысяч итераций, а через утилиту командной строки — примерно 72,62 секунды на те же 10 тысяч итераций.
Конечно
InlineC
Продолжая тему интерфейсов к языку Си, кстати будет упомянуть появившийся недавно модуль inlinec для Пайтона. Он позволяет вставлять в программу на Пайтоне
# coding: inlinec
from inlinec import inlinec

@inlinec
def Q_rsqrt(number):
    float Q_rsqrt( float number )
    {
        long i;
        float x2, y;
        const float threehalfs = 1.5F;

        x2 = number * 0.5F;
        y  = number;
        i  = * ( long * ) &y;
        i  = 0x5f3759df - ( i >> 1 );
        y  = * ( float * ) &i;
        y  = y * ( threehalfs - ( x2 * y * y ) );

        return y;
    }

print(Q_rsqrt(1.234))
Я проверил, это действительно работает. Тут вычисляется так называемый быстрый обратный квадратный корень от числа 1,234.
Пока этот модуль скорее прототип — скорость оставляет желать лучшего, в рабочем каталоге создаётся куча мусорных временных файлов, любое отступление от эталонного примера грозит выводом ошибки, которая совсем не помогает понять что не так.
Куда интереснее разобраться как это всё работает. Декоратор @inlinec тут ничего не делает. Судя по коду модуля, он возвращает функцию как есть и служит маркером, что ниже пойдёт сишная функция. Всё работу выполняет кодек, который подключается первой строкой.
Приём не новый, несколько лет назад я про него уже рассказывал — в Пайтоне в специальном магическом комментарии можно указать кодек, который пропускает через себя текст программы. Обычно он используется для программирования в кодировках, отличных
Итак, код перед выполнением скармливается специальному кодеку inlinec, который разбирает программу, находит в ней
Программисты-«волшебники»
Про
Хочу высказаться также по триаде «объект — указатель — ссылка».
Изначально в Си (не «++») ссылок не было. Были только объекты и указатели. Любой начинающий сталкивался с указателями, как только ему требовалось впервые изменить в теле функции значение переданного функции параметра:
void func1(int i) { i = 1; }
void func2(int* i) { *i = 1; }
Далее:
int i = 0;
func1(i); // всё ещё i==0
func2(i); // вот теперь i==1
Этот код демонстрирует то свойство Си,
Спрашивается, так зачем ещё потребовались ссылки? Ответ таков. В мире существует, не исчезает и даже порой ширится класс
Пусть лучше в теле func2 тоже будет написано
void func1(int i) { i = 1; }
void func1(int &i){ i = 1; }
int i = 0;
func1(i); // волшебного значка нет, i не изменилось
func2(i); // волшебный значок! i изменилось.
Смотрите, операторы в теле функций одинаковые, а работает
Программисты Си долго сопротивлялись,
PHP FFI
В ПХП 7.4 предпринята очередная попытка обзавестись интерфейсом к языку Си. Кажется наконец за это расширение взялись
Для интереса посмотрел что за АПИ получилось. В принципе, всё очень просто. Вот как выглядит
/**
 * @method object mkdtemp(string $template)
 * @method object strerror(int $errnum)
 * @property-read int $errno
 */
$ffi = FFI::cdef('
    // Импортируем функцию создания временного директория
    char *mkdtemp(char *template);

    // Импортируем функцию перевода кодов ошибок в строку
    char *strerror(int errnum);

    // Импортируем переменную, хранящую коды ошибок
    int errno;
');

/**
 * Фунция для создания временных директориев по маске
 * @param string $template Шаблон создания (см. man mkdtemp)
 * @return string Путь до временного директория
 */
$mkdtemp = function (string $template) use ($ffi): string {
    $result = $ffi->mkdtemp($template);

    if ($result === null) {
        $errno = $ffi->errno;
        $errstr = $ffi->strerror($errno);
        throw new RuntimeException(FFI::string($errstr), $errno);
    }

    return FFI::string($result);
};
Как можно понять из кода, создаётся объект, в который импортируются сущности, перечисленные в сишной нотации в первом параметре. В общем случае вторым параметром требуется указать библиотеку для импорта, но в данном случае работает и так.
Не знаю заработает ли этот код без изменений под Линуксом и Виндоузом, у кого есть под рукой, посмотрите, пожалуйста.
В этом примере параметры в импортированные функции передаются как обычные типы ПХП, а некоторые возвращаемые значения требуют конвертации. Так char * возвращается как специальный объект, который нужно преобразовывать в строку вызовом метода FFI::string.
Вот тривиальный текстовый пример использования созданной выше функции:
$template = implode(DIRECTORY_SEPARATOR, [sys_get_temp_dir(), 'ffiphp.XXXXXX']);

try {
    $tmp = $mkdtemp($template);
    rmdir($tmp);
    echo $tmp, "\n";
} catch (RuntimeException $e) {
    echo $e->getMessage(), "\n";
}
Суть происходящего проста: если директорий удалось создать, то он будет уничтожен, а его имя — выведено на экран, иначе появится текстовое сообщение об ошибке.
PHP8 и strpos
Мне очень нравится куда двигается язык ПХП в последние годы. Много вещей удалось исправить, и движение в правильную сторону не останавливается. На список изменений восьмой версии приятно смотреть, кроме пресловутой компиляции «на лету», есть очень много других приятных изменений, в том числе, в ключе поднятой темы, буду убраны некоторые архаичные и вредные штуки.
В процессе изучения списка изменений, иногда находятся грабли, на которые я, к счастью, никогда не вставал. Хорошо, что они со временем из языка исчезают. Например:
The needle argument of strpos(), strrpos(), stripos(), strripos(), strstr(), strchr(), strrchr(), and stristr() will now always be interpreted as a string. Previously
non-string needles were interpreted as an ASCII code point. An explicit call to chr() can be used to restore the previous behavior.
Я даже не подозревал, что в качестве параметра в функции поиска подстроки сейчас можно (в восьмой версии будет нельзя) передать код символа. Так как в ПХП мало кто следит за типом переменной, можно получить несколько обескураживающие результаты:
// объявили строковую переменную и где-то по коду она превратилась в число,
// 49 — это код символа «1»
$needle = (int) "49";

// выдаёт «Есть»
echo @strpos("12349", $needle) === false ? "Нету\n" : "Есть\n";

// Несколько неожиданно выдаёт «Нету», ищется символ с кодом «49» (единица)
echo @strpos("02349", $needle) === false ? "Нету\n" : "Есть\n";
В ПХП8 число будет преобразовано в строку и искаться будет именно строка, то есть оба этих примера выдадут «Есть».
Выполнение запроса с таймаутом
В продукте, который мы делаем в нашей компании, не используется PDO для соединения с базой данных — так исторически сложилось и вряд ли имеет смысл менять. Причина тому — оптимизации; мы широко используем эскуэль и задействуем диалектные особенности используемой СУБД (в нашем случае это «Постгрес»). То есть универсальность PDO нам ничего бы не дала.
Недавно возникла задача выполнения запроса с таймаутом — если выполнение запроса занимает больше времени, чем по нашему мнению пользователь готов ждать, то лучше прервать запрос и показать заглушку. В PDO кажется такая возможность есть (параметр можно задать, но мы не тестировали), а в постгресовском модуле для ПХП готового способа не оказалось.
Мы долгое время перебирали идеи (вплоть до внешнего процесса с таймером), но ничего не выглядело достаточно хорошо, чтобы помещать это в код. В конечном счёте мой братишка предложил очень простое решение. Ответ лежал в работе с асинхронным АПИ. Обычно это выглядит
$con = pg_pconnect("…");
if ($con === false) {
    throw new \RuntimeException('Could not connect');
}
// асинхронно выполняем запрос, в синхронном варианте тут было бы pg_query
if (pg_send_query($conn, "select * from users")) {
    // тут можно делать что угодно, пока мы не будем готовы принять результат
    // …
    // синхронно получаем результат
    var_dump(pg_get_result($conn));
}
Поскольку pg_send_query неблокирующий, то можно было бы попытаться
function waitForResult($connection, callable $callback, int $timeout): void
{
    $stream = pg_socket($connection);
    while (pg_connection_busy($connection)) {
        $read = [$stream];
        $write = $except = null;

        $numChangedStreams = stream_select($read, $write, $except, 0, $timeout);
        if ($numChangedStreams > 0 || $numChangedStreams === false) {
            break;
        }

        $callback();
    }
}
После отсылки запроса мы получаем сетевой сокет соединения с базой данных и ожидаем в нём появления данных для чтения. Если за таймаут этого не происходит (или возникает ошибка), то цикл ожидания прерывается, иначе вызывается функция обратного вызова для получения порции данных.
Y2K79
«Проблема
Проблемой (непонятно насколько реальной) тогда озаботились абсолютно все, государства выделяли деньги для её исправления, возможно благодаря этим усилиям ничего страшного не случилось. Я с той проблемой столкнулся минимально, уже постфактум, да и то, только потому что программировал на Перле.
Не знаю как сейчас, а тогда на Перле для получения даты часто использовали функцию localtime, шестой по порядку элемент которого совпадал с двумя последними цифрами года. Обычным способом вывода даты в то время был такой код:
my ($sec, $min, $hour, $mday, $mon, $year) = localtime;
printf "%d-%d-%d\n", $mday, $mon, '19'.$year;Атомными станциями такие программы, разумеется, не управляли, но править их всё равно пришлось, мы просто заменяли конкатенацию сложением с числом «1900».
Недавно я об этом вспомнил. Мы разбирались с ФИАСом — российской базой данных адресов, там у каждого адреса есть период его существования: начальная дата — когда адрес появился (например, дом построили) и конечная — когда исчез (дом снесли).
И оказалось, что «06.06.2079» в этой базе имеет магическое значение — если конечная дата содержит это значение, считается, что адрес существует. Сейчас все программы, обрабатывающие адреса из ФИАСа используют это значение как признак.
В общем, через 59 лет российских программистов, если таковые будут ещё существовать, ждёт работа по замене этой константы на другое значение, конечно если хоть одна из программ, которые мы сейчас пишем, проживёт столько. Впрочем, если
SplFileObject
ПХП, как известно, вырос из процедурного языка — во многих местах до сих пор видны «уши» процедурного подхода. Одно из таких мест — работа с файлами. Большинство ребят используют тут исключительно процедурный подход.
$fp = @fopen("test.log", "ab");
if ($fp !== false) {
    // в реальном коде надо бы проверить результат этих функций,
    // тут упрощённый код для иллюстрации принципа
    flock($fp, LOCK_EX);
    fwrite($fp, "Log line\n");
    fclose($fp);
} else {
    throw new \RuntimeException(error_get_last()['message']);
}
К счастью с 2005 года в языке существует класс SplFileObject, который умеет делать тоже самое,
Единственный его недостаток — у него нет операции закрытия файла. Видимо предлагается полагаться на сборку мусора, что не очень хорошо, ведь у блокирующего процесса сборка может затянуться в силу
$fp = new \SplObjectFile("test.log", "ab");
$fp->flock(LOCK_EX);
$fp->fwrite("Log line\n");
$fp->flock(LOCK_UN);
Интересно, что когда я пытался продемонстрировать проблему с блокировками, то довольно быстро накидал код, в котором она происходила:
$x = [
    new \SplFileObject('test.log', 'ab'),
    &$x
];

$x[0]->flock(LOCK_EX);
unset($x);

echo "Written\n";
sleep(10);
Если попробовать этот код запустить в двух разных консолях, то второй процесс будет ждать первый. По крайней мере по «МакОС» и ПХП 7.4.
Но, если заменить unset на $x = null, произойдёт удивительное — второй процесс получит возможность записать в файл сразу же, то есть сборщик мусора убирает его моментально. Я не знал о таком различии между этими двумя способами уничтожения объекта. Любопытно — с чем это связано и изменится ли в будущем?
Добавлено позднее: я догадался почему такой эффект, попробуйте догадаться тоже.
Как я чужие тексты своровал
Ночью не спалось и, чтобы
Тексты были
Тут нужна небольшая историческая справка. Мой блог — довольно разношёрстное собрание текстов, собранных сейчас в единую ленту, это бумажные дневники, ранний сайт, блог на движке «Регистр», блог на самописном движке, и наконец «Эгея», на которую я перешёл года полтора назад.

Чтобы понять откуда у меня чужие тексты, заглянул в резервную копию блога того времени, благо она у меня кочует с ноутбука на ноутбук в составе остального барахла. А ларчик просто открывался…
«Регистр» в своё время был ещё и РСС-читалкой других блогов на том же движке — у него была публичная страница, на которую они подключались. Тексты из других блогов валились в общую текстовую базу, отличаясь от общей массы лишь одним — наличием значения в поле «source». Я этой страницей почти не пользовался, но 34 чужие заметки успели туда попасть.
Годы спустя, когда я писал конвертор для преобразования блога в новый формат, это уже всё забылось, а поскольку, просматривая основную массу сохранённых заметок, этот тег я не увидел, то сконвертировал всё, что было в базе, вместе с чужими текстами.
Сегодня ночью эту несправедливость удалось исправить — написал
Переход на PHP 7.4
Потихоньку тестируем на работе свой продукт под интерпретатором версии 7.4. Пока релиз не производит впечатления стабильного — в свежих версиях правятся очень неприятные баги. Мы при тестировании нашли два сюрприза, которые не описаны в списке изменений.
$arr = new \ArrayObject(['key' => 'value']);
// теперь выдаёт NULL, а не «key»
var_dump(key($arr));
Маловероятно, что
Добавлено позднее: однако я неправ — про прекращение поддержки объектом класса ArrayObject функций работы с массивами вскользь всё же упомянуто.
99 бутылок: ElanTele ★
70. ElanTele («змеиный язык», видимо намёк на Пайтон) — язык программирования, интерпретатор которого позволяет писать как на английском, так и на татарском. Насколько я понял, это
Обычные конструкции на месте — ветвление, два цикла, определение функции, простенький
// beer.et by Evgeny Stepanischev
вар бөтеннәрюлы := функция(ә) бу
вар саннар := ["0","1","2","3","4","5","6","7","8","9"]
вар олыара := ә/10
вар нәтиҗә := саннар[ә - олыара*10 + 1]
әгәр ә > 9 буочракта
нәтиҗә := саннар[олыара + 1] + нәтиҗә
бетте
кайтар нәтиҗә
бетте
вар форматлау := функция(шешәләр) бу
вар нәтиҗә
әгәр шешәләр = 0 буочракта
нәтиҗә := "no bottles"
башкаочракта
әгәр шешәләр = 1 буочракта
нәтиҗә := "1 bottle"
башкаочракта
нәтиҗә := бөтеннәрюлы(шешәләр) + " bottles"
бетте
бетте
кайтар нәтиҗә + " of beer"
бетте
вар ә,  дәвамында ә эчендә 1..99 элмәк
:= форматлау(100-ә)
яз + " of beer on the wall, " + + " of beer."
яз "Take one down and pass it around, " + форматлау(99-ә) + " on the wall.\n"
бетте
яз "No more bottles of beer on the wall, no more bottles of beer."
яз "Go to the store and buy some more, 99 bottles of beer on the wall."
Естественно сначала я написал программу на английском, потом перевёл конструкции на татарский, руководствуясь примером в репозитории проекта и файлом расцветки для редактора, после чего обратился к своему хорошему другу А. Х., который помог перевести на татарский имена переменных и функций.

Было очень интересно попробовать программировать, не зная язык, который лежит в основе — из всех татарских слов в программе мне понятны «бу» («это»), «функция», «бетте» («всё»), ну может ещё «форматлау»
PythonFuck: разбор
Как я писал в конце прошлого года, есть такое развлечение — не используя
Получилась такая программа, работающая только из консоли интерпретатора и только под вторым «Пайтоном»:
_=(''<())+(''<());__=_**_**_
___='%'+('%'+`'±'`[_])%(__-_-_)

___*(_*_*_-_)%((
(__+_)*_*_,
`{_}`[_/_],
)+(`(''<'')`[_],)*_+\
(
__*_*_*_-__-_/_,
__*_+_/_,
))
Пришло время разобрать как она работает. Я собирался сделать написать разбор через неделю после её написания, но заботы конца года не позволили.
С самого начала было очевидно, что в указанных ограничениях Пайтон не позволит вызвать
module, method = "__builtin__", "print"
vars(vars()[module])[method]("Hello")
Есть варианты, но без использования букв — никак.
Так как в силу вышеизложенного функцию печати не вызовешь, пришлось довольствоваться выражением в консоли интерпретатора — там результат выводится на экран автоматически. В остальном, как будет видно ниже, удалось обойтись теми конструкциями, которые есть в языке.
Посмотрим в код. Первая строка:
_=(''<())+(''<());__=_**_**_Тут два разных выражения, разделённых точкой с запятой. В первом в скобках я дважды сравниваю строку и кортеж, получая два True. Второй Пайтон позволяет сравнивать разные встроенные типы, возвращая результат сравнения их названий, записанных как строки. Так как строка str меньше tuple, то результат — истина.
Два True в арифметической сумме дают двойку, неявно преобразовываясь к числу в этой операции. В принципе тут можно использовать унарный минус и тильду, но тогда мне это в голову не пришло:
_=-~(''<()) # число «2» можно получить и так тожеРезультат мы кладём в переменную с именем «подчёркивание». В той же строке мы получаем «16» возводя два в степень два в степени два, результат помещается в переменную «два подчёркивания».
Вторая строка:
___='%'+('%'+`'±'`[_])%(__-_-_)Тут используется символ «±», он
Этот символ вставлен внутрь конструкции «обратный апостроф», которая является во втором Пайтоне эквивалентом repr — функции, возвращающей строковое представление объекта, в данном случае это будет «'\\xc2\\xb1'». Нам отсюда нужен второй символ (нумерация с нуля) — «x». Цифра два для индекса у нас уже есть — в переменной _.
Дальше используется оператор «процент» — форматированный вывод. Полученное «x» используется как шаблон для «процента», чтобы преобразовать число в шестнадцатеричный вид. Из выражения __-_-_ (16−2−2) получаем «12» или, после преобразования, «c».
Вообще можно было обойтись без этого шага, получив эту же букву из строкового представления «±» («'\\xc2\\xb1'»), но в процессе продумывания я себе выписал ряд трюков и мне хотелось использовать их все.
В итоге, в переменную «три подчёркивания» попадает строка «%с», её мы будем использовать для оператора форматированного вывода («%»), чтобы получать символ по его коду.
Дальше символы получаются следующим образом:
(__+_)*_*_ # (16+2)*2*2 = 72, код символа «H», через шаблон «%c» получим отсюда букву
`{_}`[_/_] # первая часть даёт строку «set([2])», отсюда берём символ «e»
`(''<'')`[_]*_ # получаем строку «False», оттуда символ «l», удваиваем его умножением на два
__*_*_*_-__-_/_ # 16*2*2*2-16-2/2 = 111, код символа «о»
__*_+_/_ # 16*2+2/2 = 33, код символа «!»
Не требующее преобразования оставляем как есть, а из кодов символы получаем шаблоном «%с». В результате складывается строка «Hello!».
Второй, а не третий Пайтон нужен, в основном,
Дескрипторы файлов и PHP
На днях подошёл на работе один из программистов и спросил не знаю ли я способа как передать из ПХП во входной поток утилиты не один файл, а два. Когда мы разобрались, что он имеет ввиду, оказалось, что задача следующая: имеется утилита командной строки, которая делает PDF из двух файлов — тела и заголовочной части. Нужно работать с ней из ПХП, но создавать промежуточные файлы не хочется.
Один файл передаётся во входной поток, с этим многие знакомы и проблемы нет, но как передать два файла? В командной строке такой способ есть — создаём ещё один файловый дескриптор, связываем его с файлом или вводом/выводом
#!/bin/bash
# связываем третий дескриптор с чтением из указанного файла
exec 3< /etc/passwd
# связываем четвёртый со входом команды, которая будет писать в другой файл
exec 4> >(cat > /tmp/passwd)
# читаем из третьего дескриптора, пишем в четвёртый
cat <&3 >&4
А можно ли так в ПХП? Документация к proc_open говорит, что да:
The file descriptor numbers are not limited to 0, 1 and 2 — you may specify any valid file descriptor number and it will be passed to the child process. This allows your script to interoperate with other scripts that run
as «co-processes».
Ну что же, давайте попробуем:
<?php
// заполняем первые три файловых дескриптора как обычно и,
// кое-что новое, — создаём ещё один
$ds = [
    'stdin'  => ['file', '/dev/null', 'r',],
    'stdout' => ['pipe', 'w',],
    'stderr' => ['file', '/dev/null', 'w',],
    'stdnew' => ['pipe', 'r',],
];

// передаём наши дескрипторы команде 𝑐𝑎𝑡, специальный файл
// /𝑑𝑒𝑣/𝑓𝑑/3 связан с третьим (с нуля) дескриптором
$process = proc_open("cat /dev/fd/3", array_values($ds), $pipes);

// связываем дескрипторы с переменными, указанными в массиве $𝑑𝑠
// (пожалуйста не используйте 𝑒𝑥𝑡𝑟𝑎𝑐𝑡 без 𝑝ℎ𝑝𝑑𝑜𝑐 в своём коде)
extract(array_combine(array_intersect_key(array_keys($ds), $pipes), $pipes));

// пишем в наш новый дескриптор
fwrite($stdnew, "Hello world!\n");
fclose($stdnew);

// читаем из вывода переданное
fpassthru($stdout);
fclose($stdout);

proc_close($process);
Всё работает! Фраза, переданная на такой не совсем стандартный вход, благополучно выводится на экран.
Должен сразу сказать — не все утилиты командной строки умеют работать таким образом, некоторые требуют указания настоящего файла, не знаю из каких соображений. Но с большинством это сделать получится.
PythonFuck ★
Давайте вспомним, что у меня блог ещё и про программирование.

Есть такое развлечение — не используя
Для некоторых языков такого ещё никто не делал, приходится изобретать собственные приёмы, в конечном счете это интереснее всего. Я уже делал PHPFuck, BashFuck (и даже не один раз) и совмещал JavaScriptFuck с языком программирования Brainfuck.
Как правило ещё стараются использовать как можно меньше различных символов, но я этим не заморачиваюсь, мне гораздо интереснее соблюсти запрет на буквы и цифры.
Долго мне казалось, что с Пайтоном ничего такого не сделать и я даже пытался, но не получилось. А вчера, пока делал для студентов
_=(''<())+(''<());__=_**_**_
___='%'+('%'+`'±'`[_])%(__-_-_)

___*(_*_*_-_)%((
(__+_)*_*_,
`{_}`[_/_],
)+(`(''<'')`[_],)*_+\
(
__*_*_*_-__-_/_,
__*_+_/_,
))
Это запускается и работает (выводит строку «Hello!»), но только из командной строки и только во второй версии Пайтона. Когда напишу небольшой разбор кода, станет понятным почему.
99 бутылок: Zephir
69. Zephir — язык программирования, созданный для написания модулей расширения PHP и являющийся его сателлитом. Текущая версия (0.12.2) содержит несколько багов, с которыми пришлось столкнуться при написании программы. К счастью, перед компиляцией «Зефир» транслируется в Си, поэтому разобраться в происходящем труда не стоило.
Язык со сборкой мусора, использует как статическую, так и динамическую типизацию. Последняя необходима, например, для сохранения результата вызова пользовательских методов, похоже транслятор пока не умеет опираться на подсказку возвращаемого типа, поэтому требует в таких местах динамическую типизацию.
По синтаксису «Зефир» явный наследник ПХП, но выглядит почище — без «долларов» в именах переменных (которые многих раздражают) и скобок в управляющих конструкциях
К сожалению, реализация языка пока сыровата — на первые баги я наткнулся в первые десять минут программирования, а сообщения об ошибке синтаксиса предельно лаконичны — показывается только строка, в чём ошибка заключается приходится разбираться самостоятельно.
«Песня о пиве» на «Зефире» выглядит следующим образом:
// Beer song by Evgeny Stepanischev
// song.zep
namespace Beer;

class Song
{
	private static function format(int bottles) -> string
	{
		string result = "";

		switch bottles {
			case 0:
				let result = "No bottles";
				break;
			case 1:
				let result = "1 bottle";
				break;
			default:
				let result = "%d bottles"->format(bottles);
		}

		return result . " of beer";
	}


    public static function sing() -> void
    {
    	int bottles = 99;
    	var botStr = self::format(bottles);

        while bottles > 1 {
        	echo "%s of beer on the wall, %1$s of beer.\n"->format(botStr);

        	let bottles--;
        	let botStr = self::format(bottles);

        	echo "Take one down and pass it around, %s on the wall.\n\n"->format(botStr);
        }

        echo "No more bottles of beer on the wall, no more bottles of beer.\n",
        	"Go to the store and buy some more, 99 bottles of beer on the wall.\n";
    }

}
Поскольку язык используется для написания расширений, а не самостоятельных программ, написанному выше надо помочь запуститься:
zephir build
php -d extension=beer.so -r 'Beer\Song::sing();'PHP: доступ к приватным свойствам
Кинули ссылку на один из способов получения доступа к приватным свойствам в ПХП, тут создаётся функция, которая вызывается в контексте объекта с закрытым свойством:
function inspect_closure(object $o, string $p)
{
    return (function () use ($p) {
        return $this->$p;
    })->call($o);
}
Я решил вспомнить сколько таких способов вообще существует в ПХП.
Сначала, очевидно, на ум должен прийти рефлекшн, ведь он для этого и предназначен:
function inspect_reflection(object $o, string $p)
{
	$refClass = new \ReflectionClass(get_class($o));
	$refProp = $refClass->getProperty($p);
	$refProp->setAccessible(true);

	return $refProp->getValue($o);
}
Теперь экзотика. Например, мне вспоминается доступ через преобразование в массив, я о нём уже однажды писал. При преобразовании объекта в массив его приватные и защищённые свойства видны по специальным именам в полном соответствии с документацией:
function inspect_array(object $o, string $p)
{
    return ((array) $o)[
    	sprintf("\0%s\0%s", get_class($o), $p)
    ];
}
Последний способ самый спорный. Не работает с анонимными классами и объектами, в свойствах которого лежат анонимные функции. А ещё от него легко защититься, если закрыть магический метод, отвечающий за сериализацию.
По сути — родственник предыдущего метода. При сериализации все закрытые свойства в объекте сохраняются под теми же специальными именами, что в предыдущем способе:
function inspect_serialize(object $o, string $p)
{
	$class = get_class($o);
	$serialized = serialize($o);

	if (preg_match("/s:\d+:\"\\0{$class}\\0{$p}\";([^;]+;)/s", $serialized, $m)) {
		return unserialize($m[1]);
	}

	throw new \UnexpectedValueException('Something went wrong.');
}
Конечно такую регулярку очень легко обмануть, более корректно было бы написать парсер, но для иллюстрации принципа, думаю, вполне годится.
HA
Сначала немного не по теме.
Все файлы на виртуалку я переношу через образ дискеты
dd if=/dev/zero of=floppy.img bs=1024 count=1440
diskutil eraseVolume MS-DOS VOLUME `hdiutil attach -nomount floppy.img`
hdiutil attach floppy.img
Последняя команда смонтирует получившийся образ, после чего можно записать туда любые файлы.
Как справедливо напомнили читатели в комментариях к моему эксперименту c ARJ,
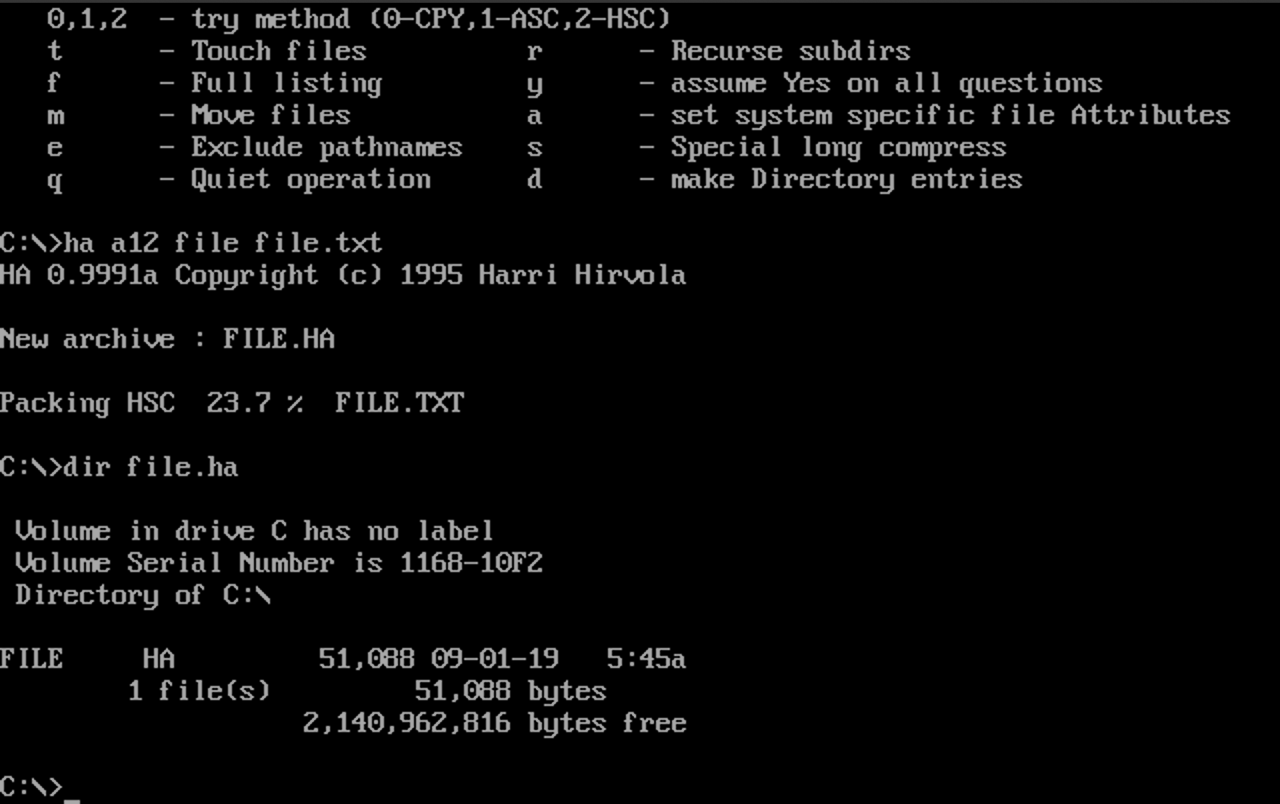
Для тестирования я выбрал форк архиватора, с которым сталкивался во времена интереса к языку программирования
ARJ
Пока экспериментировал с арифметическим кодированием,
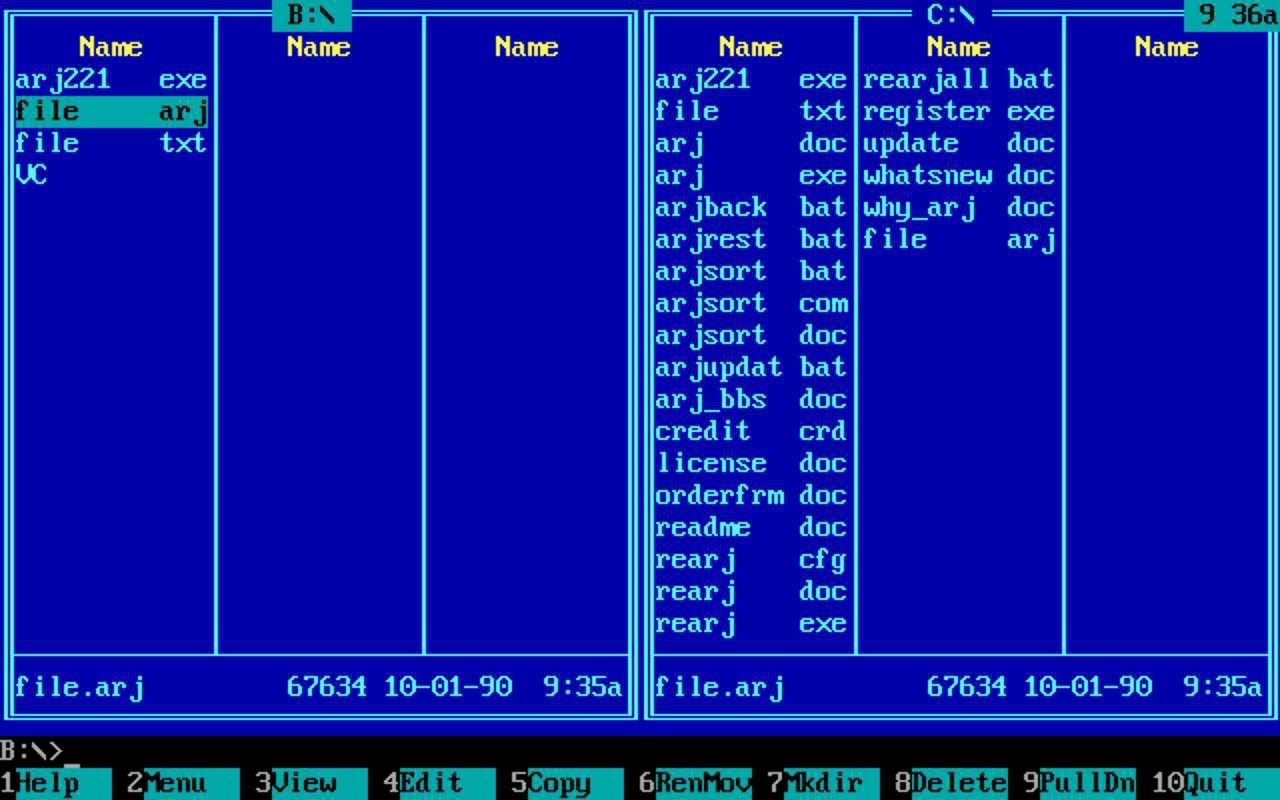
Захотелось его сравнить
Скачал виртуальную машину с
В итоге файл размером 214962 байт ужался до 67634, это 31,5% исходного объёма. Современный архиватор xz 5.4.2 на максималках (использует алгоритмы LZMA и LZMA2) ужал тот же файл до 54648 байт, это 25,4% исходного объёма. Вроде неплохой прогресс.
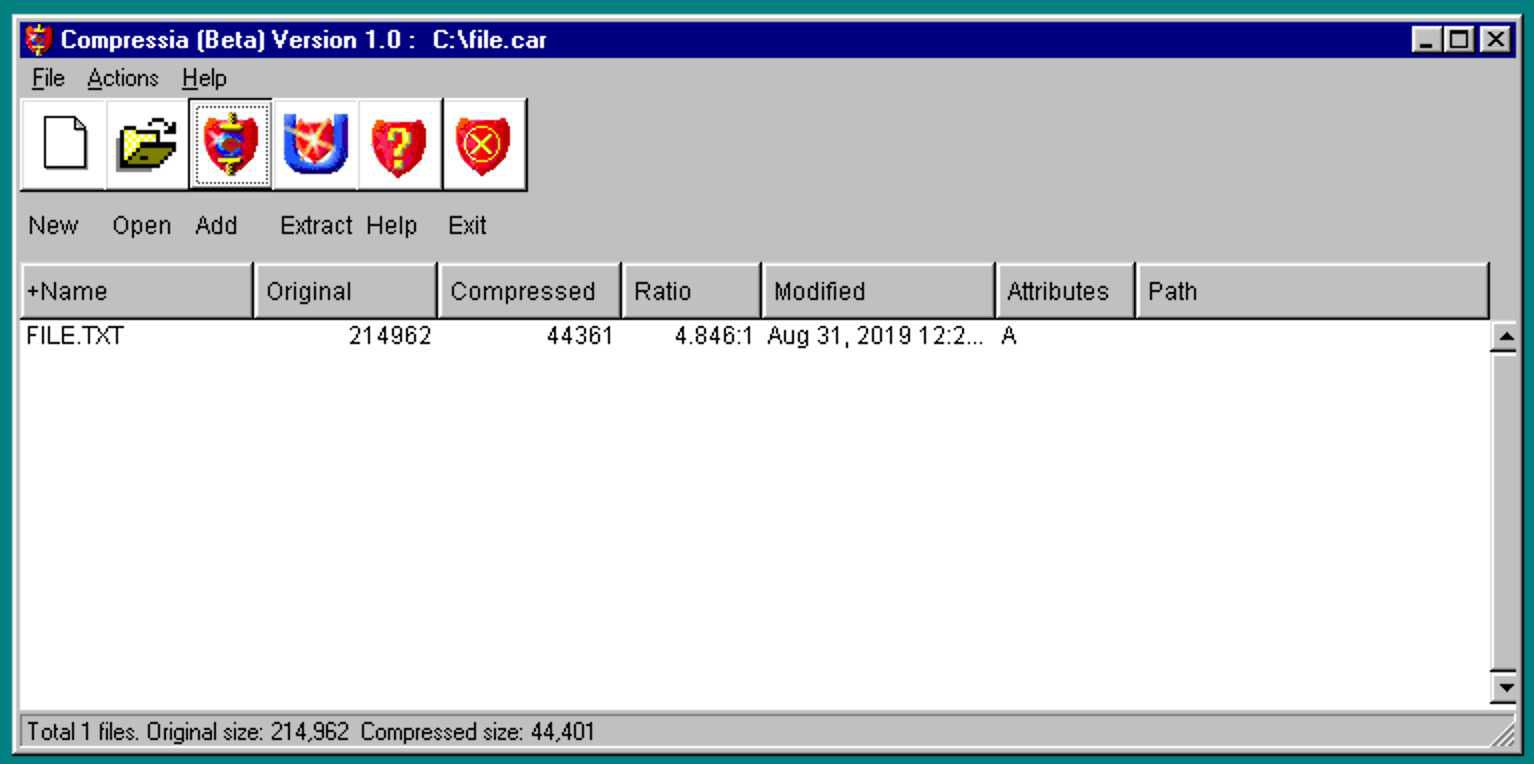
Но потом я вспомнил, что
Всё как обычно — есть популярные продукты, а есть почти неизвестные программы, которые в тёмном углу пилят
JPEG: арифметическое кодирование

С каждым годом появляется всё больше графических форматов, которые пророчат на замену привычным в вебе джейпегу, гифу и пнг. Скорость их появления так возросла, что форматы устаревают даже не будучи реализованными хотя бы в одном из распространённых браузеров.
Производители то ли осторожничают, то ли так и не сделали внутри своих продуктов некие абстракции, которые бы позволили быстро внедрять любые декодеры форматов.
WebP едва появился в большинстве браузеров, а уже предлагается добавить поддержку BPG и FLIF. На фоне этой всей движухи неясно почему почти никто не обращает внимание на арифметическое кодирование
Этот метод кодирования изначально был защищён патентами компании «АйБиЭм» и поэтому декодеры его не реализовывали, но несколько лет назад патенты истекли и теперь вполне можно было бы добавить его в браузеры, жаль, что пока никто этого не сделал.
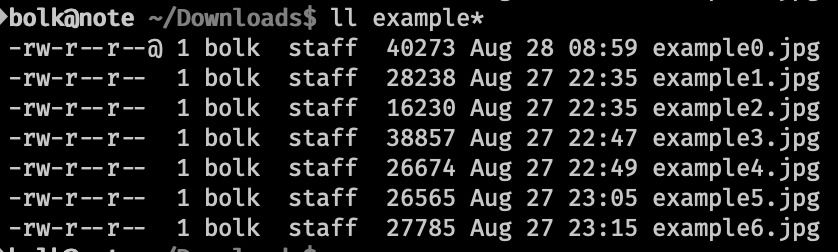
Меня привлекают в арифметическом кодировании две вещи: почти моментальная скорость преобразования без потерь из «традиционного» джейпега и бо́льшая эффективность кодирования.
Для эксперимента я взял первый попавшийся джейпег, который лежал у меня в папке «Загрузки» и попробовал сравнить результат арифметического кодирования и другие методы оптимизации в различных сочетаниях. На скриншоте выше example0 — исходный файл, example1 и example2 — результаты арифметического кодирования, остальные файлы применением других оптимизаций.
В эксперименте использовались даже те оптимизаторы, которые работают минутами, они давали превосходные результаты относительно исходного образца, но арифметическое кодирование так и не побили.