Пешая доступность от метро МК «Царицыно»?
Мне нравится микрорайон «Царицыно», куда мы с женой переедем уже в следующем году. Нравятся все инициативы застройщика — по благоустройству района, страхованию и так далее, не нравится когда меня обманывают.
Последняя новость — застрощик организует пешеходную трассу до ближайшего метро:
Партнерами было принято решение организовать дополнительный пешеходный переход, лестницу с выходом с ул. Липецкая на Каспийскую улицу, а так же разработать комплекс других мер, позволяющих оптимизировать пешеходный путь от мкр. «Царицыно» до станции метро «Царицыно».
(…) После реализации проекта, для пешеходов время в пути от мкр. «Царицыно» до станции метро «Царицыно» составит 15 минут. То есть, отныне метро будет находиться в пешеходной доступности для владельцев квартир в мкр. «Царицыно».
Есть такие «Методические рекомендации по регулированию пешеходного движения», указания 1977 года, но не думаю, что с тех пор скорость пешехода выросла. Из него следует, что средняя скорость движения пешехода по тротуару — 1,25 м/c, впрочем, там ещё есть скорость движения по наземному пешеходному переходу — 1,4 м/c. Возьмём эту цифру.
«Яндекс.Карты» сообщают нам, что от корпуса №8 в районе застройки, до ближайшей точки входа метро «Царицыно» — 1,831 километр. По прямой!.
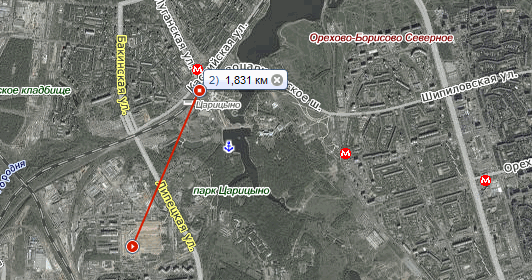
Нехитрые вычисления: 1831 / 1,4 = 1307,86 секунд или 22 минуты. Двадцать две минуты только по прямой, да ещё и довольно бодрым шагом. Я очень сомневаюсь, что застройщик сможет обеспечить пешеходов прямой, как стрела, дорогой до метро. Скорее всего, дорога до метро займёт от получаса, а это уже совсем другая цифра.
Производительность различных библиотек регулярных выражений
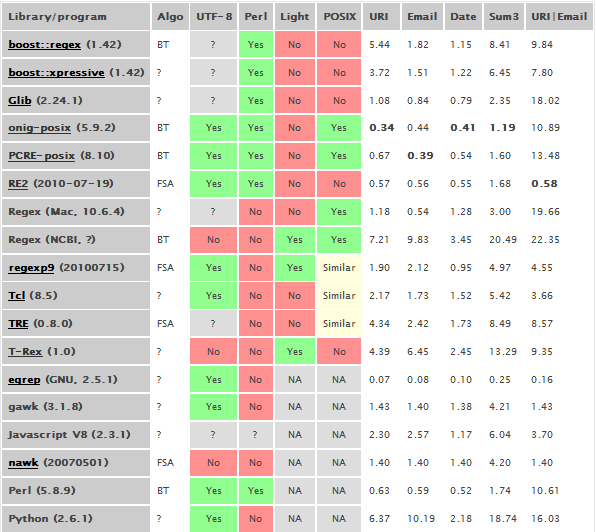
Много читал с утра о библиотеках регулярных выражений. Хочется найти такую, чтобы работала
Автор сравнивает по скорости обработки три регулярных выражения, правда довольно несложных, на приличного объёма тексте. Но даже и на этих несложных регулярках есть явные аутсайдеры — например, Python (хотя другие тесты дают другие результаты).
Жалко автор не составил такую же таблицу для режима
Например, мне из таблицы понравилась библиотека RE2, она показывает хорошие результаты, при этом в последнем тесте вырывается далеко вперёд. Правда в ней не реализована часть синтаксиса (например, нет backreferences), но это я бы пережил. А вот насколько она эффективная в режиме
Кстати, скрипты для тестирования доступны для скачивания. Можно попробовать переключить пару библиотек
Добавлено позднее: раз доступны скрипты тестирования, я решил посмотреть не находится ли уже RE2 в режиме
RE2 p(argv[1]);
buf = (char*)calloc(BUF_SIZE, 1);
while (fgets(buf, BUF_SIZE - 1, stdin)) {
        ++l;
        for (q = buf; *q; ++q); if (q > buf) *(q-1) = 0;
        if (RE2::PartialMatch(buf, p))
                printf("%d:%sn", l, buf);
}
free(buf);
Чтобы выключить режим
UTF-8: быстрые регулярные выражения в PHP
Утром я написал пост о производительности различных движков регулярных выражений, а весь день перебирал разные варианты, смотрел подробности и так далее.
Как я уже писал, мне понравилась библиотека RE2, я даже скомпилировал её и посмотрел, к сожалению, оказалось, что она использует треды, а в PHP с этим не очень (не все модули PHP thread safe, поэтому чаще всего PHP собирается без поддержки тредов).
Я уже начал смотреть другие библиотеки, когда Алексей Захлестин напомнил мне про модуль PHP Multibyte String (функции mb_*), который содержит в себе движок регулярных выражений Oniguruma.
Я всегда плохо относился к этому движку, так как считал, что у него очень бедные возможности для работы
Сегодня я присмотрелся к движку получше. Конечно, PCRE он не заменит, но некоторых случаях вполне сможет его подменить как быстрый аналог, только надо применять несколько правил (речь идёт о версии 4.7.1, которая в PHP):
Я погонял тесты, сравнивал PCRE в режиме полном
bolk-dev ~/regexp-benchmark $ php test.php
PCRE Full UTF-8: 1.0458080768585
Oniguruma:         0.24942803382874