gpu
DeepSeek V4.1 Flash: ещё быстрее
Я уже писал о запуске модели «DeepSeek V4.1 Flash» на четырёх видеокартах H200. Этой конфигурации хватает впритык и мне пришлось немало повозиться, чтобы достичь приемлемой производительности.
Недавно выяснилось, что и это не предел.
Оказалось, что эти профили используются для работы с матрицами и получаются перебором различных конфигураций на конкретном оборудовании. Потенциально правильно подобранный профиль способен ускорить инференс модели. А поскольку наш текущий «DeepSeek» использует в работе три типа данных, включая FP8, я решил попробовать этот профиль создать.
Процедура несложная — запускаешь специальный скрипт и ждёшь. Правда, создать все нужные профили получилось только с третьего раза. Они создаются под матрицы разного размера, и нейросеть, которая запускала мне скрипт, нашла все подходящие размеры лишь на третьей попытке.
| Показатель | До | После |
|---|---|---|
| Самый медленный запрос | 4,95 с | 2,46 с |
| Пиковая скорость | 1045 ток/с | 1811 ток/с |
| Успешные запросы | 12/12 | 12/12 |
В итоге разницу можно увидеть в таблице выше — тут результаты небольшого нагрузочного тестирования модели с универсальным профилем и профилем, подобранным под оборудование.
GPU — это не только процессор
Сейчас многие интересуются нейросетями и тем, чего с их помощью можно добиться, поэтому, конечно, я часто говорю о них с разными людьми. Область до сих пор считается новой, поэтому людям интересен реальный опыт, не у всех есть возможность его получить.
Одна вещь оставалась мне непонятной в таких разговорах: почему люди не осознают, что нельзя уменьшить вдвое оборудование и запустить на нём ту же модель, которая раньше
Специалисты, конечно, тут вспомнят про квантованные сети, но мы же рассматриваем общий случай, сеть уже может быть квантованной.
Вчера я наконец догадался. Оказывается, люди воспринимают видеокарты прежде всего как процессоры. По такой логике, если процессоров меньше или они слабее, значит, нейросеть на них будет работать немного медленнее. Но это не совсем так!
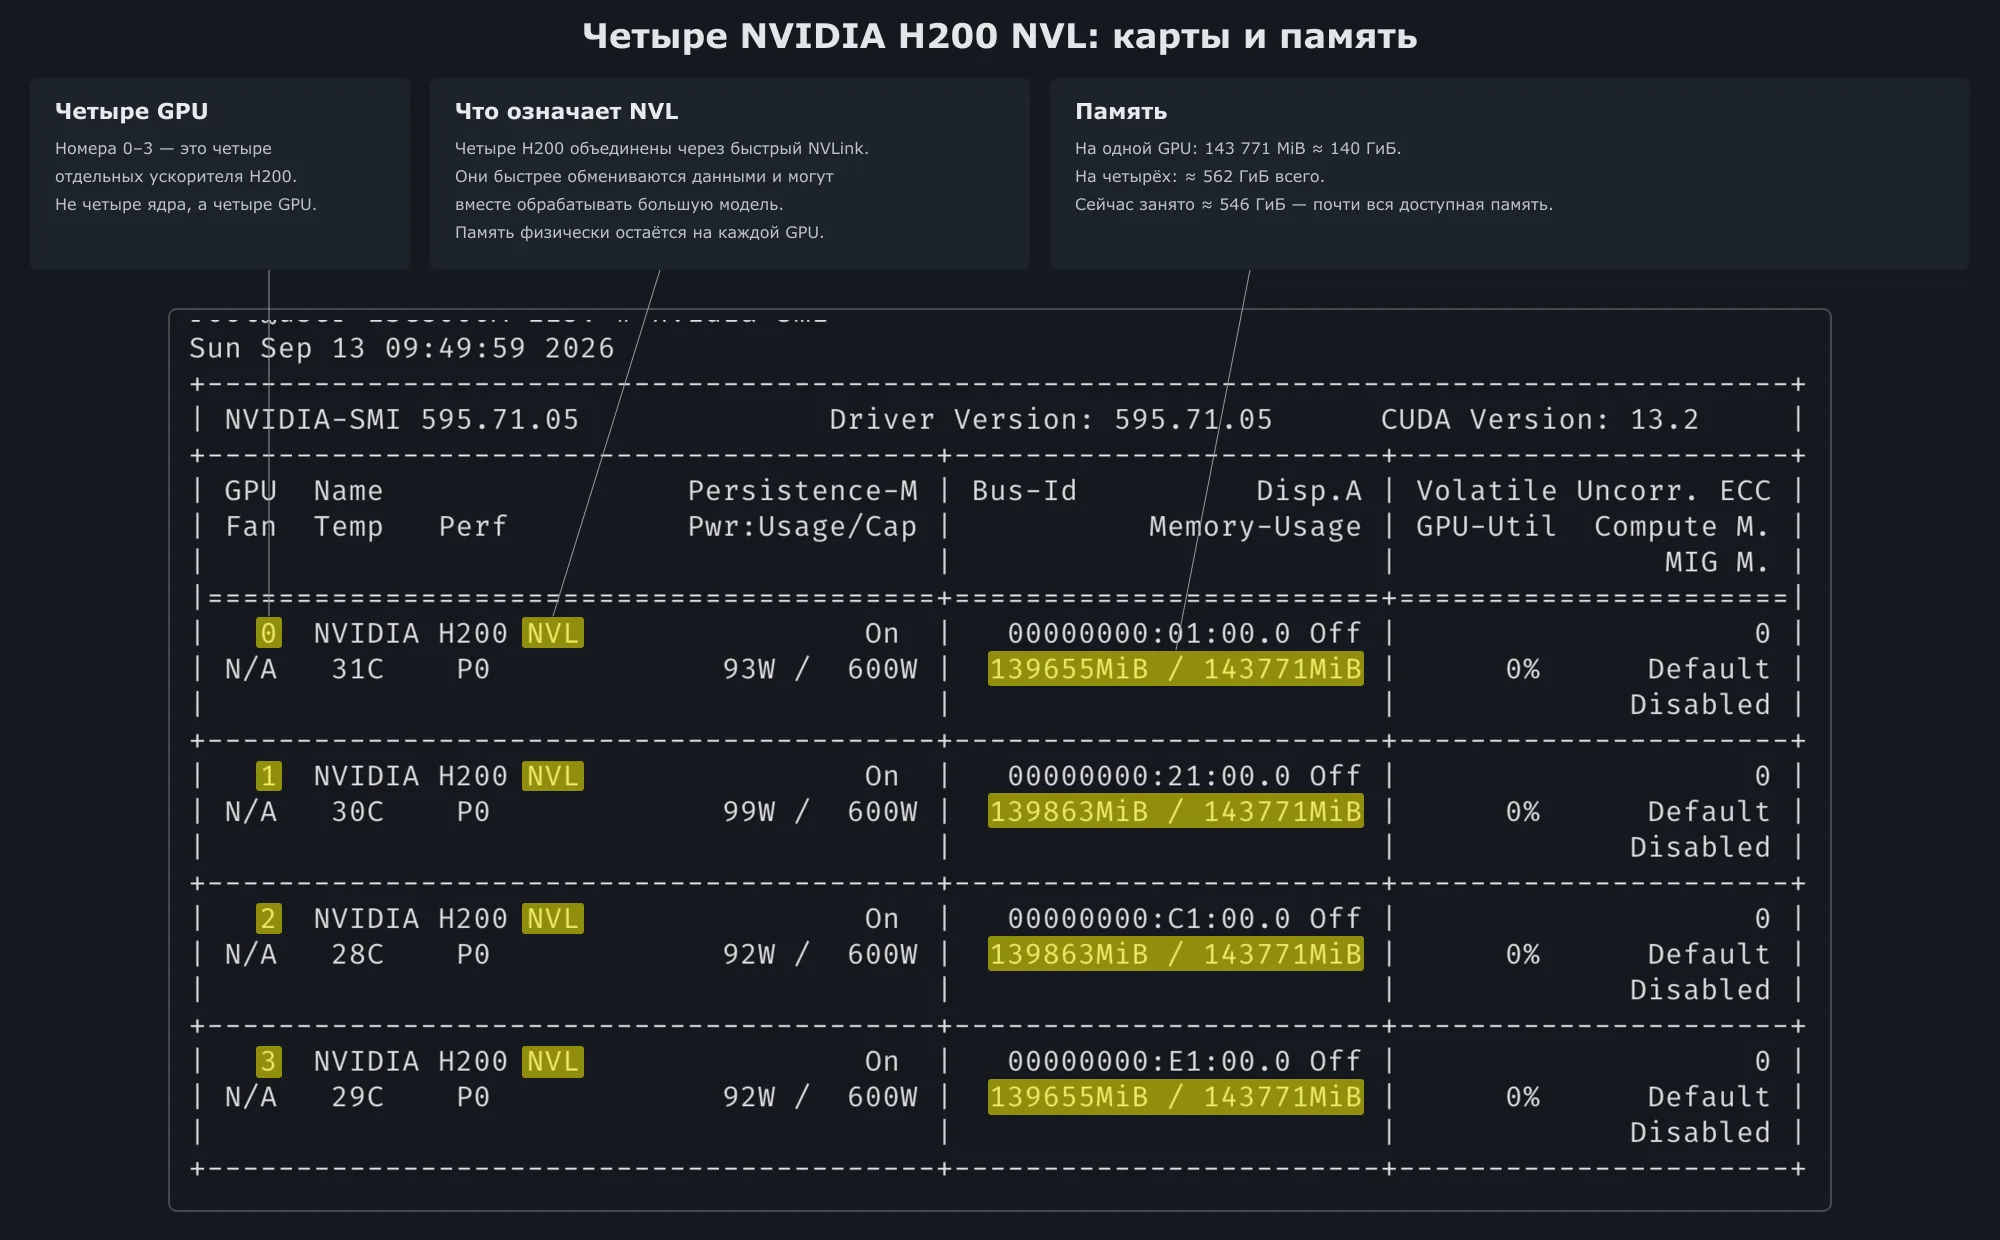
Большим нейросетям нужно много видеопамяти. На скриншоте ниже видно, что у кластера из четырёх видеокарт Nvidia H200 одна нейросеть «ДипСик 4.1» занимает практически всю имеющуюся память графических ускорителей. Это не память системы, которую использует центральный процессор!
Да, есть способы частично выгружать модель в оперативную память или даже запускать её без видеокарты — только на центральном процессоре, но будет не просто медленно, а практически неработоспособно. Я пробовал для интереса (192 ядра с использованием
Резюме такое: чтобы нейросеть работала в пригодном режиме, ей, помимо графических ядер, нужно ещё достаточно видеопамяти. Иначе пользовать этим будет не просто некомфортно, а невозможно.
DeepSeek V4.1 Flash: втрое быстрее
Ниже параметры, которые пришлось поменять:
| Параметр | Было → стало | Для чего |
|---|---|---|
swa-prefix-tails | 32 → 128 | Сохранять больше контекстов для повторного использования |
schedule-policy | fcfs → lpm | Раньше обслуживать запросы с уже закэшированным контекстом |
schedule-conservativeness | 1 → 0,7 | Уменьшить резерв памяти при допуске запросов |
DeepSeek V4.1 Flash на 4×H200
Вышла DeepSeek V4.1 Flash, и мы решили попробовать её вместо нашей DeepSeek V4 Flash‑0731, используемой в офисе для ботов и как помощник для программиста. Новая версия заметно прибавила в программировании: в опубликованных ДипСиком результатах теста DeepSWE доля решённых задач выросла с 54,4% до 74,2%.
В руководстве для размещения модели указан сервер на 8×H200, но у нас столько нет, поэтому попробовали запустить на том, что есть — 4×H200. На них модель запустилась через фреймворк SGLang с некоторыми ограничениями.
Пришлось сократить контекст с миллиона до 256K токенов и ограничить число одновременно выполняемых запросов четырьмя. Общий запас контекста они делят между собой. Но хорошо хоть, что веса модели не пришлось сжимать.
| Параметры запуска | Что дают |
|---|---|
--tp 4 --ep-size 4 | Распределяют модель между четырьмя GPU |
SGLANG_ENABLE_DSV41_ENGRAM_HOST_TABLE=0 | Переносит таблицы Engram в видеопамять: выбранный вариант хранения в память не помещался. Сам Engram остаётся включённым |
--context-length 262144 и --max-total-tokens 262144 | Ограничивают контекст и общий кэш до 256K |
--max-running-requests 4 и --cuda-graph-max-bs-decode 4 | Ограничивают параллельную работу и расход вспомогательной памяти |
--chunked-prefill-size 4096 | Позволяет обрабатывать длинный запрос небольшими порциями |
--mem-fraction-static 0.95 | Отводит до 95% видеопамяти под веса и кэш |
Ускорение генерации DSpark сохранили, вызовы инструментов работают — это проверили. После запуска на каждой карте осталось примерно 12–13ГБ свободной памяти.
На небольших задачах по программированию получается 120–140 токенов в секунду, включая внутренние рассуждения и время до полного ответа. Без рассуждений короткий тест показал 161 токен в секунду.
В небольшом тесте на зацикливание бесконечных повторов пока не встретилось — на предыдущей модели с этим пришлось бороться отдельно. Один запрос израсходовал 3072 токена на размышления, так и не выдав код; повтор с бюджетом в восемь тысяч завершился нормально. Сгенерированный алгоритм прошёл шесть проверок, включая работу с циклическими графами.
В общем, конфигурацию считаем рабочей, но без реальной эксплуатации радоваться пока рано, посмотрим как она себя покажет.
Добавлено позднее: в процессе эксплуатации выяснилось, что эта конфигурация может быть расширена. Количество одновременных запросов удалось поднять с четырёх до восьми, а общий кеш до миллиона токенов:
| Параметр запуска | Было | Стало | Что даёт |
|---|---|---|---|
--max-running-requests | 4 | 8 | До восьми запросов одновременно |
--max-total-tokens | 262144 (256К) | 1048576 (1М) | Вчетверо больший общий кэш токенов — больше места для параллельных длинных запросов |
--cuda-graph-max-bs-decode | 4 | 8 | Подготовленные CUDA-графы для обработки до восьми запросов с меньшими накладными расходами |
ИИ: локальное ревью кода
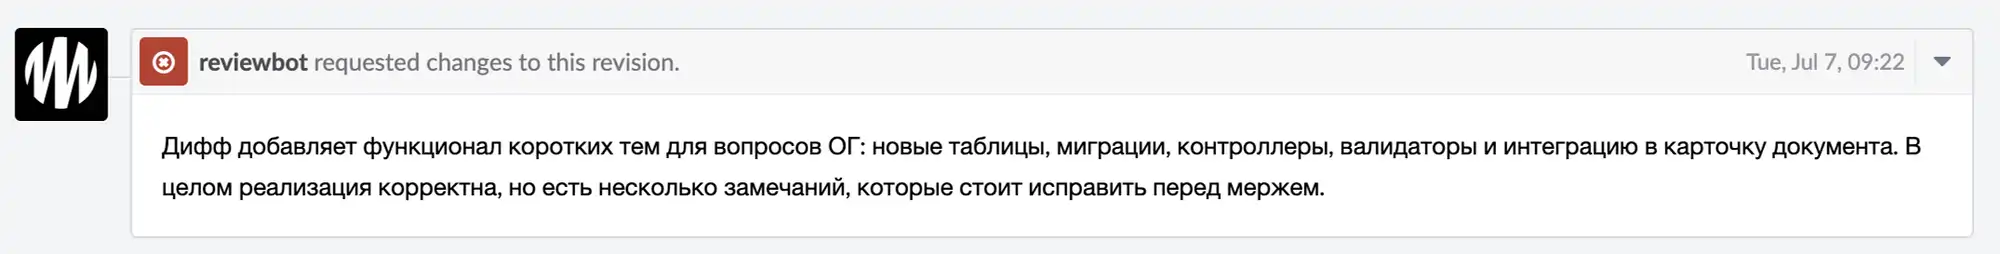
Подключил локальный
Считаю, что польза уже есть, но надо продолжать его улучшать.
Программирование на четырёх GPU
Я сходил в отпуск, но ребята в офисе не прекращали тестировать нейросетки для локального программирования. Мы уже смотрели на сети, которые запускаются на одной и двух картах Nvidia H100, и приступили к тестированию конфигурации из четырёх H200.
Я не помню, рассказывал ли я, для чего вообще мы рассматриваем конфигурации больше чем с одним графическим ускорителем. Ответ простой — большие сети занимают очень много памяти и в память одного ускорителя не помещаются. Современные фреймворки разбивают сети на части, загружают их в память нескольких ускорителей, а данные между ними гоняют по быстрой шине, соединяющей ускорители между собой. В случае карт Nvidia это шина NVlink.
К слову, мы пробовали соединение через центральную шину — с точки зрения производительности это печально, пользоваться невозможно.
В общем, мы потестировали несколько больших моделей, работающих в этой конфигурации и спустя две недели рейтинг уже сложился:
DeepSeek-V4-Flash zai-org/GLM-4.5-Air-FP8 Qwen3-Coder-480B-A35B-Instruct-FP8
Можно попробовать ещё ГЛМ поновее и КИМИ, но они обе будут с сильными квантированием, поэтому есть сомнения, что они смогут побить победителя. «Квен»

Программирование на двух GPU

На этой неделе мы наконец получили NVLink, чтобы связать наши два видеоускорителя собственной шиной. Это нужно, чтобы запускать модели большего размера, занимающие обе карты: на шине общего назначения скорости не те, и модели еле ворочаются.
Развернуть и потрогать пока успели только две модели:
deepseek-ai/DeepSeek-V4-Flash QuantTrio/MiniMax-M2.7-AWQ
Обе модели урезанные, разумеется, но даже так они еле умещаются на картах, параллельность никакая. Эти модели должны быть мощнее, чем те, которые удалось запустить на одной карте; по крайней мере, синтетика даёт ожидаемые результаты, но на практике не всё так однозначно.
Ребятам больше всех пока понравился
Надо понимать, что серьёзным облачным моделям эти модели в подмётки не годятся: они мощнее примерно на порядок, и оборудование, которое позволяет их запустить, стоит совершенно других денег.
Для серьёзного программирования такие локальные модели непригодны,
Программирование на одной GPU
Интересная штука встречается очень часто. Мне сложно её принять, хотя я понимаю, почему так произошло. Для людей нейросети слились в одно большое атомарное явление. Ну, знаете, как «учёные»: «Учёные заявили…». Какие учёные? Может, там биолог про математику говорит? Многим неважно, есть ли консенсус среди учёных по этому вопросу и насколько проверены данные, на основании которых «учёные заявили».
Так же и тут. Как будто бы многие считают, что нейросети одинаковые: видел одну — видел все. Разумеется, это не так. Они разные по размеру, а значит, и по способностям. У большинства есть специализация, они обучались на разных данных и обладают разным «опытом». И то, что вы можете развернуть у себя на ноутбуке, в подмётки не годится большинству из того, что есть в «облаках».
Мы недавно провели эксперимент среди нейросетей для программирования, которые можно развернуть на одной Nvidia H100. У неё 96 ГБ видеопамяти, и это сейчас один из самых главных критериев — размер памяти, а не мощность самой карты.
Даже в этом сегменте результаты сильно различаются. Мы попробовали следующие сети:
openai/gpt-oss-120b — четыре бита на параметрQwen/Qwen3-Coder-Next-FP8 zai-org/GLM-4.7-Flash Qwen/Qwen3-Coder-30B-A3B-Instruct gemma-4-31B-it
Среди этих почти одинаковых по параметрам сетей — выбивается только OSS со своими 120 миллиардами параметров, но в сильно урезанном виде — есть явный и безусловный лидер:
Я веду к тому, что если вы попробовали
GPU: B300
Ребята из компании «Селектел» (большое спасибо!) дали нам на несколько дней потестировать блок графических ускорителей NVIDIA DGX B300 Supermicro HGX B300. На данный момент это одно из самых производительных решений в одном корпусе.
Для меня, как техногика, это примерно как если бы
Думаю, эту штуковину было совсем не просто купить, учитывая, что страна находится под санкциями, да и разместить её тоже непросто.
Блок занимает десять юнитов в стойке; его габариты — 44 × 48 × 90 сантиметров, а вес — почти полтора центнера. Внутри — восемь ускорителей B300, водяное охлаждение, а потребляет всё это хозяйство до 19 киловатт.
Добавлено позднее: оказалось, что «Селектел» нам выделили Supermicro HGX B300. Спасибо одному из читателей, указавшему на ошибку. Я не до конца исследовал вопрос.

Помимо вполне понятного желания потрогать дорогую железку, у нас есть и практическая цель — понять, как соотносятся производительность такого решения и его цена. Мы сейчас активно внедряем искусственный интеллект у наших заказчиков, поэтому нам часто важно понимать, какое оборудование нужно под конкретную нагрузку.
Именно для этого мы и делаем все тесты, о которых я тут пишу: чтобы оценить относительную производительность доступных нам решений.
Сейчас у нас нет заказчиков, которым действительно понадобилось бы настолько серьёзное оборудование. Но понимать его возможности всё равно важно — хотя бы с прицелом на будущее.
Тесты одного ускорителя B300 я уже публиковал, и из них можно сделать такой вывод.
Одна B300 примерно в 1,8 раза быстрее, чем H100 NVL. H100 NVL, в свою очередь, примерно в 1,4 раза быстрее, чем RTX 6000 Pro. Модели, которые не помещаются в память одного ускорителя, мы пока не используем, поэтому для нас прежде всего интересны результаты именно на одной карте.
Но производительность всего кластера целиком тоже хочется протестировать. Правда сравнить с другими картами эти результаты не получится: ни у одной из них нет такого объёма видеопамяти, чтобы запускать модели сопоставимого уровня.
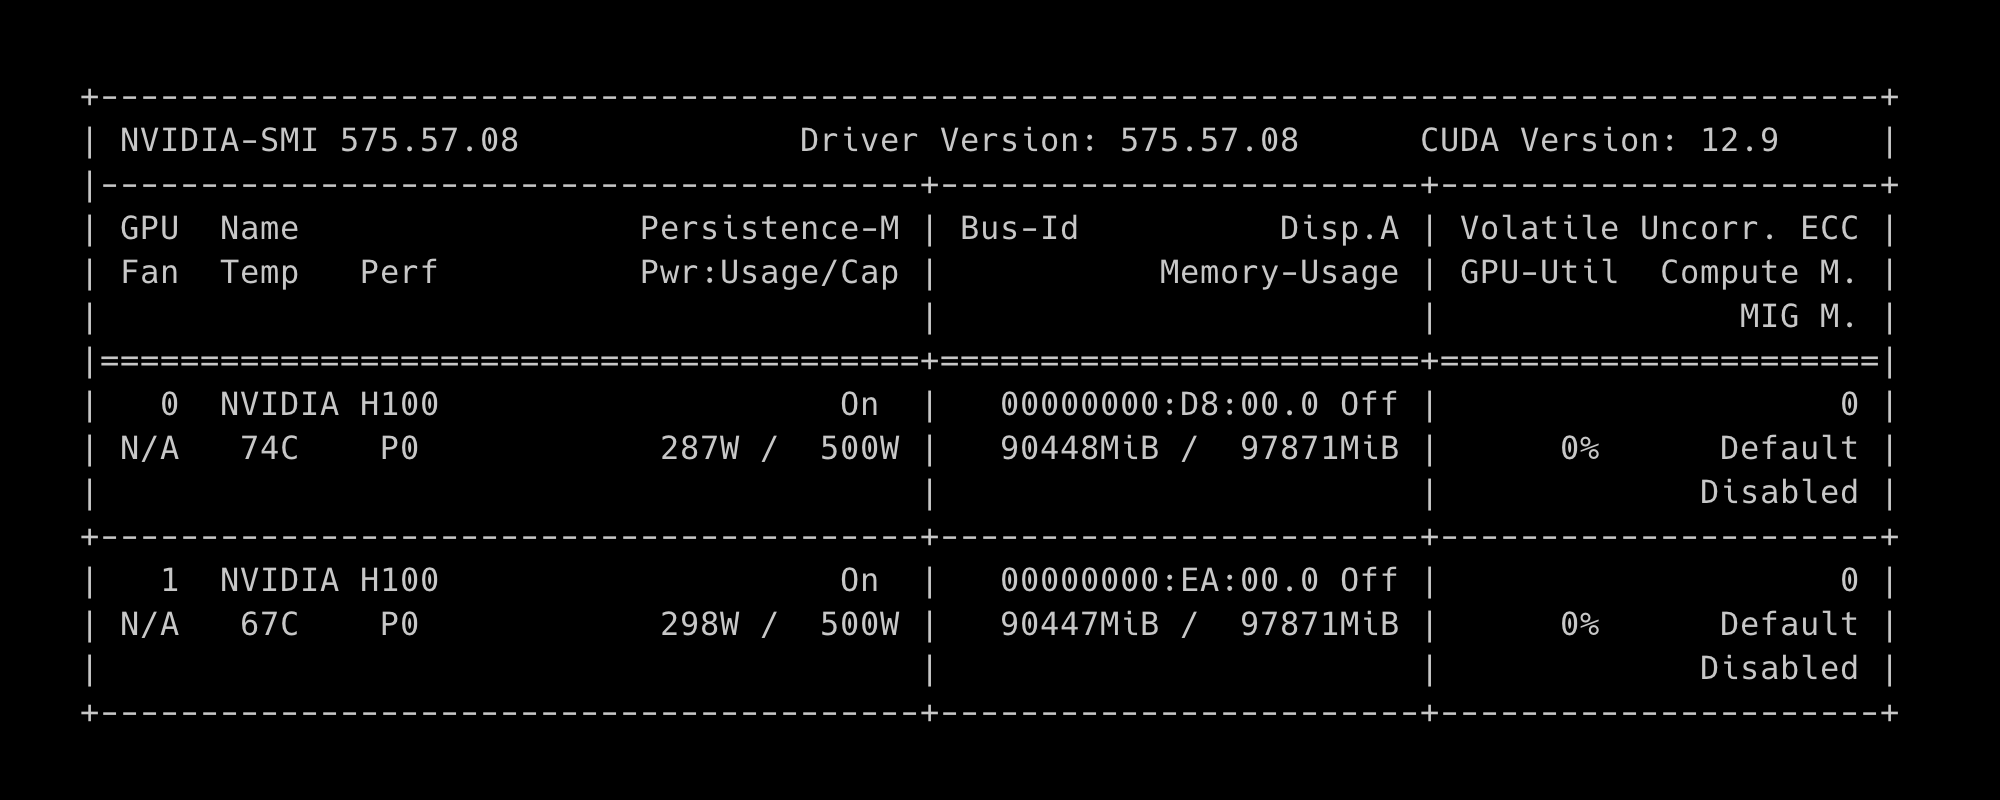
Единственная модель

При росте параллельности с 200 до 500 общая пропускная способность увеличивается почти в полтора раза — с 14 900 до 22 200 токенов в секунду. При этом время до первого токена (P99 TTFT) ожидаемо растёт, но остаётся в пределах 24—25 секунд даже на максимальной нагрузке, а время генерации одного токена (P99 TPOT) — в районе 66 мс, что для модели на 397B параметров с разреженной архитектурой является очень достойным показателем.
К сожалению, из‑за нехватки времени мы не смогли разобраться с запуском ещё более тяжёлых моделей вроде
Но и полученные цифры уже дают заказчикам ориентир: если ваша задача требует обслуживания нескольких сотен одновременных запросов к ультра‑большой LLM, DGX B300 справляется с ней без перегрева и троттлинга, сохраняя предсказуемую задержку.
GPU: B300 vs H100 NVL vs H100 vs RTX 6000 Pro
А это сырые пока данные, сведённые из нескольких разных тестов по двум разным моделям — полной

GPU: RTX 6000 Pro vs H100 на FP8
Так, кто там у меня в комментариях в телеграмном канале спрашивал о сравнении наших графических ускорителей при работе с сетями, квантованными до FP8 (однобайтового типа с плавающей точкой)?
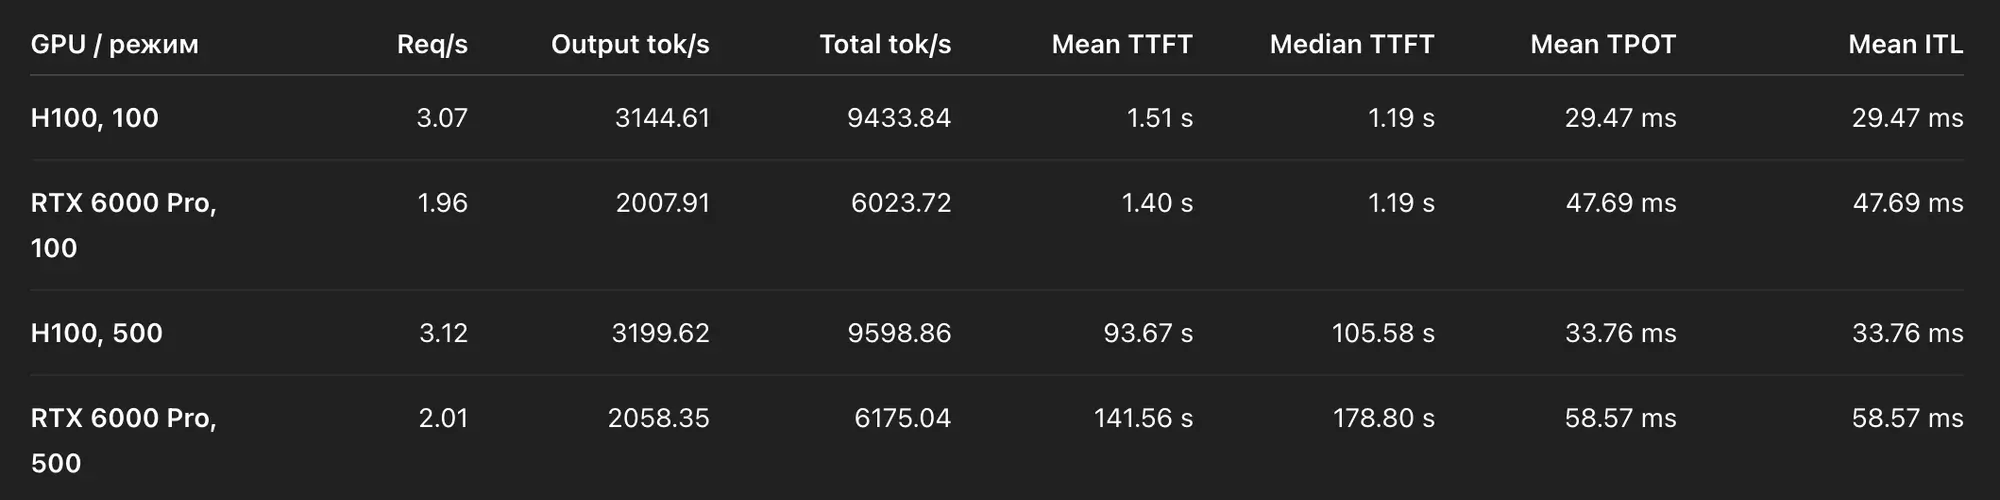
Табличка ниже, использовался «Квен 3.5» с 35 миллиардами параметров (A3B).
Что мы тут видим? А видим мы очень интересную штуку: оказывается, ускорители H100 бывают очень разными. Инференс нашей тестовой модели показывает, что NVIDIA H100 NVL
Сравнение полноразмерного «Квена 3» я уже у себя публиковал.

GPU: RTX 6000 Pro vs H100
Провели тестирование графического ускорителя NVIDIA RTX 6000 Pro WE в сравнении с NVIDIA H100. Тестировали в разных режимах, с нейросетью «Квен3» с 30 миллиардами параметров, без квантования. Тесты включали и синтетику, и реальные наши задачи; мы даже подключили ускоритель к «боевой» инсталляции и наблюдали за разницей. Обучение не тестировали, так как у нас таких задач почти нет: нас больше интересовало, как будут вести себя большие языковые модели.
Все цифры публиковать не буду, но небольшую статистику по синтетическому тесту всё же приведу. Вывод такой: на реальных наших данных разницы мы не заметили, а в синтетике H100 производительнее в 1,55—1,6 раза.
Учитывая разницу в стоимости примерно в три раза, RTX 6000 Pro выглядит более выгодным вариантом для покупки, но с оговоркой: для моделей, которые не помещаются в память одной карты, H100 (или ещё более старшие модели) предпочтительнее, так как у таких карт есть собственная высокоскоростная шина для обмена данными, и общая производительность такого решения должна превосходить производительность карт RTX 6000 Pro, соединённых по обычной шине.
GPU: нашли в чём проблема с RTX 6000 Pro
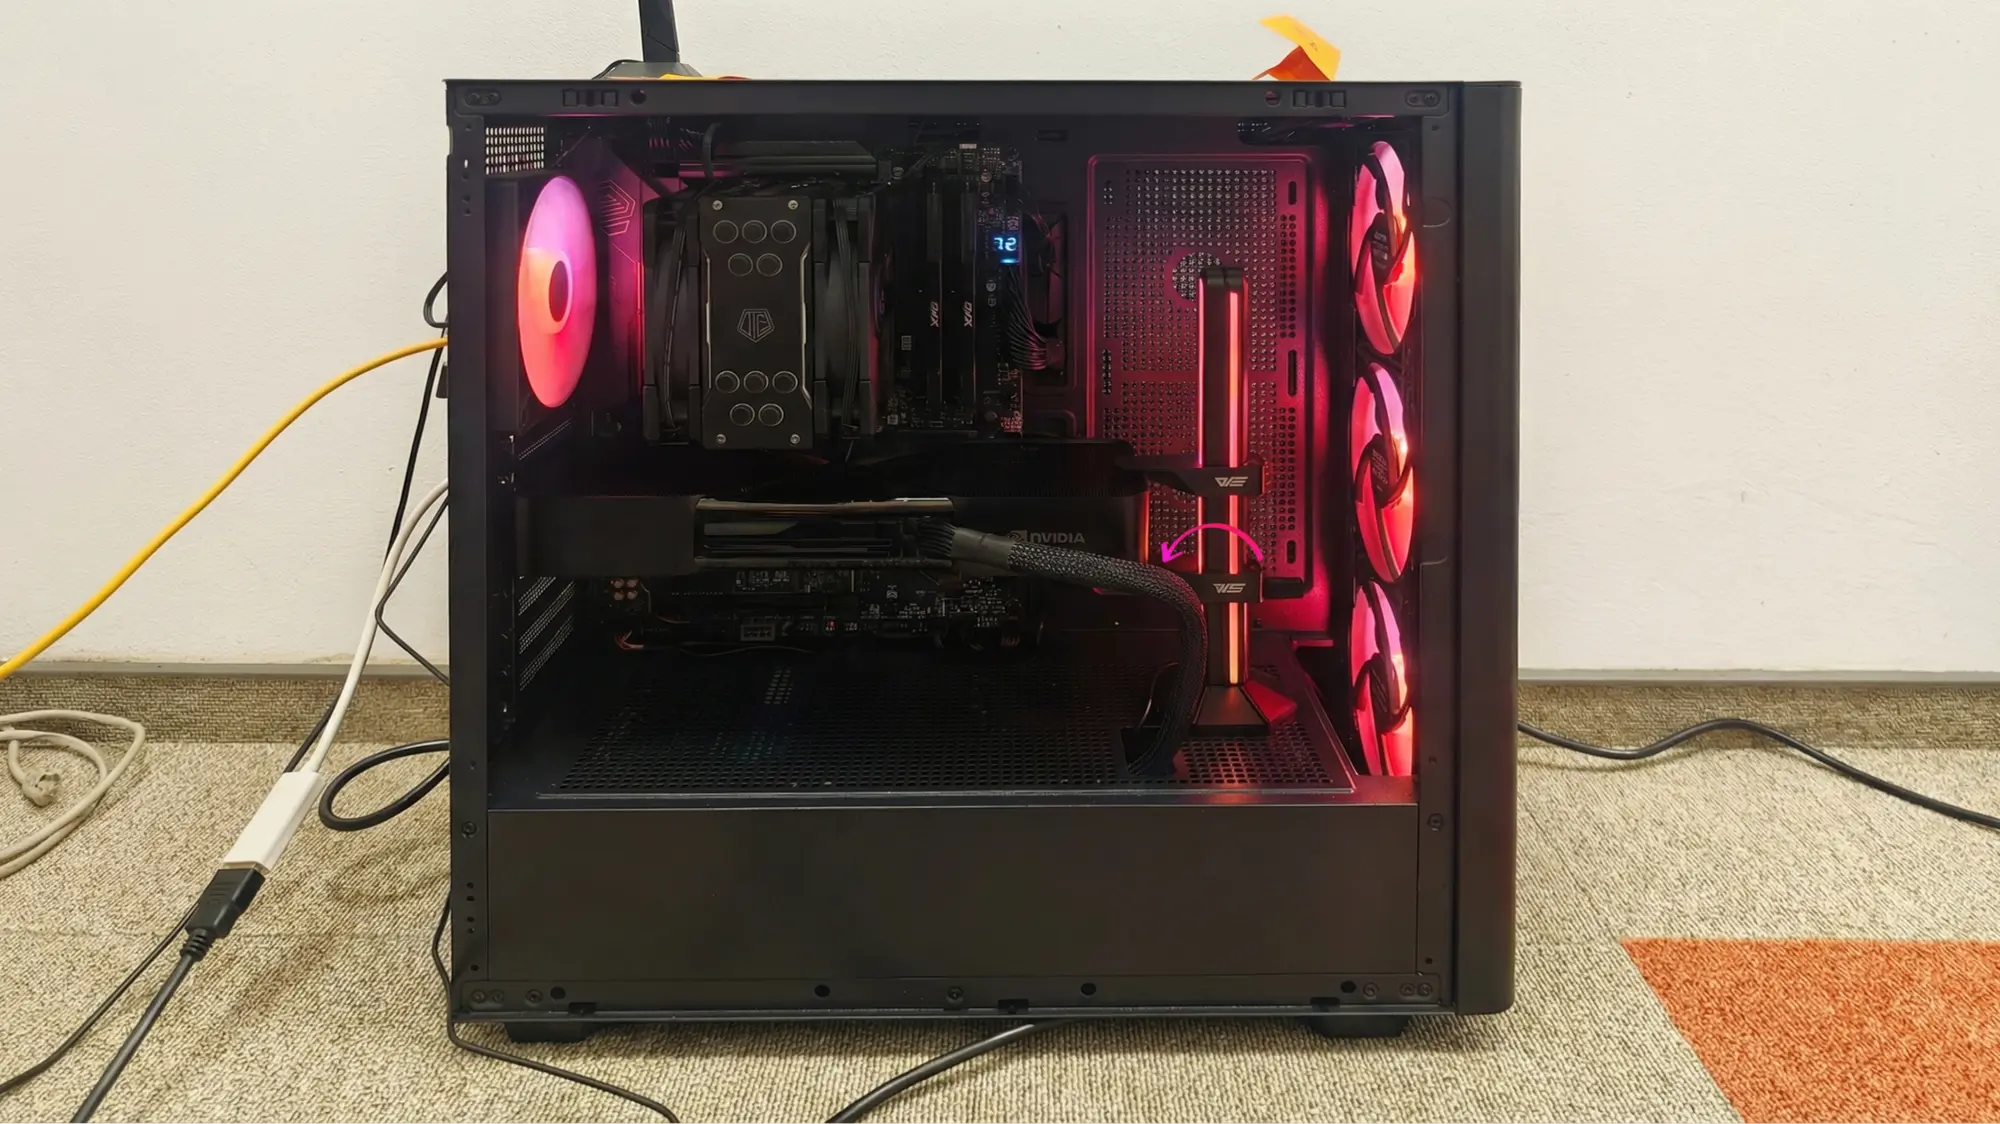
Нашли, в чём причина плохого охлаждения графического ускорителя RTX 6000 Pro. Ларчик просто открывался — я сунул руку под карту и обратил внимание, что один из двух вентиляторов не крутится. Даже когда пытаешься провернуть его рукой, он прокручивается с небольшим сопротивлением.
Оказалось, что стойка поддержки видеокарты (такие используются для тяжёлых моделей) — я обозначил её стрелкой, на снимке она справа — резиновой опорой прижала вентилятор снизу, и он вообще не вращался. После того как мы передвинули стойку, температура перестала подниматься выше 80 градусов.
Кстати, если искусственно включить вентиляторы на стопроцентную производительность, то температура держится на уровне 70—75 градусов.
GPU: кратко про RTX 6000 Pro
Некоторое время назад я обещал выложить цифры производительности очень интересного графического ускорителя — RTX 6000 Pro.
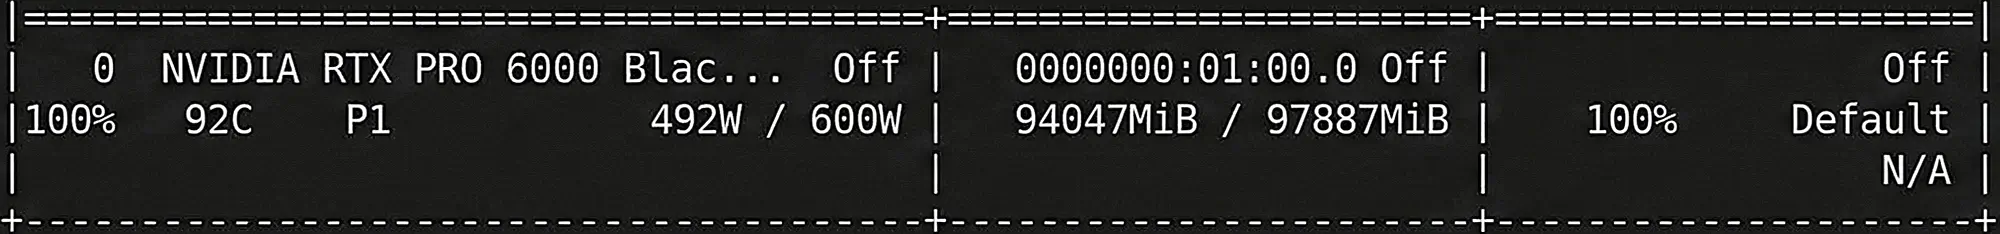
Коротко: пока результатов нет. Несмотря на мощные вентиляторы на самой карте и уже установленные в корпусе компьютера, в который мы её поставили, она перегрелась в одном из первых тестов.
Будем усиливать охлаждение — добавим дополнительные вентиляторы и попробуем снова.
RTX 6000 Pro
Настройка больших языковых моделей на оборудовании —
В ходе экспериментов выяснилось, что лучше всего себя ведёт конфигурация из четырёх одинаковых моделей, установленных на паре видеокарт каждая. Я это связываю с тем, что в других конфигурациях либо слишком интенсивный обмен по NVLink, либо, напротив, модель слишком «зажата» по памяти — на кеши выделено слишком мало.
В общем, пока всё приходится испытывать на практике — выходит новое оборудование и надо понимать можем ли мы его рекомендовать клиентам.
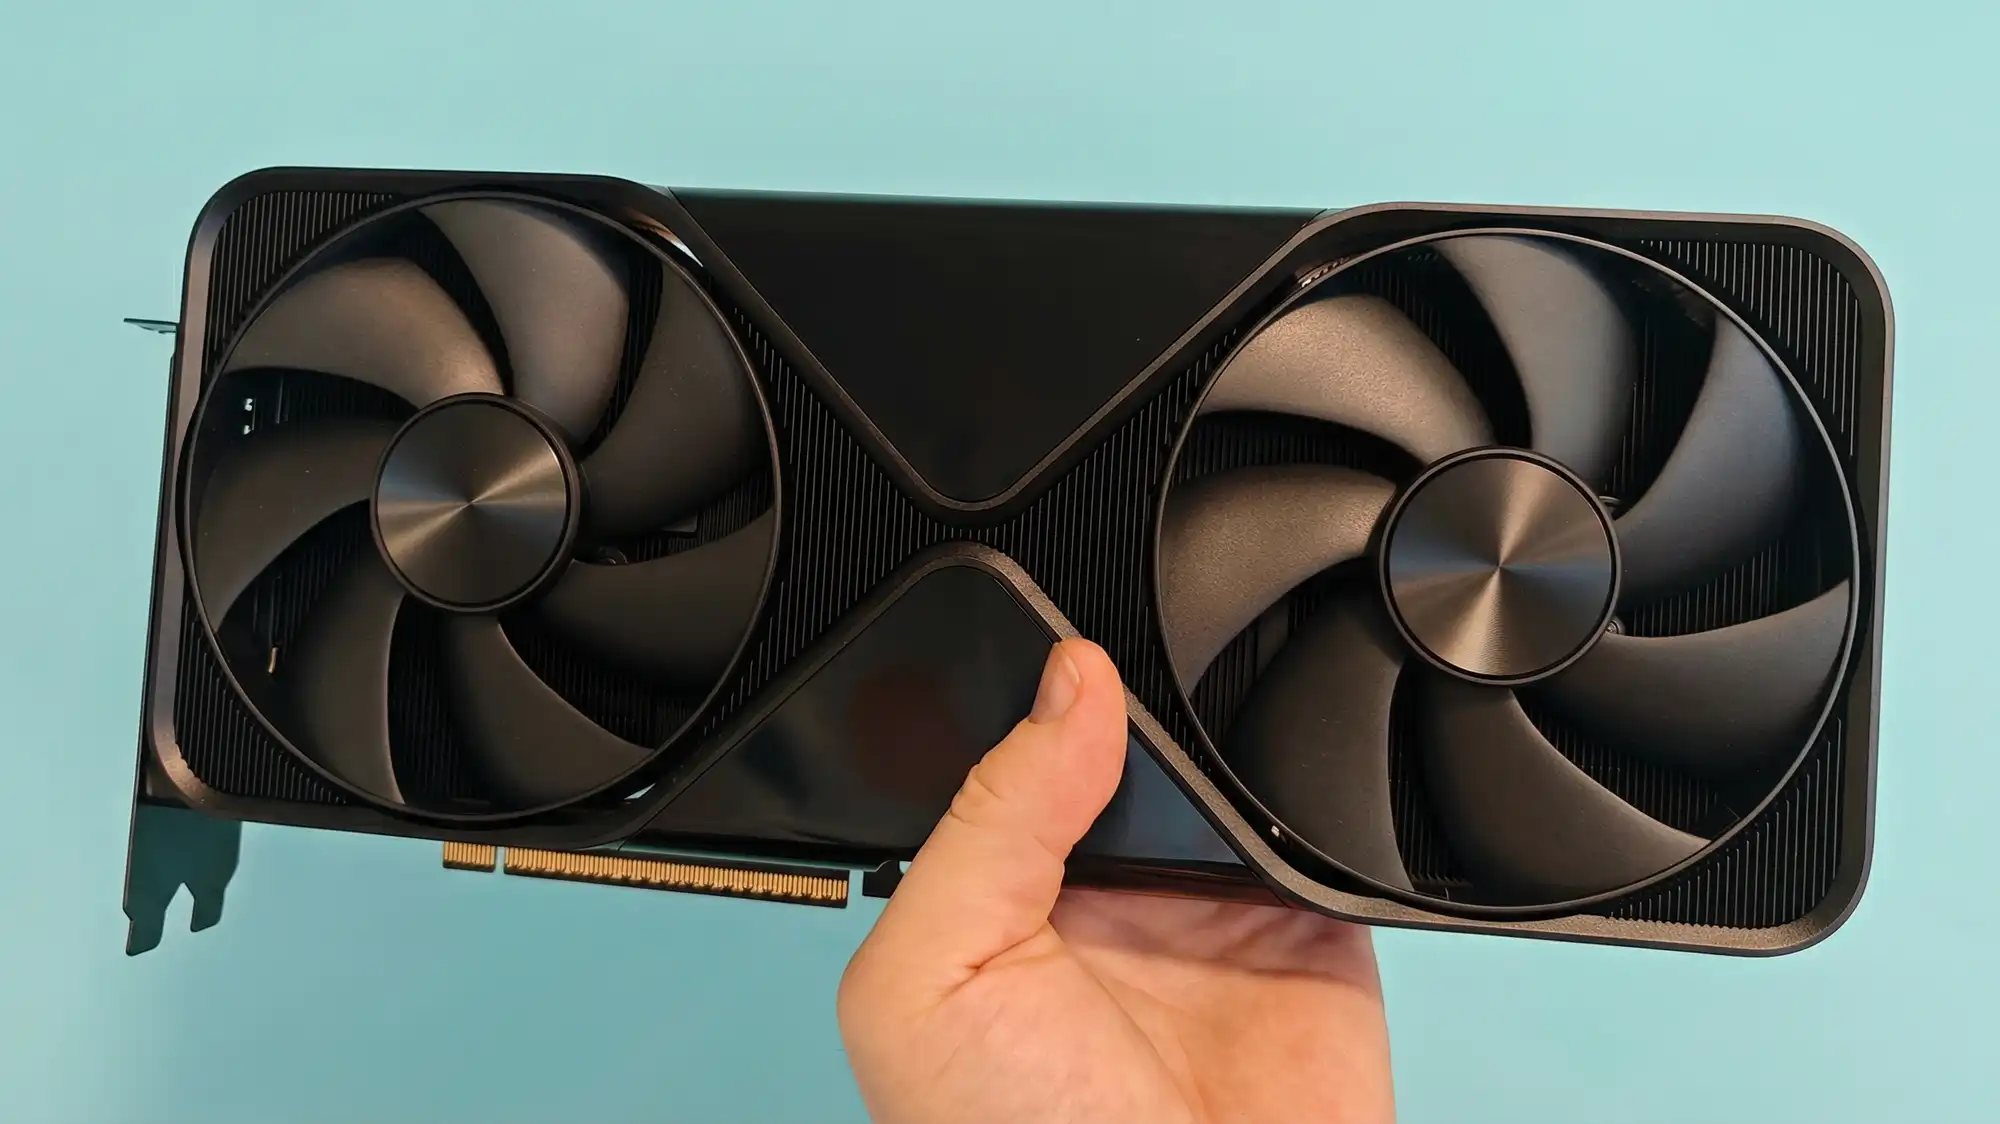
В прошлом году появилась очень интересная карта — RTX 6000 Pro. Мы её заказали, чтобы погонять на ней наши модели. Она втрое дешевле, чем H100, при этом производительность у неё далеко не втрое ниже. В аренду мы почему разным причинам не смогли её получить, поэтому купили.
На фотографии я держу её в руке — оцените, какая она огромная, и поверьте: очень увесистая. Тут она в исполнении Workstation Edition, поэтому у неё есть собственное охлаждение; обычно в серверных картах оно только пассивное.
Погоняем тесты, потом постараюсь
FP8 и Nvidia A100
Недавно вышла новая модель Qwen3 с 80 миллиардами параметров. Мы её решили попробовать, но оказалось, что версия фреймоворка vllm, которую мы используем, с ним несовместима. Чтобы не экспериментировать на своём оборудовании, арендовали у «Селектела» две Nvidia A100. Хотели
Модель рассчитывали взять квантованную до FP8, такая есть в выпущенном наборе моделей. Нам она хорошо подходит — как раз уместится в память наших карт. Я рассчитываю, что 80 миллиардов с точностью восемь бит побьют предыдущие тридцать с вдвое большей точностью.
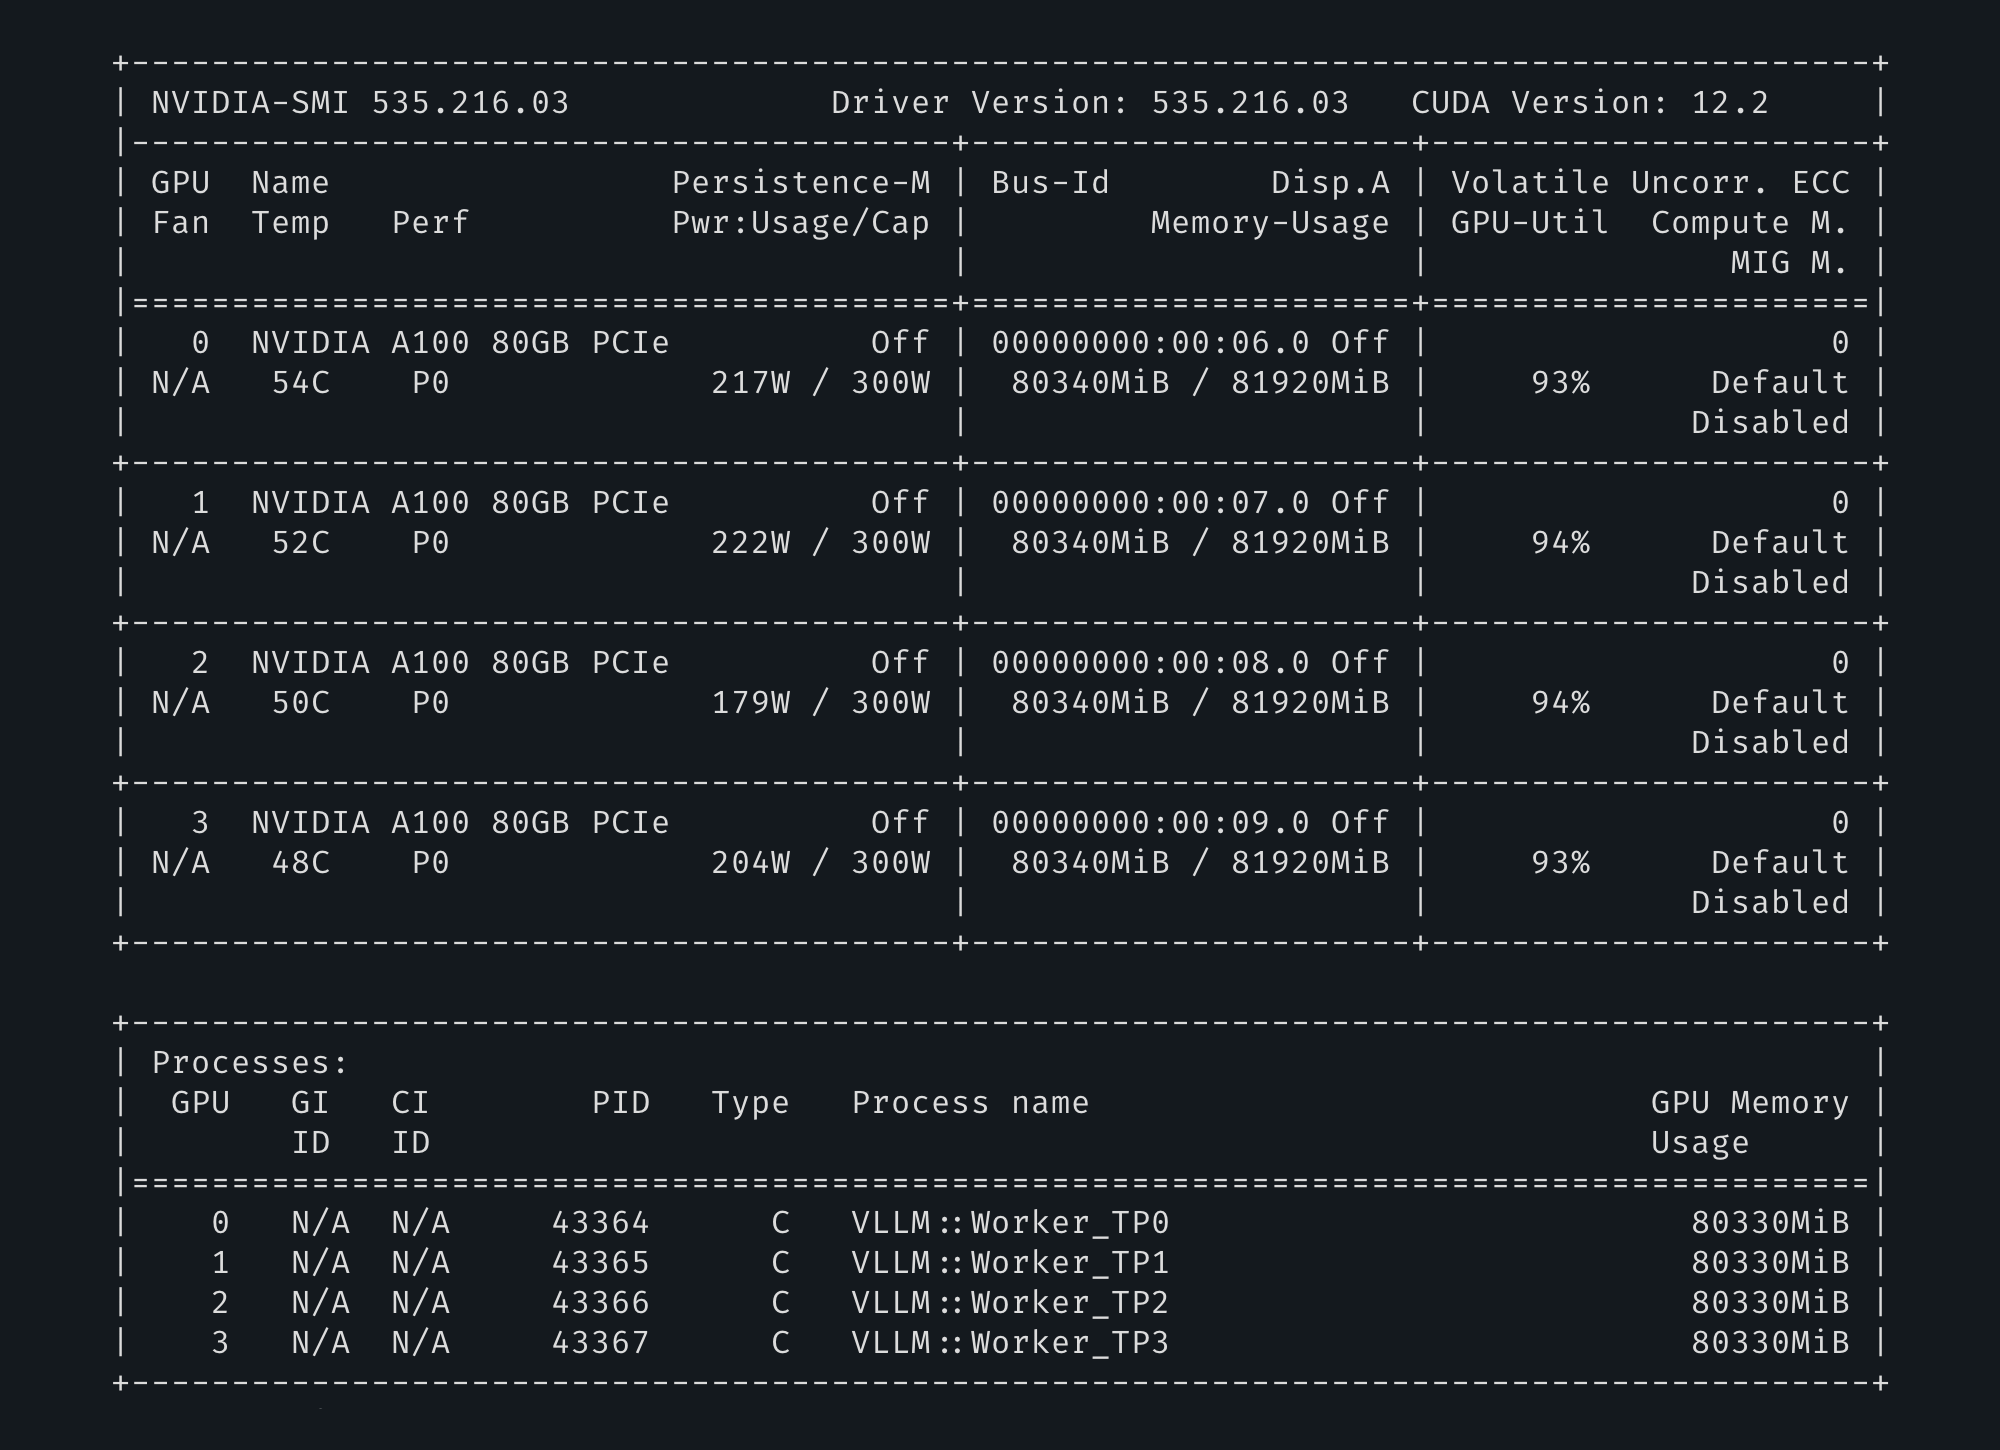
Но нас тут ждало разочарование — карты A100 тип FP8 не поддерживают, есть только эмуляция через FP16. Так как карты с FP8 всё равно пока арендовать не получится, выделили себе четыре A100 и поставили полную модель, без квантованния. Не совсем то, что хотелось, но всё равно полезно посмотреть как встанет и немного погонять по производительности.
В итоге, «завалить» модель одновременными соединениями не вышло (модели, которые мы крутили на одной или двух H100 заваливались), время ответа от нашего эталонного промпта получилось от 3,59 секунд до 8,74. Это очень быстро.
Qwen3, T4 и разные фреймворки

Ещё немного знаний о запуске моделей на картах T4.
При этом, если вы используете фреймворк vllm и получаете ошибку «Unsupported conversion from f16 to f16», то вероятно у вас установлена библиотека triton с багом. Надо её либо обновить до последней версии, либо сдаунгрейдить до 3.2.0. Первое нам не помогло, а вот даунгрейд выручил.
Не проблема, давайте запустим не на всех картах, а скажем на пяти, 80 гигабайт же должно хватить,
Соответственно, мы можем запустить
Поэтому чтобы уместить на этих картах
И последнее. Это слабо связано с предыдущим,
cmake -S llama.cpp -B llama.cpp/build \
  -DCMAKE_CUDA_ARCHITECTURES=75 \
  -DCMAKE_CUDA_FLAGS="-fPIC" \
  -DCMAKE_CXX_STANDARD=17 \
  -DCMAKE_CXX_STANDARD_LIBRARIES="-lstdc++fs" \
  -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON

cmake --build llama.cpp/build --config Release -j --clean-first \
--target llama-cli llama-gguf-split llama-server
Добавлено позже: проблема тут в том, что GCC до версии 10 не содержит std::filesystem в стандартной библиотеке, её можно подключить снаружи, но надо, чтобы она попала в конец линковки.
GPU и охлаждение
Вот проблема хорошего решения которой я не знаю.
Дано: серверный корпус, специально разработанный под установку графических ускорителей. Внутри установлены две карты Nvidia H100, которые греются, как сволочи. Не сказать, что на критических температурах,
Проблема, как я её понимаю, в том, что в корпусе есть вентиляторы, есть датчики на материнской плате и процессорах и система корпуса знает обороты какого вентилятора поднять, чтобы всё это не перегрелось. Но у графических ускорителей свои датчики, о которых эта система не имеет ни малейшего понятия.
В теории всем этим мог бы управлять Линукс, который там стоит, но он тоже понятия не имеет какими вентиляторами надо подуть, чтобы картам стало легче. То ли у нас это не настроено, то ли в принципе не настраивается.
Проблему решили, выставив повышенные обороты на вентиляторах корпуса. Теперь всё холодное даже под нагрузкой — на графических ускорителях около 30 градусов. Но как будто должно быть
Какая модель у меня запустится?
Как узнать какая нейромодель у запустится на конкретной видеокарте? Вот, например, приходит к нам заказчик и говорит — у нас есть только две Nvidia T4, запустится ли на ней модель, которую вы используете? Как быстро ответить на этот вопрос?
Судя по спецификации, каждая T4 имеет на борту 16 гигабайт видеопамяти. Для целей, на которые нам выделяют видеокарты, мы используем модель Qwen
Каждый параметр хранится в двух байтах, плюс процентов 20 надо накинуть на всякие буферы. В итоге, получается, что нам нужно 30×2+20% = 80 гигабайт. 20% я грубо накидываю, можно вычислять точнее, но для прикидки сойдёт.
Две карты по 16 могут работать вместе, современные фреймворки так умеют, то есть совокупно у нас всего 32 гигабайта. То есть модель не умещается?
Полная модель не уместится, но есть квантованные версии. Дело в том, что модели хранят свои параметры в виде чисел с плавающей точкой. Чем точнее мы храним эти числа, тем лучше работает модель (в своих пределах, конечно). Если памяти у нас мало, хорошее решение — снизить точность. Модель от этого «поглупеет», но это может оказаться некритично.
Мы выбрали квантование в 4 бита, то есть по половинке байта на модель. Таким образом, потребуется 30×0,5+20% = 18 гигабайт.
Большую группу пользователей эти видеокарты не вывезут —

Ещё немного про Nvidia H100 NVL
Надо бы записать ещё немного фактов про Nvidia H100 NVL, которую мы недавно запускали. А то забудется, а в интернете очень мало описано опыта людьми, которые делали
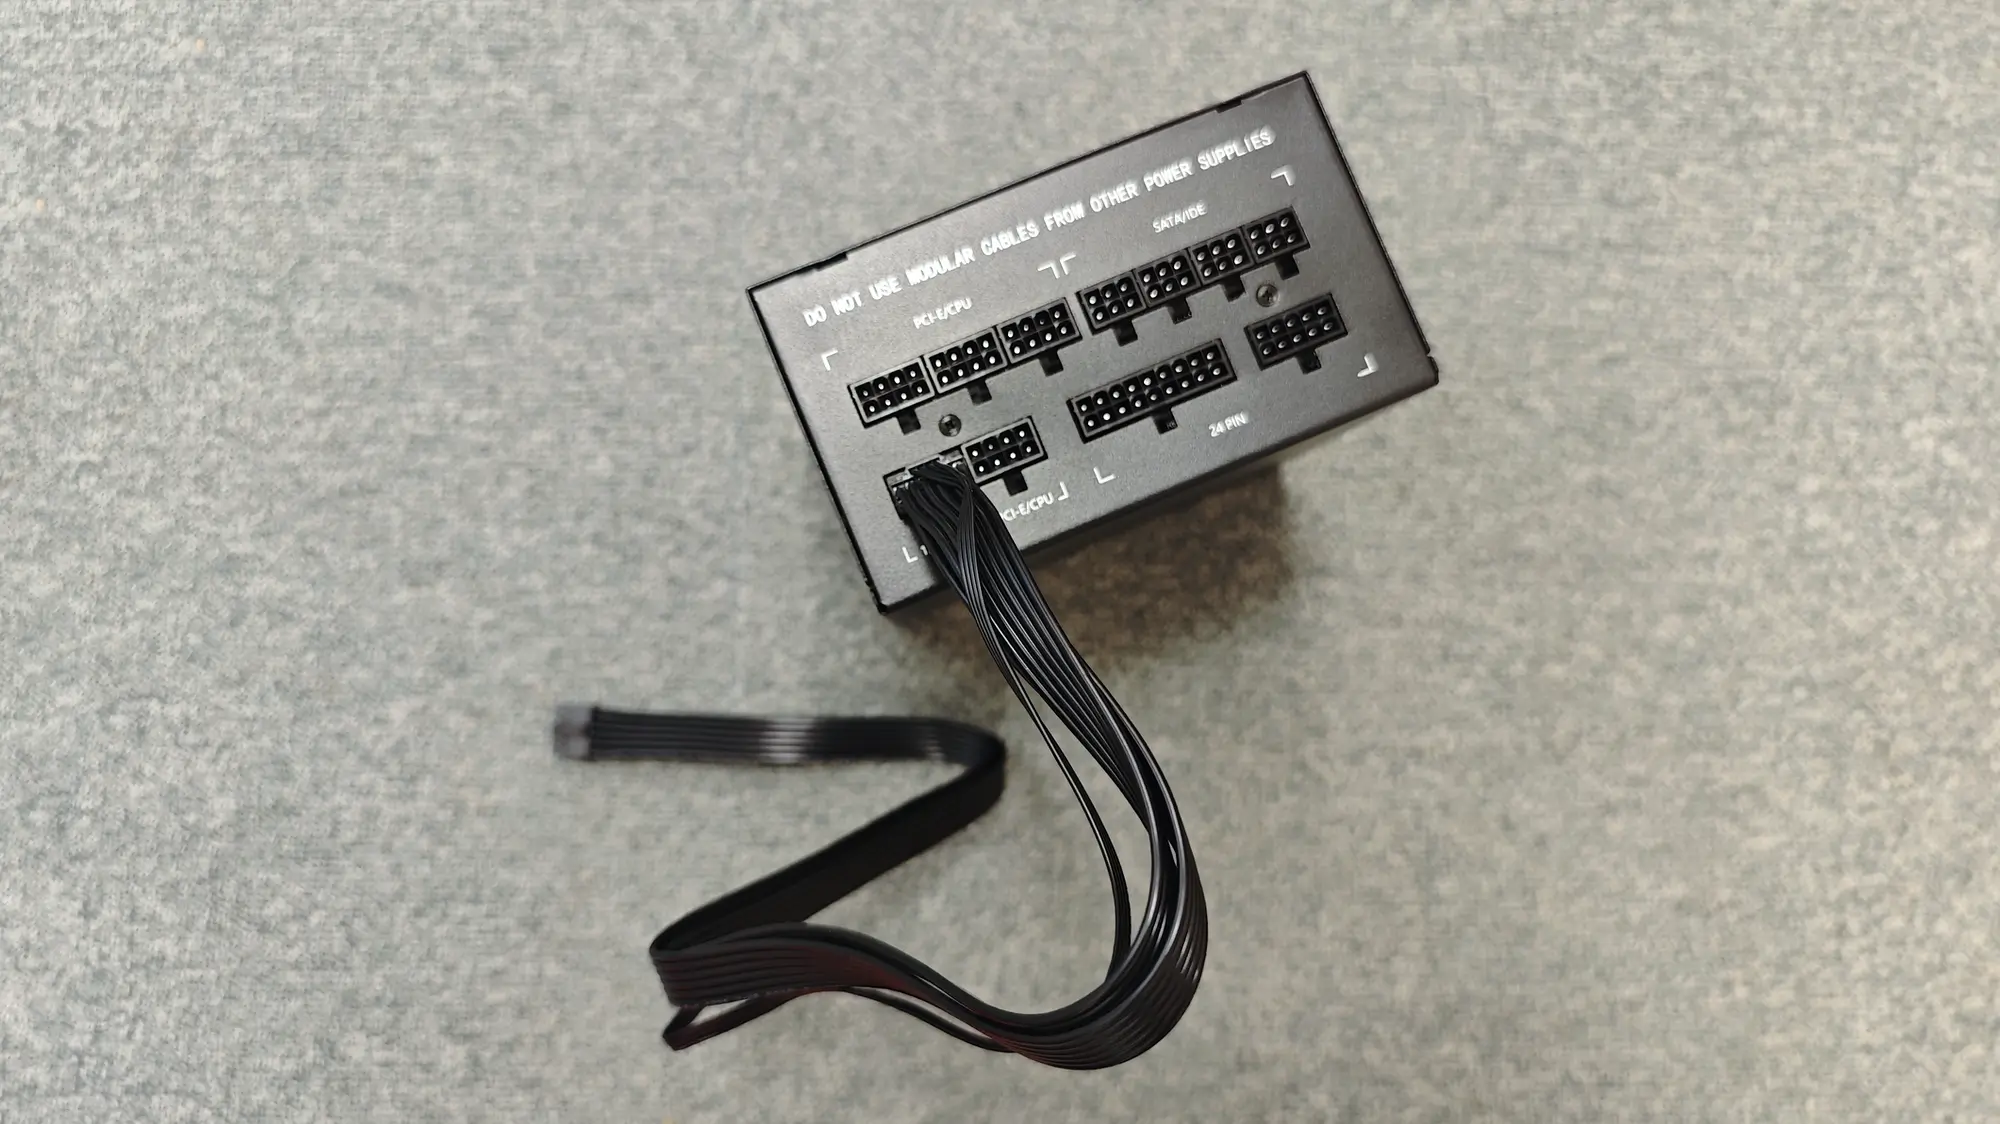
Сначала мы запустили её в менее производительном режиме, так было быстрее — переходник я просто купил на «Авито» за наличку и забрал в течение часа. Позже мы получили блок питания, у которого есть специальный разъём для мощных видеокарт, с которого можно снять до 600 Ватт включительно.
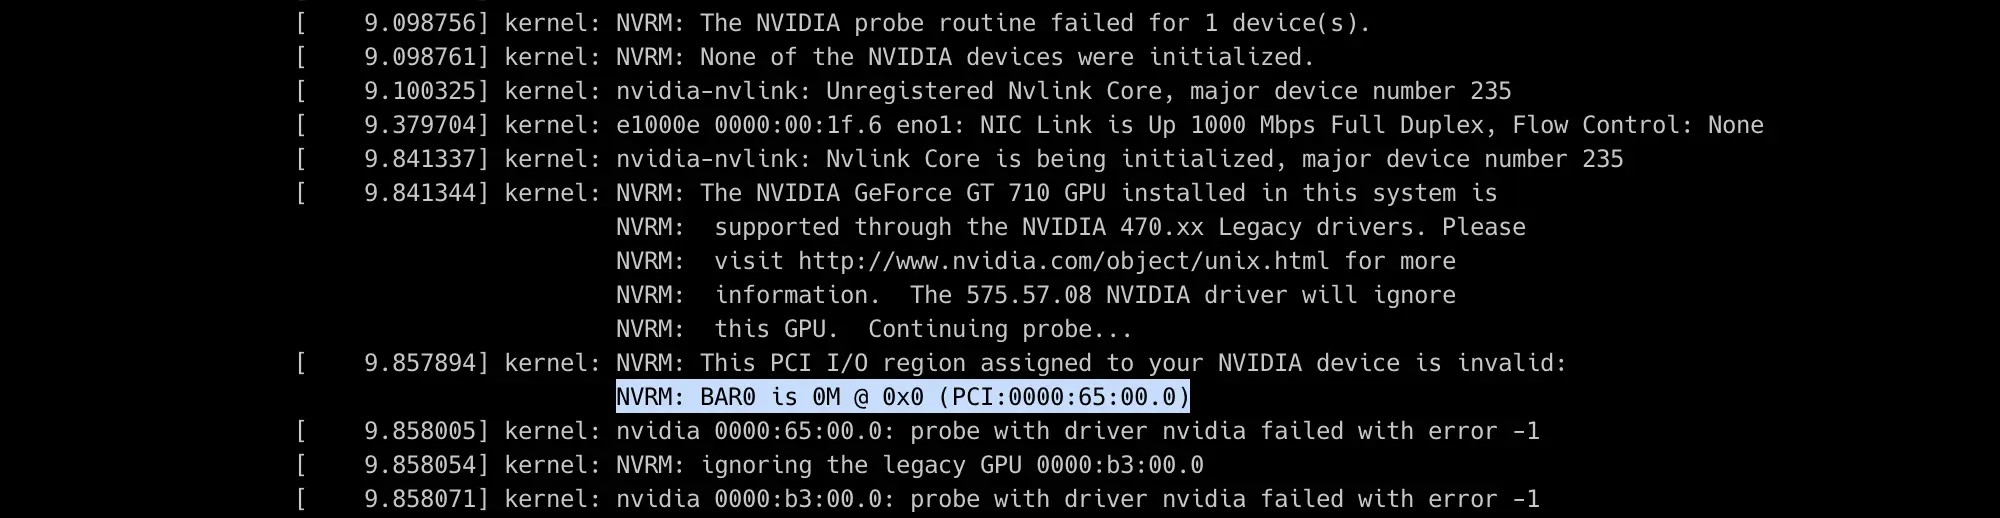
И, наконец,
Если это так, включите в БИОСе опцию RBAR (ReBAR, Resizeable BAR), а в параметры ядра добавьте опцию pci=realloc (последнее, возможно, не обязательно, но утверждать не берусь).