си
Defer в Си
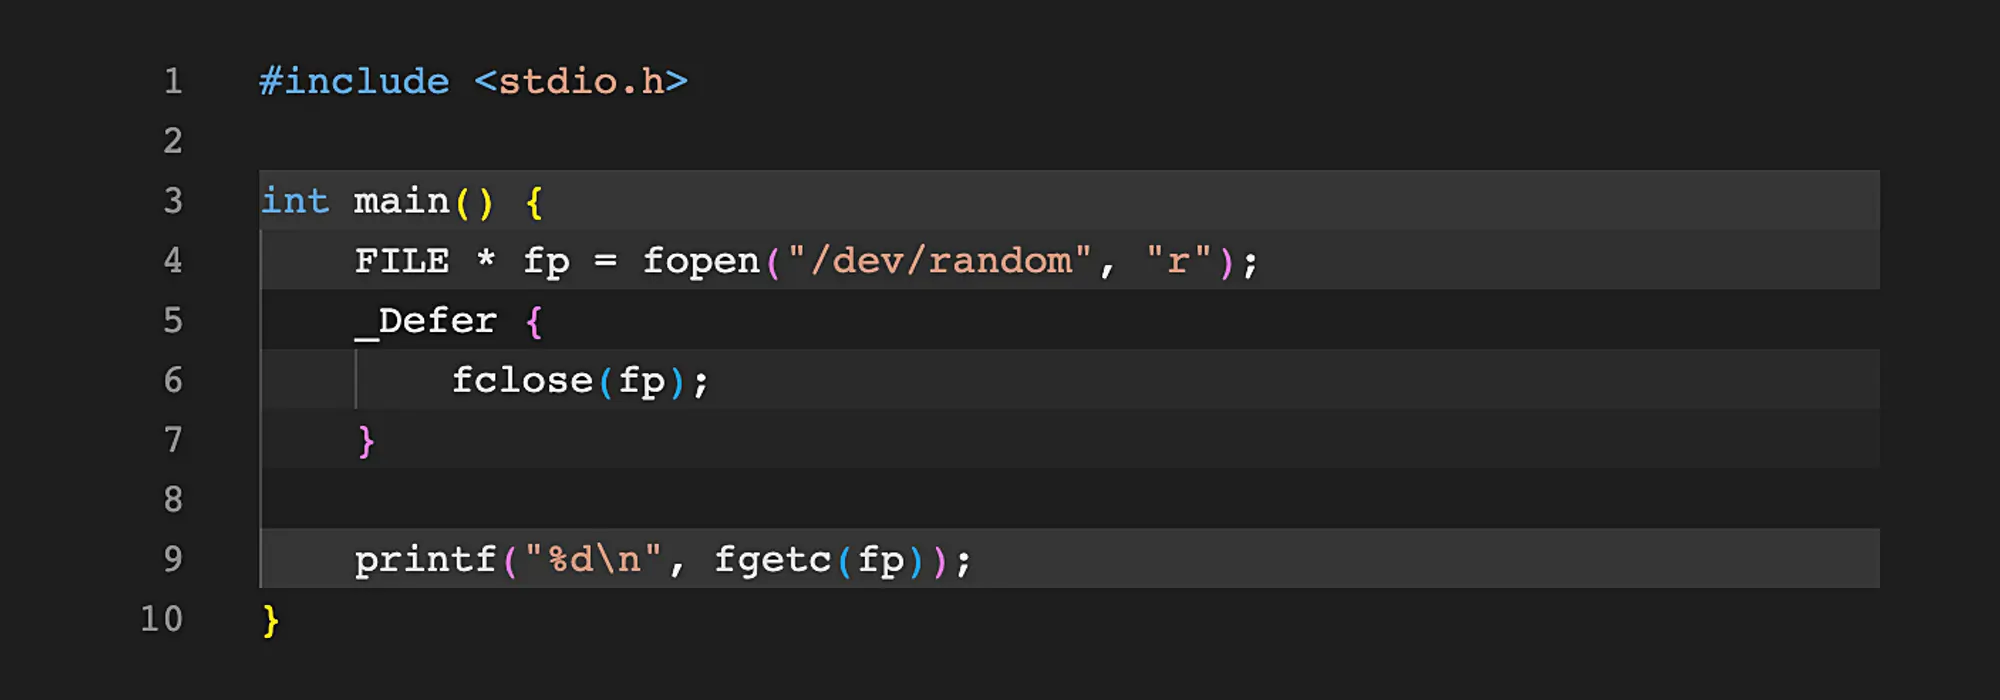
Мне очень нравится конструкция defer в «Гоу» — очень удобно для управления ресурсами, можно рядом с получением
Оказывается в прошлом году её предложили добавить и в Си (чему я очень рад, потому что в последнее время больше всего, пожалуй, пишу именно на нём),
Утилита cdecl
Какая интересная утилита есть, оказывается, а я и не знал! Позволяет по любой декларации типа в языке Си получить описание на английском или наоборот — свернуть такое описание в тип. Вот примеры:
cdecl> explain char *(* const volatile (*(*hydra)(int (*)(void), char * const * restrict))[13]) (unsigned long, char * const [static 3]);
declare hydra as pointer to function (pointer to function (void) returning integer, restricted pointer to constant pointer to character) returning pointer to array 13 of constant volatile pointer to function (unsigned long integer, non-empty array 3 of constant pointer to character) returning pointer to character

cdecl> declare fp as pointer to function (pointer to char) returning pointer to array of pointer to char
char* (*(*fp)(char*))[];Что происходит, когда main — переменная
Хочу провести работу над ошибками.
Вчера я писал о сбойной программе на Си с самым коротким текстом и, как оказалось, неправильно описал почему, собственно, она вызывает сбой.
Напомню, речь идёт о программе, которая состоит из одного слова — main; или int main;, если забыть о стандарте Си89. Я думал дело в том, что попытка запустить программу приходит к чтению переменной и передаче управления на адрес ноль, но один читателей попенял, что в оригинальной статье указана другая причина.
Я решил глянуть получившийся ассемблер, чтобы разобраться где же правда. Для этого удобно использовать утилиту objdump:
objdump -D -d -M intel ./smallОказалось, что я был неправ.
Чтобы это увидеть, надо посмотреть в ассемблерном листинге код, который вызывает функцию __libc_start_main() — она передаёт управление функции main(), указатель на которую указывается в регистре rdi. Как мы видим, адрес, записываемый в этот регистр указывает на секцию .data, код в которой запрещён к запуску, именно поэтому программа и падает.
Почему именно туда? Там хранятся все переменные, в том числе переменная main, то есть используется не адрес, записанный в этой переменной, как я думал раньше, а выполнение передаётся прямо на адрес, где хранится сама переменная.

Кстати, это означает, что на оборудовании, где защиты памяти нет или при запуске в реальном режиме (например,
Маленькая сбойная программа на Си
Попалась мне тут статья про задачку, которую автору задали в университете — написать самую маленькую (по объёму текста) программу на Си, которая компилируется, но выполняется с ошибкой. Прежде чем читать, я попробовал написать такую самостоятельно.
Сначала я подумал о рекурсии:
main(){main();}Для экономии байт можно использовать стандарт Си89, где всё, у чего нет при определении задания типа, имеет тип int — это позволяет убрать тип функции main.
Программа компилируется, но, как и задумывалось, падает с ошибкой:
bolk@note ~$ gcc-14 -std=c89 small.c && ./a.out
Segmentation fault: 11
Дальше я подумал, что вряд ли в статье используется такой очевидный способ и, перебрав в уме несколько вариантов, решил сосредоточится на делении на ноль. Лучший вариант, который мне пришёл в голову, вот такой, он на один байт меньше:
main(a){a/=0;}Очевидная идея — поделить число на ноль и никуда не присваивать, работать не будет, компилятор просто выкинет константное выражение. Поэтому его надо или присвоить переменной или вернуть. return занимает больше присваивания, но куда бы мы могли присвоить? Нужна же переменная.
Переменную можно взять из аргументов функции main, в первый её аргумент записывается число параметров при вызове. Если ноль поделить на ноль, это ошибки не вызовет, но там всегда не ноль, потому что нулевой параметр всегда существует и содержит имя программы.
Поэтому мы можем поделить его на ноль и программа упадёт при вызове:
bolk@note ~$ gcc-14 -std=c89 -Wno-div-by-zero small.c && ./a.out
Floating point exception: 8
Но самая короткая сбойная программа оказалась почти втрое меньше. Выглядит она так:
main;Она компилируется, хоть и с замечанием, и падает, как и требуется по условию:
bolk@note ~$ gcc-14 -std=c89 small.c && ./a.out
small.c:1:1: warning: data definition has no type or storage class
    1 | main;
      | ^~~~
Bus error: 10
Тут определяется статическая переменная main с неявным заданием типа int, которая, как все такие переменные, инициализируется нулём. Поскольку компоновщик видит имена, но ничего не знает о типах, он связывает адрес переменной с адресом точки входа в программу. Когда программа запускается, управление передаётся по адресу ноль, что вызывает ошибку.
Ошибка вызывается, кстати, потому что адрес ноль является зарезервированным значением в Си. Ноль обозначает, что указатель пустой (имеет значение NULL), поэтому при обращении к нему срабатывает специальная ловушка, вызывающая ошибку. Правда это возможно только на платформах с защитой памяти.
Добавлено: Оказалось, что я неправильно разобрался в происходящем.
Поправил ошибку в bc
Вчера часа проснулся около часа ночи, сна ни в одном глазу.
Бродил по коду
for (i = 0; i < f->autos.len; ++i)
{
	// Get the auto.
	BcAuto* aptr = bc_vec_item(&f->autos, i);

	// If they match, barf.
	if (BC_ERR(idx == aptr->idx && type == aptr->type))
	{
		const char* array = type == BC_TYPE_ARRAY ? "[]" : "";

		bc_error(BC_ERR_PARSE_DUP_LOCAL, line, name, array);
	}
}
Посмотрел что тут происходит и заметил, что в перечислении, описывающем виды параметров,
define a(*t[], t[]) {}Подумал, что уже достаточно утомился, чтобы лечь спать,
Уже утром я прочитал сообщение по моему коммиту — автор bc попросил отформатировать код и написать небольшой тест. Я всё исправил и теперь ещё немного моего кода есть в этой прекрасной утилите!
Throttling game
В полку́ странных игр прибыло! Помните я писал игру, где надо управлять человечком, подключая и отключая зарядку «Макбука»? Вчера вечером написал небольшую игру из той же оперы.
Фабула игры такова: у одного из блоков атомной электростанции сработала система предупреждения — все три уровня защиты вырубились, теперь управлять реактором нужно вручную. График загрузки процессора символизирует температуру внутри блока — много плохо, мало — тоже плохо.
Чтобы поиграть в эту игру, надо открыть рядом «Монитор ресурсов» и вывести график загрузки процессоров. Частоту обновления («Вид» → «Частота обновления») надо поставить «Очень часто».
После этого можно запустить игру и, управляя загрузкой процессора через клавишу «Касплок» («капс» включен — процессор загружен), держать загрузку между 10 и 90%. После старта у вас будет четыре секунды, чтобы подготовиться, вывести все нужные окна на передний план и нащупать кнопку.
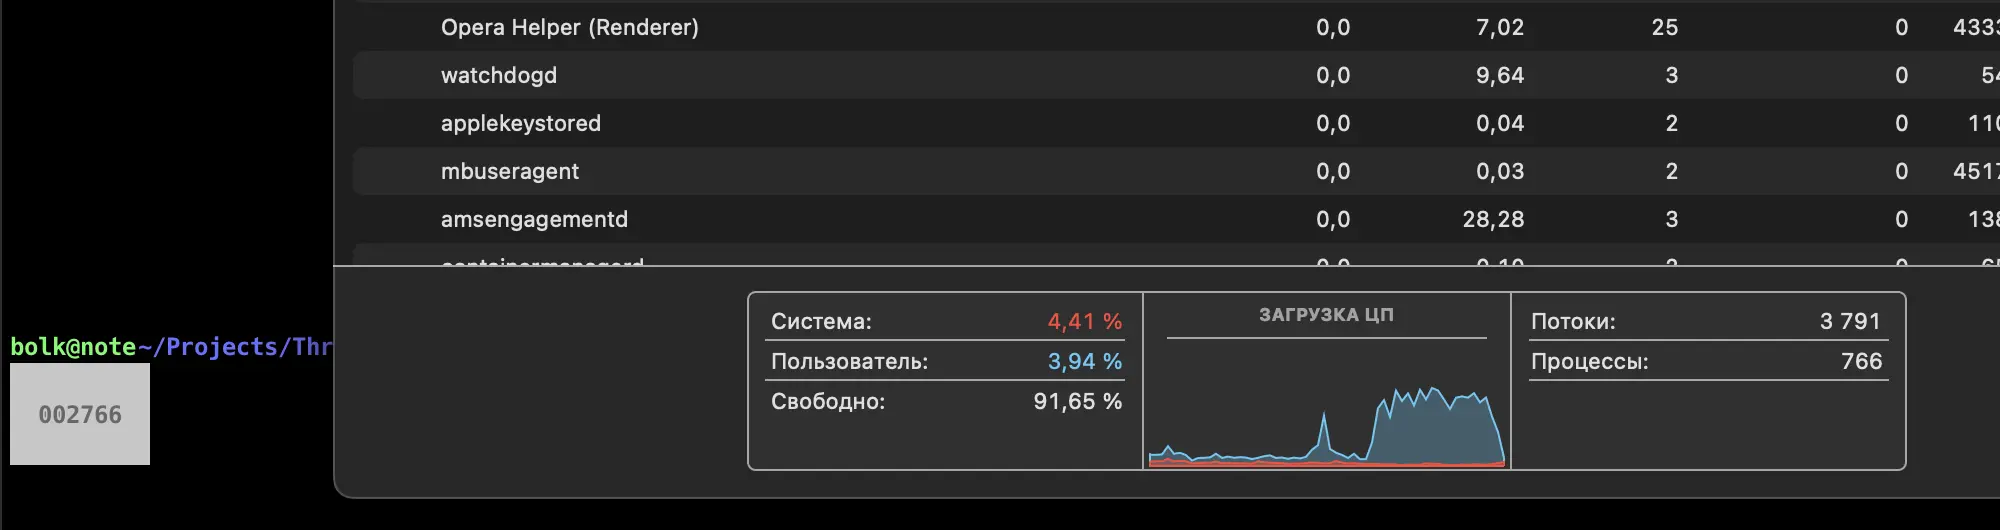
На идею меня навела бессмертная игра «Посадка на Луну» для калькулятора «Электроника
Код игрушки лежит в моём репозитории.
Нечётные числа: uint32_t
В программе есть место жёстко завязанное на тип, — печать числа, а мне хотелось сделать так, чтобы при смене типа ничего не ломалось. Поэтому я решить попробовать обобщённое программирование. Его в Си мне использовать ещё не приходилось, вот и выпал случай.
Заодно попробовал в действии функции __builtin_*_overflow, позволяющие использовать математику с контролем переполнения. Я только недавно задумался о том, что они должны бы быть в языке, а до этого переполнение я проверял дедовским способом — смотрел не стал ли результат меньше аргумента.
Обобщённое программирование выглядит следующим образом:
#define PRINT_U(x) ({ \
    _Generic((x), \
        uint128_t: printf_u128, \
        uint64_t: printf_u64, \
        uint32_t: printf_u32 \
    ); \
})(x)
Тут у меня макрос PRINT_U зависит от типа аргумента, а выбор делается при помощи стандартной конструкции _Generic — она принимает аргумент и, в зависимости от того выражение какого типа было передано, возвращает одно значение из указанного списка.
static void printf_u128(const uint128_t v) {
    unsigned long long low, high;

    #if __BYTE_ORDER__ == __ORDER_LITTLE_ENDIAN__
        low  = MASK64(v);
        high = MASK64(v >> 64);
    #else
        high = MASK64(v);
        low  = MASK64(v >> 64);
    #endif

    printf("0x%016llX%016llX\n", high, low);
    fflush(stdout);
}

static inline void printf_u64(const unsigned long long v) {
    printf("0x%016llX\n", v);
    fflush(stdout);
}

static inline void printf_u32(const unsigned int v) {
    printf("0x%08X\n", v);
    fflush(stdout);
}
Пока отлаживал, нашёл пару досадных багов в исходной программе. Получается, зря мой ноутбук трудился, результат всё равно можно было бы выкинуть.
Функции переполнения у меня используются вот так:
#define MUL2_ADD1(x) ({ \
    typeof(x) y; \
    __builtin_mul_overflow(x, 2, &y) || __builtin_add_overflow(y, 1, &y) ? 0 : y; \
})
Были сомнения будут ли они работать
Любопытно, что мой ноутбук на процессоре M3 Max справился с перебором за 57 минут, тогда как компьютер с Intel Core
В результате нашлось 14434686 значений, из них нечётных подряд — 172 значения, потом появляются «дырки».
Нечётные числа
Что же я там считаю такое, что мне понадобились
Коллега в офисе, который
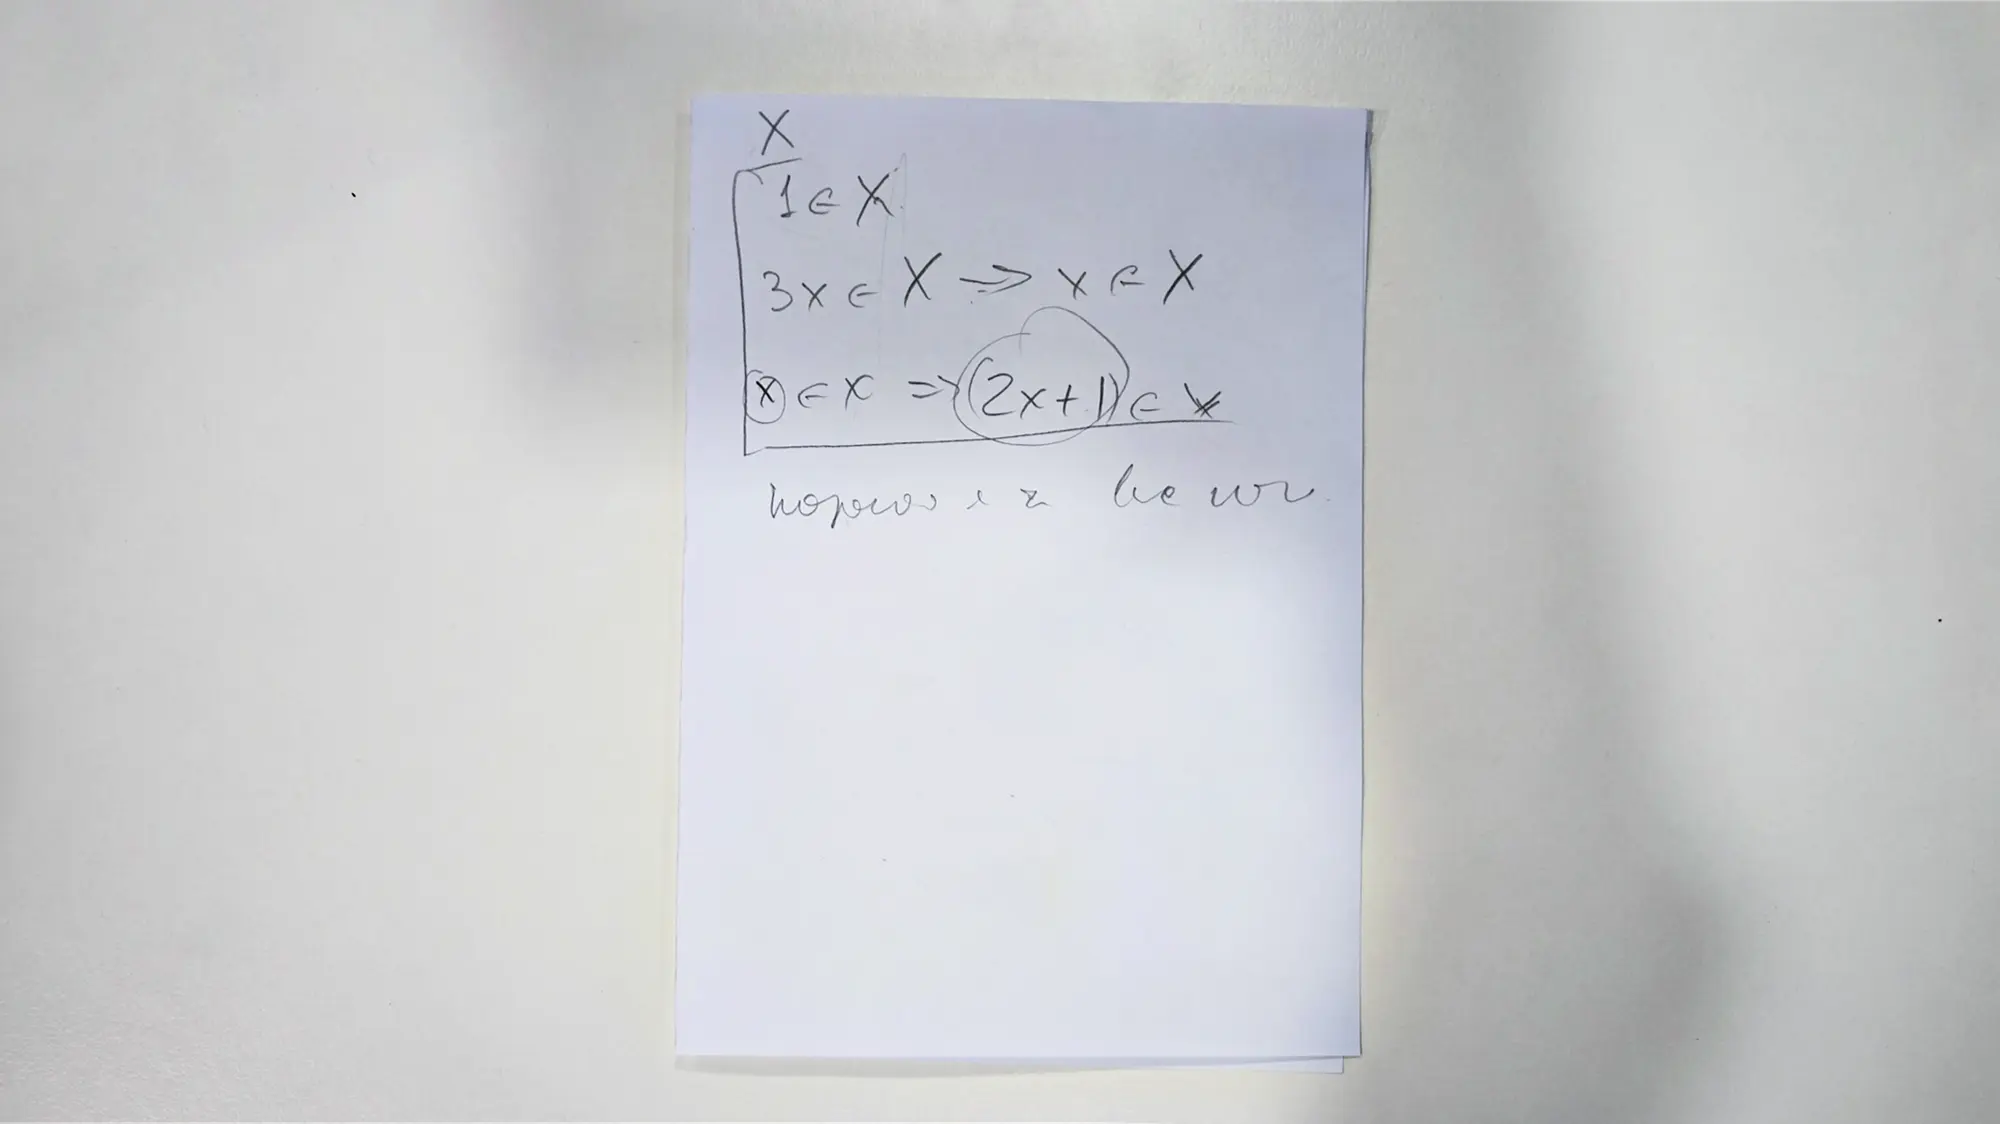
Формулировка у неё была очень простая.
Дано множество X. Единица принадлежит X. Если 3×x принадлежит X, то и x принадлежит X. Если x принадлежит X, то и 2×x + 1 принадлежит X. При этом x — натуральное, разумеется.
Требуется доказать, что таким образом можно получить множество всех натуральных нечётных чисел. Авторы статьи, кстати, были убеждены, что найти доказательство у читателей не получится.
Упомянутый коллега у себя в университете при помощи студента, Фортрана и Пролога пытался проверить эту теорему по следующему алгоритму.
Берём число, например, «9». Оно могло быть получено, согласно перечисленным утверждениям, двумя путями: либо
В этой задаче очень быстро растёт разрядность, поэтому в те времена рассчитать даже первую сотню чисел было достаточно проблематично.
В общем, я решил с этой задачкой побаловаться.
Для начала написал программу, которая вычисляет эти числа перебором. Начинаем, понятное дело, с единицы, следующее число получаем по формуле 2×x + 1, потом, пока число делится на три, делим и выводим эти числа, считая для каждого ещё и 2×x + 1 и так далее. Кроме того, пришлось ещё запоминать все найденные числа, чтобы избегать циклов.
Первую версию я написал с использованием рекурсии, но программа падала примерно через полторы минуты работы — стек просто кончался. Пришлось переписать. Новая версия работает уже несколько часов на моём ноутбуке и вычислила за это время уже почти 17 миллионов чисел. Оставлю её на ночь, интересно, закончит ли она к утру.
128-битный тип в Си
В одной из программ на Си мне понадобился
Мой компилятор _BitInt(128) прекрасно поддерживает, казалось — счастье так близко, но…
Каково же было моё удивление и разочарование, когда оказалось, что в языке нет ни способа вывести его на экран (у printf нет необходимого спецификатора формата), ни способа задать константу такого размера!
( (_BitInt(128) ) 0xFFFFFFFFFFFFFFFF << 64) | 0xFFFFFFFFFFFFFFFF
PowerShoot

Ну
Играть, правда, получится только на «МакБуке». Думаю, несложно будет адаптировать игру под терминал любой операционной системы, было бы желание.
Геймплей простой — на вас бегут враги, надо убивать их бомбами. Игрок бросает бомбу, когда «МакБук» подключается к зарядке. Чтобы бросить две бомбы, надо подключить его, потом отключить, потом снова подключить.
Врагов больше двух не бывает, но сложность в том, что игра реагирует на подключение зарядки с задержкой. Кроме того, можно в теории убиться собственной бомбой — пространство зациклено.
Добавлено: как справедливо заметил один из читателей, такие действия могут влиять на оставшееся количество циклов зарядки батареи ноутбука, но прошу не относиться к этой игре серьёзно, она, конечно же, сделана была в шутку, чтобы развеяться.
Си 23
Посмотрел список изменений, в глаза мне бросилось следующее.
Удалили старый синтаксис функций, где можно было описывать типы аргументов после определения функций. А я про него и
Атрибуты функций можно теперь писать в синтаксисе Си++, то есть в виде [[атрибут]]. Это очень хорошо. Так они лучше различимы, в отличие от спецификаторов, и имеют собственное пространство имён.
Изменили действие ключевого слова auto. В Си оно обозначало класс хранения, причём
Функции с пустым списком аргументов будут обрабатываться, как функции без аргументов. Это тоже хорошо, потому что раньше было неочевидно. В своё время для меня открытием было, что функции без аргументов должны в Си задаваться через синтаксис func(void), правда я в коде так всё равно не делаю.
Прекращена поддержка триграфов. Это, конечно, хорошо, но жалко. Речь идёт об альтернативных конструкциях в языке, которые были введены
Добавили конструкцию #embed, которая позволяет включать в код бинарные данные. Тоже здорово, в игре «Морской бой», выпущенной ко Дню радио мне пришлось включать игру на Луа внутрь сишного кода внешними утилитами, а теперь можно это делать одной директивой.
Остальные изменения тоже полезны, буду знакомиться, но эмоционального отклика не вызвали.
99 бутылок: препроцессор Си
Те программисты, кто
С тех пор как мне много лет назад
80. Препроцессор Си, разумеется, не задумывался как
Изучение этих материалов было не только для меня интересным делом, но и полезным — я лучше понял как работает препроцессор в Си, а так же узнал
Вопреки обыкновению, вывод программы я обрабатываю другой утилитой (см. строку запуска). Это приходится делать, так как в этом языке нет простого способа вывести перевод строки. Можно было бы сделать это ANSI-кодами, но их не будет видно в листинге кода, что меня не устраивает.
#if 0
Bolknote.ru, 2024.11.05
To run:
gcc -P -E - < 99 | sed 's/\\n */\n/g'
#endif

#define CAT(a, b) a##b
#define SECOND(a, b, ...) b
#define TEST(...) SECOND(__VA_ARGS__, 0)
#define LF \n

#define DEC(n) CAT(DEC_,n)
#define DEC_0 9
#define DEC_1 0
#define DEC_2 1
#define DEC_3 2
#define DEC_4 3
#define DEC_5 4
#define DEC_6 5
#define DEC_7 6
#define DEC_8 7
#define DEC_9 8

#define DEC_X0(a, b) IF_ELSE(ISZERO(b)) (DEC(a)) (a)

#define ISEND(a, b) TEST(ISEND_ ## a ## b)
#define ISEND_01 ,1

#define ISZERO(n) TEST(ISZERO_ ## n)
#define ISZERO_0 ,1

#define ISONE(n) TEST(ISONE_ ## n)
#define ISONE_1 ,1

#define IF_ELSE(b) CAT(IF_, b)
#define IF_0(i) ELSE_0
#define IF_1(i) i ELSE_1
#define ELSE_0(e) e
#define ELSE_1(e)

#define PLUR(n) IF_ELSE(ISONE(n)) (bottle) (bottles)

#define PRINT_PLUR(a, b) IF_ELSE(ISZERO(a)) (b PLUR(b)) (CAT(a, b) bottles)

#define PRINT_B(a, b) IF_ELSE(ISZERO(b)) \
        (IF_ELSE(ISZERO(a)) \
            (No bottles) \
            (PRINT_PLUR(a, b)) \
        ) \
        (PRINT_PLUR(a, b)) of beer

#define PRINT_ROW(a, b) \
    PRINT_B(a, b) on the wall, PRINT_B(a, b)! LF \
    Take on down, pass it around, LF \
    PRINT_B(DEC_X0(a, b), DEC(b))! LF LF


#define STOP(...) No more bottles of beer on the wall, LF \
No more bottles of beer! LF \
Go to the store and buy some more, LF \
PRINT_B(9, 9) on the wall!

#define EMPTY()
#define DEFER(...) __VA_ARGS__ EMPTY()

#define CROSS1(a, b) PRINT_ROW(a, b) \
    DEFER(IF_ELSE(ISEND(a, b)) (STOP) (CROSS2)) (DEC_X0(a, b), DEC(b))

#define CROSS2(a, b) PRINT_ROW(a, b) DEFER(CROSS1) (DEC_X0(a, b), DEC(b))

#define MUL0(...) MUL1(MUL1(MUL1(MUL1(__VA_ARGS__))))
#define MUL1(...) MUL2(MUL2(MUL2(MUL2(__VA_ARGS__))))
#define MUL2(...) MUL3(MUL3(MUL3(MUL3(MUL3(__VA_ARGS__)))))
#define MUL3(...) __VA_ARGS__

#define RUN(a, b) MUL0(CROSS1(a, b))

RUN(9, 9)Оператор «__has_include»
Одна штука мне очень не нравилась в программировании под «Флиппер». Фреймворк устроен так, что картинки, используемые в приложениях, должны внедряться определённым способом.
А именно — в манифесте приложения, в директиве fap_icon_assets мы указываем папку, каждая картинка в которой, позже, на этапе сборки, будет преобразована в специальный массив. Этот массив всегда называется I_имя_файла_картинки. Массивы засовываются в файл со специальным именем, который надо импортировать в код через #include.
Поскольку это происходит во время сборки, редактор (я использую «Визуал Студио Код») этот файл не видит, поэтому подчёркивает мне его импорт и все использования массивов, которые в нём описаны, как ошибку.
Лично меня такое раздражает. В редакторе мне хочется видеть полное отсутствие ошибок.
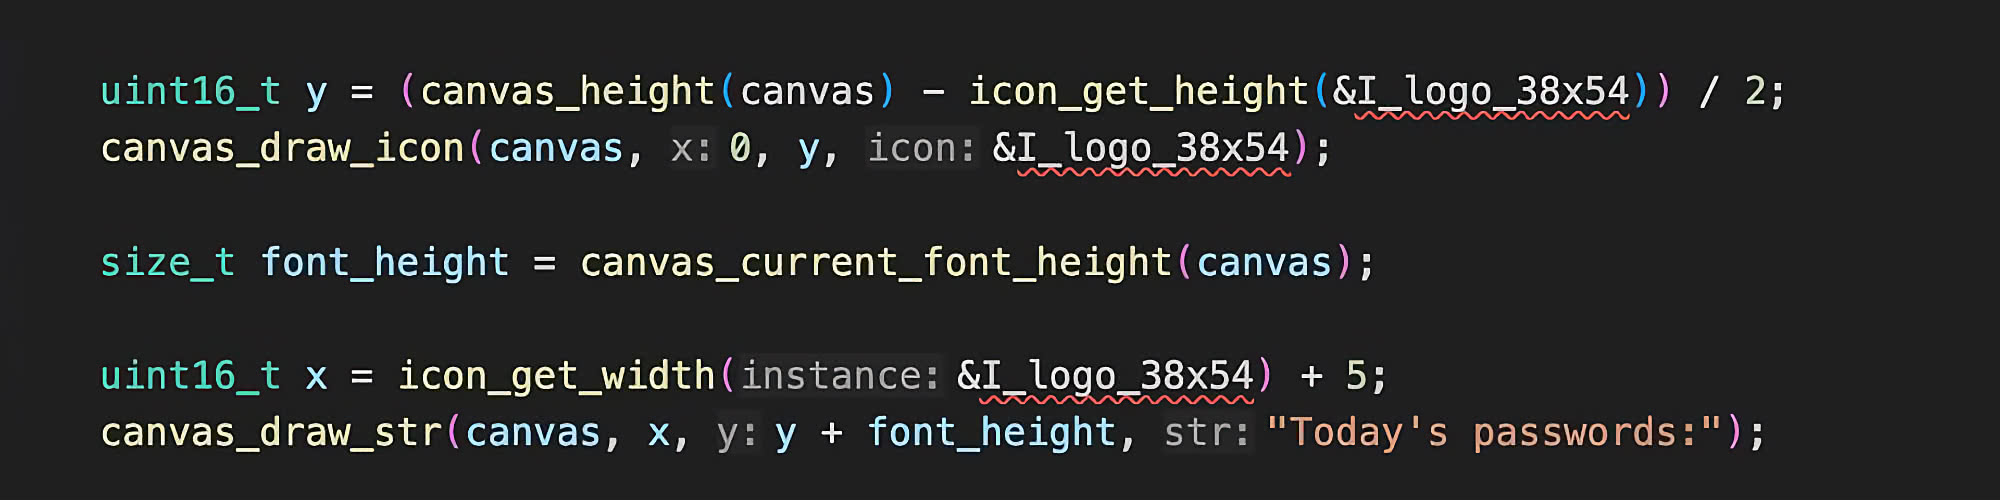
В «Виселице» я с этим смирился, а сегодня
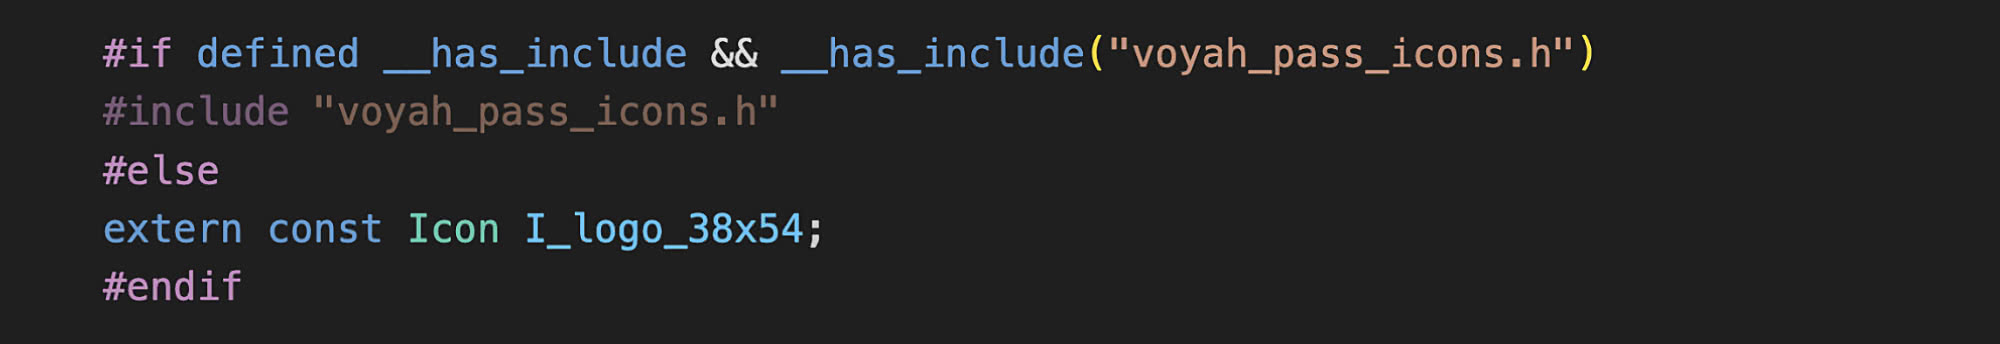
Получается, что если файл для импорта ещё не готов, то мы его не импортируем, а нужный нам массив объявляем, как имеющий внешнюю реализацию. В итоге, в редакторе ошибок не остаётся.
Конец ускоренной strlen на «Флиппере»
В итоге, эпопея с ускорением функции замера длины строки в кодировке
У меня с самого начала этой затеи были сомнения. Я понимал, что для того, чтобы решить
Тем не менее, я с удовольствием повозился инструкциями SIMD. До этого
Моя функция, кстати, претерпела некоторые изменения:
size_t furi_string_utf8_length(FuriString* str) {
    size_t len = string_size(str->string);
    const char * cstr = string_get_cstr(str->string);
    const char* end = cstr + len;

    if(len >= sizeof(uint8x4_t)) {
        const char* vend = end - sizeof(uint8x4_t);

        int8x4_t zero = 0x00000000;
        int8x4_t one = 0x01010101;
        int8x4_t threshold = -1077952577; // -65, -65, -65, -65

        do {
            int8x4_t vec = *(int8x4_t*)cstr;

            __ssub8(threshold, vec);
            uint8x4_t result = __sel(one, zero);

            len -= __usada8(result, zero, 0);

            cstr += sizeof(uint8x4_t);
        } while(cstr <= vend);
    }

    while(cstr < end) {
        signed char c = *cstr++;
        len -= c < -64;
    }

    return len;
}
Оказалось, что тип FuriString хранит в себе бинарную длину строки, поэтому я переделал код, чтобы он не пытался читать чужую память. В векторизованой части это было вероятно, но своих рассуждений и дискуссии по коммиту я сделал вывод, что в случае «Флиппера» это не имеет
Тем не менее, если использовать бинарную длину, код получается более аккуратным и немного упрощается, так что грех не воспользоваться. Интересно бы, кстати, измерить наивный алгоритм без векторной части, но с использованием бинарной длины, наверное займусь этим в ближайшее время.
В итоге, решая эту, возможно несуществующую, проблему, я опробовал на практике векторные инструкции расширений NEON и DSP SIMD, научился делать два параллельных запроса на вливание в «Гитхабе» и ещё раз вспомнил как компилировать и заливать свою прошивку во «Флиппер Зеро».
Замеры strlen_uft8 на «Флиппере Зеро»
Ну что же, я наконец сравнил свой вариант функции определения длины строки в кодировке
Оказалось, что обычные функции замера времени под «Флиппером» не работают. мне не удалось получить значение текущего времени ни одним из способов к которым я привык на Си, поэтому опять пришлось читать исходники прошивки «Флиппера».
В итоге обнаружился метод, выводящий затраченное время с секундной точностью:
FuriHalRtcDateTime curr_dt;
furi_hal_rtc_get_datetime(&curr_dt);
uint32_t start = furi_hal_rtc_datetime_to_timestamp(&curr_dt);

for (int i = 0; i<1000000; i++)
len += strlen_utf8("This is a test и русских букв тоже");

furi_hal_rtc_get_datetime(&curr_dt);
uint32_t stop = furi_hal_rtc_datetime_to_timestamp(&curr_dt);
Хотелось бы точнее, но этого, в принципе, хватает, чтобы понять какая функция быстрее и на сколько. Надо просто сделать очень много итераций. Я попробовал запускать на миллионе и десяти миллионах.
В итоге, на десяти миллионах наивная реализация выполняется примерно за 80 секунд, моя и чужая быстрая — около 50, явного лидера из этих двух реализаций выделить не удалось. Все замеры делал несколько раз.
DSP SIMD для Flipper Zero
В этом версии нет никакой защиты цикла от чтения за границей буфера, мне показалось, что во «Флиппере» это неважно, но возможно это не так.
Ну что ж, разобрался я что за зверь такой этот DSP SIMD и запрограммировал на нём векторизированную версию функции для измерения длины строки.
Сегодня описывать и замерять уже не буду, и так времени много ушло, но по крайней мере всё работает на настоящем «Флиппере».
Сразу можно заметить, что вектора тут вдвое короче — всего четыре байта, да и функций для работы с ними гораздо меньше, но этого набора оказалось достаточно, чтобы всё векторизовать.
#include <arm_acle.h>

size_t strlen_arm_utf8(char * str) {
    uint32_t len = 0;
    int8x4_t zero = 0x00000000;
    int8x4_t one  = 0x01010101;
    int8x4_t threshold = -1077952577; // -65, -65, -65, -65

    for (;;) {
        uint8x4_t result;
        int8x4_t vec = *(int8x4_t *) str;

        __uadd8(0xFFFFFFFF, vec); result = __sel(zero, one);
        if (result > 0) {
            if (result == 0x01000000) {
                __ssub8(threshold, vec); result = __sel(zero, one);
                return __usada8(result, 1, len);
            }
            break;
        }

        __ssub8(threshold, vec); result = __sel(zero, one);
        len = __usada8(result, zero, len);

        str += sizeof(uint8x4_t);
    }

    for (signed char c; (c = *str); str++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}ARM бывают разные
Преодолев внутреннее сопротивление, я
Во «Флиппере» стоит процессор ARM, а они, как оказалось, бывают очень разные.
Я ещё в самом начале посмотрел спецификацию процессора «Флиппера» и, увидев слово SIMD, совершенно успокоился — в моём понимании это означало, что я могу использовать любые команды векторизации, которые мне необходимы. Тут я немного поторопился, но меня подгоняло желание разобраться как устроена векторизация. Теорию я знал, а тут подвернулась, пусть немного синтетическая, но задача, которую руки чесались решить.
Как я уже говорил, мне захотелось срезать углы, поэтому функцию до этого момента я писал на своём ноутбуке, раз так случилось, что у меня на нём тоже процессор ARM. И лишь сегодня я попробовал вставить её в одну из своих программ и собрать её для «Флиппера».
Сначала компилятор заявил мне, что не нашёл некоторые векторные функции, в частности функцию нахождения минимума vminvq_u8 и суммы vaddvq_u8.
Ветку с vminvq_u8 я временно убрал, а функцию суммы vaddvq_u8 решил заменить на поэлементное сложение (vaddq_u8), которая, вроде, компилятору знакома.
Мысль простая — в векторах, сумму которых мы находим, на каждой позиции нули и единицы, поскольку каждый элемент вектора у нас восьмибитный, в общем случае у нас поместится результат 255 операций, а потом я могу просто просуммировать элементы циклом.
uint8x16_t len_v = vdupq_n_u8(0);
int reset = 0;

// тут у нас цикл
uint8x16_t gt = vcgtq_s8(operand, threshold);
len_v = vaddq_u8(vandq_u8(gt, delta), len_v);

if (++reset >= 255) {
    for (size_t i = 0; i < sizeof(uint8x16_t); i++) {
        len += *((uint8_t *)&len_v + i);
    }

    reset = 0;
    len_v = vdupq_n_u8(0);
}
Я был очень доволен решением (оно не совсем моё, его мне навеял код, используемый в PHP), но оказалось, что оно тоже не компилируется.
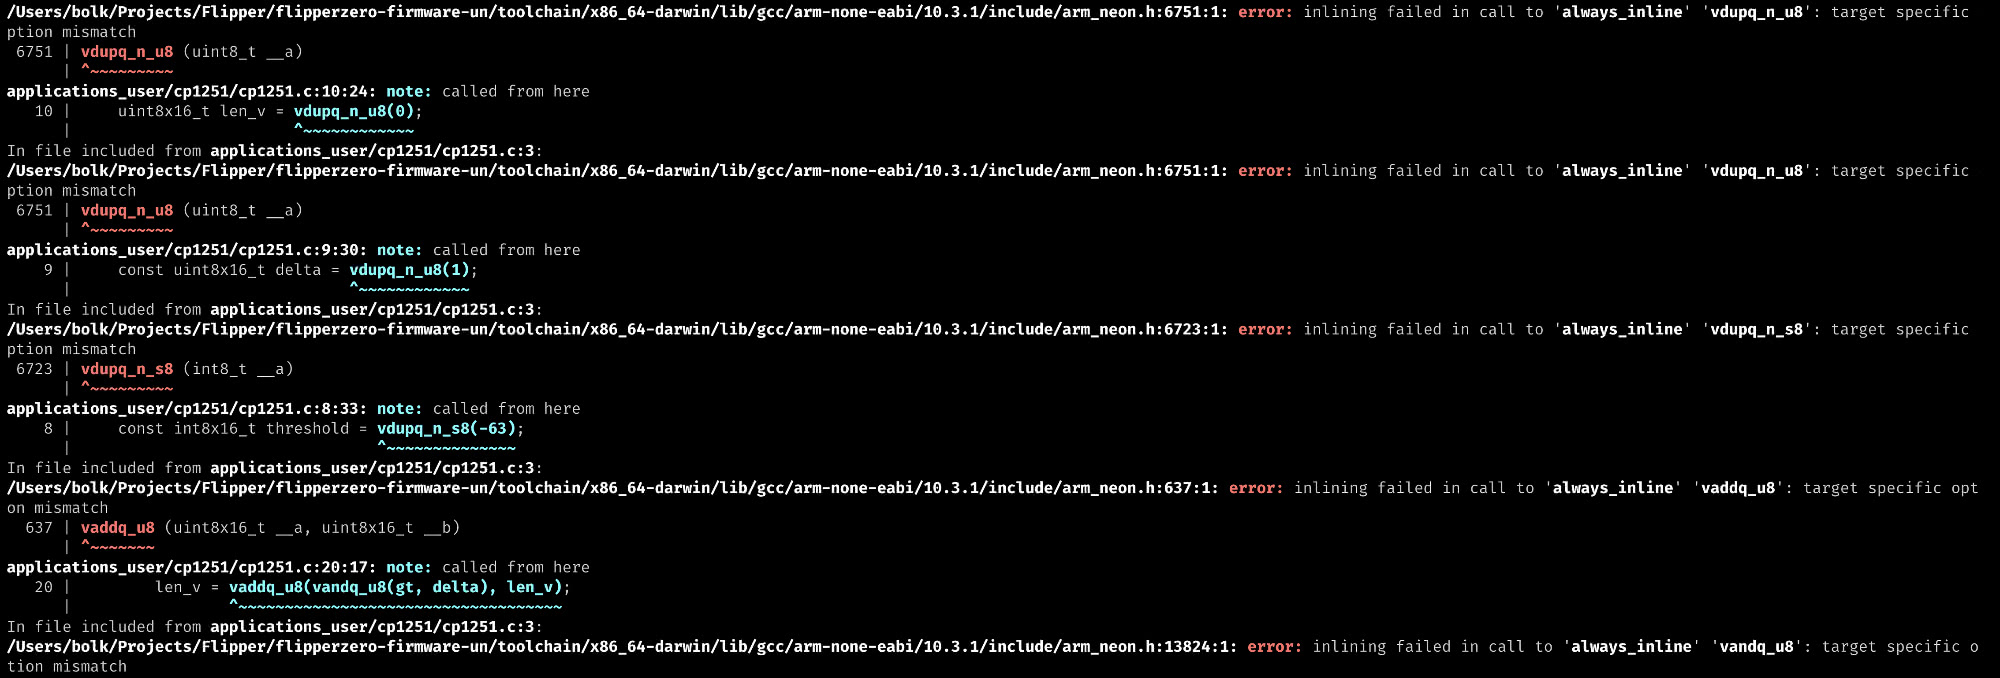
Сборка заругалась на ошибку target specific option mismatch, означающую, что указанное при компиляции железо не поддерживает те возможности, которые я пытаюсь использовать в коде. Пришлось лезть в тулчейн, чтобы разобраться какие ключи компиляции сейчас используются.
В файле compile_commands.json можно увидеть, что при сборке используется ключ -mfpu=fpv4-sp-d16, тогда как мне, чтобы использовать нужные команды векторизации нужен ключ -mfpu=neon.
Так как ключи компиляции указывали разработчики «Флиппера», думаю, они в точности знали в какие значения их выставить. Согласно спецификации на борту использованного во «Флиппере» процессора SIMD есть, но, видимо,
Чуть более быстрый подсчёт длины строки в UTF-8
Сегодня очень плохо спал — всё время просыпался, потом долго ворочался, не мог уснуть. Утром оказалось мозг никак не мог успокоиться после вчерашней заметки про разбор быстрого алгоритма для подсчёта длины строки в
Вчера я остановился на том, что у разбираемого способа есть две очевидные недоработки — ненужное вычисление, которое решается инвертированием условия и подсчёт «хвоста», который всегда вычисляется «классическим» способом — без векторизации, хотя если строка у нас кратна вектору, можно было бы этого избежать.
Первый недостаток исправлялся очень просто, а хорошая реализация второй проверки мне вчера в голову не пришла.
Зато, когда я проснулся, она уже была у меня в голове. Всего три операции — первой получаем вектор, где на позициях с ненулевым байтом записывается 255, потом делается операция «И» с номерами позиций и весь вектор суммируется.
В итоге, если ноль стоит в векторе только на крайней правой позиции, у нас получается сумма арифметической прогрессии без последнего элемента.
По замерам такой вариант чуть быстрее.
size_t strlen_utf8(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-63);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            uint8x16_t pos = {1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16};
            uint8_t sum = vaddvq_u8(vandq_u8(vtstq_u8(operand, operand), pos));

            // арифметическая прогрессия без последнего члена
            if (sum == 16*(16+1) / 2 - 16) {
                uint8x16_t gt = vcgtq_s8(operand, threshold);
                return len + vaddvq_u8(vandq_u8(gt, delta)) - 1;
            } else {
                break;
            }
        }

        uint8x16_t gt = vcgtq_s8(operand, threshold);
        len += vaddvq_u8(vandq_u8(gt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Разбор быстрого подсчёта длины строки в UTF-8
Давайте попробуем
Напомню как выглядел код:
size_t strlen_php(unsigned char * p) {
    size_t len = 0;

    const int8x16_t threshold = vdupq_n_s8(-64);
    const uint8x16_t delta = vdupq_n_u8(1);

    for(;;) {
        int8x16_t operand = vld1q_s8((const int8_t * ) p);
        if (vminvq_u8(operand) == 0) {
            break;
        }

        uint8x16_t lt = vcltq_s8(operand, threshold);
        len += sizeof(uint8x16_t) - vaddvq_u8(vandq_u8(lt, delta));
        p += sizeof(uint8x16_t);
    }

    for (signed char c; (c = *p); p++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}
Для ускорения подсчёта в алгоритме используется векторизация, — это когда мы работаем с пачкой чисел, делая над каждым из них
Вектор загружается функцией vld1q_s8, где коды символов считываются по адресу, записанному в указателе p. В дальнейшем мы будем его сдвигать на размер вектора, чтобы забирать следующую пачку данных.
Ниже используется функция vminvq_u8, которая вычисляет минимальное значение в векторе, рассматривая его как набор байтов без знака. Если там ноль, значит строка кончилась и в нашем векторе — хвост, который надо досчитать обычным способом, без вектора. Тут можно было бы проверить на какой позиции слева находится признак конца строки, если на самой последней, то строка была кратна вектору. Но я не стал заморачиваться. Но такая проверка оказалась медленнее подсчёта длины хвоста обычным способом.
Дальше функция vcltq_s8 сравнивает каждый байт в векторе со значением −64 — это значение загружается в каждый элемент вектора для сравнения функцией vdupq_n_s8.
Результирующий вектор заполняется значениями 0 или 255, в зависимости от результата сравнения. Функция vandq_u8 производит операцию «И» с единицей, после чего у нас в векторе ноль остаётся неизменным, а 255 превращается в единицу. Эти единицы мы суммируем функцией vaddvq_u8.
Теперь у нас получился вектор, в котором подсчитаны все внутренние байты символов, а чтобы подсчитать внешние, надо вычесть это число из длины вектора. Правильнее было бы инвертировать сравнение, до этого в разгаре экспериментов просто не дошли руки.
Полученное число мы добавляем к вычисляемой длине и сдвигаем указатель. В конце досчитываем хвост обычным циклом. Конец алгоритма.
Определяем границу символа в UTF-8
В Телеграме попросили рассказать как работает код, который я приводил вчера в заметке про ускорение функции, возвращающей количество символов в строке с кодировкой
Там действительно есть что рассказать, но рассказ придётся разбить на несколько частей. Я постараюсь по возможности не погружаться в дебри. В этой части начну с того, что расскажу чем вообще необычна эта кодировка.
Все кодировки условно можно разделить на две части: кодирующие символ фиксированным или переменным количеством байт. К первым можно отнести, например, CP1251,
Справедливости ради, есть и другие виды кодирования, но нам их рассматривать ни к чему.
Тут важно то, что для строки в
Посмотрим на картинку из «Википедии», которая показывает как устроена эта кодировка:

Тут нам интересна только колонка «шаблон», где видно, что все «внутренние» байты символов начинаются с одной и той же сигнатуры — старший бит установлен, младшие — сброшены.
То есть, байты в диапазоне от 10000000 до 10111111 (в бинарном представлении) — внутренние байты, остальные — начало символа. Опять же, согласно таблице начала попадают в диапазоны 00000000-01111111 и от 11000000 до 11011111.
Умные люди заметили одну закономерность, сейчас мы её тоже увидим. Давайте напишем небольшую программу:
#include <stdio.h>

int main() {
    const signed char arr[] = {
        0b10000000, 0b10111111, 0b00000000, 0b01111111, 0b11000000, 0b11011111
    };

    for (int i = 0; i < sizeof(arr) / sizeof(arr[0]); i++) {
        for (int b = 128; b; b >>= 1) {
            printf("%d", (arr[b] & i) > 0);
        }

        printf(" % d\n", arr[i]);
    }
}
Вот что она выводит (диапазон, в котором находятся внутренние байты, я выделил другим цветом):
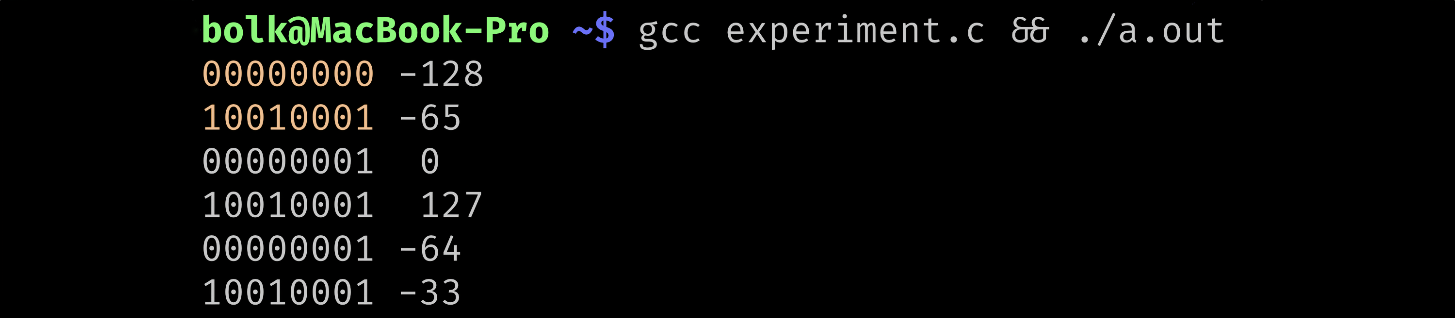
Закономерность в том, что все внутренние байты в знаковом представлении по значению меньше −64. Это довольно дешёвая проверка с точки зрения машинного кода, что очень хорошо, так как наша цель — производительность.
Про остальное — в следующий раз.