bc
ИИ: поиск ошибок в bc
Много наслышан о том, что сейчас некоторые проекты с открытым кодом переживают настоящий шквал заявок от вайбкодеров, едва отбиваясь от некачественного кода и исправлений несуществующих проблем. Впрочем, есть и положительный опыт — я встречал несколько новостей о том, что искусственный интеллект успешно нашёл и исправил
Очень интересно стало — а как ИИ вообще ищет такие проблемы? Ведь все взаимосвязи в коде он, в силу известных ограничений, просмотреть не может, может речь
Поэтому решил посмотреть как будет действовать нейросеть «Опус 4.6» на хорошо знакомом мне проекте — калькуляторе bc, работающем в командной строке. Я выбрал версию для «Линукса», так как там меньше кода.
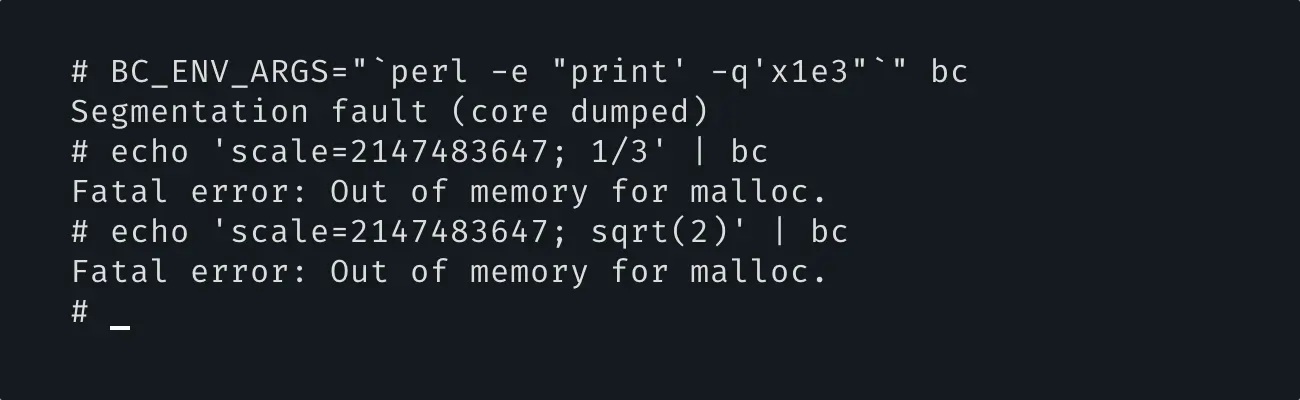
Я написал небольшой промпт, в котором попросил найти мне переполнения стека, ошибки выделения и памяти и прочие проблемы, характерные для программ на Си. Что интересно, такие проблемы нашлись! Но как же «Опус» это сделал?
Ларчик открывался просто — нейросетка подключила к проекту ASan и UBSan — стандартные инструмент для поиска ошибок работы с памятью, знаковых переполнений, деления и ноль и так далее, а после проанализировала их вывод. Никаких чудес.
Ковыряю bc
Ковырял сегодня bc на досуге, ту версию, которая помощнее.
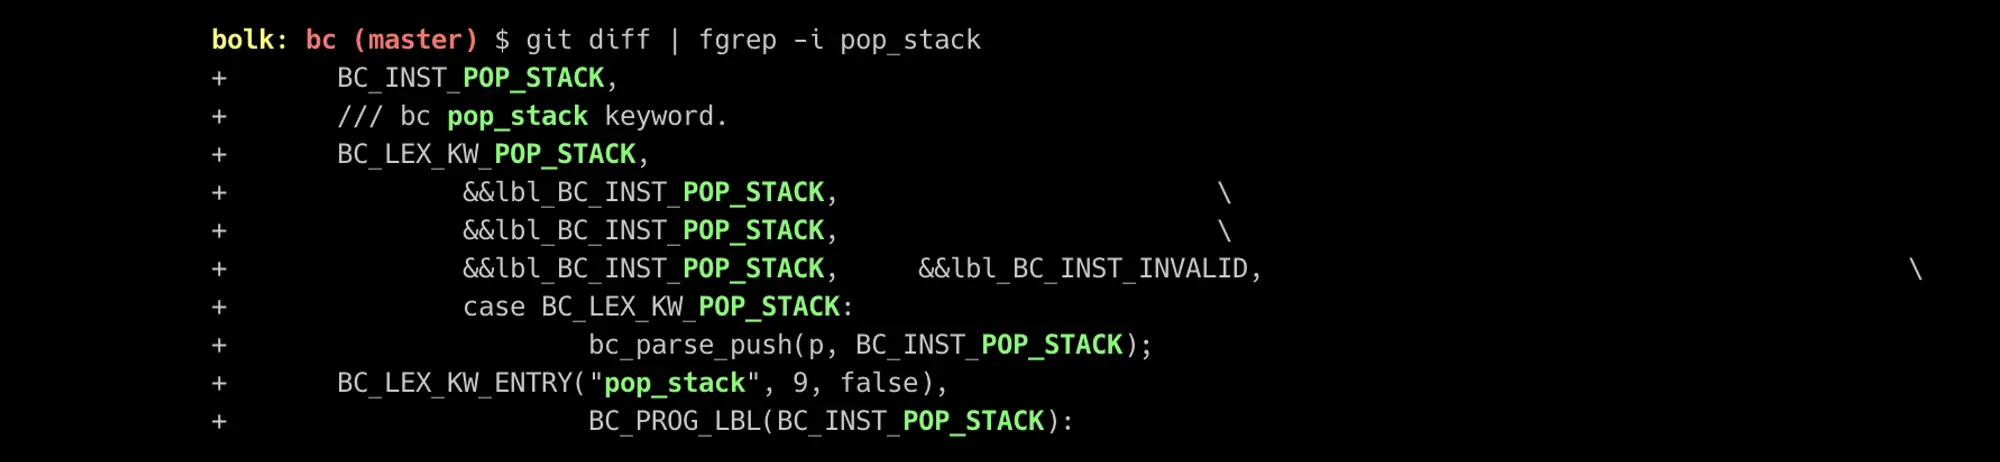
На скриншоте — количество мест, в которые пришлось её прописать. И только в одном из этих мест хранится её реализация. Взял за образец другие объявленные функции, поэтому не имею не малейшего понятия почему так много где пришлось её прописывать, не успел разобраться.
Лучше расскажу что именно я придумал добавить в язык. В bc есть несколько глобальных переменных, которые очень много на что влияют. Две, наверное, самые важные — это ibase и scale. Очень часто их приходится сохранять в начале и восстанавливать в конце своих функций, особенно библиотечных.
У более продвинутого bc есть специальный ключ, который, если его указать, меняет это поведение — при входе в каждую функцию значения этих и других глобальных переменных будут записываться в специальный стек, а на выходе — восстанавливаться оттуда.
Но библиотечные функции, всё одно, пишут, для универсальности, не рассчитывая на то, что этот флаг установлен. Вот, например, библиотечная функция косинуса:
define c(x){
    auto b,s
    b=ibase
    ibase=A
    s=scale
    scale*=1.2
    x=s(2*a(1)+x)
    scale=s
    ibase=b
    return(x/1)
}
Вот я и подумал, чтобы бы неплохо придумать директиву, при указании которой такой стек, для помеченной ею функции, всегда включался бы; а кроме того, была бы полезна функция, которая восстановила бы значения глобальных переменных ещё до выхода из функции. Иногда это необходимо, чтобы вернуть число в соответствии с установленными в них параметрами.
Функция косинуса с этими новыми возможностями выглядела бы так:
define stack c(x){
    ibase=A
    scale*=1.2
    x=s(2*a(1)+x)
    pop_stack()
    return(x/1)
}
Завтра ещё потестирую и попробую закинуть код автору bc, вдруг понравится изменение.
Добавлено позднее: Автор bc написал, что идея у меня интересная, но его жизнь серьёзно изменилась и теперь он не будет заниматься проектом бесплатно. Видимо крепко его прижало. Учитывая низкую популярность bc, можно сказать, что этот проект умер, если у него не найдётся новый мантейнер, что маловероятно.
Недокументированные возможности bc
У той версии утилиты bc, которая является частью проекта GNU, есть ряд недокументированных возможностей, про которые я узнал, исследуя её исходный код.
Я уже писал про недокументированную и сломанную функцию random(), которая починена в новой версии моими усилиями. Но кроме этого, есть ещё две вещи отсутствующие в документации.
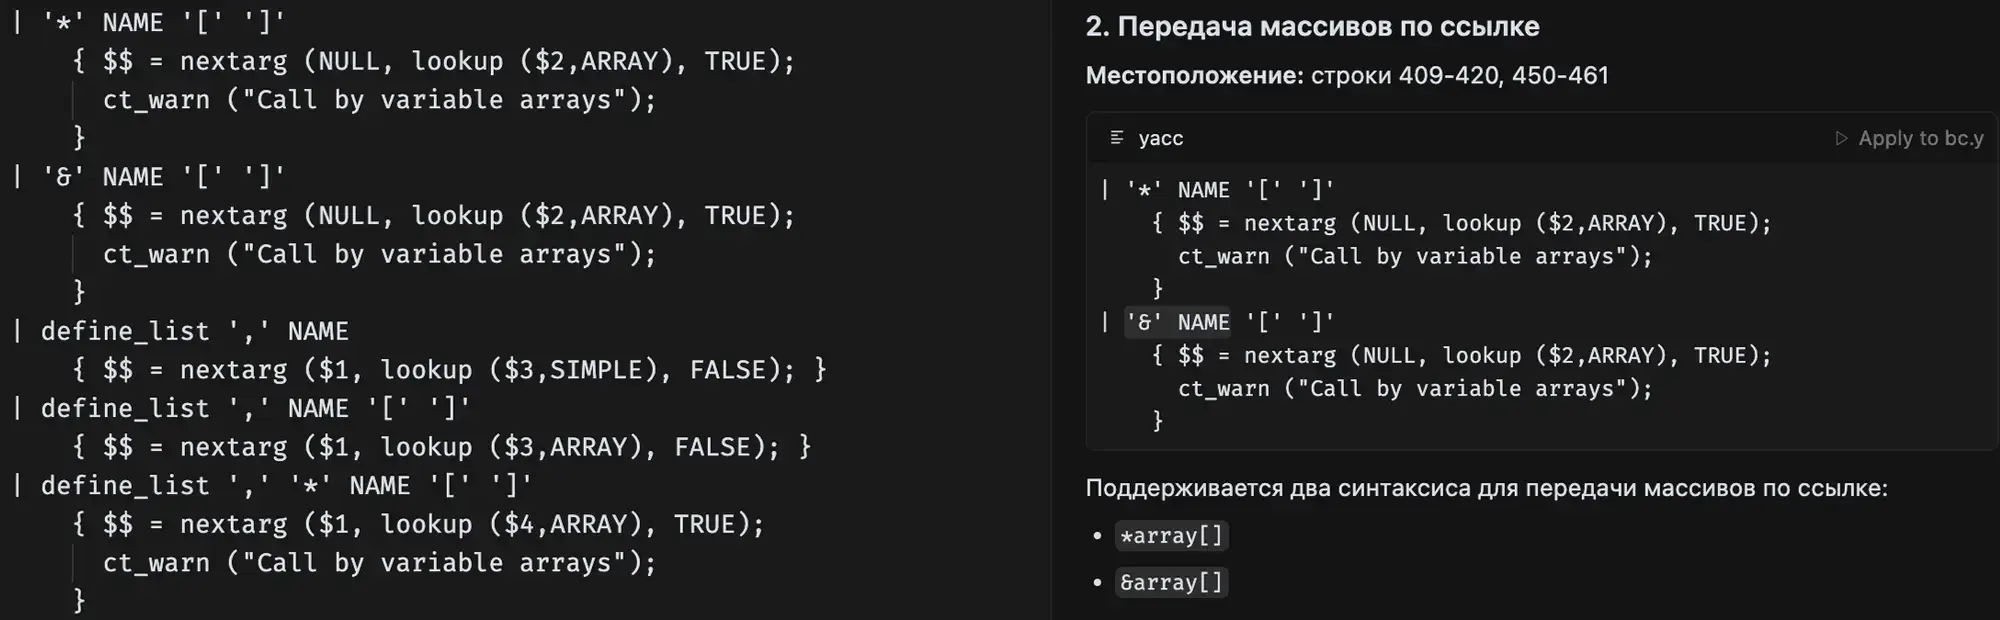
Но это я сам нашёл, руками. Стало интересно посмотреть, что могут найти языковые модели. Для исследования я выбрал редактор кода «Курсор» и модель Claude Sonnet 4.
С первого захода «Клод» нашёл много всего, но бо́льшая часть — вполне обычные возможности, присутствующие в документации. Засучил рукава, порылся в найденном. Кроме мусора там нашлось и полезное — ключ и функцию random() он нашёл, но про символ & не упомянул.
Пришлось подтолкнуть — поместить в контекст нужный файл (bc.y) и спросить нет
С минимальным участием человека нашлись все недокументированные возможности о которых я знаю — три из трёх, правда эти жемчужины пришлось искать вручную в кучке навоза.
Какой вывод?
Я считаю, что это, в определённом смысле, успех — «Клод» помог мне вычленить искомое гораздо быстрее, чем в своё время это сделал я. Да, без моей подсказки третью возможность он не нашёл, но и задача очень и очень нетривиальная.
Починили random() в bc
Вышла версия утилиты bc, в которую я присылал патч для исправления проблемы с функцией для получения случайных значений. Исправление попало в версию 1.08.2.
Интересно, что в авторы исправления меня не записали, зато поблагодарили, записав имя и фамилию русскими буквами, хотя в конце письма я подписался латиницей:
Thu Apr 10 12:59:31 PDT 2025 Ken Pizzini <ken@gnu.org>
bc/execute.c: Call srandom(time(NULL)) to seed the random number generator with something other thana built-in constant. Thanks to Евгений Степанищев for the bug report.
«Курсор»
Чтобы отойти от разочарования, решил
Попросил три понятных изменения сделать, любой дурак справится:
- a@b заменить на вызов функции floor(a, b), которую я написал;
- a$ заменить на вызов floor(a, 0);
- там, где оператор else перенесен на другую строку от конструкции if, надо либо заэкранировать перенос через обратный слеш, либо вернуть else на одну строку с if.
Задача простая, но даже тут «Курсор» накосячил, не справившись с подсчётом скобок. В итоге, тщательно проверял все замены и считал скобки я сам. К чёрту такую автоматизацию, по сумме, я бы сам быстрее сделал.
Раньше я бы к этому спокойно отнёсся, но в последнее время раздражительность повысилась — мёрзну и всё время на грани простуды. Отопление давно отключили, а на улице резко похолодало — снег уже несколько раз шёл. Но, видимо, недостаточно холодно, чтобы включать отопление обратно.
Вокруг очень многие болеют пневмонией, это ещё что такое, откуда? Я уверен, что слово «пневмония» я слышал за прошедшие два года больше, чем за всю прошлую жизнь. Сам я всё время кашляю, хотя не чувствуется, что болею, временами только
Кроссплатформенность и bc
Как мы все знаем, в мире существует две версии bc — более скромная по возможностям версия GNU, которая используется в Линуксе, и более развитая, которая, например, используется в командной строке МакОСи.
Они довольно серьёзно различаются — когда я писал игру «Виселица» на этом языке, мне пришлось сделать две версии для разных синтаксисов.
В принципе, можно писать кроссплатформенно, если использовать подмножество, которое поддерживают обе версии, но есть одна неприятность — функция получения случайного числа
Поскольку в языке нет способа узнать определена функция или нет, нужно
Каким же образом мы можем это сделать?
Вначале я возлагал надежду на переменную seed. В GNU её нету, то есть она содержит ноль, а в продвинутой версии она содержит инициализирующее значение. Как будто этого вполне достаточно, но,
Такую особенность я нашёл — она заключается в приоритете обработки операции отрицания, которая записывается как восклицательный знак.
Основываясь на этом, мы можем написать универсальную функцию для получения случайного числа:
define rnd() {
    /* Checking the bc version */
    if (!1+1) {
        return rand()
    } else {
        return random() * random()
    }
}
P. S. Надо помнить, что
P. P. S. Я умножаю random() на random(), чтобы хоть немного выровнять по диапазону значений rand() и random(), правда распределение, конечно, изменится.
GNU bc и random()
Я не задумывался об этом раньше, но это здорово сбивает с толку, что в мире есть две различающиеся версии bc — одна является частью проекта GNU и поставляется в дистрибутивах Линукса, а вторая развивается другим коллективом авторов и входит, например, в состав МакОСи.
Я уже поучаствовал в разработке последней — предложил изменение ускоряющее некоторые операции и исправил одну ошибку, а теперь, пока был отпуске, внёс вклад и в версию проекта GNU.
Как я
Я подумал — чем чёрт не шутит? Если предложить своё исправление и в этот проект, то, может, его тоже примут? Так как открытого репозитория кода у bc проекта GNU нет, свой патч я отправил на почту мантейнеру.
Он ответил почти сразу, поблагодарил за исправление бага и написал, что сейчас же внесёт исправление в код. Так что, вероятно, следующая версия bc выйдет уже с нормально работающей функцией random()!
Странности bc
Чем больше узнаёшь bc, тем больше в нём находишь странностей. Особенно меня поражают массивы.
Например, как вы думаете, чему равна длина массива, в который мы ещё ни разу не инициализировали? Правильно, единице. Почему? Да чёрт его знает, так в коде написано:
void
bc_array_init(BcVec* a, bool nums)
{
    BC_SIG_ASSERT_LOCKED;

    // Set the proper vector.
    if (nums) bc_vec_init(a, sizeof(BcNum), BC_DTOR_NUM);
    else bc_vec_init(a, sizeof(BcVec), BC_DTOR_VEC);

    // We always want at least one item in the array.
    bc_array_expand(a, 1);
}
Или вот такой код:
define void f(*a[]) {
    . = a[99]
}

f(b[]); length(b[])
Чему будет равна длина массива b[]?
Правильный ответ — она будет равна ста. Потому что в функции, куда мы передали этот массив по ссылке, происходит чтение
// The bc spec says that if an element is accessed that does not
// exist, it should be preinitialized to 0. Well, if we access
// an element *way* out there, we have to preinitialize all
// elements between the current last element and the actual
// accessed element.
if (v->len <= idx)
{
    BC_SIG_LOCK;
    bc_array_expand(v, bc_vm_growSize(idx, 1));
    BC_SIG_UNLOCK;
}
Как только идёт обращение к несуществующему элементу массива, неважно, для чтения или записи, он получается значение «ноль».
В этих случаях я даже уже и не понимаю — баги это или нет. Вроде нет, но выглядит контринтуитивно.
Поправил ошибку в bc
Вчера часа проснулся около часа ночи, сна ни в одном глазу.
Бродил по коду
for (i = 0; i < f->autos.len; ++i)
{
	// Get the auto.
	BcAuto* aptr = bc_vec_item(&f->autos, i);

	// If they match, barf.
	if (BC_ERR(idx == aptr->idx && type == aptr->type))
	{
		const char* array = type == BC_TYPE_ARRAY ? "[]" : "";

		bc_error(BC_ERR_PARSE_DUP_LOCAL, line, name, array);
	}
}
Посмотрел что тут происходит и заметил, что в перечислении, описывающем виды параметров,
define a(*t[], t[]) {}Подумал, что уже достаточно утомился, чтобы лечь спать,
Уже утром я прочитал сообщение по моему коммиту — автор bc попросил отформатировать код и написать небольшой тест. Я всё исправил и теперь ещё немного моего кода есть в этой прекрасной утилите!
Приняли коммит в bc
Ускорение операций в bc
Как вы помните, я недавно устроил себе суточный хакатон, писал «Дум» на bc. Получился он тогда довольно медленным, особенно когда на экране было много объектов. Сейчас я его потихоньку оптимизирую, но так как профилирования в bc не существует, двигаюсь наугад.
По сути я до сих пор не знаю, на что там уходит больше всего времени, но иногда выбираю
В стандартной библиотеке bc есть много функций, написанных нативно. Их, как правило, удаётся так или иначе ускорить, поэтому я решил посмотреть что у меня из такого ещё используется. Взор пал на функцию band(), особенно в форме (band(a, b) && 1), то есть там, где всё, что меня интересует — установлен бит или нет. У меня в коде было несколько таких мест.
Написал свой вариант по мотивам того кода, который используется в стандартной библиотеке:
define check_bit(x, y) {
    auto result, m[]
    result = 0
    scale = 0

    while (x && y) {
        x = divmod(x, 2, m[])
        if (m[0]) {
            y = divmod(y, 2, m[])
            result += m[0]
        } else {
            y /= 2
        }
    }
    return result
}
Получилось быстрее почти в два с половиной раза. Саму операцию band() тоже удалось ускорить в 1,7 раза, в «чистом» виде она у меня в коде тоже есть. Думаю, может сделать коммит в код bc?
Добавлено: коммит сделал. Но беда — автор bc в примечании к репозиторию на «Гитхабе» написал, что с «Гитхаба» он ушёл. К сожалению, то место, куда он ушёл не работает. Так что коммит пришлось залить на «Гитхаб»,
Улучшение в словаре на bc
За последние недели мой уровень в bc очень сильно вырос. Я стал видеть вещи в своих прежних проектах, которые можно сделать проще и изящнее. Но, кажется, мой рост остановился. Интересно, достиг ли я потолка? Или, может, стал ли я сеньором в этом? Не пора ли мне учить других? Открыть курсы, поднимать сообщество? Вопросы без ответов!
В общем, открыл сегодня, пока ехал в такси, исходник своего

Почему же я
Добавлено: грустно — на скриншоте обнаружил ошибки в словаре, который я использую.
Быстрый корень из суммы квадратов
Я недавно писал как ускорял свой «Дум» для bc. В частности я заменял тригонометрические функции их менее точными, но более быстрыми, аналогами.
Роман Парпалак посоветовал способ ускорения вычисления квадратного корня из суммы квадратов. Аппроксимация там через формулу 0,96 × x + 0,4 × y при x ≥ y. Погрешность должна быть не более 4%.
Выглядит здорово, я замерил — производительность вырастает в восемь раз, заманчиво, но если посмотреть абсолютную погрешность там она почти 5,5 единиц. Это как будто бы очень много. Я даже нарисовал график разницы между корнем и аппроксимацией в «Днунипере».
Заменять я не буду, но знать о такой возможности полезно, спасибо, Роман!
Doom на bc
Давно хотел повысить градус безумия своих приложений и изобразить
Писать начал, разумеется, на одном из самых далёких от вывода графики на экран языков — bc, я ведь теперь всё на нём пишу
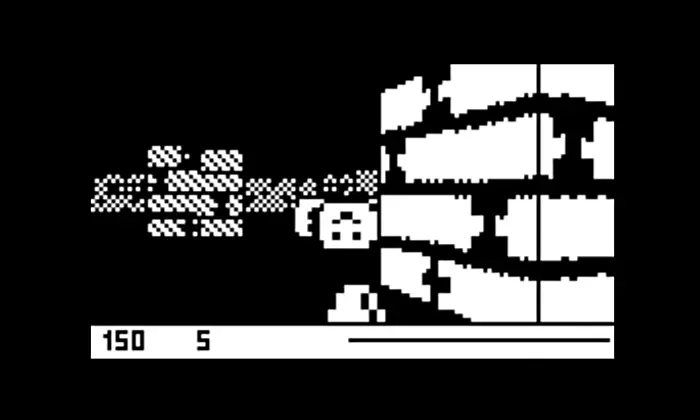
Как вообще устроен вывод графики в текстовый терминал? Надо сказать, что как правило, терминал у нас текстовый число номинально. Да, там выводятся
Обычно мы отсылаем в терминал
ESC ] 1337 ; File = [необязательные параметры] : изображение в формате base64 ^GХорошо, с этим разобрались. Но как нарисовать картинку именно из bc? Тут надо решить несколько очевидных проблем.

BMP — это, как водится во многих старых форматах, внутренне не один формат хранения графики, а несколько. В данном случае я взял самый простой и примитивный — BMP Core с индексированной палитрой из двух цветов.
Его плюс — у него очень простой заголовок и его относительно дёшево формировать. Тем более, что мне не хотелось возиться со сжатием, количество вычислений для этого могло превысить все разумные пределы.
Теперь надо было решить что же я буду писать. На самом деле к этому моменту я уже внутренне определился. В начале двухтысячных локальный фурор произвела игрушка «Wolf5k», написанная на ДжаваСкрипте. Чтобы понять, чем она крута, надо знать, что ДжаваСкрипт тогда графику выводить не умел — не существовало ни тега CANVAS, ни, тем более, WebGL или WebGPU.
Изображение формировалось в текстовом формате XBM, которое, через весьма остроумный хак, показывалось в браузере. На настоящий момент поддержки этого формата давно уже нет ни в одном современном браузере.
Это как будто могло быть очень символично — сделать порт игрушки, которая выводила свою графику на языке, для этого в те годы непригодном, на язык, который так же непригоден для этого сейчас.
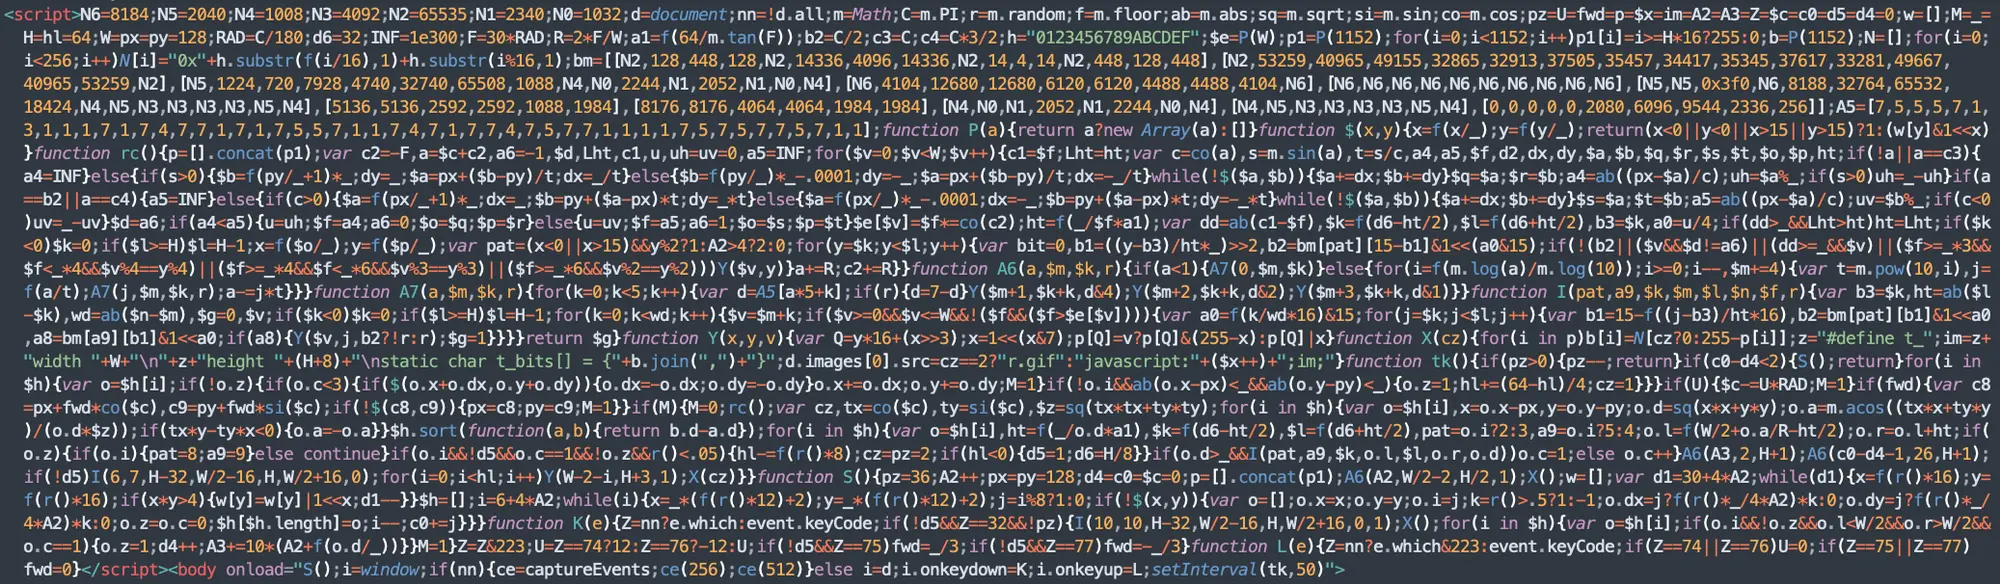
К несчастью, исходный код игры обфусцирован и, когда я в самом начале сел за его чтение, был в отчаянии — мне казалось, что за отведённый самому себе суточный срок разобраться не получится. К счастью, раскопки
Не буду описывать все сложности, с которыми пришлось столкнуться, но примерно к полуночи у меня получился код, который умел рендерить картинку покадрово — к тому времени я ещё не решил проблему опроса клавиатуры и мой «игрок» просто крутился на одном месте. В рендере я увидел несколько проблем, но не критичных.
Самой большой проблемой была производительность. Но это я отложил на следующий день — решил, что работающая, но немного глючащая и сильно подтормаживающая игра, написанная за сутки — удовлетворительный результат. До окончания хакатона мне предстояло решить ещё одну проблему — проблему опроса клавиатуры.
«Wolf5k» — динамичная игра, а во всём языке bc единственная функция ввода — read(), которая требует нажатия на «Энтер» после каждого ввода. Такой себе интерактив.
В самом языке это никак не решить, так что, признаюсь, тут я немного смухлевал — написал на zsh запускающую часть, которая сама читает клавиатуру и пересылает нажатия в bc, «нажимая» на «Энтер»:
#!/bin/zsh
x=/*
while {}; do
    v=
    read -rs -k1 -t0.4 v

    case "${v:l}" in
        [wasdljkm\ ]) printf "%d\n" "'${v:l}";;
        *)    echo 0;;
    esac
done | bc -g -Ll -f "$0"
exit; */1
/* тут программа на bc */
Да, не очень честно, но какой выбор?
К трём ночи у меня была игрушка, в которой всё работало на три с плюсом, особенно, если на экране было не так много объектов. Правда, при поворотах враги иногда пропадали, а иногда взлетали и улетали за пределы экрана. Но в это уже можно было играть.
У меня был соблазн опубликовать её на следующий же день, но хорошо, что я дал коду «отлежаться».
Результат выложил в свой репозиторий. Несмотря на то, что это порт «Wolf5k», игра называется
Ускорение тригонометрических и прочих функций в bc
Интересно, что вся стандартная библиотека (подключаемая через ключ -l) для bc написана нативно. С одной стороны, это
Я тут потихоньку ускоряю одну из своих программ на bc, но все «низко висящие фрукты» я уже подобрал. Добрался до тригонометрических функций. Во внутренней библиотеке косинус выражается через синус, так что, если ускорить синус, то ускорится сразу и косинус.
Посмотрел разные реализации, в итоге портировал функцию, которую взял из одной из статей на «Хабре», получилось так (используется многочлен Чебышёва):
define mod(a, b) {
    auto s, m
    s = scale; scale = 0; m = a$ % b$; scale = s; return m
}

define s(x) {
    auto sign, xf, per, xx, y

    x *= 0.63661977236758134308
    if (sign = (x < 0)) x = -x

    xf = x$
    x -= xf

    if (mod(xf, 2)) x = 1 - x

    per = mod(xf / 2, 2)
    xx = x * x
    y = x * (1.5707903005870776 + xx * (-0.6458858977085938 + \
    xx*(0.07941798513358536 - 0.0043223880120647346 * xx)))

    if (sign != per) return -y
    return y
}
Расхождение со встроенной в bc реализацией начинается в седьмом знаке, это более чем достаточно для меня, зато вычисление синуса ускорилось больше, чем в четыре раза.
Добавлено позднее: ещё я заменил функцию нахождения логарифма по основанию десять. Логарифмом я находил количество разрядов числа, чтобы потом вывести его на экран, так что его легко было заменить на цикл с подсчётом порядка делением. Разница в производительности — больше, чем в 60 раз. Код теперь выглядит так:
define cnt_digits(x) {
    auto i, s
    s = scale; scale = 0

    for (i = 0; x /= 10; i++){}
    scale = s; return i
}Необычная система счисления в bc
В моём временно любимом bc есть интересная, но не сразу понятная особенность работы с числами. Даже в режиме ввода десятичных чисел принимаются буквы в верхнем регистре, то есть число может состоять из цифр в диапазонах 0…9 и A…Z. Буквы при этом обозначают цифры от десяти до тридцати пяти.
Но так как режим десятичный, результирующее значение числа, содержащего буквы, вычисляется необычно. Я специально не описываю словами, ниже скажу почему. Принцип на картинке, думаю, понятно как всё получается.

Мне стало интересно решить задачу конвертации десятичных чисел в такую необычную систему. Из самого принципа следует, что десятичное число может быть представлено несколькими способами, так что придумать можно куда больше одного алгоритма.
Сегодня на работе, пока обедали с братишкой, пытались в режиме обсуждения решить задачу в уме. Потратили на это почти весь обед, в конце я перенёс то, что придумалось, в код программы:
def convert(num):
    if num == 0: return 0
    out, orig_num = "", num

    while num:
        num, r = divmod(num, 10)
        v = min(2 if r > 5 else 3, num)
        if (digit := v * 10 + r) > 9:
            out = chr(digit - 10 + ord('A')) + out
        else:
            out = str(digit) + out

        num -= v

    return out if len(out) < len(str(orig_num)) else orig_num
А потом мы решили развлечься ещё одним способом — аккуратно сформулировать эту задачу в тексте и решить её искусственным интеллектом. Взяли топовые сети — ЧатГПТ, ДипСик и так далее.
Я намеренно не показываю получившийся промпт, вдруг вы захотите тоже попробовать, но скажу сразу — с первого или даже пятого раза сформулировать задачу так, чтобы хоть
Из этого можно сделать важный
А если посмотреть чуть глубже, то можно додуматься вот до чего. В ближайшее время искусственный интеллект не убьёт профессию программиста, а просто её модифицирует. Сейчас программисты описывают задачу, переведённую ими в алгоритм, на языке программирования, а в будущем буду описывать её на натуральных языках.
Ещё немного про random() в bc
Как я уже рассказывал, bc под «Линуксом» очень старый, — на всех машинах, куда у меня есть доступ, установлена версия 1.07.1
Ранее я обнаружил недокументированную функцию random(), но генератор случайных чисел в линуксовом bc не инициализируется и функция выдаёт на старте всегда одно и тоже число. Её можно покрутить снаружи случайное число раз и это исправляет ситуацию, но способ, который я тогда придумал для этого, так себе.
Сегодня, пока ехал в такси, придумывал ещё более так себе способы это сделать.
Мысль моя крутилась вокруг запуска через утилиту env. В мире командной строки так частенько делают, так что этот способ как будто бы чуть более честный, так шелл тут не используется:
#!/usr/bin/env -S -i seed_="0${XDG_SESSION_ID};while(seed_--).=random()#" bc /proc/self/environ
print random()
quit()
Здорово, правда?
Вся чёрная магия сосредоточена в первой строке. Файл /proc/self/environ формируется в «Линуксе» для каждого запущенного процесса и содержит унаследованные переменные окружения. Так как там много ненужного нам мусора, очищаем его целиком при помощи ключа -i утилиты env.
Далее мы создаём переменную окружения seed_, а внутри её формируем небольшую программу, которая запустится до нашего кода. Для bc результат будет выглядеть так:
seed_=0123456
while(seed_--).=random()
#^@
print random()
quit()
Я развернул односрочную программу в многострочную для удобства.
Вместо 123456, конечно, будет подставлено число из переменной окружения $XDG_SESSION_ID, которая содержит число. Ноль там впереди, чтобы не случилось ничего страшного, если эта переменная в вашем дистрибутиве «Линукс» отсутствует.
Мне кажется, это неплохой способ, жаль только что содержимое $XDG_SESSION_ID остаётся одинаковым на всём протяжении жизни сессии. То есть, если запустить программу несколько раз в одном и том же окне терминала, случайные числа будут генерироваться всегда в одной и той же последовательности.
В конце файла /proc/self/environ всегда есть символ с кодом ноль, который мог бы нам всё испортить, но мы спрятали его за символом комментария — #.
Как видно, функция random() вызывается seed_ раз, что позволяет остановиться
Несложно додуматься до похожего способа, который позволяет читать число
Англо-русский словарь на bc
Пока писал «Виселицу» на bc, в процессе немало с ним экспериментировал. Обратил внимание на то, какой он шустрый. Я не делал прямых сравнений, но сложилось такое впечатление. Подмывало
Позже, не справившись с исследовательским зудом, решил попробовать сделать на нём
Сделал так же, как в версии под «Линукс» — bc переводится на ввод
Правда есть проблема — под «Мак» слова надо вводить исключительно в верхнем регистре, иначе они трактуются как имена переменных. Можно было бы создать, конечно, кучу переменных, но это работает не очень — некоторые английские слова совпадают с ключевыми словами языка.
Так что я поступил иначе — проверяю версию bc и, если она достаточной новая (как под «Маком»), запускаю bc через tr, который заменяет буквы в нижнем регистре на буквы в верхнем. В этом случае, начало программы выглядит так:
#!/bin/sh
c=/*
tr -u a-z A-Z | bc -R "$0"
exit; */1
Похожий пролог я уже использовал в прошлый раз, когда надо было «накрутить» рандомизирующую функцию.

Сам словарь нашёлся в интернете. Чтобы не заливать в свой репозиторий чужую интеллектуальную собственность, я сделал make-файл, генерирующий мне программу на bc — словарь скачивается, распаковывается и обрабатывается специально написанной программой на Пайтоне. В итоге получается программа на пятьдесят тысяч с гаком строк.
В результате всё работает шустро, несмотря на линейный поиск. Я вообще не замечаю проблем с производительностью у bc, любопытно. Умели же делать!
Чтобы минимизировать программу по объёму, я сделал два цикла, а останов поиска делаю через break — он позволяет выйти из внутреннего цикла к началу внешнего:
while(c) while (c) {
ibase=36;c=read();ibase=A

if(c==19976){"Несколько";break}
/* тут очень много строк */
if(c==2813515210532){"Сухарь";break}
if(c==2174201762){"Зигота";break}
"Неизвестное слово";}
quit()
Ноль используется для выхода — у меня в Makefile есть небольшой тест, вот он и использует ноль, чтобы прекратить выполнение получившейся программы.
Результат, как обычно, можно увидеть в моём репозитории.
Игра «Виселица» на bc под «Линукс»
Я планировал заняться адаптацией «Виселицы» на bc под «Линукс» на следующий день, то есть сегодня, но не выдержал и вчера просидел над этим почти до полуночи. Линуксовый bc, конечно, гораздо скромнее по возножностям, было где поломать мозг, но больше всего времени я, кажется, потратил на рандомизацию.
Я вчера писал уже, что в документации для линуксового bc нет упоминаний функций для генерации случайных чисел, но чтение исходников показало, что документации не всегда можно верить. Функция есть, называется она random(), но не работает так как хочется — при вызове генерирует всегда одну и ту же последовательность.

Видимо, её забыли правильно проинициализировать. Непонятно почему за столько лет это нельзя исправить, ведь новые версии иногда выходят, правда в списке изменений последних версий сплошь
Так как никаких способов исправить ситуацию, не меняя исходный код bc, я не обнаружил, решил обойтись хаком — при запуске вызвать random() случайное количество раз, чтобы в коде моей программу его внутреннее состояние тоже стало случайным.
Для этого я изменил способ запуска программы — сделал его
#!/bin/bash
x=/*
BC_LINE_LENGTH=0 bc -l -q <(/usr/bin/seq -f "x=random()+%g" $RANDOM) "$0"
exit; */1
Обвязка с комментарием сделана так, чтобы и шелл, и bc не увидели в коде ничего странно и не выдали ошибку синтаксиса, а вся мякотка происходит в строке /usr/bin/seq -f "x=random()+%g" $RANDOM. Команда seq генерирует последовательность x=random()+число столько раз, сколько указано в переменной $RANDOM. $RANDOM — это специальная переменная шелла, которая содержит случайное значение.
Подстановка %g необходима, чтобы заработал шаблон в параметре команды seq, без этого она ругается на неправильный аргумент.
Ещё одной крупной проблемой стали строки — в этой версии bc не поддерживается присваивание их переменным.
Для вывода, вместо кучи переменных, пришлось сделать функцию, которая выводит букву по её коду через горку условий. Код получился похожим на то место, где я выбираю слово по номеру:
define void print_letter(c) {
    if(!--c){"a"}
    if(!--c){"b"}
    if(!--c){"c"}
    /* …тут все 26 букв */
    if(!--c){"y"}
    if(!--c){"z"}
}
Я не стал ставить return, чтобы сделать функцию более визуально компактной, тем более, что на производительность мне, по большому счёту, наплевать.
Кстати, ввод удалось сильно упростить, перейдя на тридцатишестиричную систему исчисления, где все английские буквы соответствую числам:
define read_letter() {
    auto z, b
    b = ibase
    ibase = 36

    z = read()
    ibase = b
    return z - 9
}
Переменная ibase отвечает за систему исчисления при вводе чисел.
Таким образом, численное исчисление получили не только все одиночные буквы, но и все слова. В теории, это можно использовать для ввода одиночных команд на английском языке. Я использую это свойство, чтобы распознать команду exit.
Остальные проблемы решались попроще. Ещё я немного поломал голову чем заменить ceil (округление вверх), потом догадался прибавить единицу и, выставив через специальную переменную scale нулевую точность для цифр после запятой, разделил получившееся значение на один, чтобы отбросить дробную часть:
define word_len(c) {
    auto r
    scale=10
    r = l(c) / l(256) + 1
    scale=0
    return r/1
}
Функцию логарифма log() тут пришлось заменить на натуральный логарифм l() — это одна из немногих математических функций, которые поддерживаются в этой версии bc.
Остальные замены довольно тривиальны, я писал о них ещё в прошлый раз. Результат положил отдельным файлом в моём репозитории.
Игра «Виселица» на bc
После того как я написал «бутылки пива» на bc, стало интересно попробовать написать на этом языке
В силу специфики обработки ввода bc, писать нужно

На пути к успеху сразу начались трудности. Несмотря на то, что в bc есть многообещающая функция read(), оказалось, что с её помощью можно вводить только выражения языка и числа. В вышеупомянутом «пасьянсе» автор обошёлся числами, а мне нужны буквы, иначе играть будет невозможно.
К счастью, «выражения» — это ещё и переменные. Если задать значения всем однобуквенным переменным, мы сможем определить какую именно букву нажал пользователь.
К тому же можно ещё сразу сделать таблицу, которая позволит нам рисовать клавиатуру, так как других способов вывести последовательно буквы в языке нет.
a=1;b=2;c=3;d=4;e=5;f=6;g=7;h=8;i=9;j=10;k=11;l=12;m=13;n=14;o=15;p=16;q=17;r=18;s=19;t=20
u=21;v=22;w=23;x=24;y=25;z=26

co[a]="a";co[b]="b";co[c]="c";co[d]="d";co[e]="e";co[f]="f";co[g]="g";co[h]="h";co[i]="i";co[j]="j"
co[k]="k";co[l]="l";co[m]="m";co[n]="n";co[o]="o";co[p]="p";co[q]="q";co[r]="r";co[s]="s";co[t]="t"
co[u]="u";co[v]="v";co[w]="w";co[x]="x";co[y]="y";co[z]="z"

exit = -1
Заодно я задал значение переменной exit, это слово пользователь может ввести, чтобы выйти.
Весь интерфейс рисуется при помощи управляющих последовательностей, благо хоть тут проблем нет — указываешь коды прямо в строке и всё работает.
Кстати о строках. В языке они присутствуют, но, по большому счёту, сделать с ними ничего нельзя. Например, в игре нужна функция поиска буквы в строке или хотя бы получения символа по индексу. Ничего такого нет даже в помине. Как тогда быть?
Единственное решение, которое приходит в голову — кодировать слова, как числа. 26 букв легко умещаются в один байт, поэтому можно кодировать по байту на цифру. Я написал функцию на несколько тысяч строк, которая содержит закодированные слова и возвращает одно из них, в зависимости от аргумента:
define get_word(c) {
    if(!--c) return 4328588043
    if(!--c) return 4328588820
    /* и так далее */
    if(!--c) return 437194509

    return -c
}

word = get_word(irand(get_word(0)) + 1)
Как видно, если передать в функцию ноль, она вернёт количество элементов, это полезно для того, чтобы знать до какого предела генерировать случайное число.
Функция irand, используемая тут, является расширением bc, у меня на «Маке» она поддерживается, но под «Линуксом» её нет, так же как и вообще любой другой функции для работы со случайными числами.
С такими «строками» можно уже
define word_len(c) {
    scale=10
    return ceil(log(c, 256), 0)
}
Или вывести на печать:
define void print_word(c) {
    auto word, i, mod

    scale=0
    for (i = 0; c; i++) {
        c = divmod(c, 256, mod[])
        word[i] = mod[0]
    }

    while (i--) {
        print co[word[i]]
    }
}
В общем, всё как с обычными строками, только
Остальное,
В теории, игру можно портировать и на «Линукс», надо только избавиться от хранения строк в переменных, заменить генерацию случайных чисел на внешний генератор, заменить log() на l(), а divmod() на деление и взятие модуля и избавиться от length() — массив в качестве аргумента в «Линуксе» не поддерживается.