Копия интернета «Яндекса»

Пятнадцать лет назад, когда я работал в «Яндексе», ещё старом, «У-Яндексе», а не «А-Яндексе», как он ощущается сейчас, в одном из его корпусов стоял небольшой стеллажик с тем, что тогда называлось «Музеем Яндекса». Ни один экспонат мне не запомнился, кроме жёсткого диска, содержащего весь интернет за девяностые годы, если я верно помню.

Я не раз писал, что считаю «Веб-архив» важнейшим проектом в интернете — исчезнет он и неоткуда будет взять всё то, что он в себе содержал. Хочется чтобы он не просто не исчез, а чем-то дополнился.

Поэтому не могу отделаться от фантазии, что «Яндекс» мог бы передать содержимое того диска в «Веб-архив». Наверняка это единственный настолько полный слепок российского интернета за те годы. «Яндекс» получил бы шикарный пиар-повод, а мы бы с вами — возможность бродить по более полной копии «Рунета» 90-х.

Оставить комментарий

Кафе открылось

Ну, можете поздравить, наша кафешечка открылась! Открытие затянулось, тут просто не повезло — были проблемы с шумной вытяжкой, пока переделывали, прошёл почти весь август.

Кафешечка получилась небольшая, но, на мой взгляд, очень уютная, спасибо Алине, управляющей, которая вложила туда душу и много-много нервов.

Находится она в центре Казани, на улице Щапова, 2/16. Покушать можно офигенные бао, ну и попить кофе с лучшими в городе моти.
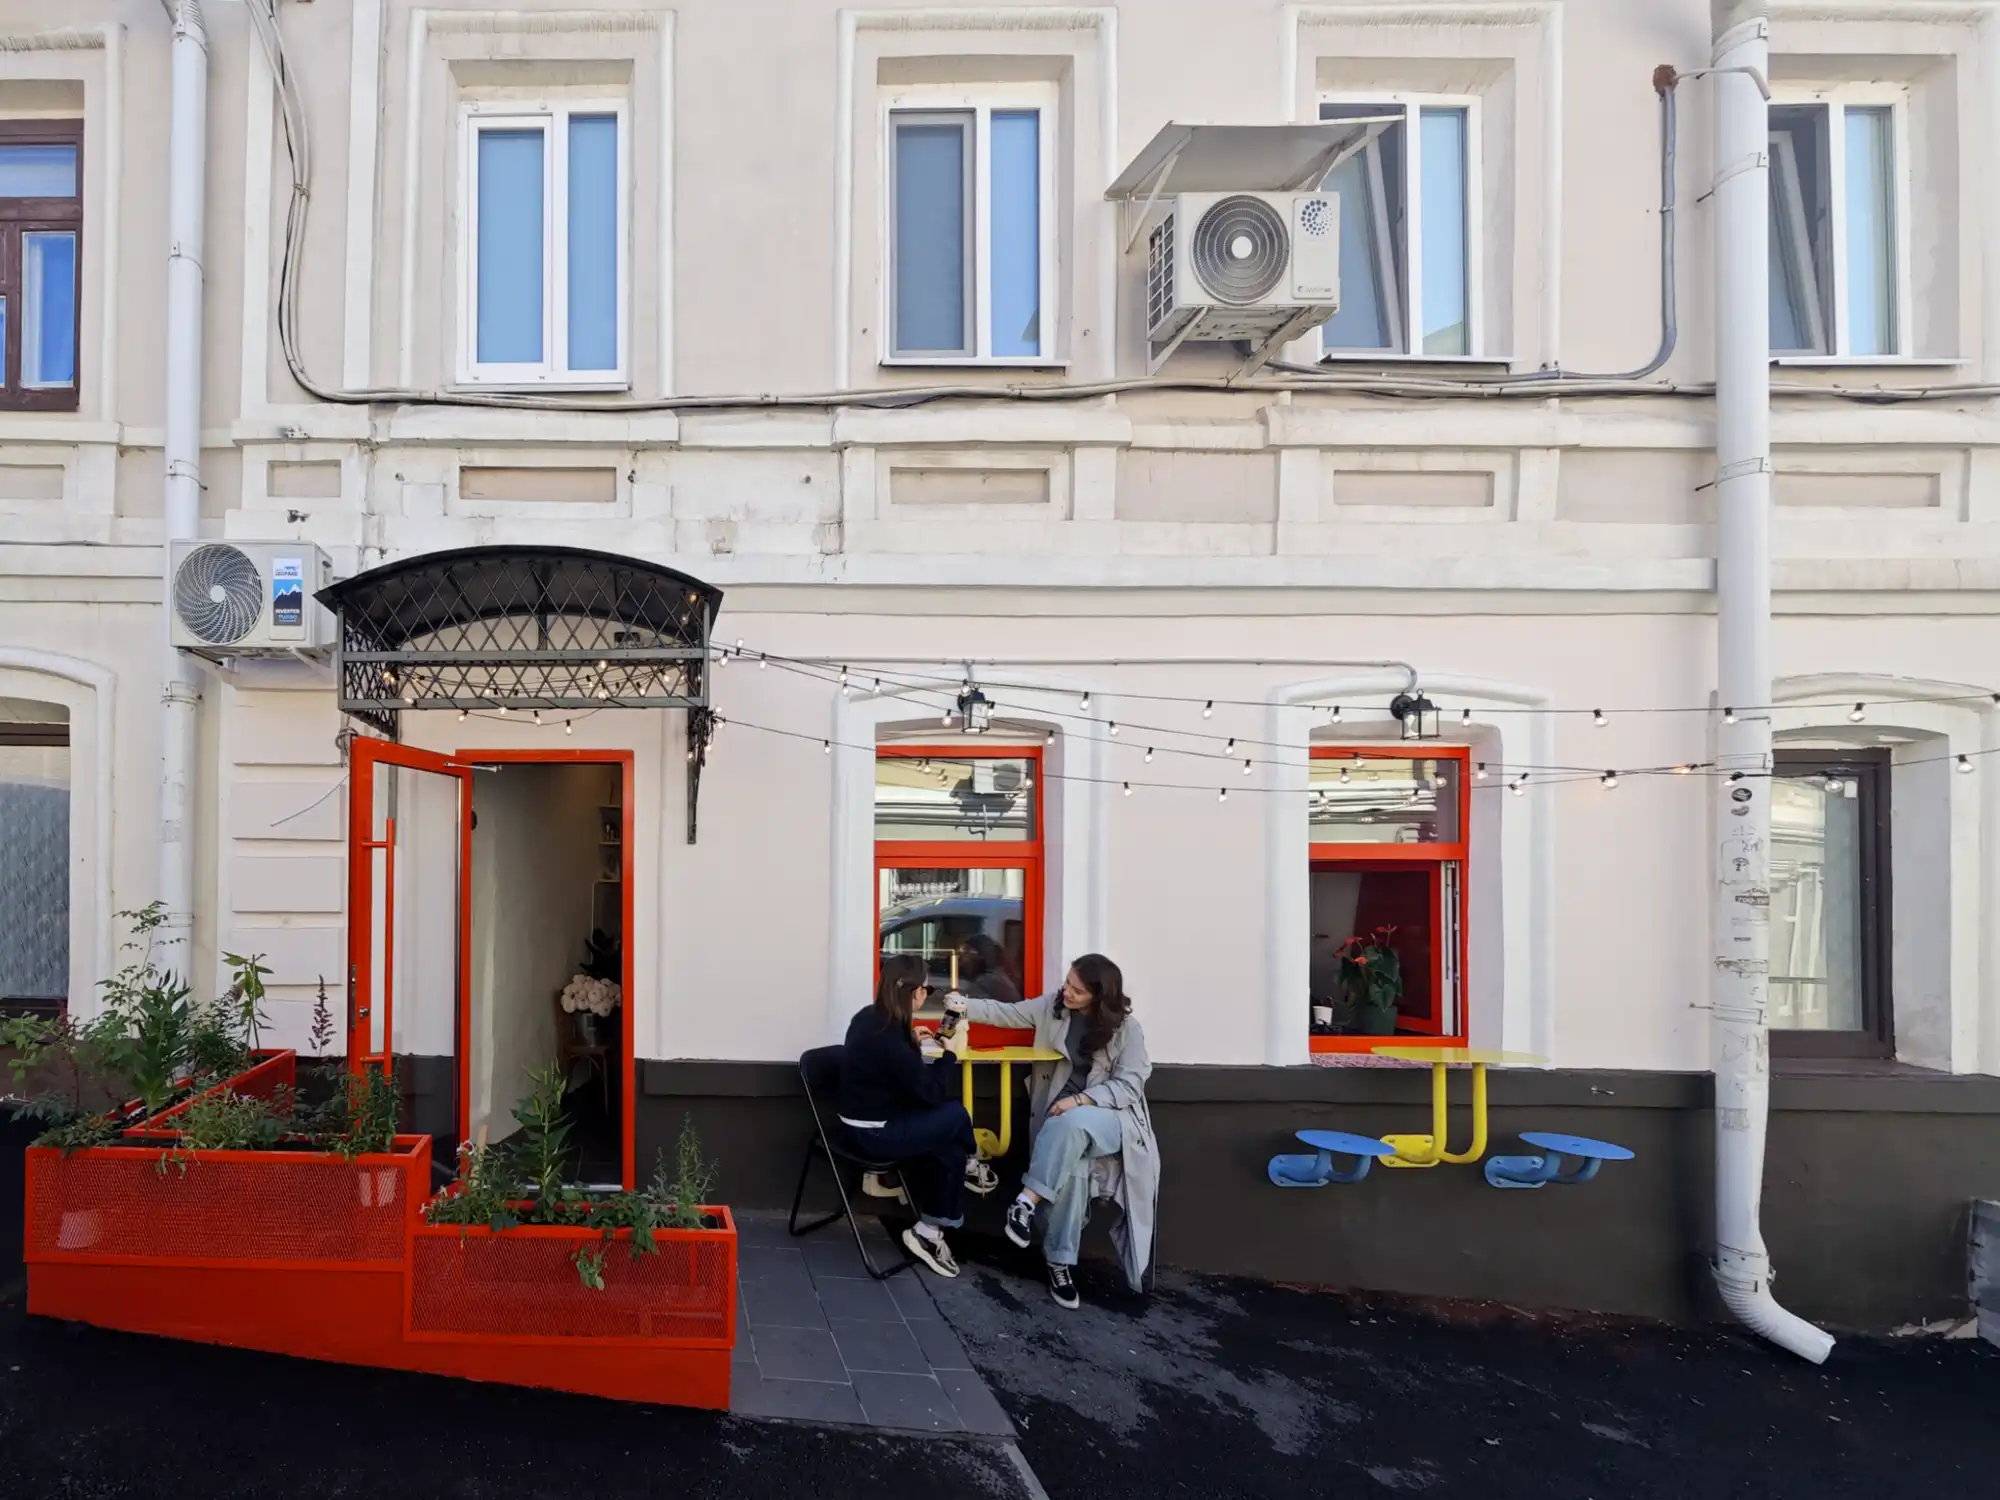
Две женщины сидят за жёлтым столиком у входа в здание с оранжевыми рамами окон и дверей, рядом красные клумбы и гирлянда лампочек.

23 комментария

Qwen3, T4 и разные фреймворки

Скриншот NVIDIA-SMI: 8 Tesla T4, драйвер 580.65.06, CUDA 13.0. Темп. 56–68°C, мощность 27–32 Вт, память ~12–14 ГБ, загрузка 0%.

Ещё немного знаний о запуске моделей на картах T4.

Во-первых, карты T4 не поддерживают тип bfloat16, поэтому при запуске надо указать параметр dtype со значением half.

При этом, если вы используете фреймворк vllm и получаете ошибку «Unsupported conversion from f16 to f16», то вероятно у вас установлена библиотека triton с багом. Надо её либо обновить до последней версии, либо сдаунгрейдить до 3.2.0. Первое нам не помогло, а вот даунгрейд выручил.

Во-вторых, вот у нас восемь карт с памятью по 16 гигабайт каждая, всего 128 гигабайт. Модель Qwen3-30B там запустится, простой расчёт в уме для этого я показывал. А что если нам надо запустить на тех же картах ещё что-то?

Не проблема, давайте запустим не на всех картах, а скажем на пяти, 80 гигабайт же должно хватить, но не тут-то было. Количество карт, с которыми будет работать модель, должно делить 32 нацело — это особенность архитектуры модели и её запуска на фреймворке.

Соответственно, мы можем запустить Qwen3-30B только на восьми картах — на четырёх картах и меньше просто места не хватит, а остальное число карт не подходит.

Поэтому чтобы уместить на этих картах что-то ещё, надо «поджать» количество потребляемой памяти на каждой из карт. Это делается параметром gpu-memory-utilization, при этом придётся ещё и скорректировать max_model_len, чтобы генерируемое умещалось в кеши.

И последнее. Это слабо связано с предыдущим, но куда-то записать хочется. Чтобы скомилировать llama.cpp восьмой версией GCC, надо использовать следующие команды:

cmake -S llama.cpp -B llama.cpp/build \
  -DCMAKE_CUDA_ARCHITECTURES=75 \
  -DCMAKE_CUDA_FLAGS="-fPIC" \
  -DCMAKE_CXX_STANDARD=17 \
  -DCMAKE_CXX_STANDARD_LIBRARIES="-lstdc++fs" \
  -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON -DLLAMA_CURL=ON

cmake --build llama.cpp/build --config Release -j --clean-first \
--target llama-cli llama-gguf-split llama-server

Добавлено позже: проблема тут в том, что GCC до версии 10 не содержит std::filesystem в стандартной библиотеке, её можно подключить снаружи, но надо, чтобы она попала в конец линковки.

Оставить комментарий