В интернете есть всё: котики, совушки и видео с регистраторов
Часто натыкаюсь на фразу, что в интернете собрана вся информация, доступная человечеству. Совершенно не согласен.
Странно, что эту фразу иногда повторяют и умные люди. Не иначе под влиянием эмоций. Если
Возможно впечатление информационного изобилия складывается из ощущения объёма всякой всячины, которой забит интернет. По моему мнению, бо́льшая часть интернета — это мусор, перепосты и бессмыслица.
У меня есть ещё и другая теория.
Как называлось село Дубовка Бавлинского района в момент основания? Как работать с Bluetooth из Пайтона на «Маке»? Где взять карту хоть
Вы сами легко и сходу сможете с уверенностью задать кучу вопросов, ответы на которые в интернете не найдутся.
Так вот, другая моя теория в том, что мы привыкли в уме отфильтровывать вопросы, ответы на которые мы вряд ли найдём в интернете. Экономный ум даже не пытается подсказать нам залезть в «Гугл», потому что знает — усилия по поиску не оправдают найденного.
Мне же приходится учиться отключать эту логику, у меня есть масса вопросов (часто это касается моего хобби — составления своей родословной), где важны любые крупицы из любых источников. Отключая эту логику экономии усилий, я не отказываюсь задавать эти вопросы интернету и понимаю, что в интернете, по факту, данных очень мало. Больше ответов содержат бумажные источники и совокупный опыт специалистов, нигде не описанный (последнее, кстати — определяющая причина по которой я посещаю конференции).
Как скачать документ из АИС ЦГАСО
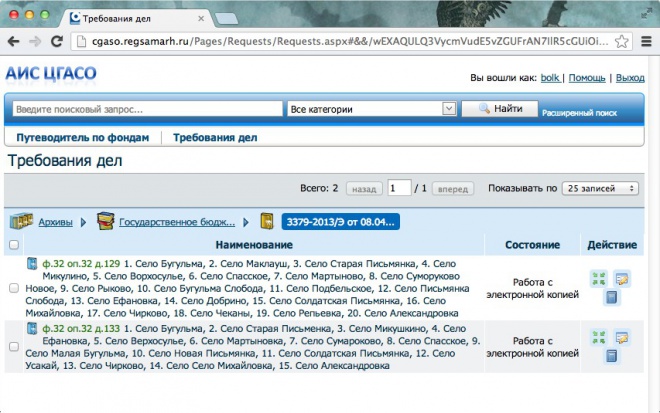
Изучаю тут самарский электронный архив, который сделан в «Эларе». Насколько я понял, продукт называется АИС ЦГАСО. Убиваю сразу двух зайцев — разбираюсь как всё работает и пытаюсь найти нужные мне документы по родственникам.
Ребята из «Элара» молодцы, делают очень нужное дело — оцифровывают бумажные архивы, это невероятный труд, но, к сожалению, интерфейс просмотра документов оставляет желать лучшего, он мне сжёг массу нервов. Решил просто выкачать нужные мне документы на компьютер и дело с концом. Написал специальную программу для скачивания документов из АИС ЦГАСО, на Гугл Гоу. Получилось довольно компактно.
Основная фишка — паралельное скачивание документов в несколько потоков. Не уверен, что это действительно работает (я не до конца понимаю как Гоу переключает свои горутины), но в теории должно. Добавлено: «полевые испытания» подтвердили, что документы действительно скачиваются параллельно. Удалось сделать крайне просто:
ch := make(chan byte, N)

for i, id := range documents {
    ch <- 1

    go func(id string, index int) {
        name := padZero5(strconv.Itoa(index)) + ".jpg"
        copyUrlToFile(strings.Replace(url, `%id`, id, 1), *dir + "/" + name)

        <-ch
    }(id, i)
}
Первой строкой в коде создаётся канал заданной размерности. С ним будут работать горутины (это такие легковесные потоки Гоу). В него можно положить только N значений, после чего следующая операция записи будет ждать его освобождения. С помещением в канал каждого нового значения, запускается горутина для скачивания одного листа документа, как только горутина отработала, она убирает из канала одно значение и цикл основного потока снова его кладёт и запускает новую горутину.
В итоге, одновременно, не будет запущено более N горутин.
Пользоваться программой просто (если
go run cgodownloader.go скачанный-файл.htmlПрограмма обработает документ, покажет сколько страниц найдено и начнёт их скачивать в виде больших джпегов в ту же папку, показывая их имена. У меня на большом документе (около 1,5 тысяч страниц) заняло прилично времени — час с лишним.
Зато теперь просматривать удобно.