У клиента дохлый канал?
В 1997 году, когда я впервые увидел веб через графический браузер (до этого у меня был опыт выхода в интернет через терминал на базе i80286 через текстовый браузер Lynx), у меня была выделенка, дело было в Казанском Государственном Университете и ещё очень долго я не знал что такое диалап и оплата за трафик.
Сейчас выделенки у большинства, но нередко встречается и такое, что клиент приходит на сайт через «дохлый канал» или с оплатой по трафику (например, через сотовый телефон).
Хорошо было бы об этом
Я вижу несколько путей.
- можно замерить время за которое страницу удалось отдать клиенту целиком. У меня пока нет оформившихся мыслей о том как это делать и есть недостаток — когда мы узнали о том, что у клиента плохой канал, содержимое уже выдали, ничего поменять нельзя. Можно выдавать
chunked-контент, как предлагал Сергей Чикуёнок, но первый кусок должен быть значительным - после загрузки страницы «пропинговать» хост. То есть обратиться через XHR на свой же сайт и замерить время ответа. Опять же, что делать с этими данными? Есть возможность в следующий раз показать более бедное содержимое, но следующий запрос может идти через другой канал. Возможное решение — сохранять
IP-адрес запроса - смотреть с какого браузера клиент приходит, если это «Опера Мини», вероятнее всего, канал плохой или с оплатой
- опять же «Опера», если включена функция «Опера Турбо» (определяется
по IP-адресу клиента), клиент экономит трафик, значит канал с оплатой - проверить грузятся ли картинки, способов много, но данные получаем постфактум, после загрузки страницы. Логика та же — выключил картинки, экономит. Загрузку Flash контролировать смысла не имеет — многие выключают, чтобы не видеть рекламы
- проверять не пришёл ли человек через канал сотового оператора
(по IP-адресу). Безлимиток, которые бы не деградировали по скорости послекакого-то лимита пока исчезающе мало, так что имеет смысл отдавать в этом случае «обеднённый» контент. Мобильные браузеры определять смысла не имеет — клиент может прийти через WiFi - в комментариях подсказали, что в «Андроидах» 2.2 и выше есть специальное
API, чтобы определять способ подключения - ещё вариант из комментариев — определять модель телефона/планшета и по базе смотреть есть ли у него GSM/3G или WiFi
Кто-нибудь ещёкакие-то пути видит?
Кодировка rot13 в Пайтоне
В стандартном интерпретаторе Пайтона есть много такого, что иначе как «пасхальным яйцом» не назовёшь. Например, можно попробовать импортировать модули «__hello__», «this» или сделать «from __future__ import braces» (попробуйте), но следующее просто гениально, хотя, видимо, получилось случайно.
В файле программы на Пайтоне в специальном коментарии принято указывать кодировку файла. В случае с латиницей работает и без этого, если применяется
Вот вполне валидная программа, которая выполняется и делает нечто осмысленное:
# coding: rot13

vzcbeg __uryyb__
cevag "Zl anzr vf Ritral Fgrcnavfpuri nxn Obyx!".rapbqr("rot13")
Кодируется только текст программы,
Проверка типа соединения в «Андроидах»
Оказывается в «Андроидах», начиная с версии 2.2 есть специальное свойство у navigator.connection, которое позволяет узнать тип соединения: «navigator.connection.type». Объект «navigator.connection» содержит так же несколько констант, с самодокументируемыми названиями, которые содержат все возможные значения типа соединения: UNKNOWN, ETHERNET, WIFI, CELL_2G, CELL_3G.
with (navigator.connection)
if (type == CELL_2G || type == CELL_3G) {
    // медленное и/или платное
}
На последней, на данный момент прошивке iOS на iPhone 4, увы, это свойство не поддерживается.
JPEG vs. DjVu
Мне кажется, формат DjVu получает незаслужено мало внимания. Те, кому надо хранить документы, делают это, чаще всего, в JPEG или TIFF (а то и в PNG), а об DjVu вообще мало кто слышал. Я взял первый попавшийся в поиске документ, чтобы проиллюстрировать всю мощь формата.

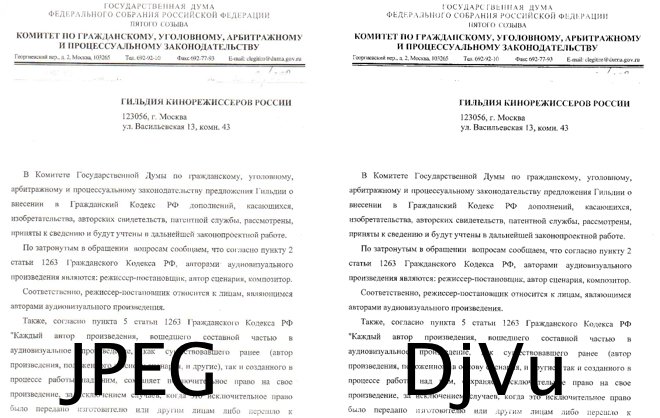
Картинку я уменьшил (до 636 по ширине) и сконвертировал в два формата. Слева на картинке JPEG, справа DjVu. Картинка в JPEG занимает 85КБ (качество — 85%, сжато jpegtran), в DjVu — 13КБ (качество — «normal», сжималось any2djvu). Выигрыш в 6,5 раз при сходном качестве.
За счёт чего достигается такой результат?
Дело в том, что JPEG — формат общего назначения, он ничего не знает о том какое изображение хранит, DjVu придумывался специально под текстовые документы и знает — внутри него, в основном,
Поэтому обрабатываемое изображение разделяется на три слоя: фон, передний план и маску. По сути, изображение разделяется на две части: то, что будет сохранено с низкой детализацией (иллюстрации и фон) и то, что с высокой детализацией (текст). Маска нужна, чтобы при просмотре наложить одно на другое. Обе части сжимаются
Эффективность сжатия DjVu сильно зависит от того есть ли на картинке задний фон, если его нет и изображение только