Частота мерцания монитора
Мне в «Телеграме» в комментариях к посту про мерцание ламп напомнили про «карандашный тест» (легко гуглится). Там же написали, что были ребята, которые могли на глаз, при помощи этого теста, определить частоту мерцания — настоящая суперспособность.
А я тут вспомнил, что во времена расцвета мониторов
Причём частоты примерно до 85 Герц я различал, глядя на монитор, а при более высоких частотах приходилось хитрить — открывать на мониторе
На фотографии мы с братишкой за моим компьютером у меня на работе в конце

FP8 и Nvidia A100
Недавно вышла новая модель Qwen3 с 80 миллиардами параметров. Мы её решили попробовать, но оказалось, что версия фреймоворка vllm, которую мы используем, с ним несовместима. Чтобы не экспериментировать на своём оборудовании, арендовали у «Селектела» две Nvidia A100. Хотели
Модель рассчитывали взять квантованную до FP8, такая есть в выпущенном наборе моделей. Нам она хорошо подходит — как раз уместится в память наших карт. Я рассчитываю, что 80 миллиардов с точностью восемь бит побьют предыдущие тридцать с вдвое большей точностью.
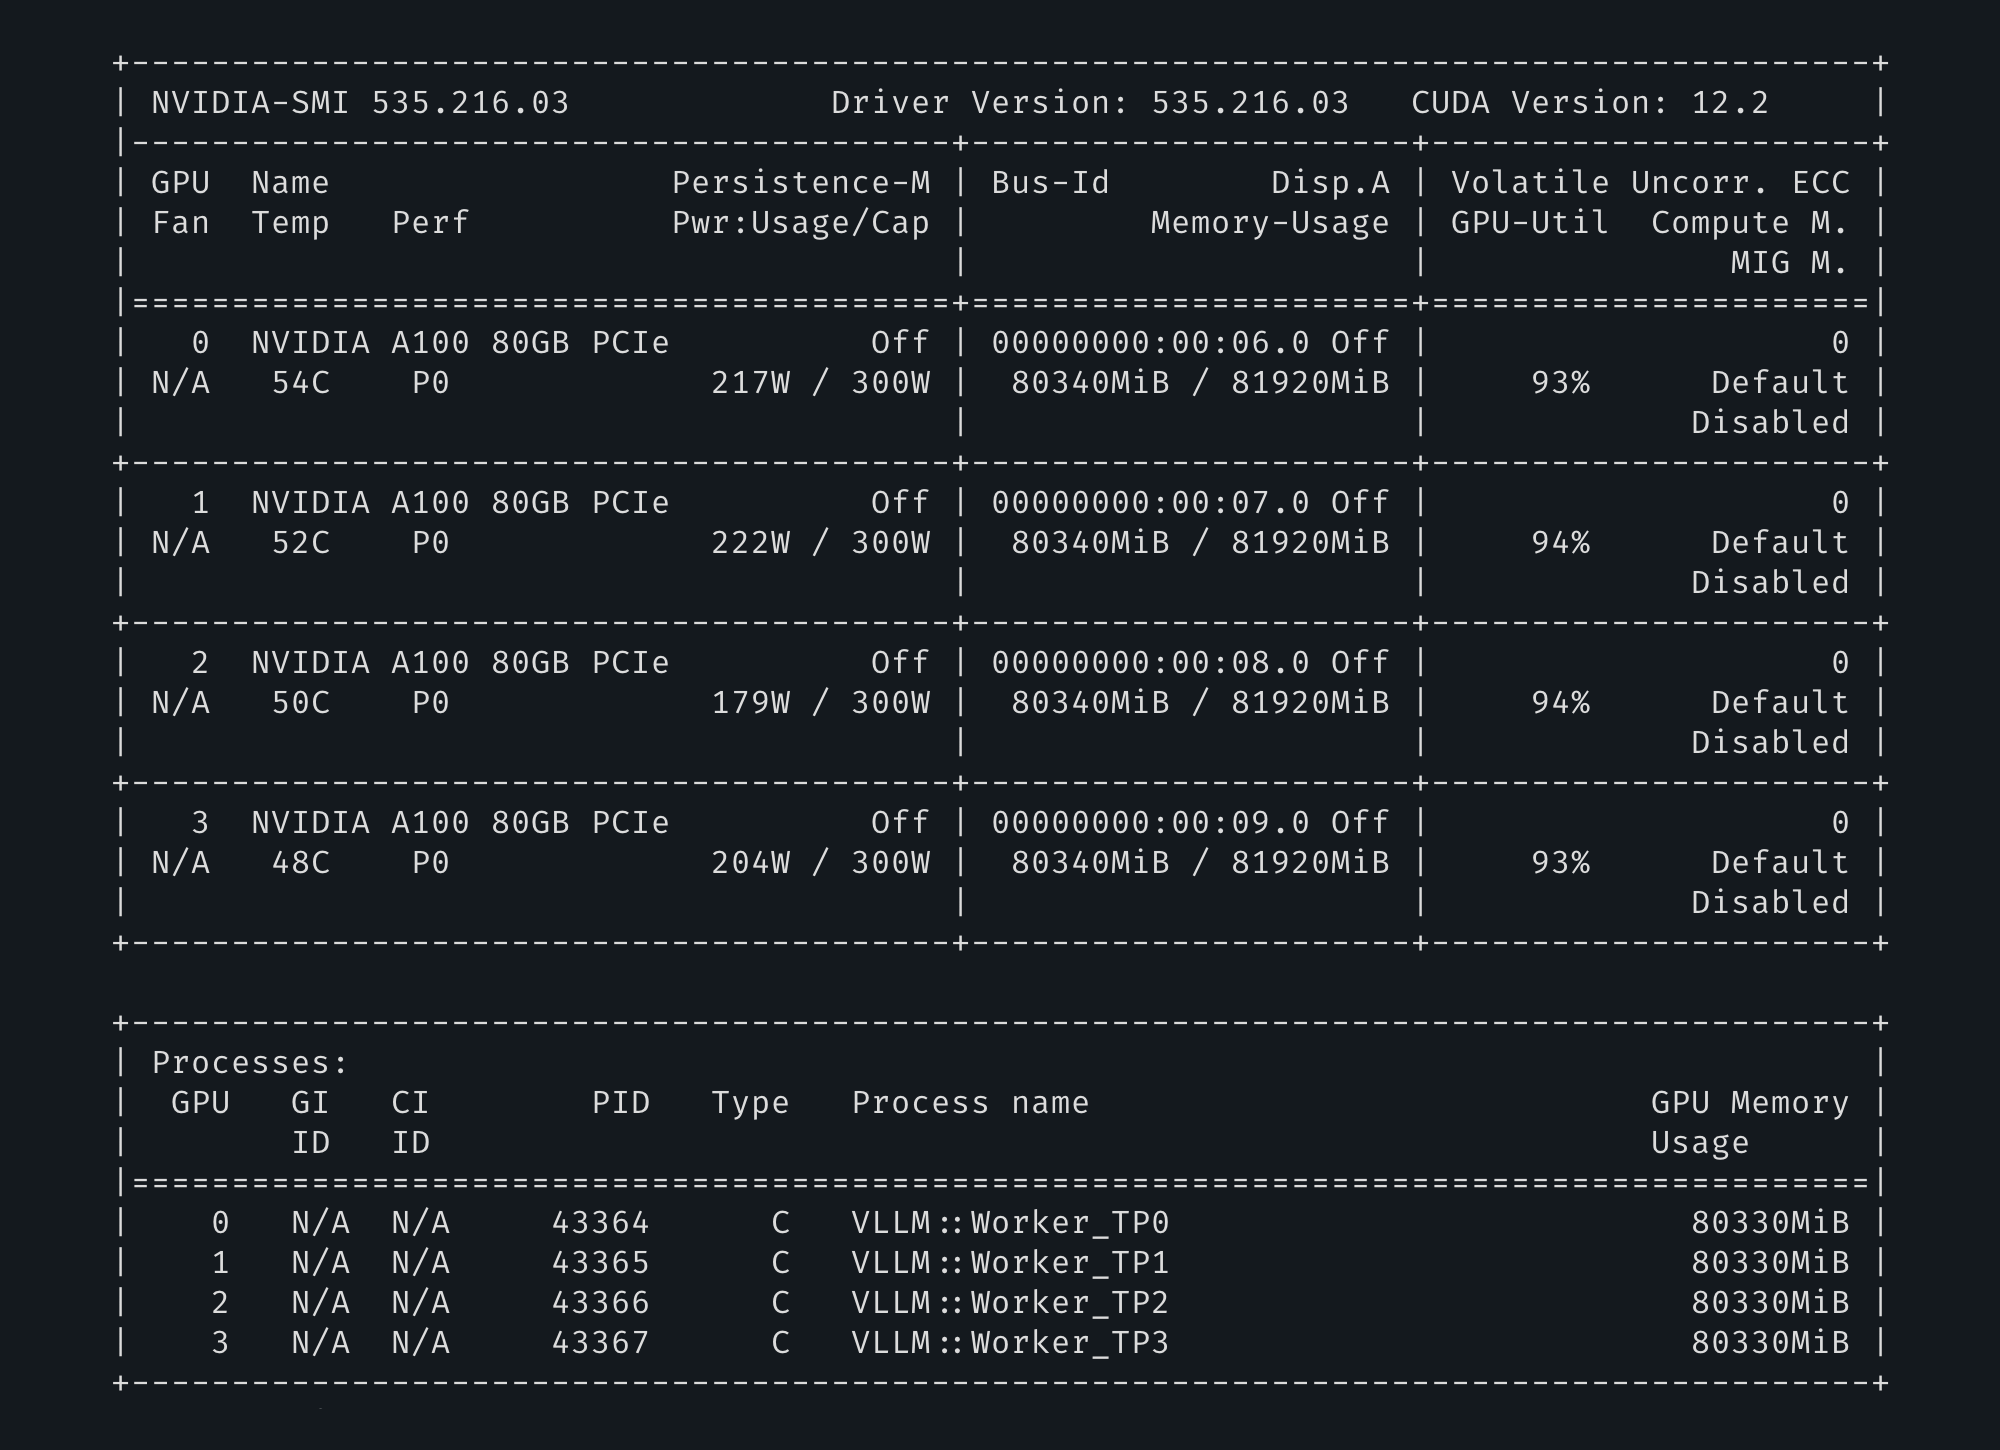
Но нас тут ждало разочарование — карты A100 тип FP8 не поддерживают, есть только эмуляция через FP16. Так как карты с FP8 всё равно пока арендовать не получится, выделили себе четыре A100 и поставили полную модель, без квантованния. Не совсем то, что хотелось, но всё равно полезно посмотреть как встанет и немного погонять по производительности.
В итоге, «завалить» модель одновременными соединениями не вышло (модели, которые мы крутили на одной или двух H100 заваливались), время ответа от нашего эталонного промпта получилось от 3,59 секунд до 8,74. Это очень быстро.