ARM бывают разные
Преодолев внутреннее сопротивление, я
Во «Флиппере» стоит процессор ARM, а они, как оказалось, бывают очень разные.
Я ещё в самом начале посмотрел спецификацию процессора «Флиппера» и, увидев слово SIMD, совершенно успокоился — в моём понимании это означало, что я могу использовать любые команды векторизации, которые мне необходимы. Тут я немного поторопился, но меня подгоняло желание разобраться как устроена векторизация. Теорию я знал, а тут подвернулась, пусть немного синтетическая, но задача, которую руки чесались решить.
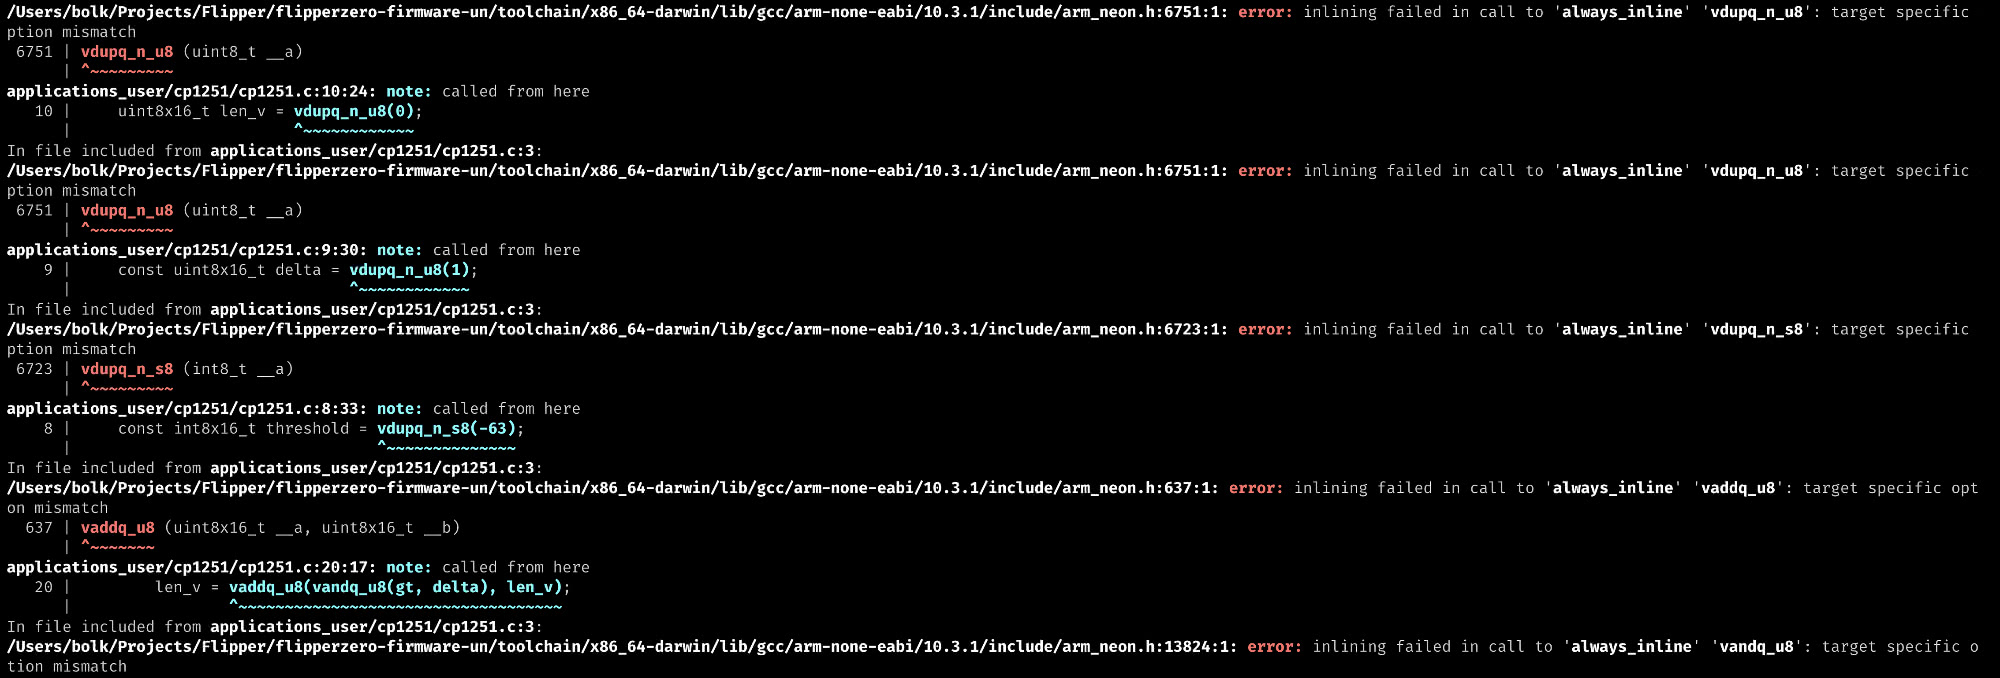
Как я уже говорил, мне захотелось срезать углы, поэтому функцию до этого момента я писал на своём ноутбуке, раз так случилось, что у меня на нём тоже процессор ARM. И лишь сегодня я попробовал вставить её в одну из своих программ и собрать её для «Флиппера».
Сначала компилятор заявил мне, что не нашёл некоторые векторные функции, в частности функцию нахождения минимума vminvq_u8 и суммы vaddvq_u8.
Ветку с vminvq_u8 я временно убрал, а функцию суммы vaddvq_u8 решил заменить на поэлементное сложение (vaddq_u8), которая, вроде, компилятору знакома.
Мысль простая — в векторах, сумму которых мы находим, на каждой позиции нули и единицы, поскольку каждый элемент вектора у нас восьмибитный, в общем случае у нас поместится результат 255 операций, а потом я могу просто просуммировать элементы циклом.
uint8x16_t len_v = vdupq_n_u8(0);
int reset = 0;

// тут у нас цикл
uint8x16_t gt = vcgtq_s8(operand, threshold);
len_v = vaddq_u8(vandq_u8(gt, delta), len_v);

if (++reset >= 255) {
    for (size_t i = 0; i < sizeof(uint8x16_t); i++) {
        len += *((uint8_t *)&len_v + i);
    }

    reset = 0;
    len_v = vdupq_n_u8(0);
}
Я был очень доволен решением (оно не совсем моё, его мне навеял код, используемый в PHP), но оказалось, что оно тоже не компилируется.
Сборка заругалась на ошибку target specific option mismatch, означающую, что указанное при компиляции железо не поддерживает те возможности, которые я пытаюсь использовать в коде. Пришлось лезть в тулчейн, чтобы разобраться какие ключи компиляции сейчас используются.
В файле compile_commands.json можно увидеть, что при сборке используется ключ -mfpu=fpv4-sp-d16, тогда как мне, чтобы использовать нужные команды векторизации нужен ключ -mfpu=neon.
Так как ключи компиляции указывали разработчики «Флиппера», думаю, они в точности знали в какие значения их выставить. Согласно спецификации на борту использованного во «Флиппере» процессора SIMD есть, но, видимо,
DSP SIMD для Flipper Zero
В этом версии нет никакой защиты цикла от чтения за границей буфера, мне показалось, что во «Флиппере» это неважно, но возможно это не так.
Ну что ж, разобрался я что за зверь такой этот DSP SIMD и запрограммировал на нём векторизированную версию функции для измерения длины строки.
Сегодня описывать и замерять уже не буду, и так времени много ушло, но по крайней мере всё работает на настоящем «Флиппере».
Сразу можно заметить, что вектора тут вдвое короче — всего четыре байта, да и функций для работы с ними гораздо меньше, но этого набора оказалось достаточно, чтобы всё векторизовать.
#include <arm_acle.h>

size_t strlen_arm_utf8(char * str) {
    uint32_t len = 0;
    int8x4_t zero = 0x00000000;
    int8x4_t one  = 0x01010101;
    int8x4_t threshold = -1077952577; // -65, -65, -65, -65

    for (;;) {
        uint8x4_t result;
        int8x4_t vec = *(int8x4_t *) str;

        __uadd8(0xFFFFFFFF, vec); result = __sel(zero, one);
        if (result > 0) {
            if (result == 0x01000000) {
                __ssub8(threshold, vec); result = __sel(zero, one);
                return __usada8(result, 1, len);
            }
            break;
        }

        __ssub8(threshold, vec); result = __sel(zero, one);
        len = __usada8(result, zero, len);

        str += sizeof(uint8x4_t);
    }

    for (signed char c; (c = *str); str++) {
        if (c >= -64) {
            len++;
        }
    }

    return len;
}«Щенячья школа»
Интересно, что дочка частенько вдохновляется в своих поделках фильмами, которые мы смотрим. Если они ей нравятся, разумеется.
Недавно смотрели документальный фильм про обучение
После него у нас появилось несколько собак, собранных из «Лего» и бумажный двухэтажный приют для щенков, сделанных из пластика и пластелина.


