Пилю «Виселицу»
Не то, чтобы я не понимал, что сообщество владельцев «Флиппера» относительно небольшое, всё же это очень специфический инструмент, но всё же не ожидал, что написанная за выходные игрушка удостоится такого внимания.
Только выложил её на «Гитхаб», как мне написал автор одной из популярных альтернативных прошивок, прислал патч, исправляющий некую ошибку и попросил английскую версию, — хочет включить игру в свою прошивку.

Доброе слово и кошке приятно, поэтому вот уже несколько дней пилю поддержку других языков.
Для начала переделал сборку на другой инструментарий — ранее игра не собиралась через более распространённый uFBT, потому что мой код использовал
Для поддержки английского пришлось довольно много переделать, всё что осталось сейчас — вывести меню, наверное сегодня уже доделаю. Я замахнулся на конфигурируемую поддержку, по моей идее, можно будет очень просто добавить любой язык, для которого есть шрифт.

В итоге, файл описания выглядит как текстовый файл, где первой строкой написано название словаря, ниже стоит цифра, показывающая сколько букв будет выведено в строке, при рисовании клавиатуры, ещё ниже — зазор между буквами в угадываемом слове в пикселях, потом цифра, про которую я расскажу дальше, ниже — шестнадцатеричные коды букв в кодировке
Если открыть словарь для английского языка обычным текстовым редактором, то внутри будет текст, с русским такой номер не пройдёт. Объясню почему.
Когда я только начал программировать игру, начал я с упаковки русского словаря в программный код и генерации случайного слова. Оказалось, что быстро выбрать случайное слово
В словаре так и сделано. Поскольку внутри программы я храню различные состояния в виде массива, мне нужно знать минимальный получившийся код символа, чтобы вычитать его, преобразовывая код в смещение в массиве. Для русского языка минимальный код будет у буквы А — 0x10, как я показывал выше, то его и нужно записать в файл описания языка. Цифра 16 в нём — это и есть 0x10 в десятичной кодировке.
Надеюсь сегодня допишу всё что нужно и выложу новый вариант.
Тыквенный кальян
Прочитал тут хохму про тыквенный спас, который предлагается праздновать как альтернативу Хэллоуину. Название пришло
Народ уже вовсю облюбовал Хеллоуин, а как уж он называется — дело десятое. Тема тыквы вполне нам близка и хорошо продаётся — вчера, например, пил тыквенный латте в кофейне.
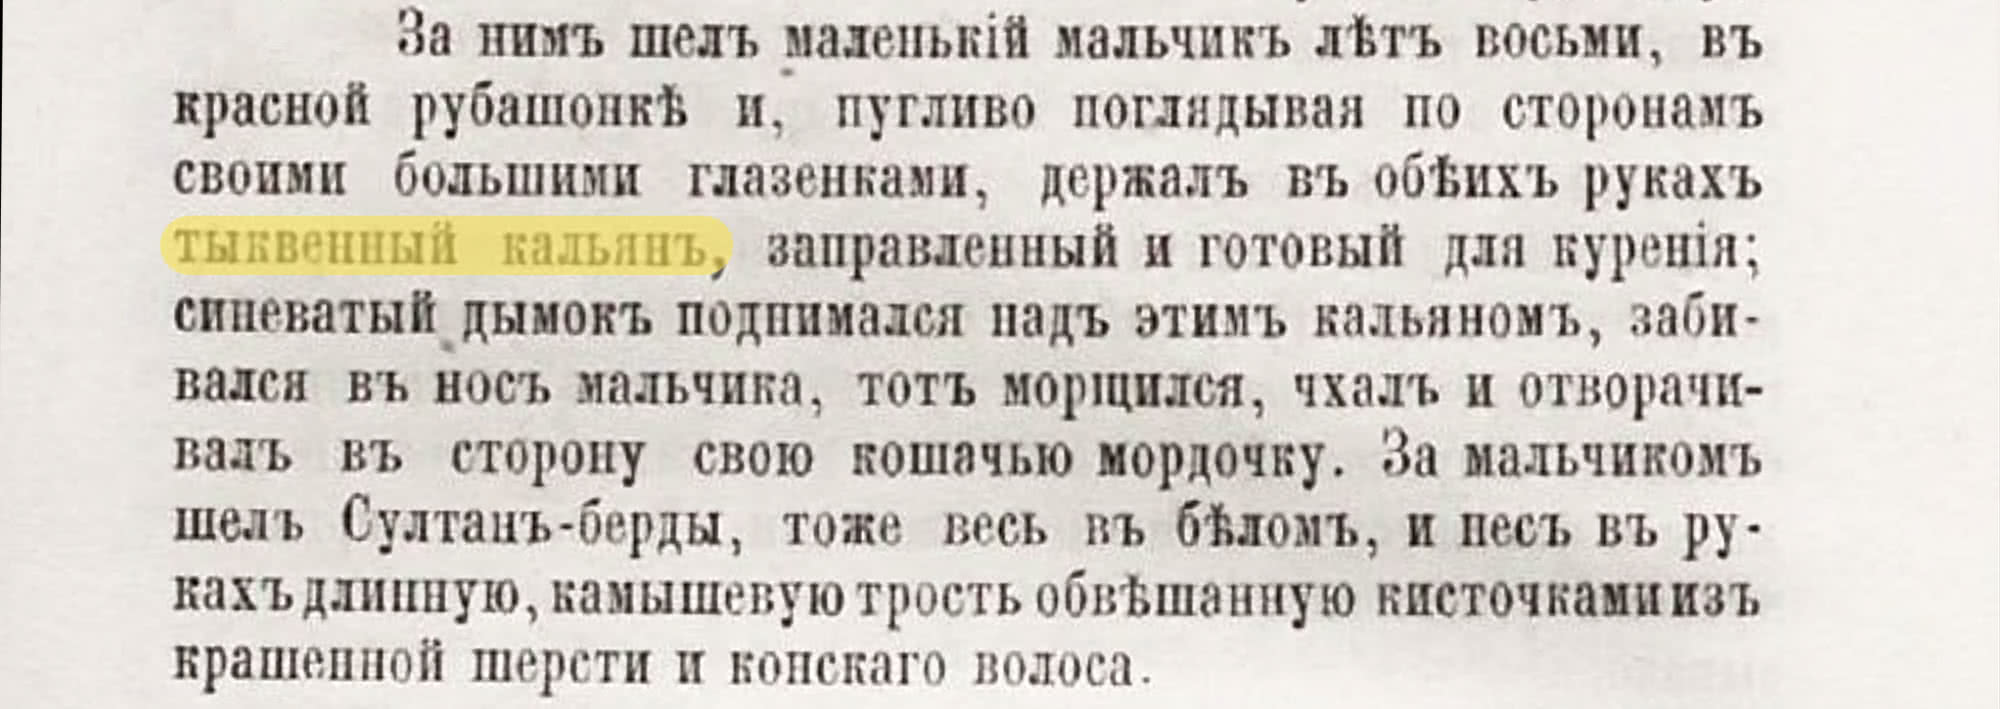
Можно развивать и дальше. Русский писатель Николай Николаевич Каразин в повести девятнадцатого века подсказывает нам идею скрестить тыкву и кальян. Впрочем, я не курю, возможно в кальянных в тыквенный спас вовсю это курят, а я просто не в курсе.
Анафема за кофе
Изучал на досуге по письменным источникам историю слов «кофе» и «кофей», ни к каким выводам не пришёл, но нашёл любопытный документ. Старообрядцам, оказывается,
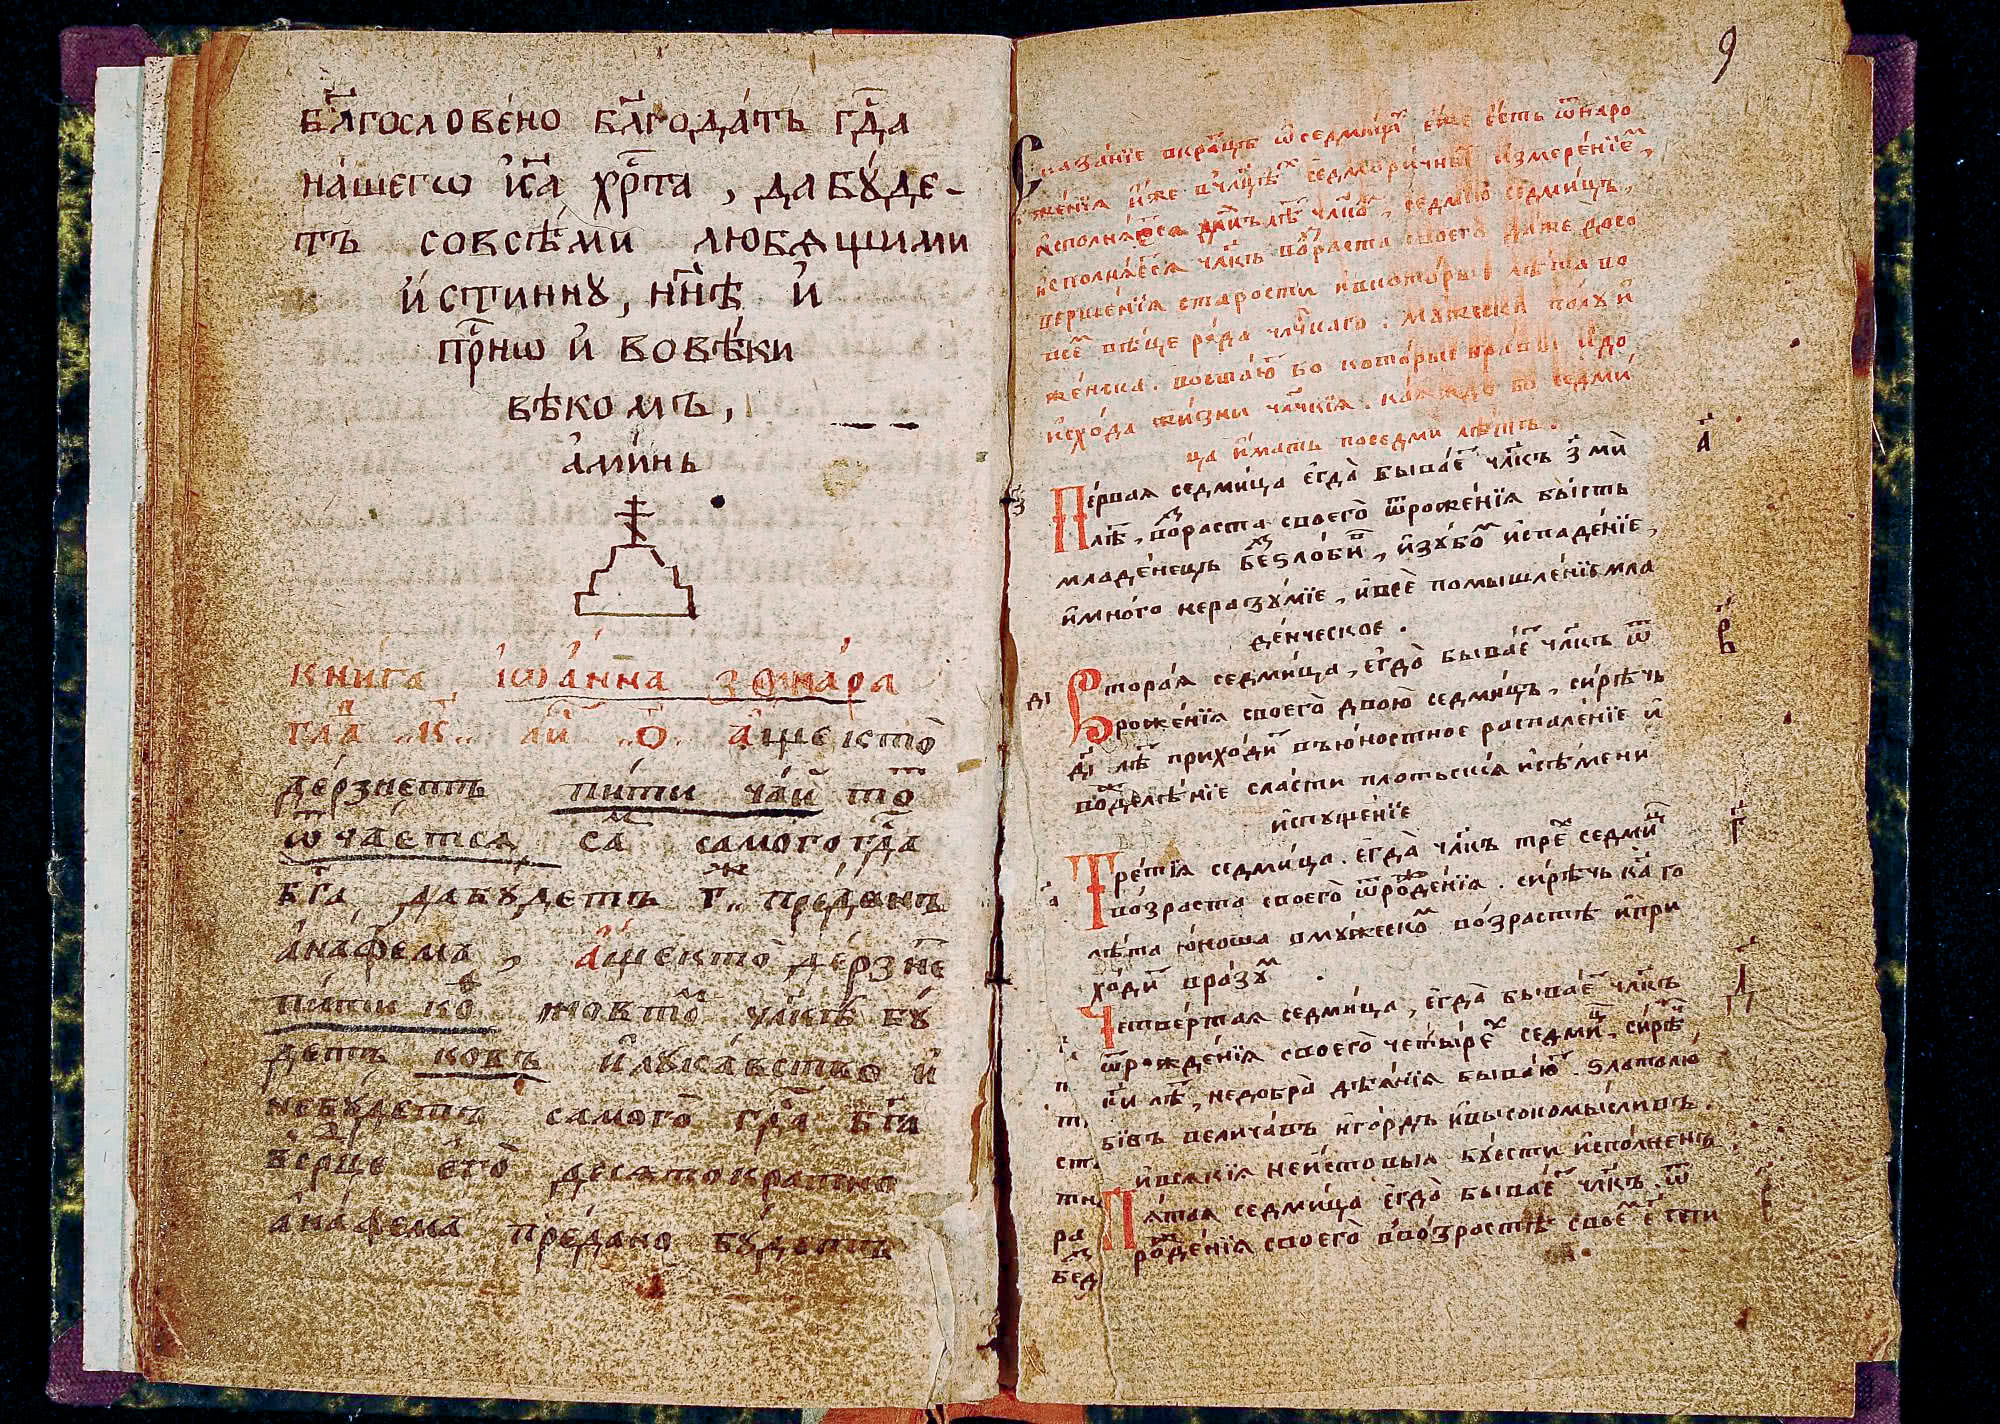
В переводе на современный язык текст выглядит так:
Книга Иоанна Зонара, глава 16, лист 70. Ещё кто посмеет пить чай, тот отлучается от самого Бога и будет тоже предан анафеме, а ещё тот, кто посмеет пить кофе, в том будет коварство и лукавство, в сердце того не будет Бога и он будет предан анафеме десятикратно.
Кстати, тут, кажется, есть игра слов «кофъ» («кофе») и «ковъ» («коварство»), но возможно я