JBIG2
У нас в документообороте всё больше используется формат ПДФ, но с ним есть проблема — документы из некоторых сторонних организаций к нашим клиентам приходят на бумаге, по факсу
Пока мы такие документы помещаем в ПДФ сканами в хорошем качестве в формате ДжПЕГ. Увы, это довольно расточительно. К счастью, ПДФ поддерживает не один, а целых три формата графики — ДжПЕГ, ДжПЕГ 2000 и ДжБИГ2. На последний я возлагал большие надежды.
Идея этого формата очень интересна и проста. Если у нас есть скан документа, его значимую часть в основном занимают буквы и цифры, если найти при помощи распознавания одинаковые символы, то их можно закодировать по одному разу, а в остальных местах использовать просто ссылки на них. Текстовые сканы действительно ужимаются значительно (я пробовал), тем более, что формат двухбитный (только
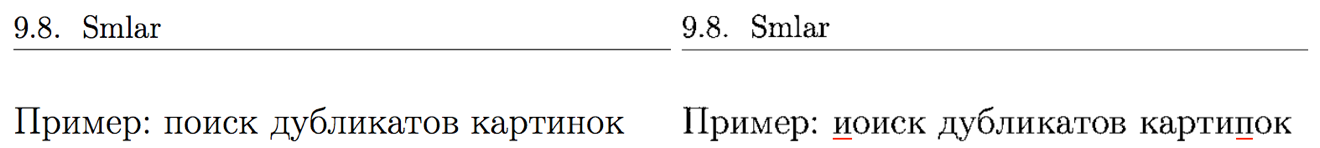
К сожалению, у формата есть серьёзный недостаток, на который я тут же и наткнулся.
Алгоритм устроен так, что он подбирает не просто одинаковые символы, а похожие. Это разумно — принтеры печатают неравномерно
Посмотрите, у меня на скриншоте выше — оригинальный ПДФ (слева) и ПДФ, где графика перекодирована в ДжБИГ2. Как видно при кодировании были перепутаны «п» и «и», «п» и «н». Для слов в документах может это ещё и не смертельно, но для цифр в суммах — беда.
Мне неясно можно ли
Остаётся ещё вариант с ДжПЕГом 2000, но с ним возможно, выигрыш будет столь незначительным, что затраты на конвертацию просто не окупятся.
Комментарии 18
Мне кажется, этот формат подходит для книг и статей, где ошибки некритичны, но никак не для документов.
Но! Алгоритм применяется очень широко, оказывается. http://www.computerra.ru/79247/jbig2/ — статья 2013 года в Компьютерре о баге в сканерах Xerox, в комментариях и Brother упомянуты.
Ещё похожий алгоритм применяется в
Ошибки то тоже будут, но зато настоящий pdf!
Комментарий для Евгения Степанищева:
Но в текущей же ситуации разницы никакой :)
Почему же никакой? Сейчас мы используем сканы, на сканах человек всё прочитает в точности, а он распознаёт буквы пока точнее машины, в случае сомнений он просто запросит бумагу ещё раз, тогда как программа подставит туда
Тогда что угодно можно назвать контейнером. Я, например, внутрь JPEG могу положить GIF. Означает ли, что фраза «JPEG не поддерживает GIF» не верна? В формате PDF описаны строго определённые форматы, которые поддерживаются.
Конечно нет, потому что эти изображения упомянуты в стандарте PDF.
FineReader поддерживает JBIG2 lossless.
Форматов изображений PDF поддерживает больше — ZIP, LZW, JPBIG2, CCIT4 FaxDecode, JPEG, JPEG2000, все они поддержаны в FineReader.
Жать можно чем угодно. Но ZIP и LZW не форматы изображений.