Непонятный баг с AJAX в IE8
В процессе переезда одного из наших проектов на новый сервер, Интернет Эксплорер восьмой версии стал выдавать
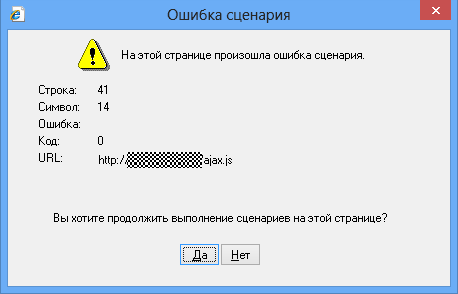
В этом месте в коде не было ничего криминального, создание объекта для «аякса», асинхронная посылка запроса и проверка свойств того что пришло. Методом проб и ошибок удалось выяснить, что ошибка возникает при попытке обращения к свойствам «status» и «responseText» (а так же «responseXML», в коде он не использовался, но я просто попробовал).
Промучавшись с полчаса, я догадался переключить IE на работу с объектом ActiveX Microsoft.XMLHTTP, вместо XMLHttpRequest, у первого диагностика получше — ему
На этот раз я получил нумерную ошибку (скриншота не сохранилось), по номеру которой я нашёл сообщение на сайте Микрософт, что ошибка связана с неверной кодировкой, пришедшей со стороны сервера. В «Хроме» посмотрел кодировку — оказалось, что кодировка с сервера приходит как «cp1251»:
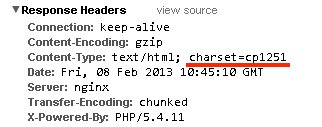
Интернет Эксплорер такую кодировку не понял, один из админов вписал её руками, поскольку при смене версии ПХП заменили сервер FastCGI на
Видимо, встретив странную кодировку, IE не смог понять как ему читать то, что пришло, он вообще не заполнил некоторые свойства, а объект, попытавшись получить к ним доступ, не понимал в чём дело и выдавал пустую ошибку, которая и символизировала это «я не понял что произошло».
Комментарии 16
charset
The optional parameter «charset» refers to the character
encoding used to represent the HTML document as a sequence of
bytes. Any registered IANA charset may be used […]
Среди зарегистрированных IANA ( http://www.iana.org/assignments/character- …
А вообще, я очень удивлён, что на дворе 2013 год, а ваши прогеры до сих пор не осилили
Посмотрите, для интереса, в какой кодировке «Мой круг» ( http://moikrug.ru )
UTF-8? Недостатки я знаю — медленнее всё станет.
В чём преимущество перевода нашего продукта на
Комментарий для Евгения Степанищева:
Комментарий для vladon.ru:
Операции подсчёта длины строки, регулярные выражения, substr и прочие подобные гораздо медленнее, потому что вUTF-8 размер одного символа в байтах варьируется от 1 до 6 байт, а однобайтных строках мне чтобы адресоваться на энтый символ, достаточно адресоваться на энтый байт.
В нашем продукте и это без надобности.
Комментарий для Евгения Степанищева:
Ну можно внутри хранить всё в1-байтовой кодировке, а выводить, конвертируя в utf-8.
Но в принципе, если необходимости расширяться на более другие языки нет, то действительно незачем.
А разве вы не делаете документооборот для Татарстана? Я даже помню ваша девочка писала, что для Татнефти и правительства РТ.
Комментарий для vladon.ru:
Однобайтовая кодировка — это всего 256 значений. АUTF-8 — это горааааздо больше значений, мне сейчас лень считать сколько, но очевидно же, что в 256 значениях нельзя хранить любое бо́льшие число, так что в чём суть предложения-то?
То, что он у нас в Татарстане используется не говорит о том, что это «документооборот для Татарстана». Например:
http://gov.tuva.ru/news.aspx?id=9221
http://www.tadviser.ru/index.php/%D0%9F%D1 … D%D0%94%29
http://www.cnews.ru/top/2012/04/16/moskva_ … aka_485865
Комментарий для vladon.ru:
Я не имею права комментировать планы и стратегии компании.
А потом прибегает задыхающийся пм и изречет — «нам нужна интернационализация!!1».
utf-8. Железо дешевеет и становится круче, а зарплата программистам только растет :)
Очень смешно, на imdb.com стали переводить названия тайтлов по геопризнаку, а вот поискать ничего не выйдет, потому что у них сайт на ISO.
Почти всегда сейчас выгодней начинать сразу на
У нас, знаете ли, коммерческая организация. Есть цель, есть бюджет, делаем. Именно в таком порядке.
Ещё в шестёрке была аяксовая проблема с кодировкой: http://htmlcssjs.ru/JavaScript/?30