Как скачать документ из АИС ЦГАСО-3
Архив ЦГАСО несколько изменил у себя вёрстку и предыдущий способ скачивания работать перестал. Сегодня мне понадобились документы из этого архива, пришлось посмотреть в чём дело.
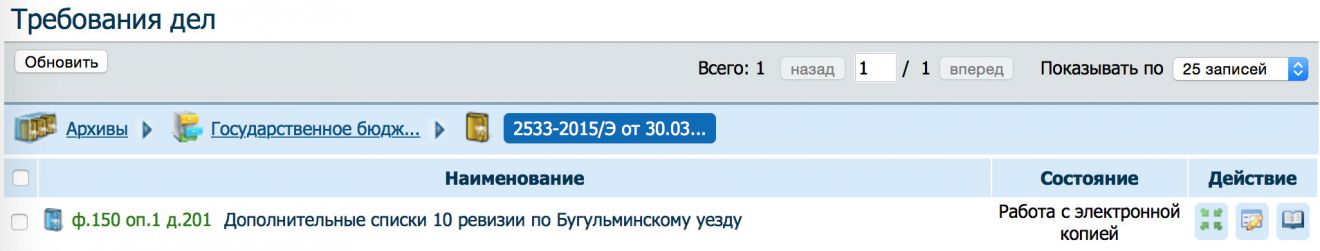
Для того, чтобы скачать листы дела, вам нужно в браузере (настоятельно рекомендую «Хром», в других браузерах я код не испытывал) перейти в раздел «Требования дел» и открыть на просмотр нужное вам дело (для этого нужно нажать на значок «книжки» в колонце «Действие»).
Когда дело откроется, нужно открыть панель разработчика (открывается по Ctrl+Alt+I на «Виндоузе» или Cmd+Alt+I на «Маках») и там перейти во вкладку «Консоль» (Console). В этой вкладке вставить нижеприведённый код и нажать «Энтер».
!function () {
    var id = '[id=storageFilesViewerPnl]';
    var bt = '[id$=ForwardBtn]';
    var pages = {};
    var o = document.querySelector(id);

    !function _observe(undefined) {
        var ob = new MutationObserver(function() {
            var imgs = $(id+' img[src*=Pages]:first');
            if (imgs && imgs[0]) {
                var page = imgs[0].src.match(/id=([^&]+)/)[1];
                if (pages[page] == undefined) {
                    pages[page] = true;

                    ob.disconnect();

                    var next = $(bt);
                    if (next && next[0]) {
                        _observe();
                        next[0].click();
                    } else {
                        console.clear();
                        console.log("dxo.itemsValue=['" + Object.keys(pages).join("','")+"'];");
                    }
                }
            }
        });

        ob.observe(o, { childList: true, attributes: true, subtree: true, attributeFilter: ['src'] });
    }();

    o.setAttribute('src', true);
}();
Начнётся пролистывание документа. Запаситесь терпением. Как только оно закончится, на экране появится длинная строка, как на скриншоте ниже. Её надо скопировать в файл целиком.

Далее, увы, вам придётся занять компилированием. Как это делается, рассказывать не буду, ищите в интернете. Вам понадобится программа cgodownloader.go из моего репозитория, её надо сохранить к себе на диск и скомпилировать (она написана на Гоу). Ей на вход надо передать имя файла (в моём случае это
Когда программа закончит работу, в указанном вами директории будет лежать дело целиком.
Комментарии 83
В Mint 17 еще попробую
До
От меня тоже огромное спасибо
«Винды» у меня нет, поэтому сказать почему виснет я, увы, не могу.
В Minte дело 2700 листов хром завис напрочь после 920 стр.
Я так понимаю не хватает памяти
В xp увеличил файл подкачки освободил больше места на с: — ноль эмоций
Очень странно, 2700 значений это не
http://pastebin.com/eQ90xJSn
Комментарий для Василий:
Как не дописан? Там код приведён.
Если у Вас Мозилла с Noscript, то разрешите pastebin.com, сам только что разобрался.
https://fotki.yandex.ru/next/users/non-alc … 979?page=0
Вот именно что в трех браузерах просмотрел, антивирус отрубил и все равно ничего не видно. и носкрипта у меня нет. Заговор
Константин, новый скрипт помог решить проблему?
К сожалению, самое длинное дело на сегодня — 153 листа, постараюсь проверить на след. неделе. Скрипт рабочий.
Возможно, я просто не вижу что могло бы так есть память.
Я немного покопался в коде. Видно, что такие
Я сравнил несколько GUID и соответствующие им
Не пробовали понять как генерируется код страницы при переходе на другой лист? Многие функции обфусцированы и под отладчиком ходить не очень удобно. Но может быть есть там
Нет, не пробовал.
Значит решил я применить Вашу схему к Тюменскому архиву http://109.233.229.20:81/Pages/Main.aspx
Схема незаработала на этапе компиляции, создала кучу джпегов, которые по сути были html с информацией об ошибке…
Начал изучать код, и понял, что строка запроса несколько отличается от исходной, да и хост не тот.
Было:
const url = ` http://%s/Pages/ImageFile.ashx?level=10%26 … iveId=1%60
const defaulthost="cgaso.regsamarh.ru"
Сделал:
const url = ` http://%s/Pages/ImageFile.ashx?level=10%26 … ation=0%60
const defaulthost="109.233.229.20:81"
В итоге качались только первые куски с координатами по х/у 0/0. А потом и вообще сайт архива застрелился. =)
Service Unavailable
HTTP Error 503. The service is unavailable.
И всё же, я думаю принцип работы в обоих архивах одинаковый, так как один и тот же софт у них стоит. Евгений, хотел вас попросить глянуть, что я не так делаю…
Общая картинка состоит так же из кусков с координатами x / y
Но у меня почему то скачивается только первый кубик с координатами 0/0, а приклеивания других кусочков не происходит.
НО, разобрался сам =) Спасибо. Вот только не пойму зачем они собирают мозайку из кучи мелких обрезков одного и того же файла, ведь по сути обращаются к одной и той же картинке. Они сами себе сервер перегружают запросами, только ради того, что бы запутать людей =)
Я не собираюського-то учить, наставлять или просвещать. Всё это я делаю для себя, блог веду тоже для себя. Если кто-то пользуется результатами моих трудов, я не против, но и только.
Что за бред? Почему я должен в своём блогечто-то удалять?
Volhvuk если получилось, помоги другим, про кубики с координатами, давно увидел, и вина тому насколько понял не архив и ПО, а браузеры, чтобы наоборот увеличить скорость загрузки, за счет многопоточности.ЦГАСО-3
А на счет высказывания это не грубо, а правда, не люблю лебезить,
Искренне считаю, если человек знает, всегда скажет что не так, хоть ночью разбуди, а здесь одна показуха, я разработчик, но типа я не консультирую, да бред это,
Вот если я сейчас знаю, то и могу рассказать свободно. как и чего достиг:
Операционная система Windows профессионал, 7, 64
Зашел на сайт архива http://109.233.229.20:81/%28%D1%83 меня есть предварительная регистрация)
выбрал архив с 5 листами(маленький для пробы)
На ПК уже предварительно установлен ХРОМ, согласно требованиям разработчика
Из поста > Как скачать документ из АИС
скопировал текст программы и выполнил рекомендации
получил данные, сохранил файл
Взял из репозитория, указанного в этом же посте взял программу и файлы, скачал в отдельную папку
Установил GO?
а далее как раз затык, что надо сделать
Вот о чем речь
а вот далее все опять более менее понятно
скачиваем программу и устанавливаем Sublime Text 3
открываем cgodownloader.go,через правую кнопку мыши
правим строки
согласно поста Volhvuk
в этой строке пишется размер шрифта и разрешение, 10 и 1024 соответственно
А вот дальше я не знаю, раз владелец не хочет консультировать, жду жаждущих, чтобы совместно одолеть этого зверя
" http://pastebin.com/raw.php?i=VamLswki%22
" http://pastebin.com/VamLswki%22
Не хочется доставлять работникам архива неудобства.
И ещё, уважаемый Евгений, подскажите пожалуйста, ваша программа качает в несколько потоков одновременно? Можно регулировать количество потоков, например сделать равным 1 ?
Программа отработала, но файлы в директории не появились
Во вторых скармливать нужно строкой вида:
C:\gopath>cgodownloader.exe -
Комментарий для Volhvuk:
Да, можно.По-умолчанию, работает на скачивание количество потоков (горутин) равное удвоенному количеству процессоров. Это строка N := runtime.NumCPU() * 2. Замените её на N := 1
Спасибо! А то я чувствую, что 16 потоков многовато =)
Евгений поясни, почему иногда после запуска, сохраняются только названия файлов, с размером 0, а иногда, этот же файл сохраняется нормально
Поддержкой программы я не занимаюсь.
Пробовал на последней версии Хром на разных машинах. Доходит до40-70 страницы и вываливается с вот этим:
что бы это могло быть?
«На последней версии Хрома», а не «Хром».
Что это такое — сказать трудно, судя по ошибке, сработала
Проверил в Firefox: стоит, как статуя, страницы не листает. В Опере — работает!
Иногда встречаются дела, где число файлов в списке больше числа страниц. Глюк
Вопрос что делать? …каким то образом выгружать данные из оперативки на HDD или настроить хром чтоб не сохранял в памяти просмотренные изображения… но как? Есть идеи?
Теперь хочу, чтобы он умел скачивать дела целиком.
Хотелось бы чтобы VBA в режиме реального времени а) определял id картинки следующей страницы б) скачивал ее в) возвращался к а) пока листы в деле не закончатся.
Есть идеи как это сделать?
У меня что ли? Нет, никакого желания задумываться об этом.
По поводу работы консоли, думаю, если сразу после кэширования id остановить загрузку страницы (получение данных), процесс перелистывания дела будет намного быстрее.
К сожалению сам не умею такого написать.
Комментарий для LuckyLuke:
Где это, у меня нет там никакого кеширования id
Как только нужное получено, сразу начинается загрузка следующей страницы, это, естественно, останавливает загрузку предыдущей
Комментарий для LuckyLuke:
Нет, неиз-за этого. Из-за задержки сети и длительности ответа сервера.
В последнее время документ невозможно скачать в глубоком разрешении… в чем причина не знаю, но при открытии инструмента разработчика стала вылетать ошибка https://cgaso.regsamarh.ru/javascript/sugg …
p/s Windows 7
Скорее всего закончился годовой доступ.
const url = ` http://%s/Pages/ImageFilePart.ashx?Crop=Fa … 6Zoom=1%60
Комментарий для Alex (Иван):
Да нет, я недавно оформлял новый. Но у менякакие-то перебои с доступом — пускает не с первого раза.
Существует ли на данный момент рабочий способ скачивания дел из Самарского архива?
Огромное спасибо за Ваш труд, несколько раз очень выручал.
Сейчас АИС архивы переходят на шифрование (https) и скачать ну никак не получается, скачиваются страницы с просьбой авторизоваться (шапка ниже). Никак не могу придумать, как запустить код на скачивание прямо из консоли браузера, после авторизации. Данной проблемой никто в рунете больше не занимался, поэтому вся надежда на Вас =)
Вход в систему АИС
По сути нужно перекомпоновать готовый код, чтобы он запускал из консоли браузера и не требовал подгрузки внешнего файла, а текст из файла просто ручками добавить в качестве массива. Но никак не пойму чем и как заменить функцию подгрузки внешнего файла на массив правильного формата.
Утилита написана на Гоу, она не может запускаться в консоли браузера, там нужен другой язык программирования. Когда я смотрел в последний раз, что они там переделали, у меня сложилось впечатление, что мою утилиту нужно будет писать с нуля, прежний способ работать не будет.
```
var imgs =
if (imgs && imgs[0]) {
var page = imgs[0].src.match(/Id=([^&]+)/)[1];
```
т.е. поменял селектор для imgs, вместо переменной id использовал
Еще одна мысль — нужно брать со страницы имена файлов и использовать их. Сделать опцию для выбора имени файла — оригинальное либо сквозная нумерация, как сейчас.
```
!function () {
var id = '[id=storageFilesViewerPnl]';
var bt = '[id$=ForwardBtn]';
var pages = {};
var o = document.querySelector(id);
!function _observe(undefined) {
var ob = new MutationObserver(function() {
console.log(«mutator!»)
var imgs =
if (imgs && imgs[0]) {
var page = imgs[0].src.match(/Id=([^&]+)/)[1];
console.log(page)
if (pages[page] == undefined) {
var title = $('input#MainPlaceHolder__storageViewerControl__storageFilesViewerControl_FilesDropDownList_I').val()
console.log(«Title:» + title)
pages[page] = page + " : " + title;
var next = $(bt);
if (next && next[0]) {
next[0].click();
} else {
ob.disconnect();
console.clear();
console.log(Object.values(pages).join(«\n»));
}
}
}
});
ob.observe(o, { childList: true, attributes: true, subtree: true, attributeFilter: ['src'] });
}();
o.setAttribute('src', true);
}();
```
Результирующий файл обхожу скриптом на Perl (пока так, мне на перле быстрее всего мокапить)
```
#!/usr/bin/env perl
while () {
print «$1: $2\n»;
`curl -sS -C — --retry 5 --output '$2' 'http://gavo.arsvo.ru:8082/Pages/ImageFileP … =$1'`;
}
}
```