А давайте увеличим этот снимок ещё в 1000 раз…
Смотрели с женой шестую серию сериала «Элементарно» (хороший, кстати), там главный герой, Шерлок на экране компьютера увеличивал изображение подозреваемого и оно из зернистого и нечёткого в доли секунды улучшилось настолько, что стало возможным разглядеть надпись на рубашке подозреваемого.
Сейчас будет много текста и рассуждений, напрягитесь.
Жена спросила правда ли такое возможно, на что я ответил «конечно нет», но сам вспомнил свой давний умственный эксперимент.
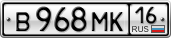
Вот смотрите, берём, например, российский автомобильный номер. На первой, четвёртой и пятой позиции там одна из двенадцати букв (это те буквы, которые в нашем алфавите совпадают по написанию с латинскими, только они используются у нас в номерах), на остальных — цифры. Между прочим, это номер моей группы (968), в которой я учился в Университете и факультет (ВМК).
Мысленно откроем этот файл в редакторе и уменьшим раз в пять, так чтобы он стал нечитаемым, пусть не полностью, а в большинстве деталей. Уменьшаем
В жизни, на обычных фотоснимках работает не графический редактор, но я предполагаю, что физики достаточно знают об этих явлениях, чтобы нарисовать
А, впрочем, зачем нам уменьшать мысленно, давайте я это в редакторе просто сделаю:
И вот мы смотрим на получившееся изображение и понимаем, что это автомобильный номер, даже некоторые цифры различаем, но не понимаем какой. Можем ли мы
Или вы думаете, что и так, без труда разбираете что там написано? Если так, то это заблуждение. На нём — В960НУ, а не В968МК, как на первом. Вот, посмотрите, разница между этими двумя уменьшенными номерами:
Нет ничего невозможного в том, чтобы «развернуть» функцию уменьшения изображения — придумать F’(IMAGE), которая бы давала обратный результат, только с одним «но». Думаю, достаточно очевидно, что функция уменьшения теряет часть информации, то есть обязательно найдутся минимум два изображения, которые дадут одинаковые уменьшенные картинки: image = F(IMAGE₁) и image = F(IMAGE₂).
Таким образом обратная функция вернёт нам не одно изображение, а набор изображений, из который наша F могла сделать уменьшенное изображение. Это было бы проблемой, если бы мы не знали на что мы смотрим. Однако, в данном случае нам дан контекст — это российский автомобильный номер.
К чему я веду. Наш номер написан вполне определённым шрифтом, у нас есть всего 10 или 12 вариантов правильного написания каждого знака, в зависимости от позиции. Если наша обратная функция дала нам множество возможных изображений, из них надо отобрать лишь те, которые дают на каждой позиции допустимый вариант. Возможно таких изображений останется всего ничего, а то и вообще одно.
Посмотрите ещё раз на разницу между уменьшенными изображениями номеров В960НУ и В968МК, на этот раз я увеличу изображение ещё в три раза:
Даже такие слаборазличающиеся номера достаточно заметно разнятся после уменьшения, что даёт надежду, что потери информации при уменьшении не столь значительны, чтобы потерять её вовсе.
В общем, я думаю, что в отдельных случаях (когда нам известно что перед нами), восстановление информации из сильно пиксилизированных изображений не фантастика, а вопрос вычислительных мощностей.
Собственно, те же рассуждения применимы и к алгоритмам другого рода — вроде тех, которым защищают приватную информацию, например, пикселиризации или смазыванию, если, конечно, нам известно информацию какого характера автор хотел скрыть. Отличный пример есть в блоге Леонида Каганова — четыре смазанные надписи, в которых нам известны все характеристики шрифта и используемый набор символов.
Комментарии 23
Ну, если никакащуй Elementary «хороший», то от нормального британского Sherlock должно просто порвать на сотни маленьких оргазмов :)
Спасибо! Досмотрю, буду знакомиться :)
Там совершенно другой алгоритм. Он базируется только на характере искажения (например, смазывание в определённую сторону) без учёта того что должно получиться (например, текст на русском,
шрифт Arial, 15 кегль).
Конечно, для текста он редко пригоден, к сожалению.
При этом я считаю, что автор молодец и статьи крайне интересны.
Комментарий для Евгения Степанищева:
«Наша обратная функция» даст нам абсолютно нереальное количество «возможных изображений». Чисто математически — если мы усреднили два пикселя в один, и получили пиксель со значением яркости 128 (из 256 возможных) — «возможных изображений» из двух пикселей будет 256 штук (от (0,255) до (255,0)). Точнее, вдвое больше, за счёт целочисленного округления:-) 10^100 вариантов при этом набирается ну о-очень легко.
пару-тройку параметров, определяющих форму размытия) по наилучшему совпадению с нашей исходной размытой фоткой, затем выбираем то изображение, которое после размытия оказалось ближе всего к нашей размытой фотке. Характеристика достоверности — насколько хуже ближайшая конкурирующая картинка совпадает с размытой фоткой чем картинка-победитель. как-то синхронизировать подбор параметров размытия для каждого из знаков — надёжность увеличится, скорость возрастёт.
какой-то момент алгоритм «сломается».
Поэтому подходить надо наоборот. Мы заранее знаем, какого вида изображение мы восстанавливаем — например, это «номер автомобиля». Исходя из этого у нас уже есть намного более реальное количество «возможных исходных изображений» (всего менее миллиарда для примера номера машины — это сильно меньше, чем 10^100), и нам примерно (а в некоторых случаях и точно) известен алгоритм размытия. Перебираем все варианты исходного изображения, для каждого — подбираем параметры размытия (координату, угол, масштаб, степень размытия,
Если использовать не весь номер, а повторять процедуру итеративно для каждой цифробуквы в номере — распознаваемость несколько ухудшится, зато вычислительные мощности понадобятся уже вполне реальные. Если в этом алгоритме ещё
Ну, и «оквадрачивание» в ФШ — намного более деструктивная операция, чем плавное размытие, потому что она убивает высокие пространственные частоты полностью, в то время как плавное размытие просто уменьшает их амплитуду. Соответственно, при расшифровке «мутных фоток» при росте мути будет плавно падать достоверность, при расшифровке «квадратиков» — в
Я ждал, что ты прокомментируешь и рад твоему дополнению, спасибо! :)
Надеюсь, у меня будет время попробовать что получится. Если ты имеешь ввиду, под моментом, когда алгоритм «сломается» размер пикселя в пикселеризации, то я ни в коем случае не утверждаю, что это будет всегда работать, конечно.
Т.е. вам видно, что там не В968МК, а В960НУ? Уменьшенная буква «м» выглядит ровно так же, как «н» для невооружённого глаза.
А букву «у» в этой загогулине я не различаю как не стараюсь.
Комментарий для Евгения Степанищева:
что касается распознавания номеров, весьма денежная, а поэтому закрытая тема.
Не, отличный сериал. На 5+.
ничего отличного, жалко потраченного времени.